
第14篇|魔术方法与数据模型
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 14 篇,也是本专栏收官篇。承接第 12 篇「类、实例、属性、方法」与第 13 篇「继承、多态、MRO」——你已经能建类型、建继承树;本篇把自定义类接到 Python 数据模型(data model) 上:让
len(obj)、print(obj)、obj == other、obj[i]、obj()等语法,落到你写的双下划线方法。为第 15 篇迭代器、第 17 篇上下文管理器、第 18 篇dataclass、第 28 篇最小 Agent、第 40~41 篇nn.Module/Dataset打桥。读完你
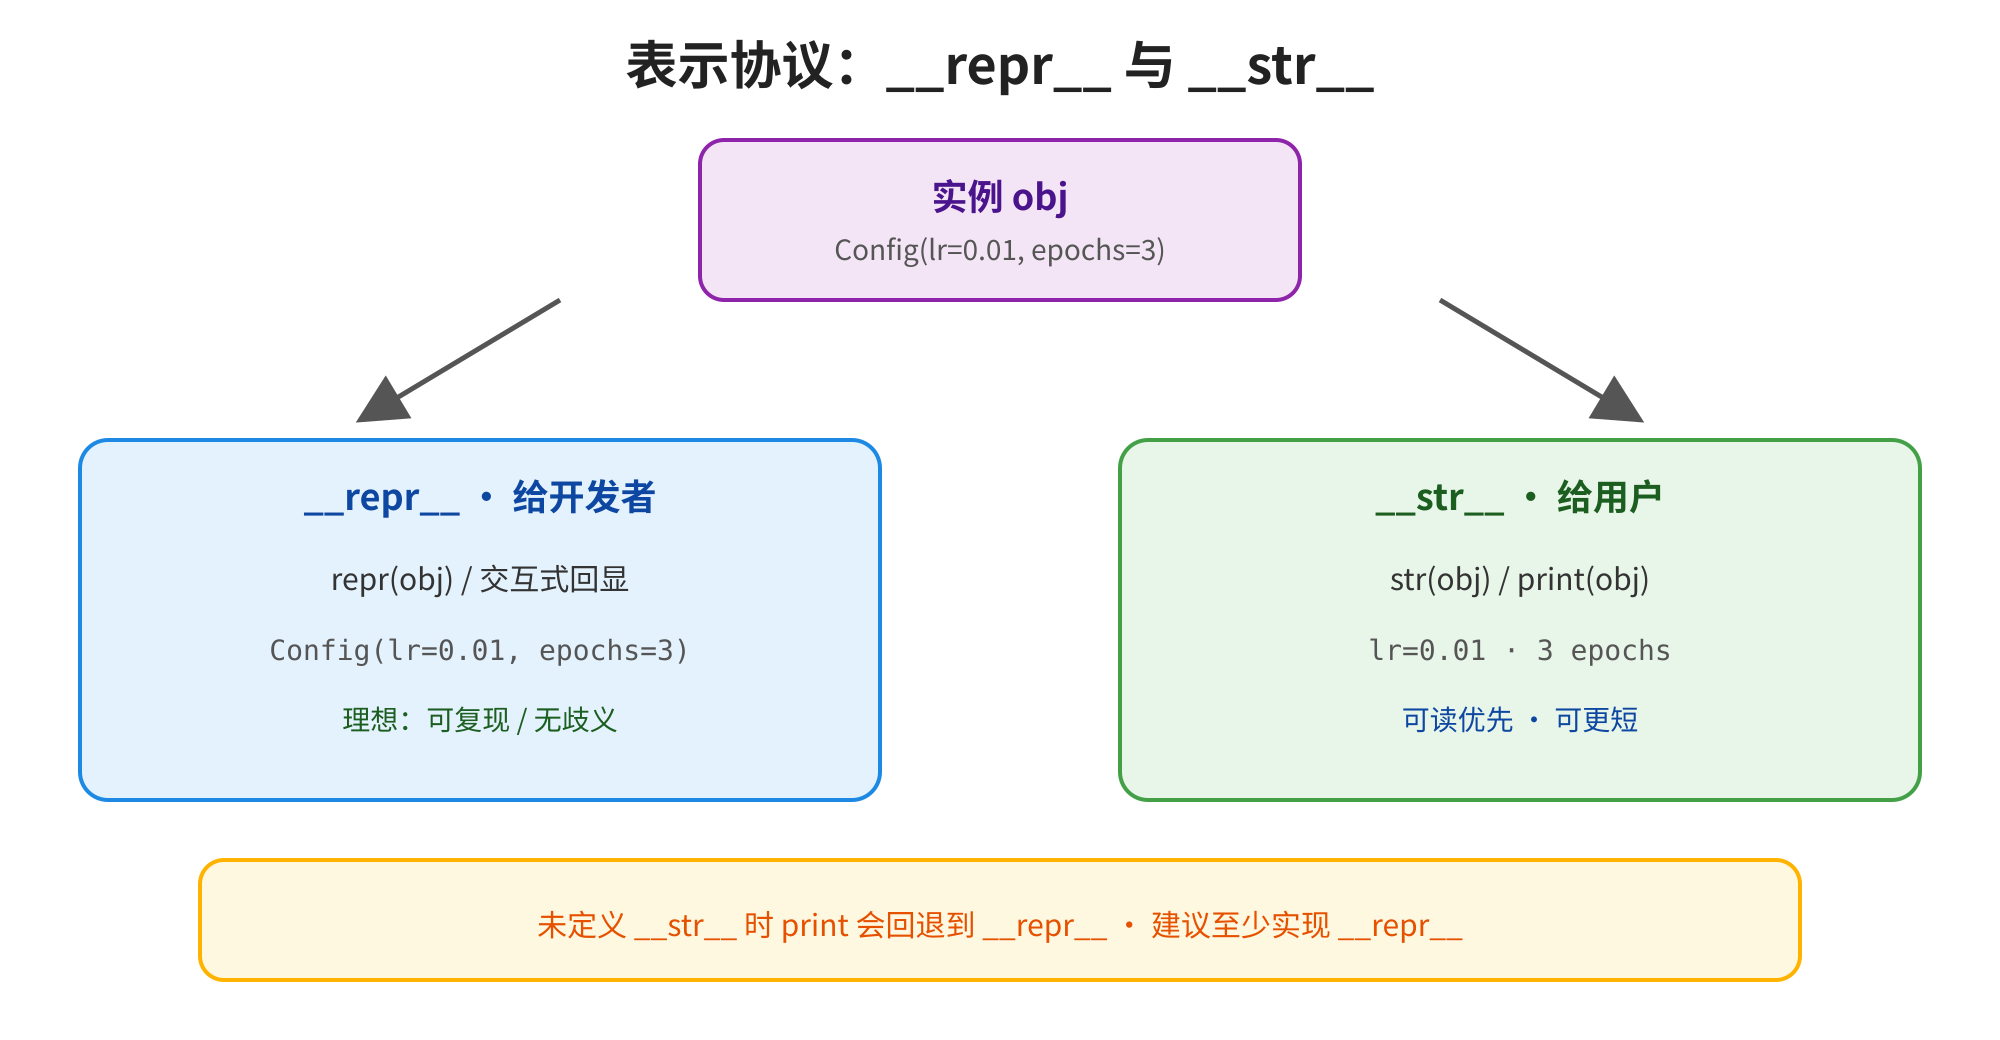
图片展示了表示协议中 __repr__与__str__的对应关系。上方紫色框为实例obj,下方分别以蓝色框和绿色框标注了__repr__和__str__的作用,__repr__给开发者,用于交互式回显,理想为可复现/无歧义;__str__给用户,用于str(obj)或print(obj),可读优先、可更短。底部黄色框提示,未定义__str__时__repr__,建议至少实现__repr__。/图片将能够:说清「语法糖 → 魔术方法」的对应关系;正确实现
repr/str;按契约写eq与hash;为类接上len/getitem/contains/iter;理解运算符重载与call;在 AI Infra / Agent 场景里给 Tool、Config、迷你 Dataset 接好协议。预计用时:阅读 35~45 分钟,动手 25~35 分钟。
第 12 篇让你能把数据与行为收进类型;第 13 篇让类型之间有关系。但打印一个 Tool 实例时,默认仍是 <Tool object at 0x...>——语言表面的操作还没认你的类。len(x)、x[i]、x + y、for i in x 背后,不是魔法,而是解释器按数据模型去找一组以双下划线命名的方法(magic methods / dunder methods)。本篇把常用协议讲透,并和前两篇的属性查找、继承覆盖接轨:这些方法仍按 MRO 查找,子类可以重写。
和第 02 篇会合:内置类型之所以“好用”,正是因为它们实现了同一套协议。和第 04、05 篇会合:列表下标、in、字典键,都依赖容器与哈希约定。和第 10 篇会合:with 背后是 enter / exit(本篇点到,第 17 篇展开)。下一篇起进入专栏二,第一条就是迭代器与生成器——本篇的 iter 是预告片。
建议边读边开练习目录(uv init --no-package)。阅读顺序:数据模型心智图 → 表示 → 相等与哈希 → 容器协议 → 运算符与 call → AI Infra 场景。踩坑大全请过一遍,尤其是「只写 eq 却仍当 dict 键」「getitem 越界不抛 IndexError」「可变对象实现 hash」。
也可以先用一句话定心:你想让语言怎么用你的对象,就实现对应的双下划线方法;协议是约定,不是语法关键词。 本篇把这句话拆开。
动手时建议继续沿用第 12、13 篇的 Tool / Config:先加 repr,再加字段相等,再做一个迷你 Dataset。对比“加协议前后”调用方写法——比背一张魔术方法表更有体感。
本篇不穷尽所有 dunder(官方文档很长)。主线是表示、相等/哈希、容器、算术与可调用;new 已在第 12 篇点过;上下文与迭代器留给 15、17。和“给每个操作写一个普通方法 get_length()”相比,协议的价值是:标准库与框架已经按这些名字调用——你接上,别人的 DataLoader / print / sorted 就能直接用。
和第 13 篇合在一起看:子类重写 repr 或 eq 时,查找仍走 MRO;super().eq(other) 可以复用父类比较逻辑。Mixin 里也可以放一组协议方法(例如统一日志风格的 repr),但别忘了协作式初始化的规矩。
和第 05 篇哈希表对照着读会更立体:dict / set 要求键可哈希,是因为桶定位依赖 hash;你自定义的键类型一旦破坏「相等 ⇒ 同哈希」,症状往往不是立刻崩溃,而是「明明放进去了却取不出来」——比语法错误更难查。本篇第三节会把这条铁律钉死。
也可以把数据模型看成「语言对外的 API」:普通方法是你自己模块的 API;dunder 是你对解释器与生态的 API。两边都要稳定、都要文档化意图。团队里若有人随手实现 add 做拼接、另一些人以为 + 是数值加,评审成本会陡增——协议该接时接,不该接时用命名方法更诚实。
读官方文档 Data Model 章节时不必一次吞完:按本篇目录对照查阅即可。遇到陌生名字(如 matmul、index),先问「有没有对应的表面语法或框架钩子」;没有强需求就搁置。入门阶段把常用插头接会,比收藏一百个方法名更重要。
一、数据模型:语法糖如何落到方法
1.1 心智模型
数据模型回答的是:内置操作如何作用于自定义对象。你可以把它想成一张对照表:左边是你写的表达式,右边是解释器实际调用的方法名。
这些方法写在类体里,和普通实例方法一样参与第 12 篇的属性查找与第 13 篇的 MRO;名字特殊,是因为语言与标准库按约定找它们。
1.2 为什么叫「魔术」又不必怕
「魔术」只表示:你很少自己写 obj.len(),而是写 len(obj),由解释器转发。调试时可以直接调 dunder 看行为,但生产代码应优先用公开语法(len / == / []),这样可读、且与内置类型一致。
class Box:
    def __init__(self, items: list[str]):
        self.items = items

    def __len__(self) -> int:
        return len(self.items)


b = Box(["a", "b", "c"])
print(len(b))
print(b.__len__())  # 能跑,但日常写法用左边
3
3
AI Infra 视角:PyTorch 的
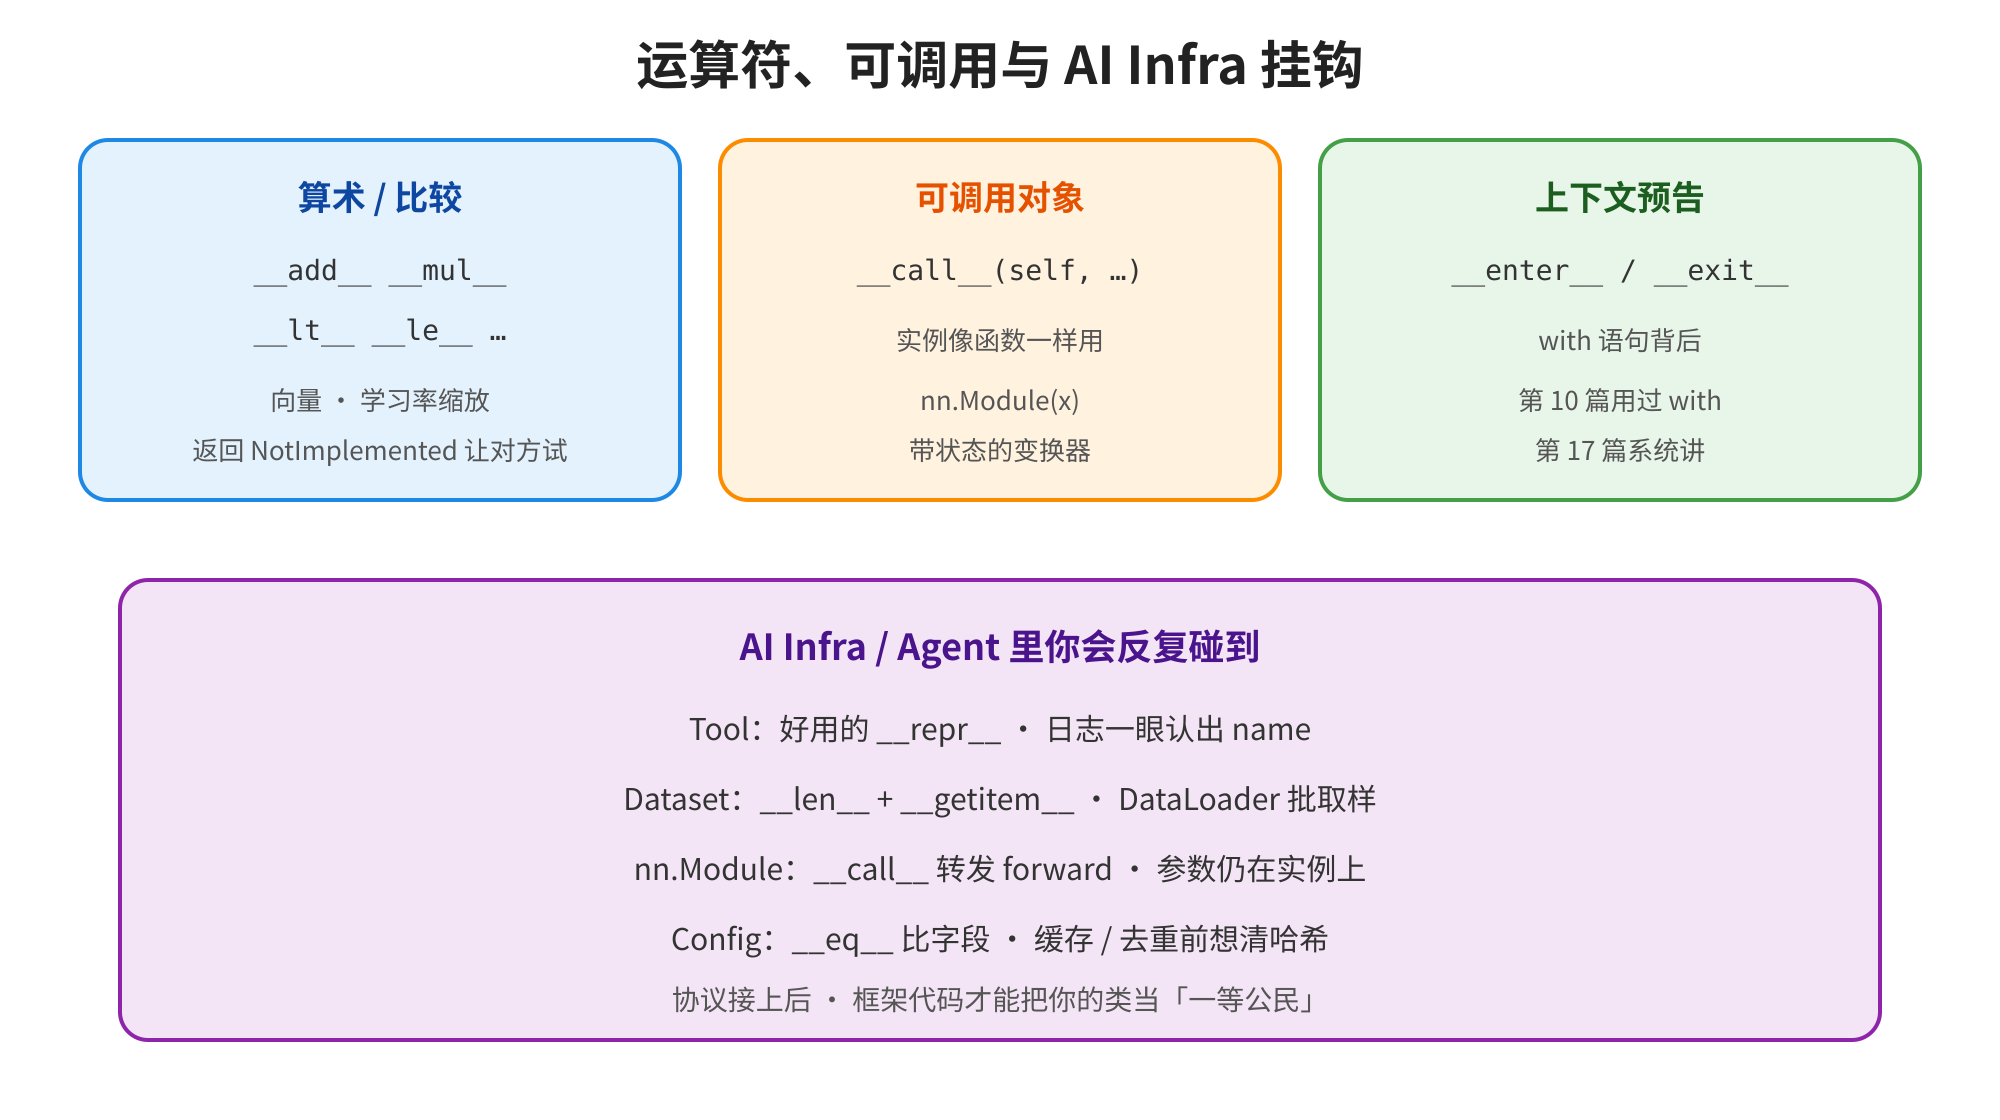
Dataset要求len/getitem;nn.Module靠call走forward;日志里清晰的repr能让你在 Agent 轨迹里一眼认出是哪个 Tool。接协议 = 让框架把你的类当一等公民。
1.3 和「普通方法」怎么选
若只有你们团队自己调用,普通方法 size() / get(i) 完全够用。一旦希望 len、for、下标、print、比较运算符开箱即用,或要对齐框架约定,就实现对应 dunder。两者可以并存:内部用清晰方法,再让 dunder 做薄封装。
经验上还有一条:协议暗示语义。看到 len,读者会假设「这是有限容器」;看到 call,会假设「这是一次调用语义清晰的变换」。若你的「长度」其实是远程近似值、每次调用还改全局状态,用普通方法名(如 estimate_size())比假扮 len 更不容易误导调用方与静态检查工具。
和鸭子类型(第 13 篇)合看:框架常常不要求你继承某个基类,只要求你「长得像」——有 getitem 和 len 就像 Dataset。这比名义继承更松,也更依赖你诚实实现协议语义(尤其是异常类型与复杂度预期)。
二、表示协议:repr 与 str
2.1 给开发者 vs 给用户
图2 表示协议:repr 与 str
repr:面向开发者与调试;理想情况下信息充分,甚至接近可重建对象的形式。str:面向终端用户或日志摘要;可以更短、更口语。
未定义 str 时,print / str() 会回退到 repr。因此至少实现 repr 是性价比最高的习惯。
class Tool:
    def __init__(self, name: str, description: str):
        self.name = name
        self.description = description

    def __repr__(self) -> str:
        return f"Tool(name={self.name!r}, description={self.description!r})"

    def __str__(self) -> str:
        return f"[{self.name}] {self.description}"


t = Tool("echo", "echo the query")
print(repr(t))
print(t)       # 走 __str__
print(f"tool={t!r}")  # !r 强制用 repr
Tool(name='echo', description='echo the query')
[echo] echo the query
tool=Tool(name='echo', description='echo the query')
!r / {self.name!r} 会调用 repr,字符串自带引号,避免空格或特殊字符造成歧义——写 repr 时很常用。
2.2 默认表示有多难读
class Bare:
    pass


print(Bare())
<__main__.Bare object at 0x...>
(具体地址因运行而异。)调试 Agent 工具链时,一长串 object at 0x 几乎等于没信息。接上 repr 后,失败现场会友好一个数量级。
2.3 继承下的表示
子类可以重写 repr,或复用父类再追加字段:
class SearchTool(Tool):
    def __init__(self, name: str, description: str, top_k: int = 3):
        super().__init__(name, description)
        self.top_k = top_k

    def __repr__(self) -> str:
        return (
            f"SearchTool(name={self.name!r}, "
            f"description={self.description!r}, top_k={self.top_k})"
        )


print(repr(SearchTool("search", "toy", top_k=5)))
SearchTool(name='search', description='toy', top_k=5)
这与第 13 篇的重写同一套路:查找在子类命中;需要父类片段时再显式拼或 super()(对 repr 更常见的是子类自己拼完整字符串)。
2.4 日志与安全
repr 很适合进日志,但也容易泄露密钥:若 Config 里有 api_key,不要原样打进表示字符串。可打印末四位、或根本不纳入 repr。Agent 轨迹若会外发到观测平台,这条更重要——调试友好与密钥最小暴露要一起设计。
另一实务:容器的 repr 默认会递归拼元素的 repr。元素实现糟糕时,一次 print(batch) 可能刷屏或触发重计算。大数据结构可提供 summary() 普通方法,repr 只报类型与长度(像上文 PairDataset(n=3))。
三、相等与哈希:eq / hash
3.1 默认:比身份
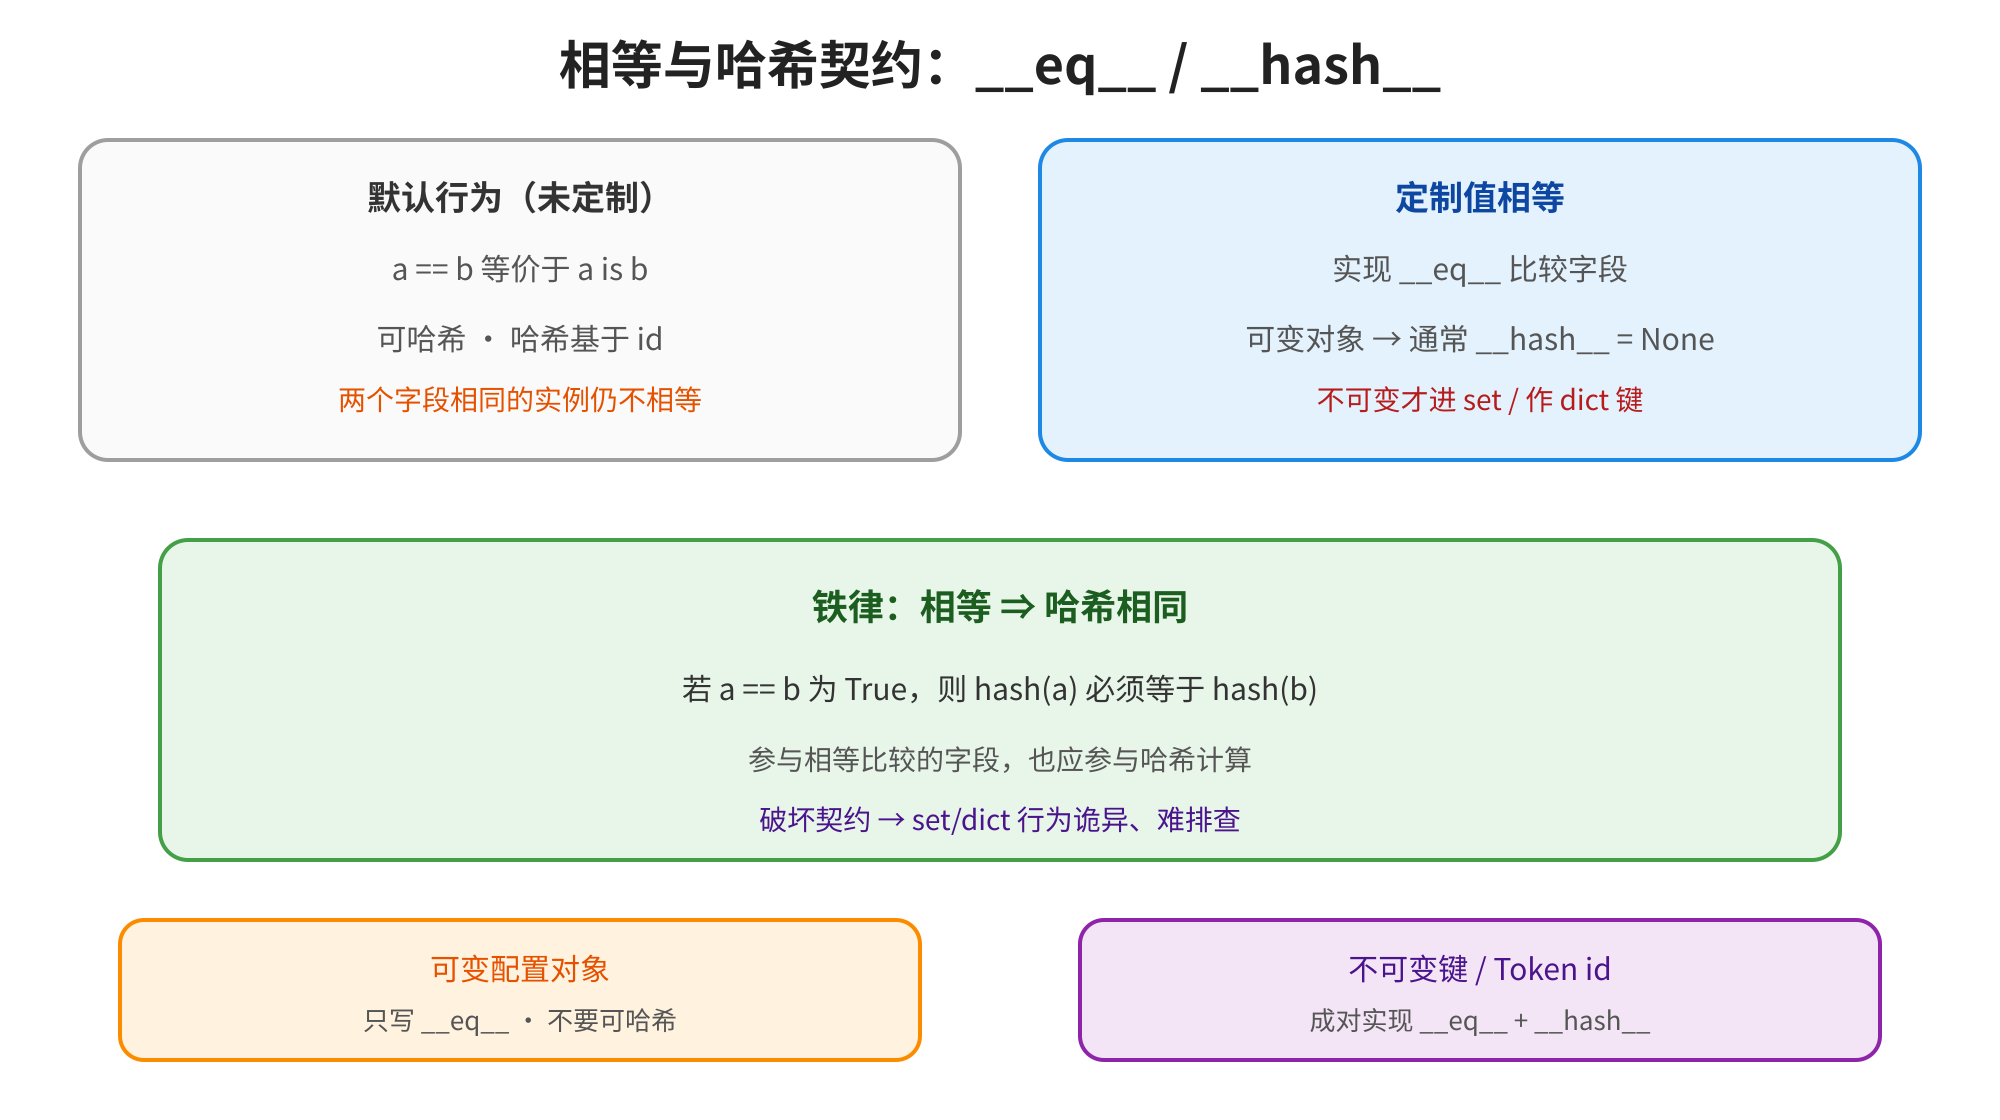
第 12 篇提醒过:未定制时 == 往往与 is 同类——比的是是不是同一个对象。
class Config:
    def __init__(self, lr: float, epochs: int):
        self.lr = lr
        self.epochs = epochs


a = Config(0.01, 3)
b = Config(0.01, 3)
print(a == b, a is b)
False False
字段一模一样,默认仍不相等。缓存键、测试断言、去重时,这常是意外来源。
3.2 定制值相等
图3 相等与哈希契约
class Config:
    def __init__(self, lr: float, epochs: int):
        self.lr = lr
        self.epochs = epochs

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, Config):
            return NotImplemented
        return self.lr == other.lr and self.epochs == other.epochs


a = Config(0.01, 3)
b = Config(0.01, 3)
c = Config(0.02, 3)
print(a == b, a == c, a == {"lr": 0.01})
True False False
返回 NotImplemented(不是抛 NotImplementedError)表示“我不知道怎么和这种类型比”,让对方有机会试反射方法。对不相干类型返回 False 也可以,但 NotImplemented 更符合运算符协议。
3.3 哈希契约(铁律)
实现 eq 后,若类仍可哈希,必须保证:相等的对象哈希值相同。可变对象(字段事后会改)通常设 hash = None,明确不可入 set / 不作 dict 键:
class Config:
    def __init__(self, lr: float, epochs: int):
        self.lr = lr
        self.epochs = epochs

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, Config):
            return NotImplemented
        return self.lr == other.lr and self.epochs == other.epochs

    __hash__ = None  # 可变配置:不可哈希


a = Config(0.01, 3)
try:
    {a}
except TypeError as e:
    print(type(e).__name__)
TypeError
若对象逻辑上不可变(例如冻结的超参快照、token 键),再成对实现:
class FreezeConfig:
    def __init__(self, lr: float, epochs: int):
        self._lr = lr
        self._epochs = epochs

    @property
    def lr(self) -> float:
        return self._lr

    @property
    def epochs(self) -> int:
        return self._epochs

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, FreezeConfig):
            return NotImplemented
        return self._lr == other._lr and self._epochs == other._epochs

    def __hash__(self) -> int:
        return hash((self._lr, self._epochs))


s = {FreezeConfig(0.01, 3), FreezeConfig(0.01, 3)}
print(len(s))
1
AI Infra 视角:实验配置去重、请求缓存键、批内样本 id,都依赖「相等」语义是否按值。可变
nn.Module实例几乎从不该靠默认身份当缓存键;要缓存就抽不可变的key元组或冻结配置。
3.4 排序:lt 等
sorted(list_of_obj) 需要比较。可以实现 lt,或使用 @functools.total_ordering(第 19 篇会再遇 functools)。入门期先保证 eq 正确;需要排序时再补 lt,并保持与相等一致(不要出现 a == b 且 a < b)。
class Ranked:
    def __init__(self, name: str, score: float):
        self.name = name
        self.score = score

    def __repr__(self) -> str:
        return f"Ranked({self.name!r}, {self.score})"

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, Ranked):
            return NotImplemented
        return self.score == other.score and self.name == other.name

    def __lt__(self, other: object) -> bool:
        if not isinstance(other, Ranked):
            return NotImplemented
        return (self.score, self.name) < (other.score, other.name)


print(sorted([Ranked("b", 0.2), Ranked("a", 0.9), Ranked("c", 0.2)]))
[Ranked('b', 0.2), Ranked('c', 0.2), Ranked('a', 0.9)]
检索结果重排、按置信度排序候选 Tool,都会用到这套比较。注意:只定义 lt 而不定义 eq 时,排序与去重行为可能让人意外——成对思考更稳。
3.5 和身份运算符分工
is / is not 不会走 eq,永远比身份。缓存里「是不是同一个模块对象」、单例判断,用 is;业务相等用 ==。调试时两者都打印,常能立刻分清「值相同但不是同一份」还是「根本不是一个东西」。
四、容器协议:长度、下标、成员、迭代
4.1 最小「序列样」对象
图4 容器协议
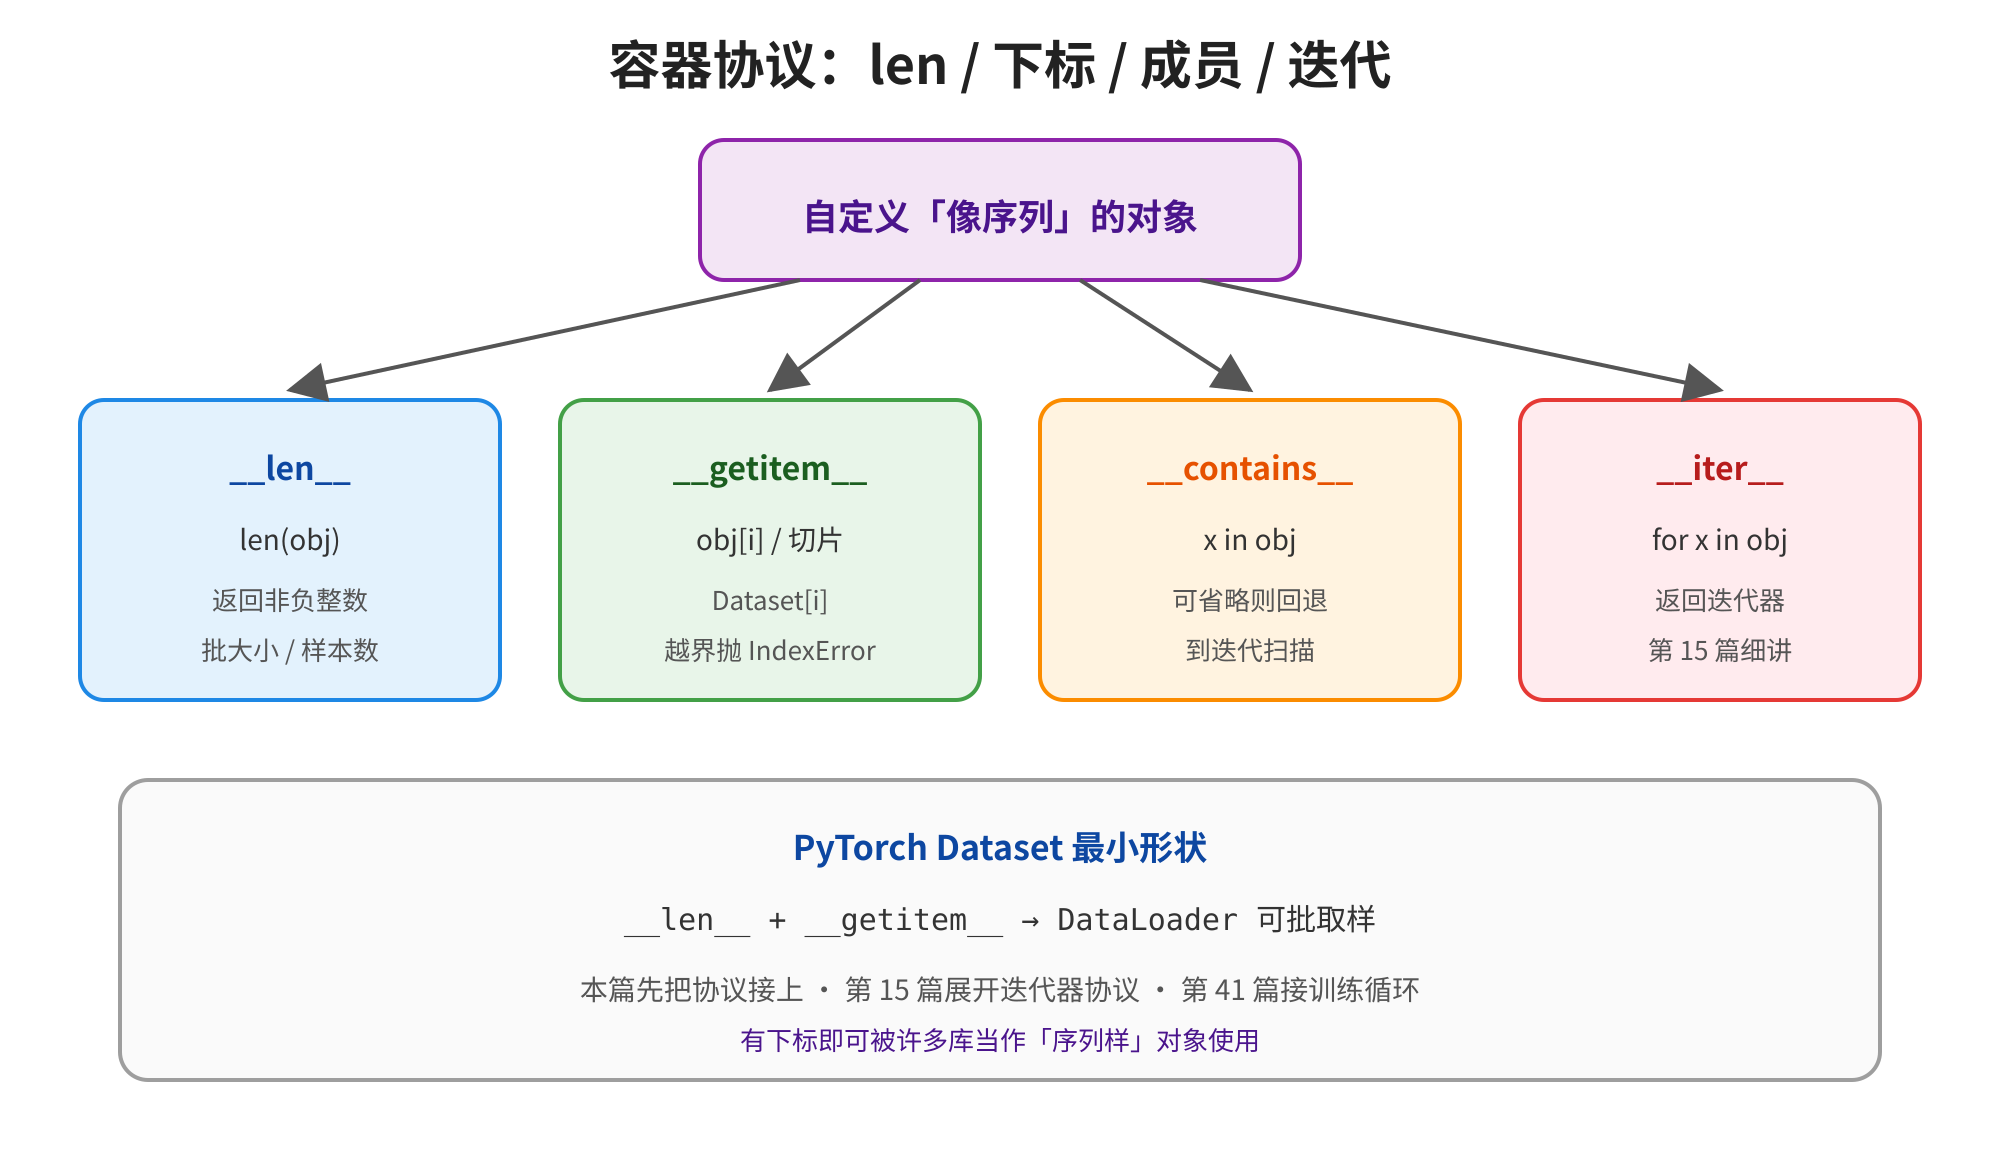
许多库(含 PyTorch Dataset)只要求你看起来像序列:
class ToyDataset:
    def __init__(self, rows: list[str]):
        self._rows = list(rows)

    def __len__(self) -> int:
        return len(self._rows)

    def __getitem__(self, index: int) -> str:
        return self._rows[index]


ds = ToyDataset(["alpha", "beta", "gamma"])
print(len(ds), ds[1])
print(ds[-1])
3 beta
gamma
getitem 越界时应抛 IndexError(不是 KeyError)——for 在仅有 getitem 时会靠不断递增下标、吃到 IndexError 结束。这是历史兼容路径;更明确的方式是实现 iter(下一篇)。
for row in ds:  # 依赖下标迭代约定
    print(row)
alpha
beta
gamma
4.2 contains 与 in
class ToyDataset:
    def __init__(self, rows: list[str]):
        self._rows = list(rows)

    def __len__(self) -> int:
        return len(self._rows)

    def __getitem__(self, index: int) -> str:
        return self._rows[index]

    def __contains__(self, item: object) -> bool:
        return item in self._rows


ds = ToyDataset(["alpha", "beta"])
print("beta" in ds, "zeta" in ds)
True False
不写 contains 时,解释器可能用迭代扫描;大数据集上会慢。成员测试很热时,显式实现更清晰。
4.3 iter 预告
class ToyDataset:
    def __init__(self, rows: list[str]):
        self._rows = list(rows)

    def __iter__(self):
        return iter(self._rows)


print(list(ToyDataset(["x", "y"])))
['x', 'y']
返回的是迭代器;生成器函数、yield、惰性流水线是第 15 篇的主菜。本篇只要你建立:for / list(obj) 会找 iter。
4.4 切片与映射味下标
getitem 的参数不一定是 int:切片 ds[1:3] 传入 slice 对象;若你做成「映射样」,也可能接收字符串键。入门 Dataset 先支持整数下标即可;若要支持切片,需自行解释 slice:
class ToyDataset:
    def __init__(self, rows: list[str]):
        self._rows = list(rows)

    def __len__(self) -> int:
        return len(self._rows)

    def __getitem__(self, index):
        if isinstance(index, slice):
            return ToyDataset(self._rows[index])
        return self._rows[index]


print(list(ToyDataset(["a", "b", "c", "d"])[1:3]))
['b', 'c']
(这里为演示让切片返回新 Dataset;也可以返回普通 list。关键是文档写清返回类型,避免调用方假设不一致。)
映射语义下缺键应抛 KeyError,与序列的 IndexError 不同——这是第 05 篇字典与第 04 篇列表在协议层的分界,自定义类同样要守。
五、运算符与可调用:add、call 等
5.1 算术重载与 NotImplemented
class Vector2:
    def __init__(self, x: float, y: float):
        self.x = x
        self.y = y

    def __repr__(self) -> str:
        return f"Vector2({self.x}, {self.y})"

    def __add__(self, other: object):
        if not isinstance(other, Vector2):
            return NotImplemented
        return Vector2(self.x + other.x, self.y + other.y)

    def __mul__(self, scalar: object):
        if not isinstance(scalar, (int, float)):
            return NotImplemented
        return Vector2(self.x * scalar, self.y * scalar)


print(Vector2(1, 2) + Vector2(3, 4))
print(Vector2(1, 2) * 10)
Vector2(4, 6)
Vector2(10, 20)
左侧不行时返回 NotImplemented,解释器会尝试右侧的反射方法(如 radd)。强行 raise 会打断这条协作链。
5.2 call:实例当函数用
图5 运算符、可调用与 AI Infra
class Linear:
    def __init__(self, w: float, b: float):
        self.w = w
        self.b = b

    def __call__(self, x: float) -> float:
        return self.w * x + self.b


f = Linear(2.0, 1.0)
print(f(3.0), callable(f))
7.0 True
这与第 08 篇闭包、第 12 篇「带状态的行为」同一需求:可调用对象把参数存在实例上。PyTorch 的 module(x) 本质是 call 里编排 hooks 再进 forward——第 40 篇会展开;本篇先记住:实现 call 就能让实例出现在调用位置。
5.3 上下文管理器点到为止
第 10 篇的 with open(...) 依赖 enter / exit。自定义资源(临时目录、计时器、CUDA stream)也会实现这对方法。完整写法、抑制异常、可重入等留到第 17 篇;本篇只需知道它们同样是数据模型的一部分。
5.4 还有哪些常见但不展开的
getattr 能做出非常「聪明」的代理对象,也极易让 AttributeError 语义变模糊、拖慢属性路径。入门期优先显式属性与 @property(第 12 篇);真要做 SDK 懒加载再研究。
六、把协议接到 Tool / Config / Dataset
6.1 可日志的 Tool
延续第 12、13 篇:
class Tool:
    def __init__(self, name: str, description: str):
        self.name = name
        self.description = description

    def run(self, query: str) -> str:
        raise NotImplementedError

    def __repr__(self) -> str:
        return f"{type(self).__name__}(name={self.name!r})"


class EchoTool(Tool):
    def run(self, query: str) -> str:
        return f"echo: {query}"


tools = {"echo": EchoTool("echo", "echo the query")}
print(tools["echo"])
print(tools["echo"].run("ping"))
EchoTool(name='echo')
echo: ping
Agent 轨迹里打印 tools.values() 时,类型名 + name 通常就够定位。
6.2 按值比较的配置
class ModelConfig:
    def __init__(self, model: str, max_tokens: int):
        self.model = model
        self.max_tokens = max_tokens

    def __repr__(self) -> str:
        return f"ModelConfig({self.model!r}, max_tokens={self.max_tokens})"

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, ModelConfig):
            return NotImplemented
        return self.model == other.model and self.max_tokens == other.max_tokens

    __hash__ = None


print(ModelConfig("toy", 128) == ModelConfig("toy", 128))
True
6.3 迷你 Dataset
class PairDataset:
    """(text, label) 列表 · 对齐 PyTorch Dataset 最小协议。"""

    def __init__(self, pairs: list[tuple[str, int]]):
        self._pairs = list(pairs)

    def __len__(self) -> int:
        return len(self._pairs)

    def __getitem__(self, index: int) -> tuple[str, int]:
        return self._pairs[index]

    def __repr__(self) -> str:
        return f"PairDataset(n={len(self)})"


data = PairDataset([("hi", 0), ("agent", 1), ("infra", 1)])
print(data, len(data), data[1])
PairDataset(n=3) 3 ('agent', 1)
第 41 篇的 DataLoader 正是在这类协议上批取样;本篇先把形状摆对。
AI Infra 视角:读框架源码时,优先搜
getitem/call/repr,比搜业务方法名更快定位扩展点。协议是框架与你的代码的「插头规格」。
6.4 一张「先接什么」清单
面向本系列后续,可以按优先级记:
- 任何会进日志的领域对象 →
repr(Tool、Config、Client)。 - 要断言 / 去重 / 当键的不可变快照 →
eq+hash;可变配置 →eq+hash = None。 - 训练 / 评测数据 →
len+getitem(Dataset 形状)。 - 带参变换、层、可调用策略 →
call。 - 资源与临时状态 → 等第 17 篇的上下文协议;流式数据 → 等第 15 篇迭代器。
不必第一天全接。先让调试与框架接入不痛,再按需加深。和第 13 篇一样:扩展点有名字、有约定,比临时 if-else 更可演进——只不过本篇的「名字」是语言级的 dunder,而不是你自己的基类方法名。
把第 12 篇的 CallableTool(持有函数)与本篇 call 对照:前者是组合「有一个可调用」;后者是「自己就是可调用」。需要热换算法时组合往往更灵活;需要分层、hooks、与 nn.Module 对齐时,call 更自然。两者可以同时出现:模块 call 内部再委托给策略对象。
七、踩坑大全
7.1 表示与相等
坑 1:只靠默认 object at 0x 调试。 现象:日志里分不清是哪个 Tool / Config。解决:至少实现 repr,关键字段写进字符串。
坑 2:eq 里对错误类型直接 return False 且从不考虑反射。 现象:与其他类型互操作时行为僵硬。解决:不相干类型返回 NotImplemented;用 isinstance 收窄后再比字段。
坑 3:实现 eq 后仍把可变实例放进 set。 现象:TypeError: unhashable type,或更糟——旧式类在改哈希语义后行为怪异。解决:可变对象显式 hash = None;需要入 set 时用冻结快照或字段元组当键。
坑 4:破坏「相等 ⇒ 同哈希」。 现象:dict / set 找不到明明「相等」的键。解决:参与 eq 的字段同步参与 hash;哈希后不要再改这些字段。
7.2 容器与运算符
坑 5:getitem 越界抛 KeyError 或返回 None。 现象:依赖下标的 for 无法正常结束或静默吞错。解决:序列语义抛 IndexError;映射语义才用 KeyError。
坑 6:len 返回负数或非整数。 现象:TypeError / 怪异行为。解决:返回 int 且 >= 0。
坑 7:算术方法里对不支持类型 raise TypeError 而非 NotImplemented。 现象:阻断 radd 等反射协作。解决:自己处理不了就 return NotImplemented。
7.3 工程与 AI Infra
坑 8:在 init 里调用会触发子类重写的 repr / 业务 dunder,且依赖尚未赋完的字段。 现象:半初始化态报错。解决:初始化阶段少触发多态钩子;与第 12、13 篇同一提醒。
坑 9(Agent):Tool 相等性含不稳定字段(时间戳、随机 id)。 现象:测试偶发失败、缓存命不中。解决:相等只比稳定业务字段;调试信息放 repr 不必进 eq。
坑 10(Dataset):getitem 有副作用(读文件却不缓存、改全局状态)。 现象:多进程 DataLoader worker 下行为难复现。解决:尽量纯函数式按 index 取样;副作用放到明确的生命周期里。
class BadEq:
    def __init__(self, x: int):
        self.x = x

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, BadEq):
            return NotImplemented
        return self.x == other.x
    # 忘记处理 hash:在 3.x 中定义了 __eq__ 后默认变不可哈希


print(BadEq.__hash__ is None)
True
(CPython 3 中,类定义了 eq 但未定义 hash 时,hash 会被设为 None——这是保护;不要误以为还能靠身份哈希。)
八、小结
合上文章后,试着用自己的话解释:为什么 print(obj) 会找 str/repr,以及为什么「相等的对象必须同哈希」。讲得清,才算真的会了。动手练习建议至少跑通:给 Tool 加 repr、给 Config 写 eq、实现迷你 Dataset 的 len/getitem。
- 数据模型:内置语法按约定调用双下划线方法;协议让自定义类接入语言与框架。
- 表示:优先实现
repr;需要友好摘要再写str;!r便于无歧义。 - 相等与哈希:默认比身份;定制
eq后处理哈希——可变则hash = None,不可变则成对实现并守契约。 - 容器:
len/getitem构成 Dataset 最小形状;contains/iter按需补齐。 - 运算符与
call:返回NotImplemented以协作;call做出带状态的可调用对象(通向nn.Module)。 - 与 12/13 衔接:dunder 仍走属性查找与 MRO;子类可重写,框架靠协议识别你的类型。
把故事连起来:对象与引用(02)→ 类与实例(12)→ 继承与 MRO(13)→ 本篇用魔术方法接入数据模型。专栏一到此收官;下一篇起专栏二从迭代器与生成器开篇,把 iter 与 yield 讲透,并走向装饰器、类型注解与工程化。
若只能带走一句话:想让语言怎么用你的对象,就实现对应 dunder;相等与哈希必须同契约。
也可以用“三个不要”自检:不要留下默认 object at 0x 当唯一日志;不要让可变对象可哈希;不要在 getitem 越界时抛错类型。
再留一个自测:写出 len(obj) / obj[i] / obj == other / obj() 各自对应的方法名;说明为何 Dataset 最小需要 len+getitem;解释 NotImplemented 与 NotImplementedError 的区别——三问都顺,本篇就站稳了。
本篇技能会立刻复利:读开源库时先扫 dunder;写 Agent Tool 时先保证 repr;接训练数据时先摆对 Dataset 协议。先把“插头规格”接准,比背五十个方法名更划算。
和专栏一前面各篇串起来复习一遍也不亏:环境与工具链(01)保证你跑得动例子;对象模型(02)解释「方法在类上、状态常在实例」;容器与哈希(04/05)是 getitem / hash 的语义土壤;函数与闭包(07/08)对照 call;文件与 with(10)预告上下文协议;异常(11)提醒协议里要抛对异常类型;OOP 两篇(12/13)提供查找与继承舞台——本篇是把自定义类型推上语言主舞台的最后一块板。
九、课后练习
- (基础) 给第 12 篇风格的
User(name, age)实现repr与str,打印repr/print对比。 - (基础) 实现
Tool的repr为EchoTool(name='...')形式(含子类名);放进列表后打印整个列表。 - (基础) 写
PairDataset:len+getitem;用for遍历并手动访问ds[0]。 - (理解) 为
Config(lr, epochs)实现eq,设hash = None;演示==为真且不能放入set。 - (理解) 实现不可变
FreezeConfig的eq+hash;证明两个等值实例在set中合并为一个。 - (理解) 写
Vector2的add/mul;对不支持类型返回NotImplemented,观察Vector2(1,2) + "x"的TypeError。 - (进阶) 实现带
call的Adder(n),使Adder(3)(10) == 13;再写简洁repr。 - (进阶 · AI Infra) 综合:
BaseTool+EchoTool(repr)+ModelConfig(eq)+PairDataset;打印工具、比较两份配置、按 index 取两条样本。思考:哪些协议是框架硬性要求,哪些只是调试体验?
下一篇预告
专栏一在本篇收官:你已经能建类、建继承、并让对象接入 Python 数据模型。专栏二「Python 进阶与工程」的第一篇是《第15篇|迭代器与生成器》——会把本篇点到的 iter / next 展开为完整迭代器协议,讲清 yield、生成器表达式、惰性流水线,以及为何 DataLoader、大文件扫描、Agent 事件流都爱用生成器。装饰器(16)、上下文管理器(17)、类型注解与 dataclass(18)会紧随其后。
专栏二后续路线:迭代器与生成器 → 装饰器 → 上下文管理器 → 类型注解 / dataclass / Pydantic → 标准库精选与工程化 → 并发与 asyncio → HTTP 与 FastAPI → 最小 Agent 实战。带着本篇的「协议插头」直觉,读源码时先找 dunder,再跟业务逻辑。
若你想提前热身:给 ToyDataset 显式写 iter 返回 iter(self._rows);再尝试把 iter 写成带 yield 的生成器方法(可先查文档或自行试验)。做完后第 15 篇谈迭代器协议时你会带着具体对象,而不是抽象术语表。
也可以把第 04 篇的列表遍历、第 10 篇的文件行迭代,与本篇的 getitem / iter 对照:都是「按需产生下一个元素」;生成器把这种模式变成语言一等写法。
若时间充裕,再多做一件事:对任意自写实例打印 dir(obj),找出所有 xxx,对照数据模型文档猜用途——你会同时复习第 12 篇的命名空间与本篇的协议表。这些都是日后啃 nn.Module、Dataset 与 Agent 框架的零件。
专栏一从环境搭建走到数据模型,主线其实一条:对象、命名空间、查找规则、再加协议。之后每一篇进阶主题,都是在这条主线上加刀具,而不是另起炉灶。
收官前再留一个对照练习:同一份 Config,分别只用字典、用「裸类无 dunder」、用「接好 repr/eq 的类」三种写法,走一遍「打印调试 → 断言相等 → 尝试进 set」。你会清楚感受到:协议不是语法糖游戏,而是把自定义类型抬到与内置类型同一套操作面的关键一步——也是专栏二工程化与框架对接的入场券。
(具体地址因运行而异。)调试 Agent 工具链时,一长串 object at 0x 几乎等于没信息。接上 repr 后,失败现场会友好一个数量级。
2.3 继承下的表示
子类可以重写 repr,或复用父类再追加字段:
class SearchTool(Tool):
    def __init__(self, name: str, description: str, top_k: int = 3):
        super().__init__(name, description)
        self.top_k = top_k

    def __repr__(self) -> str:
        return (
            f"SearchTool(name={self.name!r}, "
            f"description={self.description!r}, top_k={self.top_k})"
        )


print(repr(SearchTool("search", "toy", top_k=5)))
SearchTool(name='search', description='toy', top_k=5)
这与第 13 篇的重写同一套路:查找在子类命中;需要父类片段时再显式拼或 super()(对 repr 更常见的是子类自己拼完整字符串)。
2.4 日志与安全
repr 很适合进日志,但也容易泄露密钥:若 Config 里有 api_key,不要原样打进表示字符串。可打印末四位、或根本不纳入 repr。Agent 轨迹若会外发到观测平台,这条更重要——调试友好与密钥最小暴露要一起设计。
另一实务:容器的 repr 默认会递归拼元素的 repr。元素实现糟糕时,一次 print(batch) 可能刷屏或触发重计算。大数据结构可提供 summary() 普通方法,repr 只报类型与长度(像上文 PairDataset(n=3))。
三、相等与哈希:eq / hash
3.1 默认:比身份
第 12 篇提醒过:未定制时 == 往往与 is 同类——比的是是不是同一个对象。
class Config:
    def __init__(self, lr: float, epochs: int):
        self.lr = lr
        self.epochs = epochs


a = Config(0.01, 3)
b = Config(0.01, 3)
print(a == b, a is b)
False False
字段一模一样,默认仍不相等。缓存键、测试断言、去重时,这常是意外来源。
3.2 定制值相等
图3 相等与哈希契约
class Config:
    def __init__(self, lr: float, epochs: int):
        self.lr = lr
        self.epochs = epochs

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, Config):
            return NotImplemented
        return self.lr == other.lr and self.epochs == other.epochs


a = Config(0.01, 3)
b = Config(0.01, 3)
c = Config(0.02, 3)
print(a == b, a == c, a == {"lr": 0.01})
True False False
返回 NotImplemented(不是抛 NotImplementedError)表示“我不知道怎么和这种类型比”,让对方有机会试反射方法。对不相干类型返回 False 也可以,但 NotImplemented 更符合运算符协议。
3.3 哈希契约(铁律)
实现 eq 后,若类仍可哈希,必须保证:相等的对象哈希值相同。可变对象(字段事后会改)通常设 hash = None,明确不可入 set / 不作 dict 键:
class Config:
    def __init__(self, lr: float, epochs: int):
        self.lr = lr
        self.epochs = epochs

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, Config):
            return NotImplemented
        return self.lr == other.lr and self.epochs == other.epochs

    __hash__ = None  # 可变配置:不可哈希


a = Config(0.01, 3)
try:
    {a}
except TypeError as e:
    print(type(e).__name__)
TypeError
若对象逻辑上不可变(例如冻结的超参快照、token 键),再成对实现:
class FreezeConfig:
    def __init__(self, lr: float, epochs: int):
        self._lr = lr
        self._epochs = epochs

    @property
    def lr(self) -> float:
        return self._lr

    @property
    def epochs(self) -> int:
        return self._epochs

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, FreezeConfig):
            return NotImplemented
        return self._lr == other._lr and self._epochs == other._epochs

    def __hash__(self) -> int:
        return hash((self._lr, self._epochs))


s = {FreezeConfig(0.01, 3), FreezeConfig(0.01, 3)}
print(len(s))
1
AI Infra 视角:实验配置去重、请求缓存键、批内样本 id,都依赖「相等」语义是否按值。可变
nn.Module实例几乎从不该靠默认身份当缓存键;要缓存就抽不可变的key元组或冻结配置。
3.4 排序:lt 等
sorted(list_of_obj) 需要比较。可以实现 lt,或使用 @functools.total_ordering(第 19 篇会再遇 functools)。入门期先保证 eq 正确;需要排序时再补 lt,并保持与相等一致(不要出现 a == b 且 a < b)。
class Ranked:
    def __init__(self, name: str, score: float):
        self.name = name
        self.score = score

    def __repr__(self) -> str:
        return f"Ranked({self.name!r}, {self.score})"

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, Ranked):
            return NotImplemented
        return self.score == other.score and self.name == other.name

    def __lt__(self, other: object) -> bool:
        if not isinstance(other, Ranked):
            return NotImplemented
        return (self.score, self.name) < (other.score, other.name)


print(sorted([Ranked("b", 0.2), Ranked("a", 0.9), Ranked("c", 0.2)]))
[Ranked('b', 0.2), Ranked('c', 0.2), Ranked('a', 0.9)]
检索结果重排、按置信度排序候选 Tool,都会用到这套比较。注意:只定义 lt 而不定义 eq 时,排序与去重行为可能让人意外——成对思考更稳。
3.5 和身份运算符分工
is / is not 不会走 eq,永远比身份。缓存里「是不是同一个模块对象」、单例判断,用 is;业务相等用 ==。调试时两者都打印,常能立刻分清「值相同但不是同一份」还是「根本不是一个东西」。
四、容器协议:长度、下标、成员、迭代
4.1 最小「序列样」对象
图4 容器协议
许多库(含 PyTorch Dataset)只要求你看起来像序列:
class ToyDataset:
    def __init__(self, rows: list[str]):
        self._rows = list(rows)

    def __len__(self) -> int:
        return len(self._rows)

    def __getitem__(self, index: int) -> str:
        return self._rows[index]


ds = ToyDataset(["alpha", "beta", "gamma"])
print(len(ds), ds[1])
print(ds[-1])
3 beta
gamma
getitem 越界时应抛 IndexError(不是 KeyError)——for 在仅有 getitem 时会靠不断递增下标、吃到 IndexError 结束。这是历史兼容路径;更明确的方式是实现 iter(下一篇)。
for row in ds:  # 依赖下标迭代约定
    print(row)
alpha
beta
gamma
4.2 contains 与 in
class ToyDataset:
    def __init__(self, rows: list[str]):
        self._rows = list(rows)

    def __len__(self) -> int:
        return len(self._rows)

    def __getitem__(self, index: int) -> str:
        return self._rows[index]

    def __contains__(self, item: object) -> bool:
        return item in self._rows


ds = ToyDataset(["alpha", "beta"])
print("beta" in ds, "zeta" in ds)
True False
不写 contains 时,解释器可能用迭代扫描;大数据集上会慢。成员测试很热时,显式实现更清晰。
4.3 iter 预告
class ToyDataset:
    def __init__(self, rows: list[str]):
        self._rows = list(rows)

    def __iter__(self):
        return iter(self._rows)


print(list(ToyDataset(["x", "y"])))
['x', 'y']
返回的是迭代器;生成器函数、yield、惰性流水线是第 15 篇的主菜。本篇只要你建立:for / list(obj) 会找 iter。
4.4 切片与映射味下标
getitem 的参数不一定是 int:切片 ds[1:3] 传入 slice 对象;若你做成「映射样」,也可能接收字符串键。入门 Dataset 先支持整数下标即可;若要支持切片,需自行解释 slice:
class ToyDataset:
    def __init__(self, rows: list[str]):
        self._rows = list(rows)

    def __len__(self) -> int:
        return len(self._rows)

    def __getitem__(self, index):
        if isinstance(index, slice):
            return ToyDataset(self._rows[index])
        return self._rows[index]


print(list(ToyDataset(["a", "b", "c", "d"])[1:3]))
['b', 'c']
(这里为演示让切片返回新 Dataset;也可以返回普通 list。关键是文档写清返回类型,避免调用方假设不一致。)
映射语义下缺键应抛 KeyError,与序列的 IndexError 不同——这是第 05 篇字典与第 04 篇列表在协议层的分界,自定义类同样要守。
五、运算符与可调用:add、call 等
5.1 算术重载与 NotImplemented
class Vector2:
    def __init__(self, x: float, y: float):
        self.x = x
        self.y = y

    def __repr__(self) -> str:
        return f"Vector2({self.x}, {self.y})"

    def __add__(self, other: object):
        if not isinstance(other, Vector2):
            return NotImplemented
        return Vector2(self.x + other.x, self.y + other.y)

    def __mul__(self, scalar: object):
        if not isinstance(scalar, (int, float)):
            return NotImplemented
        return Vector2(self.x * scalar, self.y * scalar)


print(Vector2(1, 2) + Vector2(3, 4))
print(Vector2(1, 2) * 10)
Vector2(4, 6)
Vector2(10, 20)
左侧不行时返回 NotImplemented,解释器会尝试右侧的反射方法(如 radd)。强行 raise 会打断这条协作链。
5.2 call:实例当函数用
图5 运算符、可调用与 AI Infra
class Linear:
    def __init__(self, w: float, b: float):
        self.w = w
        self.b = b

    def __call__(self, x: float) -> float:
        return self.w * x + self.b


f = Linear(2.0, 1.0)
print(f(3.0), callable(f))
7.0 True
这与第 08 篇闭包、第 12 篇「带状态的行为」同一需求:可调用对象把参数存在实例上。PyTorch 的 module(x) 本质是 call 里编排 hooks 再进 forward——第 40 篇会展开;本篇先记住:实现 call 就能让实例出现在调用位置。
5.3 上下文管理器点到为止
第 10 篇的 with open(...) 依赖 enter / exit。自定义资源(临时目录、计时器、CUDA stream)也会实现这对方法。完整写法、抑制异常、可重入等留到第 17 篇;本篇只需知道它们同样是数据模型的一部分。
5.4 还有哪些常见但不展开的
getattr 能做出非常「聪明」的代理对象,也极易让 AttributeError 语义变模糊、拖慢属性路径。入门期优先显式属性与 @property(第 12 篇);真要做 SDK 懒加载再研究。
六、把协议接到 Tool / Config / Dataset
6.1 可日志的 Tool
延续第 12、13 篇:
class Tool:
    def __init__(self, name: str, description: str):
        self.name = name
        self.description = description

    def run(self, query: str) -> str:
        raise NotImplementedError

    def __repr__(self) -> str:
        return f"{type(self).__name__}(name={self.name!r})"


class EchoTool(Tool):
    def run(self, query: str) -> str:
        return f"echo: {query}"


tools = {"echo": EchoTool("echo", "echo the query")}
print(tools["echo"])
print(tools["echo"].run("ping"))
EchoTool(name='echo')
echo: ping
Agent 轨迹里打印 tools.values() 时,类型名 + name 通常就够定位。
6.2 按值比较的配置
class ModelConfig:
    def __init__(self, model: str, max_tokens: int):
        self.model = model
        self.max_tokens = max_tokens

    def __repr__(self) -> str:
        return f"ModelConfig({self.model!r}, max_tokens={self.max_tokens})"

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, ModelConfig):
            return NotImplemented
        return self.model == other.model and self.max_tokens == other.max_tokens

    __hash__ = None


print(ModelConfig("toy", 128) == ModelConfig("toy", 128))
True
6.3 迷你 Dataset
class PairDataset:
    """(text, label) 列表 · 对齐 PyTorch Dataset 最小协议。"""

    def __init__(self, pairs: list[tuple[str, int]]):
        self._pairs = list(pairs)

    def __len__(self) -> int:
        return len(self._pairs)

    def __getitem__(self, index: int) -> tuple[str, int]:
        return self._pairs[index]

    def __repr__(self) -> str:
        return f"PairDataset(n={len(self)})"


data = PairDataset([("hi", 0), ("agent", 1), ("infra", 1)])
print(data, len(data), data[1])
PairDataset(n=3) 3 ('agent', 1)
第 41 篇的 DataLoader 正是在这类协议上批取样;本篇先把形状摆对。
AI Infra 视角:读框架源码时,优先搜
getitem/call/repr,比搜业务方法名更快定位扩展点。协议是框架与你的代码的「插头规格」。
6.4 一张「先接什么」清单
面向本系列后续,可以按优先级记:
- 任何会进日志的领域对象 →
repr(Tool、Config、Client)。 - 要断言 / 去重 / 当键的不可变快照 →
eq+hash;可变配置 →eq+hash = None。 - 训练 / 评测数据 →
len+getitem(Dataset 形状)。 - 带参变换、层、可调用策略 →
call。 - 资源与临时状态 → 等第 17 篇的上下文协议;流式数据 → 等第 15 篇迭代器。
不必第一天全接。先让调试与框架接入不痛,再按需加深。和第 13 篇一样:扩展点有名字、有约定,比临时 if-else 更可演进——只不过本篇的「名字」是语言级的 dunder,而不是你自己的基类方法名。
把第 12 篇的 CallableTool(持有函数)与本篇 call 对照:前者是组合「有一个可调用」;后者是「自己就是可调用」。需要热换算法时组合往往更灵活;需要分层、hooks、与 nn.Module 对齐时,call 更自然。两者可以同时出现:模块 call 内部再委托给策略对象。
七、踩坑大全
7.1 表示与相等
坑 1:只靠默认 object at 0x 调试。 现象:日志里分不清是哪个 Tool / Config。解决:至少实现 repr,关键字段写进字符串。
坑 2:eq 里对错误类型直接 return False 且从不考虑反射。 现象:与其他类型互操作时行为僵硬。解决:不相干类型返回 NotImplemented;用 isinstance 收窄后再比字段。
坑 3:实现 eq 后仍把可变实例放进 set。 现象:TypeError: unhashable type,或更糟——旧式类在改哈希语义后行为怪异。解决:可变对象显式 hash = None;需要入 set 时用冻结快照或字段元组当键。
坑 4:破坏「相等 ⇒ 同哈希」。 现象:dict / set 找不到明明「相等」的键。解决:参与 eq 的字段同步参与 hash;哈希后不要再改这些字段。
7.2 容器与运算符
坑 5:getitem 越界抛 KeyError 或返回 None。 现象:依赖下标的 for 无法正常结束或静默吞错。解决:序列语义抛 IndexError;映射语义才用 KeyError。
坑 6:len 返回负数或非整数。 现象:TypeError / 怪异行为。解决:返回 int 且 >= 0。
坑 7:算术方法里对不支持类型 raise TypeError 而非 NotImplemented。 现象:阻断 radd 等反射协作。解决:自己处理不了就 return NotImplemented。
7.3 工程与 AI Infra
坑 8:在 init 里调用会触发子类重写的 repr / 业务 dunder,且依赖尚未赋完的字段。 现象:半初始化态报错。解决:初始化阶段少触发多态钩子;与第 12、13 篇同一提醒。
坑 9(Agent):Tool 相等性含不稳定字段(时间戳、随机 id)。 现象:测试偶发失败、缓存命不中。解决:相等只比稳定业务字段;调试信息放 repr 不必进 eq。
坑 10(Dataset):getitem 有副作用(读文件却不缓存、改全局状态)。 现象:多进程 DataLoader worker 下行为难复现。解决:尽量纯函数式按 index 取样;副作用放到明确的生命周期里。
class BadEq:
    def __init__(self, x: int):
        self.x = x

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, BadEq):
            return NotImplemented
        return self.x == other.x
    # 忘记处理 hash:在 3.x 中定义了 __eq__ 后默认变不可哈希


print(BadEq.__hash__ is None)
True
(CPython 3 中,类定义了 eq 但未定义 hash 时,hash 会被设为 None——这是保护;不要误以为还能靠身份哈希。)
八、小结
合上文章后,试着用自己的话解释:为什么 print(obj) 会找 str/repr,以及为什么「相等的对象必须同哈希」。讲得清,才算真的会了。动手练习建议至少跑通:给 Tool 加 repr、给 Config 写 eq、实现迷你 Dataset 的 len/getitem。
- 数据模型:内置语法按约定调用双下划线方法;协议让自定义类接入语言与框架。
- 表示:优先实现
repr;需要友好摘要再写str;!r便于无歧义。 - 相等与哈希:默认比身份;定制
eq后处理哈希——可变则hash = None,不可变则成对实现并守契约。 - 容器:
len/getitem构成 Dataset 最小形状;contains/iter按需补齐。 - 运算符与
call:返回NotImplemented以协作;call做出带状态的可调用对象(通向nn.Module)。 - 与 12/13 衔接:dunder 仍走属性查找与 MRO;子类可重写,框架靠协议识别你的类型。
把故事连起来:对象与引用(02)→ 类与实例(12)→ 继承与 MRO(13)→ 本篇用魔术方法接入数据模型。专栏一到此收官;下一篇起专栏二从迭代器与生成器开篇,把 iter 与 yield 讲透,并走向装饰器、类型注解与工程化。
若只能带走一句话:想让语言怎么用你的对象,就实现对应 dunder;相等与哈希必须同契约。
也可以用“三个不要”自检:不要留下默认 object at 0x 当唯一日志;不要让可变对象可哈希;不要在 getitem 越界时抛错类型。
再留一个自测:写出 len(obj) / obj[i] / obj == other / obj() 各自对应的方法名;说明为何 Dataset 最小需要 len+getitem;解释 NotImplemented 与 NotImplementedError 的区别——三问都顺,本篇就站稳了。
本篇技能会立刻复利:读开源库时先扫 dunder;写 Agent Tool 时先保证 repr;接训练数据时先摆对 Dataset 协议。先把“插头规格”接准,比背五十个方法名更划算。
和专栏一前面各篇串起来复习一遍也不亏:环境与工具链(01)保证你跑得动例子;对象模型(02)解释「方法在类上、状态常在实例」;容器与哈希(04/05)是 getitem / hash 的语义土壤;函数与闭包(07/08)对照 call;文件与 with(10)预告上下文协议;异常(11)提醒协议里要抛对异常类型;OOP 两篇(12/13)提供查找与继承舞台——本篇是把自定义类型推上语言主舞台的最后一块板。
九、课后练习
- (基础) 给第 12 篇风格的
User(name, age)实现repr与str,打印repr/print对比。 - (基础) 实现
Tool的repr为EchoTool(name='...')形式(含子类名);放进列表后打印整个列表。 - (基础) 写
PairDataset:len+getitem;用for遍历并手动访问ds[0]。 - (理解) 为
Config(lr, epochs)实现eq,设hash = None;演示==为真且不能放入set。 - (理解) 实现不可变
FreezeConfig的eq+hash;证明两个等值实例在set中合并为一个。 - (理解) 写
Vector2的add/mul;对不支持类型返回NotImplemented,观察Vector2(1,2) + "x"的TypeError。 - (进阶) 实现带
call的Adder(n),使Adder(3)(10) == 13;再写简洁repr。 - (进阶 · AI Infra) 综合:
BaseTool+EchoTool(repr)+ModelConfig(eq)+PairDataset;打印工具、比较两份配置、按 index 取两条样本。思考:哪些协议是框架硬性要求,哪些只是调试体验?
下一篇预告
专栏一在本篇收官:你已经能建类、建继承、并让对象接入 Python 数据模型。专栏二「Python 进阶与工程」的第一篇是《第15篇|迭代器与生成器》——会把本篇点到的 iter / next 展开为完整迭代器协议,讲清 yield、生成器表达式、惰性流水线,以及为何 DataLoader、大文件扫描、Agent 事件流都爱用生成器。装饰器(16)、上下文管理器(17)、类型注解与 dataclass(18)会紧随其后。
专栏二后续路线:迭代器与生成器 → 装饰器 → 上下文管理器 → 类型注解 / dataclass / Pydantic → 标准库精选与工程化 → 并发与 asyncio → HTTP 与 FastAPI → 最小 Agent 实战。带着本篇的「协议插头」直觉,读源码时先找 dunder,再跟业务逻辑。
若你想提前热身:给 ToyDataset 显式写 iter 返回 iter(self._rows);再尝试把 iter 写成带 yield 的生成器方法(可先查文档或自行试验)。做完后第 15 篇谈迭代器协议时你会带着具体对象,而不是抽象术语表。
也可以把第 04 篇的列表遍历、第 10 篇的文件行迭代,与本篇的 getitem / iter 对照:都是「按需产生下一个元素」;生成器把这种模式变成语言一等写法。
若时间充裕,再多做一件事:对任意自写实例打印 dir(obj),找出所有 xxx,对照数据模型文档猜用途——你会同时复习第 12 篇的命名空间与本篇的协议表。这些都是日后啃 nn.Module、Dataset 与 Agent 框架的零件。
专栏一从环境搭建走到数据模型,主线其实一条:对象、命名空间、查找规则、再加协议。之后每一篇进阶主题,都是在这条主线上加刀具,而不是另起炉灶。
收官前再留一个对照练习:同一份 Config,分别只用字典、用「裸类无 dunder」、用「接好 repr/eq 的类」三种写法,走一遍「打印调试 → 断言相等 → 尝试进 set」。你会清楚感受到:协议不是语法糖游戏,而是把自定义类型抬到与内置类型同一套操作面的关键一步——也是专栏二工程化与框架对接的入场券。