
第09篇|模块包与 import 机制
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 9 篇。承接第 07~08 篇“会写函数、会做转发与闭包”,把可复用逻辑拆进多个
.py文件与包目录;讲清 CPython 的import查找、sys.modules缓存、包与命名空间包,以及循环导入与name == "main"——为第 10 篇文件路径、第 20 篇打包与推理服务多文件布局打地基。读完你将能够:解释模块是对象、一次
import做了哪几步;读懂并调整sys.path;区分模块与包、写出带init.py的包树;正确使用绝对/相对导入;用sys.modules理解“只执行一次”与循环导入;写出可被 import 也可直接运行的入口;知道importlib与懒导入在大型 ML 栈里为何常见。预计用时:阅读 35~45 分钟,动手 30~40 分钟。
前几篇你已经能在一个文件里写出函数、闭包和分发表。真实项目不会把推理服务、工具注册、配置解析全塞进单个 main.py——文件一长,定位、测试和协作都会崩。Python 的答案是:模块(module)与包(package),再用 import 把名字接到当前命名空间。
本篇不满足于“import os 就能用”。我们要顺着 CPython 的路径走一遍:谁在 sys.path 里、空 module 何时登记进 sys.modules、顶层代码何时执行、包目录里的 init.py 扮演什么角色、相对导入的点号相对谁、循环导入为什么会摸到半成品属性。弄清这些,ModuleNotFoundError、ImportError: cannot import name ... 才不再是玄学。
和第 02 篇的衔接很直接:模块也是对象——有 id、有 dict、属性访问就是查命名空间。和第 01 篇的衔接是:sys.path 很像 PATH,顺序决定“同名时用到哪一份”;虚拟环境换的是解释器与 site-packages。第 10 篇会谈路径与文件;本篇先把“代码文件如何变成可调用的名字”讲透。
建议边读边建一个练习目录(uv init --no-package),亲手拆两个模块互相 import,再故意制造一次循环导入看报错。阅读顺序:模块对象 → import 流程与 sys.path → 包与 init.py → 绝对/相对导入 → 缓存、循环导入与 importlib → 工程布局。踩坑大全请过一遍,尤其是“脚本当模块跑”和“相对导入在错误入口下失败”。
和“所有逻辑挤在一个文件”相比,本篇带来的最大变化是:名字可以跨文件复用,加载过程可解释、可缓存、可拆包。 弄清这三点,后面读多文件训练脚本和推理服务入口时,就不会只剩“哪个文件先 import 谁”的猜测。
也可以先用一句话定心:import 不是复制粘贴源码,而是查找 →(必要时)执行 → 缓存 → 绑定引用。 本篇把这句话拆开。
动手时建议把每个小节的代码存成独立小文件跑一遍:改 sys.path 观察谁被挡住、给包去掉 init.py 再在不同启动方式下试相对导入、在循环导入复现后再拆 c.py。比只朗读“包就是目录”记得牢。和第 07~08 篇一样,报错信息本身就是教材——尤其是 partially initialized module 与 no known parent package 两句,建议整句抄进笔记。
一、模块就是对象:一次 import 发生了什么
1.1 模块与 .py 文件
在日常说法里,“模块”常常等于“一个 .py 文件”。更准确地说:模块是解释器里的一个对象;多数情况下,它由某个源文件(或扩展模块、内置模块)加载而来。你写的 tools.py 被成功导入后,内存里会出现一个 types.ModuleType 实例,通常绑定到名字 tools。
import math

print(type(math))
print(math.__name__)
print(hasattr(math, "sqrt"))
print(math.sqrt(9))
<class 'module'>
math
True
3.0
math 是标准库里的(多为)内置/扩展模块,但接口形态与你自己的 .py 一样:都是模块对象上的属性。第 02 篇说“一切皆对象”——模块不例外。
还可以用 dir(math) 浏览导出名字,或 math.doc 看文档字符串。不必背全属性列表;建立直觉即可:你对 math.sqrt 做的事,和对自己模块里函数做的事,机制相同——都是属性查找。
自己写一个最小模块更直观。假设当前工作目录有 greet.py:
# greet.py
"""小模块示例。"""
PREFIX = "hi"

def hello(name: str) -> str:
    return f"{PREFIX}, {name}"

print("greet module loading...")
在同目录用解释器:
import greet

print(greet.PREFIX)
print(greet.hello("Py"))
print(greet.__file__)
首次导入时你会先看到 greet module loading...,再看到属性打印。这说明:导入不只是“挂个名字”,还会执行该模块顶层代码(函数与类的 def/class 也是顶层语句,执行后把对象绑到模块命名空间)。
1.2 模块的常用属性
加载完成后,模块对象上常见字段包括:
import greet

print(greet.__name__)
print("hello" in greet.__dict__)
print(greet.__dict__["PREFIX"])
greet
True
hi
(若你在交互里已导入过 greet,顶层 print 不会再跑——见第五节缓存。)
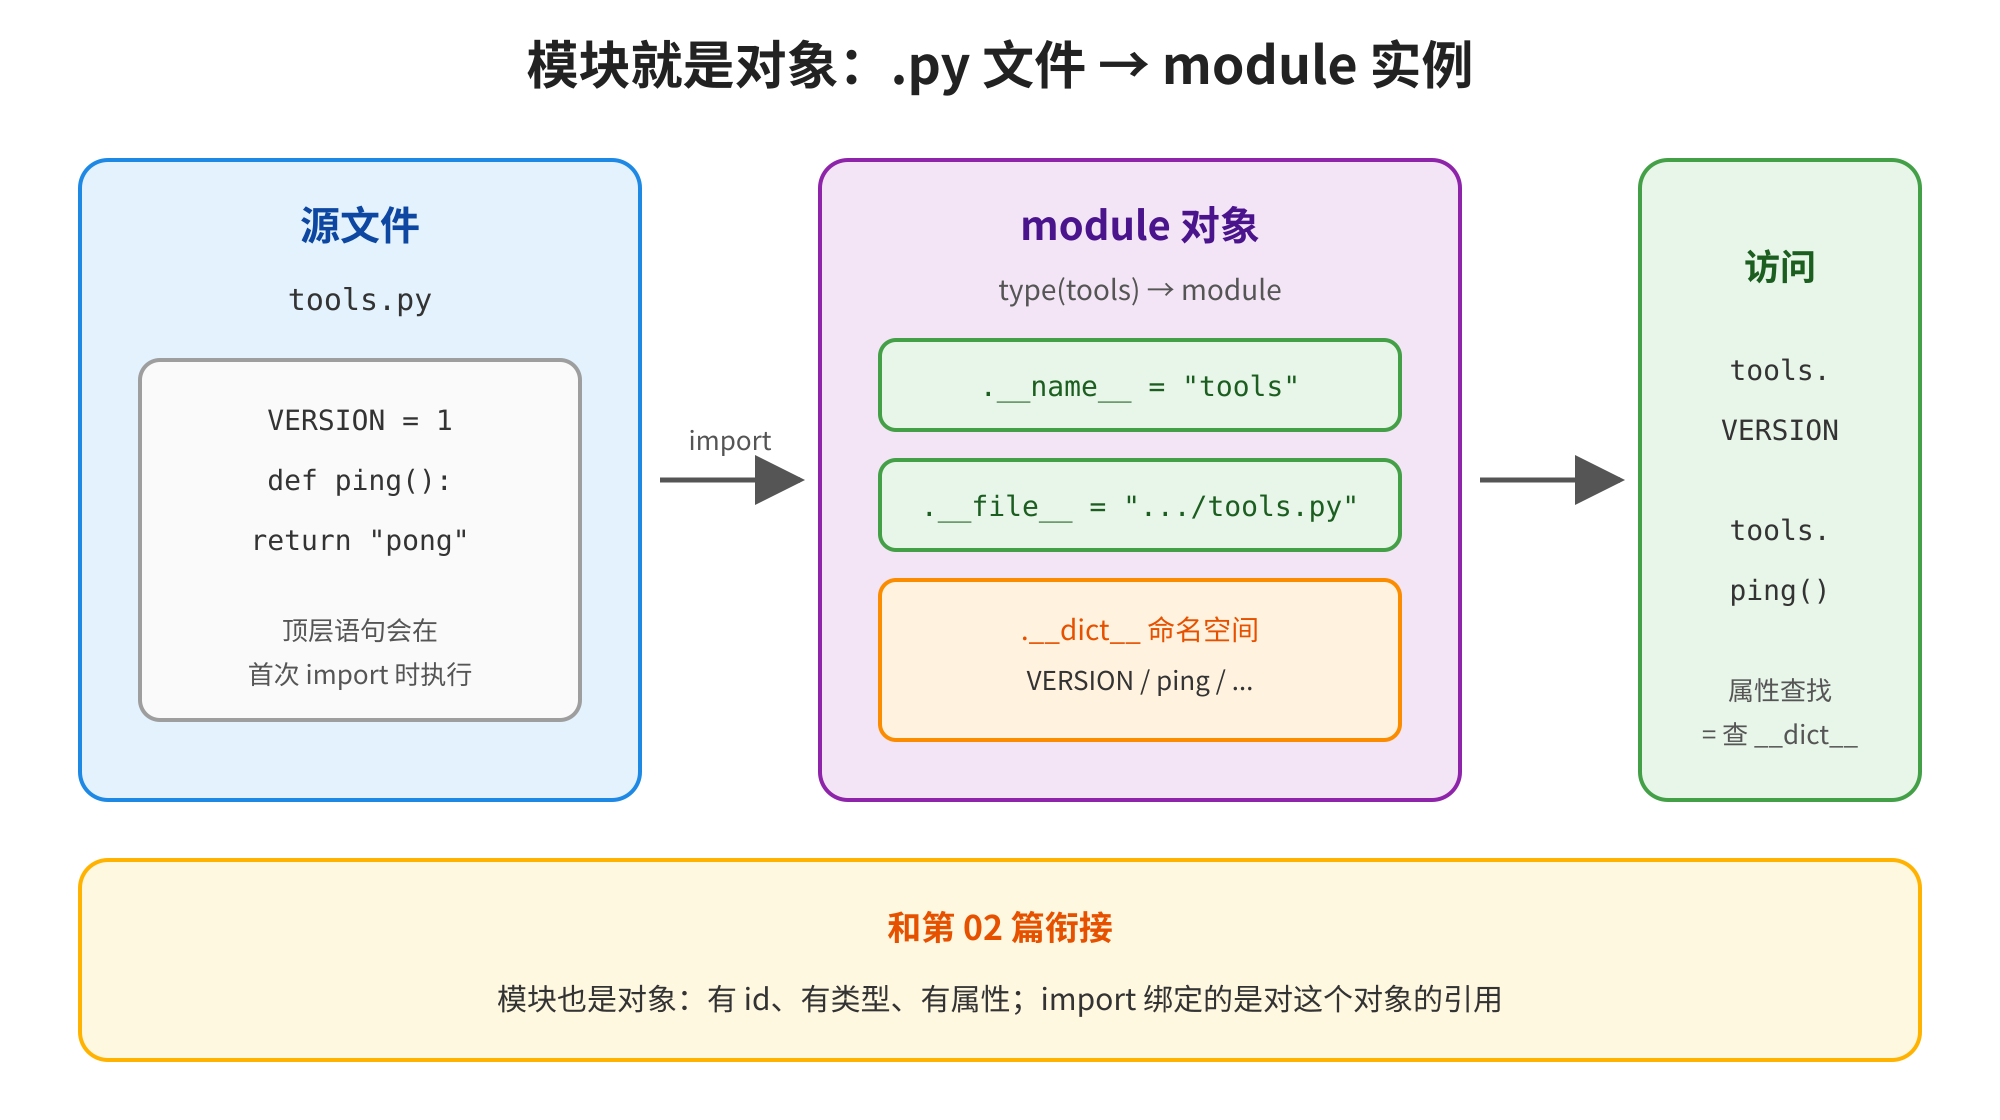
tools.py,包含VERSION和ping()函数,顶层语句会在首次import时执行。中间是module对象,包含_name、_file属性及__dict__命名空间,__dict__中存储VERSION、ping()等属性。右侧是访问模块对象的示例,如tools.VERSION、tools.ping()。底部说明模块也是对象,有id、类型、属性,import绑定的是对这个对象的引用,与上文导入模块执行顶层代码等内容相呼应。图1 模块就是对象:.py 文件 → module 实例
1.3 import / from ... import 绑定的是什么
三种常见写法,绑定结果不同:
import greet                 # 名字 greet → 模块对象
from greet import hello      # 名字 hello → 函数对象
from greet import PREFIX as P  # 名字 P → 当时的值/引用
注意:from greet import PREFIX 是在导入那一刻把 PREFIX 指向的对象绑到当前命名空间。若之后在 greet 模块里给 PREFIX 重新赋值,你这边的 PREFIX(或 P)不会自动跟着变——两边是不同的名字绑定(仍可能指向同一可变对象;若绑的是不可变 str,改模块内名字不影响你这边)。
import greet
from greet import PREFIX

greet.PREFIX = "hey"
print("module:", greet.PREFIX)
print("local :", PREFIX)
module: hey
local : hi
这和“函数参数传递名字绑定”(第 07 篇)是同一套模型,只是舞台换成了模块全局名。
AI Infra 视角
训练/推理仓库里常见
from model import Llama或import sglang as sgl。你拿到的是模块或其中的类/函数对象引用。搞清绑定时机,才不会误以为改了配置模块里的常量,所有from cfg import X的调用方都会自动更新。
二、查找路径:sys.path 与“找到哪一份”
2.1 sys.path 是什么
导入器要找名为 greet 的模块时,会沿 sys.path(字符串路径列表)从左到右搜索。这和第 01 篇的 PATH 心智模型几乎一样:顺序决定优先级,找到第一个就停。
import sys

for i, p in enumerate(sys.path[:6]):
    print(i, repr(p))
print("... total", len(sys.path))
0 ''
1 '/usr/lib/python312.zip'
...(后续为标准库、site-packages 等,随环境而变)
... total 6
(具体条目因安装与是否用 venv 而异;0 常常是空串 "",表示当前工作目录,或脚本所在目录——取决于启动方式。)
在仓库根目录执行 python scripts/train.py 时,插入 sys.path 前端的往往是 scripts/ 所在目录,而不是你以为的仓库根——于是 import my_infer 失败,而 import some_local_helper 却意外成功。这是“能跑但结构歪了”的高频源头。用 python -m 从包的父目录启动,路径语义更稳定。
常见来源包括:
- 脚本所在目录,或交互/
-c模式下的当前目录; - 环境变量
PYTHONPATH里的额外目录; - 标准库与安装相关路径;
- 虚拟环境 / 用户的
site-packages(第三方包落点)。
2.2 在每个目录里找什么
对名字 pkg,导入器大致会问:这里有没有 pkg.py?有没有 pkg 目录且可识别为包?有没有对应的扩展模块?先命中者获胜。因此:若项目根下不小心放了一个自己的 json.py,就可能挡住标准库 json——这是经典坑。
import sys
print(any(p.endswith("site-packages") for p in sys.path))
True
2.3 和虚拟环境的关系
第 01 篇激活 venv / 用 uv run,本质是换了一套解释器与它的 site-packages。import torch 失败时,先问“当前是哪个 python”(which python / sys.executable),再问“sys.path 里有没有装过 torch 的那个 site-packages”,比盲目 pip install 更有效。
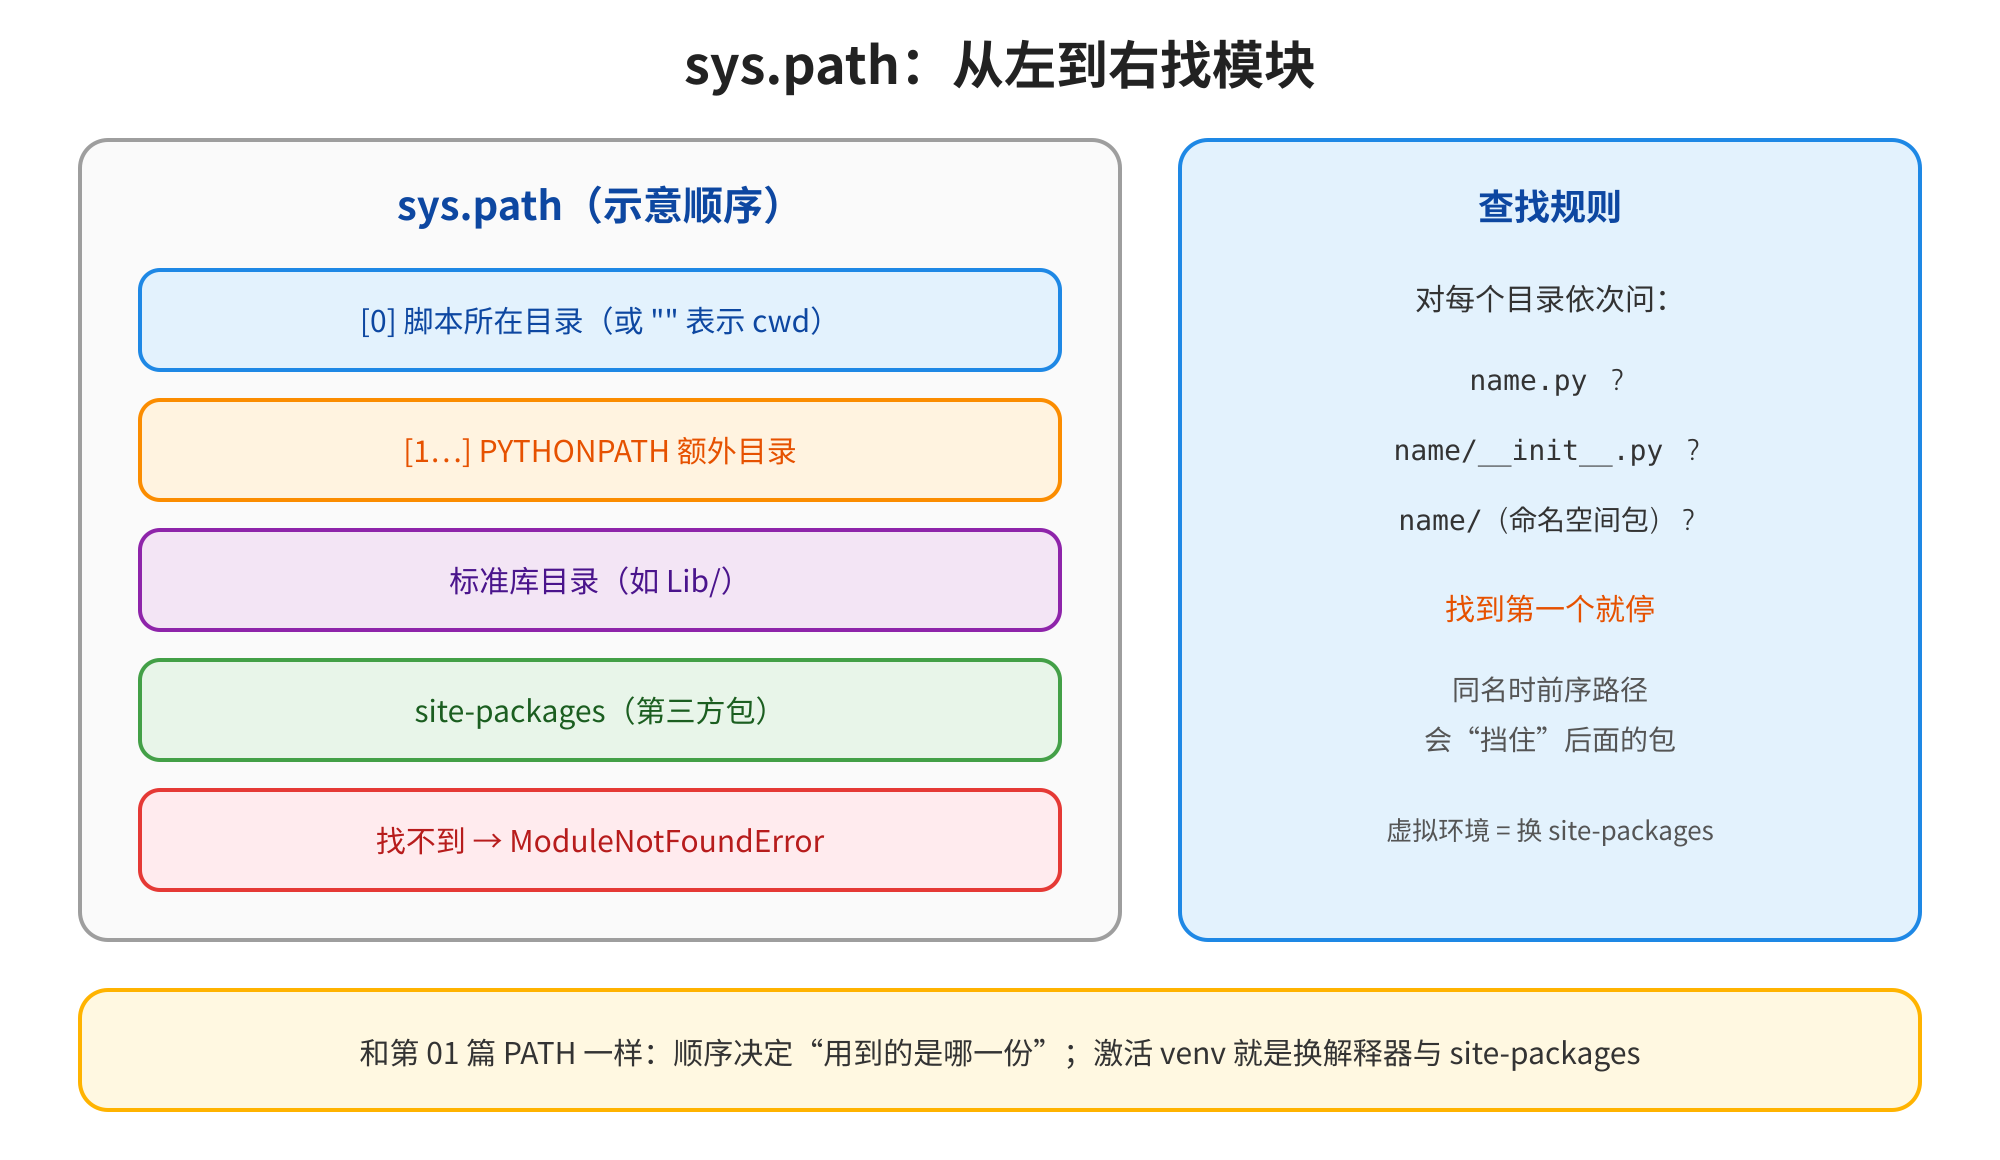
sys.path查找模块的示意图,标题为“sys.path:从左到右找模块”。左侧示意了sys.path的查找顺序,从左到右依次为[0]脚本所在目录(或cwd)、[1...]PYTHONPATH额外目录、标准库目录(如Lib/)、site-packages(第三方包),若仍未找到则会抛出ModuleNotFoundError。右侧则说明了对应的查找规则:对每个目录依次检查是否存在name.py、name/init.py或命名空间包,找到第一个匹配项就会停止查找,同时提示同名时的路径会“挡住”后续内容,激活虚拟环境就是切换解释器与site-packages,相关内容和文档中关于sys.path的说明对应,清晰展示了Python模块的查找逻辑。图2 sys.path:从左到右找模块
手动改 sys.path 可以救急(例如把仓库根目录插到最前),但长期更推荐:可安装包布局(第 20 篇)或在项目根用规范方式启动,而不是在每个文件里 sys.path.append(...)。
三、包(package):目录、init.py、命名空间包
3.1 模块 vs 包
| 模块 | 包 | |
|---|---|---|
| 常见形态 | 单个 .py | 目录(通常含 init.py) |
| 用途 | 一组相关函数/类/常量 | 组织多个子模块,形成层级名字 |
| 导入名示例 | import greet | import infer_app.models.mini |
| dict | 模块命名空间字典;greet.hello 本质是查它 |
包可以包含子包,形成树。层级用点号表示,对应目录层级。
3.2 init.py 做什么
传统(也是最常见教学)规则:目录里有 init.py 就被当成常规包。导入 infer_app 时会执行 infer_app/init.py,得到包模块对象;再导入子模块时继续加载对应文件。
init.py 可以是空文件,也可以在里面写“包级 API”:
# infer_app/__init__.py
__version__ = "0.1.0"

# 可选:把子模块符号提升到包级
# from .server import create_app
空 init.py 完全合法,且对初学者最省心:先保证目录是包,再慢慢往 init 里加导出。
注意:导入子模块 import infer_app.models.mini 时,解释器通常会先确保父包 infer_app、infer_app.models 已加载(它们也会进入 sys.modules)。因此 init.py 里若写了很重的逻辑(读配置、连网、导入 torch),即使用户只想用某一个很深的子模块,也可能先被父包初始化拖慢或拖垮。父包 init 保持轻量,是大型库的常见纪律。
3.3 包树与导入名
示意布局:
infer_app/
├── __init__.py
├── server.py
├── models/
│   ├── __init__.py
│   ├── registry.py
│   └── mini.py
└── tools/
    ├── __init__.py
    └── search.py
对应导入:
import infer_app
from infer_app import server
from infer_app.models import mini
import infer_app.tools.search as search
前提是:运行时的 sys.path 能看到包含 infer_app 目录的那一层父目录,而不是只看到 infer_app 内部。这也是“在错误的当前目录启动”导致导入失败的常见原因。
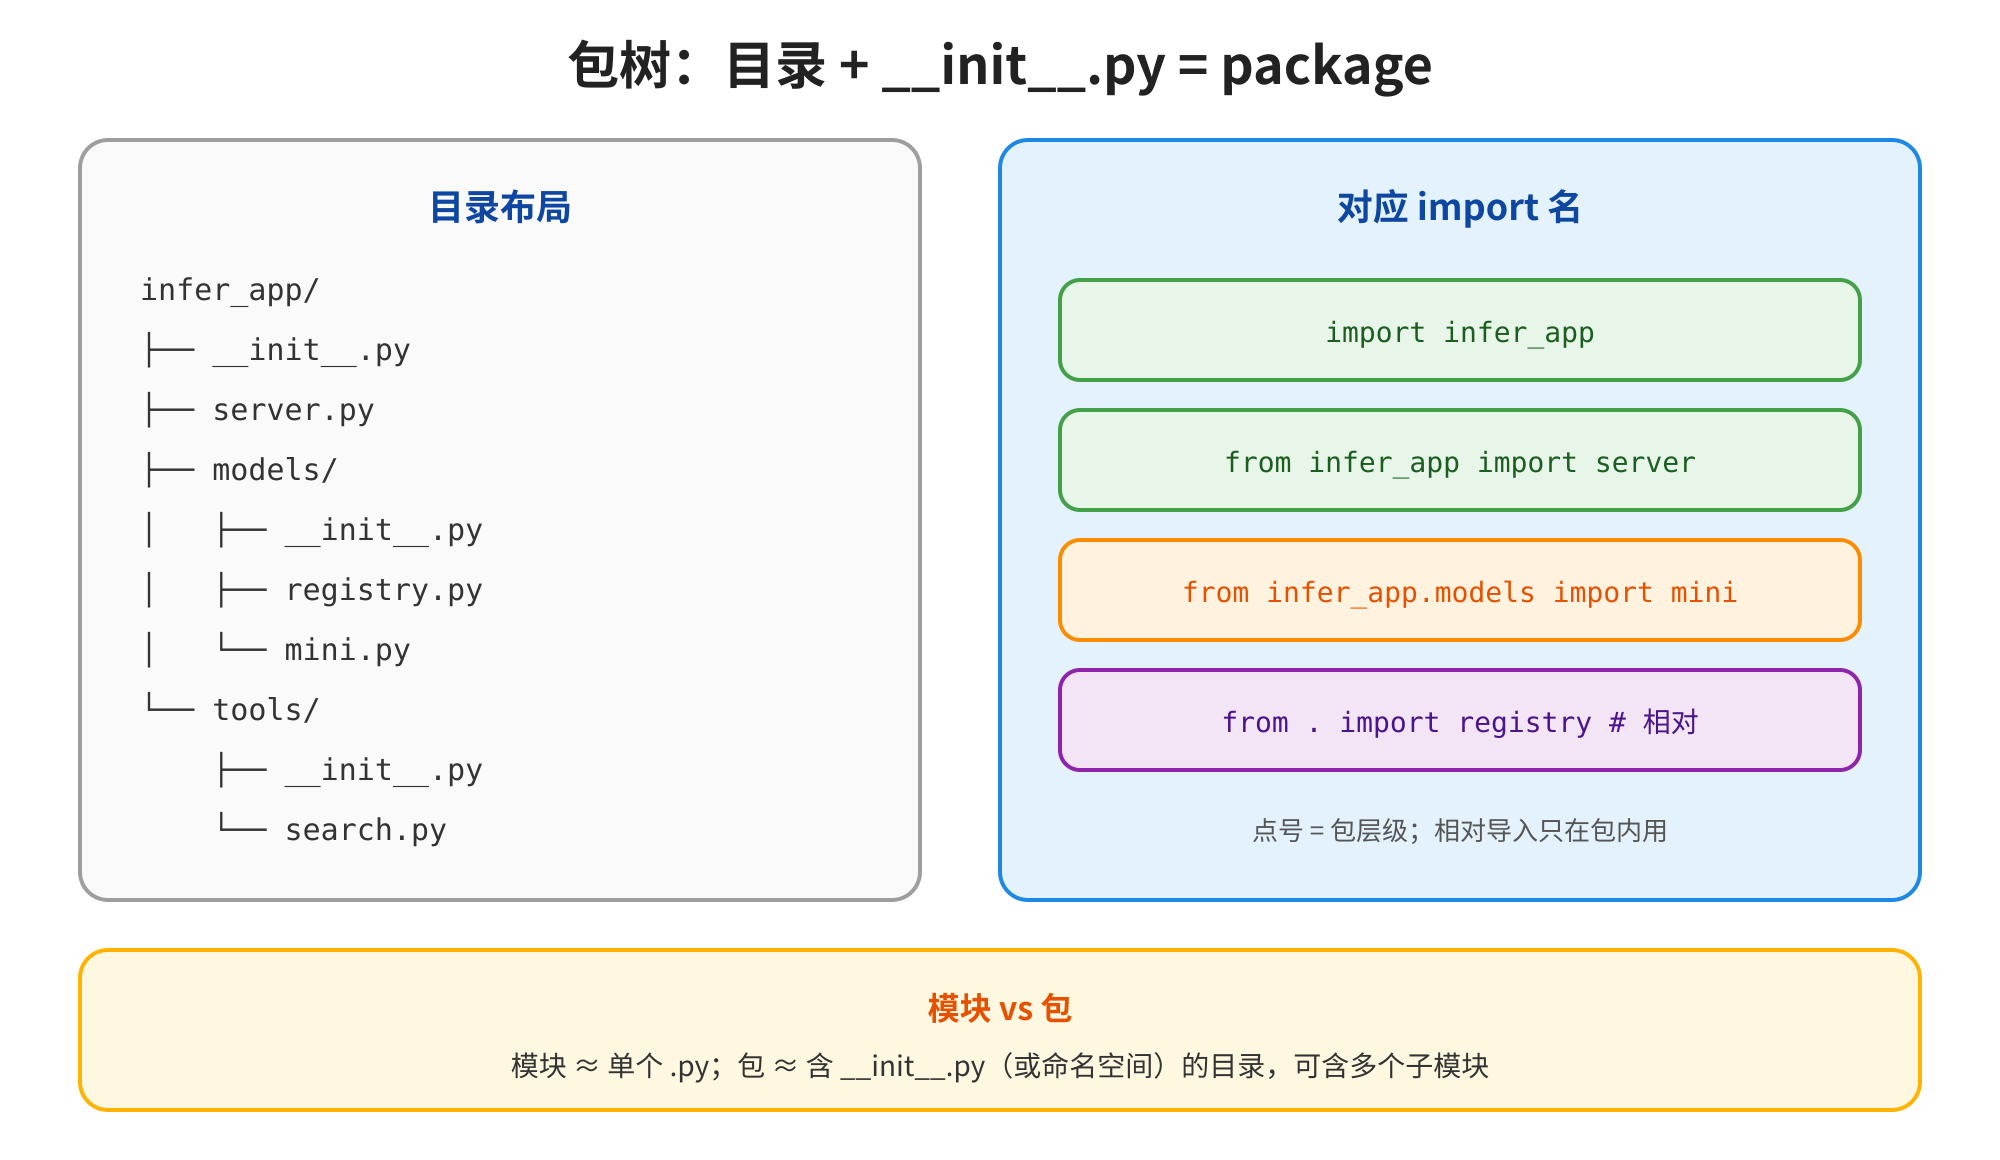
__init__.py等于包。左侧是infer_app目录结构,包含__init__.py、server.py等文件,models和tools下又有子文件。右侧列出对应import名,如import infer_app、from infer_app import server等,还展示了相对导入示例。底部橙色框内说明模块与包的区别,模块是单个.py文件,包是含__init__.py(或命名空间)的目录,可含多个子模块。此图与上文包树与导入名的内容紧密相关,直观呈现了包树的构成及import操作。图3 包树:目录 + init.py = package
3.4 命名空间包(namespace package)
PEP 420 起,没有 init.py 的目录,在某些条件下仍可作为命名空间包——允许多个路径贡献同一包名。第三方大型单体里偶尔能见到;入门项目请优先显式写 init.py,行为更直观,工具与教程也更好讲。
AI Infra 视角
vLLM、SGLang、transformers 这类仓库都是深包树:
xxx/model、xxx/engine、xxx/entrypoints……包边界就是团队边界。把“服务入口 / 模型实现 / 工具适配”拆开,比单文件巨石更容易做懒导入与可选依赖(见第六节)。
四、绝对导入与相对导入
4.1 绝对导入(推荐默认)
从项目顶层包名写起:
from infer_app.models import registry
from infer_app.tools.search import bing
优点:阅读时不依赖“当前文件在树的哪一层”;重构移动文件时,目标路径仍然清楚。团队规范里通常默认绝对导入。
4.2 相对导入
在包内用前导点号表示“相对当前包”:
# 在 infer_app/models/mini.py 内
from . import registry          # 同级
from ..tools import search      # 上一级包中的 tools
.:当前包;..:上一级包;- 不能越过顶层包“再往上”。
相对导入只在包上下文中有效。若你用 python mini.py 直接跑包内文件,package 往往不对,相对导入会报错:
ImportError: attempted relative import with no known parent package
正确姿势包括:python -m infer_app.models.mini(从包的父目录启动),或把入口放到包外/main.py,内部继续用绝对/相对导入。
4.3 怎么选
| 场景 | 建议 |
|---|---|
| 跨包、公开 API | 绝对导入 |
| 包内近邻、减少改名噪声 | 相对导入可用 |
| 脚本入口、笔记本 | 避免相对导入;用 -m 或绝对路径布局 |
| 既要库又要脚本 | 见下一节 name 与 python -m |
# 绝对:清晰
from infer_app.models.registry import register

# 相对:仅在包内模块中
# from .registry import register
五、缓存、循环导入、importlib 与主模块
5.1 sys.modules:导入缓存
每次成功导入后,模块对象会进 sys.modules 字典,键是模块名。再次 import 同名时,直接取缓存,不再执行顶层代码。
import sys
import math

print("math" in sys.modules)
print(sys.modules["math"] is math)
True
True
这解释了:为何在交互环境改了 .py 文件后 import 没变化——旧对象还在缓存里。开发时可用 importlib.reload(mod)(有限制),或重启解释器;正式服务进程则依赖“启动时导入一次”的模型。
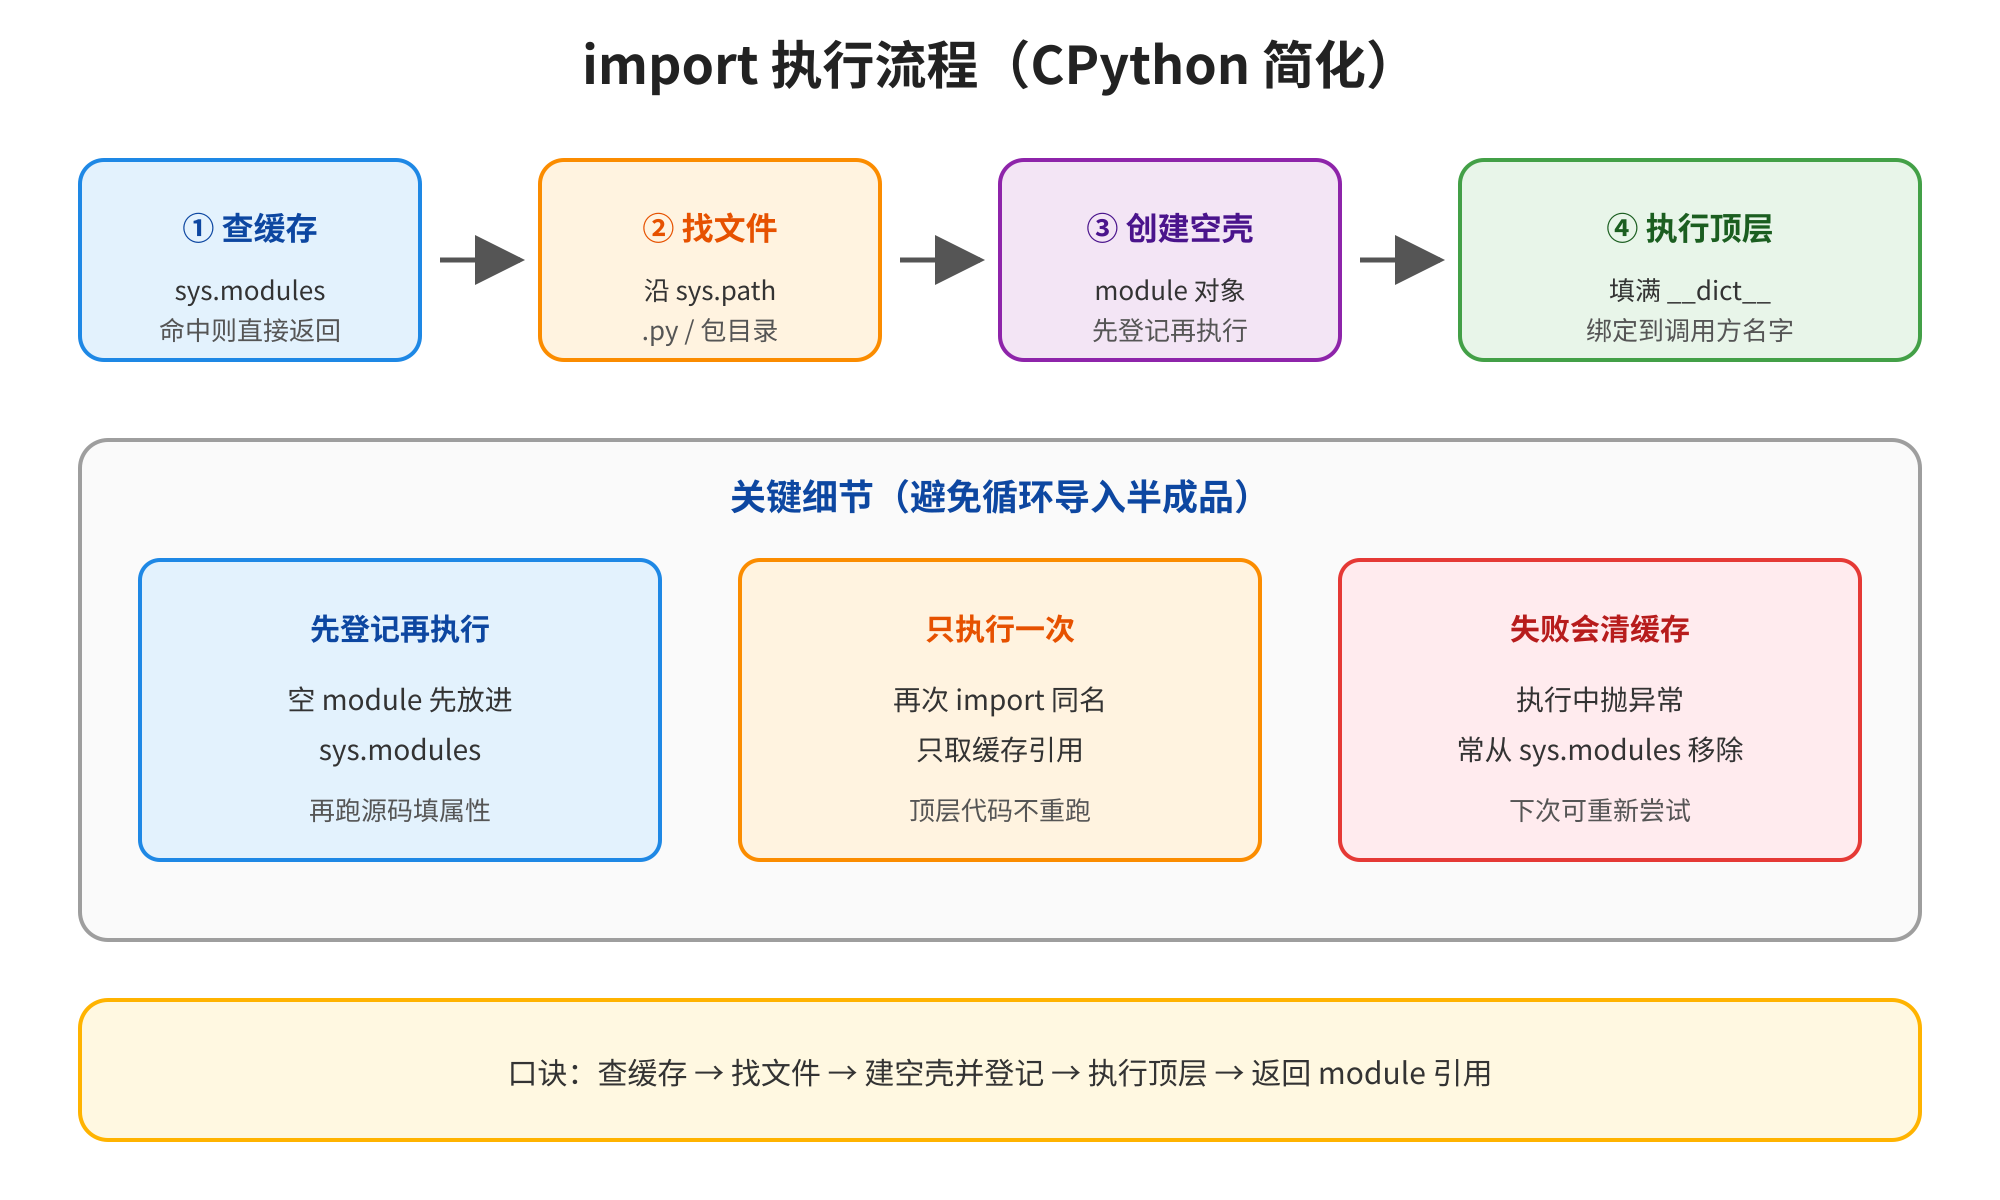
图4 import 执行流程(CPython 简化)
流程口诀:查 sys.modules → 沿 sys.path 找 → 创建空 module 并先登记 → 执行顶层填 dict → 把引用绑到调用方名字。先登记再执行,是为了让循环导入时对方至少能看到“正在加载的模块对象”;但若对方立刻访问尚未赋值的属性,仍会失败。
5.2 循环导入
典型炸弹:
# a.py
import b
def fa():
    return b.fb()

# b.py
import a
def fb():
    return a.fa
更常见的是顶层就互相 from 对方的符号:
# a.py
from b import fb   # b 正在加载,a 可能还没定义完
现象多为 ImportError: cannot import name '...' from partially initialized module ... 或 AttributeError。
解法优先级:
- 拆出第三方模块(共享类型、常量、协议放到
types.py/common.py); - 延迟导入:把
import放进函数内部(调用时双方都已加载完); - 理顺依赖方向:让底层不依赖上层(架构问题优先于技巧)。
延迟导入示例(仅作急救,仍建议拆结构):
# a.py
def fa():
    from b import fb
    return fb()
这样 import a 时不会立刻拉 b;等 fa() 被调用时,若主程序已先导入双方,循环边往往就解开了。代价是依赖关系藏进运行期,静态工具更难看清——所以优先“抽出 c.py”。
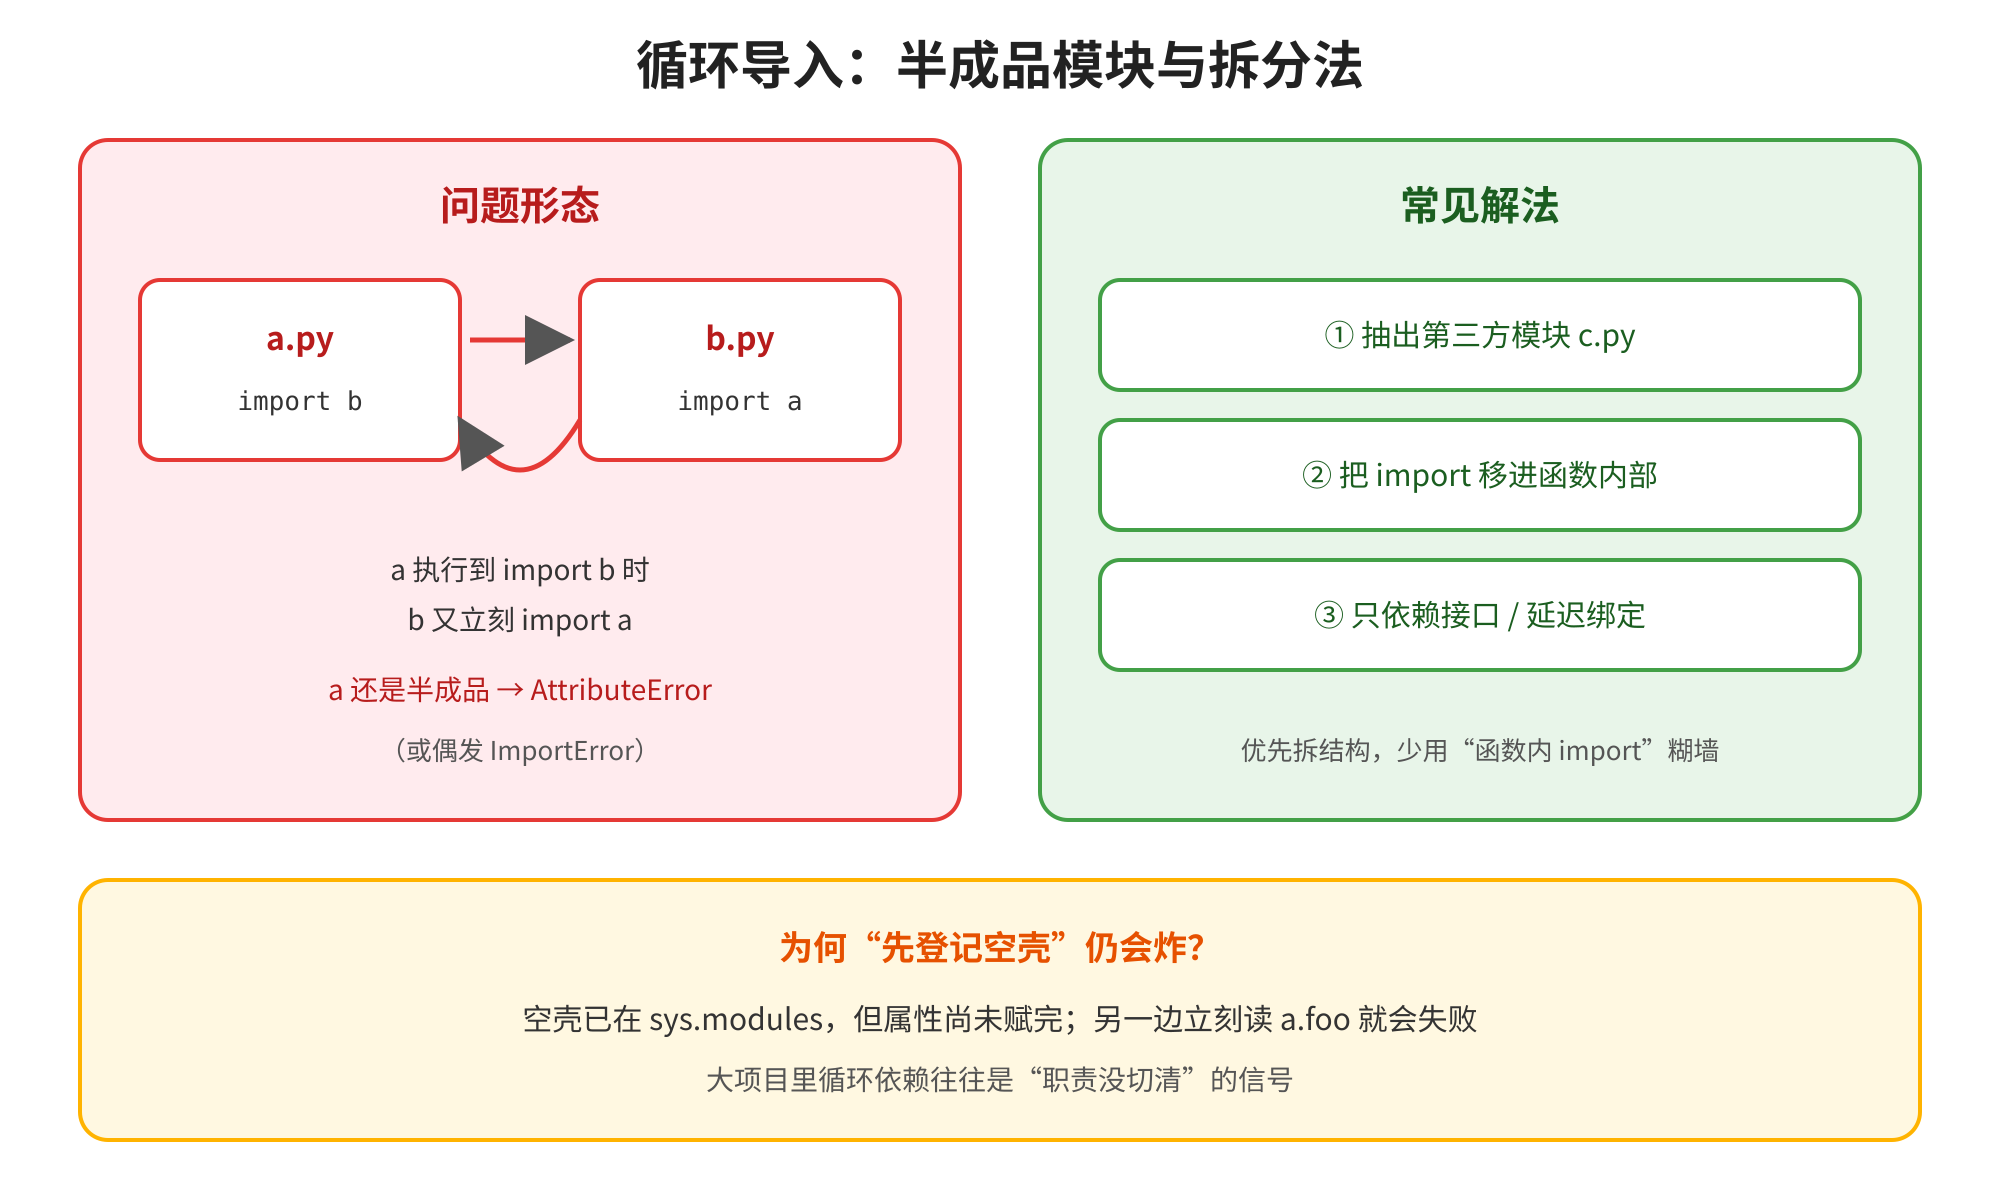
图5 循环导入:半成品模块与拆分法
5.3 if name == "main"
同一文件既可能被 import,也可能被直接运行。直接运行时,解释器把该模块的 name 设为 "main",而不是文件名。
# greet.py 末尾
def main():
    print(hello("world"))

if __name__ == "__main__":
    main()
python greet.py:执行main();import greet:只加载定义,不自动跑main()。
这是写“库模块 + 可执行入口”的标准姿势,避免导入副作用(误启动服务、误跑训练)。
5.4 importlib 与动态导入
标准库 importlib 提供编程式接口:
import importlib

math = importlib.import_module("math")
print(math.sqrt(16))
4.0
按字符串名字加载在插件系统、Agent 工具发现、可选依赖里很有用:importlib.import_module(f"infer_app.tools.{name}")。还有 importlib.util 可从文件路径构造 spec——进阶场景再用,本篇记住“导入可以代码化”即可。
六、工程布局与 AI Infra 实践
6.1 推荐的小项目骨架
my_infer/
├── pyproject.toml          # uv/pep621,第 20 篇展开
├── README.md
├── src/
│   └── my_infer/
│       ├── __init__.py
│       ├── __main__.py     # python -m my_infer
│       ├── server.py
│       └── model_loader.py
└── tests/
    └── test_loader.py
入门阶段即使暂不用 src/ 布局,也至少做到:包目录 + 入口清晰 + 测试外置。用 uv run python -m my_infer 启动,而不是到处改 sys.path。
main.py 的作用是:当用户执行 python -m my_infer 时,解释器会把 my_infer 包当作 main 来跑,从而执行该文件。这样入口留在包内,却不必教用户“请打开某深层路径下的 server.py”。和第 08 篇的 if name == "main" 守卫可以并用:库文件守副作用,main.py 专司 CLI/服务启动。
6.2 懒导入(lazy import)为何出现在大模型栈
import torch、import transformers 可能很慢、很吃内存。库作者常把重依赖放进函数内:
def load_model(name: str):
    import torch  # 延迟到真正需要时
    return torch.load(name)
或用专用懒加载工具。代价是:错误从启动时推迟到调用时;类型检查与静态分析更麻烦。服务进程若无论如何都要加载模型,启动时导入反而更早暴露问题;CLI 多子命令则懒导入能让 xxx --help 秒开。
AI Infra 视角
- 包布局:
entrypoints/engine/model分离,便于可选依赖(CPU 轮子不含 CUDA 扩展时的导入策略)。- 懒导入:避免
import sglang连带加载用不到的后端。- 插件式工具:Agent 用
importlib按配置加载tools.xxx。- 主入口:
python -m pkg+main.py,与第 27 篇 FastAPI、第 28 篇 Agent 一脉相承。
6.3 把第 08 篇工具表拆进模块
上一篇的分发表,自然拆成:
# tools.py
def ping():
    return "pong"

def add(a, b):
    return a + b

REGISTRY = {
    "ping": ping,
    "add": add,
}

# main.py
from tools import REGISTRY

def call(name, *args, **kwargs):
    return REGISTRY[name](*args, **kwargs)

if __name__ == "__main__":
    print(call("add", 2, 3))
5
两文件一拆,测试可以只测 tools,服务入口只保留路由与生命周期——这就是模块机制的日常价值。
七、踩坑大全
导入报错时,按顺序自问:当前 sys.executable 是谁?sys.path 能否看到包的父目录?名字是模块还是包内路径写错?是不是缓存了旧模块?是不是循环导入摸到半成品?是不是用 python path/to/inner.py 跑挂了相对导入?
7.1 找不到模块
坑 1:ModuleNotFoundError: No module named 'xxx'。 现象:明明文件在磁盘上。原因:父目录不在 sys.path,或虚拟环境不对,或名字拼写/大小写不符(Linux 区分大小写)。解决:确认 sys.path 与 sys.executable;用 python -m pkg 从正确位置启动;避免依赖“碰巧的当前目录”。
坑 2:自己的 json.py / random.py 挡住标准库。 现象:import json 行为怪异或报错。原因:sys.path 前部命中了同名用户文件。解决:勿用标准库名做项目模块名;删掉或改名后清 pycache。
坑 3:改完代码 import 没变化。 现象:交互/长期进程里仍是旧逻辑。原因:sys.modules 缓存。解决:重启进程;开发中谨慎 importlib.reload(子模块引用可能仍握着旧对象)。
7.2 包与相对导入
坑 4:attempted relative import with no known parent package。 现象:包内相对导入失败。原因:文件被当作顶层脚本直接执行。解决:python -m package.module,或改绝对导入,并设置好包入口。
坑 5:把包目录本身加进 sys.path,再 import server。 现象:子模块里 import infer_app.xxx 反而失败,或同一文件被加载两次(不同模块名)。原因:同一文件既以 server 又以 infer_app.server 导入。解决:path 只加父目录,统一用包名导入。
坑 6:忘记 init.py(在需要常规包的工具链里)。 现象:某些工具/旧假设下不被当包,或命名空间包行为不符合预期。解决:入门项目显式添加空 init.py。
7.3 循环导入与副作用
坑 7:循环 from x import y。 现象:cannot import name ... partially initialized module。解决:拆公共模块;或函数内延迟导入;理顺依赖方向。
坑 8:模块顶层副作用过重。 现象:import util 就连数据库、起线程、读巨大模型。原因:顶层执行了不该执行的逻辑。解决:副作用放进 main() / 工厂函数;用 if name == "main" 守住入口。
坑 9:from module import *。 现象:命名空间污染、静态分析困难。解决:显式导入;若包要暴露公共 API,在 init.py 里明确 all 并有节制地再导出。
7.4 环境差异
坑 10(macOS/Linux):大小写。 现象:本地(常不敏感)能过,服务器失败。解决:文件名与导入名大小写严格一致。
坑 11(Windows):路径与盘符。 现象:混用反斜杠字符串转义。解决:路径用 pathlib(第 10 篇);导入仍用点号包名,不要把 Windows 路径写进 import。
坑 12(GPU 服务器):系统 Python 与 conda/uv 环境混用。 现象:shell 里能 import torch,IDE 或 systemd 服务里不能。解决:服务单元与 CI 写死同一解释器绝对路径;用 uv run 或激活脚本保证一致。
import sys
print(sys.executable)
print(sys.path[0])
先打印这两行,再谈“包没装上”。
八、小结
合上文章后,试着用自己的话解释:“为什么第二次 import 不执行顶层打印”以及“相对导入为何不能随便 python foo.py”——讲得清,才算真的会了。
- 模块是对象:
.py加载后得到module,属性在dict;import绑定引用,不是文本粘贴。 sys.path:从左到右找文件/包;顺序与虚拟环境决定“用到哪一份”;勿随意同名覆盖标准库。- 包:目录 +(通常)
init.py形成层级;命名空间包是进阶例外;path 应指向包的父目录。 - 绝对 vs 相对:默认绝对;相对仅包内;入口用
python -m或main.py。 sys.modules与循环导入:先缓存再执行;循环时可能见到半成品——优先拆模块与延迟导入。name == "main"与importlib:区分库/入口;动态按名加载服务插件与可选依赖。
把故事连起来:函数(07~08)是积木 → 本篇把积木放进文件与包,用 import 组装 → 下一篇(10)处理文件内容与路径,让配置/数据也能进出程序。
本篇技能会立刻复利:读开源推理框架时先看包边界与入口;写最小 Agent 时把 tools/registry/main 拆开;遇见诡异 import 报错时先打印 sys.executable 与 sys.path[0]。先把“执行一次 + 缓存 + 父目录在 path 上”练准,比背二十个导入语法糖更划算。
若只能带走一句话:查路径、执行一次、缓存起来、绑定引用;包用目录表达层级;入口与库用 name 分开。
也可以用“三个不要”自检:不要用标准库名当自己的模块名;不要在包内文件上直接 python xxx.py 还硬刚相对导入;不要在模块顶层偷偷起服务/加载大模型。
再留一个自测:画出 import pkg.sub 时 sys.modules 里至少会出现哪些键;解释为何 from m import x 后修改 m.x 不一定反映到本地名 x;把第 08 篇工具表拆成两文件并成功互调。三问都顺,本篇就站稳了。
九、课后练习
- (基础) 新建
echo.py,定义def echo(x): return x,同目录另一文件import echo并调用;打印echo.name与echo.file。 - (基础) 打印
sys.path与sys.executable;用uv创建 venv 后再打印一次,对照site-packages是否变化。 - (基础) 建立包
demo_pkg/(含空init.py)与demo_pkg/util.py,在包外用from demo_pkg.util import ...调用;再尝试错误地把demo_pkg自身加入sys.path后只import util,观察问题并写回正确用法。 - (理解) 在
greet.py顶层加print("load"),连续import greet两次,解释第二次为何不打印;再用importlib.reload观察差异。 - (理解) 写
a.py/b.py制造一次循环导入错误;分别用“抽出c.py”和“函数内 import”各修一版。 - (理解) 在包内模块使用相对导入,分别用
python path/to/mod.py与python -m pkg.mod启动,记录哪种成功并说明原因。 - (进阶) 为第 08 篇工具分发表建立
tools.py+registry.py+ 可执行入口;入口仅当name == "main"时演示调用。 - (进阶 · AI Infra) 用
importlib.import_module按名字加载backends.cpu/backends.cuda(可用假模块);再写一个load_torch()函数内懒导入,对比模块顶层导入对“空跑 CLI”导入时间的影响(可用time.perf_counter粗测)。
下一篇预告
模块与 import 解决了“代码如何拆文件、如何按名加载”;下一篇《第10篇|文件读写、路径与 with》会处理数据与配置如何进出程序:文本/二进制、编码、pathlib、上下文管理器 with 关文件。本篇的包布局里,configs/model.yaml、日志文件、权重路径都要靠第 10 篇的刀法来读写得安全、可移植。
专栏一「Python 从零入门」的后续路线:文件与路径(10)→ 异常(11)→ 面向对象与数据模型(12~14)。带着本篇的 sys.path / 包树直觉,读开源推理框架的多文件结构时,先看“入口模块、包边界、有没有循环依赖”,再钻模型细节。
若你想提前热身:把本篇练习中的小包改成读取一个本地 hello.txt(哪怕先用原始 open);再试 pathlib.Path(file).resolve().parent 定位“相对模块文件的路径”。两道小练习做完,下一篇谈 with 与路径时你会带着具体素材,而不是抽象盘符争论。
也可以把第 08 篇的闭包工厂放进 factories.py,在 server.py 里绝对导入后构造客户端——你会同时复习“函数是对象”和“模块绑定引用”。三篇连读(07 函数基础 → 08 进阶 → 09 模块),专栏一前半的“把逻辑组织起来”主线就闭合了;后半转向文件、异常与面向对象,是另一段故事。