
代码 PR Agent 实战:从 Git 变更到自动代码审查
【AI Agent项目】从零构建一个代码 PR Agent

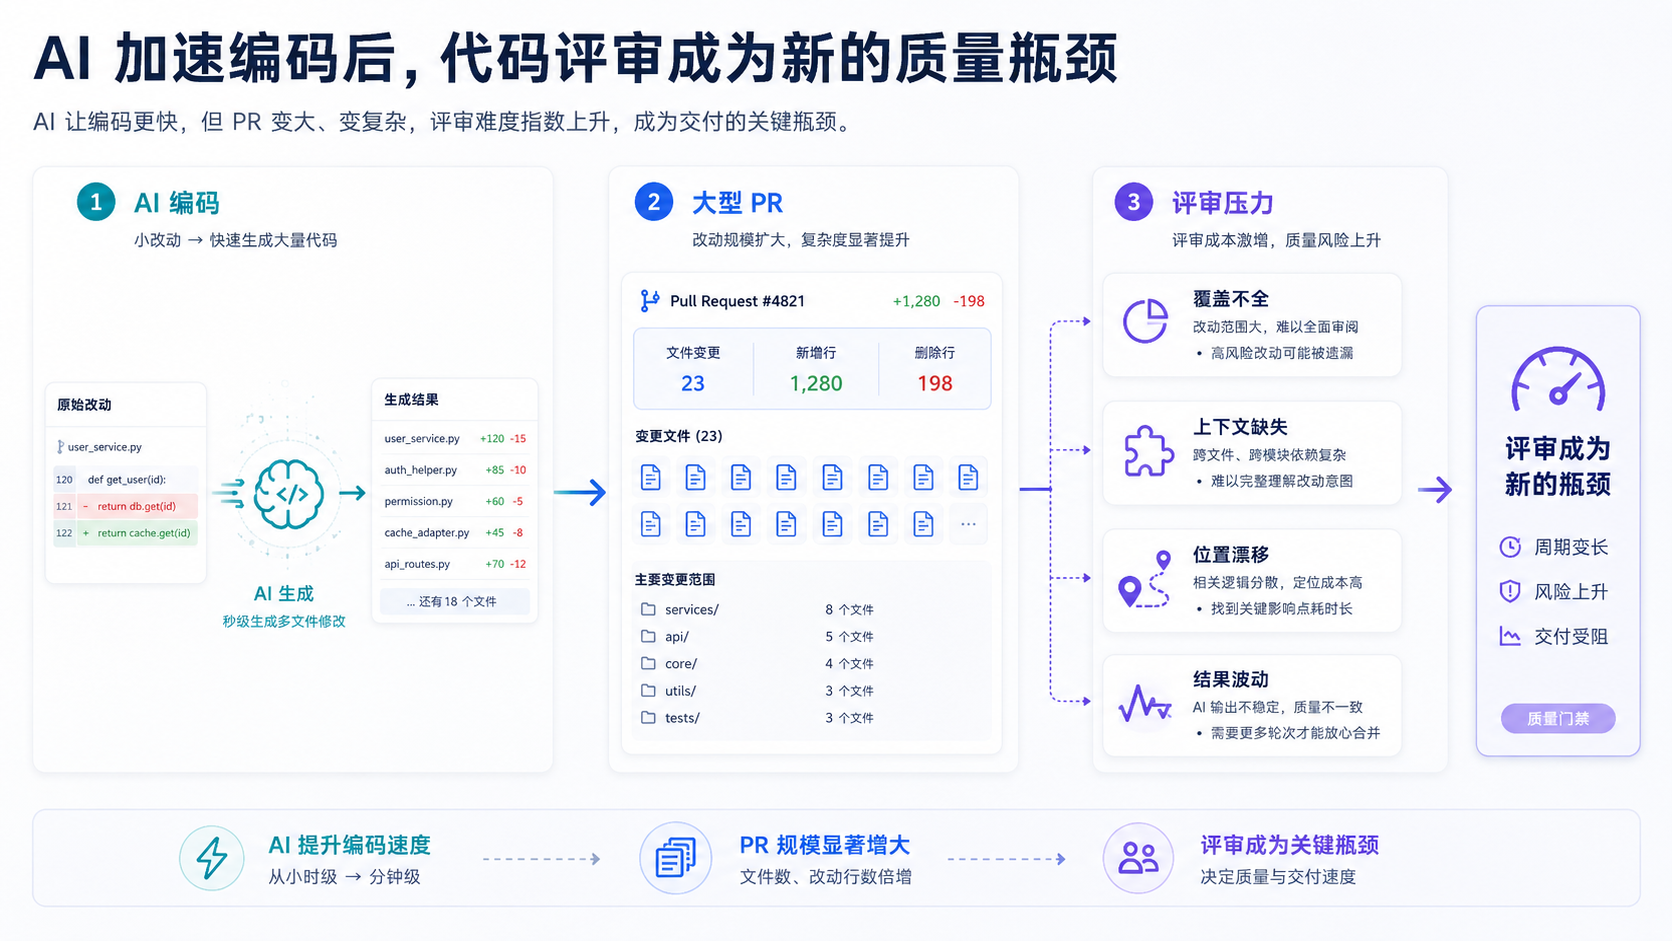
AI 编程工具让代码产出越来越快,评审却没有跟上。一个原本只改几十行的需求,交给 Coding Agent,可能转眼就变成横跨多个文件的数百行变更。评审的人既要逐文件检查实现,又要在脑子里还原跨文件的关系,还要判断 AI 给出的意见到底有没有落在本次改动上。
最直接的思路,无非是把整份 diff 丢给大模型。改动小的时候,确实能拿回一份像样的报告。改动一大,毛病就全出来了:有的文件压根没被审到,跨文件的上下文没读进去,评论位置对不上,同一段代码多跑几次,结论次次不一样。这样的报告看着挺完整,离能进真实研发流程还差得远。
review-pilot 就是为解决这个问题而生的。这个项目带你用 Python 从零实现一个代码审查 Agent:读取本地 Git 变更,组合规则、Semgrep 和 LLM 三路的审查结果,逐条校验证据,把报告送进 GitHub、GitLab 和飞书,最后还会把它和 PR-Agent 这类开源方案放到同一组真实 PR 上比一比。demo 跑通,这个项目才算刚开始。
🐵
我们的自研Review-pilot综合评分优于OpenCode,下有具体说明。
接 API 不难,难的是分工
做代码审查 Agent,把模型接上 API 只是起步。真正费脑子的是想清楚:哪些事必须由程序保证,哪些事适合交给模型判断。
review-pilot 是这么分的,程序管确定性的事:筛出本次真正需要关注的文件,建立文件之间的关系,限定工具的访问范围,卡死轮次和 Token 预算,最后把模型给出的文件、代码片段和位置逐项核验一遍。模型管需要理解的事:读代码语义,判断跨文件逻辑,证据不够时提出下一步要查什么。
落到实现上,有几条关键设计:
- 大型变更按相关文件拆成多个 ReviewUnit,每个单元有明确的输入和预算;
- 静态上下文不够用时,模型只能调用几个只读工具——读文件、搜代码、看其他 diff、按名称找文件——每次调用都留下 trace;
- 模型返回
existing_code,程序拿这段代码去 diff hunk 里做匹配、算行号,不让模型自己数行; - finding 过了证据校验,才进 Reflection 复核和最终报告;复核出错时保留原始结论,错误照常记录。
这几条机制,对应的是 AI 审查最常翻车的几个地方:漏文件、缺上下文、评论位置跑偏、结果没法复查。它们还带来一个好处:每加一个机制,都能单独量一量效果,覆盖范围、噪声、位置可靠性、延迟、Token 消耗,全都有明确的观察对象。后面的实验,就是靠这个前提跑起来的。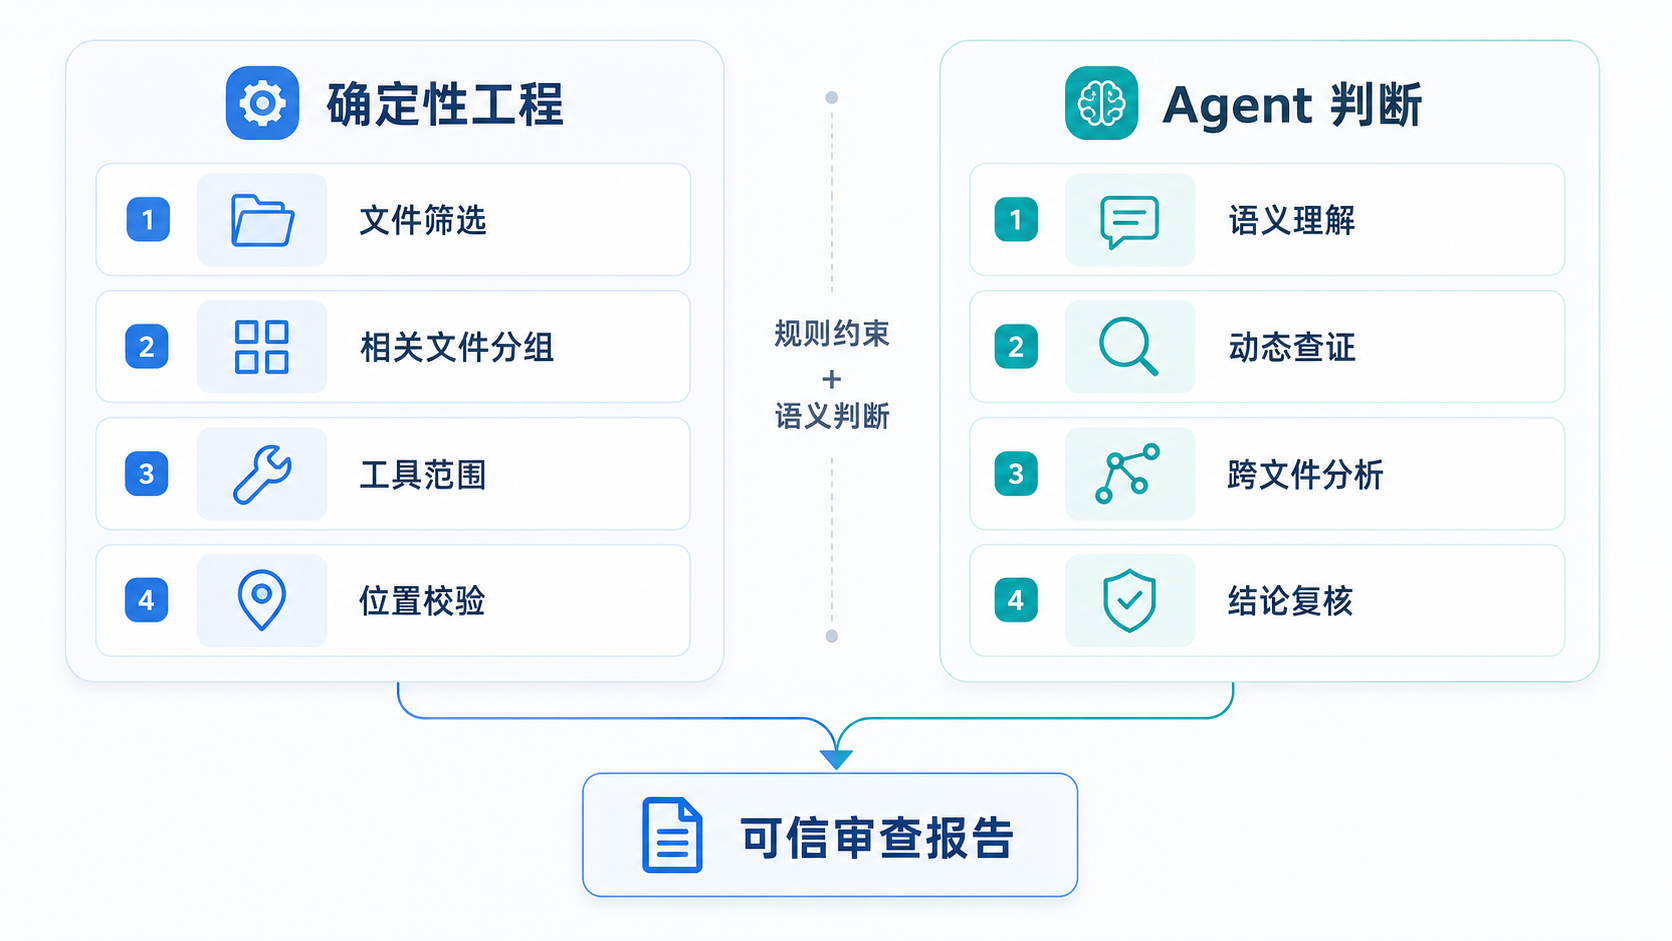
三种入口,一个审查核心
review-pilot 支持三种真实入口:本地 staged diff、GitHub Pull Request、GitLab Merge Request。三个入口各自去拿平台数据,统一转成 ReviewInput,再交给同一个 ReviewEngine 执行。
为什么要强调同一个?看看常见的做法就知道了:先写个本地脚本,接 GitHub 时复制一遍流程,接 GitLab 时再复制一遍。时间一长,三条路径用着不同的规则、Prompt 和报告格式,同一份改动从不同入口进,得出的结果也不一样,团队慢慢就不敢信这个工具了。review-pilot 把平台差异全部留在适配层,审查逻辑只维护一份。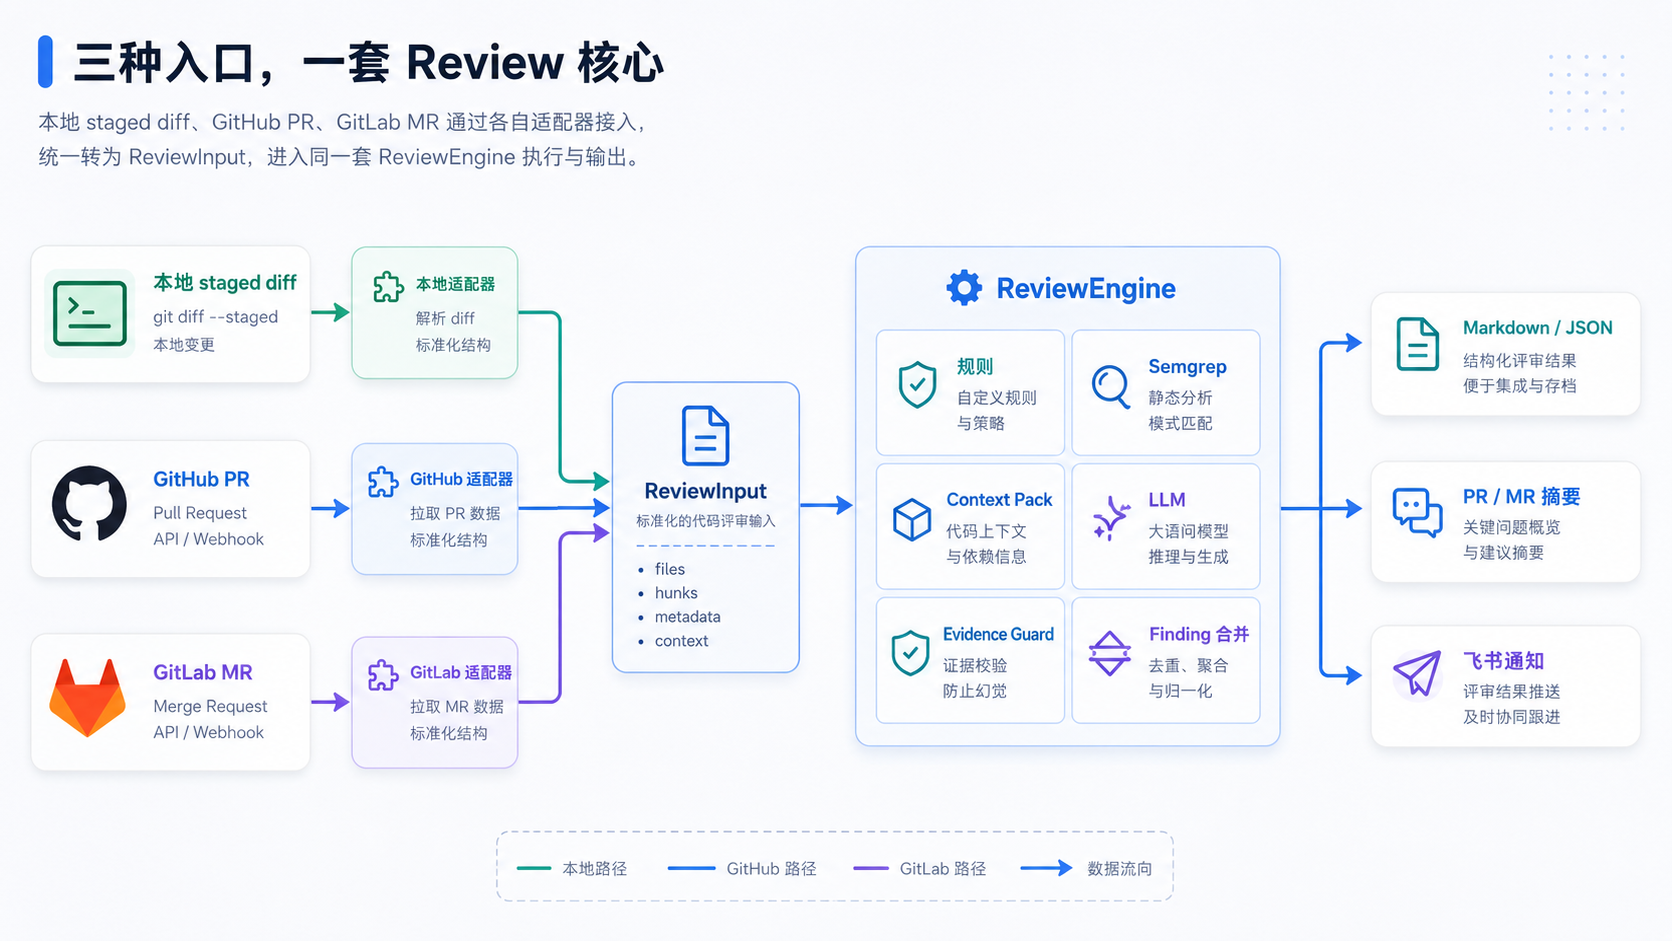
一次审查,依次做这些事:
- 解析 Git diff,拿到文件、hunk 和新旧行号;
- 跑确定性规则,检查大 PR、缺测试、敏感目录、调试输出这类问题;
- 在完整工作区跑 Semgrep,只保留落在本次变更相关行上的结果;
- 选出相关文件,在 Token 预算内生成可审计的 Context Pack;
- 调用真实的 OpenAI-compatible 模型,输出结构化 findings;
- 使用 Evidence Guard 校验文件、代码片段和位置,没有证据的意见直接过滤;
- 合并 rule、semgrep、llm 三类 findings,生成 Markdown 和 JSON 报告。
最后的报告里,每条 finding 都标着来源。规则查出来的、Semgrep 扫出来的、模型判断的,分得清清楚楚,不会搅成一段没法追溯的"AI 建议"。
把效果优化做成可验证的实验
很多 Agent 项目跑到"能演示"就停了。代码能跑,demo 有输出,但到底漏掉了多少问题?一次优化是不是真的让结果变好了?没人说得清。review-pilot 把这部分做成了硬功夫:固定样本、统一指标、可复查的实验。
统一执行核心。 本地、GitHub、GitLab 三类输入进入同一个执行核心。后面的质量策略都从统一入口启用,实验结果才有可比性。
固定样本基线。 接入公开评测数据格式,用固定样本、固定模型、固定 Prompt、固定 matcher,计算 Precision、Recall、F1、行定位指标、噪声率和平均延迟。批量运行支持失败记录和断点恢复,单个 case 失败,整批结果仍然保留。
相关文件分组。 按测试文件、直接依赖、接口实现、配置关系,把相关文件放进同一个审查单元。每个单元有独立上下文和预算,大改动分批处理,某个单元失败也单独记录。
受限动态上下文。 静态 Context Pack 答不上来时,模型可以调用只读工具继续查:读文件、搜代码、看其他 diff、按名称找文件。每次调用都有仓库范围、参数、返回数量、轮次和 Token 上限,全部写进 trace。
程序化定位评论。 模型给出 existing_code,定位器在 diff hunk 里做连续文本匹配,匹配上了由程序计算行号,不让模型自己数行。匹配不唯一或者找不到时,finding 降级或丢弃,定位原因保留下来。
结果复核。 复核层只处理已通过证据校验的 LLM finding,可以保留、降级或删除。复核调用失败时,系统记录错误并保留原 finding,不能让第二次模型调用把报告悄悄弄丢。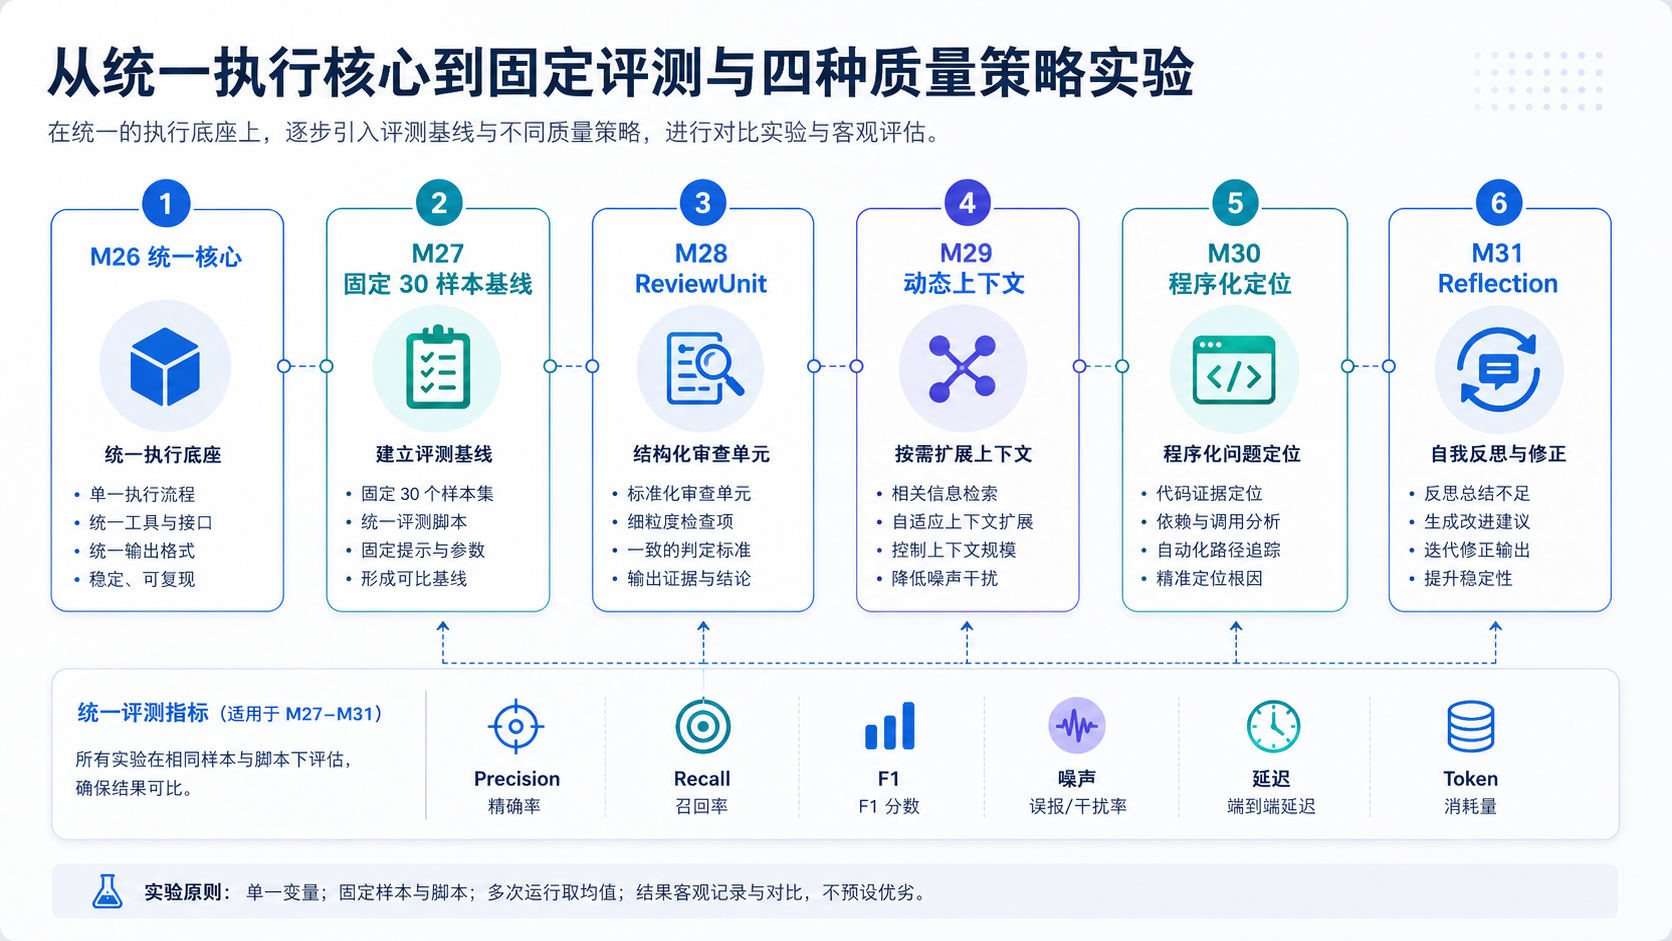
五组实验,结果有点反直觉
在同一组 30 个样本上,我们用真实的 DeepSeek 接口跑了五组独立实验。每组 30 个 case 全部跑完,失败数为 0。各组的模型、Prompt、matcher、样本完全一致,只切换要观察的那个策略。
| 实验组 | Precision | Recall | F1 | 噪声率 | 平均延迟 |
|---|---|---|---|---|---|
| baseline-30 | 35.00% | 10.61% | 16.28% | 65.00% | 85.2 秒 |
| review-units | 17.27% | 25.38% | 20.55% | 82.73% | 117.9 秒 |
| dynamic-context | 27.14% | 7.20% | 11.38% | 72.86% | 88.4 秒 |
| snippet-location | 34.29% | 9.09% | 14.37% | 65.71% | 73.0 秒 |
| reflection | 29.17% | 7.95% | 12.50% | 70.83% | 95.7 秒 |
| 这张表值得多看几眼。ReviewUnit 把 Recall 从 10.61% 拉到 25.38%,代价也很明显:评论变多了,Precision 和噪声指标跟着变差,平均延迟也更长。Snippet Location 的 Precision 和基线基本持平,延迟反而更低;51 条待定位结果里 45 条匹配成功,定位失败率 11.76%。最反常识的是后两组:Dynamic Context 和 Reflection 在当前配置下都没能改善整体指标,Reflection 还多烧了 450,986 个 Token。 |
这些结果,包括没达到预期的,课程里都完整保留。说实话,"不理想"的实验恰恰是这门课值钱的地方:文件分组、工具调用、二次复核都有各自的适用条件,默认把所有功能全开,效果可能更差。你要做的是读报告、解释差异,然后决定下一轮改什么——Prompt、策略参数、工具范围,还是模型。学会判断一个优化有没有用,比多堆两个功能难得多了。
同一批真实 PR,三个 Agent 同场跑
自己跟自己比,只能知道某个策略有没有用;想知道真实水平,得把同类工具拉到同一起跑线上。我们选了 SWE-PRBench 的 12 个 pilot 样本,把 review-pilot 和两个开源代码审查 Agent——Open Code Review 和 PR-Agent——放在一起重跑了一次:每个 Agent 保留原生输入方式,统一用人工审查评论做参照,同一套评分协议,再由真实的 DeepSeek judge 判断每条评论是否命中、是否合理。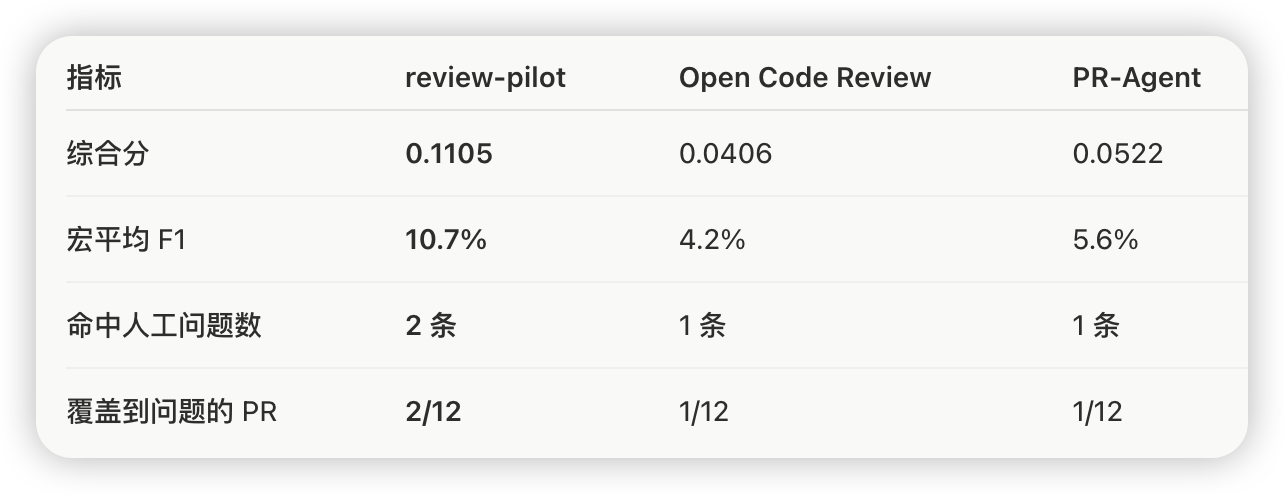
💡
几项指标都是 review-pilot 领先:综合分 0.1105,是另外两款的 2 倍多;宏平均 F1 10.7%,接近第二名的两倍;12 个真实 PR 里,review-pilot 覆盖到问题的有 2 个,另外两家各 1 个。
这组数字也得老老实实读。样本只有 12 个,评分协议是我们自定义的,结果用于项目能力验证,不等同于 SWE-PRBench 官方 leaderboard 排名。review-pilot 的候选意见更多,说明覆盖面更大,同时也带来了更多需要继续过滤的噪声;PR-Agent 的评论更少,单条命中率更高,但盖到的问题更少;Open Code Review 的误报率较低,空评论样本也更多。
怎么读这样一组对比数据,也是本项目教程的一部分:哪些结论能下,哪些不能下,下一步该往哪改。能读懂一组 benchmark,比跑出一组 benchmark 更难得!
从本地命令,到 GitHub、GitLab 和飞书
核心审查流程做完,接下来把它接进真实的协作环境。
本地可以审 staged diff,也可以把轻量检查挂进 pre-commit,完整检查挂进 pre-push。报告支持 Markdown 和 JSON,能按最高风险等级返回退出码。
review-pilot review --staged \
  --provider openai-compatible \
  --format json \
  --fail-on P1
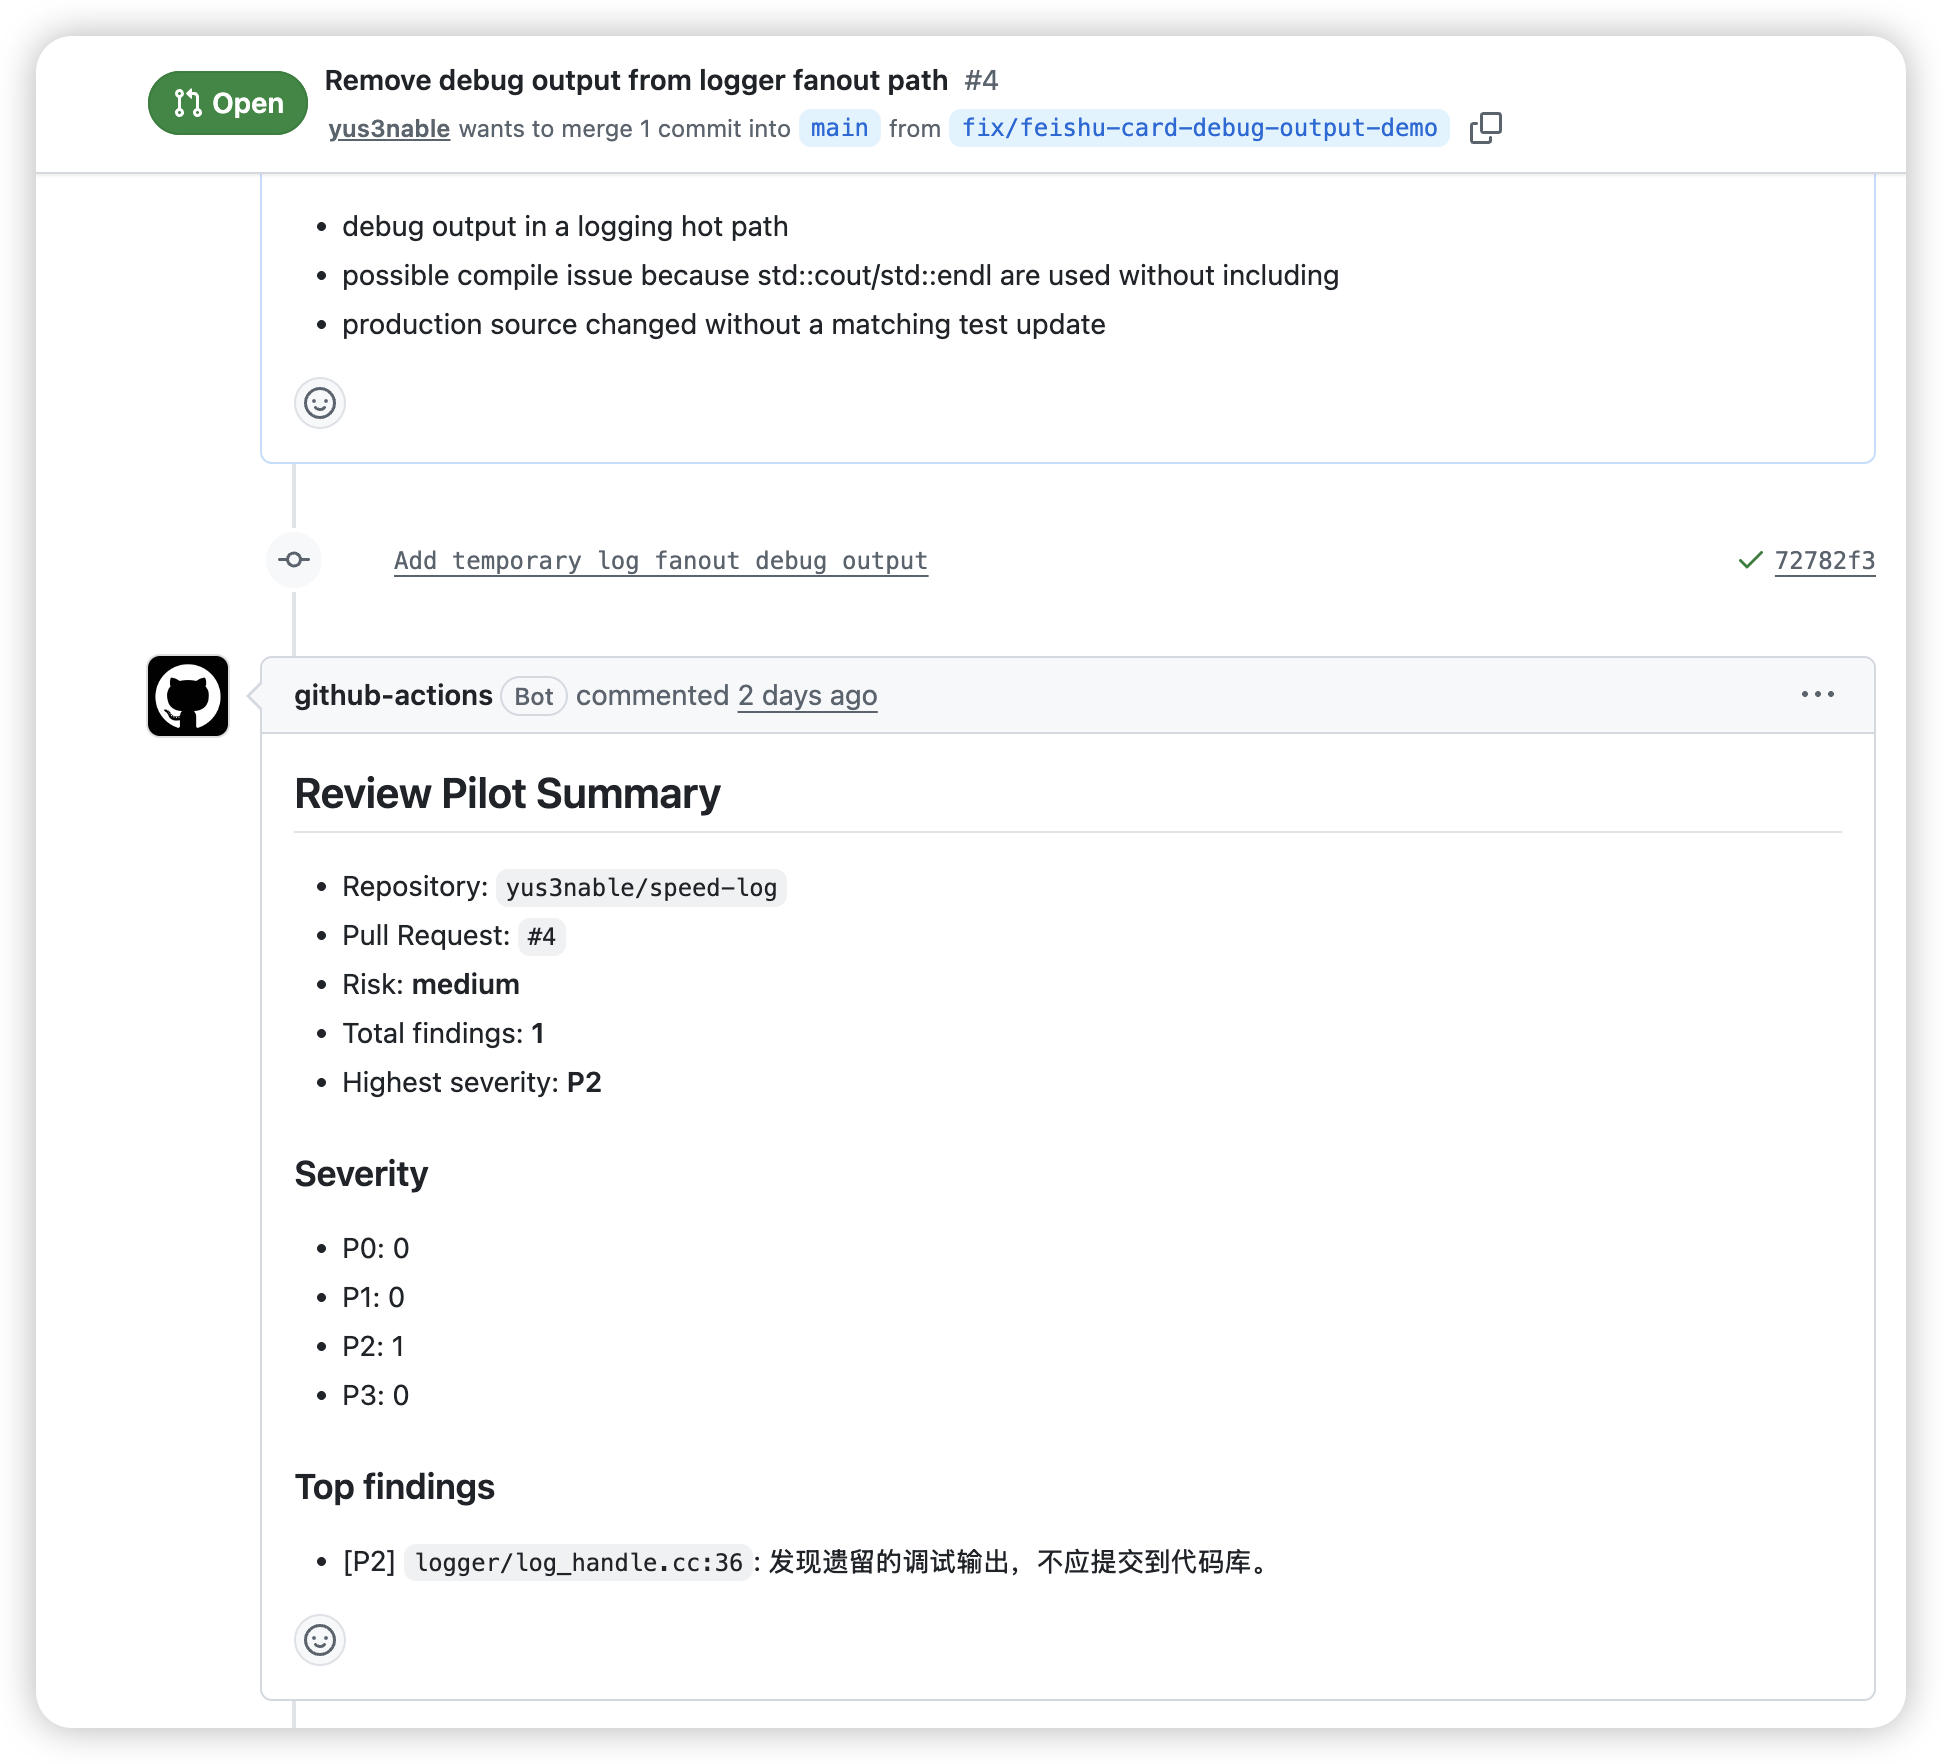
GitHub 里,Pull Request 触发 GitHub Actions:工作流读取 PR 变更,调用统一的 ReviewEngine,上传 Markdown/JSON Artifact,更新 PR Summary Comment。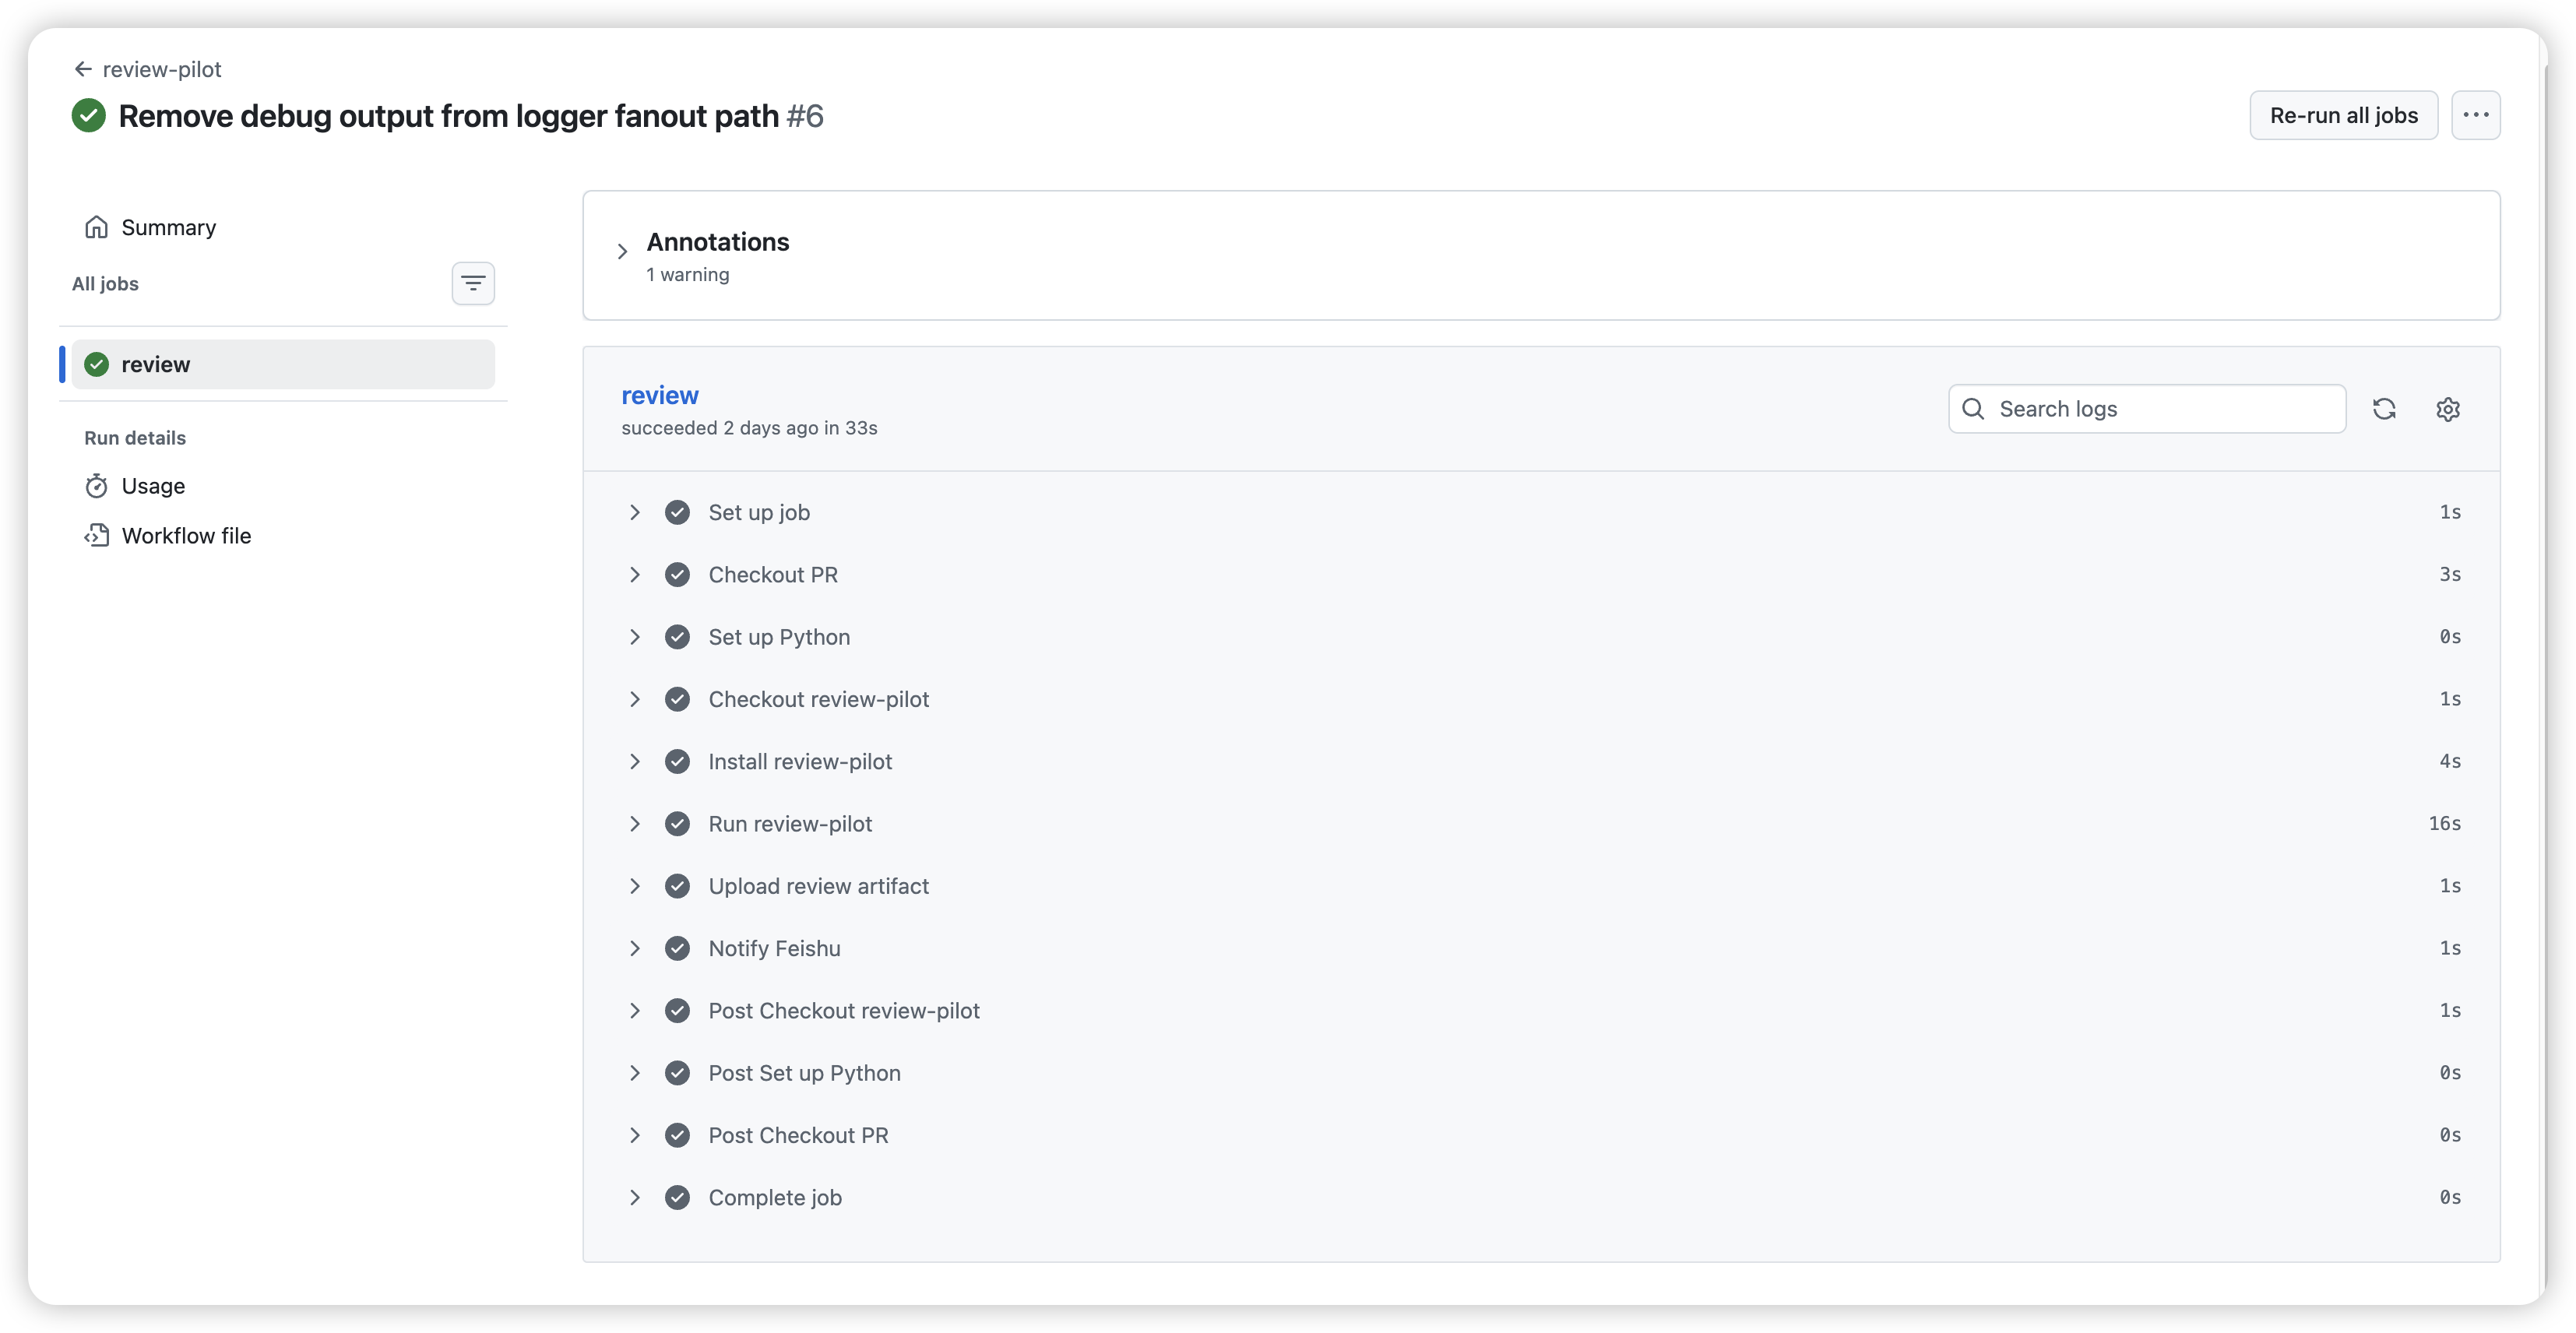
GitLab 里,Merge Request 走 GitLab CI,审查结果回写成 MR Summary Note。同一份报告摘要还能推到飞书群,大家在日常协作工具里就能看到风险等级和主要 findings。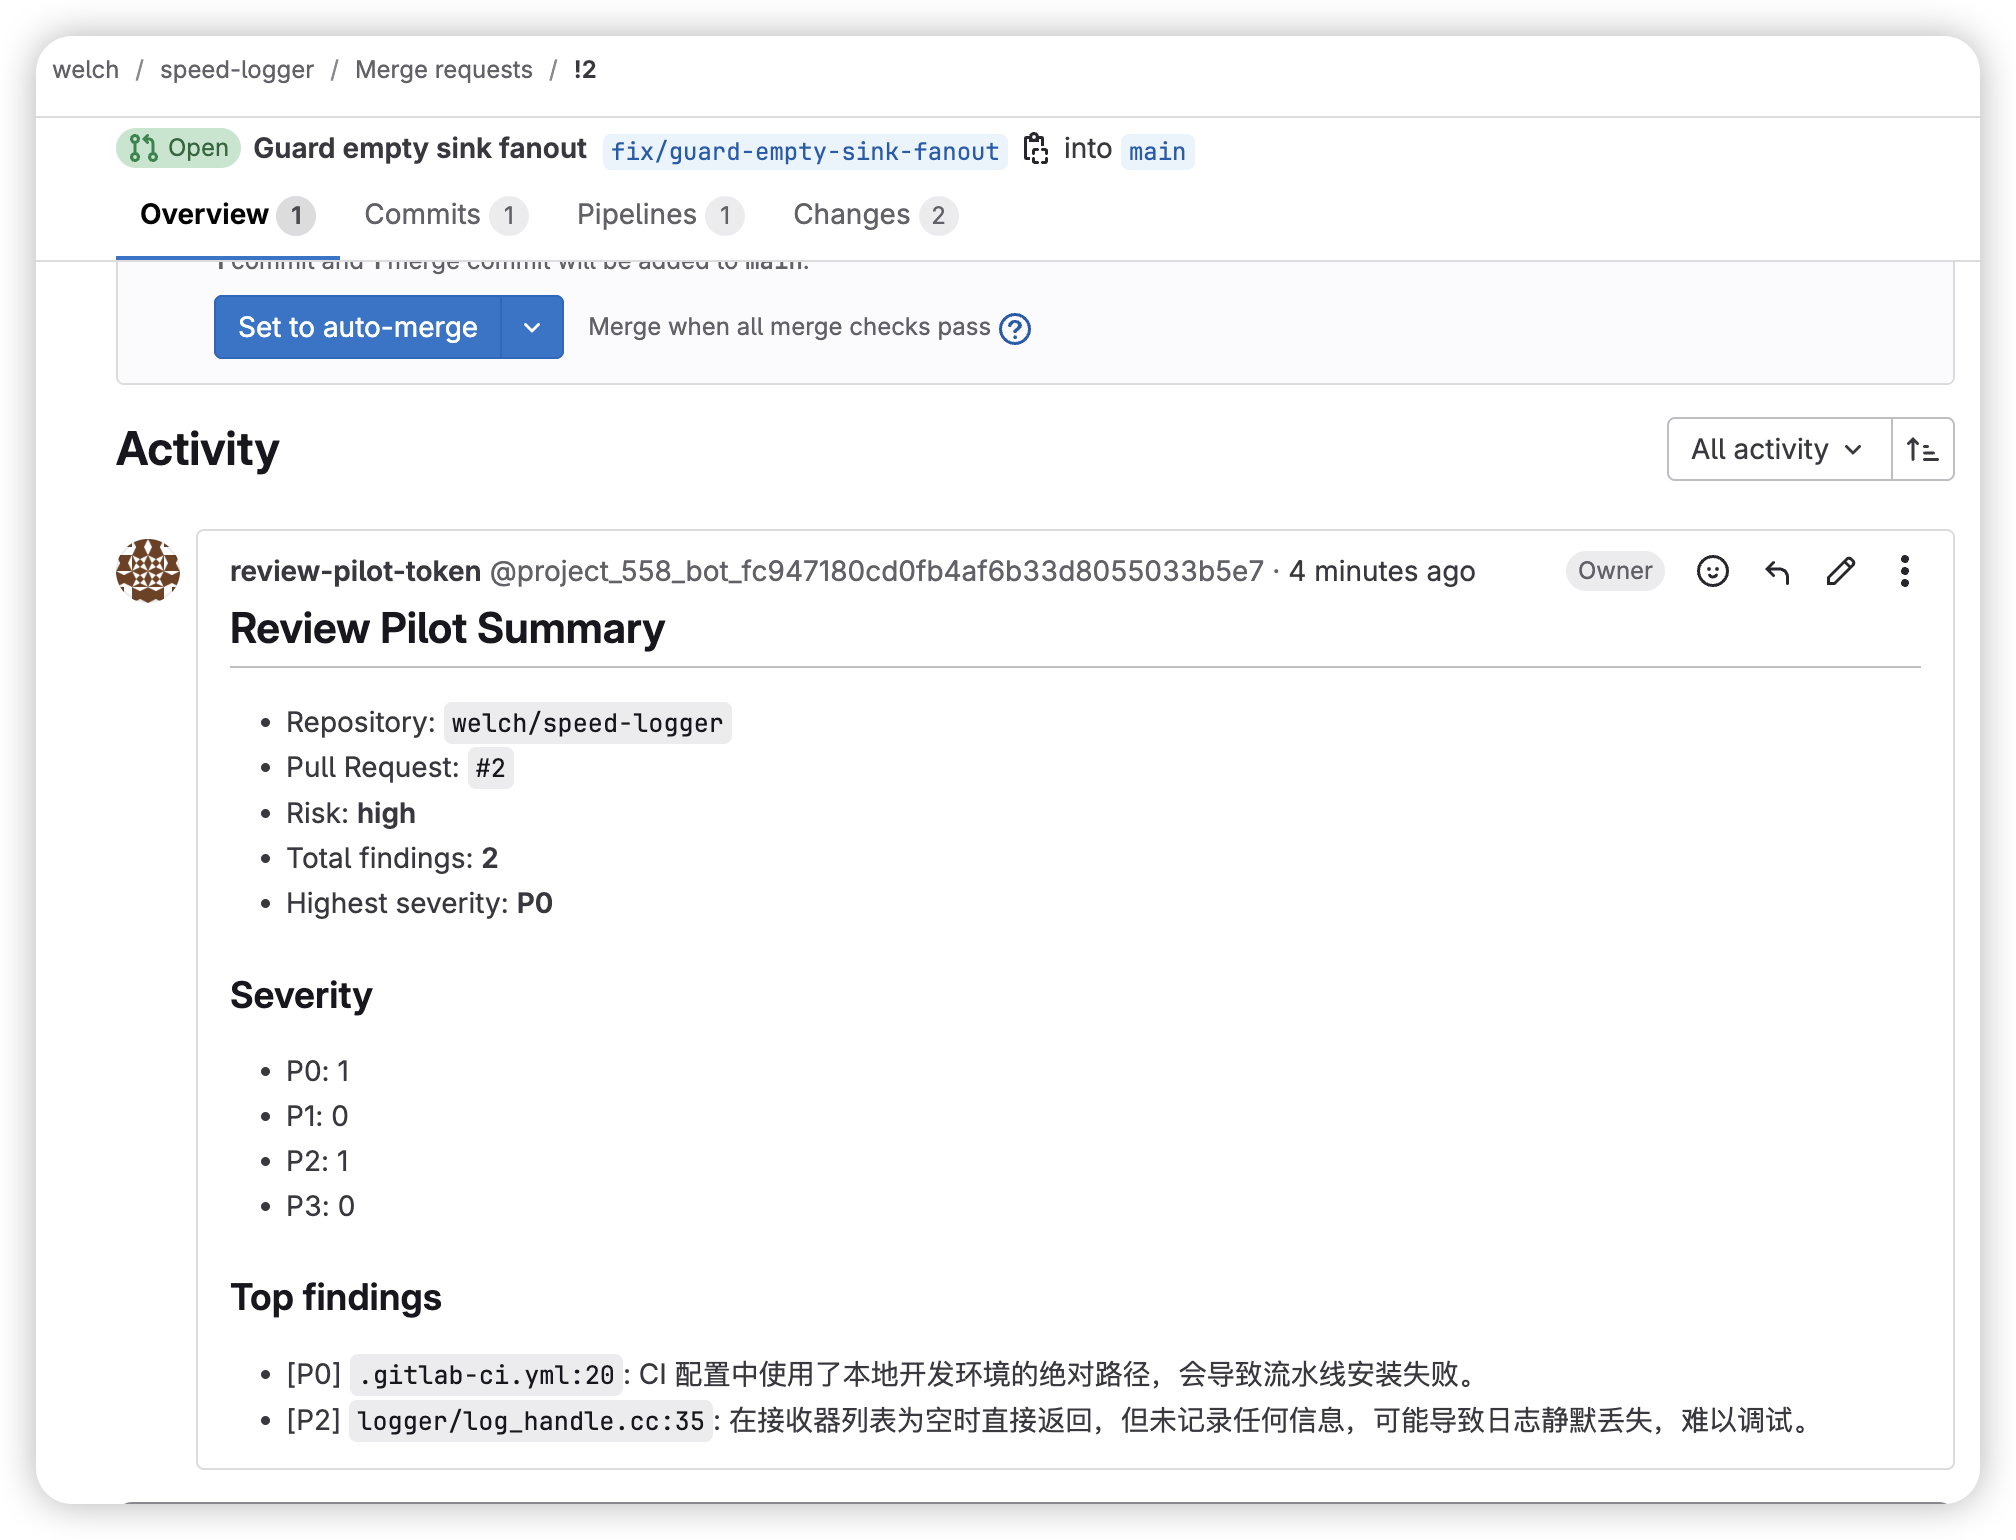
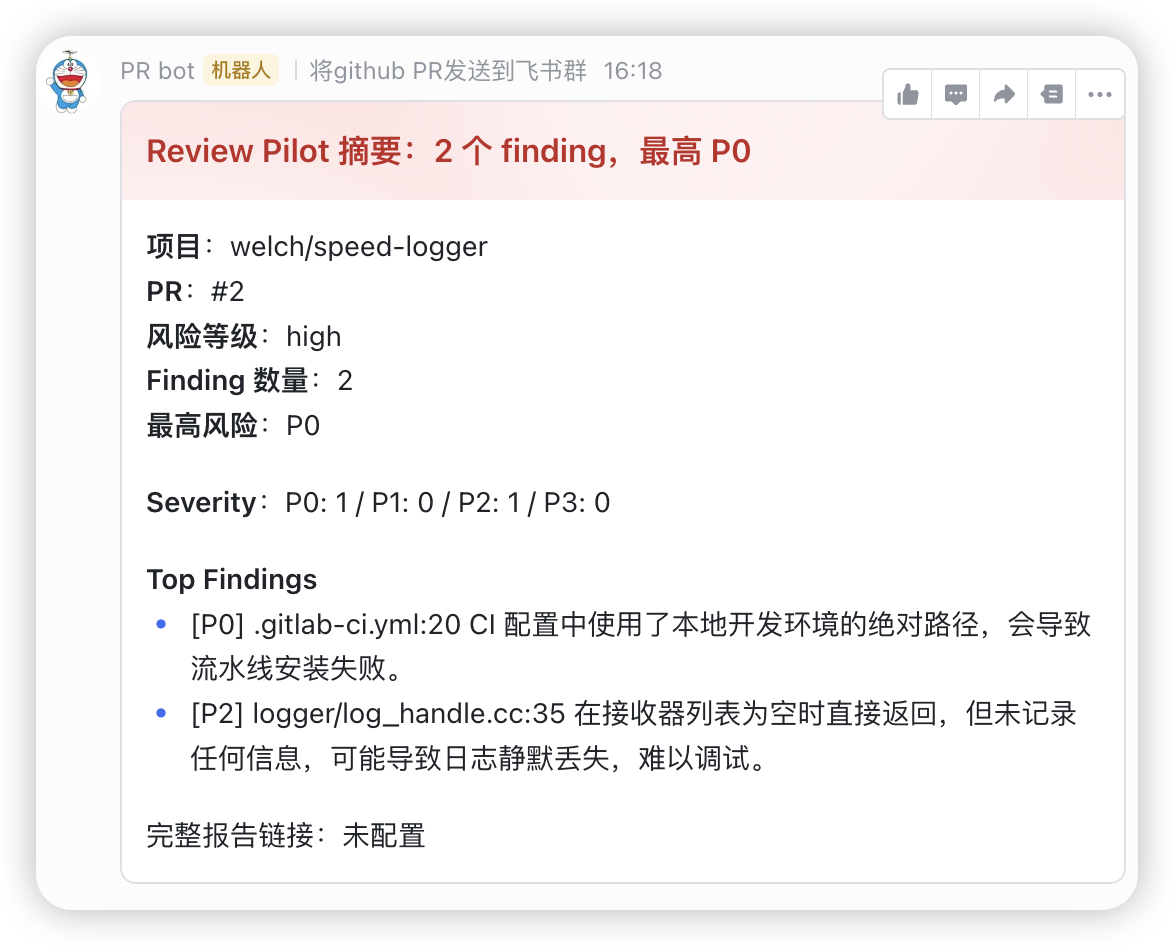
这些截图全部来自 实 Pull Request 和 Merge Request,模型调的是真实外部 API,页面是真实的 GitHub、GitLab 和飞书,没有任何"假装跑通"的环节。
从一套代码,到一条完整的研发流程
课程内容按真实研发流程组织:从最小可用版本开始,一步步完成审查核心、质量策略和协作平台接入,最后用一份完整使用手册,把安装、本地运行、GitHub、GitLab 和飞书配置串成能直接照做的流程。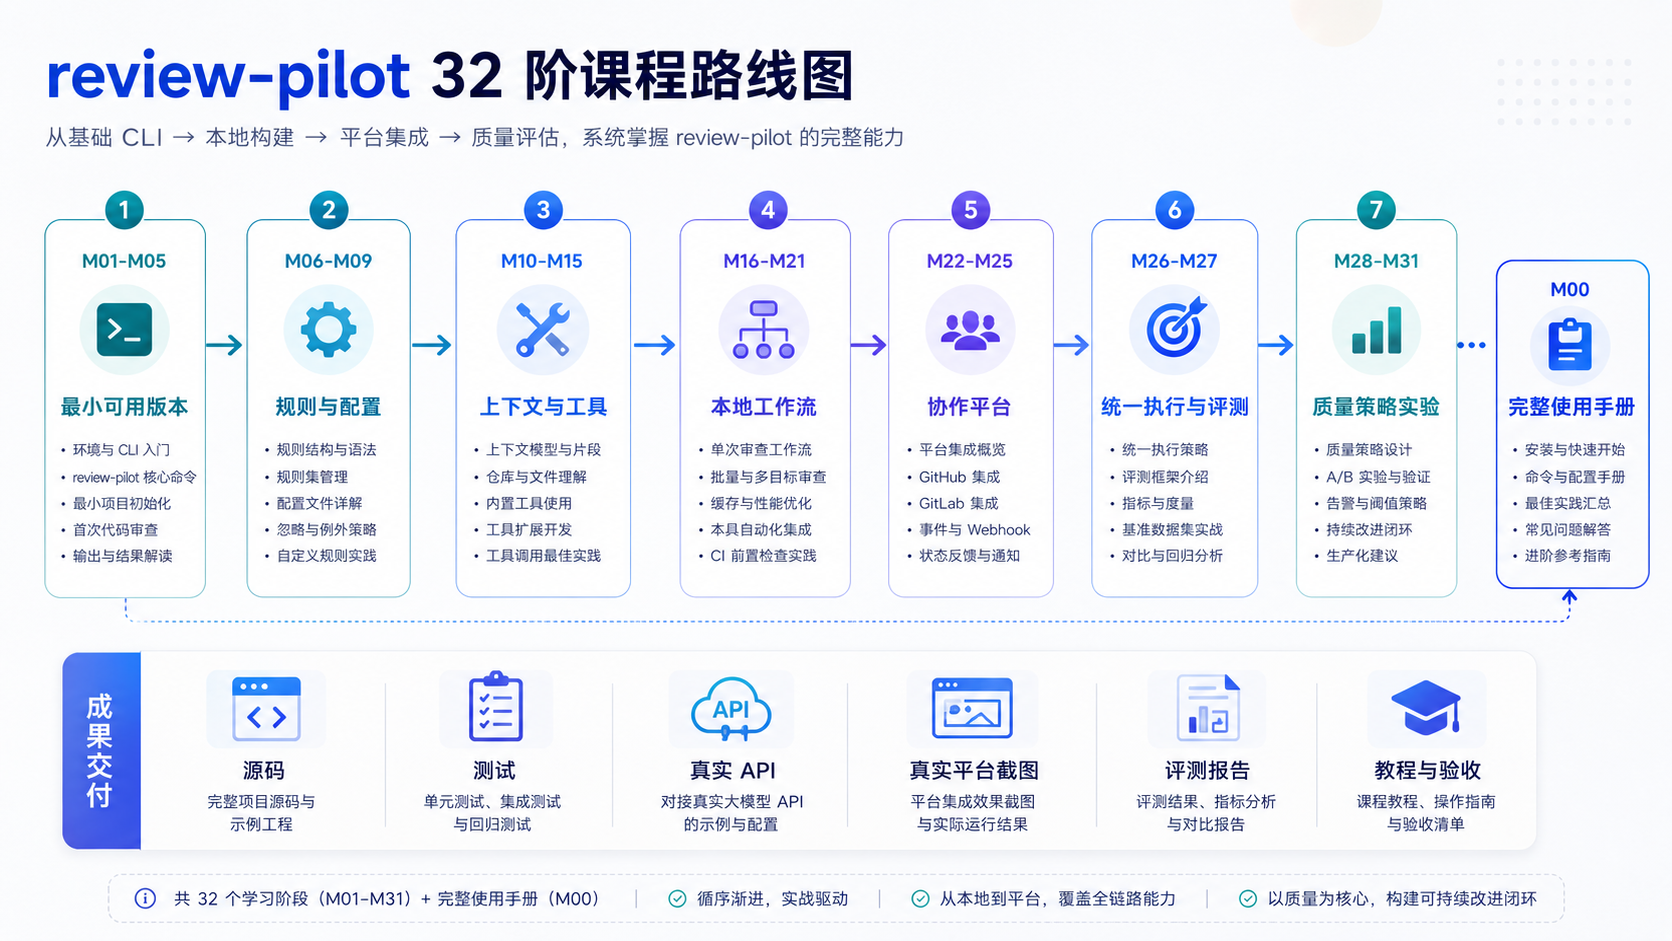
每个模块都有源码、测试、可复制的命令、真实输出、机制图解和教程。你会完整经历一个功能从设计、实现、测试到真实平台验证的过程,也会搞清楚哪些结论靠单元测试就能证明,哪些必须调用真实模型和外部平台才能确认。
学完以后,你能得到什么
先说最实在的:你会从零写出一个能独立运行、真能接进团队研发流程的代码审查工具。工具之外,还会攒下一批在项目讨论和面试里都拿得出手的工程经验:
- 怎么设计稳定的 CLI:配置优先级、退出码、JSON/Markdown 报告;
- 怎么解析 unified diff,把评论可靠地对应到本次变更;
- 怎么组合确定性规则、Semgrep 和 LLM,同时保留每条结论的来源;
- 怎么控制 Agent 的工具权限、轮次、Token 预算和错误处理;
- 怎么让本地、GitHub 和 GitLab 共用一套 ReviewEngine;
- 怎么用固定样本对比 Precision、Recall、F1、噪声、延迟和 Token 消耗;
- 怎么把自己的 Agent 和开源方案放进同一组基准里,做一次站得住脚的横向对比;
- 怎么把审查结果写进 GitHub、GitLab、Artifact 和飞书通知。
这个项目适合写过 Python、用过 Git,想完整做一次 AI Agent 工程项目的人。过程中你得愿意读真实输出、分析失败案例,你会发现:模型功能堆得越多,系统质量未必自动变好。可靠性是一点点测出来、约束出来的。
AI 项目到处都是,但能把"做完"和"做可靠"一起教明白的其实并不多,review pilot绝对算一个。
联系我
对项目感兴趣的同学,扫下面的二维码联系我,课程大纲、实验细节都可以聊。
阅读导航



