
第05篇|字典与集合:哈希表原理
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 5 篇。在 list/tuple 之后,进入按键存取的世界——dict 与 set:怎么建、怎么查、为什么平均 O(1),以及“什么能当键”背后的哈希表原理。
读完你将能够:熟练创建与读写字典;用
get/setdefault/update/视图安全操作;解释哈希 → 桶 → 冲突的心智模型;判断对象可否做键(可哈希);掌握 set/frozenset 与集合运算;写出计数、分组、配置等常见模式;并把 dict/set 映射到词表查找、配置、请求头与后续 KV 直觉。预计用时:阅读 35~45 分钟,动手 25~35 分钟。
第 02 篇讲过:名字绑定到对象,id 标识身份;不可变对象的值稳定,才谈得上“可哈希”。第 04 篇把这句话落到容器上——list 可变不能当键,元素都可哈希的 tuple 可以。本篇把那扇门推开:走进 字典(dict) 与 集合(set),看清它们为何能“按名字瞬间找到东西”。
你会立刻用上熟悉的方括号:d["name"] 很像 a[0],但下标不再是位置,而是键(key)。键可以是字符串、整数、元组……只要它可哈希(hashable)。下一篇(条件、循环与推导式)会把 for k, v in d.items() 和字典推导写顺;本篇先把“按键存取 + 哈希表为什么快”钉牢。
建议边读边在 uv run python 里敲。字典的坑多半不是语法,而是“改了键对象却还想用旧哈希找它”、或“遍历时删键”——打印 hash(...)、试一次 list 当键被拒绝,比背定义管用。
若你刚从第 04 篇过来:list 擅长有序缓冲与下标访问;dict 擅长按名字查找与去重式存在性判断。两者经常一起出现——例如用 list 收集样本,用 dict 按 req_id 索引。本篇阅读顺序:字典入门 → 哈希表心智模型 → 方法与视图 → 集合 → 常见模式 → AI Infra 收束。踩坑大全请务必过一遍。
和前几篇一样,原理旁边都配可跑的小实验。你不必一次记住所有方法名;更重要的是三张图:键经 hash 落到桶、冲突如何共存、不可哈希对象进不了键位。有了它们,后面读配置文件、查 tokenizer 词表、在 Agent 里按工具名分发,都只是同一套模型的应用。
也可以用一张对照表记住容器分工:list/tuple 回答“第几个”,dict 回答“叫什么名字”,set 回答“有没有、是否唯一”。训练脚本里三者经常同框——用 list 收 batch,用 dict 读超参,用 set 过滤停用词——本篇要把后两者的底层理由讲清楚,避免只会“花括号语法”却在 unhashable type 前发懵。
一、字典入门:创建与访问
1.1 字典是什么
字典(dict)是 Python 最常用的映射类型:用键关联值,键唯一,值任意。字面量用花括号,键值之间用冒号:
user = {"name": "Ada", "age": 36, "role": "engineer"}
print(type(user), len(user))
print(user["name"], user["age"])
<class 'dict'> 3
Ada 36
结合第 02 篇的对象模型:dict 不按“第几个槽位”找元素,而按键的哈希值定位。你给的是名字(或别的可哈希对象),解释器算出哈希,跳到对应“桶”,取出绑定的值。平均情况下,这一跳与字典里有多少条关系不大——这就是“平均 O(1) 查找”的日常说法。
空字典有两种常见写法:{} 与 dict()。注意:空集合不能写成 {}(那是空字典),要用 set()——第四节会再强调。
再做一个小实验,把“键 → 值”钉进直觉:
cfg = {"model": "mini-gpt", "layers": 12}
print("model" in cfg)       # 成员判断看的是键,不是值
print("mini-gpt" in cfg)    # False:值不参与 in
cfg["layers"] = 24          # 改已有键的值
cfg["hidden"] = 768         # 新键:插入
print(cfg)
True
False
{'model': 'mini-gpt', 'layers': 24, 'hidden': 768}
从 Python 3.7 起,dict 保持插入顺序(3.6 起 CPython 已如此,3.7 写入语言规范)。遍历时会按你当初放入的先后出现——这对打印配置、序列化 JSON 很友好。但请记住:有序不等于“按下标随机访问”;按位置取第 k 个键仍应先 list(d) 或用视图,而非常规用法。
保序还有一个实务好处:同一份配置在日志里每次打印字段顺序一致,排查“到底有没有写入某个键”时更省眼神。若你依赖的是“按键排序后的顺序”,那仍应显式 sorted(d)——插入序 ≠ 字典序。老资料里“dict 无序”的说法,对现代 Python 已过时;写新代码时按保序来思考即可。
1.2 多种创建方式
a = {"x": 1, "y": 2}                    # 字面量
b = dict(x=1, y=2)                      # 关键字参数(键必须是合法标识符)
c = dict([("x", 1), ("y", 2)])          # 键值对序列
d = dict.fromkeys(["a", "b", "c"], 0)   # 批量同初值
e = {}                                  # 空字典
print(a, b, c, d)
{'x': 1, 'y': 2} {'x': 1, 'y': 2} {'x': 1, 'y': 2} {'a': 0, 'b': 0, 'c': 0}
dict.fromkeys 很方便,但若默认值是可变对象(如 []),所有键会共享同一个列表——与第 04 篇 [[]]*n 同类陷阱。需要每键独立空列表时,应循环或字典推导(第 06 篇系统讲;这里先记“可变默认值要小心”)。
bad = dict.fromkeys(["u1", "u2"], [])
bad["u1"].append("msg")
print(bad)                  # 两个键都出现了 msg!

good = {k: [] for k in ["u1", "u2"]}
good["u1"].append("msg")
print(good)
{'u1': ['msg'], 'u2': ['msg']}
{'u1': ['msg'], 'u2': []}
键重复时,后面的覆盖前面的:
d = {"a": 1, "a": 2}
print(d)                    # {'a': 2}
{'a': 2}
1.3 读写与安全访问
直接用 d[key] 读取时,键不存在会抛 KeyError。生产代码里更常见的是 get:
d = {"name": "Ada", "age": 36}
print(d.get("name"))
print(d.get("email"))              # 缺省返回 None
print(d.get("email", "N/A"))       # 自定义默认值

d.setdefault("role", "guest")      # 没有才写入
d.setdefault("name", "Bob")        # 已有则不动
print(d)
Ada
None
N/A
{'name': 'Ada', 'age': 36, 'role': 'guest'}
删键用 del d[k] 或 d.pop(k)(可带默认值避免异常);清空用 d.clear():
d = {"a": 1, "b": 2, "c": 3}
print(d.pop("b"))
print(d.pop("z", None))     # 没有也不炸
del d["a"]
print(d)
2
None
{'c': 3}
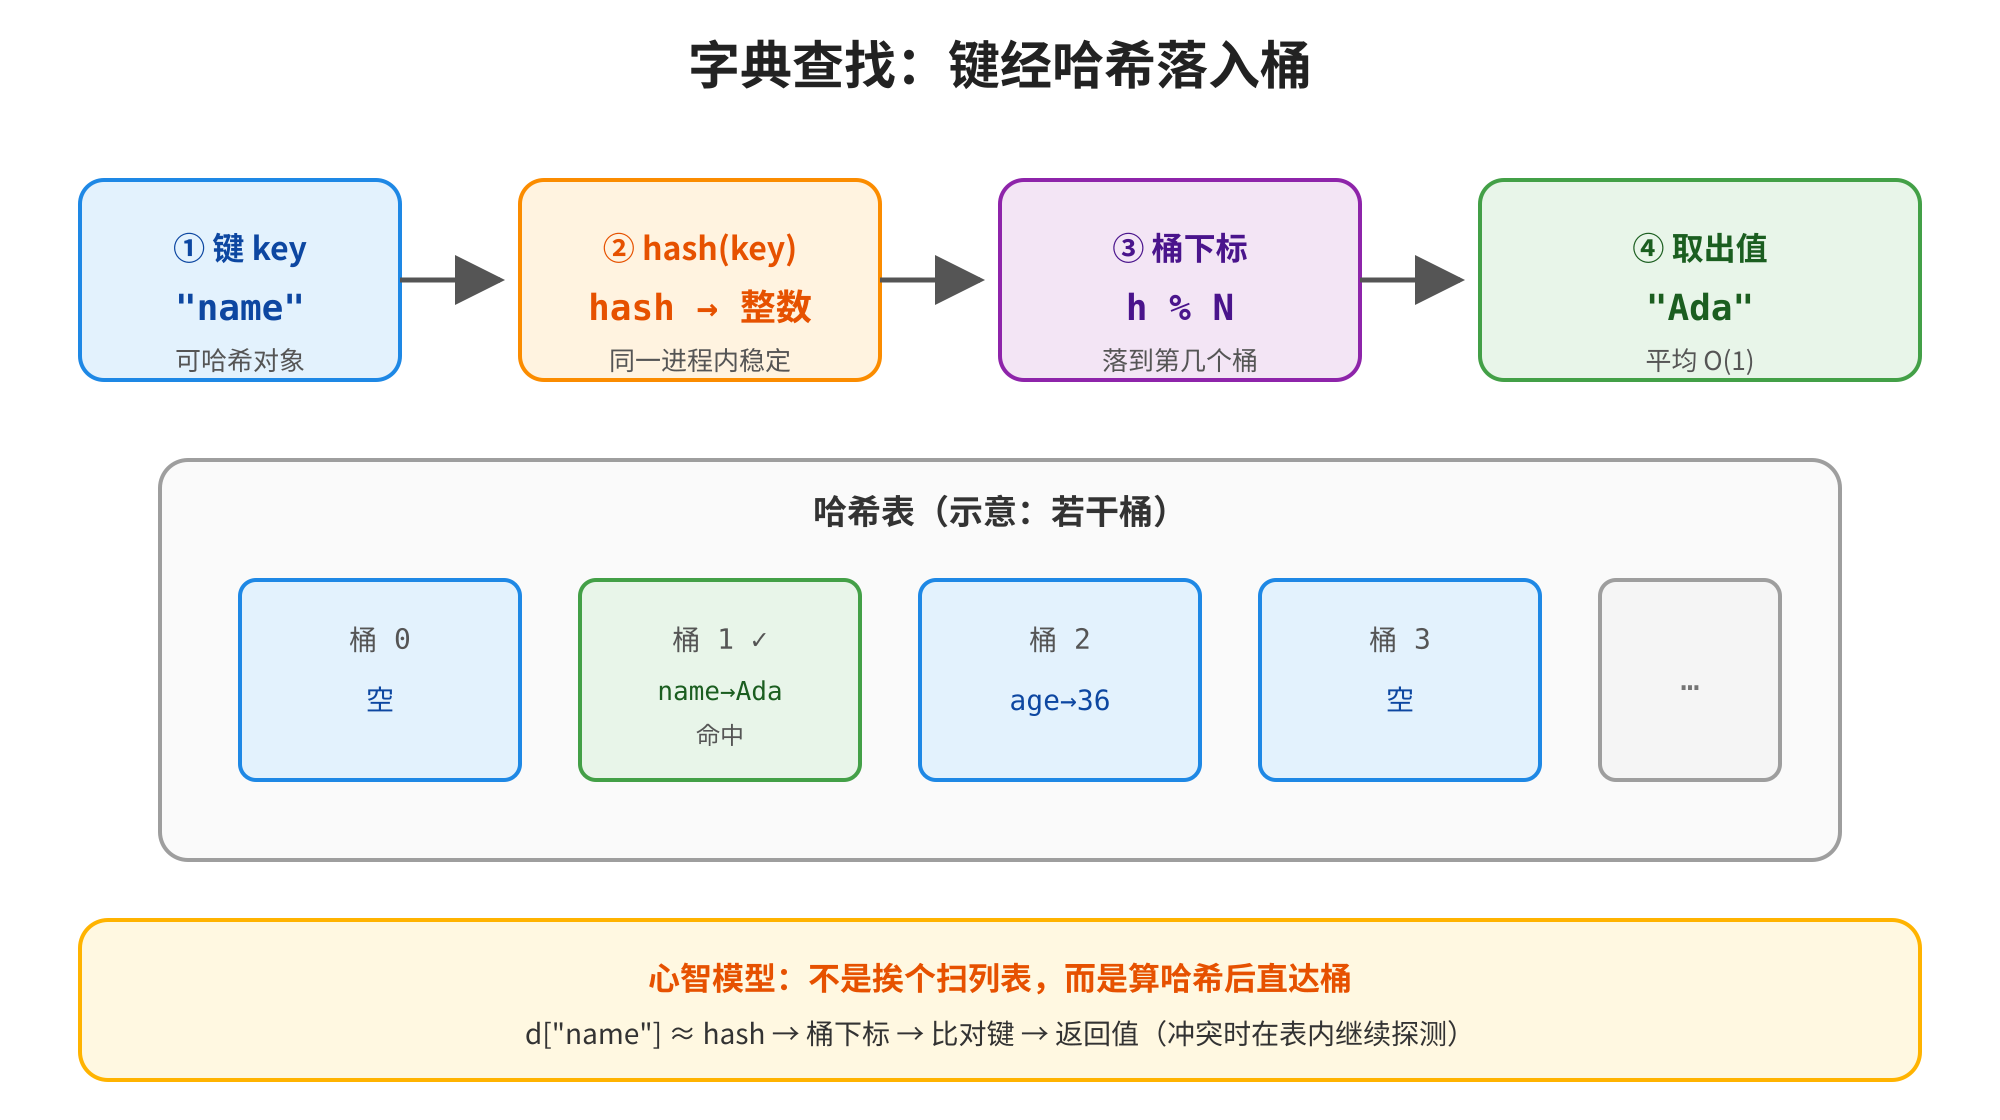
图1 字典查找:键经哈希落入桶
二、哈希表心智模型
2.1 从“按名字找”到平均 O(1)
为什么 list 里 x in big_list 可能越来越慢,而 k in big_dict 仍然很快?因为 list 的 in 往往要挨个比;dict 则把键变成一个整数哈希,直接跳到近似位置。
把字典想成一排带编号的桶(bucket):
- 对键调用
hash(key),得到一个整数; - 用哈希对桶数量取模(或位运算),得到桶下标;
- 在该桶里找到匹配的键,取出值。
桶够多、哈希够散时,多数键“一人一桶”,查找接近常数时间。这就是口头说的平均 O(1)——注意是平均,不是绝对保证(极端哈希碰撞或实现细节下可能退化,日常业务字典无需恐慌)。
print(hash("name"))
print(hash(42))
print(hash((1, 2)))         # 元组可哈希(元素也可哈希时)
(三行都是整数;具体数值因机器与进程而异,同一进程内同一不可变对象通常稳定)
同一进程里,不可变对象的 hash 在其生命周期内应稳定——这正是“能当键”的前提。解释器启动后还会给字符串等加 hash randomization(安全相关),所以不要把某次运行打印的 hash 写进持久化文件当指纹;跨进程要比对内容本身,或用加密哈希(如 hashlib)。
和 list 再对比一次直觉:在长度为 n 的列表里找某个值,最坏要看 n 次;在字典里找某个键,通常只算一次哈希再进桶比对。数据从几百涨到几十万时,这种差距会从“感觉差不多”变成“一个卡顿、一个瞬间”。这也是第 04 篇踩坑里写“超长 list 别反复 in、请转 set”的原因——set 与 dict 共用同一套哈希表家族。
2.2 冲突:两个键进了同一个桶
不同键完全可能算出相同的桶号,这叫哈希冲突(collision)。CPython 的 dict 用开放寻址等策略在表内继续探测,直到找到空位或匹配键——你写业务代码时不必手写这些,但要建立直觉:
- 冲突不可避免,实现负责解决;
- 负载因子过高时会扩容重哈希,摊到每次插入上仍可接受;
- 所以“平均很快”,而不是“每一次都绝对相同耗时”。
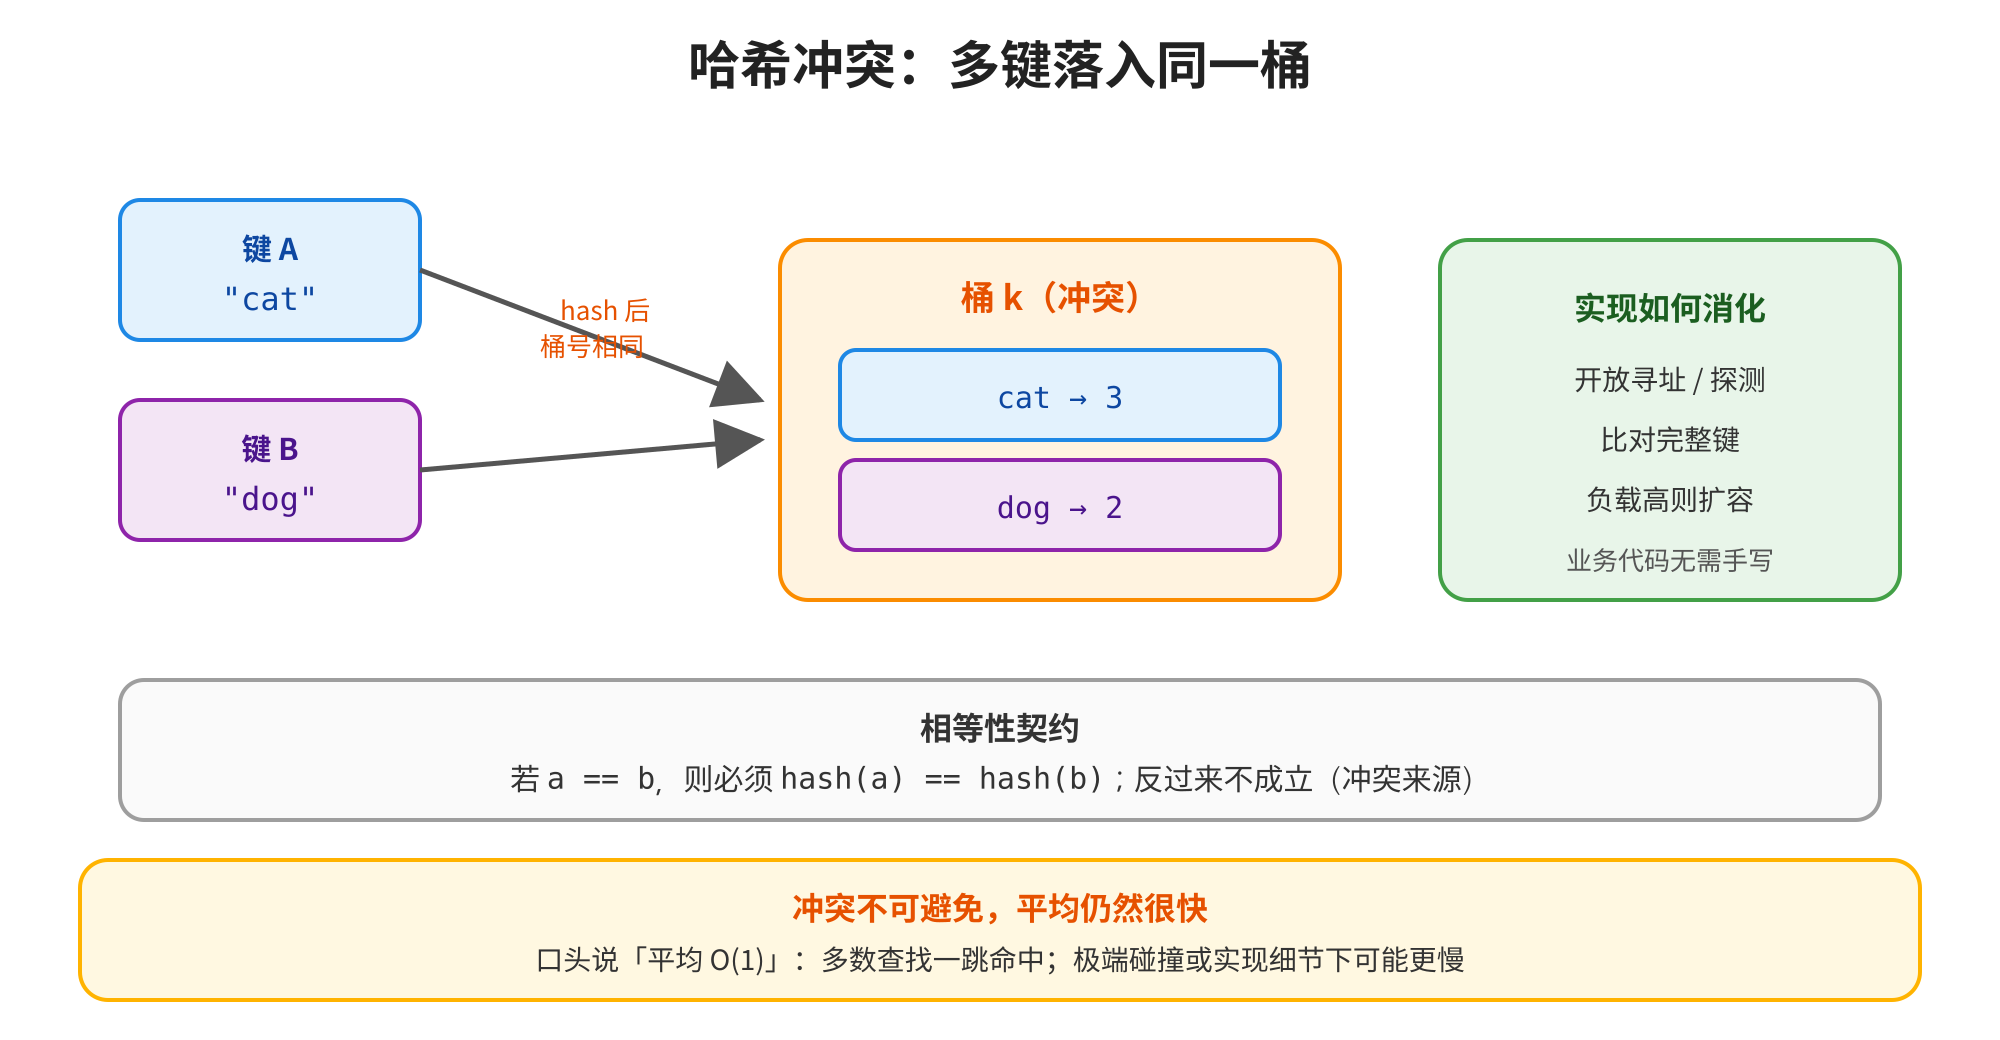
图2 哈希冲突:多键落入同一桶时如何共存
# 直觉演示:hash 相同不一定 is 相同;相等对象哈希必须相等
print(hash(1) == hash(1.0))     # True:1 与 1.0 相等,哈希一致
print(1 == 1.0)
print({1: "int", 1.0: "float"}) # 键视为同一个,后者覆盖
True
True
{1: 'float'}
这是相等性与哈希的契约:若 a == b,则必须 hash(a) == hash(b)。反过来不成立——哈希相同不必相等(冲突正来自于此)。
因此 1 与 1.0 在字典里会撞成同一键:它们相等,哈希也必须一致,后写入的覆盖先写入的。初学时这常让人惊讶;理解契约后就顺理成章。自定义类若既实现 eq 又实现 hash,必须自觉遵守同一契约,否则字典行为会变得“有时找得到、有时找不到”。入门阶段更稳妥的做法是:键只用内置不可变类型。
2.3 键必须可哈希:呼应第 02、04 篇
可哈希(hashable)粗略标准:
- 对象实现了稳定的
hash(生命周期内哈希不变); - 能与其它对象比较相等;
- 通常意味着不可变——至少“参与哈希的那部分”不可变。
ok_keys = ["Ada", 42, (1, 2), frozenset({1, 2})]
for k in ok_keys:
    print(type(k).__name__, "→", {k: True})

try:
    {[1, 2]: "no"}          # list 不可哈希
except TypeError as e:
    print(type(e).__name__ + ":", e)

try:
    {{1, 2}: "no"}          # set 本身也不可哈希
except TypeError as e:
    print(type(e).__name__ + ":", e)
str → {'Ada': True}
int → {42: True}
tuple → {(1, 2): True}
frozenset → {frozenset({1, 2}): True}
TypeError: unhashable type: 'list'
TypeError: unhashable type: 'set'
第 04 篇已埋伏笔:tuple 仅当所有元素也可哈希时才可哈希。([1],) 外表是元组,内层 list 仍会让它不可当键:
try:
    {([1],): "bad"}
except TypeError as e:
    print(type(e).__name__ + ":", e)

print({(1, 2): "good"})
TypeError: unhashable type: 'list'
{(1, 2): 'good'}
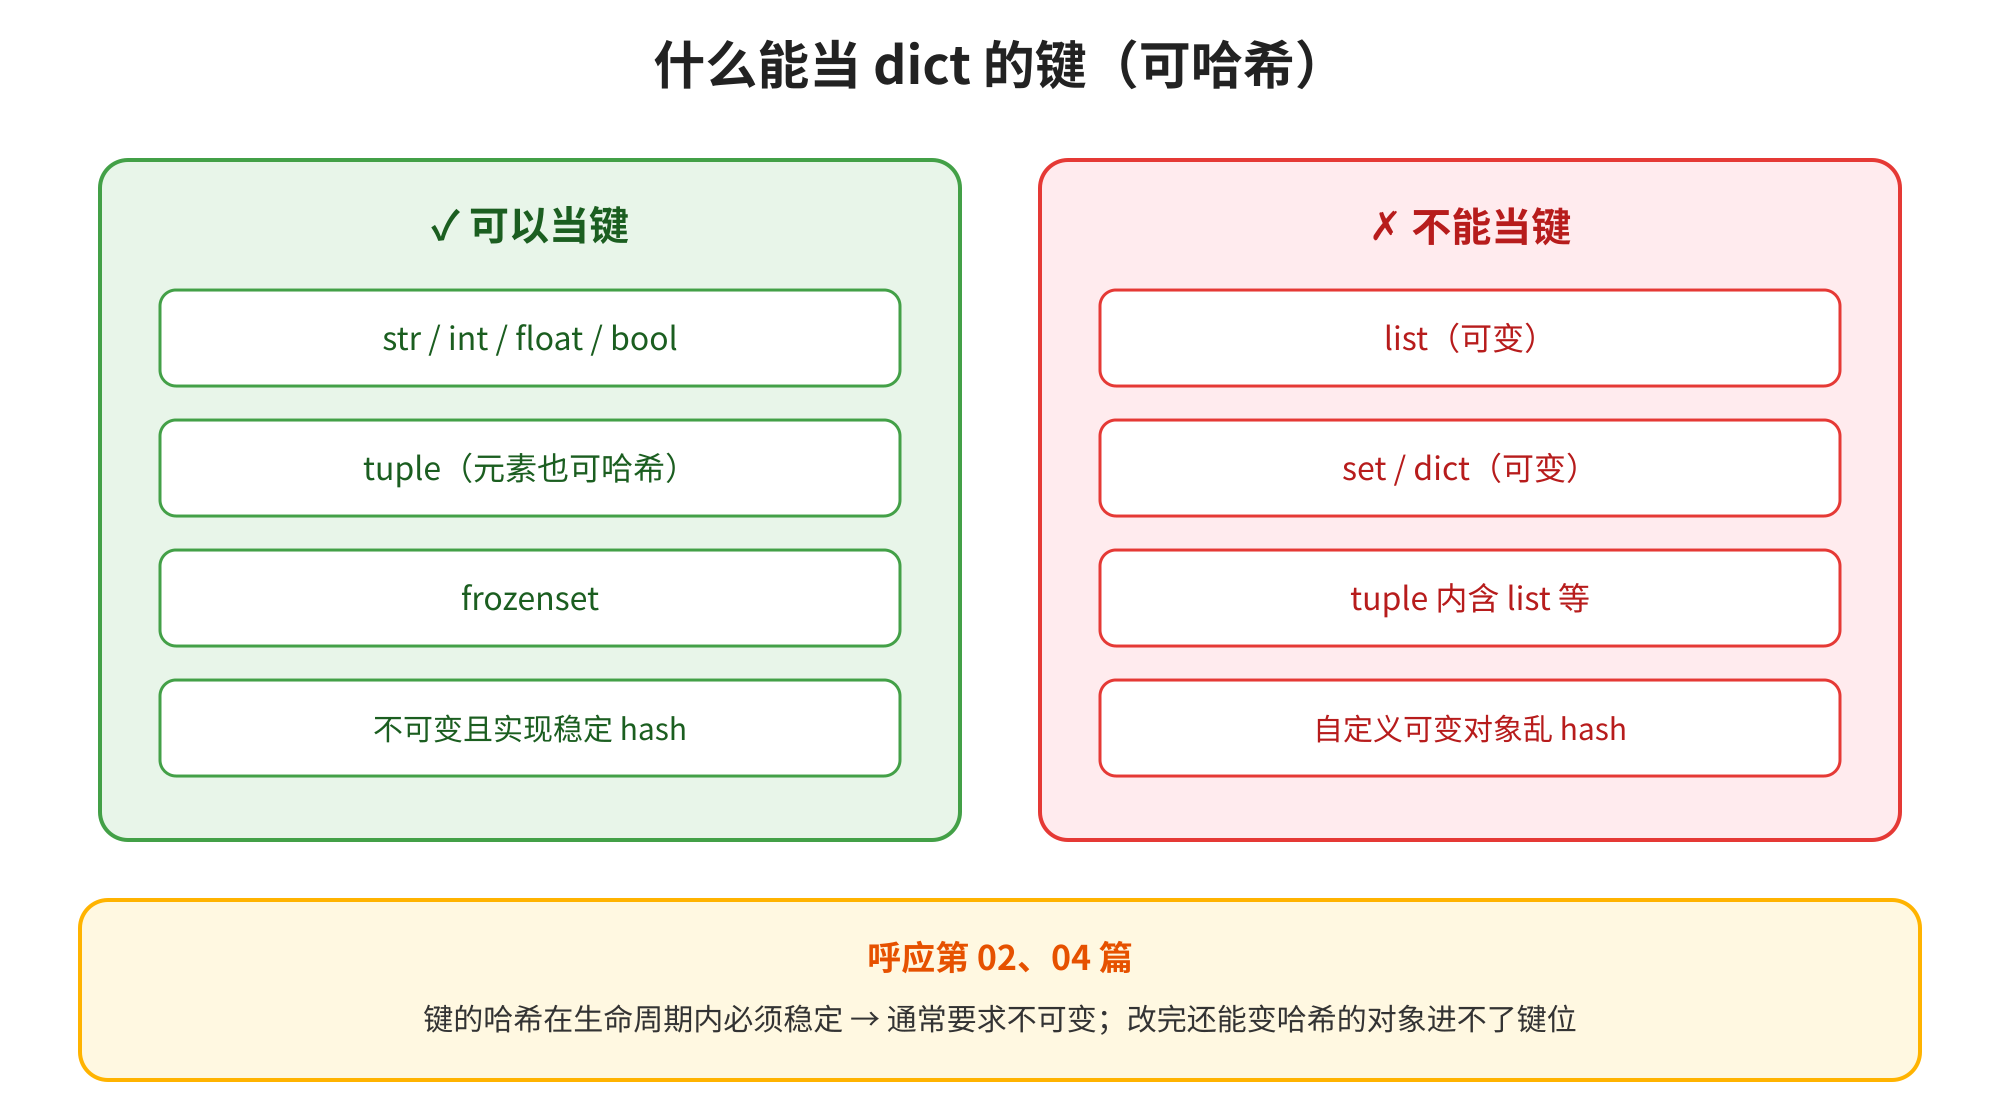
图3 什么能当 dict 的键
为什么必须不可变?
若键在插入后还能被改内容,它的哈希可能变,字典就再也找不到当初放下的桶——就像你把行李存进 3 号柜,却把钥匙上的号码涂改成 7。语言用“不可哈希”直接禁止 list/set/dict 当键,是在保护你。
把第 02 篇与第 04 篇串起来:赋值不复制、共享引用会牵一发而动全身;若再允许可变对象当键,牵动的就不仅是“另一个变量看见了修改”,而是整张哈希表的定位失效。所以“能当键”比“看起来像个标签”更严格——它要求身份与内容在哈希意义上保持稳定。复合键优先用 (layer, "k") 这类全不可变 tuple,而不是 [layer, "k"]。
三、字典常用方法与视图
3.1 更新、合并与遍历预备
a = {"x": 1, "y": 2}
a.update({"y": 20, "z": 3})     # 批量更新/插入
print(a)

b = {"x": 1}
c = {"y": 2}
print(b | c)                    # 合并为新字典(3.9+)
b |= {"z": 3}                   # 就地合并
print(b)
{'x': 1, 'y': 20, 'z': 3}
{'x': 1, 'y': 2}
{'x': 1, 'z': 3}
遍历键、值、键值对(详细循环语法见第 06 篇):
d = {"model": "mini-gpt", "layers": 12}
print(list(d.keys()))
print(list(d.values()))
print(list(d.items()))
['model', 'layers']
['mini-gpt', 12]
[('model', 'mini-gpt'), ('layers', 12)]
3.2 字典视图(dict view)
d.keys()、d.values()、d.items() 返回的是视图(view):像窗户看向字典当前内容,字典变了,视图里看到的也变;它们不是一份独立拷贝的 list。
d = {"a": 1, "b": 2}
keys = d.keys()
print(keys)
d["c"] = 3
print(keys)                     # 视图跟着变
dict_keys(['a', 'b'])
dict_keys(['a', 'b', 'c'])
需要独立快照时再 list(d.keys())。keys() 还支持类似集合的 & | 运算(与另一 keys 或 set),便于算“配置里有哪些键重叠”——这对合并多份 YAML/JSON 配置很有用。
default = {"lr": 1e-3, "bs": 32, "epochs": 10}
user = {"lr": 2e-4, "seed": 42}
print(default.keys() & user.keys())     # 重叠键
print(user.keys() - default.keys())     # 用户多出来的键
merged = default | user                 # 用户覆盖默认
print(merged)
{'lr'}
{'seed'}
{'lr': 0.0002, 'bs': 32, 'epochs': 10, 'seed': 42}
合并配置时还有一条实用惯例:先放默认值、后放用户值(default | user),这样用户侧显式写出的字段覆盖默认,没写的字段保留默认。反过来写会把默认值盖回去,排障时很隐蔽。视图上的 & / - 则适合做“声明了哪些键”“多了哪些未知键”的校验——比手写双重循环清晰得多。
3.3 浅拷贝与嵌套
与 list 相同:d.copy() / dict(d) 是浅拷贝。值若是可变对象,内外层仍共享:
import copy
outer = {"nums": [1, 2]}
shallow = outer.copy()
shallow["nums"].append(3)
print(outer)                    # 原字典也被改了

outer = {"nums": [1, 2]}
deep = copy.deepcopy(outer)
deep["nums"].append(3)
print(outer, deep)
{'nums': [1, 2, 3]}
{'nums': [1, 2]} {'nums': [1, 2, 3]}
四、集合与 frozenset
4.1 set:去重与存在性判断
集合(set)是无序(不保证业务含义上的顺序)、元素唯一、元素必须可哈希的容器。最常见的两个用途:去重与 O(1) 级别的 in 判断。
tags = {"train", "eval", "train", "infer"}
print(tags)                     # 自动去重
print("eval" in tags)

ids = [101, 102, 101, 103, 102]
unique_ids = list(set(ids))     # 去重;顺序不保证
print(sorted(unique_ids))
{'train', 'eval', 'infer'}
True
[101, 102, 103]
(打印 set 时元素顺序可能因版本/哈希随机化而不同;用 sorted(...) 得到稳定展示。)
空集合必须用 set():
print(type({}), type(set()))
<class 'dict'> <class 'set'>
in 对 set 与对 dict 的键一样,走哈希路径,所以“先把候选人名单转成 set,再反复判断是否在其中”是经典加速。注意:set 本身不记录插入次数,只关心“在不在”;若既要去重又要计数,请回到 dict 或 Counter。元素必须可哈希——{ [1,2] } 会与“list 当键”一样失败。
4.2 集合运算
a = {1, 2, 3, 4}
b = {3, 4, 5}
print(a | b)                    # 并
print(a & b)                    # 交
print(a - b)                    # 差
print(a ^ b)                    # 对称差(只在一边出现)
print(a <= {1, 2, 3, 4, 5})     # 子集
{1, 2, 3, 4, 5}
{3, 4}
{1, 2}
{1, 2, 5}
True
方法名写法:union / intersection / difference / symmetric_difference,与运算符等价;add / discard / remove / update 用于修改。
s = {1, 2}
s.add(3)
s.discard(99)                   # 没有也不报错
s.remove(2)                     # 没有则 KeyError
print(s)
{1, 3}
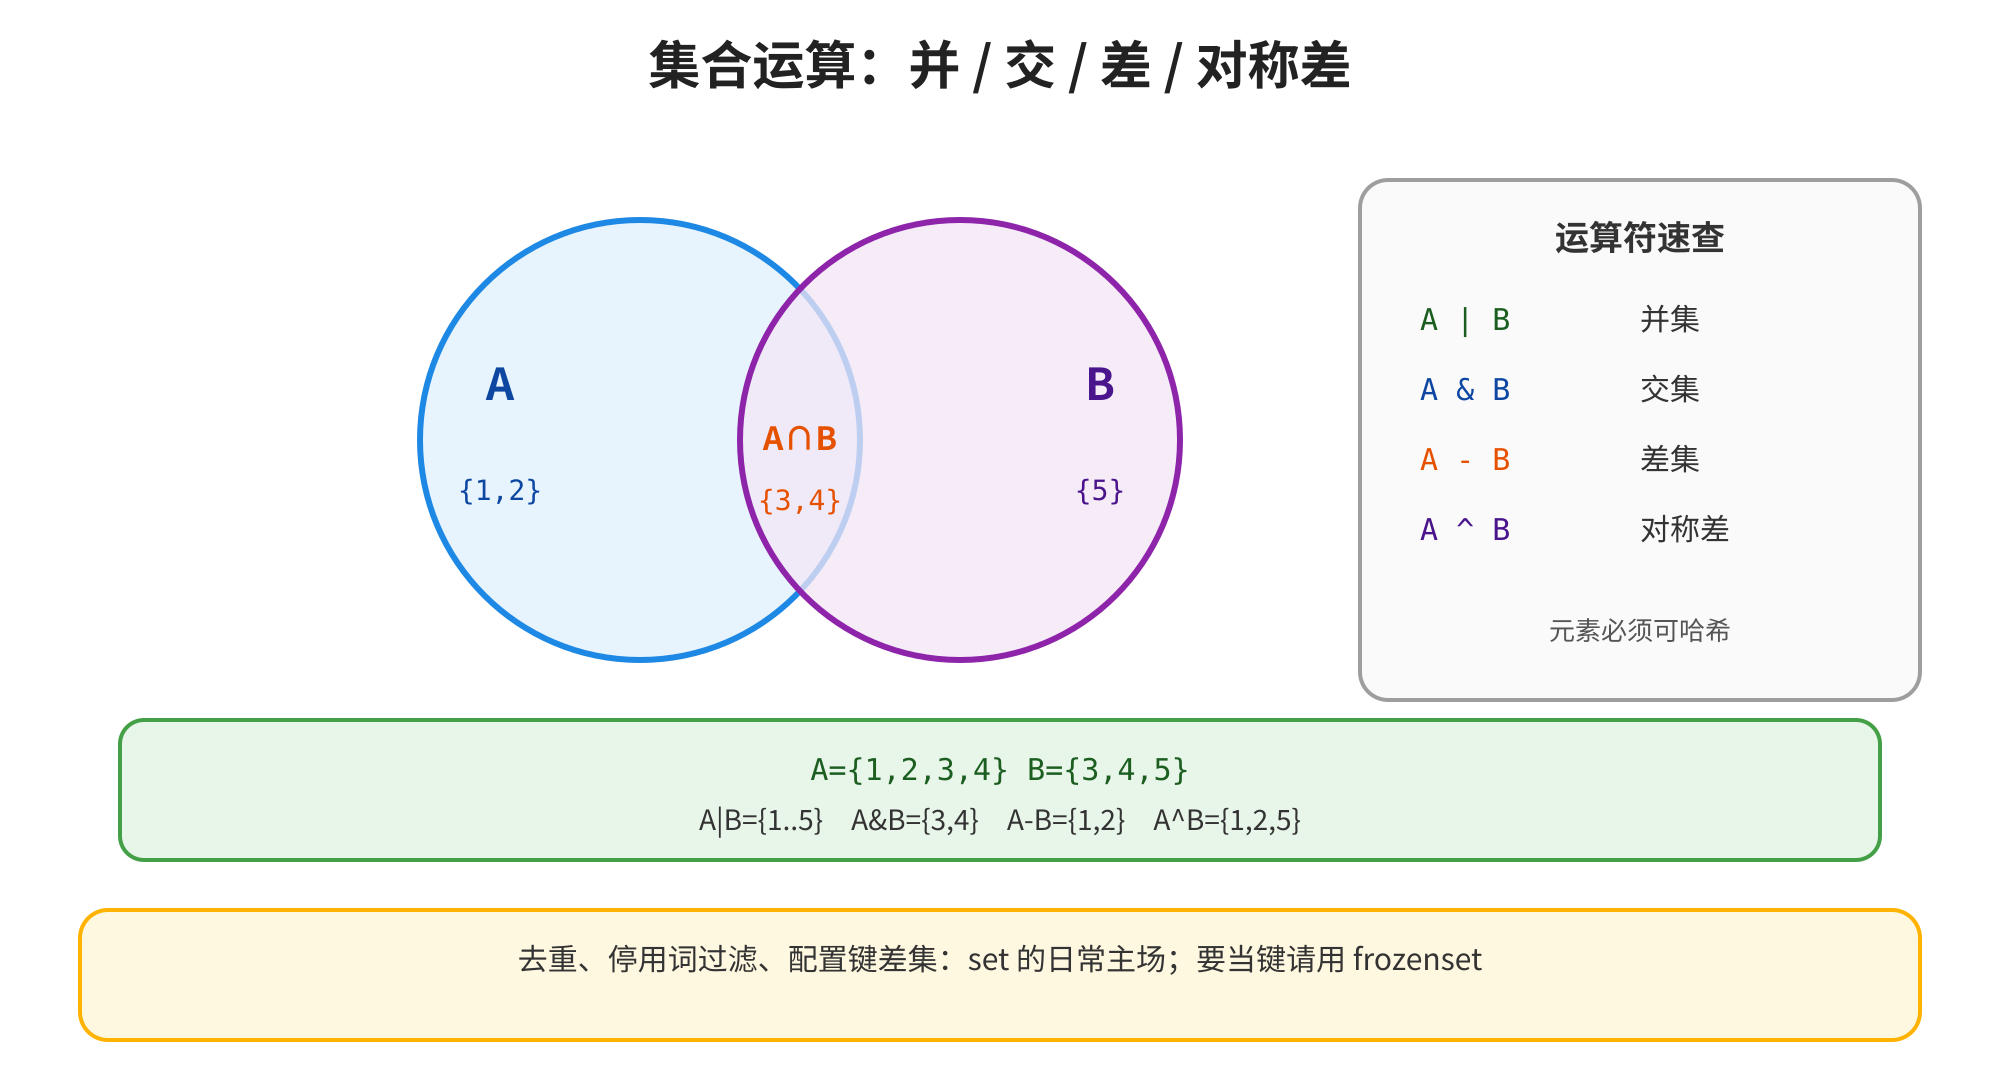
图4 集合的并交差
4.3 frozenset:不可变集合
frozenset 一旦创建不可改,因而可哈希,能当 dict 的键或嵌套进另一个 set:
fs = frozenset([1, 2, 2, 3])
print(fs)
cache = {fs: "ok"}
print(cache)
print(frozenset({1, 2}) == frozenset({2, 1}))
frozenset({1, 2, 3})
{frozenset({1, 2, 3}): 'ok'}
True
口诀:会变用 set,要当键或冻结用 frozenset——与 list/tuple 的分工同构。
一个常见场景:你想用“一组标签”当字典的键,例如把 {"train", "fp16"} 映射到某套超参。普通 set 不行,把它冻成 frozenset({"train", "fp16"}) 就可以。注意 frozenset 没有 add;要改只能新建。这正是“不可变”换来的可哈希资格。
五、常见模式:计数、分组、配置
5.1 计数
words = ["cat", "dog", "cat", "bird", "dog", "cat"]
count = {}
for w in words:
    count[w] = count.get(w, 0) + 1
print(count)
{'cat': 3, 'dog': 2, 'bird': 1}
标准库 collections.Counter(第 19 篇)是这一模式的封装;入门阶段手写 get 更能看清字典在干什么。token 频次统计、日志里按 status code 计数,都是同一套路。
也可以写成 count[w] = count[w] + 1,但第一次遇到新词会 KeyError,于是你要么先判断 if w not in count,要么统一用 get。团队里更推荐 get(或后续的 defaultdict(int)),意图是“缺省当 0 再加一”,读代码的人不必在脑子里模拟分支。计数结果若要按频次排序,用 sorted(count.items(), key=lambda kv: kv[1], reverse=True)——又一次用到第 04 篇的 key=。
5.2 分组
rows = [
    {"model": "gpt", "device": "cuda:0"},
    {"model": "gpt", "device": "cuda:1"},
    {"model": "bert", "device": "cpu"},
]
groups = {}
for r in rows:
    groups.setdefault(r["model"], []).append(r["device"])
print(groups)
{'gpt': ['cuda:0', 'cuda:1'], 'bert': ['cpu']}
setdefault + 可变容器,是分组的经典写法。第 06 篇学完推导式与 defaultdict(第 19 篇)后会更短,但思路不变:键是分组标签,值是列表缓冲。
分组与第 04 篇的“外层 list + 内层 list”不同:那里靠位置分桶(第 0 个 batch、第 1 个 batch),这里靠标签分桶(模型名、用户 id、工具名)。Agent 把多轮轨迹按 session_id 归拢、评估脚本按 dataset_split 汇总指标,都是分组字典。注意值列表仍然是可变共享对象——若你把 groups["gpt"] 传给函数并被原地修改,字典里那份也会变;需要隔离时再拷贝。
5.3 配置字典 vs 列表
| 需求 | 更合适 | 原因 |
|---|---|---|
| 按名字读超参 lr / batch_size | dict | 键语义清晰,查找 O(1) |
| 有序 token id 序列 | list | 位置即时间步 |
| 固定 shape (B,T,H) | tuple | 不可变、可当键 |
| 标签去重、词汇集合 | set | 唯一 + 快 in |
| 复合索引 (layer, "k") | dict + tuple 键 | 第 04 篇已见 |
config = {
    "model": "mini-gpt",
    "lr": 3e-4,
    "max_tokens": 128,
    "dtype": "float16",
}
print(config["lr"])

# 复合键:层号 + 缓存名
kv_meta = {}
kv_meta[(0, "k")] = {"shape": (2, 8, 64), "dtype": "float16"}
kv_meta[(0, "v")] = {"shape": (2, 8, 64), "dtype": "float16"}
print(kv_meta[(0, "k")]["shape"])
0.0003
(2, 8, 64)
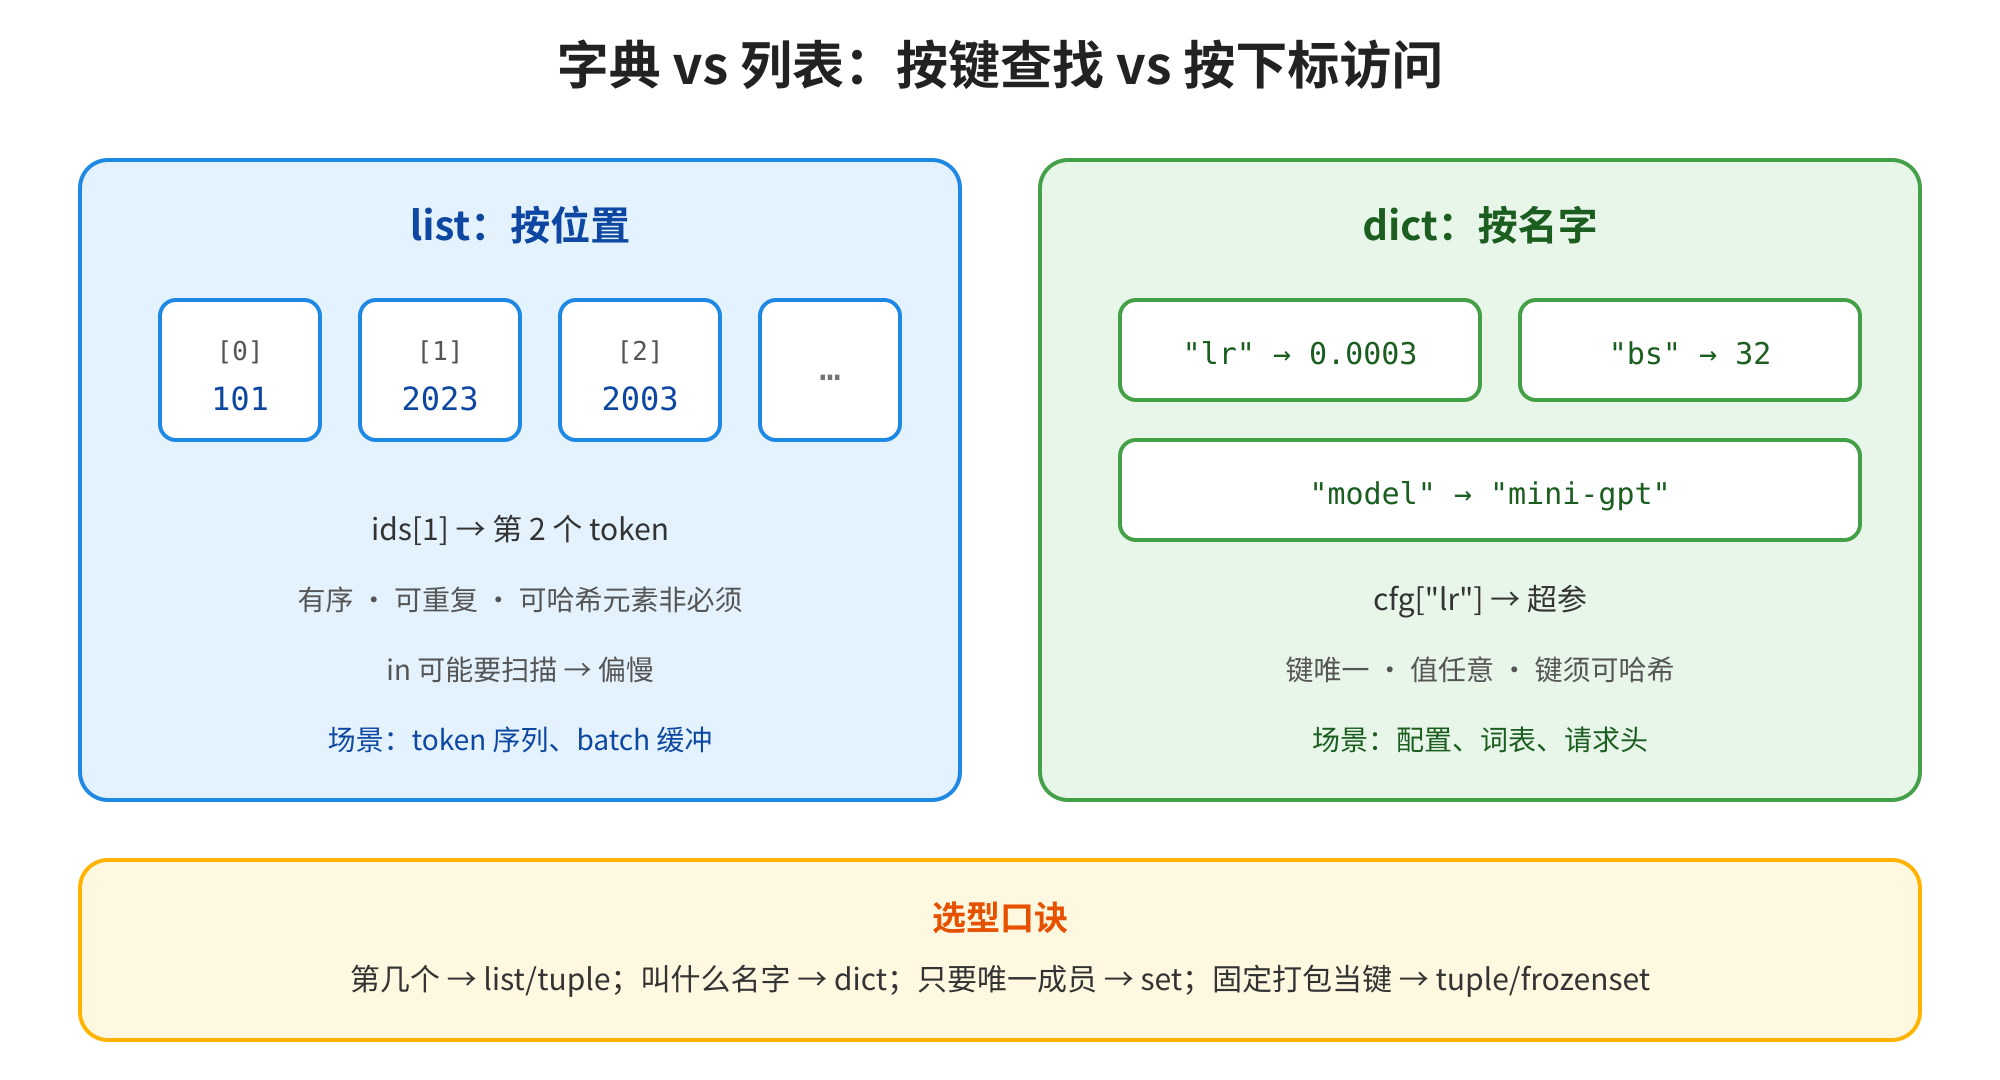
图5 字典与列表:按键 vs 按下标
六、AI Infra 视角:词表、配置与 KV 直觉
6.1 token 词表查找
Tokenizer 的核心表往往是“字符串 ↔︎ 整数 id”。用 dict 表达最自然:
# 极简词表示意(真实 BPE/WordPiece 远复杂于此)
vocab = {"<pad>": 0, "<bos>": 1, "hello": 15, "world": 28}
inv_vocab = {i: t for t, i in vocab.items()}

def encode(text_tokens):
    return [vocab[t] for t in text_tokens]

def decode(ids):
    return [inv_vocab[i] for i in ids]

ids = encode(["hello", "world"])
print(ids)
print(decode(ids))
print("hello" in vocab, vocab.get("unknown", vocab["<pad>"]))
[15, 28]
['hello', 'world']
True 0
热路径上百万次查询时,CPython dict 已经很快;更高性能场景会把词表收成专用结构。对你而言,先把“词 ↔︎ id”建成 dict,逻辑就对了。未知 token 用 get 落到 <unk> / <pad>,比直接 vocab[tok] 更稳。
反向表 inv_vocab 用推导式一行生成(第 06 篇会系统练);这里先体会“一对 dict 互为镜像”。真实 tokenizer 还要处理子词切分、特殊符号、字节回退等,那些是算法问题;存储与查找层仍然是映射表。训练日志里把 id 解回可读字符串,靠的就是反向 dict。
6.2 配置与请求头
推理服务、Agent 调工具,满眼都是字典:
# 模型/服务配置
serve_cfg = {
    "host": "0.0.0.0",
    "port": 8000,
    "model": "mini-gpt",
    "max_batch_tokens": 8192,
}

# HTTP 请求头(键值都是字符串的常见约定)
headers = {
    "Content-Type": "application/json",
    "Authorization": "Bearer <token>",
}

# 一次推理请求体(示意)
request = {
    "prompt": "hello",
    "max_tokens": 64,
    "temperature": 0.7,
}
print(serve_cfg["port"], headers["Content-Type"], request["max_tokens"])
8000 application/json 64
读配置时优先 cfg.get("temperature", 1.0),避免缺字段直接炸穿;写对外 API 时,用 dict 拼 JSON 是第 10、26 篇的日常。Agent 里“工具名 → 可调用对象”也是一张 dict:tools["search"] = search_fn。
请求头的键往往大小写有约定(HTTP 头不区分大小写,但 Python 字典区分)。落地时要么统一成规范大小写,要么在查找前做规范化——这又是“键的稳定性”主题的变体。配置合并则回到第三节的 default | user:默认配置进镜像,用户覆盖进运行时,既安全又好测。
6.3 和 KV Cache 的直觉——不过度宣称
第 04 篇用 tuple 键演示了 cache[("layer3", "k")]。本篇可以再进一步建立弱类比(帮助记忆,不是说推理引擎真用 Python dict 存显存):
| Python dict(本篇) | 推理里的 KV 直觉 |
|---|---|
| 键定位一条记录 | 用 request / layer 等标识定位缓存槽 |
| 值可巨大、可更新 | K/V 张量随解码步追加 |
| 键宜不可变、宜稳定 | 标识在生命周期内不应漂移 |
| 查找平均很快 | 调度上希望“按请求拿到自己的 cache” |
真实的 vLLM / SGLang(第 48 篇)会在分页显存、块表、前缀复用上做大量工程;底层绝不是一个普通 dict[(layer,"k")] = tensor 就能概括。你现在只需记住:
AI Infra 视角
按名字查表用 dict;去重与成员检验用 set;复合标识用可哈希 tuple 当键;词表、配置、请求头、工具注册表都是 dict 的主场。 KV Cache 让你对“键定位、值很大、持续更新”有直觉即可——实现细节留给专栏四。第 06 篇会把对 dict/set 的遍历与推导式写熟练,那时拼词表过滤、按字段分组会更短。
七、踩坑大全
下面这些坑,大多能归到三句话:“键必须可哈希且稳定”“视图不是拷贝”“遍历时不要删改键结构”。遇到 unhashable type 或“明明插过却 KeyError”,先回到这三条。
排查时可自问:键是 list/set/dict 吗?元组里夹了可变元素吗?用的是 get 还是直接 []?是不是在 for k in d 时 del d[k]?四问下来,十之八九能定位。
7.1 键与哈希
坑 1:用 list 当键。 现象:TypeError: unhashable type: 'list'。原因:list 可变、不可哈希。解决:改成 tuple(元素也可哈希),或改用字符串等不可变键。
坑 2:元组里塞了 list。 现象:{([1],): 1} 同样 TypeError。原因:元组可哈希性取决于元素。解决:深层都换成不可变类型,或重新设计键。
坑 3:用可变对象当键并在插入后修改。 现象:自定义可变类若错误实现 hash,改完就找不到。原因:破坏了哈希表不变量。解决:键用不可变数据;自定义类遵循“不可变才定义 hash”。
坑 4:把某次 hash(x) 的结果持久化。 现象:重启后对不上。原因:字符串等存在哈希随机化。解决:持久化用内容本身或 hashlib。
7.2 访问与拷贝
坑 5:d[k] 遇缺键直接崩溃。 现象:线上偶发 KeyError。解决:get / setdefault;或先 if k in d。
坑 6:dict.fromkeys(keys, []) 共享可变默认值。 现象:改一个键的列表,全部跟着变。解决:{k: [] for k in keys}。
坑 7:浅拷贝嵌套 dict。 现象:b = a.copy() 后改 b["x"].append(...),a 也变。解决:copy.deepcopy,或只拷需要隔离的那一层。
坑 8:误以为 d.keys() 是 list。 现象:想 keys[0] 或改视图。原因:视图不支持按任意下标改键。解决:需要列表时显式 list(d.keys())。
7.3 集合与迭代
坑 9:{} 写成空集合。 现象:type({}) 是 dict。解决:空集合用 set()。
坑 10:遍历字典时删除键。 现象:RuntimeError: dictionary changed size during iteration。解决:先 list(d) 再删,或收集待删键后二次处理。
d = {"a": 1, "b": 0, "c": 3}
for k in list(d):
    if d[k] == 0:
        del d[k]
print(d)
{'a': 1, 'c': 3}
坑 11:用 set 去重后假定顺序还在。 现象:输出顺序与输入不同。解决:需要稳定顺序时用 list(dict.fromkeys(xs))(3.7+ 保序)或排序。
坑 12:remove vs discard。 现象:s.remove(x) 在元素不存在时抛 KeyError。解决:不确定在不在用 discard。
7.4 环境与性能
坑 13(Jupyter):单元格反复更新同一个 dict 却忘记重置。 现象:键越积越多。解决:实验开头重新 d = {},或重启内核。
坑 14:热循环里对超长 list 用 in 做成员检验。 现象:越来越慢。解决:转为 set 再查(本篇正题)。
坑 15:把 float 当键却遇上精度。 现象:0.1 + 0.2 作键与 0.3 对不上。解决:键尽量用 int/str;必须用小数时先量化到固定精度字符串。
坑 16:布尔与整数当键的相等性。 现象:{True: "t", 1: "i"} 只剩一条。原因:True == 1 且哈希相同。解决:键类型保持一致,避免混用 bool/int。
print({True: "t", 1: "i"})
{True: 'i'}
八、小结
合上文章后,试着用自己的话解释:“为什么 list 不能当键”以及“get 和 setdefault 差在哪”——讲得清,才算真的会了。
- dict 是映射:键唯一、值任意;字面量
{k: v};平均查找 O(1);3.7+ 保插入序。 - 哈希表心智模型:
hash(key)→ 桶 → 处理冲突;a == b则必须hash(a) == hash(b)。 - 键必须可哈希:常用 str/int/tuple/frozenset;list/set/dict 不行;元组元素也必须可哈希。
- 方法与视图:
get/setdefault/pop/update/|;keys/values/items是活视图,要快照再list(...)。 - set / frozenset:去重与快速
in;并交差;frozenset 不可变可当键。 - AI Infra 映射:词表与配置用 dict;去重与词表过滤用 set;复合键用 tuple;对 KV 只借“键定位、值更新”的直觉,不把实现简化成纯 Python dict。
把故事连起来:不可变才有稳定哈希 → 稳定哈希才能当键 → 键经哈希落入桶 → 冲突由实现消化 → 于是你享受到平均 O(1)。list 负责“第几个”,dict 负责“叫什么名字”。
若只能带走一句话:按名字查用 dict,去重用 set;键必须可哈希,缺键用 get,可变默认值别共享。
再留一个自测:默写 hash → 桶 → 冲突 三步,并举一个明确失败的例子({[1]: 2})和一个复合键成功的例子({(0, "k"): ...})。能默写出来,本篇就站稳了。
九、课后练习
- (基础)创建字典
cfg = {"lr": 1e-3, "bs": 32},读取lr;用get读取不存在的seed(默认 0);再setdefault写入seed=42,打印最终字典。 - (基础)演示
dict.fromkeys(["a", "b"], [])的共享陷阱,并给出每键独立空列表的正确写法。 - (基础)对列表
[3, 1, 3, 2, 1]分别用 set 去重、用dict.fromkeys去重并保持顺序,打印两种结果(后者用list(...))。 - (理解)解释为什么
{([1],): "x"}会失败,而{(1,): "x"}成功;再验证hash(1) == hash(True)时{1: "i", True: "t"}的结果。 - (理解)手写词频统计:输入字符串列表,输出
dict[str, int];再用集合运算求出“只在 A 出现、不在 B 出现”的单词集合。 - (理解)令
d = {"a": 1, "b": 2},k = d.keys(),再执行d["c"] = 3,打印k;说明视图与list(d.keys())的差别。 - (进阶)实现
def group_by(rows: list[dict], key: str) -> dict:按row[key]分组,值为该组行组成的 list;不要修改传入的rows。 - (进阶 · AI Infra)用两个 dict 实现最小词表
vocab/inv_vocab,编写encode/decode;对未知词返回<unk>的 id(先在词表里登记<unk>)。额外:用 set 保存stopwords,过滤后再 encode,打印过滤前后的 id 列表。
下一篇预告
字典与集合解决了“按键存取与去重”;下一篇 《第06篇|条件、循环与推导式》 会把控制流写顺:if/elif/else、for/while、break/continue,以及列表/字典/集合推导式——包括 for k, v in d.items()、{k: v for ...}、在推导里过滤词表与配置。本篇的 dict/set 会立刻变成推导式的主菜。
专栏一「Python 从零入门」的后续路线:条件循环与推导式(06)→ 函数(07、08)→ 模块与 import(09)→ 文件(10)→ 异常(11)→ 面向对象与数据模型(12~14)。带着本篇的哈希表直觉,读配置、查词表、在 Agent 里按名字分发工具时会顺手很多。
若你已经在用 Jupyter,建议把“list 当键失败”和“fromkeys 共享可变值”各跑一遍,留下 TypeError 与打印对比——比单纯高亮笔记记得牢。下一篇开始,容器之上的控制流与一行推导就要登场了。