
第04篇|列表与元组
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 4 篇。在“名字与对象”“数字与字符串”之后,进入最常用的两类容器——可变的 list 与不可变的 tuple:怎么建、怎么改、怎么切、怎么拷,以及什么时候该用哪一个。
读完你将能够:熟练创建、索引、切片列表与元组;用 append/extend/insert/pop/remove/sort 等方法就地操作列表;解释可变与不可变的差异并正确选型;避开浅拷贝与迭代中修改等陷阱;用解包与
*拆包写更干净的代码;并把 list/tuple 映射到 batch、token id、配置常量与后续张量 shape。预计用时:阅读 35~45 分钟,动手 25~35 分钟。
第 02 篇建立了“名字绑定到对象”的心智模型:赋值不复制,共享引用会牵一发而动全身。第 03 篇把字符串当作不可变序列操练了索引与切片。本篇把镜头对准另一类序列——列表(list)与元组(tuple)。
你会立刻感到熟悉:a[0]、a[1:3]、a[::-1] 的规则与字符串几乎一样。差别在于:列表是可变的,可以 append、改某个下标、排序;元组是不可变的,更适合当“固定的一小包数据”。下一篇(字典与集合)会进入哈希表世界;本篇的“可哈希 / 不可变”讨论正是那扇门的钥匙。
建议边读边在 uv run python 里敲代码。列表的坑多半不是语法难,而是“以为复制了其实没复制”——打印 id、改一处再看另一处,比背定义管用十倍。
若你刚从第 03 篇过来:字符串的索引/切片肌肉记忆可以直接迁移;真正要新建的肌肉,是“可变容器 + 共享引用”带来的别名问题。第 02 篇的图在本篇会变得非常具体——因为 list 是你每天改得最多的可变对象。
本篇阅读顺序:先建立列表内存图 → 对比 list/tuple → 吃透常用方法 → 嵌套与浅拷贝 → 序列协议与栈队列 → AI Infra 场景收束。踩坑大全请务必过一遍。
和前几篇一样,本篇刻意把“能跑的小实验”放在原理旁边。你不必一次记住所有方法名;更重要的是建立三张图:列表槽位存引用、list 与 tuple 的可变性分界、浅拷贝只复制外层。有了这三张图,后面遇到 DataLoader 拼 batch、函数默认参数踩坑、NumPy 视图,都只是同一套模型的变体。
一、列表入门:创建、索引与切片
1.1 列表是什么
列表(list)是 Python 最常用的可变序列:有序、可重复、可容纳任意类型的对象。字面量用方括号:
nums = [10, 20, 30]
mixed = [1, "hi", 3.14, True]
empty = []
print(type(nums), len(nums), nums[0])
<class 'list'> 3 10
结合第 02 篇的对象模型:列表对象自己有一块“槽位数组”,每个槽位存的是指向元素对象的引用,不是元素本身。改 nums[0] = 99,是把槽位 0 换成指向另一个对象的引用;10 那个 int 对象本身并没有被“改写”(int 本来也不可变)。
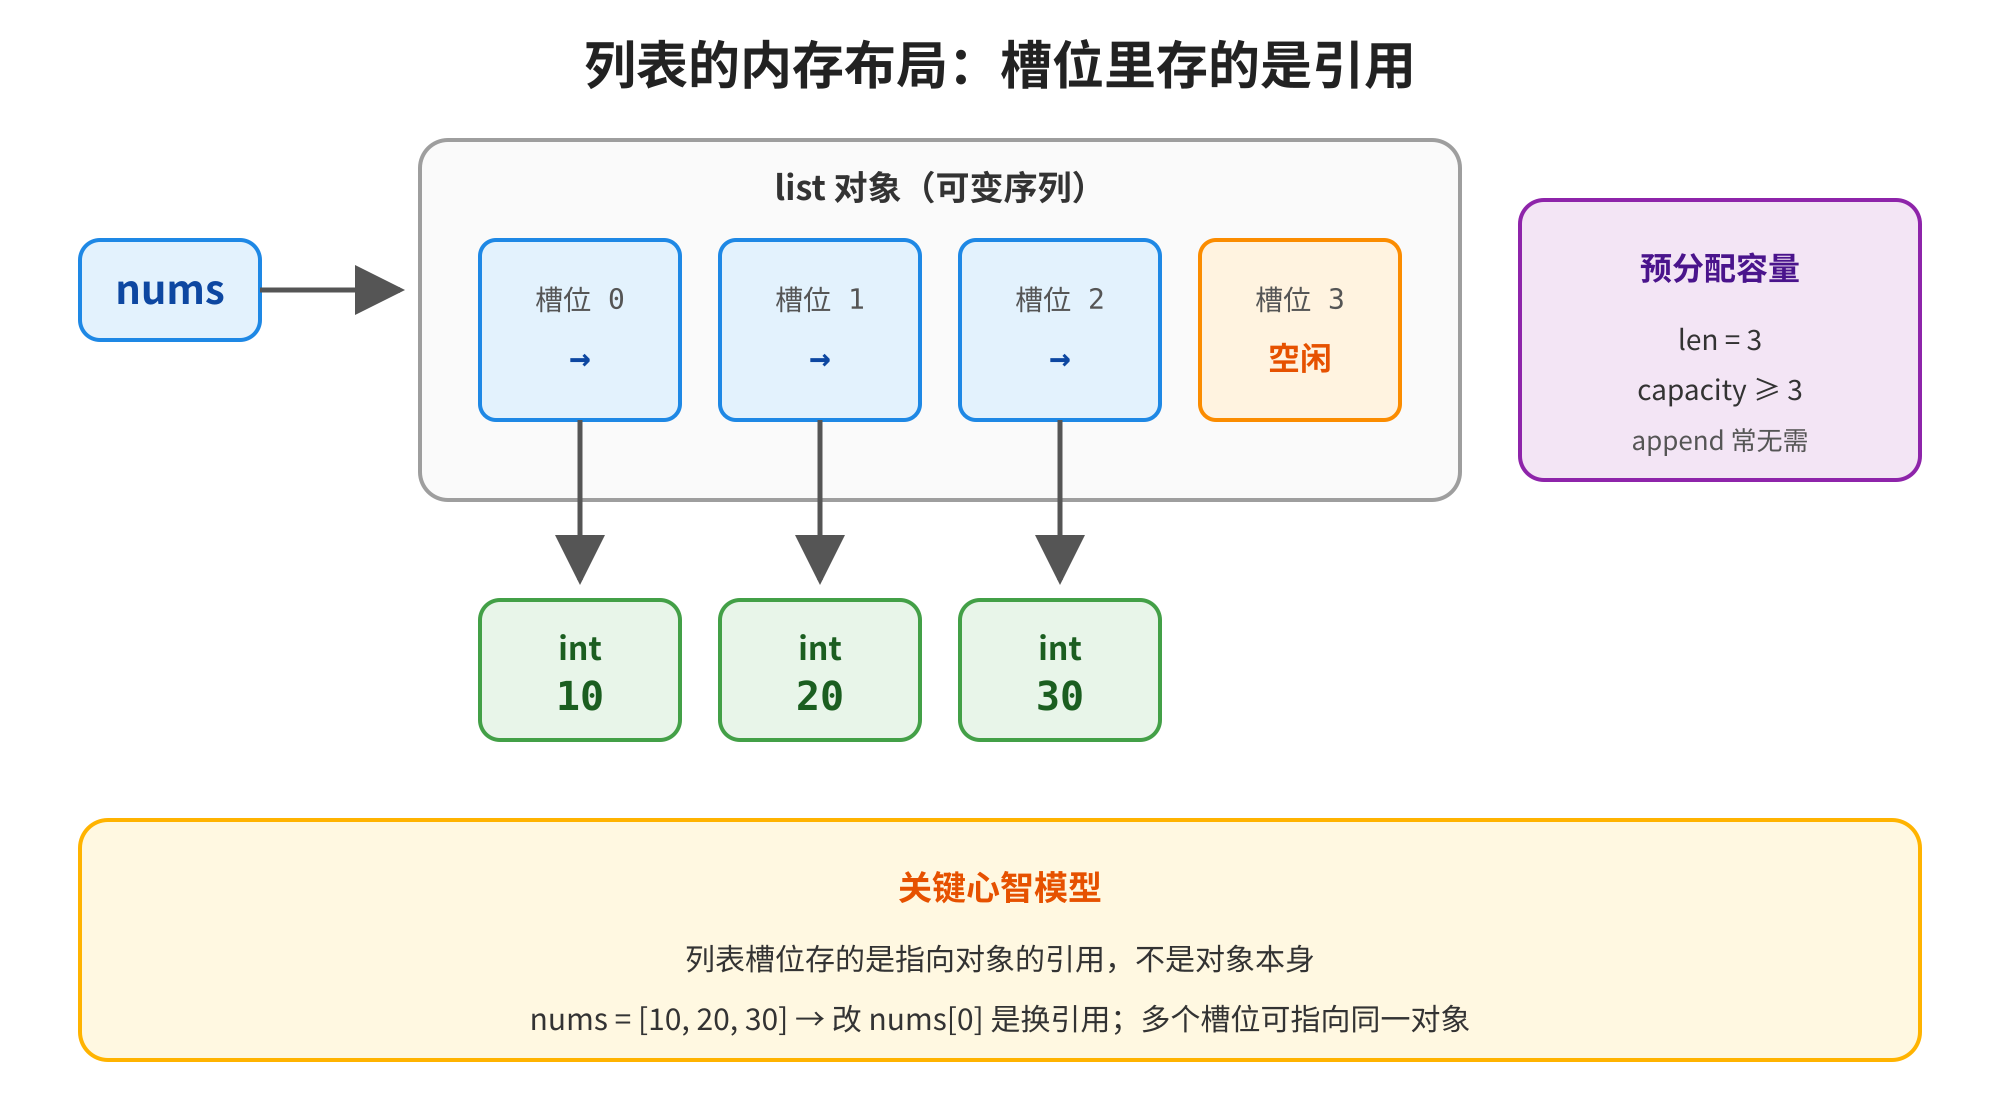
图1 列表的内存布局:槽位里存的是引用
CPython 实现里,列表还会预留一点多余容量,所以连续 append 多数时候不必每次都重新分配整块内存——这是性能细节,语义上你只需记住:len 是当前元素个数,底层可能比 len 更大。
再做一个小实验,把“槽位存引用”钉进直觉:
x = [1000, 2000]
print(id(x[0]), id(x[1]))
x[0] = 3000                 # 换了一个引用
print(x)
print(id(x[0]))             # 槽位 0 指向了新对象
(前两行 id 因机器而异;第三行打印 [3000, 2000];第四行 id 与原来的 1000 不同)
若两个槽位指向同一个对象,改的是“可变元素内部”时两边都会看见——这正是嵌套列表浅拷贝陷阱的前奏。
1.2 多种创建方式
a = [1, 2, 3]              # 字面量
b = list("hi")             # 从可迭代对象构造 → ['h', 'i']
c = list(range(3))         # [0, 1, 2]
d = [0] * 5                # [0, 0, 0, 0, 0]  注意:只适合不可变元素
e = []                     # 空列表
print(a, b, c, d)
[1, 2, 3] ['h', 'i'] [0, 1, 2] [0, 0, 0, 0, 0]
[0] * 5 很方便,但若写成 [[] ] * 3,三个槽位会指向同一个内层空列表——改一个等于改全部。正确做法是列表推导:[[] for _ in range(3)](第 06 篇会系统讲推导式;这里先当“安全写法”记住)。
bad = [[]] * 3
bad[0].append(1)
print(bad)                 # [[1], [1], [1]]  坑!

good = [[] for _ in range(3)]
good[0].append(1)
print(good)                # [[1], [], []]  符合预期
[[1], [1], [1]]
[[1], [], []]
1.3 索引与切片(规则与字符串相同)
正索引从 0 起,负索引从 -1(末尾)起;切片 a[start:stop:step] 左闭右开。这些规则你在第 03 篇字符串里已经练过,列表原样复用:
a = [10, 20, 30, 40, 50]
print(a[0], a[-1])         # 10 50
print(a[1:4])              # [20, 30, 40]
print(a[:3], a[3:])        # [10, 20, 30]  [40, 50]
print(a[::2])              # [10, 30, 50]
print(a[::-1])             # [50, 40, 30, 20, 10]
10 50
[20, 30, 40]
[10, 20, 30] [40, 50]
[10, 30, 50]
[50, 40, 30, 20, 10]
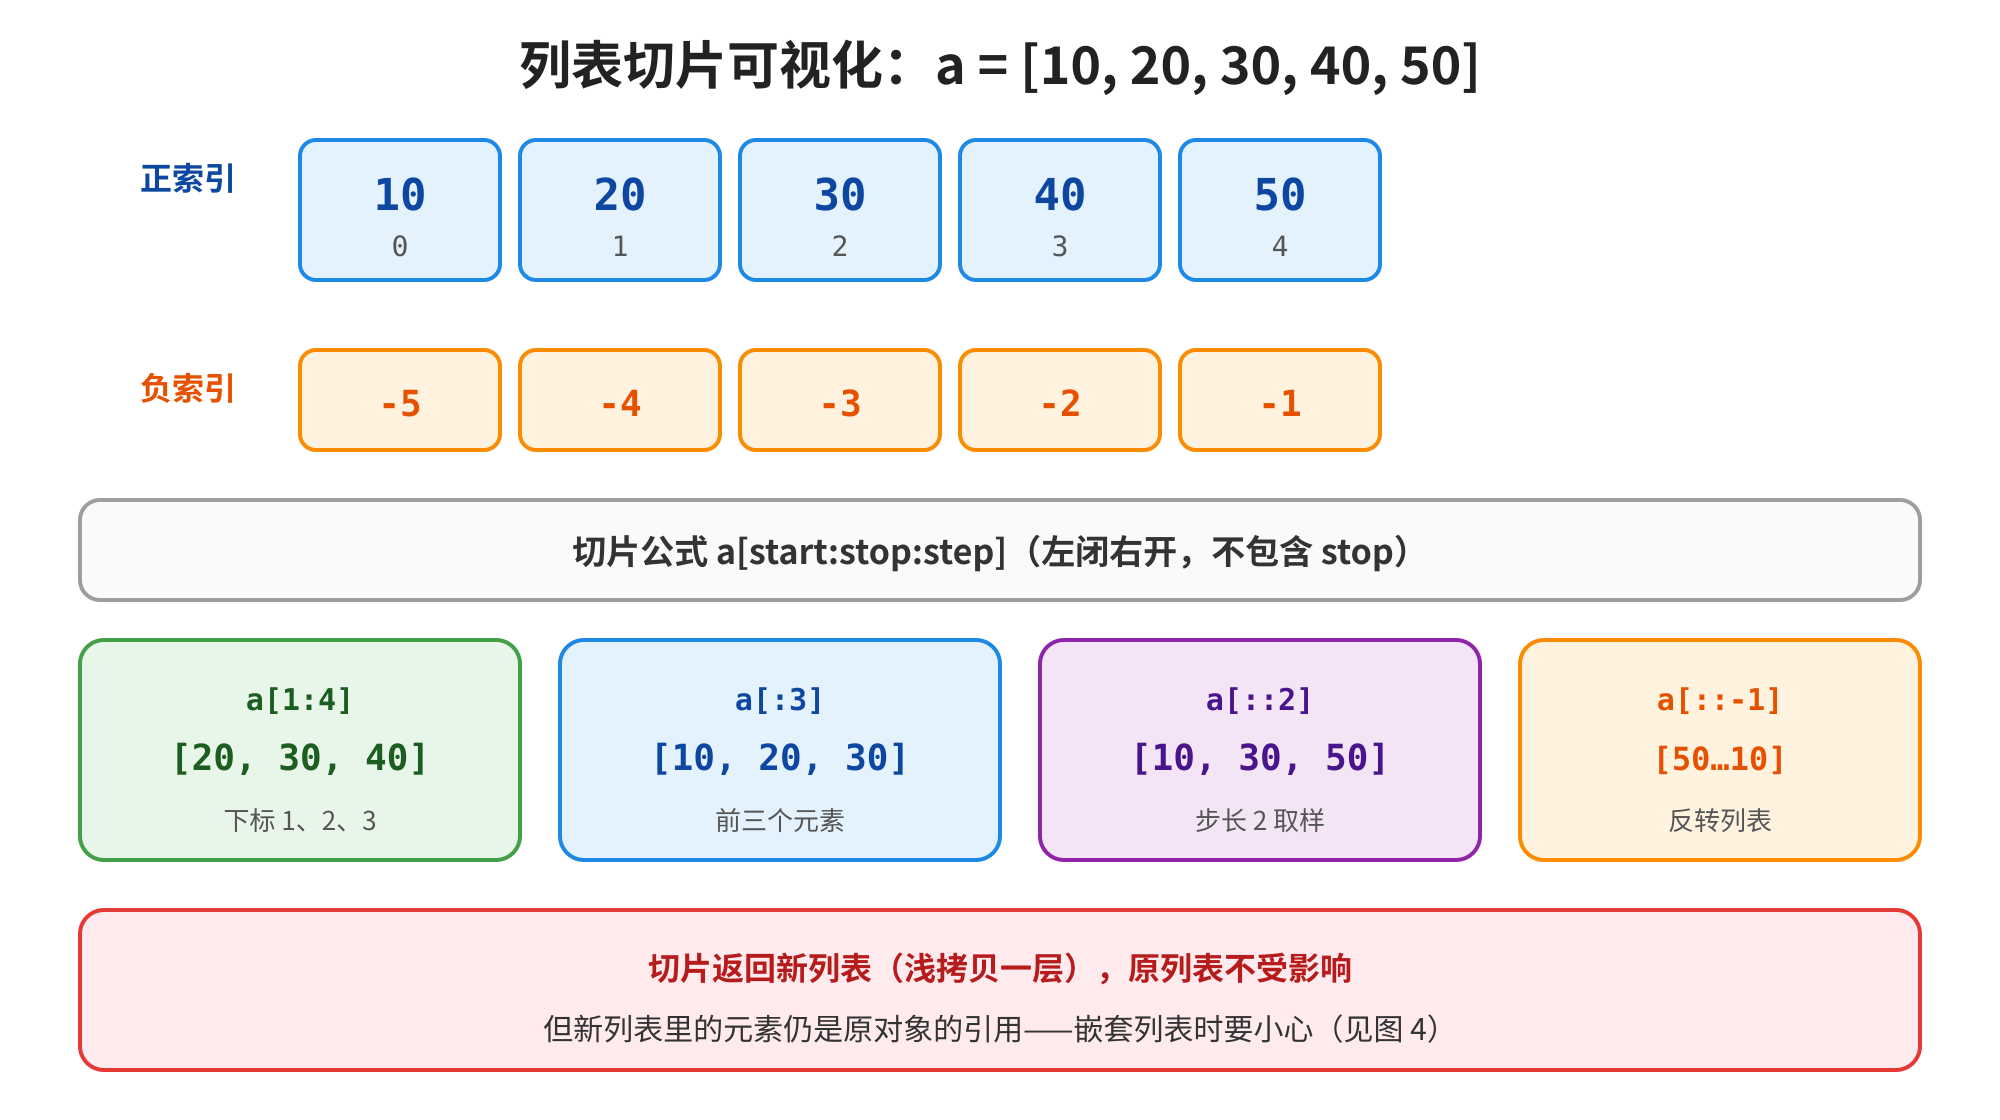
图3 列表切片可视化
与字符串的关键差别:列表切片返回的是新列表,但元素仍是原对象的引用(浅拷贝一层);且列表允许赋值切片做批量替换:
a = [10, 20, 30, 40, 50]
a[1:3] = [200, 300]        # 替换一段
print(a)
a[1:3] = [7, 8, 9, 10]     # 替换段长度可以不同
print(a)
[10, 200, 300, 40, 50]
[10, 7, 8, 9, 10, 40, 50]
越界索引会 IndexError;越界切片则“夹紧”到边界,不会报错:a[100:200] 得到 []。调试时若“切出来是空的”,先查起止下标有没有写反或写飞。
切片还有一个实用习惯:用 a[:] 得到浅拷贝的完整副本,等价于 a.copy()。需要“从某处一直切到尾”或“从头切到某处”时,省略一端比写死长度更稳,列表变长时少改代码:
ids = [101, 2023, 2003, 102]
print(ids[1:-1])           # 去掉首尾特殊 token 的常见写法
print(ids[:])              # 浅拷贝整表
[2023, 2003]
[101, 2023, 2003, 102]
字符串切片得到的是新字符串;列表切片得到的是新列表——两者都“不共享容器本身”,但列表元素若是可变对象,内层仍可能共享。这是本篇后面要反复强调的一点。
二、可变 vs 不可变:list 与 tuple
2.1 一眼对比
| 特性 | list | tuple |
|---|---|---|
| 字面量 | [1, 2, 3] | (1, 2, 3) |
| 可变性 | 可变(可就地改) | 不可变 |
| 典型方法 | append / pop / sort … | 几乎只有 count / index |
| 可做 dict 的键 | 否 | 元素都可哈希时可以 |
| 典型用途 | 动态数据、缓冲 | 固定结构、配置、多返回值 |
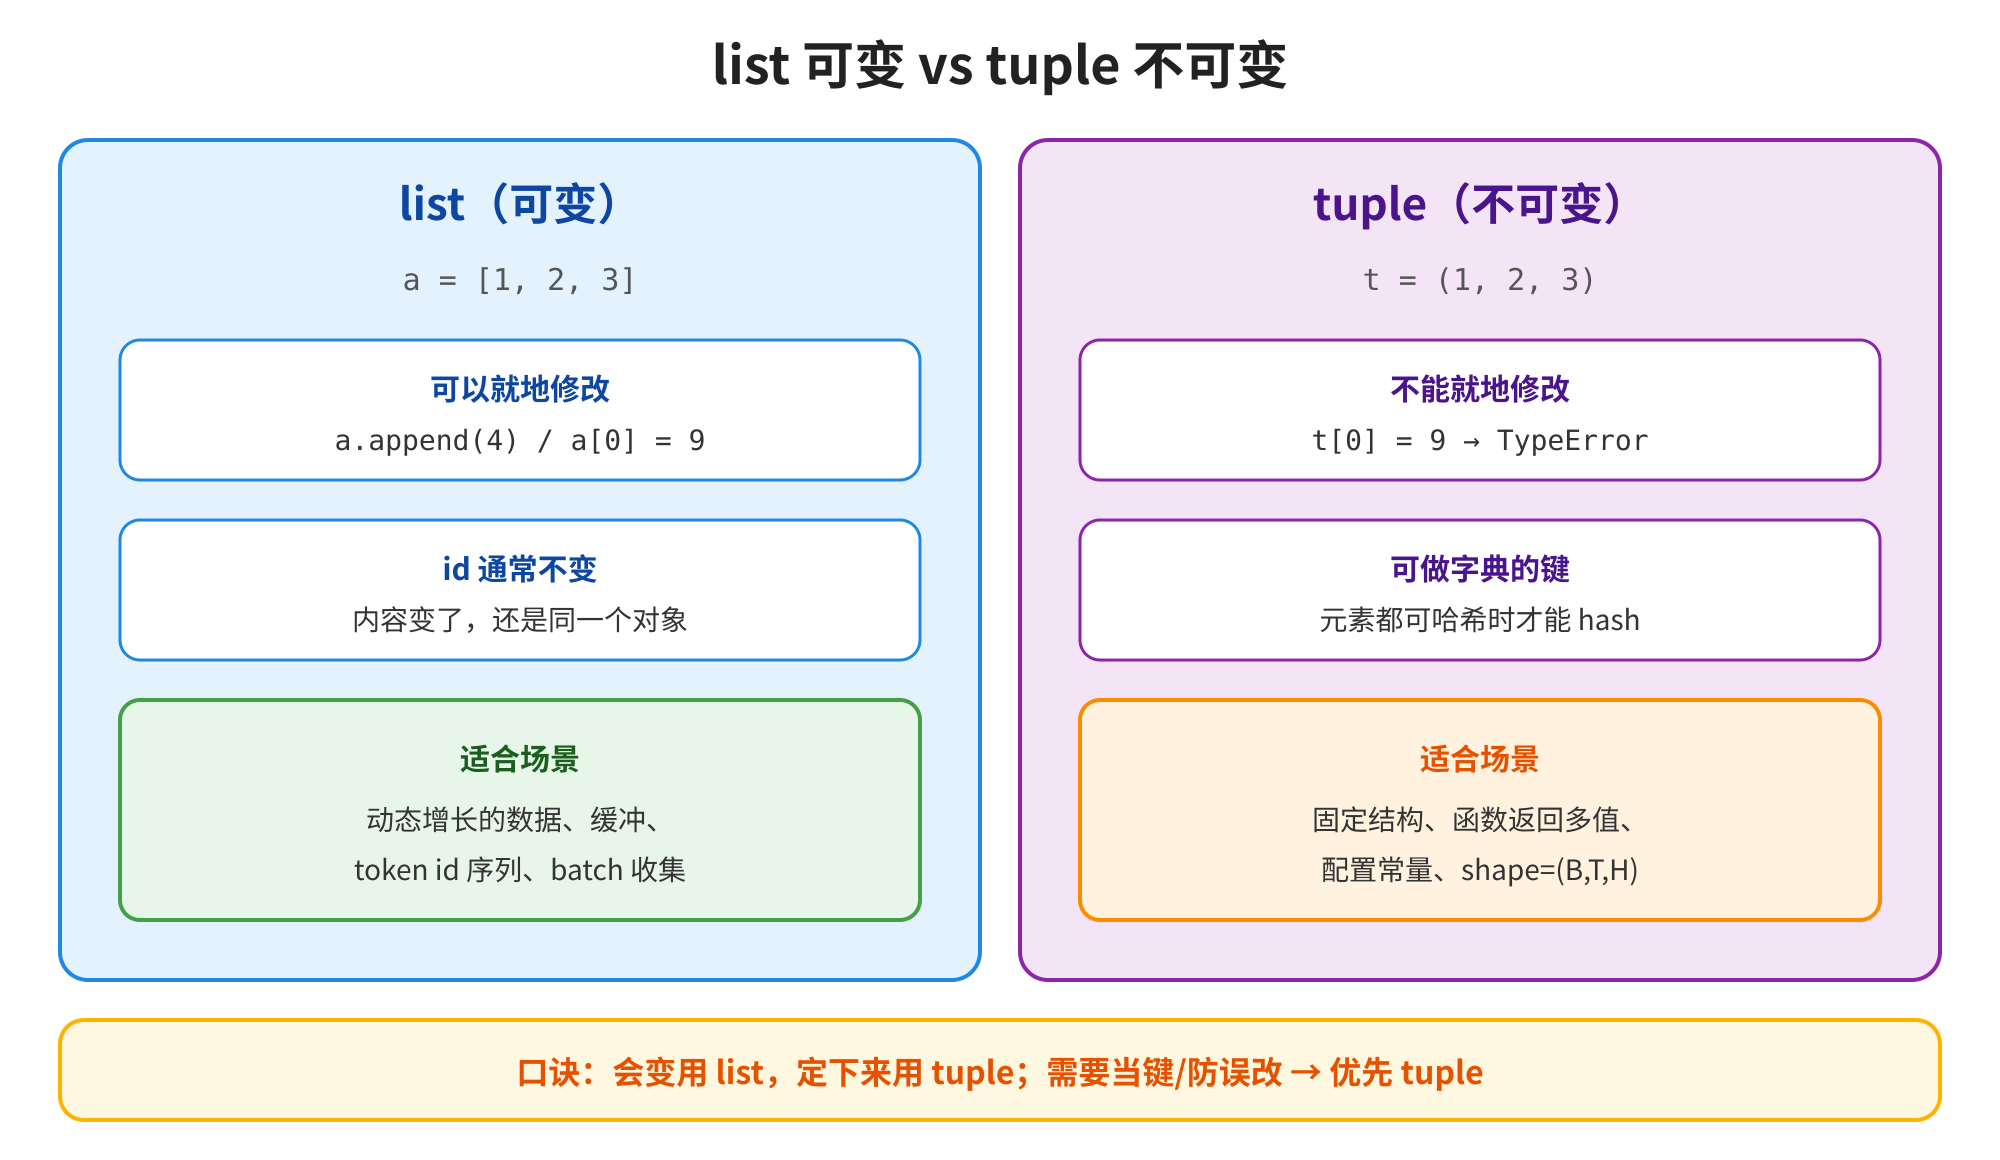
a = \[1, 2, 3\],明确其可变特性,可就地修改(如调用append方法、修改指定索引元素),修改后对象id通常不变,适合用于动态数据、缓冲等场景。右侧紫色区域对应tuple,示例为t = (1, 2, 3),体现不可变特性,尝试就地修改会报错(如t\[0\] = 9会出现TypeError),仅当所有元素可哈希时可做字典的键,适合固定结构、配置等场景,底部还总结了“会变用list,定下来用tuple;需要当键/防篡改→优先tuple”的口诀。图2 list 可变 vs tuple 不可变
亲手验证可变性:
a = [1, 2, 3]
print(id(a))
a.append(4)
a[0] = 9
print(a, id(a))            # 内容变了,id 通常不变

t = (1, 2, 3)
try:
    t[0] = 9
except TypeError as e:
    print(type(e).__name__ + ":", e)
(第一行 id 因机器而异)
[9, 2, 3, 4] (与上一行 id 相同)
TypeError: 'tuple' object does not support item assignment
2.2 元组的创建与单元素陷阱
t1 = (1, 2, 3)
t2 = 1, 2, 3               # 括号常可省略
t3 = ()                    # 空元组
t4 = (42,)                 # 单元素必须有逗号!
t5 = (42)                  # 这只是加了括号的 int
print(type(t4), type(t5))
print(tuple([1, 2, 3]))    # 从列表构造
<class 'tuple'> <class 'int'>
(1, 2, 3)
坑中之坑:(42) 不是单元素元组,逗号才是关键。写配置、写函数返回值时,单元素务必写成 (x,)。
元组不可变,但若元素本身是可变对象,元素内部仍可改:
t = ([1, 2], [3, 4])
t[0].append(99)            # 合法:改的是内层 list,不是换槽位
print(t)
# t[0] = [0, 0]            # 非法:不能替换槽位上的引用
([1, 2, 99], [3, 4])
所以“tuple 不可变”精确含义是:槽位上的引用不能换;不保证“整棵对象树只读”。需要真正冻结时,元素也应是不可变类型(int、str、tuple…)。
2.3 何时用 list、何时用 tuple
口诀:会变用 list,定下来用 tuple;需要当键或防误改 → 优先 tuple。
- 用 list:收集样本、拼 batch、动态追加 token id、当栈、临时缓冲。
- 用 tuple:函数返回多个值
(loss, acc)、配置常量、表示“一条记录的固定字段”、作为 dict 的复合键、表示 shape 如(batch, seq, hidden)。
def train_step():
    # 演示:多返回值其实是打包成 tuple
    return 0.12, 0.98

loss, acc = train_step()   # 解包
print(loss, acc)
print(type(train_step()))
0.12 0.98
<class 'tuple'>
再看一个“用错容器”的小对照:
# 配置:希望读的时候不被误改
CONFIG = ("mini-gpt", 12, 768)     # name, layers, hidden
# CONFIG[1] = 24                   # TypeError,正好防止误改

# 缓冲:希望不断追加
pending = []
pending.append({"req_id": 1, "tokens": 32})
pending.append({"req_id": 2, "tokens": 16})
print(CONFIG, len(pending))
('mini-gpt', 12, 768) 2
团队协作时,把“常量结构”和“可变缓冲”从类型上分开,能减少一类“不小心改了共享状态”的 bug。第 07 篇讲函数默认参数时,你会再次看到:默认值若写成可变 list,坑会更大——那时 tuple 或 None 哨兵是常见解法。
AI Infra 视角
推理配置里
dtype="float16"、max_tokens=128这类“启动后不该乱改”的字段,用 tuple 或后面会学的 dataclass(第 18 篇)更安全。动态的请求队列、正在拼的 batch,则天然是 list。张量的shape在 PyTorch 里常以 tuple 出现——它描述尺寸,不是一份要改来改去的缓冲区。
三、列表常用方法
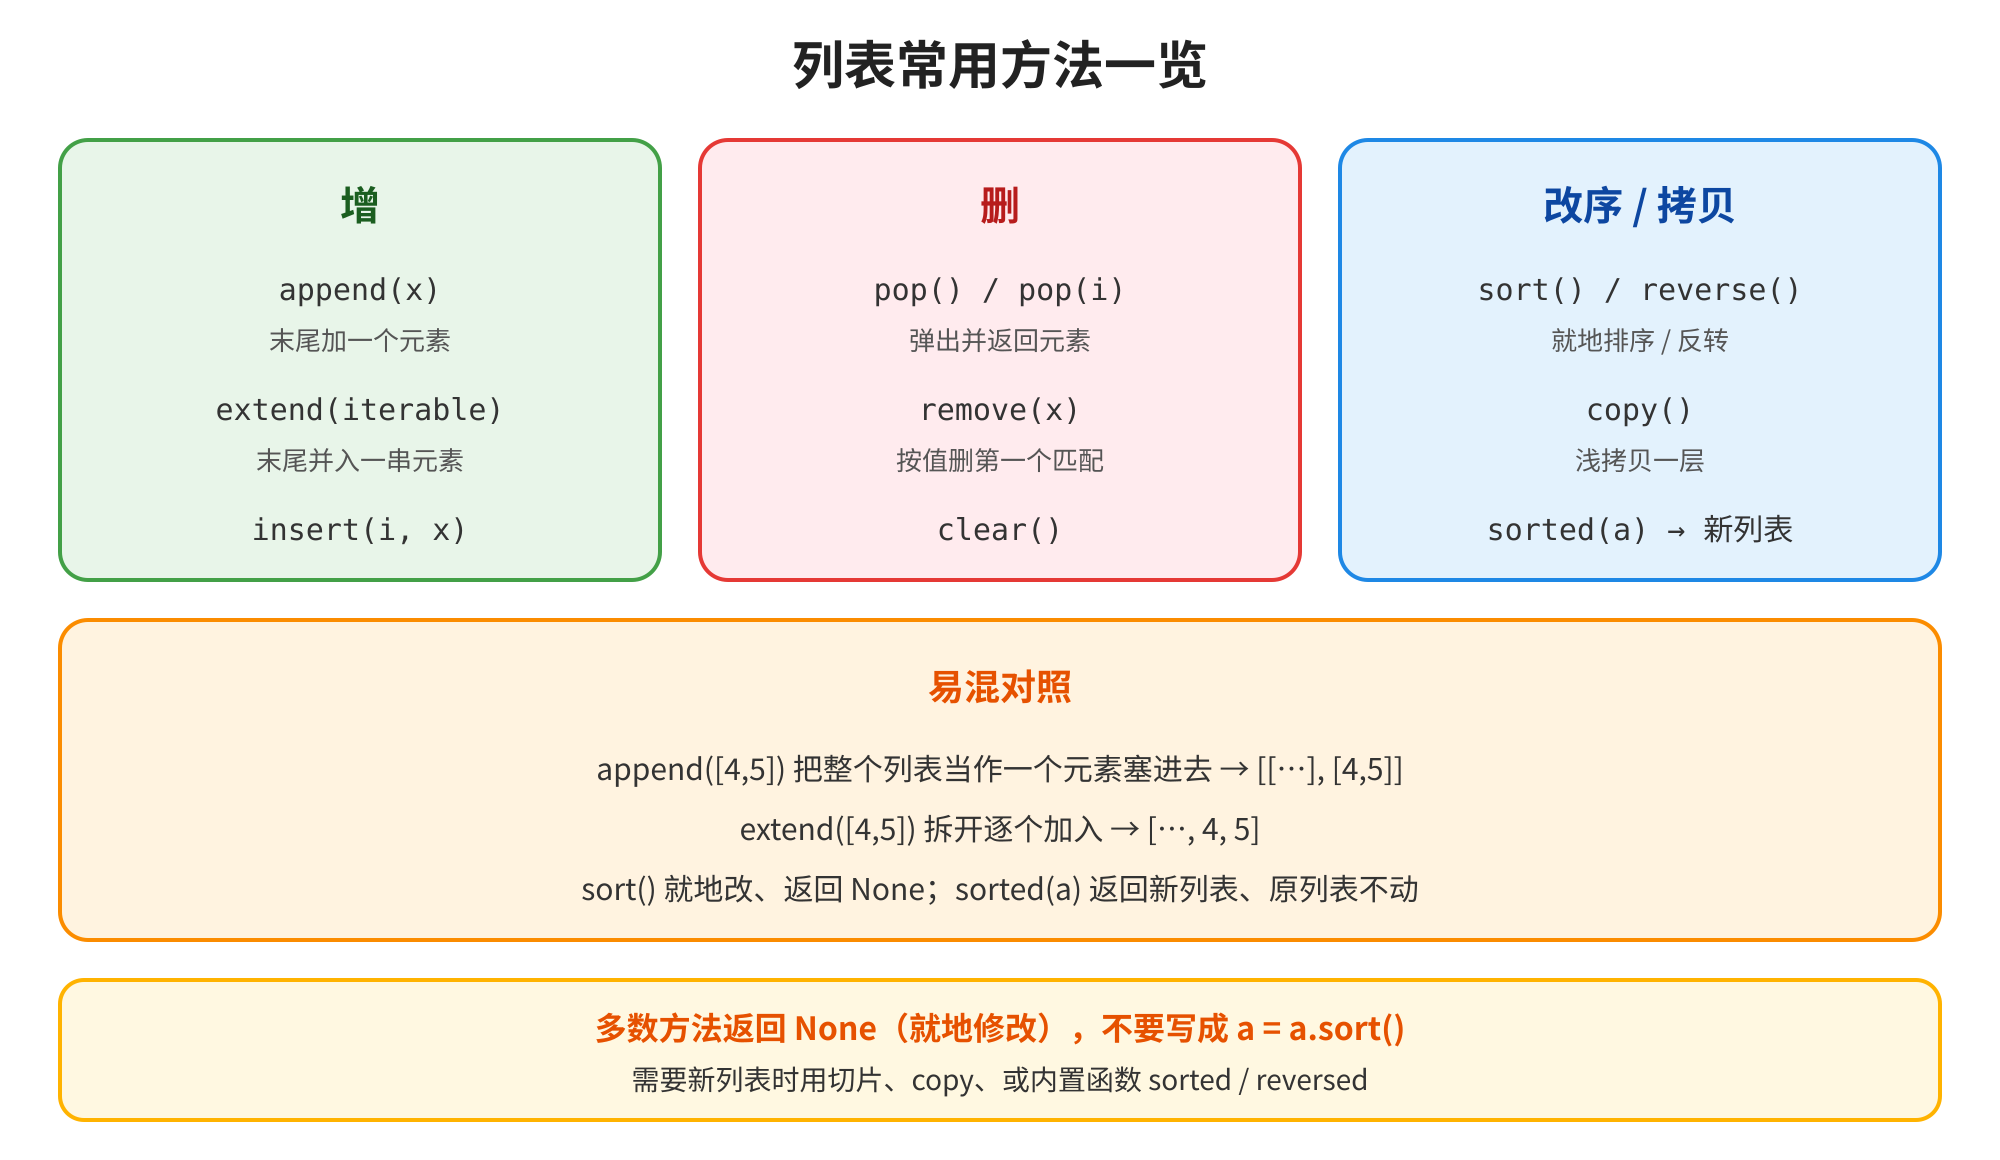
图5 列表常用方法一览
3.1 增:append / extend / insert
a = [1, 2]
a.append(3)                # 末尾加“一个”元素
print(a)

a.extend([4, 5])           # 拆开并入
print(a)

a.insert(0, 0)             # 在下标 0 插入
print(a)
[1, 2, 3]
[1, 2, 3, 4, 5]
[0, 1, 2, 3, 4, 5]
append 与 extend 是经典易混点:
x = [1, 2]
y = [1, 2]
x.append([3, 4])           # 整个列表当一个元素
y.extend([3, 4])           # 逐个加入
print(x)
print(y)
[1, 2, [3, 4]]
[1, 2, 3, 4]
a += [3, 4] 对列表等价于 extend(就地修改,id 不变);a = a + [3, 4] 则创建新列表再重绑(第 02 篇的 rebind)。在函数里若外界还握着原列表的别名,这两种写法效果不同——后面踩坑会再钉一次。
3.2 删:pop / remove / clear
a = [10, 20, 30, 20]
print(a.pop())             # 默认弹出末尾 → 20
print(a.pop(0))            # 弹出下标 0 → 10
print(a)

a.remove(20)               # 按值删除第一个匹配
print(a)

a.clear()
print(a)
20
10
[20, 30]
[30]
[]
pop 有返回值,适合当栈用;remove 找不到值会 ValueError。按条件删一批元素时,不要在 for 遍历正本时边删边改(见第七节),应建新列表或倒序删除。
3.3 改序与拷贝:sort / reverse / copy
a = [3, 1, 4, 1, 5]
a.sort()                   # 就地排序,返回 None
print(a)

a.reverse()                # 就地反转
print(a)

b = [3, 1, 4]
c = sorted(b)              # 内置函数:返回新列表
print(b, c)

d = b.copy()               # 浅拷贝
print(d, d is b)
[1, 1, 3, 4, 5]
[5, 4, 3, 1, 1]
[3, 1, 4] [1, 3, 4]
[3, 1, 4] False
千万别写 a = a.sort():sort 返回 None,会把 a 弄成 None。需要保留原列表时用 sorted(a)。sort 还支持 key= 与 reverse=:
words = ["banana", "fig", "apple"]
words.sort(key=len)
print(words)
['fig', 'apple', 'banana']
按“某个字段”排序在日志与评估里很常见:比如按 loss 升序看最差样本、按长度排序做 bucket batching(把相近长度的序列凑在一起,减少 padding 浪费)。key= 接受一个函数,对每个元素算出“排序用的钥匙”,本身不改变元素:
samples = [
    {"id": "a", "loss": 0.9},
    {"id": "b", "loss": 0.2},
    {"id": "c", "loss": 0.5},
]
samples.sort(key=lambda s: s["loss"])
print([s["id"] for s in samples])
['b', 'c', 'a']
lambda 与字典细节分别在第 08、05 篇展开;这里只要知道 sort(key=...) 能按派生值排序即可。
四、嵌套、浅拷贝与解包
4.1 嵌套列表
列表元素可以是列表,于是得到二维结构——很像“简易矩阵”,但请记住它不是 NumPy 数组:各行长度可以不同,也没有向量化运算。
matrix = [
    [1, 2, 3],
    [4, 5, 6],
]
print(matrix[1][2])        # 6:先取第 1 行,再取第 2 列
matrix[0][0] = 99
print(matrix)
6
[[99, 2, 3], [4, 5, 6]]
做真正的数值矩阵请等第 29 篇 NumPy;这里的嵌套 list 适合存“参差不齐”的结构,例如每个样本长度不同的 token id 列表。
4.2 浅拷贝陷阱(必读)
import copy

a = [[1, 2], [3, 4]]
b = a.copy()               # 或 b = a[:]  或 b = list(a)
print(a is b)              # False:外层是两个 list
print(a[0] is b[0])        # True:内层仍共享!

b[0].append(99)
print(a)                   # a 也被影响
print(b)

c = copy.deepcopy(a)
c[0].append(100)
print(a)                   # deepcopy 后互不影响
print(c)
False
True
[[1, 2, 99], [3, 4]]
[[1, 2, 99], [3, 4]]
[[1, 2, 99], [3, 4]]
[[1, 2, 99, 100], [3, 4]]
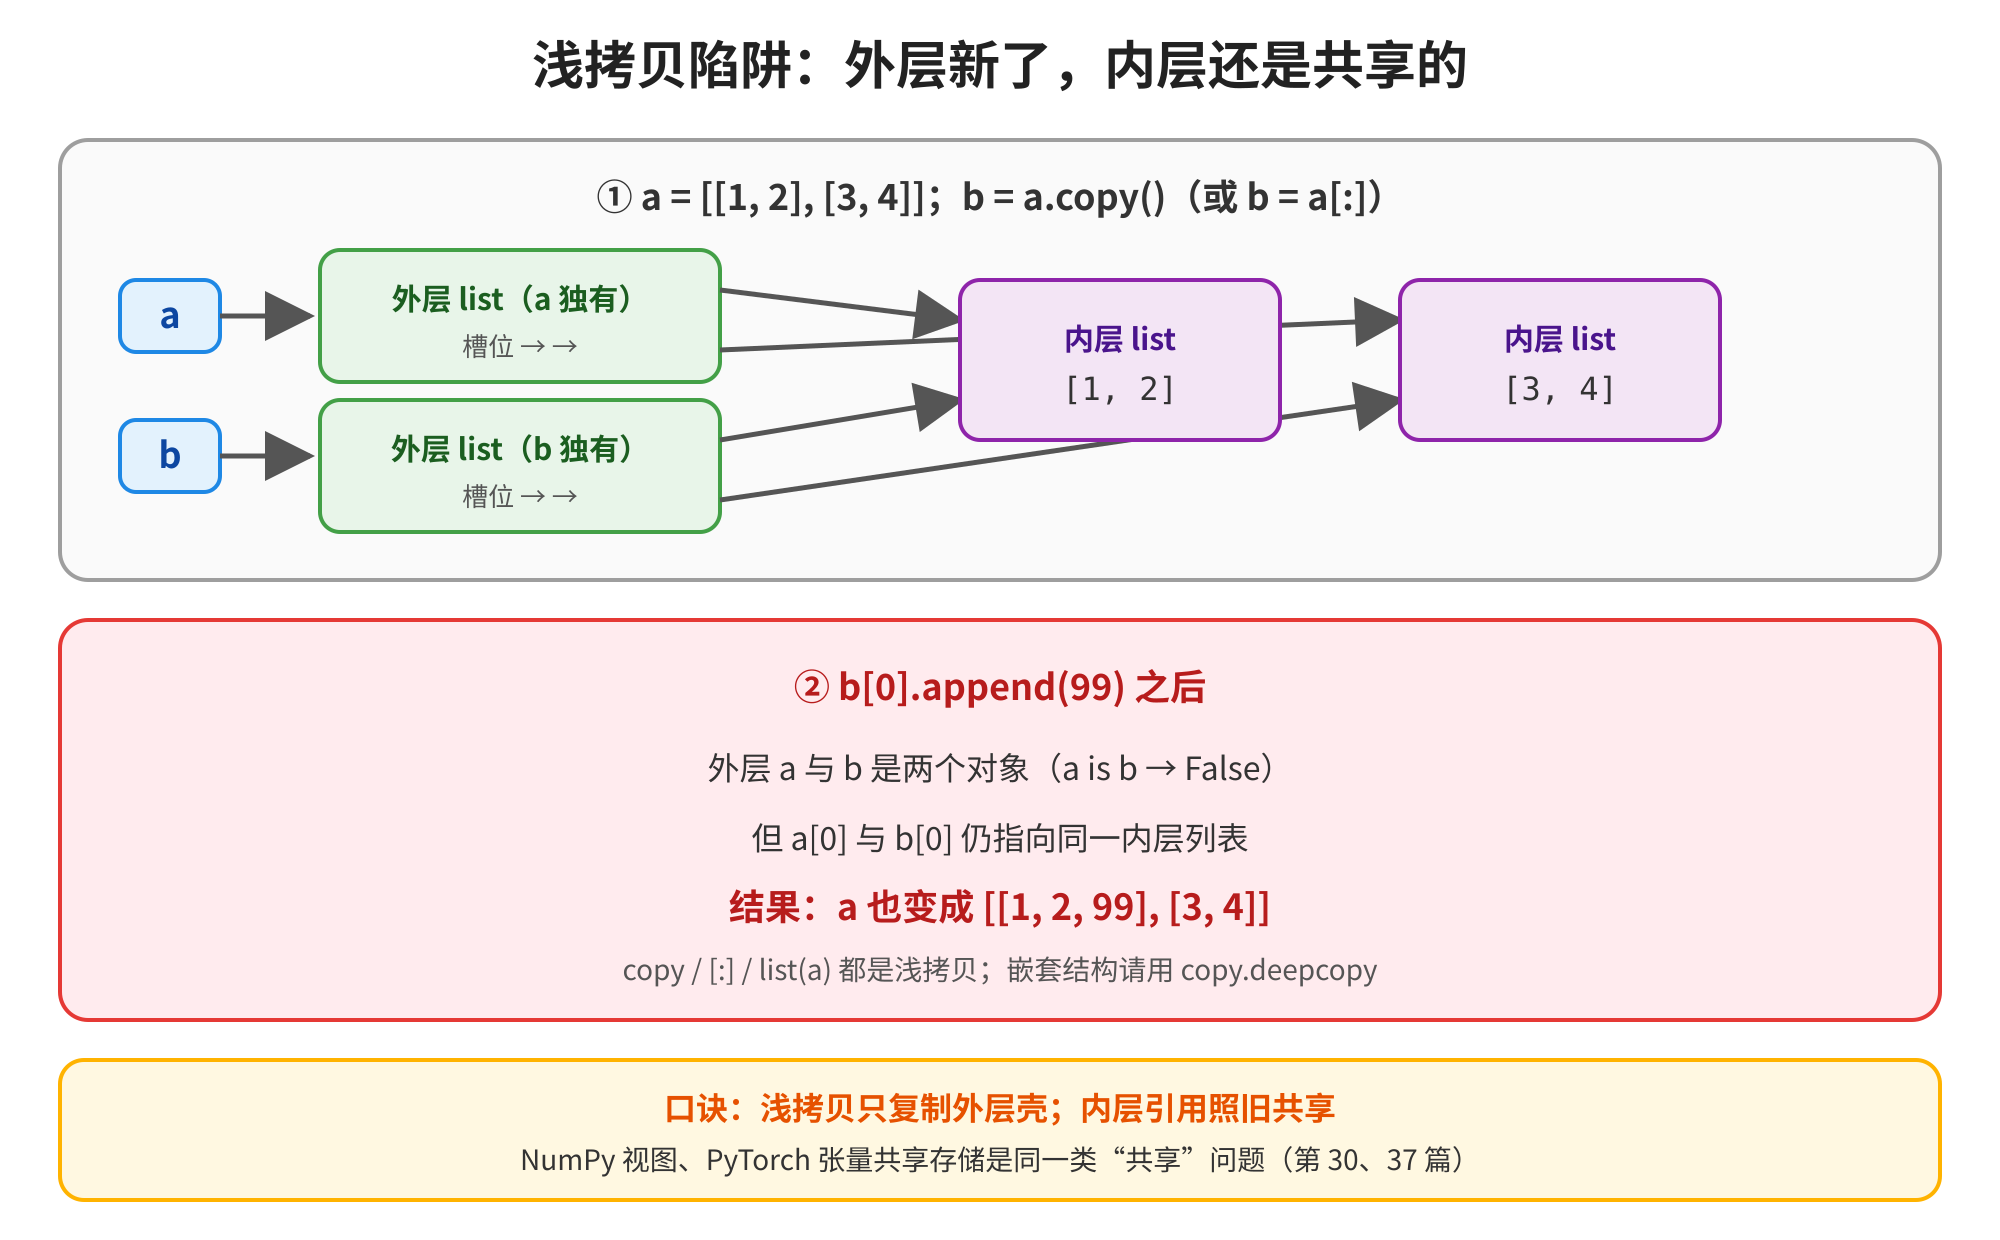
图4 浅拷贝陷阱:外层新了,内层还是共享的
口诀:浅拷贝只复制外层壳;内层引用照旧共享。 嵌套结构要独立副本,用 copy.deepcopy。后面 NumPy 的 view/copy、PyTorch 的共享 storage,是同一类问题的高性能版本。
4.3 解包与 * 拆包
point = (3, 4)
x, y = point               # 元组解包
print(x, y)

first, *middle, last = [1, 2, 3, 4, 5]
print(first, middle, last)

# 交换(不必临时变量)
a, b = 1, 2
a, b = b, a
print(a, b)

# * 在函数调用侧拆开序列(第 08 篇会系统讲 *args)
print(max(*[3, 1, 4]))     # 等价于 max(3, 1, 4)
3 4
1 [2, 3, 4] 5
2 1
4
解包时左右数量必须匹配,否则 ValueError;用 *rest 可以吞掉“剩下的”。这在拆分 (system_msg, *user_turns) 或 (loss, *metrics) 时非常好用。
再补两个在 Agent / 数据处理里常见的写法:
row = ("user", "你好", 0.95)
role, content, score = row
print(role, content)

# 只要前两个字段时
role, content, *_ = row
print(role, content)

# 构造新序列时 * 也可在字面量里展开
prefix = [101]
body = [2023, 2003]
ids = [*prefix, *body, 102]
print(ids)
user 你好
user 你好
[101, 2023, 2003, 102]
[*a, *b] 比 a + b 更易扩展到“中间再插几个元素”的场景,可读性也不错。注意解包失败时错误信息是 ValueError: not enough values to unpack 或 too many values——看到它,先数左右两边的“坑位”是否对齐。
五、序列协议与栈 / 队列
5.1 序列共通操作
list、tuple、str 都遵循序列协议,一批操作可以共用:
a = [1, 2, 3]
print(len(a), 2 in a, 9 not in a)
print(a + [4, 5])          # 拼接 → 新列表
print(a * 2)               # 重复 → 新列表
print(min(a), max(a), sum(a))
print(a.index(2), a.count(1))
3 True True
[1, 2, 3, 4, 5]
[1, 2, 3, 1, 2, 3]
1 3 6
1 1
注意:+ 与 * 都返回新序列;对 list,+= / *= 则是就地修改。in 对 list/tuple 是线性扫描,元素很多时别在热循环里反复 in——那时该换 set(第 05 篇)。
再强调一次 *= 与可变元素的组合拳——它和 [[]]*n 是亲戚:
row = [[0] * 3 for _ in range(2)]   # 正确的二维初始化
print(row)
row[0][0] = 7
print(row)                          # 只有第一行变了
[[0, 0, 0], [0, 0, 0]]
[[7, 0, 0], [0, 0, 0]]
这里内层 [0] * 3 安全,因为 0 是不可变 int;外层用推导式保证每行是新列表。若写成 [[0]*3]*2,两行又会共享,改 row[0][0] 会两行一起变。写“二维缓冲”时,把这条当成检查清单。
5.2 用 list 模拟栈;队列请谨慎
stack = []
stack.append("a")          # 入栈
stack.append("b")
print(stack.pop())         # 出栈 → 'b'
print(stack)
b
['a']
栈(后进先出)用 append + pop() 很自然,均摊 O(1)。队列(先进先出)若用 list.pop(0),每次都要搬移后续元素,大数据量会慢;标准库有 collections.deque(第 19 篇),两端增减都是 O(1)。本篇只需建立印象:小数据用 list 无所谓,热路径上的队列请用 deque。
Agent 里的“待办工具调用”、推理服务里的“等待调度的请求”,概念上都是队列。入门阶段用 list 写清楚逻辑完全没问题;等到压测发现 pop(0) 吃掉过多 CPU,再换成 deque 是工程上的正常节奏——先正确,再在测量指导下变快。
六、AI Infra 视角:batch、token 与配置
6.1 token id 列表与 batch
大模型里,一段文本经 tokenizer 后变成 token id 的整数列表,例如:
# 伪数据:模拟 tokenizer 输出
prompt_ids = [101, 2023, 2003, 1037, 102]
print(type(prompt_ids), len(prompt_ids), prompt_ids[:3])

# 组 batch:多个样本的 id 列表再放进一个外层 list
batch_ids = [
    [101, 7592, 102],
    [101, 2023, 2003, 102],
]
print(len(batch_ids), [len(x) for x in batch_ids])
<class 'list'> 5 [101, 2023, 2003]
2 [3, 4]
真实训练/推理里,参差不齐的序列还要 padding 成矩形再喂给模型——那时结构会变成 NumPy / Tensor 的二维数组。但在 Python 边界上,你最先碰到的仍是“list[int]”和“list[list[int]]”。Agent 拼工具调用轨迹、收集多轮对话,同样是 list 的主场。
一个最小的“对齐长度”演示(仅帮助建立直觉,不是生产实现):
batch = [
    [101, 7592, 102],
    [101, 2023, 2003, 102],
]
max_len = max(len(x) for x in batch)
pad_id = 0
padded = [x + [pad_id] * (max_len - len(x)) for x in batch]
print(padded)
print(tuple(len(x) for x in padded))   # 每条都齐了
[[101, 7592, 102, 0], [101, 2023, 2003, 102]]
(4, 4)
真实框架还会生成 attention mask(哪些位置是 pad)、按长度排序以减少浪费,并最终转为张量。你现在只需记住:Python 侧用 list 灵活收集,进入模型前要变成规整的矩形结构。
6.2 配置与 shape:为什么偏爱 tuple
# 模型结构尺寸:描述性、不应被误改
shape = (2, 128, 768)      # (batch, seq_len, hidden)
batch, seq, hidden = shape
print(f"B={batch} T={seq} H={hidden}")

# 作为 dict 的键(list 做不到)
cache = {}
cache[("layer3", "k")] = [0.1, 0.2]   # 键是 tuple
print(cache)
B=2 T=128 H=768
{('layer3', 'k'): [0.1, 0.2]}
shape 用 tuple,既表达“固定三维”,又能安全解包。第 47 篇讲 KV Cache 时,你会见到按层、按请求组织的缓存结构——键常用不可变的标识,值才是可变的大块存储。本篇先把“键必须可哈希 → 常用 tuple”种下。
再看一个“复合键”的小例子——用 tuple 把多层信息合成一个键,比拼字符串更干净,也比较时不会因为格式问题踩坑:
kv = {}
for layer in (0, 1):
    for name in ("k", "v"):
        kv[(layer, name)] = []     # 值稍后填入真正的 cache 张量
print(sorted(kv.keys()))
print(kv[(1, "k")])
[(0, 'k'), (0, 'v'), (1, 'k'), (1, 'v')]
[]
若误用 list 当键,解释器会直接拒绝:TypeError: unhashable type: 'list'。这不是刁难,而是哈希表要求键的哈希值在生命周期内稳定——可变对象改了内容,哈希表就找不到它了。第 05 篇会把原理讲透。
6.3 从 list 到张量的心理准备
# 概念演示:list → 需要数值库才能高效算
xs = [1.0, 2.0, 3.0]
# 纯 Python 循环可以加,但慢;真正训练会用 torch.tensor(xs)
print([x * 2 for x in xs])
[2.0, 4.0, 6.0]
list 灵活但慢(动态类型、指针数组、缓存不友好)。NumPy / PyTorch 把同质数据收成连续内存块,才能吃满 CPU/GPU。Python list 负责编排与接口;数值热路径交给数组/张量。 这是本系列贯穿始终的分工。
可以这样分工记忆:
| 层次 | 典型结构 | 擅长 |
|---|---|---|
| 编排 / 业务 | list / tuple / 稍后的 dict | 异构对象、控制流、API 边界 |
| 数值批量 | ndarray / Tensor | 同质数值、向量化、GPU |
| 持久化 | JSON 数组 / 二进制格式 | 落盘与传输 |
你在写训练脚本时,常会经历“从 JSON 读出 list → 转成 tensor → 算完再把指标放回 list/dict 打日志”这样的来回。每一步选对容器,代码既清晰也少拷贝浪费。
AI Infra 视角
一句话串起来:动态缓冲与 token 序列用 list;固定结构、配置、shape、dict 键用 tuple;嵌套拷贝想清楚浅/深;真正算数时再把 list 转成 ndarray / Tensor。 第 05 篇的 dict 会告诉你“按名字取配置”如何做到 O(1);第 41 篇的 DataLoader 则大量用 list 收集样本再堆成 batch。
七、踩坑大全
下面这些坑,大多能归到三句话:“列表槽位存引用”“切片/copy 是浅的”“就地方法返回 None”。遇到“怎么另一个变量也变了”或 “a 变成 None 了”,先回到这三条。
排查时可按这个顺序自问:是不是共享了同一对象(is)?是不是只浅拷了外层?是不是调用了返回 None 的就地方法?是不是在遍历时改了正在遍历的列表?四问下来,十之八九能定位。
7.1 拷贝与别名
坑 1:b = a 以为复制了列表。 现象:改 b 时 a 一起变。原因:只是多了一个名字指向同一对象(第 02 篇)。解决:要独立副本用 a.copy() / a[:];嵌套用 copy.deepcopy。
坑 2:浅拷贝嵌套列表。 现象:b = a.copy() 后改 b[0][0],a 也变。原因:只复制了外层。解决:deepcopy,或手动拷每一层。
坑 3:[[]]*n 或 [零活对象]*n。 现象:三行变成同一行。原因:* 重复的是引用。解决:[[] for _ in range(n)]。
7.2 修改与迭代
坑 4:一边 for 一边删元素。 现象:漏删、错位、甚至异常。原因:迭代器按索引走,长度在变。解决:迭代副本 for x in a[:]:,或建新列表,或倒序 pop。
a = [1, 2, 3, 4, 5]
# 错误示范不写;正确:保留偶数
a = [x for x in a if x % 2 == 0]
print(a)
[2, 4]
坑 5:a = a.sort() 得到 None。 现象:排序后列表消失。原因:sort 就地改并返回 None。解决:a.sort() 或 a = sorted(a),不要混用。
7.3 元组与运算符
坑 6:单元素元组漏逗号。 现象:type((42)) 是 int。原因:括号只是分组。解决:(42,)。
坑 7:+= 与 + 对 list 的语义不同。 现象:函数内 lst += [x] 影响了调用方;lst = lst + [x] 却不影响。原因:前者就地,后者重绑。解决:写函数时想清楚要不要修改传入的列表;需要隔离就先 lst = list(lst) 或明确文档约定。
坑 8:对元组里的 list 修改,误以为“破坏了不可变”。 现象:t[0].append(1) 成功。原因:不可变的是槽位引用,不是元素内部。解决:需要真只读时,元素也用不可变类型。
7.4 环境与性能
坑 9(Jupyter):单元格反复 append 却忘记重新初始化。 现象:列表越跑越长。解决:每个实验单元格开头重新 data = [],或重启内核。
坑 10:热循环里用 list.pop(0) 当队列。 现象:数据一大就慢。解决:collections.deque;或架构上改成批量处理。
坑 11:用 in 对超长 list 反复查找。 现象:校验/去重变慢。解决:转为 set(第 05 篇)再查;或先排序再双指针,视场景而定。
坑 12:把 tuple 与“函数参数括号”搞混。 现象:写 return (x) 以为返回了元组。原因:逗号才定义元组。解决:多返回值写 return x, y 或 return (x, y);单值若确要元组写 return (x,)。
坑 13:切片赋值长度心里没数。 现象:a[1:2] = [9, 9, 9] 后列表突然变长,后续下标全乱。原因:切片赋值按“删掉旧段、插入新段”工作,两端长度不必相等。解决:改之前先 print(len(a)),或对等长替换写清楚意图;批量重构时优先构建新列表再整体赋回。
八、小结
合上文章后,试着用自己的话解释:“为什么 b = a 改 b 会动 a”以及“为什么 (42) 不是元组”——讲得清,才算真的会了。
- list 是可变序列:槽位存引用;可索引、切片、就地增删改排。
- tuple 是不可变序列:槽位引用不可换;适合固定结构、多返回值、dict 键、配置与 shape。
- 切片与
copy()都是浅拷贝;嵌套结构用deepcopy;[[]]*n是共享陷阱。 - 方法分工:
append/extend/insert增,pop/remove/clear删,sort/reverse就地改序;sorted返回新列表。 - 解包与
*:多变量赋值、交换、first, *rest拆分;序列协议共享in/len/+/*/min/max。 - AI Infra 映射:token id 与 batch 收集用 list;shape/配置/缓存键用 tuple;数值热路径再转为数组或张量。
把“可变 / 不可变 / 浅拷贝”连成一条故事:名字指向容器 → 容器槽位指向元素 → 拷贝容器只新建外层槽位数组 → 元素对象该不该共享,取决于你有没有 deepcopy 或手工拷内层。故事通了,代码就不会再“玄学地一起变”。
若只能带走一句话:动态缓冲用 list,固定打包用 tuple;复制想清楚深浅,就地方法别接返回值。
九、课后练习
- (基础)创建列表
a = [10, 20, 30, 40, 50],写出a[0]、a[-1]、a[1:4]、a[::2]、a[::-1]的结果。 - (基础)演示
append([7, 8])与extend([7, 8])的区别;再演示sort()与sorted()的区别(打印返回值与原列表)。 - (基础)创建单元素元组,验证
type((42,))与type((42))不同;再写一个函数返回两个值并解包接收。 - (理解)令
a = [[1, 2], [3, 4]],b = a.copy(),执行b[0].append(9)后打印a与b;再用copy.deepcopy做对照,解释差异。 - (理解)解释为什么
bad = [[]] * 3后bad[0].append(1)会让三行都变成[1];给出正确初始化方式。 - (理解)用解包写出:从
[0, 1, 2, 3, 4, 5]取出第一个、最后一个,以及中间剩余部分;再写一行交换两个变量。 - (进阶)实现函数
def move_even_to_front(xs: list[int]) -> list[int]:返回新列表,偶数在前、奇数在后,保持各自相对顺序;不要修改传入的xs。 - (进阶 · AI Infra)用 list 模拟“拼 batch”:已有
batch = [],循环中每次得到一条ids: list[int](自己造 3~4 条长度不同的),append进去;最后打印 batch 的样本数、每条长度、以及用 tuple 表示的“最大长度 shape 提示”(len(batch), max(len(x) for x in batch))。思考:若下一步要喂给模型,还缺什么(padding)?
下一篇预告
列表与元组解决了“有序序列”的问题;下一篇 《第05篇|字典与集合:哈希表原理》 会进入按键存取的世界:为什么 dict 平均 O(1)、什么对象能当键、set 如何去重,以及哈希冲突与“list 不能当键、tuple 可以”的底层原因。本篇的可变性与可哈希讨论会直接派上用场。
专栏一「Python 从零入门」的后续路线:字典与集合(05)→ 条件循环与推导式(06)→ 函数(07、08)→ 模块与 import(09)→ 文件(10)→ 异常(11)→ 面向对象与数据模型(12~14)。带着本篇的 list/tuple,读配置、拼 batch、接 tokenizer 输出时会顺手很多。
若你已经在用 Jupyter 做小实验,建议把本篇的浅拷贝与 [[]]*n 两个例子各跑一遍,截一张 id 对比图留给自己——比单纯高亮笔记记得牢。下一篇开始,容器世界的另一半(按键访问)就要登场了。