
第08篇|函数进阶:*args/**kwargs、闭包、lambda
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 8 篇。承接第 07 篇的
def、参数与 LEGB,把接口写活:用*args/**kwargs收可变实参,用闭包“带着配置返回小函数”,用lambda写短表达式,并复习函数一等公民与分发表——为第 16 篇装饰器与第 28 篇 Agent 工具注册铺路。读完你将能够:正确声明与调用含
*args/**kwargs的函数;掌握形参书写顺序(含关键字仅参数);用*args, **kwargs做透明转发;解释闭包、自由变量与closure,避开循环里晚绑定坑;判断何时用lambda、何时写def;用函数字典做简单分发,并知道functools.partial与装饰器的预习位置。预计用时:阅读 35~45 分钟,动手 30~40 分钟。
第 07 篇把函数写成了“有名字的积木”:参数进、返回值出、名字按 LEGB 找。真实脚本里很快会出现新需求——调用方参数个数不固定(日志、工具注册)、想先冻住一部分配置再返回可调用对象(工厂)、排序时只想塞一个极短的 key(lambda)。本篇就是这些“进阶语法”的心智模型课,不是花活清单。
你会在推理服务、训练脚本和 Agent 里反复见到它们:@tool 装饰器底层是闭包;register(name, fn) 把函数放进字典;包装一层计时/鉴权时用 *args, **kwargs 原样转发。第 09 篇讲模块与 import;第 16 篇装饰器几乎整篇建立在“函数是对象 + 闭包”上。先把本篇三样武器摸熟:可变参数、闭包、短 lambda。
建议边读边在 uv run python 里敲。易混点通常是:把 * 只当成“解包”忘了“打包”;闭包以为捕获的是“当时的值”其实是“变量格子”;lambda 里写了语句却期望像 def 一样。每节都有可跑实验与预期输出。
阅读顺序:*args/**kwargs 打包解包 → 形参顺序与仅关键字参数 → 转发包装器 → 闭包与晚绑定 → lambda 边界 → 分发表与 AI Infra 小样例。踩坑大全请过一遍,尤其是“循环里建 lambda/闭包”和“形参顺序写乱”。
和“固定三个形参”相比,本篇带来的最大变化是:接口可以长宽可调,函数可以带着环境被返回。弄清这两点,后面读装饰器、偏函数、Agent 工具表时就不会觉得魔法凭空出现。
和第 07 篇的关系可以画成一张进度条:那边解决“会不会写函数”,这边解决“函数能不能适配多变调用、能不能把配置藏进闭包”。若 LEGB 或默认参数哨兵还不熟,请先回看第 07 篇对应小节,再继续——本篇会频繁用到 Enclosing 层与“函数是对象”这两个前提。
动手时建议新建一个小目录(例如 uv init --no-package 后的练习项目),把每个代码块存成独立片段跑一遍;改掉 *args 的名字、故意写乱形参顺序、在循环里去掉 i=i,观察报错与输出变化,比只朗读语法结论记得牢。
也可以先用一句话定心:*args/**kwargs 管“吃进多少实参”;闭包管“带着 enclosing 变量活下去”;lambda 只是表达式版的短函数。 本篇把这句话拆开讲透。
一、*args 与 **kwargs:打包与解包
1.1 为什么需要可变参数
第 07 篇的形参个数在 def 时就定死了。若要写一个“打印任意多个值再返回它们个数”的小工具,难道为 1 个、2 个、10 个实参各写一个函数?Python 的答案是:用 *args 把多出来的位置实参打成元组,用 **kwargs 把多出来的关键字实参打成字典。
def report(*args, **kwargs):
    print("args =", args, type(args))
    print("kwargs =", kwargs, type(kwargs))
    return len(args), len(kwargs)

n_pos, n_kw = report(1, 2, 3, model="mini", temp=0.7)
print("counts:", n_pos, n_kw)
args = (1, 2, 3) <class 'tuple'>
kwargs = {'model': 'mini', 'temp': 0.7} <class 'dict'>
counts: 3 2
名字不必叫 args / kwargs,叫 *values、**options 也可以;社区约定用这两个名字,读别人代码时更省脑。记住:* / ** 是语法,名字只是标签。
再强调类型:args 一定是 tuple(不可变),kwargs 一定是 dict(插入顺序在现代 Python 中保留)。若你在函数里改了 kwargs 的内容,那是在改这个新字典对象,一般不会回头改调用方传入的那份映射——除非你又把同一个 dict 以别的方式传出去。打包发生在进入函数的那一刻,调用方写的字面量参数此时已经被收进这两个容器。
零个多余参数也合法:report() 得到空元组与空字典。这让“可选地接收一批额外字段”的 API 很好写——有就处理,没有就走默认路径。
1.2 调用处的解包:把容器拆开传进去
* / ** 也能出现在调用一侧:把已有序列/映射拆成位置实参或关键字实参。
def connect(host, port, debug=False):
    return f"{host}:{port} debug={debug}"

pair = ("0.0.0.0", 8000)
opts = {"debug": True}
print(connect(*pair, **opts))

# 等价于 connect("0.0.0.0", 8000, debug=True)
0.0.0.0:8000 debug=True
打包与解包是一对镜子:定义侧 *args 把多余位置收成 tuple;调用侧 *seq 把序列拆成位置。** 对 dict 同理。
解包时类型要对:* 右侧需要可迭代对象(list/tuple/等);** 右侧需要映射,且键必须是字符串(才能当作关键字参数名)。若键不是合法标识符,调用阶段会失败——这也是为什么配置 dict 的键通常用 host、port 这种标识符风格,而不是随便起中文键名再 ** 进函数。
实践中常见组合是:从 JSON/YAML 读出配置 dict(第 10 篇再谈文件),校验后再 connect(**cfg)。这样“配置文件的字段名”和“函数形参名”对齐,胶水代码极短。
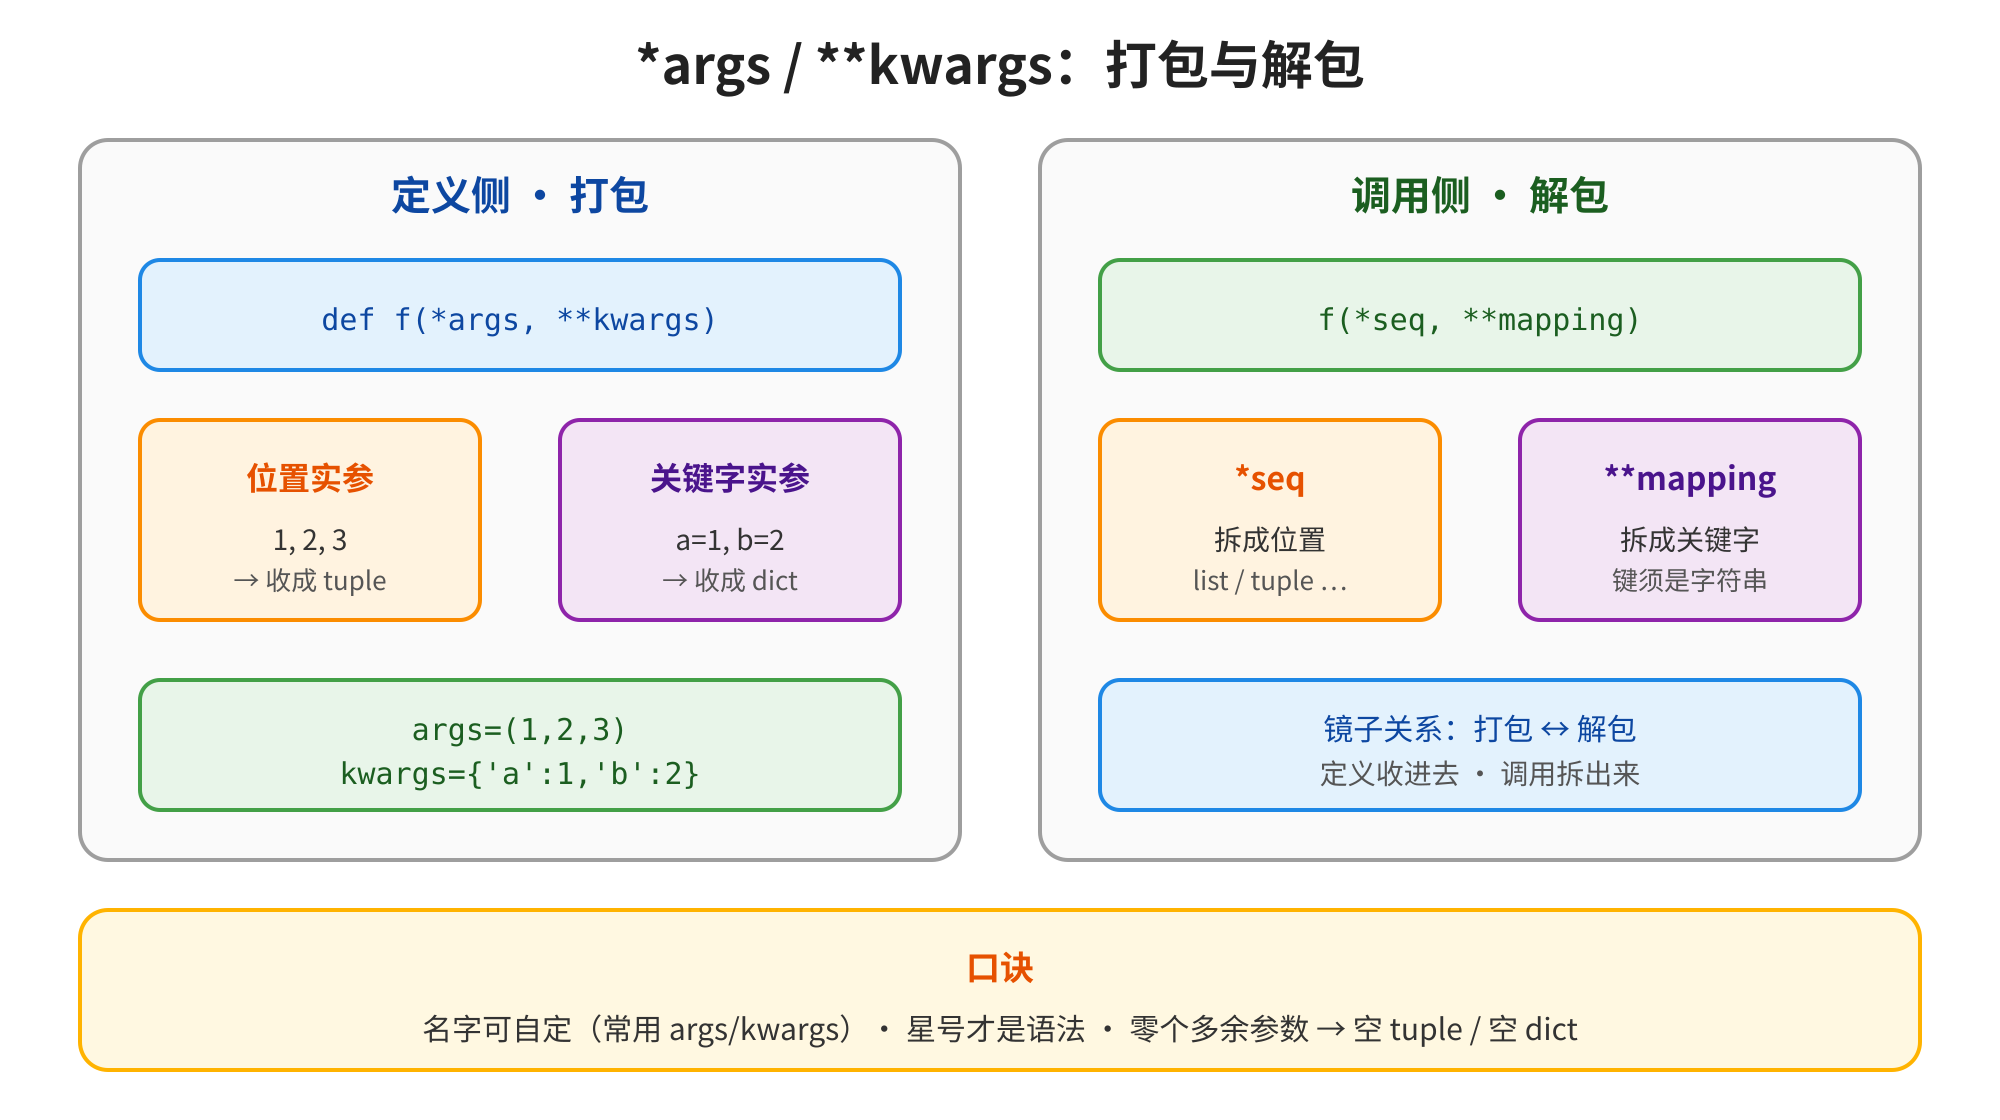
*args/**kwargs打包与解包的示例。定义侧,def f(*args, **kwargs)接收位置实参1, 2, 3(收成tuple)和关键字实参a=1, b=2(收成dict),分别对应args=(1, 2, 3)和kwargs={'a': 1, 'b': 2}。调用侧,f(*seq, **mapping)将*seq拆成位置list/tuple等,**mapping拆成关键字,键须是字符串。图片与上下文紧密相关,直观呈现了*args/**kwargs在函数定义与调用中的打包与解包操作。图1 *args/**kwargs:打包与解包
1.3 和普通形参混用
常见写法是“固定几个必选 + 其余进 *args / **kwargs”:
def log(level, *messages, **fields):
    body = " | ".join(str(m) for m in messages)
    extra = " ".join(f"{k}={v}" for k, v in fields.items())
    return f"[{level}] {body}" + (f" ({extra})" if extra else "")

print(log("INFO", "ready", "ok", service="infer", qps=12))
[INFO] ready | ok (service=infer qps=12)
AI Infra 视角
工具注册、中间件、配置合并经常要“先收住未知字段,再按需转发”。例如 Agent 的
call_tool(name, *args, **kwargs),或给模型客户端包一层chat(*messages, **options)。先学会打包/解包,比死记某个框架的装饰器语法更有用。
二、形参顺序:位置、*args、仅关键字、**kwargs
2.1 书写顺序口诀
在同一个 def 里,形参必须按固定顺序出现(从左到右):
- 普通位置形参(可带默认值,且无默认的必须在有默认的前面);
*args(或单独的*,见下);- 关键字仅参数(keyword-only):只能用
name=value传入; **kwargs。
def serve(host, port=8000, *extra, reload, **opts):
    return {
        "host": host,
        "port": port,
        "extra": extra,
        "reload": reload,
        "opts": opts,
    }

print(serve("127.0.0.1", 9000, "a", "b", reload=True, workers=2))
{'host': '127.0.0.1', 'port': 9000, 'extra': ('a', 'b'), 'reload': True, 'opts': {'workers': 2}}
这里 reload 在 *extra 之后,因此不能写成位置实参,必须 reload=True。这能防止调用方把布尔标志塞错位置。
2.2 只要仅关键字、不要 *args:用光秃秃的 *
若你不需要收集多余位置参数,但仍想强制后面的形参用关键字传入,可以写一个单独的 *:
def sample(prompt, *, temperature=1.0, max_tokens=64):
    return f"{prompt!r} T={temperature} max={max_tokens}"

print(sample("hi", temperature=0.2))
# sample("hi", 0.2)  # TypeError:0.2 不能按位置传给 temperature
'hi' T=0.2 max=64
推理 API 里把 temperature、top_p 设成仅关键字,能显著减少“第三个位置到底是温度还是 top_p”的低级事故。
仅关键字参数还有一个文档价值:阅读 def 签名的人立刻知道“这些开关必须按名字传”,调用示例也更自说明。团队协作时,宁可多打几个 name=,也比 silently 依赖位置约定要安全——尤其是布尔参数相邻时,True, False, True 这种位置串几乎不可维护。
2.3 顺序写乱会怎样
定义时顺序错了,解释器直接 SyntaxError;调用时把仅关键字按位置传,则是 TypeError。不必死记报错文案,记住口诀即可:位置 → *args/* → 仅关键字 → **kwargs。
# 反例(不要运行指望成功):
# def bad(**kwargs, *args): ...
# def bad(a, **kwargs, b): ...
三、转发:*args, **kwargs 做包装器
3.1 透明转发的形状
很多“胶水层”并不关心内部函数有哪些参数,只想在调用前后加点逻辑(计时、日志、鉴权),然后原样转发:
import time

def timed(fn):
    def wrapper(*args, **kwargs):
        t0 = time.perf_counter()
        result = fn(*args, **kwargs)
        ms = (time.perf_counter() - t0) * 1000
        print(f"{fn.__name__} took {ms:.2f} ms")
        return result
    return wrapper

def add(x, y):
    return x + y

add_t = timed(add)
print("sum =", add_t(3, 4))
add took 0.00 ms
sum = 7
(耗时数字会随机器抖动,数量级接近 0~几毫秒即可。)
注意两处对称:wrapper 用 *args, **kwargs 接收任意调用;内部再用 fn(*args, **kwargs) 拆开传给真正的函数。这就是第 16 篇装饰器的核心骨架——本篇先当“返回函数的工厂”来理解。
包装器还有两个好习惯:① 需要时把异常继续抛出(让调用方看见真实失败),只在 finally 里记耗时;② 不要在包装层悄悄吞掉返回值。第 11 篇会系统讲异常;此处只要记住——转发层的首要职责是透明,附加逻辑是第二位。
若包装后还想保留原函数的名字与文档字符串,将来会用 functools.wraps(第 16、19 篇)。现在先接受一个现象:上面例子里 add_t.name 往往是 wrapper 而不是 add,这不影响计算,只影响日志与调试观感。
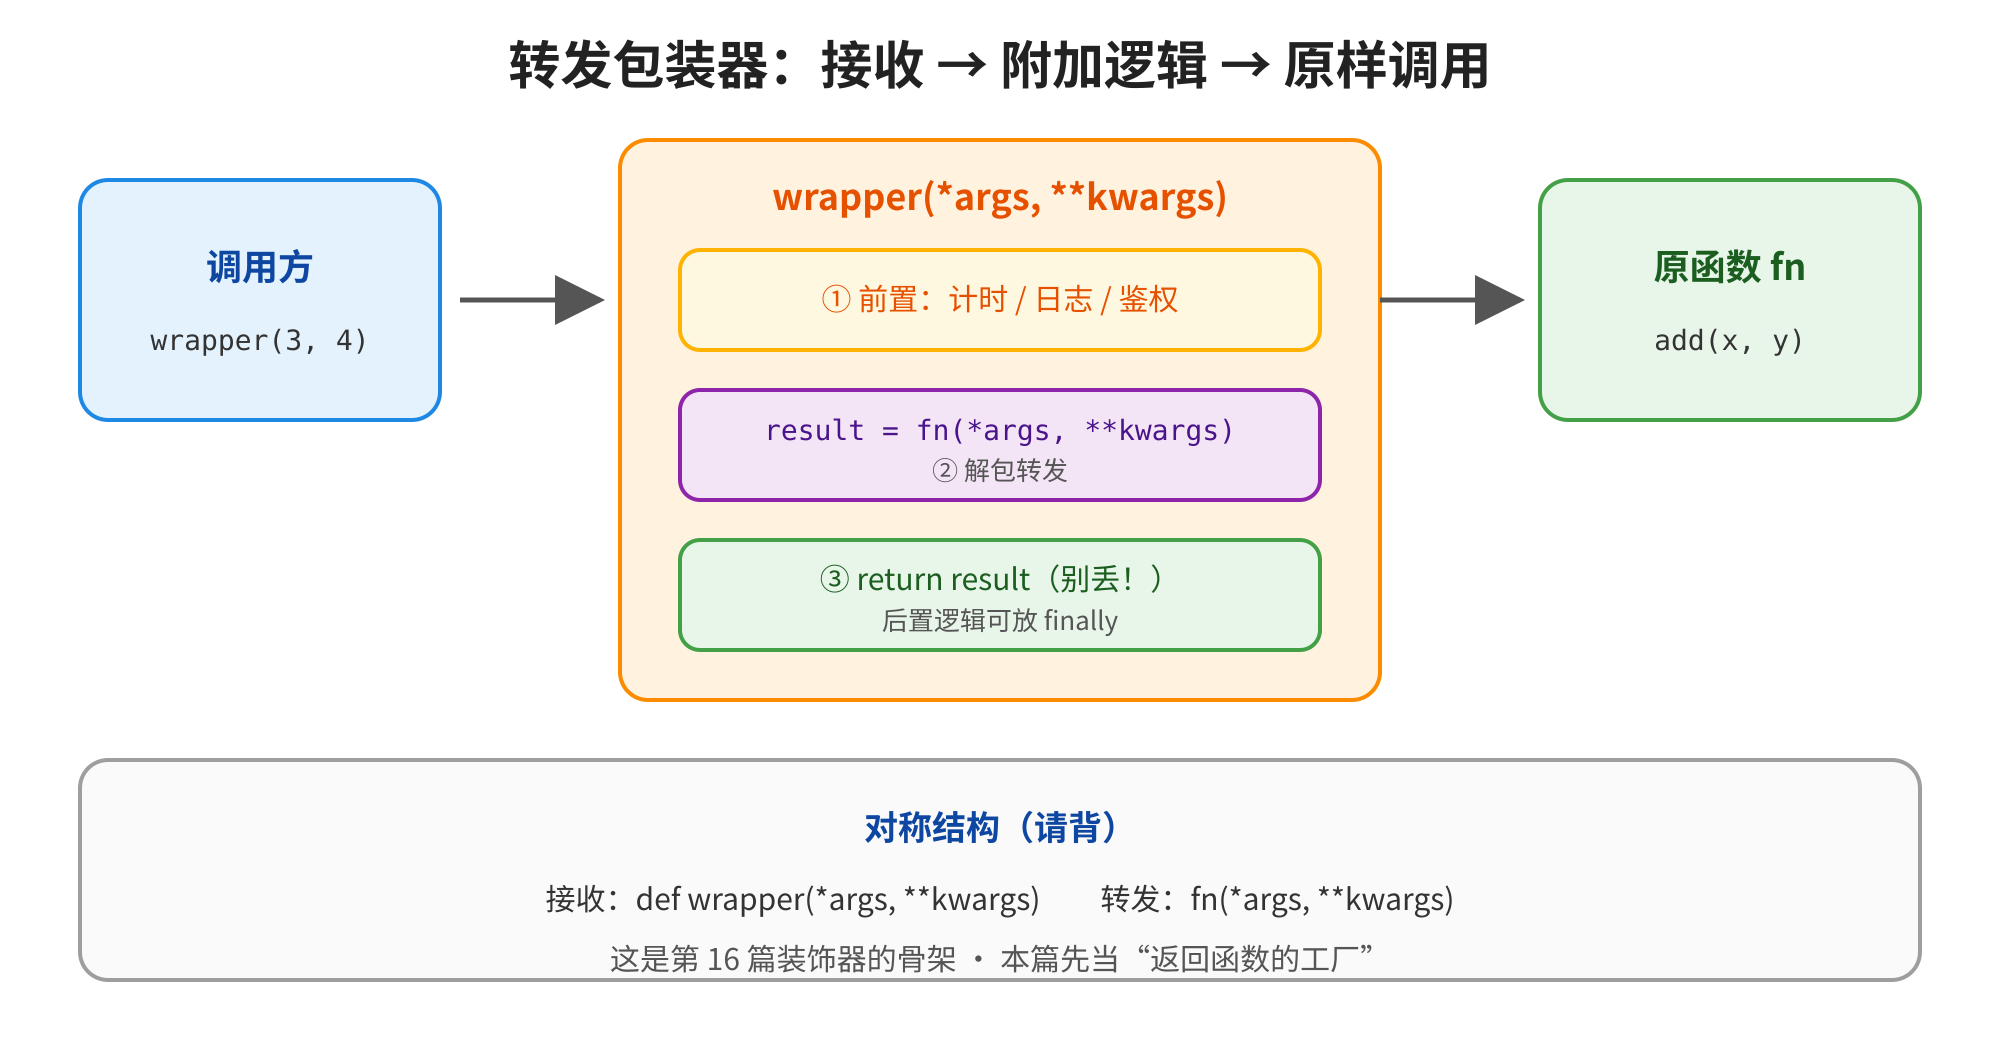
*args,**kwargs做包装器”的图2“转发包装器:接收再拆开传给原函数”,展示了转发包装器的完整工作流程:调用方传入参数后,wrapper函数先执行前置的计时、日志、鉴权逻辑,接着解包参数传给原函数fn执行并获取结果,最后返回结果。该包装器使用对称结构,通过*args和**kwargs实现接收与参数转发,是装饰器的骨架,符合文档中介绍的透明转发核心内容,明确了转发包装器接收、附加逻辑、原样调用的工作逻辑。图2 转发包装器:接收再拆开传给原函数
3.2 改一点、转其余:常见 API 胶水
有时你要固定或改写个别参数,其余原样交给底层:
def chat_raw(model, *messages, temperature=1.0, **opts):
    return {"model": model, "messages": messages, "temperature": temperature, "opts": opts}

def chat_safe(model, *messages, **opts):
    # 强制温度上限,其余选项继续转发
    temp = min(opts.pop("temperature", 1.0), 0.9)
    return chat_raw(model, *messages, temperature=temp, **opts)

print(chat_safe("mini", {"role": "user", "content": "hi"}, temperature=1.5, stream=True))
{'model': 'mini', 'messages': ({'role': 'user', 'content': 'hi'},), 'temperature': 0.9, 'opts': {'stream': True}}
AI Infra 视角
vLLM / SGLang / OpenAI 兼容客户端常有“官方函数 + 你们团队的薄封装”。薄封装用
*args, **kwargs转发,升级官方 SDK 时签名变化不易把你们的包装层撕烂。代价是类型提示与文档要另想办法(第 18 篇类型注解会回来谈)。
四、闭包:带着 enclosing 变量的函数
4.1 嵌套函数与自由变量
第 07 篇 LEGB 里的 E(Enclosing) 就是闭包的舞台:内层函数引用了外层函数的局部变量,并且外层已经返回,内层仍能读到那些变量——这些被“带出去”的变量叫自由变量(free variable),形成的对象叫闭包(closure)。
def make_multiplier(n):
    def mul(x):
        return x * n          # n 来自 enclosing
    return mul

double = make_multiplier(2)
triple = make_multiplier(3)
print(double(5), triple(5))
print(double.__closure__[0].cell_contents)   # 窥一眼捕获的值
10 15
2
make_multiplier 是工厂:每次调用创建独立的 n 格子和独立的 mul。double 与 triple 互不干扰。这比满世界 global SCALE 清晰得多。
closure 是一个元组,元素是 cell 对象;cell_contents 取出当前绑定的值。生产代码很少直接摸它,但调试“到底捕获了啥”时很有用。若内层函数没有自由变量,closure 为 None。结合第 07 篇:自由变量的查找落在 LEGB 的 E 层——闭包不过是把 E 层在外层返回之后仍然留住。
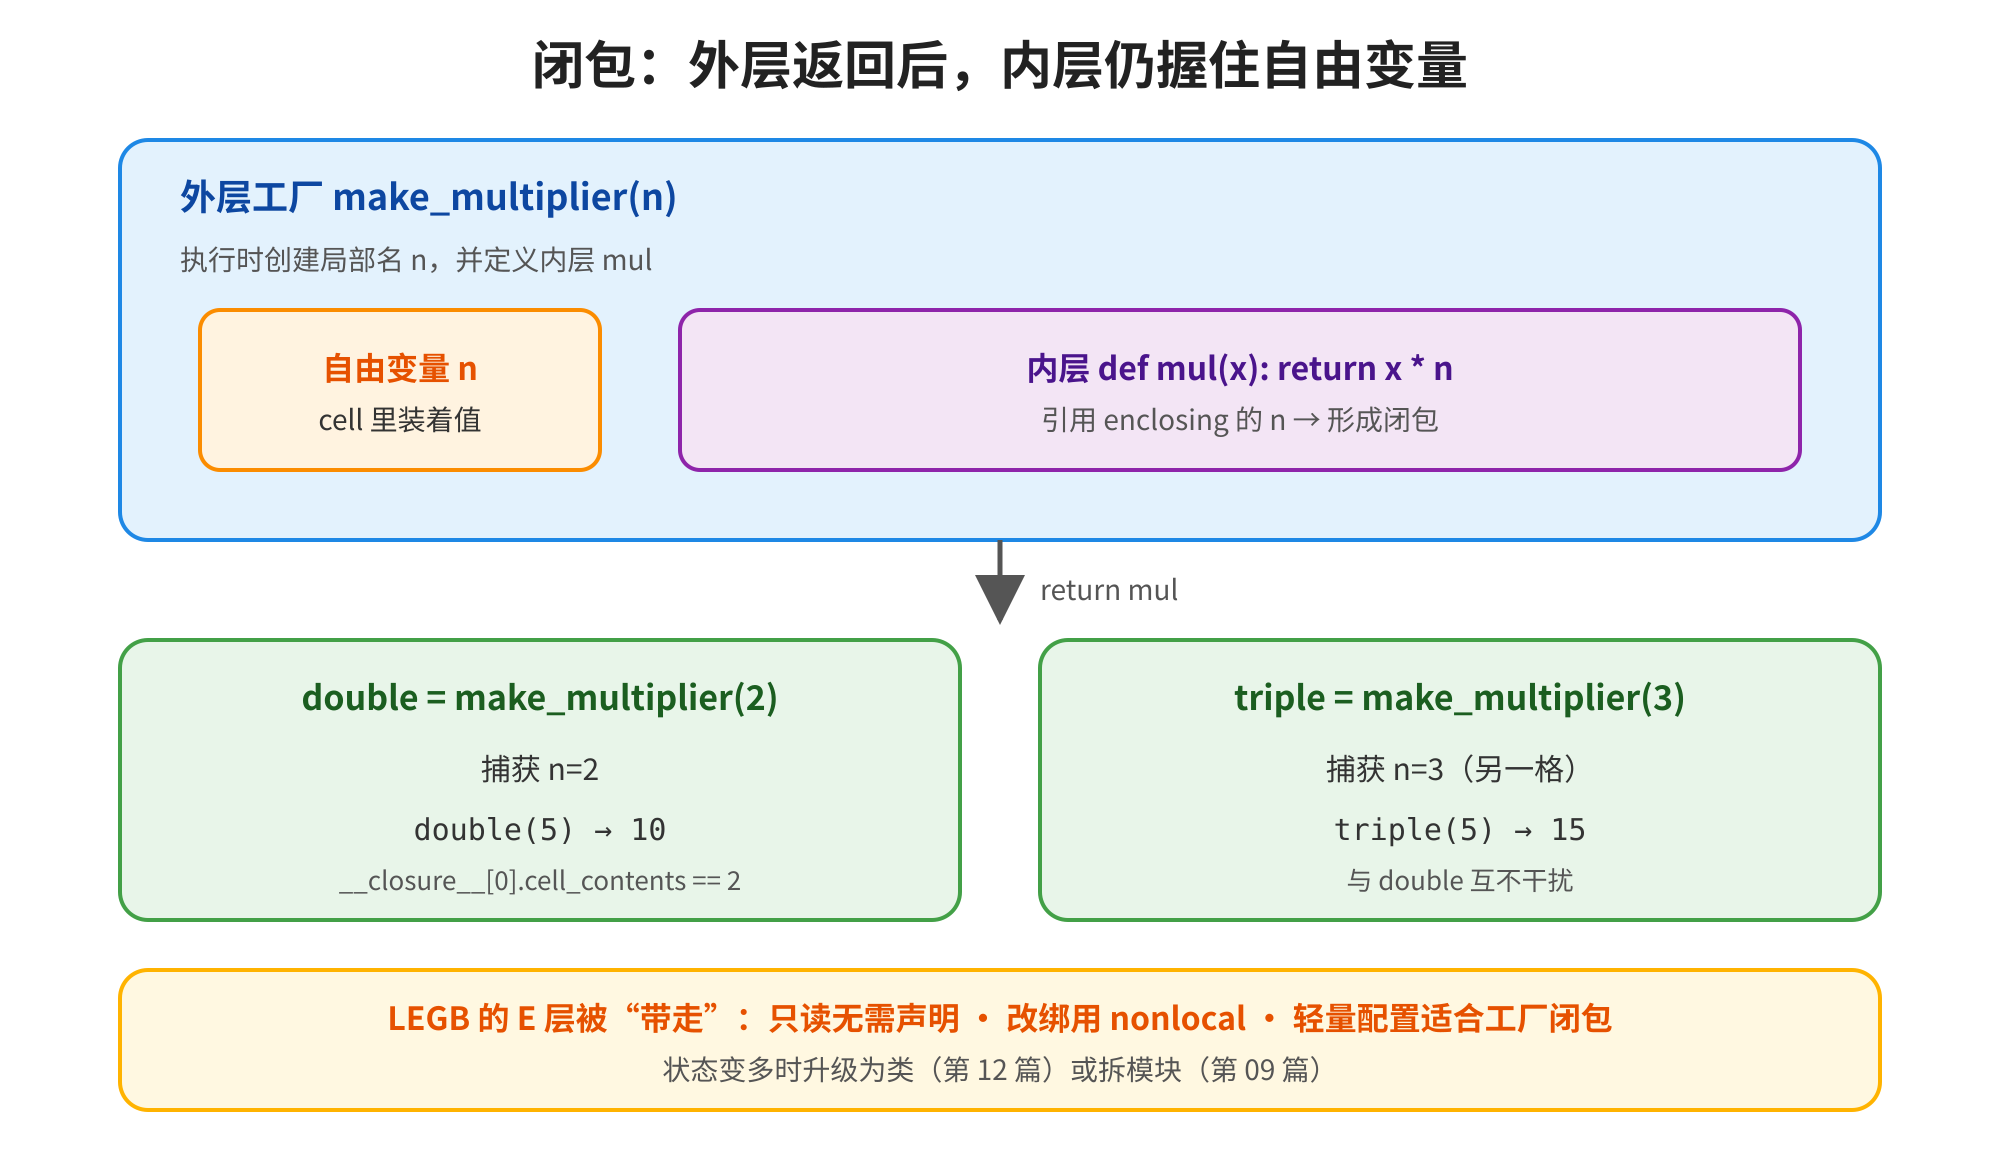
make_multiplier函数为例,执行时创建局部名n,并定义内层mul,mul引用enclosing的n形成闭包。double和triple分别捕获n=2和n=3,与double互不干扰。底部说明LEGB的E层被“带走”:只读无需声明,改绑用nonlocal,轻量配置适合工厂闭包,状态变多时升级为类或拆模块。图3 闭包:外层返回后,内层仍握住自由变量
4.2 nonlocal:闭包里改绑外层名
只读 enclosing 变量无需声明;若要重新绑定外层名字(例如计数器加一),用第 07 篇提过的 nonlocal:
def make_counter(start=0):
    n = start

    def inc(step=1):
        nonlocal n
        n += step
        return n

    def value():
        return n

    return inc, value

inc, value = make_counter(10)
print(inc(), inc(5), value())
11 16 16
4.3 经典坑:循环里的晚绑定
闭包捕获的是变量本身(cell),不是创建那一刻的快照。循环里批量造函数时,若都去读同一个循环变量,等到真正调用时,循环往往已经结束,大家都看到最后的值:
# 错误期待:希望得到 0,1,2 的加成
bad = []
for i in range(3):
    bad.append(lambda x: x + i)

print([f(10) for f in bad])     # 全是 10+2

# 正确:用默认参数把当前 i 冻进形参默认值
good = []
for i in range(3):
    good.append(lambda x, i=i: x + i)

print([f(10) for f in good])
[12, 12, 12]
[10, 11, 12]
列表推导里写 lambda 同样中招。口诀:晚绑定按“调用时”的变量值算;需要早绑定就用默认参数 i=i 或 functools.partial。
为什么默认参数能修好?因为默认值在定义函数对象时求值并绑进该函数,每个循环迭代都会创建一个新的函数对象,顺手把当时的 i 冻进自己的默认值槽。这和“闭包共享同一个 cell”是两条不同路径。你也可以写成:
def make_add(i):
    return lambda x: x + i

good2 = [make_add(i) for i in range(3)]
print([f(10) for f in good2])
[10, 11, 12]
工厂函数每次调用有自己的局部 i,内层闭包捕获的是那一次的格子,自然互不干扰。三种修法(默认参数、工厂、partial)选你团队最易读的一种即可。
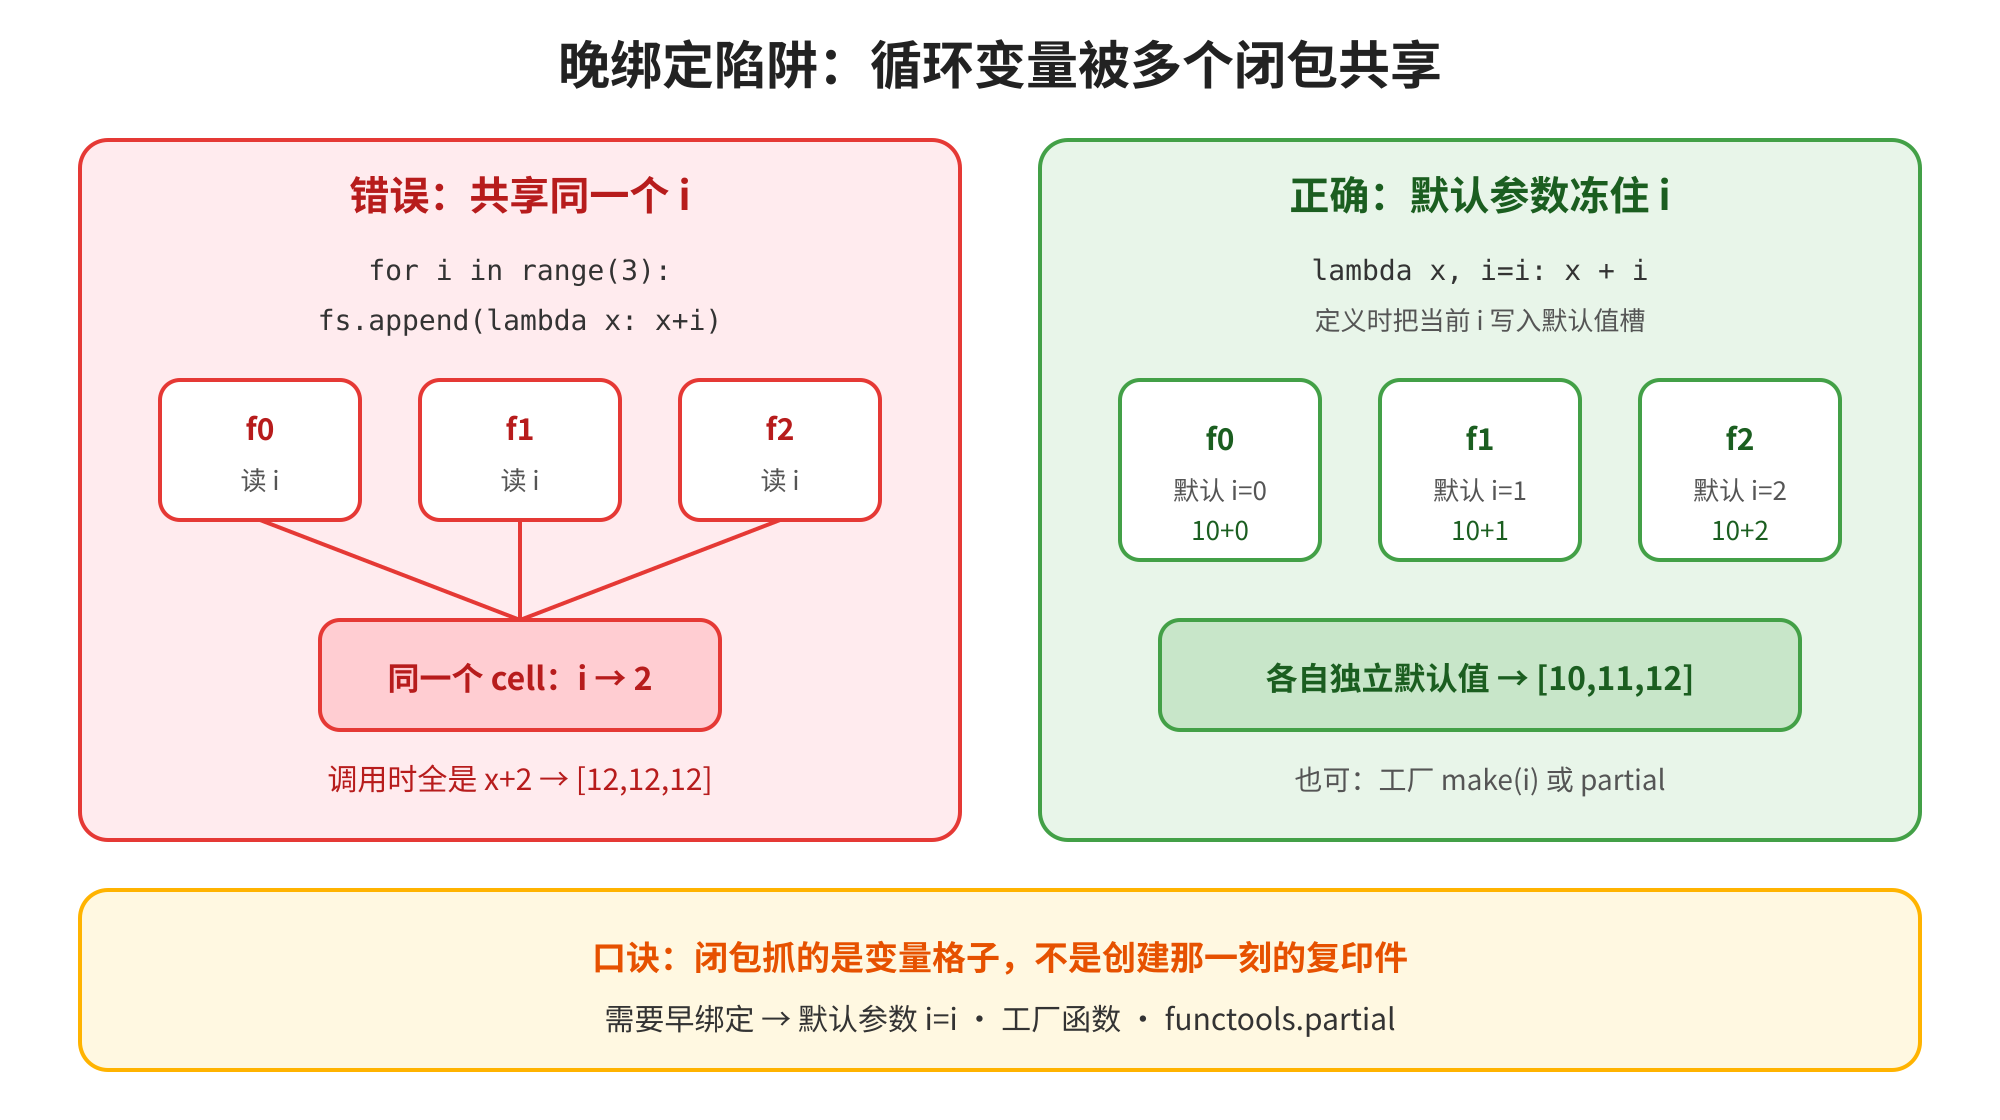
for i in range(3)定义的闭包共享同一个变量格子i,三个闭包f0、f1、f2读取的都是同一个i,调用时全取x+2,最终返回\[12,12,12\]。右侧绿色区域展示了正确的解决方式,通过默认参数i=i冻结循环时的i值,三个闭包f0、f1、f2各自拥有独立的默认值,分别为10、11、12,对应返回10+0、10+1、10+2,结果为\[10,11,12\]。图下方还给出了关于闭包陷阱的口诀与解决方案说明。图4 晚绑定:循环变量被多个闭包共享
4.4 工厂模式:配置进闭包,调用更干净
def make_tokenizer(vocab, unk_id=0):
    def encode(tokens):
        return [vocab.get(t, unk_id) for t in tokens]
    return encode

vocab = {"<unk>": 0, "hi": 1, "agent": 2}
enc = make_tokenizer(vocab)
print(enc(["hi", "agent", "missing"]))
[1, 2, 0]
调用方使用 enc(...) 时不必每次都带上 vocab——工厂已经把依赖封进闭包。Agent 里“按工具名生成 handler”、推理里“按模型名生成 client”,都是同一模式。
闭包不是唯一封装手段:把 vocab 放进类的实例属性(第 12 篇)往往更清晰,尤其是状态变多、需要多种方法时。闭包适合“一两个配置 + 一个主函数”的轻量场景;一旦发现你在闭包里塞了五个变量、三个内嵌 def,就该考虑升级成小类或拆模块(第 09 篇)。
五、lambda:表达式版的短函数
5.1 语法与限制
lambda 创建匿名函数,体只能是单个表达式,不能写语句(没有多行 if/for/return 块):
add = lambda x, y: x + y
print(add(2, 3), (lambda s: s.strip().lower())("  Hi "))
5 hi
等价于 def add(x, y): return x + y,只是没有名字、不能写 docstring、不能写复杂逻辑。需要名字、文档、多行时,请用 def。
5.2 真正适合的地方:key= 与短回调
rows = [
    {"name": "b", "score": 90},
    {"name": "a", "score": 95},
    {"name": "c", "score": 88},
]
print(sorted(rows, key=lambda r: r["score"], reverse=True))
print(sorted(rows, key=lambda r: (-r["score"], r["name"])))
[{'name': 'a', 'score': 95}, {'name': 'b', 'score': 90}, {'name': 'c', 'score': 88}]
[{'name': 'a', 'score': 95}, {'name': 'b', 'score': 90}, {'name': 'c', 'score': 88}]
map / filter 也能塞 lambda,但多数情况列表推导(第 06 篇)更直观。团队规范里常见建议:lambda 只出现在 key=、短回调等“当场用完”的位置。
对比可读性:
xs = ["  A", "b  ", " C "]
# 推导式通常更清楚
print([s.strip().lower() for s in xs])
# map+lambda 也能做,但层数一多就糊
print(list(map(lambda s: s.strip().lower(), xs)))
['a', 'b', 'c']
['a', 'b', 'c']
两者结果相同;选更易扫读的写法。性能在这种量级上几乎不是理由——可读性才是。
5.3 何时不要用 lambda
- 需要多行、异常处理、日志;
- 需要复用与单测(有名字更好引用);
- 已经开始嵌套三层
lambda——立刻改def。
# 推荐:有名字的小函数
rows = [
    {"name": "b", "score": 90},
    {"name": "a", "score": 95},
    {"name": "c", "score": 88},
]

def score_of(row):
    return row["score"]

print(max(rows, key=score_of)["name"])
a
5.4 轻预告:functools.partial
冻结部分参数也可以用标准库,而不必手写闭包:
from functools import partial

def power(base, exp):
    return base ** exp

square = partial(power, exp=2)
print(square(5), square(9))
25 81
partial 的完整故事在第 19 篇(collections / itertools / functools)。本篇只要知道:它和闭包一样都是“带着一点配置的可调用对象”,官方实现更省事。
六、一等公民、分发表与装饰器预习
6.1 函数可以放进容器
第 07 篇已强调函数是对象。进阶用法是分发表(dispatch table):用字典把名字映射到可调用对象,代替长串 if/elif。
def tool_echo(text):
    return text

def tool_len(text):
    return len(text)

TOOLS = {
    "echo": tool_echo,
    "len": tool_len,
    "upper": lambda s: s.upper(),   # 极短回调可以 lambda
}

def call_tool(name, *args, **kwargs):
    fn = TOOLS.get(name)
    if fn is None:
        raise KeyError(f"未知工具: {name}")
    return fn(*args, **kwargs)

print(call_tool("echo", "hi"))
print(call_tool("len", "agent"))
print(call_tool("upper", "sg"))
hi
5
SG
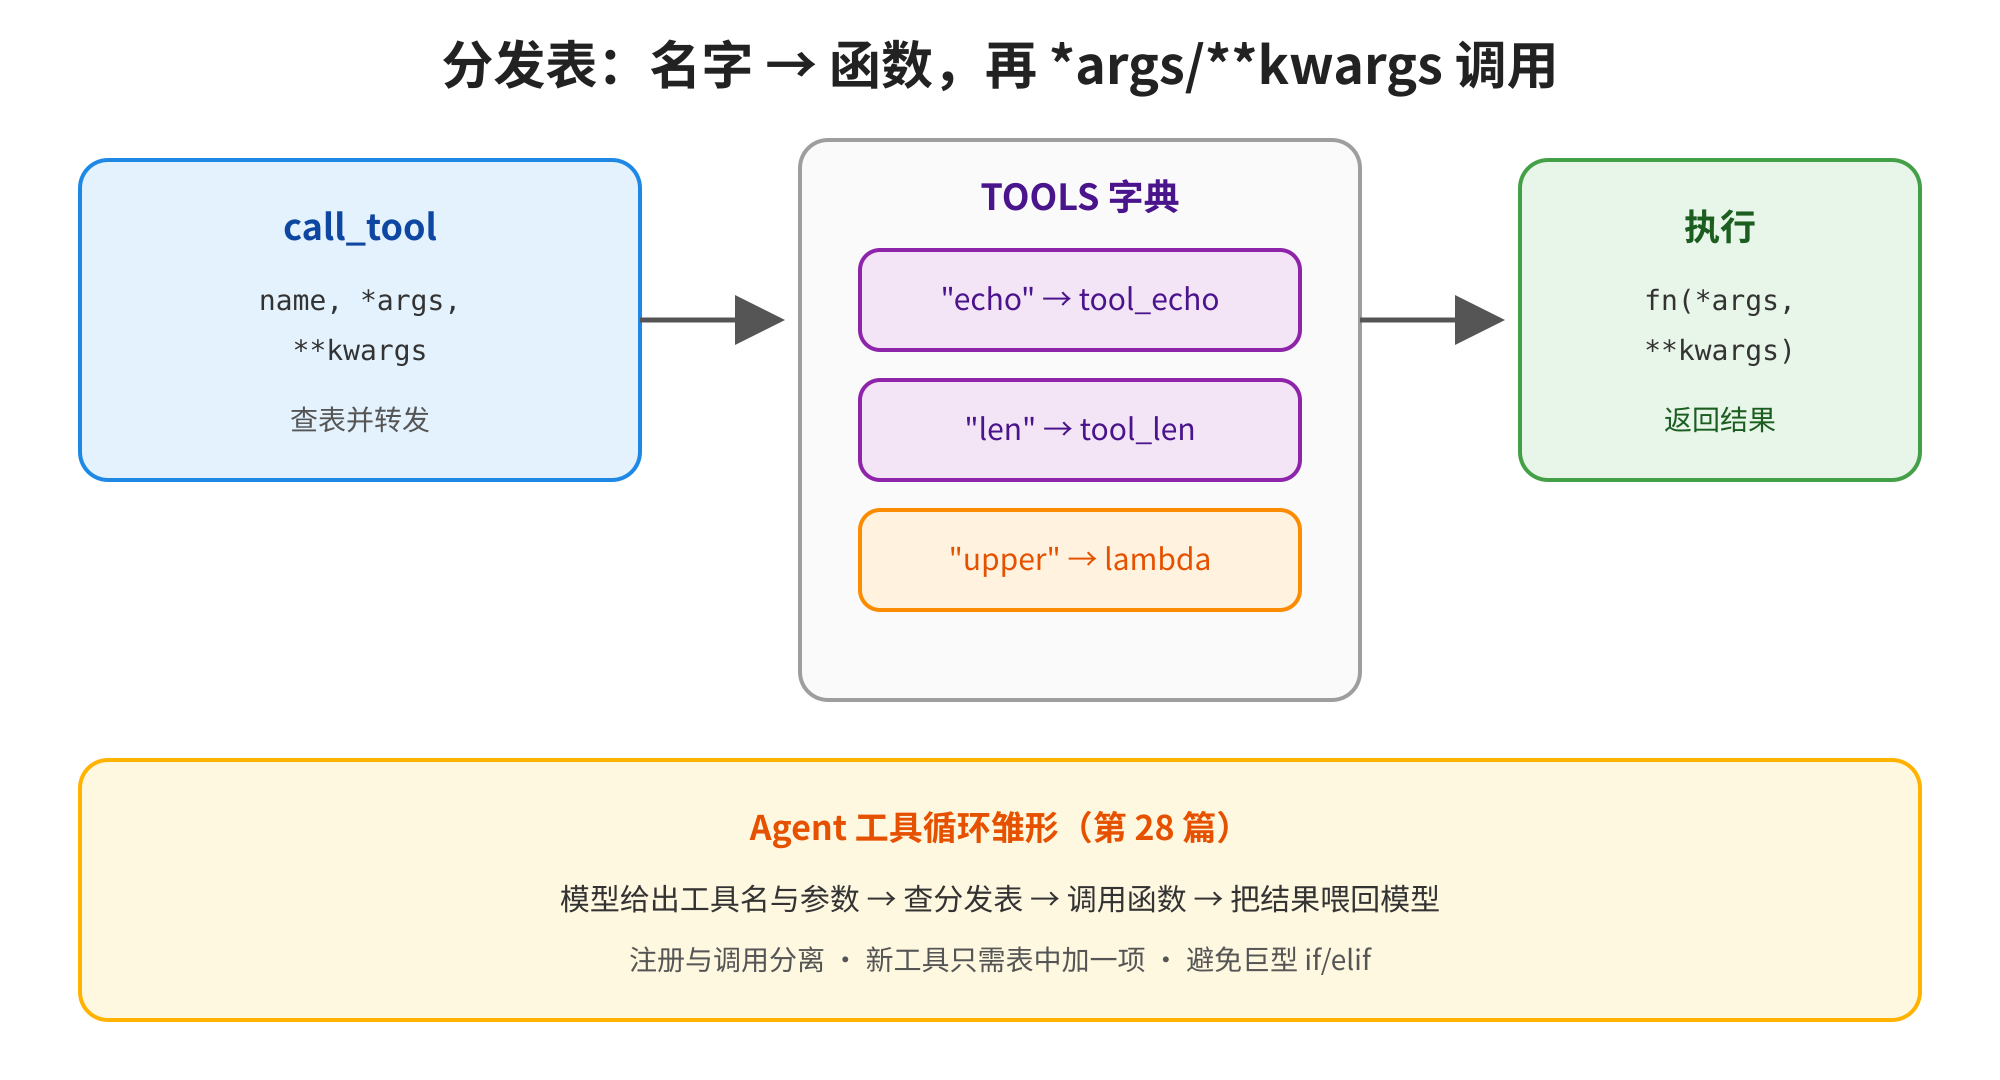
图5 分发表:名字 → 函数,配合 *args/**kwargs 调用
这正是最小 Agent 工具循环(第 28 篇)的雏形:模型返回工具名与参数 → 查表 → fn(*args, **kwargs)。
和长串 if name == "echo": ... elif name == "len": ... 相比,分发表的好处是:注册与调用分离——新工具只需往字典加一项,不必改中央 if 丛林。测试时也可以注入假工具(mock),替换 TOOLS 里的某个值即可。这和面向对象里的策略模式是同一思想,只是用函数字典先实现最小版本。
6.2 闭包工厂注册工具
def build_registry():
    table = {}

    def register(name, fn):
        table[name] = fn
        return fn

    def run(name, *args, **kwargs):
        return table[name](*args, **kwargs)

    def names():
        return sorted(table)

    return register, run, names

register, run, names = build_registry()
register("ping", lambda: "pong")
register("add", lambda a, b: a + b)
print(names(), run("ping"), run("add", 2, 3))
['add', 'ping'] pong 5
table 被三个闭包共享,外部拿不到裸 dict(除非你故意返回它)——这是用闭包做封装的朴素办法;更完整的封装会在面向对象篇(12~14)用类来做。
6.3 装饰器只是“语法糖 + 闭包”
下面两段在语义上同类(细节与 @functools.wraps 留给第 16 篇):
def loudly(fn):
    def wrapper(*args, **kwargs):
        print("call", fn.__name__)
        return fn(*args, **kwargs)
    return wrapper

def inc(x):
    return x + 1

inc = loudly(inc)          # 手工装饰
print(inc(10))
call inc
11
看见 @loudly 时,把它读成“用闭包包一层再赋回原名”即可。本篇只要建立条件反射:装饰器 = 接收函数、返回函数;里面几乎总有 *args, **kwargs 转发。
若写成语法糖,等价于:
@loudly
def inc(x):
    return x + 1
# 大致等于:先 def inc,再 inc = loudly(inc)
现在你不必深究装饰器参数、叠多个 @、类装饰器等变体——那是第 16 篇的菜。只要看见 @ 不发慌,能还原成“工厂返回的 wrapper 换掉了原函数”,本篇目标就达成了。
AI Infra 视角
- 工具表:
dict[str, Callable]+*args/**kwargs。- 配置工厂闭包:
make_tokenizer(vocab)/make_client(base_url)。- 中间件/装饰器:计时、重试、鉴权——第 16 篇展开。
- 偏函数:
partial(chat, model="mini")少传重复参数(第 19 篇)。
七、踩坑大全
下面这些坑,大多能归到三句话:“* 在定义侧是打包、在调用侧是解包”“闭包抓变量不抓快照”“lambda 只能写表达式”。遇到参数对不上、循环回调全是最后一个值、或 lambda 语法错误,先回到这三条。
排查时可自问:形参顺序是否符合口诀?仅关键字有没有被按位置传入?包装器有没有漏掉 return?循环里的闭包是否用了 i=i?lambda 里是不是偷偷写了语句?
7.1 可变参数与形参顺序
坑 1:把 *args 当 list 去改。 现象:想 args.append 却别扭。原因:args 是 tuple。解决:需要可变序列时 args = list(args),或在逻辑里用新列表。
坑 2:形参顺序写反。 现象:SyntaxError(如 **kwargs 出现在 *args 前)。解决:位置 → *args/* → 仅关键字 → **kwargs。
坑 3:仅关键字被当成位置传入。 现象:TypeError: takes 1 positional argument but 2 were given。解决:调用时写 temperature=0.2,或检查定义里是否有 * / *args 隔开。
坑 4:解包时键对不上形参。 现象:TypeError: got an unexpected keyword argument。解决:检查 **dict 的键是否都是目标函数认识的形参名;多余键应先过滤或改为目标也声明 **kwargs。
7.2 转发与包装器
坑 5:包装器忘了 return。 现象:原函数明明返回了值,外面却拿到 None。解决:return fn(*args, **kwargs),不要只调用不返回。
坑 6:在包装器里修改了可变的 kwargs 却影响调用方。 现象:调用方 dict 被 pop 掉键。解决:先 kwargs = dict(kwargs) 再改;或明确文档“会消耗 opts”。
7.3 闭包与 lambda
坑 7:循环晚绑定。 现象:三个回调结果一模一样。原因:共享同一个循环变量 cell。解决:lambda x, i=i: ...,或在循环体内用 partial,或写成 def make(i): ... 工厂。
坑 8:以为闭包复制了对象。 现象:改外层 list,所有闭包都看见新内容。原因:捕获的是变量引用的对象。解决:需要快照就 tuple(xs) / list(xs) 拷一份再绑进默认参数或局部名。
坑 9:lambda 里写语句。 现象:SyntaxError。解决:改 def;分支用条件表达式 a if cond else b 仅限极简单场景。
坑 10:用 lambda 冒充复杂业务函数。 现象:无法 docstring、难测、难栈追踪。解决:超过一行或需要复用就 def。
7.4 环境与习惯
坑 11(Jupyter):装饰/包装后单元格重跑导致双重包装。 现象:一次调用打印两遍日志。解决:重启内核,或把 fn = wrap(fn) 写成幂等注册;正式代码用 @decorator 并避免重复执行定义单元。
坑 12:分发表里存了“调用结果”而不是函数。 现象:TOOLS["echo"] = tool_echo() 立刻执行,表里是字符串。解决:存 tool_echo 本身,调用时再加括号。
# 晚绑定修复对照
fs = [lambda x, i=i: x + i for i in range(3)]
print([f(0) for f in fs])
[0, 1, 2]
八、小结
合上文章后,试着用自己的话解释:“*args 在定义和调用时各做什么”以及“为什么循环里的闭包常常都是最后一个值”——讲得清,才算真的会了。
*args/**kwargs:定义侧打包多余位置/关键字实参;调用侧*/**解包序列/映射。- 形参顺序:位置(含默认)→
*args或裸*→ 关键字仅参数 →**kwargs;裸*可强制关键字传入。 - 转发包装器:
wrapper(*args, **kwargs)再return fn(*args, **kwargs),是装饰器与中间件的骨架。 - 闭包:内层握住 enclosing 自由变量;只读无需声明,改绑用
nonlocal;循环晚绑定用默认参数冻值。 lambda:单表达式匿名函数,适合key=等短回调;复杂逻辑用def;partial作相关工具(第 19 篇)。- 一等公民与分发表:函数可进 dict;
call_tool(name, *args, **kwargs)是 Agent 工具循环雏形;装饰器 = 闭包包一层(第 16 篇)。
把故事连起来:函数基础(07)把逻辑收成积木 → 本篇让积木接口可伸缩、可携带环境 → 下一篇(09)把积木放进模块与包,用 import 在文件之间复用。
本篇技能会立刻复利:读开源推理框架的 *args, **kwargs 包装层不再慌;写最小工具注册表只需一张字典;看见 @decorator 能还原成闭包赋值。先把打包/解包与晚绑定练准,比背十个技巧函数名更划算。
若只能带走一句话:定义用 */** 打包,调用用 */** 解包;闭包抓变量不抓瞬时值;短用 lambda,长用 def。
也可以用“三个不要”自检:不要写乱形参顺序;不要在循环里裸捕获循环变量;不要用 lambda 硬塞多行业务。三条守住,函数进阶就很少翻车。
再留一个自测:默写 def f(a, *args, b, **kwargs) 的合法调用一例;解释 lambda x, i=i: x+i 里默认参数为何能修好晚绑定;用字典写一个两工具分发并成功调用。三问都顺,本篇就站稳了。
九、课后练习
- (基础) 编写
def product(*nums):,返回所有数字乘积(无参数时返回1);分别用多个位置实参与*列表解包两种方式调用。 - (基础) 编写
def label(name, *, prefix="模型", version=1):,演示仅关键字参数;尝试错误地按位置传prefix并阅读报错。 - (基础) 编写
def show(a, b=0, *args, **kwargs):,打印四类内容;自行设计一组调用,使args与kwargs都非空。 - (理解) 实现
def timed(fn):包装器(可用time.perf_counter),包装一个busy(n)(累加range(n)),确认返回值仍正确且有耗时打印。 - (理解) 解释下列代码输出为何全是
2;改成输出0 1 2(至少给出默认参数冻值与工厂函数两种修法之一)。
funcs = []
for i in range(3):
    funcs.append(lambda: i)
print([f() for f in funcs])
- (理解) 用闭包实现
make_adder(n),返回add(x);再实现带nonlocal的make_counter()。对比“只读捕获”与“改绑捕获”。 - (进阶) 实现迷你工具表:
register(name, fn)、call(name, *args, **kwargs)、list_tools();注册至少三个工具(含一个lambda),并写出正常调用与未知工具名时的错误处理。 - (进阶 · AI Infra) 写
make_encoder(vocab, unk=0)闭包工厂;再写chat_safe(model, *messages, **opts),将temperature限制到<=0.9后转发到自拟的chat_raw;最后用sorted(samples, key=lambda ...)按分数排序一组假样本 dict。选做:用functools.partial固定model="mini"生成chat_mini。
下一篇预告
函数进阶解决了“可变参数、闭包携带环境、短 lambda 与分发表”;下一篇《第09篇|模块、包与 import 机制》会把这些函数放到文件与包结构里复用:import 到底执行了什么、sys.path 如何找模块、为什么“主模块”要写 if name == "main"。本篇的工厂与工具表,正好适合拆成 tools.py / registry.py 再被别人 import。
专栏一「Python 从零入门」的后续路线:模块与 import(09)→ 文件与路径(10)→ 异常(11)→ 面向对象与数据模型(12~14)。带着本篇的转发与闭包直觉,读训练脚本的多文件结构和推理服务的路由注册时,会先看懂“名字从哪个模块来、函数带着什么环境”,再钻业务细节。
若你想提前热身:把本篇的工具分发表存成一个 .py 文件,在另一个文件里 import 并调用(即使还不懂包,先用同目录模块试);再把第 07 篇的 make_serve_cfg 与本篇的 *args/**kwargs 包装器拼一次。两道小练习做完,下一篇谈 import 机制时你会带着具体素材,而不是空壳目录树。