
第03篇|数字、字符串与格式化
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 3 篇。在理解“名字与对象”之后,钻进最常用的两类内置对象——数字与字符串:它们怎么存、怎么算、怎么拼、怎么打印,以及为什么
0.1 + 0.2 != 0.3。读完你将能够:正确选用
int/float/bool;解释浮点误差并用Decimal/Fraction/math.isclose应对;把字符串当作不可变的 Unicode 序列来索引、切片与调用方法;熟练使用 f-string 做格式化;分清str与bytes、UTF-8 编码;并把这些知识映射到 token 文本、数值 dtype 与日志输出。预计用时:阅读 35~45 分钟,动手 20~30 分钟。
上一篇我们弄清了“名字绑定到对象”:整数是不可变对象,a = a + 1 其实是换了一个新对象。本篇把镜头推近,看两类每天都要用的对象——数字(numbers)与字符串(str)。
你会反复碰到这些问题:为什么大整数不会溢出,浮点加法却对不上?字符串能不能改某一个字符?打印 loss 时小数点后留几位?中文在磁盘上到底占几个字节?做 Agent 时拼接提示词、做推理时打印指标、做数据管道时读 UTF-8 文件——全都落在本篇。下一篇(列表与元组)会在“序列”这条线上继续展开,本篇的索引与切片规则会原样复用。
建议边读边在 uv run python 或交互窗口里敲代码。数字与字符串的坑,多半是“打印一下就明白”的那种。
本篇的阅读顺序是:先建立数字类型地图 → 吃透整数与浮点 → 把字符串当作不可变序列操练索引/切片/方法 → 学会三种格式化并选定 f-string → 最后打通 UTF-8 与 AI Infra 场景。若某一节的代码你已经很熟,也请至少把“踩坑大全”过一遍——那里集中了课堂上最容易栽的跟头。
一、数字类型总览:int、float、bool、complex
1.1 四种内置数字类型
Python 内置了四种数字相关类型,日常前三种几乎天天见:
| 类型 | 含义 | 字面量例子 | 典型用途 |
|---|---|---|---|
| int | 整数 | 42、-7、10**100 | 计数、索引、token id |
| float | 浮点数 | 3.14、1e-3、-0.5 | loss、学习率、概率 |
| bool | 布尔 | True、False | 条件、开关 |
| complex | 复数 | 3+4j | 科学计算(本系列少用) |
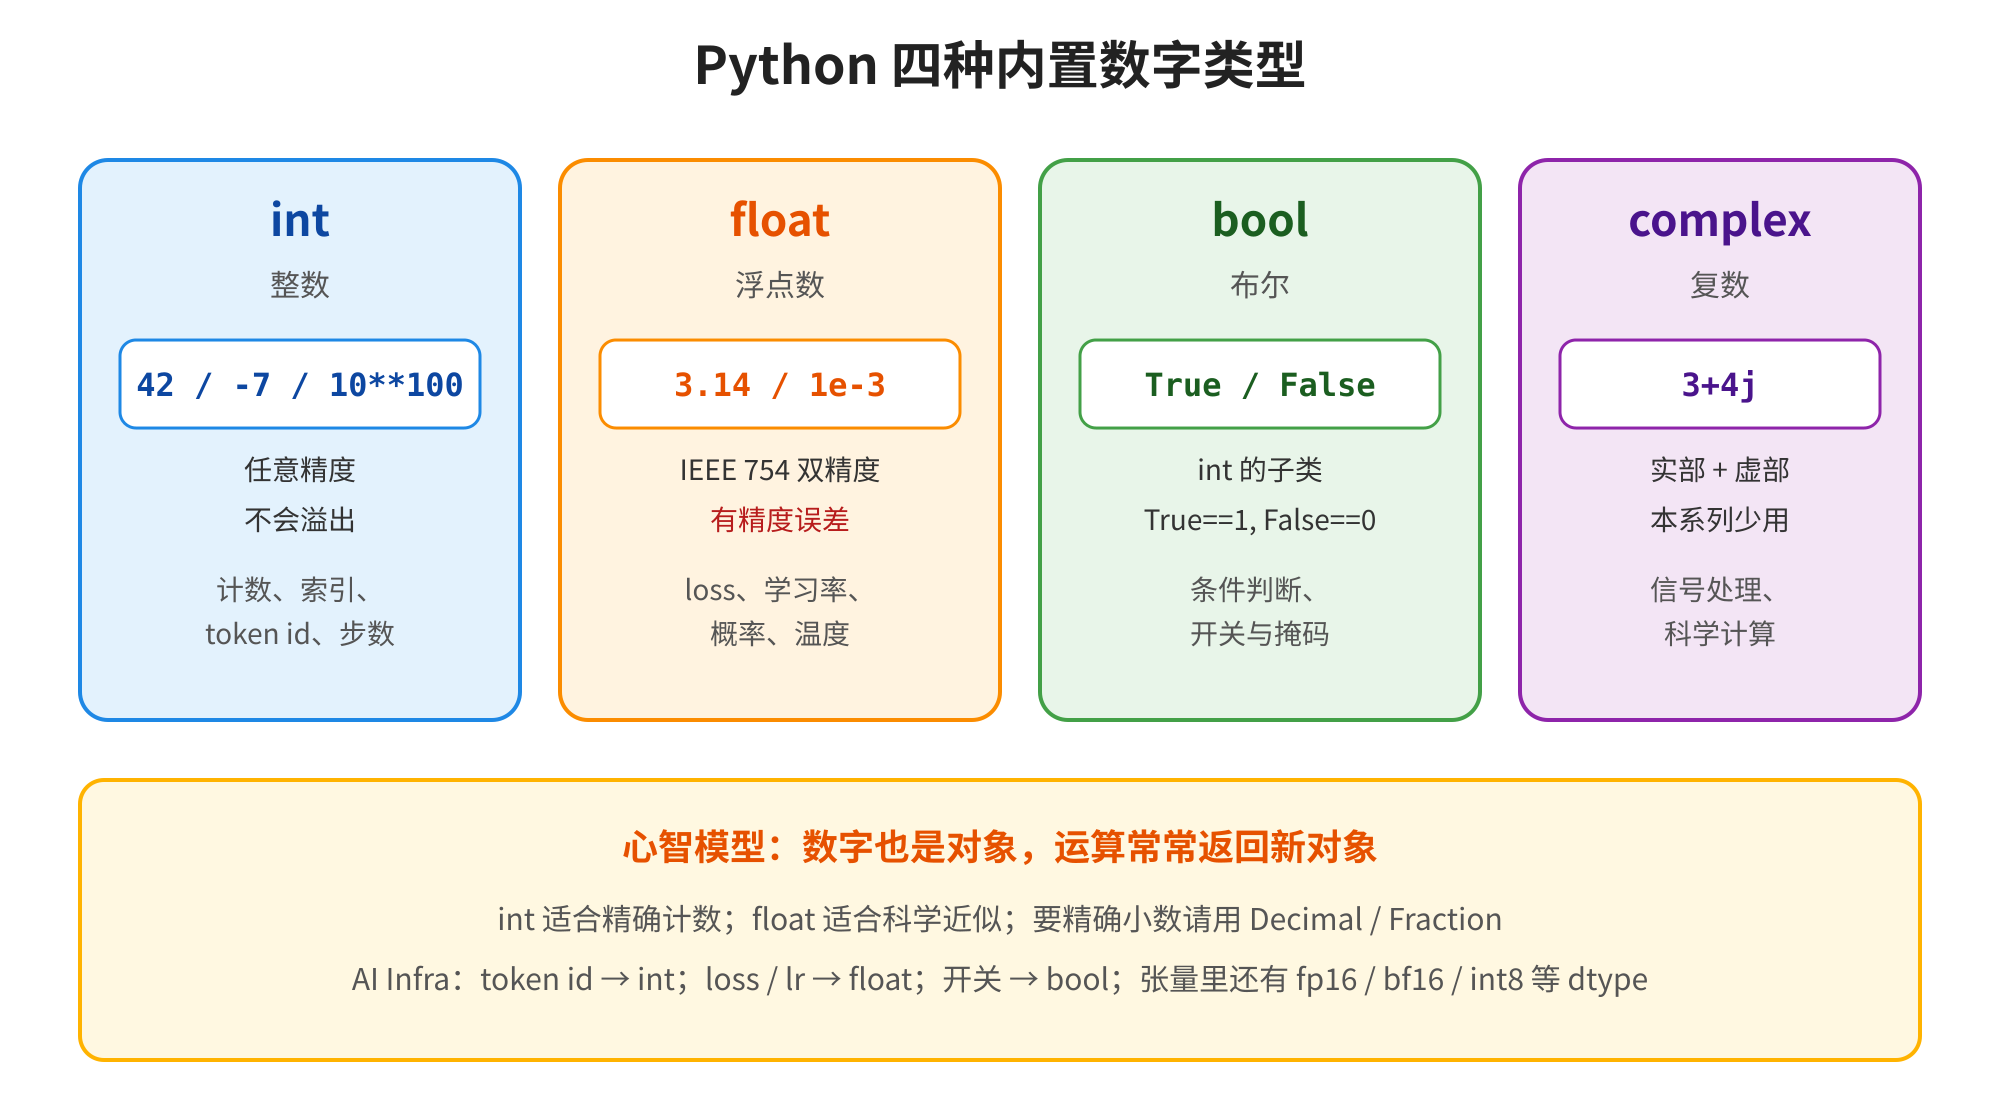
图1 Python 四种内置数字类型
用 type 确认一下:
print(type(42))         # <class 'int'>
print(type(3.14))       # <class 'float'>
print(type(True))       # <class 'bool'>
print(type(3 + 4j))     # <class 'complex'>
<class 'int'>
<class 'float'>
<class 'bool'>
<class 'complex'>
它们都是不可变对象:运算通常返回新对象,不会就地改原来的数字。这和上一篇的结论一致——x = x + 1 是重绑,不是改盒子里的值。
再做一个小实验,把“运算返回新对象”钉进直觉:
a = 1000
print(id(a))
a = a + 1
print(id(a))          # 通常已经变了:绑定到新的 int 对象
(两行 id 不同;具体数字因机器而异)
混用类型时,Python 会尽量给出合理结果:int 与 float 运算通常得到 float;bool 参与算术时按 0/1 处理。显式转换用 int() / float() / bool():
print(3 + 0.5, type(3 + 0.5))     # 3.5 <class 'float'>
print(int(3.9), float(3), bool(0), bool("hi"))
3.5 <class 'float'>
3 3.0 False True
注意:int 截断向零(int(-3.9) == -3),不是四舍五入;需要四舍五入用 round。bool(x) 对数字是“非零为真”,对字符串是“非空为真”——空串 ""、0、0.0、None、空容器都是假值。这一点在第 06 篇写条件判断时还会用到。
1.2 bool 其实是 int 的子类
这是一个常被忽略、却很有用的事实:
print(issubclass(bool, int))   # True
print(True + True)             # 2
print(False * 10)              # 0
print(isinstance(True, int))   # True
True
2
0
True
所以在需要 0/1 的地方,True/False 可以当整数用。但可读性优先:写条件用布尔,写算术用 0/1,不要靠“布尔能加”炫技。比较时仍建议用 ==,不要写 flag is True(上一篇讲过:is 留给身份,== 留给值;对布尔用 if flag: 往往更地道)。
1.3 complex 一眼带过
复数用 j 表示虚部:z = 3 + 4j,z.real / z.imag 分别取实部与虚部。本教程后续几乎不涉及;知道 Python 原生支持即可。信号处理、部分科学计算库会用到它。
AI Infra 视角
训练与推理里,Python 侧常见的是
int(步数、batch size、token id)和float(loss、learning rate、temperature)。真正进 GPU 的张量还有更细的 dtype(float32/float16/bfloat16/int8……)。本篇先把 Python 标量数字摸熟;第 29、37 篇会讲数组与张量的 dtype 选择如何影响精度与显存。
二、整数:任意精度与常见运算
2.1 没有溢出的 int
许多语言的 int 有固定位宽(如 32/64 位),加到上限会溢出。Python 的 int 是任意精度(arbitrary-precision)的:只要内存够,可以表示天文数字。
n = 2 ** 200
print(n)
print(type(n))
print(n.bit_length())   # 需要多少个二进制位
1606938044258990275541962092341162602522202993782792835301376
<class 'int'>
201
这对写算法很友好:不用提前担心“中间结果爆了”。代价是:超大整数的运算比机器字长整数慢,因为底层要用多段“数字肢(digit)”来存。日常计数、索引完全感觉不到;密码学或组合爆炸场景才会在意。
对比一下“看起来像溢出、其实没有”的感觉:
big = 10 ** 50
print(big + 1)
print(big * big)          # 约 100 位,仍然是普通 int
100000000000000000000000000000000000000000000000001
10000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000
在 C 或 Java 里,固定宽度整数加到上限会绕回负数或抛异常;在 Python 里你更常碰到的反而是“算得太慢 / 占内存太大”,而不是静默溢出。写竞赛或数值算法时,这是一种安心;写高性能路径时,又提醒你:热点循环里的大整数运算该下沉到 NumPy / C 扩展。
上一篇提过小整数缓存(大约 -5~256):那是性能优化,不改变“int 任意精度”的语义,也不能拿来当 is 比较的依据。
2.2 整除、取模与常见运算
print(7 + 3, 7 - 3, 7 * 3)   # 10 4 21
print(7 / 3)                  # 2.333...  真除法,结果是 float
print(7 // 3)                 # 2         向下取整的整除
print(7 % 3)                  # 1         余数
print(divmod(7, 3))           # (2, 1)    同时得到商和余数
print(2 ** 10)                # 1024      幂
print(abs(-5), round(3.6))    # 5 4
10 4 21
2.3333333333333335
2
1
(2, 1)
1024
5 4
记住两个易混点:
/永远返回 float(即便能整除:8 / 2是4.0);要整数商用//。- 负数整除向下取整:
(-7) // 3 == -3,不是“向零截断”的-2。余数满足a == (a // b) * b + (a % b)。
print((-7) // 3, (-7) % 3)     # -3 2
print((-7) == (-7) // 3 * 3 + (-7) % 3)
-3 2
True
位运算(& | ^ << >>)在写底层、权限掩码或某些哈希/压缩逻辑时有用,本篇不展开;见到时知道它们作用于整数的二进制表示即可。布尔场景下,& / | 与 and / or 也不相同——前者是按位运算且不短路,后者是逻辑运算且短路;条件判断请用 and / or / not(第 06 篇详述)。
2.3 进制字面量
print(0b1010)    # 二进制 → 10
print(0o17)      # 八进制 → 15
print(0xFF)      # 十六进制 → 255
print(hex(255), bin(10))
10
15
255
0xff 0b1010
读配置、看内存地址、调试颜色值时,十六进制很常见。int("ff", 16) 也能从字符串按指定进制解析。
三、浮点数:IEEE 754 与精度陷阱
3.1 为什么 0.1 + 0.2 != 0.3
这是每个语言学习者的成人礼:
print(0.1 + 0.2)
print(0.1 + 0.2 == 0.3)
0.30000000000000004
False
不是 Python 算错了,而是 IEEE 754 双精度浮点数用二进制表示小数时,很多十进制小数(包括 0.1)无法精确存储,只能存“最接近的近似值”。两个近似值相加,误差可能露出来。
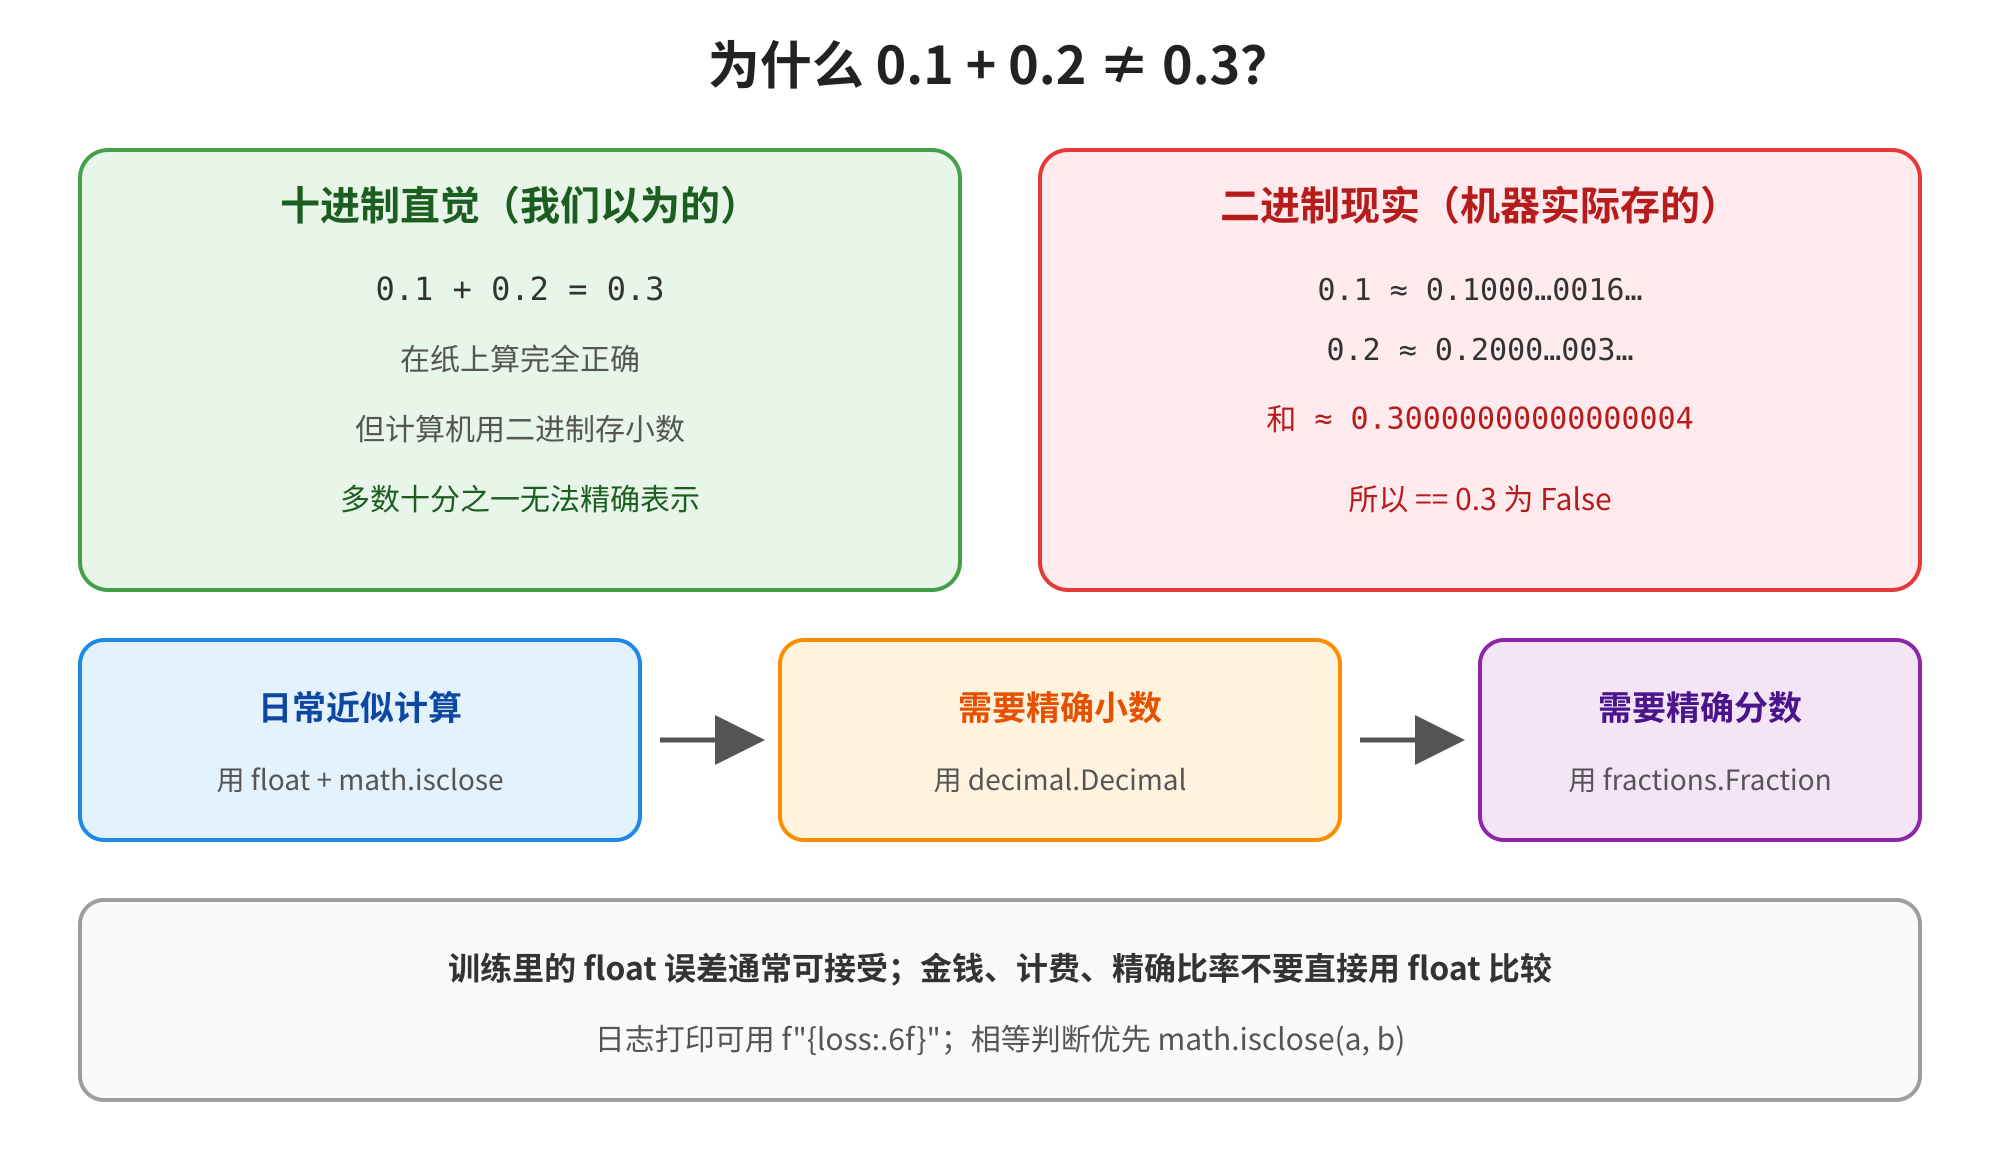
图2 为什么 0.1 + 0.2 ≠ 0.3
查看真实存储的近似值:
print(f"{0.1:.60f}")
0.100000000000000005551115123125782702118158340454101562500000
float 大约有 15~17 位有效十进制数字,这对科学计算通常够用,但不要用 == 直接比较两个浮点运算结果是否“理论上相等”。
推荐写法:
import math

a = 0.1 + 0.2
b = 0.3
print(math.isclose(a, b))                 # True:允许微小相对/绝对误差
print(math.isclose(a, b, rel_tol=1e-9))
True
True
打印时还可以主动控制“看见多少误差”:
x = 0.1 + 0.2
print(x)                 # 默认会露出那点尾巴
print(f"{x:.1f}")        # 按一位小数显示 → 0.3
print(round(x, 1) == 0.3)
0.30000000000000004
0.3
True
round 与格式化解决的是展示与近似,不能消灭底层误差。做单元测试时,对 float 断言请用 math.isclose 或测试框架提供的近似比较(如 pytest.approx),不要写死 assert result == 0.3。
积累误差也会放大:在循环里反复加 0.1 一万次,结果往往不是精确的 1000.0。训练里这种误差通常可接受;若你在做财务累计或精确计步,换 Decimal 或改用整数(以“分”为单位计数)更稳妥。
3.2 特殊值:inf 与 nan
print(float("inf"), float("-inf"))
x = float("nan")
print(x, x == x)          # nan 与任何值(包括自己)比较都是 False
print(math.isnan(x), math.isinf(float("inf")))
inf -inf
nan False
True True
训练中若 loss 变成 nan,通常意味着数值炸了(学习率过大、除零、溢出等)。判断要用 math.isnan,不能写 x == float("nan")。
3.3 何时用 Decimal 与 Fraction
需要精确的十进制小数(金额、计费、税率)时,用标准库 decimal.Decimal,并且用字符串构造,避免先经过 float:
from decimal import Decimal, getcontext

print(Decimal("0.1") + Decimal("0.2"))     # 0.3
print(Decimal(0.1) + Decimal(0.2))         # 先被 float 污染,仍然不准!
getcontext().prec = 50                     # 可调精度
print(Decimal(1) / Decimal(7))
0.3
0.3000000000000000166533453694
0.14285714285714285714285714285714285714285714285714
需要精确的有理数时,用 fractions.Fraction:
from fractions import Fraction

print(Fraction(1, 10) + Fraction(1, 5))    # 3/10
print(Fraction("0.1") + Fraction("0.2"))   # 3/10
3/10
3/10
选型口诀:
- 训练 / 推理中的近似量 →
float(或张量 dtype),比较用isclose; - 金钱、精确小数 →
Decimal; - 精确比率 / 分数演算 →
Fraction。
不必把 Decimal 用到一切地方:它比 float 慢、也更占内存。机器学习里的梯度与激活值,天生就是近似计算;这时死磕十进制精确没有意义,选对 dtype、控制数值稳定才更重要。反过来,一旦数字代表“钱”或“必须可复现的精确比率”,就别省那点性能去用 float。
四、字符串:不可变的 Unicode 序列
4.1 str 是不可变对象
字符串(str)是 Unicode 字符的不可变序列。创建后不能改其中某个字符;所谓“修改”都是生成新字符串再重绑名字。
s = "hello"
print(type(s), len(s))
try:
    s[0] = "H"          # 试图就地修改
except TypeError as e:
    print(type(e).__name__ + ":", e)

s = "H" + s[1:]         # 正确:构造新串,再绑定
print(s)
<class 'str'> 5
TypeError: 'str' object does not support item assignment
Hello
这和上一篇“不可变对象只能通过重绑修改”完全一致。好处是:字符串可以安全地共享、做字典键;坏处是:循环里反复 s = s + chunk 可能产生大量临时对象(短串通常没事;超长拼接更推荐 "".join(parts))。
再看一个“看起来在改、其实在换”的例子:
msg = "hello"
print(id(msg))
msg = msg.upper()       # upper 返回新串
print(msg, id(msg))     # 内容变了,身份通常也变了
hello 的 id(旧)
HELLO <新的 id>
因此,调用任何“修改类”方法后,一定要用返回值(或重新绑定),不要以为原变量会变——这是初学 str / tuple 时最常见的落空预期。
字符串字面量可用单引号或双引号,三者等价于包一层字符;多行文本用三引号:
title = "第03篇"
path = 'C:\\temp'           # 或用原始字符串 r"C:\temp"
doc = """第一行
第二行"""
print(title, len(doc))
第03篇 7
(doc 含换行符,长度因换行而计入。)
4.2 索引与切片
字符串支持与列表相同的索引(indexing)与切片(slicing)规则——下一篇讲列表时会原样复用。
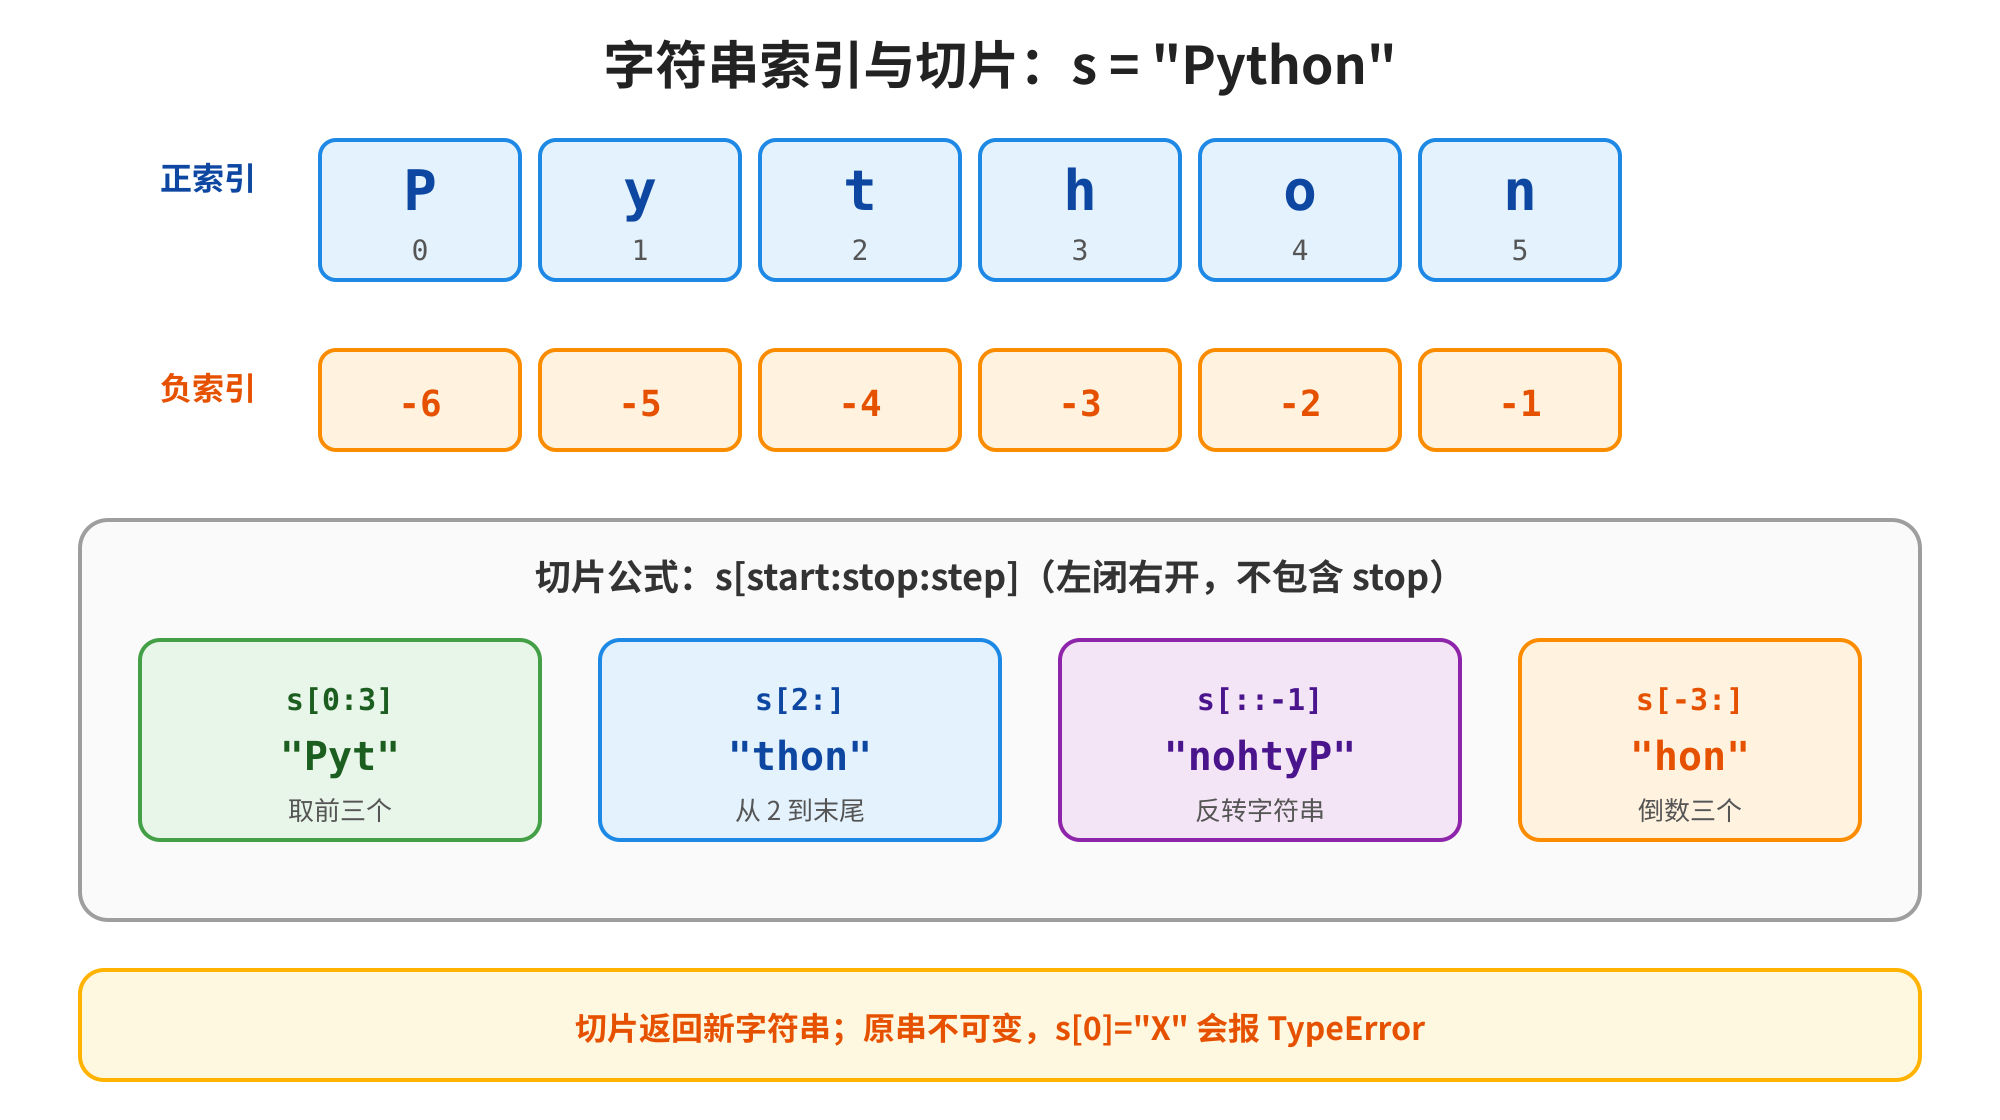
图3 字符串索引与切片
s = "Python"
print(s[0], s[-1])       # P n
print(s[0:3])            # Pyt   左闭右开
print(s[2:])             # thon
print(s[:2])             # Py
print(s[::-1])           # nohtyP  反转
print(s[-3:])            # hon
P n
Pyt
thon
Py
nohtyP
hon
要点:
- 索引越界会
IndexError;切片越界不会,只是结果变短或变空——这让切片很好用。 s[i:j]不包含j(半开区间)。- 步长可为负:
s[::-1]是反转的惯用写法。 - 切片得到的是新字符串,与原串无关。
4.3 常用字符串方法
方法不改变原串,而是返回新串(或返回信息):
s = "  Hello, AI Infra  "
print(s.strip())                  # 去两侧空白
print(s.lower(), s.upper())
print("infra" in s.lower())       # 成员判断
print(s.strip().startswith("Hello"))
print("a,b,c".split(","))         # ['a', 'b', 'c']
print("-".join(["a", "b", "c"]))  # a-b-c
print("hello".replace("l", "L"))  # heLLo
print("score={}".format(95))      # 见下一节;也可用 f-string
print("你好".isalpha(), "42".isdigit())
Hello, AI Infra
  hello, ai infra     HELLO, AI INFRA
True
True
['a', 'b', 'c']
a-b-c
heLLo
score=95
True True
处理用户输入或 Agent 工具返回时,几乎总要先 .strip(),再按需 .lower() / .split()。拼接列表成一句提示词时,优先 "".join(parts) 或 "\n".join(lines),而不是在循环里用 +。
查找位置用 .find(sub)(找不到返回 -1)或 .index(sub)(找不到抛异常)。判断包含关系用 sub in s 最清晰。
一个拼提示词的小样板(后面写 Agent 时会反复用到类似结构):
system = "你是严谨的助手。"
user = "解释什么是 KV Cache"
tools = ["search", "calculator"]
prompt = "\n".join([
    f"系统:{system}",
    f"用户:{user}",
    "可用工具:" + ", ".join(tools),
])
print(prompt)
系统:你是严谨的助手。
用户:解释什么是 KV Cache
可用工具:search, calculator
注意:这里每一段都是 str,用 join 一次拼好;若某段来自网络且是 bytes,先 .decode("utf-8") 再拼(见第六节)。
五、格式化:f-string、format 与 %
把变量嵌进字符串,是日志、报表、提示词里的日常操作。Python 提供三种主流方式,新代码优先 f-string。
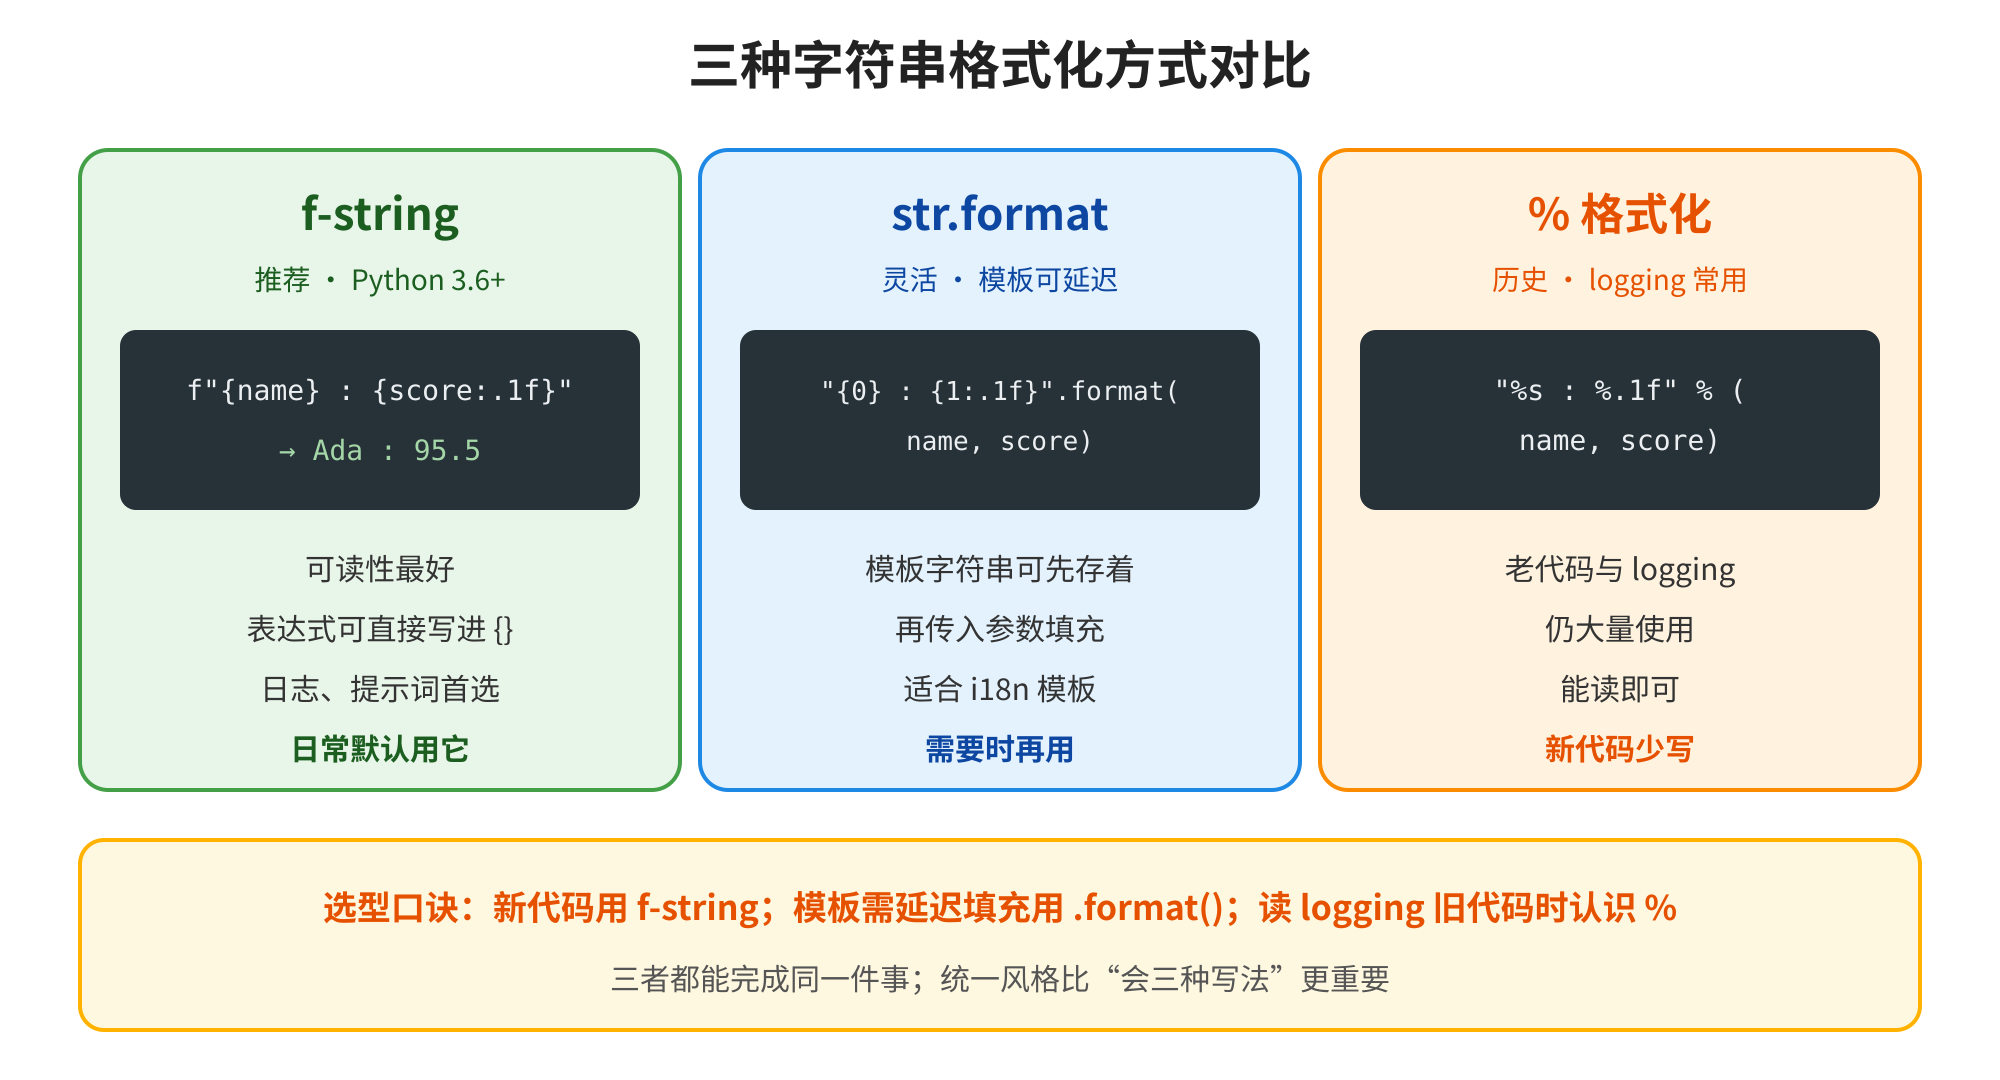
f"{name}: {score:.1f}",示例输出为“Ada : 95.5”,下方说明了它可读性最好、表达式可直接写进{}、支持日志提示词的特点;中间是str.format,标注为灵活但模板可延迟,示例代码为"{0}: {1:.1f}".format(name, score),说明其可先存模板字符串再传参填充,适合i18n模板;右侧是%格式化,标注为历史常用多用于logging,示例代码为"%s: %.1f" % (name, score),特点为读即写、新代码少写。图下方还有选型口诀,总结新代码用f-string、模板需延迟填充用.format()、读logging旧代码时认识%,并强调三者功能一致,统一风格更重要。图4 三种字符串格式化方式对比
5.1 f-string(推荐)
在字符串前加 f,用 {表达式} 嵌入值;可直接写格式说明:
name = "Ada"
score = 95.5
step = 1200
loss = 0.123456789

print(f"{name} scored {score}")
print(f"{name} scored {score:.1f}")       # 一位小数
print(f"step={step:06d} loss={loss:.4f}") # 步数补零,loss 四位小数
print(f"{name:>10} | {score:<8.2f}")      # 对齐
print(f"{0.15:.1%}")                      # 百分比
Ada scored 95.5
Ada scored 95.5
step=001200 loss=0.1235
       Ada | 95.50
15.0%
f-string 里可以调用函数、做简单运算:f"{len(name)} chars"、f"{score/100:.2%}"。调试时(Python 3.8+)还能写 f"{score=}",自动带上变量名——排错很省事:
score = 95.5
threshold = 90
print(f"{score=} {threshold=} passed={score >= threshold}")
score=95.5 threshold=90 passed=True
嵌套引号时留心:外层用了双引号,内层表达式里的字符串就改用单引号,例如 f"name={row['name']}"。表达式里避免过于复杂的逻辑——复杂时先算到中间变量,再放进 f-string,可读性更好,也方便单测。
5.2 str.format 与 % 格式化
当模板需要先保存、稍后再填参数(例如多语言模板)时,用 .format():
template = "{name} scored {score:.1f}"
print(template.format(name="Ada", score=95.5))
print("{0} scored {1:.1f}".format("Ada", 95.5))
Ada scored 95.5
Ada scored 95.5
更老的 % 写法在 logging 模块里仍常见(为了延迟插值、避免没开 DEBUG 时白做格式化):
print("%s scored %.1f" % ("Ada", 95.5))
Ada scored 95.5
读旧代码时能认即可;新业务代码统一 f-string,团队风格会干净很多。
5.3 格式说明速查
| 写法 | 含义 | 例子 |
|---|---|---|
| 小数点后 2 位 | 3.14 | |
| 整数宽 6,不足补 0 | 42 | |
| 右对齐,宽 10 | (左侧补空格) | |
| 左对齐 | (右侧补空格) | |
| 乘 100 后加 % | 15.00% | |
| 科学计数法 | 1.23E+04 |
训练日志里一句很实用的模板:
epoch, step, loss, lr = 3, 1200, 0.123456, 3e-4
print(f"[epoch {epoch}] step={step:6d}  loss={loss:.6f}  lr={lr:.2e}")
[epoch 3] step= 1200 loss=0.123456 lr=3.00e-04
列对齐后,肉眼扫几百行日志会轻松得多。
格式化还有一个实用技巧:把“怎么展示”和“怎么计算”分开。先算好 loss、throughput,再用同一套 f-string 模板打印——这样改精度或字段顺序时只动一处。写推理服务时,也可以把访问日志模板提成常量:
ACCESS_FMT = "{ts}  model={model}  tokens={tokens:4d}  latency_ms={ms:.1f}"
print(ACCESS_FMT.format(ts="10:45:01", model="mini-gpt", tokens=128, ms=23.4))
10:45:01 model=mini-gpt tokens= 128 latency_ms=23.4
这里故意用了 .format:模板是常量、参数后到,正是“延迟填充”的典型场景。若参数在手边且模板很短,f-string 仍然更爽。
六、编码、bytes 与 AI Infra 视角
6.1 UTF-8:文本与字节的桥梁
str 是 Unicode 文本;磁盘、网络上传输的是字节(bytes)。二者之间靠编码(encoding)转换。现代默认编码是 UTF-8:一个 Unicode 字符编码成 1~4 个字节(英文多 1 字节,常用汉字多 3 字节)。
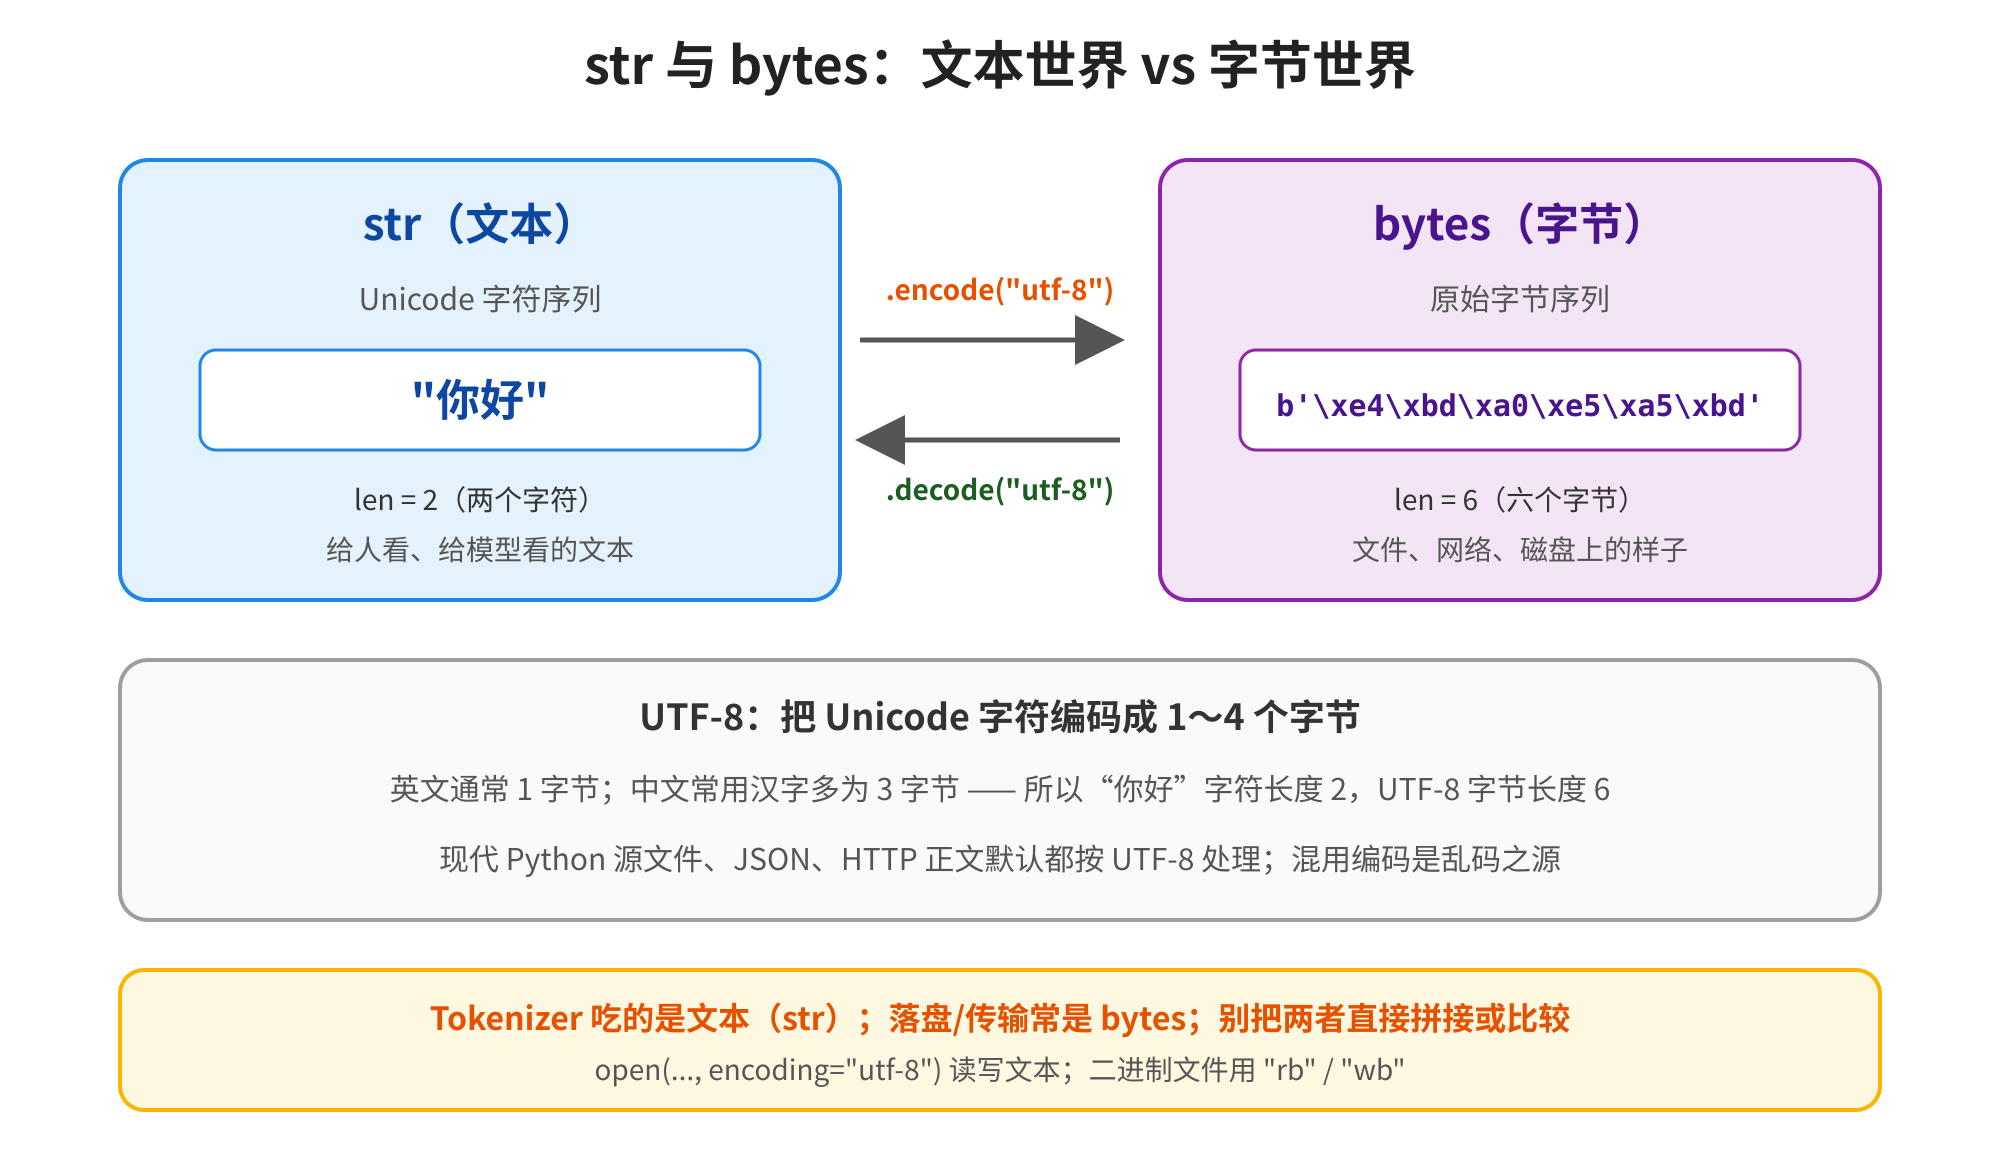
图5 str 与 bytes:文本世界 vs 字节世界
text = "你好"
data = text.encode("utf-8")
print(data)
print(len(text), len(data))     # 字符数 2,字节数 6
print(data.decode("utf-8"))
b'\xe4\xbd\xa0\xe5\xa5\xbd'
2 6
你好
乱码几乎总是“用错编码去 decode”。例如把 UTF-8 字节误用 Latin-1 / GBK 解码,就会看到一串莫名其妙的字符;反过来,用错误编码 encode 再按 UTF-8 读,同样完蛋。团队协作时约定“源代码、配置、数据集、日志全部 UTF-8”,能消灭一大类玄学问题。
读写文本文件时显式写上编码:
# 演示:写了再读(路径按需修改)
from pathlib import Path
p = Path("/tmp/demo_utf8.txt")
p.write_text("你好,Python\n", encoding="utf-8")
print(p.read_text(encoding="utf-8"))
你好,Python
6.2 bytes vs str:不要混用
s = "hi"
b = b"hi"
print(type(s), type(b))
print(s == b)              # False:类型不同
try:
    print(s + b)           # 不能直接拼接
except TypeError as e:
    print(type(e).__name__)
<class 'str'> <class 'bytes'>
False
TypeError
规则很简单:
- 处理语义文本(提示词、日志消息、JSON 字段)→
str; - 处理原始二进制(图片、模型权重文件、socket 缓冲)→
bytes,用"rb"/"wb"开关文件; - 跨越边界时显式
.encode()/.decode(),并写明"utf-8"。
bytes 也支持索引与切片,但索引得到的是 0~255 的 int,不是长度为 1 的 bytes——这和 str 索引得到单字符字符串不同,初学时容易愣一下:
b = "你好".encode("utf-8")
print(b[0], type(b[0]))     # 228 <class 'int'>
print(b[0:3], type(b[0:3])) # 前三个字节,仍是 bytes —— 刚好是“你”
print(b[0:3].decode())
228 <class 'int'>
b'\xe4\xbd\xa0' <class 'bytes'>
你
记住口诀:str 按字符切,bytes 按字节切;单下标对 bytes 取出的是整数。
6.3 AI Infra:token、dtype 与日志格式
把本篇收束到后续会反复用到的三条线上:
(1)Token 与文本。 大模型的 tokenizer 吃的是 str(或已经切好的 token id 列表,元素是 int)。拼接 system / user / tool 消息时用 f-string 或 join;注意不要把未 decode 的 bytes 塞进提示词。统计“这段文本多长”时,分清是字符数(len(s))、UTF-8 字节数(len(s.encode())),还是 token 数(要跑 tokenizer 才知道)——三者不是一回事,计费与上下文窗口看的是 token。
(2)数值 dtype。 Python float 对应双精度;张量里为了省显存常用 float16 / bfloat16,精度更低,误差更大。本篇的 math.isclose 思路在比较低精度张量结果时同样适用:别用严格相等。整数 token id 用 int / int64;量化后还有 int8 等——类型选错会直接导致算子报错或精度崩坏(第 29、37、45 篇展开)。
(3)日志与可观测性。 训练、推理服务要长期盯指标。统一用 f-string(或 logging 的 %/{} 模板)固定字段宽度与小数位,例如 loss={loss:.6f}、lr={lr:.2e}。避免 print(huge_object) 把整段 prompt 或整张 logits 刷屏;需要时截断:f"{text[:80]}..."。Agent 轨迹落盘也建议 UTF-8 JSON 行(JSONL),方便后续回放。
再补一个“字符数 ≠ token 数”的直觉实验(不依赖第三方库也能懂结论):
samples = ["hi", "你好", "KV Cache 很重要"]
for t in samples:
    print(f"text={t!r:16}  chars={len(t):2d}  utf8_bytes={len(t.encode()):2d}")
text='hi'             chars= 2  utf8_bytes= 2
text='你好'           chars= 2  utf8_bytes= 6
text='KV Cache 很重要' chars=13  utf8_bytes=19
英文几乎“一字一字节”;中文常见三字节;而 tokenizer 可能把一个词、一个字或一个子词切成一个或多个 token。做上下文长度与计费时,以模型的 tokenizer 为准,不要用 len(s) 估算硬塞进 4K/8K/128K 窗口。
AI Infra 视角
一句话串起来:文本用 str + UTF-8,计数与 id 用 int,近似量用 float(比较用 isclose),展示用 f-string。 后面做 vLLM / SGLang 服务时,请求体是 UTF-8 JSON,token id 是整数数组,采样温度是 float——本篇的三类对象会同时出现在同一个 HTTP 接口里。
七、踩坑大全
下面这些坑,大多能用三句话归因:“浮点是近似”“字符串不可变”“文本和字节是两个世界”。遇到诡异的相等失败、乱码、TypeError,先回到这三条排查。
7.1 数字类
坑 1:用 == 比较浮点运算结果。 现象:0.1 + 0.2 == 0.3 为 False;测试偶发失败。原因:二进制浮点误差。解决:math.isclose;展示用格式化;精确场景换 Decimal。
坑 2:Decimal(0.1) 而不是 Decimal("0.1")。 现象:明明用了 Decimal 仍不准。原因:参数先经过 float,误差已经进来了。解决:用字符串或整数构造。
坑 3:以为 / 是整除。 现象:7 / 2 得到 3.5,后续代码按 int 用就报错。原因:Python 3 的 / 是真除法。解决:要整数商写 //。
坑 4:负数整除方向与直觉不符。 现象:(-7) // 3 是 -3。原因:向下取整。解决:记住公式,或用 math.trunc / math.floor 按需选择。
7.2 字符串与编码
坑 5:试图修改字符串的某个字符。 现象:s[0] = "A" 抛 TypeError。原因:str 不可变。解决:拼出新串,或先 list(s) 改完再 "".join。
坑 6:循环里用 + 拼超长字符串。 现象:处理大文件/大日志时变慢。原因:每次 + 可能复制整段内容。解决:收集到 list,最后 "".join(parts)。
坑 7:str 与 bytes 混用。 现象:s + b 报 TypeError;比较永远 False;文件读出来“不像字”。原因:类型世界不同。解决:边界上显式 encode/decode,文本模式带 encoding="utf-8"。
坑 8:默认编码依赖平台。 现象:Windows 上写的文件到 Linux 乱码,或反之。原因:历史默认编码不一致。解决:读写文本永远显式 UTF-8;团队约定源文件与数据文件都 UTF-8。
7.3 格式化与日志
坑 9:在 logging 里先 f-string 再传给 logger。 现象:没开 DEBUG 也在做昂贵的字符串拼接。原因:f-string 立即求值。解决:logger.debug("loss=%s", loss) 这种延迟插值;或确认消息很轻再 f-string。
坑 10(Jupyter):单元格里打印了巨大字符串导致界面卡顿。 解决:截断输出,或写到文件再打开;调试张量用 .shape / 小切片,不要直接 print(tensor)。
坑 11:用 len(s) 估算 token 数去截断上下文。 现象:中英文混合时,有时截太短、有时又超窗。原因:字符数、字节数、token 数是三把不同的尺子。解决:截断与计费一律走模型对应的 tokenizer;临时调试可以先按字符粗截,但不要写进生产逻辑。
八、小结
把本篇收成六条可自测的要点。合上文章后,试着用自己的话解释“为什么 0.1+0.2 不等于 0.3”以及“为什么不能改 s[0]”——讲得清,才算真的会了。
- 数字四兄弟:
int(任意精度)、float(IEEE 754,有误差)、bool(int 子类)、complex(少用)。运算多返回新对象。 /真除法,//整除;浮点比较用math.isclose;精确小数用Decimal("..."),精确分数用Fraction。str是不可变 Unicode 序列:索引/切片规则与列表相同;“修改”靠重绑;批量拼接用join。- 格式化优先 f-string;模板延迟填充用
.format();认识%以便读 logging 旧代码。 str↔︎bytes靠 UTF-8 encode/decode;文本与二进制分清世界,文件读写写明编码。- AI Infra 映射:token 文本是 str、token id 是 int、loss/lr 是 float、落盘传输常是 UTF-8 bytes;日志用固定格式的 f-string,比较低精度结果时放宽容差。
若只能带走一句话:整数放心数,浮点防相等,字符串当只读序列,展示交给 f-string,出入边界记 UTF-8。
九、课后练习
- (基础)分别计算
9 / 2、9 // 2、9 % 2、divmod(9, 2),并说明/与//的区别。 - (基础)验证
0.1 + 0.2 == 0.3与math.isclose(0.1 + 0.2, 0.3);再用Decimal("0.1") + Decimal("0.2")得到精确结果。 - (基础)对字符串
s = "AI-Infra",写出s[0]、s[-1]、s[3:]、s[::-1]、s.split("-")的结果。 - (理解)用 f-string 打印一行训练日志:包含
epoch(int)、step(至少 6 位、不足补 0)、loss(小数点后 6 位)、lr(科学计数法)。自己设定数值。 - (理解)解释为什么
Decimal(0.1) + Decimal(0.2)仍然可能不精确,而Decimal("0.1") + Decimal("0.2")可以;写代码证明。 - (理解)对
"机器学习"分别打印字符长度与 UTF-8 字节长度,并说明差在哪里。 - (进阶)写函数
def safe_concat(parts: list[str]) -> str,用join拼接;再对比循环+在拼接 10000 个短串时的耗时差异(可用time.perf_counter)。 - (进阶 · AI Infra)假设 tokenizer 把文本变成
list[int],而日志需要同时记录“原文前 40 字符”和“token 数”。写一段伪代码或真代码,用 f-string 打出一行:tokens=N preview="...",并确保 preview 里的引号或换行不会把日志弄乱(提示:可先.replace("\n", "⏎"))。
下一篇预告
数字与字符串是“标量与文本”的地基;下一篇 《第04篇|列表与元组》 会进入最常用的容器:可变的 list 与不可变的 tuple。你会把本篇的索引/切片规则直接复用到列表上,并看清“可变序列 + 共享引用”如何放大上一篇的别名问题;同时为第 05 篇的字典、第 06 篇的推导式打好序列协议的基础。
专栏一「Python 从零入门」的后续路线:列表与元组(04)→ 字典与集合(05)→ 流程控制(06)→ 函数(07、08)→ 模块与 import(09)→ 文件(10)→ 异常(11)→ 面向对象与数据模型(12~14)。带着本篇的“不可变序列 + 格式化 + UTF-8”,读文件与拼提示词时会顺手很多。