
第06篇|条件、循环与推导式
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 6 篇。把前几篇攒下的对象、数字、字符串、list/tuple、dict/set 串成程序的骨架——用
if做判断,用for/while做重复,用推导式把“映射 + 过滤”写成一行清晰的变换。读完你将能够:熟练书写
if/elif/else;用for遍历可迭代对象、用while做条件驱动循环;正确使用break/continue与循环else;掌握range/enumerate/zip;写出 list/dict/set 推导式,并知道何时该退回普通循环;把控制流映射到配置守卫、batch 处理、词表过滤与采样循环等 AI Infra 场景。预计用时:阅读 35~45 分钟,动手 25~35 分钟。
第 02 篇建立了“名字绑定对象”的心智模型;第 03~05 篇依次装满了数字与字符串、列表与元组、字典与集合。容器会存数据,但程序还不会“想”和“重复”——本篇补上这两块肌肉:条件决定走哪条路,循环决定做多少遍。
你会立刻认出日常脚本里的骨架:读配置时 if cfg.get("debug");扫 batch 时 for sample in batch;建反向词表时 {i: t for t, i in vocab.items()}。下一篇(函数基础)会把这些骨架收进可复用的函数里;本篇先把分支、循环、推导写顺、写对。
建议边读边在 uv run python 里敲。控制流的坑多半不是记不住关键字,而是缩进层级错了、循环条件没更新、推导式里塞了副作用——打印中间变量、故意写一次死循环再 Ctrl+C,比只看文档印象深。
阅读顺序:条件分支 → for 与可迭代直觉 → while 与 break/continue/else → range/enumerate/zip → 三种推导式 → 何时不用推导 + AI Infra 收束。踩坑大全请过一遍,尤其是“空容器上的 for 与循环 else”“可变对象在循环里被改结构”。
也可以先用一张对照表记住控制流分工:if 回答“走哪条路”,for 回答“把已知的东西挨个做完”,while 回答“条件还成立就继续”,推导式回答“把一串数据干净地变成另一串”。训练脚本里四者经常同框——用 if 读开关,用 for 扫 DataLoader,用 while 做采样,用推导抽字段——本篇要把各自的边界讲清楚,避免只会抄模板却在缩进和 else 语义前发懵。
和前几篇一样,原理旁边都配可跑的小实验。你不必一次背完所有写法;更重要的是三张图:分支决策树、for 取出元素的流水线、推导式的源→过滤→映射。有了它们,后面读配置校验、扫词表、写 Agent 工具循环,都只是同一套模型的应用。
一、条件分支:if / elif / else
1.1 最基本的二分
条件语句根据布尔值决定执行哪段代码。最简形式只有 if:
temperature = 0.0
if temperature <= 0:
    print("贪婪解码:几乎总是选概率最高的 token")
print("无论是否进入 if,这行都会执行")
贪婪解码:几乎总是选概率最高的 token
无论是否进入 if,这行都会执行
冒号后面的缩进块(通常 4 个空格)属于该分支。Python 用缩进表达结构,没有花括号——缩进错一级,逻辑就错一层。
条件里常见的是比较运算与逻辑运算:
| 写法 | 含义 |
|---|---|
| a == b / a != b | 相等 / 不等 |
| a < b / <= / > / >= | 大小比较 |
| a and b / a or b / not a | 与 / 或 / 非 |
| x in xs / x not in xs | 成员检验 |
记住:= 是赋值,== 才是比较。写 if score = 90 会直接语法错误,这是好事。
再强调一次缩进:同一层级的语句必须对齐;分支内部比 if 多缩进一级。编辑器若自动混入 Tab,会在别的机器上炸出 TabError。团队项目请统一用空格,并在编辑器里打开“显示空白字符”。
条件可以很复杂,但可读性优先于把一切塞进一行。if a and b and not c: 尚可;再叠三层括号加海象运算符,不如拆成中间变量 ready = ... 再 if ready:。调试时你也能直接打印 ready。
1.2 elif 与 else:多路分支
需要“否则如果……”时用 elif(可以多个),最后兜底用 else:
score = 85
if score >= 90:
    grade = "A"
elif score >= 80:
    grade = "B"
elif score >= 60:
    grade = "C"
else:
    grade = "D"
print(grade)
B
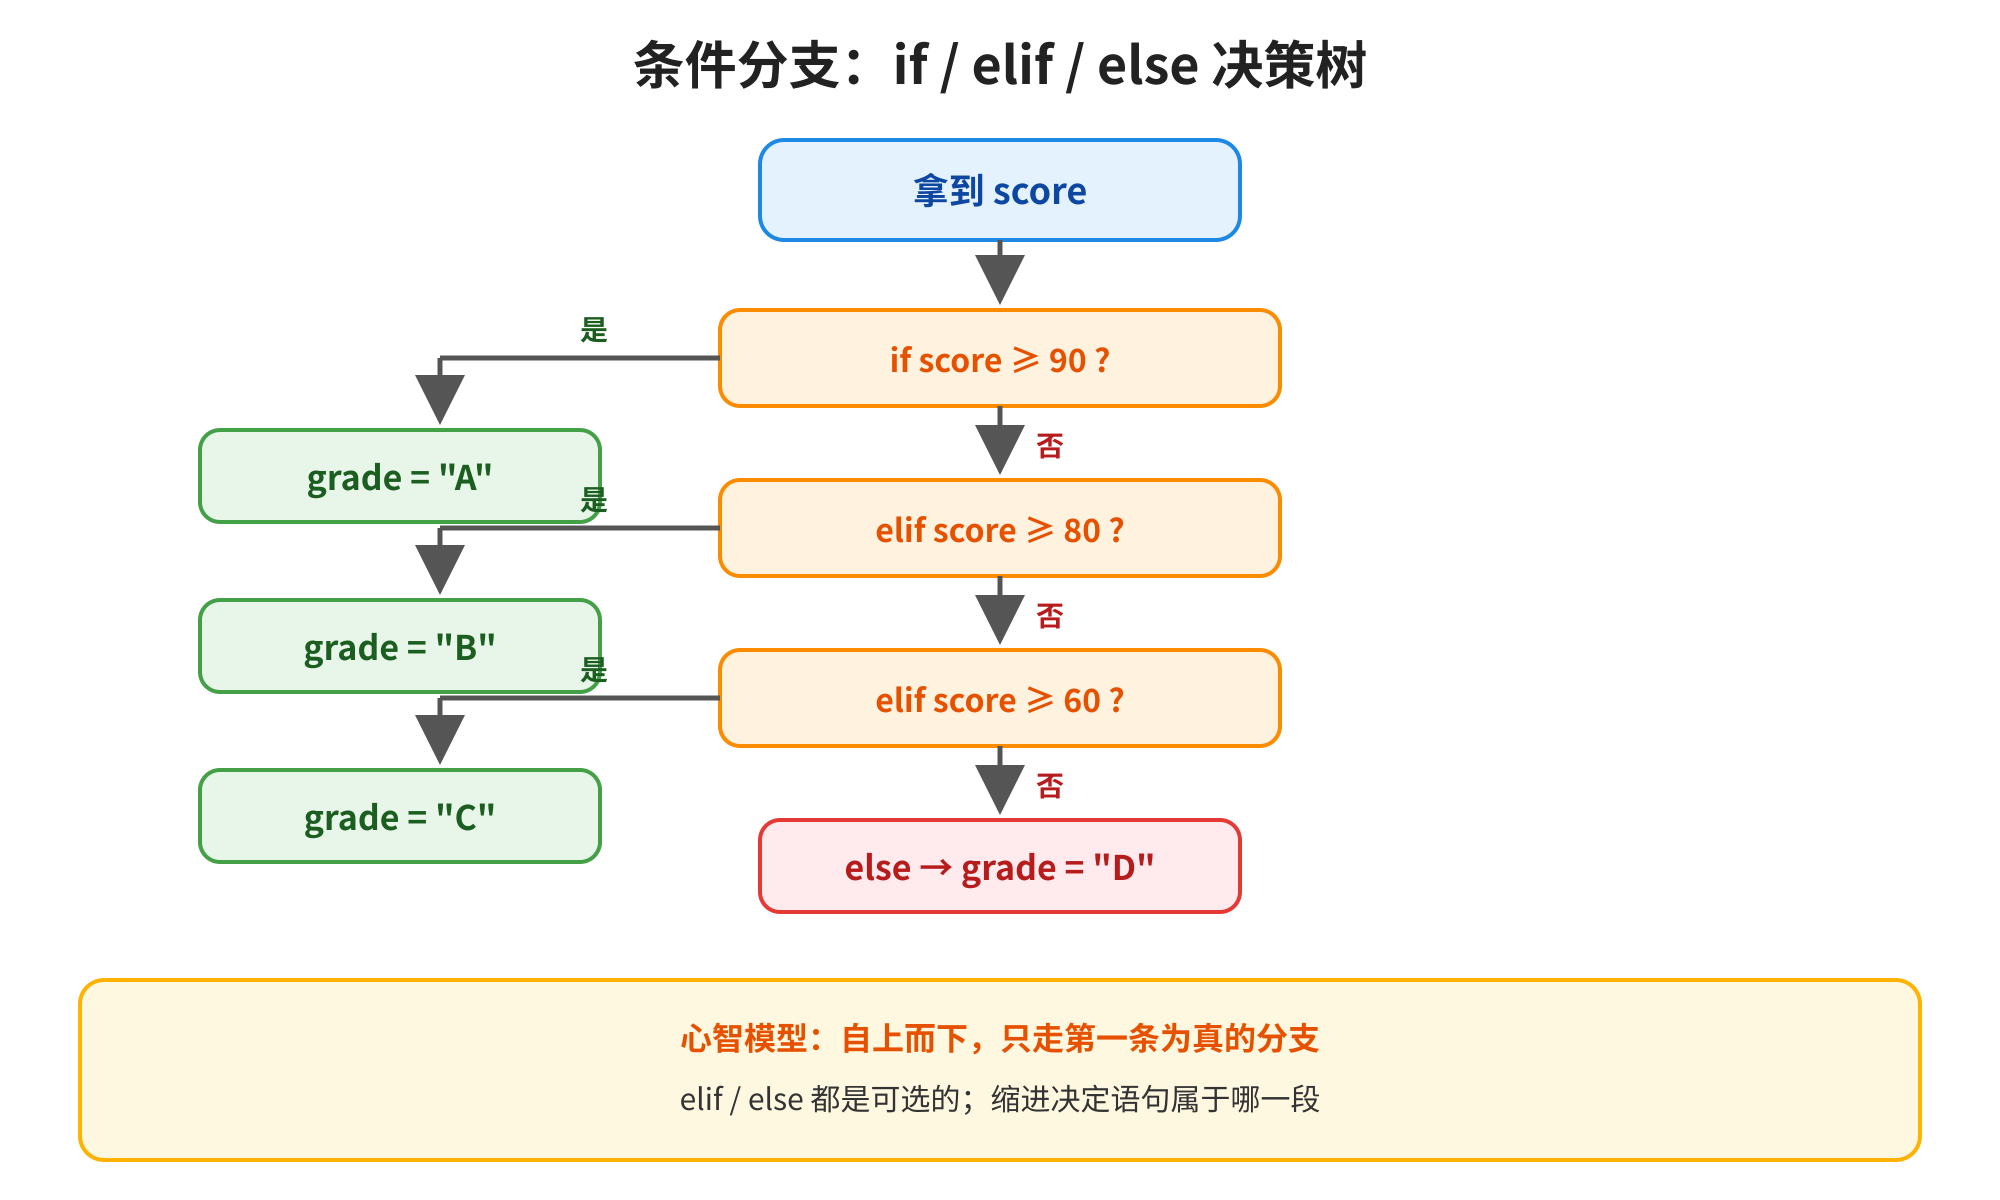
图1 条件分支:if / elif / else 决策树
解释器自上而下检查:第一条为真的分支执行后,后面的 elif/else 全部跳过。所以把更具体、更可能命中的条件放前面,既清晰又略省几次比较。
elif 与 else 都是可选的。只有 if 时,“不满足就什么都不做”;有 else 时,“总有一条路可走”。
多路分支还有一个实务习惯:把互斥且穷尽的情况写全,让 else 真正表示“意外/其它”,而不是默默吞掉一种合法状态。例如模型精度只允许 "fp16"/"bf16"/"fp32",就在 else 里报错,而不是假装走默认路径——配置错误越早暴露越好。
也可以用字典分发代替长串 elif(工具名 → 可调用对象),那是第 05 篇 dict 的用武之地;等第 07 篇有了函数,这种写法会更自然。本篇先把线性分支写稳。
1.3 真值与常见简写
不只是 True/False 能当条件。下列对象在布尔上下文中视为假(falsy):None、False、0、0.0、空字符串 ""、空容器 [] {} set() 等;其余多数为真。
cfg = {"model": "mini-gpt", "layers": 12}
name = ""
batch = [1, 2, 3]

if cfg:                         # 非空 dict → 真
    print("有配置")
if not name:                    # 空字符串 → 假
    print("名字为空,使用默认")
if batch:                       # 非空 list → 真
    print("batch 长度", len(batch))
有配置
名字为空,使用默认
batch 长度 3
生产代码里更稳妥的是显式判断:if cfg.get("debug") is True 或 if len(batch) > 0,避免把 0、空串误当成“没设置”。配置守卫尤其常见:
serve = {"host": "0.0.0.0", "port": 8000, "enable_log": False}
if serve.get("enable_log"):
    print("打开详细日志")
else:
    print("默认安静模式")
默认安静模式
AI Infra 视角
推理服务启动时一堆
if:有没有 GPU、max_batch_tokens是否超上限、是否开启 prefix caching。这些不是“炫技分支”,而是配置守卫——缺字段用get给默认值,非法组合尽早raise(异常留给第 11 篇)。先养成“进热路径前先问清楚”的习惯。
二、for 循环:遍历可迭代对象
2.1 for 不是“数到 N”
许多语言里的 for 从 0 数到 n-1。Python 的 for 更贴近这句话:把可迭代对象里的元素一个个拿出来,绑定到循环变量,执行缩进块。
tokens = ["hello", "world", "!"]
for t in tokens:
    print(t, "→", len(t))
hello → 5
world → 5
! → 1
字符串按字符、字典默认按键、集合按元素(顺序不保证):
for ch in "AI":
    print(ch)

cfg = {"lr": 1e-3, "bs": 32}
for key in cfg:                 # 等价于 for key in cfg.keys()
    print(key, cfg[key])

for key, value in cfg.items():  # 更常用:直接解包键值
    print(f"{key}={value}")
A
I
lr 0.001
bs 32
lr=0.001
bs=32
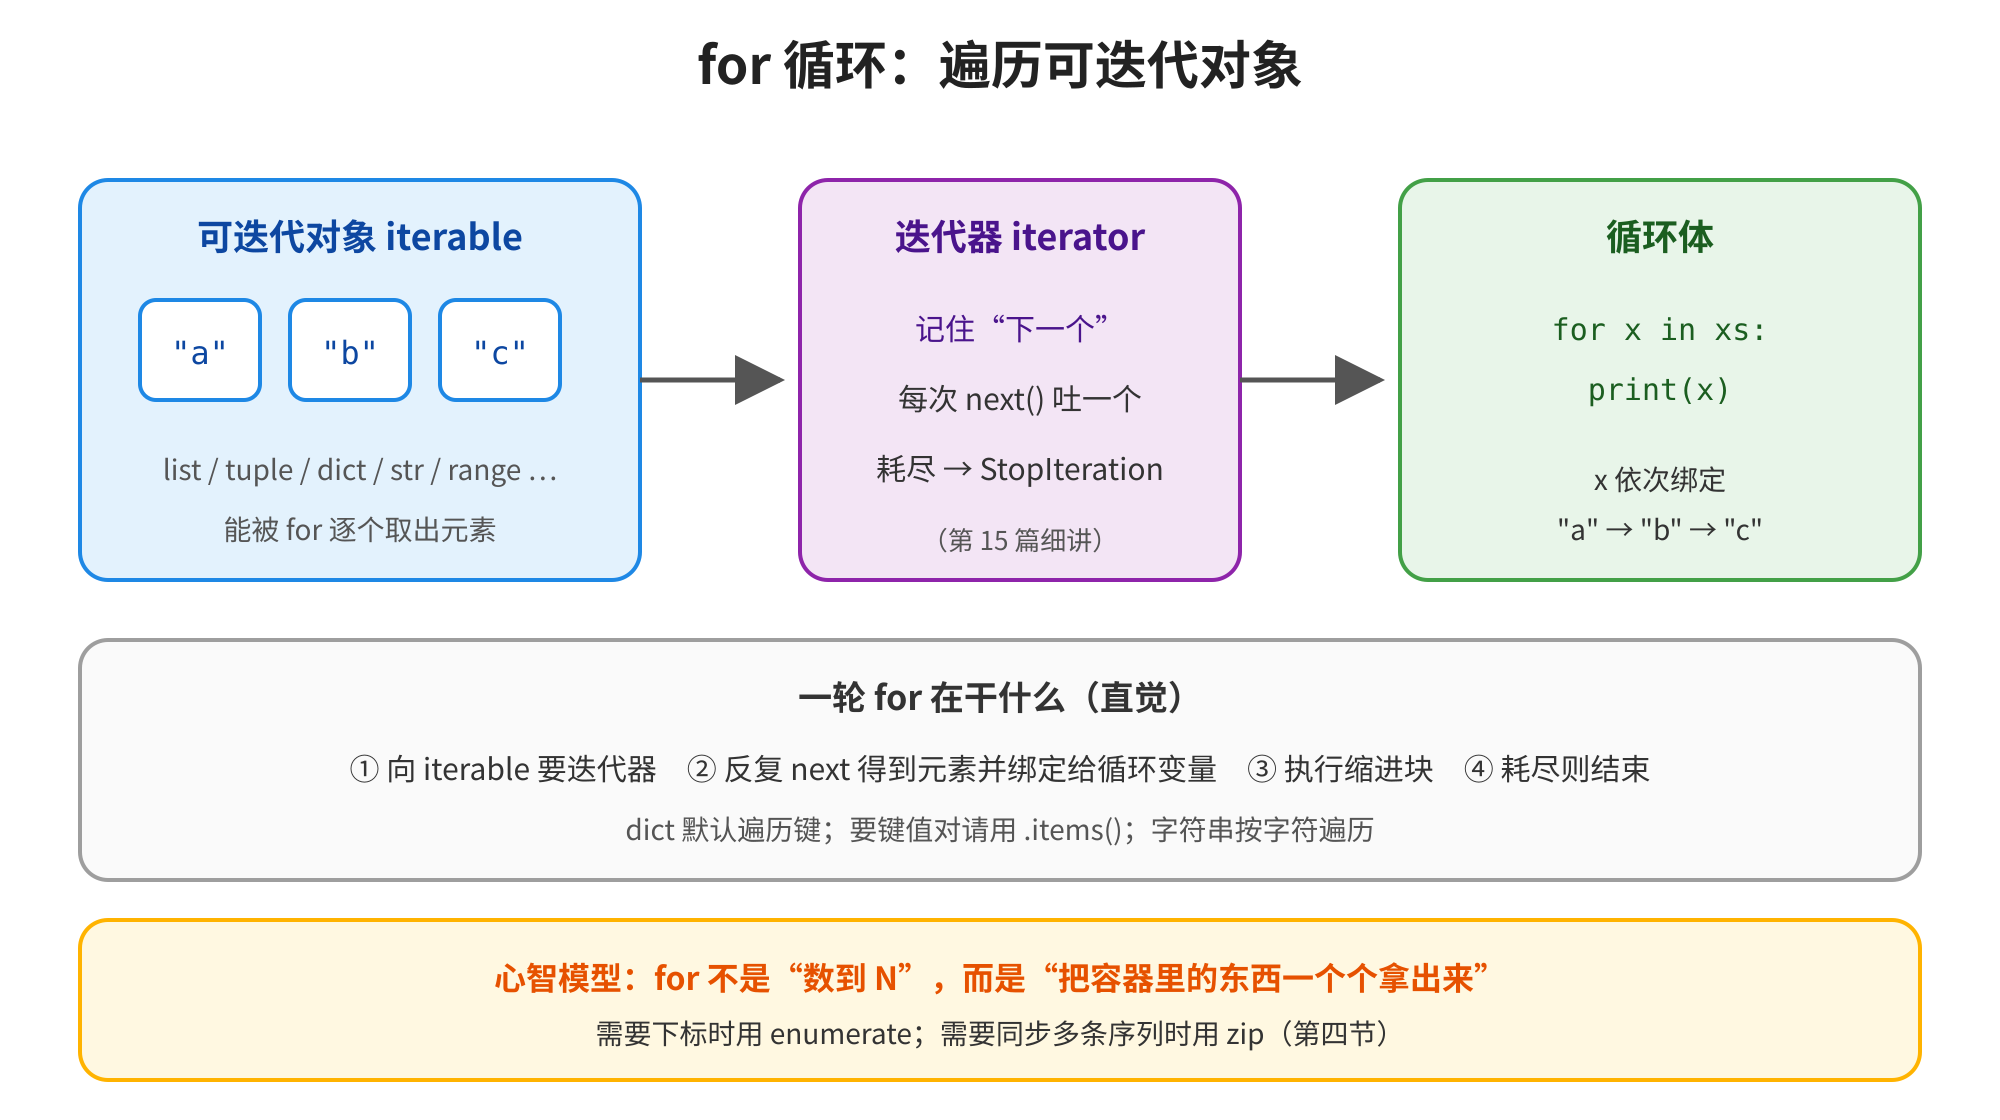
图2 for 循环:遍历可迭代对象
2.2 可迭代与迭代器(直觉版)
第 15 篇会系统讲迭代器协议。本篇只需建立直觉:
for向对象要一个迭代器(iterator);- 反复
next取出元素,赋给循环变量; - 元素耗尽时循环正常结束。
因此 for x in xs 要求 xs 可迭代(iterable)——list/tuple/dict/set/str/range 都是;整数不行:
# for i in 3:  # TypeError: 'int' object is not iterable
for i in range(3):
    print(i)
0
1
2
2.3 嵌套 for 与扁平化直觉
处理“batch 里每条样本、每条里每个 token”时会出现嵌套:
batch = [["hi", "there"], ["ok"]]
flat = []
for seq in batch:
    for tok in seq:
        flat.append(tok)
print(flat)
['hi', 'there', 'ok']
嵌套超过两层就该警惕可读性——后面推导式也能写嵌套,但不等于应该写。能拆成两步(先拉平再映射)往往更清晰。
遍历时还有一个小习惯:循环变量名要表意。for t in tokens、for batch in loader、for k, v in cfg.items() 都比满屏 for i in ... 好读。需要下标时用 enumerate,不要为了“有个 i”就退回 range(len(...))——除非你真的在做交换、填洞等必须按下标写的算法。
空容器上的 for 不会报错,只是循环体一次都不执行。这有时是特性(“没有数据就跳过”),有时是隐患(你以为跑了预处理,其实 list 是空的)。不确定时先 print(len(xs)) 或在上游断言非空。
三、while、break、continue 与循环 else
3.1 while:条件驱动
当“事先不知道要转几圈,只知道何时停”时,用 while:
n = 3
while n > 0:
    print("countdown", n)
    n -= 1                      # 务必更新条件,否则死循环
print("go")
countdown 3
countdown 2
countdown 1
go
采样循环、等待队列非空、失败重试,都是 while 的主场。相对地,已经有 list/range 可枚举时,优先 for——意图更直白。
while True: 加内部 break 也常见,用来表达“先做再判断是否离开”。务必保证每条路径都有退出条件(成功、失败次数用尽、超时),并在注释里写清“什么情况下会停”。在 notebook 里误写死循环时,中断内核即可;在服务器脚本里则可能拖满 CPU——所以提交前至少空跑一遍边界情况。
3.2 break 与 continue
break:立刻离开当前循环(只破一层)。continue:跳过本轮剩余语句,进入下一轮。
for i in range(5):
    if i == 2:
        continue                # 跳过 2
    if i == 4:
        break                   # 到 4 就停,不再看后面
    print(i)
print("after loop")
0
1
3
after loop
注意:break 之后的 4 不会打印;循环外的 after loop 仍会执行——break 只跳出循环,不退出整个程序。
3.3 循环上的 else(常被忽略)
for/while 都可以带 else:仅当循环正常耗尽(没有被 break)时才执行。用来表达“找遍了都没有”非常优雅:
for n in range(2, 6):
    for x in range(2, n):
        if n % x == 0:
            print(n, "不是质数")
            break
    else:
        # 内层 for 没被 break → n 没有因子
        print(n, "是质数")
2 是质数
3 是质数
4 不是质数
5 是质数
把 else 读成“没有被 break 才庆祝”,就不易和 if/else 混淆。
许多人第一次见到循环 else 会别扭,甚至团队规范禁止使用。你可以分两步接纳:先在“搜索”场景用(找到就 break,找不到走 else);再在质数、校验“全部通过”这类例子里体会它的简洁。若同事普遍不熟,改用旗标变量也完全正确——清晰比炫技重要。
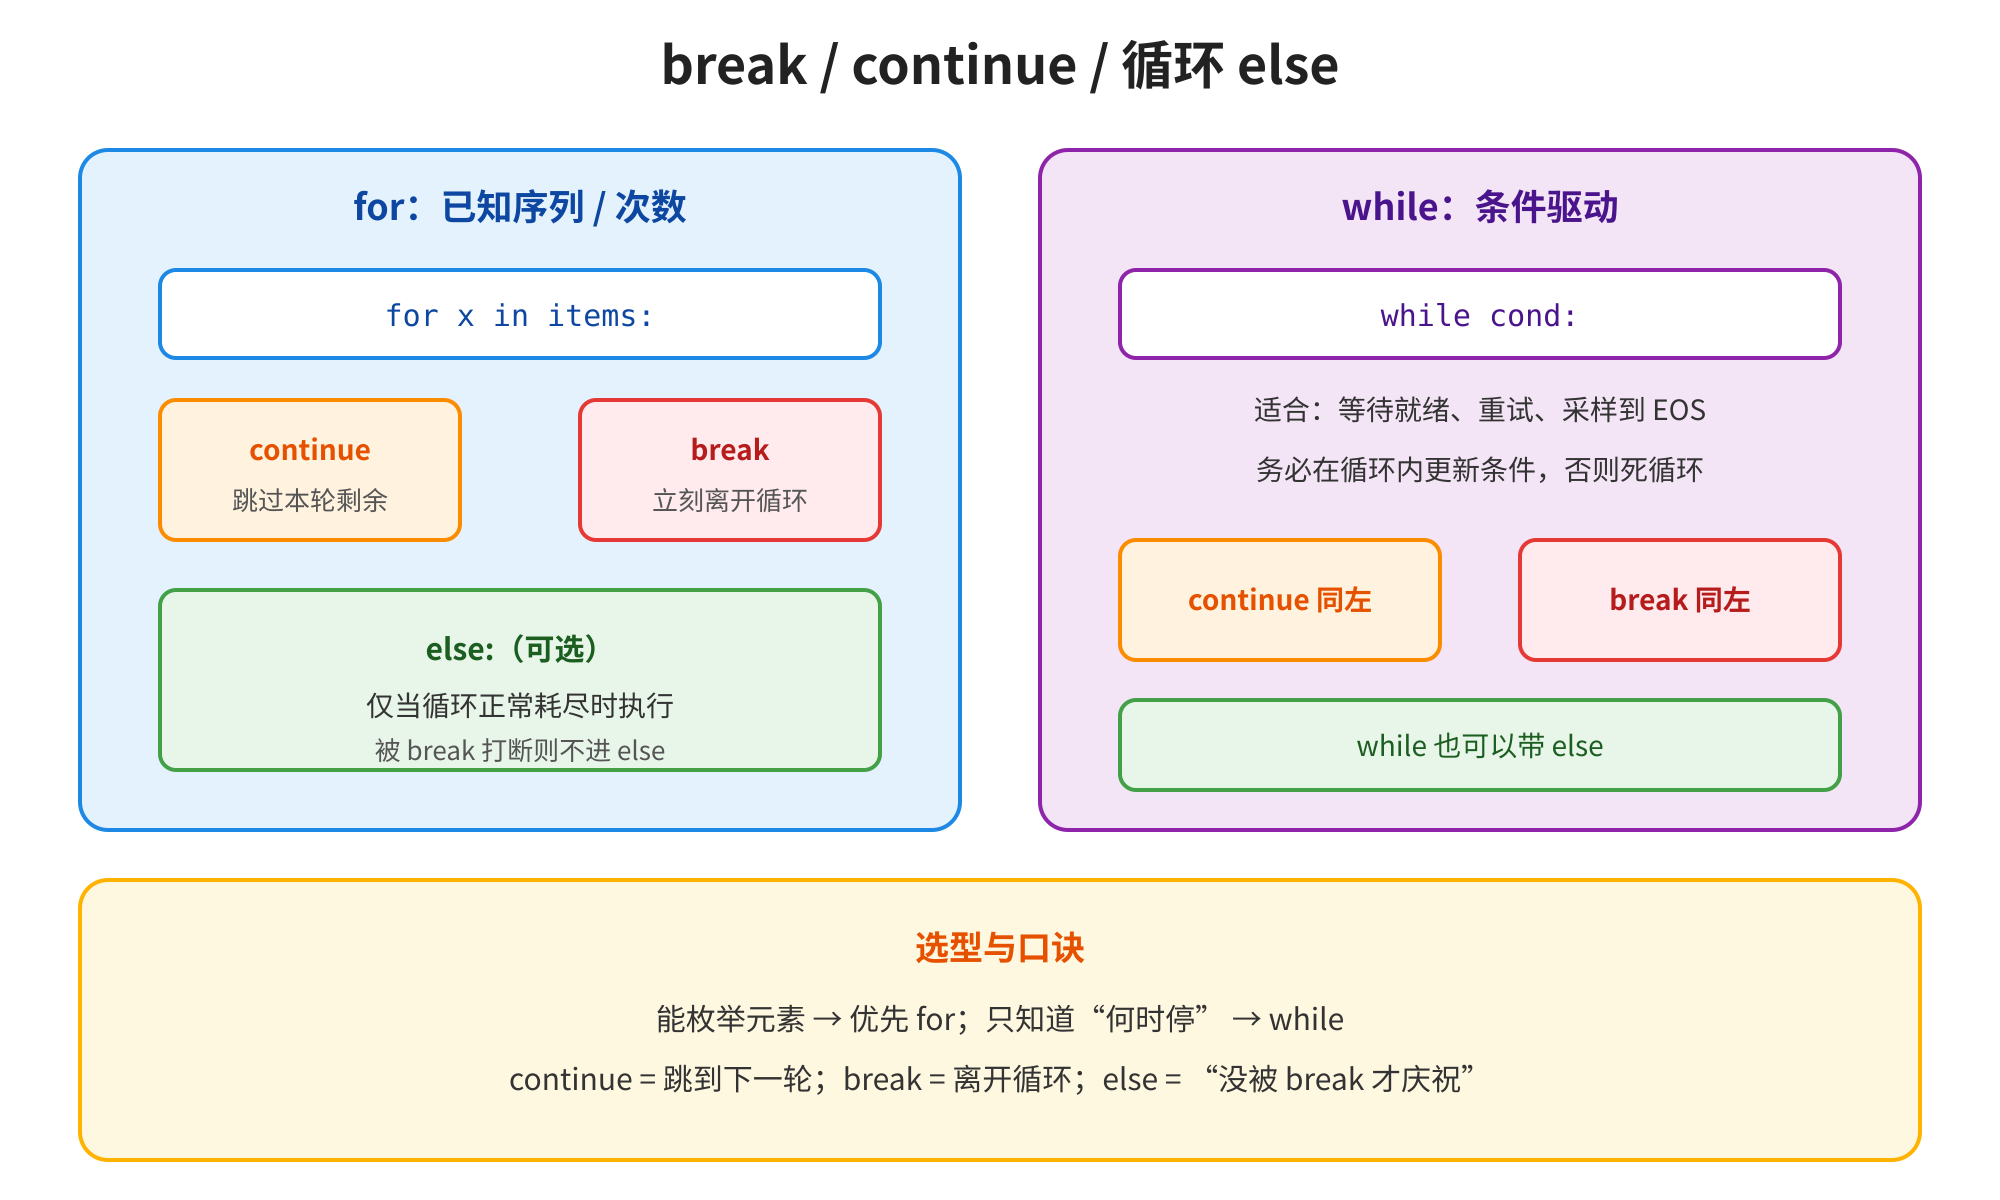
图3 break / continue / 循环 else
AI Infra 视角
自回归采样常是
while:step < max_new_tokens且尚未抽到 EOS 就继续;抽到 EOS 就break。训练则更像for step in range(max_steps)或for batch in dataloader。两种循环形态会在专栏四反复出现——本篇先把语法与break语义钉牢。
四、range、enumerate、zip
4.1 range:懒的整数序列
range(stop) / range(start, stop) / range(start, stop, step) 产生惰性的整数序列,常与 for 联用:
print(list(range(3)))           # 0,1,2
print(list(range(1, 5)))        # 1..4
print(list(range(0, 10, 3)))    # 0,3,6,9
print(list(range(5, 0, -1)))    # 倒序
[0, 1, 2]
[1, 2, 3, 4]
[0, 3, 6, 9]
[5, 4, 3, 2, 1]
半开区间 [start, stop):含头不含尾。这与切片 a[1:5] 一致,是 Python 的统一习惯。
只需要下标、不需要元素时用 range(len(xs)) 可以,但多数情况更推荐下一小节的 enumerate。
4.2 enumerate:同时要下标与元素
names = ["attn", "ffn", "norm"]
for i, name in enumerate(names):
    print(i, name)

for i, name in enumerate(names, start=1):
    print(f"第{i}层模块: {name}")
0 attn
1 ffn
2 norm
第1层模块: attn
第2层模块: ffn
第3层模块: norm
避免手写 i = 0 再 i += 1——那是 C 风格残留,既冗长又易漏改。
4.3 zip:并行遍历多条序列
keys = ["lr", "bs", "epochs"]
vals = [1e-3, 32, 10]
print(list(zip(keys, vals)))
print(dict(zip(keys, vals)))    # 快速拼配置

for k, v in zip(keys, vals):
    print(f"{k} -> {v}")
[('lr', 0.001), ('bs', 32), ('epochs', 10)]
{'lr': 0.001, 'bs': 32, 'epochs': 10}
lr -> 0.001
bs -> 32
epochs -> 10
zip 的长度以最短的那条为准,多出来的元素会被默默丢掉。需要严格等长时,Python 3.10+ 可用 zip(..., strict=True) 在不等长时直接报错——写数据管道时很有用。
| 工具 | 典型用途 |
|---|---|
| range | 固定次数、整数下标、倒序步进 |
| enumerate | 遍历时需要位置编号 |
| zip | 多序列对齐;dict(zip(keys, vals)) |
三者经常组合:for i, (k, v) in enumerate(zip(keys, vals), start=1) 同时拿到编号与键值对。写日志、写对照表时很好用。若序列很长且只想看前几项,可用 itertools.islice(第 19 篇)或先切片——但注意:对迭代器切片和 list 切片语义不同,现阶段对 list 切片即可。
range 本身很省内存:range(10**8) 并不会真的造出一亿个整数对象,只在迭代时产出。这和列表推导一次造齐所有结果形成对比——大数据时“要不要立刻物化成 list”是后面性能话题的伏笔。
五、列表 / 字典 / 集合推导式
5.1 列表推导:映射 + 过滤
把“新建空列表 → for → append”收成一行,叫列表推导式(list comprehension):
xs = [1, 2, 3, 4, 5]
squares = [x * x for x in xs]
evens_sq = [x * x for x in xs if x % 2 == 0]
print(squares)
print(evens_sq)
[1, 4, 9, 16, 25]
[4, 16]
阅读顺序建议:先看 for,再看 if,最后看前面的表达式——对应“源 → 过滤 → 映射”。
等价的展开写法:
evens_sq = []
for x in xs:
    if x % 2 == 0:
        evens_sq.append(x * x)
推导式不是语法糖那么简单:它往往更短、更不易漏写 append,在“纯变换”场景下也更符合 Python 习惯。
还可以在表达式位置使用三元运算:[x if x >= 0 else 0 for x in xs] 表示把负数截成 0。这仍算“映射”,可读性尚可;一旦三元里再套三元,请停手,改成普通循环或小函数(第 07 篇)。
过滤条件只支持 if,没有 elif/else 分支结构——需要多路分类时,用字典分发或普通 for,不要硬拧推导式。
5.2 字典推导与集合推导
xs = [1, 2, 3, 4, 5]
sq_map = {x: x * x for x in xs if x > 2}
letters = {c for c in "banana"}
print(sq_map)
print(sorted(letters))          # set 无序,排序后便于对照
{3: 9, 4: 16, 5: 25}
['a', 'b', 'n']
第 05 篇留下的两道经典菜,现在可以正式上桌:
# 每键独立空列表(避免 fromkeys 共享陷阱)
users = {u: [] for u in ["u1", "u2"]}
users["u1"].append("msg")
print(users)

# 反向词表
vocab = {"<pad>": 0, "hello": 15, "world": 28}
inv_vocab = {i: t for t, i in vocab.items()}
print(inv_vocab[15])
{'u1': ['msg'], 'u2': []}
hello
花括号里有没有冒号,决定是 dict 还是 set:{k: v for ...} vs {expr for ...}。空 dict 是 {},空 set 仍是 set()——与第 05 篇一致。
5.3 嵌套推导:能写 ≠ 该写
matrix = [[1, 2], [3, 4]]
flat = [x for row in matrix for x in row]
print(flat)
[1, 2, 3, 4]
一层嵌套尚可;再套过滤、再套三元表达式,很快变成“只有昨天的自己看得懂”。那时请拆回普通 for,或拆成两步列表推导。
性能微优化上,列表推导通常略快于手写 append 循环,但对可读性的收益更大。千万不要为了“快几个百分点”把业务逻辑压成一行密码。AI Infra 热路径的真正加速来自向量化、算子融合与推理引擎,而不是把 Python 推导写得更短。
六、何时不用推导式,以及 AI Infra 里的循环
6.1 选型口诀
推导式擅长把一串数据变成另一串数据。下列情况请退回普通 for/while:
- 有副作用:
print、写文件、发 HTTP、改全局状态; - 分支复杂:多个
elif、需要break/continue; - 状态累积很绕:中间变量超过两三个,推导式会挤成一团;
- 嵌套过深:两层以上还叠加过滤时,可读性通常更差。
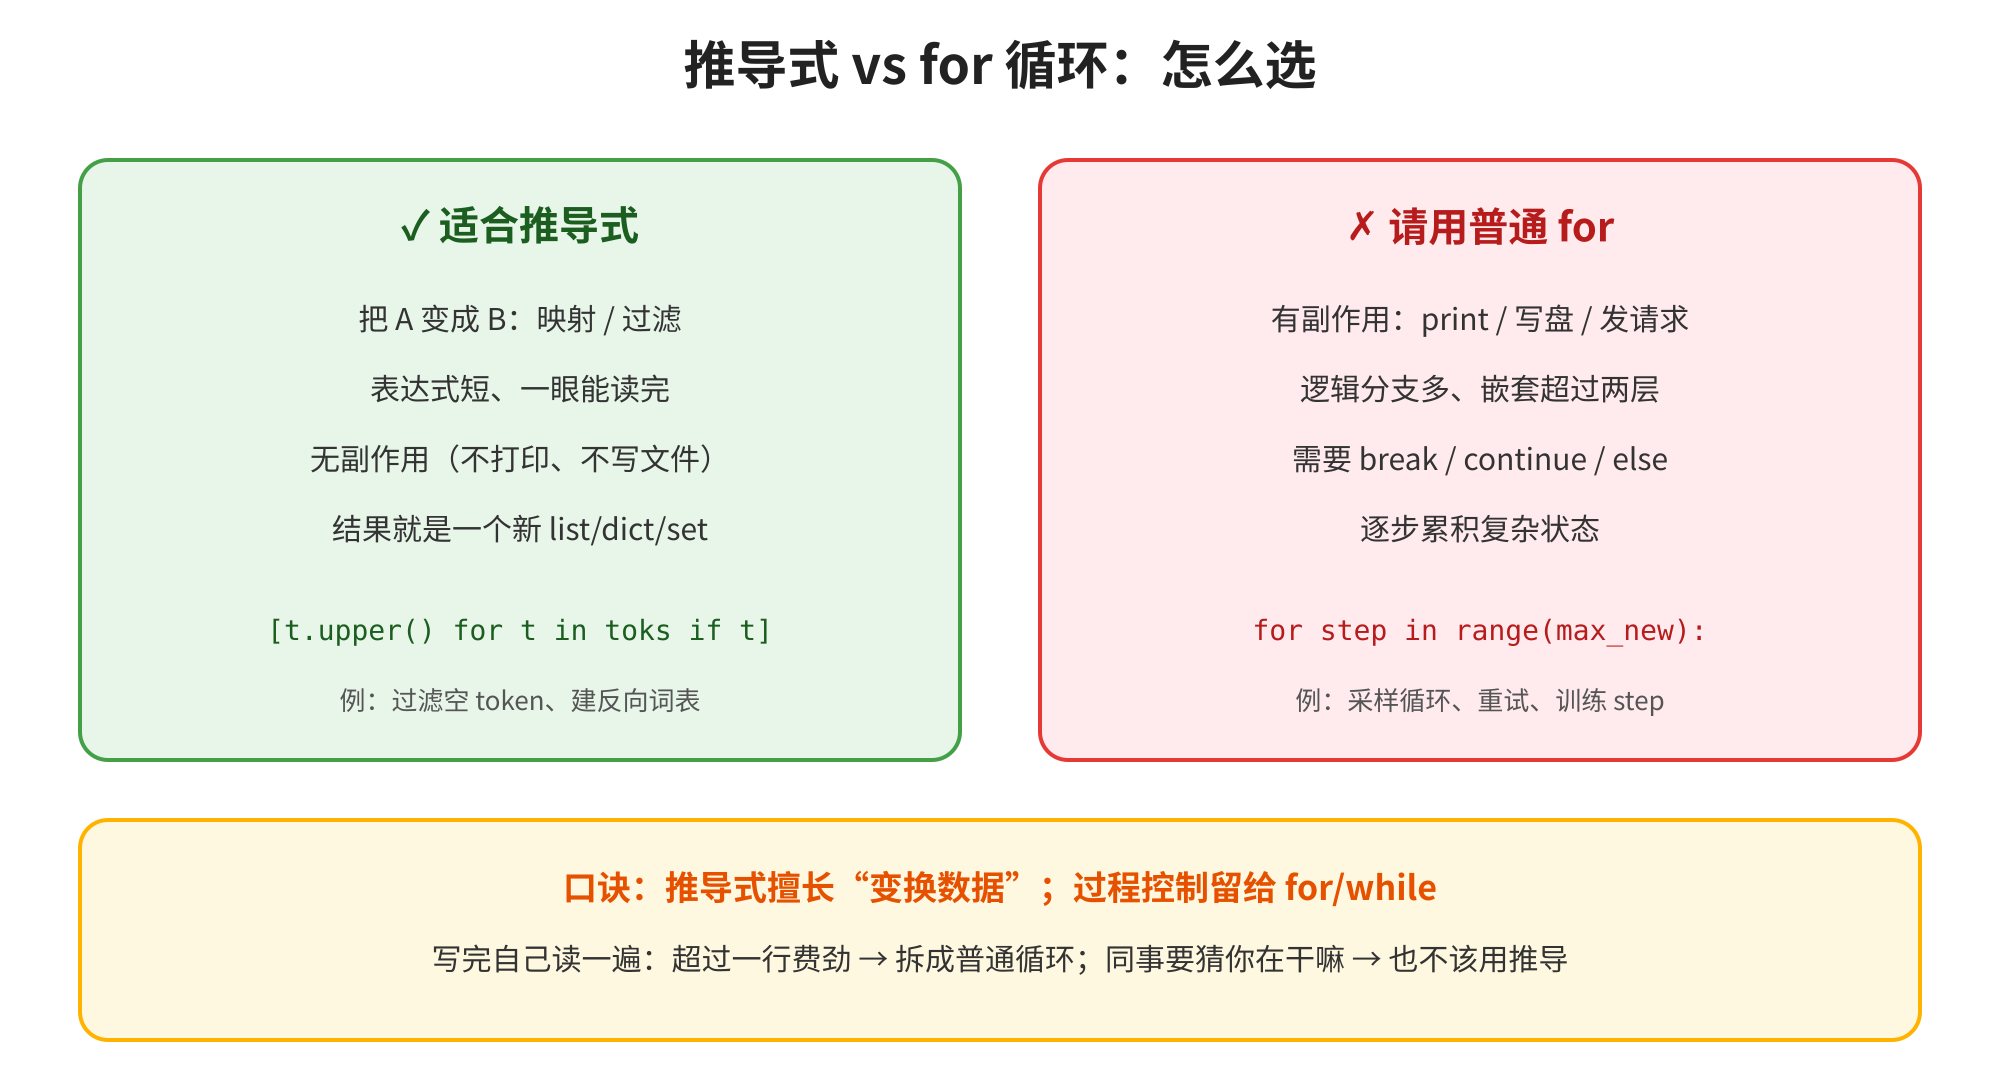
图5 推导式 vs for 循环:怎么选
反例(不要这么写):
# 坏:用推导式只为了 print(有副作用,结果还被丢掉)
_ = [print(x) for x in range(2)]
0
1
正例:副作用用 for;纯变换用推导:
for x in range(2):
    print("log:", x)

logs = [f"log:{x}" for x in range(2)]
print(logs)
log: 0
log: 1
['log:0', 'log:1']
6.2 配置、词表、batch:把前几篇串起来
cfg = {"model": "mini-gpt", "layers": 12, "debug": False}

# 配置守卫
if not cfg.get("model"):
    raise ValueError("model 不能为空")
if cfg.get("debug"):
    print("debug on")

# 词表过滤 + 编码(set 成员检验 + 列表推导)
vocab = {"hello": 1, "world": 2, "<unk>": 0}
stopwords = {"a", "the"}
text = ["hello", "a", "world", "the", "unknown"]
kept = [t for t in text if t not in stopwords]
ids = [vocab.get(t, vocab["<unk>"]) for t in kept]
print(kept, ids)

# batch 字段抽取
batch = [
    {"id": 0, "ok": True,  "loss": 0.4},
    {"id": 1, "ok": False, "loss": 1.2},
    {"id": 2, "ok": True,  "loss": 0.3},
]
ok_ids = [r["id"] for r in batch if r["ok"]]
avg_loss = sum(r["loss"] for r in batch) / len(batch)   # 生成器表达式
print(ok_ids, round(avg_loss, 3))
['hello', 'world', 'unknown'] [1, 2, 0]
[0, 2] 0.633
注意最后一行的 (r["loss"] for r in batch):圆括号包起来的是生成器表达式,惰性、不一次建完整 list。本篇会认、会用即可;原理与 yield 留给第 15 篇。
6.3 采样循环骨架(预习)
max_new = 5
eos_id = 2
generated = []
step = 0
# 假装每次“采样”到的 token id
fake_samples = [7, 9, 2, 8, 4]

while step < max_new:
    tok = fake_samples[step]
    generated.append(tok)
    step += 1
    if tok == eos_id:
        break                       # 遇到结束符提前停
print(generated, "steps=", step)
[7, 9, 2] steps= 3
真实采样要接模型 logits、温度、top-p(专栏四)。这里只要看清:while + break 如何表达“上限步数 + 提前结束”两个条件——这是 Agent 工具循环、推理解码的共同骨架。
Agent 的工具调用循环也可以用同一骨架理解:while step < max_turns: → 模型决定是否调用工具 → 若给出最终答案则 break → 否则执行工具并把结果追加进上下文。细节留给第 28 篇;你现在只需认出:过程控制是 while/for + break,数据变换才是推导式。
再补一个与第 04、05 篇的接头:对 list 做过滤用推导,对 dict 做过滤也一样——{k: v for k, v in cfg.items() if not k.startswith("_")} 可以去掉私有配置键。键存在性判断继续用 in / get;不要在推导里写复杂的网络请求。
AI Infra 视角
- 配置 if-guards:启动前校验端口、dtype、并行度。
- batch / 词表 for 与推导:字段抽取、停用词过滤、
dict(zip)拼超参。- 采样 / Agent while:
break在 EOS 或max_new_tokens;不要用推导式硬写过程控制。- 热路径上百万次纯 Python 循环会慢——后面有 NumPy 向量化与框架算子;先把逻辑写对、写清楚,再谈加速。
七、踩坑大全
下面这些坑,大多能归到三句话:“缩进决定结构”“循环条件要自己更新”“推导式别塞副作用”。遇到死循环、少一轮、或多跑了 else,先回到这三条。
排查时可自问:条件用的是 = 还是 ==?while 循环变量有没有更新?else 挂在 if 上还是挂在 for 上?推导式里有没有 print?zip 两侧长度一致吗?五问下来,十之八九能定位。
7.1 条件与缩进
坑 1:= 写成了比较。 现象:SyntaxError。原因:条件里需要 ==。解决:比较用 ==,成员用 in。
坑 2:缩进混用 Tab 与空格。 现象:TabError 或逻辑所属分支错乱。解决:统一 4 空格;编辑器显示空白字符。
坑 3:把 0、空串当成“未设置”。 现象:if port: 在 port=0 时误入假分支。解决:对可能为 0 的值用 if port is None 或 if "port" not in cfg。
坑 4:链式比较看走眼。 现象:误以为 a == b == c 非法。其实 Python 支持链式比较;但 a < b > c 虽合法、可读性差,建议拆开写。
7.2 循环控制
坑 5:while 条件永不更新。 现象:死循环,CPU 空转。解决:循环体内修改条件变量,或设置最大重试次数后 break。
坑 6:在遍历的 list/dict 上增删元素。 现象:漏元素、RuntimeError: dictionary changed size during iteration。解决:遍历副本 for x in list(xs):,或先收集再二次处理(第 05 篇已强调)。
坑 7:误用循环 else。 现象:以为 else 是“循环失败才走”。原因:语义是“未被 break 才走”。解决:用“没被 break 才庆祝”记忆;不确定就改成旗标变量。
坑 8:break 只破一层。 现象:嵌套循环里 break 后外层还在跑。解决:抽成函数后 return;或用旗标;或改数据结构避免深嵌套。
7.3 推导式与工具函数
坑 9:用列表推导执行副作用。 现象:代码难读,还多建一个用不到的 list。解决:有 print/IO 就写普通 for。
坑 10:忘记 zip 按最短截断。 现象: 静默丢数据。解决:先断言等长,或 zip(..., strict=True)(3.10+)。
坑 11:range 含头不含尾搞错。 现象:少循环一次。解决:记住与切片一致;需要 1..N 用 range(1, N+1)。
坑 12:对 dict 写 {v: k for k, v in d.items()} 时值不唯一。 现象:反向映射丢键。原因:dict 键唯一,重复值会覆盖。解决:确认值唯一,或改成 defaultdict(list) 收集。
7.4 环境与性能
坑 13(Jupyter):改了循环却用旧变量继续跑。 现象:输出对不上代码。解决:重跑定义单元格,或重启内核。
坑 14:热循环里反复 x in big_list。 现象:越来越慢。解决:先转 set 再判断(第 05 篇);过滤场景可写成 [x for x in xs if x not in stop_set]。
坑 15:海量数据用纯 Python 双重循环。 现象:训练前处理要跑几十分钟。解决:逻辑正确后,迁移到 NumPy/Pandas 向量化(专栏三);本篇先保证正确与可读。
# 安全删除示例:先拷贝键
d = {"a": 1, "b": 0, "c": 3}
for k in list(d):
    if d[k] == 0:
        del d[k]
print(d)
{'a': 1, 'c': 3}
八、小结
合上文章后,试着用自己的话解释:“for 在遍历什么”以及“循环 else 什么时候执行”——讲得清,才算真的会了。
if/elif/else:自上而下一分支命中即走;缩进定结构;配置用get+ 显式判断更稳。for:遍历可迭代对象,不是“数到 N”;dict 用.items()解包键值。while+break/continue:条件驱动与提前离开;循环else= 未被 break 才执行。range/enumerate/zip:次数与下标、带编号遍历、多序列对齐(注意最短截断)。- 推导式:
[映射 for x in 源 if 过滤],同理{}可做 dict/set;擅长纯数据变换。 - AI Infra 映射:配置守卫用 if;batch/词表用 for 与推导;采样与 Agent 用 while+break;有副作用或复杂控制时不要硬写推导式。
把故事连起来:容器存数据(02~05)→ 条件选路、循环重复(本篇)→ 下一篇把这些收进函数,形成可复用的积木。
本篇的技能会立刻复利:第 07 篇函数体里全是 if/for;第 10 篇按行处理文件是 for;第 28 篇 Agent 循环是 while;专栏四的训练步与解码步还是这两种形态。先把语义练准,比急着背标准库函数名更划算。
若只能带走一句话:能枚举元素用 for,只知何时停用 while;纯变换用推导,过程控制用普通循环。
再留一个自测:默写一个带 break 的质数 for-else,再写一行字典推导生成 inv_vocab。两题都顺,本篇就站稳了。
九、课后练习
- (基础) 写一段脚本:输入
score=72,用if/elif/else打印等级A/B/C/D(阈值与第一节相同)。 - (基础) 用
for遍历字符串"SGLang",打印每个字符及其enumerate下标(从 0 开始)。 - (基础) 用
while计算1+2+…+100的和并打印;再改成sum(range(1, 101))对照。 - (理解) 解释下面代码为何打印
找不到,若把break去掉会怎样;改写为不用循环else、改用旗标变量的版本。
target = 7
for x in [1, 3, 5]:
    if x == target:
        print("找到了")
        break
else:
    print("找不到")
- (理解) 给定
keys=["a","b","c"]、vals=[1,2],分别演示普通zip与(若环境 ≥3.10)zip(..., strict=True)的行为差异。 - (理解) 用三种推导式:从
["Hello", "", "World", "AI"]得到非空小写列表;得到首字母到原词的 dict;得到字符种类的 set(可先"".join(...))。 - (进阶) 嵌套列表
batch = [["a","b"],["a","c"],["b"]]:用推导式得到去重后的词表 list(保持首次出现顺序,提示:dict.fromkeys),再构建vocab/inv_vocab两个 dict,打印encode(["a","c","x"])(未知词映射到<unk>,需先登记)。 - (进阶 · AI Infra) 模拟采样:
fake_logits_choice = [3, 1, 5, 2, 9],eos_id=2,max_new=4。用while生成 id 列表,遇 EOS 或达上限停止;再用列表推导把 id 映射成字符串标签(自建一个小id2tok)。打印生成序列与实际步数。额外:把“有副作用的打印”放在普通 for 里,不要写进推导式。
下一篇预告
条件、循环与推导式解决了“怎么判断、怎么重复、怎么变换”;下一篇 《第07篇|函数基础:参数、返回值、作用域(LEGB)》 会把这些逻辑收进函数:怎么定义与调用、位置参数与默认参数、返回值与 None、以及名字在局部/全局如何查找(LEGB)。本篇的 if/for/推导会立刻成为函数体里的日常。
专栏一「Python 从零入门」的后续路线:函数基础与进阶(07、08)→ 模块与 import(09)→ 文件(10)→ 异常(11)→ 面向对象与数据模型(12~14)。带着本篇的控制流直觉,读训练循环、采样循环和 Agent 工具循环时,会先看懂骨架再钻细节。
若你想提前热身:打开第 05 篇的词表例子,改写成“停用词 set + 列表推导编码”;再写一个最多 8 步的假采样 while。两道小练习做完,下一篇谈函数时你会带着具体素材,而不是空壳语法。