
第07篇|函数基础:参数、返回值、作用域(LEGB)
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 7 篇。把第 06 篇练熟的
if/for/推导式收进可复用的积木——用def定义函数,理清参数与实参、返回值与None,建立 LEGB 作用域心智模型,并看清调用栈如何一进一出。读完你将能够:独立书写带参数与默认值的函数;区分位置参数与关键字参数;正确使用
return(含多返回与隐式None);写简短 docstring;按 LEGB 解释名字从哪来;谨慎使用global/nonlocal;把配置工厂、预处理步骤、batch 工具写成小函数,为第 08 篇的*args/**kwargs、闭包与lambda打底。预计用时:阅读 35~45 分钟,动手 25~35 分钟。
第 02 篇讲过:名字绑定对象,函数名也不例外——def 执行后,名字指向一个函数对象。第 06 篇让程序会判断、会重复;但若同一段校验配置、清洗 token、抽 batch 字段的逻辑复制三遍,改一处漏两处,脚本很快腐烂。本篇的解药很朴素:把“怎么做”写进函数,把“对谁做”写成参数。
你会在训练脚本、推理服务和 Agent 工具循环里反复见到函数:load_config()、tokenize(text)、encode(tokens)、sample_next(logits)。下一篇(函数进阶)会讲可变参数、闭包与 lambda;本篇先把定义、调用、返回、作用域写稳,避免还没学会 *args 就先踩进可变默认参数和“局部变量未绑定”的坑。
建议边读边在 uv run python 里敲。函数相关的困惑多半不是记不住 def,而是搞混了形参与实参、以为没写 return 会报错、改了全局名却忘了 global——每节都有可跑的小实验,改参数、看栈、打印 id,比只看语法表记得牢。
阅读顺序:函数长什么样 → 参数三种传法 → 返回值与 docstring → 调用栈直觉 → LEGB 与 global/nonlocal → AI Infra 里的小函数设计。踩坑大全请过一遍,尤其是“可变默认参数”和“函数内赋值会让名字变局部”。
和前几篇一样,原理旁边配可跑代码与预期输出。你不必一次背完所有规则;先抓住三张图:定义与调用的对应、调用栈的进出、LEGB 四层查找。有了它们,后面读装饰器、生成器、Agent 工具注册,都是同一套模型的延伸。
也可以先用一句话定心:函数 = 有名字的代码块 + 输入(参数)+ 输出(返回值)+ 自己的局部命名空间。本篇把这句话拆开讲透。
和“脚本从上往下执行”相比,函数带来的最大变化是:执行流会跳进一块代码,跑完再跳回来,并且每次跳进都带着自己的局部名字。弄清这件事,后面看装饰器、生成器、异步函数时才不会觉得魔法凭空出现。
一、定义与调用:函数也是对象
1.1 为什么要把逻辑收进函数
没有函数时,重复逻辑只能复制粘贴:
text_a = "  Hello  "
text_b = " World\n"
clean_a = text_a.strip().lower()
clean_b = text_b.strip().lower()
print(clean_a, clean_b)
hello world
两行还好;若清洗规则变成“去空白 → 小写 → 去停用词 → 截断长度”,复制十处就灾难了。函数让你改一处,处处生效:
def normalize(text):
    return text.strip().lower()

print(normalize("  Hello  "), normalize(" World\n"))
hello world
AI Infra 视角
数据处理流水线本质是一串可复用步骤:读配置 → 校验 → tokenize → 组 batch → 前向。每一步写成函数,既可以单独单测(第 22 篇),也可以在 Agent 里当“工具”注册。先养成“一段有名字的意图就抽函数”的习惯,比过早追求框架更重要。
1.2 最简 def:定义、调用、文档串
def greet(name):
    """返回一句问候。"""
    return f"你好, {name}"

msg = greet("SGLang")
print(msg)
print(greet)                 # 函数对象本身
print(callable(greet))       # 可否调用
你好, SGLang
<function greet at 0x...>
True
拆开看:
| 部分 | 含义 |
|---|---|
| def greet(...) | 定义函数,名字 greet 绑定到函数对象 |
| name | 形参(parameter):定义时声明的名字 |
| """...""" | docstring:函数文档,可被 help(greet) 读到 |
| return ... | 把值交还给调用方,并立刻离开函数体 |
| greet("SGLang") | 调用;"SGLang" 是实参(argument) |
注意:def 语句执行时才创建函数对象(第 02 篇:名字绑定对象)。若 def 写在 if 里且条件为假,那个名字根本不会存在。
初学者常问:“函数要写在调用前面吗?”——对模块顶层的普通写法,是的,先定义再调用,因为 Python 是解释执行:跑到调用那一行时,def 必须已经执行过。把工具函数集中放在文件前部或单独模块(第 09 篇),是常见工程习惯。
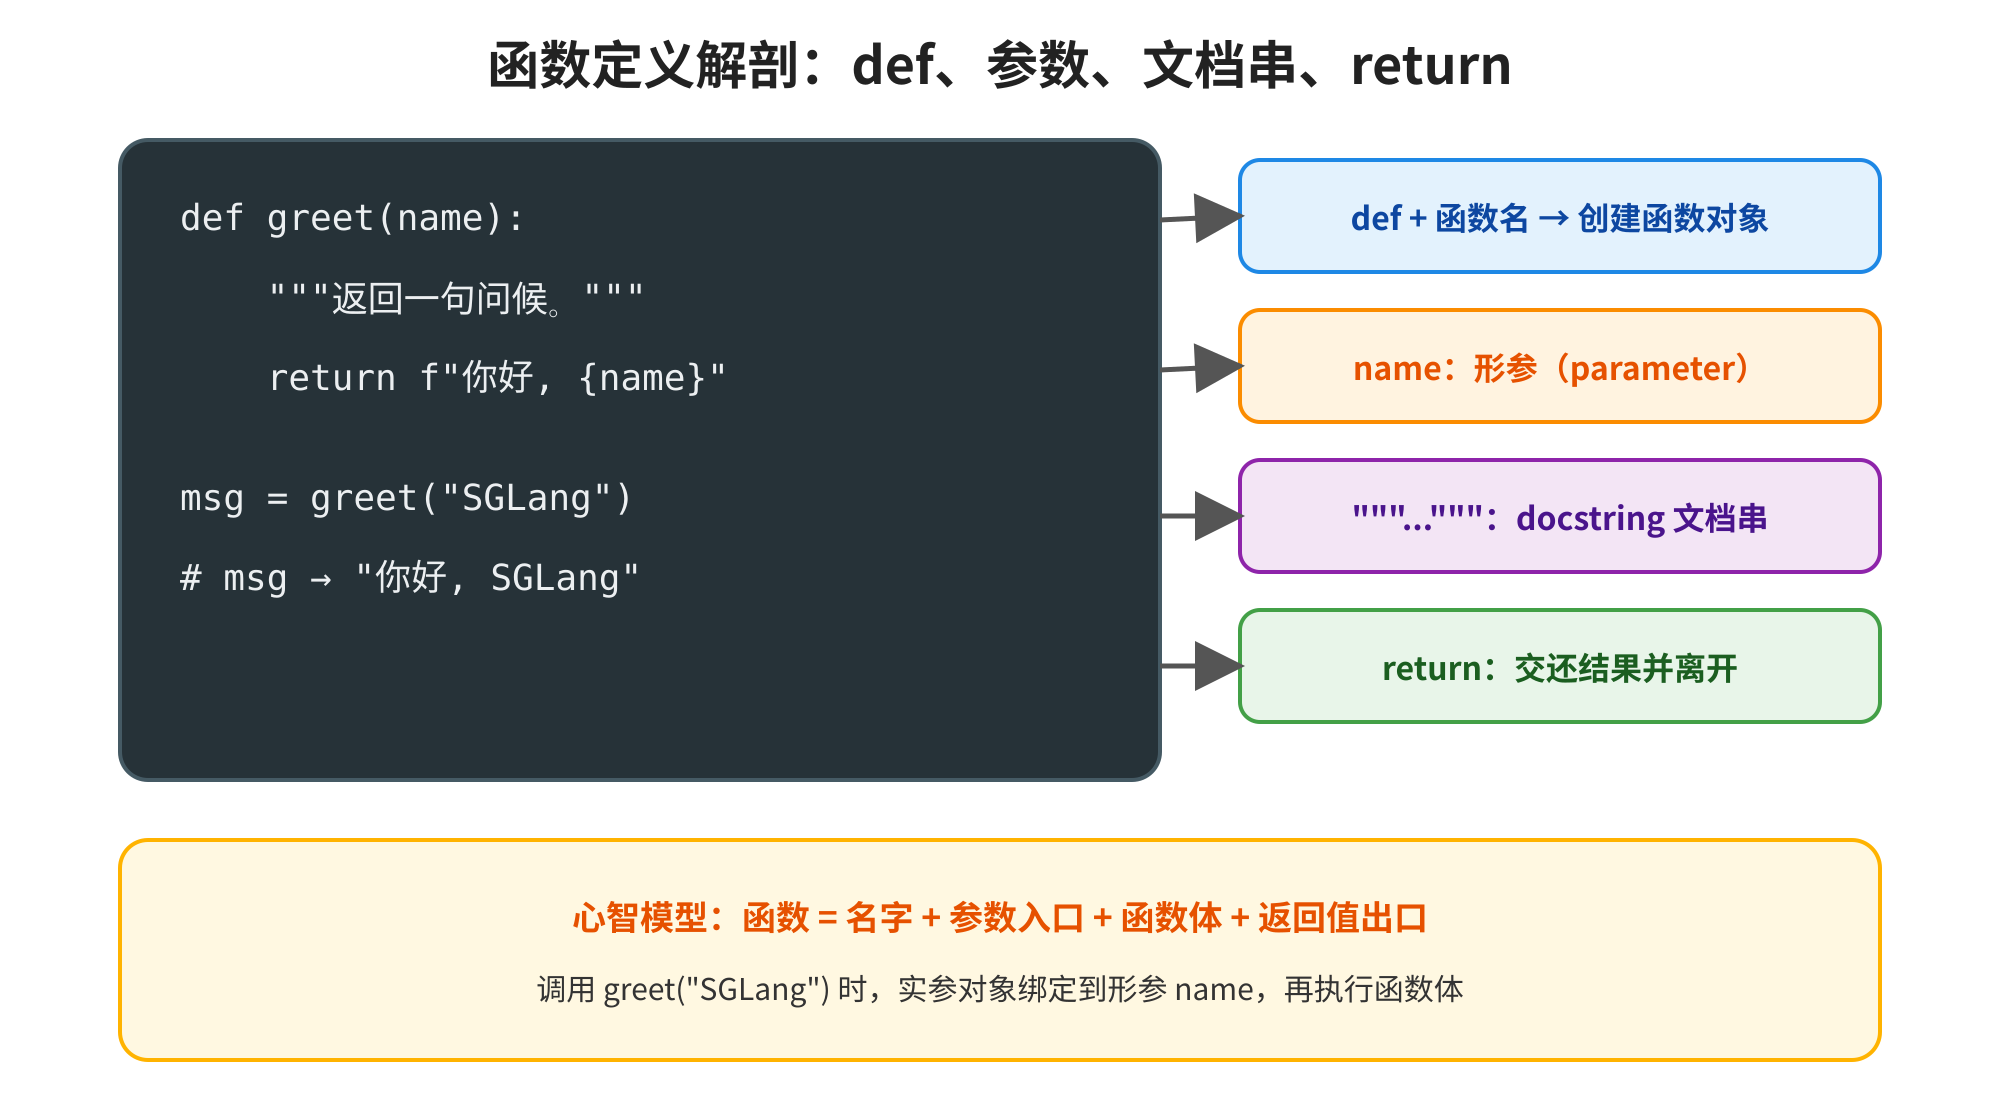
图1 函数定义解剖:def、参数、文档串、return
1.3 函数是一等对象(呼应第 02 篇)
函数可以赋值给别的名字、放进 list/dict、当作参数传递——这是后面装饰器、回调、工具注册的基础:
def add(a, b):
    return a + b

op = add
print(op(2, 3))

ops = {"add": add, "mul": lambda x, y: x * y}   # lambda 细节见第 08 篇
print(ops["add"](10, 5), ops["mul"](10, 5))
5
15 50
第 05 篇用 dict 做分发时预告过“工具名 → 可调用对象”;现在你有了真正可放进字典的函数。lambda 只是匿名小函数,本篇能认即可,系统讲法留给下一篇。
这也解释了为什么 AI Agent 框架喜欢“注册工具”:底层往往是一个名字到函数的映射表,模型返回工具名后查表调用。你现在用字典手动注册,和后面用装饰器注册,心智模型是同一条河。
二、参数与实参:位置、关键字、默认值
2.1 形参 vs 实参
- 形参:写在
def括号里,是函数内部的局部名字。 - 实参:写在调用括号里,是传进去的对象(更准确:传入的是引用,见第 02 篇)。
def square(n):          # n 是形参
    return n * n

x = 4
print(square(x))        # x 的值(指向的对象)作为实参传入
16
调用时发生的事可以记成:实参对象被绑定到对应形参名,然后执行函数体。对可变对象(list/dict)而言,函数内若原地修改,调用方能看见——因为共享同一对象。对不可变对象(int/str/tuple)“改形参”只会让形参改绑到新对象,不影响外面的名字。
def append_unk(tokens):
    tokens.append("<unk>")      # 原地修改同一个 list

ids = ["hello"]
append_unk(ids)
print(ids)
['hello', '<unk>']
这不是“传值 / 传引用”的口号能概括的;用第 02 篇的话说:传的是对象的引用,名字绑定规则照旧。
2.2 位置参数与关键字参数
按位置对齐,叫位置参数;写明 名字=值,叫关键字参数:
def encode(text, max_len):
    text = text[:max_len]
    return text, len(text)

print(encode("hello-world", 5))           # 全位置
print(encode(text="hello-world", max_len=5))  # 全关键字
print(encode("hello-world", max_len=5))   # 混合:位置在前,关键字在后
('hello', 5)
('hello', 5)
('hello', 5)
规则要点:
- 位置实参必须出现在关键字实参之前;
- 每个形参最多被赋值一次(不能既按位置又按关键字重复传);
- 关键字实参的次序可以打乱,可读性往往更好。
def serve(host, port, debug):
    return f"{host}:{port} debug={debug}"

print(serve(port=8000, host="0.0.0.0", debug=False))
0.0.0.0:8000 debug=False
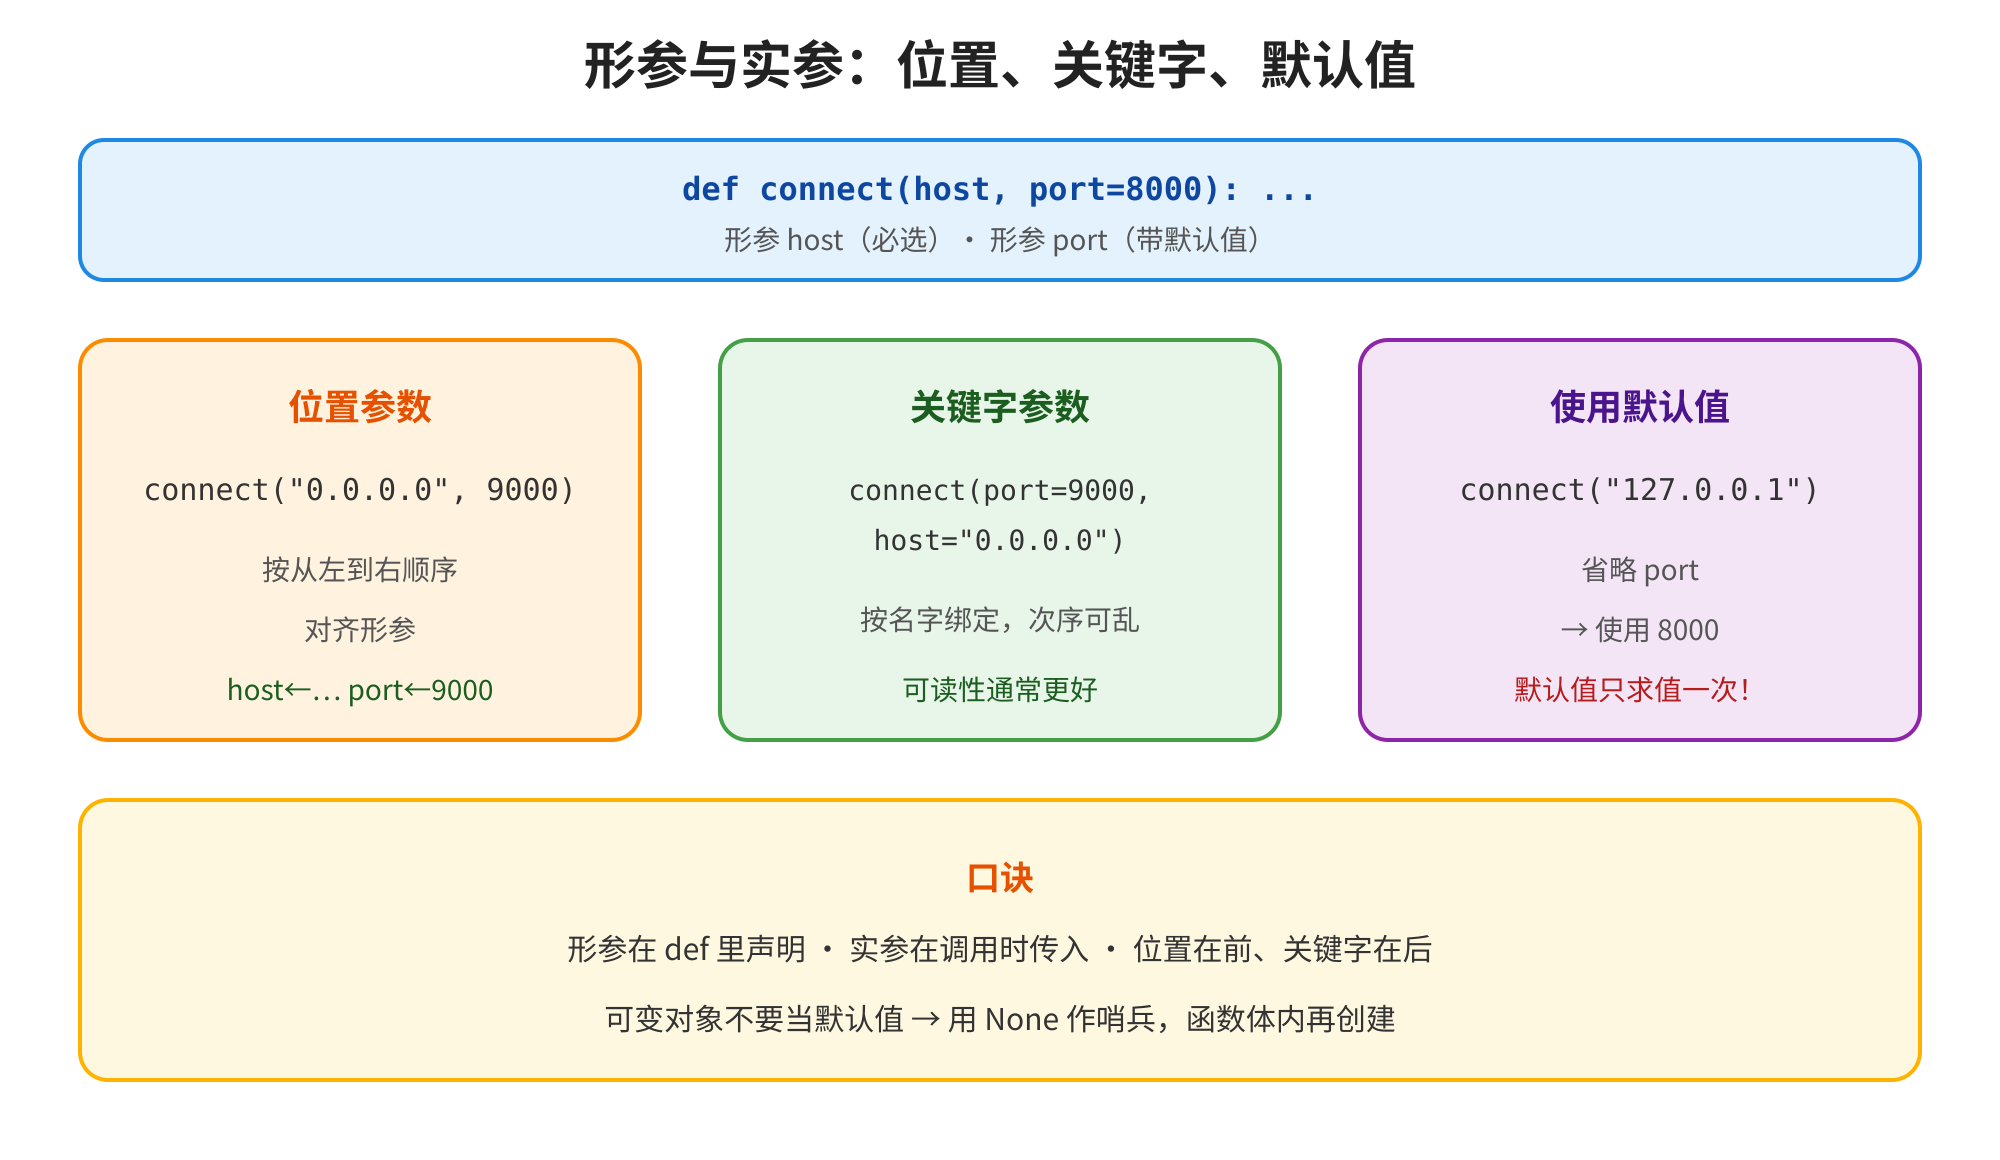
connect("0.0.0.0", 9000),按从左到右顺序对齐;关键字参数示例为connect(port=9000, host="0.0.0.0"),按名字绑定,次序可乱,可读性更好;使用默认值示例为connect("127.0.0.1"),省略port,使用默认值8000。图片下方有口诀总结,强调形参在def里声明,实参在调用时传入,位置在前、关键字在后,可变对象用None作哨兵。图2 形参与实参:位置、关键字、默认值
2.3 默认参数:常见且易踩坑
形参可以带默认值;调用时省略则用默认:
def connect(host="127.0.0.1", port=8000):
    return f"tcp://{host}:{port}"

print(connect())
print(connect(port=9000))
print(connect("10.0.0.2", 9000))
tcp://127.0.0.1:8000
tcp://127.0.0.1:9000
tcp://10.0.0.2:9000
默认参数有一条铁律:默认值在 def 执行时求值一次,而不是每次调用时。因此不要用可变对象当默认值([]、{} 是经典陷阱),详见第七节。正确写法是用 None 作哨兵,在函数体内再创建:
def add_token(token, vocab=None):
    if vocab is None:
        vocab = {}
    vocab[token] = len(vocab)
    return vocab

print(add_token("hello"))
print(add_token("world"))       # 每次都是新 dict,不会串味
{'hello': 0}
{'world': 0}
带默认值的形参必须写在无默认值形参之后:def f(a, b=1) 合法,def f(a=1, b) 语法错误。
实务上还有一条可读性建议:对外暴露的函数,重要且常改的参数用关键字传递,例如 encode(text, max_len=512) 而不是让人猜第二个位置数是什么。位置参数适合“不言自明”的主输入(如第一个 text);选项型参数适合关键字。
三、返回值:return、多返回与 None
3.1 return 立刻把结果交给调用方
def clamp(x, lo, hi):
    if x < lo:
        return lo
    if x > hi:
        return hi
    return x

print(clamp(1.5, 0.0, 1.0))
print(clamp(-1, 0.0, 1.0))
1.0
0.0
执行到 return 后,函数体剩余语句不会再跑。可以把 return 想成“带着值离开当前栈帧”。
3.2 多返回值:其实是打包成元组
def min_max(xs):
    return min(xs), max(xs)     # 等价于 return (min(xs), max(xs))

lo, hi = min_max([3, 1, 4, 1, 5])
print(lo, hi)
print(min_max([3, 1, 4]))       # 不解开时就是一个 tuple
1 5
(1, 4)
这与第 04 篇的元组解包是同一机制。返回“多个结果”在 AI 代码里很常见:(loss, metrics)、(tokens, lengths)、(ok, err)。
3.3 没有 return 就返回 None
def log_ok(msg):
    print("OK:", msg)
    # 没有 return

result = log_ok("loaded")
print("result =", result)
OK: loaded
result = None
None 是单例对象,表示“没有有意义的值”。写配置校验函数时,常见两种风格:成功返回数据 / 失败返回 None;或成功返回数据 / 失败直接 raise(异常见第 11 篇)。不要静默返回 None 又让调用方忘记检查。
def get_lr(cfg):
    if "lr" not in cfg:
        return None
    return float(cfg["lr"])

print(get_lr({"lr": "1e-3"}))
print(get_lr({}))
0.001
None
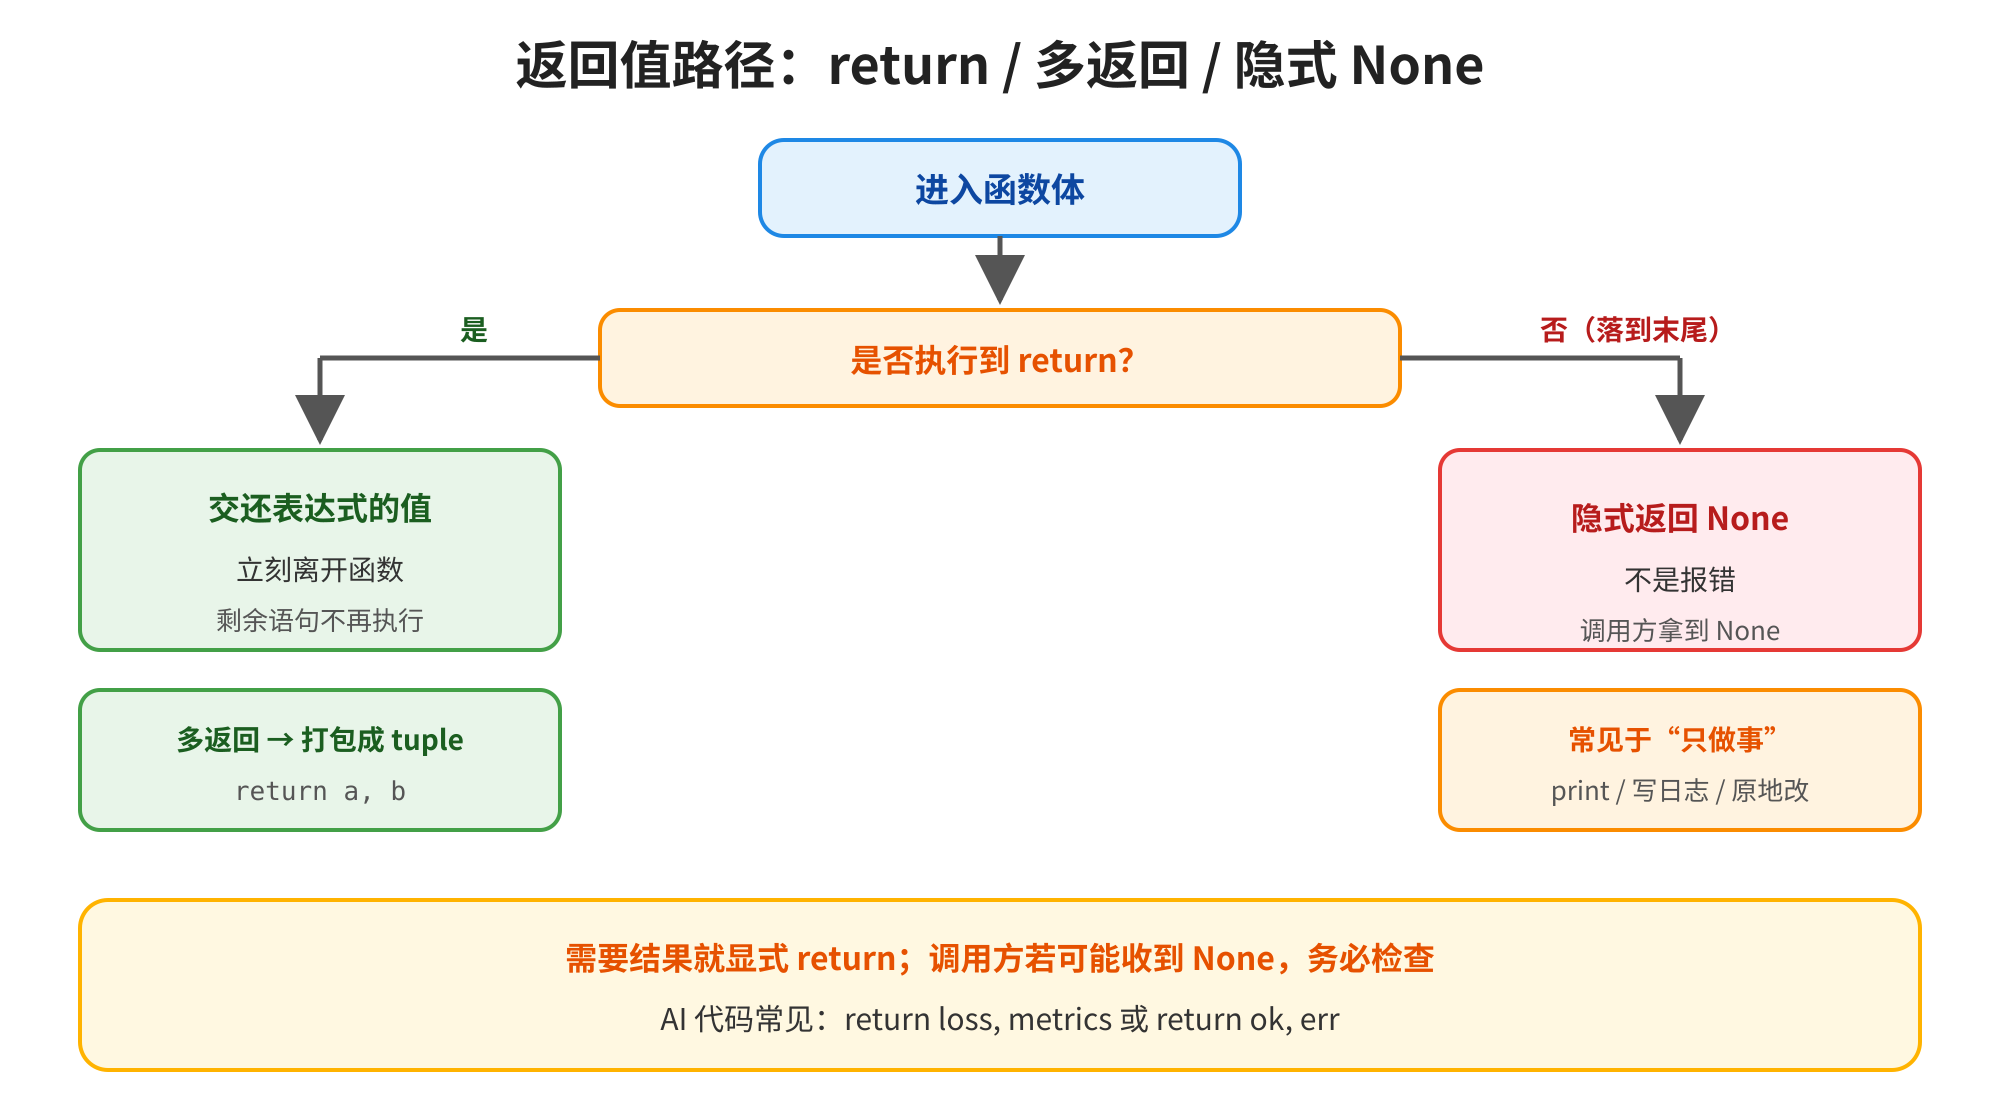
图3 返回值路径:return / 多返回 / 隐式 None
3.4 docstring:给未来的自己(和同事)留一句
三引号字符串若出现在函数体第一条,就是 docstring,不会影响返回值:
def tokenize(text, max_len=512):
    """按空白切分并截断。

    Args:
        text: 原始字符串。
        max_len: 最多保留的 token 数。

    Returns:
        token 列表。
    """
    toks = text.split()
    return toks[:max_len]

print(tokenize.__doc__.splitlines()[0])
print(tokenize("a b c d e", max_len=3))
按空白切分并截断。
['a', 'b', 'c']
入门阶段不必写成长篇 Google/NumPy 风格;一句话说明意图 + 关键参数就够。类型注解与更完整的文档习惯放到第 18 篇。
一个实用习惯:如果你发现 docstring 里开始写长篇“步骤 1、2、3”,往往说明函数本身太长——优先拆函数,而不是把说明书写得比代码还长。代码写清楚,文档才能短。
四、调用栈直觉:谁调用谁
4.1 每次调用推入一帧
程序从模块顶层开始。调用函数时,解释器推入一个栈帧(frame):里面有该次调用的局部变量;函数返回(或异常冒泡)时弹栈。嵌套调用就是栈变高:
def tokenize(text):
    return text.lower().split()

def encode(text, vocab):
    toks = tokenize(text)
    return [vocab.get(t, 0) for t in toks]

def pipeline(text, vocab):
    ids = encode(text, vocab)
    return {"n": len(ids), "ids": ids}

vocab = {"hello": 1, "world": 2}
print(pipeline("Hello World", vocab))
{'n': 2, 'ids': [1, 2]}
调用顺序:pipeline → encode → tokenize;返回顺序相反:tokenize 先返回 list,encode 再返回 id 列表,最后 pipeline 打包 dict。
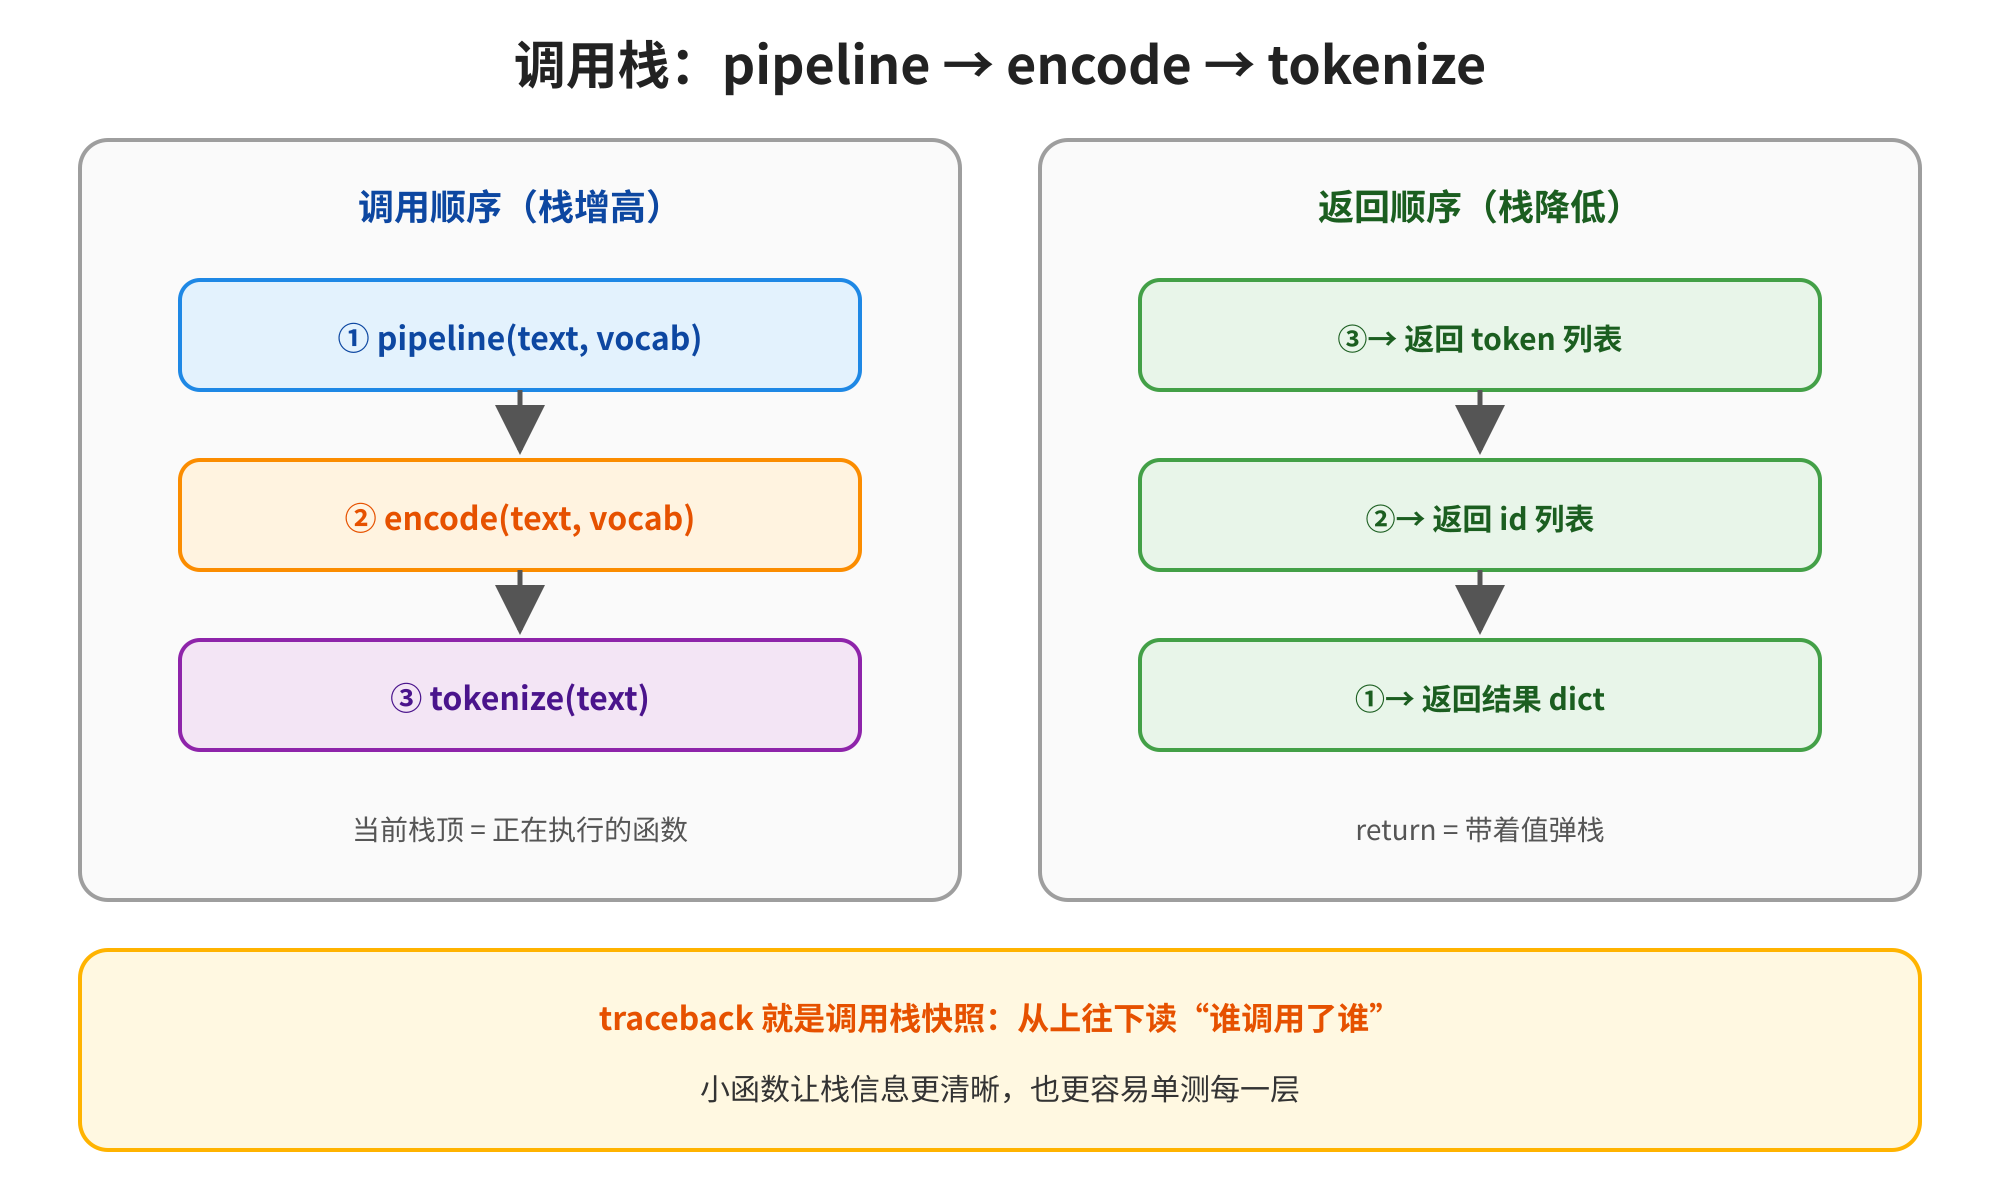
图4 调用栈:pipeline → encode → tokenize
4.2 为什么栈有助于调试
报错时的 traceback 正是调用栈的快照:最底下是入口,最上面是炸点。读 traceback 时从上往下看“谁调用了谁”,比盯着一行表达式空猜更快。嵌套过深(递归没有出口、互相调用绕圈)会触发 RecursionError——本篇不展开递归,但请记住:每次调用都占一帧,帧不是免费的。
把大段脚本拆成小函数,另一个好处是:出问题时栈信息更清晰——你能立刻看到失败发生在 tokenize 还是 encode,而不是百行脚本的某一行。
调用栈也可以帮助你设计 API:若发现自己经常把五个参数一层层往下传,说明中间层可能只是“搬运工”。那时可以考虑把相关参数收成一个 cfg dict(第 05 篇)或后续的 dataclass(第 18 篇),减少形参噪声。本篇先做到“每一层的输入输出说得清”。
五、作用域 LEGB:名字从哪找
5.1 四层查找心智模型
在函数里读到一个名字时,Python 按固定顺序查找:
- L — Local:当前函数的局部命名空间;
- E — Enclosing:外层函数的局部(闭包场景,第 08 篇会加重);
- G — Global:当前模块的全局名字;
- B — Built-in:内置名字(
len、print、range…)。
记成 LEGB。找不到就 NameError。
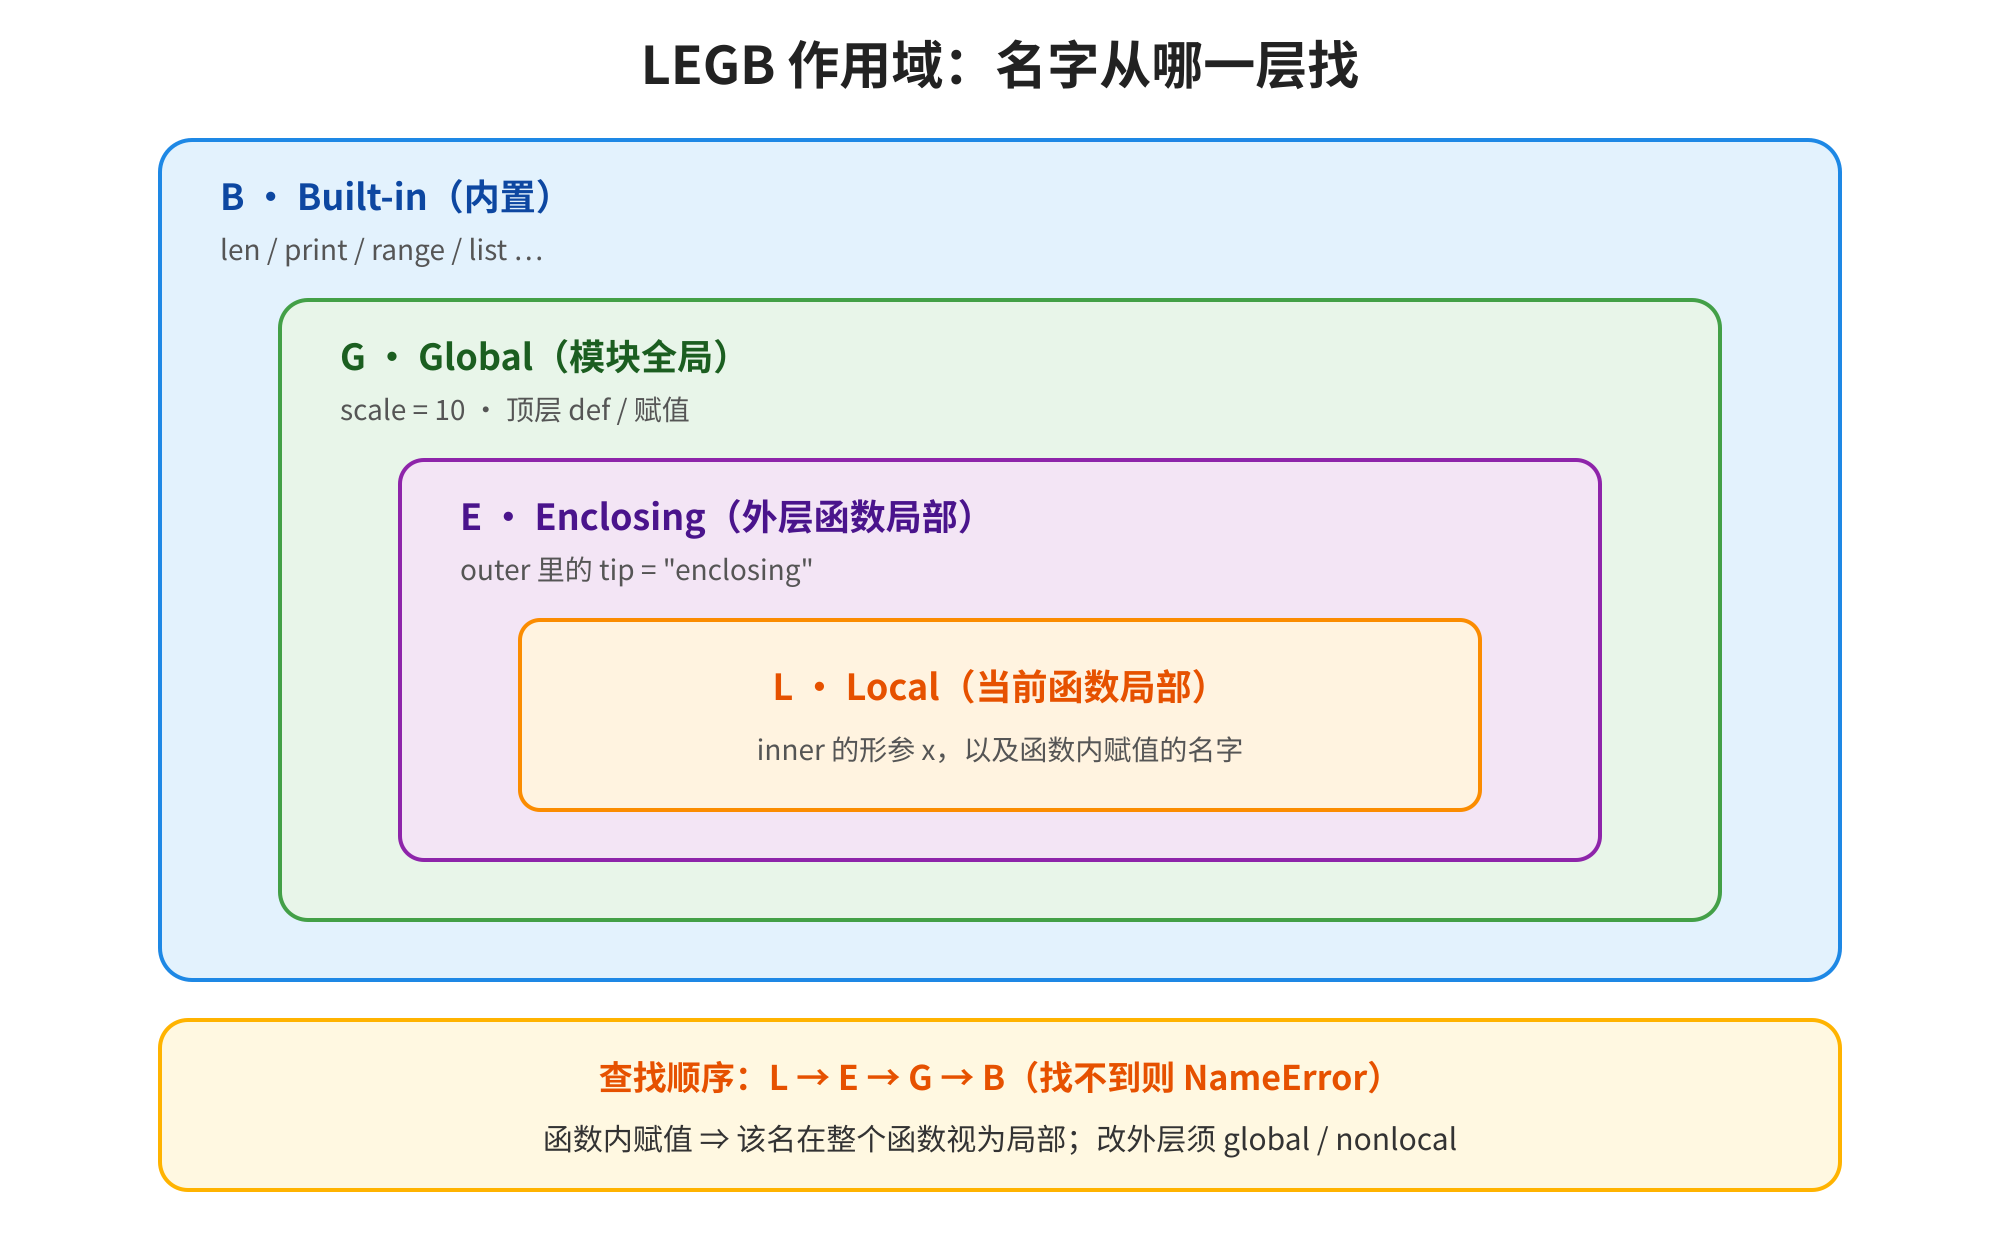
图5 LEGB 作用域:Local → Enclosing → Global → Built-in
scale = 10                      # Global

def outer():
    tip = "enclosing"           # Enclosing(对 inner 而言)

    def inner(x):               # x 是 Local
        return x * scale, tip, len("ab")   # scale→G, tip→E, len→B

    return inner(3)

print(outer())
(30, 'enclosing', 2)
5.2 赋值默认创建局部名
关键规则:在函数体内对名字赋值,该名字在整个函数里都被视为局部——即使赋值写在后面的分支里。这是“局部变量在赋值前被引用”错误的根源:
count = 0

def bump_wrong():
    # count += 1   # UnboundLocalError:count 被当成局部,但右边还没赋值
    pass

def bump_local():
    count = 1                   # 这是局部 count,与全局无关
    return count

print(bump_local(), "global still", count)
1 global still 0
5.3 global 与 nonlocal:声明“我要改外层”
若确实要在函数内改绑全局名字,用 global:
step = 0

def next_step():
    global step
    step += 1
    return step

print(next_step(), next_step(), "final", step)
1 2 final 2
若要改的是外层函数的局部名(不是全局),用 nonlocal(闭包场景):
def make_counter():
    n = 0

    def inc():
        nonlocal n
        n += 1
        return n

    return inc

c = make_counter()
print(c(), c(), c())
1 2 3
使用原则(请背)
- 默认通过返回值把结果交出去,而不是改全局;
- 配置、计数器若必须共享,优先放进 dict/对象参数里传递(显式依赖);
global/nonlocal能不用就不用——它们让数据流变隐式,测试与并发时更难推理。第 08 篇讲闭包时会再见到
nonlocal;本篇只要建立“赋值即局部、要改外层须声明”的模型。
5.4 内置名不要挡
# 反例:把内置名盖住
# list = [1, 2, 3]     # 之后 list() 会炸
# 正例:用 xs / items / rows 等业务名
xs = [1, 2, 3]
print(list(xs))                 # 仍是内置 list
[1, 2, 3]
在函数里写 list = ... 会让该函数内的 list 变局部,连构造列表都可能失败。同理避免覆盖 id、type、input、dict、min、max。
再对比一次“只读全局”与“改绑全局”:函数里读取全局配置 DEBUG = True 无需声明;一旦出现 DEBUG = False 这样的赋值,整个函数里的 DEBUG 都变局部,读的时候就可能 UnboundLocalError。这不是语法刁难,而是 LEGB 与“赋值即局部”规则的直接推论。
六、把控制流收进函数:AI Infra 小样例
6.1 配置工厂与守卫
第 05、06 篇的配置 dict,现在可以做成“构造 + 校验”函数:
def make_serve_cfg(host="0.0.0.0", port=8000, debug=False):
    """构造推理服务配置,并做基础守卫。"""
    if not (1 <= port <= 65535):
        raise ValueError(f"非法 port: {port}")
    cfg = {"host": host, "port": port, "debug": debug}
    return cfg

def describe(cfg):
    mode = "详细日志" if cfg.get("debug") else "安静模式"
    return f"{cfg['host']}:{cfg['port']} ({mode})"

cfg = make_serve_cfg(port=8000, debug=True)
print(describe(cfg))
0.0.0.0:8000 (详细日志)
工厂函数把默认值集中在一处,调用方只覆盖关心的字段——这比满项目散落字面量 dict 好维护得多。
你也可以把“从环境变量 / JSON 文件读入后再校验”放进同一个工厂(文件 IO 见第 10 篇)。本篇先用关键字参数模拟“调用方覆盖默认”,抓住显式构造的味道即可。
6.2 词表与 batch:复用第 04~06 篇技能
def build_vocab(tokens):
    """按首次出现顺序建词表(含 <unk>)。"""
    vocab = {"<unk>": 0}
    for t in tokens:
        if t not in vocab:
            vocab[t] = len(vocab)
    return vocab

def encode(tokens, vocab):
    return [vocab.get(t, vocab["<unk>"]) for t in tokens]

def filter_batch(batch, key="ok"):
    """留下 key 为真的样本 id。"""
    return [row["id"] for row in batch if row.get(key)]

vocab = build_vocab(["hello", "world", "hello", "ai"])
print(vocab)
print(encode(["hello", "missing", "ai"], vocab))

batch = [
    {"id": 0, "ok": True},
    {"id": 1, "ok": False},
    {"id": 2, "ok": True},
]
print(filter_batch(batch))
{'<unk>': 0, 'hello': 1, 'world': 2, 'ai': 3}
[1, 0, 3]
[0, 2]
注意:encode 里的列表推导来自第 06 篇;vocab.get 来自第 05 篇;函数只是把它们封成稳定接口。以后换 BPE 或 SentencePiece,调用方仍写 encode(...)。
6.3 采样一步:while 的函数版预习
def fake_sample(max_new, eos_id, choices):
    """用假采样序列演示:达上限或遇 EOS 就停。"""
    generated = []
    step = 0
    while step < max_new:
        tok = choices[step]
        generated.append(tok)
        step += 1
        if tok == eos_id:
            break
    return generated, step

ids, n = fake_sample(4, eos_id=2, choices=[7, 9, 2, 8])
print(ids, "steps=", n)
[7, 9, 2] steps= 3
真实采样要接模型与温度(专栏四);Agent 工具循环(第 28 篇)也是 while + break。本篇重点是:过程控制进函数后,返回值把结果带出来,而不是靠全局列表偷偷累积。
对比两种坏味道:① 在函数里 global results; results.append(...);② 依赖函数外的可变 list 默认参数当“隐藏缓存”。它们都会让测试变得脆弱。好的函数让人一眼看出:喂什么进去、期望什么出来、会不会改传入对象。
AI Infra 视角
- 配置工厂:
make_*_cfg集中默认值与校验。- 纯变换函数:
normalize/encode/filter_batch——输入明确、输出明确,易测。- 有副作用的函数:写日志、发请求——命名上可加
log_/save_前缀,并在 docstring 里写清。- 下一篇的
*args/**kwargs会让包装器、装饰器更自然;闭包适合“带着配置的小函数”。先把本篇的显式参数与返回值写干净。
七、踩坑大全
下面这些坑,大多能归到三句话:“默认值只求值一次”“函数内赋值即局部”“用返回值交结果,少改全局”。遇到 UnboundLocalError、共享 list 串味、或 traceback 看不懂,先回到这三条。
排查时可自问:这个名字是形参还是实参?默认值是不是 []/{}?函数里有没有对同名全局赋值却没写 global?调用时位置参数和关键字是否重复?有没有把内置名盖住?五问下来,十之八九能定位。
7.1 定义与参数
坑 1:可变默认参数被共享。 现象:多次调用同一个函数,list/dict 内容越积越多。原因:默认值在 def 时创建一次。解决:默认写 None,函数体内再 vocab = {}。
坑 2:位置实参写在关键字后面。 现象:SyntaxError: positional argument follows keyword argument。解决:位置在前,关键字在后。
坑 3:同一参数传了两次。 现象:TypeError: got multiple values for argument。解决:不要既按位置又按关键字传同一个形参。
坑 4:必选参数放在默认参数后面。 现象:定义时 SyntaxError。解决:无默认值形参全部在前。
7.2 返回值与副作用
坑 5:以为没写 return 会报错。 现象:调用结果是 None,后续 NoneType 报错。解决:需要值就显式 return;检查调用方是否忘记接收。
坑 6:在函数里修改传入的 list/dict 却没意识到。 现象:调用方数据被悄悄改掉。解决:若不应修改,先拷贝(list(xs) / dict(d) / copy);或在 docstring 写明“会原地修改”。
坑 7:用全局 list 收集结果。 现象:测试互相污染,并发更糟。解决:结果用 return;必须共享状态时传入容器参数。
7.3 作用域
坑 8:UnboundLocalError。 现象:函数里先读后写同名全局变量。原因:赋值使该名变局部。解决:只读则不要赋值;要改全局则 global;更好是改成参数/返回值。
坑 9:误以为 global 能改“外层函数的局部”。 现象:改的是模块全局,不是闭包变量。解决:外层函数局部用 nonlocal。
坑 10:覆盖内置名。 现象:list/id/type 变成你的对象后,内置功能失效。解决:换业务命名。
7.4 环境与习惯
坑 11(Jupyter):改了函数定义却在跑旧对象。 现象:输出对不上新代码。解决:重跑定义单元格,或重启内核;确认没有旧名字仍指向旧函数。
坑 12:函数又长又多职责。 现象:难测、难复用、traceback 不定位。解决:一个函数做一件事;校验、变换、IO 拆开。
坑 13:递归过深。 现象:RecursionError。解决:改循环;或确认有明确终止条件。深度递归不是本篇主线,知道栈会爆即可。
# 可变默认:错误 vs 正确
def bad(x, bucket=[]):
    bucket.append(x)
    return bucket

print(bad(1), bad(2))           # 第二次带着第一次的 1

def good(x, bucket=None):
    if bucket is None:
        bucket = []
    bucket.append(x)
    return bucket

print(good(1), good(2))
[1, 2] [1, 2]
[1] [2]
八、小结
合上文章后,试着用自己的话解释:“形参和实参差在哪”以及“LEGB 四层各自找什么”——讲得清,才算真的会了。
def创建函数对象:名字绑定对象(第 02 篇);docstring 写在函数体首行;函数可放入 dict 做分发。- 形参 vs 实参:定义时声明形参,调用时传入实参;支持位置、关键字、默认值;默认值只求值一次。
return:立刻离开并交回值;多返回即元组;无return则得None。- 调用栈:每次调用一帧,返回则弹栈;traceback 是栈的快照。
- LEGB:Local → Enclosing → Global → Built-in;函数内赋值默认变局部;改外层用
global/nonlocal,优先返回值。 - AI Infra 映射:配置工厂、
encode/filter_batch、采样一步都应是显式输入输出的小函数;为第 08 篇的可变参数与闭包打底。
把故事连起来:容器存数据(02~05)→ 控制流选路与重复(06)→ 函数把逻辑收成积木(本篇) → 下一篇让积木更灵活(*args/**kwargs、闭包、lambda)。
本篇技能会立刻复利:第 09 篇模块里导出的就是函数与常量;第 16 篇装饰器包装的是函数;第 28 篇 Agent 注册的工具还是函数。先把“参数进、返回值出、作用域清楚”练准,比急着写花式语法更划算。
若只能带走一句话:用参数表达依赖,用返回值表达结果;默认值用不可变哨兵;名字查找记 LEGB。
也可以用“三个不要”自检:不要让默认参数变成共享可变对象;不要为了省事到处 global;不要写没有返回值却又被当成有返回值用的函数。三条守住,函数基础就很少翻车。
再留一个自测:默写一个带默认参数的 connect(host, port=8000),再解释为什么 def f(xs=[]) 危险,并用 LEGB 说出 len 从哪一层找到。三问都顺,本篇就站稳了。
九、课后练习
- (基础) 编写
def area(w, h):返回矩形面积;分别用位置参数与关键字参数调用一次并打印。 - (基础) 编写
def greet(name, prefix="你好"):,演示省略与覆盖默认参数的两种调用。 - (基础) 编写
def stats(xs):返回(len(xs), min(xs), max(xs)),用解包接收三个结果并打印。 - (理解) 解释下面代码两次调用的输出为何不同;改成安全版本(
None哨兵)。
def push(x, s=[]):
    s.append(x)
    return s
print(push(1))
print(push(2))
- (理解) 阅读下列代码,指出
x、y、len分别在 LEGB 哪一层解析;画出(或文字描述)调用outer()时的栈变化。
y = 10
def outer():
    x = 1
    def inner():
        return x + y + len("ok")
    return inner()
- (理解) 写两个版本的计数:① 使用
global;② 不使用global,通过参数传入 dict 或通过返回值累积。对比可读性,说明你更推荐哪一种。 - (进阶) 实现
build_vocab/encode/decode:decode用反向词表(字典推导,见第 06 篇);未知 token 编码为<unk>;对["hi","there","hi","x"]跑通编码再解码(未知词可保留<unk>字符串)。 - (进阶 · AI Infra) 实现配置工厂
make_train_cfg(lr=1e-3, bs=32, max_steps=1000):校验lr>0、bs>=1、max_steps>=1,返回 dict;再写summary(cfg)返回一行描述字符串。额外:把第 06 篇的假采样 while 收进sample_ids(max_new, eos_id, choices),返回(ids, steps),并保证不使用全局列表。
下一篇预告
函数基础解决了“怎么定义、怎么传参、怎么返回、名字从哪找”;下一篇《第08篇|函数进阶:*args/**kwargs、闭包、lambda》会让接口更灵活:可变位置/关键字参数、把函数当作返回值的闭包、以及适合短表达式的 lambda。本篇的 LEGB 与“函数是对象”会立刻用在装饰器预习与工具注册上。
专栏一「Python 从零入门」的后续路线:函数进阶(08)→ 模块与 import(09)→ 文件(10)→ 异常(11)→ 面向对象与数据模型(12~14)。带着本篇的显式参数与返回值习惯,读训练步进函数、推理服务 handler 和 Agent 工具时,会先看懂输入输出契约,再钻实现细节。
若你想提前热身:把第 06 篇的词表推导与假采样 while 各收成一个函数;再故意制造一次可变默认参数 bug 并修好。两道小练习做完,下一篇谈 *args/**kwargs 与闭包时你会带着具体素材,而不是空壳语法。