
第10篇|文件读写、路径与 with
本篇定位:《Python 教程》专栏一「Python 从零入门」的第 10 篇。承接第 09 篇把代码拆进模块与包,本篇处理数据与配置如何进出程序:
open模式、文本/二进制、编码、pathlib.Path、以及用with保证文件关闭——为第 11 篇异常处理、第 17 篇完整上下文管理器、以及后续日志/打包/推理服务里的配置与 checkpoint 路径打地基。读完你将能够:按场景选择
r/w/a/x与文本/二进制模式;显式用encoding="utf-8"读写文本;用pathlib.Path拼接、判断存在、建目录、按行迭代;用with open(...) as f安全开关文件;分清 cwd、脚本目录与绝对路径;在 AI Infra 场景里稳健读写配置、日志、权重路径与数据集清单。预计用时:阅读 35~45 分钟,动手 30~40 分钟。
上一篇你学会了把函数放进模块、用 import 组装。真实项目里,程序还要和磁盘上的文件打交道:读 configs/model.json、写训练日志、保存 checkpoint、扫数据集目录。文件一碰,就会撞上三个老问题——用什么模式打开、路径相对谁、忘了关闭会怎样。
本篇不满足于“open 一下就能读”。我们要建立一条清晰流水线:磁盘上的字节如何经缓冲、解码变成 str;写入时又如何编码、刷缓冲落盘;pathlib.Path 为何比手工拼斜杠更安全;with 如何在正常返回和异常时都调用关闭逻辑。弄清这些,FileNotFoundError、UnicodeDecodeError、以及“明明写了却文件是空的”才不再是玄学。
和第 09 篇的衔接很直接:模块有 file,常常用来定位“相对本文件的配置路径”。和第 02 篇的衔接是:文件对象也是对象,有方法、有状态(位置指针、是否关闭)。第 11 篇会系统讲异常——读写失败几乎总以异常形式出现;本篇先把成功路径与资源释放讲透。第 17 篇会展开自定义上下文管理器;本篇对 enter / exit 只做轻触。
建议边读边建一个练习目录(uv init --no-package),亲手写几个小文件、改 cwd 观察相对路径、故意漏掉 close 对比 with。阅读顺序:打开模式与编码 → 读写与缓冲 → pathlib → with → cwd/跨平台 → AI Infra 场景。踩坑大全请过一遍,尤其是“相对路径相对的是 cwd”和“文本模式读二进制”。
也可以先用一句话定心:打开要对模式,读写要对编码,路径要对锚点,关闭要靠 with。 本篇把这句话拆开。
动手时建议把每个小节的代码存成独立小脚本跑一遍:用 Path.write_text 造数据,再 open 读回来核对;从别的目录启动同一脚本看相对路径是否炸;用 json 读写一份迷你配置。比只朗读“记得关文件”记得牢。和第 09 篇一样,报错信息本身就是教材——No such file or directory、codec can't decode、'xxx' is not a valid Path 相关提示,建议整句抄进笔记。
和“所有输入输出都靠打印到终端”相比,本篇带来的最大变化是:程序可以持久化状态,并且在不同机器、不同启动方式下仍找得到自己的文件。 弄清模式、编码、锚点与 with,后面读训练脚本里的 torch.load、推理服务里的配置热加载时,就不会只剩“路径好像写错了”的猜测。
你也可以把本篇看成第 09 篇的“数据面”:模块解决代码如何按名加载;文件解决字节如何按路径进出。两边合在一起,一个最小可运行的实验目录才算齐——有包、有配置、有输出目录。
一、打开文件:模式、文本与二进制
1.1 open 与文件对象
读写文件的入口是内置函数 open。它返回一个文件对象(file object,有时也称文件句柄),上面有 read / write / close 等方法。最简形态:
from pathlib import Path

demo = Path("demo_hello.txt")
demo.write_text("hello\n", encoding="utf-8")  # 先造一个文件,见第三节

f = open(demo, "r", encoding="utf-8")
text = f.read()
f.close()
print(repr(text))
'hello\n'
open 的第一个参数可以是字符串路径,也可以是 Path 对象(会走文件系统路径协议)。第二个参数是模式(mode);文本模式下强烈建议始终写上 encoding=。
文件对象内部还维护读写位置(像书签)。连续 read 会从上次停下的地方继续;需要回到开头可用 f.seek(0)。入门阶段更常见的是“打开 → 读完/写完 → 关闭”,而不是在同一句柄上反复 seek。
还可以先问文件对象几个状态问题:f.closed 是否已关闭?f.mode 当初用什么模式打开?文本模式下 f.encoding 实际编码是什么?出问题时打印这三项,往往比盲目重跑更快定位。记住:文件对象是有生命周期的资源,不是一次函数调用就消失的临时值。
1.2 读写追加与新建
常用模式字母:
| 模式 | 含义 | 文件不存在时 | 注意 |
|---|---|---|---|
| r | 只读(默认) | 报错 | 最安全的读法 |
| w | 写入 | 新建 | 会清空已有内容 |
| a | 追加 | 新建 | 写在末尾,不清空 |
| x | 独占新建 | 新建 | 已存在则失败(防覆盖) |
| + | 读写 | 视主模式 | 如 r+、w+ |
from pathlib import Path

p = Path("modes_demo.txt")
p.write_text("line1\n", encoding="utf-8")

with open(p, "a", encoding="utf-8") as f:
    f.write("line2\n")

print(p.read_text(encoding="utf-8"))
line1
line2
w 与 a 的差别要刻进肌肉:日志、逐步追加结果用 a;重新生成整份文件用 w。需要“仅当不存在才创建”时用 x,可避免误覆盖 checkpoint。
1.3 文本 vs 二进制、编码
- 文本模式(默认,或不带
b):面向str;读写时按encoding做编码/解码。配置、源码、日志、JSON 文本走这里。 - 二进制模式(模式里加
b,如rb/wb):面向bytes;不做文本解码。图片、权重、压缩包、protobuf 走这里。
from pathlib import Path

p = Path("bin_demo.bin")
data = bytes([0x00, 0xFF, 0x10, 0x80])
with open(p, "wb") as f:
    f.write(data)

with open(p, "rb") as f:
    got = f.read()
print(got)
print(list(got))
b'\x00\xff\x10\x80'
[0, 255, 16, 128]
文本模式下,请显式写 encoding="utf-8"。不写时,解释器使用“区域默认编码”——在部分 Windows 环境可能是 gbk/cp936,同一份 UTF-8 文件在 Linux 服务器能读、在同学电脑报 UnicodeDecodeError。团队约定 UTF-8,比事后对编码表更省命。
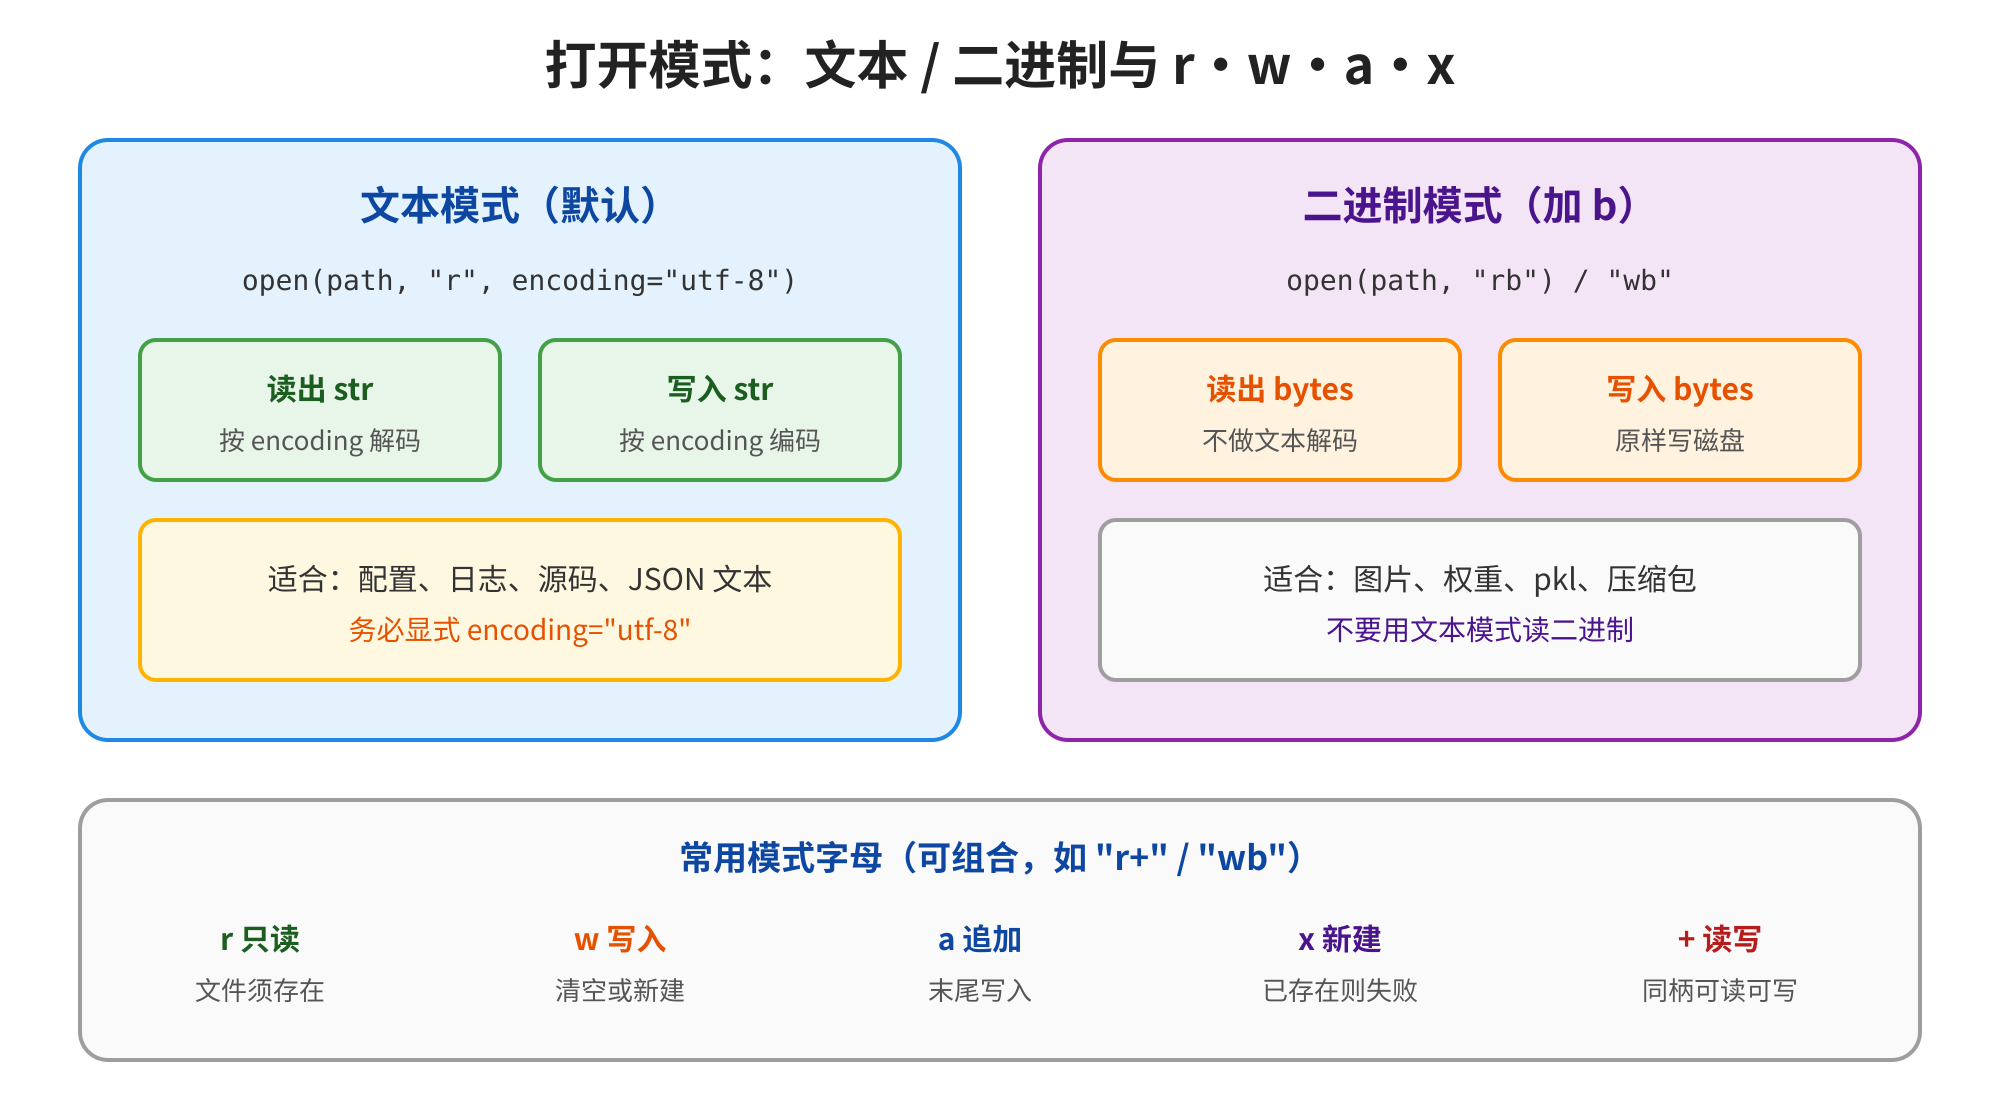
图1 打开模式:文本 / 二进制与 r·w·a·x
AI Infra 视角
权重文件(
.pt/.safetensors/ 自定义 shard)按二进制处理;config.json、tokenizer.json、YAML 配置按文本 + utf-8。两者不要混:用文本模式“看一眼”二进制,轻则乱码,重则破坏文件(若又写回去)。
二、读写流水线:从字节到字符串
2.1 读:read / readline / 按行迭代
from pathlib import Path

p = Path("lines.txt")
p.write_text("alpha\nbeta\ngamma\n", encoding="utf-8")

with open(p, "r", encoding="utf-8") as f:
    print("all:", repr(f.read()))

with open(p, "r", encoding="utf-8") as f:
    print("one:", repr(f.readline()))

with open(p, "r", encoding="utf-8") as f:
    for i, line in enumerate(f, 1):
        print(i, repr(line))
all: 'alpha\nbeta\ngamma\n'
one: 'alpha\n'
1 'alpha\n'
2 'beta\n'
3 'gamma\n'
注意:readline / 迭代得到的行通常带末尾换行符 \n。需要干净内容时用 line.rstrip("\n") 或 line.strip()(后者会去掉两侧空白,语义更强)。
对大日志、大清单,优先 for line in f,而不是 f.read() 一次吞进内存。训练数据 meta 文件动辄数十万行时,这个习惯直接决定会不会把机器撑爆。
2.2 写:write、缓冲与 flush
f.write(s) 写入字符串(文本模式)或字节串(二进制模式),返回写入的字符/字节数。写入往往先进入缓冲(buffering),不一定立刻出现在磁盘上;flush() 请求刷缓冲,close() 会先刷再关。
from pathlib import Path

p = Path("buffer_demo.txt")
with open(p, "w", encoding="utf-8") as f:
    f.write("step-1\n")
    f.flush()  # 需要其它进程立刻看到时
    f.write("step-2\n")
# 离开 with:自动 flush + close

print(p.read_text(encoding="utf-8"))
step-1
step-2
若进程在未 close/flush 时被强杀,缓冲里的数据可能丢失——这也是“日志少了最后几行”的常见原因之一。日常代码用 with 即可覆盖绝大多数情况。
缓冲存在的理由是性能:每次写几个字符就触发一次内核/磁盘操作会很慢。代价是“程序以为写了”和“磁盘上能看见”之间有时间差。对交互式进度文件或跨进程协作,显式 flush(必要时再 os.fsync)才是契约;对普通脚本,信任 with 结束时的关闭即可。第 21 篇讲 logging 时还会再碰到“何时刷日志”的问题,心智模型一脉相承。
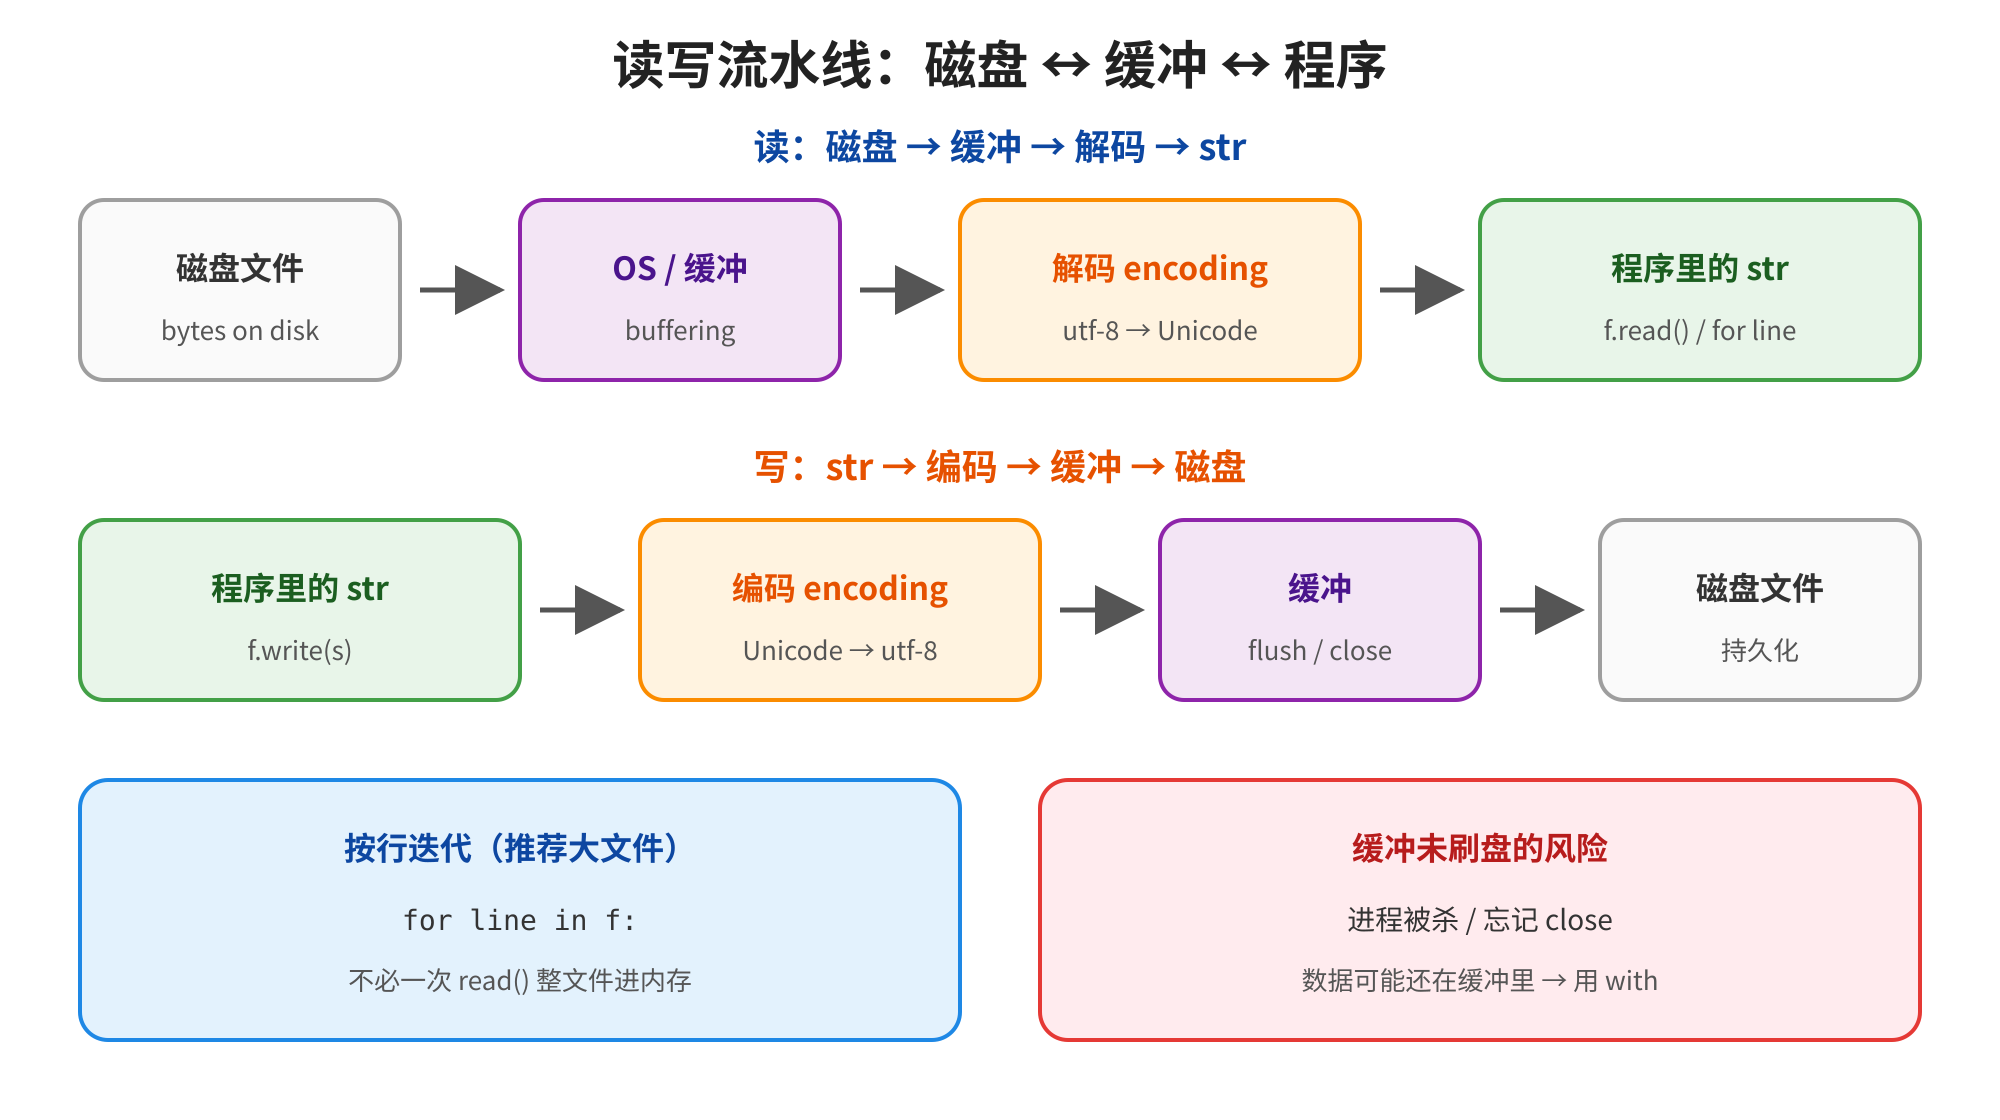
图2 读写流水线:磁盘 ↔︎ 缓冲 ↔︎ 程序
2.3 小文件便捷法与 JSON 轻例
pathlib.Path 提供 read_text / write_text / read_bytes / write_bytes,适合整文件读写的配置与小文本:
from pathlib import Path
import json

cfg_path = Path("mini_cfg.json")
payload = {"model": "mini-gpt", "lr": 0.001, "epochs": 3}
cfg_path.write_text(
    json.dumps(payload, ensure_ascii=False, indent=2),
    encoding="utf-8",
)
loaded = json.loads(cfg_path.read_text(encoding="utf-8"))
print(loaded["model"], loaded["epochs"])
mini-gpt 3
CSV 同理:小表可用标准库 csv,大表日后再上 pandas。要点不变——打开时带编码,用完靠 with(或 Path 便捷方法内部替你关)。
import csv
from pathlib import Path

rows_path = Path("metrics.csv")
with open(rows_path, "w", encoding="utf-8", newline="") as f:
    w = csv.writer(f)
    w.writerow(["step", "loss"])
    w.writerow([1, 2.5])
    w.writerow([2, 1.8])

with open(rows_path, "r", encoding="utf-8", newline="") as f:
    for row in csv.reader(f):
        print(row)
['step', 'loss']
['1', '2.5']
['2', '1.8']
(newline="" 是 csv 模块在文本模式下的推荐写法,避免多余空行,尤其在 Windows。)
三、路径:pathlib.Path 与 os.path
3.1 为什么优先 Path
旧代码大量使用 os.path.join、os.path.exists 等字符串 API。Python 3.4+ 的 pathlib.Path 把路径提升为对象:用 / 拼接、属性取后缀、方法建目录,可读性与跨平台性都更好。新代码建议默认 Path;与只接受字符串的旧库交互时再 str(p)。
把路径当普通字符串的最大麻烦是:拼接、判断、改后缀、取父目录各自是一堆散落函数,还容易在 Windows 上踩分隔符。Path 把这些收成方法与运算符,阅读时像在描述“文件在树里的位置”,而不是在做字符串算术。标准库与多数第三方库如今都接受“路径类对象”(实现了 os.PathLike),不必恐惧“别人只要 str”。
from pathlib import Path
import os

p = Path("data") / "train" / "a.json"
print(p)
print(os.path.join("data", "train", "a.json"))  # 旧写法,结果类似
data/train/a.json
data/train/a.json
(在 Windows 上 os.path.join 会用反斜杠;Path 打印形态随平台,但逻辑操作一致。)
3.2 路径解剖与拼接
from pathlib import Path

p = Path("/data/runs/exp01/ckpt.pt")
print("parts :", p.parts)
print("name  :", p.name)
print("stem  :", p.stem)
print("suffix:", p.suffix)
print("parent:", p.parent)
print("joined:", Path("/data/runs") / "exp01" / "ckpt.pt")
parts : ('/', 'data', 'runs', 'exp01', 'ckpt.pt')
name  : ckpt.pt
stem  : ckpt
suffix: .pt
parent: /data/runs/exp01
joined: /data/runs/exp01/ckpt.pt
口诀:用 / 拼接,用 .parent 往上走,用 .name / .suffix 看文件名。不要再手写 path + "/" + name——漏写、双斜杠、Windows 反斜杠都会找上门。
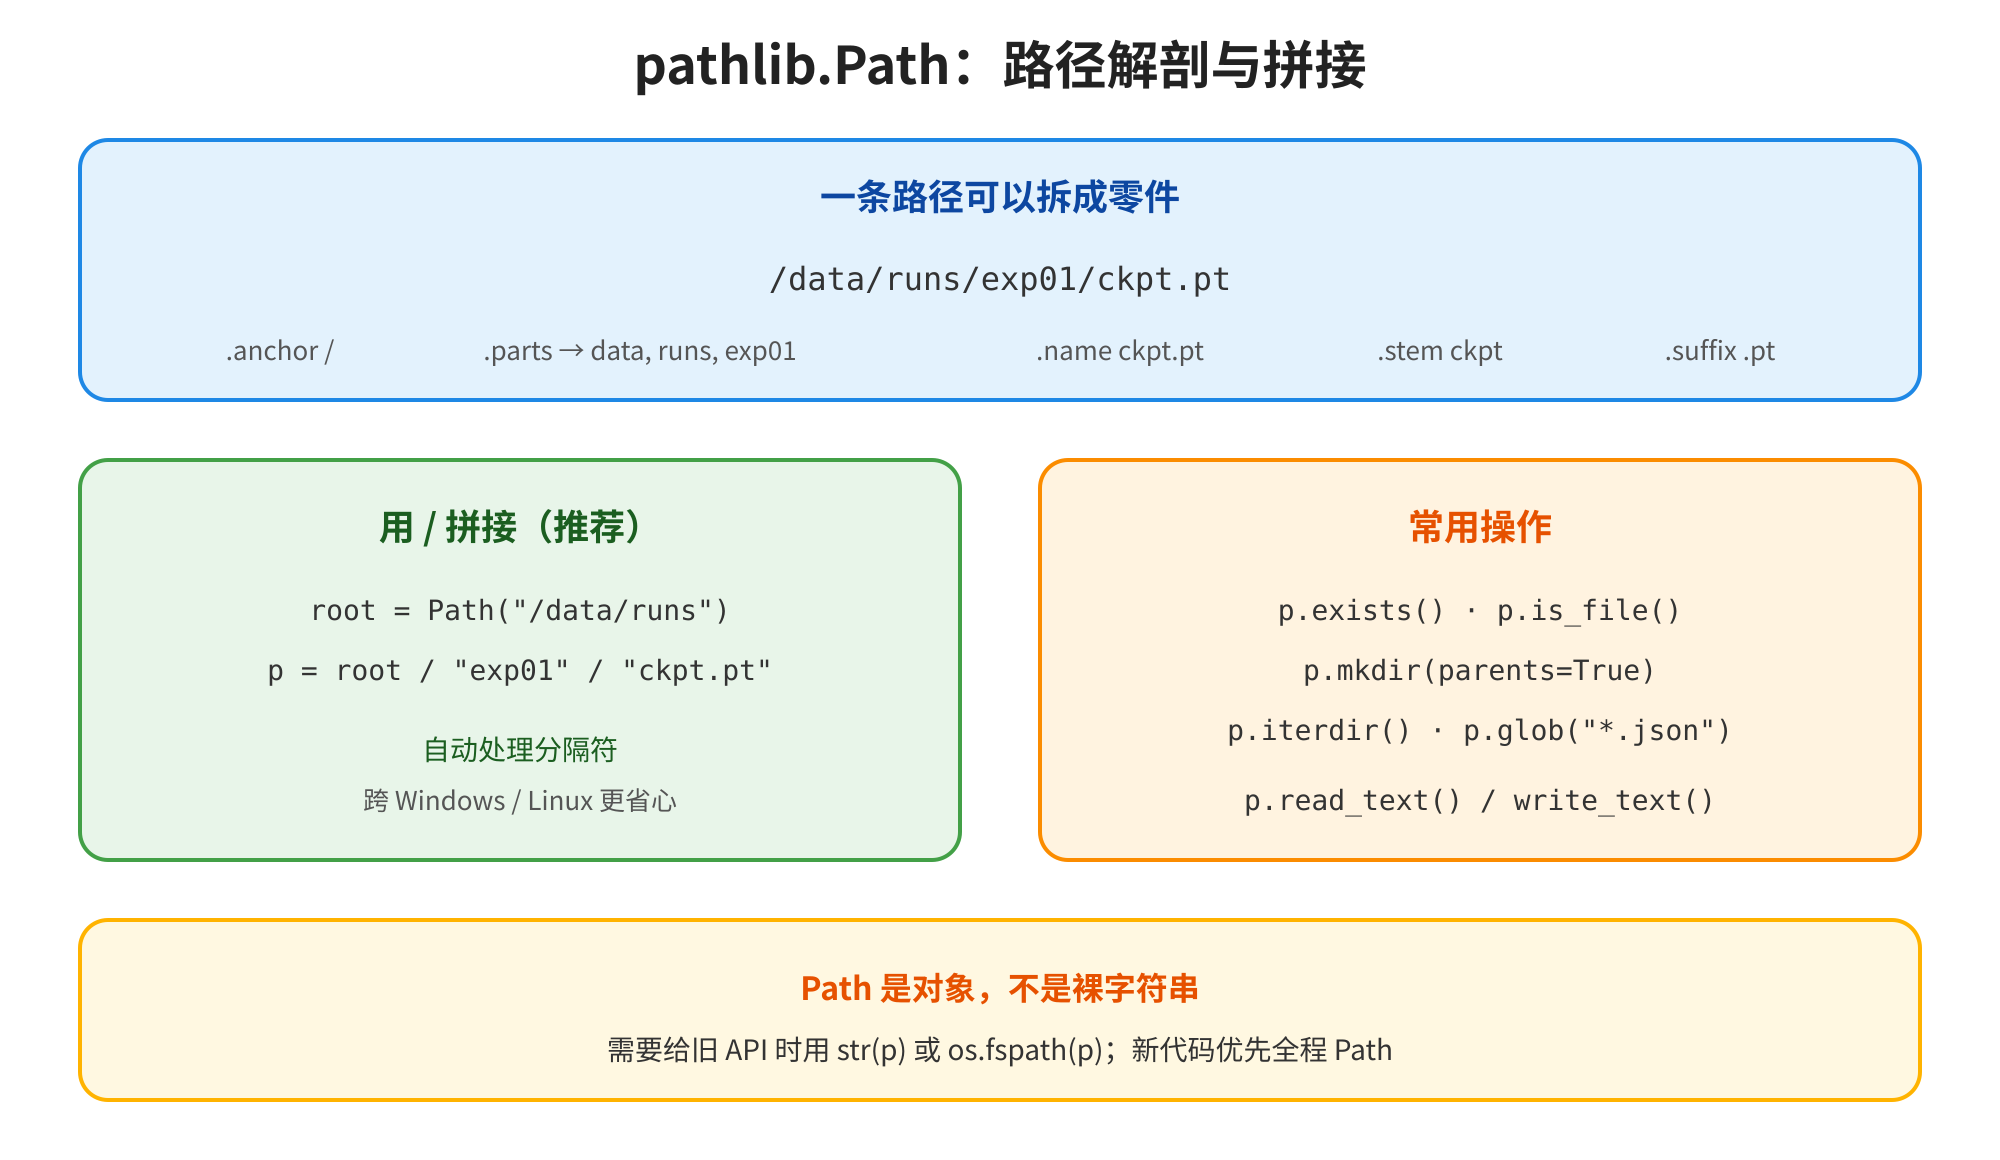
图3 pathlib.Path:路径解剖与拼接
3.3 存在性、目录与遍历
from pathlib import Path

root = Path("sandbox_demo")
(root / "configs").mkdir(parents=True, exist_ok=True)
(root / "configs" / "a.json").write_text('{"ok": true}\n', encoding="utf-8")
(root / "readme.txt").write_text("hi\n", encoding="utf-8")

print("exists:", (root / "configs").exists())
print("is_dir:", (root / "configs").is_dir())
print("files :", sorted(p.name for p in root.iterdir()))
print("json  :", [p.name for p in root.glob("**/*.json")])
exists: True
is_dir: True
files : ['configs', 'readme.txt']
json  : ['a.json']
mkdir(parents=True, exist_ok=True):嵌套创建,已存在不报错——建runs/exp01/tb时很常用。iterdir():当前层;glob/rglob:按模式匹配。resolve():变成绝对路径并尽量解析符号链接,排错时很有用。
Path.read_text / write_text 已在上一节见过;它们内部仍是打开文件,只是把样板代码收短了。大文件、需要细控缓冲或模式时,回到 open + with。
四、with 与上下文管理器入门
4.1 为什么必须关闭
文件句柄是操作系统资源。不关闭可能导致:缓冲未刷盘而丢数据;句柄泄漏(打开过多文件后 OSError: Too many open files);其它进程无法按预期替换/删除文件。手写 close() 看起来简单,但只要中间任何一行抛异常,就可能跳过 close——除非你包一层 try / finally。
4.2 with 语法:保证退出
from pathlib import Path

p = Path("with_demo.txt")
with open(p, "w", encoding="utf-8") as f:
    f.write("safe\n")
# 到这里 f 已关闭

with open(p, "r", encoding="utf-8") as f:
    print(f.read().strip())
safe
with 背后是上下文管理器协议:进入代码块前调用对象的 enter,离开时(含异常)调用 exit。对文件对象而言,exit 里会关闭文件。你几乎总是写:
with open(path, mode, encoding="utf-8") as f:
    ...
而不是手动 open / close。完整自定义上下文管理器(自己实现 enter / exit、contextlib)留给第 17 篇;本篇目标是:凡打开文件,优先 with。
可以把它想成“带自动清理的代码块”。第 11 篇会看到 try / finally 也能保证清理;with 是把这种模式标准化、可读化之后的语法糖。数据库连接、线程锁、临时目录日后都会出现同样的形状——今天用文件练熟,后面迁移成本几乎为零。若你在阅读开源代码时看见 with torch.no_grad(): 或 with open(...),识别的是同一套“进入 / 退出”协议,只是退出时做的事不同。
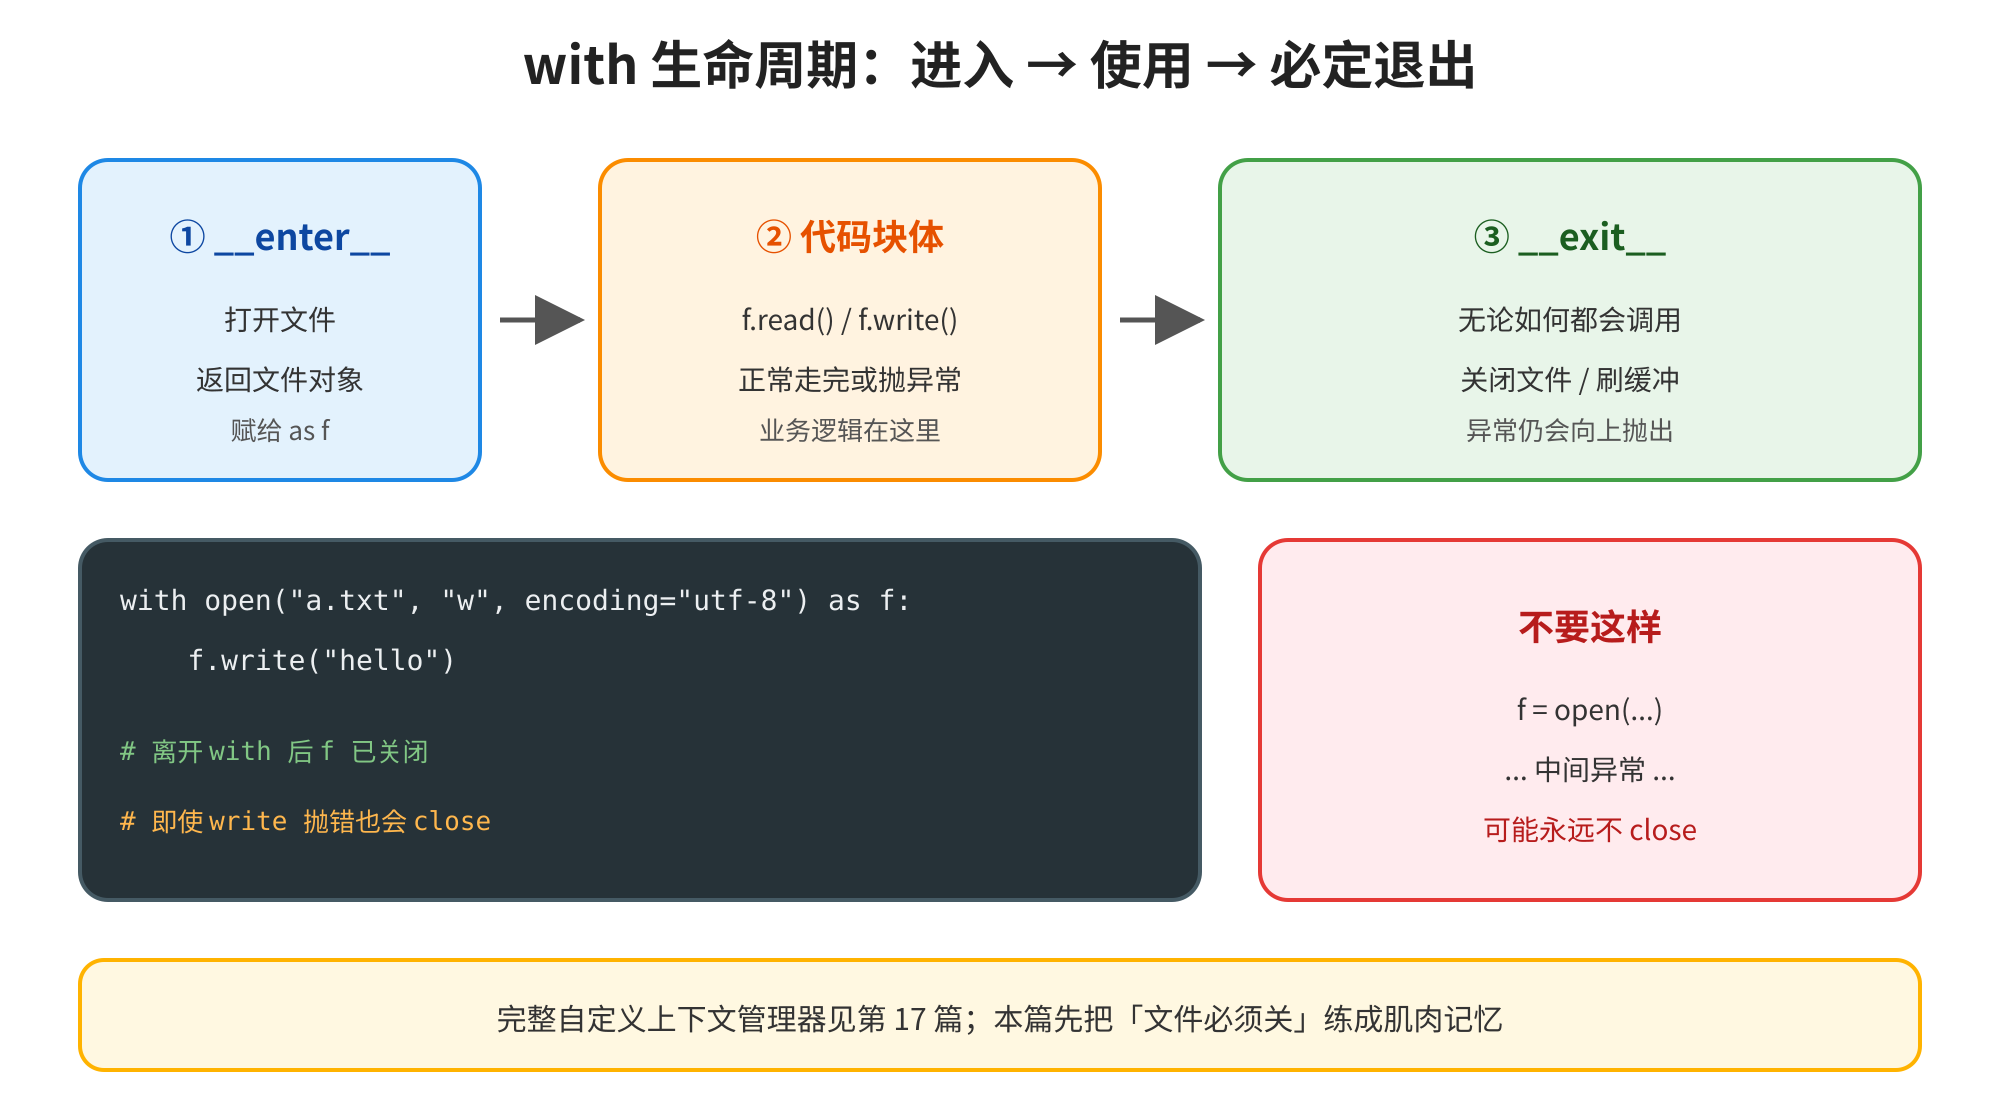
图4 with 生命周期:进入 → 使用 → 必定退出
4.3 多个文件与嵌套
from pathlib import Path

a = Path("a.txt")
b = Path("b.txt")
a.write_text("A\n", encoding="utf-8")
b.write_text("B\n", encoding="utf-8")

with open(a, "r", encoding="utf-8") as fa, open(b, "r", encoding="utf-8") as fb:
    print(fa.read().strip(), fb.read().strip())
A B
一个 with 可以打开多个资源(用逗号分隔)。读写成对文件、合并两个日志时很方便。若逻辑复杂,也可以嵌套两个 with,语义相同。
五、相对路径、cwd 与跨平台
5.1 cwd 不是脚本目录
相对路径(如 "configs/model.json")相对的是当前工作目录(cwd, current working directory),不是“脚本文件所在目录”。cwd 由你在 shell 里站的位置、IDE 运行配置、systemd 的 WorkingDirectory 等决定。
from pathlib import Path
import os

print("cwd     :", Path.cwd())
print("getcwd  :", os.getcwd())
# 若在脚本中:
# print("script  :", Path(__file__).resolve().parent)
同一脚本:
- 在仓库根执行
python scripts/train.py→ 相对路径常相对仓库根; - 在
scripts/里执行python train.py→ 相对路径相对scripts/; - 在完全无关目录执行绝对路径脚本 → 相对路径可能指向“空气”。
这是训练任务在本机“能跑”、提交到集群就 FileNotFoundError 的高频根因。
另一个容易忽略的点:Jupyter / 交互环境里的 cwd 常常是“你启动 notebook 时的目录”,而不是 .ipynb 文件所在目录。笔记本里写相对路径时,先执行一格 Path.cwd(),比假设“和 notebook 同级”更诚实。把数据准备脚本改成 .py 并用 file 锚定,也是从探索到可复现实验的常见一步。
5.2 锚到 file 或显式绝对路径
稳健写法:以模块/脚本文件为锚:
from pathlib import Path

HERE = Path(__file__).resolve().parent
CFG = HERE / "configs" / "model.json"
DATA = HERE.parent / "data" / "train"
或在入口处要求调用方传入绝对路径 / 用环境变量 / 用明确的 --data-root 参数(推理服务常见)。不要默默依赖“大家都会在仓库根启动”。
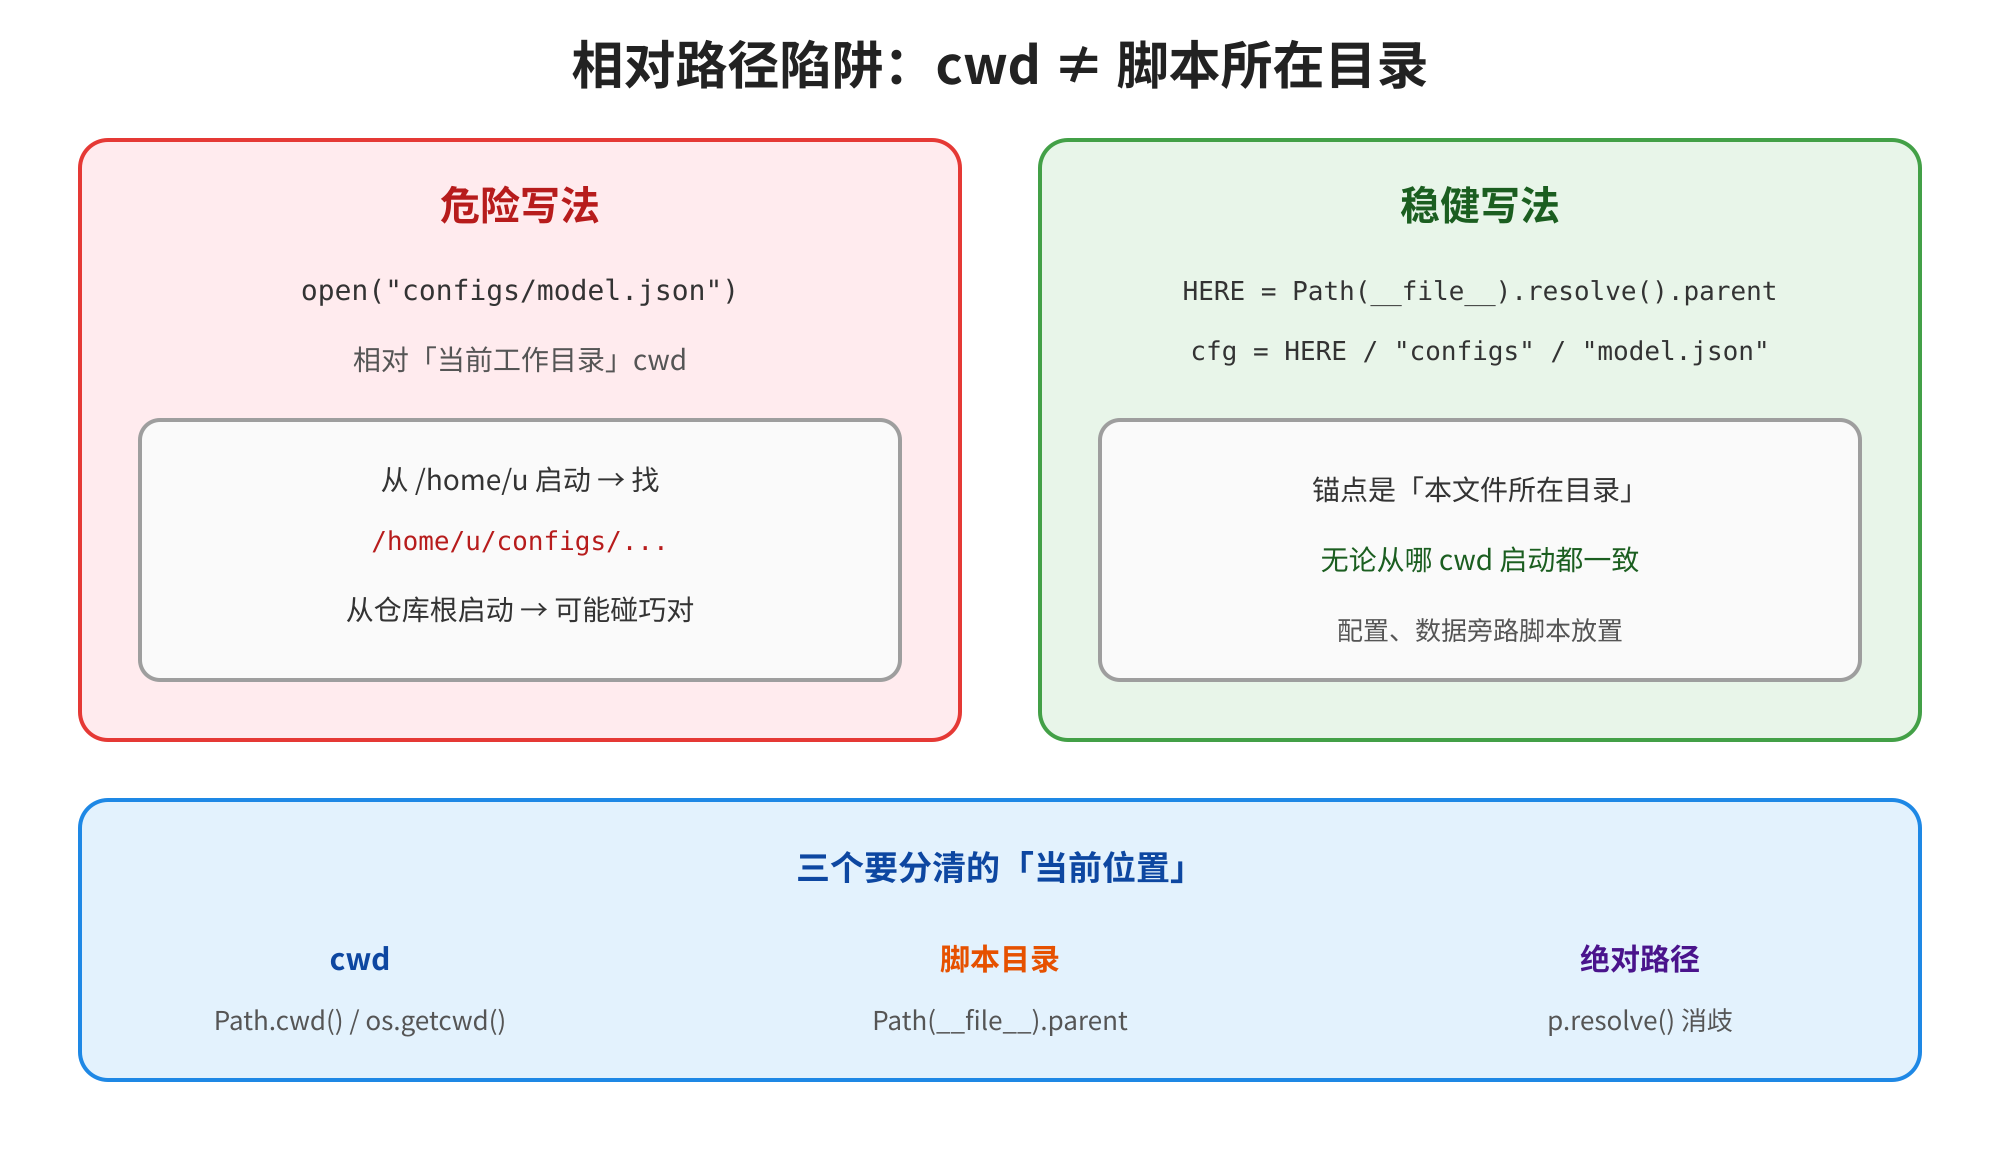
cwd不等于脚本所在目录。左侧红框为危险写法,用open("configs/model.json")从/home/u启动时会找/home/u/configs/...,从仓库根启动可能碰巧对。右侧绿框为稳健写法,以HERE = Path(__file__).resolve().parent和cfg = HERE / "configs" / "model.json"为准,锚点是本文件所在目录,无论从哪cwd启动都一致。底部蓝色框区分cwd、脚本目录和绝对路径,分别对应Path.cwd()/os.getcwd()、Path(__file__).parent和p.resolve()。图5 相对路径陷阱:cwd ≠ 脚本所在目录
5.3 Windows vs Linux
| 话题 | 建议 |
|---|---|
| 分隔符 | 用 Path / PurePath,勿硬编码 \ 或假设 / |
| 盘符 | Windows 有 C:;服务器路径常是 /data/...——配置里写可移植根 |
| 大小写 | Linux 区分大小写;macOS 默认常不敏感——文件名与引用保持一致 |
| 编码 | 统一 UTF-8;Windows 记事本旧版可能带 BOM,注意 utf-8-sig |
from pathlib import Path, PureWindowsPath, PurePosixPath

print(PurePosixPath("data") / "a.txt")
print(PureWindowsPath("data") / "a.txt")
data/a.txt
data\a.txt
Pure* 只做路径计算、不访问磁盘,适合在测试里模拟另一平台的路径形态。
AI Infra 视角
集群上作业的 cwd 经常是 scratch 或 home,而不是你 git clone 的目录。配置里写死
"data/train"而不给绝对--data-root,是复现实验失败的经典原因。把“路径根”变成显式参数,比在代码里猜 cwd 可靠得多。
六、AI Infra 场景:配置、日志、checkpoint、数据集
配置、日志、权重、样本清单——四类文件几乎出现在每一个训练或推理仓库里。它们对“模式 / 编码 / 路径锚点 / 关闭”的要求略有不同,但底层是同一套工具。下面按场景过一遍,方便你对照自己的目录习惯。
6.1 配置:JSON(及一点 YAML 心态)
小项目用 JSON 足够;更大项目常见 YAML(需 pyyaml 等依赖)。无论格式,纪律相同:
- 路径用
Path,编码 UTF-8; - 配置文件位置相对已知锚点或由 CLI 传入;
- 读失败要让异常尽早暴露(第 11 篇),不要静默成空字典。
配置里嵌路径时,建议存“相对某个 root 的相对路径”或可替换的占位,而不是把某台机器的 /Users/xxx/... 写死进仓库。否则同事一 clone,第一步就踩坑。
from pathlib import Path
import json

def load_json(path: Path) -> dict:
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

# 示例:把配置与代码放一起时
# CFG = Path(__file__).resolve().parent / "configs" / "model.json"
6.2 日志与 checkpoint
- 日志:追加模式
a,或交给第 21 篇的logging模块(它内部仍是文件/流)。注意多进程写同一文件需要额外策略。 - checkpoint:二进制写入;常用“写到临时文件再
replace原子替换”,避免写到一半进程挂掉留下半截权重。
from pathlib import Path
import os

def atomic_write_bytes(path: Path, data: bytes) -> None:
    path = Path(path)
    path.parent.mkdir(parents=True, exist_ok=True)
    tmp = path.with_suffix(path.suffix + ".tmp")
    with open(tmp, "wb") as f:
        f.write(data)
        f.flush()
        os.fsync(f.fileno())
    tmp.replace(path)  # 同文件系统上近似原子

atomic_write_bytes(Path("ckpt_demo.pt"), b"fake-weights")
print(Path("ckpt_demo.pt").read_bytes())
b'fake-weights'
6.3 数据集路径纪律
目录扫描用 Path.glob;清单文件(每行一个样本路径)用按行迭代。样本路径建议在清单里写绝对路径,或写“相对 data root 的相对路径”并在代码里统一拼接——两种策略二选一,团队内固定一种。
from pathlib import Path

data_root = Path("sandbox_demo")  # 演示用;真实项目换成绝对 root
manifest = data_root / "manifest.txt"
manifest.write_text("configs/a.json\nreadme.txt\n", encoding="utf-8")

with open(manifest, "r", encoding="utf-8") as f:
    for line in f:
        rel = line.strip()
        if not rel:
            continue
        abs_path = (data_root / rel).resolve()
        print(abs_path.exists(), abs_path.name)
True a.json
True readme.txt
把第 09 篇的包布局和第 10 篇的路径纪律合在一起:configs/、data/、runs/ 各司其职;入口模块用 Path(file) 或 CLI 根路径定位它们——读开源训练脚本时,先找“数据根从哪来”,再看模型细节。
七、踩坑大全
文件 I/O 出问题时,按顺序自问:路径是相对 cwd 还是相对脚本?文件真的存在吗(Path.resolve() 打印看看)?模式是 r 还是误用了 w?编码写了 utf-8 吗?是不是用文本模式碰了二进制?有没有 with 保证关闭?
7.1 路径与存在性
坑 1:相对路径在“另一个目录启动”时找不到。 现象:本机能跑,服务器 / CI / IDE 里 FileNotFoundError。原因:相对路径相对 cwd。解决:Path(file).resolve().parent 锚定,或 CLI 传入绝对根路径。
坑 2:搞混 cwd 与脚本目录。 现象:Path.cwd() 与预期不符。解决:打印两者对照;文档里写清“请在仓库根执行”不如代码不依赖这句话。
坑 3:mkdir 忘记 parents=True。 现象:FileNotFoundError 创建深层目录失败。解决:path.mkdir(parents=True, exist_ok=True)。
7.2 模式与编码
坑 4:用 w 本想追加,结果清空文件。 现象:日志/结果只剩最后一次写入。解决:追加用 a;覆盖整文件才用 w。
坑 5:未指定 encoding,跨平台炸。 现象:Windows 与 Linux 表现不一致,UnicodeDecodeError。解决:文本模式统一 encoding="utf-8";必要时读带 BOM 文件用 utf-8-sig。
坑 6:文本模式读写二进制。 现象:解码失败或写入损坏。解决:权重/图片用 rb/wb;不要用编辑器当十六进制工具去“修”权重。
7.3 关闭与缓冲
坑 7:忘记 close,异常路径泄漏句柄。 现象:偶发丢尾部数据或打开文件过多。解决:一律 with open(...) as f。
坑 8:以为 write 立刻落盘。 现象:进程被杀后文件不完整。解决:with + 关键时 flush/fsync;checkpoint 用临时文件再 replace。
7.4 平台与工具
坑 9(Windows):路径里反斜杠与转义。 现象:字符串里 \t、\n 被当成转义。解决:用 Path 或原始字符串 r"...";正斜杠在 Windows API 上通常也可接受。
坑 10(macOS/Linux):大小写不一致。 现象:笔记本上能找着,Linux 数据盘找不到。解决:清单与真实文件名大小写严格一致。
坑 11(GPU 服务器):NFS / 共享盘上的 rename 与锁。 现象:原子替换、多进程写同一日志出现怪异行为。解决:了解共享文件系统语义;日志按 rank 分文件;大权重先写本地再拷贝。
坑 12:把 Path 对象直接字符串拼接。 现象:p + "/x" 报错。解决:用 p / "x",或先 str(p)。
from pathlib import Path
print(Path("runs") / "exp01" / "log.txt")
先打印路径,再谈“文件丢了”。
八、小结
合上文章后,试着用自己的话解释:“为什么 open('cfg.json') 在邻目录启动会失败”以及“with 比手写 close 到底多保证了什么”——讲得清,才算真的会了。
- 模式:
r/w/a/x(及+、b)决定读写与是否清空;文本对str,二进制对bytes。 - 编码:文本模式显式
encoding="utf-8";解码失败优先怀疑编码与文件真实格式。 - 读写:小文件可用
Path.read_text/write_text;大文件按行迭代;写入经缓冲,关闭/flush才安心。 pathlib.Path:用/拼接,查exists/mkdir/glob;新代码优先 Path,而非手拼斜杠。with:保证离开代码块时关闭文件(含异常路径);本篇先形成习惯,第 17 篇再深挖协议。- 路径锚点:分清 cwd、脚本目录、绝对路径;AI Infra 里配置/数据/checkpoint 根路径要显式、可移植。
把故事连起来:模块(09)解决代码如何拆文件 → 本篇让数据与配置安全进出 → 下一篇(11)系统处理读写与其它操作失败时的异常。再往后,日志(21)、打包(20)、训练循环里的 Dataset 路径(41)都会反复用到今天的刀法。
若只能带走一句话:模式对、编码对、锚点对、用 with 关。
也可以用“三个不要”自检:不要依赖碰巧的 cwd;不要在文本模式下碰权重;不要手写 open 却寄希望于每条路径都执行到 close。
再留一个自测:写出以 file 为锚读取同级 configs/app.json 的三行代码;解释 w 与 a 的区别;说明为何 checkpoint 要先写 .tmp 再 replace。三问都顺,本篇就站稳了。
本篇技能会立刻复利:读开源训练脚本时先找 Path/open/json.load 落点;写最小 Agent 时把工具结果落盘、把 prompt 模板当文本文件读;遇见“偶发空文件”时先怀疑缓冲与关闭,而不是先怀疑磁盘坏了。先把“utf-8 + with + 锚点”练准,比背二十个冷门 open 参数更划算。
九、课后练习
- (基础) 用
Path.write_text写入三行中文,再用with open(..., encoding="utf-8")按行打印repr(line)。 - (基础) 分别用
w与a对同一文件写入两次,观察最终内容差异并写进注释。 - (基础) 构造一个
Path:runs/exp01/ckpt.pt,打印parts、name、stem、suffix、parent。 - (理解) 把脚本放在子目录,内部用相对路径
"data.txt"读取;分别从仓库根与子目录启动,记录哪种失败;改成Path(file).resolve().parent / "data.txt"后再试。 - (理解) 用二进制模式写入 16 个随机字节(
os.urandom),再读回比对;故意用文本模式去读,观察报错或异常表现。 - (理解) 写
load_json/save_json两个函数(签名接受Path),读写含中文键值的字典;确认文件为 UTF-8。 - (进阶) 实现
atomic_write_bytes(临时文件 +flush+fsync+replace),用它保存一份假 checkpoint,并模拟“写到一半抛异常”时正式路径不应留下半截文件。 - (进阶 · AI Infra) 扫描某数据根下所有
*.json(rglob),生成manifest.txt(每行一个绝对路径);再写读取函数,逐行检查Path.exists(),打印缺失计数。思考:若把清单提交到 git,应用绝对路径还是相对 data root?
下一篇预告
文件读写让程序与磁盘对话;一旦文件不存在、编码错误、磁盘满、权限不足,解释器会抛出异常。下一篇《第11篇|异常处理》会系统介绍 try / except / else / finally、异常层级、自定义异常,以及何时该捕获、何时该让程序失败得响亮——和本篇的 with(finally 关闭资源的近亲)首尾相接。
专栏一「Python 从零入门」的后续路线:异常(11)→ 面向对象与数据模型(12~14)。带着本篇的路径锚点与 with 习惯,读训练脚本时先看“配置从哪读、日志往哪写、失败时资源有没有关”,再钻模型细节。
若你想提前热身:给本篇的 load_json 包一层,在文件不存在时打印友好中文提示(先用粗糙的 except Exception 也无妨);再查一下 FileNotFoundError 是哪个基类的子类。两道小练习做完,下一篇谈异常层级时你会带着具体场景,而不是抽象类图。
也可以把第 09 篇练习中的小包改成:入口读取 configs/hello.json,把问候语写进 runs/hello.log(追加模式)。两篇技能叠在一起——模块组装代码,文件搬运数据——专栏一中段的“让程序在真实环境里干活”主线就连上了。
若时间充裕,再多做一件事:给 atomic_write_bytes 加一个“目标已存在则先备份 .bak”的选项,并思考备份该用 replace 还是拷贝。你会同时复习二进制模式、父目录创建与路径后缀变换——这些都是日后写 checkpoint 工具函数的零件。