
第47篇|推理基础:KV Cache、batching、采样
本篇定位:专栏四「PyTorch 与 AI Infra 入门」的第十一篇。承接第 46 篇的
torch.compile,把关注点从“模型如何执行”推进到“生成请求如何被服务”:理解自回归解码、KV Cache、batching 与采样,并建立从 Tensor 到推理引擎的系统视角。读完你将能够:解释 prefill 与 decode 的区别;用形状和显存账本推导 KV Cache;写出一个可运行的最小缓存解码器;比较静态 batching、动态 batching 与 continuous batching;实现 greedy、temperature、top-k、top-p 采样;知道 vLLM、SGLang 为什么要把调度和缓存管理放在模型外面。
预计用时:阅读 70~90 分钟,动手 60~90 分钟。
第 46 篇里,我们看到 torch.compile 可以把稳定的 Tensor 图编译成更少、更大的执行单元。但一个大语言模型服务的瓶颈,并不只在单次 forward:同一个请求要生成很多 token,每一步的输入长度在变,多个请求还会同时到达。若每一步都把整段前缀重新算一遍,GPU 会反复做相同的工作;若只追求大 batch,又可能让短请求长时间排队。
本篇从一次“下一个 token 是什么”的推理开始。先区分 prefill(提示词预填充)和 decode(逐 token 解码),再用 Attention 的 Q、K、V 说明为什么缓存 K/V 能省掉重复计算。随后把单请求扩展到 batch,讨论吞吐、延迟、padding、请求到达和显存之间的取舍,最后将 logits 变成 token 的采样过程接到 vLLM、SGLang 的 AI Infra 运行时。目标不是手写一个生产级引擎,而是让你能读懂它为什么这样设计。
一、生成式推理到底在算什么
1.1 自回归:一次只决定下一个 token
语言模型通常学习一个条件概率:给定前面的 token,预测下一个 token。对提示词 请解释缓存,模型先读完所有输入,得到最后位置的 logits;采样出一个 token 后,把它追加到序列末尾,再预测下一个。这个“预测、追加、再预测”的循环叫自回归(autoregressive)生成。
import torch

vocab_size = 8
logits = torch.tensor([0.1, 0.3, 2.4, -0.2, 0.7, 1.1, 0.0, 0.4])
next_token = logits.argmax(dim=-1)
print("next token:", int(next_token))
print("vocab size:", vocab_size)
next token: 2
vocab size: 8
这段代码只展示最后一步的选择。真实模型会先经过 embedding、多个 Transformer block 和输出头,把隐藏状态映射成词表大小的 logits。logits 是尚未归一化的分数;对它做 softmax 才得到概率分布。推理阶段不需要保存梯度,所以通常使用 model.eval() 与 torch.inference_mode(),减少 autograd 元数据和显存占用。
1.2 prefill 与 decode 是两种不同的工作负载
把一次请求分成两段,很多性能现象就容易解释了。
- Prefill:一次输入整段 prompt,例如 2,048 个 token。模型可以把这些位置组成矩阵并行计算,重点是吞吐、矩阵乘法和首 token 延迟(TTFT,time to first token)。
- Decode:每次通常只输入新生成的 1 个 token,但它要关注已有上下文。生成 500 个 token 就要循环约 500 次,重点是每步延迟、显存带宽、调度和小矩阵效率。
Prefill 像把一整箱货一次搬上流水线,GPU 更容易“吃饱”;decode 像每隔一会儿搬一个小包裹,单步计算量小,却要反复读上下文和调度 kernel。不能用 prefill 的 benchmark 直接推断 decode 的表现,也不能只看模型的理论 FLOPS 判断服务吞吐。
from dataclasses import dataclass

@dataclass
class Request:
    prompt_tokens: int
    generated_tokens: int = 0

request = Request(prompt_tokens=6)
print("prefill tokens:", request.prompt_tokens)
for step in range(3):
    request.generated_tokens += 1
    print("decode step:", step + 1, "total:", request.prompt_tokens + request.generated_tokens)
prefill tokens: 6
decode step: 1 total: 7
decode step: 2 total: 8
decode step: 3 total: 9
这里的计数器不是模型,只是把时间线写清楚:prompt 长度固定,已生成长度逐步增加。真正的调度器还要维护请求状态、停止条件、采样随机数和 KV Cache 的位置。
1.3 为什么第 46 篇的 compile 不能单独解决问题
torch.compile 能优化稳定的 Tensor 子图,但 decode 每一步可能有不同的有效长度、不同请求的完成时间和动态的 batch 组成。把整个网络请求循环包进编译器,既会把队列和 Python 状态混进图,也可能因为 shape 变化不断触发新的编译路径。更合理的分层是:让模型核心尽量使用稳定的算子和 shape,把请求接入、排队、缓存分配、采样和停止判断交给推理运行时。
AI Infra 视角:推理系统同时优化三件事:模型计算、GPU 显存和请求时间线。编译器主要改善第一件事;KV Cache 与 batching 决定第二、三件事。最终指标应包含 TTFT、每输出 token 延迟(TPOT)、tokens/s、p95/p99 和单位请求成本。
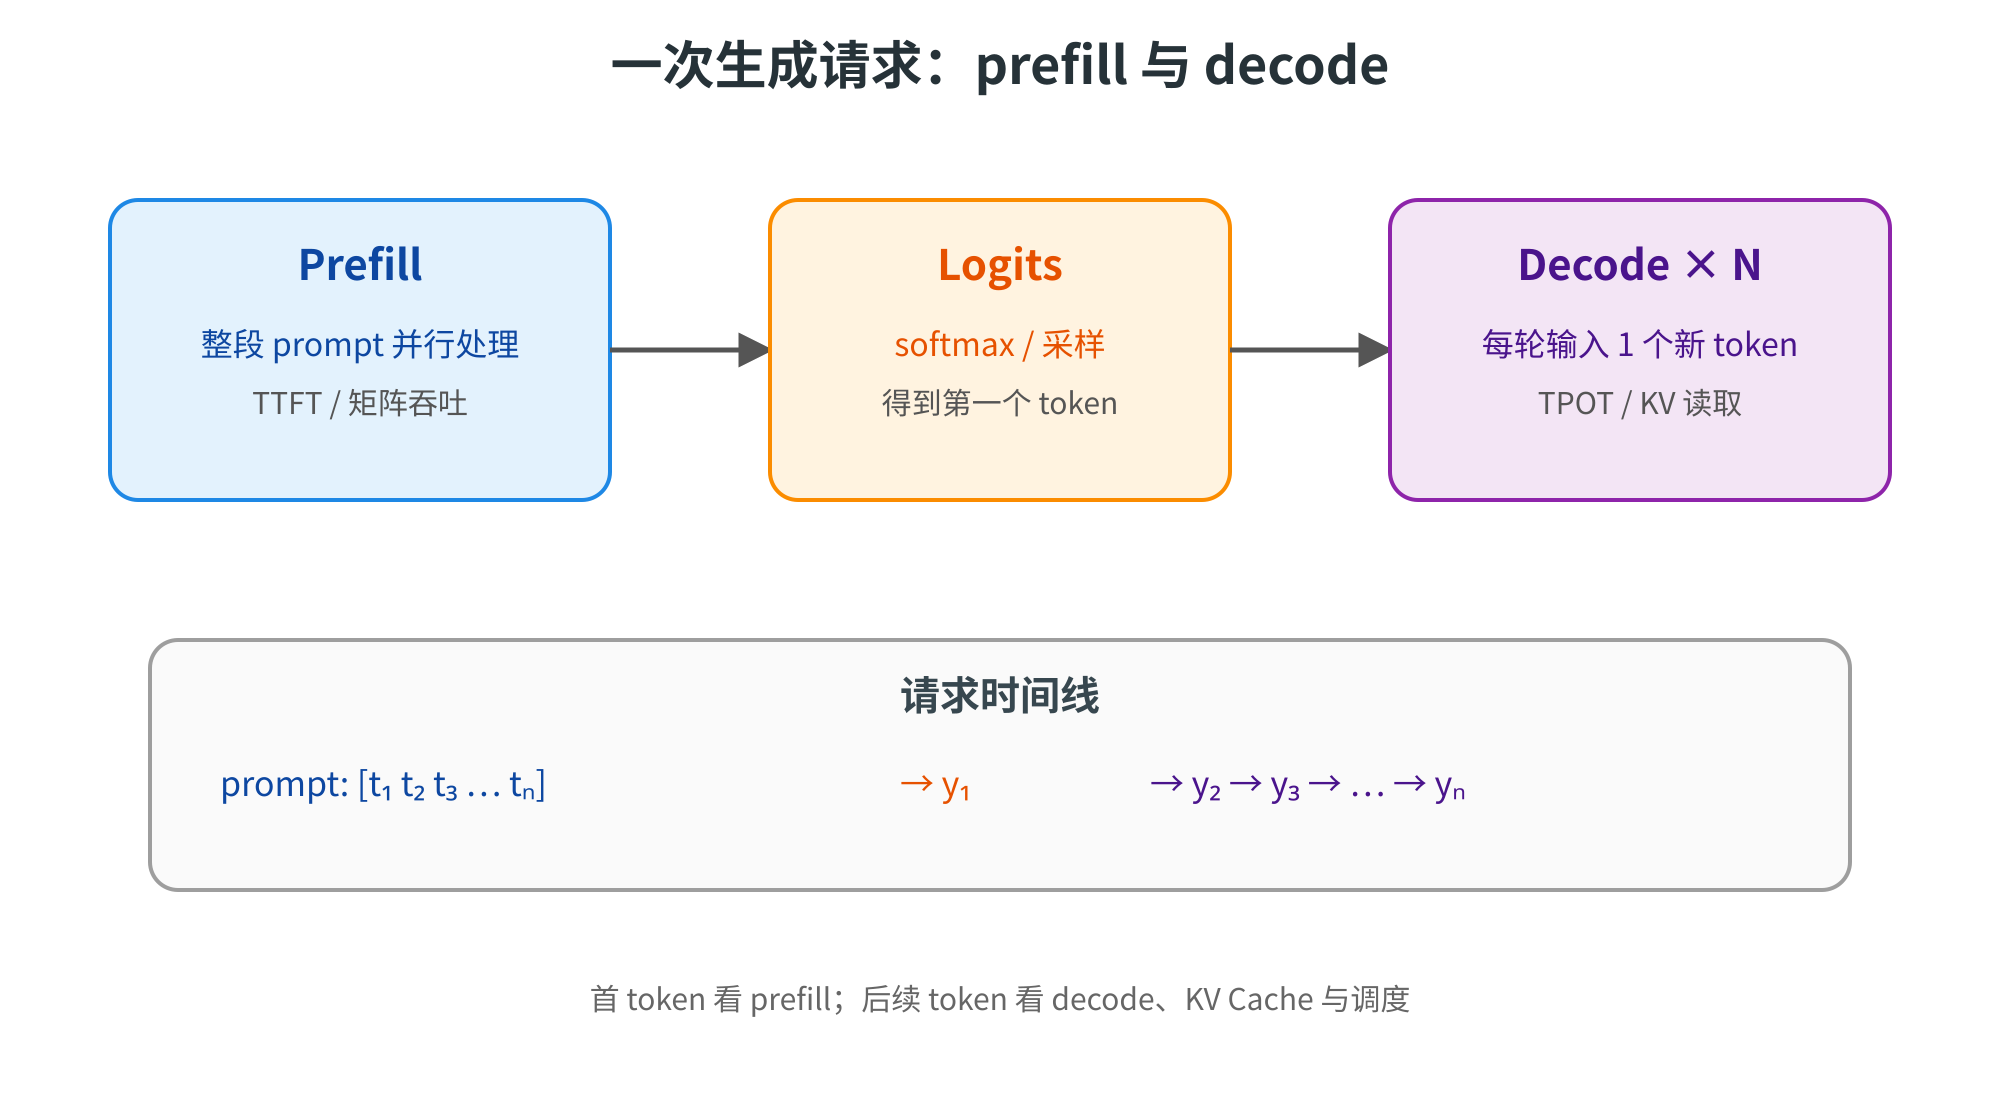
图1 一次生成请求的 prefill 与 decode 时间线
二、KV Cache:把重复的注意力工作留下来
2.1 Attention 为什么会重复计算
回忆第 43 篇的缩放点积注意力。对序列长度为 T 的输入,每个位置会产生 Query、Key、Value:
Q = X Wq       K = X Wk       V = X Wv
Attention(Q, K, V) = softmax(Q Kᵀ / √d) V
在生成第 t 个 token 时,新 token 的 Query 需要和从第 1 个到第 t 个位置的 Key 做点积,并用对应的 Value 加权。关键观察是:旧位置的 K 和 V 由旧 token 决定。生成下一个 token 后,旧位置并没有改变,没必要再次通过每一层的线性投影计算它们。
如果朴素实现每次都把完整序列送入模型,那么第 1 步计算长度 T+1,第 2 步计算长度 T+2,一直到 T+N。这不仅重复生成旧位置的 K/V,还重复生成旧位置的隐藏状态和许多中间结果。序列越长、生成越多,重复工作越明显。
2.2 缓存的直觉:旧 K/V 放在“草稿纸”上
KV Cache(键值缓存)就是每一层、每个注意力头保存已经计算过的 Key 和 Value。prefill 时,模型一次处理 prompt,得到各层的 K/V 并写入缓存。decode 时只给模型一个新 token:它产生一个新的 Query、Key、Value,把新的 K/V 追加到缓存,再用这个 Query 读取完整的 K/V 做注意力。
因此,decode 的输入 token 数从“整个前缀”降为“一个新 token”,但注意力仍要读取越来越长的 K/V。KV Cache 消除了重复的投影和前缀处理,却没有让注意力完全变成常数时间:每步仍然要访问上下文。这也是为什么长上下文 decode 经常受显存带宽限制,而不是只受矩阵乘法 FLOPS 限制。
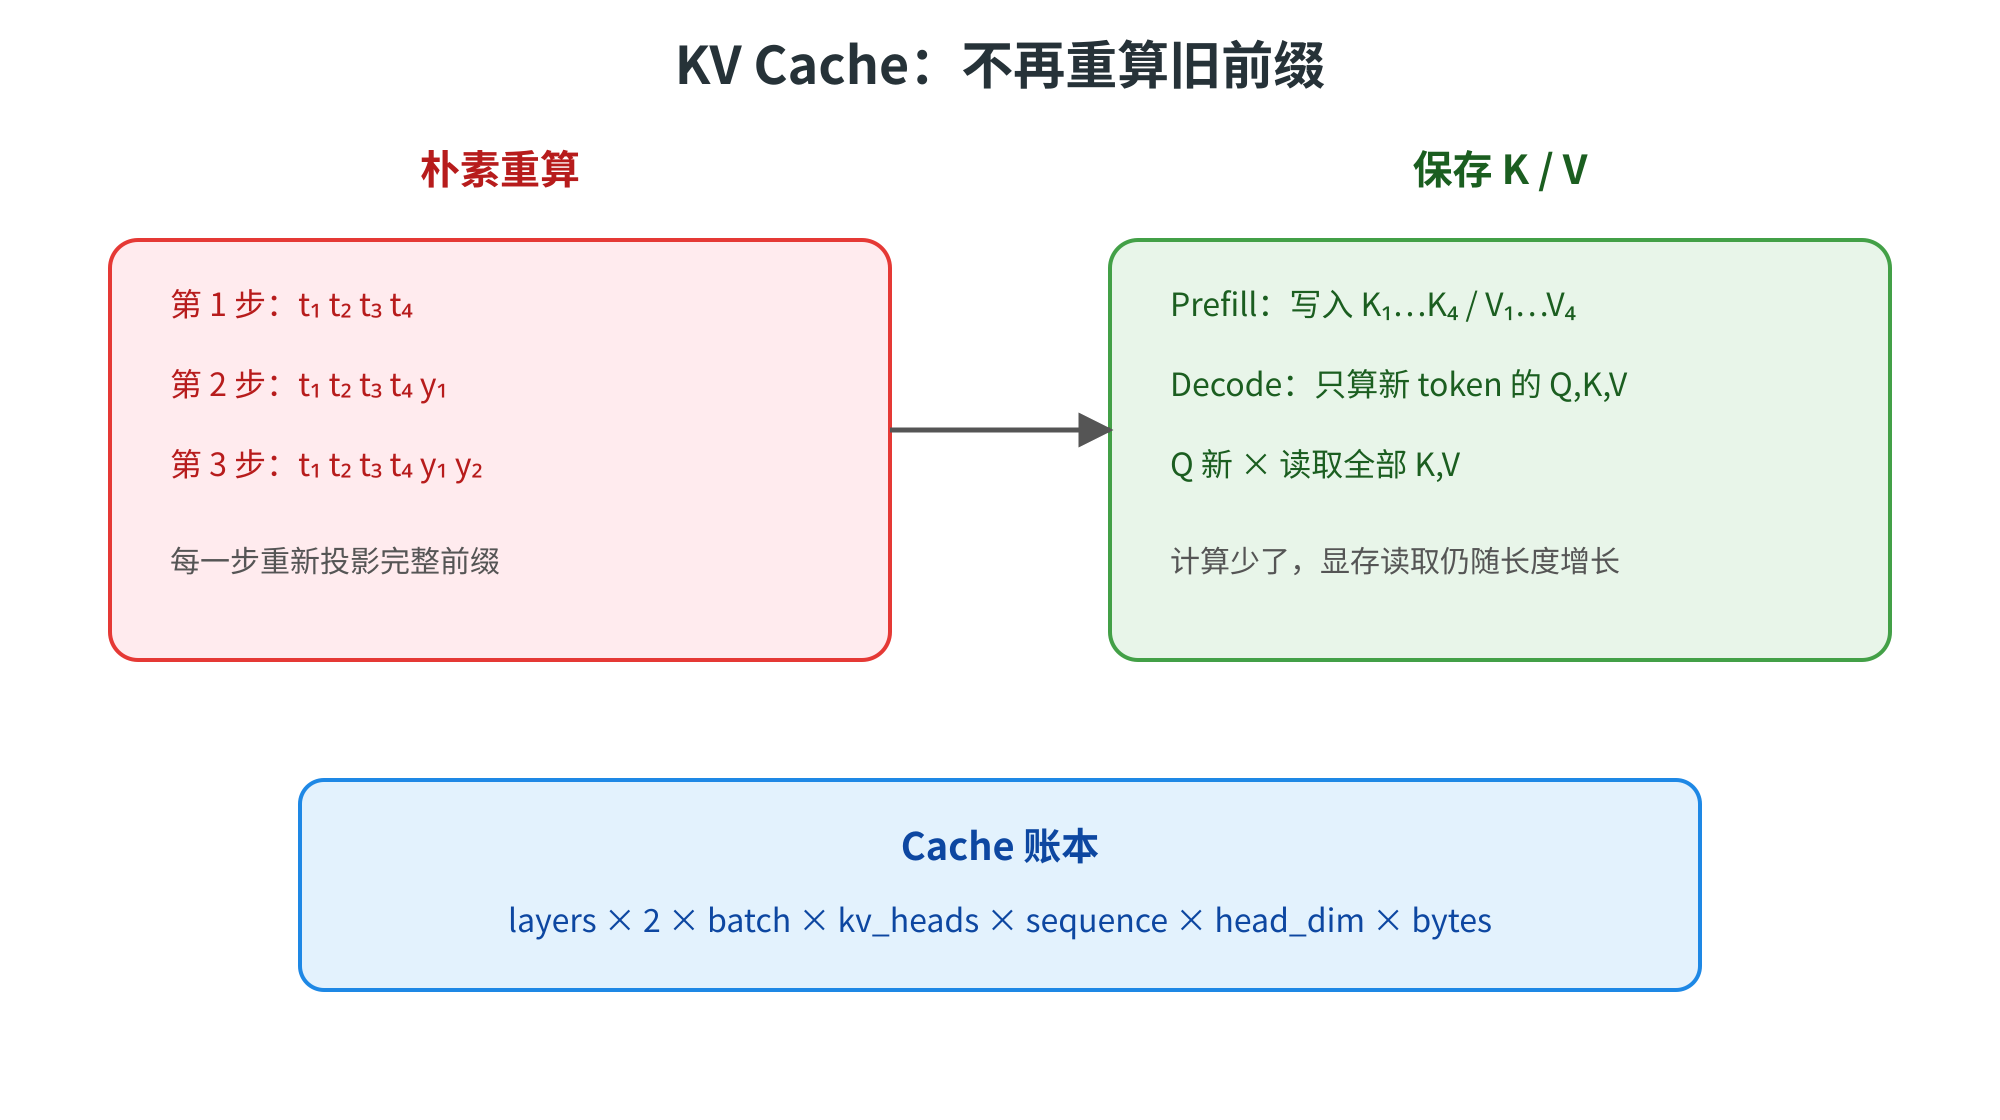
图2 朴素重算与 KV Cache 的工作量对比
用一个极小的 toy attention 可以看见“追加缓存”的数据结构。下面代码不用真实 Transformer,而是把每一步的 K、V 追加到列表,再对当前 Query 读取全部缓存:
import math
import torch

keys, values = [], []
for step in range(3):
    q = torch.randn(1, 4)
    k = torch.randn(1, 4)
    v = torch.randn(1, 4)
    keys.append(k)
    values.append(v)
    all_k = torch.cat(keys, dim=0)
    all_v = torch.cat(values, dim=0)
    weights = torch.softmax(q @ all_k.T / math.sqrt(q.size(-1)), dim=-1)
    out = weights @ all_v
    print(f"step={step + 1} cached_tokens={all_k.size(0)} out_shape={tuple(out.shape)}")
step=1 cached_tokens=1 out_shape=(1, 4)
step=2 cached_tokens=2 out_shape=(1, 4)
step=3 cached_tokens=3 out_shape=(1, 4)
示例中用 torch.cat 追加会不断分配新 Tensor,生产实现不会这样做;它通常预分配页或块,在指定位置写入新 K/V。这个 toy 的重点是生命周期:缓存随着 token 位置增长,当前 Query 每次读取截至当前位置的全部历史。
2.3 KV Cache 的形状与显存账本
常见的 KV Cache 形状可以抽象为:
[num_layers, 2, batch, num_kv_heads, sequence_length, head_dim]
其中 2 对应 K 和 V。若每个元素占 bytes_per_element 字节,粗略显存为:
layers × 2 × batch × kv_heads × sequence_length × head_dim × bytes
例如 32 层、32 个 KV head、每个 head 128 维、batch 为 4、上下文加生成共 4,096 token、BF16 每元素 2 字节:
layers = 32
kv_heads = 32
head_dim = 128
batch = 4
sequence_length = 4096
bytes_per_element = 2

cache_bytes = (layers * 2 * batch * kv_heads * sequence_length
               * head_dim * bytes_per_element)
print(f"KV cache: {cache_bytes / 1024**3:.2f} GiB")
KV cache: 8.00 GiB
这只是一个层数和形状固定的估算,实际模型还会受到 GQA/MQA、padding、页粒度、临时 workspace、权重和 allocator 碎片影响。若使用 Grouped-Query Attention(GQA)或 Multi-Query Attention(MQA),num_kv_heads 可以小于 Query head 数,缓存显著变小;这也是模型架构和服务成本之间的直接连接。
2.4 缓存不是免费午餐
KV Cache 省的是重复计算,付出的是显存容量和带宽。请求越多、上下文越长、并发越高,缓存越容易成为容量上限。GPU 放不下时,系统可能拒绝请求、降低 batch、把一部分状态换出,或者使用量化缓存;换出又会带来 PCIe/NVLink 传输和延迟。
还要注意缓存属于“请求状态”,不是模型权重。权重通常被所有请求共享,而每个请求的 KV 只在自己的序列上有效。请求结束后必须回收对应块;若把一个请求的缓存错误地复用给另一个请求,结果会直接错误。做 prefix caching 时,只有完全相同且可验证的前缀才能安全共享,并且要管理引用计数、租期和隐私边界。
AI Infra 视角:显存账本至少分成权重、激活/临时 buffer、KV Cache 和框架开销四栏。decode 中,权重可能被重复读取,而 KV Cache 随活跃 token 数增长。调度器的核心问题不是“还能塞几个请求”,而是“还能容纳多少有效 token,以及它们的读写是否能保持吞吐”。
三、从一个请求到一组请求:batching 的取舍
3.1 静态 batching:整齐但会等待
最简单的 batching 是收集固定数量请求,padding 到相同长度,一起调用模型。固定 batch 和固定 sequence length 对 GPU、编译器和内存布局都友好,吞吐通常不错;缺点是请求要等 batch 凑齐,短请求会被最长请求拖着走。
import torch

requests = [
    torch.tensor([1, 2, 3]),
    torch.tensor([4, 5]),
    torch.tensor([6]),
]
padded = torch.nn.utils.rnn.pad_sequence(requests, batch_first=True, padding_value=0)
attention_mask = padded.ne(0)
print("padded shape:", tuple(padded.shape))
print("valid tokens:", int(attention_mask.sum()))
padded shape: (3, 3)
valid tokens: 6
padding token 不应该被当成真实上下文。注意力需要 mask,位置编码也要和实现约定一致。若长度差距很大,padding 的无效计算会吞掉收益。静态 batch 适合离线推理或长度分布稳定的场景;交互式服务还要考虑用户不能接受“只差一个 token 却再等一轮”的体验。
3.2 动态 batching:按到达窗口组队
动态 batching(也叫 request batching)在一个短时间窗口内收集到达的请求,再组成 batch。它比固定批次灵活:流量低时可以更快发车,流量高时提高 GPU 利用率。窗口过短,batch 太小、吞吐低;窗口过长,排队时间和 TTFT 上升。最大 batch、最大 token 数和最大等待时间必须一起限制。
对生成请求,还存在一个困难:不同请求的 prompt 长度和已经生成长度不同。只看请求数的 batch 可能显存爆炸;更可靠的预算单位是 token。一个调度循环通常会先计算“本轮还能放入多少新 token”,再决定接收多少 prompt、推进多少 decode。
3.3 continuous batching:完成就退出,新请求随时补位
静态 batch 往往要等整个 batch 中最慢的请求结束,GPU 才能开始下一组。Continuous batching(连续 batching)把调度粒度改成迭代:每一轮为仍活跃的请求生成一个 token;某个请求遇到 EOS 或达到上限,就释放它的 KV Cache;空出来的位置立刻由等待队列中的请求补入。这样不同长度的请求可以交错推进,减少“陪跑”的空槽。
它不是把所有请求拼成一个永远变化的 Python list 就结束了。系统需要维护每个请求的 token 数、KV 块映射、停止状态、优先级和采样状态,还要决定新请求是进入 prefill 还是 decode。长 prompt 的 prefill 可能占用很多计算,若一次塞入太多,就会阻塞正在 decode 的短请求,所以还会采用 chunked prefill,把长 prompt 分成几轮。
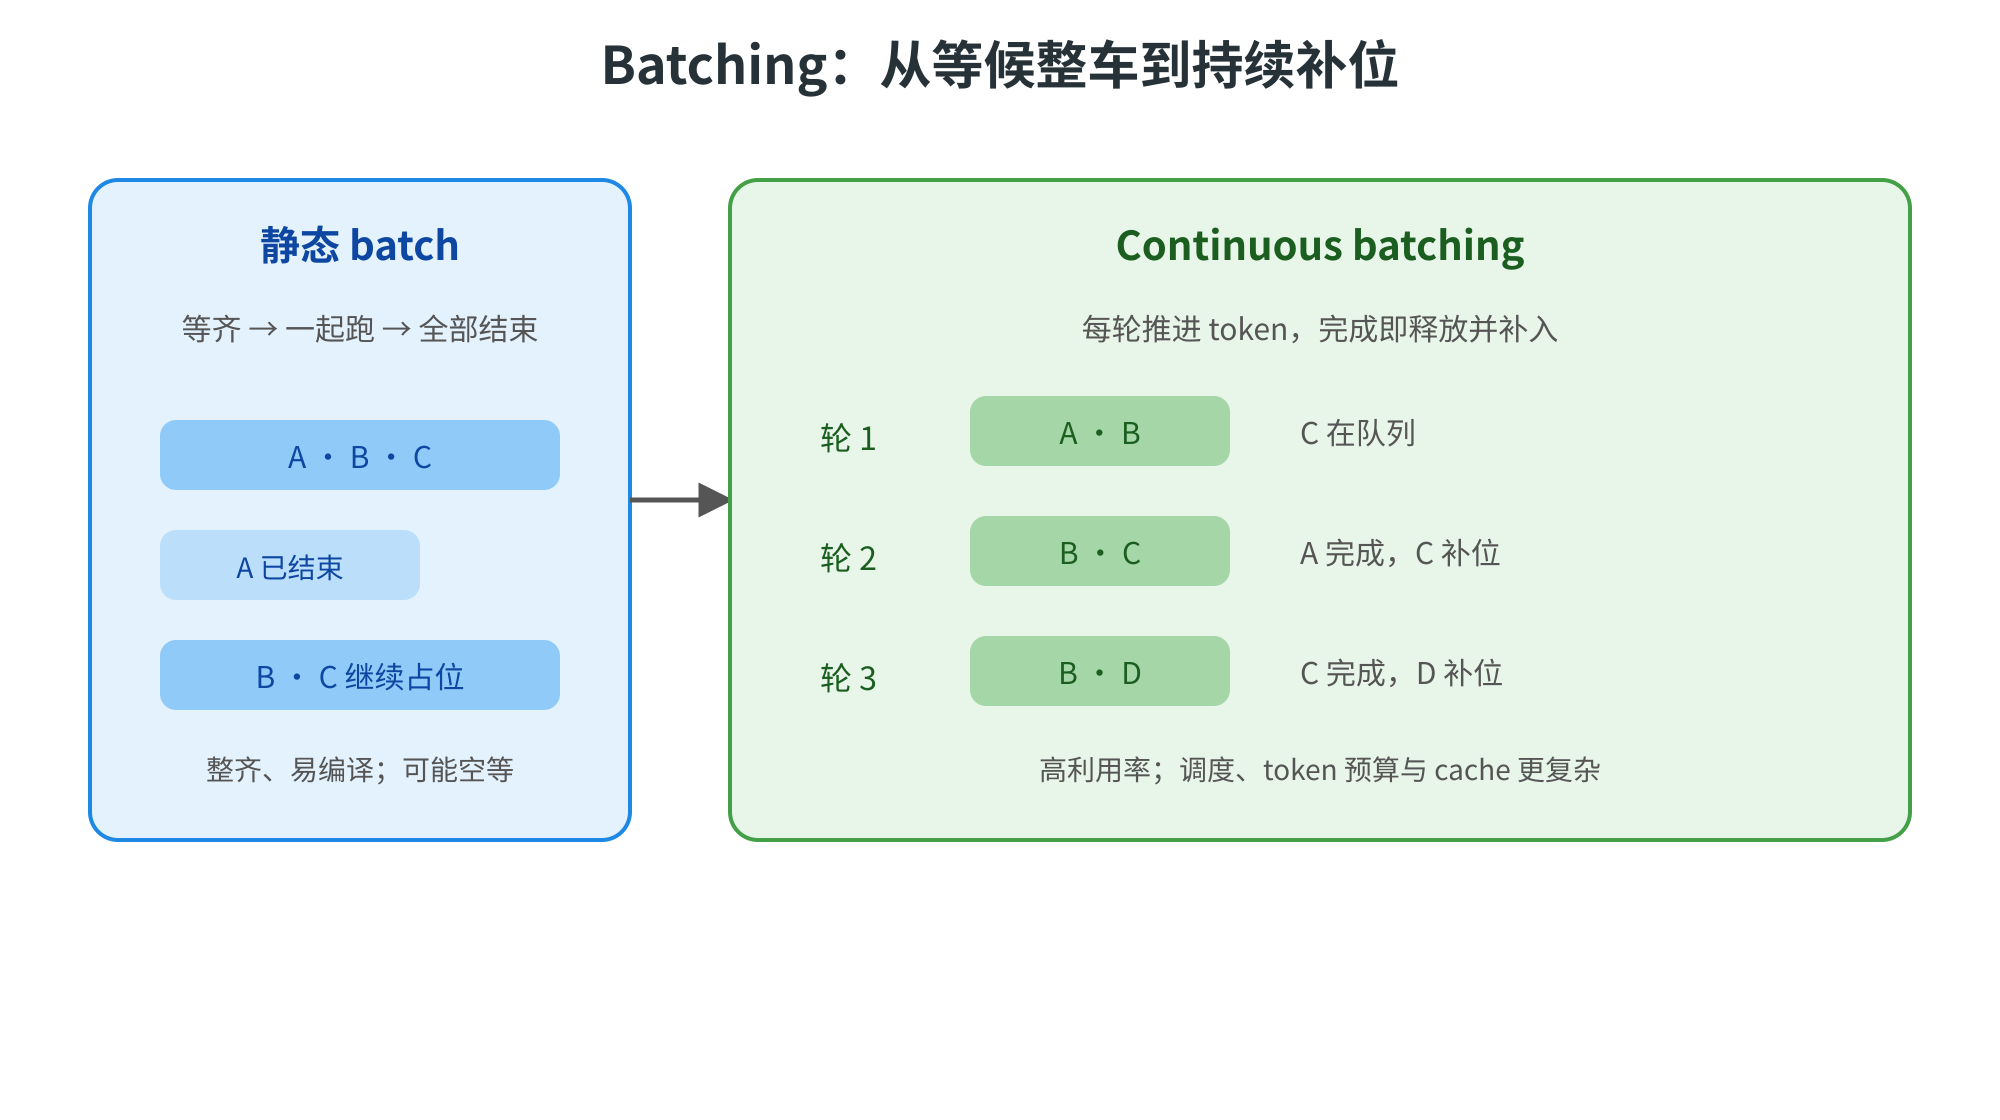
图3 静态 batching 与 continuous batching
3.4 用一个小调度器理解“补位”
下面的模拟只处理请求生命周期,不执行模型。它展示一个请求结束后,下一轮如何补位;真实调度器还要检查 token 预算、显存块和优先级。
waiting = ["A", "B", "C", "D"]
active = []
finished = {"A": 2, "B": 4, "C": 3, "D": 1}
max_batch = 2

for round_id in range(5):
    while len(active) < max_batch and waiting:
        active.append(waiting.pop(0))
    print(f"round={round_id} active={active}")
    done = []
    for name in active:
        finished[name] -= 1
        if finished[name] == 0:
            done.append(name)
    active = [name for name in active if name not in done]
round=0 active=['A', 'B']
round=1 active=['A', 'B']
round=2 active=['B', 'C']
round=3 active=['B', 'C']
round=4 active=['D']
A 在第二轮结束后立即给 C 让位,而不是等 B。注意打印的是本轮开始时的 active 集合;真正的服务还要把完成请求的最后一个 token 返回给客户端,并处理取消请求和异常回收。
3.5 吞吐和延迟没有单一最优点
增大 batch 通常能摊薄 kernel launch、提高矩阵乘法利用率,但会增大显存压力、排队时间和单请求响应延迟。continuous batching 提高了活跃槽位利用率,却增加了调度器和缓存映射的复杂度。一个服务要先明确目标:聊天接口更看重 TTFT、TPOT 和 p99;离线生成更看重总 tokens/s 和 GPU 小时成本;多租户系统还要看公平性和最长等待时间。
建议用真实长度分布做压测,而不是只用相同长度的随机 Tensor。记录每个请求的到达时间、进入 batch 时间、prefill 开始结束、每次 decode、完成时间、输入输出 token 数和显存占用。平均吞吐变好但 p99 恶化,往往意味着 batch 等待、长请求饥饿或 prefill 抢占了 decode 资源。
四、采样:从 logits 到可控的文本
4.1 greedy、随机性与温度
模型输出的是词表上的 logits,不是直接的文字。最简单的 greedy decoding(贪心解码)选择最大 logit:确定、可复现,但容易重复,也可能陷入局部高概率路径。随机采样则按概率抽取 token,让生成保留多样性。
温度(temperature)是对 logits 的缩放:
probabilities = softmax(logits / temperature)
温度小于 1 会让分布更尖锐,接近贪心;温度大于 1 会让分布更平,低概率 token 更有机会。它不是凭空制造知识,过高会增加跑题、乱码或不稳定输出。工程上通常在 0 < temperature 时使用随机采样,temperature 等于 0 时明确走 greedy 分支,避免除零。
import torch

logits = torch.tensor([1.0, 1.5, 2.0, 0.5])
for temperature in (0.5, 1.0, 2.0):
    probs = torch.softmax(logits / temperature, dim=-1)
    print(temperature, [round(float(x), 3) for x in probs])
0.5 [0.032, 0.087, 0.644, 0.237]
1.0 [0.102, 0.167, 0.276, 0.455]
2.0 [0.169, 0.216, 0.278, 0.337]
4.2 top-k:只在前 k 个候选里抽
top-k 采样先保留 logit 最大的 k 个 token,把其余候选设为负无穷,再对剩余分布 softmax 和采样。它能过滤长尾噪声,但 k 是固定数量:当模型非常确定时,可能仍保留过多;当模型不确定时,可能过早截断有用候选。
import torch


def top_k_filter(logits: torch.Tensor, k: int) -> torch.Tensor:
    values, _ = torch.topk(logits, k=min(k, logits.numel()))
    threshold = values[-1]
    return logits.masked_fill(logits < threshold, float("-inf"))

logits = torch.tensor([0.2, 2.0, 0.7, 1.4, -0.5])
filtered = top_k_filter(logits, k=2)
print(filtered.tolist())
[ -inf, 2.0, -inf, 1.4, -inf]
真实 batch 推理时,logits 往往是 [batch, vocab],过滤要沿最后一个维度做,不能把不同请求的词表混在一起。还要处理 k <= 0、k > vocab_size 和过滤后没有有限值的异常输入。
4.3 top-p:保留累计概率的最小集合
top-p(nucleus sampling)先把候选按概率从高到低排序,再保留累计概率达到 p 的最小集合。模型很确定时,集合可能只有几个 token;模型不确定时,集合自动变大,比固定 k 更能适应分布。实现时容易犯一个边界错误:排序后需要把“第一个使累计概率超过 p 的 token”保留下来,否则会把累计概率截到小于 p 的集合。
import torch


def sample_top_p(logits: torch.Tensor, p: float = 0.9) -> torch.Tensor:
    if not 0 < p <= 1:
        raise ValueError("p must be in (0, 1]")
    sorted_logits, sorted_indices = torch.sort(logits, descending=True)
    sorted_probs = torch.softmax(sorted_logits, dim=-1)
    cumulative = torch.cumsum(sorted_probs, dim=-1)
    remove = cumulative > p
    remove[1:] = remove[:-1].clone()
    remove[0] = False
    sorted_logits = sorted_logits.masked_fill(remove, float("-inf"))
    filtered = torch.full_like(logits, float("-inf"))
    filtered.scatter_(0, sorted_indices, sorted_logits)
    return filtered

logits = torch.tensor([2.0, 1.0, 0.2, -0.5])
filtered = sample_top_p(logits, p=0.8)
print(torch.isfinite(filtered).tolist())
print(torch.multinomial(torch.softmax(filtered, dim=-1), 1).item())
[True, True, False, False]
0
最后一行是随机的,运行时可能是 1;前两行留下了累计概率达到阈值的候选。为了复现实验,可以先调用 torch.manual_seed(7),线上则要明确每个请求的随机数生成器,避免多线程调度改变全局随机状态。
4.4 一个组合 sampler
下面把 temperature、top-k、top-p 和 greedy 接成一个简化版本。采样顺序通常是先温度缩放,再做 top-k/top-p 过滤,最后从剩余概率抽取;不同推理框架的参数边界和实现细节可能不同,读文档并做对照测试。
import torch


def sample_next(logits, temperature=1.0, top_k=0, top_p=1.0):
    logits = logits.float()
    if temperature <= 0:
        return logits.argmax(dim=-1)
    logits = logits / temperature
    if top_k > 0:
        values, _ = torch.topk(logits, min(top_k, logits.size(-1)), dim=-1)
        cutoff = values[..., -1, None]
        logits = logits.masked_fill(logits < cutoff, float("-inf"))
    if top_p < 1.0:
        sorted_logits, sorted_idx = torch.sort(logits, descending=True, dim=-1)
        probs = torch.softmax(sorted_logits, dim=-1)
        remove = torch.cumsum(probs, dim=-1) > top_p
        remove[..., 1:] = remove[..., :-1].clone()
        remove[..., 0] = False
        sorted_logits = sorted_logits.masked_fill(remove, float("-inf"))
        logits = torch.full_like(logits, float("-inf"))
        logits.scatter_(-1, sorted_idx, sorted_logits)
    probs = torch.softmax(logits, dim=-1)
    return torch.multinomial(probs, num_samples=1).squeeze(-1)

scores = torch.tensor([[0.2, 1.1, 2.4, 0.4]])
torch.manual_seed(7)
print("greedy:", int(sample_next(scores, temperature=0)))
print("sample:", int(sample_next(scores, temperature=0.8, top_k=3, top_p=0.9)))
greedy: 2
sample: 2
采样参数改变的是“从分数到 token”的后处理,不会减少 Transformer 本身的 KV 读取。高并发服务还要考虑采样本身的 GPU/CPU 开销、batch 维度、约束解码和停止词。若输出要满足 JSON、正则或工具调用格式,top-p 并不能替代语法约束。
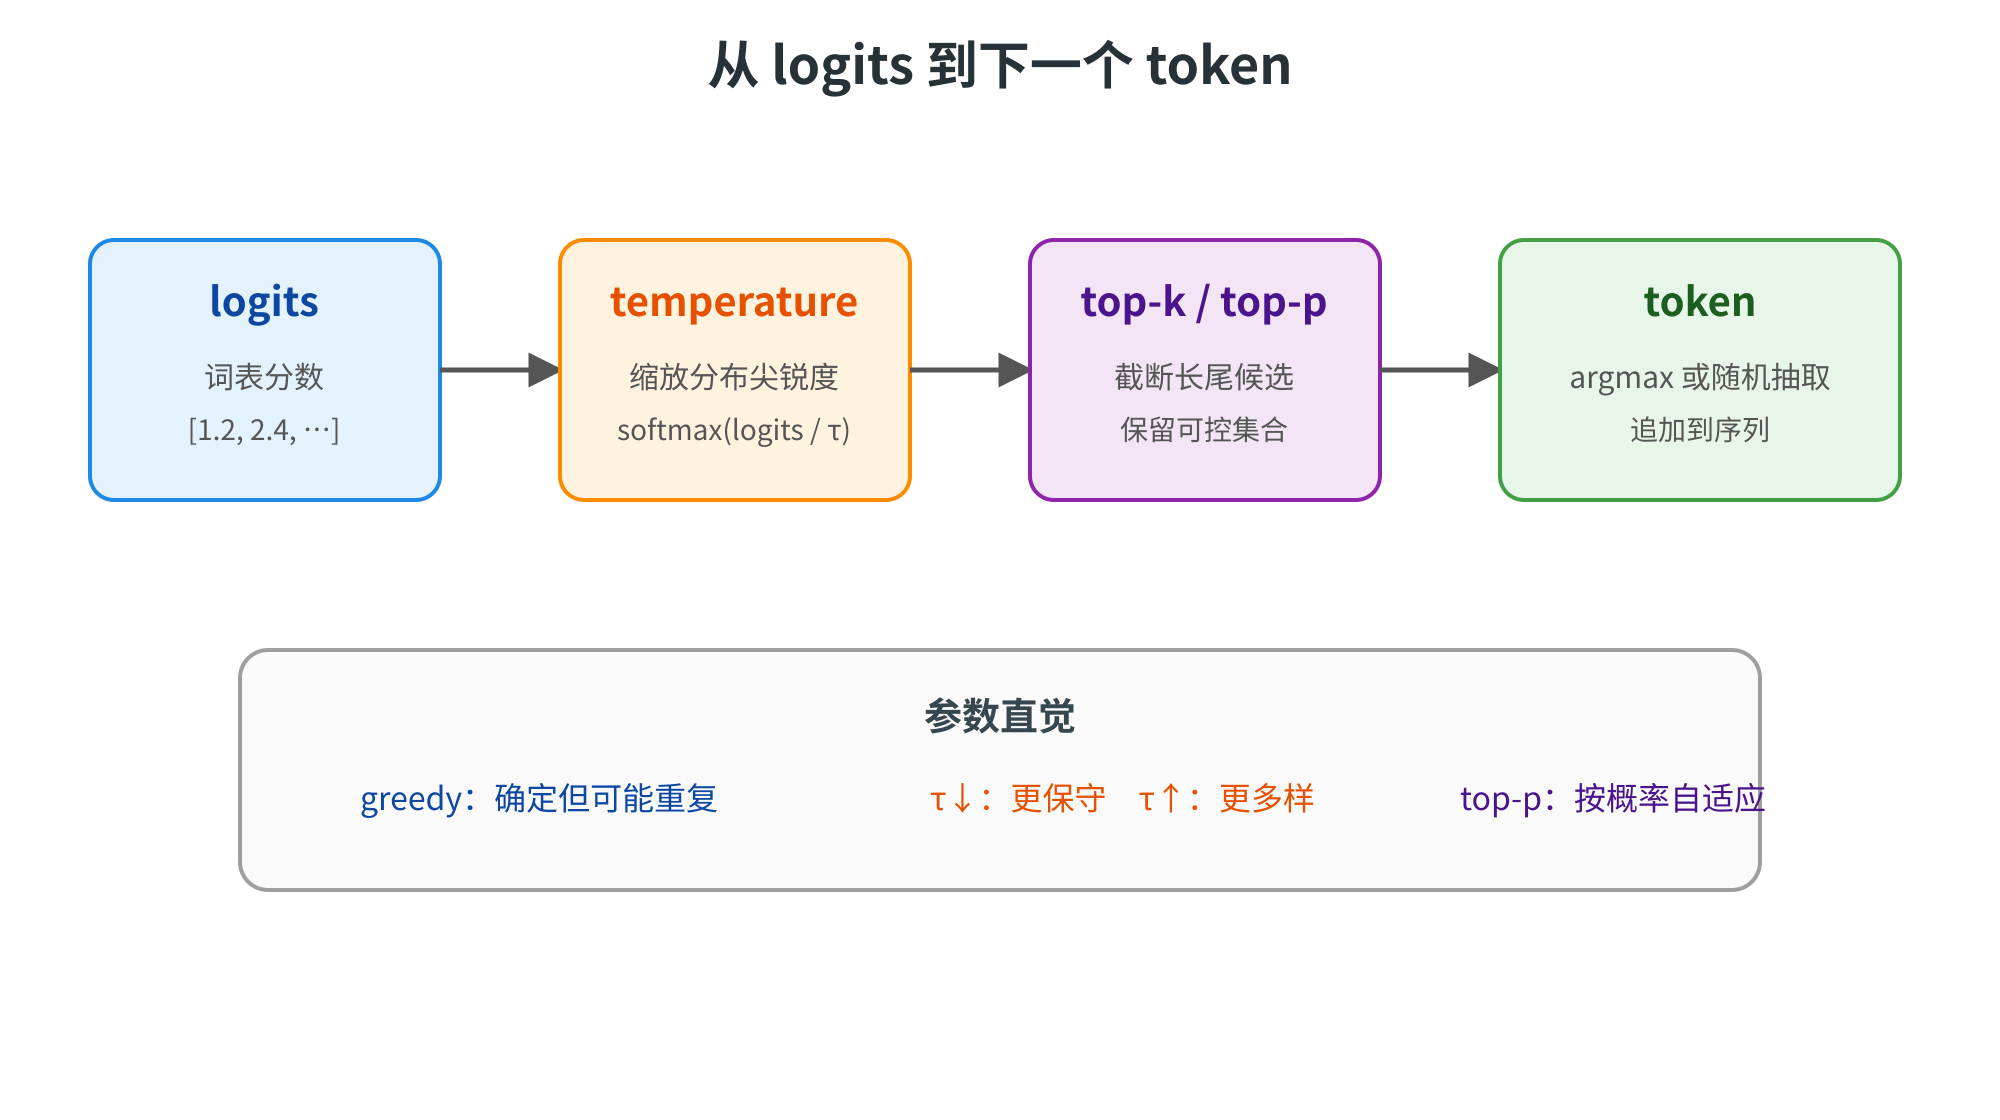
图4 logits 经过温度、top-k、top-p 到 token
AI Infra 视角:模型 forward 给出 logits,运行时负责把它变成请求状态的下一步。把采样做成 batch-aware 的 GPU kernel 或高效的后处理,可以减少 decode 每轮的 Python 开销;但越复杂的约束也越可能打断稳定图,因此需要在正确性、延迟和可观测性之间取平衡。
五、把机制接到 vLLM 与 SGLang
5.1 为什么需要推理运行时
如果只用 PyTorch,我们可以加载模型、循环 forward、自己维护列表形式的 KV Cache。但生产服务还要解决:数百请求的排队和取消、不同长度的缓存分配、batch 动态变化、显存碎片、流式返回、张量并行、量化、prefix caching、指标和故障恢复。把这些都塞进业务代码,会很快变成一个难以验证的调度器。
vLLM、SGLang 等推理系统把模型执行放进运行时。它们会跟踪活跃序列和 token 预算,使用更适合碎片化请求的 KV Cache 管理方式,尽量让 GPU 每轮都有工作。它们不是“换一个 import 就自动变快”的魔法:模型架构支持、GPU、权重格式、并行策略、采样参数和请求分布都会影响结果。
5.2 vLLM 的切入点:Paged KV Cache 与调度
vLLM 的经典思路是把 KV Cache 按固定大小的 block 管理,让逻辑序列不必占据一段连续显存。一个请求的 token 可以映射到多个物理块;块可以按需分配和回收。这样新请求不需要为最大长度一次性预留完整连续区域,也降低了不同长度请求交错时的碎片问题。调度器以 token/block 预算为约束,配合 continuous batching 推进序列。
这里的“paged”可以类比操作系统的分页:逻辑地址连续,物理页不必连续。但 GPU kernel 需要根据 block table 找到实际 K/V,间接寻址和内存访问模式也要付出代价。优化目标不是消灭所有开销,而是让总吞吐、可用并发和尾延迟更好。
5.3 SGLang 的切入点:程序化生成与缓存复用
SGLang 关注把复杂的生成程序、结构化输出和模型调用组织在一个运行时里。一个 Agent 可能先生成计划,再调用工具,把工具结果拼回 prompt,最后生成回答;如果每一步都由应用层拆成独立请求,前缀会重复传输和计算。运行时可以识别共享前缀、安排多分支生成,并把缓存复用纳入执行计划。
这不是说 SGLang 与 vLLM 只有一个功能差异,也不是要在本篇给出版本绑定的性能结论。更稳妥的理解是:它们都在解决“如何把生成程序和高效模型执行连接起来”,具体 kernel、调度、模型支持和 API 会随版本变化。选型时应以目标模型、约束输出、并行规模、运维能力和实际压测为准。
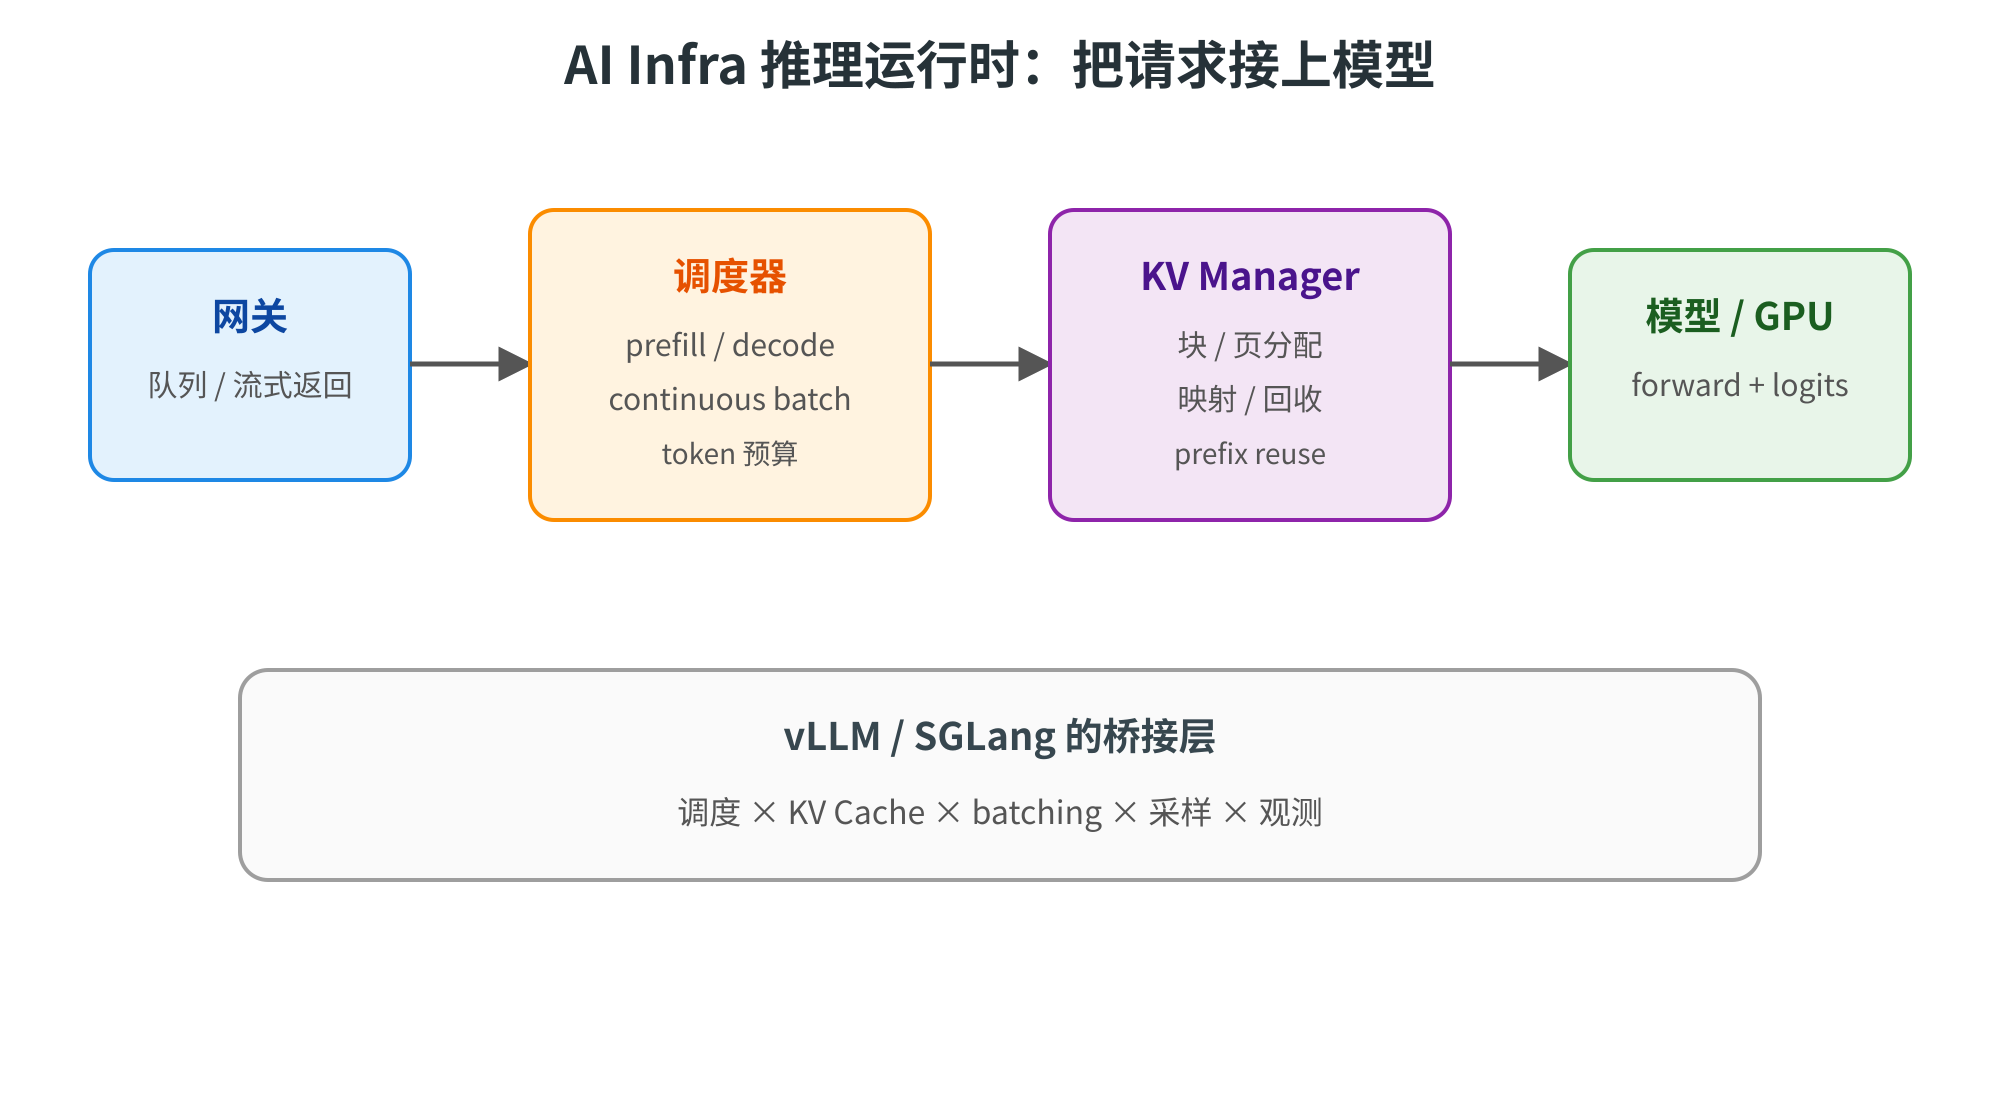
图5 从请求到 AI Infra 推理运行时的桥
5.4 一次请求在系统中的观测点
把端到端链路写成事件,排查会比只看 GPU 利用率有效:
- 网关收到请求,记录队列时间、租户和取消信号。
- tokenizer 产生 prompt token,记录输入长度和截断策略。
- 调度器决定 prefill、decode、batch 和 token 预算。
- KV Cache 管理器分配、映射、追加和释放块。
- 模型执行产生 logits;采样器应用 temperature、top-k、top-p 或约束。
- detokenizer 流式返回 token,记录输出长度和首 token 时间。
指标也要按阶段分开:TTFT 主要反映排队和 prefill;TPOT 主要反映 decode、KV 读取和采样;GPU 显存反映权重与活跃 cache;p99 反映偶发的长 prompt、抢占、重新编译或块分配。第 46 篇提到的 compile time、graph break 和 shape bucket 也应作为启动与热路径的维度保留。
5.5 一个本地实验矩阵
没有多卡服务器时,仍可以用小模型或 toy 模型验证机制。不要把 toy 的绝对 tokens/s 当成生产结论,而要验证趋势和测量方法:
| 变量 | 对照 | 重点观察 |
|---|---|---|
| cache | 每步重算 / 保存 K,V | decode 时间、显存增长 |
| batch | 1 / 2 / 4 / 8 | 吞吐、单请求 p95、OOM |
| 调度 | 静态 / continuous 模拟 | 空槽、等待时间、完成顺序 |
| 采样 | greedy / top-k / top-p | 多样性、重复率、CPU/GPU 时间 |
| 长度 | 短 prompt / 长 prompt | TTFT、KV 占用、TPOT |
每个实验固定模型、dtype、设备、随机种子和停止条件;先测正确性,再测性能。若改变 batch 的同时改变了 prompt 长度和采样参数,就无法知道收益来自哪里。
六、写一个可验证的最小解码实验
6.1 先用线性层模拟缓存路径
完整 Transformer 太重,不适合为了学习调度而反复等待。可以先写一个“每个 token 产生一个 K/V 并累积”的 toy 模型,分别实现重算路径与缓存路径,确认两者输出在同一数学定义下接近,再测调用次数。真实 Transformer 的缓存是在每一层进行,toy 只保留结构直觉。
import torch

class ToyKV:
    def __init__(self, dim=4):
        self.dim = dim
        self.keys = []
        self.values = []

    def step(self, token):
        key = token @ torch.eye(self.dim)
        value = token * 2
        self.keys.append(key)
        self.values.append(value)
        keys = torch.stack(self.keys)
        values = torch.stack(self.values)
        weights = torch.softmax(key @ keys.T, dim=-1)
        return weights @ values

cache = ToyKV()
for i in range(3):
    token = torch.zeros(4)
    token[i] = 1
    print(i, cache.step(token).round(decimals=3).tolist())
0 [0.0, 0.0, 0.0, 2.0]
1 [0.0, 0.0, 0.731, 1.269]
2 [0.0, 0.576, 0.712, 0.712]
这个输出的具体数字来自 toy 的向量定义,重点是每次调用后 keys 与 values 的长度只增加一个。正式实现不应使用 Python list 保存 GPU Tensor 并频繁 stack,但用它做单元测试很直观。
6.2 正确性检查要先于速度
缓存版本和重算版本应该在相同权重、相同 token、相同 mask 与位置编码下比较 logits。浮点运算顺序变化时使用 torch.testing.assert_close,并检查没有 NaN/Inf。停止 token、最大新 token 数、空 prompt、batch 中不同完成时间都是边界案例。
import torch

def check_logits(reference, actual):
    assert reference.shape == actual.shape
    assert torch.isfinite(actual).all()
    torch.testing.assert_close(reference, actual, rtol=1e-4, atol=1e-5)

reference = torch.tensor([[0.1, 0.2, 0.7]])
actual = reference + 1e-7
check_logits(reference, actual)
print("cache correctness: ok")
cache correctness: ok
性能测试再加入 warmup、GPU 同步和多轮重复。分别记录 prefill、每轮 decode、采样和端到端时间,避免把 tokenizer 或打印时间混入模型时间。批量实验要报告每请求延迟与总输出 tokens/s;只报告后者会掩盖某个请求一直等待的问题。
6.3 设计一个可复现的报告
hardware: GPU model / CPU
software: Python, PyTorch, CUDA, runtime version
model: layers, hidden, heads, kv_heads, parameters
data: prompt length distribution, max new tokens
cache: dtype, block size or contiguous, peak GiB
batching: static / dynamic / continuous, max tokens
sampling: greedy / temperature / top-k / top-p
result: TTFT, TPOT, p50, p95, p99, output tokens/s
correctness: max diff, stop behavior, finite logits
finding: bottleneck, memory limit, next experiment
有了这张报告,才可以把第 46 篇的“稳定编译执行”与本篇的“动态请求执行”放在一起比较:编译 warmup 影响冷启动,KV Cache 影响活跃 token 容量,batching 影响排队与吞吐,采样影响输出行为。它们是一个系统里的不同旋钮,不应互相替代。
七、踩坑大全
坑 1:把 prefill 和 decode 混在一个平均数里。 现象是 benchmark 看似稳定,却无法解释首 token 慢还是后续 token 慢。原因是两段工作负载的并行度和瓶颈不同;分别记录 TTFT、TPOT 与总吞吐。
坑 2:以为 KV Cache 让每一步都是常数时间。 Cache 省掉旧 K/V 的重算,但当前 Query 仍要读取越来越长的上下文;长上下文 decode 可能受带宽限制。记录上下文长度、cache 读取和 TPOT。
坑 3:用 torch.cat 反复追加真实 KV。 现象是显存复制和延迟随长度恶化。原因是每次追加都可能分配新存储;生产路径使用预分配、块表或分页 cache,并测试碎片和释放。
坑 4:只按请求数限制 batch。 两个长上下文请求可能比十个短请求占用更多显存。用 token 数、KV block 数和权重余量共同设置预算,OOM 时保留可诊断日志。
坑 5:padding 没有 mask。 现象是输出受到补齐 token 污染。原因是模型把 padding 当作有效上下文;检查 attention mask、位置编码和 tokenizer 的 pad/eos 约定。
坑 6:静态 batch 等最慢请求。 现象是 GPU 有工作但短请求 p99 很差。原因是 batch 生命周期被最长序列决定;尝试 continuous batching、长度分桶或设置最大等待时间。
坑 7:top-p 边界实现错一位。 现象是候选集合比预期过小、输出突然重复。原因是把第一个超过阈值的 token 也删掉;排序后应保留跨过累计概率阈值的那个候选,并测试 p 接近 0 和 1 的情况。
坑 8:temperature 等于 0 仍然除法。 现象是 NaN 或运行时警告。温度为 0 应显式选择 greedy;正温度才做缩放,并限制参数范围。
坑 9:把采样随机性当成模型质量。 同一 prompt 的两个不同答案不一定代表模型变好。固定 seed 做回归测试,再用多 seed 评估多样性、重复率和任务成功率。
坑 10:缓存跨请求错误复用。 现象是答案混入别的用户上下文。KV Cache 默认属于单个序列;prefix caching 必须验证前缀、隔离租户、维护引用计数,并在请求结束后可靠回收。
坑 11:只看 GPU 利用率。 利用率高可能是在做无效 padding 或频繁搬运,利用率低也可能是 decode 的正常小步工作。结合 TTFT、TPOT、tokens/s、显存、队列时间和 p99 判断。
坑 12:认为 vLLM/SGLang 参数在所有版本都相同。 运行时的模型支持、block 配置、量化和采样 API 会变化。固定版本和硬件,先读对应文档,再用目标 workload 压测,不要复制别人的绝对数字。
八、小结
- 自回归生成由 prefill 和 decode 组成:前者处理整段 prompt,后者逐 token 推进,二者的并行度和瓶颈不同。
- KV Cache 保存每层历史 Key/Value,避免每一步重复投影旧前缀;代价是随活跃 token 数增长的显存和带宽读取。
- Cache 的核心账本是
layers × 2 × batch × kv_heads × sequence × head_dim × bytes;GQA/MQA、块管理和回收策略都会影响容量。 - 静态 batching 简单且适合稳定形状,dynamic batching 用短窗口组队,continuous batching 在请求完成后立即补位;吞吐、TTFT、TPOT 和 p99 必须一起看。
- greedy、temperature、top-k、top-p 是 logits 到 token 的后处理旋钮;实现采样要处理 batch 维度、边界、随机种子和约束输出。
- vLLM、SGLang 把 KV Cache、调度、分页/块管理和生成程序放进 AI Infra 运行时;第 46 篇的 compile 只是其中的模型执行优化一环。
九、课后练习
- (基础) 用一个固定 logits 向量实现 greedy 和 temperature 采样,打印三种温度下的概率,解释分布变化。
- (基础) 为 toy attention 增加
batch维度,检查每个请求的 KV 长度可以不同,并写出 padding mask。 - (理解) 根据一个真实或假设模型的层数、
kv_heads、head_dim、dtype 和并发数,计算 1,024、4,096、16,384 上下文的 KV Cache 显存。 - (理解) 分别实现重算前缀与复用 K/V 的 toy decode,固定随机输入,比较结果误差和每步 Tensor 操作次数。
- (进阶) 写一个静态 batch 和 continuous batching 模拟器,输入不同到达时间、生成长度,比较平均等待、p95 和活跃槽位利用率。
- (进阶) 从零实现 batch-aware 的 top-k/top-p,测试
k=1、p=1、极端 logits、batch size 大于 1 和无效参数。 - (AI Infra) 用小模型或 mock engine 记录 TTFT、TPOT、p50、p95、显存和 tokens/s,比较 batch 上限与最大 token 预算的影响。
- (综合) 画出一个 vLLM/SGLang 风格服务的状态机:请求队列、prefill、decode、KV block 分配、采样、停止和回收,并标注每个阶段的观测指标。
下一篇预告
第48篇|通往 AI Infra 和 Agent:vLLM/SGLang 与 Agent 框架全景。下一篇把本篇的单个生成请求、KV Cache 和 continuous batching 放到更大的地图里:从 PyTorch 模型、推理运行时、网关和观测,到工具调用、记忆、规划与多步 Agent 框架,厘清 vLLM、SGLang 与 Agent 编排层各自负责什么,以及如何选择边界。专栏四也将在这里收束:你将能从 Tensor、CUDA 和模型结构一路追到可部署的 AI Infra 服务。