
第43篇|手写 Attention 与 Transformer Block
本篇定位:专栏四「PyTorch 与 AI Infra 入门」的第七篇。承接第 42 篇的优化器、损失函数与学习率调度,把“模型如何在序列里选择信息”落到可运行的 Attention 与 Transformer Block。
读完你将能够:从张量 shape 推导缩放点积 Attention;解释
Q、K、V与多头的直觉;手写带 causal mask 的 Attention、残差连接、LayerNorm 和前馈网络;用 PyTorch 组装一个小型 Transformer Block,并从计算量、显存和 KV Cache 的角度读懂 AI Infra 的取舍。预计用时:阅读 60~80 分钟,动手 60~90 分钟。
第 42 篇解决了“有梯度之后怎样更新参数”:loss 告诉我们错多少,优化器决定怎么走,scheduler 决定步子怎样变化。但模型还缺一个关键能力:输入是一串 token 时,当前位置怎样找到真正有用的上下文?例如,代词“它”应该关注前面的哪个名词,代码中的括号应该和哪一个括号配对。Attention(注意力)正是把这个选择过程写成一次可学习的加权读取。
本篇不把 Transformer 当成一只黑盒。我们先用矩阵乘法写出最小 Attention,再加入多头、残差、归一化和 FFN(Feed-Forward Network,前馈网络),最后看一个 decoder-only block 的完整前向。下一篇第 44 篇会把这些积木放进 token 预测训练循环,做出一个能生成字符的 mini-GPT。
一、Attention:让每个位置读取上下文
1.1 从“相似度检索”开始
设一批序列已经被编码成隐藏状态 X,shape 是 [B, T, D]:B 是 batch size,T 是序列长度,D 是隐藏维度。对序列中的某个位置来说,它需要提出一个问题:“我想找什么信息?”这就是 query;其他位置提供“我是否匹配”的索引 key,以及被真正取回的内容 value。
在 Attention 里,Q、K、V 通常由同一个 X 经过三个不同的线性投影得到:
Q = X W_Q       # 查询:当前行想找什么
K = X W_K       # 键:每个位置有什么特征可匹配
V = X W_V       # 值:匹配后真正读取的内容
如果 Q 的第 i 行和 K 的第 j 行点积很大,说明位置 i 对位置 j 的需求相似,位置 j 会得到更高权重。把所有位置的相似度写成矩阵,就是 QKᵀ,shape 为 [B, T, T]。最后用这个权重矩阵去乘 V,得到每个位置融合上下文后的结果。
这和数据库检索有一个容易混淆但很有用的类比:Q 像查询条件,K 像索引,V 像记录内容。Attention 并不只返回最相似的一条记录,而是用 softmax 形成一个平滑的加权读取,所以梯度可以同时流向多个候选位置。
1.2 为什么要除以 sqrt(d_k)
原始分数是点积:
scores = QKᵀ
假设 Q 和 K 的每个分量均值接近 0、方差接近 1,维度越大,点积的方差大约也越大。分数范围变宽后,softmax 很容易变得尖锐:最大值几乎拿走全部概率,其余位置接近 0,梯度就不友好。缩放点积 Attention(Scaled Dot-Product Attention)把分数除以 sqrt(d_k):
Attention(Q, K, V) = softmax(QKᵀ / sqrt(d_k)) V
这里的 d_k 是每个 head 的 key 维度,而不是整个模型维度。缩放不是装饰,而是让不同隐藏宽度下的 logits 保持更合适的数值尺度。进入半精度训练时,softmax 前的范围尤其重要;过大的 logits 还可能放大 Inf、NaN 风险。
import math
import torch

torch.manual_seed(7)
q = torch.randn(2, 3, 4)  # [B, T_query, d_k]
k = torch.randn(2, 5, 4)  # [B, T_key, d_k]
v = torch.randn(2, 5, 6)  # [B, T_key, d_v]
score = q @ k.transpose(-2, -1) / math.sqrt(k.size(-1))
weight = torch.softmax(score, dim=-1)
out = weight @ v
print(score.shape, weight.shape, out.shape)
print(torch.allclose(weight.sum(dim=-1), torch.ones(2, 3)))
torch.Size([2, 3, 5]) torch.Size([2, 3, 5]) torch.Size([2, 3, 6])
True
注意最后一维是被读取的 key 位置。对每个 query 行做 softmax,所以 weight.sum(dim=-1) 应接近 1。先写这类 shape 断言,比盯着一串浮点数更容易发现转置方向错误。
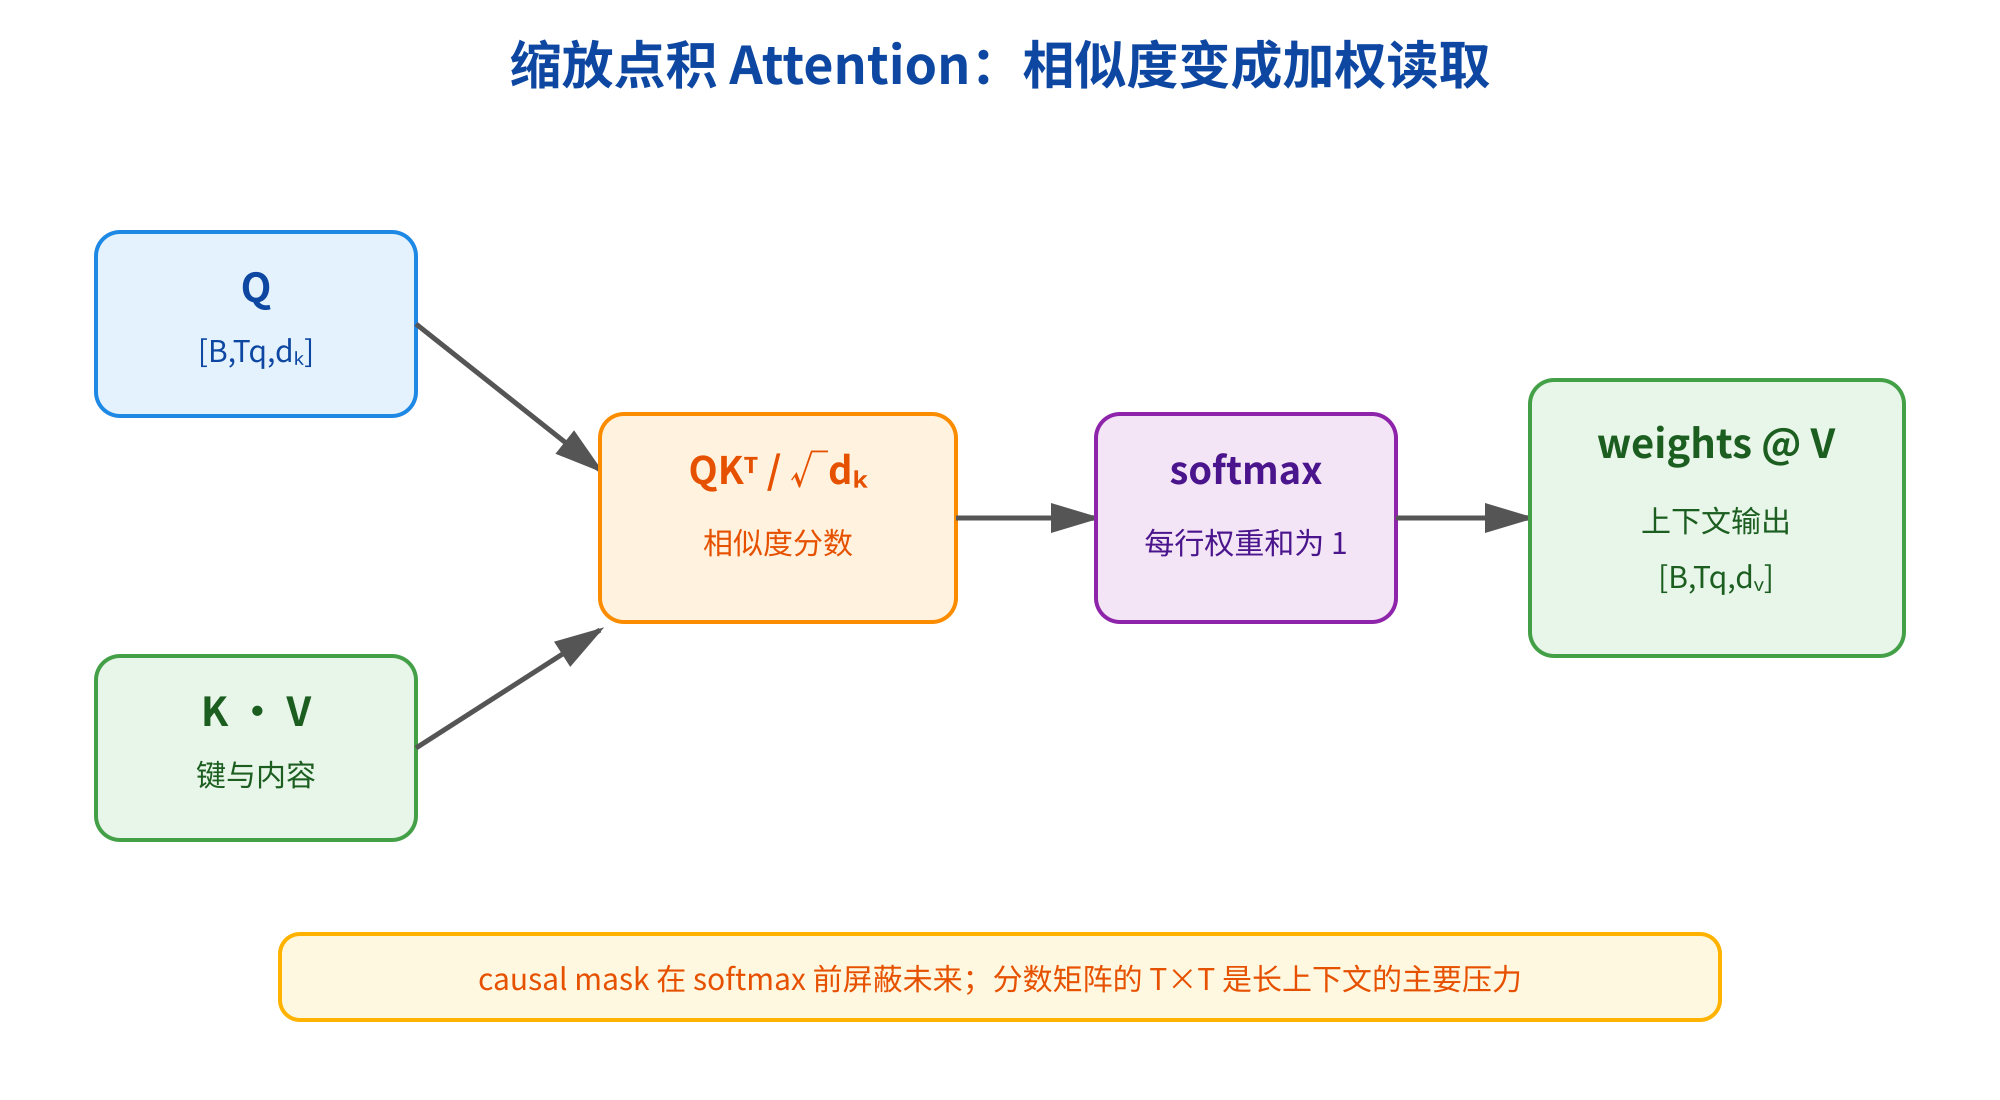
图1 缩放点积 Attention 的数据流
AI Infra 视角:标准 Attention 的分数矩阵是
[B, T, T]。序列长度从T变成2T时,分数和临时权重的元素数量大约变成 4 倍,这就是长上下文主要的计算与显存压力来源之一。
1.3 causal mask:不能偷看未来
做语言模型时,位置 t 只能读取 0...t,不能看到目标 token 之后的内容,否则训练时模型会作弊。causal mask 是一个上三角为负无穷的矩阵:softmax 前把不允许的位置设成 -inf,softmax 后它们就变成 0。
import math
import torch

T, d = 4, 3
torch.manual_seed(1)
x = torch.randn(T, d)
scores = x @ x.T / math.sqrt(d)
future = torch.triu(torch.ones(T, T, dtype=torch.bool), diagonal=1)
scores = scores.masked_fill(future, float("-inf"))
weights = torch.softmax(scores, dim=-1)
print(weights.round(decimals=3))
print(torch.all(weights.masked_select(future) == 0).item())
tensor([[1.000, 0.000, 0.000, 0.000],
        [0.XXX, 0.XXX, 0.000, 0.000],
        [0.XXX, 0.XXX, 0.XXX, 0.000],
        [0.XXX, 0.XXX, 0.XXX, 0.XXX]])
True
不同 PyTorch 版本打印的随机小数可能不同,关键性质是对角线以下可见、右上角全为 0。实际模块里 mask 往往注册成 buffer,随模型一起移动到 GPU,但不作为可训练参数。
二、QKV 与多头:同一序列的多种关系
2.1 一次线性层同时产生 QKV
教学代码可以分别写 W_Q、W_K、W_V,工程实现通常用一个线性层把最后一维从 D 映射到 3D,再切成三份。这样做减少了 Python 调度和小矩阵操作,底层也更容易融合成高效 kernel。
import torch
from torch import nn

B, T, D = 2, 5, 8
x = torch.randn(B, T, D)
qkv = nn.Linear(D, 3 * D)(x)
q, k, v = qkv.chunk(3, dim=-1)
print(x.shape, qkv.shape, q.shape)
torch.Size([2, 5, 8]) torch.Size([2, 5, 24]) torch.Size([2, 5, 8])
这是 self-attention,因为 query、key、value 都来自同一个 x。在 encoder-decoder 架构的 cross-attention 中,Q 可以来自 decoder,而 K、V 来自 encoder 输出;shape 的规则不变,只是 query 长度和 key 长度可能不同。
2.2 多头的直觉
一个 head 只有一组投影,可能更擅长学习局部邻近、指代、语法或位置等某一种关系。Multi-Head Attention(多头注意力)把 D 拆成 H 个 head,每个 head 宽度为 d_head = D / H,让它们在不同的子空间里并行计算,最后拼回 D:
[B, T, D]
    → [B, T, H, d_head]
    → [B, H, T, d_head]
    → attention per head
    → [B, T, H, d_head]
    → [B, T, D]
多头不是把相同结果复制 H 次。每个 head 有自己的投影参数和注意力分布,因此可能同时表达“这个词和主语相关”“这个位置和括号相关”等不同依赖。D 必须能被 H 整除,否则无法均匀拆分;这是配置校验应在模型初始化阶段完成的条件。
import math
import torch
from torch import nn

class TinyMultiHead(nn.Module):
    def __init__(self, dim: int, heads: int):
        super().__init__()
        if dim % heads != 0:
            raise ValueError("dim must be divisible by heads")
        self.heads = heads
        self.head_dim = dim // heads
        self.qkv = nn.Linear(dim, 3 * dim)
        self.out = nn.Linear(dim, dim)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        b, t, d = x.shape
        q, k, v = self.qkv(x).chunk(3, dim=-1)
        def split(z):
            return z.view(b, t, self.heads, self.head_dim).transpose(1, 2)
        q, k, v = map(split, (q, k, v))  # [B, H, T, d_head]
        score = q @ k.transpose(-2, -1) / math.sqrt(self.head_dim)
        weight = score.softmax(dim=-1)
        y = weight @ v
        y = y.transpose(1, 2).contiguous().view(b, t, d)
        return self.out(y)

x = torch.randn(2, 5, 8)
print(TinyMultiHead(8, 2)(x).shape)
torch.Size([2, 5, 8])
transpose 只改变 stride 视图,之后用 view 前常常需要 contiguous();或者使用 reshape 让 PyTorch 在需要时复制。这个细节不会改变数学公式,却经常决定代码是否能运行。
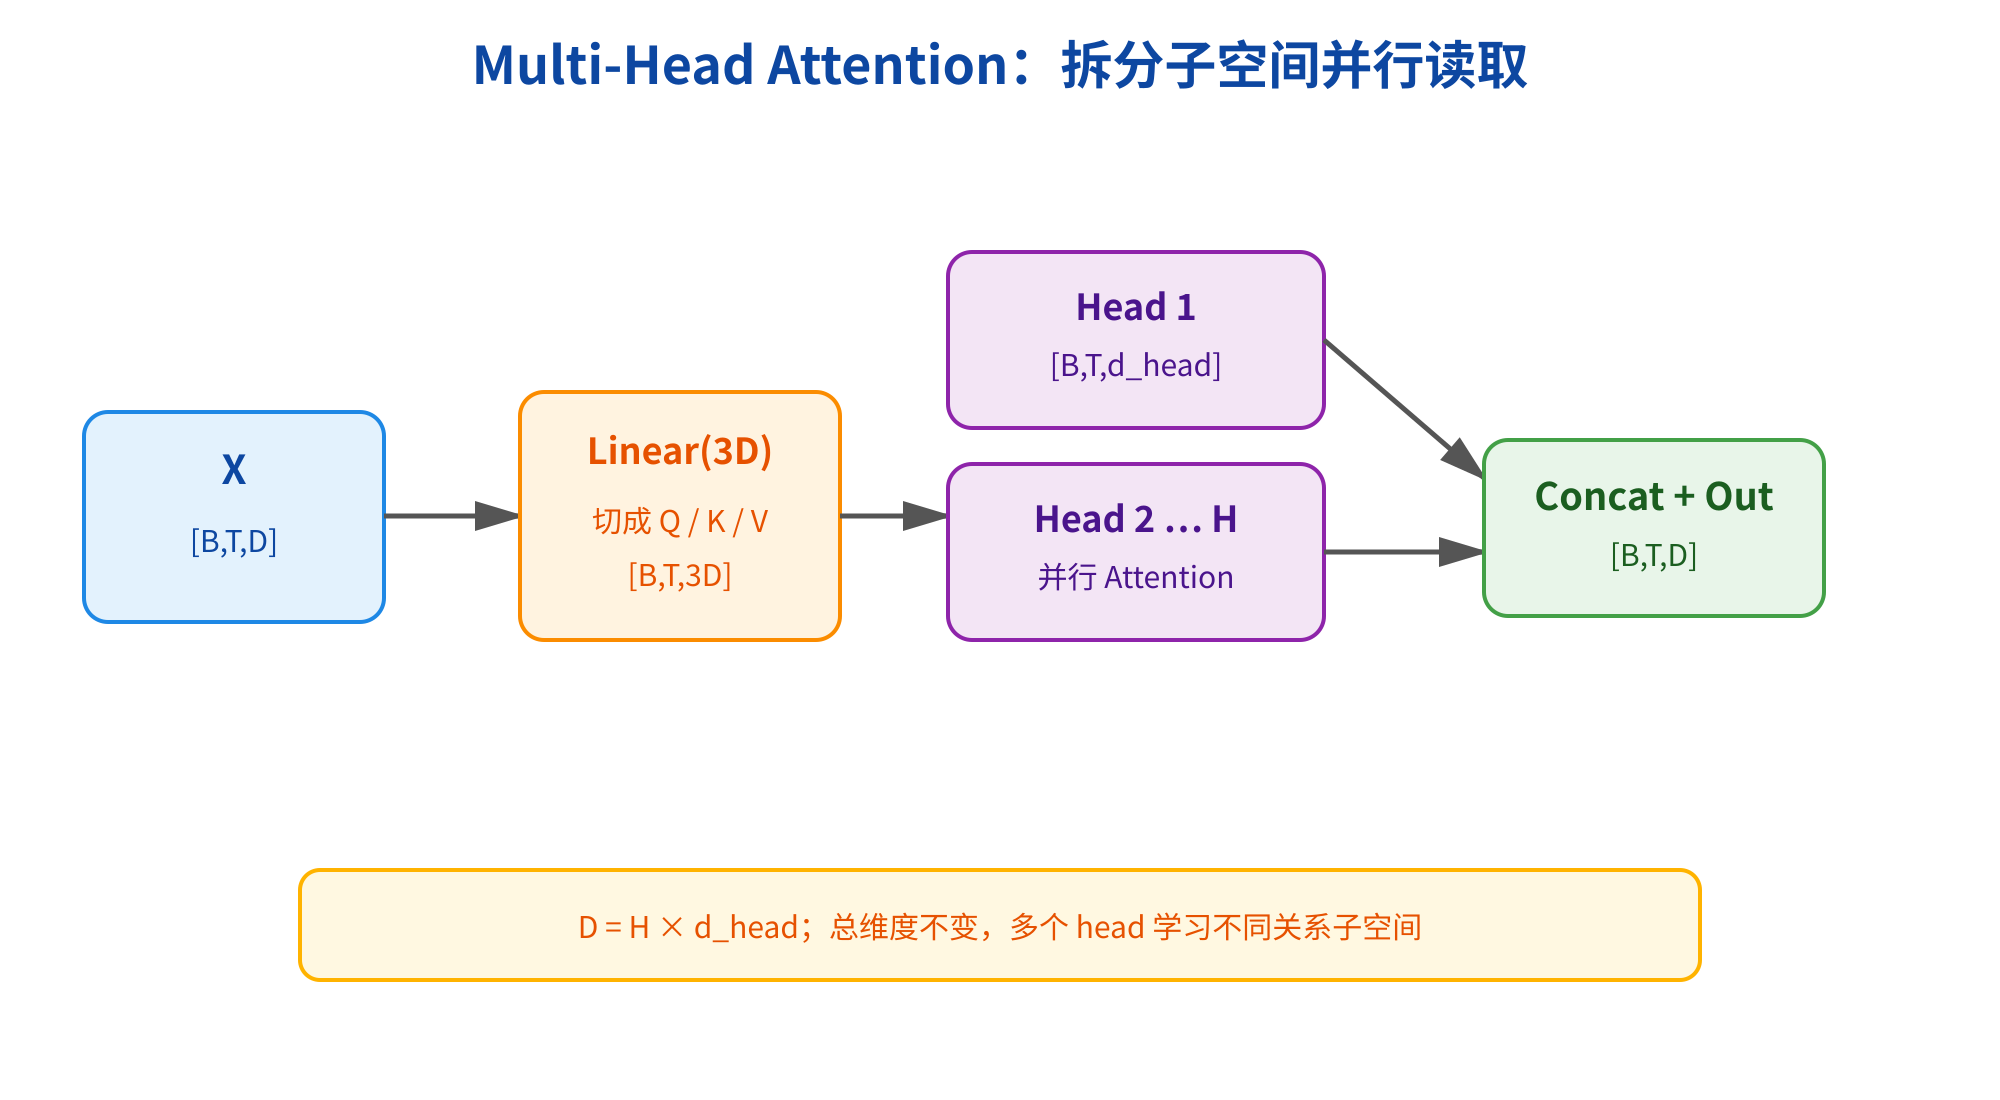
图2 多头 Attention 的 shape 变换
AI Infra 视角:head 数增加不一定带来线性收益。总维度
D不变时,投影参数量大致不变,但 kernel 的形状、访存合并、并行粒度和小矩阵效率会改变。生产系统要同时看 tokens/s、显存带宽利用率和 kernel launch 开销。
2.3 mask 的 shape 与广播
真实模型常见两类 mask:padding mask 表示哪些 token 是填充,causal mask 表示哪些未来位置不可见。Attention 权重的 shape 通常是 [B, H, T_query, T_key],mask 要能广播到这个 shape,例如 [1, 1, T, T] 或 [B, 1, 1, T]。把 [B, T] 的 padding mask 直接和四维 scores 相加,可能广播到错误的轴,甚至不报错但语义错误。
一个稳妥习惯是:在 mask 进入模块前明确写注释,说明每一维代表什么,并用小的 B=1、H=1、T=4 打印被屏蔽位置。mask 的 dtype 也要统一:布尔 mask 适合 masked_fill,加性 mask 则应包含 0 与很小的负数。
三、Transformer Block:注意力只是半边
3.1 残差连接让深层网络可训练
Attention 输出的是“融合上下文后的更新建议”,不应该完全覆盖原输入。残差连接(residual connection)把输入直接加回来:x + Attention(x)。如果某一层暂时学不到有用变换,网络仍可近似恒等映射,梯度也有一条短路径向前传播。深层模型通常重复很多 block,残差是优化稳定性的关键结构。
LayerNorm(层归一化)则在每个 token 的特征维度上计算均值和方差,把激活保持在较稳定的尺度,再用可学习的 gamma、beta 恢复表达能力。它和 BatchNorm 不同:LayerNorm 不依赖 batch 内其他样本,序列长度变化也更自然,适合 Transformer。
标准 Transformer 原论文使用 post-norm:LayerNorm(x + Sublayer(x))。现代 decoder 模型普遍使用 pre-norm:先归一化再进子层:
x = x + Attention(LayerNorm(x))
x = x + FFN(LayerNorm(x))
pre-norm 往往让深层训练和梯度传播更稳,但并不表示两种布局可以随意混换;加载 checkpoint、对照论文或复现结果时,norm 的位置就是架构的一部分。
3.2 FFN:每个位置独立的特征变换
Attention 负责位置之间的信息交换,FFN 负责每个位置内部的非线性变换。最小形式是:
FFN(x) = W₂ activation(W₁x + b₁) + b₂
第一层把 D 扩宽到 D_ff,经过 GELU 或 ReLU,再投影回 D。它在序列位置之间共享参数,但每个位置独立计算,不产生新的 token-to-token 混合。常见配置是 D_ff 约为 4D;这会让 FFN 的参数量和矩阵乘法计算量很可观。
import torch
from torch import nn

ffn = nn.Sequential(
    nn.Linear(8, 32),
    nn.GELU(),
    nn.Linear(32, 8),
)
x = torch.randn(2, 5, 8)
print(ffn(x).shape)
torch.Size([2, 5, 8])
Attention 和 FFN 的职责可以这样记:Attention 是跨位置的路由,FFN 是逐位置的加工。没有 Attention,token 之间无法交换信息;没有 FFN,每个位置只有线性加权读取,表达能力不足。
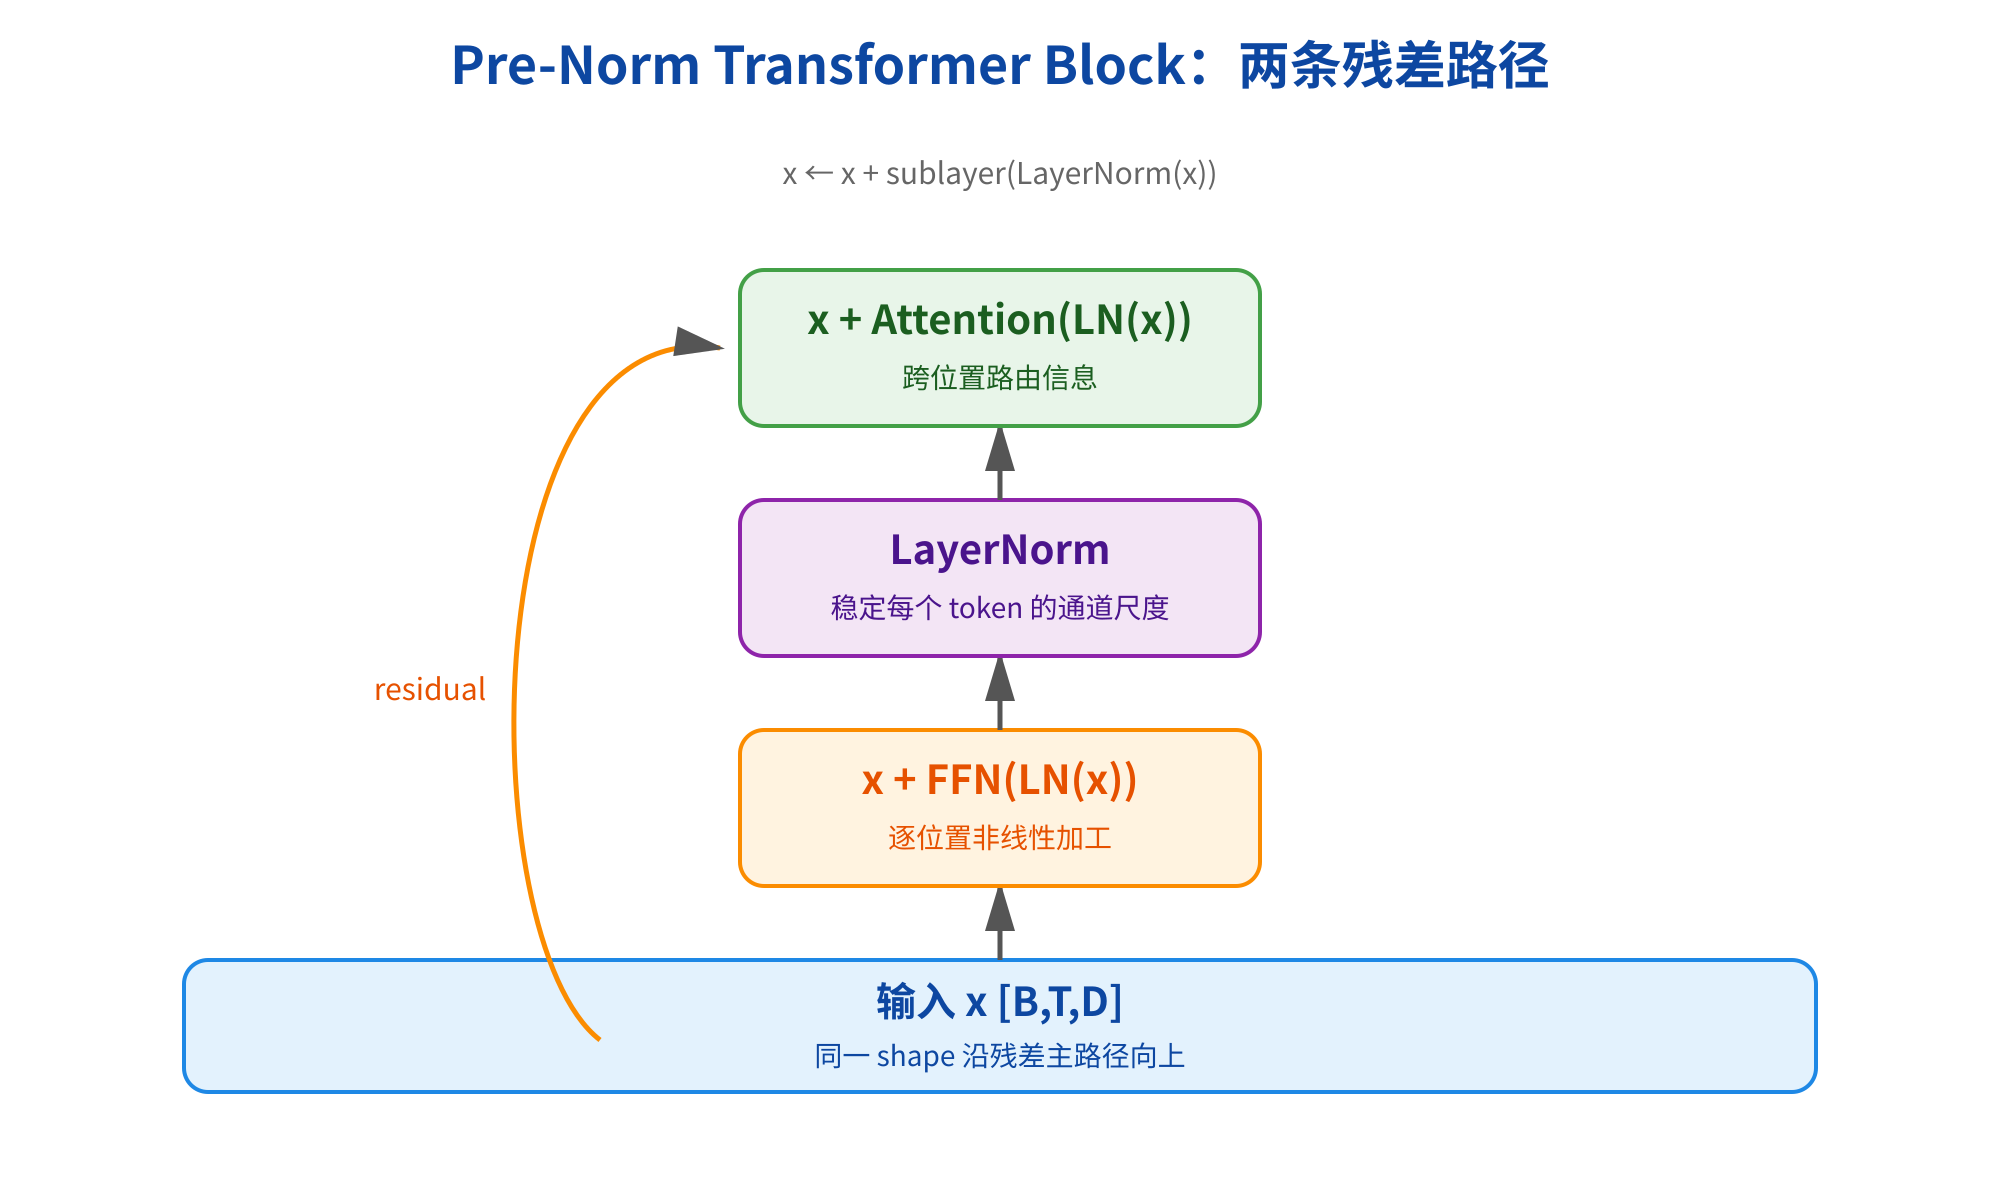
图3 Transformer Block 的 pre-norm 结构
3.3 Dropout 与训练/推理模式
教学 block 可以先不加 Dropout,以便复现数值;训练大模型时通常会在注意力权重或子层输出处使用 Dropout。model.train() 会启用 Dropout,model.eval() 会关闭它。推理时再配合 torch.inference_mode(),减少 autograd 保存的中间结果。不要把 eval() 误认为“不计算梯度”,也不要把 no_grad() 误认为会关闭 Dropout;这是两个不同的开关。
四、手写一个可运行的 Transformer Block
4.1 先把 Attention 写成模块
下面的实现采用 decoder-only 场景:输入和输出长度相同,使用 causal mask。mask 注册为 buffer,因此会随着 model.to(device) 一起移动;persistent=False 表示它不必占 checkpoint 空间,每次按最大长度生成也可以。为了便于教学,我们保留显式的 scores 和 weights。
import math
import torch
from torch import nn

class CausalSelfAttention(nn.Module):
    def __init__(self, dim: int, heads: int, max_tokens: int):
        super().__init__()
        if dim % heads != 0:
            raise ValueError("dim must be divisible by heads")
        self.heads = heads
        self.head_dim = dim // heads
        self.qkv = nn.Linear(dim, 3 * dim)
        self.proj = nn.Linear(dim, dim)
        mask = torch.triu(torch.ones(max_tokens, max_tokens), diagonal=1)
        self.register_buffer("future", mask.bool()[None, None], persistent=False)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        b, t, d = x.shape
        if t > self.future.size(-1):
            raise ValueError("sequence is longer than max_tokens")
        q, k, v = self.qkv(x).chunk(3, dim=-1)
        shape = (b, t, self.heads, self.head_dim)
        q = q.view(shape).transpose(1, 2)
        k = k.view(shape).transpose(1, 2)
        v = v.view(shape).transpose(1, 2)
        scores = q @ k.transpose(-2, -1) / math.sqrt(self.head_dim)
        scores = scores.masked_fill(self.future[:, :, :t, :t], float("-inf"))
        weights = scores.softmax(dim=-1)
        y = weights @ v
        y = y.transpose(1, 2).contiguous().view(b, t, d)
        return self.proj(y)
为了确认 mask 真生效,可以把 weights 临时返回,检查每个 head 的右上角为零。生产实现通常不会保存完整 weights,因为它和 scores 都是 [B, H, T, T];只要输出 y,就可能使用 memory-efficient attention 或 fused scaled dot-product kernel,减少中间张量写回显存。
4.2 pre-norm Block 的完整代码
现在把 Attention 和 FFN 接成一个 block。LayerNorm 默认对最后一维 D 做归一化,恰好对应每个 token 的通道。两个残差分支都保持 [B, T, D],所以 block 可以堆叠,也能被后续的 token embedding 和输出头复用。
class TransformerBlock(nn.Module):
    def __init__(self, dim=64, heads=4, max_tokens=128, expansion=4):
        super().__init__()
        self.norm1 = nn.LayerNorm(dim)
        self.attn = CausalSelfAttention(dim, heads, max_tokens)
        self.norm2 = nn.LayerNorm(dim)
        hidden = expansion * dim
        self.ffn = nn.Sequential(
            nn.Linear(dim, hidden),
            nn.GELU(),
            nn.Linear(hidden, dim),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = x + self.attn(self.norm1(x))
        x = x + self.ffn(self.norm2(x))
        return x

if __name__ == "__main__":
    torch.manual_seed(42)
    block = TransformerBlock(dim=16, heads=4, max_tokens=12)
    tokens = torch.randn(2, 7, 16)
    output = block(tokens)
    print(tokens.shape, output.shape)
    print(sum(p.numel() for p in block.parameters()))
torch.Size([2, 7, 16]) torch.Size([2, 7, 16])
3216
参数数量会随 PyTorch 版本保持一致,因为它只取决于线性层和 LayerNorm;如果你修改 dim、heads 或 expansion,输出 shape 应保持不变,参数量则会变化。这个 smoke test 是第 42 篇所说的“先用一个 batch 验证 shape、dtype、device”的延续。
4.3 和官方模块对照,而不是盲信对照
PyTorch 提供 torch.nn.functional.scaled_dot_product_attention,也提供 nn.MultiheadAttention 和更高层的 Transformer 组件。官方实现可以根据 device、dtype 和 mask 选择优化 kernel。手写版本的价值是理解数据流、定位 shape bug、制作最小实验;生产服务通常应优先使用经过测试和融合的实现。
import torch
import torch.nn.functional as F

q = torch.randn(2, 4, 5, 8)  # [B, H, T, d]
k = torch.randn(2, 4, 5, 8)
v = torch.randn(2, 4, 5, 8)
y = F.scaled_dot_product_attention(q, k, v, is_causal=True)
print(y.shape)
torch.Size([2, 4, 5, 8])
同样的数学公式不保证每个实现逐元素相等:融合 kernel、浮点精度、mask 类型和 dropout 选项都会影响最后几位。对照时先比较 shape、mask 语义和大致数值范围,再用固定 seed 与 float32 做严格测试。
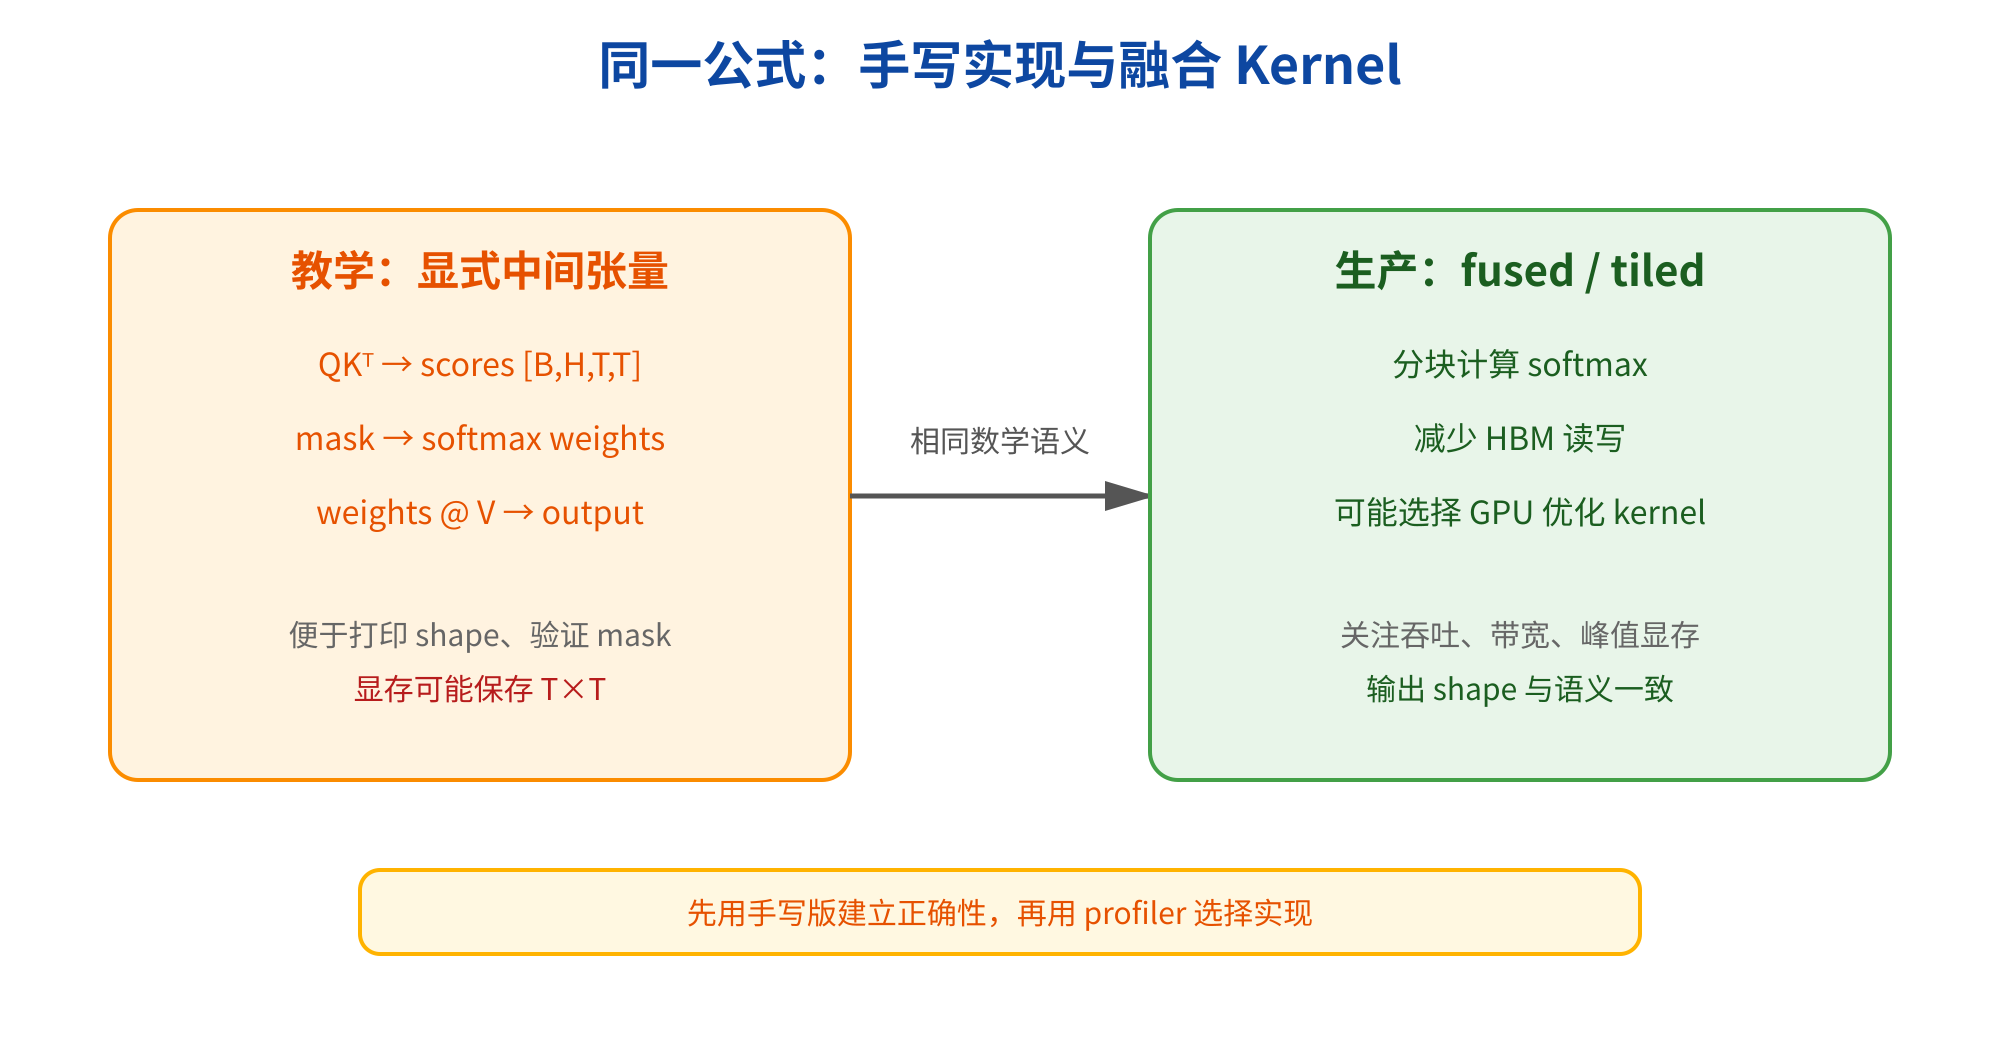
图4 手写实现与 fused kernel 的边界
五、AI Infra:计算量、显存和 KV Cache
5.1 为什么 Attention 是二次复杂度
对单层、单个 batch,QKᵀ 大约需要 O(T²D) 的乘加,得到的注意力矩阵需要 O(T²) 空间;weights @ V 还需要一次类似规模的乘法。T 是真正危险的变量。增大 batch 会近似线性增加工作,而增大上下文长度会让两两位置交互平方增长。
可以用一个粗略表格建立量级感。这里忽略常数、head 拆分、数据类型和 kernel 融合,只看注意力矩阵的元素数:
如果 B=8、H=16、T=4096,仅一个 [B,H,T,T] 的 fp16 权重就有约 1.07 billion 个元素,约占 2 GiB;训练还要保存反向所需的更多中间激活。实际实现会避免显式保留完整矩阵,使用 tiled 或 flash 类算法,在片上内存中分块计算 softmax,减少显存读写,但不能把数学上的 token 两两交互凭空变成线性。
AI Infra 视角:优化 Attention 时要区分 FLOPs 和显存带宽。一个理论 FLOPs 更少的 kernel,如果频繁把大矩阵写回 HBM,也可能比融合实现慢。基准测试应报告 batch、序列长度、dtype、mask、warmup、tokens/s、峰值显存和 p50/p99 延迟。
5.2 训练与生成的访问模式不同
训练时通常已知整段 token,可以并行计算所有位置的 Q、K、V;causal mask 只限制信息可见性。生成时一次只追加一个 token,但如果每一步都把完整前缀重新计算,长度为 T 的生成会反复处理旧 token,延迟很高。
KV Cache 的核心想法是:历史 token 的 K 和 V 不会因为新 token 到来而改变,所以把它们缓存起来。第 t 步只为新 token 计算 q_t、k_t、v_t,将新的 k_t、v_t 追加到缓存,再让 q_t 读取全部历史 K/V。于是单步的注意力不再重新投影整个前缀,代价从重复计算换成了缓存显存和读带宽。
prefill:一次处理 prompt,建立 K/V cache
   ↓
decode step:新 token 只算 q、k、v,追加 k/v
   ↓
q_new 与 cache 中全部 K/V 做注意力,得到下一个 token 的 logits
KV Cache 不是免费加速:每层、每个 batch、每个 head 都要保存历史 K/V,长度越长占用越大。服务端做 continuous batching 时,不同请求的长度和结束时间不同,缓存管理会产生碎片、页式分配和调度问题。第 47 篇会系统讨论 KV Cache、batching 和采样;本篇只需要记住它是“用显存换重复计算”的设计。
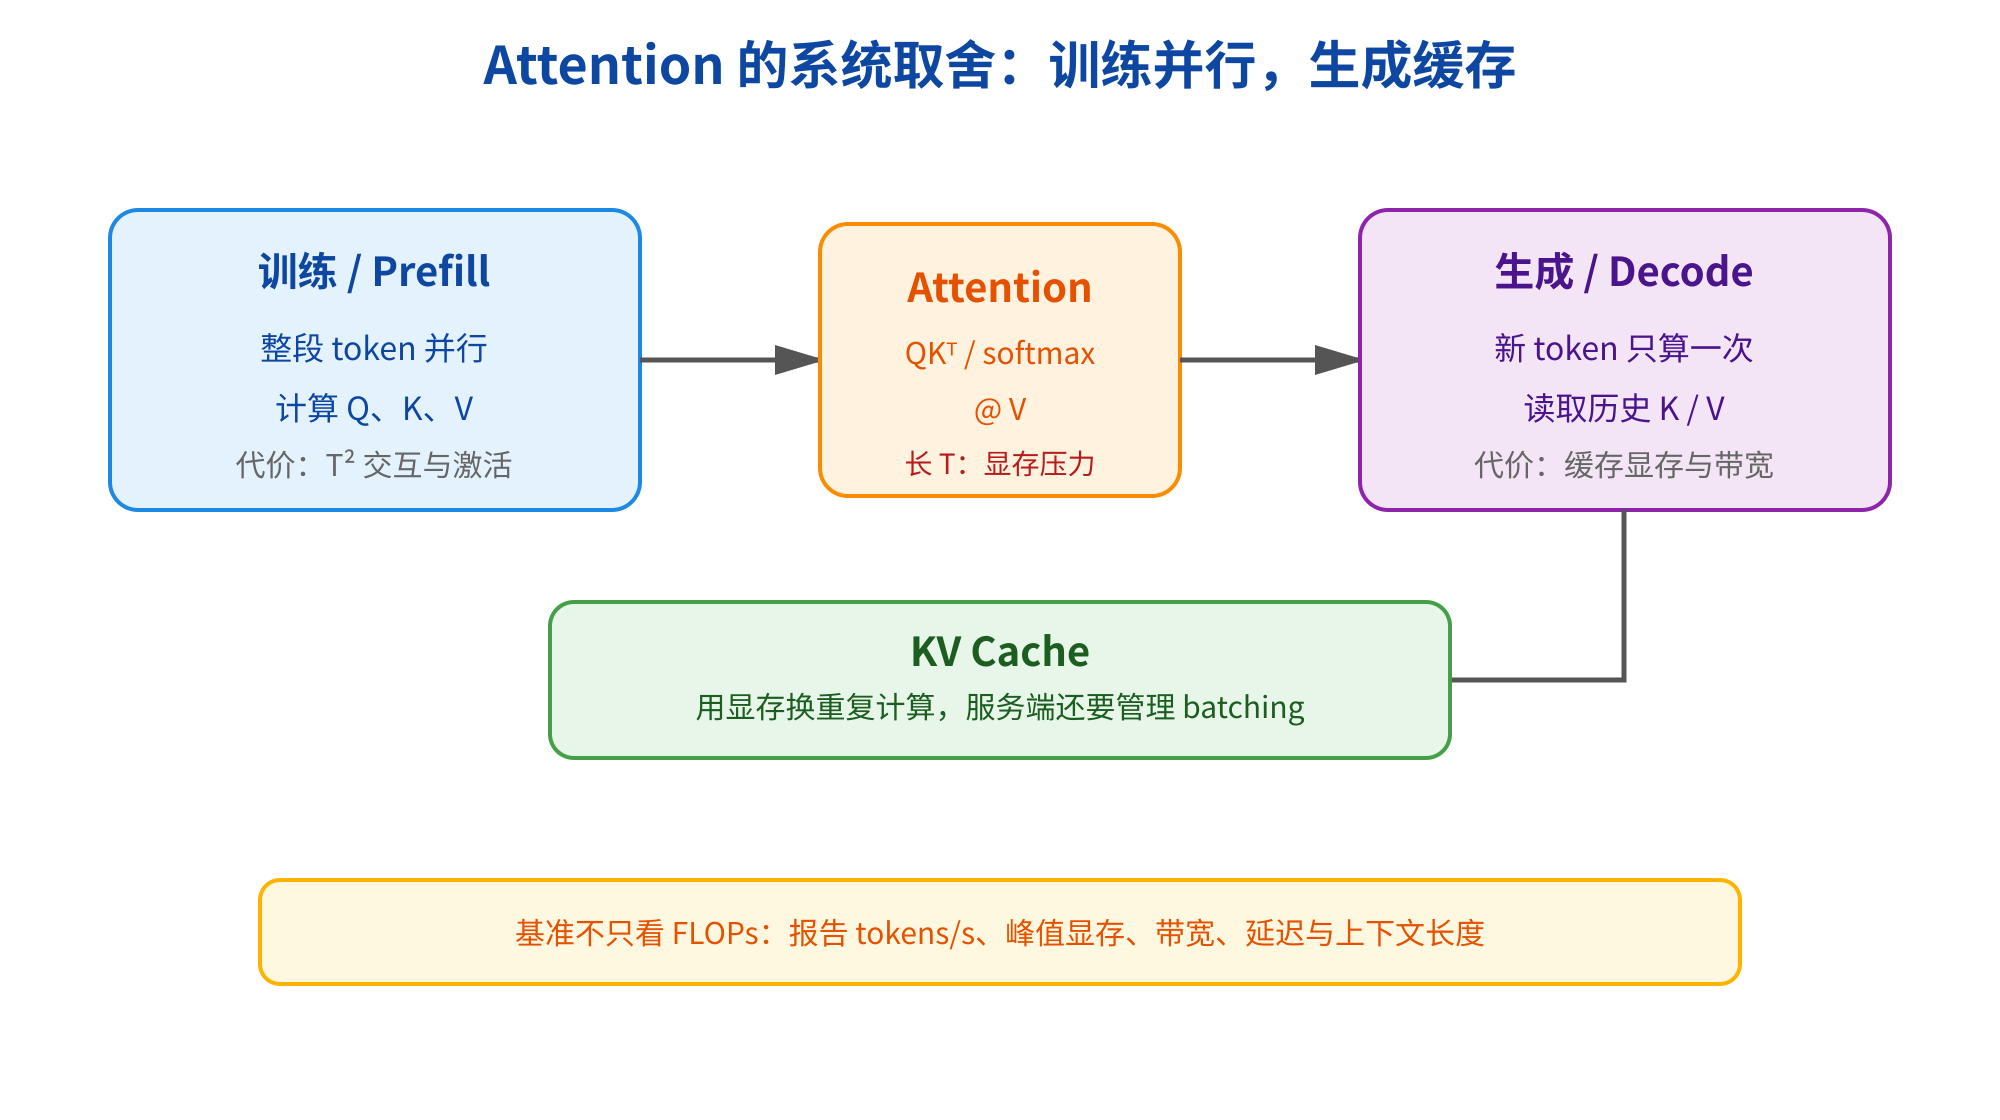
图5 Attention 的计算与 KV Cache 取舍
5.3 从 PyTorch smoke test 走向基准
不要用第一次运行的时间判断 kernel。GPU 需要 warmup,异步执行还需要同步;不同长度的 padding 也会让比较失真。一个最小基准至少固定随机种子、device、dtype、B、T 和 head 配置,先 warmup 若干轮,再用 CUDA event 或同步后的墙钟时间测量。
import time
import torch
from torch import nn

if not torch.cuda.is_available():
    print("CUDA unavailable: run shape test on CPU")
else:
    device = torch.device("cuda")
    layer = nn.MultiheadAttention(64, 4, batch_first=True).to(device)
    x = torch.randn(8, 512, 64, device=device)
    for _ in range(10):
        layer(x, x, x, need_weights=False)
    torch.cuda.synchronize()
    start = time.perf_counter()
    for _ in range(20):
        layer(x, x, x, need_weights=False)
    torch.cuda.synchronize()
    elapsed = time.perf_counter() - start
    print(f"tokens/s={8 * 512 * 20 / elapsed:.0f}")
这个基准不应该在没有 GPU 时伪造结果;CPU 可以验证正确性,却不代表线上 GPU 性能。进一步可使用 torch.profiler 看 kernel、显存分配和 CPU/GPU 空洞,再决定是否换 fused Attention、调整 batch 或采用更短的上下文。第 45 篇会把混合精度、显存分析与 profiler 接起来。
5.4 做一张显存账本
遇到显存不足时,不要只盯着模型参数量。训练时至少有参数、梯度、优化器状态、激活和临时 workspace 几类占用。若使用 AdamW,参数的一阶和二阶状态可能让优化器部分达到参数量的数倍;混合精度还可能同时保留一份更高精度的 master weight。Attention 的 [B,H,T,T] 中间结果和 FFN 的宽层激活,则会随 batch、序列长度和层数增长。
一个有用的估算顺序是:先计算 token 数 B×T,再分别估计隐藏激活 B×T×D、FFN 激活 B×T×D_ff 和注意力矩阵 B×H×T×T,最后乘以每个元素的字节数。估算不需要替代 profiler,但能提前发现“把上下文从 2K 改成 8K”不是只增加四倍输入的问题。fp16 或 bf16 通常占 2 字节,fp32 占 4 字节;临时复制、对齐和 allocator 缓存还会带来额外空间。
降低峰值显存有不同层次的办法:减小 micro-batch 或上下文长度,使用梯度累积保持有效 batch;用 fused attention 避免物化完整权重;用 activation checkpointing 以额外重算换保存激活的空间;推理时使用 KV Cache、分页缓存和合理的请求 batching。每种办法都在另一处付出代价:吞吐可能下降,计算可能增加,或调度实现变复杂。因此报告“显存下降”时,也要同时报告 step time、tokens/s 和结果是否一致。
AI Infra 视角:平台的资源预算应把“每个请求的 token 数、每层 KV 字节数、并发数和 batch 调度”写进配置,而不是只写一个模型参数量。相同参数量的模型,在上下文长度、精度和服务并发不同的情况下,显存曲线可以完全不同。
六、从一个 Block 接到语言模型
6.1 形状契约:embedding、位置与输出头
一个最小 decoder-only 模型的外层结构是:token id 先查 embedding,和位置 embedding 相加,经过若干 Transformer Block,再由线性输出头把隐藏维度映射到词表大小 V:
ids [B,T]
 → token_embedding [B,T,D] + position_embedding [1,T,D]
 → blocks [B,T,D]
 → lm_head [B,T,V]
lm_head 的最后一维是每个位置对下一个 token 的 logits。训练时把输入 ids[:, :-1] 与目标 ids[:, 1:] 错开,用 CrossEntropyLoss 展平为 [B*T, V] 和 [B*T]。这正好复用第 42 篇关于 logits、类别索引和 loss shape 的契约。
import torch
from torch import nn

class TinyLanguageModel(nn.Module):
    def __init__(self, vocab=100, dim=32, heads=4, layers=2, max_tokens=64):
        super().__init__()
        self.token = nn.Embedding(vocab, dim)
        self.position = nn.Embedding(max_tokens, dim)
        self.blocks = nn.ModuleList([
            TransformerBlock(dim, heads, max_tokens) for _ in range(layers)
        ])
        self.norm = nn.LayerNorm(dim)
        self.lm_head = nn.Linear(dim, vocab, bias=False)

    def forward(self, ids):
        b, t = ids.shape
        positions = torch.arange(t, device=ids.device)[None, :]
        x = self.token(ids) + self.position(positions)
        for block in self.blocks:
            x = block(x)
        return self.lm_head(self.norm(x))

model = TinyLanguageModel()
ids = torch.randint(0, 100, (2, 12))
logits = model(ids)
print(logits.shape)
torch.Size([2, 12, 100])
这段代码使用了本篇前面定义的 TransformerBlock,所以应放在同一个 Python 文件中运行。真实训练还需要数据集、交叉熵、AdamW、scheduler、梯度裁剪和 checkpoint;这些正是第 41、42 篇已经铺好的零件。
6.2 一个最小训练 step
为了把连续性说清楚,下面只展示 shape 正确的单步,不承诺随机数据能学出语言规律。注意 target 要向左错位,padding 时则要使用 ignore_index 或显式 mask,不能让填充 token 影响 loss。
import torch

model = TinyLanguageModel(vocab=100, dim=32, heads=4, layers=2, max_tokens=64)
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4, weight_decay=0.01)
ids = torch.randint(0, 100, (4, 16))

optimizer.zero_grad(set_to_none=True)
logits = model(ids[:, :-1])
target = ids[:, 1:]
loss = torch.nn.functional.cross_entropy(
    logits.reshape(-1, logits.size(-1)), target.reshape(-1)
)
loss.backward()
grad_norm = torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
optimizer.step()
print(logits.shape, round(loss.item(), 3), round(float(grad_norm), 3))
torch.Size([4, 15, 100]) 4.XXX X.XXX
随机初始化和随机 token 的 loss 会因版本、seed 和 batch 变化,通常接近 log(100);这里的重点是输入输出错位、展平维度、梯度裁剪和更新顺序。第 44 篇会换成有规律的小语料,加入训练、生成和停止条件。
6.3 可解释性与工程边界
查看 Attention 权重有助于教学和调试,但不要把“权重最大的位置”简单等同于模型唯一的解释。Dropout、残差、多个 head、FFN 和后续层都会共同影响 logits。工程上更重要的是验证:causal mask 没有泄漏、padding 没有污染 loss、长序列没有超出位置表、checkpoint 恢复后的输出一致、GPU 运行没有非有限值。
建议写一组小测试:T=1 时 mask 仍可工作;T=max_tokens 不越界;错误长度抛出清晰异常;改变未来 token 时,当前 token 的输出不变;CPU 与 GPU 的 shape 和有限性一致。把这些测试放在模型性能优化之前,能避免“更快地得到错误答案”。
七、踩坑大全
坑 1:忘记除以 sqrt(d_head)。 分数随 head 维度变大,softmax 过尖;按每个 head 的 key 维度缩放,不要误用总维度。
坑 2:q @ k 的转置方向错了。 Attention 分数最后两维应是 [T_query, T_key];使用 k.transpose(-2, -1),并打印完整 shape。
坑 3:mask 在 softmax 之后才应用。 这会破坏归一化;应在 softmax 前用 -inf 屏蔽,或使用正确的 fused API 参数。
坑 4:causal mask 漏掉一位。 diagonal=1 表示屏蔽严格未来,不能把当前位置也屏蔽;用 T=4 打印右上角验证。
坑 5:dim 不能被 heads 整除。 拆 head 时会 reshape 失败;在 init 里提前检查并给出明确错误。
坑 6:transpose 后直接 view。 非连续视图可能报错或产生错误理解;用 contiguous().view(...) 或 reshape(...)。
坑 7:把 LayerNorm 当成 BatchNorm。 Transformer 的 LayerNorm 默认归一化最后一维;不要随意改成依赖 batch 统计的归一化。
坑 8:残差相加前 shape 不一致。 Attention 和 FFN 必须回到 [B,T,D];扩宽后的 D_ff 只能是中间维度。
坑 9:训练时忘记 model.train(),推理时忘记 eval()。 Dropout 行为会不一致;inference_mode() 不能代替模式切换。
坑 10:把手写版本直接用于生产。 显式保存 [B,H,T,T] 的 scores 和 weights 可能浪费显存;生产优先评估 scaled_dot_product_attention 或更成熟的 fused kernel。
坑 11:以为 KV Cache 能降低所有复杂度。 它减少 decode 时对历史 token 的重复投影,却增加每层 K/V 的显存与读取;服务端还要考虑 batch 和缓存生命周期。
坑 12:用 CPU 第一次运行时间代表 GPU 性能。 GPU 有异步、warmup 和 kernel 选择;固定配置、同步计时,并报告完整 benchmark 条件。
坑 13:语言模型 target 没有错位。 应用输入预测下一个 token;ids[:, :-1] 对 ids[:, 1:],否则训练目标和可见上下文语义不对。
坑 14:padding token 参与交叉熵。 padding 会污染梯度和 loss;用 ignore_index 或有效 token mask,并记录真实 token 数作为分母。
八、小结
- Scaled dot-product Attention 用
QKᵀ / sqrt(d_head)产生相似度,用 softmax 权重读取V;Q、K、V的最后两维决定 shape 契约。 - Causal mask 在 softmax 前屏蔽未来位置;多头把
D拆成多个子空间,让不同 head 学习不同关系,再拼回原维度。 - Transformer Block 通常由 pre-norm、Attention、残差、FFN 和第二个残差组成;Attention 做跨位置路由,FFN 做逐位置非线性加工。
- 手写实现适合理解和测试,生产环境应评估 PyTorch 的 scaled dot-product 或 fused kernel,并关注
transpose、连续内存和 mask 广播。 - Attention 的分数矩阵随序列长度呈二次增长;Flash/Tiled 类算法能减少中间显存读写,但不能消除长上下文的计算取舍。
- KV Cache 用显存保存历史 K/V,减少生成时的重复计算;它会把瓶颈转向缓存容量、带宽、分页和 batching,后续篇章会展开。
九、课后练习
- (基础) 用一个
[1, 3, 4]的 Tensor 手算一次QKᵀ、缩放和 softmax,并验证每个 query 的权重和为 1。 - (基础) 给 Attention 加一个 padding mask,构造
B=2、H=2、T=4的 scores,打印并验证广播后的屏蔽位置完全为 0。 - (理解) 把
heads从 1 改成 2、4,固定dim=16,记录参数量、前向耗时和每个 head 的注意力分布。 - (理解) 分别实现 pre-norm 和 post-norm block,在相同 seed 和学习率下训练一个小的序列任务,比较 loss 和梯度 norm。
- (进阶) 不调用
nn.MultiheadAttention,实现支持T_query != T_key的 cross-attention,并为 decoder 写一个 encoder-decoder 小测试。 - (AI Infra) 对比显式 Attention 与
F.scaled_dot_product_attention的峰值显存和 tokens/s,至少测试T=256、512、1024,记录 dtype 与 mask 条件。 - (进阶) 为一个两步生成循环实现简单 KV Cache:第一步保存 K/V,后续只追加新 token,并与每次重算前缀的输出做数值对照。
- (综合) 把本篇的 block 接到第 42 篇的 AdamW、Cosine scheduler 和 checkpoint,训练一个字符级预测器,报告验证 loss、tokens/s、峰值显存和恢复后的输出一致性。
下一篇预告
第44篇|实战:从零写一个 mini-GPT。下一篇会把 token 化、位置编码、多个 Transformer Block、交叉熵训练和自回归生成串成一条完整链路:先用小语料做可复现的 CPU smoke test,再切到 GPU,观察 batch、上下文长度、学习率和显存如何共同影响训练。我们还会实现 temperature、top-k 等采样选项,理解“训练目标是下一个 token”怎样变成“逐 token 生成文本”。再往后,第 45 篇进入混合精度、显存分析与 profiler,第 47 篇回到本篇埋下的 KV Cache 和 batching,最终在第 48 篇把这些基础映射到 vLLM、SGLang 与 Agent 服务。