
第40篇|nn.Module 与参数
本篇定位:专栏四「PyTorch 与 AI Infra 入门」的第四篇。承接第 39 篇 autograd,把“梯度沿计算图返回”组织成可复用、可保存、可迁移的模型对象。
读完你将能够:理解
nn.Module、forward、nn.Parameter与参数注册;使用parameters()、named_parameters()、buffers()、children()、modules()检查模型;掌握state_dict()、load_state_dict()、register_parameter()、register_buffer()以及train()/eval();从 AI Infra 角度设计可靠的权重 checkpoint。预计用时:阅读 50~70 分钟,动手 60~90 分钟。
第 39 篇里,我们让一个 Tensor 通过 backward() 把梯度写回叶子节点。可是,真实模型不会把每个权重散落在脚本的局部变量里:线性层、归一化层、注意力层需要组合,需要统一搬到 GPU,需要交给优化器,还要在训练中途保存、恢复并部署。把“计算”与“状态”装进一个有层次的对象,正是 nn.Module 解决的问题。
可以把本篇的主线记成一句话:forward 描述一次计算,注册机制决定哪些对象属于模型,state_dict 定义可持久化的状态。三者分工清楚,模型才能既能训练又能上线。下一篇我们会把模型接到 Dataset、DataLoader 和训练循环;如果本篇没有分清参数、缓冲区和临时 Tensor,后面的循环会出现设备不一致、优化器漏参数或 checkpoint 不完整等问题。学习时不要只记 API 名字,建议每写一个模块都回答四个问题:它的参数在哪里?哪些状态需要迁移?哪些状态需要保存?训练和推理时行为是否相同?这四问正是从实验脚本走向基础设施代码的检查表。
一、nn.Module:模型是带状态的计算树
1.1 从函数到可组合对象
最小的神经网络其实可以写成函数:输入 x,乘以矩阵 W,加上偏置 b,返回结果。但训练还需要让 W、b 被发现,让优化器拿到它们的梯度,让 .to("cuda") 一次移动整个模型。nn.Module 是 PyTorch 对这组职责的统一抽象。
一个模块通常包含三类东西:可学习参数(parameter)、子模块(submodule)和非学习但要随模型保存或迁移的缓冲区(buffer)。父模块把子模块挂到属性上,就形成一棵模块树;根节点是模型本身,叶节点可能是 nn.Linear、nn.LayerNorm 等内置模块。
import torch
from torch import nn

class ScoreHead(nn.Module):
    def __init__(self, in_features: int, out_features: int):
        super().__init__()
        self.proj = nn.Linear(in_features, out_features)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.proj(x)

model = ScoreHead(4, 2)
x = torch.ones(3, 4)
y = model(x)                 # 等价于 model.forward(x),但推荐调用 model(x)
print(y.shape)
print(list(model.children()))
torch.Size([3, 2])
[Linear(in_features=4, out_features=2, bias=True)]
调用 model(x) 而不是手写 model.forward(x) 很重要。Module.call 会在真正进入 forward 前后处理 hooks、模块状态和其他框架逻辑。自定义模块只实现 forward,外部统一使用括号调用,这也是和 PyTorch 生态、调试工具保持兼容的习惯。
1.2 init、super() 与 forward
定义子模块前必须先调用 super().init()。父类初始化会创建保存参数、子模块和缓冲区的内部注册表;若省略它,常见结果是“不能在 Module 初始化前赋值子模块”或参数无法被发现。
init 负责组装结构、创建状态;forward 负责描述一次前向数据流。不要在每次 forward 中临时创建本应训练的 nn.Linear,否则每次调用都可能得到一组新权重,优化器也看不到它们。输入、输出和中间激活则通常是调用期间临时存在的 Tensor,不会自动成为模型状态。
class TinyMLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(4, 8),
            nn.ReLU(),
            nn.Linear(8, 2),
        )

    def forward(self, x):
        return self.net(x)

model = TinyMLP()
print(model)
nn.Sequential 本身也是 Module,因此里面的层被递归注册。自定义的 ModuleList 和 ModuleDict 也用于保存动态数量的子模块;普通 Python list、dict 里即使放了 nn.Linear,PyTorch 也不会自动递归发现它们。
AI Infra 视角:模块树不仅服务于可读性。分布式包装、参数分片、量化替换、算子融合和服务端的层级监控都依赖这棵树。一个层若藏在普通列表中,可能既不在优化器里,也不在设备迁移或 checkpoint 中。
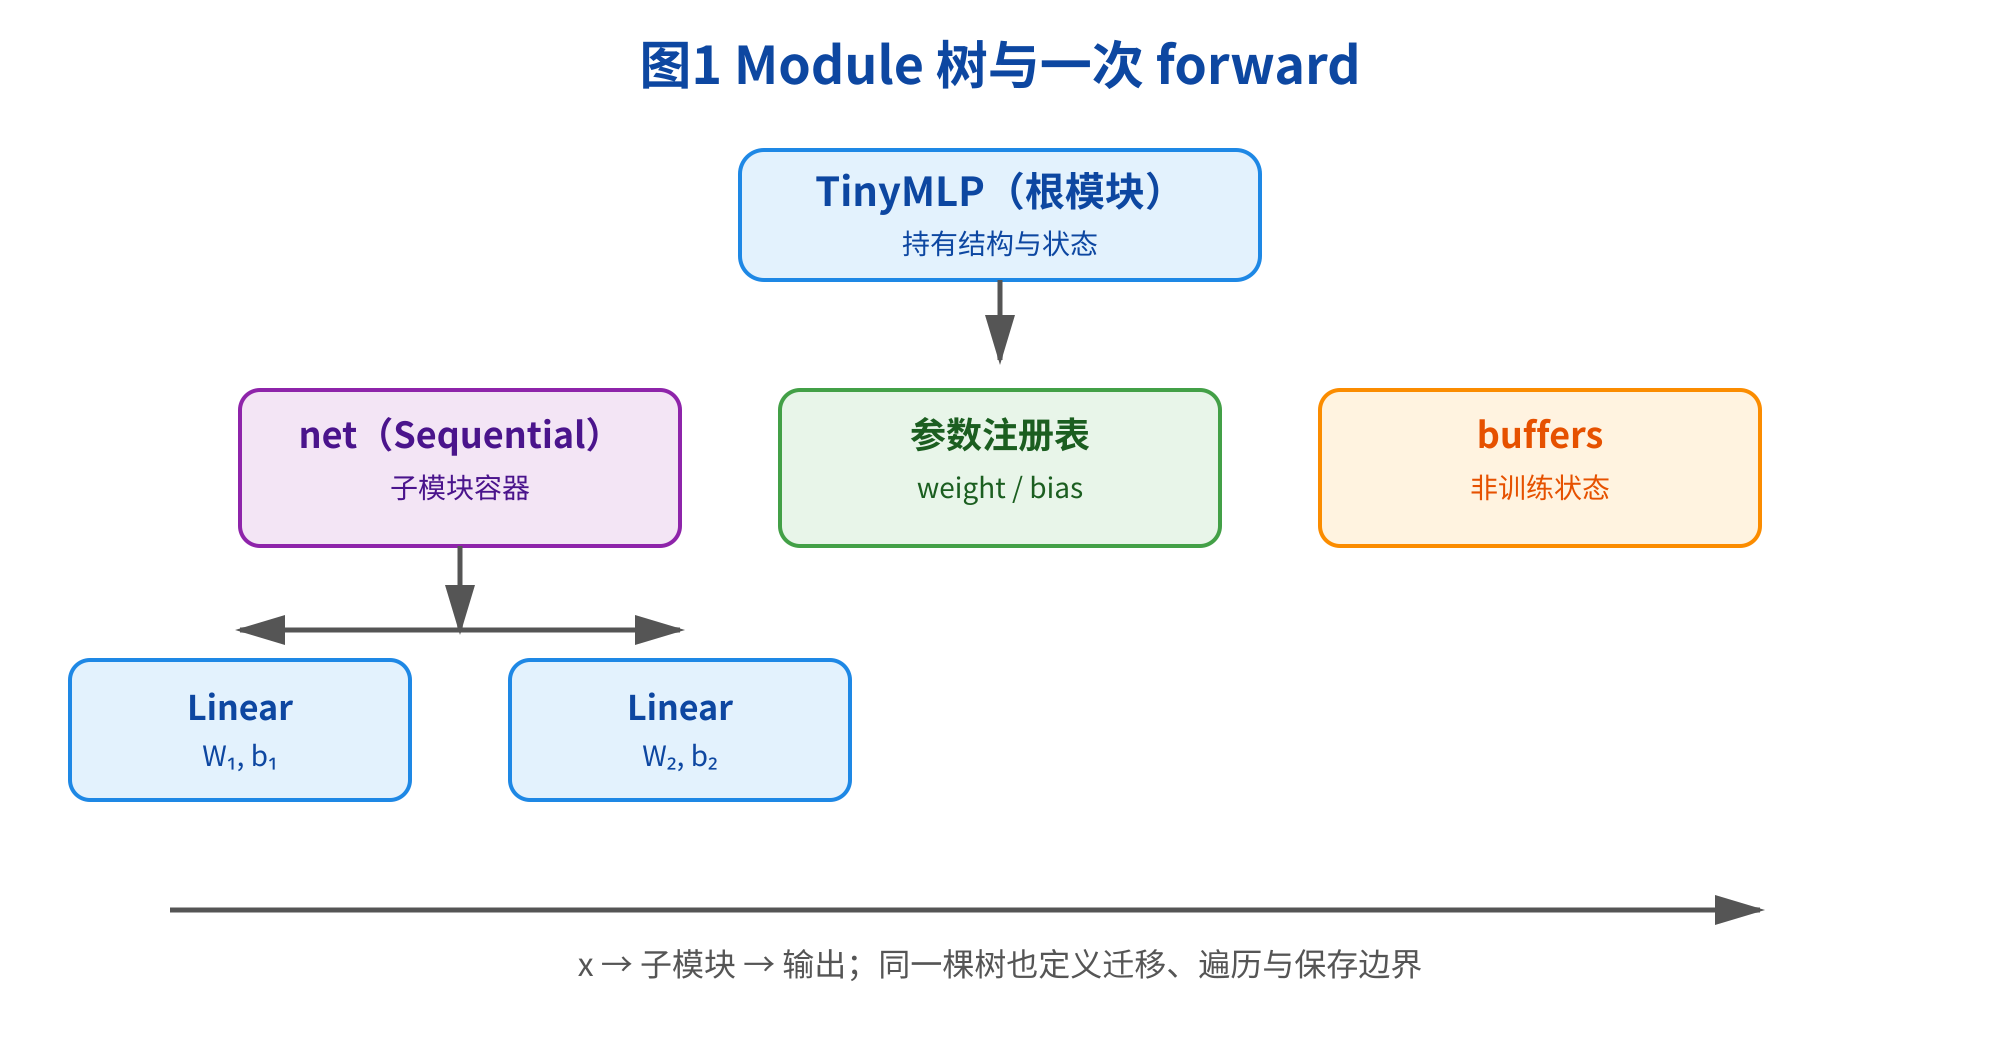
图1 Module 树与一次 forward
1.3 nn.Module 不等于计算图
模块树是长期存在的 Python 对象结构;第 39 篇讲的 autograd 图则是一次 forward 执行时动态生成的临时依赖图。调用同一个模块两次,通常得到两次新的计算图,但共享同一组参数。model.parameters() 看到的是长期状态,loss.grad_fn 看到的是本轮计算路径,不要混为一谈。
这也解释了为什么评估后仍可以继续训练:eval() 会切换模块行为,却不会销毁参数或永久关闭 autograd;with torch.no_grad() 只控制代码块中的图记录。
二、参数注册:优化器究竟能看见什么
2.1 nn.Parameter 是特殊的 Tensor
把一个 Tensor 赋值给 Module 属性,并不会让它自动成为可学习参数;用 nn.Parameter 包装后,Module.setattr 才会把它放进参数注册表。内置层已经替我们完成了这件事。
class Affine(nn.Module):
    def __init__(self):
        super().__init__()
        self.weight = nn.Parameter(torch.tensor([[2.0]]))
        self.bias = nn.Parameter(torch.tensor([1.0]))
        self.scale = torch.tensor([10.0])  # 普通 Tensor,不是参数

    def forward(self, x):
        return x @ self.weight + self.bias

m = Affine()
print([name for name, _ in m.named_parameters()])
print(any(p is m.scale for p in m.parameters()))
['weight', 'bias']
False
Parameter 默认 requires_grad=True,但“是参数”和“这次是否求梯度”仍是两个概念。冻结骨干网络时可以把参数的 requires_grad 设为 False;它仍然会出现在 named_parameters() 和 state_dict() 中,只是优化器不会得到它的梯度更新。若要完全排除某些参数,还要在构造优化器时明确筛选。
参数命名来自属性路径。稳定的命名也便于长期维护、迁移、协作、测试和安全审计。嵌套在 net.0.weight 下的权重会带上完整名字,这让分组学习率、冻结特定层和故障定位成为可能。
2.2 parameters() 与 named_parameters()
parameters() 返回递归遍历到的参数迭代器,最常见用途是交给优化器:
model = TinyMLP()
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)

for name, parameter in model.named_parameters():
    print(name, tuple(parameter.shape), parameter.requires_grad)
如果只想训练分类头,可以按名字或模块范围筛选:
backbone = nn.Linear(4, 8)
head = nn.Linear(8, 2)
model = nn.Sequential(backbone, nn.ReLU(), head)

for name, p in model.named_parameters():
    p.requires_grad_(name.startswith("2."))
trainable = [p for p in model.parameters() if p.requires_grad]
optimizer = torch.optim.AdamW(trainable, lr=1e-3)
print(len(trainable))
不要在训练开始后随意替换 model.weight = nn.Parameter(...),因为优化器保存的是原参数对象的引用。若确实要改结构或替换参数,应在创建优化器前完成,或者同步重建优化器,并检查参数数量和名字。
2.3 普通容器是一个高频陷阱
下面的错误代码把层放在普通列表里:
class BadStack(nn.Module):
    def __init__(self):
        super().__init__()
        self.layers = [nn.Linear(4, 4), nn.Linear(4, 2)]  # 不会注册

    def forward(self, x):
        for layer in self.layers:
            x = layer(x)
        return x
正确写法是 nn.ModuleList:
class GoodStack(nn.Module):
    def __init__(self):
        super().__init__()
        self.layers = nn.ModuleList([nn.Linear(4, 4), nn.Linear(4, 2)])

    def forward(self, x):
        for layer in self.layers:
            x = layer(x)
        return x

print(sum(p.numel() for p in GoodStack().parameters()))
ModuleList 解决“动态序列”的注册问题,ModuleDict 解决“按名字选择分支”的问题。它们不是普通 Tensor 容器;若要保存许多固定常量,应考虑 register_buffer,而不是把 Tensor 放进普通列表后期待 .to(device) 递归处理。写完后先用一个小 batch 验证输出形状,再检查参数名、设备和状态字典,通常比直接跑完整训练更快发现注册错误。
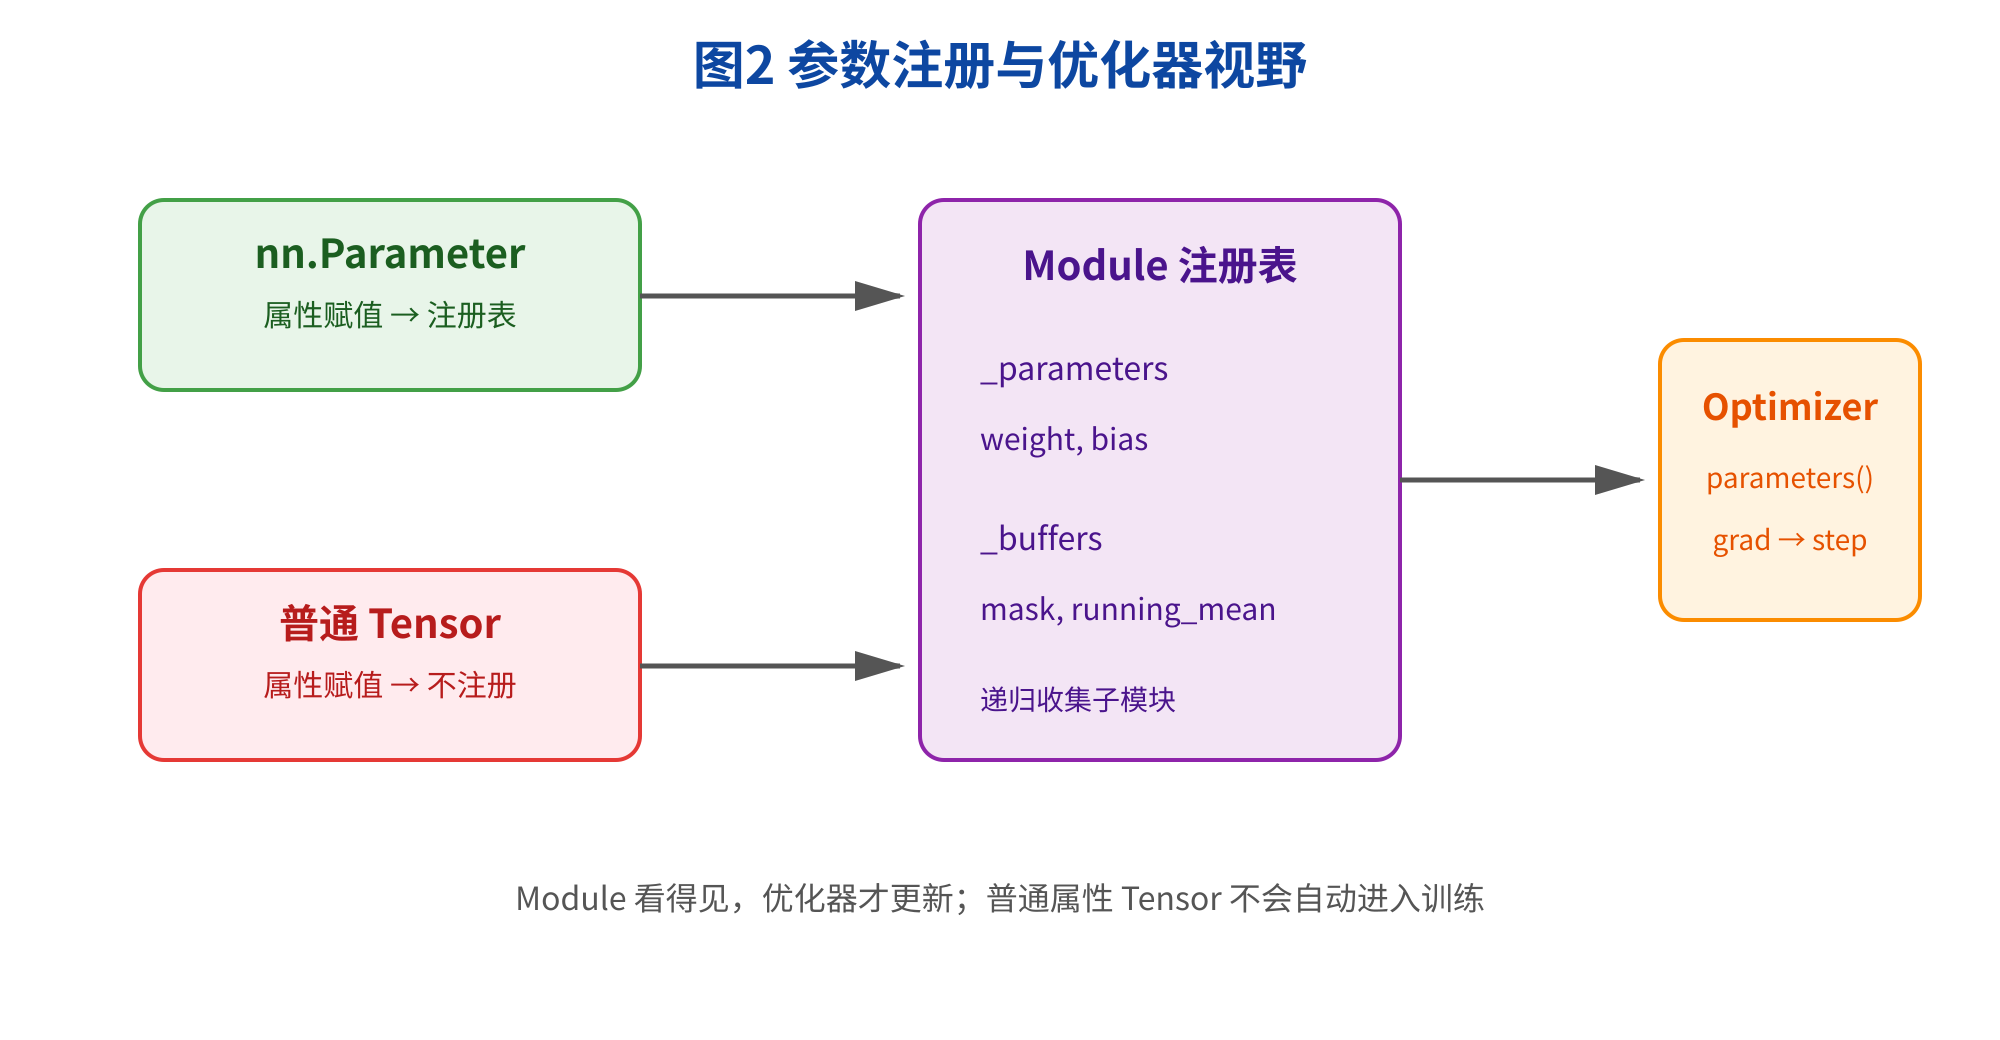
parameters()获取注册表中的参数,grad对应step。图中还标注“Module看得见,优化器才更新;普通属性Tensor不会自动进入训练”,直观呈现了不同属性Tensor在训练过程中的处理方式。图2 参数注册与优化器视野
三、参数、buffer 与临时 Tensor
3.1 什么应该成为 buffer
有些状态不是要优化的参数,却必须和模型一起移动到 GPU、保存到 checkpoint。例如 BatchNorm 的 running_mean、running_var,或固定的正弦位置编码、因果 attention mask。这些对象适合注册为 buffer。
class PositionalBias(nn.Module):
    def __init__(self, length: int):
        super().__init__()
        bias = torch.arange(length, dtype=torch.float32)
        self.register_buffer("bias", bias)

    def forward(self, x):
        return x + self.bias[:x.size(-1)]

m = PositionalBias(8)
print(list(m.named_parameters()))
print([(n, tuple(b.shape)) for n, b in m.named_buffers()])
print("bias" in m.state_dict())
[]
[('bias', (8,))]
True
buffer 默认 persistent=True,因此会进入 state_dict。如果某个缓存可以随时重建、太大而不应写入权重文件,可以设置 persistent=False:它仍会随 .to(device) 移动,但不出现在 state_dict 中。
class Cache(nn.Module):
    def __init__(self):
        super().__init__()
        self.register_buffer("runtime_cache", torch.zeros(2), persistent=False)

c = Cache()
print(c.runtime_cache.device)
print(c.state_dict())  # OrderedDict(),非持久化缓存不保存
3.2 register_parameter 的显式形式
直接写 self.weight = nn.Parameter(...) 最常见,但框架代码有时需要根据配置动态决定某个参数是否存在。这时可以使用 register_parameter(name, parameter);传入 None 表示注册一个占位名字,它不会出现在参数迭代器中。
class OptionalBias(nn.Module):
    def __init__(self, width: int, use_bias: bool):
        super().__init__()
        value = nn.Parameter(torch.zeros(width)) if use_bias else None
        self.register_parameter("bias", value)

    def forward(self, x):
        return x if self.bias is None else x + self.bias

print(list(OptionalBias(3, False).named_parameters()))
print(list(OptionalBias(3, True).named_parameters())[0][0])
register_parameter 会检查名字不能包含 .、不能覆盖已有非参数属性等。手动操作 _parameters、_buffers 这类内部字典虽然短,却绕过了检查,不应在业务代码中使用。
3.3 三张清单要分开
调试一个模块时,可以把状态分成三张清单:
最后一行是很多设备错误的根源:如果把 self.mask = torch.ones(...) 当常量放在 CPU,模型搬到 CUDA 后,x + self.mask 仍可能报 device mismatch。把它注册成 buffer,模块迁移和 checkpoint 语义才完整。
AI Infra 视角:大模型推理中的位置编码表、量化 scale、路由器的静态 mask 和 KV cache 的元数据并不都应该训练,但它们是否持久化、是否迁移、是否被分片系统识别,直接影响恢复一致性和线上故障率。
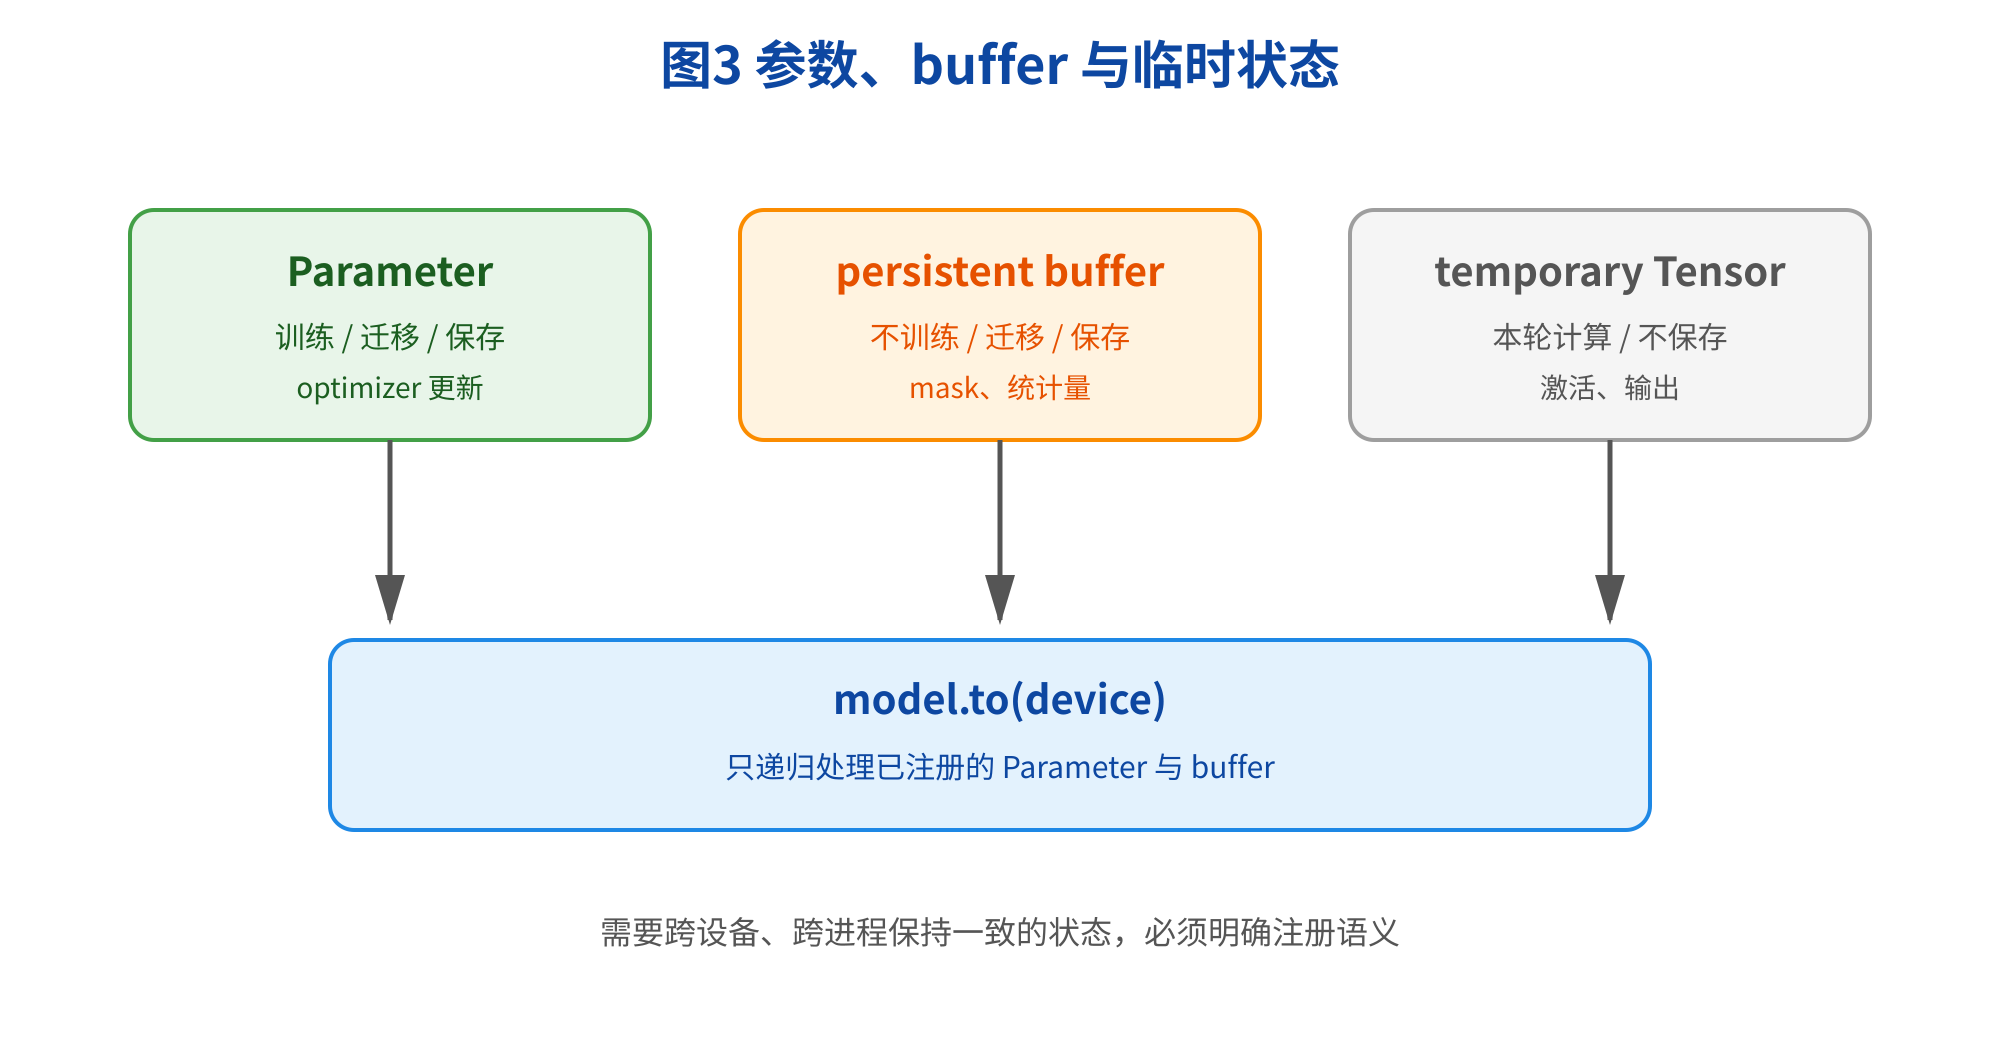
图3 参数、buffer 与临时状态
四、遍历模块树与切换训练模式
4.1 children()、modules() 和 named 版本
children() 只返回当前模块的直接子模块;named_children() 还给出直接属性名。modules() 会递归遍历整棵树,而且结果的第一个通常是模块自身;named_modules() 同理,根模块的名字通常是空字符串。
model = TinyMLP()
print([type(m).__name__ for m in model.children()])
print([type(m).__name__ for m in model.modules()])
print([name for name, _ in model.named_modules()])
['Sequential']
['TinyMLP', 'Sequential', 'Linear', 'ReLU', 'Linear']
['', 'net', 'net.0', 'net.1', 'net.2']
这几个 API 解决的问题不同:需要替换直接子层时看 named_children();统计所有层、注册 hook 或做结构检查时看 modules();需要参数路径时看 named_parameters()。遍历时要注意共享模块:如果同一个子模块被多个属性引用,模块遍历默认会去重;参数也不会因为被多处使用就复制一份。
4.2 train() 与 eval() 是行为开关
model.train() 把自身及所有子模块的 training 标志设为 True;model.eval() 递归设为 False。它主要影响 Dropout、BatchNorm 等有训练/评估差异的模块,不会关闭梯度,也不会冻结参数。
model = nn.Sequential(nn.Linear(4, 4), nn.Dropout(p=0.5))
model.train()
print(model.training, model[1].training)
model.eval()
print(model.training, model[1].training)
True True
False False
验证和推理的典型边界是:
model.eval()
with torch.inference_mode():
    prediction = model(batch)
其中 eval() 决定 Dropout 是否随机丢弃、BatchNorm 使用哪套统计;inference_mode() 决定 autograd 是否记录图。不要只写其中一个。训练时则使用 model.train(),并让第 39 篇介绍的梯度生命周期正常工作。
如果只想让某个子树保持评估模式,可以在全局 model.train() 后再次调用 model.encoder.eval()。但这只是行为选择;若还要冻结 encoder 的参数,需要额外设置 requires_grad_(False),并在优化器参数列表中确认它没有被更新。实际调试时可以在每个 epoch 开头显式调用 model.train(),在验证函数内部显式调用 model.eval(),避免上一次验证留下的模式影响下一轮训练。验证结束后,控制权应回到训练入口,而不是依赖调用顺序的偶然性。
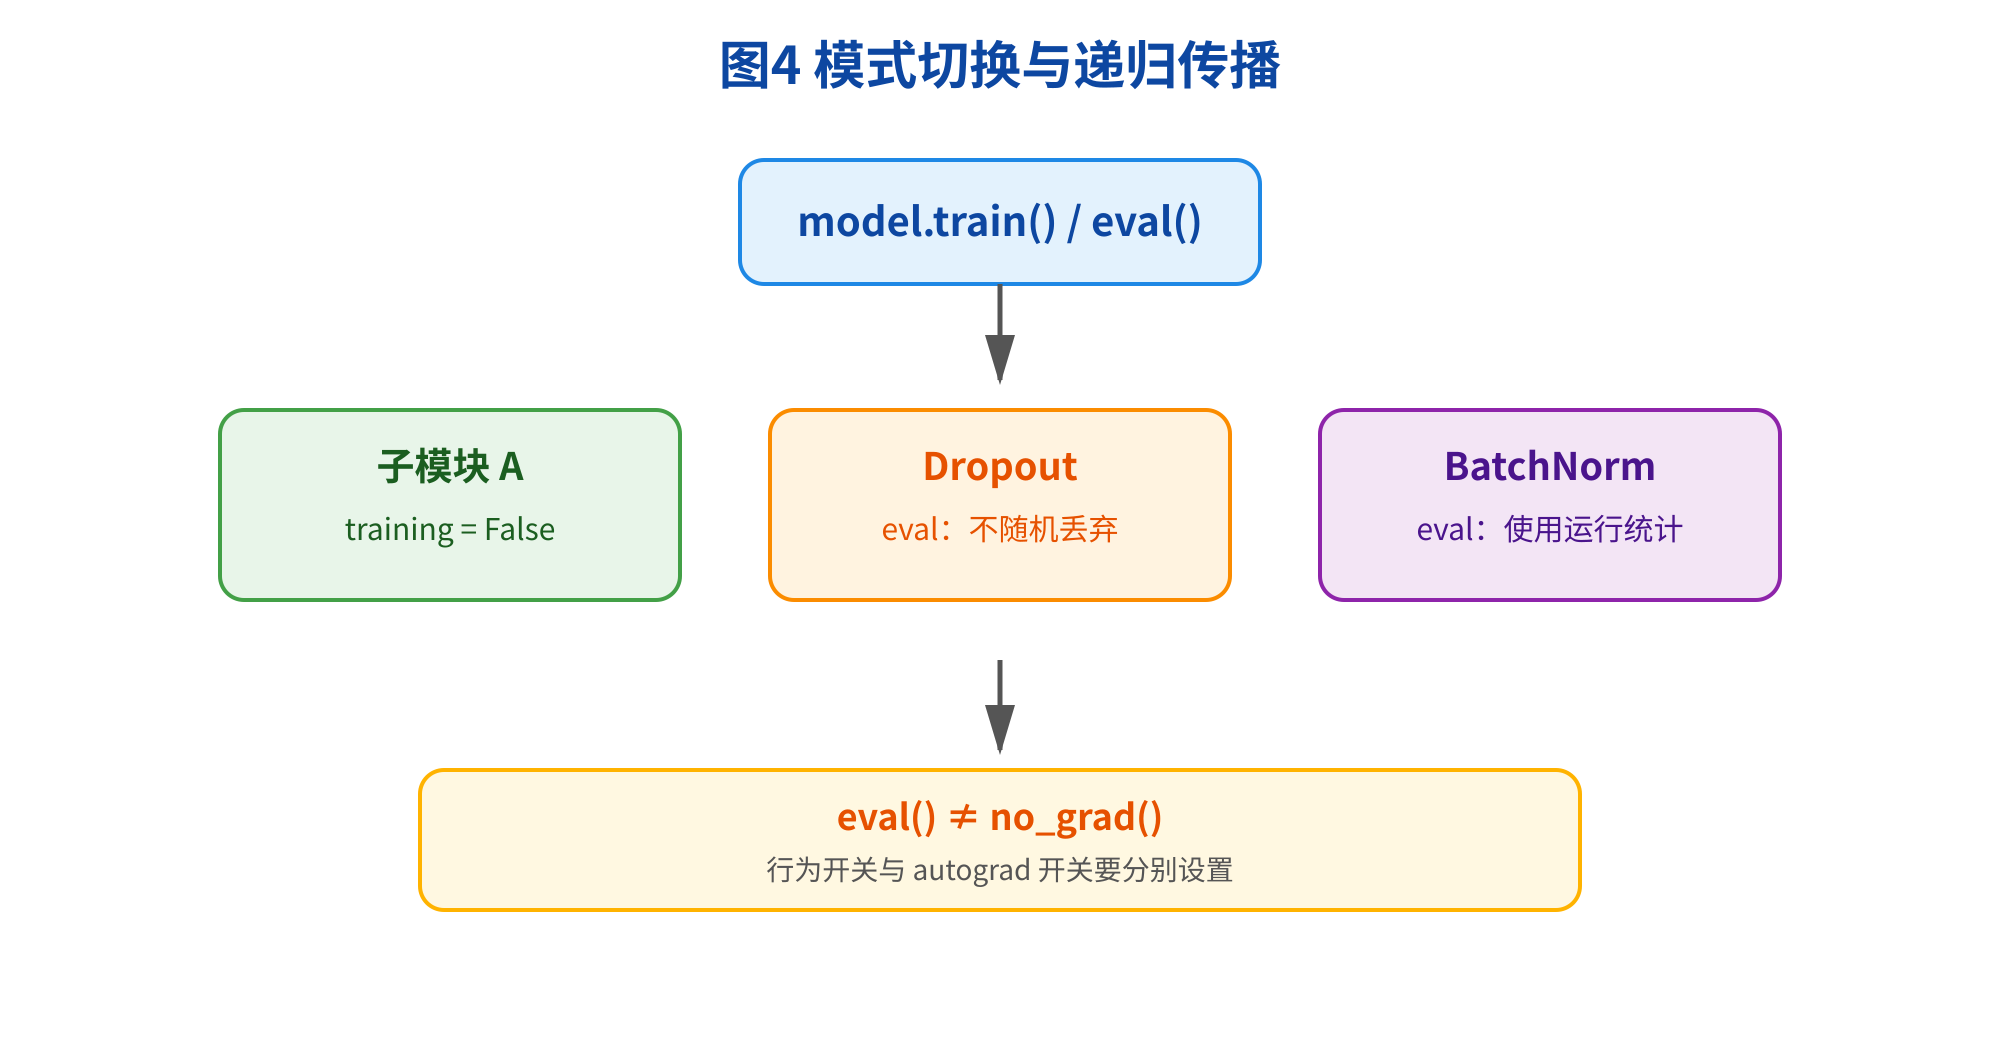
model.train()/eval()操作,下方有三个子模块,分别是training = False的子模块A,eval: 不随机丢弃的Dropout,eval: 使用运行统计的BatchNorm。最下方是eval() ≠ no_grad(),说明行为开关与autograd开关要分别设置。该图与上下文紧密相关,直观呈现了在训练和评估模式下,不同模块的行为及与autograd的关系,帮助理解模型在不同模式下的运行状态。图4 模式切换与递归传播
五、state_dict:可恢复的模型状态边界
5.1 它是什么,不是什么
state_dict() 返回一个从字符串名字到 Tensor 的映射,包含递归收集的参数和持久化 buffer。它通常是 OrderedDict 风格的字典;保存的是张量状态,不是完整 Python 对象的结构和代码。
model = TinyMLP()
state = model.state_dict()
for name, tensor in state.items():
    print(name, tuple(tensor.shape))
保存和加载一个权重文件:
from pathlib import Path

path = Path("tiny-mlp.pt")
torch.save(model.state_dict(), path)

restored = TinyMLP()
state = torch.load(path, map_location="cpu", weights_only=True)
result = restored.load_state_dict(state)
print(result.missing_keys, result.unexpected_keys)
[] []
map_location="cpu" 让 GPU 机器保存的权重先落到 CPU,适合检查、转存和避免加载时立刻占满显存。不同 PyTorch 版本对 weights_only 的默认策略可能变化;在只加载权重且格式允许时显式使用它,可以缩小反序列化风险。不要对不可信来源的完整 pickle 文件随意 torch.load。
5.2 严格匹配与迁移检查
load_state_dict 默认 strict=True:模型名字或形状不匹配时会报告缺失键、意外键或直接报错。加载后必须认真看结果,不要把 warning 当成功。
old = TinyMLP()
new = nn.Sequential(nn.Linear(4, 8), nn.ReLU(), nn.Linear(8, 3))

try:
    new.load_state_dict(old.state_dict())
except RuntimeError as exc:
    print("结构或形状不兼容")
迁移学习常用 strict=False,例如只加载 backbone 而保留新分类头:
result = new.load_state_dict(old.state_dict(), strict=False)
print(result.missing_keys)
print(result.unexpected_keys)
但 strict=False 不是“忽略一切错误”的按钮。形状冲突通常仍然需要处理;更重要的是,加载结果中的 missing/unexpected keys 应被记录并审查。改变前缀、裁剪层或从分布式包装模型导出时,可以先做明确的键名转换,再加载。
state_dict 返回的 Tensor 与模型参数共享存储语义时,若要在内存中保留一个不会被后续训练改写的快照,应该显式 detach().clone();不要只把字典对象赋给另一个变量就以为完成了深拷贝。
snapshot = {name: value.detach().cpu().clone()
            for name, value in model.state_dict().items()}
# 后续训练不会通过共享存储改写 snapshot
还要区分三种“保存”:保存 Python 对象、保存 state_dict、保存一个服务可读的标准格式。保存完整对象会依赖类的导入路径和序列化行为,代码重构后可能无法加载;保存状态字典更适合在代码版本变化时做显式迁移;若进入生产推理,还要遵守团队约定的导出格式、版本和安全扫描流程。checkpoint 是系统边界,不是随手调用一次 torch.save 就结束。
5.3 checkpoint 不只是一份权重
只保存 model.state_dict() 适合发布推理权重,但要从训练中断处继续,还应保存优化器状态、学习率调度器状态、当前 epoch/step、随机数状态以及配置版本:
checkpoint = {
    "model": model.state_dict(),
    "optimizer": optimizer.state_dict(),
    "step": 12000,
    "config": {"hidden": 8, "classes": 2},
}
torch.save(checkpoint, "train-step-12000.pt")
恢复时先构造相同结构,再分别加载:
payload = torch.load("train-step-12000.pt", map_location="cpu", weights_only=True)
model.load_state_dict(payload["model"])
optimizer.load_state_dict(payload["optimizer"])
start_step = payload["step"] + 1
如果只为了推理,不需要把 optimizer 的动量、二阶统计和梯度一起带上;这能显著减小文件和加载内存。训练恢复则不能把“权重恢复成功”误当成“训练轨迹完全恢复”:随机种子、数据采样位置、混合精度 scaler 和分布式切分策略也可能影响复现。
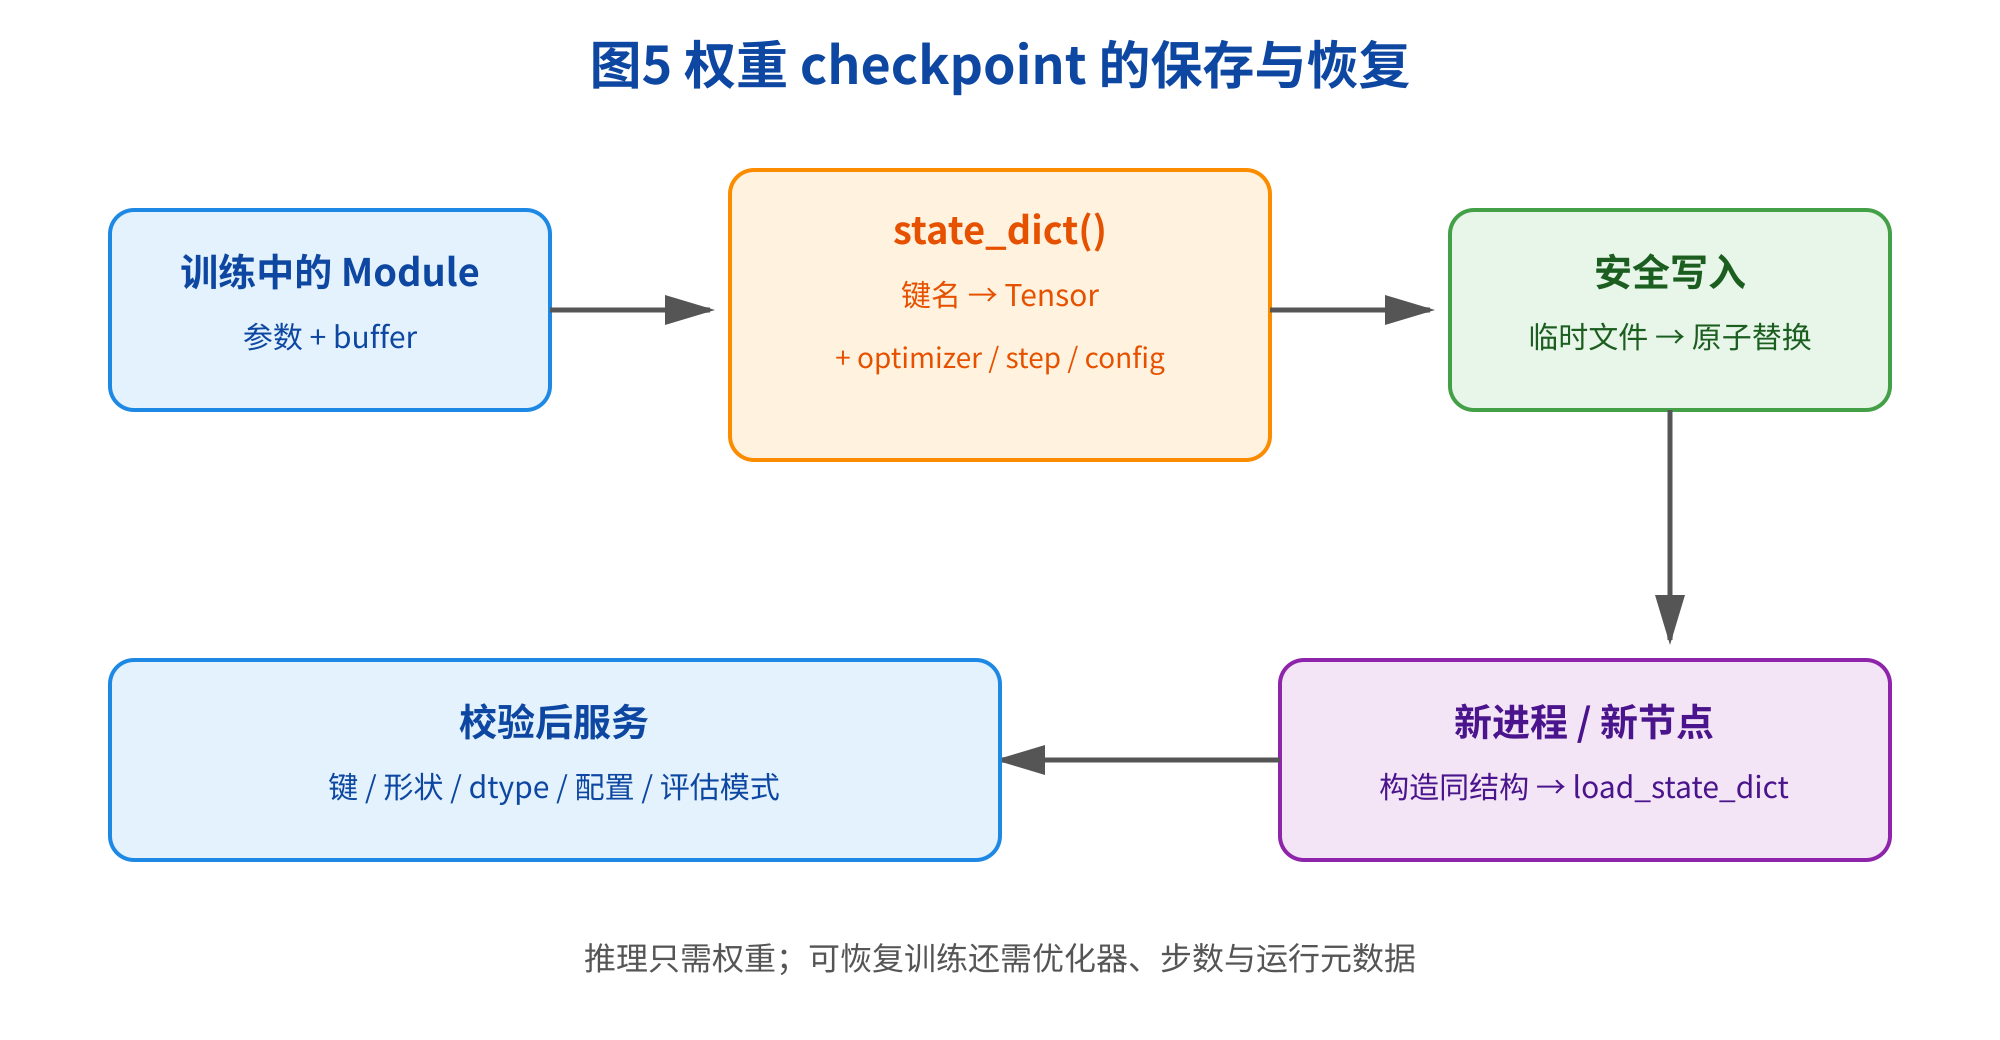
图5 权重 checkpoint 的保存与恢复
六、面向 AI Infra 的模块设计
6.1 让设备迁移成为一条命令
模型和输入必须在同一设备。只要参数与 buffer 都通过注册机制挂在模块树上,model.to(device) 就会递归迁移它们;普通属性中的 Tensor 则不会。工程上可以在启动阶段做一次断言:
def check_devices(model: nn.Module) -> None:
    devices = {p.device for p in model.parameters()}
    devices.update(b.device for b in model.buffers())
    print("model devices:", devices)

model = TinyMLP().to("cpu")
check_devices(model)
对于多 GPU、参数分片或 CPU offload,代码更不能到处写死 .cuda()。让上层决定 device,让模块通过参数和 buffer 接收迁移,是从单机实验走向训练平台的第一步。
6.2 checkpoint 的原子性、版本和校验
训练作业可能在写文件时被抢占、节点故障或磁盘满。生产系统通常先写临时文件,完成后再原子替换;文件名记录 step,旁边保存配置和版本元数据,并在上传对象存储后校验大小或哈希。不要让一个半写入的 latest.pt 覆盖上一个可恢复版本。
大型模型还要考虑分片 checkpoint:单文件会受到内存、网络和文件系统限制,分片能让不同 worker 并行写入和读取。但无论是单文件还是分片,逻辑上都应保持明确的参数键、形状、dtype 和模型配置;加载器要能报告缺失分片,而不是静默使用随机初始化。
6.3 state_dict 是边界,代码是契约
权重文件本身无法告诉你“这个数字是 4096 维还是 8192 维 hidden size”,也无法保证新代码的 forward 仍与旧代码兼容。因此发布 checkpoint 时至少配套保存:模型配置、词表或 tokenizer 版本、PyTorch/算子版本、dtype、训练数据或数据快照标识、Git commit 和评估指标。加载前先检查配置与键形状,再进入 GPU,能减少昂贵的失败。
从服务角度看,启动流程可以分成:CPU 读取与校验、必要的键名迁移、构造模块、加载权重、切换 eval()、迁移到目标设备、预热一次 forward。这样权重错误发生在服务对外接流量之前,也方便把加载耗时和显存峰值纳入监控。
6.4 共享参数与权重绑定
模块树中的不同路径不一定代表不同的参数对象。语言模型经常让输入 embedding 和输出投影共享权重,或者让多个 Transformer 层共享同一个小模块。共享可以减少参数量和显存,但也会改变 checkpoint、梯度和遍历时的直觉。
class TiedHead(nn.Module):
    def __init__(self, vocab: int, hidden: int):
        super().__init__()
        self.embedding = nn.Embedding(vocab, hidden)
        self.decoder = nn.Linear(hidden, vocab, bias=False)
        self.decoder.weight = self.embedding.weight  # 同一个 Parameter

    def forward(self, token_ids):
        hidden = self.embedding(token_ids)
        return self.decoder(hidden)

m = TiedHead(10, 4)
print(m.embedding.weight is m.decoder.weight)
print(sum(p.numel() for p in m.parameters()))
True
40
默认的 named_parameters() 会对共享对象去重,因此参数量不会因为两条引用路径而翻倍。需要检查所有引用路径时,可以研究 remove_duplicate=False 选项,但统计可训练参数和估算显存时通常应该按真实对象去重。保存时,多个键可能反映同一底层存储;加载后的模型仍应通过行为测试确认绑定关系,而不是只看键名数量。
共享参数还有一个反向传播含义:同一个参数从多条路径收到的梯度会累加,这是链式法则的正常结果。若误把“想复制一层”写成“复用一个对象”,训练结果就会与独立层不同。工程检查可以同时打印 id(parameter)、形状、dtype 和名称,把有意的权重共享写进配置或注释。
6.5 参数量、dtype 与显存的快速估算
numel() 给出元素数量,element_size() 给出每个元素的字节数。只统计参数容易低估运行成本,因为持久化 buffer、梯度、优化器状态和前向激活也占用内存:
def report(model: nn.Module):
    params = list(model.parameters())
    count = sum(p.numel() for p in params)
    bytes_ = sum(p.numel() * p.element_size() for p in params)
    print("parameters:", count)
    print("parameter bytes:", bytes_)
    print("buffers:", sum(b.numel() for b in model.buffers()))

report(TinyMLP())
若参数使用 float32,每个元素通常占 4 字节;float16 或 bfloat16 通常占 2 字节,但实际训练还可能有 float32 master weight、Adam 的一阶和二阶状态。切换 dtype 应在明确的设备和算子支持范围内进行,不能只因 checkpoint 文件变小就假设吞吐、精度和显存都会按同一比例改善。
在服务部署中,加载前先打印 checkpoint 的键数量、总元素数、dtype 分布和最大张量,往往比启动后才发现显存不足更便于定位。对量化模型,还应把 scale、zero point、group size 等元数据作为明确的状态或配置处理,不能把它们藏在一个未注册的普通属性里。
七、踩坑大全
坑 1:层放进普通 list,参数数量为 0。 原因是 Python 容器不会触发子模块注册;改用 nn.ModuleList 或 nn.ModuleDict,并在建优化器前打印 named_parameters()。
坑 2:把常量写成普通属性,搬到 GPU 后 device mismatch。 原因是 .to() 只递归处理参数和 buffer;用 register_buffer 注册需要迁移的 Tensor。
坑 3:直接调用 forward。 这会绕过 Module.call 的 hooks 等框架路径;外部使用 model(x)。
坑 4:把 eval() 当成关闭梯度。 eval() 只切换 Dropout、BatchNorm 等行为;验证还需要 no_grad() 或 inference_mode()。
坑 5:strict=False 后不检查返回值。 可能有分类头没加载、键名前缀错或文件版本不匹配;逐项记录 missing_keys 和 unexpected_keys。
坑 6:只保存模型权重却声称能恢复训练。 恢复训练还要保存 optimizer、scheduler、scaler、step、配置和必要的随机状态;纯推理发布才只需模型状态。
坑 7:替换参数后继续使用旧优化器。 优化器引用旧的参数对象;结构或参数替换后重建优化器,并重新检查参数组。
坑 8:把可变的共享模块当成两份独立层。 同一个子模块挂到多个位置时会共享权重;确认这是权重共享还是误写,并用名字和对象 id 检查。
八、小结
nn.Module是带有参数、子模块和可选 buffer 的可组合计算树;forward描述一次前向,model(x)才是推荐调用入口。nn.Parameter才会进入参数注册表;parameters()供优化器使用,named_parameters()适合分组、冻结和排错。- 动态子模块放进
ModuleList/ModuleDict;需要迁移但不训练的状态用register_buffer。 children()看直接子模块,modules()递归看整棵树;train()/eval()切换行为,不等价于开启或关闭 autograd。state_dict是参数和持久化 buffer 的键值快照;加载后必须检查键和形状,strict=False也不能跳过审查。- 推理权重与可恢复训练 checkpoint 的边界不同。AI Infra 系统还要管理设备、分片、版本、原子写入和校验。
九、课后练习
- (基础) 写一个
ScaleAdd(nn.Module),包含一个可学习标量和一个 buffer,打印两者的名字与state_dict键。 - (基础) 用
ModuleList写一个可配置深度的 MLP,并比较它和普通list的参数数量。 - (理解) 给模型加入 Dropout,固定随机种子,分别在
train()和eval()下运行多次,观察输出差异;再分别加上no_grad()和inference_mode()。 - (理解) 保存一个二分类头的
state_dict,构造三分类头,用strict=False尝试加载,解释每个 missing/unexpected key。 - (进阶) 实现一个固定上三角 attention mask,注册为 buffer,并验证模型从 CPU 移到 CUDA 后 mask 与输入设备一致。
- (进阶) 写一个 checkpoint 字典,加入 optimizer、step、配置和一个自定义版本号;模拟训练中断后恢复并继续一步更新。
- (AI Infra) 统计模型参数量、参数 dtype 和每个子模块的参数量,设计一个启动前的 checkpoint 键名与形状校验函数。
下一篇预告
第41篇|Dataset、DataLoader 与训练循环。有了本篇的模块树和状态边界,下一步要回答“数据怎样稳定、并行地送到 forward”:我们会实现 Dataset,理解 DataLoader 的批处理、shuffle、worker 与 pinned memory,再把 model.train()、损失、反向、优化器和 checkpoint 串成一个完整训练循环。沿着这条路线,后续第 42 篇将进入优化器、损失函数与学习率调度,第 43 篇再把这些组件推进到手写 Attention 和 Transformer Block。
管理