
第38篇|GPU、device 与 CUDA 基础
本篇定位:专栏四「PyTorch 与 AI Infra 入门」的第二篇。承接第 37 篇 Tensor 与 NumPy 互转,把
device从一个属性提升为数据搬运、算子执行和服务部署的完整契约。读完你将能够:解释 CPU、CUDA device 与显存的关系;正确使用
.to(device)、.cuda()、.cpu()和 device 字符串;检查 CUDA 是否可用;理解 Tensor 的 device affinity、pinned memory 与非阻塞拷贝;定位跨 device 运算、模型漏搬运和错误 benchmark 等常见问题。预计用时:阅读 50~70 分钟,动手 60~90 分钟。
第 37 篇里,我们已经会检查 Tensor 的 shape、dtype、stride 和 device。但如果只把 device 当作打印结果,模型一旦从 CPU 迁移到 GPU,就会遇到一连串看似突然的错误:输入在 cuda:0,权重还在 CPU;结果明明已经算完,计时却总是偏小;一个 batch 搬到显卡后,下一批又被无意中搬了两次。
本篇建立一条简单而可靠的心智模型:Tensor 的数值存储在某个 device 上,算子必须在兼容的 device 上执行,跨 device 的移动是有成本的显式边界。 CUDA 不是“给 Python 加一个加速开关”,而是 PyTorch、驱动、GPU 和内存系统共同完成的一条执行链。当前环境可能没有 torch 或 NVIDIA GPU,因此正文中的 CUDA 示例按真实 PyTorch 语义书写;能在 CPU 上检查的部分可以运行,涉及 GPU 的部分用条件判断保护。
一、从 CPU 到 GPU:device 是执行契约
1.1 CPU、GPU 与两类内存
CPU 是主机处理器,通常直接访问进程的主机内存(host memory);GPU 是设备处理器,使用自己的设备内存,也就是常说的显存(device memory)。Tensor 的数据在哪块内存,就决定了哪些 kernel 可以直接读取它。CPU kernel 不能直接把一个 CUDA Tensor 当作普通内存指针使用,GPU kernel 也不能免费读取 Python 进程里的任意对象。
import torch

cpu_x = torch.ones((2, 3), device="cpu")
print(cpu_x.device, cpu_x.device.type, cpu_x.device.index)

if torch.cuda.is_available():
    gpu_x = torch.ones((2, 3), device="cuda:0")
    print(gpu_x.device, gpu_x.device.type, gpu_x.device.index)
cpu  cpu  None
cuda:0 cuda 0
device 不只是一个字符串标签。它与 Tensor 的存储绑定,影响算子调度、可访问地址和内存生命周期。cpu 没有设备编号,因为主机通常只有一个 PyTorch CPU device;cuda:0 表示第 0 个 CUDA 设备,cuda:1 表示第 1 个。即使机器只有一张显卡,也建议在服务配置里明确写出目标 device,而不是让隐式默认值决定行为。
| 概念 | 含义 | 典型例子 |
|---|---|---|
| host memory | CPU 可直接访问的主机内存 | Python 对象、NumPy 数组、CPU Tensor |
| device memory | 某个加速设备可直接访问的内存 | cuda:0 上的 Tensor |
| device | 数据和算子所在的执行位置 | cpu、cuda:0 |
| H2D | host to device,主机到 GPU | batch 上传显存 |
| D2H | device to host,GPU 到主机 | 取回预测结果 |
1.2 Tensor 有 device affinity
一个 Tensor 创建之后,就有了自己的 device affinity(设备归属)。同一个 Python 变量名在不同时间可以指向不同 device 的 Tensor,但一个 Tensor 本身不会“部分在 CPU、部分在 GPU”。查看 x.device 是最直接的检查;x.device.type 适合判断 CPU/CUDA,x.device.index 适合区分多卡编号。
import torch

x = torch.arange(6, dtype=torch.float32).reshape(2, 3)
print(x.device)                 # cpu
print(x.device.type == "cpu")  # True
print(x.device == torch.device("cpu"))  # True

for name in ("cpu", "cuda", "cuda:0"):
    d = torch.device(name)
    print(name, d.type, d.index)
cpu
True
True
cpu cpu None
cuda cuda None
cuda:0 cuda 0
torch.device("cuda") 通常表示当前 CUDA 默认设备;torch.device("cuda:0") 明确指定第 0 张卡。多卡服务不要只传 "cuda",因为当前进程的默认设备可能受 CUDA_VISIBLE_DEVICES、启动器或上层框架影响。配置、日志和指标最好记录解析后的完整 device,例如 cuda:1。
AI Infra 视角:device 是资源路由的一部分。模型副本、请求 batch、KV cache、临时 workspace 和输出都要有明确的 placement;只记录“用了 GPU”无法解释多卡服务的吞吐、显存碎片或请求间抖动。
1.3 CUDA availability 不是“只要有显卡就行”
判断 CUDA 是否可用,至少要通过 PyTorch 的运行时检查。机器有 NVIDIA 显卡,不代表当前环境已经装好匹配的驱动、CUDA runtime 和 PyTorch wheel;反过来,安装了 CUDA toolkit,也不代表 PyTorch 能找到设备。
import torch

print("torch:", torch.__version__)
print("cuda available:", torch.cuda.is_available())
print("compiled cuda:", torch.version.cuda)

if torch.cuda.is_available():
    print("count:", torch.cuda.device_count())
    print("name:", torch.cuda.get_device_name(0))
else:
    print("fallback: cpu")
在只支持 CPU 的环境中,最后一段仍应能正常执行;不要把 torch.cuda.get_device_name(0) 放在无条件路径上。torch.version.cuda 表示当前 PyTorch 构建关联的 CUDA 版本信息,不能单独证明驱动和设备工作正常。若要诊断服务器,还应在同一运行环境检查驱动、容器的 GPU 透传、可见设备和显存容量,而不是只看系统层面的“有 GPU”。
二、.to(device)、.cuda() 与 .cpu()
2.1 .to(device) 是通用迁移入口
最推荐的通用写法是先选择 device,再让输入和模型都迁移到同一个位置:
import torch

if torch.cuda.is_available():
    device = torch.device("cuda:0")
else:
    device = torch.device("cpu")

x = torch.randn(4, 8, dtype=torch.float32).to(device)
print(x.device)
cpu
在 GPU 可用时,输出会是 cuda:0;在 CPU-only 环境中输出是 cpu。.to(device) 返回目标 device 上的 Tensor,不能只看成“修改了变量内部标签”。如果发生跨 device 移动,通常会分配目标存储并复制数据;原 Tensor 仍可能被其他变量引用。于是必须接住返回值:
x = torch.zeros(2)
y = x.to("cpu")
print(x.device, y.device)
# x.to("cuda:0")  # 不能只调用而不接收返回值
当源 Tensor 已经在目标 device 上时,PyTorch 通常可以复用原对象或存储,但工程代码不要依赖对象身份;依赖的应该是 device、dtype、shape 等契约。.to() 还可以同时转换 dtype:x.to(device=device, dtype=torch.float16)。设备迁移与精度转换叠加时,测量要把它们作为一个明确边界记录。
2.2 .cuda() 和 .cpu() 是快捷方式
.cuda() 是把 Tensor 放到 CUDA device 的便捷写法,.cpu() 是把 Tensor 放回 CPU。它们易读,但表达能力不如 .to(device) 完整:
import torch

x = torch.ones(3)
if torch.cuda.is_available():
    x = x.cuda()       # 默认 CUDA device
    x = x.cuda(0)      # 明确第 0 张卡
    y = x.cpu()        # 回到 CPU
    print(x.device, y.device)
else:
    print("CUDA unavailable; x remains", x.device)
在可复用模块、命令行工具和多卡服务中,优先使用 .to(device),让 device 由配置或调用者注入。.cuda() 适合短实验或明确只支持 CUDA 的代码;把 .cuda() 散落在模型内部,会让 CPU 测试、单元测试和设备切换变得困难。
模型也有同样的迁移语义:
import torch
from torch import nn


device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
model = nn.Sequential(nn.Linear(8, 16), nn.ReLU(), nn.Linear(16, 2))
model = model.to(device)
inputs = torch.randn(4, 8).to(device)
outputs = model(inputs)
print(model[0].weight.device, inputs.device, outputs.device)
nn.Module.to() 会迁移已注册的参数和 buffer;它同样应当接回返回值。标准模块通常会原地更新模块并返回自身,但把 model = model.to(device) 写出来可以让边界意图更明显。自定义模块里若用普通 Python list 保存 Tensor,而不是 nn.ParameterList、nn.ModuleList 或注册 buffer,里面的对象可能不会被模块的 .to() 自动发现,这是后面参数管理章节会继续展开的工程坑。
2.3 迁移不是计算:区分复制、算子与同步
一次 .to(device) 可能包含分配、复制和必要的同步;一次 x + y 是在某个 device 上执行算子。二者都是时间成本,但性质不同。把一批数据反复在 CPU 和 GPU 之间来回搬,会抵消 kernel 加速:
# 不推荐:每一步都发生 D2H/H2D
for batch in batches:
    scores = model(batch.to(device))
    scores = scores.cpu()
    decisions = scores.argmax(dim=-1)
    # 下一步若又把 decisions 送回 GPU,就形成往返
更好的做法是尽量在同一 device 上完成连续计算,只在真正需要的边界回 CPU,例如最终展示、落盘或交给只支持 NumPy 的库:
with torch.inference_mode():
    scores = model(batch.to(device))
    decisions = scores.argmax(dim=-1)

# 只在输出边界回 CPU
answer = decisions.cpu().tolist()
.cpu() 不代表“把结果转换成 Python 值”;它只把 Tensor 移到主机。.tolist()、.item() 和 .numpy() 才是不同的表示层转换,而且大多需要 CPU Tensor。大型结果逐元素调用 .item() 既会产生 Python 对象,也可能造成频繁同步,应优先批量 .cpu() 后处理。
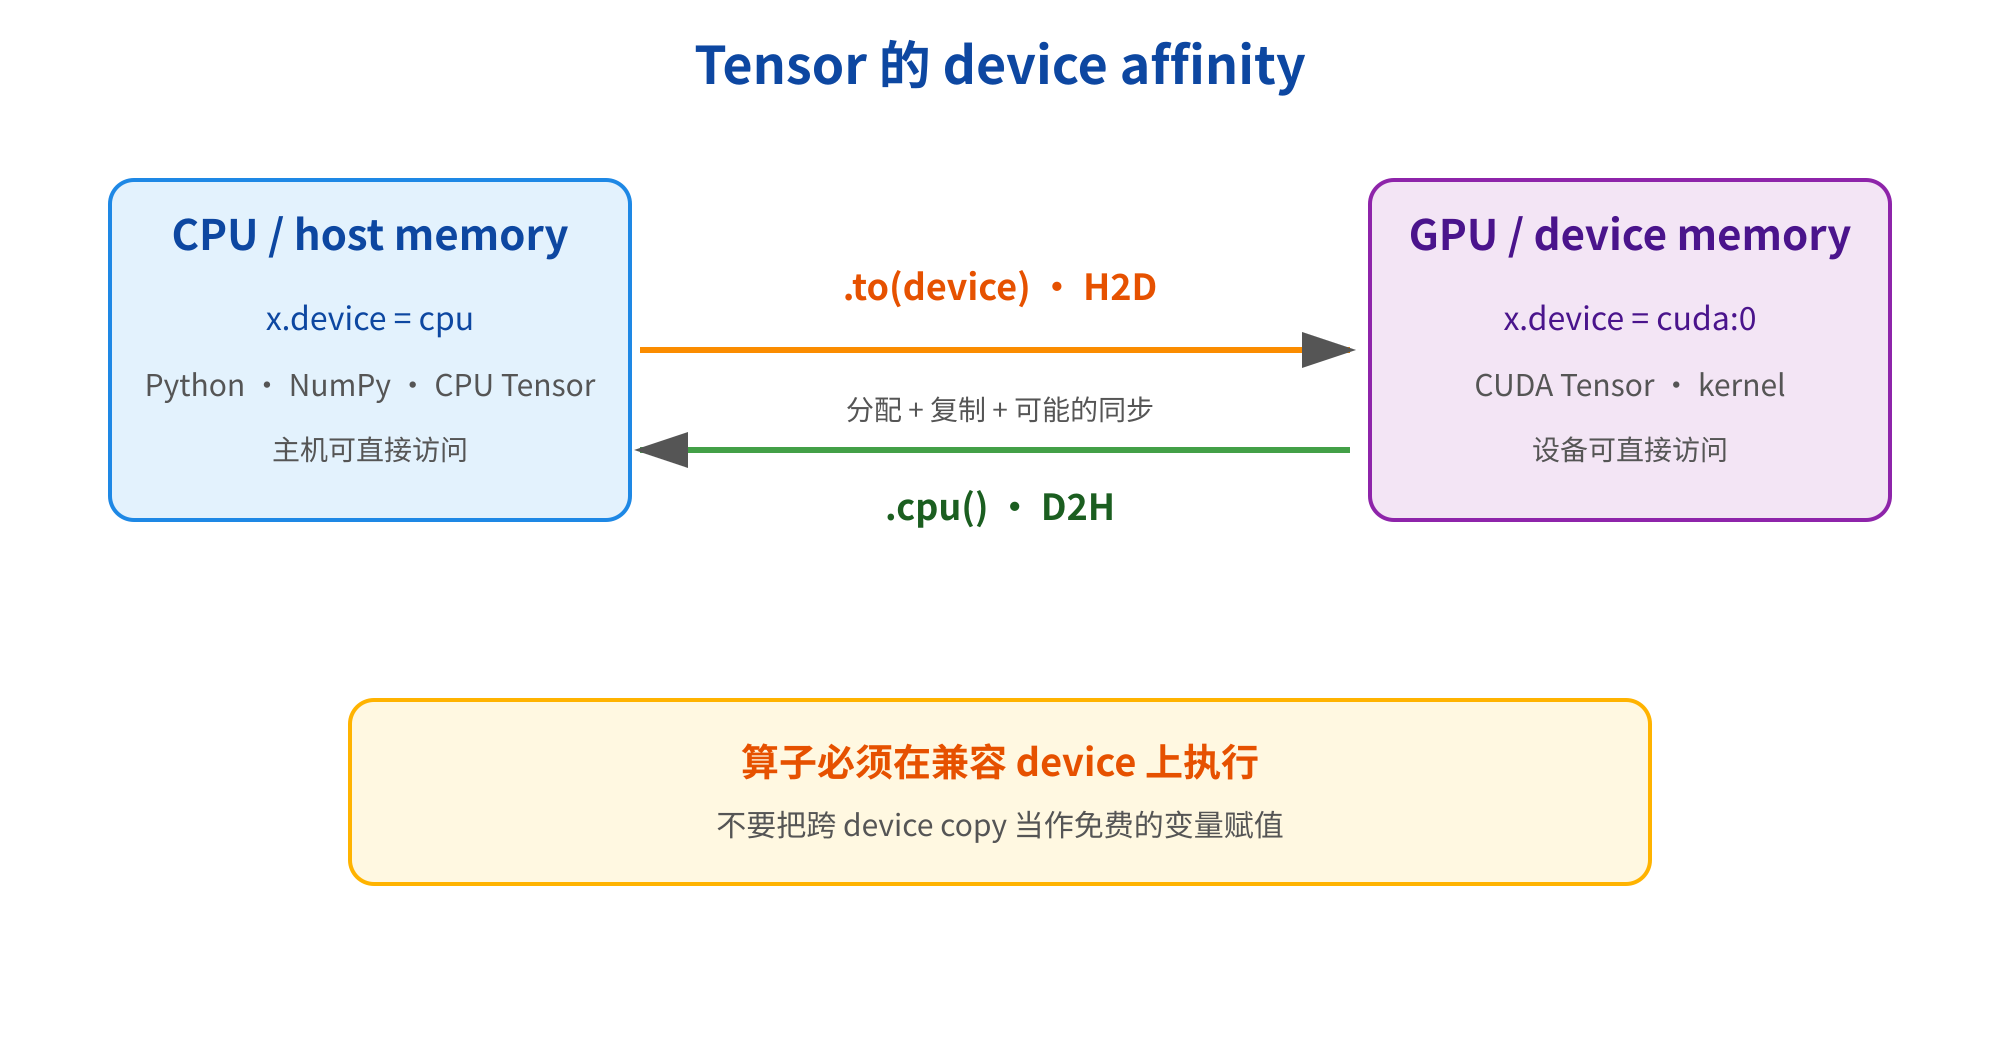
图1 Tensor 的 device affinity 与迁移边界
三、设备创建、迁移与跨 device 运算
3.1 从源 Tensor 继承 device
在 GPU 代码中,临时 Tensor 是最容易漏迁移的对象。torch.zeros(…)、torch.arange(…) 和 torch.tensor(…) 默认创建在 CPU,即使模型和输入已经在 CUDA 上。解决方法之一是显式传 device,另一种是使用 zeros_like、new_zeros 等从已有 Tensor 继承属性的 API。
import torch

x = torch.ones(2, 3)
mask = torch.zeros_like(x, dtype=torch.bool)
scale = x.new_tensor(0.5)
print(mask.device, mask.dtype, scale.device, scale.dtype)
cpu torch.bool cpu torch.float32
如果 x 在 cuda:0,上面的 mask 和 scale 也会跟随到 cuda:0。对于与输入有关的临时量,*_like 和 new_* 能减少硬编码;对于与模块参数有关的常量,使用参数或 buffer 的 device 创建。不要在热路径里每次都创建一个 CPU 常量再 .to(device),这会增加不必要的分配和搬运。
# 更稳:跟随 x 的 device 和 dtype
bias = torch.zeros_like(x)
indices = torch.arange(x.shape[0], device=x.device)

# 需要固定 dtype 时也要显式说明
probability = torch.zeros(x.shape, device=x.device, dtype=torch.float32)
torch.tensor(3.0, device=x.device) 适合少量标量;如果常量会反复使用,可以注册成模块 buffer,避免每个请求重新分配。创建 Tensor 的地方就是 placement policy 的一部分,应当能在代码审查中看出来。
3.2 跨 device 运算通常会报错
PyTorch 不会为了让表达式“方便运行”而自动把所有输入搬到同一张卡。不同 device 的 Tensor 参与大多数运算,会得到明确的错误;这比静默复制更安全,因为隐式搬运会让性能和资源边界不可见。
import torch

if torch.cuda.is_available():
    cpu_x = torch.ones(2)
    gpu_y = torch.ones(2, device="cuda:0")
    try:
        cpu_x + gpu_y
    except RuntimeError as exc:
        print(type(exc).__name__)
        print("check: cpu_x.device and gpu_y.device")
else:
    print("skip mixed-device example: CUDA unavailable")
RuntimeError
check: cpu_x.device and gpu_y.device
排查这类错误时,不要只检查输入。模型参数、buffer、临时 mask、索引 Tensor、标签和目标值都可能成为异物。一个实用的入口检查函数如下:
import torch


def assert_same_device(*tensors):
    devices = {str(t.device) for t in tensors if t is not None}
    if len(devices) != 1:
        raise ValueError(f"mixed devices: {sorted(devices)}")


def forward(x, weight, bias):
    assert_same_device(x, weight, bias)
    return x @ weight + bias
生产代码可以把检查放在 debug 模式、请求入口或单元测试里;不建议在每一个小算子上重复昂贵的 Python 检查。错误信息应包含张量名字、shape、dtype 和 device,这样多卡服务日志才能定位到具体 placement。
3.3 多卡不是一个更大的 cuda
cuda:0 和 cuda:1 是两个不同的 device。即使两张卡型号相同,也不能直接把它们的 Tensor 相加。多卡并行有数据并行、张量并行、流水线并行等不同组织方式,每种方式都明确规定了哪些数据在哪张卡。
import torch

if torch.cuda.device_count() >= 2:
    left = torch.ones(2, device="cuda:0")
    right = torch.ones(2, device="cuda:1")
    # left + right  # 不要这样写;先按并行策略通信或迁移
    print(left.device, right.device)
else:
    print("need at least two CUDA devices")
把 Tensor 从 cuda:0 移到 cuda:1 不是免费的变量赋值,而是设备间通信。AI Infra 框架会用 NCCL、collective communication 和分片策略管理这些边界;应用层最重要的第一步,是不要在无意中制造跨卡 copy。记录 CUDA_VISIBLE_DEVICES 后的逻辑编号也很重要:容器里看到的 cuda:0 不一定对应宿主机物理编号 0。
四、异步执行、pin_memory 与拷贝链路
4.1 为什么 GPU 计时会“少算时间”
CPU 代码通常调用函数后等待结果返回;CUDA kernel 则常常由 CPU 发射后在 GPU 上异步执行。于是 Python 看到的“提交 kernel 时间”可能很短,不能直接当作真实计算时间。需要准确测量时,使用 CUDA event,或在计时边界显式同步:
import time
import torch

if torch.cuda.is_available():
    x = torch.randn(4096, 4096, device="cuda")
    torch.cuda.synchronize()
    start = time.perf_counter()
    y = x @ x
    torch.cuda.synchronize()
    elapsed_ms = (time.perf_counter() - start) * 1000
    print(f"elapsed: {elapsed_ms:.2f} ms", y.shape)
else:
    print("CUDA unavailable; do not compare this timing")
第一次运行还可能包含 kernel 选择、缓存分配、上下文初始化或编译开销;正式 benchmark 要预热、固定输入、重复多次,并说明是否包含 H2D、D2H 和同步。torch.cuda.synchronize() 很有用,但不要在服务每一步都无条件调用:它会把原本可以重叠的工作强制串行化。准确测量时同步,优化时再研究怎样减少同步。
4.2 pinned memory 是什么直觉
普通 CPU 内存可能被操作系统换出,或者不满足设备 DMA 直接高效读取的条件。pinned memory(页锁定内存)是不会被换出的主机内存,GPU 可以更直接地通过 DMA 读取它。它不是显存,也不是“CPU 版本的 GPU”;它只是 H2D/D2H 路径上更适合异步传输的 host buffer。
import torch

batch = torch.randn(32, 128)
pinned_batch = batch.pin_memory()
print(batch.is_pinned(), pinned_batch.is_pinned())
False True
页锁定内存很珍贵。大量、长期 pin 住 CPU 内存会增加主机内存压力,甚至影响系统稳定性,所以不要把所有数组都 pin_memory()。在数据加载场景,更常见的是让 DataLoader(pin_memory=True) 管理批次缓冲,再配合到 GPU 的拷贝:
from torch.utils.data import DataLoader, TensorDataset

# dataset = TensorDataset(features, labels)
# loader = DataLoader(dataset, batch_size=64, pin_memory=True,
#                     num_workers=2, persistent_workers=True)
# for features, labels in loader:
#     features = features.to(device, non_blocking=True)
#     labels = labels.to(device, non_blocking=True)
pin_memory=True 不会自动把数据送到 GPU;它只改变 host 侧缓冲的属性。non_blocking=True 是允许在满足条件时异步提交拷贝的意图,不是“保证拷贝一定异步”。源内存通常需要是 pinned memory,目标和生命周期也要满足重叠条件;否则 PyTorch 可能退化为同步行为。正确做法是 profile 验证,而不是只添加参数就宣称吞吐提升。
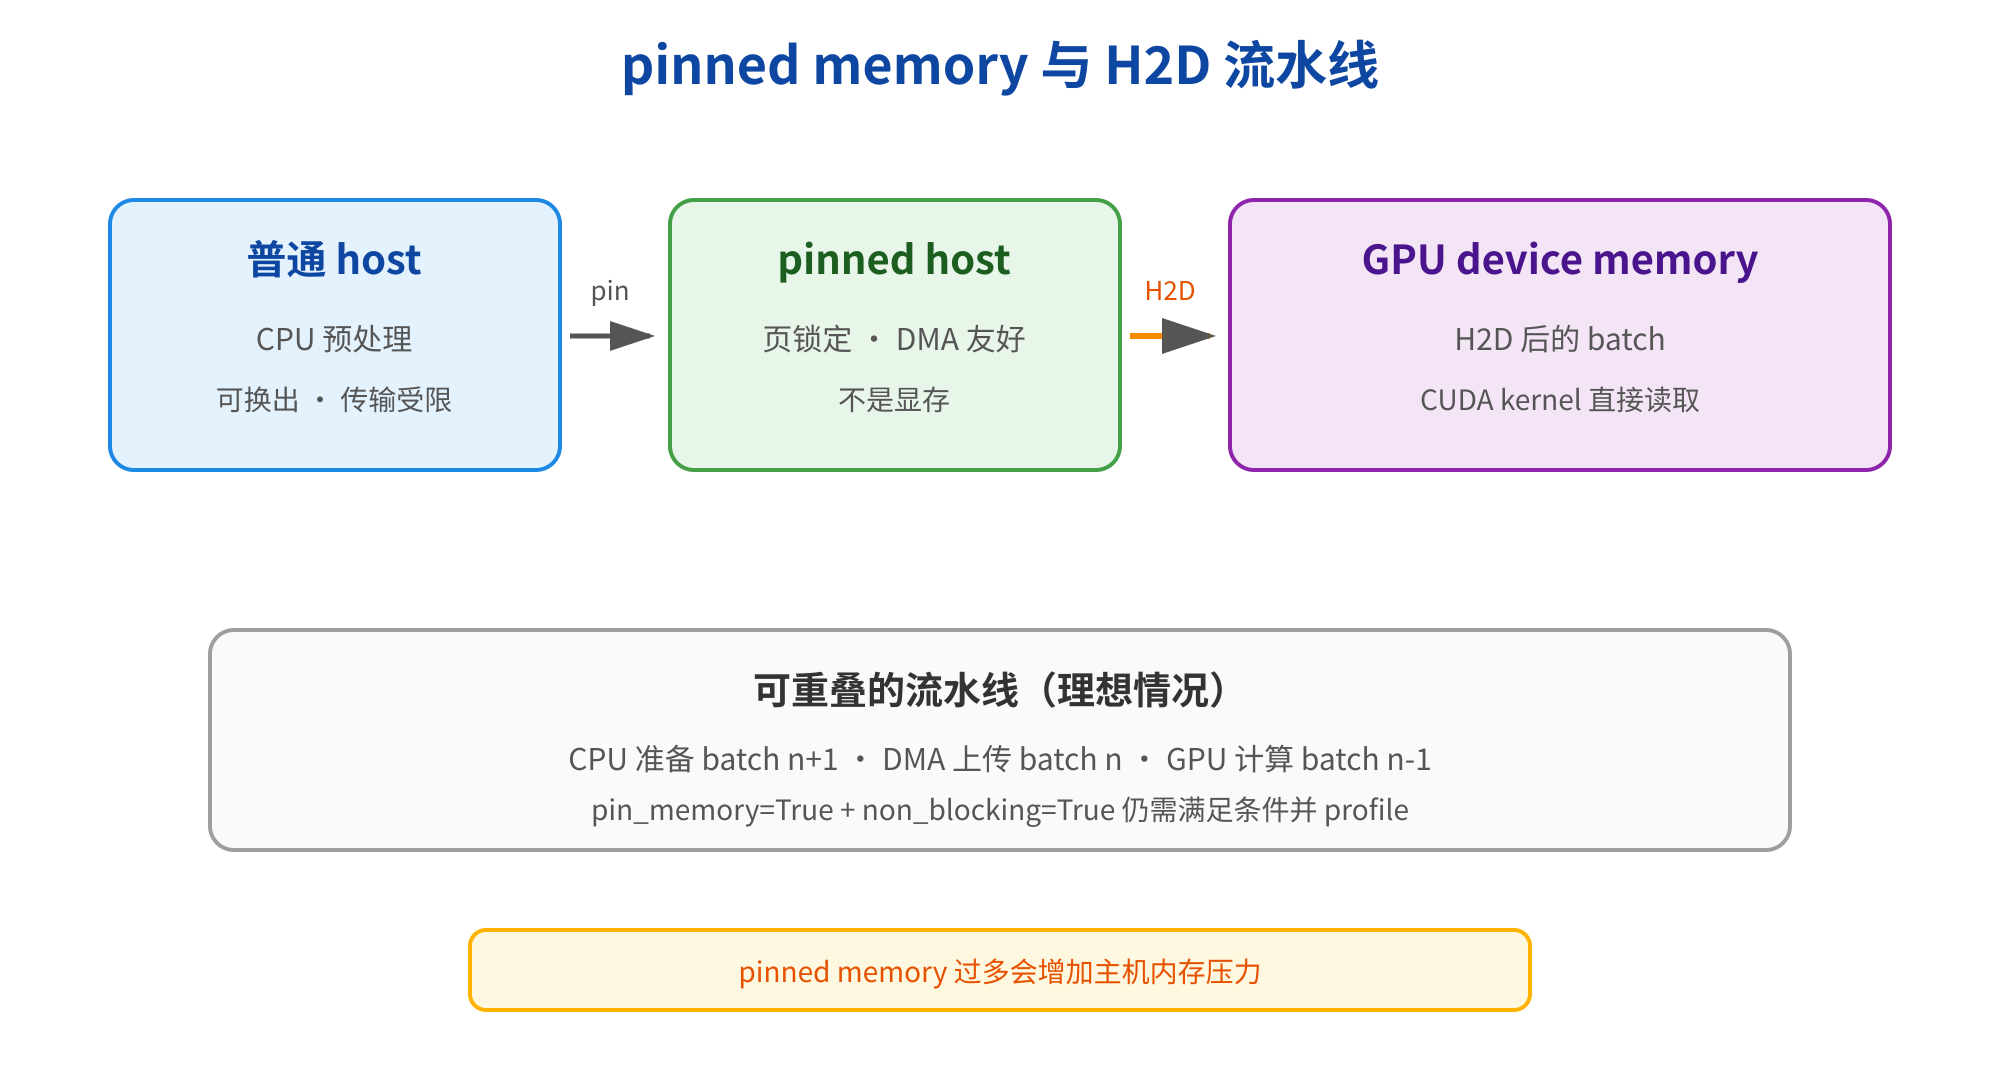
图2 H2D 拷贝、pinned memory 与计算重叠
4.3 把计算与搬运看成流水线
一个 batch 的端到端路径通常是:数据读取 → CPU 预处理 → pinned host buffer → H2D → GPU kernel → D2H 或下一阶段消费。理想情况下,GPU 处理第 n 批时,CPU 和 DMA 可以准备第 n+1 批;这需要数据加载、stream、buffer 生命周期和算子执行互相配合。
不要把“CPU 准备快”和“GPU 利用率高”混为一谈。如果每批数据太小,H2D 启动开销占主导;如果 host 预处理慢,GPU 会空等;如果输出每一步 .cpu(),又会迫使流水线同步。先用 profiler 或分阶段计时确认瓶颈,再决定增加 worker、调整 batch、启用 pinned memory 还是改变输出策略。
五、把 device 设计进训练与推理代码
5.1 一个可迁移的模型入口
设备策略应该集中在程序边界,而不是散落在业务函数里。下面的示例让调用者选择 device,模型、输入和标签统一迁移;代码在没有 GPU 时仍可运行。
import torch
from torch import nn


def choose_device() -> torch.device:
    return torch.device("cuda:0" if torch.cuda.is_available() else "cpu")


def build_model(device: torch.device) -> nn.Module:
    model = nn.Sequential(nn.Linear(8, 16), nn.ReLU(), nn.Linear(16, 2))
    return model.to(device)


device = choose_device()
model = build_model(device)
x = torch.randn(32, 8, device=device)
target = torch.zeros(32, dtype=torch.long, device=device)
logits = model(x)
loss = nn.functional.cross_entropy(logits, target)
print(device, logits.device, loss.device)
cpu cpu cpu
当训练代码进一步加入优化器时,优化器应在模型迁移后创建,或者至少确认参数引用没有被错误替换。输入、标签和模型输出要在同一 device;损失函数通常会根据输入执行,但 target 仍然必须与参与计算的 Tensor 兼容。任何在循环里新增的 mask、权重或索引,都应继承 x.device 或从模型参数查询。
5.2 checkpoint 与加载位置
保存模型时,checkpoint 可能来自另一台机器、另一张卡或 CPU。加载时不要假设保存时的 device 仍然存在,可以指定 map_location:
import torch

# 保存:state = model.state_dict(); torch.save(state, "model.pt")

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
# state = torch.load("model.pt", map_location=device, weights_only=True)
# model.load_state_dict(state)
# model.to(device)
map_location 负责把反序列化的 Tensor 映射到可用位置;model.to(device) 负责把模型当前注册的参数和 buffer 放到最终执行位置。实际项目要按 PyTorch 版本确认 weights_only、自定义对象和安全反序列化策略,不能把不可信 checkpoint 当成普通数据文件直接加载。
5.3 推理服务里的 placement
在 AI Infra 服务中,device placement 不是单个请求的临时决定,而是启动阶段的资源规划。常见模式是:进程启动时选择一张 GPU,加载一份模型副本并预分配必要 buffer;请求进入后只把输入 batch 搬到该 device;模型在 inference_mode 下运行;输出在协议要求的边界一次性回 CPU。
import torch

class Predictor:
    def __init__(self, model):
        self.device = torch.device(
            "cuda:0" if torch.cuda.is_available() else "cpu"
        )
        self.model = model.eval().to(self.device)

    def predict(self, features):
        x = torch.as_tensor(features, dtype=torch.float32)
        x = x.to(self.device)
        with torch.inference_mode():
            y = self.model(x)
        return y.cpu().numpy()
这个骨架仍可继续优化:预处理可以在 CPU worker 中批量完成,DataLoader 可以使用 pinned memory,多个请求可以动态 batching,输出可以减少 D2H 次数。关键是 placement 规则清楚:输入在哪儿进入、模型在哪儿驻留、中间结果是否留在 GPU、什么时候允许回 CPU。
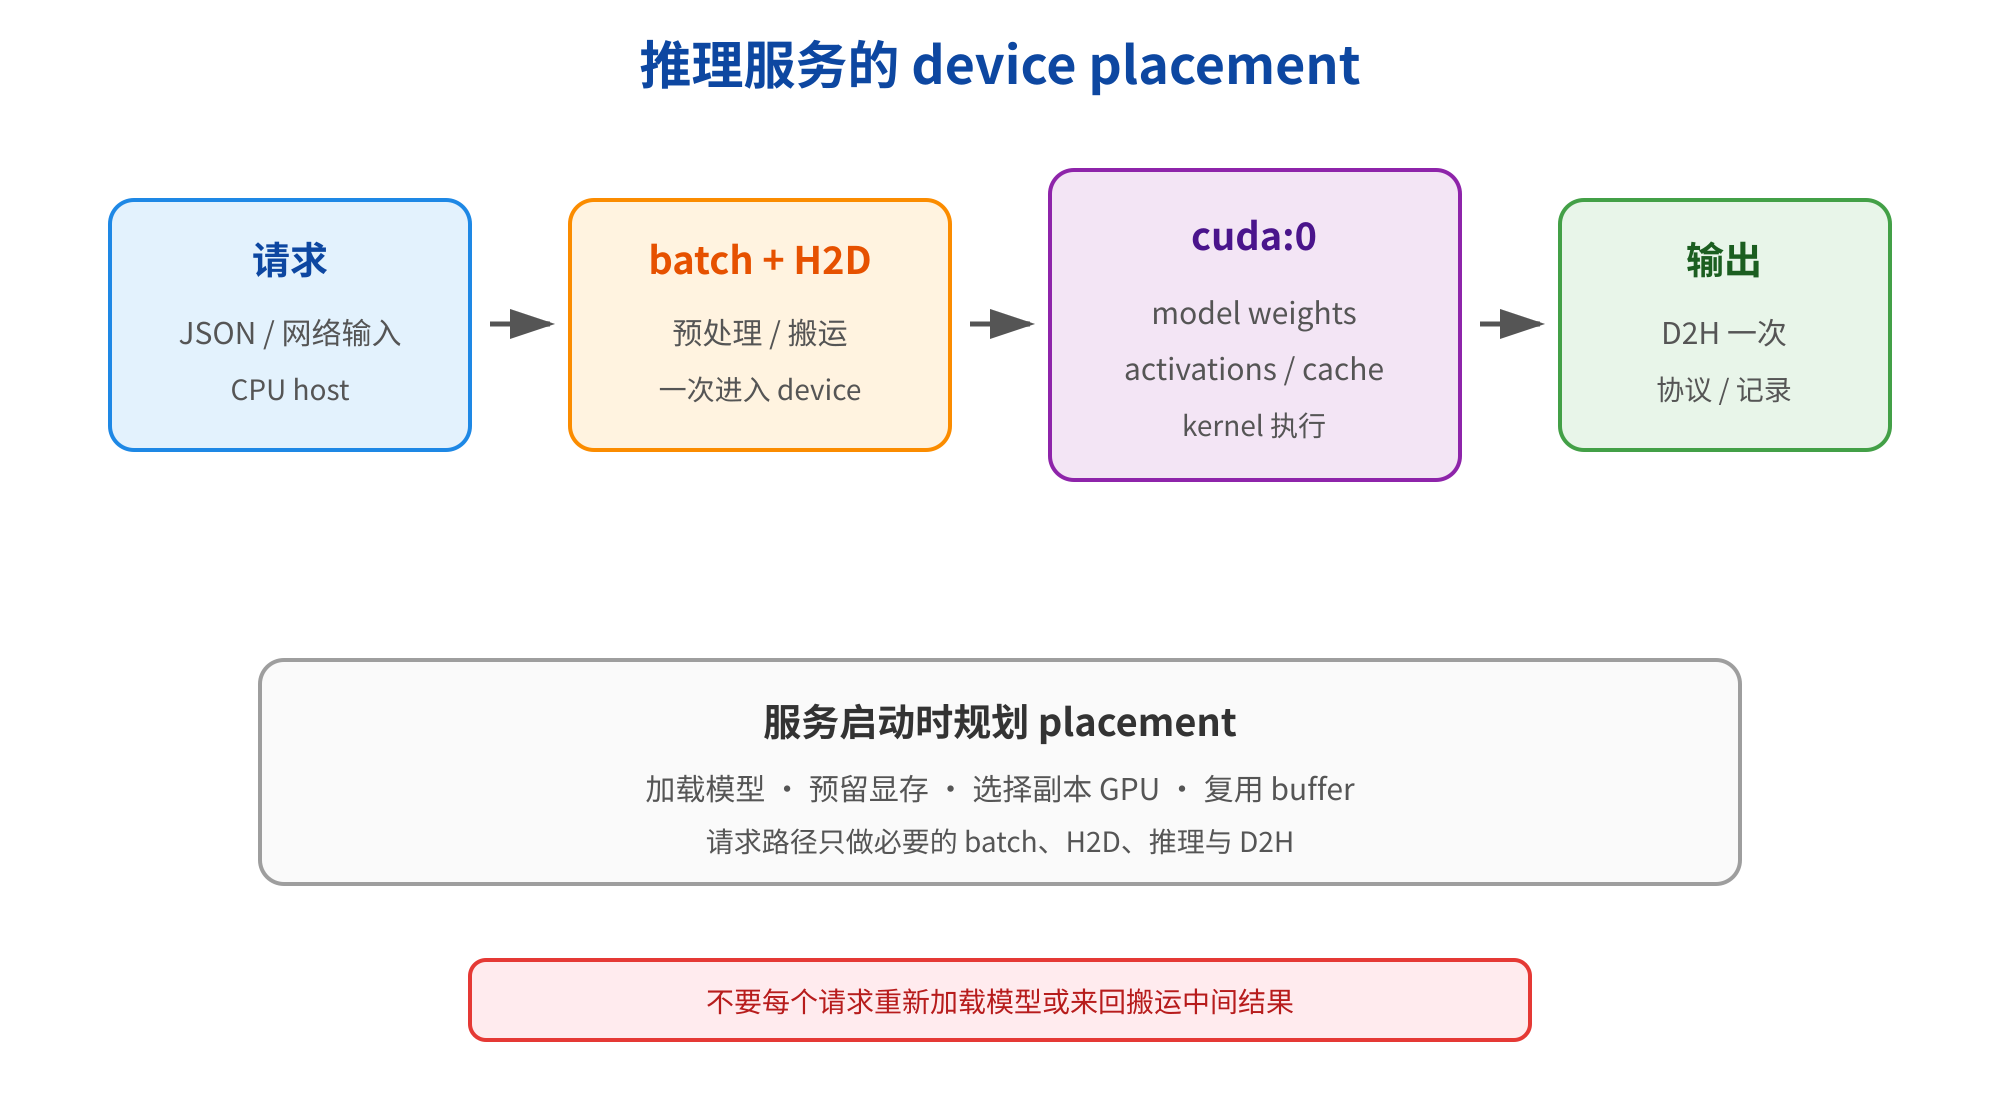
图3 推理服务的 device placement 与请求路径
多副本服务还要考虑显存容量、模型权重复制、并发请求的临时激活和 KV cache。把每个请求“随机丢给当前空闲 GPU”并不等于负载均衡;如果发生跨卡搬运,通信成本可能比计算更高。vLLM、SGLang 等推理系统会进一步管理 batch、KV cache、并行和调度,但它们仍然建立在本篇的基础规则上:数据与执行 kernel 必须有可解释的 device 归属。
设备放置还要和故障处理、扩缩容一起设计。服务启动时可以把目标 GPU、显存预算、模型版本和 batch 上限写入启动日志;健康检查不仅要返回进程存活,还可以验证 CUDA 可用性、模型参数 device 和一次小尺寸 dry run。请求失败时,日志应区分“输入转换失败”“H2D 失败”“kernel 执行失败”和“显存不足”,不要只返回一个笼统的 500。这样的分类会帮助平台判断应该重试、摘除实例,还是回退到 CPU。
当系统从单卡扩展到多卡时,先画出数据流图,再决定使用副本、数据并行还是张量并行。每一条跨卡箭头都要有带宽、同步和生命周期的解释;每一个 cache 都要有容量和回收策略。把 placement 写成配置,把 device 写入指标标签,把 H2D、D2H 和同步作为 trace span,才能让“GPU 利用率不高”变成可验证的工程问题,而不是凭感觉增加显卡。
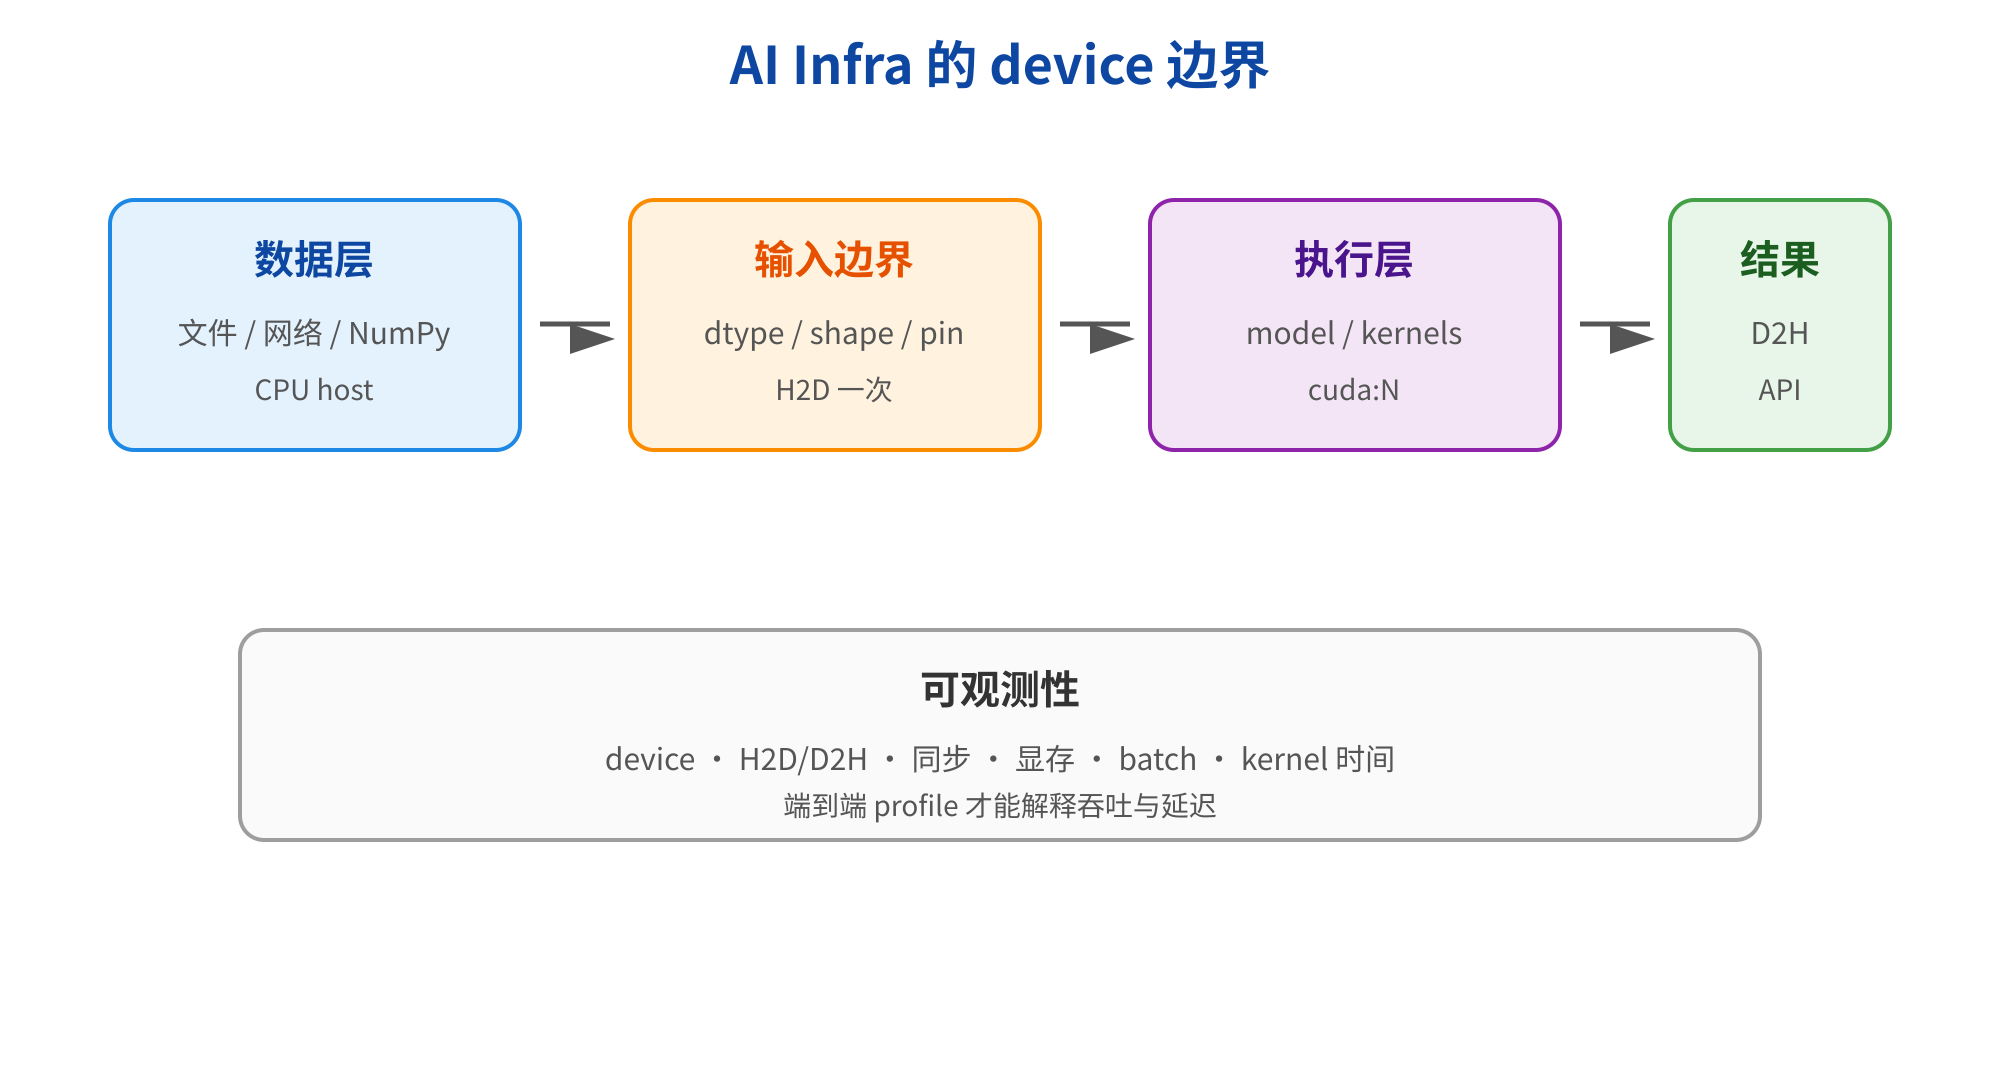
图5 AI Infra 中从数据边界到 device 执行层的可观测链路
六、一个安全的 CUDA 检查与迁移实验
把下面脚本保存为 check_device.py。它在 CPU-only 环境也能完整运行;GPU 分支只在 torch.cuda.is_available() 为真时执行。实验重点不是追求某个固定毫秒数,而是观察 device、内存属性和迁移结果。
import torch


def report(name, x):
    print(
        f"{name}: shape={tuple(x.shape)} dtype={x.dtype} "
        f"device={x.device} pinned={x.is_pinned()}"
    )


cpu_x = torch.arange(12, dtype=torch.float32).reshape(3, 4)
report("cpu_x", cpu_x)

if torch.cuda.is_available():
    device = torch.device("cuda:0")
    if not cpu_x.is_pinned():
        host_x = cpu_x.pin_memory()
    else:
        host_x = cpu_x
    gpu_x = host_x.to(device, non_blocking=True)
    report("gpu_x", gpu_x)
    back = gpu_x.cpu()
    report("back", back)
    assert torch.equal(cpu_x, back)
    print("CUDA transfer: OK")
else:
    print("CUDA unavailable; CPU checks: OK")
cpu_x: shape=(3, 4) dtype=torch.float32 device=cpu pinned=False
CUDA unavailable; CPU checks: OK
注意:pin_memory() 本身通常要求当前 PyTorch 构建支持可用的 pinned allocator;某些特殊 CPU-only 环境可能不支持它。若实验只想验证迁移语义,可把 pinned 分支换成 gpu_x = cpu_x.to(device),不要因为机器缺 CUDA 就修改生产代码中的 device 策略。练习时记录 torch.version、torch.version.cuda、设备名和 batch shape,结果才具备可复现性。
常用诊断清单如下:
| 检查项 | 示例 | 说明 |
|---|---|---|
| CUDA 是否可用 | torch.cuda.is_available() | 运行时能力,不是显卡存在性 |
| 可见设备数 | torch.cuda.device_count() | 受环境变量和容器影响 |
| Tensor 归属 | x.device | 记录完整 cuda:N |
| 模型归属 | next(model.parameters()).device | 检查参数而非只看输入 |
| 显存概况 | torch.cuda.memory_allocated() | 需在 CUDA 分支调用 |
| 精确计时 | torch.cuda.synchronize() | 只放在测量边界 |
七、踩坑大全
通用
- 坑 1:调用
.to(device)却不接返回值。 现象是打印变量仍在 CPU。原因是迁移通常返回目标 Tensor;写成x = x.to(device),模型也明确执行model = model.to(device)。 - 坑 2:只迁移输入,没有迁移模型。 现象是输入在
cuda:0,权重在 CPU,运算报 mixed devices。原因是模型参数不会因为输入迁移而自动移动;统一在入口迁移并检查next(model.parameters()).device。 - 坑 3:临时 Tensor 默认落在 CPU。 现象是 mask、索引或常量成为唯一的异物。原因是
torch.zeros等默认使用 CPU;用device=x.device、zeros_like或注册 buffer。 - 坑 4:把
.cpu()当成 NumPy 转换。 现象是把 CPU Tensor 传给只接受数组的接口仍然失败。原因是.cpu()只改变设备;按需要再调用.numpy()或.tolist(),并考虑 detach 与同步。 - 坑 5:把
torch.cuda.is_available()当成性能保证。 现象是代码能找到 GPU 但吞吐不高。原因可能是 batch 太小、频繁 H2D/D2H、同步过多、数据加载慢或模型没有命中合适 kernel;要端到端 profile。
Linux / GPU 服务器
- 坑 6:混淆
cuda、cuda:0与物理编号。 现象是多卡任务跑错卡或互相抢显存。原因是可见设备会被CUDA_VISIBLE_DEVICES重映射;日志同时记录可见列表、逻辑 device 和显存使用。 - 坑 7:用 CPU 墙钟时间直接 benchmark GPU。 现象是矩阵乘法看起来快得不真实。原因是 kernel 异步提交;使用 CUDA event 或在计时前后同步,并单独报告预热成本。
- 坑 8:对所有内存都 pin。 现象是主机内存压力上升甚至系统抖动。原因是 pinned memory 不能像普通页一样自由换出;只为需要重叠传输的有限 buffer 启用,并通过 profile 验证收益。
- 坑 9:以为
non_blocking=True必然异步。 现象是代码写了参数但吞吐没有变化。原因是源内存、stream 或生命周期不满足条件时会退化;确认 DataLoader 的 pinned buffer 和实际时间线。 - 坑 10:在每个请求里加载模型或分配大 buffer。 现象是显存碎片、延迟尖峰和 OOM。原因是 placement 与生命周期没有放到服务启动阶段;启动时加载模型,复用 buffer,按并发和 batch 预算显存。
训练与推理
- 坑 11:每一步都把输出
.cpu()。 现象是 GPU 利用率低、延迟抖动。原因是 D2H 往往引入同步;在 GPU 上批量完成后处理,只有协议或持久化边界才回 CPU。 - 坑 12:把普通 list 里的 Tensor 当成模块参数或 buffer。 现象是
model.to(device)后它们仍在 CPU。原因是模块无法发现未注册对象;使用ParameterList、ModuleList或register_buffer,并在自定义类里设计清晰的状态契约。
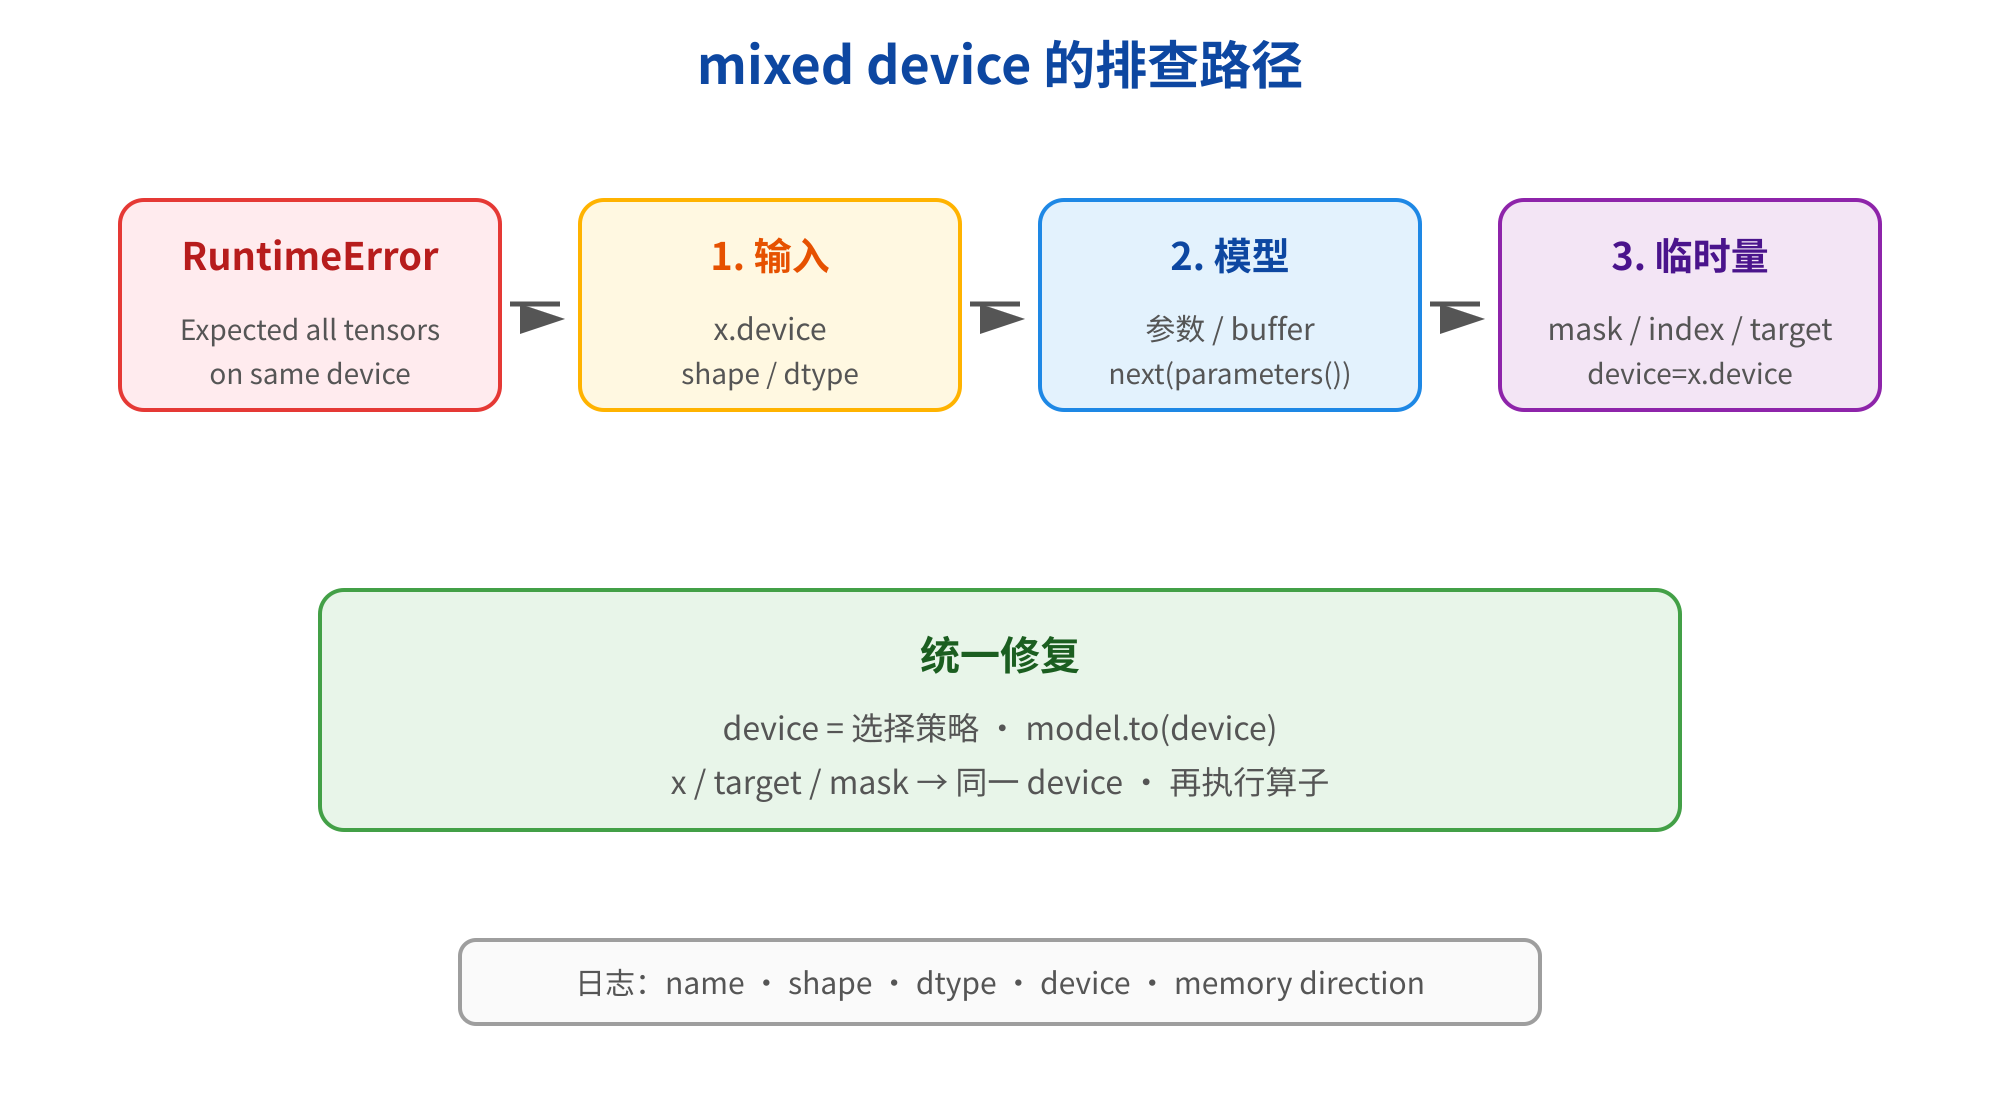
图4 常见 device 错误的排查路径
八、小结
- Tensor 的 device affinity 决定存储位置和可直接执行它的 kernel;CPU、
cuda:0与cuda:1是不同执行位置。 - 用
torch.cuda.is_available()做运行时能力判断,用.to(device)作为可配置的迁移入口;.cuda()和.cpu()是快捷方式。 .to()、H2D、D2H、算子计算和同步是不同成本;GPU 加速不能掩盖频繁往返和错误计时。- 临时 Tensor 应通过
device=x.device、*_like或注册 buffer 保持归属一致;PyTorch 不会替你静默解决跨 device 运算。 - pinned memory 是适合 DMA 的页锁定 host memory,不是显存;
pin_memory与non_blocking要在满足条件并经过 profile 后才有意义。 - 训练和推理服务要在启动边界规划 model、batch、cache 和输出的 placement,日志记录完整 device 与显存指标。
九、课后练习
- (基础) 在 CPU 环境创建一个
(2, 3)Tensor,打印device、device.type和device.index,再写一个 CUDA 可用时才执行的分支。 - (基础) 比较
x.to("cpu")、x.cpu()和x.cuda()的表达能力,解释为什么可复用代码更适合注入torch.device。 - (理解) 构造模型、输入、标签和 mask,故意让其中一个留在 CPU,捕获错误后写出一个
assert_same_device检查函数。 - (理解) 用
zeros_like、new_tensor和torch.zeros(device=x.device)创建临时量,分别观察它们继承了哪些 dtype 和 device 属性。 - (进阶) 在有 CUDA 的机器上比较普通 CPU Tensor 与 pinned Tensor 的 H2D 时间,区分首次分配、预热、拷贝和同步时间。
- (进阶) 编写一个计时脚本,分别用 CPU 墙钟、CUDA event 和同步后的墙钟测量矩阵乘法,解释三种结果为什么不同。
- (AI Infra) 写一个
Predictor,启动时加载一次模型,批量输入只在入口搬到目标 device,输出只在接口边界回 CPU;记录每个阶段耗时。 - (AI Infra) 设计两张 GPU 的 placement 表,说明模型副本、输入 batch、临时激活和最终输出分别在哪张卡,并标出所有跨卡通信点。
下一篇预告
下一篇是 第39篇|autograd 自动求导。本篇解决了“数据和模型在哪儿执行”,下一篇将回答“PyTorch 如何记住这些运算并反向计算梯度”:从 requires_grad、计算图和 grad_fn 出发,理解 backward()、叶子 Tensor、梯度累积与 no_grad 的边界。
路线会继续沿用第 36 篇的 NumPy MLP:第 37 篇把数组对象迁移为 Tensor,第 38 篇把 CPU/GPU device 和 H2D/D2H 链路补齐,第 39 篇再让 autograd 接管手写的 cache 与反向公式。之后进入 nn.Module、DataLoader、优化器、Attention 和 mini-GPT;当 device、梯度和参数管理各自有清晰契约,训练与推理系统才有可观测、可优化的基础。