
第37篇|Tensor 基础与 NumPy 互转
本篇定位:专栏四「PyTorch 与 AI Infra 入门」的第一篇。承接第 36 篇用 NumPy 手写 MLP 的 shape、dtype、stride 与缓存约束,把
ndarray迁移到 PyTorchTensor。读完你将能够:解释
Tensor与ndarray的共同点和关键差异;创建、索引、变形并检查 Tensor;理解dtype、device、requires_grad的职责;正确使用from_numpy、as_tensor、tensor和.numpy();识别共享内存、非连续布局与隐式拷贝的风险。预计用时:阅读 50~70 分钟,动手 60~90 分钟。
第 36 篇的 NumPy MLP 已经把一件事讲清楚:模型不是“几行矩阵乘法”,而是一组同时约束 shape、dtype、stride 和所有权的数组操作。今天把同一套心智模型带到 PyTorch。Tensor 看起来像一个会自动求导的数组,但在 AI Infra 中,它还携带设备、布局和计算图语义;这些属性会影响算子选择、内存搬运以及后续能否进入 GPU kernel。
本篇只打好 CPU Tensor 的地基,不展开 CUDA 的线程、流和异步拷贝。第 38 篇会专门讨论 device 与 GPU。由于当前构建环境未安装 torch,正文中的 PyTorch 代码按 Python 3.12 与常见 PyTorch 版本编写;复制到安装了 PyTorch 的环境即可运行。代码旁边会先用输出和断言说明预期行为,而不是假装在没有依赖的环境里执行。
一、从 ndarray 到 Tensor:相似的外形,不同的契约
1.1 两种数组对象都描述一块多维数据
NumPy 的 ndarray 和 PyTorch 的 Tensor 都可以用 shape、dtype、索引、切片、广播、矩阵乘法来表达数据。第 36 篇中的 X @ W1 + b1,换成 Tensor 后仍然是 X @ W1 + b1;模型的数学没有因为换了容器而改变。
import torch

X = torch.tensor([[1.0, -1.0], [2.0, 0.5]], dtype=torch.float32)
W = torch.tensor([[1.0, 0.0], [0.5, 2.0]], dtype=torch.float32)
b = torch.tensor([0.1, -0.2], dtype=torch.float32)
Y = X @ W + b
print(Y)
print(Y.shape, Y.dtype, Y.device, Y.stride(), Y.is_contiguous())
tensor([[ 0.6000, -2.2000],
        [ 2.2500,  1.0000]])
torch.Size([2, 2]) torch.float32 cpu (2, 1) True
二者的第一层差异是定位。NumPy 主要提供 CPU 数值数组和科学计算 API;Tensor 是深度学习运行时的核心数据对象,除了数值,还要回答“数据在哪个设备”“是否记录梯度”“怎样解释 stride”“该由哪个 kernel 执行”。在训练服务、推理服务和编译器边界上,这些信息都是执行契约的一部分。
| 属性 | NumPy ndarray | PyTorch Tensor | 迁移时的问题 |
|---|---|---|---|
| shape | 维度与长度 | 维度与长度 | batch、特征轴是否一致 |
| dtype | float32、int64 等 | torch.float32、torch.int64 等 | 是否发生提升或不匹配 |
| device | 通常是 CPU | CPU、CUDA 等 | 是否触发数据搬运 |
| stride | 以字节为单位 | 以元素为单位 | view 是否可行、kernel 是否喜欢 |
| 梯度 | 没有内建记录 | requires_grad 与 autograd | 数据还是可微参数 |
1.2 Tensor 的四元检查表
拿到一个 Tensor,不要只打印数值。至少检查 shape、dtype、device、stride;训练代码还要检查 requires_grad 和 is_leaf,布局敏感的边界再看 is_contiguous()。可以把它写成一个小工具:
import torch


def inspect(name, x):
    print(
        f"{name}: shape={tuple(x.shape)} dtype={x.dtype} "
        f"device={x.device} stride={x.stride()} "
        f"contiguous={x.is_contiguous()} "
        f"requires_grad={x.requires_grad}"
    )

x = torch.arange(12, dtype=torch.float32).reshape(3, 4)
inspect("x", x)
inspect("x.T", x.T)
x: shape=(3, 4) dtype=torch.float32 device=cpu stride=(4, 1) contiguous=True requires_grad=False
x.T: shape=(4, 3) dtype=torch.float32 device=cpu stride=(1, 4) contiguous=False requires_grad=False
这里的 stride 是“沿某一维前进一个元素,要跨过多少个元素”。x 的最后一维连续,所以 stride 是 (4, 1);转置只改变了解释方式,通常没有立刻复制数据,于是得到 (1, 4)。这和第 35 篇讲过的 NumPy view 直接对应,但不要因此认为所有后续算子都能零成本接受它。
AI Infra 视角:shape 决定算子能否对齐,dtype 决定精度和带宽,device 决定执行位置,stride 决定读取方式。线上排查“模型变慢”时,仅打印 loss 往往不够;先把这四类元数据放进日志,才能分辨是计算慢还是发生了布局转换、CPU/GPU 拷贝。
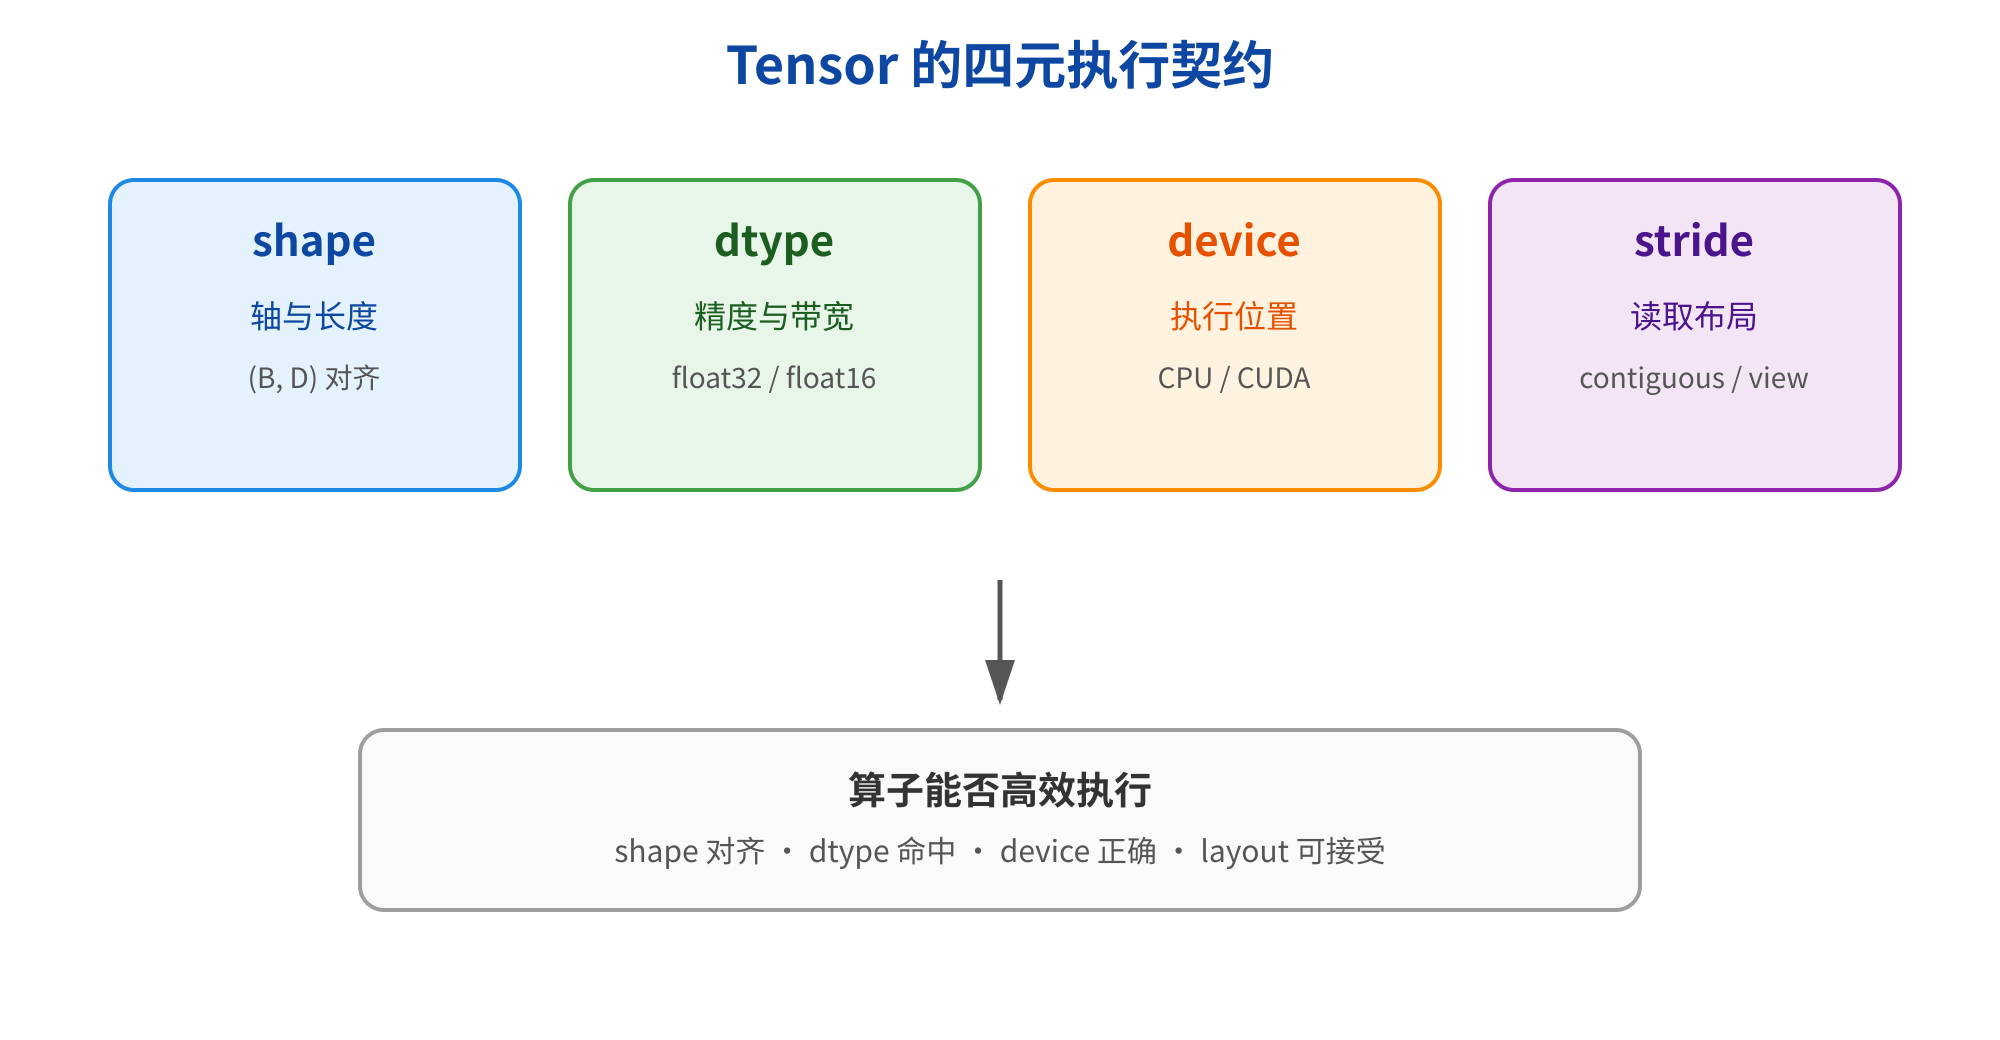
图1 Tensor 的 shape、dtype、device、stride 四元执行契约
1.3 requires_grad 不是“是否是参数”的同义词
requires_grad=True 表示从这个 Tensor 出发的运算,autograd 需要记录反向所需的信息。它不等同于“这是一个 nn.Parameter”,也不等同于“它已经有梯度”。本篇先只观察标志,不展开反向公式;第 39 篇会从计算图和 backward() 开始。
import torch

x = torch.tensor([2.0, 3.0], requires_grad=True)
y = (x * x).sum()
print(x.requires_grad, y.requires_grad, y.grad_fn is not None)
print(x.grad)  # 还没有调用 backward,因此是 None
True True True
None
数据输入通常不需要梯度,模型参数才需要。即使如此,也不要为了“让代码跑快”随手把所有 Tensor 设成 requires_grad=False;推理阶段用 torch.no_grad() 或 torch.inference_mode() 表达意图,训练阶段保留必要的图信息。Tensor 的值、存储、设备和梯度元数据是相互关联但不同的概念。
二、创建 Tensor:从 Python 值到可控的存储
2.1 常用创建 API 的语义
最常用的入口有四类:从 Python 序列创建、按形状创建、按范围创建、从现有数组转换。按形状创建时要显式写 dtype,否则整数输入、默认浮点类型和模型参数之间可能出现不一致。
import torch

zeros = torch.zeros((2, 3), dtype=torch.float32)
ones = torch.ones_like(zeros)
full = torch.full((2, 3), 7, dtype=torch.int32)
arange = torch.arange(0, 6, dtype=torch.float32).reshape(2, 3)
linspace = torch.linspace(0, 1, steps=5)
empty = torch.empty((2, 3), dtype=torch.float32)  # 未初始化,不可直接当作零

for name, value in [("zeros", zeros), ("ones", ones), ("full", full),
                    ("arange", arange), ("linspace", linspace)]:
    print(name, tuple(value.shape), value.dtype)
zeros (2, 3) torch.float32
ones (2, 3) torch.float32
full (2, 3) torch.int32
arange (2, 3) torch.float32
linspace (5,) torch.float32
empty 只申请存储,不填零,适合你会立刻完整写入的内部 buffer;教学和业务初始化优先使用 zeros、ones 或显式值,避免把未定义内容带进计算。*_like 会继承参考 Tensor 的 shape、dtype、device 等属性,是写通用模块时减少硬编码的好办法。
import torch

reference = torch.zeros((4, 2), dtype=torch.float16)
a = torch.empty_like(reference)
b = torch.zeros_like(reference)
print(a.shape, a.dtype, a.device)
print(b.shape, b.dtype, b.device)
如果从整数 Python 列表写入,得到的通常是整型 Tensor;如果从浮点列表写入,得到默认浮点 dtype。不要把“数值看起来像小数”当成 dtype 保证。数据加载、模型初始化和 NumPy 互转的边界都应该显式写出 dtype=torch.float32 或项目规定的类型。
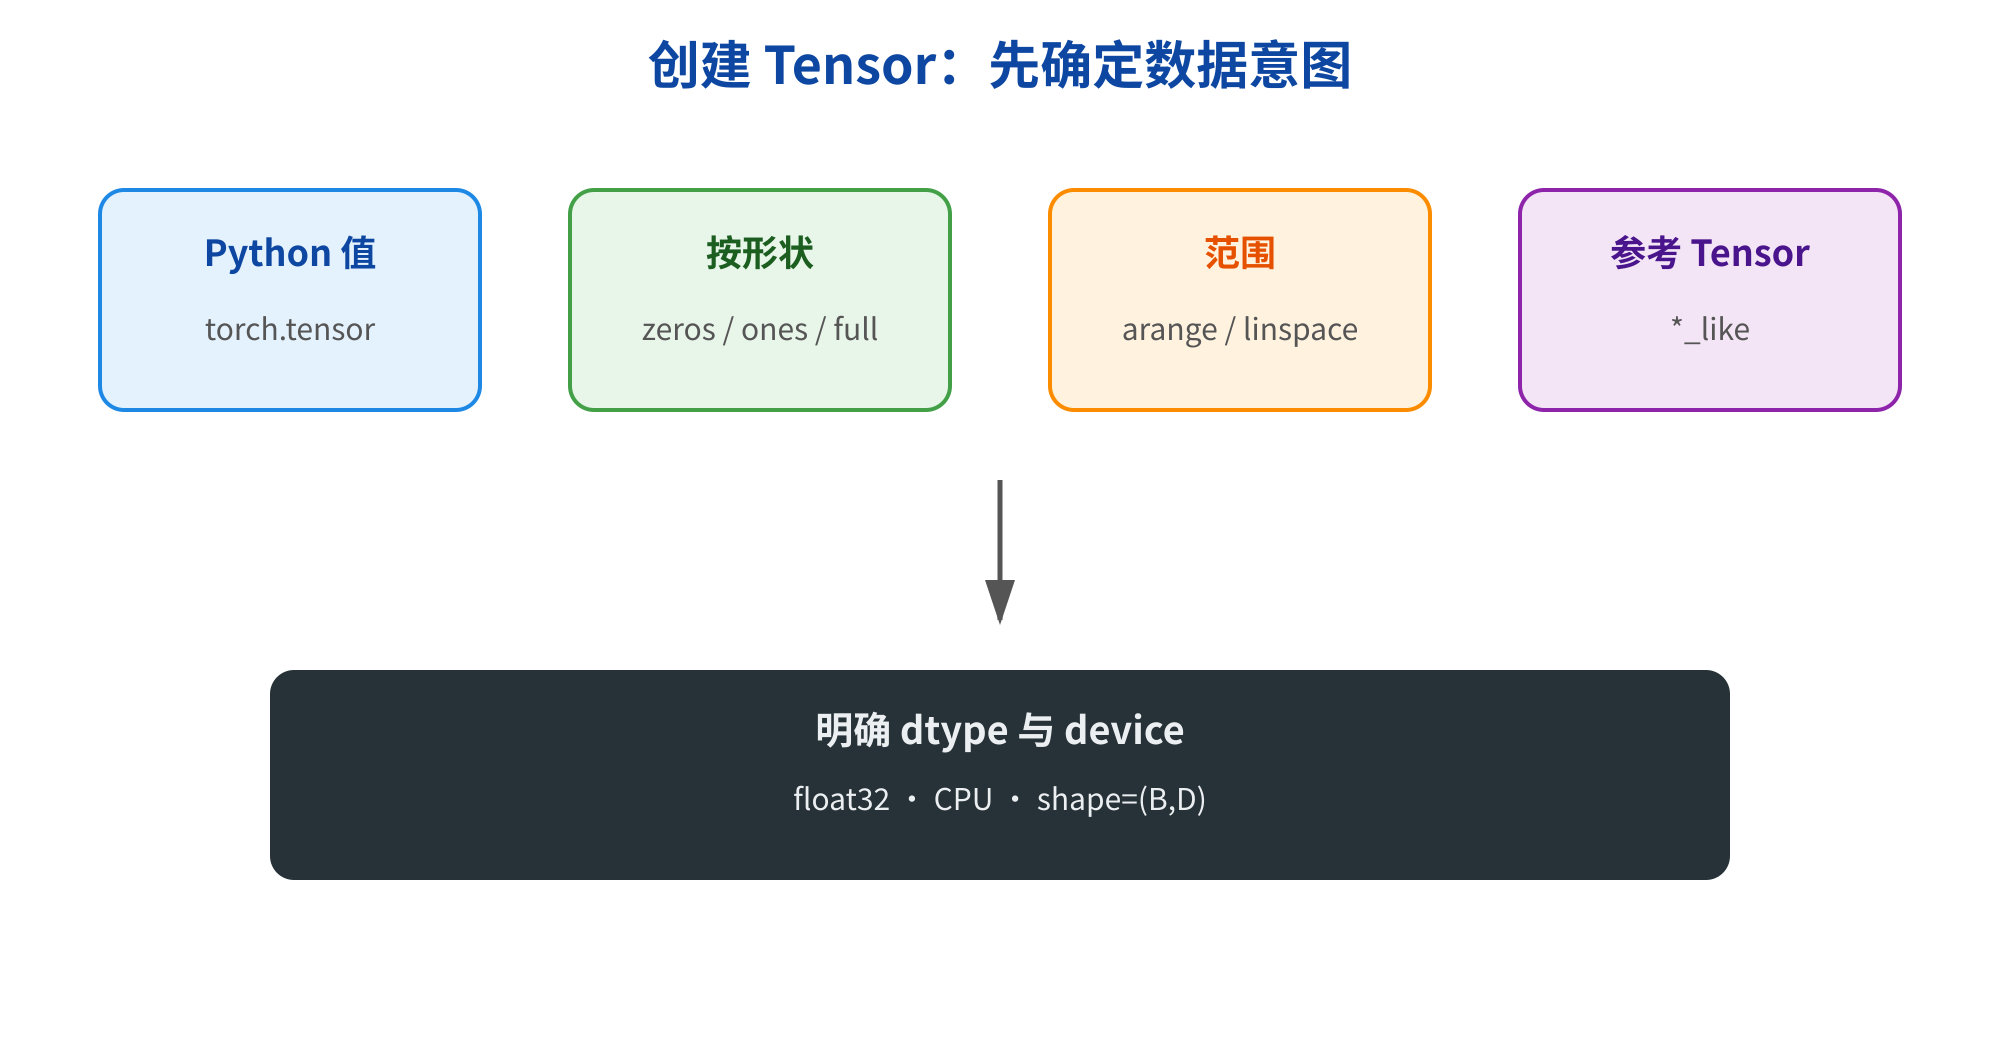
图2 常用 Tensor 创建 API 与 dtype、device 契约
2.2 reshape、view 与连续性
和 NumPy 类似,reshape 改变逻辑 shape;在可能的情况下它返回共享存储的 view,在不满足 stride 条件时也可能为了完成操作而创建副本。view 的要求更严格:它只接受能按当前布局解释的新形状,否则直接报错。工程代码中更推荐先理解布局,再选择 API,而不是用 reshape 掩盖所有问题。
import torch

x = torch.arange(12).reshape(3, 4)
y = x[:, ::2]
print("x", tuple(x.shape), x.stride(), x.is_contiguous())
print("y", tuple(y.shape), y.stride(), y.is_contiguous())

z = y.contiguous()
print("z", tuple(z.shape), z.stride(), z.is_contiguous())
print(torch.equal(y, z), y.data_ptr() == z.data_ptr())
x (3, 4) (4, 1) True
y (3, 2) (4, 2) False
z (3, 2) (2, 1) True
True False
contiguous() 在输入已经连续时通常直接返回可复用的结果,在非连续时分配一块按行连续的新存储。它不是“让所有 Tensor 都变快”的按钮:复制有成本,且会增加内存峰值。只有当下游算子、扩展或外部库确实需要连续布局时,才在明确的边界调用它,并把这次 copy 纳入 profile。
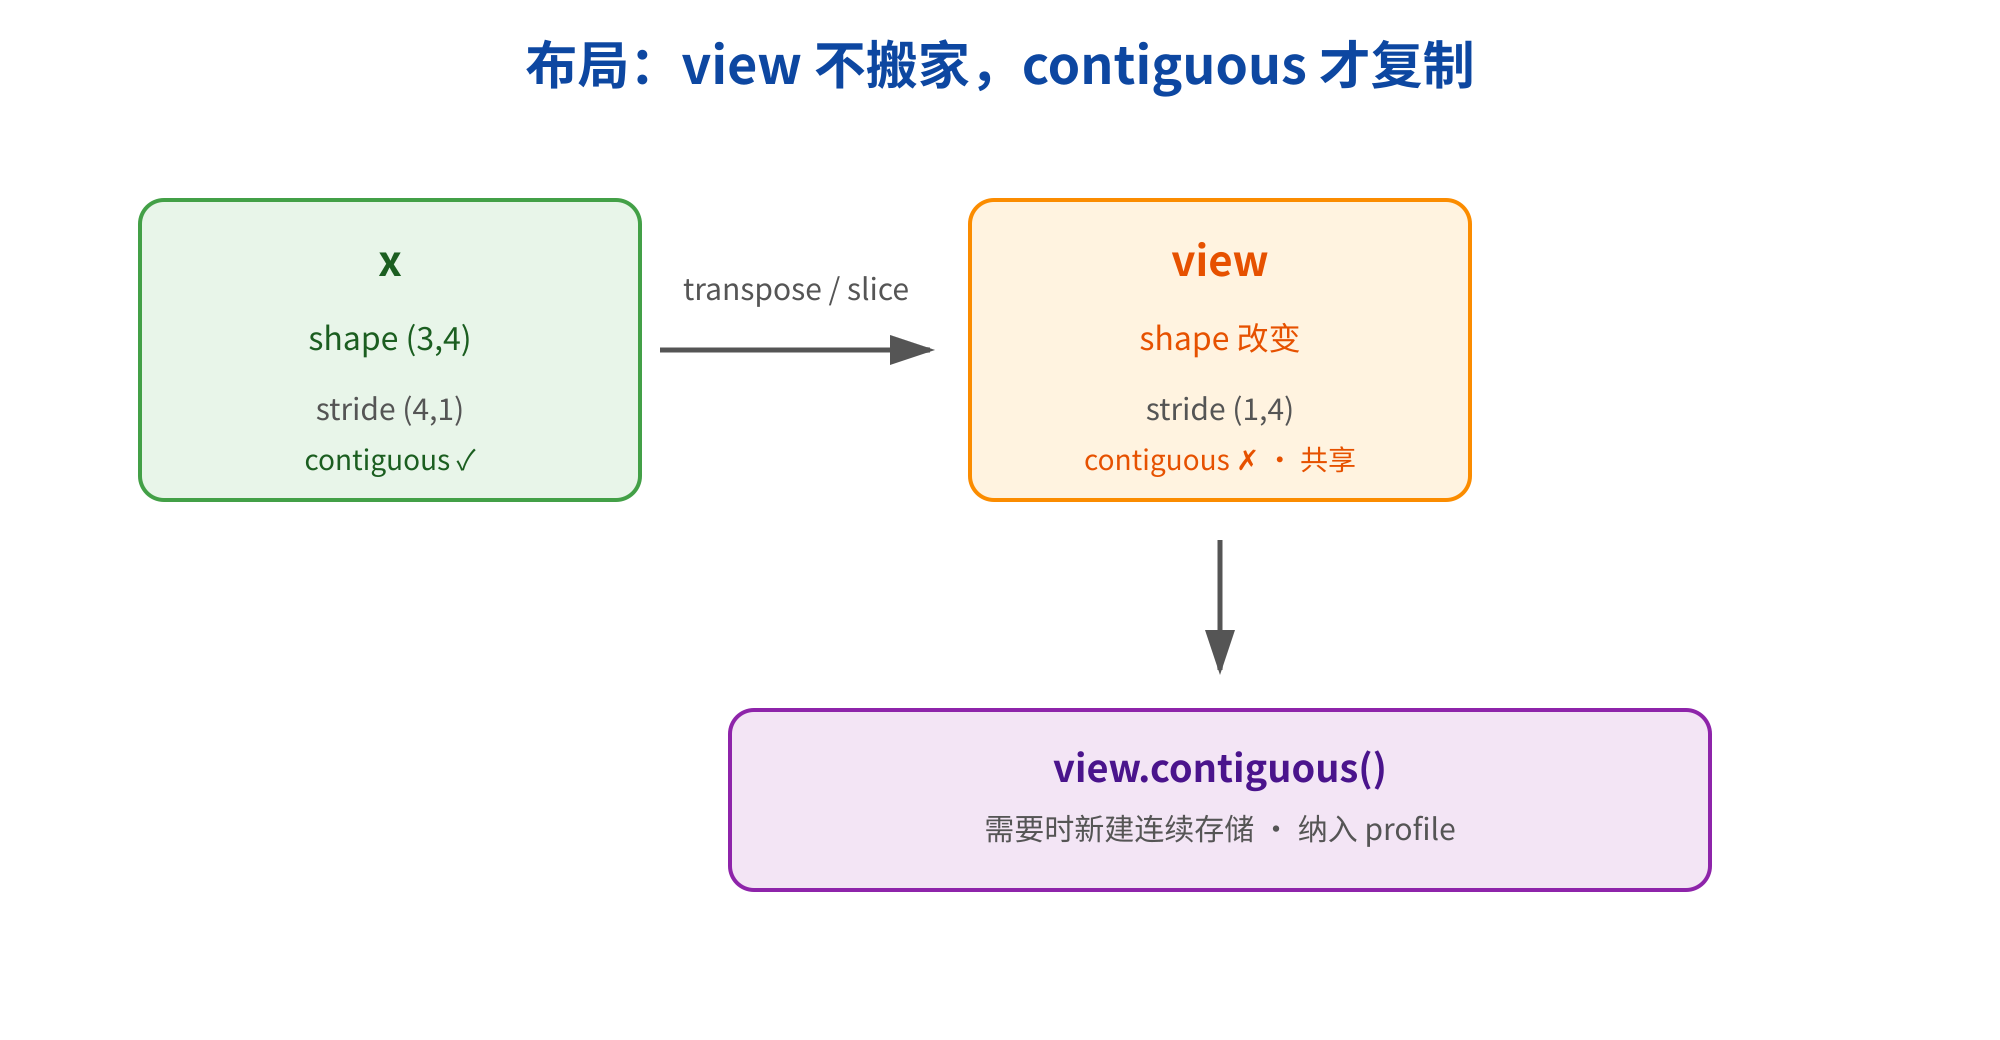
图4 view、非连续布局与 contiguous 的关系
2.3 与第 36 篇 MLP 对齐
我们把 NumPy 版本的三项核心数据换成 Tensor,并保持 (B, D)、(D, H)、(H, O) 的约定:
import torch

B, D, H, O = 3, 2, 4, 1
X = torch.zeros((B, D), dtype=torch.float32)
W1 = torch.zeros((D, H), dtype=torch.float32)
b1 = torch.zeros(H, dtype=torch.float32)
W2 = torch.zeros((H, O), dtype=torch.float32)
b2 = torch.zeros(O, dtype=torch.float32)
Z1 = X @ W1 + b1
A1 = torch.relu(Z1)
Yhat = A1 @ W2 + b2
print(X.shape, Z1.shape, A1.shape, Yhat.shape)
torch.Size([3, 2]) torch.Size([3, 4]) torch.Size([3, 4]) torch.Size([3, 1])
这里 torch.relu 对应 np.maximum,@ 仍然是矩阵乘法,偏置仍然沿 batch 轴广播。改变的是执行系统:Tensor 可以在另一种 device 上运行,操作可以被 autograd 记录,后续还能交给编译器或融合 kernel。迁移的第一原则是先让 shape 与 NumPy 参考实现逐项相同,再谈设备和性能。
三、NumPy 互转:共享内存还是复制
3.1 torch.from_numpy:CPU 上的共享存储
torch.from_numpy(array) 会从 NumPy 数组创建 Tensor。对支持的 CPU dtype,它通常与原数组共享同一块内存:一边修改,另一边可见。这个特性很快,但也把所有权和生命周期责任交给了你。
import numpy as np
import torch

array = np.arange(6, dtype=np.float32).reshape(2, 3)
tensor = torch.from_numpy(array)
array[0, 0] = 99.0
print(tensor)
tensor[1, 2] = -5.0
print(array)
print(np.shares_memory(array, tensor.numpy()))
tensor([[99.,  1.,  2.],
        [ 3.,  4., -5.]])
[[99.  1.  2.]
 [ 3.  4. -5.]]
True
共享内存特别适合把已经在 CPU 内存中的预处理结果交给模型,避免无意义的复制;但它不适合“两个组件互不影响”的场景。
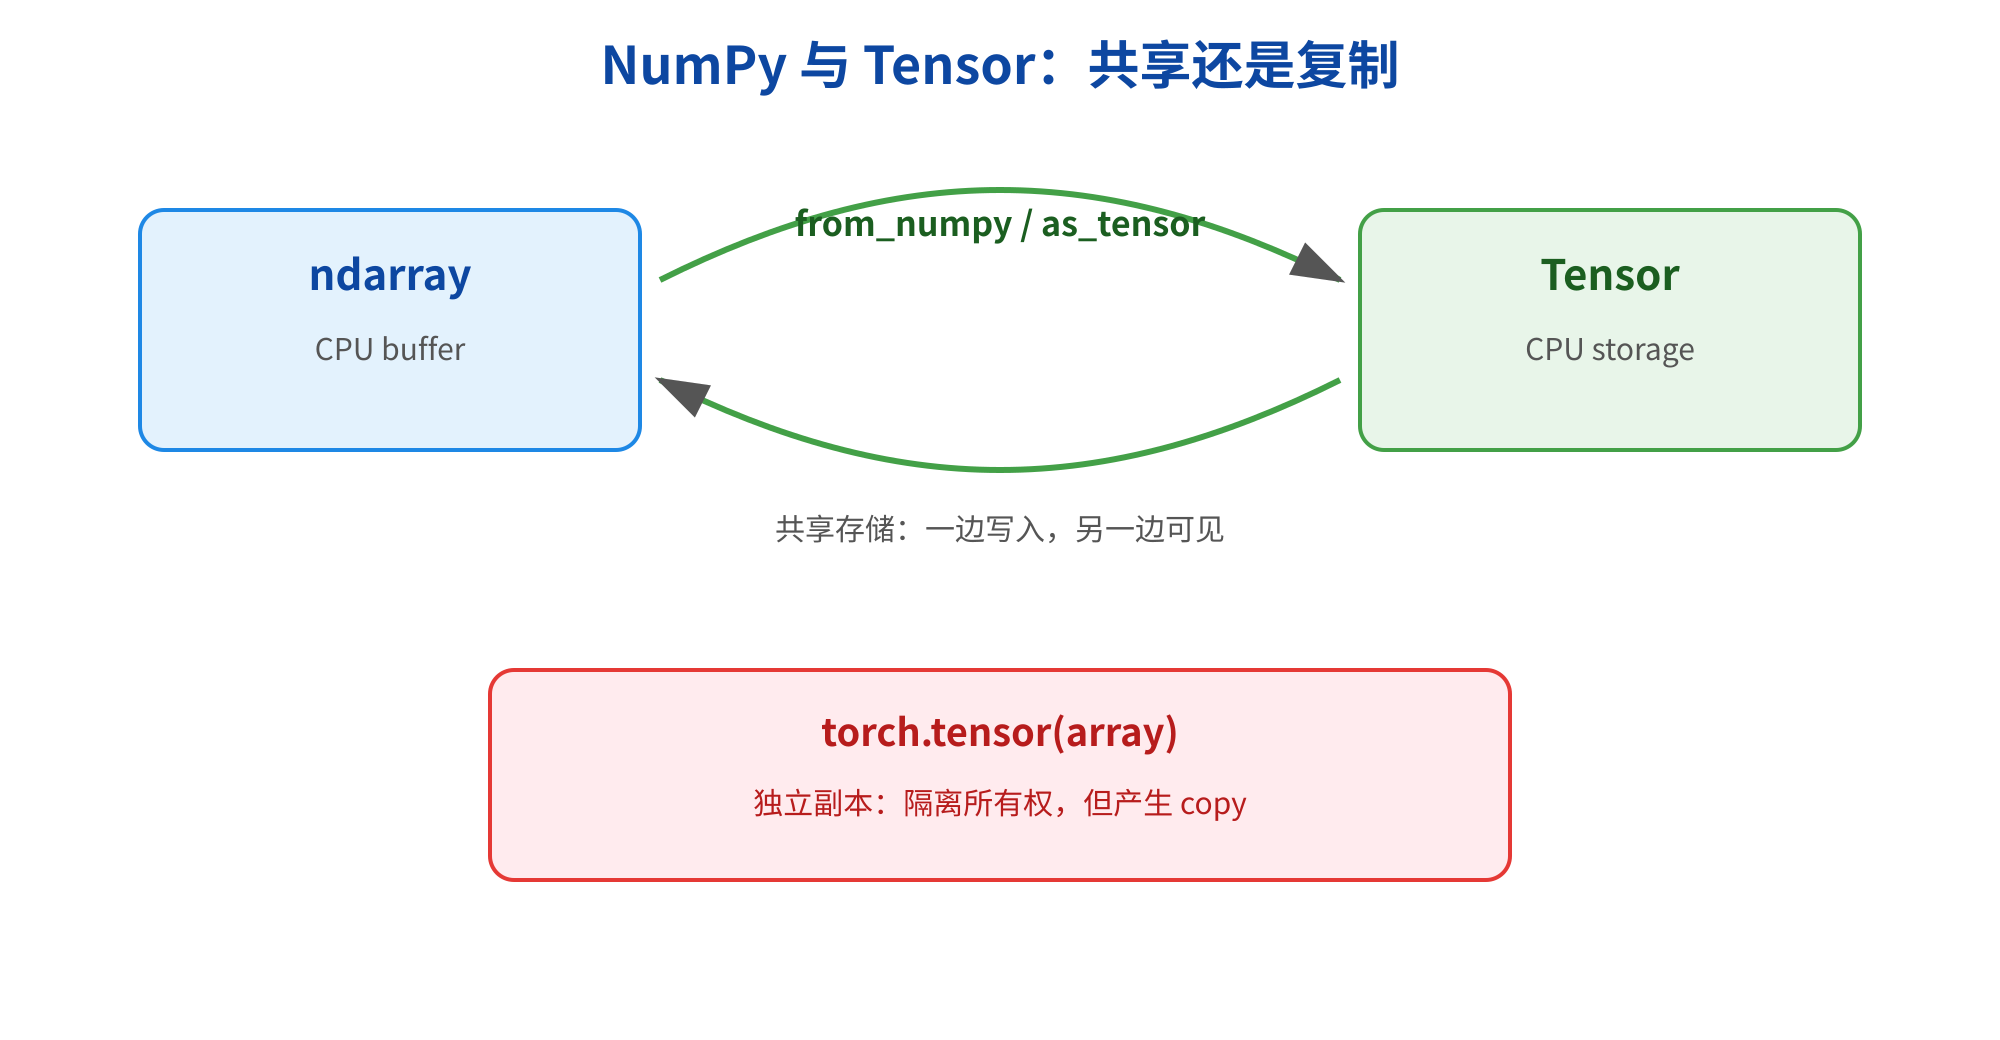
数据集缓存、异步预取或多线程处理时,如果生产者还在修改 NumPy buffer,消费者看到的 Tensor 可能在同一批处理中悄悄变化。跨模块传递前要明确谁拥有可写权限、何时完成写入、何时可以复用 buffer。
3.2 torch.tensor:明确复制,隔离变化
torch.tensor(array) 会根据输入构造一个新的 Tensor,语义上是复制;后续修改通常不会回写原数组。它更安全,但复制也意味着时间和内存成本。对于性能敏感的 pipeline,不能把 tensor() 当成无成本的类型标注。
import numpy as np
import torch

array = np.array([1.0, 2.0, 3.0], dtype=np.float32)
copy_tensor = torch.tensor(array)
copy_tensor[0] = 100.0
print(array)
print(copy_tensor)
[1. 2. 3.]
tensor([100.,   2.,   3.])
3.3 torch.as_tensor:尽量共享,必要时才复制
as_tensor 的目标是避免不必要的复制:输入已经是合适的 Tensor 时,它可能直接返回或复用;输入是兼容的 NumPy 数组时,通常也会共享;dtype、device 或布局不兼容时才可能复制。选择它之前要知道自己想要的是“尽量零拷贝”还是“独立副本”。
可以用下面的决策表记忆:
| API | 常见结果 | 适合的意图 |
|---|---|---|
| torch.from_numpy(a) | 与 CPU NumPy a 共享 | 明确需要 NumPy/Tensor 双向可见 |
| torch.as_tensor(a) | 尽量共享,必要时复制 | 通用适配层,避免无谓复制 |
| torch.tensor(a) | 创建独立副本 | 明确隔离所有权、输入很小或安全优先 |
| a_tensor.numpy() | CPU Tensor 与 NumPy 共享 | 把结果交给 NumPy,先确认不再写入 |
不同 dtype、只读数组、特殊 stride、带负 stride 的数组或不支持的 NumPy 类型可能改变上述结果。不要仅凭 API 名字猜零拷贝;在关键路径用 data_ptr()、np.shares_memory 和实际 profile 验证。
3.4 .numpy() 的边界条件
CPU、未参与梯度记录的 Tensor 通常可以调用 .numpy() 得到共享视图。若 Tensor 需要梯度,直接转换会被拒绝,因为 NumPy 不知道如何追踪后续修改。常见的安全表达式是 x.detach().cpu().numpy():切断梯度关系,把数据放到 CPU,再交给 NumPy。
import torch

x = torch.arange(4, dtype=torch.float32, requires_grad=True)
# x.numpy()  # 会报错:不能直接把 requires_grad Tensor 交给 NumPy
array = x.detach().numpy()
array[0] = 88.0
print(x)
print(array)
tensor([88.,  1.,  2.,  3.], requires_grad=True)
[88.  1.  2.  3.]
这段代码很容易被误读:detach() 切断的是 autograd 记录,不是物理复制;所以 NumPy 修改仍然影响原 CPU Tensor。若需要完全独立的快照,应显式复制,例如 x.detach().cpu().numpy().copy()。反过来,若只想读结果并且确认不会改写,可以保留共享视图,避免额外内存。
AI Infra 视角:零拷贝只回答“是否复制这块内存”,不回答“是否已经在 GPU”。CPU NumPy 与 CPU Tensor 共享,仍然要在进入 CUDA 模型前搬运;GPU Tensor 不能直接成为 NumPy view。第 38 篇会把这条边界放进 device、同步和拷贝时间的完整链路。
3.5 一个可复用的边界函数
边界函数应该把 dtype、device、所有权策略写进名字或参数,而不是让调用者猜。下面的函数把 NumPy 输入转换为 CPU、连续的 float32 Tensor;它优先避免复制,但若输入不合约就进行一次明确转换。
import numpy as np
import torch


def as_model_input(array: np.ndarray) -> torch.Tensor:
    if array.dtype != np.float32:
        array = array.astype(np.float32, copy=False)
    if not array.flags.c_contiguous:
        array = np.ascontiguousarray(array)
    return torch.from_numpy(array)

source = np.arange(12, dtype=np.float64).reshape(3, 4).T
x = as_model_input(source)
print(x.shape, x.dtype, x.device, x.is_contiguous())
torch.Size([4, 3]) torch.float32 cpu True
这个函数的重点不是“永远连续”,而是把边界契约集中起来:输入若已是连续 float32,就不额外复制;否则在 NumPy 侧一次性完成 dtype 和 layout 整理。真实服务还会加上 batch 维、数值范围检查、只读策略和 pinned memory 策略,但这些都应建立在明确的所有权模型上。
四、布局、别名与 copy:用实验而不是猜测
4.1 切片和转置可能仍然共享底层存储
Tensor 的切片、转置、窄化常常只创建一个新的视图对象,并保留对原存储的引用。视图的 shape 变了,数据指针可能不变;这就是别名(aliasing)。别名让操作高效,也让原地写入有更大的影响范围。
import torch

base = torch.arange(12, dtype=torch.float32).reshape(3, 4)
view = base[:, 1:3]
print("same storage:", base.untyped_storage().data_ptr() == view.untyped_storage().data_ptr())
view[0, 0] = -1
print(base)

copy = view.clone()
copy[0, 0] = 999
print("base after clone change:", base[0])
same storage: True
tensor([[ 0., -1.,  2.,  3.],
        [ 4.,  5.,  6.,  7.],
        [ 8.,  9., 10., 11.]])
base after clone change: tensor([ 0., -1.,  2.,  3.])
clone() 是显式复制,detach() 是切断梯度记录;二者解决的问题不同。需要独立数值和独立梯度语义时,通常写 x.detach().clone(),但要意识到这会分配内存。不要用 detach() 代替 clone(),也不要为了避免一个原地操作而到处复制。
4.2 contiguous() 的正确位置
转置后的 Tensor 往往是非连续的。某些 PyTorch 算子可以直接处理它,某些低层扩展要求连续,某些算子内部会悄悄复制。最稳妥的做法不是在每一行后面都加 .contiguous(),而是在外部接口或已测量的热点处处理。
import torch

x = torch.arange(24).reshape(4, 6)
t = x.transpose(0, 1)
print(t.shape, t.stride(), t.is_contiguous())
try:
    bad = t.view(-1)
except RuntimeError as exc:
    print(type(exc).__name__)
flat = t.contiguous().view(-1)
print(flat.shape, flat.is_contiguous())
torch.Size([6, 4]) (1, 6) False
RuntimeError
torch.Size([24]) True
reshape(-1) 在这个场景可能自动完成连续化,因此“代码能跑”不代表没有 copy。性能诊断时要把算子前后的内存分配、峰值和时间一起观察。对大 batch,额外 copy 可能比一次简单算术更贵;对小张量,清晰和正确通常更重要。
4.3 原地操作的三重风险
带下划线的 API 或 +=、*= 往往是原地操作。它可能影响共享 view,可能覆盖 autograd 之后仍需要的旧值,也可能破坏只读输入的约定。第 36 篇中我们在完成整个 backward 后才更新参数;Tensor 版本也要保留这个纪律。
import torch

x = torch.ones(3)
y = x[:]
y.add_(2)
print(x)  # y 和 x 共享存储

z = torch.ones(3, requires_grad=True)
q = z * z
# z.add_(1)  # 对需要梯度的叶子 Tensor 原地改写通常会报错
print(q)
原地并非绝对禁止:在确认没有别名、没有梯度依赖、并且 profile 证明它有收益时,可以局部使用。默认优先写出非原地版本,让数据流和所有权更容易审查。对于模型参数,使用优化器管理更新;不要在训练图中随意修改叶子 Tensor。
五、把 Tensor 接到 AI Infra:边界契约先于优化
5.1 NumPy 原型与 Tensor 执行层的分工
第 36 篇的 NumPy MLP 是很好的黄金参考(golden reference):它直观、易调试,适合先验证公式和 shape。Tensor 版本把同一公式交给 PyTorch 的算子系统,可以进一步获得自动求导、GPU kernel、混合精度和编译优化。两者不是互相替代,而是常常在一条工程链路中共存。
典型的数据流是:数据读取为 NumPy 或其他 CPU buffer;预处理整理为规定 dtype 和 layout;边界层转成 Tensor;批处理后搬到目标 device;模型执行;评估或可视化阶段再把结果转回 CPU NumPy。每个箭头都可能产生 copy、同步或格式转换。把转换集中在边界,通常比在模型内部到处隐式转换更容易测量。
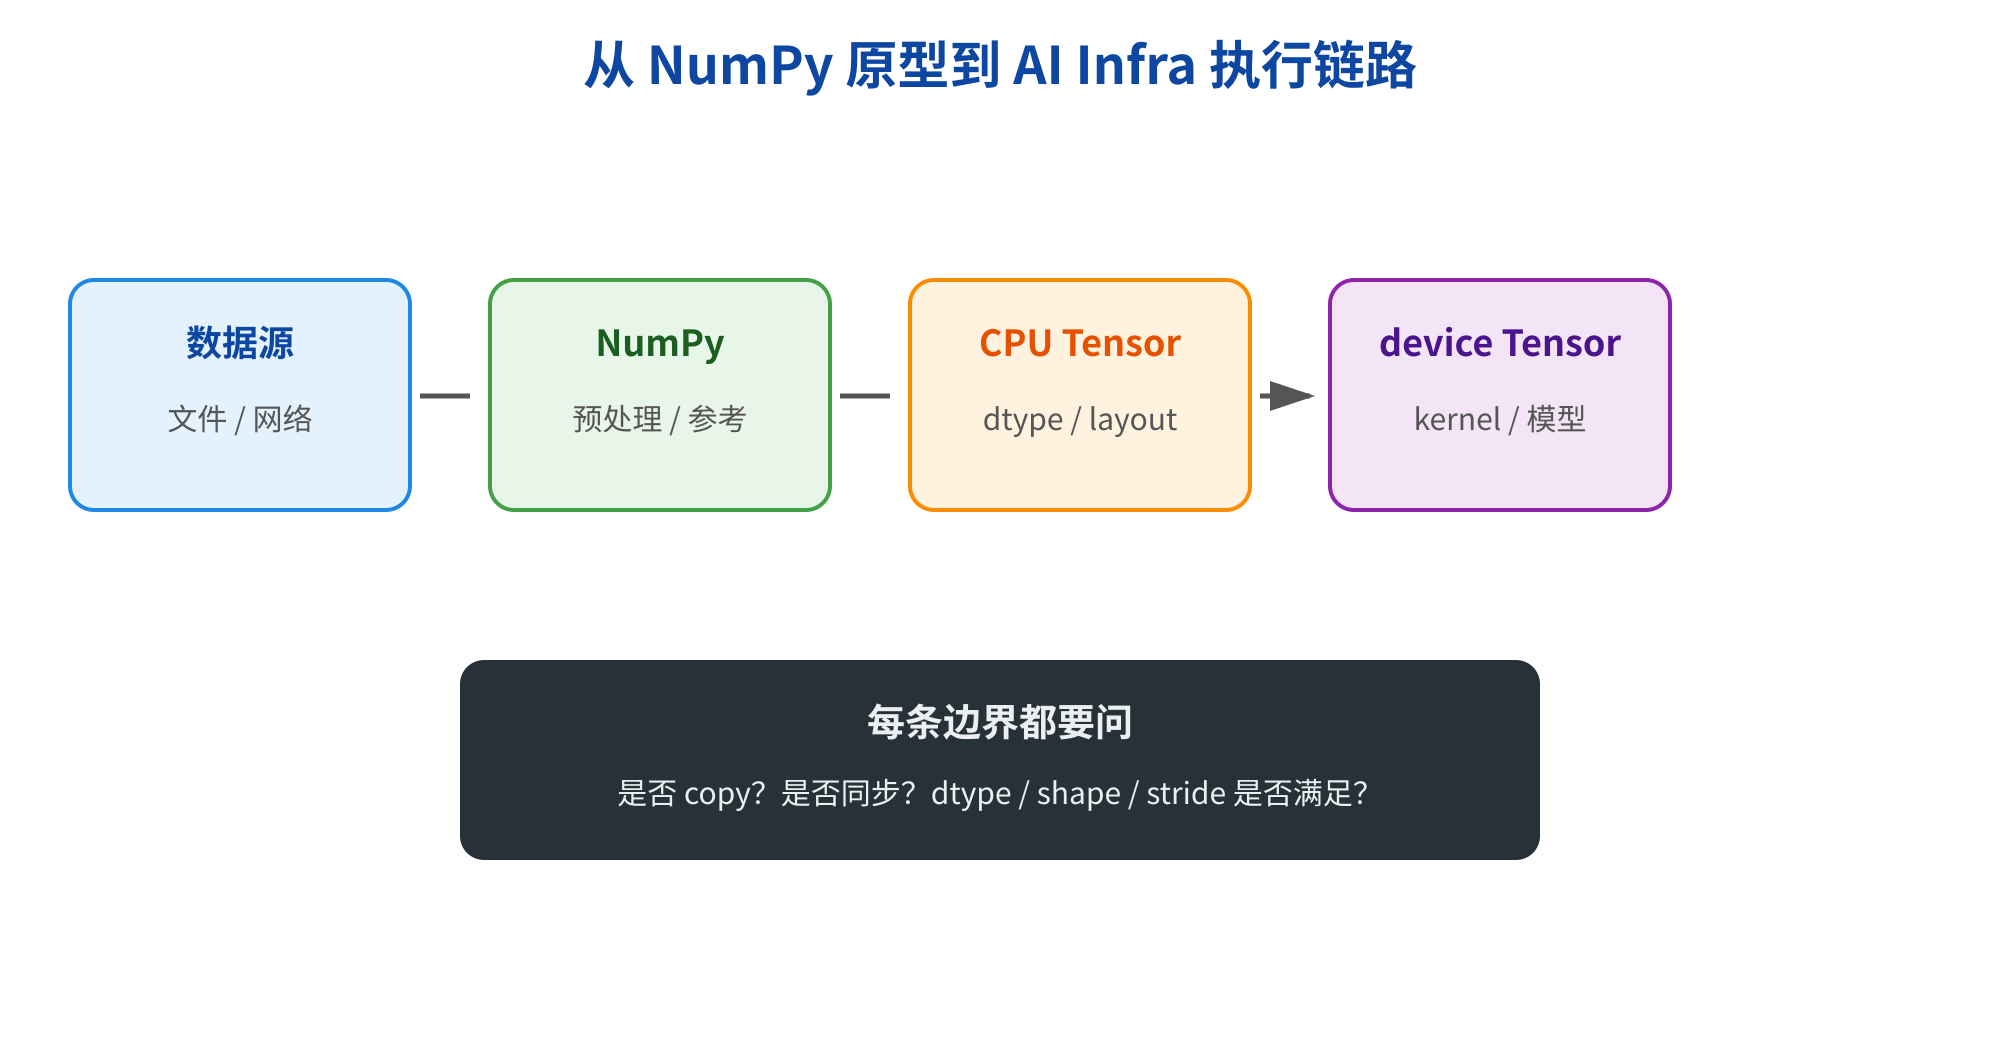
图5 从 NumPy 原型到 device Tensor 的 AI Infra 数据链路
文件/网络 -> NumPy 预处理 -> CPU Tensor -> device Tensor -> 模型算子
                                      |                         |
                                      +---- 评估 .detach().cpu().numpy() <---+
5.2 一个“合约优先”的 MLP 前向
即使现在不使用 GPU,也可以把模型输入契约写清楚。下面的函数只接受二维 float32 CPU Tensor,并在入口进行断言;后续第 38 篇会把 CPU 限制替换为显式 device 处理。
import torch


def mlp_forward(X, W1, b1, W2, b2):
    assert X.ndim == 2 and X.dtype == torch.float32
    assert X.device.type == "cpu"
    assert X.shape[1] == W1.shape[0]
    assert W1.shape[1] == b1.shape[0] == W2.shape[0]
    assert W2.shape[1] == b2.shape[0]
    Z1 = X @ W1 + b1
    A1 = torch.relu(Z1)
    return A1 @ W2 + b2

X = torch.randn(3, 2, dtype=torch.float32)
W1 = torch.randn(2, 4, dtype=torch.float32)
b1 = torch.zeros(4, dtype=torch.float32)
W2 = torch.randn(4, 1, dtype=torch.float32)
b2 = torch.zeros(1, dtype=torch.float32)
print(mlp_forward(X, W1, b1, W2, b2).shape)
torch.Size([3, 1])
这段代码没有注册参数,也没有训练;它只证明 Tensor 版的 shape 契约与 NumPy 版一致。下一步可以把 W1 等替换为 requires_grad=True 的参数,再由 autograd 生成梯度。先固定 CPU 结果,再迁移 device,是定位差异最便宜的顺序。
5.3 零拷贝不是性能结论
共享内存可以减少一次分配和复制,但它可能带来写竞争、缓存复用冲突、生命周期延长和同步约束。复制也不一定是坏事:如果复制把非连续、错误 dtype 的数据整理成一次连续 float32,后续 GEMM 也许反而更快。AI Infra 优化要比较端到端成本:预处理、转换、等待、计算、结果回收,而不是只盯住某个 API 是否“零拷贝”。
建议给数据边界记录三件事:输入和输出的 dtype、shape、layout;是否共享存储;转换耗时和分配字节数。等第 38 篇加入 GPU 后,再加上 device、H2D/D2H 方向和同步点。这样看到吞吐下降时,可以判断是 CPU 预处理、host-to-device copy、kernel 计算,还是结果转换在拖慢请求。
还可以把“边界”理解成一个小型协议,而不是一行转换代码。协议至少要写明输入是否允许被修改、结果是否允许被调用方持有、异常时谁负责释放或重试,以及批次是否会在后台线程继续使用。对于离线评估,复制一份数据换取隔离通常值得;对于高并发推理,复用 buffer 可能更重要,但必须配合队列、引用生命周期和完成事件。没有所有权说明的零拷贝,往往只是把一次显式成本变成难以定位的竞态。
在数值验证层,可以用 NumPy 版本作为参考,但不要比较未经处理的浮点字符串。先统一 dtype,再使用 torch.testing.assert_close 或 NumPy 的容差比较;同时确认两边的归约轴、keepdim 和广播规则一致。若结果不同,按照 shape、dtype、stride、共享存储、requires_grad 的顺序排查,通常比直接怀疑 PyTorch 算子更有效。等模型扩大后,再用 profiler 确认这些检查不会进入正式热路径。这套顺序也适用于数据集、缓存和服务接口:先定义契约,再测量复制,最后才选择优化和回归测试。
六、一个小实验:确认转换和布局
把下面脚本保存为 check_tensor_boundary.py,在安装了 torch 和 numpy 的环境运行。它同时检查共享、复制和连续化;不依赖 CUDA。
import numpy as np
import torch


def report(name, x):
    print(name, "shape=", tuple(x.shape), "dtype=", x.dtype,
          "stride=", x.stride(), "contiguous=", x.is_contiguous())

source = np.arange(12, dtype=np.float32).reshape(3, 4)
shared = torch.from_numpy(source)
owned = torch.tensor(source)
report("shared", shared)
report("owned", owned)

source[0, 0] = 42
assert shared[0, 0].item() == 42
assert owned[0, 0].item() != 42

transposed = shared.T
continuous = transposed.contiguous()
report("transposed", transposed)
report("continuous", continuous)
assert not transposed.is_contiguous()
assert continuous.is_contiguous()
print("boundary checks: OK")
shared shape= (3, 4) dtype= torch.float32 stride= (4, 1) contiguous= True
owned shape= (3, 4) dtype= torch.float32 stride= (4, 1) contiguous= True
transposed shape= (4, 3) dtype= torch.float32 stride= (1, 4) contiguous= False
continuous shape= (4, 3) dtype= torch.float32 stride= (3, 1) contiguous= True
boundary checks: OK
如果你的机器没有安装 torch,会在导入阶段得到 ModuleNotFoundError,这是环境缺依赖而不是代码逻辑失败。可以用 Python 3.12 的虚拟环境安装与项目锁定版本匹配的 PyTorch,再运行脚本;CPU wheel 足以完成本篇实验。第 38 篇涉及 CUDA 时,安装包和驱动必须再按服务器平台核对,不能把 CPU 环境的成功直接推断为 GPU 可用。
七、踩坑大全
通用
- 坑 1:把
torch.tensor当成零拷贝。 现象是转换处出现额外耗时和内存。原因是它通常创建独立副本;需要共享时考虑from_numpy或as_tensor,并实际验证。 - 坑 2:只用
detach()解决别名。 现象是 NumPy 修改仍改变原 Tensor。原因是detach只切断 autograd,不复制存储;需要独立快照时使用detach().clone()或 NumPy.copy()。 - 坑 3:直接对
requires_grad=True的 Tensor 调.numpy()。 现象是运行时报错。原因是 NumPy 不参与 PyTorch 的梯度图;先detach(),GPU Tensor 还要先.cpu()。 - 坑 4:把
dtype当成显示格式。 现象是矩阵乘法报类型错误,或内存与吞吐异常。原因是整型、float64、float32的算子和带宽契约不同;入口显式转换并统一记录。 - 坑 5:看到非连续就无条件
.contiguous()。 现象是内存峰值上升。原因是连续化可能分配副本;先确认下游要求,再用 profile 决定边界。 - 坑 6:对 view 做原地写入。 现象是原数组、另一批数据或缓存被悄悄修改。原因是切片和转置可能共享存储;需要隔离时
clone(),默认避免原地操作。
Linux / GPU 服务器与 AI Infra
- 坑 7:把 CPU Tensor 的
.numpy()经验搬到 GPU。 现象是无法转换或发生意外同步。原因是 NumPy 只能读取主机内存;GPU 结果需要显式回 CPU,且同步成本要计时。 - 坑 8:只 benchmark 模型算子,不算数据转换。 现象是单算子很快,端到端服务却变慢。原因是 dtype/layout 整理、H2D/D2H 和同步都在算子之外;基准范围要覆盖真实请求链路。
- 坑 9:用
empty后只写一部分元素。 现象是结果出现随机大数或 NaN。原因是empty不初始化;若不能保证完整覆盖,使用zeros等明确初始化 API。 - 坑 10:用 shape 相同证明两端相同。 现象是数值、精度或梯度不一致。原因是还可能有 dtype、device、stride、所有权和
requires_grad差异;迁移测试至少逐项比较这些属性。
八、小结
Tensor与ndarray共享数组计算的外形,但 Tensor 还携带 device、梯度和执行布局语义。- 调试 Tensor 至少检查
shape、dtype、device、stride与is_contiguous();训练再检查requires_grad。 zeros、*_like、arange等创建 API 要显式控制 dtype;empty不会初始化数据。from_numpy与兼容的 CPU NumPy 数组共享存储,tensor通常复制,as_tensor尽量避免不必要复制。.detach()切断梯度但不等于复制;需要独立存储时用clone(),GPU 结果转 NumPy 还需要.cpu()。- view、transpose 和 slice 可能非连续且共享别名;
contiguous()应放在明确的接口或经过测量的热点。 - NumPy 原型是逻辑和数值的参考,Tensor 是接入 autograd、device、kernel 与编译优化的执行层。
九、课后练习
- (基础) 用
torch.zeros、torch.arange和torch.randn创建第 36 篇 MLP 的X/W1/b1/W2/b2,打印每个对象的 shape、dtype 和 stride。 - (基础) 分别用
from_numpy、as_tensor、tensor转换一个float32数组,修改数组和 Tensor,记录哪些修改会互相可见。 - (理解) 对一个
(3, 4)Tensor 做转置和步长切片,比较 stride、连续性和data_ptr();解释为什么逻辑 shape 改变不代表发生复制。 - (理解) 比较
reshape(-1)、view(-1)和contiguous().view(-1)在非连续 Tensor 上的行为,写下每一步是否可能分配新存储。 - (进阶) 用 Tensor 重写第 36 篇的 NumPy MLP 前向,逐层比较 NumPy 与 Tensor 的数值,检查误差是否在浮点容差内。
- (进阶) 构造
requires_grad=True的输入,观察.detach()、.clone()、.detach().clone()对requires_grad和共享存储的影响。 - (AI Infra) 写一个输入边界函数,统一
float32、二维 batch 和连续布局;分别测量“已满足契约”和“需要 dtype/layout 转换”的耗时。 - (AI Infra) 在安装了 CUDA 的机器上把 CPU Tensor 与 GPU Tensor 的转换链路完整计时,为第 38 篇预先记录 device、同步和 H2D/D2H 事件。
下一篇预告
下一篇是 第38篇|GPU、device 与 CUDA 基础。我们会把本篇的 device 从一个打印出来的属性,变成一条可测量的执行链路:CPU 内存与 GPU 显存如何区分,.to(device) 何时复制,为什么 GPU 操作可能异步,以及 CUDA stream、同步和 pinned memory 为什么会影响端到端吞吐。
路线仍然从第 36 篇的 NumPy MLP 出发:本篇先完成 ndarray 到 Tensor 的对象与内存模型迁移;第 38 篇把同一个 MLP 放到 CPU/GPU 两端;第 39 篇再让 autograd 接管第 36 篇手写的 cache 与反向公式。之后才进入 nn.Module、DataLoader、优化器、Attention 和 mini-GPT。先把数据在哪、以什么 dtype 和 layout 存在说清楚,后面的训练与推理优化才不会沦为“换一行代码试试看”。