
第41篇|Dataset、DataLoader 与训练循环
本篇定位:专栏四「PyTorch 与 AI Infra 入门」的第五篇。承接第 40 篇
nn.Module与参数管理,把模型接上可索引的数据,并把一批样本送进完整训练循环。读完你将能够:实现 map-style
Dataset的getitem与len;理解DataLoader的 batch、shuffle、num_workers、collate_fn;写出包含Module、autograd、梯度清零和参数更新的最小训练程序;从 AI Infra 角度判断吞吐瓶颈、配置 worker 与pin_memory。预计用时:阅读 50~70 分钟,动手 60~90 分钟。
第 40 篇解决了“模型是什么、参数在哪里、状态怎样保存”。但模型不会凭空产生输入:真实训练要从磁盘、对象存储、数据库或流式队列取出样本,把不同长度或不同字段的样本整理成 batch,再稳定地交给 forward。如果数据供给慢,GPU 会等 CPU;如果 batch 形状错,计算图还没有建立,程序就已经失败。
本篇用一个小型回归任务贯穿始终:给定一个数值 x,学习 y = 3x + 2。数据很简单,目的是把“样本索引 → 组 batch → 搬到 device → 前向 → 反向 → 更新”的边界看清楚。这里的训练循环只使用基础组件,不提前依赖第 42 篇的优化器和损失函数细节;我们会先手写梯度下降,下一篇再系统比较优化器、损失函数和学习率调度。先记住一条流水线:Dataset 管样本,DataLoader 管供给,Module 管计算,autograd 管梯度,训练循环管时序。
一、先建立数据流水线的心智模型
1.1 样本、batch 与 step
一个样本是模型一次消费的最小语义单位。回归样本可以是 (x, y),分类样本可以是 (input_ids, label),多模态样本还可能带图像、文本和 metadata。Dataset 暴露的是“第几个样本是什么”,而不是“如何训练”。
batch_size=4 时,四个样本会被整理成一个 batch。一次 forward 处理一个 batch,称为一个 step 或 iteration;遍历一遍训练集称为一个 epoch。若数据集有 100 个样本、batch size 为 4,drop_last=False 时有 25 个 batch;若有 101 个样本,则最后一个 batch 只有 1 个样本,除非设置 drop_last=True。
from torch.utils.data import DataLoader, TensorDataset
import torch

x = torch.arange(10, dtype=torch.float32).reshape(-1, 1)
y = 3 * x + 2
dataset = TensorDataset(x, y)
loader = DataLoader(dataset, batch_size=4, shuffle=False)

print(len(dataset), len(loader))
for batch_x, batch_y in loader:
    print(tuple(batch_x.shape), batch_x[:, 0].tolist())
10 3
(torch.Size([4, 1]), [0.0, 1.0, 2.0, 3.0])
(torch.Size([4, 1]), [4.0, 5.0, 6.0, 7.0])
(torch.Size([2, 1]), [8.0, 9.0])
注意 len(loader) 不是样本数,而是 batch 数。训练日志按 step 统计吞吐、学习率和耗时,按 epoch 统计完整遍历;混淆这两个单位,会让进度条、学习率 warmup 或 checkpoint step 都产生偏差。
1.2 谁负责什么
可以把职责拆成四层:
Dataset:定义索引语义,知道如何取得第i个样本。DataLoader:决定按什么顺序取索引、同时取多少个、由多少 worker 预取,并调用组 batch 的函数。- 训练循环:把 batch 移到目标设备,调用模型和反向传播,决定何时更新与记录。
Module:只关心给定形状的输入怎样计算输出,不应该在forward里打开文件或随机读取网络。
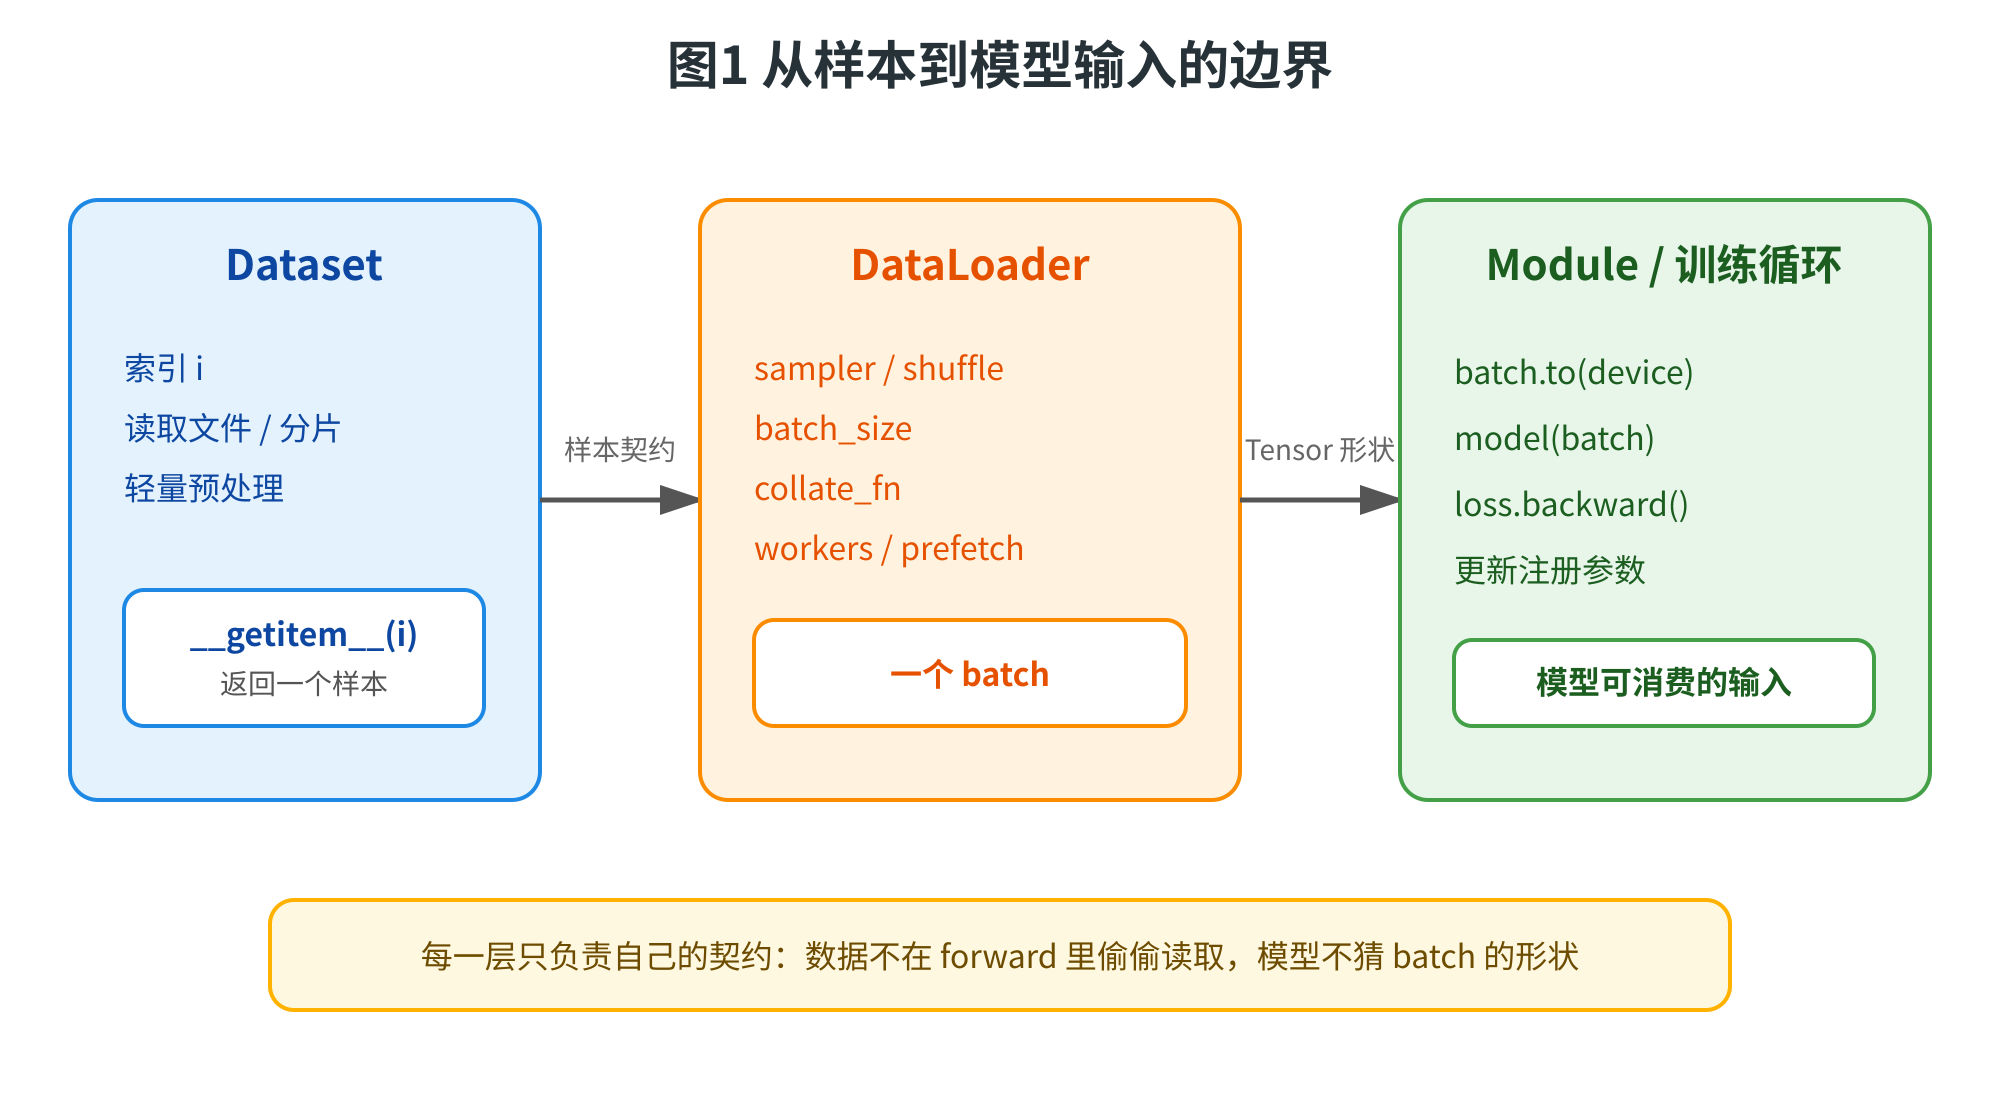
图1 从样本到模型输入的边界
这种分层让同一个模型可以替换数据来源:本地小数据集、WebDataset 分片、数据库游标或分布式 sampler 都能提供相似的 batch 接口。反过来,如果把读取、增强、搬 GPU 和反向传播全部塞进一个函数,任何一步变慢都很难定位。
AI Infra 视角:训练集不是“一个文件”,而是一条数据服务。样本读取、解码、tokenize、padding 和 host-to-device copy 都会消耗 CPU、内存、PCIe/NVLink 带宽。指标不仅要看 loss,也要看 data wait、step time、samples/s 和 GPU utilization。
二、实现 Dataset:把样本契约写清楚
2.1 len 和 getitem
最常用的是 map-style dataset(可映射数据集):继承 torch.utils.data.Dataset,实现两个方法。len 返回样本总数;getitem(index) 返回一个样本。索引通常是整数,但不应该假设调用顺序永远是 0, 1, 2...,因为 shuffle、sampler 和多 worker 都可能改变顺序。
from torch.utils.data import Dataset
import torch

class LineDataset(Dataset):
    def __init__(self, count: int = 12):
        self.x = torch.arange(count, dtype=torch.float32).reshape(-1, 1)
        self.y = 3 * self.x + 2

    def __len__(self) -> int:
        return self.x.shape[0]

    def __getitem__(self, index: int) -> tuple[torch.Tensor, torch.Tensor]:
        return self.x[index], self.y[index]

dataset = LineDataset(5)
print(len(dataset))
print(dataset[2])
5
(tensor([2.]), tensor([8.]))
这里把全部张量预先放在内存里,适合演示和小数据。大数据集通常只保存路径、偏移量、索引表或轻量 metadata,在 getitem 中按需打开或读取。这样可以把启动内存降下来,但要留意随机磁盘访问、文件句柄和解码成本。
2.2 Dataset 的返回值是公开协议
getitem 可以返回 Tensor、数字、字符串、字典、元组或嵌套结构,但要考虑一个 batch 能否把它们合理堆叠。下面的样本返回字典,默认 collate 会按键递归组织:
class DictDataset(Dataset):
    def __init__(self):
        self.values = torch.arange(6, dtype=torch.float32).reshape(-1, 1)

    def __len__(self):
        return len(self.values)

    def __getitem__(self, index):
        value = self.values[index]
        return {"feature": value, "label": value + 1, "id": index}

loader = DataLoader(DictDataset(), batch_size=2, shuffle=False)
batch = next(iter(loader))
print(batch["feature"].shape)
print(batch["label"].flatten().tolist())
print(batch["id"].tolist())
torch.Size([2, 1])
[1.0, 2.0]
[0, 1]
默认行为对定长 Tensor 很方便;但“能返回”不等于“适合训练”。如果一条文本被 tokenize 成长度 7,另一条长度 12,默认 stack 无法把它们直接堆成规则矩阵。此时需要在 collate_fn 中 padding、截断或返回 packed representation。把 padding 放在 batch 级别,往往比每条样本都 padding 到全局最大长度更节省算力。
2.3 计算和 I/O 的边界
尽量让 Dataset 的职责是读取与轻量预处理,把模型相关的计算留给 Module。例如随机裁剪、文本分词、图像解码可以在数据侧完成;依赖参数的归一化、神经网络增强和需要 GPU 的操作应谨慎放置。数据增强的随机数还要配合 worker seed,否则多个 worker 可能产生相同随机序列。
对于大规模数据,可以实现 IterableDataset,让 iter 从日志、消息队列或分片流中连续产生样本。它没有可靠的随机索引,len 也可能未知;在多 worker 场景必须为每个 worker 切分数据,否则每个进程会重复消费同一流。初学阶段先掌握 map-style dataset,因为 sampler、shuffle 和 epoch 长度更容易推理。
三、DataLoader:从索引到 batch
3.1 batching、shuffle 和 sampler
最小配置只需要 DataLoader(dataset, batch_size=..., shuffle=...)。shuffle=True 通常在每个 epoch 开始时产生新的随机顺序,避免模型按照数据原始排列学习到不应有的模式;验证集一般使用 shuffle=False,方便复现和对齐样本。
import torch
from torch.utils.data import DataLoader

torch.manual_seed(7)
loader = DataLoader(LineDataset(8), batch_size=3, shuffle=True)
for x_batch, _ in loader:
    print(x_batch[:, 0].to(torch.int64).tolist())
[7, 0, 3]
[4, 1, 5]
[2, 6]
需要更精确的采样策略时使用 sampler,例如类别不均衡的加权采样或分布式训练的 DistributedSampler。通常 shuffle 与显式 sampler 不能同时指定,因为两者都在决定索引顺序。分布式训练每个 epoch 还要调用 sampler.set_epoch(epoch),让不同 epoch 的 shuffle 真正变化。
3.2 collate_fn:把一组样本变成 batch
DataLoader 先取得一个样本列表,再调用 collate_fn。默认函数 default_collate 会把同类 Tensor 沿新维度堆叠,把字典按键递归处理。自定义 collate 的核心问题是:输入是一组样本,输出应该是模型一次能消费的对象。
下面模拟长度不同的 token id,并在 batch 内 padding:
from torch.nn.utils.rnn import pad_sequence

samples = [
    {"ids": torch.tensor([4, 8, 2]), "label": 0},
    {"ids": torch.tensor([9, 1]), "label": 1},
]

def pad_collate(items):
    ids = pad_sequence([item["ids"] for item in items],
                       batch_first=True, padding_value=0)
    labels = torch.tensor([item["label"] for item in items])
    mask = ids.ne(0)
    return {"input_ids": ids, "attention_mask": mask, "labels": labels}

batch = pad_collate(samples)
print(batch["input_ids"].tolist())
print(batch["attention_mask"].tolist())
[[4, 8, 2], [9, 1, 0]]
[[True, True, True], [True, True, False]]
padding_value、mask 和 dtype 都是协议的一部分。token id 通常是整数,不能为了方便把它们变成浮点;label 的 dtype 则取决于损失函数。collate_fn 出错时,优先打印一个 batch 的键、shape、dtype、device 和最小最大值,而不是直接启动长训练。
3.3 最后一个 batch 与稳定形状
默认 drop_last=False,最后一个 batch 可以更小。大部分模型能处理动态 batch 维度,但某些依赖固定形状的编译、批归一化统计或硬件优化,可能更喜欢 drop_last=True。这不是“越稳定越好”:丢弃样本会改变每个 epoch 的有效数据量,分布式训练还需要确保各 rank 的 batch 数一致。
batch_size 也不是越大越好。它受显存、单步延迟、梯度噪声和数据读取吞吐共同约束。扩大 batch 可能提升矩阵乘法效率,却让一次更新等待更久;如果要保持相近的有效 batch,可以在后续学习梯度累积。第 42 篇会把 batch、学习率和优化器放到一起讨论。
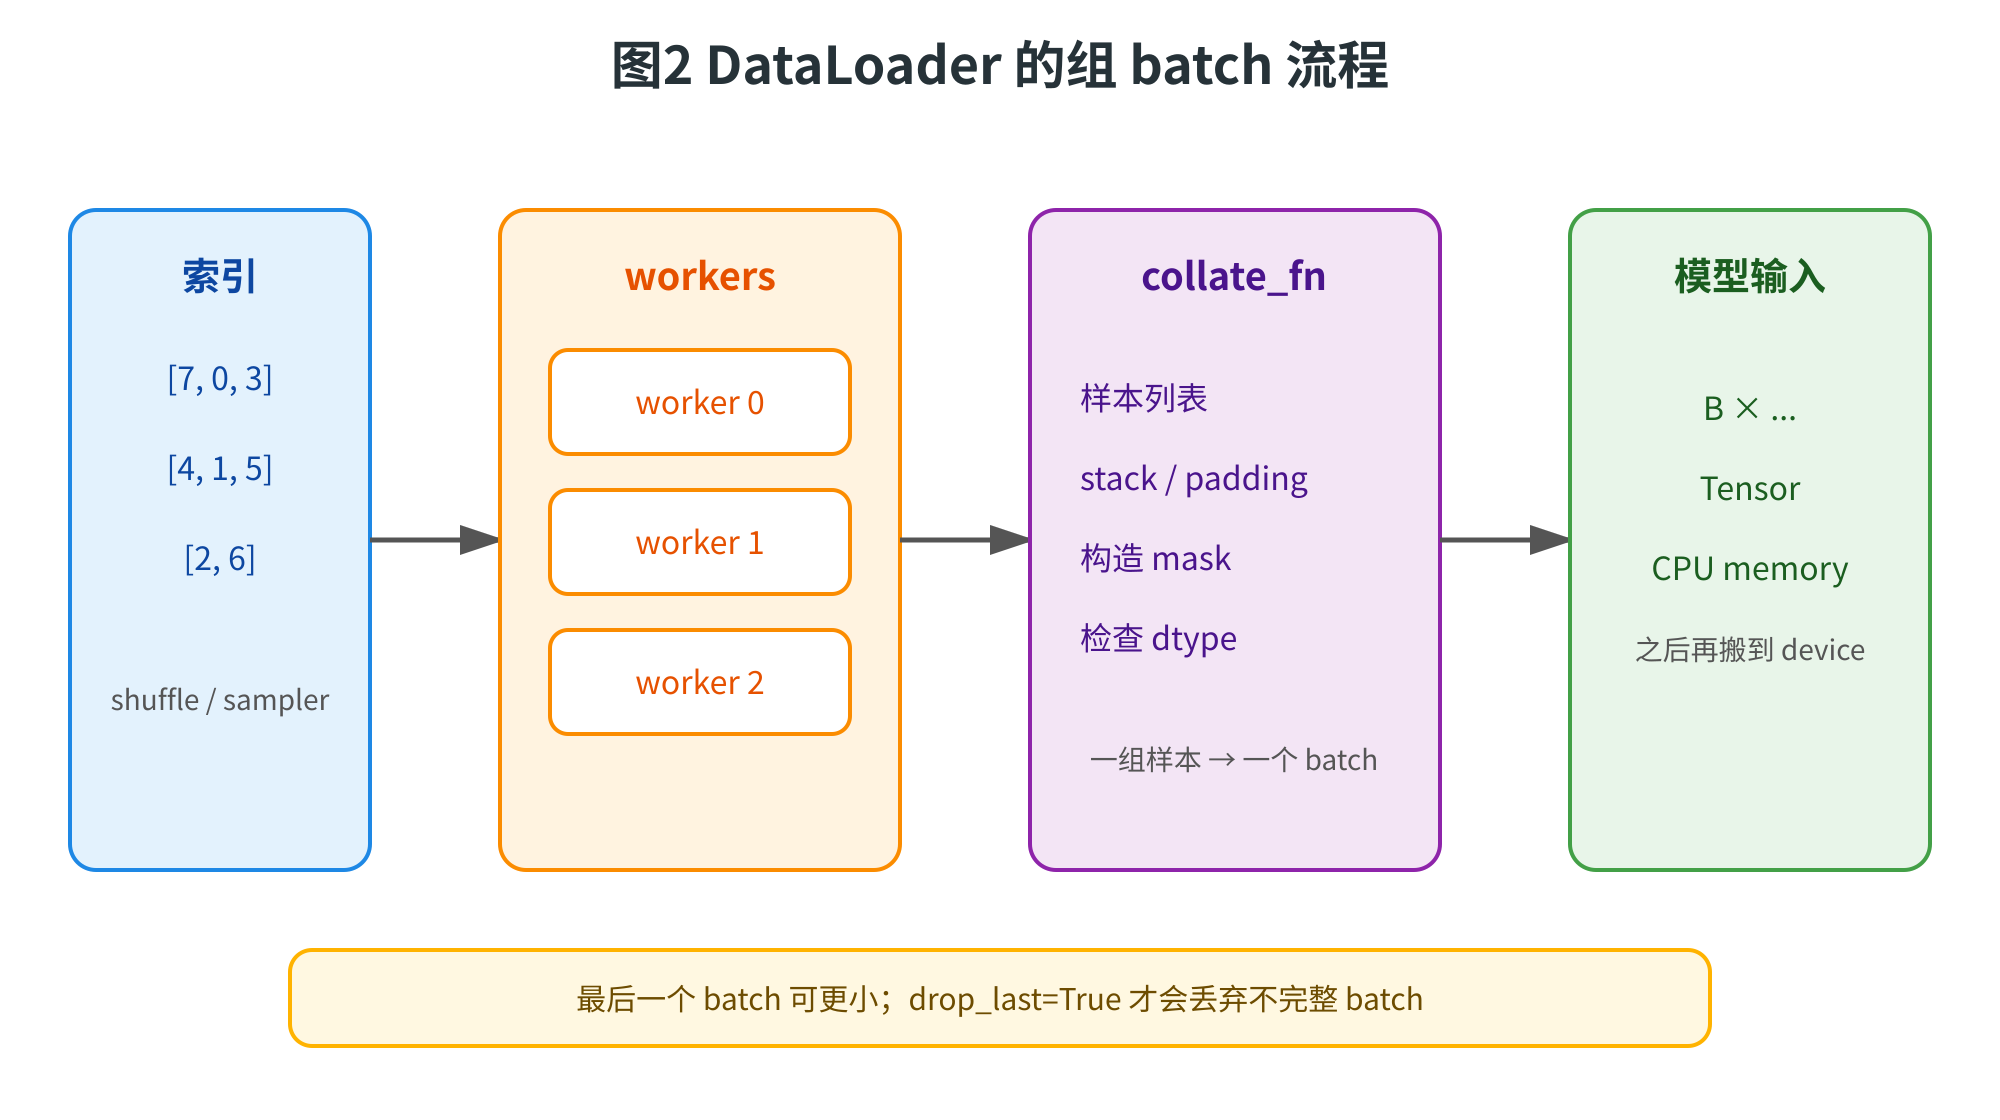
图2 DataLoader 的组 batch 流程
四、把 Module、autograd 和更新串成循环
4.1 一个可运行的最小模型
第 40 篇已经知道 nn.Module 会注册参数。下面使用一个线性层,故意不调用现成优化器和损失函数,让每一步都可见。目标是让 weight 接近 3、bias 接近 2。
import torch
from torch import nn
from torch.utils.data import DataLoader

class LineDataset(torch.utils.data.Dataset):
    def __init__(self, count=64):
        self.x = torch.linspace(-1, 1, count).reshape(-1, 1)
        self.y = 3 * self.x + 2

    def __len__(self):
        return len(self.x)

    def __getitem__(self, index):
        return self.x[index], self.y[index]

model = nn.Linear(1, 1)
loader = DataLoader(LineDataset(), batch_size=16, shuffle=True)
learning_rate = 0.2
这里的 model.parameters() 就是第 40 篇讲过的注册参数;输入 batch 不需要手动设置 requires_grad=True,因为我们只需要对模型参数求梯度。autograd 会在前向过程中记录从参数到 loss 的计算图。
4.2 每个 step 的严格顺序
一个最小训练 step 有六件事:清除上一步梯度、前向计算、计算 loss、反向传播、更新参数、记录指标。顺序不能随意交换。梯度默认是累积的,所以必须在本轮反向前清零;更新参数时要禁止 autograd 记录“更新操作”本身。
for epoch in range(20):
    model.train()
    total_loss = 0.0

    for x_batch, y_batch in loader:
        prediction = model(x_batch)
        loss = ((prediction - y_batch) ** 2).mean()

        model.zero_grad(set_to_none=True)
        loss.backward()

        with torch.no_grad():
            for parameter in model.parameters():
                parameter -= learning_rate * parameter.grad

        total_loss += loss.item() * x_batch.size(0)

    epoch_loss = total_loss / len(loader.dataset)
    if epoch in (0, 19):
        print(f"epoch={epoch + 1}, loss={epoch_loss:.4f}")

print(model.weight.item(), model.bias.item())
epoch=1, loss=3.8...
epoch=20, loss=0.0...
2.99... 2.00...
具体小数会随随机初始化、PyTorch 版本和 batch 顺序略有变化,但 loss 应下降,参数应接近目标。loss.item() 把一个标量 Tensor 转成 Python 数字,适合日志;不要把带计算图的 loss 对象不断放进列表,否则会让旧图无法释放,造成内存增长。
zero_grad(set_to_none=True) 把梯度设为 None,通常比写成全零更省一次填充,也能更明显地区分“本轮没有产生梯度”和“梯度恰好为零”。如果一个参数的 grad is None,要检查它是否参与了当前 loss,而不是盲目访问 .grad 做乘法。
4.3 把时序画出来
前向阶段产生输出与计算图;backward() 沿图反向,把梯度累加到叶子参数;更新阶段读取梯度改变参数;下一 step 再建立一张新图。模块对象和参数跨 step 存在,单轮 autograd 图通常在反向后释放。
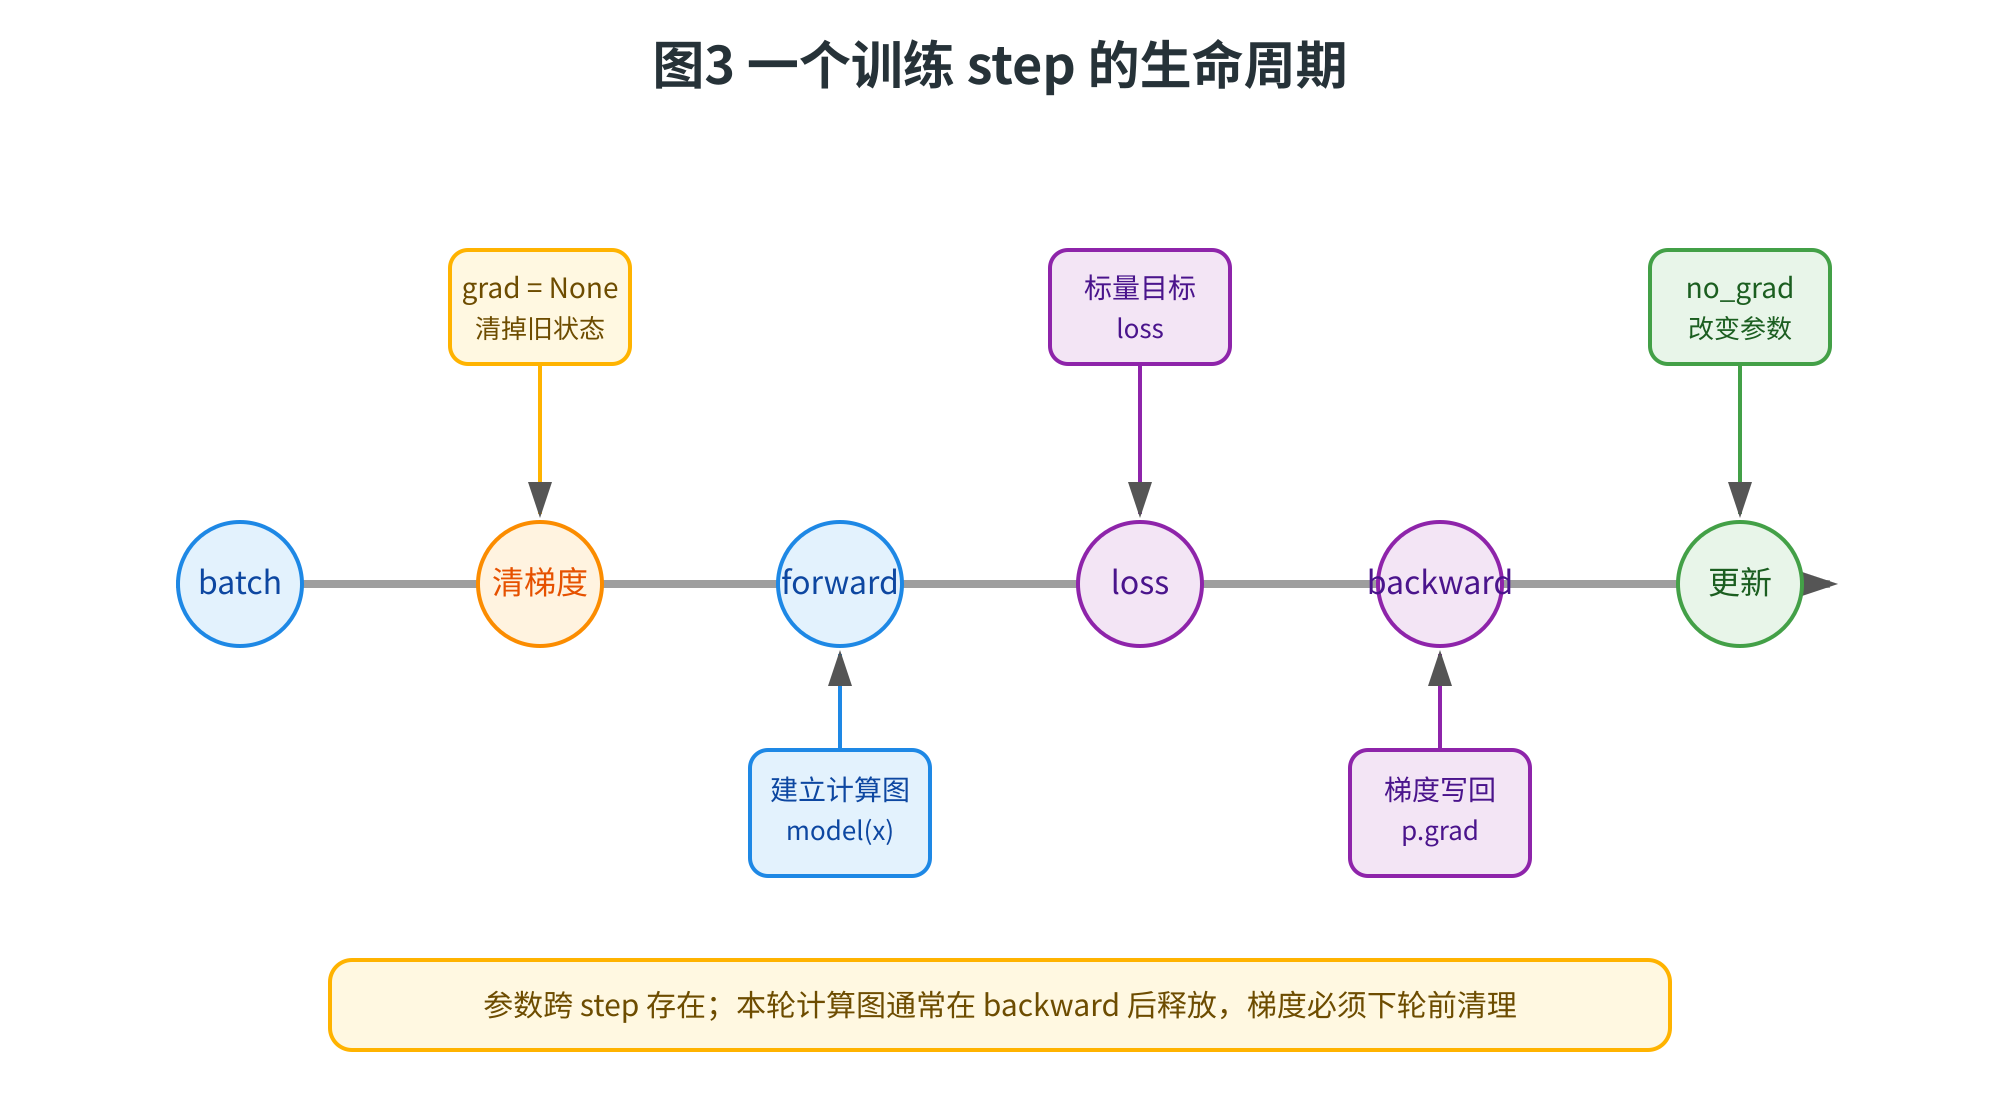
图3 一个训练 step 的生命周期
训练循环不是神秘黑盒,而是一个明确的状态机:模型参数是长期状态,梯度是 step 间需要清除的短期状态,loss 和激活是本轮中间结果,DataLoader 迭代器负责样本进度。checkpoint 若要支持断点续训,就必须思考这些状态分别在哪里。
4.4 训练与验证边界
训练集需要 model.train(),验证需要 model.eval()。后者切换 Dropout、BatchNorm 等模块的行为,但不等于关闭梯度;验证时还要用 torch.inference_mode() 或 torch.no_grad()。
model.eval()
validation_loss = 0.0
with torch.inference_mode():
    for x_batch, y_batch in validation_loader:
        prediction = model(x_batch)
        validation_loss += ((prediction - y_batch) ** 2).mean().item()
model.train()
如果验证函数忘记恢复训练模式,下一轮可能仍以 eval 行为训练;如果只写 no_grad() 而忘记 eval(),Dropout 和 BatchNorm 仍处于训练行为。把模式切换放在训练入口和验证函数的显式位置,是比依赖调用顺序更可靠的工程习惯。
五、AI Infra:worker、预取与 pinned memory
5.1 GPU 等数据时,瓶颈在哪里
当模型在 GPU 上计算时,CPU 侧要同时完成索引、读取、解码、增强、collate 和把数据拷贝到 GPU。如果这些工作没有赶在下一次计算前完成,GPU 利用率会出现锯齿:算一小段,等待一小段。此时“再换更大的 GPU”未必有效,先看数据等待时间更重要。
num_workers=0 表示主进程同步读取,最容易调试,但训练和读取不能重叠。num_workers>0 会启动多个 worker 进程,让它们提前准备 batch。worker 数量不是越多越好:进程有启动和 IPC 成本,每个 worker 还可能占用 Python、解码库和 batch 缓冲内存;如果底层存储带宽已经饱和,增加 worker 只会争抢资源。
一个实用的调参顺序是:先用 num_workers=0 确认正确性,再逐步尝试 2、4、8,记录 step time、data time、CPU 利用率、内存和 GPU utilization。不要只看单个最快 step,要观察多个 epoch 的稳定平均值。网络文件系统、机械磁盘、本地 NVMe 和内存数据集的最佳点完全不同。
5.2 pin_memory 和 host-to-device copy
固定页内存(pinned memory,也叫 page-locked memory)是不容易被操作系统换出的主机内存。DataLoader(pin_memory=True) 会尝试把返回的 Tensor 放到 pinned memory,随后把 batch 搬到 CUDA 时,可以配合 non_blocking=True 发起更高效、可重叠的拷贝:
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
loader = DataLoader(
    LineDataset(), batch_size=32, shuffle=True,
    num_workers=2, pin_memory=(device.type == "cuda"),
)

for x_batch, y_batch in loader:
    x_batch = x_batch.to(device, non_blocking=True)
    y_batch = y_batch.to(device, non_blocking=True)
    prediction = model.to(device)(x_batch)
pin_memory 不是把数据直接放进 GPU,也不会让所有程序自动变快。它会增加主机内存压力;数据已经在 CPU、batch 很小、或瓶颈在解码和网络 I/O 时,收益可能很有限。只有源 Tensor 确实位于 pinned memory、目标是 CUDA,并且拷贝与计算有机会重叠时,non_blocking=True 才有价值。先测量再打开。
persistent_workers=True 可以让跨 epoch 的 worker 不必反复启动,适合训练 epoch 较多、worker 初始化昂贵的场景;prefetch_factor 控制每个 worker 提前准备多少 batch,但预取越多也意味着更多内存和可能的陈旧数据。调参时把 batch size、worker 数、prefetch、pin memory 一起记录,保证实验可比较。
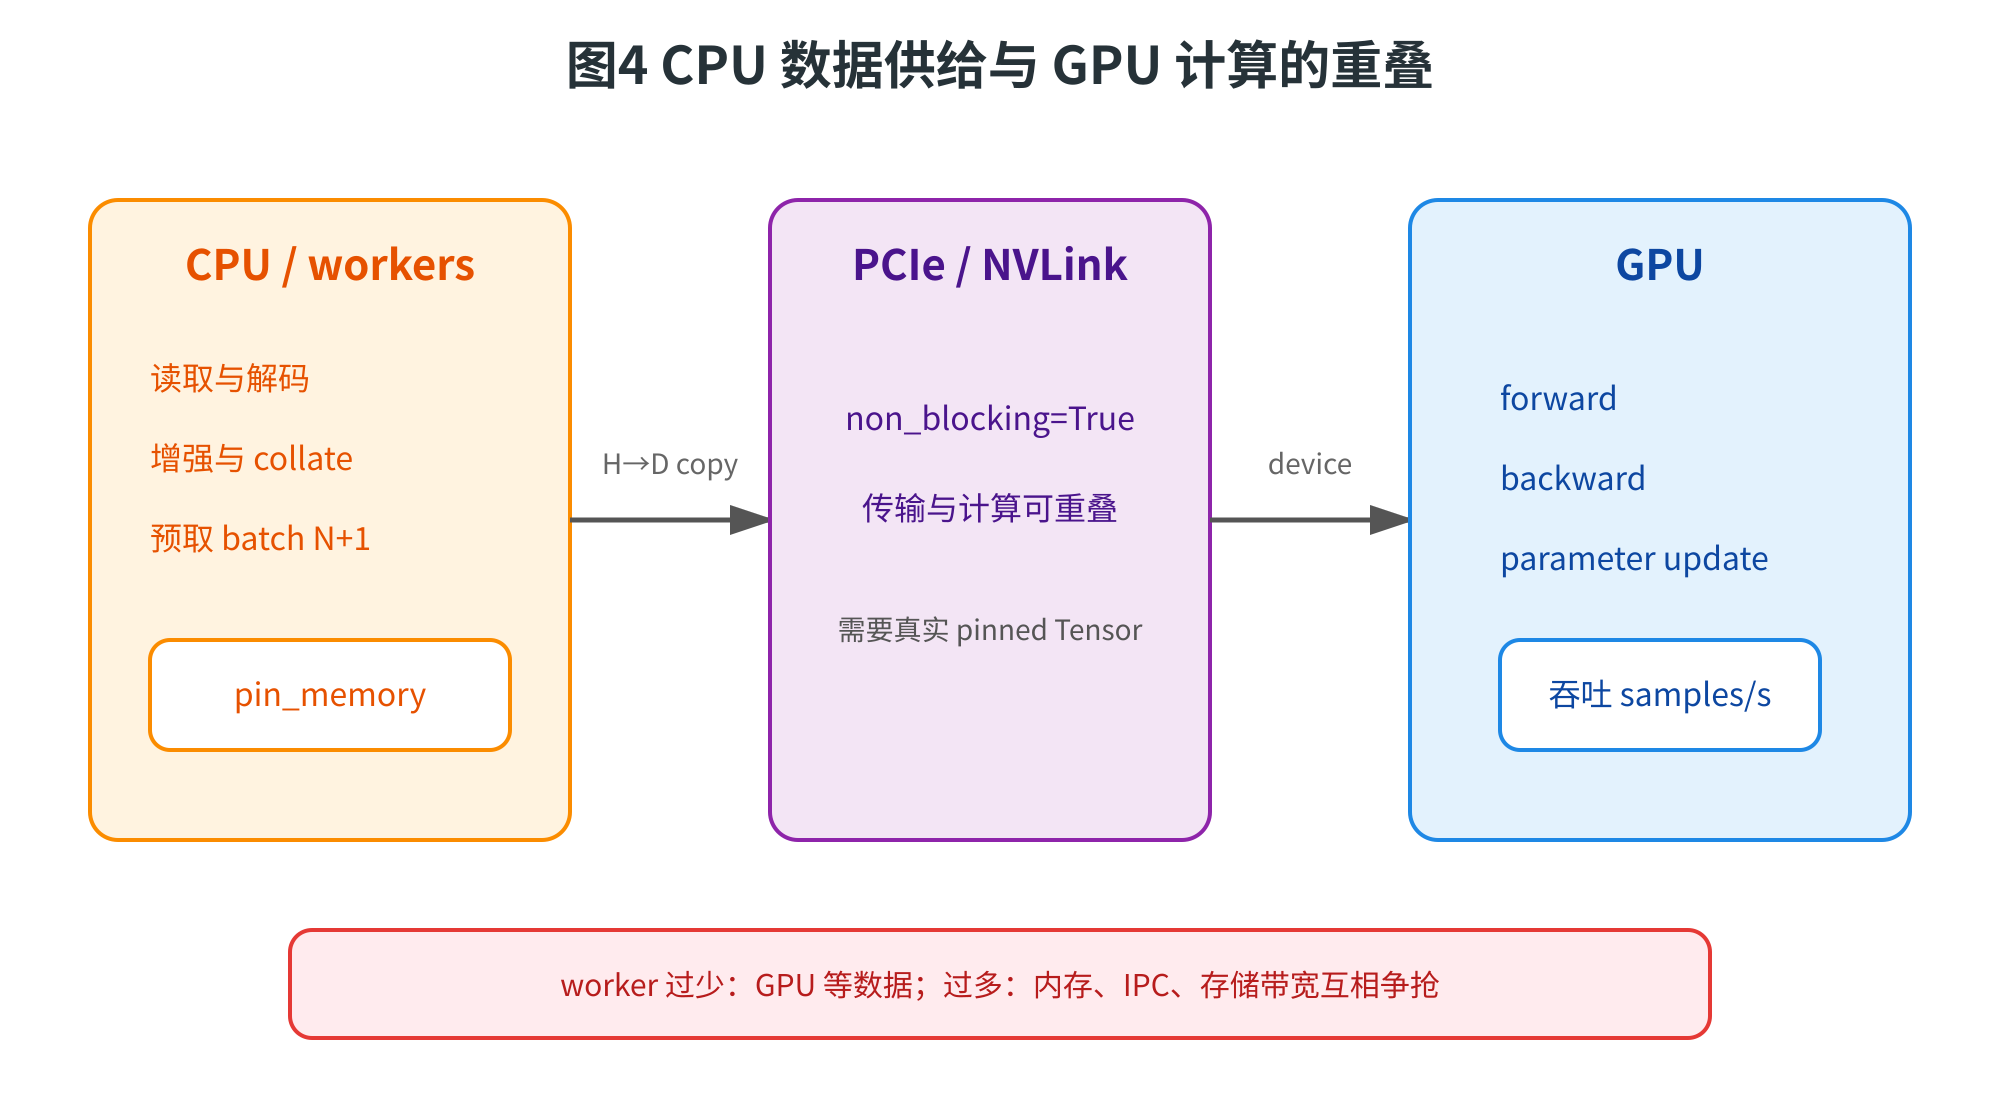
pin_memory、数据传输与计算重叠的相关内容。图中左侧橙色模块代表CPU/workers,标注了其工作流程为读取与解码、增强与collate、预取batch N+1,还标注了pin_memory为对应设置。中间紫色模块对应PCIe/NVLink,标注当non_blocking=True时传输与计算可重叠,需要真实pinned Tensor,箭头标注H→D copy,右侧蓝色模块代表GPU,标注其工作流程为forward、backward、parameter update,底部红色框标注了worker数量的影响:过少会使GPU等待数据,过多则会造成内存、IPC、存储带宽互相争抢。图4 CPU 数据供给与 GPU 计算的重叠
5.3 多进程的可移植性与随机性
worker 不是线程,而通常是进程。Linux 常见 fork,Windows 和部分环境使用 spawn;后者会重新导入模块,因此启动 DataLoader 的代码应放在 if name == "main": 保护下。Notebook 中的局部函数、不可序列化对象也可能让 worker 启动失败。
每个 worker 都应该拥有可区分的随机种子。使用随机增强时,可以通过 worker_init_fn 或 generator 设定种子,并记录主进程 seed、数据版本和 sampler 状态。想要可复现,不能只写一次 torch.manual_seed(0) 就结束:Python、NumPy、CUDA、worker 和分布式 sampler 都有自己的随机来源。
数据集对象还要避免在 init 中打开大量不可共享的资源。多进程复制后,每个 worker 可能持有自己的文件句柄或缓存,导致句柄耗尽、内存倍增或读写冲突。生产数据管道通常会在 worker 内延迟初始化连接,并在结束时正确释放。
5.4 用指标而不是猜测优化
可以给训练循环加两个计时点:等待 batch 的时间和模型计算时间。更完整的系统还会记录读取字节数、解码耗时、队列深度、worker 重启次数、GPU memory allocated 和每个 rank 的 batch 数。若 data time 大于 compute time,优先优化数据侧;若 compute time 占主导,才考虑模型、混合精度、编译或更大的 batch。
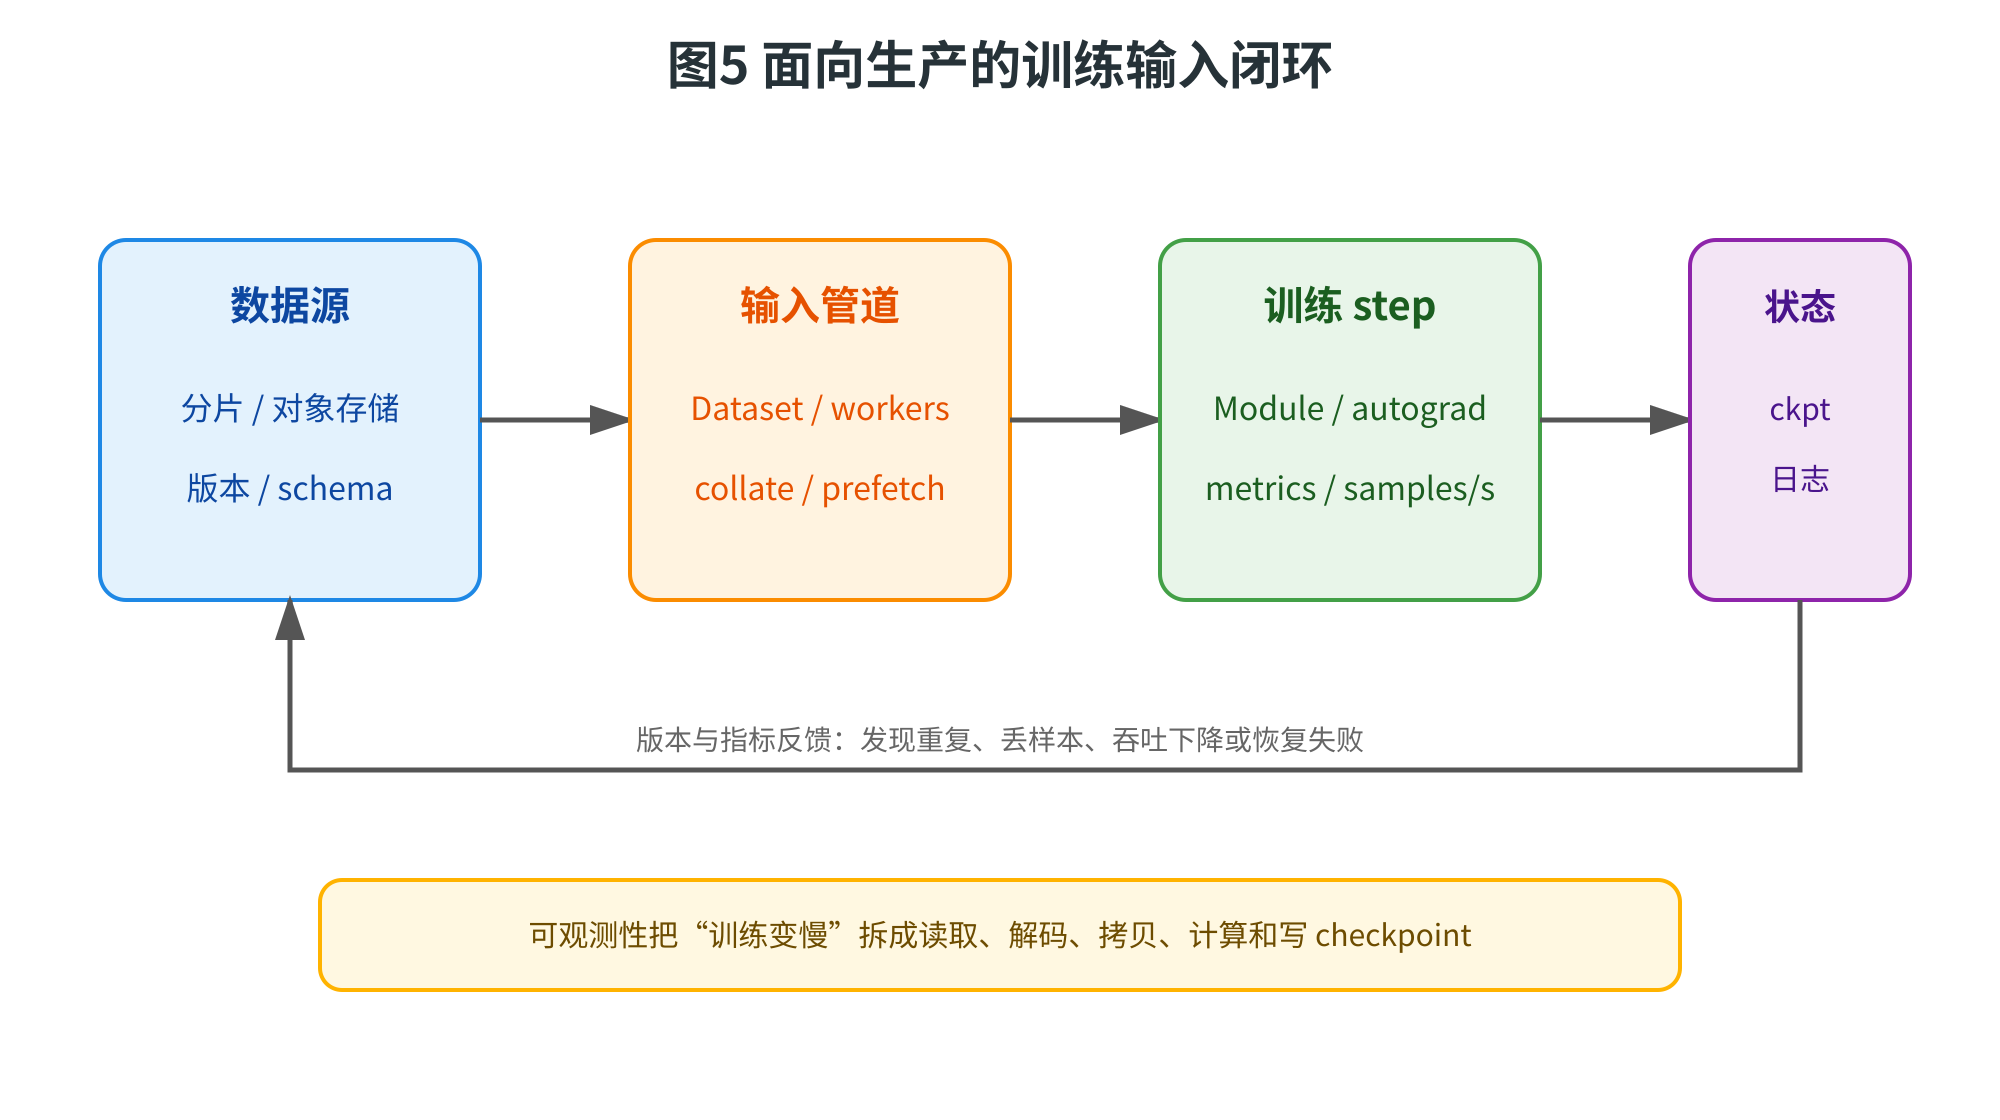
图5 面向生产的训练输入闭环
AI Infra 视角:训练吞吐是端到端指标,不是 GPU 峰值 FLOPS。数据分片、缓存、worker、pinned memory、PCIe/NVLink、模型计算和 checkpoint 写入共同决定
samples/s。一次只改一个变量,保存配置和测量结果,才能知道优化是否真的有效。
六、把训练循环做成可恢复的工程组件
6.1 设备、dtype 与 batch 检查
训练开始前做小 batch smoke test,可以快速发现数据和模型的协议不一致:
def inspect_batch(batch):
    if isinstance(batch, dict):
        for name, value in batch.items():
            if hasattr(value, "shape"):
                print(name, tuple(value.shape), value.dtype, value.device)
    else:
        for index, value in enumerate(batch):
            print(index, tuple(value.shape), value.dtype, value.device)

batch = next(iter(loader))
inspect_batch(batch)
模型参数、输入 Tensor 和目标 Tensor 要在兼容 device 上;标签 dtype 要符合后续损失函数;batch 第一维通常表示样本数,其他维度要与 forward 契约一致。不要在循环中无条件写 .cuda(),而应由配置决定 device,这样 CPU 调试、单 GPU 和多 GPU 代码能共享入口。
6.2 先做一个 batch 的契约测试
在平台代码中,训练作业不应等到跑满几个小时才发现字段顺序或设备错误。可以把第一个 batch 当成接口测试:检查键集合是否符合配置,样本数是否大于零,输入与标签第一维是否相同,padding 后的 mask 是否为布尔类型,数值是否包含 NaN 或无穷大。对于图像,还应检查通道顺序、像素范围和颜色空间;对于文本,还应检查词表版本、特殊 token 和最长长度。
一个小而稳定的检查能把问题定位在数据边界,而不是让异常穿过 collate、模型和反向传播后才出现。正式训练还可以在每个 epoch 开头记录第一个 batch 的摘要哈希:不记录原始隐私数据,只记录 shape、dtype、id 范围和统计值。这样当吞吐或 loss 突然变化时,可以比较是数据版本变了,还是模型代码变了。
6.3 端到端的可观测性
把时间拆成“等待 batch”“host-to-device 拷贝”“forward 与 backward”“参数更新”和“日志或 checkpoint”,比只看一个 step 总耗时更有诊断价值。CPU 侧可以统计 worker 队列是否经常为空;GPU 侧可以观察 kernel 间隙和显存峰值;存储侧可以记录读取吞吐与错误重试。每项指标都要带 epoch、step、rank 和数据版本,否则不同实验之间无法比较。
当数据管线跨机器时,还要区分本地缓存命中、对象存储请求、解压、解码和网络传输。一个常见误区是把所有等待都归咎于 Python;实际瓶颈可能是共享存储的尾延迟,或者 batch 过小导致 GPU kernel 启动开销占比过高。先建立基线,再一次只改变 worker、缓存、batch 或预取策略,才能得到可解释的结论。
6.4 checkpoint 的边界
第 40 篇已经区分了 model.state_dict() 和可恢复训练的 checkpoint。本篇的循环还需要保存当前 epoch、step、随机状态、数据配置和指标。如果只保存权重,重新开始时可能使用不同的 batch 顺序、学习率或 worker 随机序列,结果不一定是从中断处继续。
checkpoint = {
    "model": model.state_dict(),
    "epoch": epoch,
    "step": step,
    "config": {"batch_size": 32, "num_workers": 2},
    "metrics": {"loss": epoch_loss},
}
torch.save(checkpoint, "checkpoint.pt")
实际项目还应把数据集版本、采样器进度、代码 commit、PyTorch 版本和硬件信息写入 metadata。保存前先写临时文件,成功后原子替换,并保留最近若干个可验证 checkpoint。这样节点被抢占或磁盘写入中断时,至少还有一个完整版本可恢复。
6.5 从单机循环到分布式训练
单机 DataLoader 的 shuffle=True 只保证一个进程内的随机顺序;多 GPU 时每个 rank 必须拿到不重叠的数据子集。DistributedSampler 通常负责切分索引,每个 epoch 由入口调用 set_epoch,然后每个 rank 的 batch 送入自己的模型副本。最后的 loss、吞吐和样本数还要做跨 rank 聚合,不能只打印 rank 0 的局部数字就认为是全局指标。
这也是为什么数据和模型接口要尽量稳定:当 Dataset 只定义样本契约,sampler 可以替换;当 Module 只接收规范 batch,分布式包装、混合精度和 checkpoint 才容易插入。先把单机循环的边界写清楚,比一开始复制一份“能跑但不可解释”的分布式脚本更重要。
七、踩坑大全
坑 1:把 len(dataset) 当成 len(loader)。 前者是样本数,后者是 batch 数;训练进度和平均 loss 要明确分母。
坑 2:getitem 返回形状不一致的 Tensor。 默认 collate 需要堆叠规则形状;文本或检测框等变长数据应使用 padding、mask 或自定义 collate_fn。
坑 3:训练集和验证集都 shuffle=True。 验证顺序会变化,难以复现和对齐预测;通常只对训练集 shuffle。
坑 4:把 shuffle=True 与自定义 sampler 同时传入。 两者都控制索引顺序,通常会冲突;需要按 sampler 的语义配置。
坑 5:忘记 model.train() 或验证后没切回训练模式。 Dropout、BatchNorm 等层会使用错误行为;eval() 也不等于关闭梯度。
坑 6:忘记清零梯度。 autograd 默认累加梯度,loss 可能异常变大;每次反向前调用 zero_grad 或等价逻辑。
坑 7:在更新参数时没有 no_grad()。 参数更新操作会被记录进图,造成额外图和错误的梯度关系;更新阶段应关闭 autograd。
坑 8:把带图的 loss 存进日志列表。 这会保留整张计算图;记录标量用 loss.item(),需要 Tensor 时先 detach()。
坑 9:num_workers 一上来就开很大。 worker 有进程、内存、文件句柄和 IPC 成本;先用 0 验证,再测量 2、4、8 等配置。
坑 10:误解 pin_memory。 pinned memory 仍在 CPU,不是显存;它可能增加内存压力,只有 CUDA 拷贝和计算能重叠时才可能有明显收益。
坑 11:Windows 或 spawn 环境没有 main guard。 worker 会重复导入主模块;把启动训练的代码放入 if name == "main":。
坑 12:多 worker 重复读取同一份流。 IterableDataset 必须依据 worker 信息切分数据,否则样本会重复;分布式时还要再按 rank 切分。
八、小结
Dataset用len描述规模,用getitem定义单样本协议;数据读取和模型计算应保持边界清楚。DataLoader把索引组织成 batch;batch_size、shuffle、sampler、drop_last与collate_fn共同决定模型实际收到什么。- 变长样本要在
collate_fn中 padding、构造 mask 或采用其他表示,并明确 dtype、shape 和语义。 - 一个训练 step 的顺序是清梯度、前向、算 loss、
backward()、无梯度更新和记录指标;模型参数是长期状态,autograd 图是本轮状态。 train()/eval()与no_grad()/inference_mode()解决不同问题,训练、验证入口都应显式设置。num_workers、预取、pin_memory和non_blocking需要结合 data time、compute time、内存和 GPU 利用率测量,而不是凭经验堆配置。
九、课后练习
- (基础) 实现一个
Dataset,返回 100 个(x, y)样本,并用断言检查len、单样本 shape 和 dtype。 - (基础) 分别设置
batch_size=7、drop_last=False/True,打印每个 batch 的大小,解释丢弃了多少样本。 - (理解) 让
Dataset返回长度不同的 token id,写collate_fn产生input_ids、padding mask 和 label。 - (理解) 在最小训练循环中打印一次参数的
grad,比较清零前后梯度是否累积;解释set_to_none=True的含义。 - (进阶) 写一个验证函数,确保它使用
eval()和inference_mode(),验证结束后恢复train(),并比较 Dropout 的行为。 - (AI Infra) 对
num_workers=0、2、4计时,分别记录平均 data time、compute time、内存和 samples/s,写出你的拐点。 - (AI Infra) 在有 CUDA 的机器上比较
pin_memory与non_blocking的组合;没有 CUDA 时说明为什么不能把 CPU 结果直接当作 GPU 结论。 - (进阶) 为训练循环加入 checkpoint,保存模型、epoch、step、配置和随机种子;模拟中断后恢复,并验证 batch 顺序与指标记录策略。
下一篇预告
第42篇|优化器、损失函数与学习率调度。本篇手写了最小参数更新,但真实训练不会长期直接写 parameter -= learning_rate * grad。下一篇将拆解 SGD、Momentum、Adam/AdamW 如何保存状态,比较回归与分类损失的梯度形状,并用学习率 warmup、衰减和 scheduler 把训练过程变成可控制的策略。再往后,第 43 篇会把这些组件接入手写 Attention 与 Transformer Block,继续沿着“数学原理 → PyTorch 实现 → AI Infra 性能边界”的路线前进。