
第46篇|torch.compile 与算子融合入门
本篇定位:专栏四「PyTorch 与 AI Infra 入门」的第十篇。承接第 45 篇的 AMP、显存账本与 profiler,把“看见慢在哪里”推进到“让框架生成更少、更大的执行单元”:理解 eager 与编译执行的差异,使用
torch.compile做可复现的加速实验。读完你将能够:解释
torch.compile的图捕获、graph break、算子融合和 Inductor 的基本链路;区分default、reduce-overhead、max-autotune等模式的直觉;写出包含 warmup、同步和正确性检查的 benchmark;判断动态 shape、首次编译、I/O 和不支持算子何时会让编译收益消失;从训练、推理服务和 AI Infra 资源管理角度设计编译策略。预计用时:阅读 60~80 分钟,动手 60~90 分钟。
第 45 篇中,我们用 profiler 把一个训练 step 拆成了 CPU 调度、CUDA kernel、数据拷贝和显存事件。你可能会看到这样的时间线:一串很短的逐元素算子,每个都要由 Python 发起一个 kernel;中间有几次读回显存、类型转换或同步;真正的矩阵乘法反而不是唯一的瓶颈。把 dtype 换成 bfloat16 只能优化某些计算,却不会自动消除这些调度和中间 Tensor。
这就是本篇的切入点:torch.compile 不是“把 Python 代码翻译成 C++”的按钮,也不是“打开后所有模型都快”。它尝试从一段稳定重复的 PyTorch 程序中捕获计算图,分析算子之间的依赖,生成更适合目标设备的代码。在合适的输入形状和算子组合下,多个小操作可以融合,少写几次显存、少发几次 kernel;在形状变化、图被频繁打断或模型本来就被大型 GEMM 主导时,收益则可能很小,甚至被首次编译成本抵消。
一、先建立 eager 与编译执行的心智模型
1.1 eager mode:每一步都即时执行
PyTorch 默认的 eager mode(即时执行)强调灵活性。我们写下 y = torch.relu(x + bias) 时,Python 先调用加法对应的算子,再调用 relu;在 CUDA 上,通常会形成两个可以独立调度的设备操作,并可能产生一个中间 Tensor。这个模型非常适合探索:可以随时打印值、改变分支、传入不同 shape,也容易用 debugger 逐行查看。
灵活性的另一面是调度开销和中间读写。假设输入有一亿个元素,x + bias 写出一块结果,relu 再读这块结果并写出另一块结果。算术本身很简单,时间可能主要花在 kernel launch、显存带宽和 Tensor 生命周期上。Python 还需要在每个算子之间参与调度,CPU 和 GPU 之间形成很多细小的工作单元。
import torch

x = torch.randn(1024, 4096)
bias = torch.randn(4096)
y = torch.relu(x + bias)
print(y.shape, y.is_contiguous())
这段代码在 eager 下已经是正确的,也可能已经足够快。编译的目标不是改变数学结果,而是寻找等价但执行成本更低的表示。不要因为代码短,就假设它值得编译;要先用第 45 篇的方法测量端到端时间和实际瓶颈。
1.2 torch.compile 在做什么
可以把 torch.compile(model) 暂时理解为“返回一个带缓存的可调用对象”。第一次用某组输入调用时,框架大致经历:观察 Python 字节码和 Tensor 操作;捕获一段图;对图做优化;调用后端生成代码;编译并缓存结果。后续输入满足同一组假设时,直接复用已生成的代码,不必再次走完整路径。
import torch
from torch import nn

class Block(nn.Module):
    def __init__(self, dim: int):
        super().__init__()
        self.norm = nn.LayerNorm(dim)
        self.fc = nn.Linear(dim, 4 * dim)
        self.proj = nn.Linear(4 * dim, dim)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        h = self.norm(x)
        h = torch.nn.functional.gelu(self.fc(h))
        return x + self.proj(h)

model = Block(256).eval()
compiled = torch.compile(model, mode="default")
x = torch.randn(8, 128, 256)
with torch.inference_mode():
    y = compiled(x)
print(y.shape)
第一次调用很慢并不奇怪;它包含捕获、分析、代码生成和编译。这里的 compiled 不是另一份完全不同的模型权重,而是带有编译执行路径的包装对象。参数仍由原模块管理,部署时要把编译后的对象和它所依赖的模型生命周期一起考虑。
AI Infra 视角:编译优化的收益要摊到请求或训练 step 上。离线训练跑几百万个 step 时,一次几十秒的编译通常可以摊薄;短命的 serverless 请求只有一次推理,首次编译反而可能是全部延迟。
1.3 图捕获与 graph break
编译器需要一段相对稳定、能表示成 Tensor 图的代码。纯 Tensor 运算通常容易捕获;依赖 Python 值的控制流、把 Tensor 转成 Python 标量、调用没有编译规则的第三方函数,则可能让捕获暂时结束,这叫 graph break(图断裂)。断裂后,前一段由编译代码执行,断裂处回到 eager,再尝试捕获后面的部分。
下面是一个可运行、但可能产生图断裂的例子:
import torch

@torch.compile
def with_python_branch(x: torch.Tensor) -> torch.Tensor:
    # item() 把设备上的值取回 Python,可能触发同步与 graph break
    if x.sum().item() > 0:
        return x * 2
    return x - 2

print(with_python_branch(torch.ones(4)))
为了诊断,可暂时使用 fullgraph=True:它要求整个函数被捕获,遇到不能捕获的地方就报错,帮助我们找到边界;它不是“生产环境必须打开”的加速开关。还可以使用 torch._dynamo.explain 查看捕获结果,但这是诊断接口,版本间输出可能变化。工程上更重要的是:把数据预处理、日志、随机 Python 逻辑和 Tensor 核心计算拆开,让可编译区域边界清楚。
import torch

@torch.compile(fullgraph=True)
def tensor_only(x: torch.Tensor) -> torch.Tensor:
    return torch.sigmoid(x) * 3 + 1

print(tensor_only(torch.randn(4)))
图捕获也会记录输入的 guard(守卫),例如 dtype、设备、rank、某些尺寸或对象属性。输入违反守卫时,编译器可能重新编译另一份专用代码。重新编译不是“随机变慢”,而是为了保证原代码语义;但缓存变多会吃时间和内存,服务端还可能出现长尾抖动。
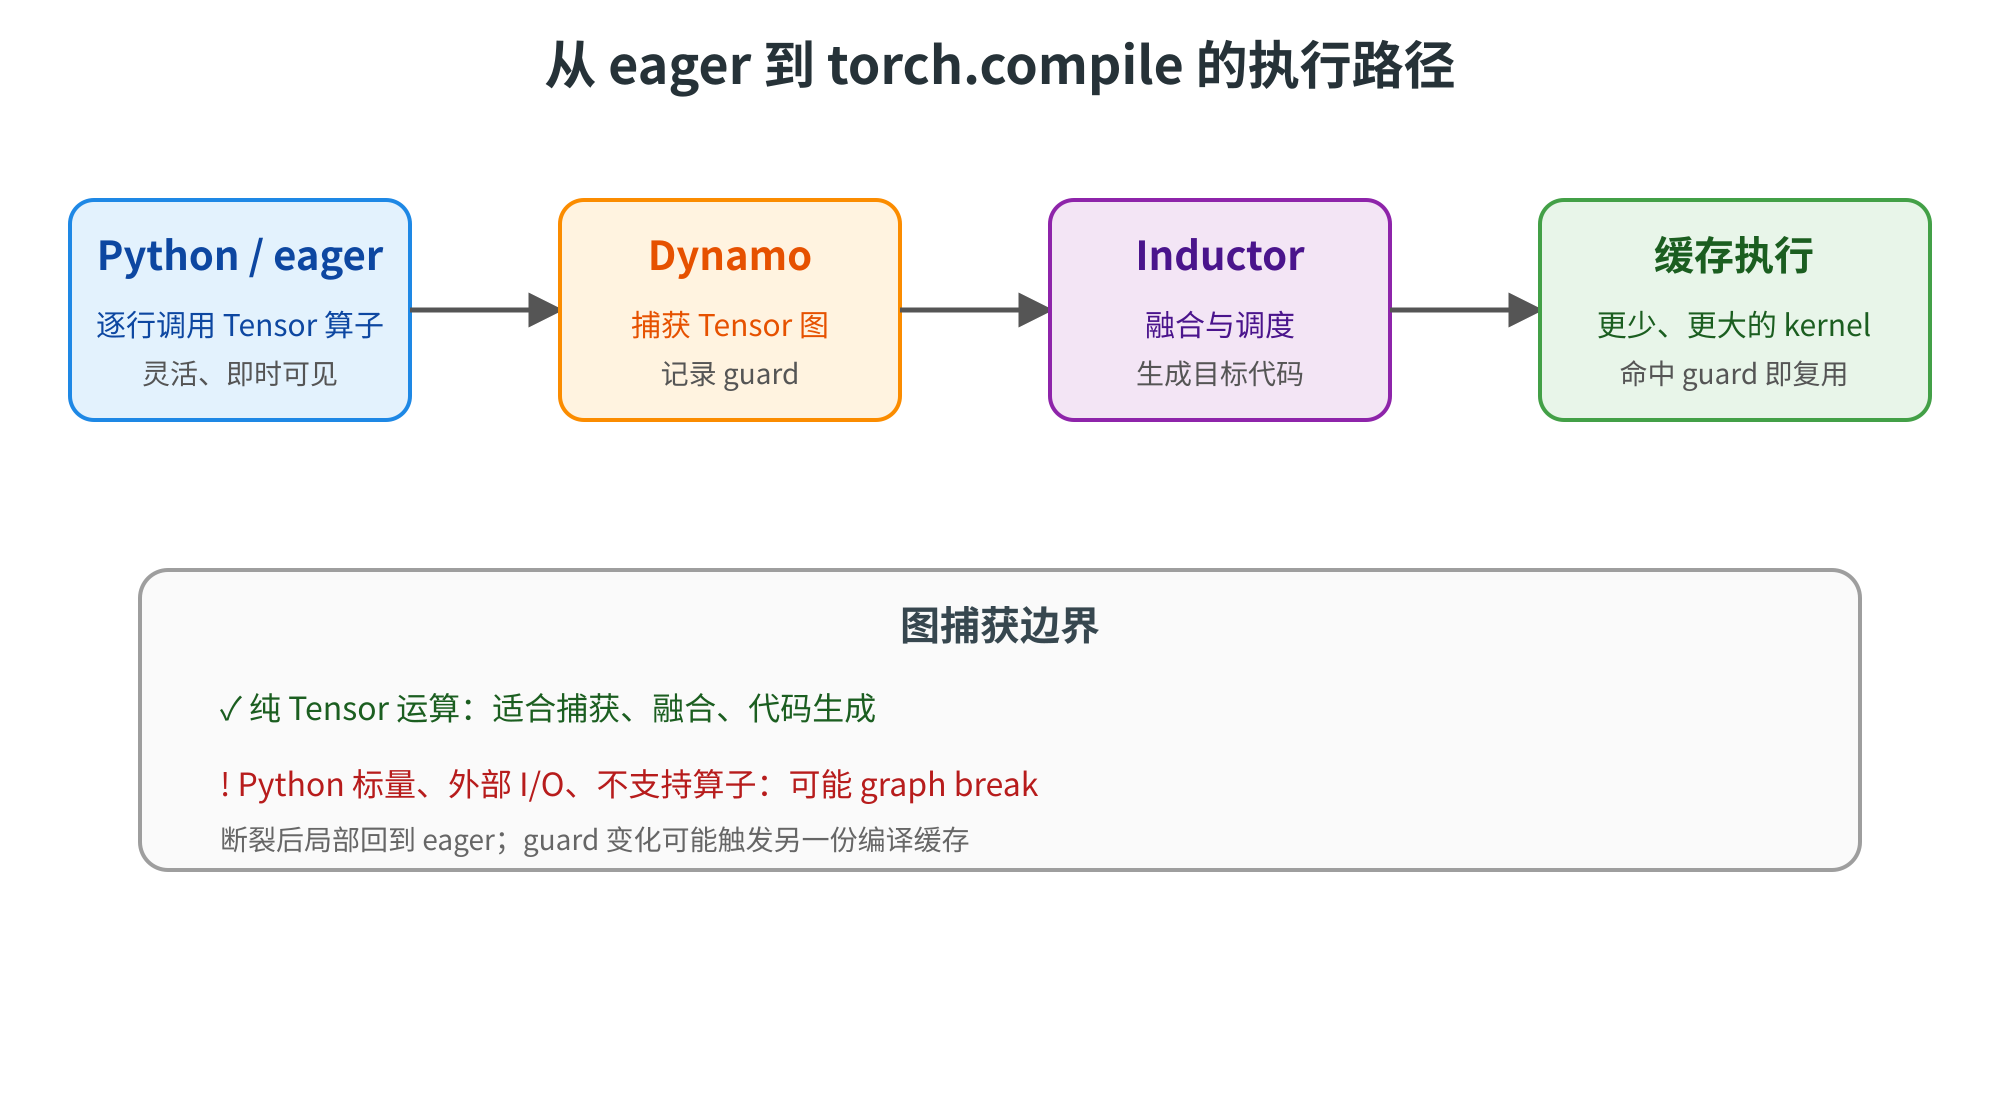
图1 eager 与 torch.compile 的执行路径
1.4 编译边界应该放在哪里
最稳妥的起点是编译计算密集、调用频繁、输入结构相对稳定的 nn.Module 或其 forward,而不是把整个训练脚本、DataLoader、日志和评估循环一起包进去。训练时可以先编译模型,再保留 optimizer、梯度清零和指标记录在外层;推理时可以编译“单请求的 Tensor 核心”,把 tokenizer、网络 I/O、队列和响应序列化放在外层。
这不是绝对规则。如果模型前向内部有大量 Python 循环,编译更大的区域可能帮助优化循环;如果模块边界导致 Tensor 在多个包装层之间来回转换,也可能需要扩大范围。原则是先用 profile 找到稳定热点,再逐步扩大,而不是一开始把所有东西交给编译器。
二、第一次使用:模式、缓存与正确 benchmark
2.1 环境与最小 smoke test
第 45 篇统一使用 Python 3.12 和 uv。建议在项目中固定 PyTorch、CUDA 和驱动兼容矩阵,再运行:
uv init --no-package
uv add torch
uv run python -c "import torch; print(torch.__version__); print(torch.cuda.is_available())"
torch.compile 的后端和可用优化会随 PyTorch、Python、CUDA、GPU 架构变化。CPU 可以做功能 smoke test,但性能结论不能直接迁移到 CUDA。先确认编译前后输出形状、dtype 和有限性,再在目标硬件上做 benchmark。
import torch
from torch import nn

model = nn.Sequential(nn.Linear(64, 128), nn.GELU(), nn.Linear(128, 10)).eval()
compiled = torch.compile(model)
x = torch.randn(16, 64)
with torch.inference_mode():
    eager_y = model(x)
    compile_y = compiled(x)
print("shape:", compile_y.shape)
print("finite:", torch.isfinite(compile_y).all().item())
print("max_diff:", (eager_y - compile_y).abs().max().item())
浮点计算顺序可能改变,不能要求差值逐元素严格为零。应设定与 dtype、模型规模匹配的容差,例如 torch.testing.assert_close(eager_y, compile_y, rtol=1e-3, atol=1e-4);训练模型还要比较一小段 loss 趋势和验证指标。
2.2 mode 的直觉,而不是死记参数
torch.compile 的 mode 是对性能、编译成本和内存的取舍提示。常见模式可以这样记:
版本不同,模式内部策略和支持范围会变化;表格是决策直觉,不是性能承诺。先用 default 建 baseline,再只改变 mode。reduce-overhead 并不等价于“模型计算更少”,它更关注调用开销;max-autotune 也不等于所有模型都快。
dynamic 是另一个常见选项。dynamic=False 往往让编译器针对已知 shape 生成更专门的代码;dynamic=True 尝试生成可处理多种尺寸的代码,减少重新编译,但可能牺牲专门化程度。dynamic=None 让系统启发式选择。对于长度变化的 NLP 请求,应该用 shape bucket 或上限策略做实验,而不是盲目打开动态支持。
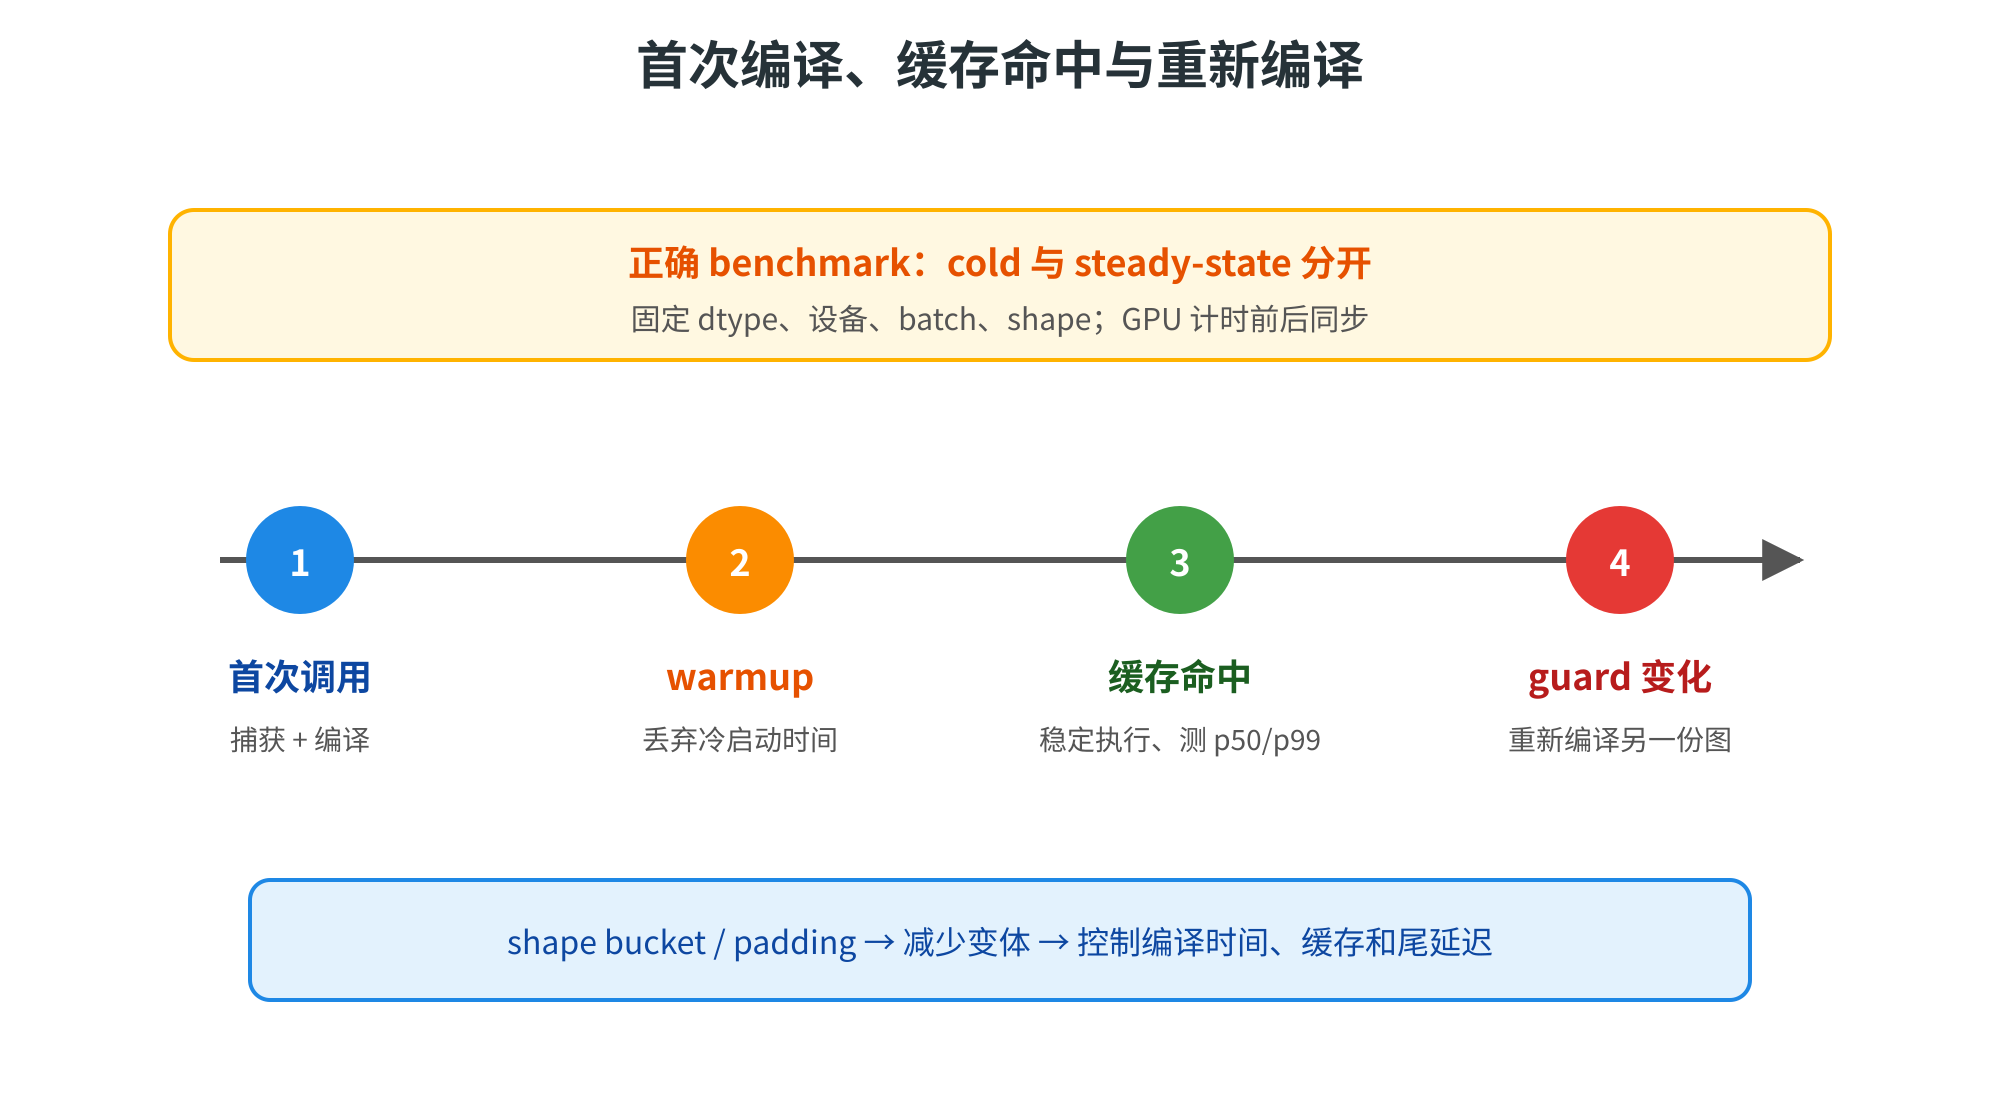
图2 首次编译、缓存命中与重新编译
2.3 warmup、同步与计时
GPU kernel 是异步提交的。若不在计时前后同步,CPU 看到的可能只是“把工作放入队列”的时间;若把第一次调用算进平均值,又会把编译时间和稳定执行时间混在一起。一个基础 benchmark 至少要包含:固定输入、若干次 warmup、GPU 同步、重复测量、输出正确性和显存记录。
import time
import torch
from torch import nn

use_cuda = torch.cuda.is_available()
device = torch.device("cuda" if use_cuda else "cpu")
model = nn.Sequential(nn.Linear(1024, 2048), nn.GELU(), nn.Linear(2048, 1024)).to(device).eval()
compiled = torch.compile(model, mode="default")
x = torch.randn(64, 1024, device=device)

with torch.inference_mode():
    eager_y = model(x)
    _ = compiled(x)  # 含编译的首次调用,不作为稳定延迟
    for _ in range(10):
        model(x)
        compiled(x)
    if use_cuda:
        torch.cuda.synchronize()

    def measure(fn, rounds=30):
        if use_cuda:
            torch.cuda.synchronize()
        start = time.perf_counter()
        for _ in range(rounds):
            y = fn(x)
        if use_cuda:
            torch.cuda.synchronize()
        return (time.perf_counter() - start) / rounds * 1000, y

    eager_ms, _ = measure(model)
    compile_ms, compiled_y = measure(compiled)

print(f"device={device} eager_ms={eager_ms:.3f} compiled_ms={compile_ms:.3f}")
print("max_diff=", (eager_y - compiled_y).abs().max().item())
示例的 warmup 先触发一次编译,再测稳定调用。真实报告要另外记录 compile time,因为线上冷启动和离线训练摊销是两个问题。GPU 上还应记录 p50、p95、p99;平均值看起来变好,不代表尾延迟没有因为重新编译而变坏。
2.4 编译缓存与进程生命周期
编译结果通常与代码、设备、dtype、shape 和 guard 条件有关。修改模型代码、升级 PyTorch 或换 GPU 后,旧缓存不应被当作新的实验结果。训练任务可以把编译放在启动阶段,并把这段时间标记为初始化;服务进程可以在接流量前用代表性 shape 预热。
不要把“编译一次”的假设写成全局真理。不同请求长度可能命中不同专用图;某些 shape 可能触发重新编译。可以限制输入尺寸、做 padding 或 bucket,把无限多的长度收敛成少量候选。生产环境还要监控编译次数、编译耗时、缓存命中率和 graph break,而不只是监控 GPU 利用率。
AI Infra 视角:编译缓存是推理服务的另一种资源。它消耗 CPU 内存、文件缓存和启动时间;多个 worker 各自编译还会重复消耗。部署时应明确“每个进程是否独立编译、何时预热、何时淘汰、升级时如何失效”。
三、算子融合:为什么少几个 kernel 会更快
3.1 从逐元素链到一个执行单元
考虑 y = sigmoid(x) * scale + bias。三个操作都要遍历同一批元素,算术强度低、读写频繁。eager 可能产生多个 kernel 及中间结果;融合后,一个 kernel 可以在寄存器或片上临时空间中完成连续计算,减少中间结果落到全局显存的次数。数学表达式没有变,数据移动和调度方式变了。
import torch

@torch.compile
def pointwise(x: torch.Tensor, scale: torch.Tensor, bias: torch.Tensor):
    return torch.sigmoid(x) * scale + bias

x = torch.randn(4096, 4096)
scale = torch.ones(4096)
bias = torch.zeros(4096)
print(pointwise(x, scale, bias).shape)
这里是否真的融合、融合成什么 kernel,由编译后端、设备、shape、dtype 和版本决定。不要仅凭源代码推断结果;用 profiler 对比 kernel 数量、aten:: 事件、GPU 时间和显存读写,才能确认假设。
3.2 融合收益来自哪里
第一是减少 kernel launch。一次 launch 有 CPU 调度、驱动和设备队列成本;小算子越多,固定成本越明显。第二是减少全局显存往返。融合前的中间 Tensor 可能需要写回显存、再被下一个算子读出;融合后可以复用寄存器或共享内存。第三是让编译器看到更大的局部计算,能安排线程、向量化和内存访问。
融合不是无条件收益。一个很大的矩阵乘法本身已经调用高度优化的库 kernel,旁边加一个小逐元素操作可能有收益,但强行把大型算子拆开或生成不成熟 kernel 反而会慢。融合还可能增加寄存器压力,导致 occupancy 下降;临时值太多时,生成的 kernel 可能溢出到 local memory。因此要测“端到端有效吞吐”,不能只数 kernel。
3.3 Inductor 在链路中的位置
一个高层次的 PyTorch 2 编译链路可以这样理解:
- TorchDynamo 观察 Python 字节码,把可捕获的 Tensor 运算记录成图,并用 guard 保证语义。
- 训练场景可以经由 AOTAutograd(Ahead-Of-Time Autograd)把前向和反向的图分开处理,减少运行时 autograd 解释开销。
- TorchInductor 分析图中的依赖和调度,做融合、布局选择、内存规划等,再生成目标代码。
- 在 GPU 上常见的生成路径会使用 Triton kernel 或调用已有库;CPU 则可能生成 C++/编译器相关代码。最终仍由设备驱动执行。
这是一张工程心智图,不是每个版本唯一的内部实现。Inductor 不会神奇地把所有 nn.Linear 重新发明一遍;对 GEMM、卷积等成熟算子,通常会选择合适的库实现,同时优化它们前后的可融合区域。
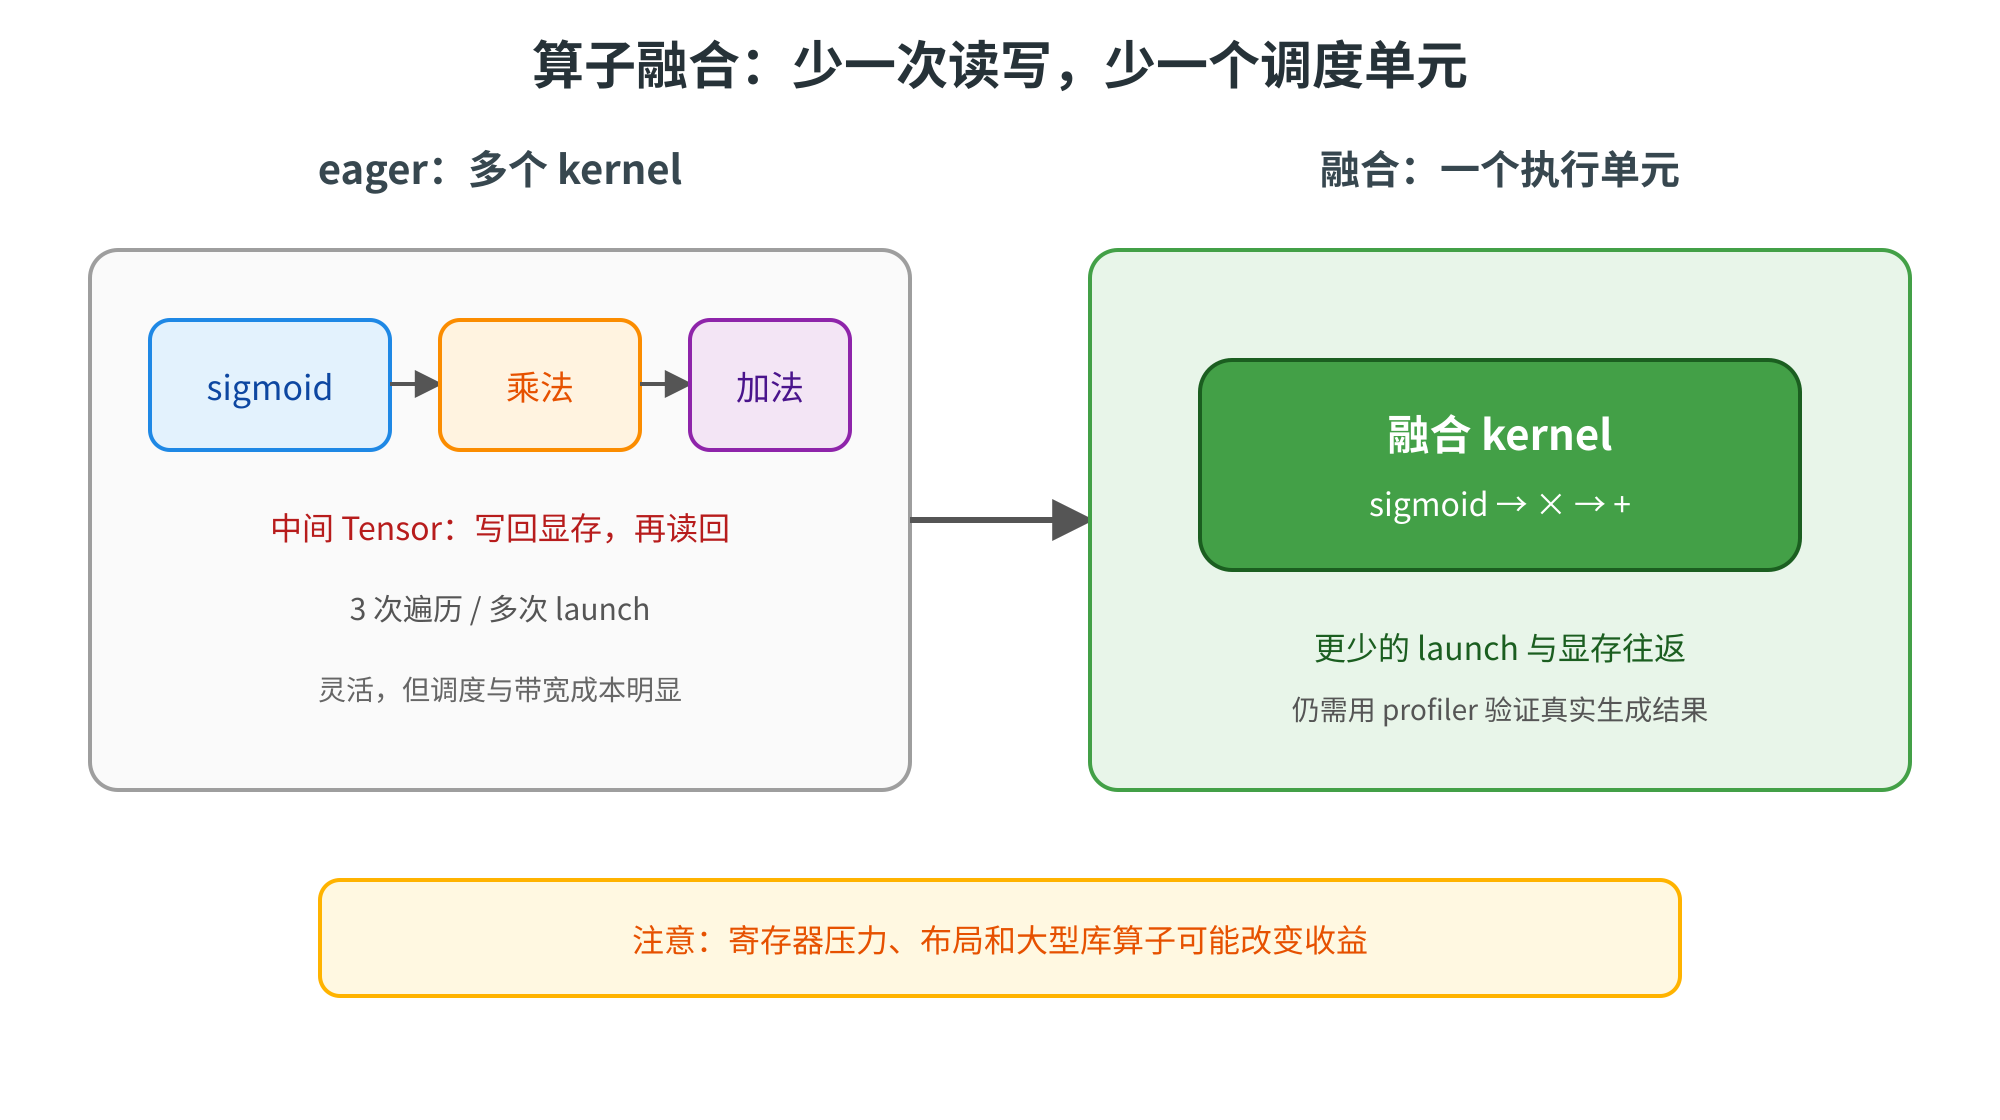
图3 算子融合:从多个读写到更少的执行单元
3.4 AMP、融合与 profiler 是一条闭环
第 45 篇的 AMP 会改变 dtype 和可用 kernel;本篇的 compile 会改变图和调度;两者叠加后,必须重新 profile。一个合理的实验矩阵可以是:eager + FP32、eager + AMP、compile + FP32、compile + AMP。每次只改变一个变量,并记录 loss、tokens/s、step time、峰值显存、kernel 数量和编译时间。
如果 compile + AMP 更快,不能立即归因于融合。可能是半精度矩阵乘法更快,也可能是融合减少了转换;如果只记录总时间,就无法分辨。把 profiler 当作诊断,把 benchmark 当作比较,把正确性测试当作护栏,三者缺一不可。
四、什么时候有帮助,什么时候会变慢
4.1 通常更容易受益的模型
编译更可能帮助以下工作负载:
- 同一个模型被调用很多次,能够摊薄首次编译成本;
- Tensor 运算占主要比例,Python 控制流和外部 I/O 很少;
- batch、序列长度、dtype 和设备相对稳定;
- 有许多逐元素、归一化、reshape 等可分析的组合;
- 训练或推理持续时间足够长,且对吞吐或单步延迟有明确目标。
典型例子是固定长度 batch 的 Transformer block、视觉模型的重复训练 step、服务中经过 padding 的固定 shape 请求。对于这些场景,编译器可以在看到更多上下文后做融合和内存规划。
4.2 常见的负收益来源
第一是首次编译太贵。小脚本只跑一次时,编译时间可能比执行时间还长。第二是 graph break 太多。若编译段被切成许多小段,Python 仍在频繁接管,融合空间也被切断。第三是 shape 抖动。长度从 1 到 8192 任意变化,可能产生多份代码或保守的动态 kernel。第四是工作负载主要由一个已经很快的库 GEMM 或通信组成,编译没有太多可优化空间。
此外,某些自定义算子、Python 扩展、数据处理和副作用不适合直接捕获;编译过程会占用 CPU、内存和磁盘缓存;调试栈和报错信息也比 eager 更复杂。分布式训练还要考虑每个 rank 的编译同步、通信算子边界和不同 rank 是否看到一致 shape。
4.3 动态 shape 的取舍
动态 shape 不是简单的“支持任意输入”。编译器要在通用性和专门化之间选择:更通用的代码可能少触发重新编译,但不能利用某个固定尺寸的全部信息;专用代码可能更快,却需要为新尺寸付出编译成本。
NLP 服务可以把 token 长度分成少量 bucket,例如 128、256、512、1024,短请求 padding 到最近的 bucket。padding 会多算一些 token,却能让 kernel shape 稳定、缓存可控。是否值得要用请求分布计算:如果长度高度离散、padding 浪费很大,动态策略可能更合理;如果流量集中在少数长度,bucket 往往更容易管理。这个选择同时影响算力、显存和尾延迟。
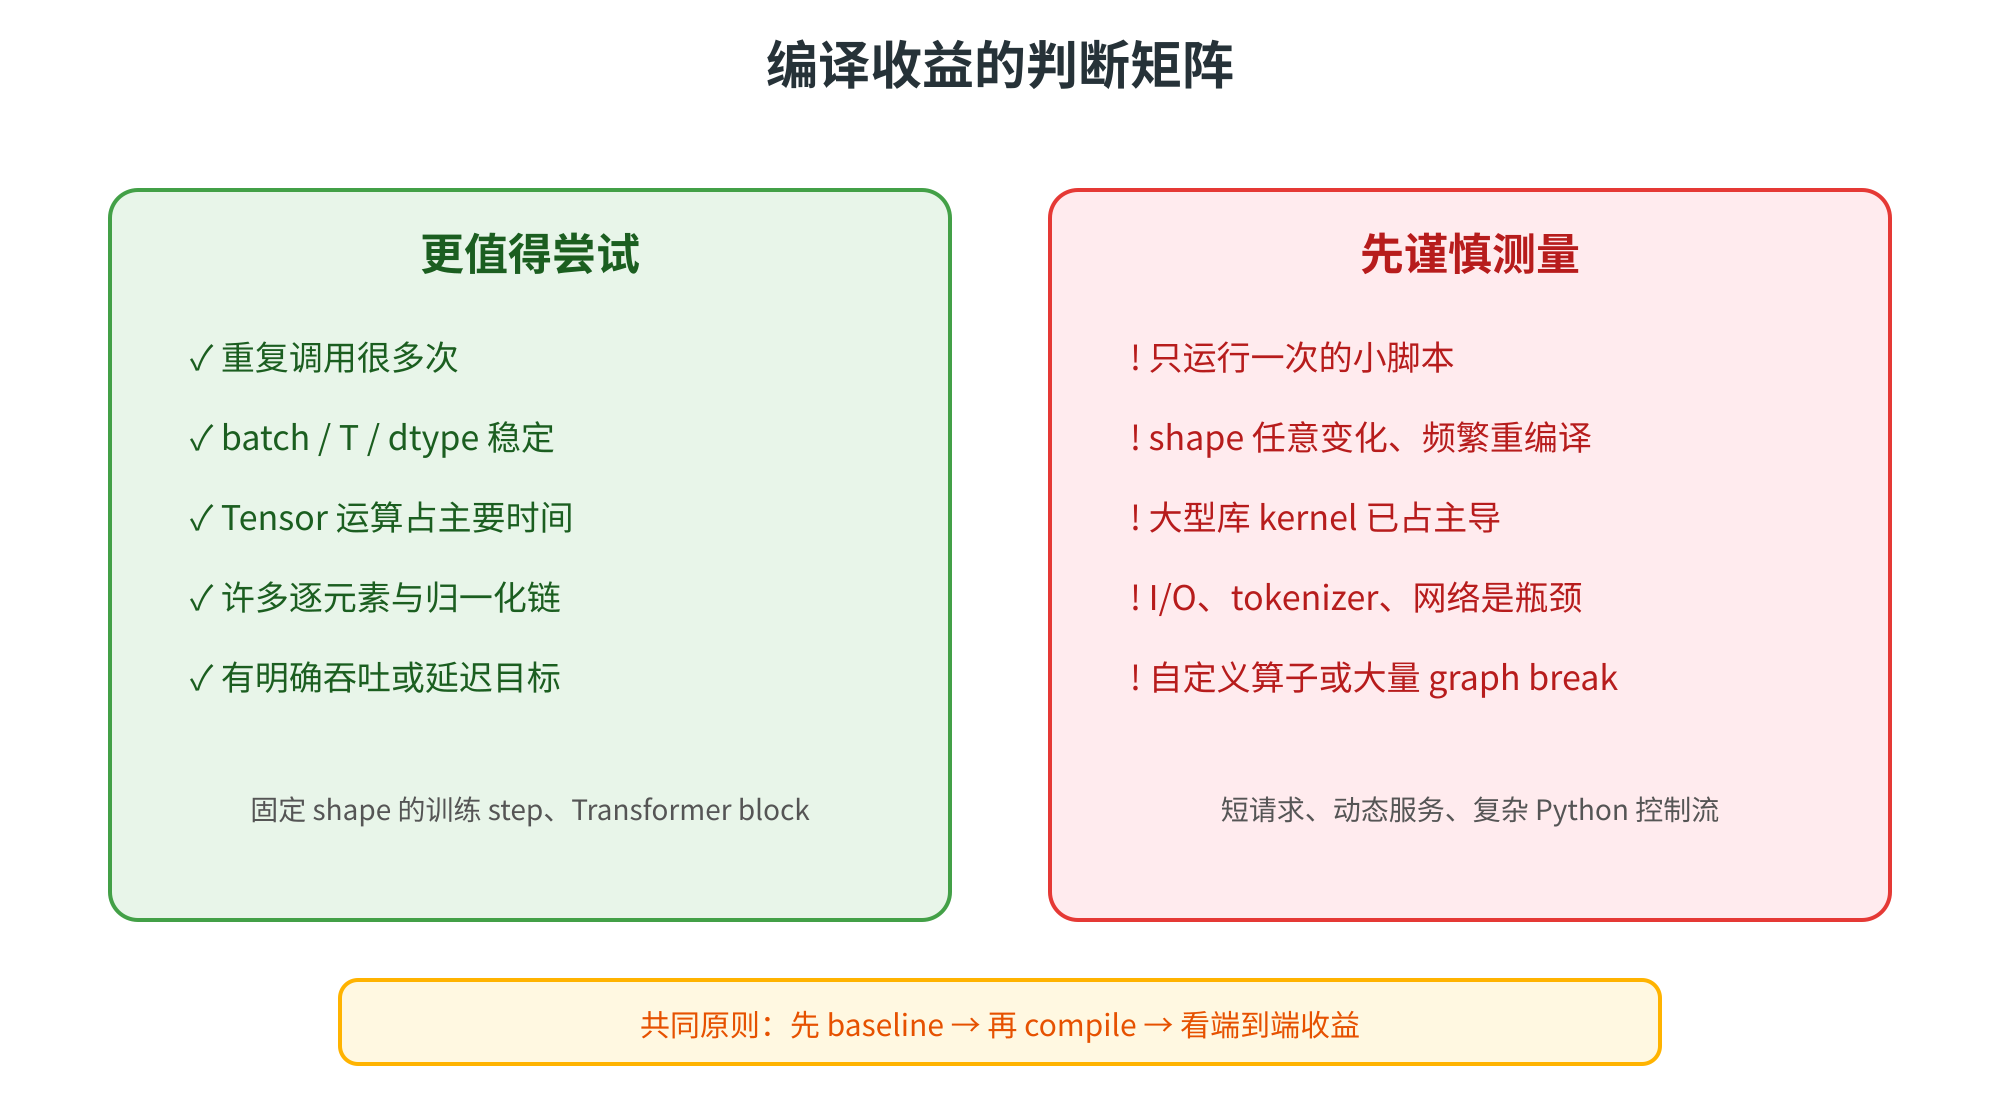
图4 编译收益的判断矩阵:重复、稳定与图完整性
4.4 用 profiler 识别“该不该编译”
在 compile 前先做一次短 profile。若时间线里有大量短小的逐元素 kernel、aten::copy_、类型转换和 Python 调度间隙,编译和融合值得尝试。若绝大部分时间集中在少量大型矩阵乘法,先检查矩阵 shape、dtype、Tensor Core 利用率、数据加载和通信;compile 可能不是第一优先级。
compile 后再 profile 时,区分首次调用和稳定调用。首次调用的捕获事件不应与 steady-state kernel 混在同一张图里,否则会误判。对服务还要把 prefill 和 decode 分开:前者可能受大矩阵和输入搬运影响,后者可能受 KV Cache 带宽、调度和小 batch 影响,优化结论不能互相代替。
AI Infra 视角:生产优化的对象不是单个 kernel 的漂亮数字,而是单位成本下的有效请求。把编译时间、GPU 利用率、tokens/s、p99、显存峰值、错误率和 worker 启动时间放在一张仪表盘上,才能知道局部加速是否真的改善服务。
五、从训练到推理服务:把 compile 放进系统
5.1 训练:编译 model,而不是编译实验脚本
训练场景往往最适合摊薄编译成本。可以在构建 optimizer 前后测试模型包装关系,并固定 batch、序列长度和 AMP 配置。实际工程要留意 optimizer 是否持有原参数、checkpoint 保存的是原模块还是编译包装对象,以及恢复训练时是否重新 warmup。建议先在少量 batch 上跑 eager 和 compile 的 loss、梯度有限性和速度,再扩大训练规模。
import torch
from torch import nn

model = nn.Sequential(nn.Linear(128, 256), nn.GELU(), nn.Linear(256, 10)).cuda()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
compiled_model = torch.compile(model, mode="default")

for step in range(3):
    x = torch.randn(32, 128, device="cuda")
    target = torch.randint(0, 10, (32,), device="cuda")
    optimizer.zero_grad(set_to_none=True)
    with torch.autocast(device_type="cuda", dtype=torch.bfloat16):
        loss = nn.functional.cross_entropy(compiled_model(x), target)
    loss.backward()
    optimizer.step()
    print(step, float(loss.detach()))
示例假定有 CUDA 和支持 BF16 的设备;没有 GPU 时不要直接复制 .cuda()。这段代码的重点是结构:AMP 和 compile 是两个独立开关,必须在目标硬件上分别做对照。训练中如果使用梯度累积、checkpoint 或分布式包装,编译边界要通过小规模测试确认。
5.2 推理:冷启动、热路径与 batch
推理服务可以把模型加载、编译预热和请求处理分成三个阶段:启动阶段加载权重;预热阶段用代表性 shape 调用 compiled model;热路径只做 token 化、batch 调度、模型调用和结果后处理。预热输入应覆盖主要 shape,但不要为了覆盖所有可能长度而制造无限多编译变体。
请求 batching 会改变输入 shape 和延迟分布。静态 batch 容易编译,但可能等待请求;动态 batch 提高利用率,却可能触发更多 shape。连续 batching、padding bucket、最大 batch 和最长上下文都需要与 compile 策略一起设计。后续第 47 篇会专门讨论 KV Cache、batching 和采样,这些机制会决定 decode 阶段是否能真正把编译收益转化为吞吐。
5.3 观测编译本身
服务端至少记录这些字段:模型版本、PyTorch/CUDA/GPU、编译 mode、输入 bucket、是否 cold、compile time、graph break/重新编译次数、batch、输入输出 token 数、p50/p95/p99、GPU 显存与错误类型。发生长尾时,要能回答是排队、tokenizer、编译、prefill、decode、显存回收还是网络返回慢。
不要在请求线程里无界等待编译。可以在部署前离线预热,或让新 worker 先进入 warming 状态,完成主要 bucket 后再接收流量。升级模型或后端时,让缓存按版本失效,避免旧代码生成物与新权重、驱动混用。
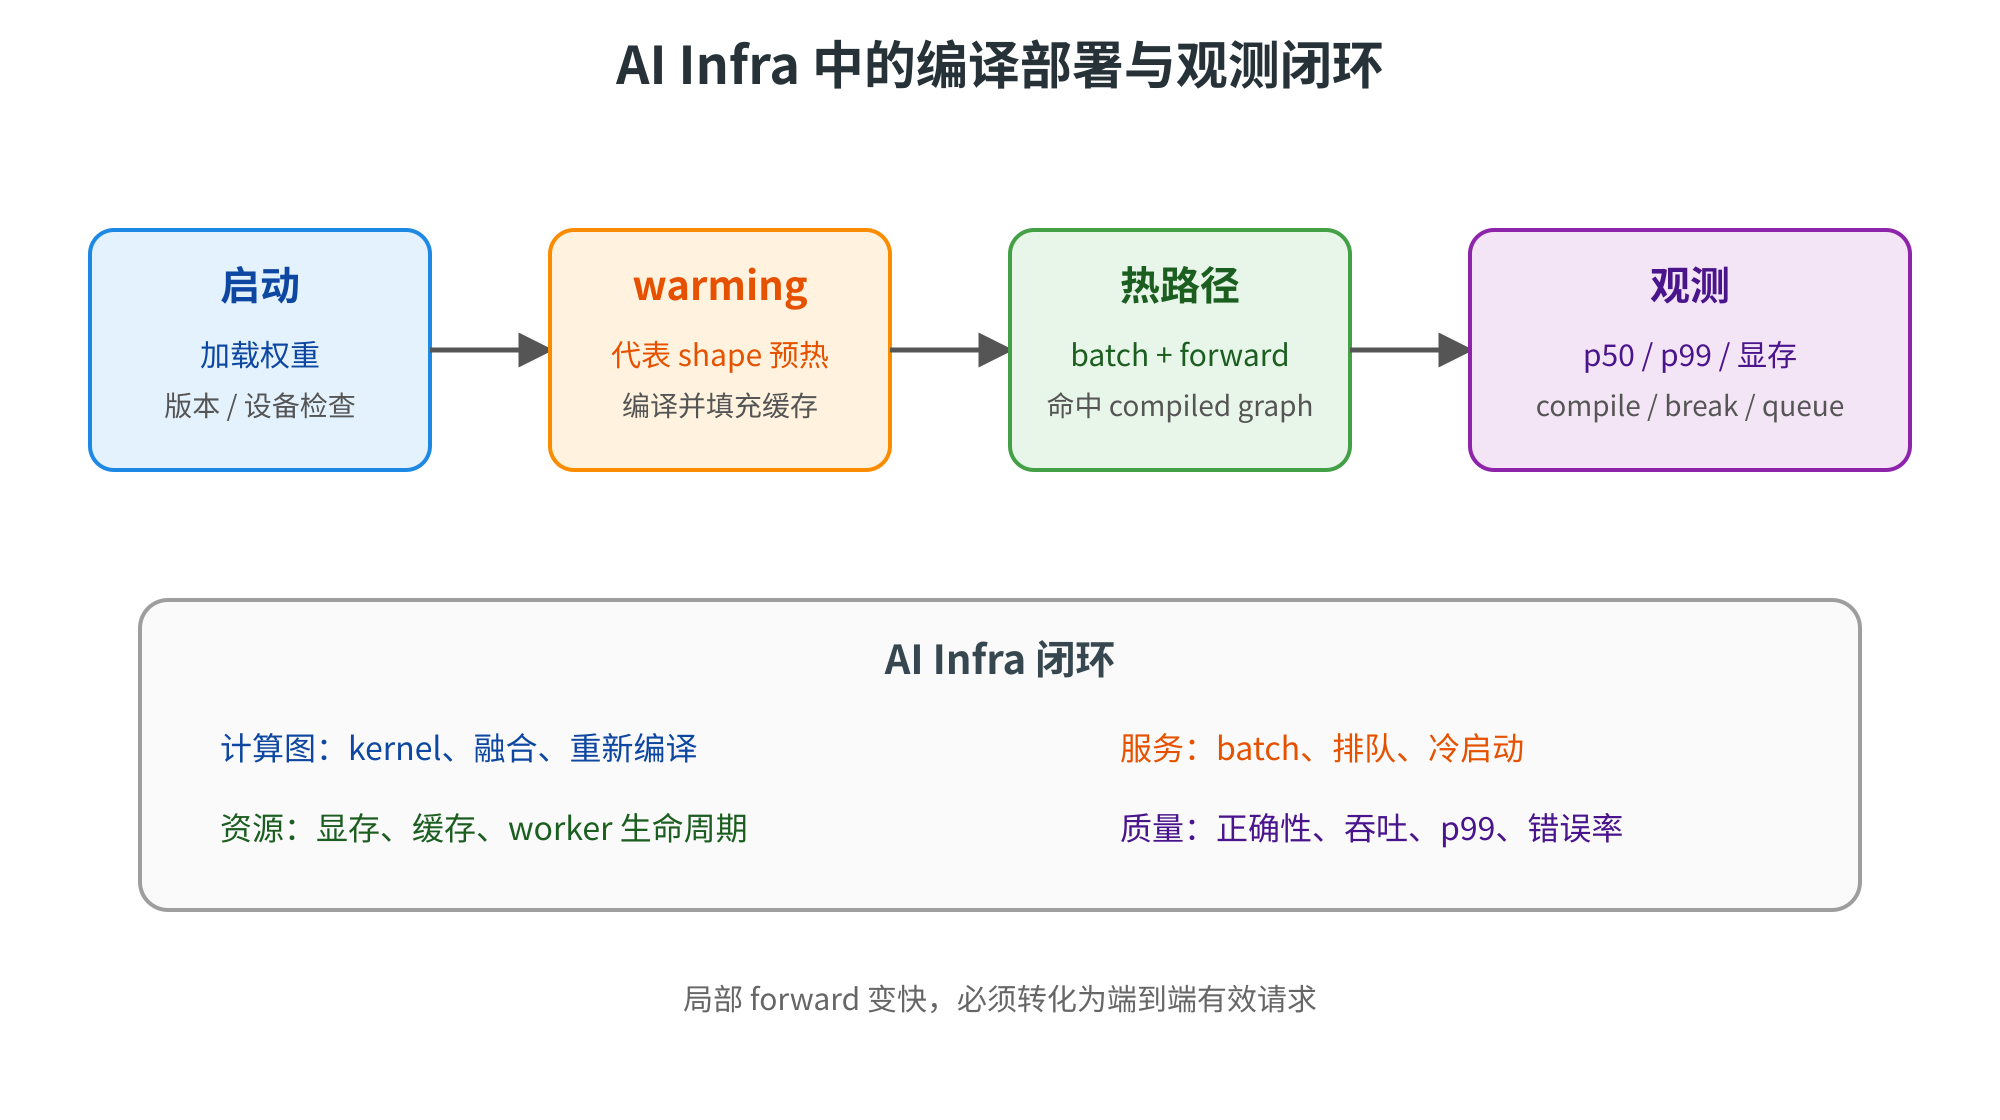
图5 AI Infra 中的编译部署与观测闭环
5.4 与 vLLM、SGLang 的关系
torch.compile 是 PyTorch 程序级的图编译和代码生成能力;vLLM、SGLang 等推理系统则在更高层管理请求调度、KV Cache、continuous batching、分页内存和模型执行。它们可能在内部使用编译或专用 kernel,但二者不是简单的互相替代。
理解 compile 的价值在于:当你使用这些系统时,仍能读懂“为什么某个模型 shape 会重新编译”“为什么 cache 变体导致启动时间上升”“为什么一个 kernel 变快但 p99 没改善”。AI Infra 工程师要同时看计算图、显存生命周期和请求队列,而不是只看某一个框架开关。
六、一次可复现的 compile 实验
6.1 先写实验假设
不要从“打开 compile 看看”开始。先写一句可检验的假设,例如:“固定 [B,T,D] 的 Transformer block 中存在大量逐元素和归一化读写;default 编译后,在完成一次 warmup 后,稳定 step time 降低至少 10%,loss 趋势和峰值显存不恶化。”
然后固定模型、随机种子、输入 shape、dtype、设备、batch、训练/推理模式、warmup 次数和重复次数。保存 eager、compile、compile + AMP 三组结果;如果换 mode 或 dynamic 参数,另起一组,不要覆盖 baseline。
6.2 训练与推理都要做正确性检查
推理至少比较输出 shape、有限性和容差;训练比较若干步 loss、梯度有限性、参数更新是否发生。随机输入要固定或使用同一批输入,避免数据变化掩盖执行路径变化。
import torch


def check_close(eager, compiled):
    torch.testing.assert_close(eager, compiled, rtol=1e-3, atol=1e-4)
    assert torch.isfinite(compiled).all(), "compiled output is not finite"

x = torch.randn(8, 128)
model = torch.nn.Linear(128, 4).eval()
compiled = torch.compile(model)
with torch.inference_mode():
    expected = model(x)
    actual = compiled(x)
check_close(expected, actual)
print("correctness: ok")
如果编译路径和 eager 路径的误差超出容差,先确认是否混用了不同 dtype、随机状态或训练/评估模式,再缩小到单个模块。不要为了让测试通过而无限放大容差;正确性问题应被定位,而不是被数字掩盖。
6.3 最小报告格式
hardware: GPU model / CPU
software: Python, PyTorch, CUDA, driver
model: layers, hidden, heads, parameters
input: batch, sequence, dtype, device
mode: eager / default / reduce-overhead / max-autotune
dynamic: None / True / False
warmup: first compile + N steady iterations
compile_time: seconds
result: p50, p95, tokens/s, peak allocated/reserved
correctness: max diff, loss trend, validation metric
graph: breaks, recompiles, shape buckets
finding: bottleneck, gain, next hypothesis
报告中同时保留 cold 和 steady-state。若稳定延迟从 10 ms 降到 8 ms,但每次新 worker 要编译 30 秒,要根据 worker 生命周期和流量计算摊销;若 GPU 时间下降却 p99 上升,可能是 batch 等待或重新编译造成的系统级问题。这个思路会把第 45 篇的 profiler baseline 延伸成真正的工程实验。
七、踩坑大全
坑 1:把第一次调用当作平均延迟。 现象是 compile 比 eager 慢很多。原因是首次调用包含捕获、代码生成和编译;单独记录 cold start,再测 warm steady-state。
坑 2:不做 GPU 同步就计时。 现象是结果异常快、重复运行波动大。CUDA 默认异步提交;计时前后用 torch.cuda.synchronize(),并说明同步边界。
坑 3:以为 torch.compile 保证全模型融合。 编译器会遇到 graph break、外部函数和不支持算子。用 profiler、诊断输出和 fullgraph=True 的小实验定位,不要凭装饰器判断结果。
坑 4:把 fullgraph=True 当生产默认值。 它适合暴露不能捕获的边界,但会牺牲对复杂代码的容错。先用它诊断,再决定是否重构代码或接受局部 eager。
坑 5:输入长度任意变化却不观察重新编译。 现象是线上偶发长尾、CPU 内存上涨。原因是 guard 不满足并产生新图;使用 bucket、padding、上限和编译次数监控。
坑 6:把 dynamic=True 当成一定更快。 动态图减少部分专用编译,但可能失去固定 shape 的优化。比较 dynamic、静态 bucket 和实际请求分布,不要只跑一个输入。
坑 7:只看 kernel 数量,不看端到端结果。 融合可能减少 kernel,却增加寄存器压力、编译成本或排队时间。最终同时看 step time、tokens/s、p99、显存和正确性。
坑 8:compile、AMP、batch、shape 一次全改。 这样无法归因。先建立 eager FP32 baseline,再逐项增加 AMP、compile 和 batch,保留每组实验报告。
坑 9:在 DataLoader、tokenizer 和网络 I/O 外层盲目 compile。 这些部分通常不是可融合 Tensor 图。先编译稳定的模型核心,把 I/O 和调度留在服务层。
坑 10:保存和恢复时忽略包装对象。 现象是 checkpoint、optimizer 或部署对象不一致。明确保存原模型权重、配置和版本;恢复后在目标进程重新构建并预热 compile 路径。
坑 11:没有 GPU 却复制 CUDA 专用示例。 .cuda()、CUDA Graph 和某些 autotune 路径需要目标环境。CPU 先做功能检查,性能结论必须回到目标 GPU 验证。
坑 12:把局部 benchmark 当成服务收益。 模型 forward 变快不代表请求 p99、吞吐和成本都改善。把排队、batch、tokenizer、KV Cache、网络和 worker 启动纳入端到端测量。
八、小结
- eager mode 灵活但可能产生许多 Python 调度和短小 kernel;
torch.compile试图捕获稳定 Tensor 图并缓存生成代码。 - graph break 会把编译区域切回 eager;guard 不满足可能触发重新编译,所以要管理控制流、shape 和缓存变体。
default适合建立基线,reduce-overhead偏向降低调用开销,max-autotune愿意用更多编译成本换潜在性能;模式不是速度保证。- 算子融合主要减少 kernel launch 和中间显存往返,但可能受到寄存器、布局、成熟库 kernel 和动态 shape 的限制。
- Inductor 在图捕获之后做调度、融合和代码生成,GPU 常见 Triton/库 kernel 路径;最终要用 profiler 验证,而不是猜测。
- 编译优化必须和 AMP、benchmark、正确性检查、shape bucket、冷启动与 p99 观测放在同一条 AI Infra 闭环里。
九、课后练习
- (基础) 用
torch.compile包装一个Linear + GELU + Linear,分别运行 eager 和 compiled,检查 shape、有限性和最大绝对误差。 - (基础) 写一个包含首次调用、10 次 warmup、30 次稳定测量的 benchmark;在 CPU 和 CUDA(若可用)上比较同步前后的计时差异。
- (理解) 对比
default、reduce-overhead和max-autotune,记录 compile time、steady-state 延迟、p95 和峰值显存,解释差异。 - (理解) 构造包含
.item()、Python 分支和纯 Tensor 分支的函数,使用fullgraph=True做小实验,说明哪些代码触发 graph break。 - (进阶) 用第 45 篇 profiler 分别观察 eager 和 compile 的稳定 step,比较 kernel 数量、
aten::copy_、GPU time 与首次编译事件。 - (AI Infra) 模拟长度为 128、256、512、1024 的请求,比较任意动态 shape、padding bucket 和固定 shape 的编译次数、显存与 p95。
- (进阶) 把 AMP 与 compile 组合成四组实验:eager/compile × FP32/AMP,固定输入和随机种子,写出性能收益真正来自哪里。
- (综合) 为一个推理 worker 设计 warming、缓存失效、编译次数、p50/p95/p99 和显存告警指标,并说明模型升级时如何避免旧缓存污染。
下一篇预告
第47篇|推理基础:KV Cache、batching、采样。本篇把计算图从 eager 推向编译执行,下一篇转向生成式推理的运行时:理解 prefill 与 decode 的差异,推导 KV Cache 的形状与显存增长,比较静态 batching、continuous batching 和请求排队,并实现 temperature、top-k、top-p 等采样策略。之后第 48 篇会把这些能力接到 vLLM、SGLang 与 Agent 框架,形成从 PyTorch 模型到 AI Infra 服务的完整路线。