
第42篇|优化器、损失函数与学习率调度
本篇定位:专栏四「PyTorch 与 AI Infra 入门」的第六篇。承接第 41 篇的
Dataset、DataLoader和训练循环,把“算出梯度”之后的目标函数、参数更新策略与学习率时间表补齐。读完你将能够:解释 MSE 与交叉熵(Cross Entropy)的直觉和标签约定;使用
optim.SGD、Momentum、Adam/AdamW;正确安排zero_grad()、backward()、step();配置StepLR与余弦调度;从 batch size、吞吐、显存和有效学习率的关系诊断训练问题。预计用时:阅读 55~75 分钟,动手 60~90 分钟。
第 41 篇把数据从 Dataset 送进 DataLoader,并手写了 parameter -= learning_rate * parameter.grad。这已经是一个完整训练循环的骨架,但生产代码不会把更新规则散落在循环里:我们需要明确回答“错得多不多”“梯度怎样变成更新”“更新步子随训练怎样变化”。这三个问题分别对应损失函数、优化器和学习率调度器。
可以把训练想成在地形上找低谷。模型参数是当前位置,损失函数把当前位置映射成高度,梯度指出最陡的上坡方向,优化器决定沿反方向怎么走,学习率调度器则决定不同阶段迈多大的步。第 41 篇的 batch、model.train()、backward() 都会在本篇继续出现;下一篇第 43 篇会把这里的组件接到手写 Attention 与 Transformer Block 上。
一、损失函数:把“预测好不好”变成一个数
1.1 从目标到误差
损失函数(loss function)是一个可微的评分器。它接收模型输出 prediction 和目标 target,返回一个通常为标量的 Tensor。训练循环要最小化这个数,而不是直接最小化某个参数。一个好的损失函数需要同时满足三件事:能表达任务目标,能对参数产生有用的梯度,并且数值尺度适合优化。
回归任务的最直观选择是均方误差(Mean Squared Error,MSE):
MSE = mean((prediction - target) ** 2)
误差被平方后,正负误差不会互相抵消;大误差会被更强地惩罚。比如误差为 1 和 3 时,平方后的贡献分别是 1 和 9,所以 MSE 会推动模型优先修正离目标很远的样本。它适合温度、坐标、价格以及第 41 篇中的 y = 3x + 2 这类连续数值。
import torch
from torch import nn

prediction = torch.tensor([[2.0], [5.0]])
target = torch.tensor([[3.0], [1.0]])
loss = nn.MSELoss()(prediction, target)
print(loss.item())
两个误差是 -1 和 4,平方的平均值是 (1 + 16) / 2 = 8.5。这个小例子提醒我们:不要凭印象写日志,先用公式和实际 Tensor 检查 shape、配对关系与归约方式。代码的预期输出是:
8.5
nn.MSELoss(reduction="mean") 默认对所有元素求平均。若设置 reduction="sum",batch 变大时 loss 也会随元素数量变大;这会改变梯度尺度,不能只看数字大小判断模型变好还是变坏。做跨实验比较时,要固定 reduction、batch size 和统计分母。
1.2 分类为什么常用交叉熵
分类模型通常输出每个类别的 logits(未归一化分数),例如三分类输出 [2.0, 0.3, -1.0]。交叉熵(Cross Entropy)希望正确类别拥有较高分数,并惩罚模型把概率质量放错地方。可以把它理解为“目标类别被模型分配的概率越小,惊讶程度越高”:
CE = -log(p_of_correct_class)
nn.CrossEntropyLoss 的输入是 logits,不是手动做过 softmax 的概率;它在内部组合了 log_softmax 和负对数似然,数值上更稳定。标签通常是类别索引,dtype 必须为 torch.long,shape 通常是 [batch],而不是 one-hot 的 [batch, classes]。
import torch
from torch import nn

logits = torch.tensor([[3.0, 0.1, -1.0], [0.2, 2.4, 0.0]])
labels = torch.tensor([0, 1], dtype=torch.long)
loss = nn.CrossEntropyLoss()(logits, labels)
print(round(loss.item(), 4))
print(logits.argmax(dim=1).tolist())
0.1272
[0, 1]
如果把 softmax(logits) 再传给 CrossEntropyLoss,有时仍能运行,却相当于重复做了一次概率变换,可能造成梯度变差。推理阶段要概率时才调用 softmax;训练阶段通常直接把 logits 交给交叉熵。
1.3 loss 的 shape 是训练契约
损失函数不只规定数学公式,也规定输入输出契约。二分类可以使用单个 logit 配合 BCEWithLogitsLoss,目标通常是浮点 0/1;多分类用 CrossEntropyLoss,目标是整数类别;多标签任务则可能使用每个类别独立的二元目标。不要仅凭“都是分类”就互换它们。
import torch
from torch import nn

# 二分类:logit 和 target 都是 [batch],target 为 float
logits = torch.tensor([1.2, -0.7])
target = torch.tensor([1.0, 0.0])
loss = nn.BCEWithLogitsLoss()(logits, target)
print(round(loss.item(), 4))
0.3332
在调试时,先打印 output.shape、target.shape、output.dtype、target.dtype,再检查 loss 是否是有限值。一个多余的 squeeze() 可能把 batch size 为 1 的 [1, 1] 变成标量,让问题直到最后一个 batch 才出现。
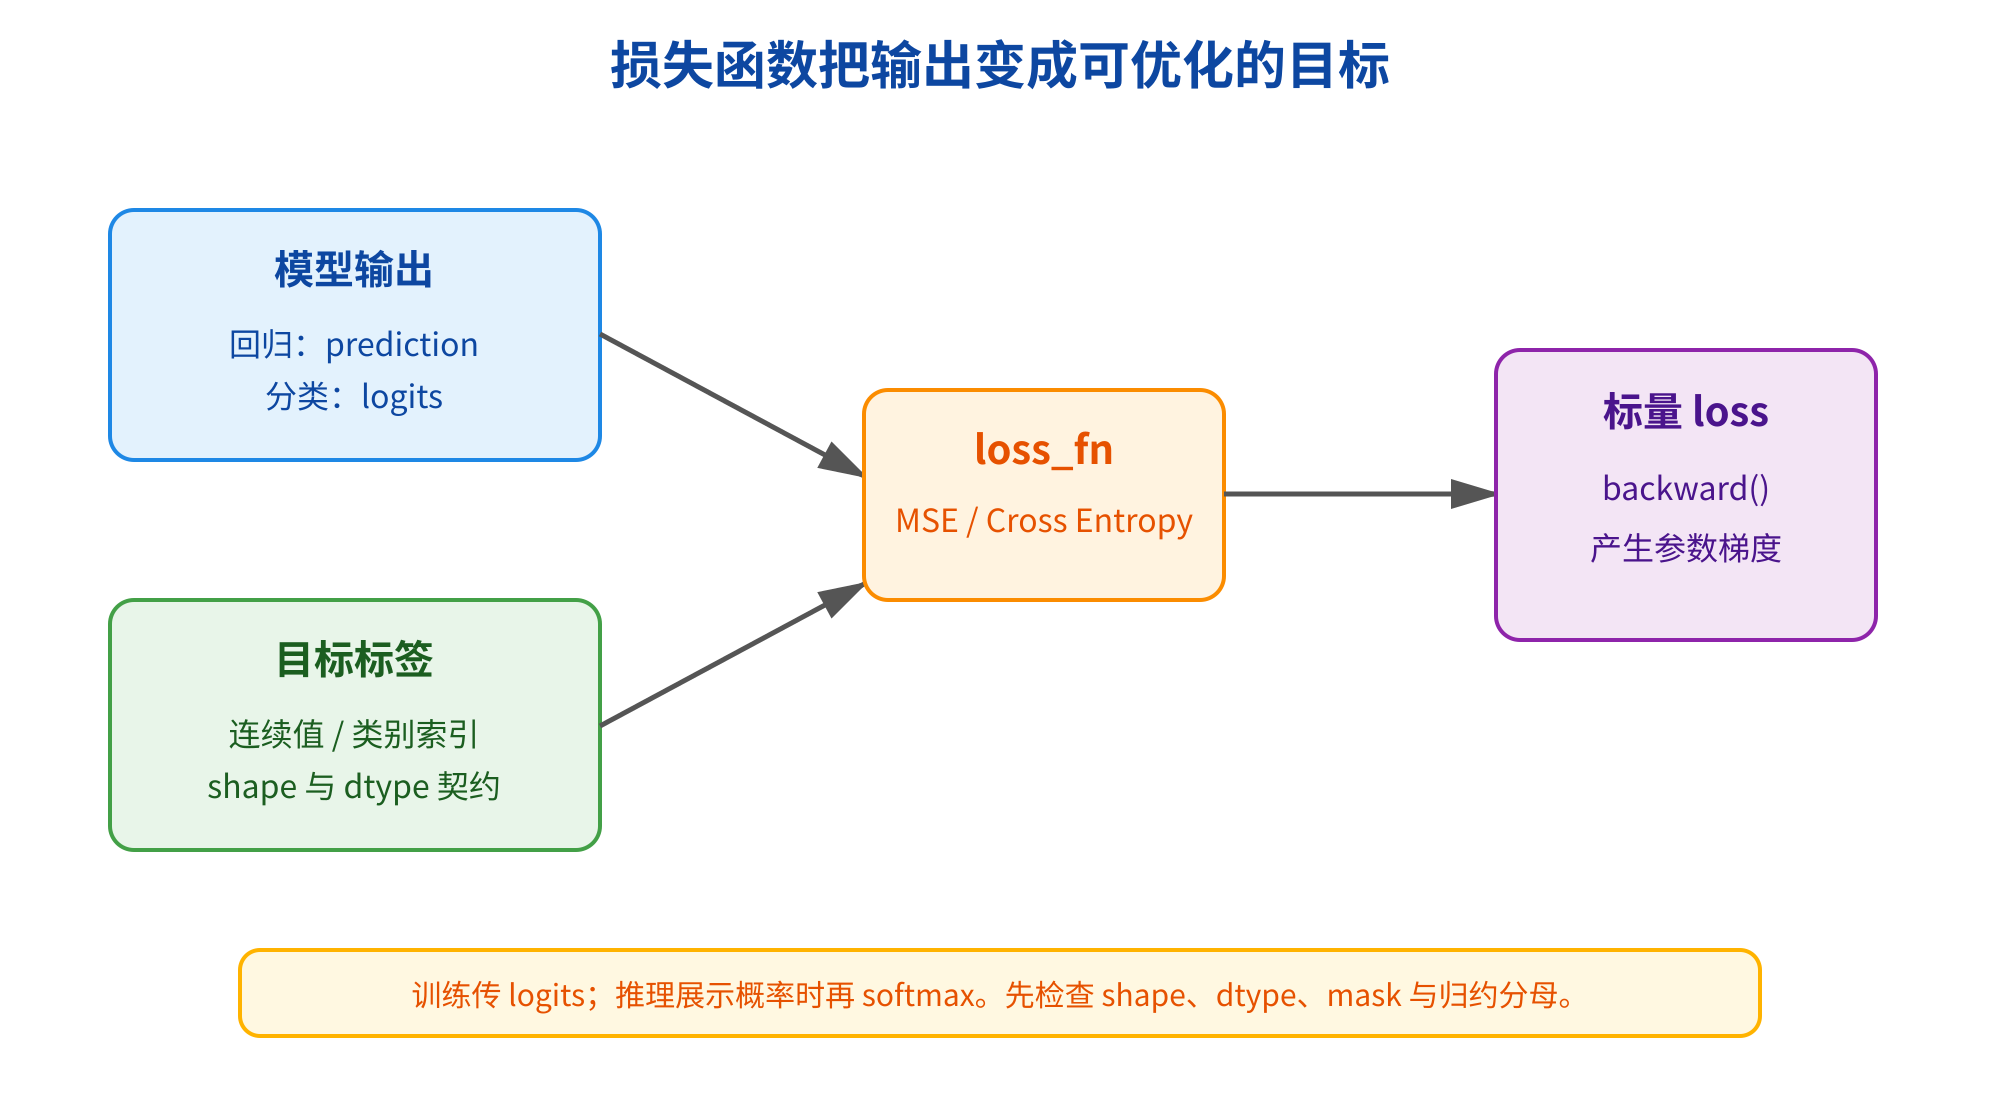
图1 从模型输出到损失的契约
AI Infra 视角:loss 是训练平台的可观测接口。除了平均 loss,还应记录 token 数、有效样本数、不同 mask 下的分母和异常值计数。语言模型的 padding 如果也参与平均,会让短序列和长序列的 loss 含义发生漂移。
二、优化器:梯度怎样变成参数更新
2.1 SGD 是最小的更新规则
随机梯度下降(Stochastic Gradient Descent,SGD)把第 41 篇的手写代码封装起来。对参数 θ 和梯度 g,最基本的规则是:
θ_next = θ - lr * g
lr 是学习率(learning rate),它不是模型自动学出的参数,而是训练策略中的超参数。SGD 每次使用一个 batch 的梯度近似全量数据梯度,因此 batch 顺序会带来噪声。适度噪声能帮助走出平坦区域,但学习率过大时会在谷底两侧来回跳,过小时则训练很慢。
import torch
from torch import nn

model = nn.Linear(1, 1)
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
print(optimizer.param_groups[0]["lr"])
0.1
优化器持有两类信息:要更新的参数引用,以及自己的超参数和状态。不要把临时 Tensor 而不是 model.parameters() 传给优化器,也不要在创建优化器之后悄悄替换模型参数,否则新参数可能没有被更新。
2.2 Momentum 和 Adam 为什么更会“记路”
带 Momentum 的 SGD 不只看当前梯度,还维护一个速度。直觉上,连续多个 batch 都指向相近方向时,速度会累积,更新更快;梯度方向来回抖动时,速度会起到平滑作用。这对狭长的损失谷地尤其有帮助:沿陡峭方向少来回震荡,沿平缓方向更稳定地前进。
Adam(Adaptive Moment Estimation)为每个参数维护梯度的一阶移动平均和平方梯度的二阶移动平均,再用它们调整每个坐标的步长。它通常比裸 SGD 更容易在初始阶段跑起来,适合很多模型的默认基线,但“更容易收敛”不等于一定泛化最好。AdamW 把 weight decay 从 Adam 的梯度更新中解耦,现代 Transformer 训练中很常见。
import torch
from torch import nn

model = nn.Sequential(nn.Linear(4, 8), nn.ReLU(), nn.Linear(8, 2))
sgd = torch.optim.SGD(model.parameters(), lr=0.05, momentum=0.9,
                      weight_decay=1e-4)
adamw = torch.optim.AdamW(model.parameters(), lr=3e-4,
                          betas=(0.9, 0.999), weight_decay=0.01)
print(type(sgd).__name__, type(adamw).__name__)
SGD AdamW
这里不要同时用两个优化器去更新同一组参数;示例只是展示配置。实验时一次只改变优化器、学习率或正则化中的一个主要因素,否则 loss 曲线变化无法归因。
2.3 参数组与优化器状态
不同模块可能需要不同学习率,例如预训练 backbone 用 1e-5,新加的分类头用 1e-3。可以使用参数组:
backbone = nn.Linear(4, 4)
head = nn.Linear(4, 2)
optimizer = torch.optim.AdamW([
    {"params": backbone.parameters(), "lr": 1e-5},
    {"params": head.parameters(), "lr": 1e-3},
], weight_decay=0.01)
print([group["lr"] for group in optimizer.param_groups])
[1e-05, 0.001]
Adam 的状态可能与参数同等数量级甚至更多,checkpoint 不能只保存 model.state_dict()。要支持断点续训,至少保存 optimizer.state_dict()、scheduler 状态、当前 epoch/step 和随机状态。只恢复模型权重而不恢复 Adam 的动量,重新开始时更新方向会突然改变。
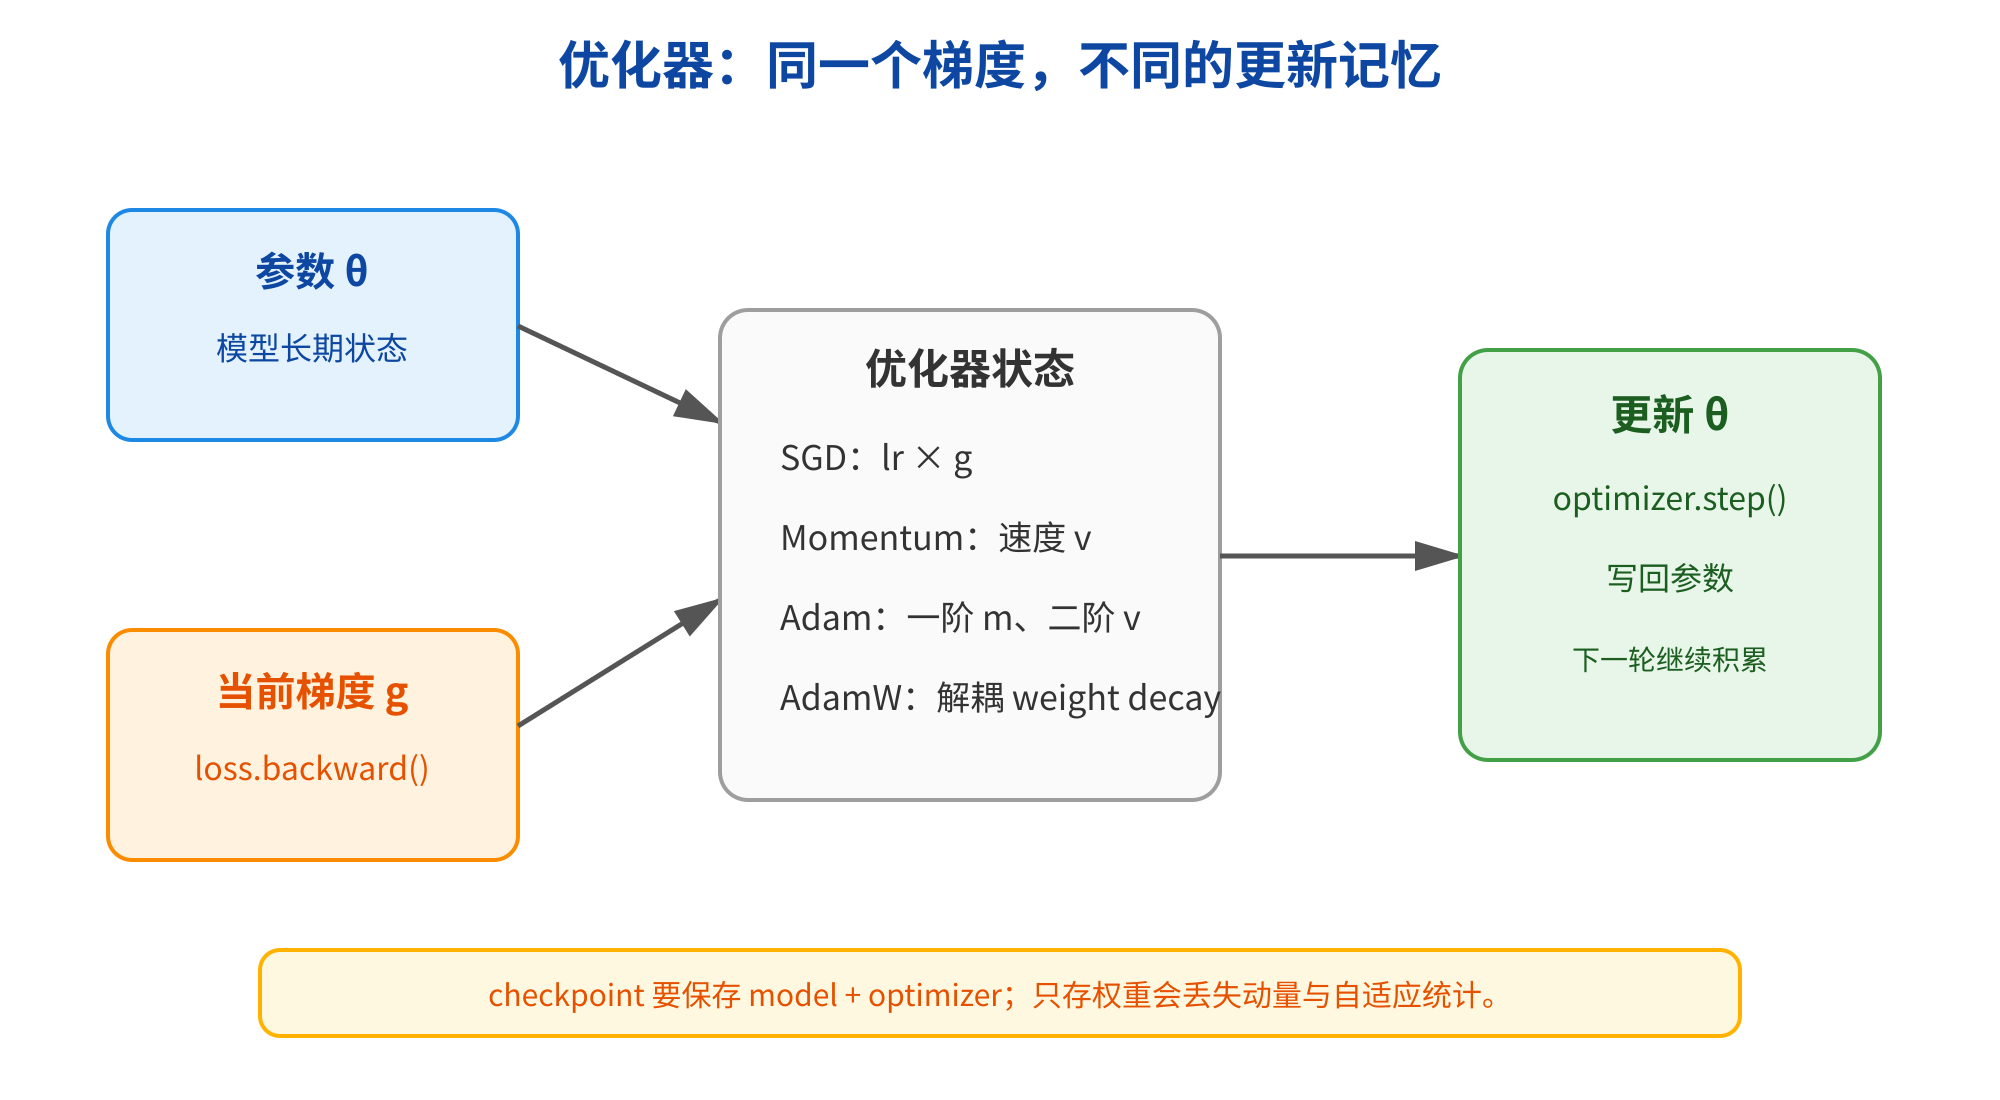
图2 SGD、Momentum 与 Adam 的状态
三、训练 step:顺序就是正确性
3.1 zero_grad、backward、step
使用优化器后,一个标准 step 的顺序通常是:
- 从
DataLoader取得一个 batch,并搬到目标device。 - 调用模型前向,得到 logits 或回归输出。
- 用正确的目标和 loss 计算标量损失。
- 调用
optimizer.zero_grad(set_to_none=True)清理上一步梯度。 - 调用
loss.backward(),让 autograd 把梯度写入参数。 - 必要时裁剪梯度或使用混合精度 scaler。
- 调用
optimizer.step()更新参数。 - 读取
loss.item()、当前学习率和吞吐,写入日志。
清梯度放在前向之后、反向之前也可以,但必须保证它发生在本轮 backward() 之前。梯度默认是累积的,这是梯度累积训练所需要的机制,却也是初学者忘记清零时的常见 bug。set_to_none=True 让 .grad 变成 None,通常节省一次填零,并能暴露没有参与本轮计算的参数。
for x_batch, y_batch in loader:
    optimizer.zero_grad(set_to_none=True)
    prediction = model(x_batch)
    loss = loss_fn(prediction, y_batch)
    loss.backward()
    optimizer.step()
更新操作由优化器在内部以不记录梯度的方式完成。不要手动在 step() 前后再次调用 backward(),也不要把 loss.detach() 后的 Tensor 拿去反向;detach 后已经切断了计算图。
3.2 把第 41 篇的回归任务接上优化器
下面的程序沿用第 41 篇的 y = 3x + 2,只把手写更新换成 MSELoss + SGD。它不依赖 GPU,适合先做 smoke test:
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(7)
x = torch.linspace(-1, 1, 64).reshape(-1, 1)
y = 3 * x + 2
loader = DataLoader(TensorDataset(x, y), batch_size=16, shuffle=True)

model = nn.Linear(1, 1)
loss_fn = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.2)

for epoch in range(20):
    model.train()
    total = 0.0
    for x_batch, y_batch in loader:
        optimizer.zero_grad(set_to_none=True)
        prediction = model(x_batch)
        loss = loss_fn(prediction, y_batch)
        loss.backward()
        optimizer.step()
        total += loss.item() * x_batch.size(0)
    if epoch in (0, 19):
        print(f"epoch={epoch + 1}, loss={total / len(loader.dataset):.4f}")

print(round(model.weight.item(), 2), round(model.bias.item(), 2))
epoch=1, loss=2.0...
epoch=20, loss=0.0...
3.0 2.0
精确的小数会随 PyTorch 版本和初始化略有变化,但 loss 应总体下降,参数应接近 3 和 2。注意我们用样本数加权累加 batch loss,再除以整个数据集大小;直接平均每个 batch 的 loss,在最后一个 batch 较小时会产生轻微偏差。
3.3 训练、验证与梯度裁剪
训练阶段调用 model.train(),验证阶段调用 model.eval() 并配合 torch.inference_mode()。优化器只在训练阶段调用;验证 loss 只是观测值,不能对它 step()。RNN、Transformer 或异常数据可能产生很大的梯度,这时可以在 step() 前裁剪:
loss.backward()
grad_norm = torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
optimizer.step()
print(float(grad_norm))
裁剪不是治疗学习率过大的万能药。它适合限制偶发爆炸,不能替代检查输入范围、loss 公式、初始化和数值精度。记录裁剪前的 norm,才能知道模型是否经常撞到阈值。
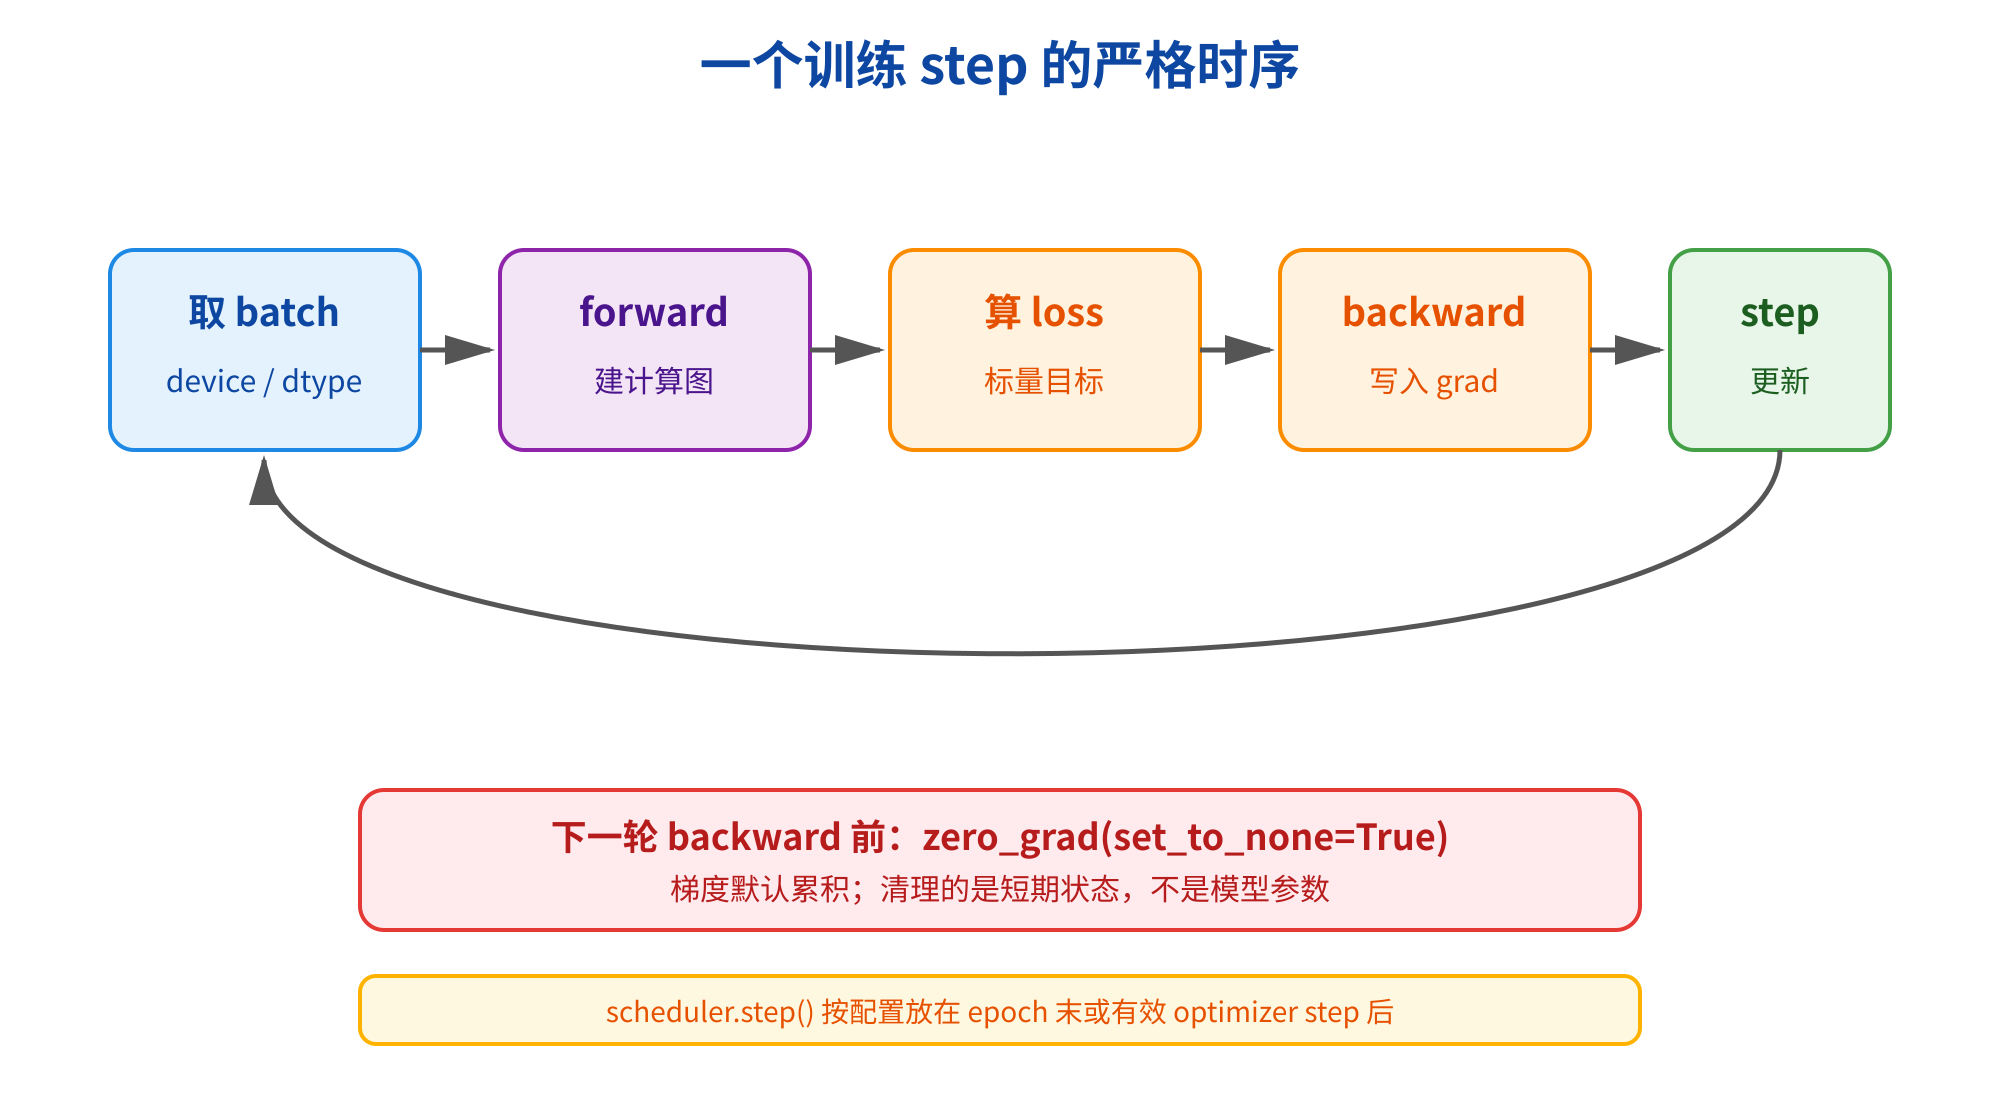
图3 一个可观测的训练 step
四、学习率调度:让步子随时间改变
4.1 为什么固定学习率不总够用
训练早期离目标很远,较大的学习率可以快速移动;训练后期接近低谷,较小的学习率有助于稳定收敛。固定学习率往往遇到二选一:一开始够快,后面震荡;后面够稳,一开始又太慢。学习率调度器(learning-rate scheduler)把 lr 变成 epoch 或 step 的函数,而不是每轮手写修改字典。
最简单的是 StepLR:每隔固定数量的 epoch,把学习率乘以 gamma。它像逐级下楼,易于解释、易于复现,适合教学和某些阶段明确的训练流程。
import torch
from torch import nn

model = nn.Linear(2, 1)
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=2, gamma=0.5)

for epoch in range(5):
    print(epoch, optimizer.param_groups[0]["lr"])
    # 这里省略真实的 forward/backward/optimizer.step()
    scheduler.step()
0 0.1
1 0.1
2 0.05
3 0.05
4 0.025
示例把调度器按 epoch 使用,所以每个 epoch 结束调用一次。若按每个 training step 调度,就要按照 step 的总数、warmup 步数和 checkpoint 语义重新计算 step_size,不能把 epoch 级配置直接照搬。
4.2 Cosine 的平滑下降
余弦调度(Cosine Annealing)让学习率从较高值平滑下降到较低值,曲线开始和结束都比较柔和。它没有 StepLR 那样突然的台阶,在训练 Transformer 或大规模视觉模型时常作为基线。直觉上,它给模型一段“快走”阶段,再逐渐收紧步子;T_max 表示一个余弦周期的长度。
import torch
from torch import nn

model = nn.Linear(2, 1)
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(
    optimizer, T_max=4, eta_min=1e-5
)
for step in range(5):
    print(step, f"{optimizer.param_groups[0]['lr']:.6f}")
    scheduler.step()
0 0.001000
1 0.000854
2 0.000505
3 0.000156
4 0.000010
实际项目还常用 warmup:前若干 step 从很小的学习率线性升到目标值,再进入 cosine 或其他衰减。warmup 能减少模型刚开始时随机初始化、放大 batch 或混合精度带来的不稳定,尤其适合大 batch 和 Transformer。调度策略不是越复杂越好,先建立固定 seed、固定数据和固定总步数的基线。
4.3 调度器的调用顺序与恢复
现代 PyTorch 通常建议先执行 optimizer.step(),再执行 scheduler.step(),这样第一个训练更新使用初始学习率。若反过来,某些版本会跳过调度表的第一个值,并出现警告。最可靠的做法是明确 scheduler 的粒度,并打印前几次学习率验证:
for batch in loader:
    optimizer.zero_grad(set_to_none=True)
    loss = loss_fn(model(batch[0]), batch[1])
    loss.backward()
    optimizer.step()
    scheduler.step()  # step-level scheduler 放在更新之后
恢复 checkpoint 时,加载顺序和计数单位很重要:先建立相同的优化器与 scheduler,再加载它们的 state_dict(),最后从保存的 epoch/step 继续。不要只把当前 lr 写回配置而忽略 scheduler 的内部计数,否则下一次 step() 可能从错误位置继续。
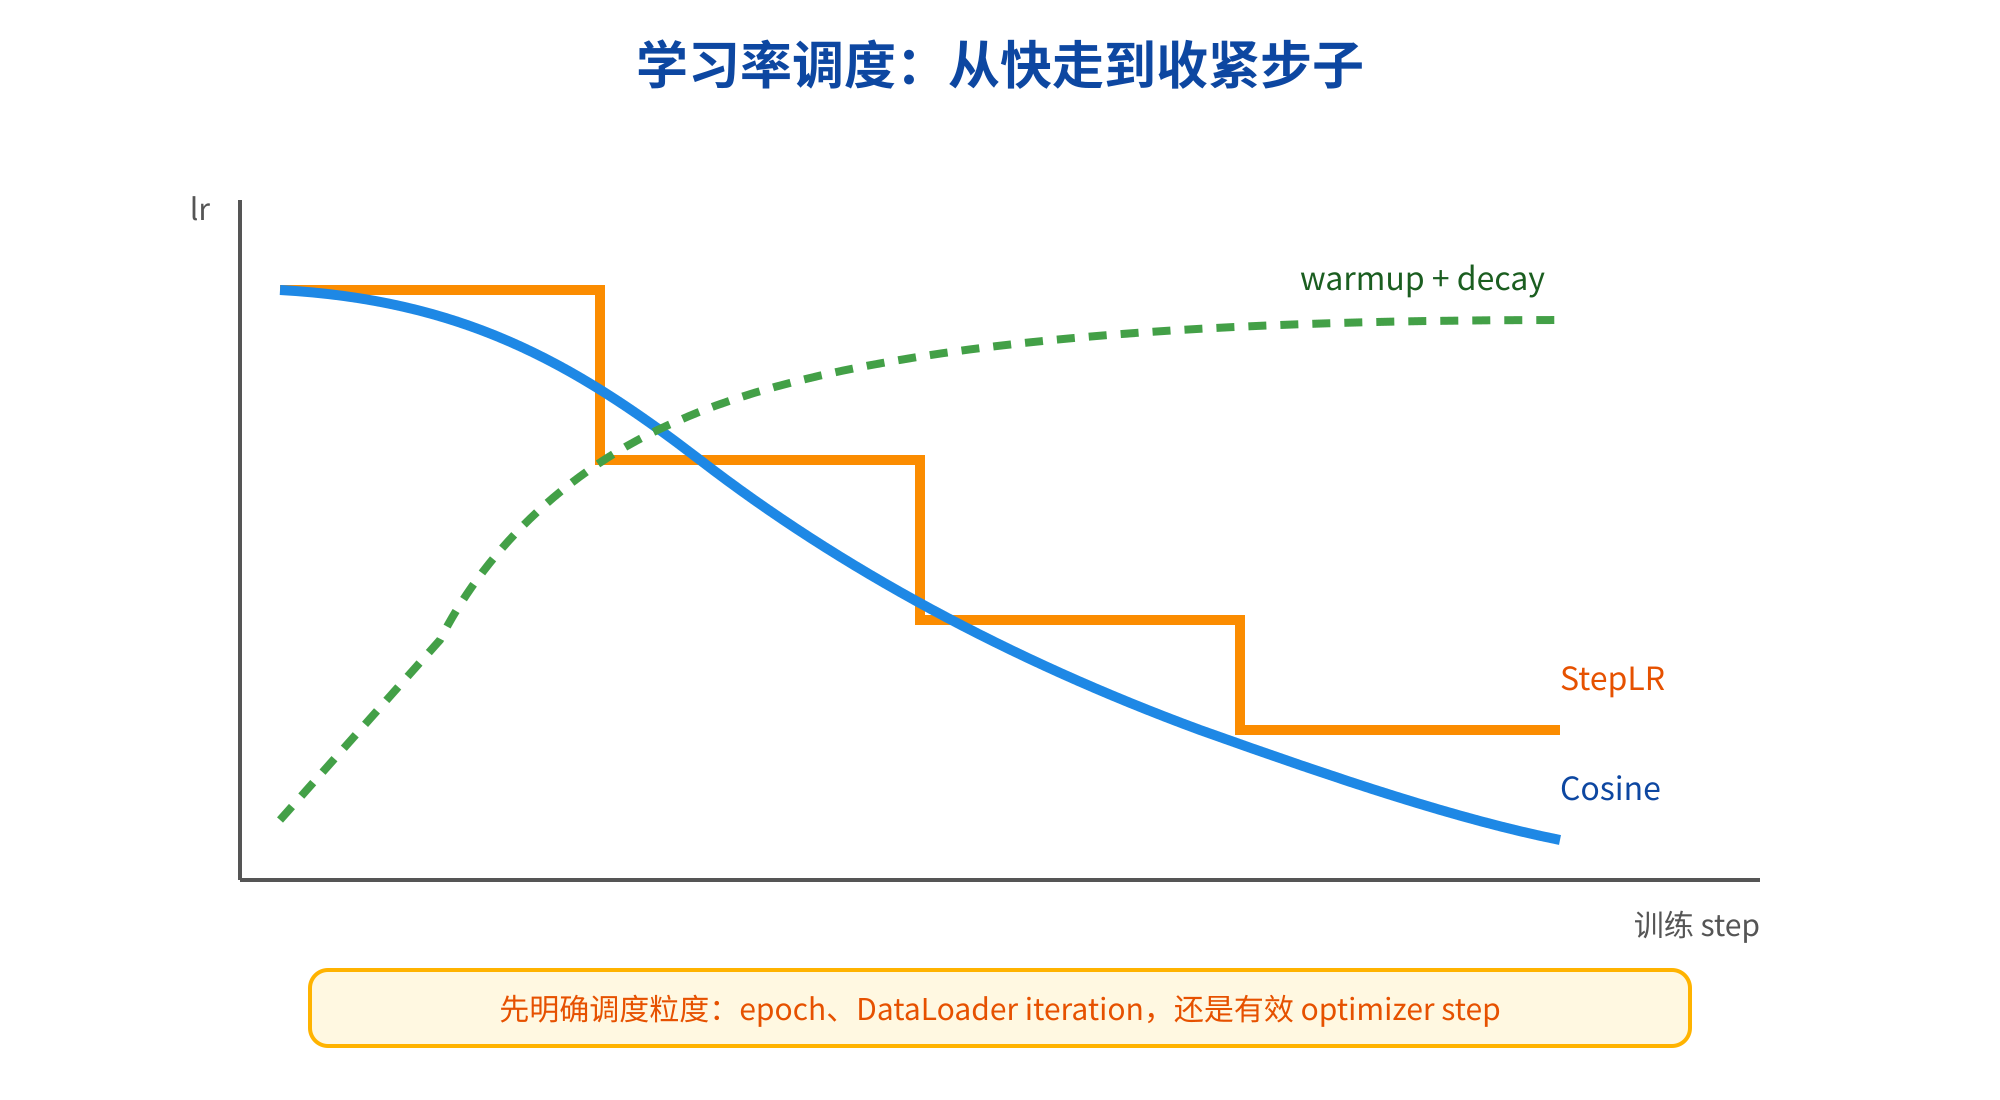
图4 StepLR 与 Cosine 学习率直觉
AI Infra 视角:调度器应当以“全局 step”理解,而不是以某台机器的本地循环次数理解。多卡训练中每个 rank 的 step 要对齐;梯度累积时,真正的 optimizer step 少于 DataLoader iteration,warmup 和日志也应按有效更新次数统计。
五、AI Infra:学习率、batch size 与系统吞吐
5.1 batch 变大,学习率能否一起变大
第 41 篇介绍了 batch_size 受显存、读取速度和梯度噪声共同约束。现在加上优化器后,batch 还会改变每次更新看到的样本数。小 batch 的梯度噪声大,更新频繁;大 batch 的梯度估计更平滑,但每次更新等待更久、显存占用更高、一个 epoch 内更新次数更少。
当把 batch size 从 B 扩大到 kB,常见的经验是对 SGD 尝试把学习率也扩大到 k * lr,这叫线性缩放规则;Adam 往往使用更保守的调整。它们只是起点,不是定律。大 batch 可能降低泛化、遇到通信瓶颈,或者因为数据读取和 kernel 利用率改变而无法带来实际加速。
显存不够时可以做梯度累积:连续 accumulation_steps 个 micro-batch 反向但不更新,累积后再 optimizer.step()。有效 batch 近似为:
micro_batch_size × accumulation_steps × data_parallel_world_size
要注意 loss 是否除以累积步数。通常把每个 micro-batch 的 loss 除以 accumulation_steps,这样累积梯度的尺度接近一次大 batch;只累积不缩放会把梯度放大,等价于偷偷改变学习率。
optimizer.zero_grad(set_to_none=True)
for micro_step, (x_batch, y_batch) in enumerate(loader):
    loss = loss_fn(model(x_batch), y_batch)
    (loss / accumulation_steps).backward()
    if (micro_step + 1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
最后不足一个累积窗口的 batch 要怎么处理,需要在训练配置中明确:丢弃、补齐,或在 epoch 末尾更新一次。日志里的 iteration、optimizer_step、samples_seen 不要混成一个数字。
5.2 用指标判断是不是“学习率问题”
loss 不下降时,不要第一反应就是把学习率调大或调小。先看一组最小指标:当前 lr、训练 loss、验证 loss、梯度 norm、参数 norm、NaN/Inf 计数、data time、compute time、samples/s 和 GPU memory allocated。若 loss 从第一步就 NaN,优先检查输入、标签、dtype 和数值溢出;若 loss 平稳但极慢,可能是数据或 kernel 瓶颈,不是优化器。
可以记录每个参数组的学习率,因为 backbone 和 head 可能不同。对于分布式训练,还要区分 local batch、global batch 和有效 batch;只打印 rank 0 的局部 loss 会误导排查。吞吐变化也要和学习率变化分开记录:调度器影响收敛速度,num_workers、pin_memory、通信和 batch shape 影响每秒处理多少样本。
混合精度下,半精度的可表示范围更窄。torch.amp.GradScaler 会在反向前缩放 loss,在更新前检查梯度,并在溢出时跳过本次更新、调整 scale。此时“每个 DataLoader batch 都调用 scheduler”尤其危险,因为 scaler 可能跳过 optimizer step,而 scheduler 却继续前进。若调度策略要求和真实更新对齐,就应围绕有效的 optimizer step 设计计数。
5.3 checkpoint 是系统状态,不只是权重
一个可恢复训练的 checkpoint 至少包含:模型参数、优化器状态、scheduler 状态、当前 epoch、全局 optimizer step、梯度累积配置、随机种子和数据版本。AI Infra 作业还应记录 world size、global batch、每个参数组的初始 lr、代码 commit、PyTorch/CUDA 版本和硬件信息。
保存后要实际加载并做一次恢复 smoke test:比较恢复前后的 lr、optimizer state 数量和下一 batch 的 loss,确认不是“文件存在但语义不一致”。节点抢占、训练队列迁移和弹性扩缩容都可能让恢复发生在不同 rank 或不同主机上;路径、设备映射和随机状态不能靠默认值猜测。
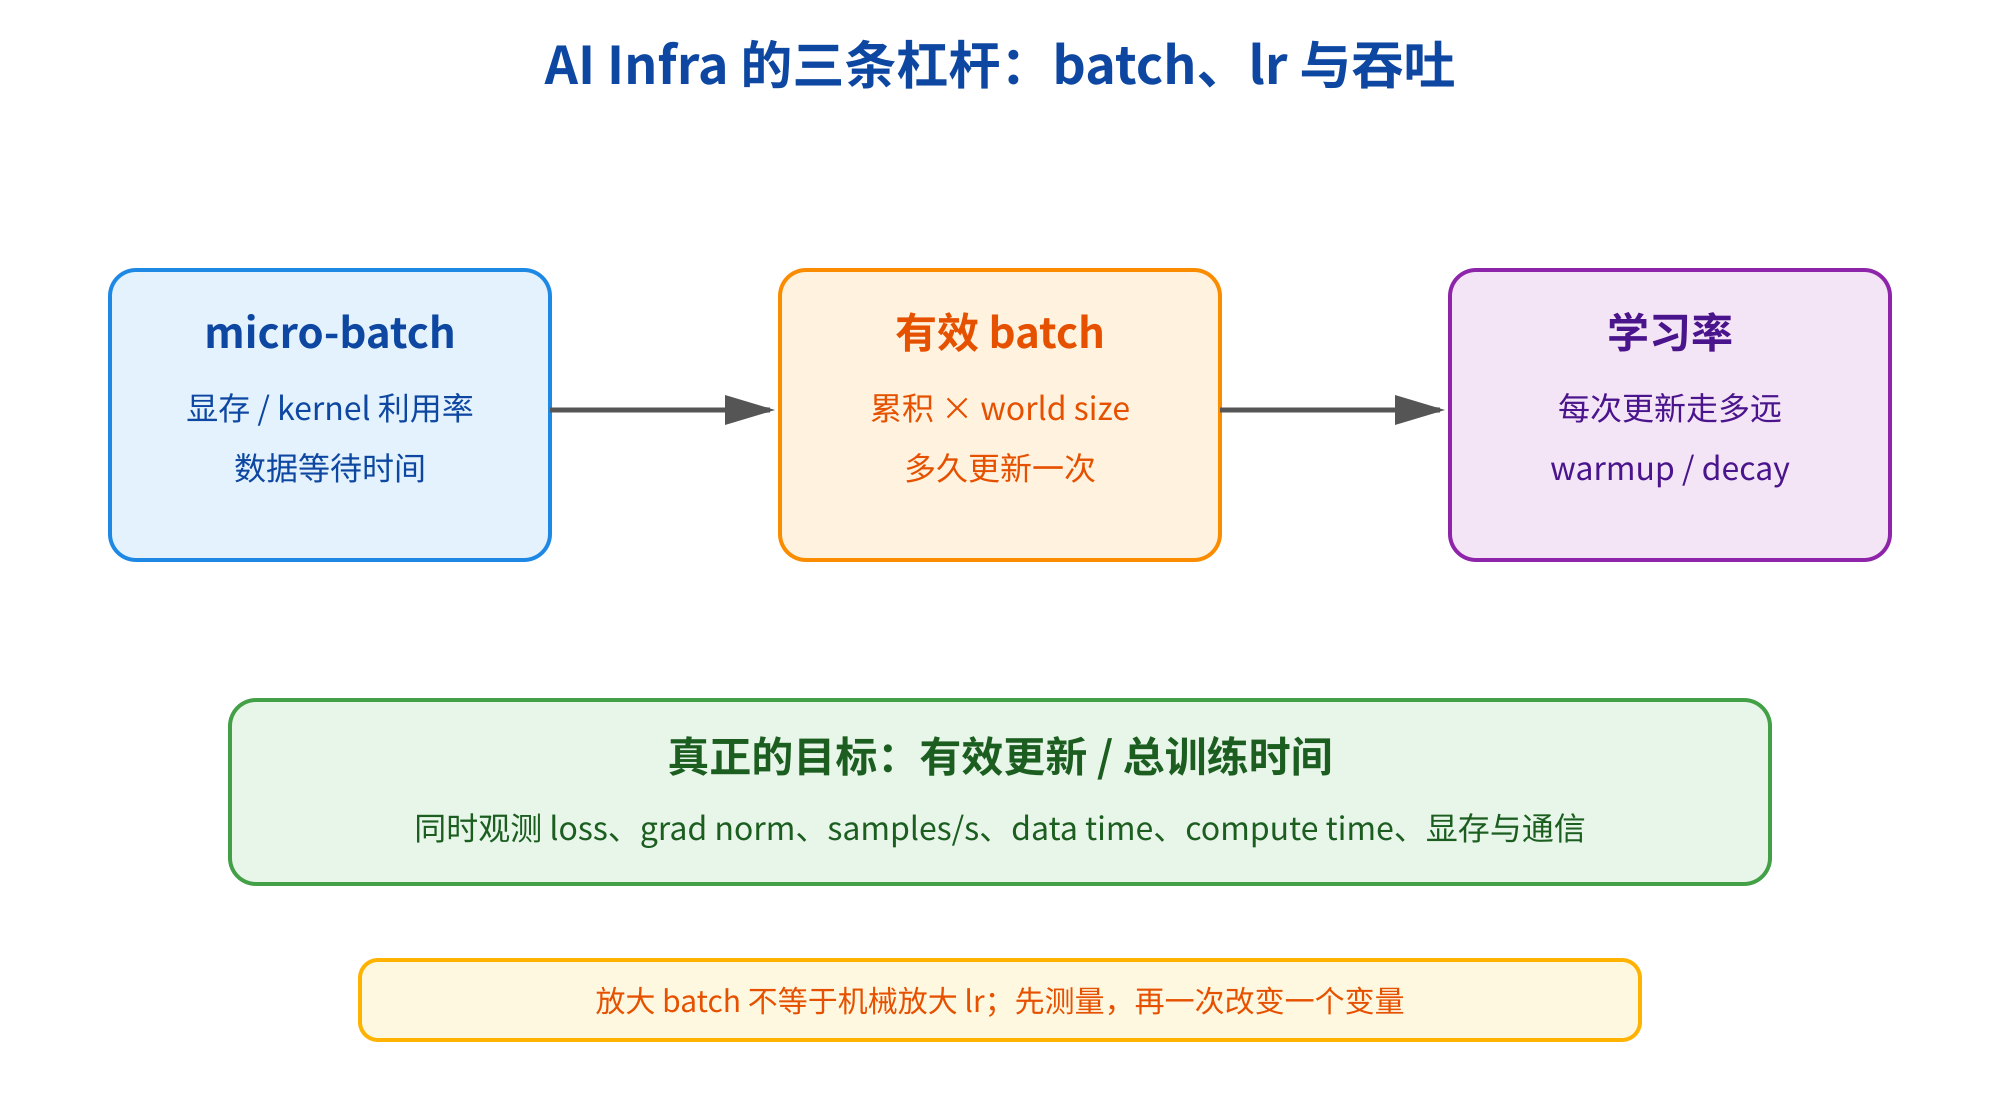
图5 从 batch 到更新的系统杠杆
AI Infra 视角:优化收敛与系统吞吐是两个闭环。学习率决定“每次更新走多远”,batch 和累积决定“多久更新一次”,数据管线与通信决定“每秒能完成多少次有效更新”。平台调优要同时报告 tokens/s 或 samples/s、每步耗时和达到目标指标所需的总时间。
六、一个可复用的配置与实验模板
把模型、数据、优化器和调度器分开配置,能让实验可比较,也方便第 43 篇复用。配置中要明确学习率的粒度是 epoch 还是 optimizer step:
from dataclasses import dataclass
import torch
from torch import nn

@dataclass
class TrainConfig:
    lr: float = 3e-4
    weight_decay: float = 0.01
    epochs: int = 3
    warmup_steps: int = 100
    accumulation_steps: int = 1

model = nn.Sequential(nn.Linear(8, 16), nn.GELU(), nn.Linear(16, 3))
cfg = TrainConfig()
optimizer = torch.optim.AdamW(
    model.parameters(), lr=cfg.lr, weight_decay=cfg.weight_decay
)
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(
    optimizer, T_max=1000, eta_min=cfg.lr * 0.1
)
loss_fn = nn.CrossEntropyLoss()

x = torch.randn(4, 8)
labels = torch.tensor([0, 1, 2, 1])
optimizer.zero_grad(set_to_none=True)
loss = loss_fn(model(x), labels)
loss.backward()
optimizer.step()
scheduler.step()
print(loss.ndim, optimizer.param_groups[0]["lr"])
0 0.000299...
先用一个 batch 验证 shape、dtype、device、loss 是否有限、梯度是否存在,再跑短实验。短实验中固定 seed,保存配置和前 20~50 个 step 的曲线;只有确认循环正确,才增加 worker、GPU 数、batch 或训练时长。这样出现异常时,可以判断是数学问题、数据问题、调度问题,还是系统吞吐问题。
对比实验最好使用表格记录:实验名、commit、数据版本、optimizer、base lr、effective batch、scheduler、warmup、精度模式、最大梯度 norm、验证指标、samples/s 和总训练时长。不要只保留一条“最好看的 loss 曲线”,否则以后无法解释某个参数为什么有效。
七、踩坑大全
坑 1:把 CrossEntropyLoss 的输入先做 softmax。 训练可能仍然运行,但重复归一化会损害数值稳定性;直接传 logits,推理展示概率时再做 softmax。
坑 2:分类标签用了浮点或 one-hot,却没有匹配损失。 多分类交叉熵通常需要 torch.long 的类别索引;二分类的 BCEWithLogitsLoss 目标通常是浮点 0/1,先确认任务契约。
坑 3:输出和标签 shape 靠 squeeze()“碰巧对上”。 batch size 为 1 时可能挤掉 batch 维;用明确的 reshape 或断言检查每一维语义。
坑 4:忘记 zero_grad()。 梯度默认累积,连续 step 会把旧梯度带进来;只有有意做梯度累积时才延迟清零,并正确缩放 loss。
坑 5:在 optimizer.step() 前没有 backward(),或把 detach 后的 loss 反向。 前者没有有效梯度,后者切断了图;打印参数的 grad 和 requires_grad 定位问题。
坑 6:创建优化器后替换了模型参数。 优化器仍指向旧 Tensor;应先完成模型结构和参数替换,再创建 optimizer,或正确重建参数组。
坑 7:同时用两个优化器更新同一参数。 两套状态会互相覆盖语义;实验不同优化器时重新初始化模型和优化器,保证比较公平。
坑 8:scheduler 调用粒度错了。 StepLR 按 epoch 设计却每个 batch 调用,会过快衰减;先写清楚 epoch、iteration、optimizer_step 的定义。
坑 9:只保存模型权重。 恢复 Adam 或 scheduler 时状态丢失,学习率计数和动量都会跳变;保存完整训练状态并做恢复测试。
坑 10:盲目按 batch size 放大学习率。 线性缩放只是 SGD 的经验起点;改变 batch 后要重新观察梯度 norm、验证指标、稳定性和总训练时间。
坑 11:梯度累积没有除以累积步数。 梯度被放大,等价于改变学习率;使用 (loss / accumulation_steps).backward(),并处理 epoch 尾部不完整窗口。
坑 12:只看 loss,不看吞吐和数据等待。 GPU 空闲可能是 DataLoader、I/O 或通信瓶颈;同时记录 data time、compute time、samples/s 和显存。
坑 13:混合精度溢出后 scheduler 仍按每次迭代推进。 scaler 可能跳过了真实更新;根据训练目标让调度计数和有效 optimizer step 对齐。
坑 14:验证集也调用 optimizer.step()。 验证应使用 eval() 和 inference_mode(),只记录指标,不改变参数或优化器状态。
八、小结
- 损失函数把预测和目标变成可优化的标量;MSE 适合连续回归,交叉熵通常接收 logits 和整数类别标签。
SGD实现最直接的梯度下降,Momentum 用速度平滑方向,Adam/AdamW 为参数维护自适应状态;优化器状态需要进入 checkpoint。- 标准训练 step 是清梯度、前向、算 loss、
backward()、可选裁剪、optimizer.step()和记录指标。 StepLR逐级衰减,Cosine 平滑衰减;调度器按 epoch 还是 optimizer step 调用,必须和配置中的计数单位一致。- batch size、梯度累积、学习率和分布式 world size 共同决定有效更新尺度;放大 batch 后不能机械地放大学习率。
- AI Infra 的优化目标是可解释的端到端时间:同时看收敛曲线、有效更新次数、samples/s、data/compute time、通信和显存。
九、课后练习
- (基础) 用
MSELoss训练第 41 篇的线性回归,分别比较reduction="mean"与"sum",解释 batch size 改变时梯度为何不同。 - (基础) 构造三分类 logits,分别传入正确的类别索引、错误 dtype 的标签和 one-hot 标签,记录错误信息并修正它们。
- (理解) 在同一个小数据集上比较 SGD、带 Momentum 的 SGD 和 AdamW,固定 seed,画出 loss 与梯度 norm。
- (理解) 用
StepLR和CosineAnnealingLR打印前 20 个 optimizer step 的学习率,说明两条曲线各自的适用场景。 - (进阶) 实现梯度累积,比较真实大 batch 与 micro-batch 累积的梯度差异,并处理最后不足一个累积窗口的情况。
- (AI Infra) 改变
batch_size、num_workers和pin_memory,记录有效 batch、samples/s、显存与验证指标;不要只比较单个 step。 - (进阶) 保存并恢复 model、optimizer、scheduler、epoch 和随机状态,验证恢复后的下一步学习率与 loss 是否和未中断运行一致。
- (综合) 给训练循环加入 NaN 检查、梯度 norm、每个参数组 lr 和 data/compute time 日志,写一份能够定位“收敛慢”和“吞吐低”的诊断报告。
下一篇预告
第43篇|手写 Attention 与 Transformer Block。有了损失、优化器和学习率调度,我们就能把一个结构真正训练起来。下一篇会从 Q、K、V 的缩放点积开始,手写多头 Attention、残差连接、LayerNorm 和前馈网络,逐步对照 nn.MultiheadAttention 与 Transformer Block 的张量 shape、mask 和显存开销。再往后,第 44 篇将把这些积木组装成一个可生成文本的 mini-GPT,继续沿着“数学原理 → PyTorch 实现 → AI Infra 性能边界”的路线前进。