
第36篇|实战:用 NumPy 手写 MLP 前向与反向
本篇定位:专栏三「NumPy 数值计算」的收束篇。承接第 35 篇的
stride、reshape、transpose,把数组布局、广播、ufunc、矩阵乘法和归约串成一条可训练的 MLP(多层感知机,Multi-Layer Perceptron)链路。读完你将能够:用 NumPy 写出两层 MLP 的前向传播、均方误差、手动反向传播和小批量梯度下降;为每个中间数组标注 shape、dtype 和布局;用数值梯度检查反向公式;理解这套手写代码如何过渡到 PyTorch 的
Tensor与 autograd。预计用时:阅读 60~80 分钟,动手 90~120 分钟。
第 35 篇我们追踪了一个元素怎样通过 stride 找到内存地址。今天把视线拉回到模型:输入样本进入线性层,经过激活函数,再进入下一层,最后产生预测;损失沿着这条计算图反向传播,告诉每个参数应该怎样改变。看起来这是深度学习框架的工作,但它的核心并不神秘,正是 NumPy 已经提供的 @、广播、ufunc 和 sum。
我们不会调用自动求导,也不会把循环藏在训练库里。通过一个很小的二分类回归式例子,亲手保存前向缓存、推导局部导数、沿 batch 维做归约,再用数值检查对照结果。这样做不是为了用 CPU 上的 NumPy 取代 PyTorch,而是为了建立一份可以迁移的心智模型:框架的每个梯度,最终都必须和 shape、axis、内存布局以及算子语义对得上。
一、先写清楚模型契约:每一维代表什么
1.1 两层 MLP 的形状
我们使用最小但完整的网络:输入有 D=2 个特征,隐藏层有 H=4 个神经元,输出是 O=1 个数。训练时一次处理 B 个样本。所有样本按行放置,因此输入矩阵 X 的 shape 是 (B, D):
X       (B, D)  --@ W1(D, H) + b1(H,)-->  Z1 (B, H)
Z1      (B, H)  --ReLU------------------>  A1 (B, H)
A1      (B, H)  --@ W2(H, O) + b2(O,)-->  Yhat(B, O)
W1 的每一列对应一个隐藏神经元,W2 把隐藏层的 H 个值混合成输出。偏置 b1、b2 是一维数组,正好触发 NumPy 广播:(B, H) + (H,) 会把同一组偏置加到每一行。这里的广播不是复制出一个 (B, H) 的新数组,而是按规则扩展形状来完成逐元素运算;它既简洁,也提醒我们必须把轴语义写准确。
import numpy as np

B, D, H, O = 3, 2, 4, 1
X = np.zeros((B, D), dtype=np.float32)
W1 = np.zeros((D, H), dtype=np.float32)
b1 = np.zeros(H, dtype=np.float32)
W2 = np.zeros((H, O), dtype=np.float32)
b2 = np.zeros(O, dtype=np.float32)

print("X", X.shape, "W1", W1.shape, "b1", b1.shape)
print("W2", W2.shape, "b2", b2.shape)
print("Z1", (X @ W1 + b1).shape)
X (3, 2) W1 (2, 4) b1 (4,)
W2 (4, 1) b2 (1,)
Z1 (3, 4)
如果误把 W1 写成 (H, D),X @ W1 会直接报维度错误;如果把偏置写成 (B,),有时会广播失败,有时会广播到错误的轴。模型代码的第一道测试不是看 loss,而是把每个张量的名字、shape 和语义写在一起。
在这里还要把“参数”和“数据”区分开:参数会在优化步骤中改变,输入与标签通常只读。若把一个切片 view 直接交给原地更新逻辑,可能无意中改写数据集的共享 buffer。第 35 篇的 np.shares_memory 在这里仍然有用;边界处明确谁拥有数组,能避免训练若干轮后才出现的隐蔽数据污染。
1.2 初始化不是随便填零
线性层的权重需要打破神经元之间的对称性。若 W1 全为零,所有隐藏神经元会得到相同的输出和相同的梯度,训练不会真正学出不同的特征。偏置可以从零开始;权重用固定种子的正态分布,并按输入宽度缩放,得到一个简单的 Xavier 风格初始化:
import numpy as np

rng = np.random.default_rng(36)
D, H, O = 2, 4, 1
W1 = (rng.normal(size=(D, H)) * np.sqrt(1 / D)).astype(np.float32)
b1 = np.zeros(H, dtype=np.float32)
W2 = (rng.normal(size=(H, O)) * np.sqrt(1 / H)).astype(np.float32)
b2 = np.zeros(O, dtype=np.float32)

print(W1.shape, W2.shape, b1.shape, b2.shape)
print(W1.dtype, W1.flags.c_contiguous, W2.flags.c_contiguous)
(2, 4) (4, 1) (4,) (1,)
float32 True True
default_rng 来自第 34 篇:固定 seed 让调试可复现,但不代表生产系统的随机性需求都一样。这里还显式选择 float32,让例子接近 AI Infra 常用的数据类型。NumPy 在参与运算时会遵循 dtype 规则;如果把某个中间结果悄悄提升成 float64,数值也许仍然正确,却会增加内存带宽和与后端设备交互的成本。
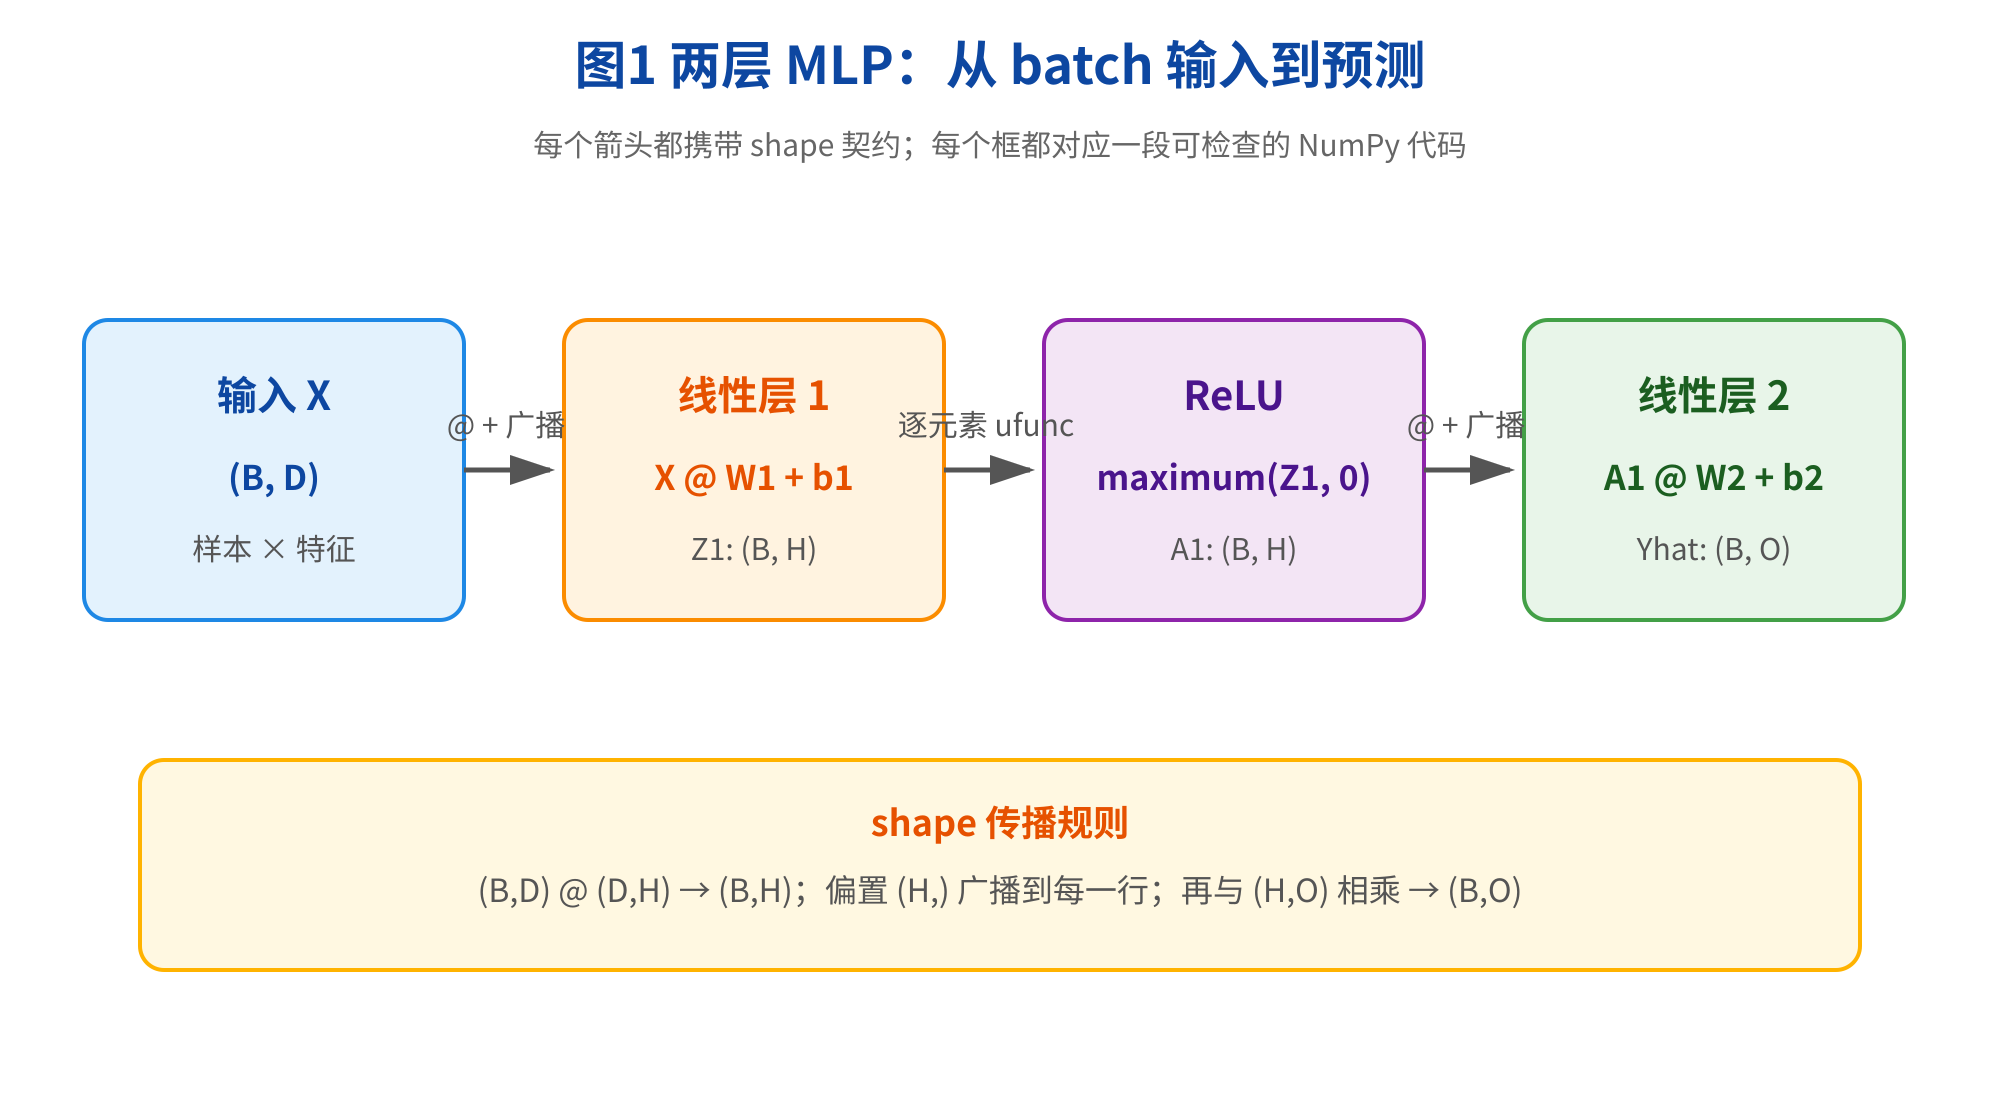
图1 两层 MLP 的数据流:shape 从输入一路对齐到输出
AI Infra 视角:在真实推理服务中,shape 契约还会包含 batch 上限、dtype、device 和 layout。一个算子只有在这些契约都满足时,才能稳定地命中预期 kernel;NumPy 原型的价值,是先把逻辑契约用最透明的方式固定下来。
二、前向传播:矩阵乘法加广播激活
2.1 把线性层拆成三个动作
单个线性层的公式是 Z = XW + b。对 batch 输入,X @ W 是矩阵乘法,沿输入特征轴 D 做乘加;+ b 是沿每一行广播偏置。接着使用 ReLU(Rectified Linear Unit,修正线性单元):A = max(0, Z)。np.maximum 是逐元素 ufunc,输出 shape 与 Z 相同。
import numpy as np

X = np.array([[1.0, -1.0], [2.0, 0.5]], dtype=np.float32)
W1 = np.array([[1.0, -2.0, 0.5], [0.5, 1.0, -1.0]], dtype=np.float32)
b1 = np.array([0.0, 0.5, -0.5], dtype=np.float32)

Z1 = X @ W1 + b1
A1 = np.maximum(Z1, 0.0)
print("Z1=\n", Z1)
print("A1=\n", A1)
print("shapes:", X.shape, Z1.shape, A1.shape)
Z1=
 [[ 0.5 -2.5  1.5]
 [ 2.25 -3.5   0.5 ]]
A1=
 [[0.5  0.   1. ]
 [2.25 0.   0. ]]
shapes: (2, 2) (2, 3) (2, 3)
要注意 np.maximum(Z1, 0.0) 中的 0.0 是标量,可以广播到全部元素;它不改变 batch 轴。为了反向传播,我们需要保留 Z1 或等价的激活掩码,因为 ReLU 的导数取决于前向时哪些位置大于零。只保留 A1 也能在非零处推断一部分信息,但当输入恰好等于零时,最好明确规定边界行为。
2.2 封装 forward,并保存 cache
把每层散落在训练循环里的写法改成函数。cache 是反向传播要用的前向中间结果;它不是“多余的临时变量”,而是计算图的局部记录。返回预测值和缓存,可以让训练、推理、梯度检查各自复用同一份前向逻辑。
import numpy as np


def forward(X, params):
    W1, b1 = params["W1"], params["b1"]
    W2, b2 = params["W2"], params["b2"]
    Z1 = X @ W1 + b1
    A1 = np.maximum(Z1, 0.0)
    Yhat = A1 @ W2 + b2
    cache = {"X": X, "Z1": Z1, "A1": A1}
    return Yhat, cache

params = {
    "W1": np.array([[1.0, -1.0], [0.5, 2.0]], dtype=np.float32),
    "b1": np.array([0.0, 0.0], dtype=np.float32),
    "W2": np.array([[1.0], [-0.5]], dtype=np.float32),
    "b2": np.array([0.0], dtype=np.float32),
}
X = np.array([[2.0, 1.0], [-1.0, 2.0]], dtype=np.float32)
Yhat, cache = forward(X, params)
print("Yhat:\n", Yhat)
print({name: value.shape for name, value in cache.items()})
Yhat:
 [[ 2.5]
 [-2.5]]
{'X': (2, 2), 'Z1': (2, 2), 'A1': (2, 2)}
这里第二个样本的第二个隐藏单元为负,被 ReLU 截断;这种“门”会在反向时阻断对应梯度。生产模型会有 GELU、SiLU 等更平滑的激活,但它们依然遵循同样的套路:前向计算输出,缓存反向需要的量,反向使用局部导数。
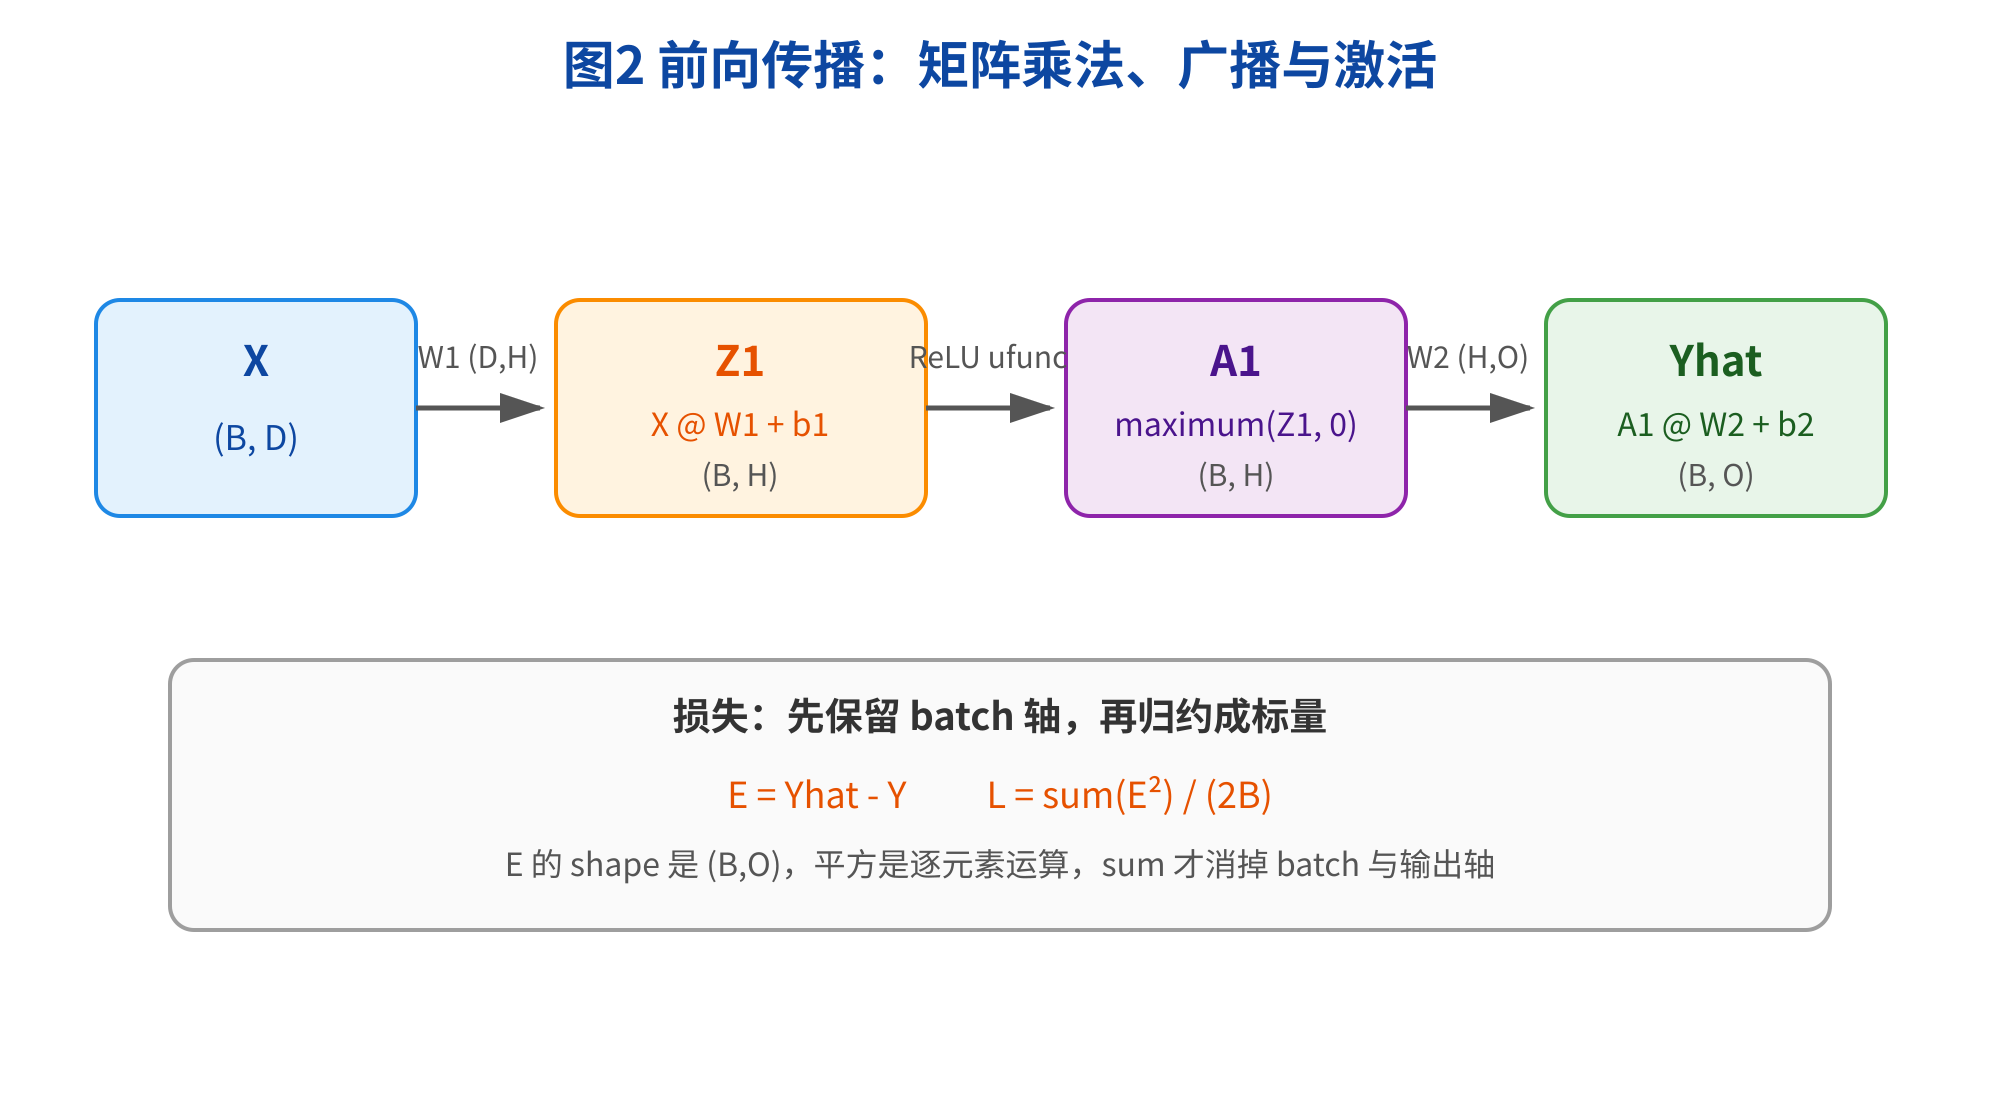
图2 前向传播:每个节点都带有可检查的 shape
2.3 损失函数把预测变成一个标量
用均方误差(Mean Squared Error,MSE)作为教学损失:
L = 1/(2B) × sum((Yhat - Y)²)
除以 2 是为了让导数中的 2 抵消;除以 B 则让 loss 和梯度不随 batch 大小线性放大。sum 是归约:输出从 (B, O) 变成标量。若是多输出模型,也可以先沿输出维度求和,再沿 batch 求平均,但要明确自己选择的归一化。
import numpy as np

Yhat = np.array([[1.5], [-1.5]], dtype=np.float32)
Y = np.array([[1.0], [-2.0]], dtype=np.float32)
B = Yhat.shape[0]
loss = np.sum((Yhat - Y) ** 2) / (2 * B)
print("loss:", loss)
print("error shape:", (Yhat - Y).shape, "loss shape:", np.shape(loss))
loss: 0.125
error shape: (2, 1) loss shape: ()
标量 shape 是 (),不要把它误认为 (1,)。优化器需要的是一个数;梯度则要回到每个参数各自的 shape。
三、手动反向传播:从标量沿图反推
3.1 先求输出层的梯度
反向传播(backpropagation)就是链式法则(chain rule)沿计算图反向应用。令 E = Yhat - Y,损失是 sum(E²)/(2B),所以:
dYhat = E / B
输出层 Yhat = A1 @ W2 + b2。矩阵微积分可以按形状推导:
dW2 = A1.T @ dYhat       (H, B) @ (B, O) -> (H, O)
db2 = sum(dYhat, axis=0) (B, O) -> (O,)
dA1 = dYhat @ W2.T       (B, O) @ (O, H) -> (B, H)
d 前缀表示“损失对该变量的导数”。A1.T 是第 35 篇讲过的 transpose view;在 NumPy 的 @ 中,底层实现会读取它的 stride。小矩阵不用担心,但对大激活要在 profile 中观察是否产生连续化副本。
3.2 穿过 ReLU 和第一层
ReLU 的局部导数是:1(当 Z1 > 0)或 0(当 Z1 <= 0)。因此:
dZ1 = dA1 * (Z1 > 0)
dW1 = X.T @ dZ1
db1 = sum(dZ1, axis=0)
布尔掩码会参与逐元素 ufunc 乘法,NumPy 会把它安全地用于筛选梯度。注意 db1 必须沿 axis=0 汇总 batch;若写成 axis=1,得到的是每个样本的数,而不是每个偏置参数的梯度。
import numpy as np


def backward(Y, Yhat, cache, params):
    X, Z1, A1 = cache["X"], cache["Z1"], cache["A1"]
    W2 = params["W2"]
    B = X.shape[0]

    dYhat = (Yhat - Y) / B
    dW2 = A1.T @ dYhat
    db2 = dYhat.sum(axis=0)
    dA1 = dYhat @ W2.T
    dZ1 = dA1 * (Z1 > 0)
    dW1 = X.T @ dZ1
    db1 = dZ1.sum(axis=0)
    return {"W1": dW1, "b1": db1, "W2": dW2, "b2": db2}

X = np.array([[2.0, 1.0], [-1.0, 2.0]], dtype=np.float32)
Y = np.array([[1.0], [-2.0]], dtype=np.float32)
Yhat, cache = forward(X, params)
grads = backward(Y, Yhat, cache, params)
for name in ("W1", "b1", "W2", "b2"):
    print(name, grads[name].shape, np.round(grads[name], 3))
W1 (2, 2) [[ 1.5   -0.125]
 [ 0.75   0.25 ]]
b1 (2,) [0.75  0.125]
W2 (2, 1) [[ 1.875]
 [-1.25 ]]
b2 (1,) [0.5]
这段实现没有参数专属的魔法:每个梯度都来自一次 @、一次逐元素乘法或一次沿 batch 的 sum。dW2 的 shape 必须和 W2 完全一致,更新才能写成 W2 -= learning_rate * dW2。这就是反向传播最实用的检查规则:先按公式写 shape,再写代码。
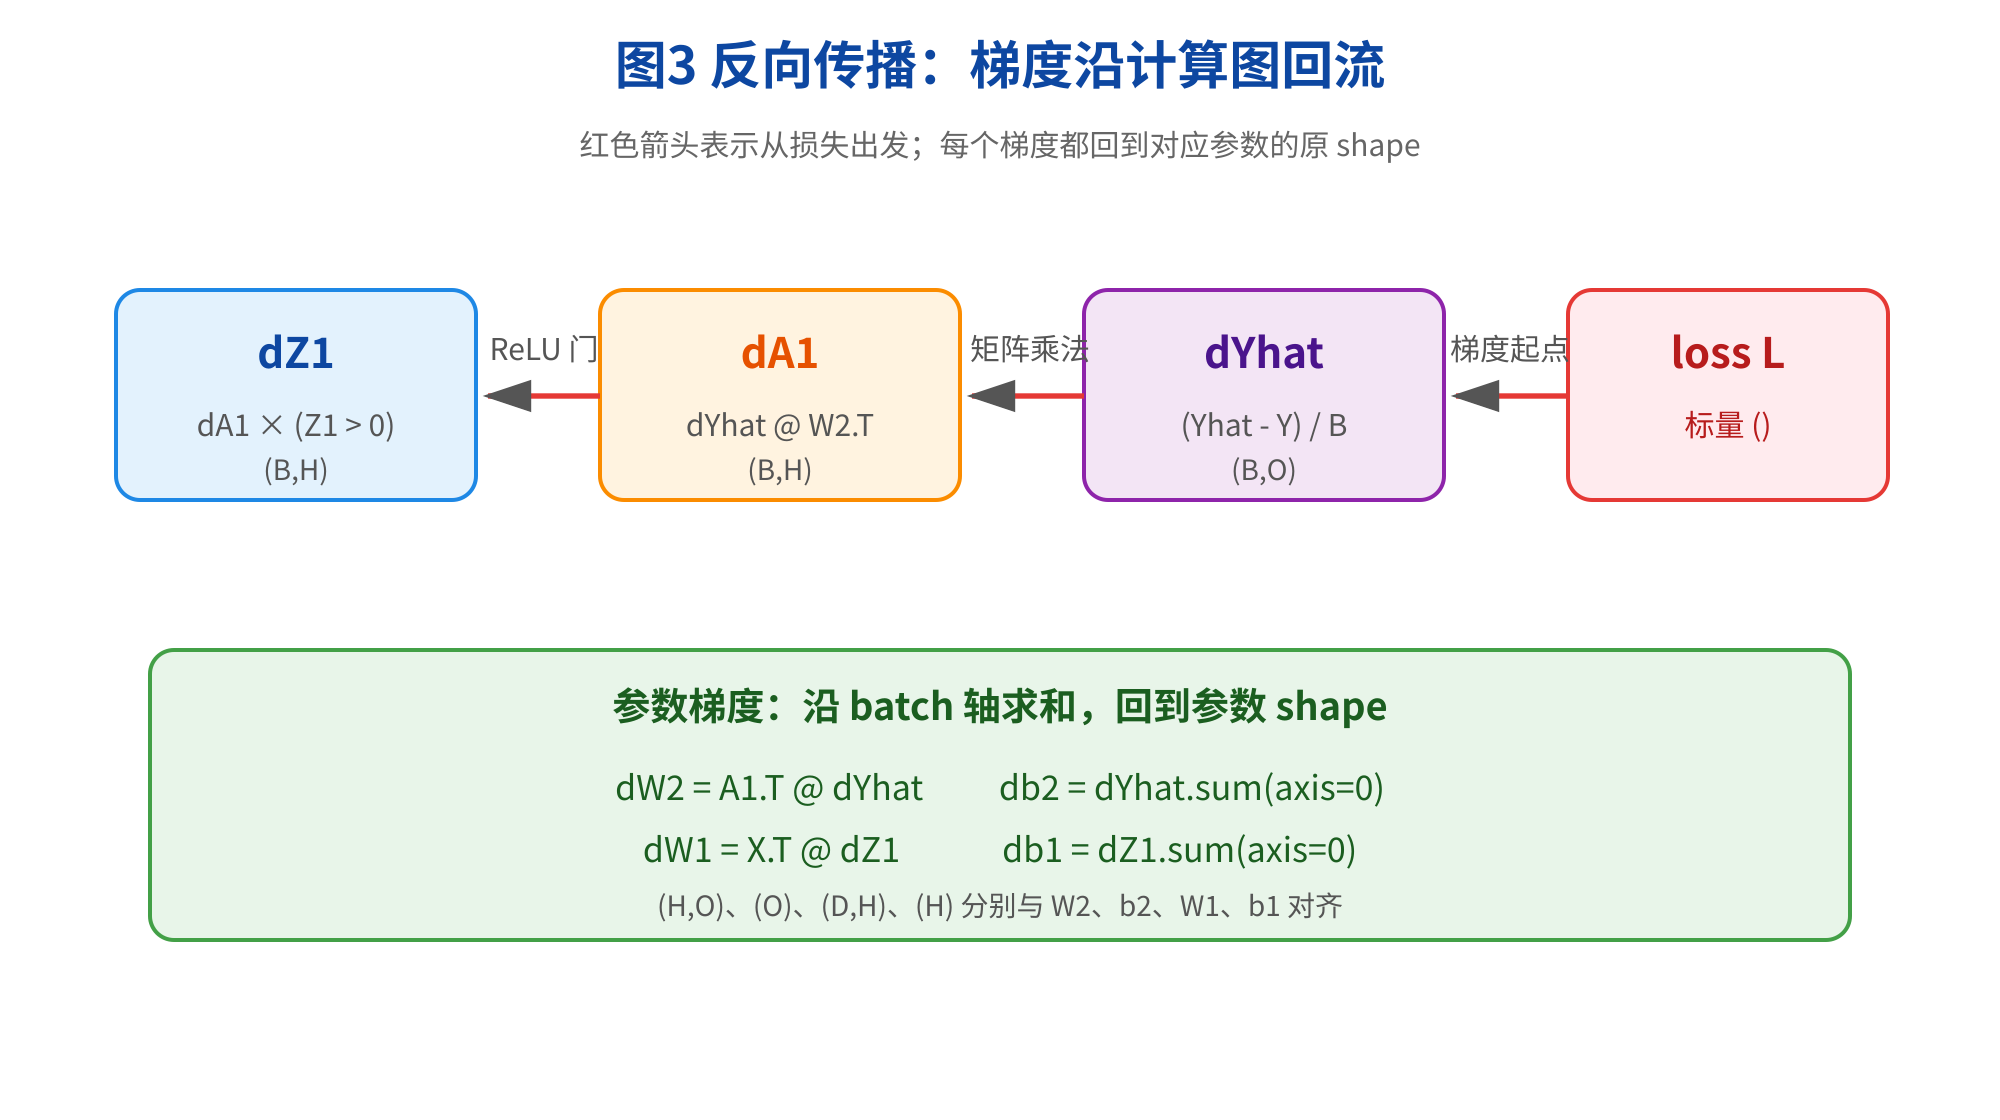
图3 反向传播:梯度沿箭头回流并在 batch 轴归约
3.3 用数值梯度检查公式
手推公式容易把转置、归约轴或平均因子写错。数值梯度提供了一个独立参照:对参数中的一个元素加上很小的 epsilon,计算 L(θ+ε);再减去 L(θ-ε),除以 2ε:
∂L/∂θ ≈ [L(θ+ε) - L(θ-ε)] / (2ε)
有限差分很慢,因为每个参数都要做两次前向,但它特别适合小网络的单元测试。比较时使用 np.allclose,不要要求浮点数逐位相等;float32 的误差通常比 float64 更明显。
import numpy as np


def loss_only(X, Y, params):
    Yhat, _ = forward(X, params)
    return float(np.sum((Yhat - Y) ** 2) / (2 * X.shape[0]))


def numerical_gradient(X, Y, params, name, index, eps=1e-3):
    value = params[name][index]
    params[name][index] = value + eps
    plus = loss_only(X, Y, params)
    params[name][index] = value - eps
    minus = loss_only(X, Y, params)
    params[name][index] = value
    return (plus - minus) / (2 * eps)

# 把 ReLU 的边界移开,避免有限差分跨过 Z1=0。
params["b1"] = np.array([0.2, 0.3], dtype=np.float32)
Yhat, cache = forward(X, params)
grads = backward(Y, Yhat, cache, params)
for name, index in (("W1", (0, 0)), ("b1", (1,)),
                    ("W2", (0, 0)), ("b2", (0,))):
    numeric = numerical_gradient(X, Y, params, name, index)
    print(name, index, "analytic=", round(float(grads[name][index]), 5),
          "numeric=", round(numeric, 5))
W1 (0, 0) analytic= 1.775 numeric= 1.77497
b1 (1,) analytic= -0.275 numeric= -0.27496
W2 (0, 0) analytic= 2.0475 numeric= 2.04748
b2 (0,) analytic= 0.55 numeric= 0.54991
实际测试应随机抽取多个位置,并在 ReLU 的零点附近格外小心:零点处导数存在约定差异,有限差分也可能跨过分段边界。梯度检查不是训练的一部分,而是实现新算子时的安全网。
3.4 用“形状传播”代替猜公式
推导梯度时,可以把每一个中间量当作带标签的接口。dYhat 与 Yhat 同形状;对 A1 @ W2 求 W2 的梯度时,A1.T 必须提供 (H, B),所以结果自然是 (H, O)。这是一种比背公式更可靠的方法:先确定上游梯度的 shape,再让矩阵乘法的匹配轴消失,剩下的轴就是参数梯度的 shape。
对偏置也可以用同样的直觉。b2 在前向被广播到 B 行,反向就要把这 B 份贡献沿被广播的轴相加,因此 db2 = dYhat.sum(axis=0)。广播的逆过程通常就是沿扩展出来的轴归约;这条规律在 LayerNorm、Attention mask 和批量损失中都会再次出现。若一个梯度的 shape 不对,先问“前向在哪个轴广播了”,往往比继续改转置更快。
还要区分数学上的导数和数组对象。dW1 是一份新数组,拥有自己的值;X.T 只是一个可能共享 buffer 的 view。我们没有对 X.T 做原地写入,但如果某个优化版本复用内存,就必须确认不会覆盖仍被 cache 引用的前向输入。数值正确性、对象所有权和布局连续性是三个不同问题,调试时不能用其中一个属性替代另外两个。
四、向量化训练:batch 不是 Python 循环
4.1 一次处理全部样本
如果逐样本写循环,每个样本都要重复调用矩阵乘法,Python 调度和临时数组会成为开销。向量化的关键是把样本堆成第一维:一次 X @ W1 计算整个 batch,NumPy 把循环交给底层 C/BLAS。前面推导的公式已经是批量版本,不需要再写一个样本版本。
准备一个简单数据集:标签等于两个特征之和是否为正。这个规则不重要,重要的是它能让网络看到固定 shape 的 batch。
import numpy as np

rng = np.random.default_rng(2026)
X = rng.normal(size=(32, 2)).astype(np.float32)
Y = (X.sum(axis=1, keepdims=True) > 0).astype(np.float32)
print("X", X.shape, "Y", Y.shape)
print("positive:", int(Y.sum()), "of", len(Y))
X (32, 2) Y (32, 1)
positive: 16 of 32
这里 sum(axis=1, keepdims=True) 先把两个特征归约,再保留一个长度为 1 的输出轴,因此结果是 (B, 1),能和 Yhat 对齐。若不写 keepdims=True,会得到 (B,);它有时也能参与广播,但会让 (B, 1) 与 (B,) 的运算意外得到 (B, B),这是最危险的广播错误之一。
4.2 写一个最小训练循环
训练循环由四步组成:前向得到 loss,反向得到 grads,按学习率更新参数,记录指标。参数字典中的数组是可写的;更新使用同 shape 的梯度,不要在这里调用 np.resize 或隐式 reshape 来“修复”错误。
import numpy as np


def mse_loss(Yhat, Y):
    return np.mean((Yhat - Y) ** 2) / 2


def train_step(X, Y, params, lr=0.1):
    Yhat, cache = forward(X, params)
    loss = mse_loss(Yhat, Y)
    grads = backward(Y, Yhat, cache, params)
    for name in params:
        assert params[name].shape == grads[name].shape
        params[name] -= lr * grads[name]
    return float(loss)

rng = np.random.default_rng(36)
params = {
    "W1": (rng.normal(size=(2, 4)) * 0.5).astype(np.float32),
    "b1": np.zeros(4, dtype=np.float32),
    "W2": (rng.normal(size=(4, 1)) * 0.5).astype(np.float32),
    "b2": np.zeros(1, dtype=np.float32),
}
X = np.array([[-1.0, -1.0], [-1.0, 1.0], [1.0, -1.0], [1.0, 1.0]], dtype=np.float32)
Y = (X.sum(axis=1, keepdims=True) > 0).astype(np.float32)

for step in range(1, 1001):
    loss = train_step(X, Y, params, lr=0.5)
    if step in (1, 100, 1000):
        print(step, round(loss, 4))
1 0.1376
100 0.0
1000 0.0
输出的具体小数会随初始化细节变化;测试时更稳妥的断言是 losses[-1] < losses[0],而不是绑定某一个精确值。这个例子使用全量 batch;若改成小批量,只需按索引取 X[order]、Y[order],每个 batch 的 B 会随最后一批变化,而 D/H/O 不变。
4.3 让 shape 和 layout 成为断言
向量化代码的好处是短,风险是错误也可能一次广播到很大的结果。可以在开发阶段集中写检查函数:
import numpy as np


def check_batch(X, Y, params):
    assert X.ndim == 2 and Y.ndim == 2
    assert X.shape[0] == Y.shape[0]
    assert X.shape[1] == params["W1"].shape[0]
    assert params["W1"].shape[1] == params["W2"].shape[0]
    assert params["W2"].shape[1] == Y.shape[1]
    for name, value in params.items():
        assert value.dtype == np.float32, (name, value.dtype)
        assert value.flags.c_contiguous, (name, value.strides)

check_batch(X, Y, params)
print("contract: OK")
contract: OK
这不是说所有算子都必须 C contiguous;而是示例选择了一个明确的参数契约。第 35 篇的原则仍然成立:不要无条件地对所有输入复制。若某个 GEMM 实现接受任意 stride,就可以保留 view;若边界 API 只接受连续 float32,就在边界一次性用 astype(..., copy=False) 和 ascontiguousarray 处理,并把复制成本算进 profile。
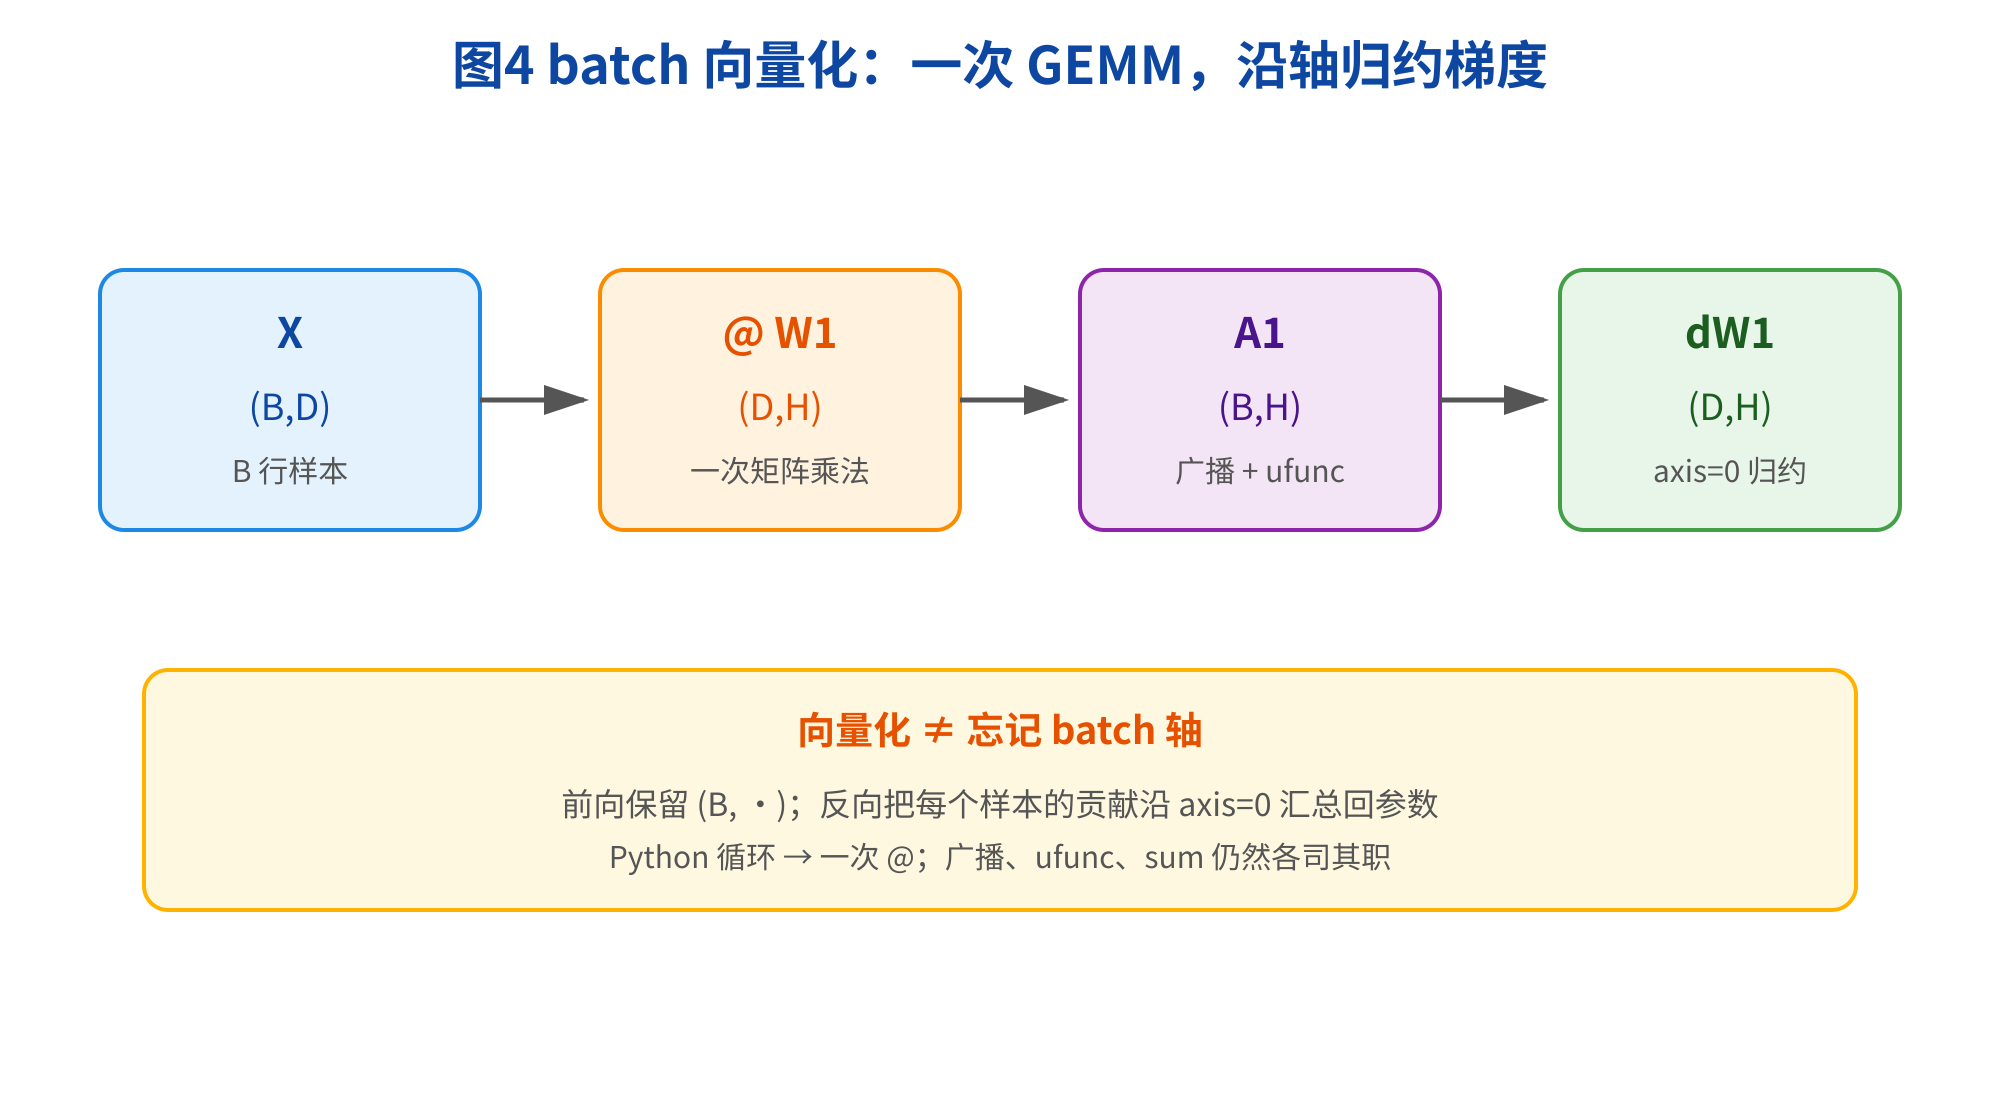
图4 batch 向量化:矩阵乘法、广播与沿 axis=0 的梯度归约
AI Infra 视角:batch 维把许多独立样本合并成一次 GEMM,通常比 Python 循环更容易利用 SIMD、BLAS 或 GPU tensor core。真正的吞吐还取决于
B是否合适、最后一维是否连续、dtype 是否命中 kernel,以及数据装载和 layout conversion 是否占掉了收益。
4.4 用 mini-batch 观察归约语义
把全量数据拆开以后,每一个 batch 的 loss 都是该批样本的平均,而不是整个数据集的总和。最后一个 batch 可能比其他 batch 小,所以在记录 epoch 指标时不能简单地对“每批 loss”做不加权平均;更稳妥的方式是累计每批的 loss 总和与样本数,再除以总样本数。训练更新可以使用每批平均梯度,日志聚合则应使用真实样本数加权。
import numpy as np

loss_sums = 0.0
seen = 0
for start in range(0, len(X), 3):
    xb = X[start:start + 3]
    yb = Y[start:start + 3]
    pred, _ = forward(xb, params)
    batch_sum = np.sum((pred - yb) ** 2) / 2
    loss_sums += float(batch_sum)
    seen += len(xb)
print("weighted mean loss:", round(loss_sums / seen, 4))
print("samples:", seen)
weighted mean loss: 0.0
samples: 4
上面的 0.0 只是因为前面训练循环已经把这个四点数据集拟合得很接近;换一组未训练参数就会看到非零值。示例的重点是 batch_sum 没有先除以一个固定的最大 batch,而是最后用真实的 seen 归一化。数据管道、评估器和分布式训练都需要明确这种归约语义:是 sum、mean,还是按 token 数加权的 mean。
五、从“能跑”到“可信”:数值、缓存与性能
5.1 缓存哪些中间值
反向传播至少需要 X、Z1、A1 和当前参数 W2。缓存越多,反向越方便,但激活也会占内存。Transformer 训练时保存的中间激活可能远大于参数本身,因此会出现 activation checkpointing(激活重计算):前向少保存一些,反向时重新计算以换取显存。
本例的 cache 用字典表达可读性;工程实现可能把多个中间结果打包、复用 buffer,或者由框架的 autograd 节点管理生命周期。无论形式怎样,原则不变:反向使用的值必须和对应前向保持一致,不能在更新参数后再拿新权重去解释旧缓存。
5.2 观察 dtype、stride 和临时数组
X.T @ dZ1 可能读一个非连续 view;np.maximum、减法和平方也会产生中间数组。教学代码优先清楚,性能优化则要用测量来决定。下面的小工具把本文反复关注的属性一次打印出来:
import numpy as np


def inspect(name, x):
    print(f"{name:5s} shape={x.shape} dtype={x.dtype} "
          f"strides={x.strides} C={x.flags.c_contiguous}")

for name, value in [("X", X), ("W1", params["W1"]),
                    ("W2", params["W2"]), ("X.T", X.T)]:
    inspect(name, value)
X     shape=(4, 2) dtype=float32 strides=(8, 4) C=True
W1    shape=(2, 4) dtype=float32 strides=(16, 4) C=True
W2    shape=(4, 1) dtype=float32 strides=(4, 4) C=True
X.T   shape=(2, 4) dtype=float32 strides=(4, 8) C=False
X.T 共享底层数据但不是 C contiguous,这正是第 35 篇所说的“逻辑换轴不等于物理搬运”。不要仅凭 C=False 就认定它一定慢;先测量矩阵规模、BLAS 实现和实际调用。更不要在每一层入口盲目 .copy(),否则减少 stride 复杂度的同时,可能把内存带宽变成瓶颈。
5.3 手写反向如何过渡到 autograd
PyTorch 的 autograd 会记录类似 matmul、加法、ReLU、归约的操作节点,并在 backward() 时按相同的链式法则生成梯度。我们手写的 cache 可以看作最朴素的计算图节点保存;dW2、dA1 等就是节点收到的上游梯度经过局部规则后的结果。
迁移时有几组对应关系:
| NumPy 手写部分 | PyTorch 中的对应概念 | 需要继续关心的契约 |
|---|---|---|
| ndarray | Tensor | shape、dtype、device、stride |
| X @ W | torch.matmul / nn.Linear | 可广播维度与矩阵乘法维度 |
| np.maximum | torch.relu | 非线性和梯度的定义 |
| sum(axis=0) | sum(dim=0) | 归约轴、keepdim、平均因子 |
| 参数字典 | nn.Parameter / nn.Module | 参数注册、梯度生命周期 |
| 手动 params -= lr * grads | optimizer step() | zero grad、更新时机、device |
自动求导减少了手写公式的机会,却没有消灭 shape 错误、错误的 dim、意外的 device copy 或非连续 layout。掌握今天的版本,才能在 PyTorch 里看懂一个梯度为何是这个 shape,也更容易理解 fused operator、反向 kernel 和显存峰值。
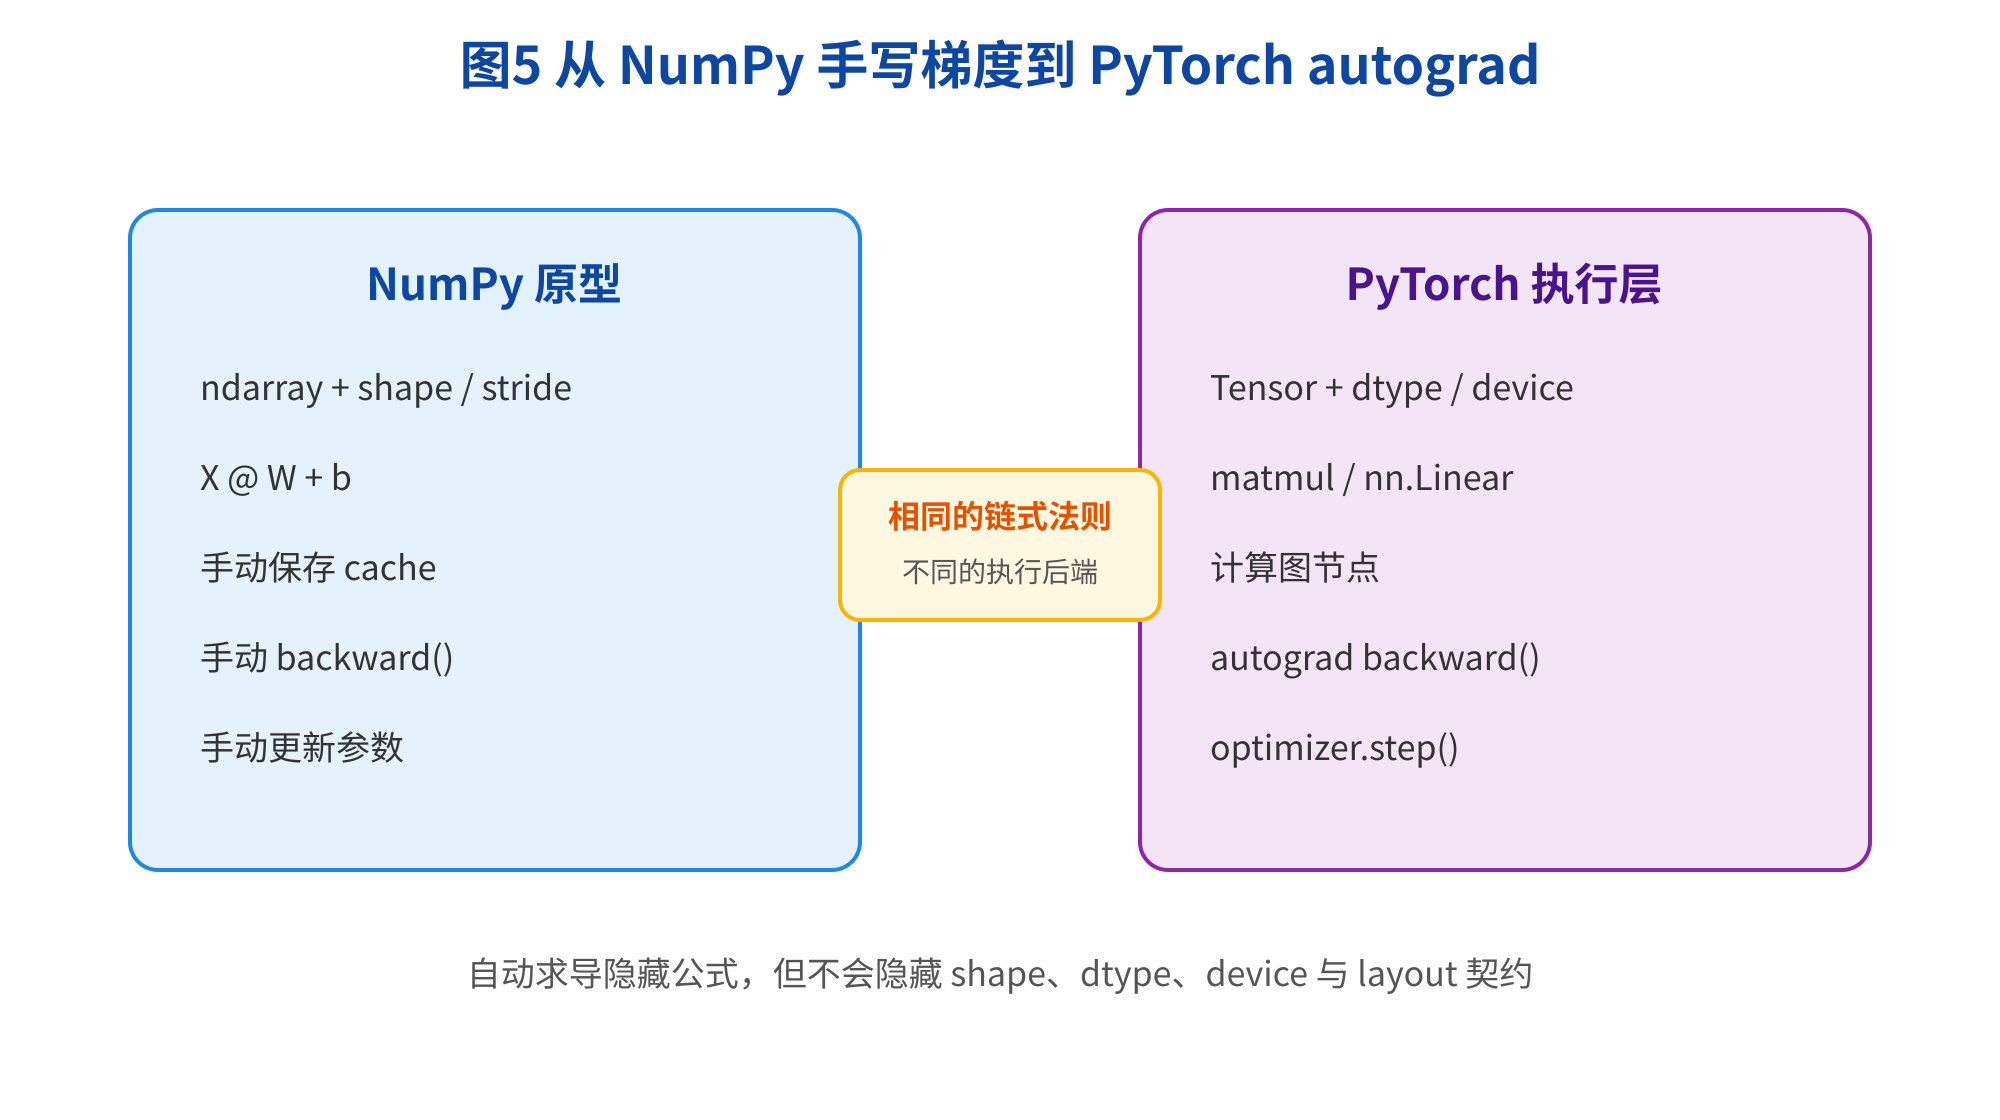
图5 从 NumPy 手写梯度到 PyTorch autograd:相同算子,不同执行层
5.4 训练日志也要有可解释的边界
一个下降的 loss 并不能证明实现完全正确。若标签被广播成了错误形状,模型可能仍然在优化一个错误目标;若某个隐藏单元永远被 ReLU 关闭,整体 loss 也可能缓慢下降。建议在小数据集上同时记录预测范围、激活比例和梯度范数:np.mean(Z1 > 0) 能告诉你 ReLU 有多少位置打开,np.linalg.norm(dW1) 能告诉你梯度是否接近全零或突然爆炸。
Yhat, cache = forward(X, params)
grads = backward(Y, Yhat, cache, params)
print("loss:", round(mse_loss(Yhat, Y), 4))
print("relu active:", round(float(np.mean(cache["Z1"] > 0)), 3))
print("grad norm:", round(float(np.linalg.norm(grads["W1"])), 4))
loss: 0.0
relu active: 0.562
grad norm: 0.0
这里的输出会随着训练状态改变,数字只是格式示意。重要的是把“数值、shape、布局、统计量”放在同一个检查面板中。进入更大的框架后,这些观察会对应 profiler、梯度监控、异常值检测和算子级 trace;先在小模型里养成习惯,才能在复杂服务中快速定位问题。
六、把 NumPy 原型接到 AI Infra
6.1 从算子图到执行图
本文的 forward 是一个逻辑算子图:矩阵乘法、加法、ReLU、损失和归约。真正的运行时还要把它变成执行图,决定哪些节点融合、哪些 buffer 复用、在哪个线程或设备上运行。NumPy 让我们先观察数学结果;BLAS 负责部分矩阵乘法;PyTorch、XLA 或推理引擎则会继续做调度、内存规划和 kernel 选择。
因此,优化不应从“把每一行 Python 改得更短”开始,而应先问三个问题:最大的计算是不是 GEMM,数据是否以 kernel 喜欢的 dtype 和 layout 到达,临时数组和同步是否吞掉了算力。比如 Z1 = X @ W1 + b1 在框架里可能融合成一个更少写回的实现;但融合只有在输入 shape、类型和设备条件满足时才成立。手写版本为这些判断提供了可读基线。
6.2 训练与推理的边界
训练需要保存反向所需的激活、计算梯度并更新参数;推理通常只需要前向,可以关闭梯度记录并尽量复用输出 buffer。即便模型数学相同,两条路径的内存峰值、batch 策略和延迟目标也不同。线上推理还会遇到动态 batch、请求排队、padding、量化和 KV Cache 等问题,不能用一次 NumPy 小实验直接推断端到端性能。
把今天的实现迁移到 PyTorch 时,建议先逐项对照:固定 seed,使用同一批 X/Y,比较每一层的数值,再比较梯度,最后才切换到 GPU、混合精度或编译优化。每跨过一层抽象,都保留一份小而确定的回归测试;这样出现结果差异时,能知道问题来自公式、dtype、device、layout 还是执行调度,而不是把所有差异都归咎于“框架黑盒”。
七、踩坑大全
通用
- 坑 1:把样本维和特征维写反。 现象是
@报错,或结果能算却语义错。原因是本文约定X=(B,D);先给每个轴命名,再检查X.shape[1] == W1.shape[0]。 - 坑 2:偏置形状随手写成
(B,)。 现象是广播失败或输出悄悄变成(B,B)。原因是偏置属于输出特征轴,应使用(H,)、(O,),需要保留维度时用(1,O)并配合keepdims。 - 坑 3:忘记缓存 ReLU 的输入。 现象是梯度经过死神经元,loss 不下降。原因是 ReLU 导数依赖
Z1 > 0;前向和反向必须共享同一份门控信息。 - 坑 4:
sum的 axis 写错。 现象是db1形状不对,或 batch 越大更新越异常。原因是偏置梯度要沿axis=0汇总样本,不是沿特征轴汇总。 - 坑 5:梯度平均因子不一致。 现象是数值梯度差一倍或随 batch 大小变化。原因是 loss 除了
2B,反向也必须除以B;先写出标量损失再求导。 - 坑 6:原地更新破坏缓存。 现象是同一步的多个梯度不稳定。原因是先更新了
W2再计算依赖旧W2的dA1;应完整 backward 后再统一更新参数。
Linux / GPU 服务器与 AI Infra
- 坑 7:只看 shape,不看 dtype 和 stride。 现象是 NumPy 原型正确,迁移后显存或吞吐异常。原因是
float64、非连续 view、对齐或 device copy 触发了额外成本;日志中同时记录dtype、strides、device 和 contiguous。 - 坑 8:把
transpose当成永远免费。 现象是转置本身几乎为零耗时,但后续 GEMM 很慢。原因是下游 kernel 可能需要连续输入并隐式 materialize;分别测 view、copy 和 kernel。 - 坑 9:数值梯度检查放进正式训练。 现象是每一步训练极慢、内存占用高。原因是有限差分要重复前向;它只应作为小模型单元测试,生产训练使用解析梯度或 autograd。
- 坑 10:只用全量 batch 推断性能。 现象是小 batch 延迟或大 batch 吞吐不符合预期。原因是 kernel 启动、缓存、padding、通信和显存占用随 batch 变化;基准测试要覆盖真实的 batch 分布,并把数据搬运计时纳入范围。
八、小结
- 两层 MLP 可以用
X @ W + b、逐元素激活和另一次@清楚表达;每一步都有可验证的 shape。 - 广播负责把偏置沿 batch 轴加到每一行,ufunc 负责 ReLU 等逐元素规则,归约负责把 batch 梯度汇总回参数。
- 手动反向传播就是链式法则:先得到
dYhat,再依次算dW2、dA1、dZ1、dW1和偏置梯度。 - 向量化把 batch 放入第一维,让一次矩阵乘法替代 Python 样本循环;
keepdims和axis是防止广播错误的关键。 - 数值梯度检查能发现转置、归约和平均因子的错误;缓存、dtype、stride 和 copy 则决定实现能否走向可靠性能。
- PyTorch autograd 自动记录并反传同类算子,但不会替你决定 shape、device、layout 和显存策略。
九、课后练习
- (基础) 把隐藏层宽度从
4改成8,逐个打印Z1、A1、Yhat和所有梯度的 shape,确认代码没有写死维度。 - (基础) 把
np.maximum换成 leaky ReLU,并写出对应的dZ1;在负数区域检查梯度不再为零。 - (理解) 分别用
Y.shape == (B,)和(B, 1)跑损失,故意观察广播结果;解释为什么推荐保留输出轴。 - (理解) 为
W1、b1、W2、b2的每个元素做中心差分,计算解析梯度与数值梯度的最大相对误差。 - (进阶) 用
rng.permutation实现每轮打乱,再切出大小为4的 mini-batch;比较全量 batch 与小批量 loss 曲线。 - (进阶) 对
X做X[:, ::-1]或转置,打印strides和 contiguous;在进入@前选择是否ascontiguousarray,测量 copy 与计算时间。 - (AI Infra) 把参数改成
float16或float64,比较 loss 曲线、梯度检查误差、内存占用,并说明为何生产环境通常需要混合精度策略。 - (AI Infra) 用 PyTorch 重写同一网络,打开
requires_grad,将 NumPy 手写梯度与tensor.grad对照;记录 Tensor 的 shape、dtype、device 和 stride。
下一篇预告
下一篇是 第37篇|Tensor 基础与 NumPy 互转,专栏四「PyTorch 与 AI Infra 入门」从这里开始。你会把今天的 ndarray 换成 PyTorch Tensor,观察 CPU Tensor 与 NumPy 数组如何共享内存、何时发生 copy,以及 dtype、device、shape 和 stride 怎样共同决定一次运算能否执行。
第 36 篇的手写 MLP 会成为后续路线的参照物:第 38 篇把它放到 GPU 和 CUDA 的 device 世界;第 39 篇让 autograd 接管我们手动维护的 cache 和梯度;再往后用 nn.Module、DataLoader、优化器和 Attention 逐步搭出更接近真实模型的训练与推理系统。下一篇先解决最基础但最容易被忽略的边界——NumPy 和 Tensor 之间,哪些转换是零拷贝,哪些转换会搬运数据。