
第29篇|ndarray 基础:dtype、shape、内存布局
本篇定位:《Python 教程》专栏三「NumPy 数值计算」开篇。承接专栏二「能编排、能服务」之后,进入连续内存上的多维数组:弄清
dtype、shape、内存布局(C/F 连续与 strides 直觉),为索引视图、广播、向量化、手写 MLP,以及专栏四 PyTorch Tensor 打地基。读完你将能够:用
uv add numpy建环境并创建常见数组;解释dtype/itemsize/nbytes;读懂并改写shape、ndim、size、reshape;用flags/strides区分 C 连续与 F 连续;说清「元数据 + 数据缓冲」模型,并预告视图与拷贝。预计用时:阅读 35~45 分钟,动手 40~60 分钟。
专栏二用十四篇把「写得对、测得住、连得上、编排得起」立住了;从本篇起,数据从 JSON 消息换成同质、定长、连续(或按步长可寻址)的字节块。一句话定心:ndarray = 一块 typed buffer + 一份描述它的元数据(dtype、shape、strides)。
建议边读边开练习目录:uv init --no-package,再 uv add numpy。本系列默认 Python 3.12 + uv;示例用 uv run python 即可。没有 GPU、没有 PyTorch 也不影响——本篇只谈 CPU 上的 NumPy 心智;第 37 篇再谈与 Tensor 互转。
阅读顺序:为何需要 ndarray → 创建数组 → dtype → shape/reshape → 内存布局与 strides 直觉 → 和 AI Infra 的挂钩 → 踩坑。每个概念都配可运行代码与预期输出。
本篇不穷尽全部创建函数与全部 dtype 字符串,不深入广播与 ufunc(第 31、32 篇),不把 stride 公式讲透(第 35 篇)。主线是:对象 vs buffer 的差 → 创建 → dtype → shape → 布局直觉 → 为视图/拷贝铺路。
和第 02 篇对照:那里讲 Python「一切皆对象、引用与 id」;本篇讲「数值计算为何要暂时离开对象协议」。和第 04 篇对照:list 适合异质、变长容器;ndarray 适合同质、定长、要加速的数值。和第 28 篇对照:Agent 循环编排工具;本专栏让「算」这件事变快——以后你可以给 Agent 挂一个 np_dot 工具。
动手时建议「先建、再看属性、再改形状、再看 flags」四步:先 np.array / zeros;再打印 dtype、shape、strides;再 reshape;最后对比 order='C' 与 order='F'。做完后你会对「为什么向量化快」有肌肉记忆,而不是只记住一句「NumPy 很快」。
写数值代码时保持工程直觉:先定 dtype 与 shape,再谈算法;「默认 float64 通吃」在玩具脚本里方便,在显存/带宽敏感场景会立刻变成成本。排障时一条最小打印(a.dtype, a.shape, a.flags['C_CONTIGUOUS'], a.strides),往往比一百次「再试一次 reshape」更值钱。
也可以把本篇看成专栏三的「地基课」:后面索引切片、广播、向量化、线性代数、随机统计、stride 原理、手写 MLP,全都挂在本篇的元数据模型上。PyTorch 的 Tensor 几乎是同一套语言换皮——先把 NumPy 说清楚,专栏四会轻松很多。
写数值代码时再记一条:先让小例子的 dtype / shape 正确,再放大到百万元素。 很多人倒过来「先写三层循环再谈向量化」,修的时候容易把 Python 对象协议又请回来——速度又变成复杂度放大器。
和「背完整 NumPy API」相比,本篇更看重三件套直觉:dtype(格子是什么)、shape(怎么排成几维)、布局(内存里怎么扫)。会这三样,查文档时才知道该搜什么;不会这三样,背一百个函数名也会在广播与视图上翻车。
若你刚从第 28 篇 Agent 过来,前两节会换一种体感:同样是「数据」,但挂钩点从「消息列表里的 dict」换成「缓冲里的原始字节」。把 list 乘法与 ndarray 乘法各跑一遍计时——数量级差一出来,专栏三的存在理由就不抽象了。
动手前再立一条纪律:创建时写清 dtype;变形后打印 shape;共享前问 shares_memory。 先对 (3,) 与 (2, 3) 跑通并看 flags,再引入转置与 F 序。很多人倒过来「先 transpose 再猜为什么慢」,排障成本会高一个数量级。
和「在聊天里口头说会用 NumPy」相比,可运行示例的价值是:机器可重复、属性可打印、视图可证伪——本地与 CI 上同一套结论。排障时你面对的是「谁改了缓冲、谁触发拷贝、谁 dtype 不对」,而不是「我记得好像 reshape 过」。
也可以把本篇看成「从对象世界踏进 buffer 世界」的海关手续:护照上盖三个章——dtype、shape、strides。后面每篇都是在这本护照上盖新签证;没有护照,广播与 MLP 都会变成抄作业。
一、为什么需要 ndarray?
1.1 list 能算,但算不快
Python 的 list 是动态数组,元素是对象引用。三个 float 并不是并排躺着的三个 8 字节,而是三个完整的 PyFloat 对象(带引用计数、类型指针等),外加 list 里的三个指针。对每个元素做加法,解释器都要:取出引用 → 拆箱 → 运算 → 再装箱成新对象。
xs = [1.0, 2.0, 3.0]
ys = [x * 2 for x in xs]
print(ys)
[2.0, 4.0, 6.0]
结果正确,但当长度变成百万、运算变成多层嵌套循环时,开销会爆。第 01 篇已经说过:纯 Python 数值循环比 C 慢几十到上百倍——瓶颈往往不在「算术本身」,而在对象协议。
1.2 一张图:list 与 ndarray 的内存差
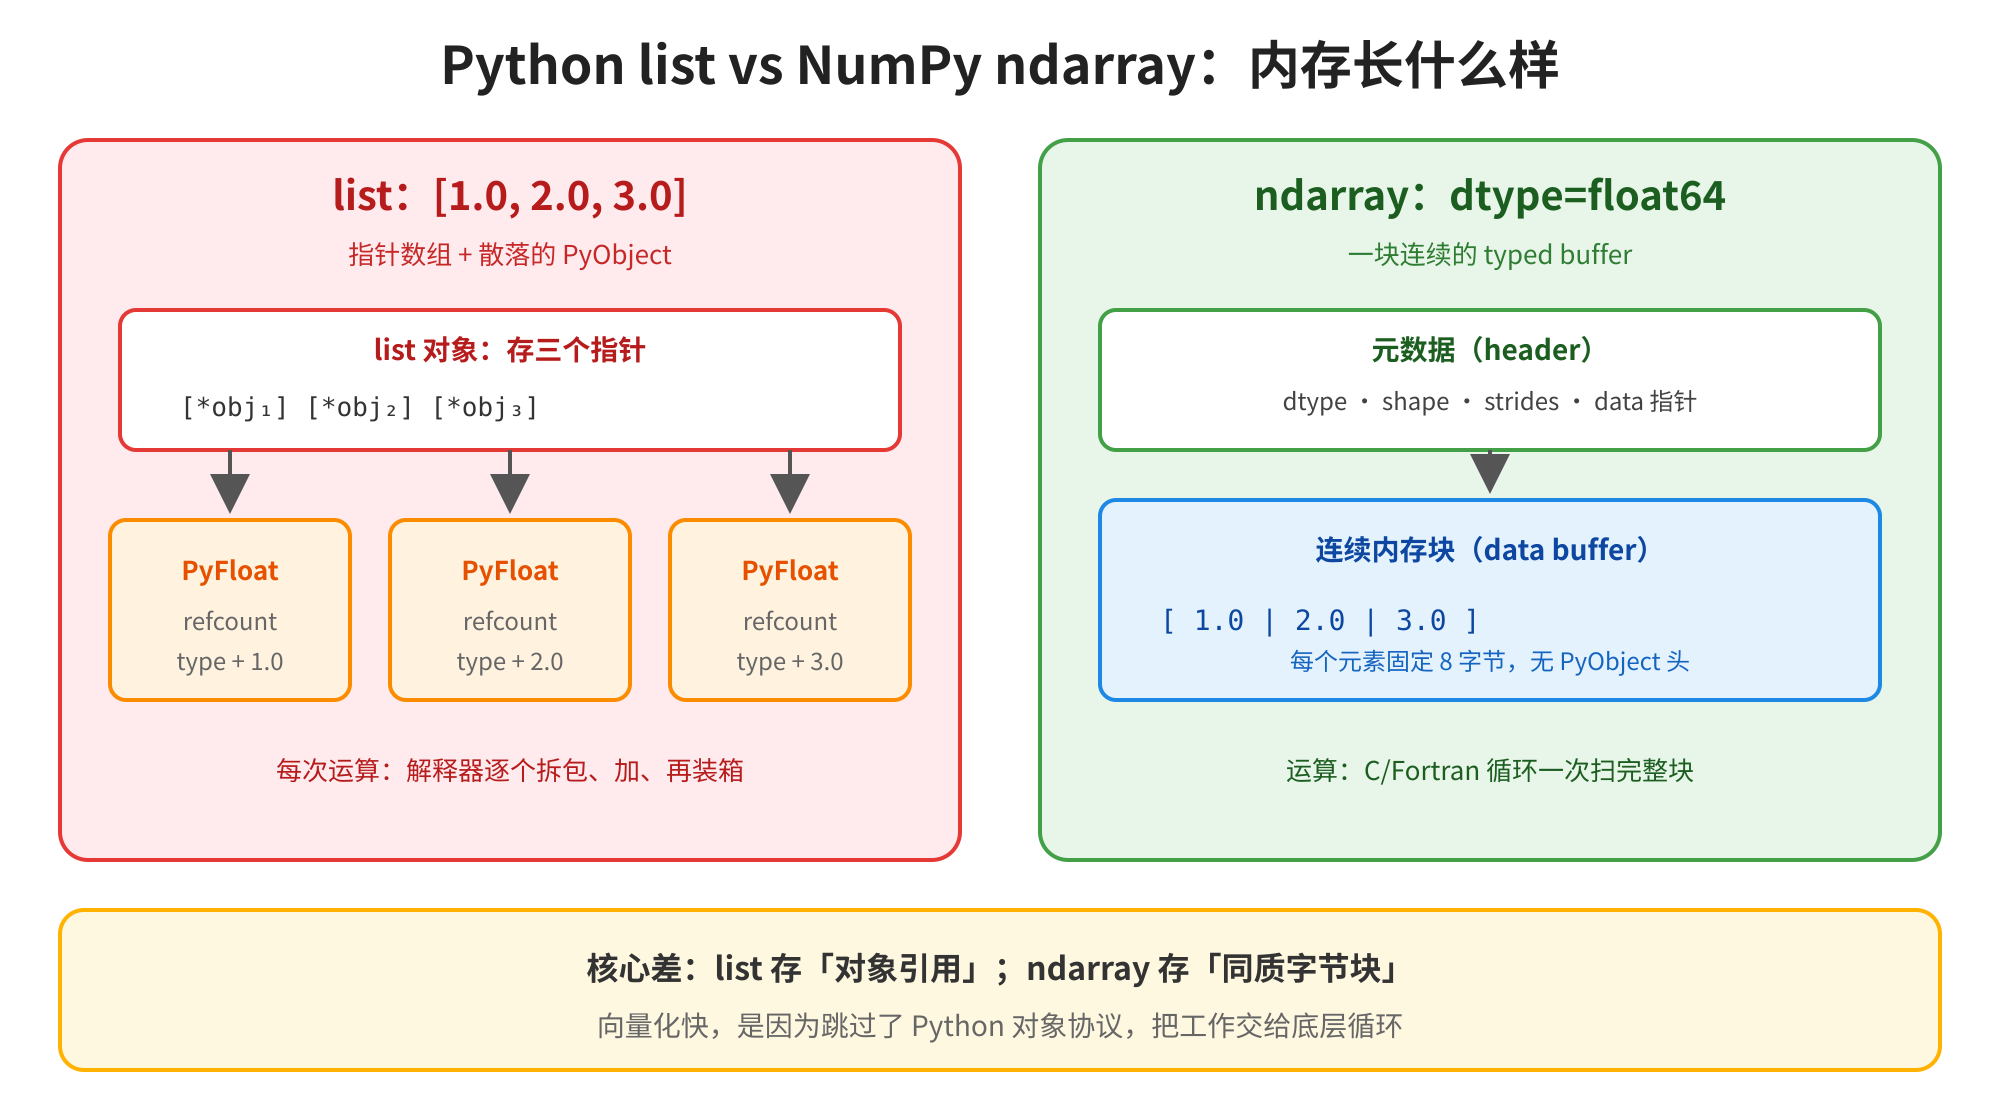
图1 Python list vs NumPy ndarray:内存长什么样
import numpy as np

a = np.array([1.0, 2.0, 3.0])
print(type(a), a.dtype, a.shape, a.nbytes)
<class 'numpy.ndarray'> float64 (3,) 24
三个 float64:3 × 8 = 24 字节数据缓冲;外加一份不大的元数据。运算时 Python 只负责「下指令」,真正循环在底层完成——这就是向量化的入口(第 32 篇展开)。
AI Infra 视角:训练与推理里的权重、激活、KV Cache,本质上都是「大块 typed buffer」。NumPy 是 CPU 侧的标准说法;PyTorch Tensor / CUDA buffer 是同一心智的延伸。不会读
dtype与shape,后面谈显存与带宽都会飘。
1.3 安装与约定
uv init --no-package
uv add numpy
uv run python -c "import numpy as np; print(np.__version__)"
下文统一 import numpy as np。打印属性时请养成习惯:dtype、shape、ndim、size、itemsize、nbytes、strides、flags——本篇后半会逐项点到。
1.4 什么时候仍该用 list?
不是所有东西都该进 ndarray。下面这些场景,list / dict 往往更合适:
- 异质结构:一行里混着字符串、嵌套 dict、可变长列表。
- 频繁在中间插入/删除:
list的语义就是动态序列;ndarray 定长,改长度通常意味着新分配。 - 元素本身是 Python 对象且需要身份语义:例如缓存「模型实例」列表。
经验法则:算法核心是「同类型数字的批量运算」→ ndarray;编排、配置、异质消息 → Python 容器。 Agent 的 messages 用 list;消息里的 embedding 向量用 ndarray——两者可以共存。
1.5 和「纯 Python 矩阵类」差在哪
你可以手写一个 Matrix 类,用嵌套 list 存数据并实现 add。教学上有趣,工程上会输在三处:
- 没有同质缓冲:仍走对象协议。
- 没有成熟的 dtype / BLAS 后端:乘法不会自动接到优化内核。
- 没有生态:SciPy、pandas、PyTorch 都认 ndarray(或与之零拷贝互操作的缓冲协议)。
因此本专栏直接学 NumPy,而不是先造一轮玩具矩阵——把时间花在会读布局、会控 dtype上,比再实现一遍加法更划算。
二、创建数组:从 Python 容器到 buffer
2.1 np.array:最常用的入口
import numpy as np

a = np.array([1, 2, 3])
b = np.array([[1.0, 2.0], [3.0, 4.0]])
c = np.array([1, 2, 3], dtype=np.float32)
print(a.dtype, b.dtype, c.dtype)
print(a.shape, b.shape, c.shape)
int64 float64 float32
(3,) (2, 2) (3,)
(具体整数默认位宽可能因平台略有差异;现代 64 位 Linux 上常见 int64。)要点:
- 嵌套 list 的层数 → ndim;每层长度一致才能变成规则矩形数组。
- 不写
dtype时,NumPy 会从数据推断(全整数 → 整数 dtype;出现浮点 → 浮点)。 - 显式
dtype=是工程习惯:训练脚本里常见float32,掩码用bool,索引用整数。
2.2 工厂函数:zeros / ones / full / empty / arange / linspace
import numpy as np

z = np.zeros((2, 3))
o = np.ones((2,), dtype=np.int32)
f = np.full((2, 2), 7)
e = np.empty((2, 2))          # 未初始化,内容不确定
r = np.arange(0, 10, 2)
l = np.linspace(0, 1, 5)
print(z)
print(o, r, l)
[[0. 0. 0.]
 [0. 0. 0.]]
[1 1] [0 2 4 6 8] [0.   0.25 0.5  0.75 1.  ]
import numpy as np

eye = np.eye(3)
diag = np.diag([1, 2, 3])
print(eye)
print(diag)
[[1. 0. 0.]
 [0. 1. 0.]
 [0. 0. 1.]]
[[1 0 0]
 [0 2 0]
 [0 0 3]]
随机数组(np.random)本篇只用到「能建」;分布与种子纪律留给第 34 篇。
2.3 从已有数组再造:zeros_like / astype / copy
import numpy as np

a = np.array([[1, 2], [3, 4]], dtype=np.int64)
b = np.zeros_like(a, dtype=np.float32)
c = a.astype(np.float64)
d = a.copy()
print(b.dtype, c.dtype, np.shares_memory(a, d))
float32 float64 False
astype 通常会分配新缓冲(即使目标 dtype 相同,默认也可能拷贝——以文档与 copy= 参数为准)。需要「同形状、同布局的空壳」时,用 zeros_like / empty_like 比手写 zeros(a.shape) 更不易漏维。
2.4 asarray vs array:何时避免多余拷贝
import numpy as np

x = [1, 2, 3]
a = np.array(x)          # 总是新数组(相对输入而言)
b = np.asarray(x)        # 若已是 ndarray 且 dtype/order 合适,可避免拷贝
c = np.asarray(a)
print(np.shares_memory(a, c))
True
写库函数时,入口常用 np.asarray:调用方传入 ndarray 则尽量零拷贝复用;传入 list 再转换。需要「铁定独立副本」时用 np.array(..., copy=True) 或 .copy()(具体默认随 NumPy 版本略有演化,以你环境的文档为准,关键是意图写清楚)。
2.5 只读与可写:flags.writeable
import numpy as np

a = np.arange(4)
a.setflags(write=False)
try:
    a[0] = 1
except ValueError as e:
    print(type(e).__name__, ":", str(e)[:40])
ValueError : assignment destination is read-only
只读视图在「对外暴露缓冲但不允许篡改」时很有用;也解释了某些库返回的数组为何改不了——不是坏了,是 writeable=False。
三、dtype:每个格子多大、怎么解释
3.1 常见 dtype 一览
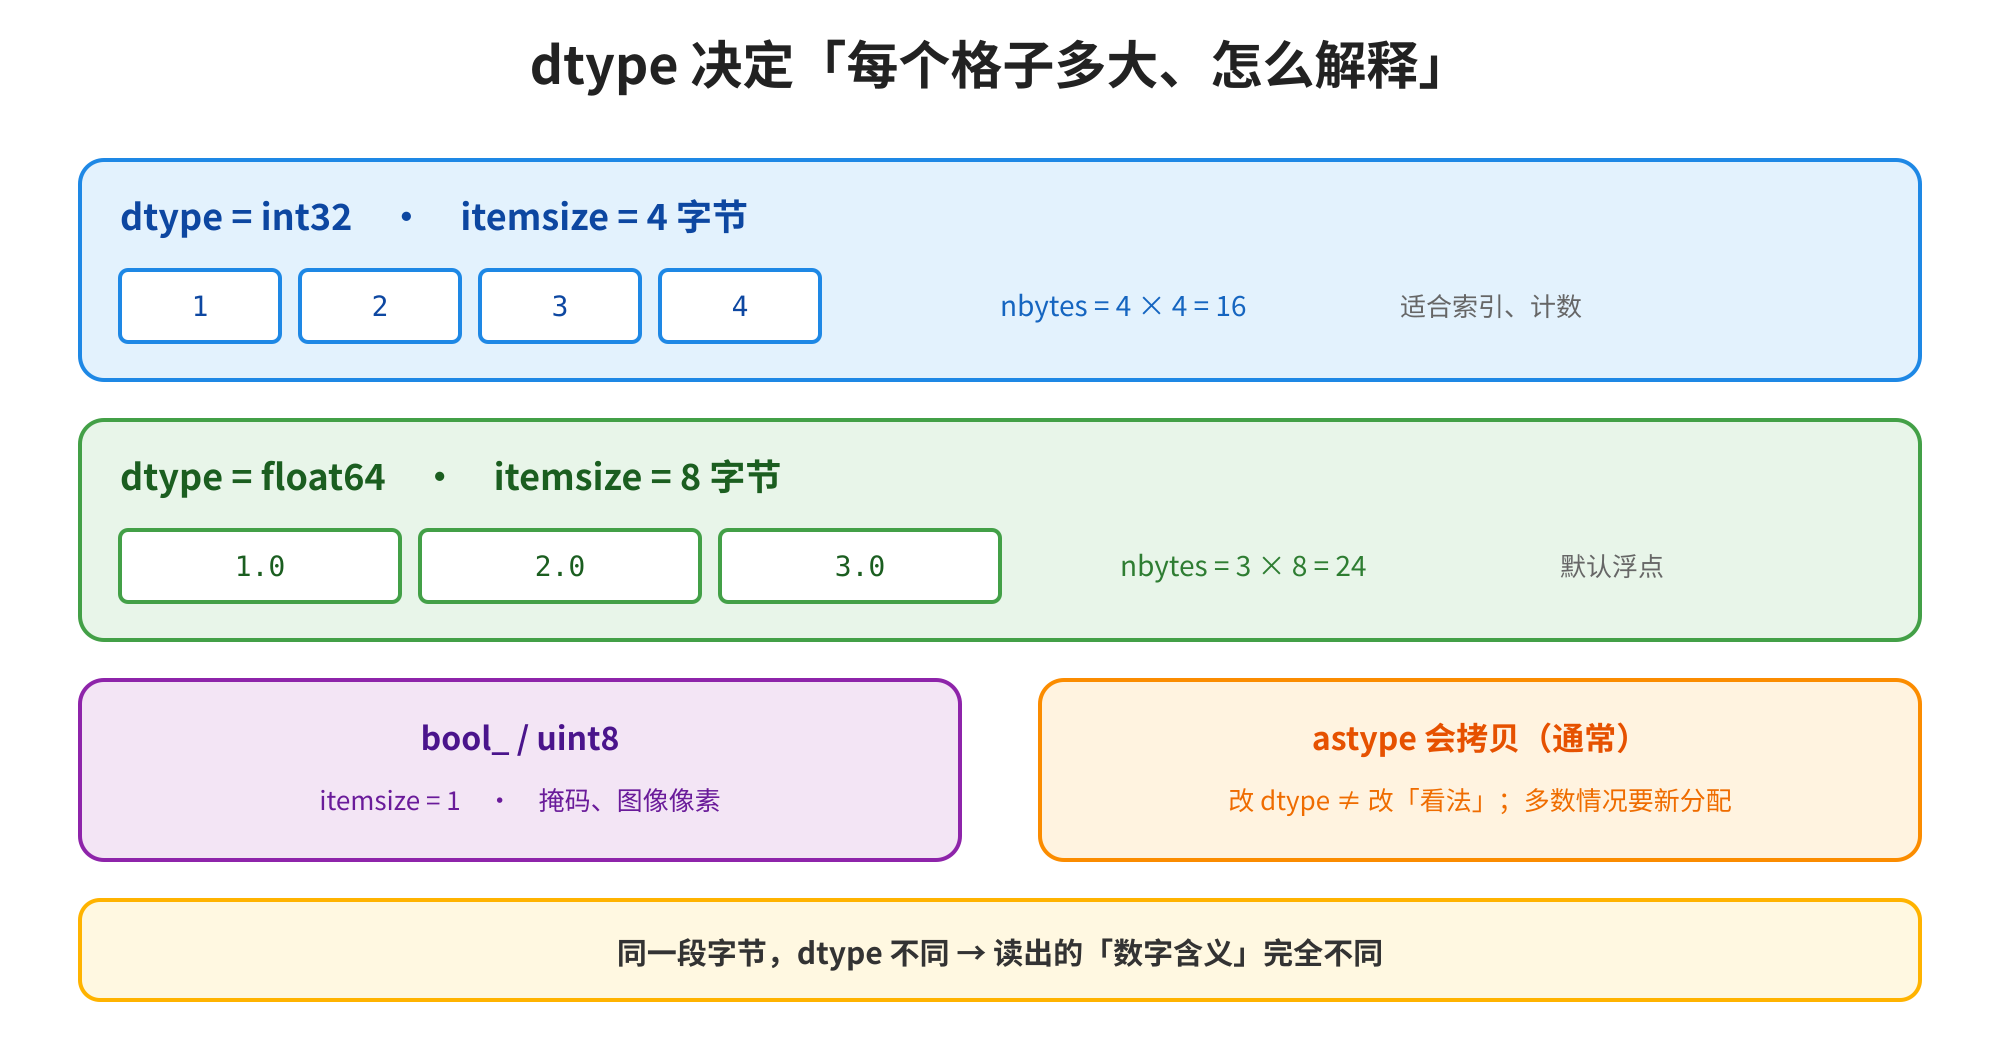
图2 dtype 决定「每个格子多大、怎么解释」
import numpy as np

for dt in [np.bool_, np.uint8, np.int32, np.float32, np.float64]:
    x = np.array([1, 2, 3], dtype=dt)
    print(dt, x.dtype, x.itemsize, x.nbytes)
<class 'numpy.bool'> bool 1 3
uint8 uint8 1 3
int32 int32 4 12
float32 float32 4 12
float64 float64 8 24
nbytes = size × itemsize(对连续数组成立;有偏移/子视图时「逻辑 nbytes」与「底层分配」可能更绕,本篇先记连续情况)。
3.2 推断、强制与溢出
import numpy as np

print(np.array([1, 2, 3]).dtype)
print(np.array([1.0, 2, 3]).dtype)
print(np.array([1, 2, 3], dtype=np.float32).dtype)

u = np.array([250, 251, 252], dtype=np.uint8)
print(u + 10)   # 溢出按 dtype 模运算,不会自动升位
int64
float64
float32
[4 5 6]
uint8 上 250 + 10 变成 4(模 256),这是按位宽截断,不是 bug。图像处理里常见;若你期望大整数,先升到 int32 / int64 / float。
3.3 字符串与对象 dtype(知道边界即可)
import numpy as np

s = np.array(["a", "bc"], dtype="U4")
print(s.dtype, s)
o = np.array([1, "x"], dtype=object)
print(o.dtype, o)
<U4 ['a' 'bc']
object [1 'x']
object dtype 又退回「存引用」——向量化红利大减。本专栏主线是数值 dtype;结构化 dtype / 字符串阵列点到为止。
AI Infra 视角:模型权重常用
float16/bfloat16/float32;量化权重可能是int8。同一算法,dtype 一变,数值范围、精度与吞吐全变。 先在 NumPy 里养成「打印 dtype」的习惯,上 GPU 后会少踩很多坑。
3.4 字节序与 dtype 字符串写法
import numpy as np

print(np.dtype("float32"))
print(np.dtype(np.float32))
print(np.dtype("<f4"), np.dtype(">f4"))  # 小端 / 大端
float32
float32
float32 >f4
日常写 np.float32 或 "float32" 即可。读写跨平台二进制文件时才会认真对待字节序(< / >)。本篇只需知道:dtype 不只是「名字」,还包含大小、符号、字节序等完整描述。
3.5 从 buffer 协议看「为何能和别的库握手」
许多库(含部分 PyTorch 路径、内存映射、共享内存)通过 Python buffer 协议交换裸字节,而不必来回 tolist()。ndarray 天生支持这套协议——这是它成为数值生态「普通话」的原因之一。你暂时不必手写 buffer 接口;只要记住:能保持 ndarray / Tensor,就不要无必要地拆成 Python list。
四、shape、ndim、size 与 reshape
4.1 形状三件套
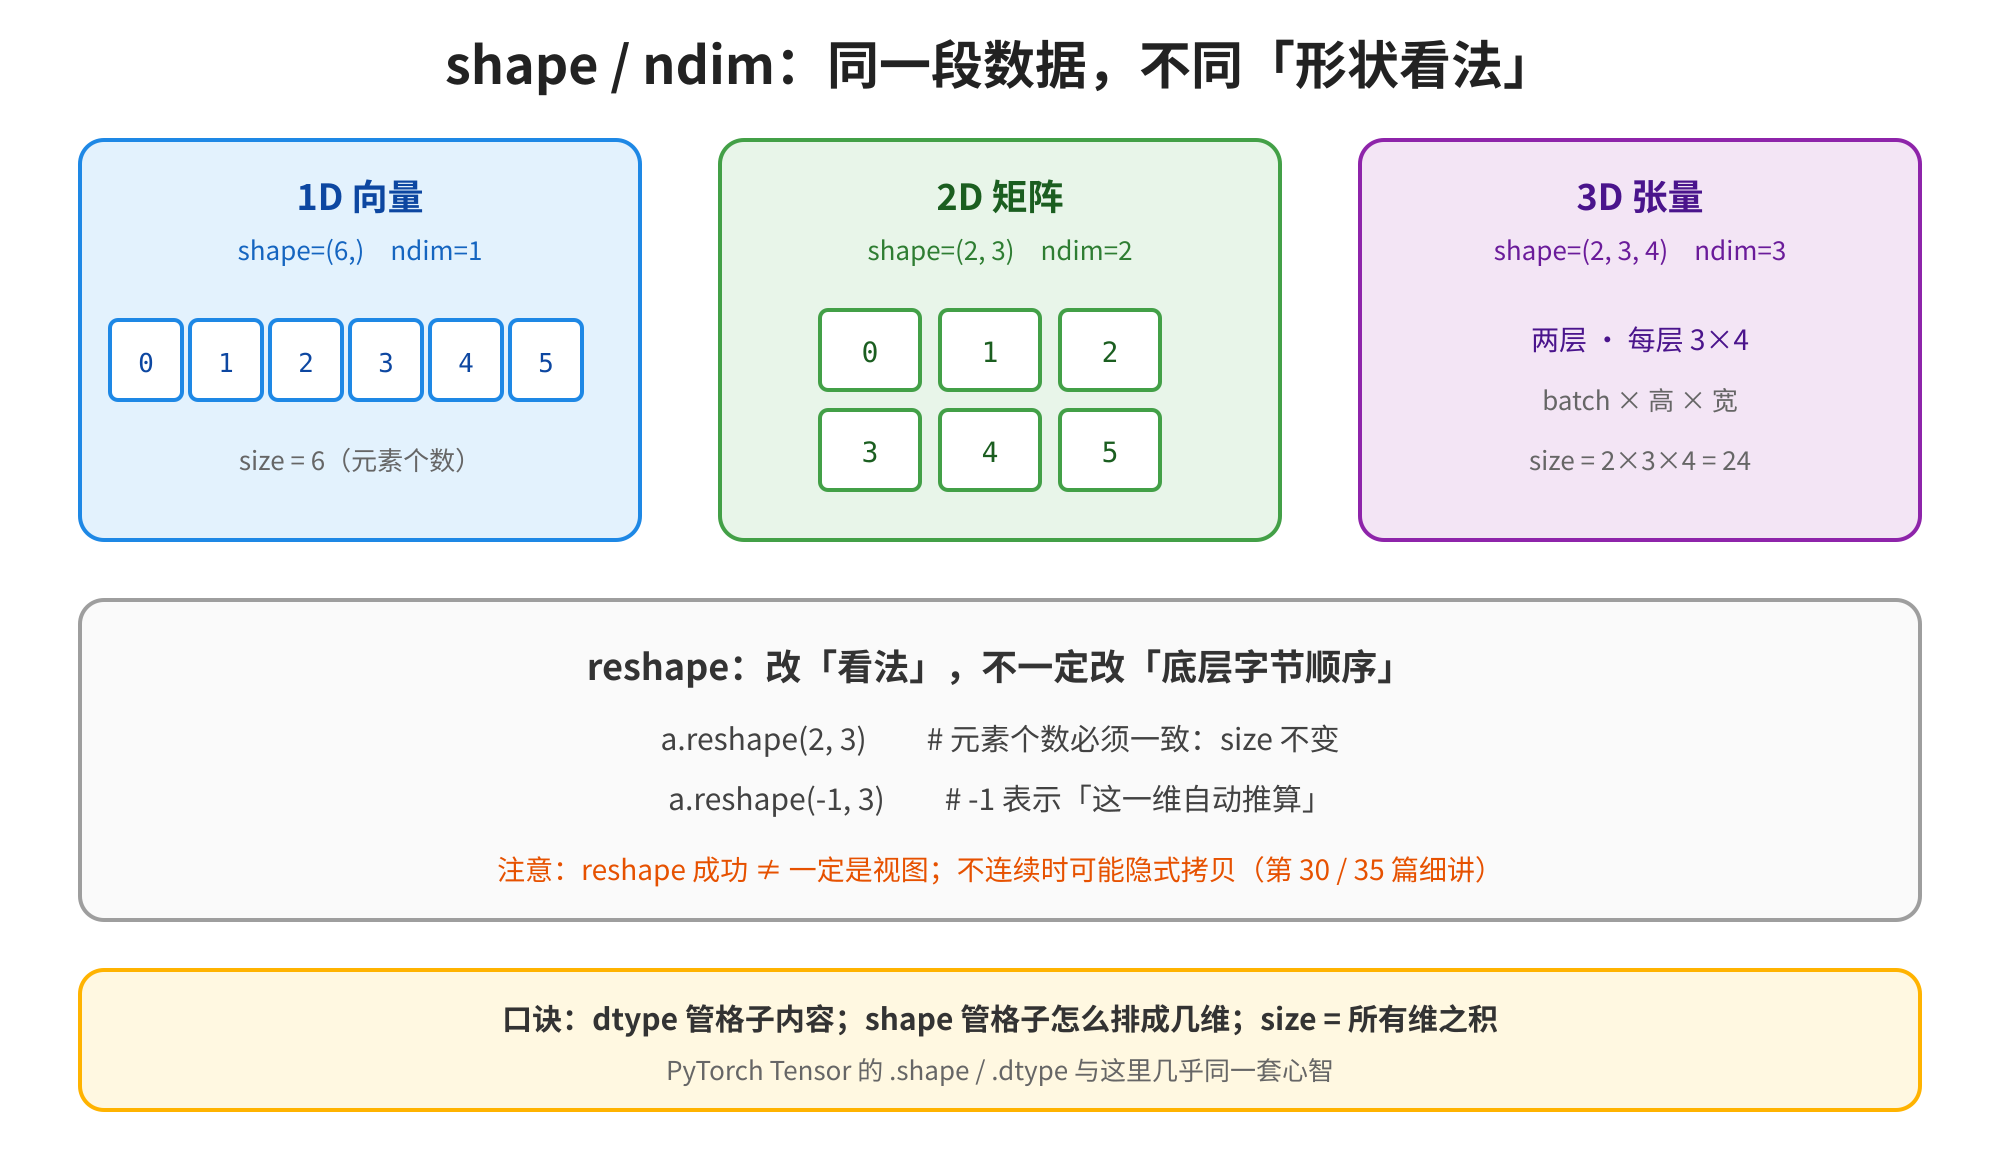
图3 shape / ndim:同一段数据,不同「形状看法」
import numpy as np

a = np.arange(6)
b = a.reshape(2, 3)
c = np.zeros((2, 3, 4))
print(a.shape, a.ndim, a.size)
print(b.shape, b.ndim, b.size)
print(c.shape, c.ndim, c.size)
(6,) 1 6
(2, 3) 2 6
(2, 3, 4) 3 24
注意:(6,) 是一维;(6, 1) 与 (1, 6) 是二维——后面广播(第 31 篇)会严格区分它们。
4.2 reshape:改看法,元素个数不能变
import numpy as np

a = np.arange(12)
print(a.reshape(3, 4))
print(a.reshape(2, -1))      # -1 = 自动推算
print(a.reshape(2, 2, 3).shape)
# a.reshape(5, 3)  # ValueError:size 对不上
[[ 0  1  2  3]
 [ 4  5  6  7]
 [ 8  9 10 11]]
[[ 0  1  2  3  4  5]
 [ 6  7  8  9 10 11]]
(2, 2, 3)
reshape 优先返回视图(共享缓冲);若当前内存布局无法用新 strides 表达,则可能隐式拷贝。本篇先记住口诀:「成功 reshape ≠ 一定没拷贝」;用 np.shares_memory 自查。细则留给第 30、35 篇。
import numpy as np

a = np.arange(6)
b = a.reshape(2, 3)
print(np.shares_memory(a, b))
b[0, 0] = 99
print(a)   # 若共享,原数组也被改
True
[99  1  2  3  4  5]
这正是「元数据变了、缓冲没变」的现场——下一篇会系统讲视图与拷贝。
4.3 ravel / flatten / 改 shape 属性
import numpy as np

m = np.arange(6).reshape(2, 3)
print(m.ravel())       # 通常视图(C 连续时)
print(m.flatten())     # 总是拷贝
m2 = m.copy()
m2.shape = (3, 2)      # 原地改 shape(要求兼容)
print(m2)
[0 1 2 3 4 5]
[0 1 2 3 4 5]
[[0 1]
 [2 3]
 [4 5]]
初学更推荐 reshape 返回新对象(或赋给新名),少直接改 .shape,可读性更好。flatten 要「铁定拷贝」时用;日常展平优先 ravel / reshape(-1),并清楚是否共享。
五、内存布局:C 连续、F 连续与 strides 直觉
5.1 同一矩阵,两种铺法
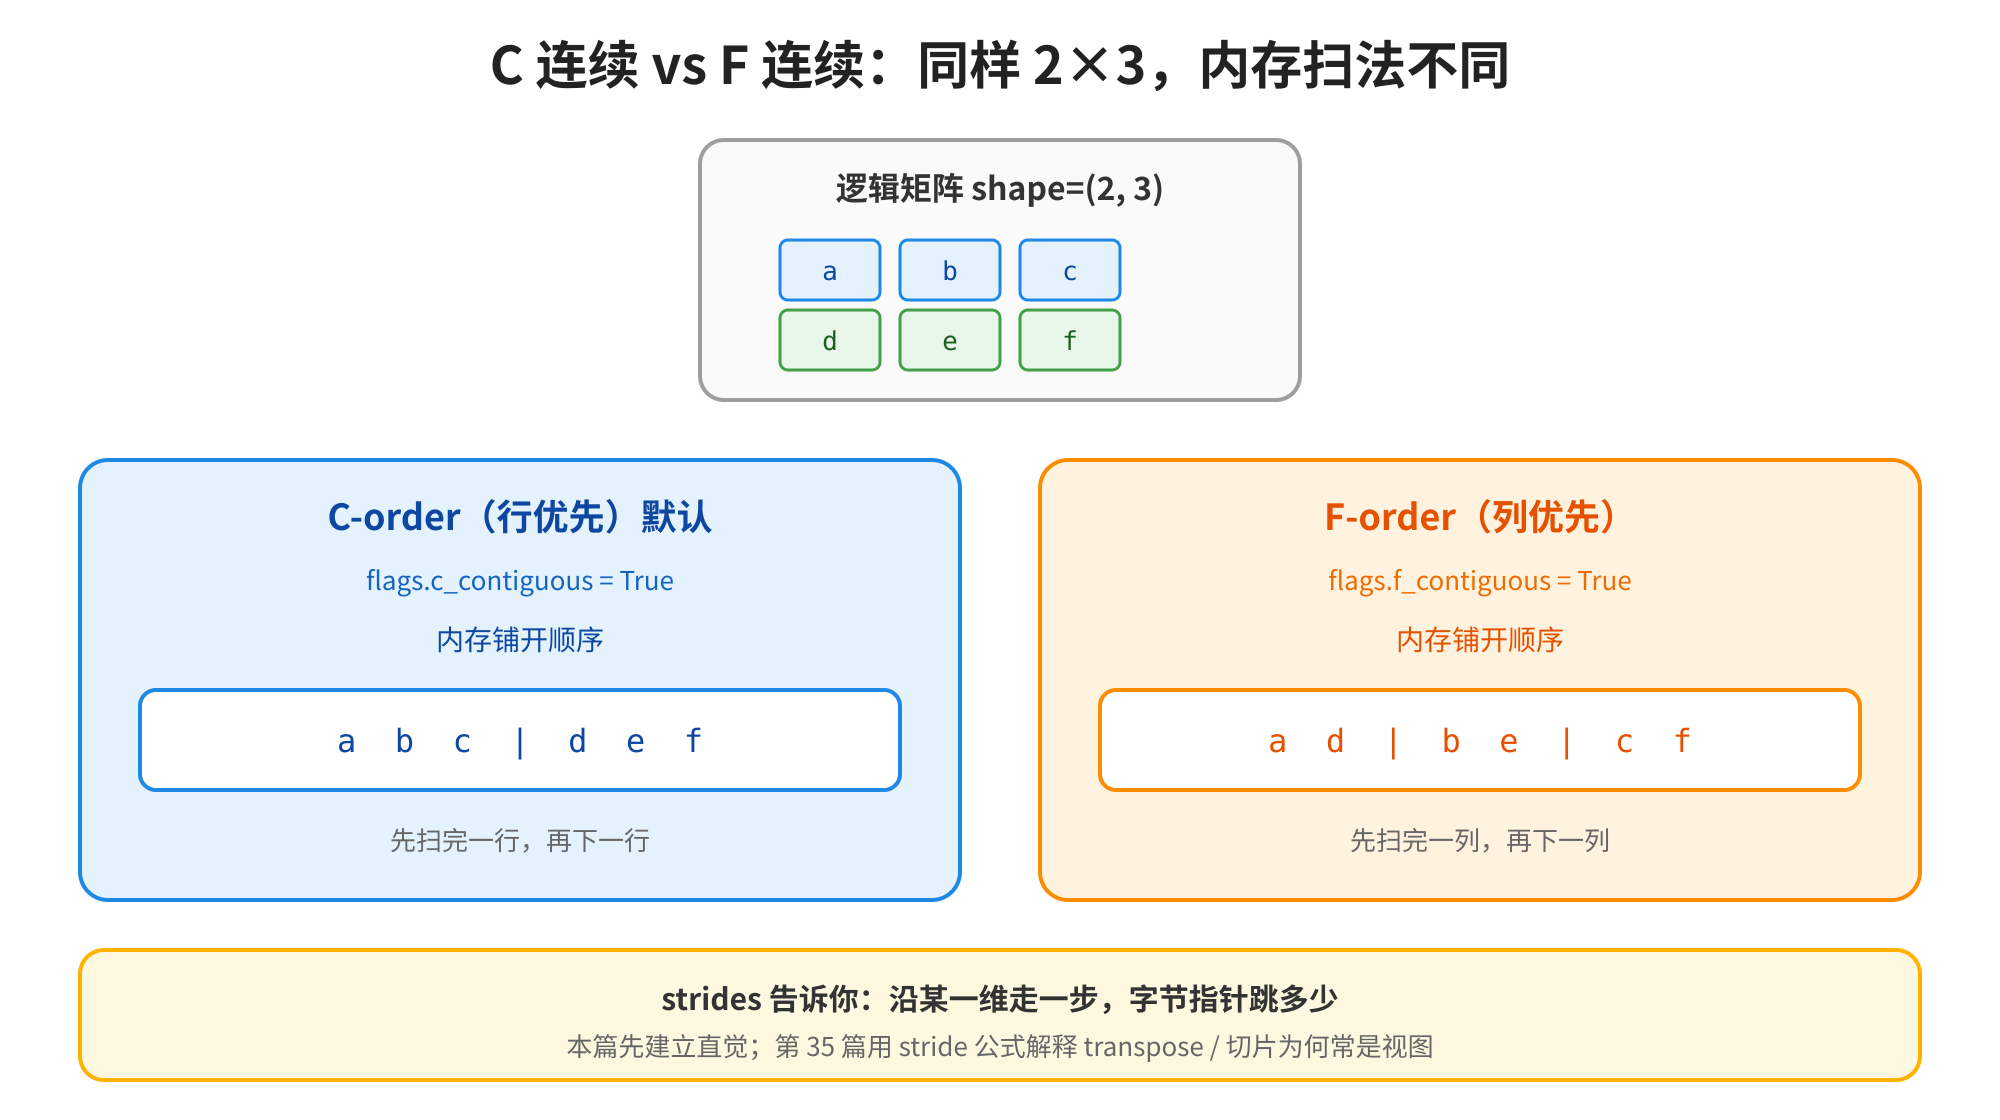
图4 C 连续 vs F 连续:同样 2×3,内存扫法不同
import numpy as np

c = np.array([[1, 2, 3], [4, 5, 6]], order="C")
f = np.array([[1, 2, 3], [4, 5, 6]], order="F")
print("C:", c.flags["C_CONTIGUOUS"], c.flags["F_CONTIGUOUS"], c.strides)
print("F:", f.flags["C_CONTIGUOUS"], f.flags["F_CONTIGUOUS"], f.strides)
print(np.asarray(c).ravel(order="K"))  # 按内存实际顺序看
C: True False (24, 8)
F: False True (8, 16)
[1 2 3 4 5 6]
对 float64 的 (2, 3):
- C-order(行优先,默认):内存里是
1 2 3 4 5 6;strides=(24, 8)表示「下行跳 24 字节(3×8),右列跳 8 字节」。 - F-order(列优先):内存里是
1 4 2 5 3 6;strides=(8, 16)。
多数 Python / C 生态默认 C 连续;部分科学计算与 Fortran 血统库偏好 F。和 BLAS / 某些转置结果打交道时,flags 会解释「为什么拷了一份」。
5.2 strides:走一步跳多少字节
import numpy as np

a = np.arange(6, dtype=np.float64).reshape(2, 3)
print(a)
print("strides:", a.strides)
print("itemsize:", a.itemsize)
# 元素 a[i, j] 的字节偏移 ≈ i * strides[0] + j * strides[1]
[[0. 1. 2.]
 [3. 4. 5.]]
strides: (24, 8)
itemsize: 8
不必本篇背公式;先建立直觉:shape 说「有几格」,strides 说「沿维走时指针怎么跳」。转置、切片、广播,很多「零拷贝」技巧都靠改 strides(第 35 篇)。
5.3 元数据 + 缓冲:一张总图
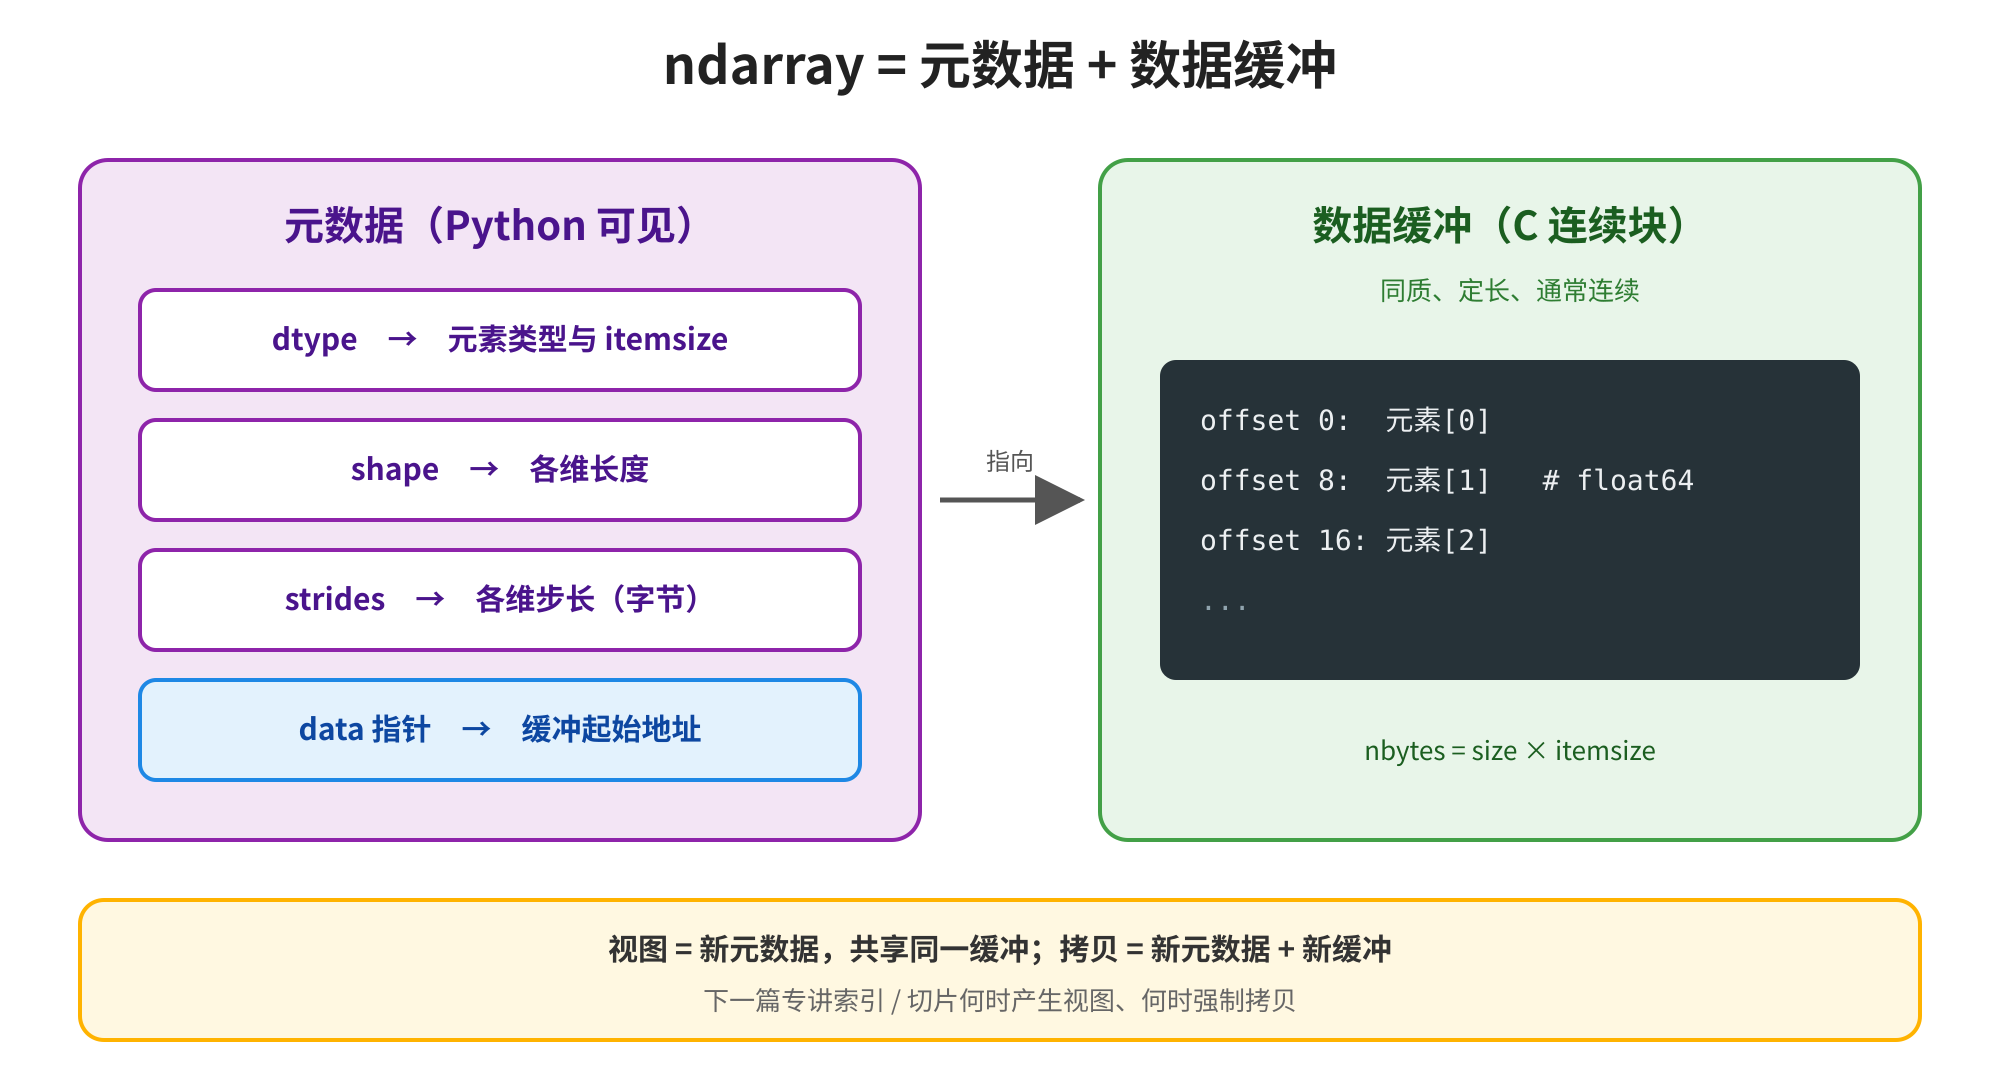
图5 ndarray = 元数据 + 数据缓冲
请把 ndarray 记成两层:
- 元数据:
dtype、shape、strides、数据指针、可写标志等。 - 数据缓冲:真正的字节块。
于是:
- 视图(view):新元数据,共享缓冲 → 改视图常改原数组。
- 拷贝(copy):新元数据 + 新缓冲 → 互不影响。
import numpy as np

base = np.arange(4)
view = base.view()
copy = base.copy()
view[0] = 100
copy[1] = 200
print(base)   # 被 view 改到;不被 copy 改到
[100 1 2 3]
下一篇会专门讲:哪些索引/切片产生视图、哪些强制拷贝、如何用 base / owns_data / shares_memory 诊断。
AI Infra 视角:GPU 上「多一个不必要的拷贝」= 多一次 PCIe/HBM 流量。CPU 上 NumPy 养成「先问是不是视图」的习惯,迁到 PyTorch 时同样受用:
.view()/.reshape()/.contiguous()的语义血缘,就在本篇的布局模型里。
5.4 contiguous:什么时候需要「收回连续」
转置、跨步切片之后,数组可能仍共享原缓冲,但不再 C 连续。某些底层 API(部分 BLAS、必须按行扫的 C 扩展)会要求连续块,于是出现:
import numpy as np

a = np.arange(12).reshape(3, 4)
t = a.T
print(t.flags["C_CONTIGUOUS"], t.strides)
c = np.ascontiguousarray(t)
print(c.flags["C_CONTIGUOUS"], np.shares_memory(t, c))
False (4, 12)
True False
ascontiguousarray 在已连续时尽量不拷贝,否则分配新缓冲并按 C 序重排。PyTorch 里的 .contiguous() 是近亲。本篇先认识「不连续是常态之一」;第 30、35 篇会说明切片如何制造不连续。
5.5 小练习:用 strides 手算偏移
对 float64 的 shape=(2, 3)、strides=(24, 8):
a[0, 0]偏移0a[0, 2]偏移0*24 + 2*8 = 16a[1, 1]偏移1*24 + 1*8 = 32
用代码核对:
import numpy as np

a = np.arange(6, dtype=np.float64).reshape(2, 3)
for i in range(2):
    for j in range(3):
        off = i * a.strides[0] + j * a.strides[1]
        print(f"a[{i},{j}] value={a[i,j]} offset={off}")
你会看到偏移正好是「第几个元素 × 8」。这就是 strides 的日常用法:解释下标如何映射到字节。
六、和前后篇、和工程的挂钩
6.1 和 Python 对象模型的关系
第 02 篇的「引用与 id」仍然成立:ndarray 自身是一个 Python 对象;但它的元素通常不是 Python 对象,而是缓冲里的原始字节。a[0] 取标量时,NumPy 会「临时装箱」成 numpy.float64 之类——看起来像 Python 数,却不是任意精度的 int / 普通 float 的全部行为。
import numpy as np

a = np.array([1.5])
x = a[0]
print(type(x), isinstance(x, float), float(x))
<class 'numpy.float64'> True 1.5
写入 JSON / 某些 ORM 时,偶发需要 float(x) / x.item() 转成原生 Python 标量——踩坑节会再提。
6.2 最小性能对照(感受数量级)
import time
import numpy as np

n = 1_000_000
py = list(range(n))
t0 = time.perf_counter()
_ = [x * 2 for x in py]
t1 = time.perf_counter()
arr = np.arange(n, dtype=np.float64)
_ = arr * 2
t2 = time.perf_counter()
print(f"list: {t1 - t0:.4f}s  ndarray: {t2 - t1:.4f}s")
list: 0.0xxx s ndarray: 0.00xx s
具体数字随机器而变;你应看到 ndarray 明显更快(往往一个数量级以上)。这不是魔法,而是「少对象协议、多连续访问、底层循环」。
6.3 专栏三路线图(带着地图读)
6.4 和 pandas / PyTorch 的一句话关系
- pandas:
Series/DataFrame底层常是 ndarray(或 Arrow);列 dtype 的心智与本篇一致,只是多了标签与缺失值语义。 - PyTorch:
torch.Tensor有dtype、shape、stride、device;CPU Tensor 与 NumPy 可互转(第 37 篇)。先掌握本篇,再学 Tensor,是加法而不是重学一门外语。
6.5 工程检查清单(贴在显示器边上)
- 创建后立刻看:
dtype、shape。 - 变形后立刻看:
shape、是否shares_memory。 - 交给底层 / 存盘前看:是否 C 连续、
nbytes是否符合预期。 - 和 Python 生态交界:标量用
.item(),容器用tolist()(仅在真正需要时)。 - 性能怀疑时:先确认没在 Python 层逐元素循环,再谈算法。
七、踩坑大全
通用
- 坑 1:把
empty当零数组。 现象:结果「随机脏数据」。原因:empty只分配不初始化。解决:要零用zeros;要未初始化且马上写满再用empty。 - 坑 2:默认
float64通吃。 现象:内存/磁盘翻倍,和深度学习float32权重对不上。原因:NumPy 浮点默认双精度。解决:创建时显式dtype=,或统一astype。 - 坑 3:
uint8运算溢出。 现象:250 + 10 → 4。原因:定宽整数模运算。解决:先升 dtype 再算。 - 坑 4:
reshape后改子数组,原数组跟着变。 现象:「明明新建了变量却串改」。原因:共享缓冲的视图。解决:要独立数据用.copy();诊断用np.shares_memory。 - 坑 5:
(3,)与(3, 1)混用。 现象:广播结果形状「怪」、矩阵乘法维度报错。原因:一维与二维列向量不同。解决:打印shape;需要列向量时reshape(-1, 1)。 - 坑 6:jagged list 直接
np.array。 现象:得到dtype=object或报错。原因:各行长度不一致,构不成矩形。解决:先对齐 / padding,或改用列表的列表并接受 object(失去向量化)。
macOS
- 坑 7:多份 BLAS / Accelerate 混用导致诡异性能。 现象:同脚本有时快有时慢。原因:环境里多套数值库。解决:用 uv/venv 隔离;需要时查
np.show_config()。
Linux(含 GPU 服务器)
- 坑 8:系统 Python +
sudo pip install numpy。 现象:与系统包冲突或externally-managed-environment。原因:污染系统解释器。解决:始终uv/ venv;服务器上尤其不要 sudo pip。 - 坑 9:HDF5 / 内存映射文件上的数组「看起来像 ndarray」却很慢。 现象:切片一次巨卡。原因:底层可能按页读盘。解决:先理解数据在哪;热数据再
np.array(...)载入内存(细节超出本篇)。
Windows
- 坑 10:路径与编辑器解释器不一致。 现象:终端里
import numpy成功,IDE 红线。原因:选错解释器。解决:VS Code / Cursor 选中 uv 环境的 Python(第 01 篇)。
与下游交互
- 坑 11:
numpy标量进 JSON 失败。 现象:TypeError: Object of type float64 is not JSON serializable。解决:x.item()或float(x)/int(x)。 - 坑 12:和 PyTorch 互转时忽略
dtype/device。 现象:隐式拷贝或精度变化。解决:第 37 篇细讲;现在先养成「两侧都打印 dtype」的习惯。
读官方 NumPy「绝对基础」文档时,按本篇目录对照即可。入门阶段把「会建数组、会控 dtype、会读 shape 与 strides、会区分视图与拷贝的存在」做扎实,比背完整创建函数列表更重要。排障时一条最小可复现(打印四元组 dtype/shape/strides/flags),往往比一百次「再换一种 reshape」更值钱。
和「一切数组操作都先 tolist 再回来」的坏习惯相比,更值钱的是尽量留在 ndarray 世界里完成变换:你会控类型、会变形、会问是否共享,框架与底层内核只是加速器。把这个品味带进 code review,比强制「必须用某某封装」温和且有效。
八、小结
- ndarray = 元数据 + typed buffer:Python 对象描述
dtype/shape/strides,元素本身通常是连续(或按步长可寻址)的原始字节。 dtype决定格子的解释与itemsize;nbytes ≈ size × itemsize;显式 dtype 是工程刚需。shape/ndim/size描述形状;reshape改看法且要求size不变,可能是视图。- 默认 C 连续(行优先);F 连续是列优先;
strides描述「沿维跳多少字节」。 - 视图共享缓冲,拷贝不共享——这是第 30 篇的核心预告,也是性能与调试的总开关。
- 和 AI Infra 同构:Tensor / 显存上的权重与激活,是同一套「dtype + shape + 布局」语言;本篇是字典,后面是作文。
九、课后练习
- (基础) 创建
np.arange(12),分别reshape成(3, 4)、(2, 2, 3)、(12, 1),打印每次的shape、ndim、strides。 - (基础) 用
zeros/ones/full/eye各建一个数组,指定dtype=np.float32,确认itemsize == 4。 - (基础) 构造
uint8数组[200, 200],计算a + 100与a.astype(np.int32) + 100,解释差异。 - (理解) 对同一
np.arange(6).reshape(2, 3),比较order='C'与转置.T的flags与strides;用np.shares_memory(a, a.T)看是否共享。 - (理解) 写函数
describe(a):打印dtype, shape, ndim, size, itemsize, nbytes, strides, C_CONTIGUOUS;对随机三个数组调用。 - (理解) 证明:
b = a.reshape(...)后修改b.flat[0],在共享时会改a;再对a.copy().reshape(...)重复,确认不串改。 - (进阶) 计时对比:长度
10**6的 list 推导式平方 vsndarray ** 2;再试float32与float64的 ndarray,记录耗时与nbytes。 - (进阶 · AI Infra) 假设权重矩阵
shape=(4096, 4096):分别估算float32与float16的nbytes(MB);写 150 字说明为何推理框架关心 dtype 与连续布局。
下一篇预告
下一篇是《第30篇|索引、切片与视图/拷贝》——在本篇「元数据 + 缓冲」模型上,专门回答:a[i]、a[i:j]、花式索引、布尔掩码,哪些共享内存、哪些强制拷贝? 你会练会用 base / shares_memory / copy 诊断「改子数组为何改爆原数据」,并为广播与向量化扫清地雷。
专栏三后续:索引视图 → 广播 → 向量化 → 线性代数 → 随机统计 → stride 原理 → 手写 MLP。带着本篇的 dtype / shape / strides 三件套前进即可。
若想提前热身:对同一个数组分别做 a[:]、a[::2]、a[[0, 2]],用 np.shares_memory 猜谁是视图——带着答案进下一篇核对。
也可以把本篇收进你的「数值速查」:创建 → 看 dtype/shape → 看 flags/strides → 再谈算法。这个顺序比「先写出双层 for 再优化」更接近生产里的排障路径。
下一篇见。把 describe(a) 留在练习库里——专栏三每学一篇,就对更多数组跑一遍,你会亲眼看到视图、转置与广播如何改写元数据、却常常不动那块 buffer。
写完练习后,不妨在自己的仓库里开一小段笔记:只记录三组你亲手测过的 shares_memory 结果(reshape、切片、花式索引各一)。这种「小步实证」比空读「视图很快」更能把布局刻进肌肉记忆。
若你带新人,可以把图 1 与图 5 打印成一页速查:左列 list vs ndarray,右列元数据字段。新人第一次把 float64 权重误存成 object 数组时,对着图两分钟就能定位——工具文化是带出来的。
最后把专栏三的位置再钉一次:专栏一解决「语言与对象」;专栏二解决「工程与编排」;专栏三解决「算得快、算得清」——八篇之后,你应能在纯 NumPy 里写完一个可检查的 MLP 前向与反向。本篇是第一块砖:砖放正了,墙才不会歪。
进入第 30 篇之前,可把本节的 describe(a) 与 strides 手算留在练习库。数值篇学完后,你可以给第 28 篇的 Agent 加一个 np_matmul 工具——会编排也会算,才是 AI 工程的日常。