
第33篇|线性代数与矩阵乘法
本篇定位:专栏三「NumPy 数值计算」第五篇。承接第 32 篇的向量化与 ufunc:逐元素运算解决了“每个位置分别算什么”,本篇进入“沿哪些轴相乘并求和”的线性代数。
读完你将能够:区分
*、np.dot、@与np.matmul;按 shape 推导向量内积、矩阵乘法和批量矩阵乘法;使用转置、einsum和断言写出清晰的线性代数代码;把 GEMM、Attention 的QK^T和 MLP 线性层联系起来。预计用时:阅读 45~60 分钟,动手 60~80 分钟。
第 32 篇里,我们把高基数的逐元素循环交给 ufunc:a + b 会按广播后的每个坐标计算。可是神经网络里最常见的计算并不是只看同一个坐标。一个输出神经元要把输入特征逐项相乘,再把这些乘积加起来;Attention 要让每个 query 和所有 key 做相似度计算。这就是矩阵乘法。
先记住一条边界:* 是逐元素乘法,@ 是矩阵乘法;线性代数的核心是“乘法后沿指定维度求和”。 二者都可能只占一行,但 shape 规则、内存访问和底层内核完全不同。NumPy 的矩阵乘法是在 Python 表达式下面调用 C / BLAS 实现,AI Infra 里的 GEMM 又会把它映射到 CPU 向量指令或 GPU Tensor Core。
一、从向量内积到矩阵乘法
1.1 向量内积:乘完再加
给定两个长度相同的向量,内积(dot product)是对应元素乘积的总和:
x × y=sum_{i=1}^nx_i y_i
import numpy as np

x = np.array([1.0, 2.0, 3.0])
y = np.array([10.0, 20.0, 30.0])

print(x * y)
print(np.dot(x, y))
print(x @ y)
print((x @ y).shape)
[10. 40. 90.]
140.0
140.0
()
x * y 只完成逐元素乘法,结果仍然是 (3,);np.dot(x, y) 和 x @ y 则把长度为 3 的轴缩并(reduce)掉,得到 NumPy 标量,shape 是空元组 ()。这正好连接第 32 篇:逐元素乘法之后,再沿最后一个轴做加法归约,才是内积。
如果输入是一维数组,@ 的结果是标量,而不是形状为 (1, 1) 的二维矩阵。工程代码里,标量和一行一列矩阵的广播行为不同;要表达“一个 batch 中每个样本的结果”,通常需要把数据组织成二维或更高维数组,而不是依赖隐式的维度猜测。
1.2 矩阵乘法:行与列的成对内积
设 A.shape == (M, K),B.shape == (K, N),矩阵乘积 C = A @ B 的 shape 是 (M, N),每个位置满足:
C_ij=sum_{k=0}^{K-1}A_ikB_kj
中间维度 K 必须相等:A 的列数与 B 的行数相遇并被求和;外侧维度 M 和 N 留在结果中。
import numpy as np

A = np.array([[1, 2, 3],
              [4, 5, 6]])          # (2, 3)
B = np.array([[10, 20],
              [30, 40],
              [50, 60]])            # (3, 2)

print(A * B.T)                     # (2, 3),逐元素乘法
print(A @ B)                       # (2, 2),矩阵乘法
print((A @ B).shape)
[[10 60 150]
 [80 200 360]]
[[220 280]
 [490 640]]
(2, 2)
这里 B.T 的 shape 是 (2, 3),所以 A * B.T 能逐元素运行,但它表达的是另一件事:把 B 的每一列转成一行后逐格相乘。A @ B 则分别计算两行 A 与两列 B 的内积。表达式没有报错,不代表语义就是对的;在数值代码里,shape 注释是接口契约。
1.3 一个可操作的 shape 心智模型
判断二维矩阵乘法时,可以把每个矩阵写成“行数 × 列数”:
(M, K) @ (K, N) -> (M, N);- 中间的两个
K必须一致; - 外面的
M、N形成结果; - 输出的每一个格子,都是一行与一列的内积。
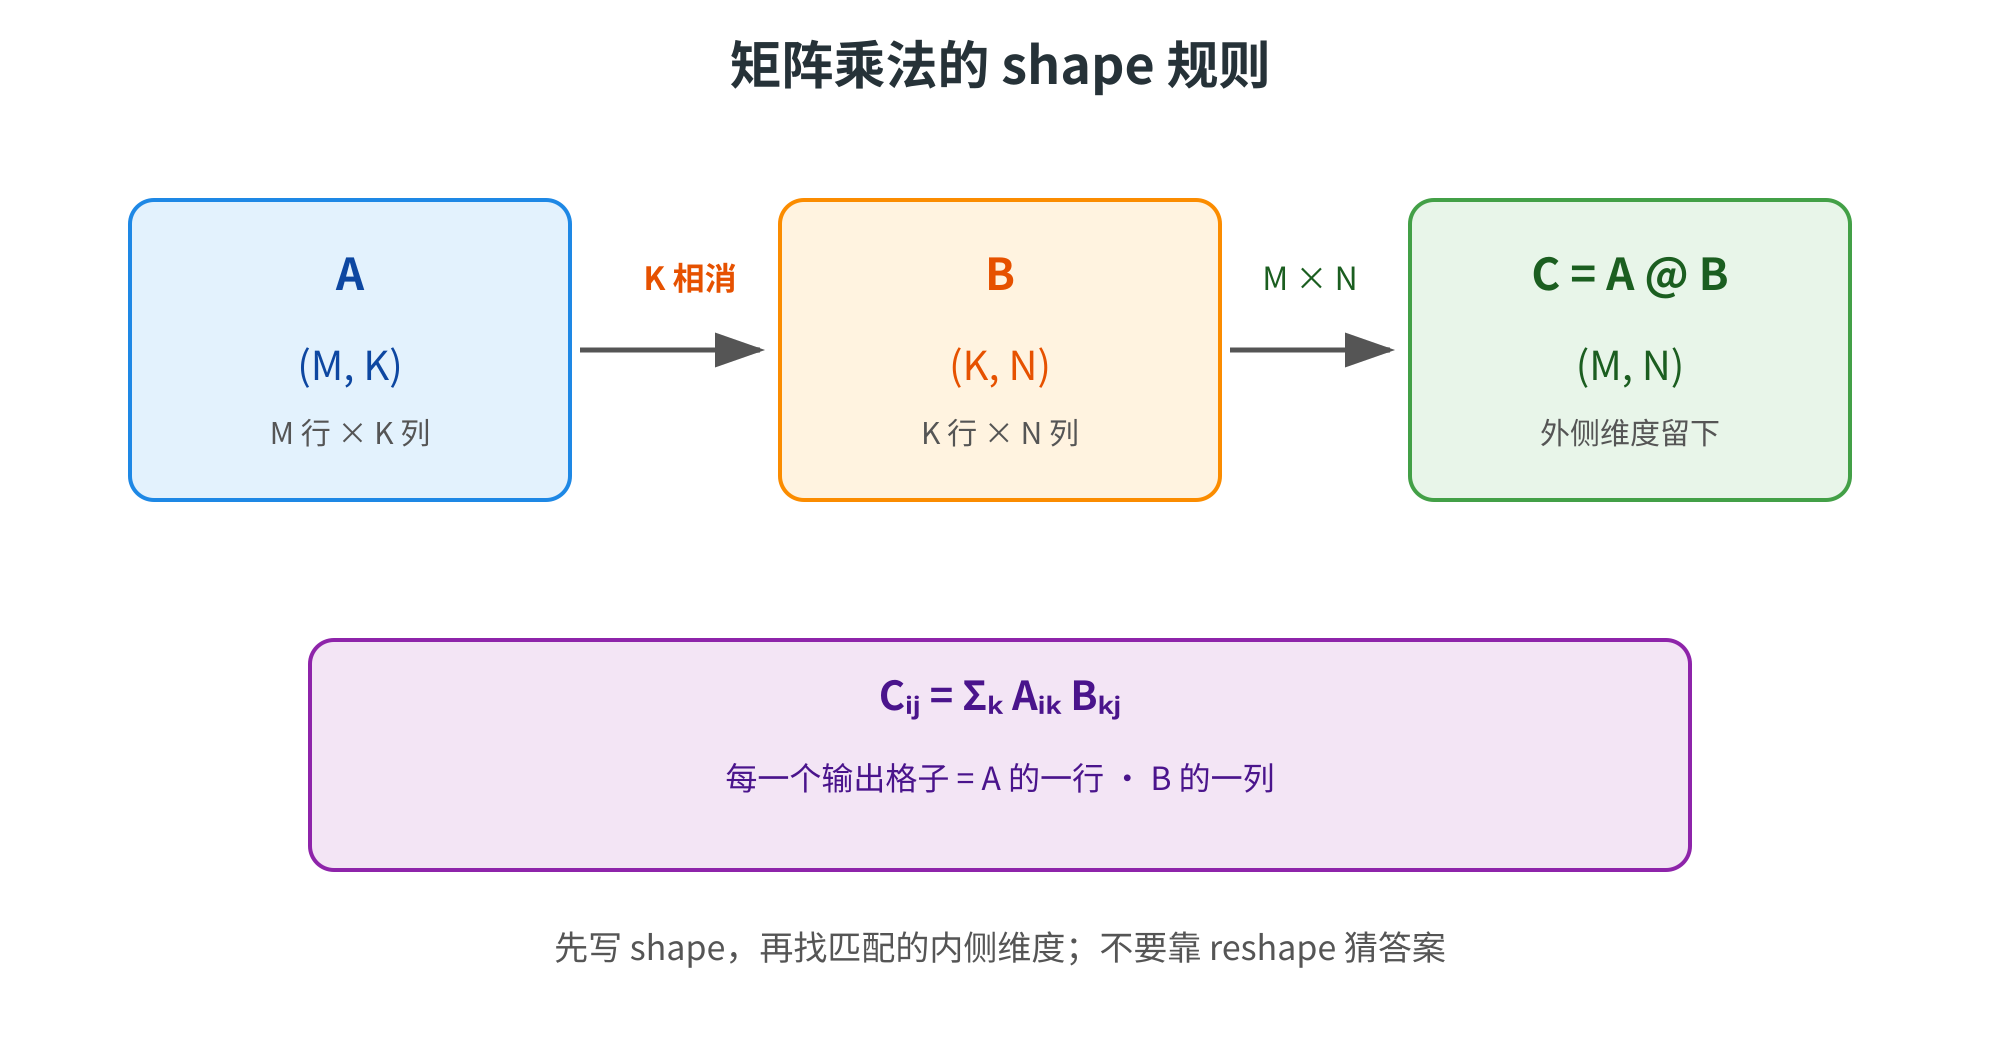
图1 矩阵乘法的 shape 规则:中间维度相消
这套口诀比死记 API 更可靠。遇到 A @ B,先写出两个 shape,再找“相消”的维度;遇到错误,优先检查数据布局和业务轴,而不是随意 reshape 直到代码能跑。reshape 改变的是解释方式,不会替你证明语义正确。
AI Infra 视角:神经网络的线性层通常把输入特征维记作
K,权重矩阵的相容维也必须是K。一次 GEMM(General Matrix-Matrix Multiplication,通用矩阵乘法)本质就是大量独立的行列内积。GPU kernel 会把这些内积分块,搬入 shared memory 或寄存器,再用 Tensor Core 做高吞吐的乘加。
二、*、np.dot、@ 与 matmul
2.1 * 永远先问广播
NumPy 中,* 对 ndarray 是逐元素乘法,使用第 31 篇的广播规则。它不因为操作数看起来像矩阵就自动变成线性代数乘法:
import numpy as np

A = np.arange(6).reshape(2, 3)
B = np.full((2, 3), 2)
print(A * B)

try:
    print(A @ B)
except ValueError as exc:
    print(type(exc).__name__, "inner dimensions do not match")
[[ 0  2  4]
 [ 6  8 10]]
ValueError inner dimensions do not match
A * B 的输出还是 (2, 3);A @ B 需要 (2, 3) @ (3, N),但这里右侧是 (2, 3),中间维度不相等。不要用“两个二维数组就应该能乘”来推导,线性代数的维度约束更严格。
2.2 np.dot 的历史接口与维度差异
np.dot 可以处理标量、向量、二维矩阵和更高维数组,但它对高维输入的规则有历史包袱:二维情况下是矩阵乘法;两个一维输入是内积;一维与二维会在合适的轴上做乘法;高维组合的语义不如 matmul 直观。
import numpy as np

v = np.array([1, 2, 3])
M = np.arange(12).reshape(3, 4)

print(np.dot(v, M))
print(v @ M)
print(np.dot(M, v))
[32 38 44 50]
[32 38 44 50]
ValueError shapes (3,4) and (3,) not aligned (4 (dim 1) != 3 (dim 0))
np.dot(v, M) 和 v @ M 都把向量视为长度为 3 的行方向参与计算,结果是 (4,)。但 M @ v 要求 M 的列数是 3,而本例 M 的 shape 是 (3, 4),所以失败。不同 NumPy 版本的错误文本可能略有差别,不应在测试中硬编码整句错误消息。
对于新的代码,若意图就是矩阵乘法,优先使用 @ 或 np.matmul;若意图是明确的内积且输入就是向量,np.dot 仍然可读。API 名字不是性能保证,真正的实现依然由 dtype、布局、BLAS 和设备决定。
2.3 @ 与 np.matmul:同一套主规则
@ 是矩阵乘法运算符,通常分派到 np.matmul。二维数组时二者等价;matmul 还明确规定了高维批次的行为:最后两个轴参与矩阵乘法,前面的轴作为 batch 维并按广播对齐。
import numpy as np

A = np.arange(6, dtype=np.float32).reshape(2, 3)
B = np.arange(12, dtype=np.float32).reshape(3, 4)
print(np.array_equal(A @ B, np.matmul(A, B)))
print(np.matmul(A, B).shape)

# 标量不允许作为 matmul 的输入
try:
    np.matmul(2, B)
except ValueError as exc:
    print(type(exc).__name__)
True
(2, 4)
ValueError
np.matmul 与 ufunc 一样支持 out=,但它不是普通的逐元素 ufunc;它有矩阵乘法专用的维度规则。可用 np.matmul.signature 观察其广义签名:输入的最后两个轴是矩阵轴,前面的轴是批次轴。
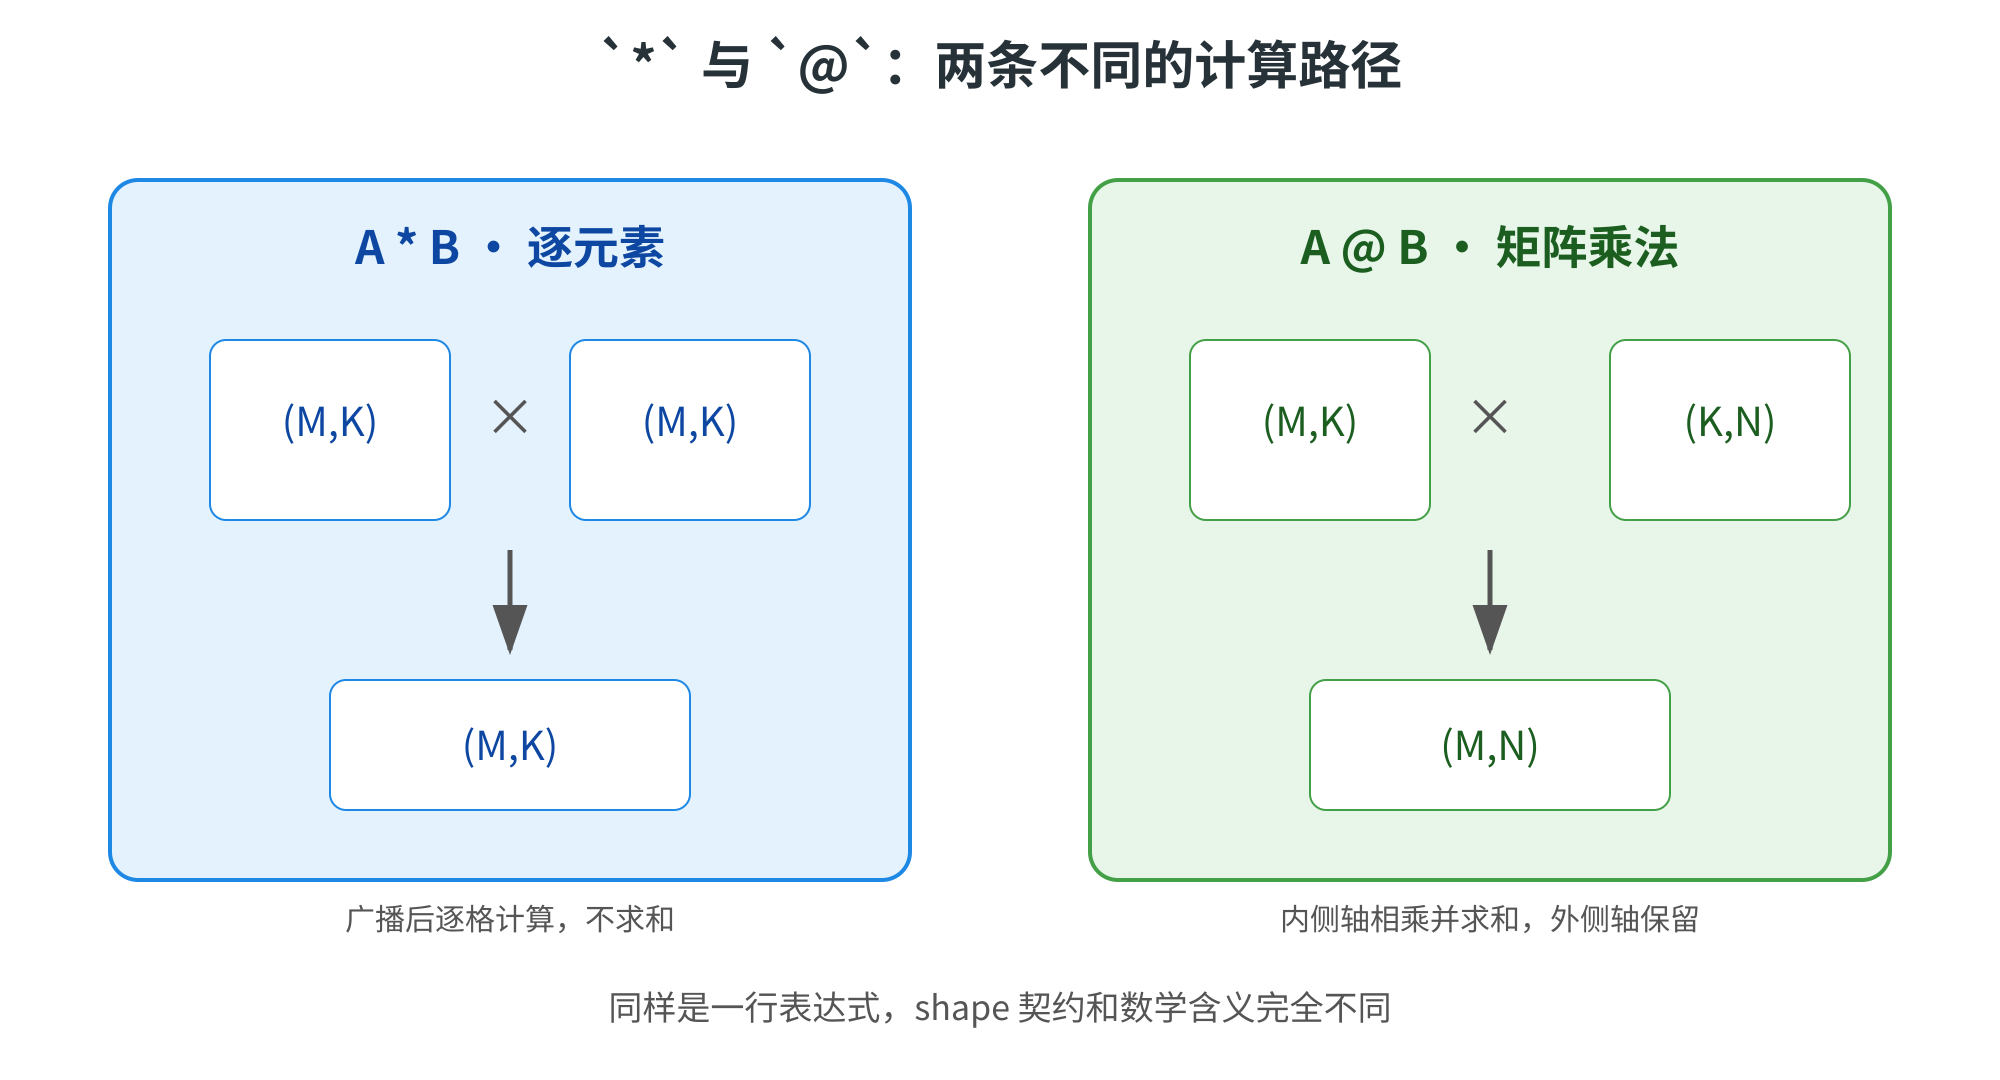
A * B逐元素运算,输入两个形状为(M,K)的矩阵,经逐元素广播后,输出形状仍为(M,K),运算逻辑为广播后逐格计算,不求和;右侧绿色区域是A @ B矩阵乘法,输入为(M,K)矩阵和(K,N)矩阵,经内侧轴相乘求和、外侧轴保留的规则计算,输出形状为(M,N),图片明确体现了两种运算的shape契约与数学含义完全不同的核心区别,呼应了文档中关于*和@运算的相关说明。图2 * 与 @:逐元素路径和缩并路径
2.4 结果 shape 与语义一起写
建议在关键代码旁边写出数学和 shape:
# X: (batch, in_features), W: (in_features, out_features)
# y[b, o] = sum_k X[b, k] * W[k, o]
y = X @ W
assert y.shape == (batch, out_features)
这比只写 y = X @ W 更容易审查。若项目使用类型检查工具,还可以进一步使用 jaxtyping 一类的 shape 注解;但工具不能代替对矩阵轴的理解。尤其在 Transformer 中,(B, T, H)、(B, H, T) 和 (B, T, T) 都很常见,一次 transpose 就会改变后续乘法含义。
三、转置、轴与内存布局
3.1 转置不是复制
二维数组的转置交换行轴和列轴:A.T 是 A.transpose() 的简写。多数时候它返回一个 view,只改变 strides,让同一片数据以不同的坐标解释;因此修改转置视图可能影响原数组。
import numpy as np

A = np.arange(6).reshape(2, 3)
T = A.T
print(A)
print(T)
print(T.shape, T.strides)
print(np.shares_memory(A, T))

T[0, 1] = 99
print(A)
[[0 1 2]
 [3 4 5]]
[[0 3]
 [1 4]
 [2 5]]
(3, 2) True
[[ 0 99  2]
 [ 3  4  5]]
这里 T 的第 (0, 1) 个元素对应 A 的第 (1, 0) 个元素。第 29、30 篇讲过,view 是否共享内存和 stride 有关。转置后的访问可能不连续,底层矩阵乘法库有时会复制或打包(pack)输入,以换取更好的缓存访问;“没有显式 .copy()”不代表执行中绝不会发生临时缓冲。
3.2 transpose 与 swapaxes
对高维数组,.T 会反转所有轴,往往不是你想要的操作。应明确写轴顺序:
import numpy as np

x = np.zeros((2, 3, 4))       # (batch, time, hidden)
print(x.T.shape)
print(x.transpose(0, 2, 1).shape)
print(np.swapaxes(x, -1, -2).shape)
(4, 3, 2)
(2, 4, 3)
(2, 4, 3)
x.transpose(0, 2, 1) 把 (B, T, H) 变成 (B, H, T),适合需要交换最后两个矩阵轴的场景;swapaxes(-1, -2) 更直接表达“只交换最后两个轴”。代码中最好用注释标出轴名,避免看到 transpose(1, 0, 2) 却不知道它在业务上交换了什么。
3.3 转置与内积:得到 Gram 矩阵
给定 X.shape == (B, H),X @ X.T 的结果是 (B, B):第 i 行与第 j 行的内积,表示样本之间的相似度。它是很多检索、聚类和 Attention 思维模型的简化版。
import numpy as np

X = np.array([[1.0, 0.0, 1.0],
              [0.0, 2.0, 0.0]])      # (2, 3)
G = X @ X.T
print(G)
print(G.shape)
[[2. 0.]
 [0. 4.]]
(2, 2)
如果把 X.T @ X 写出来,结果会变成 (H, H),表示特征之间的 Gram 矩阵。两种写法都合法,但统计对象完全不同:前者聚合样本对,后者聚合特征对。遇到对称矩阵时也要问清楚对称的轴是什么,不要只凭输出形状判断正确。
AI Infra 视角:在 CPU 上,C-contiguous 和 F-contiguous、转置 view 与打包副本都会影响缓存命中;在 GPU 上,布局和 stride 会影响 kernel 是否需要重排。性能问题要用 profiler 验证,不能仅凭
.T看起来“零拷贝”就断言更快。
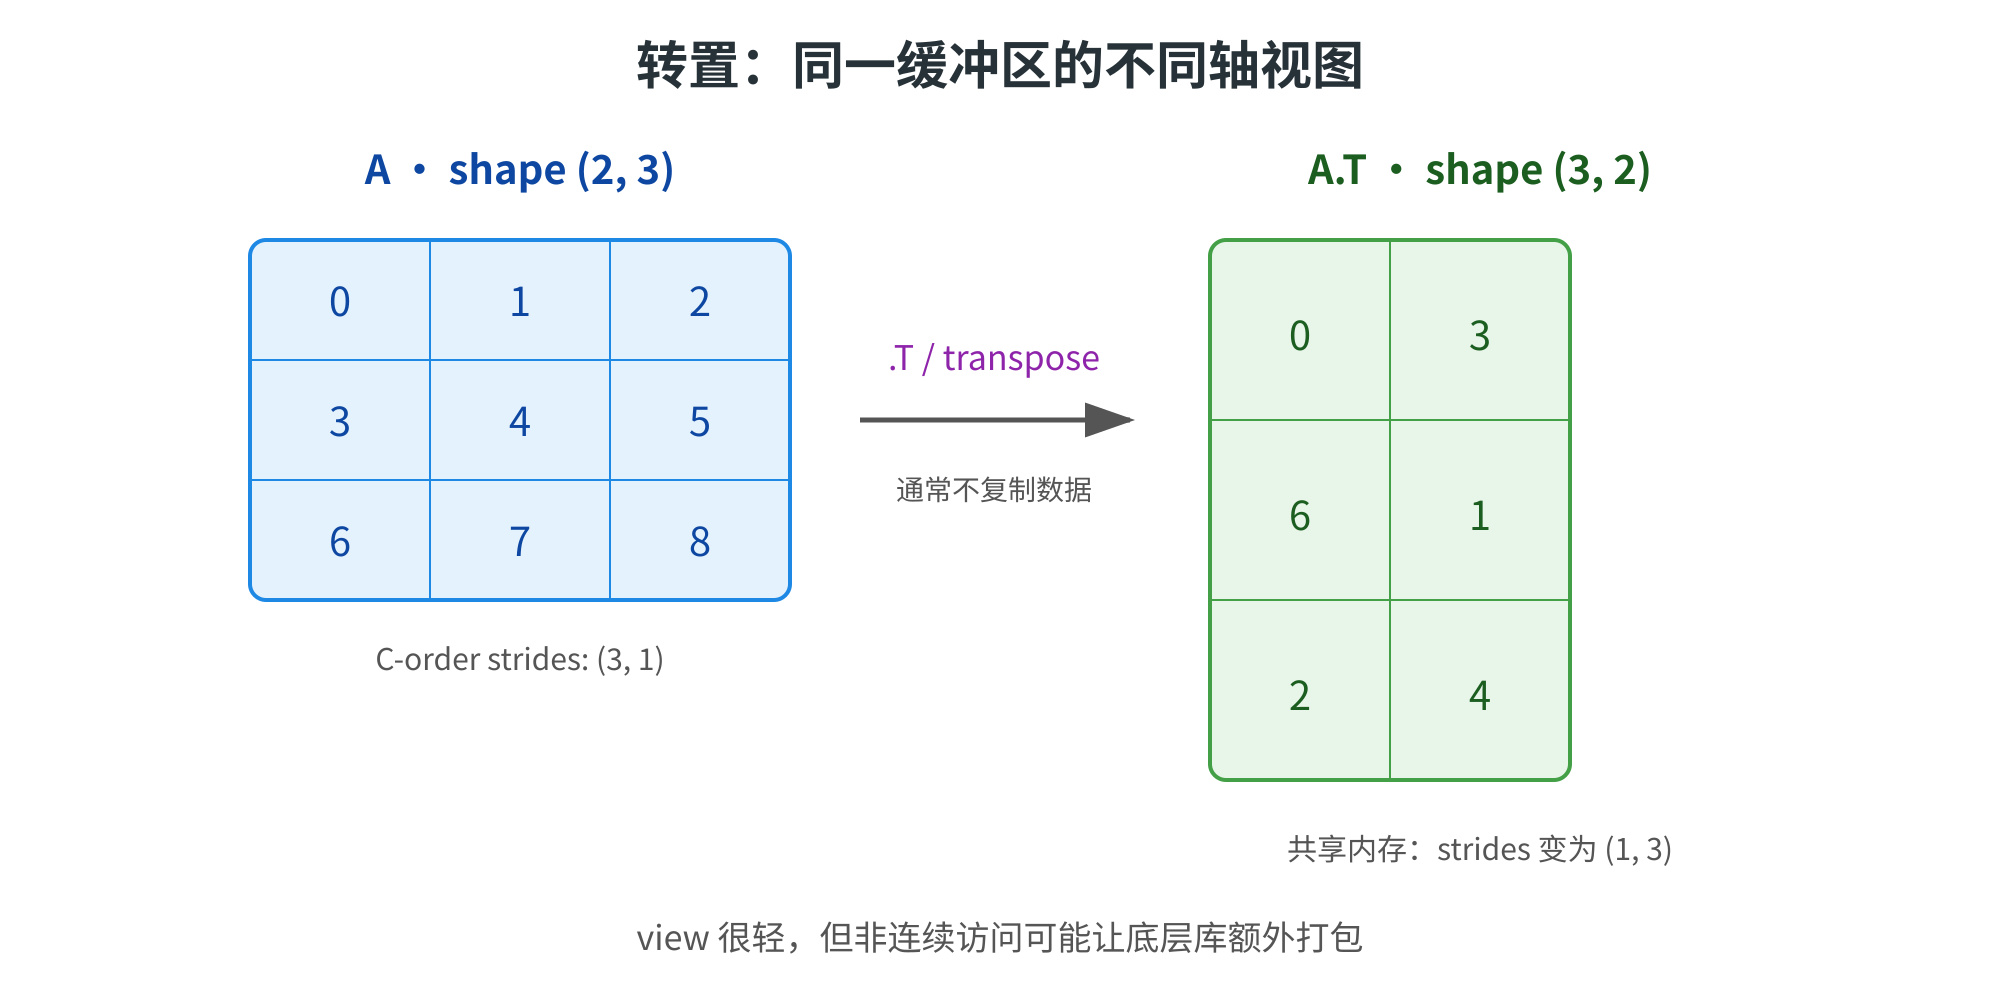
图3 转置与 stride:同一缓冲区的不同轴视图
四、批量矩阵乘法与 Attention
4.1 matmul 的 batch 轴规则
对高维数组,np.matmul 把最后两个轴当矩阵轴,前面的轴当 batch 轴。例如:
(B, M, K) @ (B, K, N) -> (B, M, N);(B, M, K) @ (K, N) -> (B, M, N),同一个矩阵 B 被每个 batch 复用;(M, K) @ (B, K, N) -> (B, M, N),左侧矩阵被广播到每个 batch;- 前置 batch 轴还可以按广播规则对齐。
import numpy as np

B, M, K, N = 2, 3, 4, 5
left = np.arange(B * M * K, dtype=np.float32).reshape(B, M, K)
right = np.ones((B, K, N), dtype=np.float32)
out = left @ right

print(left.shape, right.shape, out.shape)
print(out[0, 0])
(2, 3, 4) (2, 4, 5) (2, 3, 5)
[6. 6. 6. 6. 6.]
out[0, 0] 的每个元素都是 left[0, 0] 的 4 个值之和,因为右矩阵对应列全是 1。批量矩阵乘法不是把三个轴全部“摊平”后做一次乘法,而是对每个 batch 坐标独立执行一组 (M, K) @ (K, N)。
4.2 共享权重与 batch 广播
线性层经常把权重在 batch 之间共享:输入 X 是 (B, T, H),权重 W 是 (H, O),则 X @ W 得到 (B, T, O)。前两轴是 batch 和 token,最后一轴 H 与权重的第一矩阵轴对齐并消失。
import numpy as np

X = np.arange(2 * 3 * 4, dtype=np.float32).reshape(2, 3, 4)
W = np.ones((4, 2), dtype=np.float32)
bias = np.array([0.5, -0.5], dtype=np.float32)
Y = X @ W + bias

print(X.shape, W.shape, Y.shape)
print(Y[0, 0])
(2, 3, 4) (4, 2) (2, 3, 2)
[6.5 5.5]
矩阵乘法先把最后的 hidden 维从 4 变成 2,随后 bias.shape == (2,) 按最后一轴广播。这正是第 31、32 篇的广播与 ufunc 在矩阵计算后的衔接:@ 完成缩并,+ 完成逐元素偏置。
4.3 用 QK^T 理解自注意力
自注意力的相似度矩阵通常写作:
S=(QK^T)/(√(d_k))
如果单个 batch、单个 head 中 Q.shape == (T_q, D)、K.shape == (T_k, D),那么 K.T.shape == (D, T_k),因此 Q @ K.T 是 (T_q, T_k)。每一个 query 都得到对所有 key 的分数。
import numpy as np

Q = np.array([[1.0, 0.0],
              [0.0, 1.0]])       # (Tq=2, D=2)
K = np.array([[1.0, 0.0],
              [1.0, 1.0],
              [0.0, 1.0]])       # (Tk=3, D=2)

scores = Q @ K.T / np.sqrt(Q.shape[-1])
print(scores.round(3))
print(scores.shape)
[[0.707 0.707 0.   ]
 [0.    0.707 0.707]]
(2, 3)
这里最后一个维度 D 是被缩并的特征维,Tq 和 Tk 留在结果中。真正的多头实现还会有 (B, H_heads, T, D) 等批次和 head 轴,通常用 transpose 把矩阵轴放到最后,再调用 matmul;关键不是背某个固定排列,而是始终检查 Q 与 K 的最后矩阵轴是否相容。
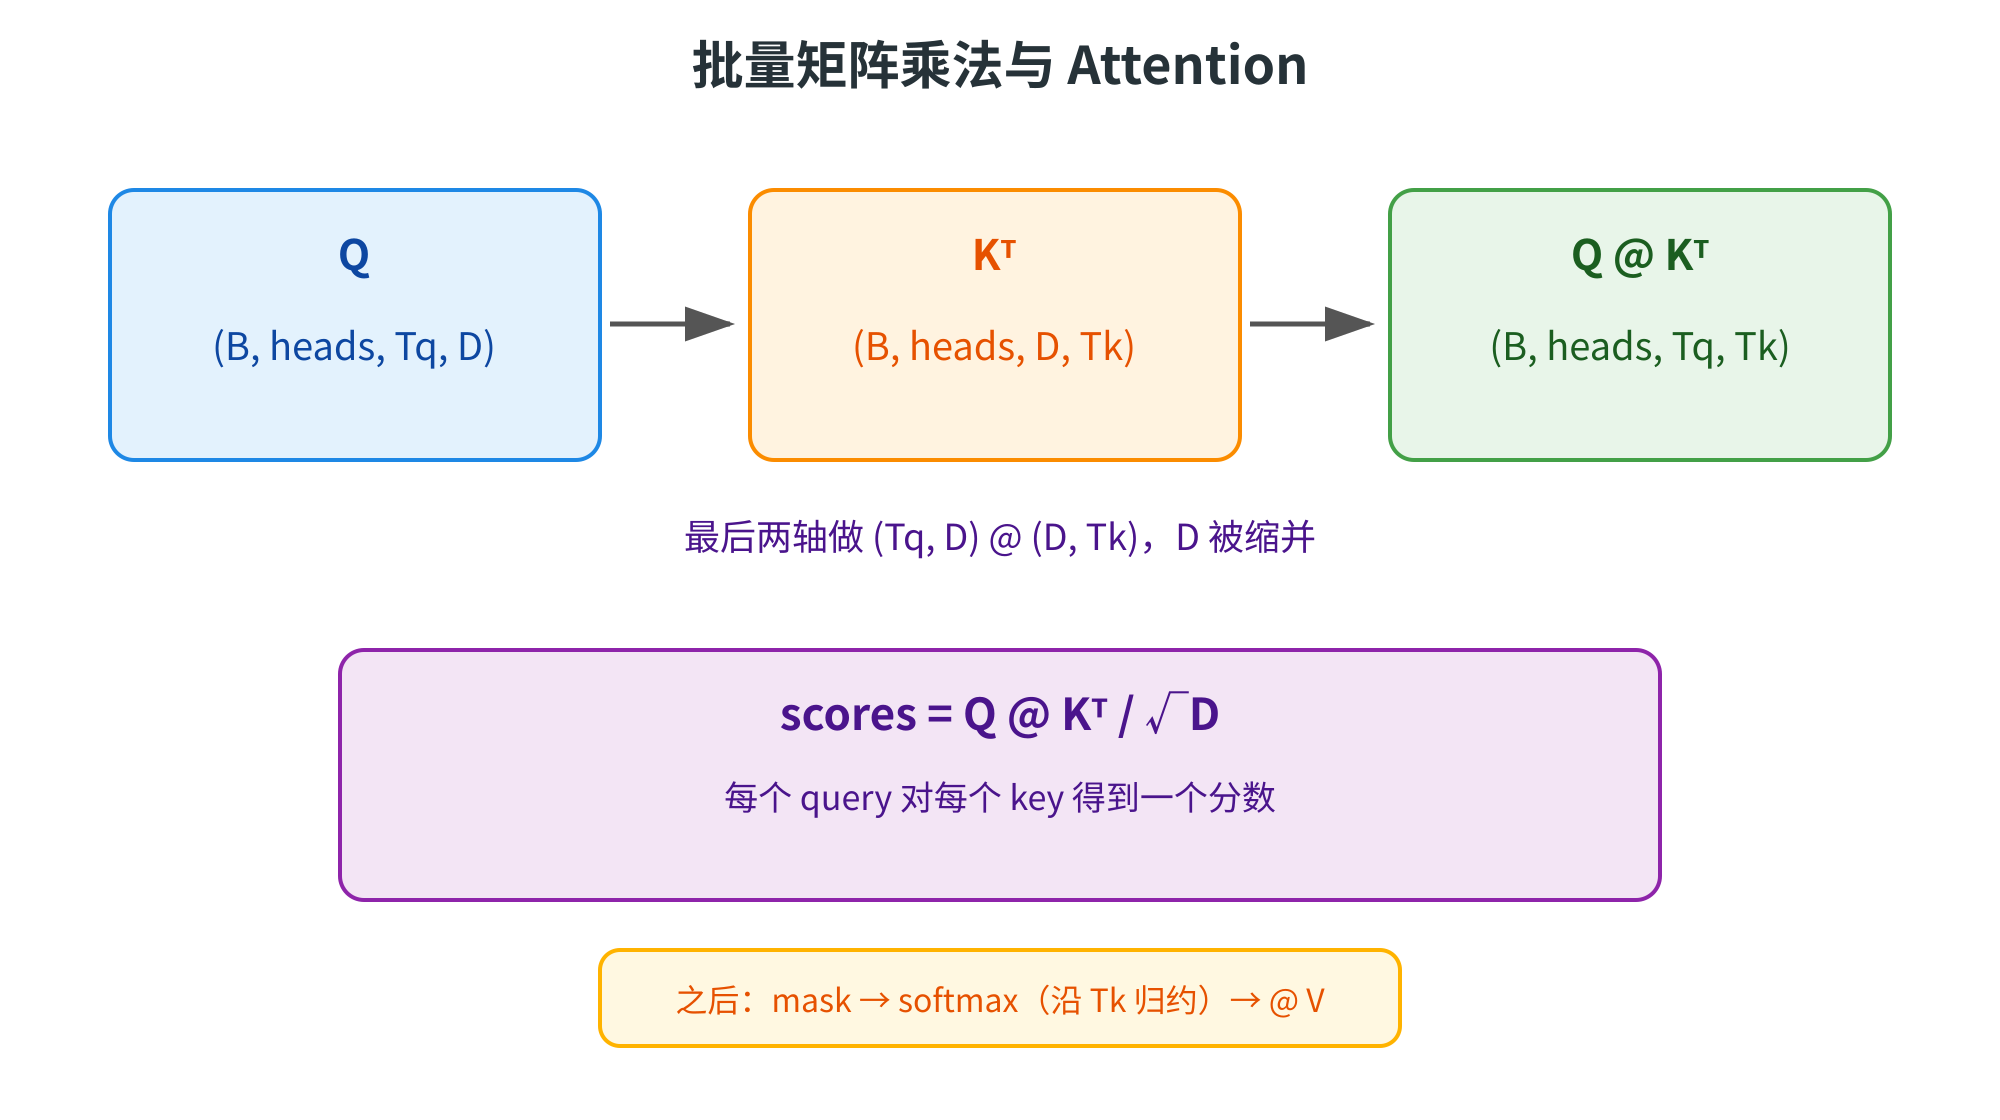
图4 批量矩阵乘法与 Attention:最后两轴做缩并
4.4 缩放、mask 与 softmax 的分工
Q @ K.T 只产生相似度分数。除以 sqrt(D) 控制数值范围;因果 mask 通常用 np.where 或加上很小的值屏蔽未来位置;softmax 则是逐元素 exp 加上沿最后一轴的归约。它们分别对应本专栏已经学过的矩阵乘法、广播、ufunc 和 reduce。
import numpy as np

scores = np.array([[1.0, 2.0, -np.inf],
                   [0.0, -np.inf, 3.0]])
shifted = scores - np.max(scores, axis=-1, keepdims=True)
weights = np.exp(shifted)
weights /= np.sum(weights, axis=-1, keepdims=True)
print(weights.round(3))
print(weights.sum(axis=-1))
[[0.269 0.731 0.   ]
 [0.047 0.    0.953]]
[1. 1.]
注意 keepdims=True:最大值和总和保持 (2, 1),才能和 (2, 3) 广播。第 32 篇讲过,归约并不会自动保留被压缩的轴;在 Attention 中漏掉 keepdims,常常会得到 shape 能运行但语义错位的代码。
五、GEMM、einsum 与性能边界
5.1 线性层就是一次 GEMM
设一批输入 X 的 shape 为 (B, K),权重 W 的 shape 为 (K, N),偏置为 (N,):
Y=XW+b
这就是常见的全连接层前向。每个输出元素要做 K 次乘法和 K-1 次加法,整个输出有 B×N 个元素,计算量约为 2BKN 次浮点操作。矩阵越大,越能摊薄 Python 调度成本;底层库也更容易使用分块、并行和向量化。
import numpy as np

rng = np.random.default_rng(7)
X = rng.normal(size=(2, 3)).astype(np.float32)
W = rng.normal(size=(3, 4)).astype(np.float32)
b = np.zeros(4, dtype=np.float32)
Y = X @ W + b

print(X.shape, W.shape, Y.shape)
print(Y.dtype)
(2, 3) (3, 4) (2, 4)
float32
不要为了展示公式而写 Python 双重循环。下面的循环可以帮助理解,但不是生产实现:
Y_slow = np.empty((X.shape[0], W.shape[1]), dtype=np.float32)
for i in range(X.shape[0]):
    for j in range(W.shape[1]):
        Y_slow[i, j] = np.sum(X[i, :] * W[:, j]) + b[j]

print(np.allclose(Y, Y_slow))
True
循环版本明确展示了“行与列内积”,但每次 i、j 都回到 Python,并且重复调用 sum。@ 把整个运算交给底层实现,通常更快,也更容易与后续框架的算子图对接。
5.2 einsum:用下标表达缩并
np.einsum(Einstein summation,爱因斯坦求和约定)允许用字母标出每个轴:重复出现的下标会被求和,只出现一次的下标出现在输出中。
import numpy as np

A = np.arange(6).reshape(2, 3)
B = np.arange(12).reshape(3, 4)
C1 = A @ B
C2 = np.einsum("ik,kj->ij", A, B)

print(C1)
print(np.array_equal(C1, C2))
[[20 23 26 29]
 [56 68 80 92]]
True
i、k、j 分别表示 A 的行、相消的列/行和 B 的列;k 在输入中出现两次而不在输出中,所以沿它求和。einsum 还能表达转置、批量内积、外积和多输入缩并:
import numpy as np

X = np.arange(24).reshape(2, 3, 4)  # (B, T, H)
W = np.ones((4, 5))                 # (H, O)
Y = np.einsum("bth,ho->bto", X, W)
print(Y.shape)
print(Y[0, 0])
(2, 3, 5)
[6. 6. 6. 6. 6.]
einsum 的力量也是风险:下标写错可能仍然得到一个合法数组。初学时先用 @ 表达标准矩阵乘法,只有在需要多轴缩并、避免多次中间转置或确实能让公式更清晰时再用 einsum。可配合 np.einsum_path 查看计算顺序,但最终仍应 benchmark。
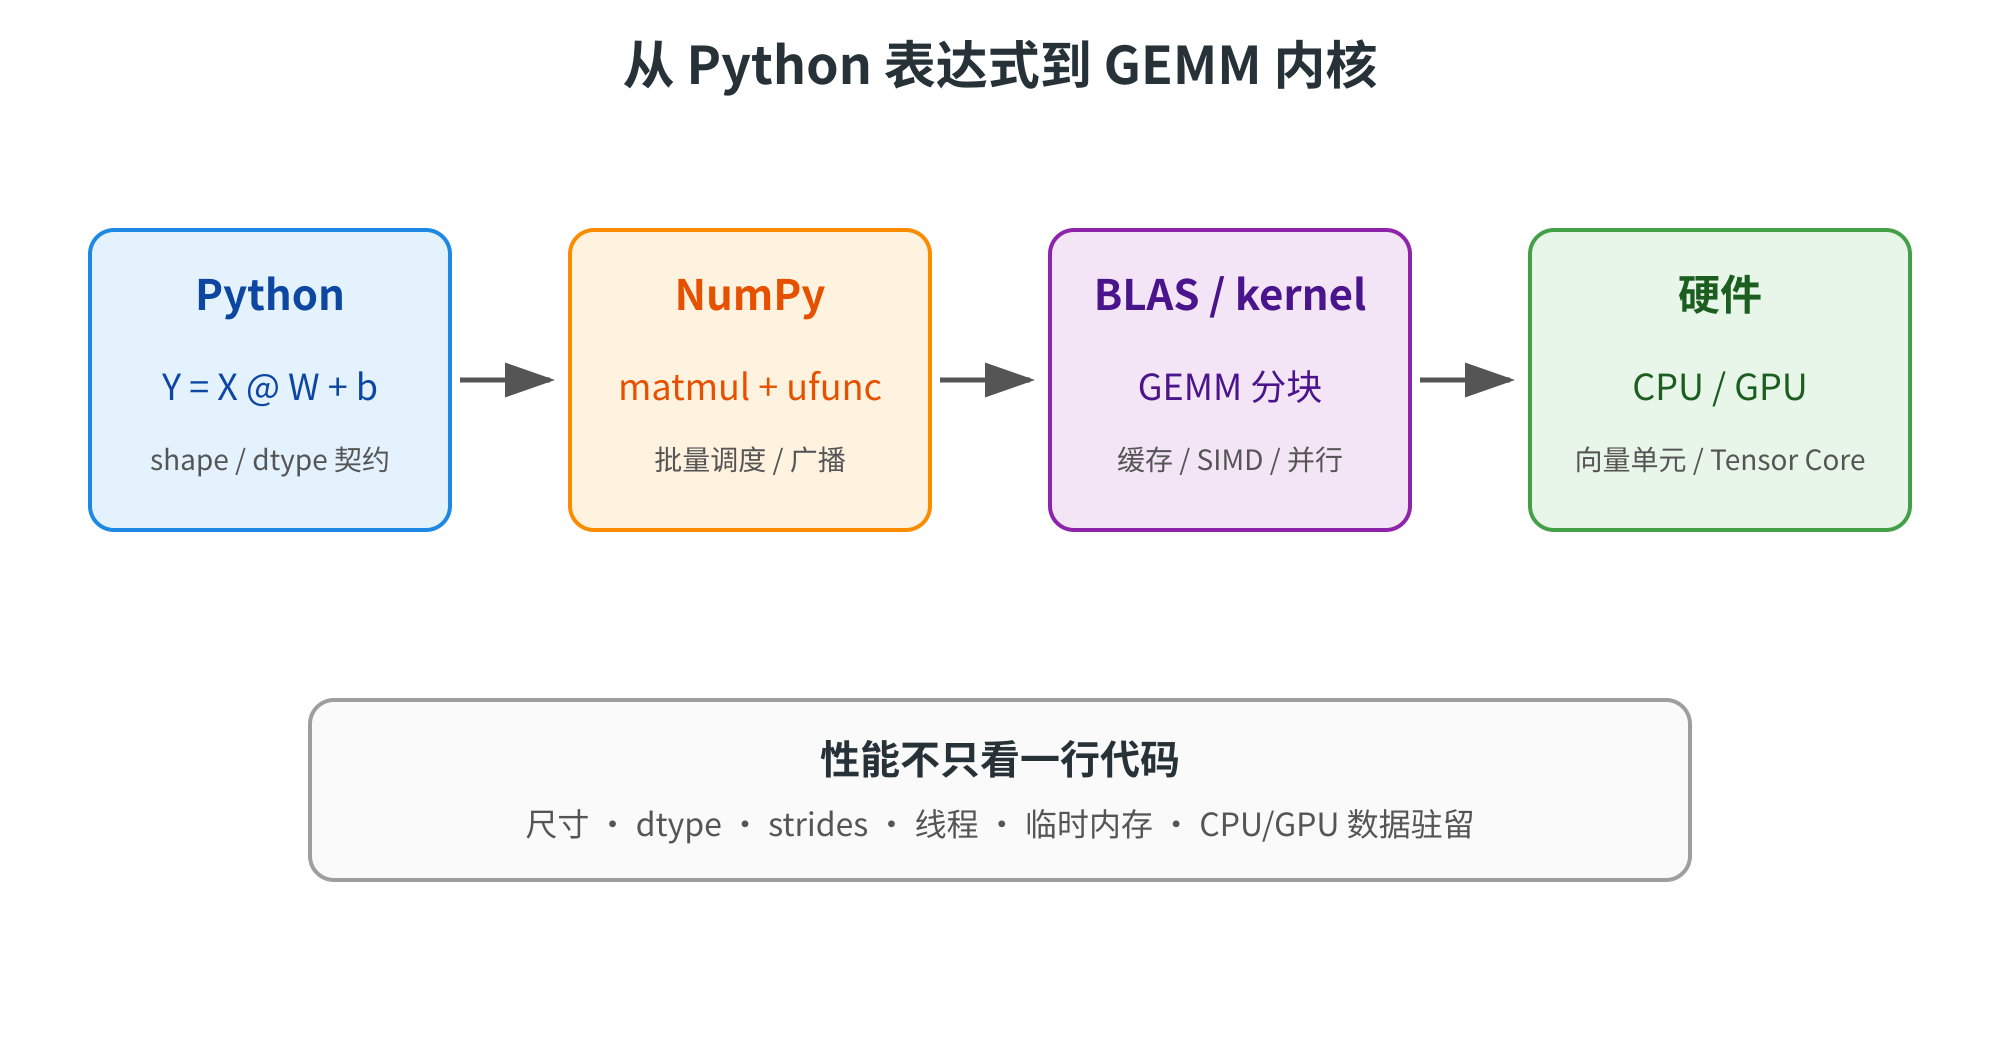
图5 从 Python 表达式到 GEMM:线性层的内核路径
5.3 性能不只取决于“用了 @”
@ 通常是正确的抽象,但速度还受以下因素影响:
- 尺寸:过小的矩阵无法充分利用并行资源,函数调用成本会占比较大。
- dtype:
float32、float16、bfloat16和float64对吞吐、精度和硬件支持不同;NumPy 是否支持某个低精度路径也要看版本和平台。 - 布局:转置 view、非连续 stride 可能触发复制或降低缓存效率。
- 线程:NumPy 可能调用 OpenBLAS、MKL 等多线程库;线程数过多会和服务进程争抢 CPU。
- 临时数组:
X @ W + b至少有矩阵乘法输出,后续 ufunc 还可能产生新数组;要看峰值内存而不只看单次耗时。
基准测试要使用接近生产的 batch、dtype、线程设置和预热流程,并同时验证结果。不要因为某台机器上的 einsum 比 @ 快就推断所有输入都会更快;底层库会根据 shape 选择不同算法。
还要把“算力”和“数据搬运”分开看。矩阵乘法的算术强度较高时,GEMM 可能接近硬件峰值;但小矩阵、稀疏访问或频繁的 layout 转换,会让时间花在函数调用、缓存未命中和内存复制上。服务端如果把一个请求拆成许多很小的 @,即使每次调用都很快,累计的调度开销仍可能压过一次合并计算。反过来,盲目把所有请求拼成超大 batch,也会增加排队延迟和峰值显存。吞吐与延迟要结合业务目标测量。
在 CPU 侧,NumPy 只负责提出数组运算,具体矩阵乘法可能由 BLAS 后端完成;同一个脚本换机器后,OpenBLAS、MKL 或 Accelerate 的线程策略可能不同。可以通过环境和 profiler 了解实际后端,但不要在文章或测试里假设“调用 @ 就必定使用某个库”。在 GPU 侧,框架还会根据形状选择不同 kernel、是否使用 Tensor Core 以及是否融合 bias 和激活。先用清晰的 @ 表达数学,再测量布局、线程和融合是否值得优化。
六、综合案例:批量线性层与形状契约
6.1 从 (B, T, H) 到 (B, T, O)
下面实现一个不依赖深度学习框架的线性层:输入是 batch 中的 token 表示,权重对所有 token 共享。我们显式记录每一个矩阵轴,并在边界用断言检查。
import numpy as np

rng = np.random.default_rng(42)
B, T, H, O = 2, 3, 4, 2
x = rng.normal(size=(B, T, H)).astype(np.float32)
w = rng.normal(size=(H, O)).astype(np.float32)
b = rng.normal(size=(O,)).astype(np.float32)

assert x.shape == (B, T, H)
assert w.shape == (H, O)
assert b.shape == (O,)

y = x @ w + b
assert y.shape == (B, T, O)
print(x.shape, w.shape, y.shape)
print(y[0, 0].round(3))
(2, 3, 4) (4, 2) (2, 3, 2)
[ 1.128 -1.36 ]
随机数输出依赖 NumPy 版本和生成器细节,生产测试不应硬编码浮点打印值;这里使用固定 seed 只是让演示更容易复现。真正重要的是 shape、dtype 和数值关系。若要在不同实现间对拍,可以用 np.testing.assert_allclose,设置合适的相对与绝对误差。
6.2 手算一个位置,定位轴错误
当结果 shape 正确但指标异常时,应抽查一个位置:
b_id, t_id, o_id = 0, 1, 0
manual = np.sum(x[b_id, t_id, :] * w[:, o_id]) + b[o_id]
print(np.allclose(y[b_id, t_id, o_id], manual))
True
这个检查对应公式 y[b,t,o] = Σ_h x[b,t,h] w[h,o] + bias[o]。如果误把权重写成 (O, H),可以使用 w.T,但必须把“权重存储布局”和“数学矩阵方向”写清楚;靠试错转置很容易掩盖模型参数加载时的错误。
6.3 复用输出与设备边界
np.matmul(x, w, out=buffer) 可以把矩阵乘法结果写入预分配的 buffer,但 buffer 必须有正确 shape、dtype,并且不能和输入产生危险的重叠。偏置加法可以再原地进行:
buffer = np.empty((B, T, O), dtype=np.float32)
np.matmul(x, w, out=buffer)
np.add(buffer, b, out=buffer)
print(buffer.shape, np.allclose(buffer, y))
(2, 3, 2) True
这适合 CPU 侧反复处理固定形状的 batch,但不要把它当作无条件优化。需要保留中间结果、多个请求并发或异步传输时,过度复用可能制造数据竞争。NumPy 数组还在 CPU 内存中;把它交给 PyTorch 或 GPU 时会有设备拷贝、同步和生命周期问题,边界处应明确谁拥有这块缓冲。
AI Infra 视角:推理服务里,线性层前后的数据最好保持批量和明确的 dtype,避免逐 token 调
.tolist()或.item()。在 GPU 路径中,matmul会选择设备 kernel;在 CPU 预处理和 GPU 计算之间来回搬运,可能比一次矩阵乘法本身更贵。优化前先画出数据驻留图,再用 profiler 找瓶颈。
七、踩坑大全
通用
坑 1:把 * 写成 @ 的替代品。 现象:输出 shape 没变,模型结果却完全不同。原因是 * 是逐元素乘法;解决:写出 (M,K) @ (K,N) -> (M,N),并为矩阵轴加注释。
坑 2:只看结果能否运行,不看轴的含义。 现象:广播成功、shape 也“像对的”,指标下降。原因是 batch、token、feature 轴排列错了;解决:入口断言 shape,抽查一个位置的手算值。
坑 3:随意 reshape 修复维度错误。 现象:错误消失但数据顺序被重新解释。原因是 reshape 不会替你交换语义轴;解决:需要换轴时使用带明确顺序的 transpose / swapaxes,并验证元素对应关系。
坑 4:忘记向量是一维数组。 现象:以为 (N,) 是行向量或列向量,广播结果和预期不一致。原因是 NumPy 的一维数组没有行列方向;解决:需要二维语义时显式使用 v[None, :] 或 v[:, None]。
坑 5:误解 dot 的高维行为。 现象:二维时正确,换成 batch 后结果轴不对。原因是 np.dot 的历史规则不如 matmul 的最后两轴模型直观;解决:批量矩阵乘法优先用 @ / np.matmul,复杂缩并再考虑 einsum。
坑 6:转置 view 被意外修改。 现象:改了转置数组,原数组也变了。原因是 .T 通常共享内存;解决:只读使用或显式 .copy(),用 np.shares_memory 检查所有权。
坑 7:认为 @ 一定没有临时内存。 现象:峰值内存超出预期。原因是非连续输入可能被打包,后续 + bias 还会产生结果;解决:检查 flags、dtype 和 profiler,再决定是否预分配 out 或调整布局。
AI Infra / 环境
坑 8:用 NumPy 代替 GPU tensor。 现象:数据已经在 GPU,却为了调用 NumPy 发生同步和拷贝。原因是 NumPy 只理解 CPU 内存;解决:在设备上使用 PyTorch / CuPy 等对应 API,减少跨设备往返。
坑 9:只 benchmark 一个小矩阵。 现象:本地结果和线上吞吐不一致。原因是矩阵尺寸、线程、缓存和 batch 分布不同;解决:用生产 shape 预热,多次测量,并同时记录内存和 CPU 利用率。
坑 10:混用 float64 与模型的 float32。 现象:结果变慢或占用更多内存。原因是输入提升到更宽 dtype,可能失去硬件快速路径;解决:在数据入口统一 dtype,并用容差检查精度。
坑 11:Attention 的 mask 轴错位。 现象:softmax 每行仍然等于 1,但模型关注了未来 token。原因是 mask 广播到了错误的 query/key 轴;解决:明确 scores 的 (B, heads, Tq, Tk),检查 mask shape 和几个边界位置。
坑 12:用 einsum 追求神秘性能。 现象:公式难读,速度还不稳定。原因是下标写法、路径选择和布局都会影响实现;解决:标准二维乘法先用 @,复杂场景用 einsum_path 与真实数据 benchmark。
八、小结
- 逐元素和缩并不同:
*遵循广播逐元素相乘;@/matmul沿匹配的矩阵轴相乘并求和。 - 二维 shape 口诀:
(M, K) @ (K, N) -> (M, N);中间K相消,外侧M、N留下。 - 批量乘法看最后两轴:
matmul把最后两个轴当矩阵,前置轴按广播规则作为 batch;这正适合(B,T,H)的线性层。 - 转置改变轴视图:
.T常是共享内存的 view;高维场景应显式写transpose/swapaxes,并关注 strides 和连续性。 - Attention 是已学概念的组合:
QK^T是批量矩阵乘法,缩放与 mask 使用逐元素运算,softmax 使用exp和沿轴归约。 - 性能要看底层路径:
@通常调用 BLAS 或设备 kernel,但 dtype、布局、线程、临时数组和数据搬运同样决定吞吐。
把本篇和前两篇连起来:第 31 篇的广播回答“不同 shape 如何对齐”,第 32 篇的 ufunc 回答“对齐后每个位置做什么”,本篇的矩阵乘法则回答“哪些轴要相乘并归约”。掌握这三种规则,才能读懂后续 MLP、Attention 和训练循环中的张量表达式。
九、课后练习
- (基础) 创建
A.shape == (2, 3)、B.shape == (3, 4),分别运行A * B、A @ B,解释前者为何失败或需要广播,后者为何得到(2, 4)。 - (基础) 用
np.dot、@和np.sum(x * y)实现两个一维向量的内积,并比较三者的结果类型与 shape。 - (理解) 构造
(B, M, K) @ (K, N)和(B, M, K) @ (B, K, N),验证共享权重与逐 batch 权重的输出 shape。 - (理解) 对
(B, T, H)数组分别使用x.T、x.transpose(0, 2, 1)和np.swapaxes(x, -1, -2),写出每种结果的轴含义。 - (理解) 手写一个
(B,T,H) @ (H,O)的三重循环,与 NumPy@对拍,并用time.perf_counter比较真实 batch 下的耗时。 - (进阶) 使用
np.einsum("bth,ho->bto", x, w)重写线性层,和x @ w比较结果、峰值内存与可读性。 - (进阶 · AI Infra) 用 NumPy 实现一个带因果 mask 的简化 Attention,打印
scores.shape、每行 softmax 和,解释Q、K的最后一轴为什么必须相同。 - (进阶 · 工程) 为批量矩阵乘法写一个 shape 检查函数,错误时给出输入 shape、期望的相容轴和建议的 transpose,而不是只抛出裸
ValueError。
下一篇预告
下一篇是《第34篇|随机数、统计与归约》——从“如何把矩阵乘起来”继续走向“如何生成可复现的数据、描述分布并沿轴汇总”。你会学习 Generator、随机种子、均值方差、百分位数、sum / mean / argmax 等归约,以及 axis、keepdims 和 NaN 处理如何影响统计结果。
专栏三路线:ndarray 基础(29)→ 索引与视图(30)→ 广播(31)→ 向量化与 ufunc(32)→ 线性代数与矩阵乘法(本篇) → 随机数、统计与归约(34) → stride 原理(35)→ 手写 MLP(36)。下一篇会把本篇的矩阵运算放进更可靠的实验数据和指标管线中。
现在可以做一个热身:创建 X.shape == (2, 3, 4) 和 W.shape == (4, 5),运行 X @ W,再用 np.einsum("bth,ho->bto", X, W) 对拍。观察最后两个矩阵轴如何相乘,以及偏置 (5,) 如何广播到 (2, 3, 5)。