
第34篇|随机数、统计与归约
本篇定位:专栏三「NumPy 数值计算」第六篇。承接第 33 篇的线性代数与矩阵乘法:矩阵乘法沿匹配轴做乘加,而本篇把“沿一个轴汇总”推广成随机采样、统计量与归约(reduction)。
读完你将能够:使用
np.random.Generator生成可复现的随机数;选择合适的分布并理解size;用axis=、keepdims=写出sum、mean、std、argmax等归约;把随机掩码、采样和指标聚合连接到 AI Infra 的训练与推理。预计用时:阅读 45~60 分钟,动手 60~90 分钟。
第 33 篇里,A @ B 把一行和一列的乘积沿中间轴相加,得到一个更小的结果。这个“沿轴消掉维度”的动作,就是归约。真实的模型系统还需要两类能力:一是用随机数初始化参数、打乱样本、生成 dropout 掩码和抽取 token;二是把大量 loss、延迟、吞吐、命中率汇总成可以观察的指标。
随机数不是“随便出现的数字”。计算机使用确定性的伪随机数生成器(pseudo-random number generator,PRNG):给它一个状态,算法就能产生一串看似随机的数。状态、种子(seed)、分布、数组 shape 和归约轴共同决定了实验能否复现、指标是否算对。本文会把这些概念放在同一张图里:先生成一批结构明确的数组,再沿明确的轴归约;需要随机性时,显式持有生成器。
一、随机数的来源:从 default_rng 开始
1.1 伪随机不是魔法
物理随机数来自噪声,NumPy 的常用随机数则来自算法。算法根据内部状态计算下一个状态和输出;如果初始状态相同、调用顺序相同,输出就相同。因此它适合测试、模拟和训练实验,但不能直接当作密码学随机源,也不能把“看起来随机”理解成不可预测。
在现代 NumPy 代码中,推荐使用 np.random.default_rng() 创建 Generator(生成器),而不是在全局作用域调用旧式的 np.random.seed() 和 np.random.randn()。生成器把状态装进一个对象,调用者可以把它作为依赖传入函数,减少模块之间互相重置随机状态的风险。
import numpy as np

rng = np.random.default_rng(2026)
print(type(rng).__name__)
print(rng.random(3).shape)
print(rng.integers(0, 10, size=5).shape)
Generator
(3,)
(5,)
上面的浮点输出会随 NumPy 版本和显示精度变化,因此示例只强调类型和 shape;不要把随机数组的完整文本复制进测试。default_rng(seed) 默认使用现代的 Generator,底层通常是 PCG64 系列位生成器。你可以把它当成一个有状态、可传递的随机数服务,而不是一个全局开关。
1.2 四个最常用的入口
Generator 中有几组特别值得形成肌肉记忆的 API:
rng.random(size):[0, 1)上的均匀分布浮点数,size=(B, T)就生成对应形状;rng.integers(low, high, size):整数区间是左闭右开[low, high),可以指定dtype;rng.choice(a, size, replace, p):从整数范围或数组中抽样,可放回或不放回,也可传概率;rng.permutation(x)/rng.shuffle(x):得到一个排列或原地打乱,前者返回新数组,后者修改输入。
import numpy as np

rng = np.random.default_rng(7)
ids = rng.integers(0, 100, size=(2, 4), dtype=np.int64)
coins = rng.choice(np.array(["keep", "drop"]), size=6, p=[0.8, 0.2])
order = rng.permutation(5)

print(ids.shape, ids.dtype)
print(coins.shape)
print(order.shape, np.sort(order))
(2, 4) int64
(6,)
(5,) [0 1 2 3 4]
注意 rng.shuffle(x) 没有返回打乱后的数组,而是返回 None。这和 permutation 的“返回副本”语义不同;在数据管道中,如果原数组是共享 view,原地操作还可能影响其他阶段。对于索引,常见且清晰的写法是先生成 order,再用 batch[order] 取样本。
1.3 随机 API 也遵守 shape 契约
size 描述输出形状,low、high 或 p 描述数值规则;二者不要混为一谈。rng.integers(10) 生成一个标量,rng.integers(10, size=1) 生成 (1,),rng.integers(10, size=(2, 3)) 生成 (2, 3)。后续要和 (B, T, H) 的张量广播时,先写出期望 shape,再决定 size。
import numpy as np

rng = np.random.default_rng(1)
for size in [None, 1, (2, 3)]:
    x = rng.normal(loc=0.0, scale=1.0, size=size)
    print(size, np.shape(x))
None ()
1 (1,)
(2, 3) (2, 3)
这和第 29 篇的 ndarray.shape、第 31 篇的广播直接相连。随机数只负责把数组填满,业务含义仍由 shape 决定。一个 (B, T) 的 dropout mask 表示每个 token 一个开关;一个 (B, T, H) 的 mask 则表示每个隐藏特征各自独立采样,两者不是同一件事。
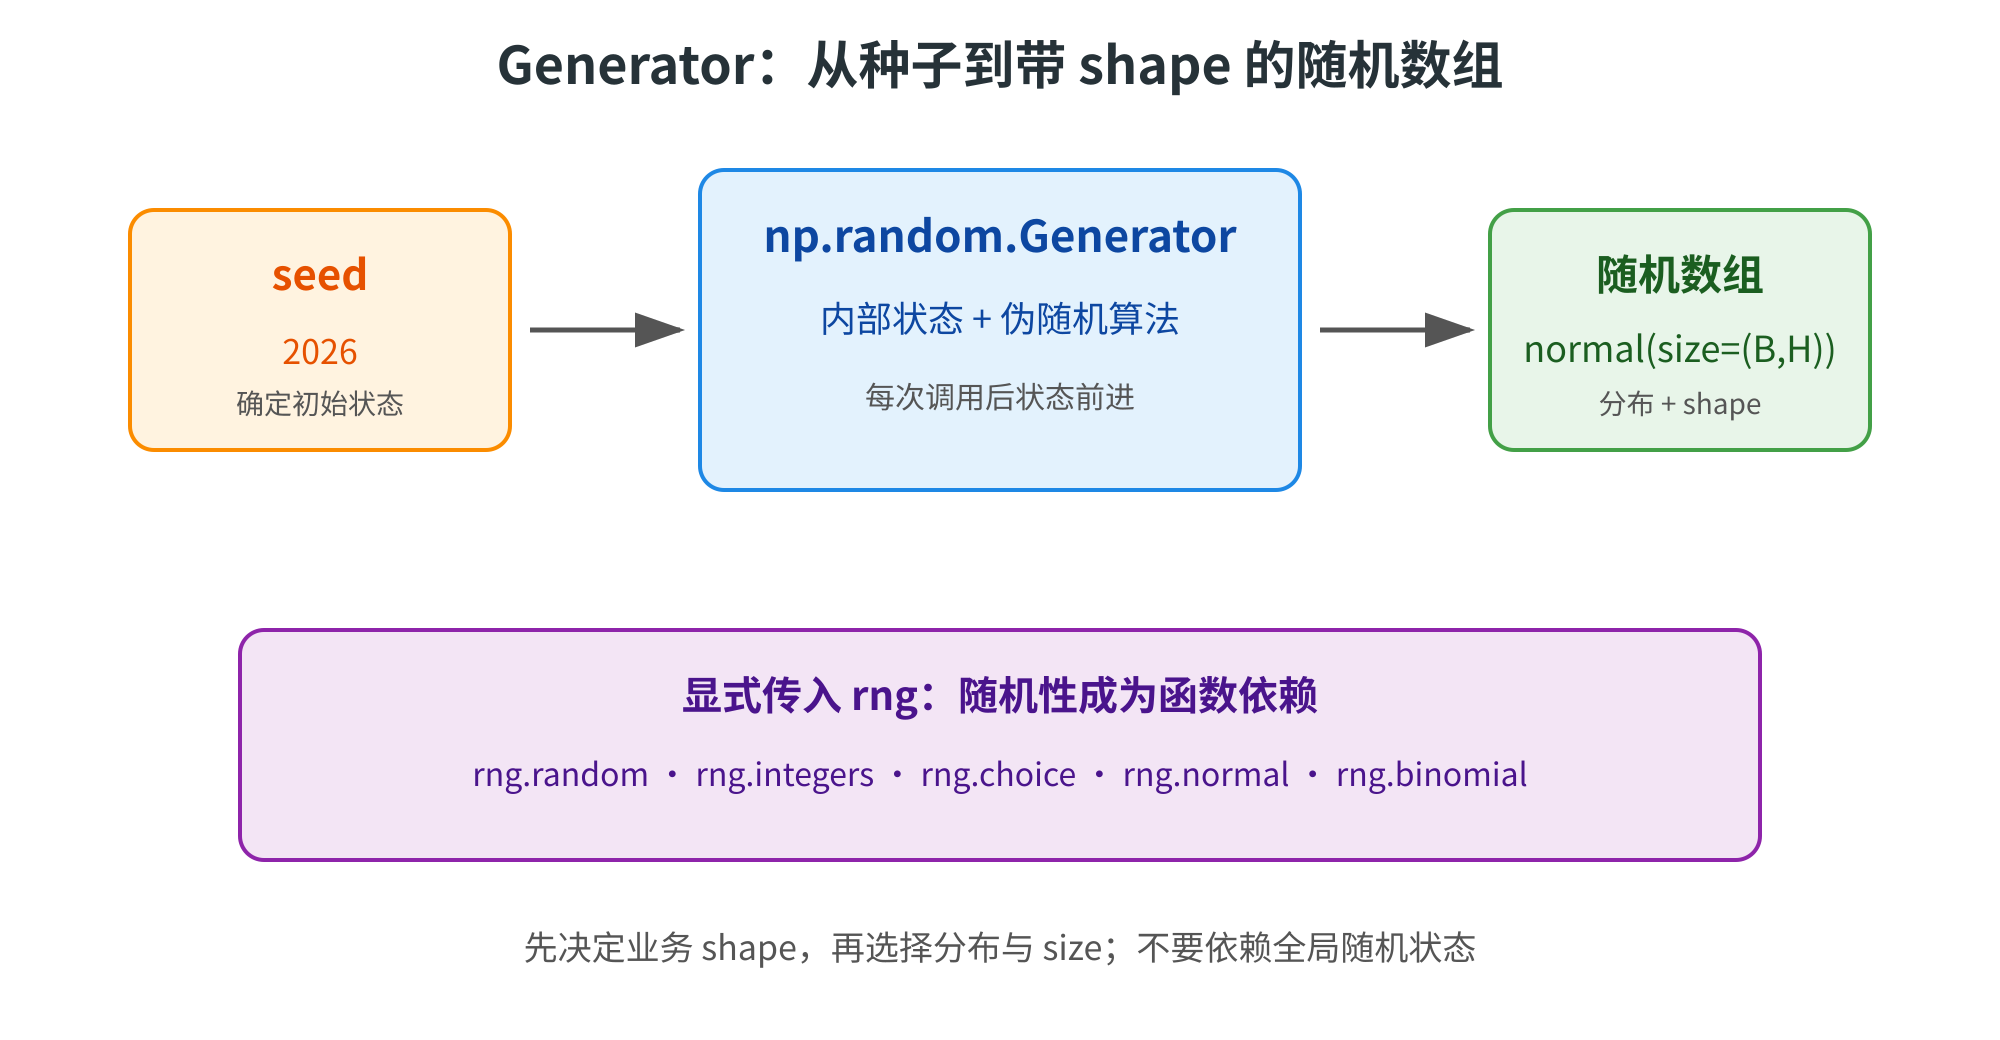
图1 Generator:从种子到带 shape 的随机数组
AI Infra 视角:训练框架会为数据顺序、参数初始化、dropout 和数据增强分别管理随机流。把生成器作为函数参数传递,相当于把“随机性”纳入依赖注入,便于单测、故障复现和多 worker 调试;全局随机状态则像隐藏的全局变量,最难审计。
二、种子、状态与可复现性
2.1 seed 是起点,不是随机性开关
同一个整数种子创建两个生成器,它们会产生相同序列;同一个生成器连续调用,则状态会前进。下面的例子用 array_equal 验证这一点,而不是比较带省略号的打印文本:
import numpy as np

left = np.random.default_rng(1234)
right = np.random.default_rng(1234)
a = left.normal(size=(2, 3))
b = right.normal(size=(2, 3))
print(np.array_equal(a, b))
print(np.array_equal(left.random(4), right.random(4)))
True
True
如果先从 left 取一次整数,再从 right 取浮点数,两个流的“调用进度”就不同了。复现要求的不仅是 seed,还包括算法、NumPy 版本、dtype、调用顺序、并行调度和输入数据。对于跨机器的科学实验,应把这些信息和配置一起记录,而不是只记一个整数。
旧接口 np.random.seed(1234) 修改的是模块级共享状态。它仍然可能出现在旧项目或兼容代码中,但一个库函数不应该偷偷调用它:库的调用者可能同时运行另一个实验,重置全局状态会产生难以定位的关联。更稳妥的函数签名是 def augment(x, rng): ...,由最外层程序决定 seed。
2.2 为不同任务分开随机流
多个任务共用一个生成器时,某个任务多调用一次随机数,就会改变所有后续任务的结果。小脚本里这不明显,分布式训练、数据加载 worker 和故障重试中却很常见。可以为子任务创建独立的生成器;需要组织多个可复现子流时,可使用 SeedSequence.spawn。
import numpy as np

root = np.random.SeedSequence(2026)
children = root.spawn(2)
rng_data = np.random.default_rng(children[0])
rng_model = np.random.default_rng(children[1])

print(rng_data.integers(0, 100, size=3))
print(rng_model.integers(0, 100, size=3))
这里的重点不是记住每个数字,而是让“数据随机性”和“模型随机性”拥有不同的状态。以后只改变数据增强策略,不应意外重排参数初始化。多进程场景还要避免父进程创建完生成器后,直接把同一个可变对象复制给所有子进程;应该根据 worker id 派生独立子流。
2.3 可复现检查清单
一个有价值的复现报告至少包含以下内容:
- seed 或
SeedSequence的记录; - NumPy、Python、硬件和相关框架版本;
- 输入文件、数据切分和样本顺序;
- 随机调用发生的位置以及并行 worker 数;
- 浮点 dtype、线程数和是否启用非确定性 GPU kernel。
“固定 seed 但结果不完全一样”并不自动表示 NumPy 错了。浮点加法不满足结合律,多线程归约的执行顺序可能变化;GPU 的原子操作、通信和 kernel 选择也可能引入非确定性。工程上应先定义可接受的误差范围,再决定是否要付出确定性模式的性能成本。
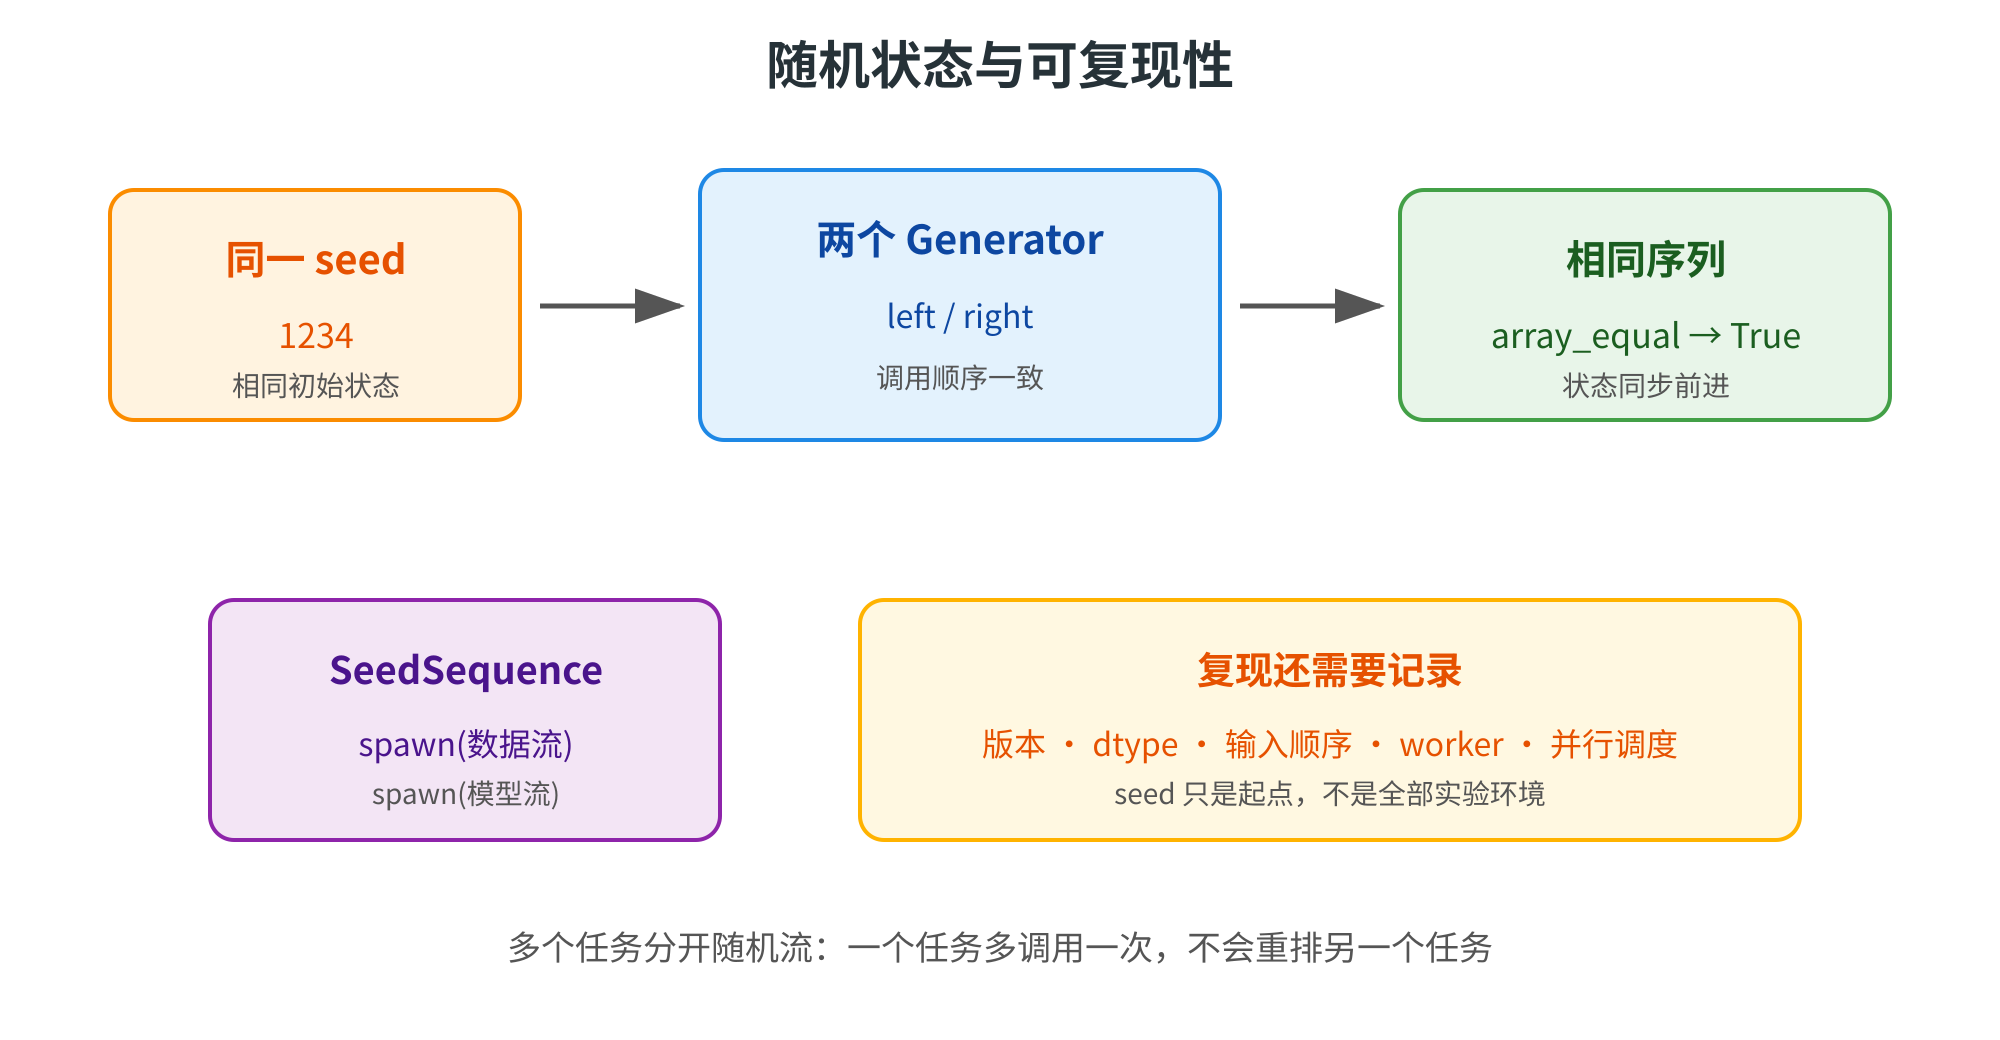
图2 随机状态:同一 seed 同一流,分支后各走各的
三、分布:随机数的形状与含义
3.1 均匀、正态与整数分布
均匀分布(uniform)在区间内没有偏好,适合比例、阈值和简单抽样。rng.random 的范围是 [0, 1),不包含右端点。正态分布(normal)由均值 loc 和标准差 scale 控制,常用来初始化或构造噪声:rng.normal(loc=0, scale=1, size=...)。整数抽样则用于 token id、索引和离散标签。
import numpy as np

rng = np.random.default_rng(42)
u = rng.uniform(-1.0, 1.0, size=100_000)
z = rng.normal(0.0, 2.0, size=100_000)
k = rng.integers(0, 8, size=100_000)

print(u.min() >= -1.0 and u.max() < 1.0)
print(round(float(z.mean()), 1), round(float(z.std()), 1))
print(k.min(), k.max())
True
0.0 2.0
0 7
大样本的统计量会接近理论值,但不会每次刚好等于理论值。normal 的 scale 是标准差,不是方差;若目标方差是 v,应传 scale=np.sqrt(v)。而且 rng.normal(size=(B, H)) 是独立地为每个位置抽样;若想让整个 batch 共享一个噪声标量,shape 就应改成 (1,) 或明确广播的形状。
3.2 离散抽样与概率
choice 的 p 必须是一维概率,长度和候选集合一致,非负且总和接近 1。replace=False 表示不放回,样本数不能超过候选数;replace=True 是默认值,更适合 token 采样这种可重复抽取。
import numpy as np

rng = np.random.default_rng(8)
tokens = np.array(["A", "B", "C"])
counts = {token: 0 for token in tokens}
for token in rng.choice(tokens, size=10_000, p=[0.7, 0.2, 0.1]):
    counts[token] += 1
print(counts)
{'A': 约 7000, 'B': 约 2000, 'C': 约 1000}
输出中的“约”是重点:随机抽样的频率会围绕概率波动,样本越多通常越接近目标,但没有逐次保证。大模型生成时,通常先得到 logits,再减去最大值做数值稳定的 softmax,最后把概率传给采样器。温度改变分布的尖锐程度,top-k 或 top-p 改变候选集合;它们都不是把 argmax 换成随机数这么简单。
3.3 二项分布与 dropout 掩码
二项分布可以理解成重复进行成功概率为 p 的伯努利试验。rng.binomial(1, keep_prob, size=shape) 直接产生由 0 和 1 组成的掩码。训练时若 dropout 概率为 p,保留概率是 q = 1 - p。常见的 inverted dropout 写法是保留后除以 q,让期望值保持不变:
import numpy as np

rng = np.random.default_rng(99)
x = np.full((2, 4), 3.0)
keep_prob = 0.75
mask = rng.binomial(1, keep_prob, size=x.shape)
y = x * mask / keep_prob

print(mask.dtype, mask.shape)
print(y.shape)
print(np.unique(mask))
int64 (2, 4)
(2, 4)
[0 1]
训练阶段使用 mask,评估阶段通常关闭 dropout;不能在评估时继续随机丢弃而又忘记缩放。还要先决定掩码粒度:对 (B, T, H) 的每个元素丢弃,和对整个 token 或整个 hidden channel 丢弃,是不同的正则化策略。生产推理服务中,随机性还会影响缓存命中、批次比较和延迟基准,必须显式配置。
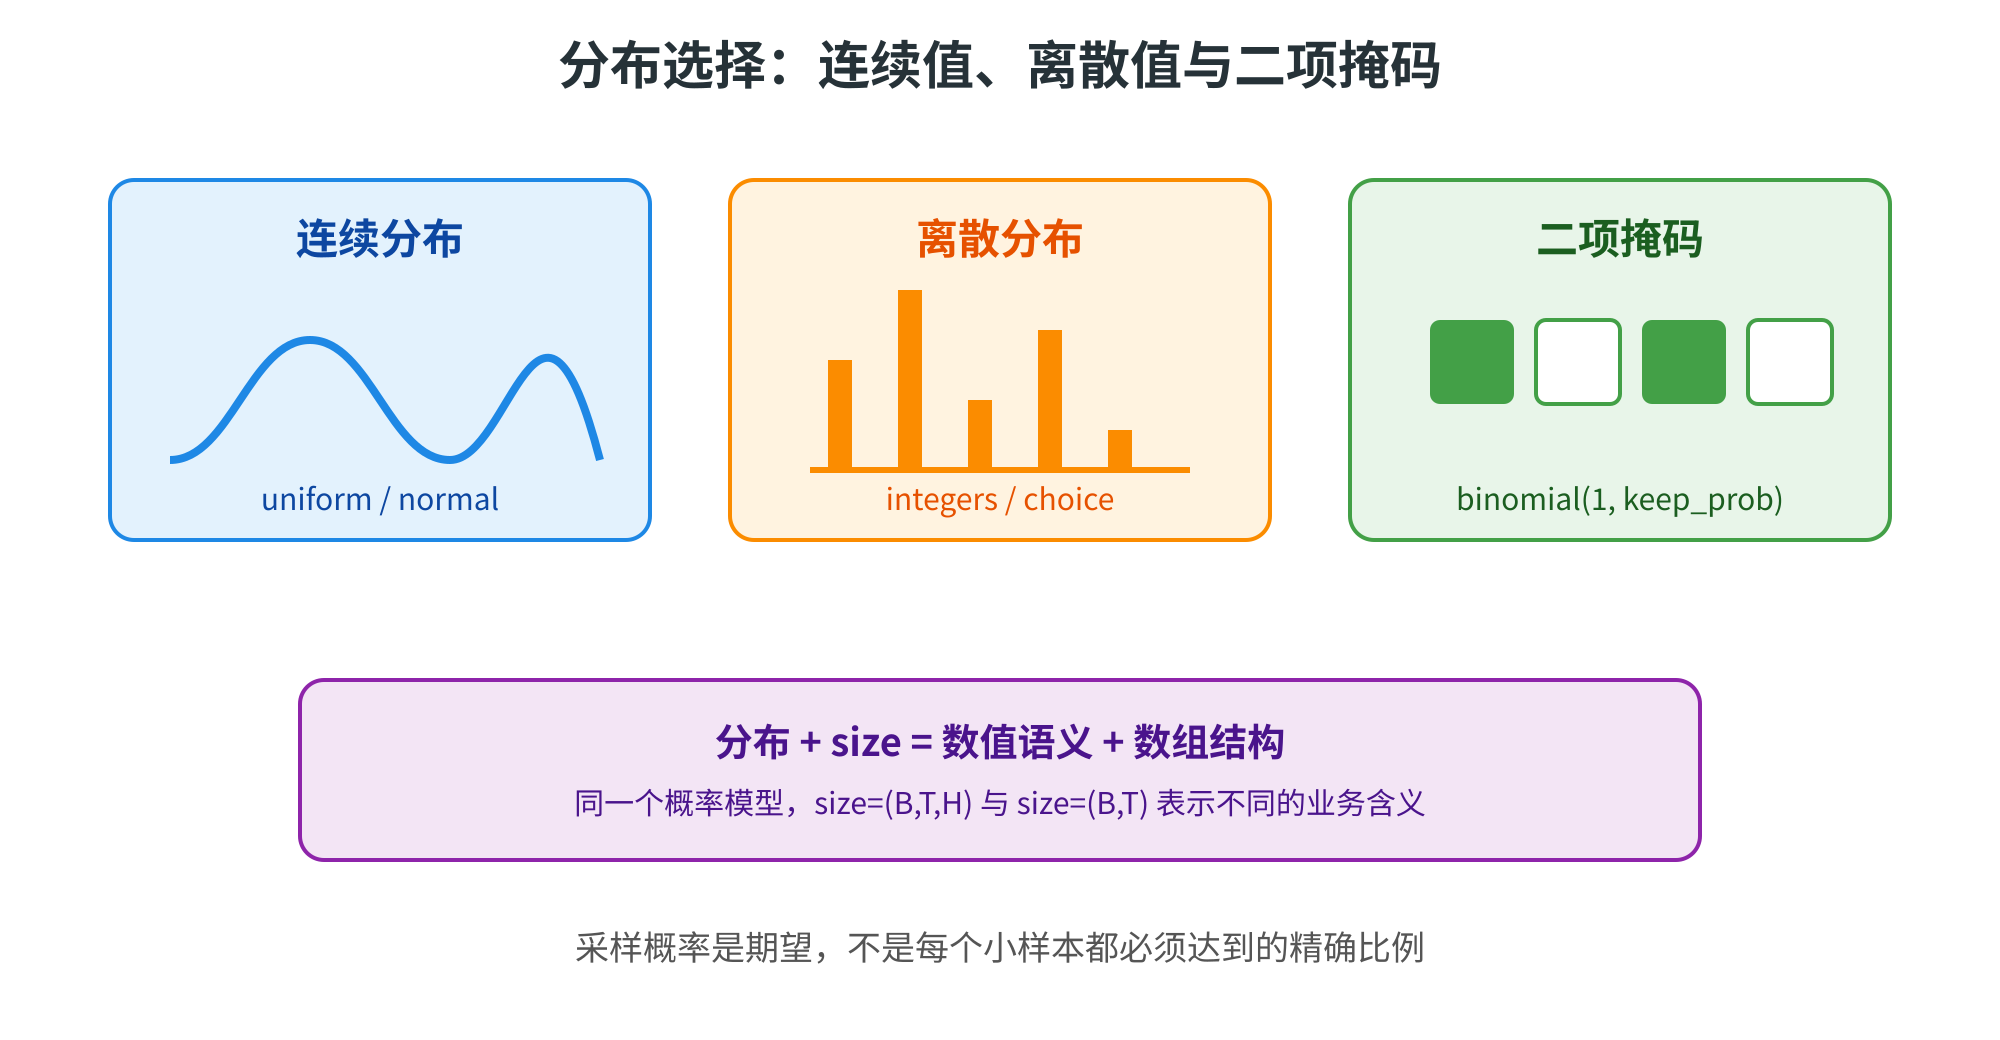
图3 分布选择:连续值、离散值与二项掩码
AI Infra 视角:采样是推理链路的最后一个概率决策,dropout 是训练链路中的随机门控,数据 shuffle 是输入链路的随机排序。三者都应有自己的 shape、概率和随机流;把它们混成一个“全局 seed”只会让故障复现更脆弱。
四、归约:axis 决定消掉哪一维
4.1 sum、mean、std 与 argmax
归约把多个元素汇总为更少的元素。对二维数组 x.shape == (B, F):
x.sum()消掉所有轴,得到一个标量;x.sum(axis=0)沿 batch 轴相加,留下特征轴,shape 是(F,);x.mean(axis=1)沿特征轴求均值,留下每个样本,shape 是(B,);x.std(axis=...)衡量对应轴上的离散程度;x.argmax(axis=...)返回最大值的位置,不是最大值本身。
import numpy as np

scores = np.array([[1.0, 4.0, 2.0],
                   [5.0, 0.0, 3.0]])
print(scores.sum())
print(scores.mean(axis=0))
print(scores.std(axis=1).round(3))
print(scores.argmax(axis=1))
15.0
[3. 2. 2.5]
[1.247 2.055]
[1 0]
把 axis 读成“沿哪条轴折叠”。axis=0 把两行叠起来,所以每一列留下一个结果;axis=1 把每行折成一个结果,所以每一行留下一个结果。对三维数组,axis=(1, 2) 表示同时消掉两个轴。第 33 篇的矩阵乘法是在匹配轴上做乘加;这里的归约则可以只做加法、均值、最大值或其他聚合。
4.2 keepdims:归约后保留长度为 1 的轴
默认归约会删除目标轴。若后续要广播回原数组,keepdims=True 往往更安全:目标轴不再包含原数据,但保留为长度 1。以按行标准化为例:
import numpy as np

x = np.arange(6, dtype=float).reshape(2, 3)
row_mean = x.mean(axis=1, keepdims=True)
row_std = x.std(axis=1, keepdims=True)
z = (x - row_mean) / row_std

print(row_mean.shape, row_std.shape)
print(z.mean(axis=1).round(6))
print(z.std(axis=1).round(6))
(2, 1) (2, 1)
[0. 0.]
[1. 1.]
如果写成 x.mean(axis=1),结果是 (2,)。它与 (2, 3) 相减时,NumPy 会从尾部对齐,(2,) 会被理解为每一列对应一个数,而不是每一行一个数;有时因此报错,有时恰好广播成功却表达错语义。keepdims 是对业务轴的显式声明,不是“多写一个参数”。
4.3 argmax 和值索引
分类 logits 常见 shape 是 (B, C)。logits.argmax(axis=1) 返回每个样本的类别 id,shape (B,);logits.max(axis=1) 返回最大 logit 的值。若要同时取值和索引,可用 np.max 与 np.argmax,或使用 np.take_along_axis 对应索引取概率。
import numpy as np

logits = np.array([[0.2, 1.4, 0.7],
                   [2.0, 0.3, 0.8]])
pred = np.argmax(logits, axis=1)
confidence = np.max(logits, axis=1)
print(pred, confidence)
[1 0] [1.4 2. ]
argmax 遇到并列最大值时返回第一个位置。如果业务需要随机打破平局,必须明确实现并记录规则,不能假设它会随机。对全局数组调用 argmax() 得到的是扁平化后的索引;要还原坐标,可以配合 np.unravel_index,或者直接指定轴。
4.4 where、NaN 与 dtype
真实指标往往有 padding、无效样本或缺失值。np.mean 遇到 NaN 会传播 NaN;np.nanmean 会忽略 NaN,但如果一整条切片都是 NaN,结果仍可能是 NaN 并发出警告。更稳妥的做法是同时保留有效计数,用 sum / count 明确分母。
import numpy as np

loss = np.array([0.2, 0.4, np.nan, 0.8])
valid = ~np.isnan(loss)
print(np.nansum(loss), valid.sum())
print(np.nansum(loss) / valid.sum())
1.4 3
0.4666666666666667
归约的 dtype 也影响精度和性能。整数求和通常会提升到更宽的整数类型;浮点求和默认沿输入 dtype 或 NumPy 规则累加。对很长的 float32 指标,必要时写 dtype=np.float64,并在输出边界再转回目标 dtype。mean 不是免费操作:它需要考虑计数,且对空数组会产生警告和 NaN;接口层应提前约束 batch 不能为空。
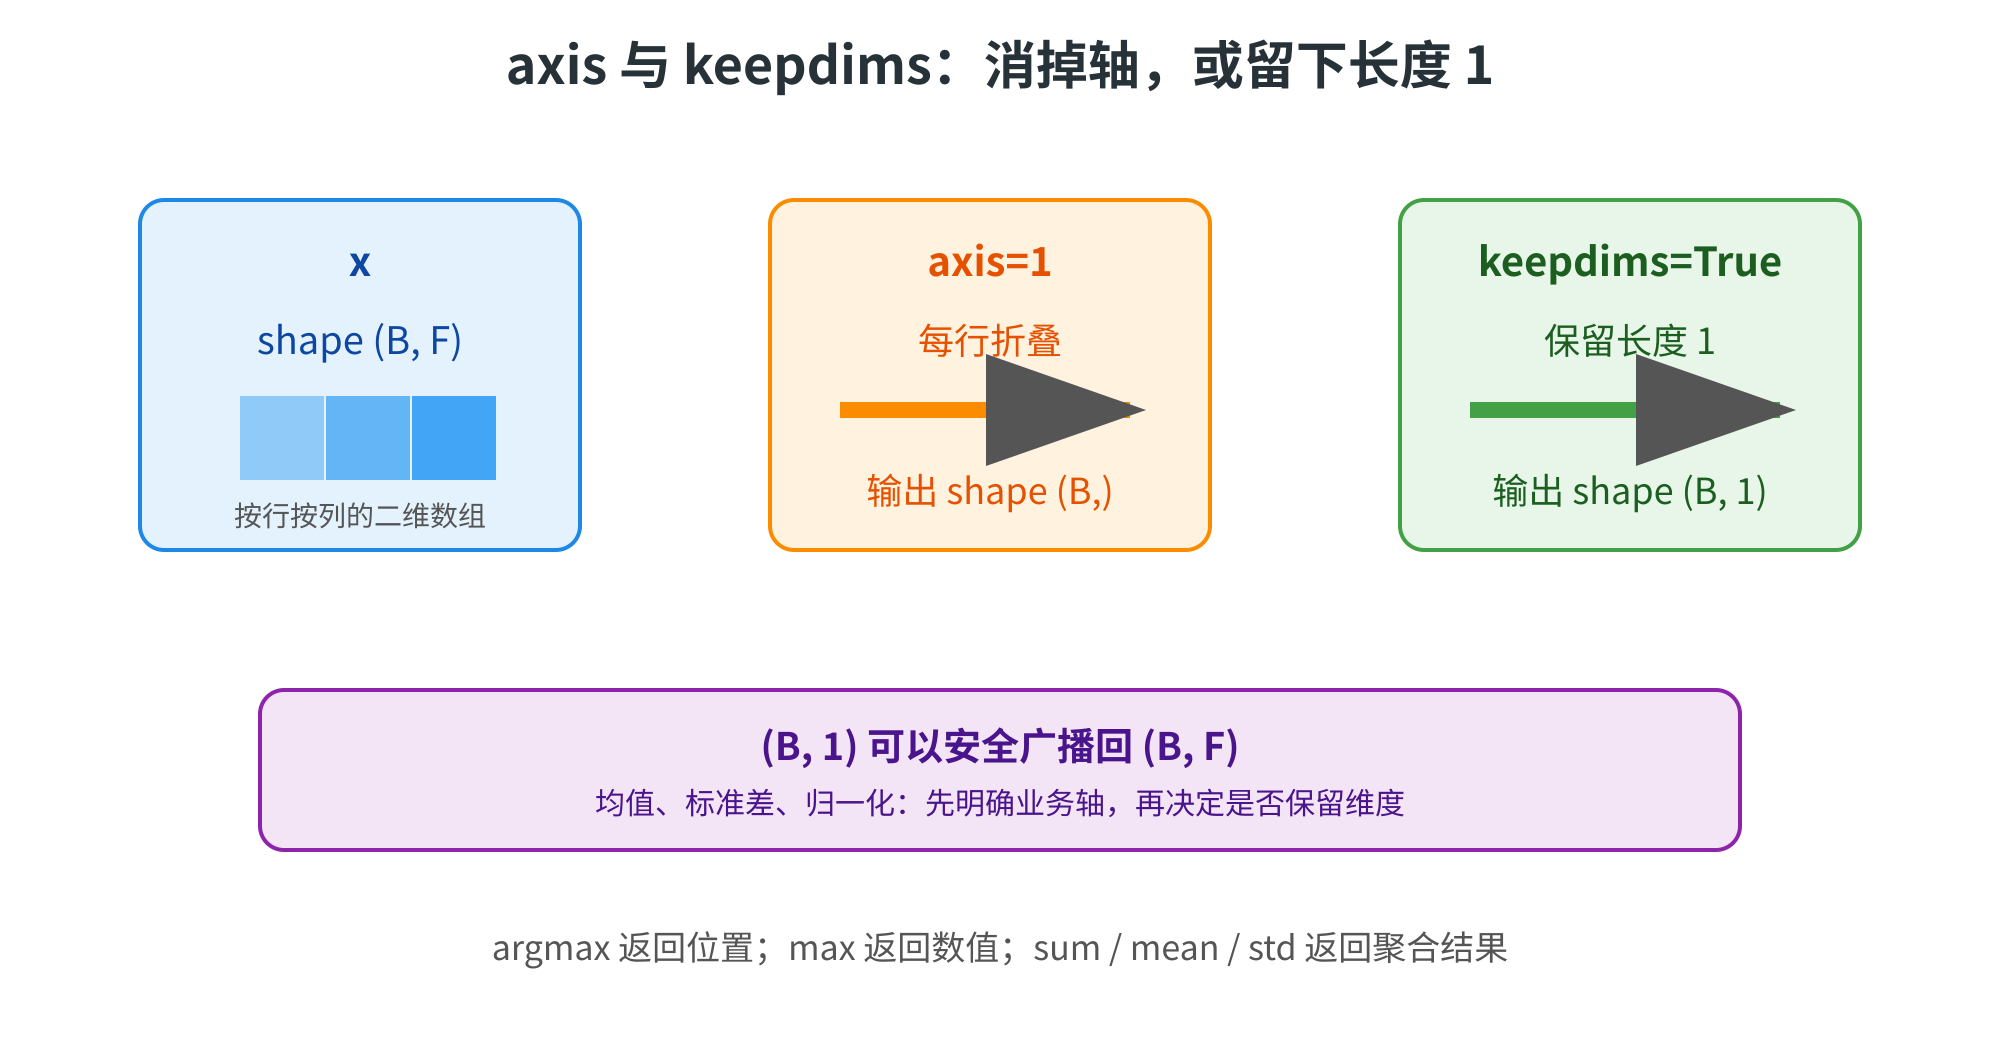
axis与keepdims在归约操作中的作用。左侧是形状为(B, F)的二维数组x。中间,axis=1表示按行折叠,输出形状为(B,)。右侧,keepdims=True保留长度为1的轴,输出形状为(B, 1)。底部说明(B, 1)可安全广播回(B, F),强调先明确业务轴,再决定是否保留维度。此图与上下文紧密相关,直观呈现了归约操作中axis和keepdims的用法及影响。图4 axis 与 keepdims:消掉轴,或保留长度为 1 的轴
AI Infra 视角:归约经常成为通信边界。单卡上
loss.mean(axis=...)很便宜,但多卡训练要做 all-reduce;如果先在每张卡上平均,再对卡平均,必须确认各卡有效样本数相同,否则应聚合 loss 总和与 count。shape 和分母都是指标协议的一部分。
五、综合实践:从随机掩码到指标聚合
5.1 用生成器写可测试的 dropout
把随机源显式传入,函数就不依赖全局状态,也能在测试中注入固定生成器。下面的实现返回 mask 和输出,方便观察比例与验证 shape:
import numpy as np


def dropout(x, drop_prob, rng, training=True):
    if not 0.0 <= drop_prob < 1.0:
        raise ValueError("drop_prob must be in [0, 1)")
    if not training:
        return x.copy(), np.ones_like(x, dtype=np.int8)
    keep = 1.0 - drop_prob
    mask = rng.binomial(1, keep, size=x.shape).astype(x.dtype)
    return x * mask / keep, mask

rng = np.random.default_rng(5)
x = np.ones((4, 6), dtype=np.float32)
y, mask = dropout(x, 0.25, rng)
print(y.shape, mask.shape, np.unique(mask))
(4, 6) (4, 6) [0. 1.]
测试时可以创建两个同 seed 的生成器,验证两个结果完全相同;再创建不同 seed,验证不应把某个偶然结果写死。大样本统计测试比“小矩阵刚好丢掉两个元素”更可靠:例如检查保留比例在 keep ± 0.02 内。对于极小输入,随机波动很大,不能把理论概率当作每次输出的精确计数。
5.2 从 logits 到可复现采样
下面是一个教学版 categorical sampling:先把 logits 变成概率,再用 choice 取一个类别。减去最大值避免 exp 溢出;如果 logits shape 是 (B, V),每一行要有一个概率分布,采样也要按行进行。
import numpy as np


def softmax(logits):
    shifted = logits - logits.max(axis=-1, keepdims=True)
    exp = np.exp(shifted)
    return exp / exp.sum(axis=-1, keepdims=True)


def sample_one(logits, rng, temperature=1.0):
    if temperature <= 0:
        raise ValueError("temperature must be positive")
    probs = softmax(logits / temperature)
    ids = np.arange(logits.shape[-1])
    return rng.choice(ids, p=probs)

rng = np.random.default_rng(2026)
logits = np.array([1.0, 2.0, 0.5])
print(sample_one(logits, rng))
1
温度越低,概率越集中在最大 logit;温度越高,分布更平。生产推理还要处理 top-k、top-p、重复惩罚、停止 token 和 batch 内不同序列长度。最重要的工程原则是:采样参数、随机流和过滤顺序都要记录。只记录最终 token,无法解释为什么一次请求和另一次请求不同。
5.3 正确聚合 batch 指标
假设每个样本有一个 loss,但最后一个 batch 可能比其他 batch 小。直接对“每个 batch 的平均 loss”再求平均,会让小 batch 和大 batch 权重相同。应累加 loss 总和和样本数,最后一次相除:
import numpy as np

batch_losses = [np.array([1.0, 3.0]),
                np.array([2.0, 2.0, 2.0]),
                np.array([4.0])]
wrong = np.mean([batch.mean() for batch in batch_losses])
total = np.sum([batch.sum() for batch in batch_losses])
count = np.sum([batch.size for batch in batch_losses])
correct = total / count
print(round(float(wrong), 3), round(float(correct), 3))
2.667 2.333
这就是一个小小的归约协议:局部阶段输出 (sum, count),全局阶段再做一次归约。分布式训练、流式评测、服务监控都可以复用这个协议。准确率也要明确分子和分母;延迟的平均值、P50、P95 更不能混用。均值适合描述整体负载,分位数适合发现尾延迟,两者是不同的统计对象。
5.4 组合轴:每个样本、每个 token 与全局
假设 loss.shape == (B, T),其中 padding 位置由 valid.shape == (B, T) 标记。每个样本的平均 loss 应沿 T 归约;全局平均则沿两个轴归约,而且分母是有效 token 数:
import numpy as np

loss = np.array([[1.0, 2.0, 0.0],
                 [3.0, 0.0, 0.0]])
valid = np.array([[True, True, False],
                  [True, False, False]])
per_sample = np.divide(
    np.where(valid, loss, 0.0).sum(axis=1),
    valid.sum(axis=1),
)
global_mean = np.where(valid, loss, 0.0).sum() / valid.sum()
print(per_sample.round(3), round(float(global_mean), 3))
[1.5 3. ] 2.0
如果直接 loss.mean(axis=1),padding 的零会把第一个样本算成 1.0,把第二个样本算成 1.0,完全改变指标含义。where、axis 和分母必须一起审查。对 (B, T, H) 的激活做层归一化时,也要说明是沿 hidden 轴,还是沿 token 和 hidden 两个轴;仅凭函数名字无法判断。
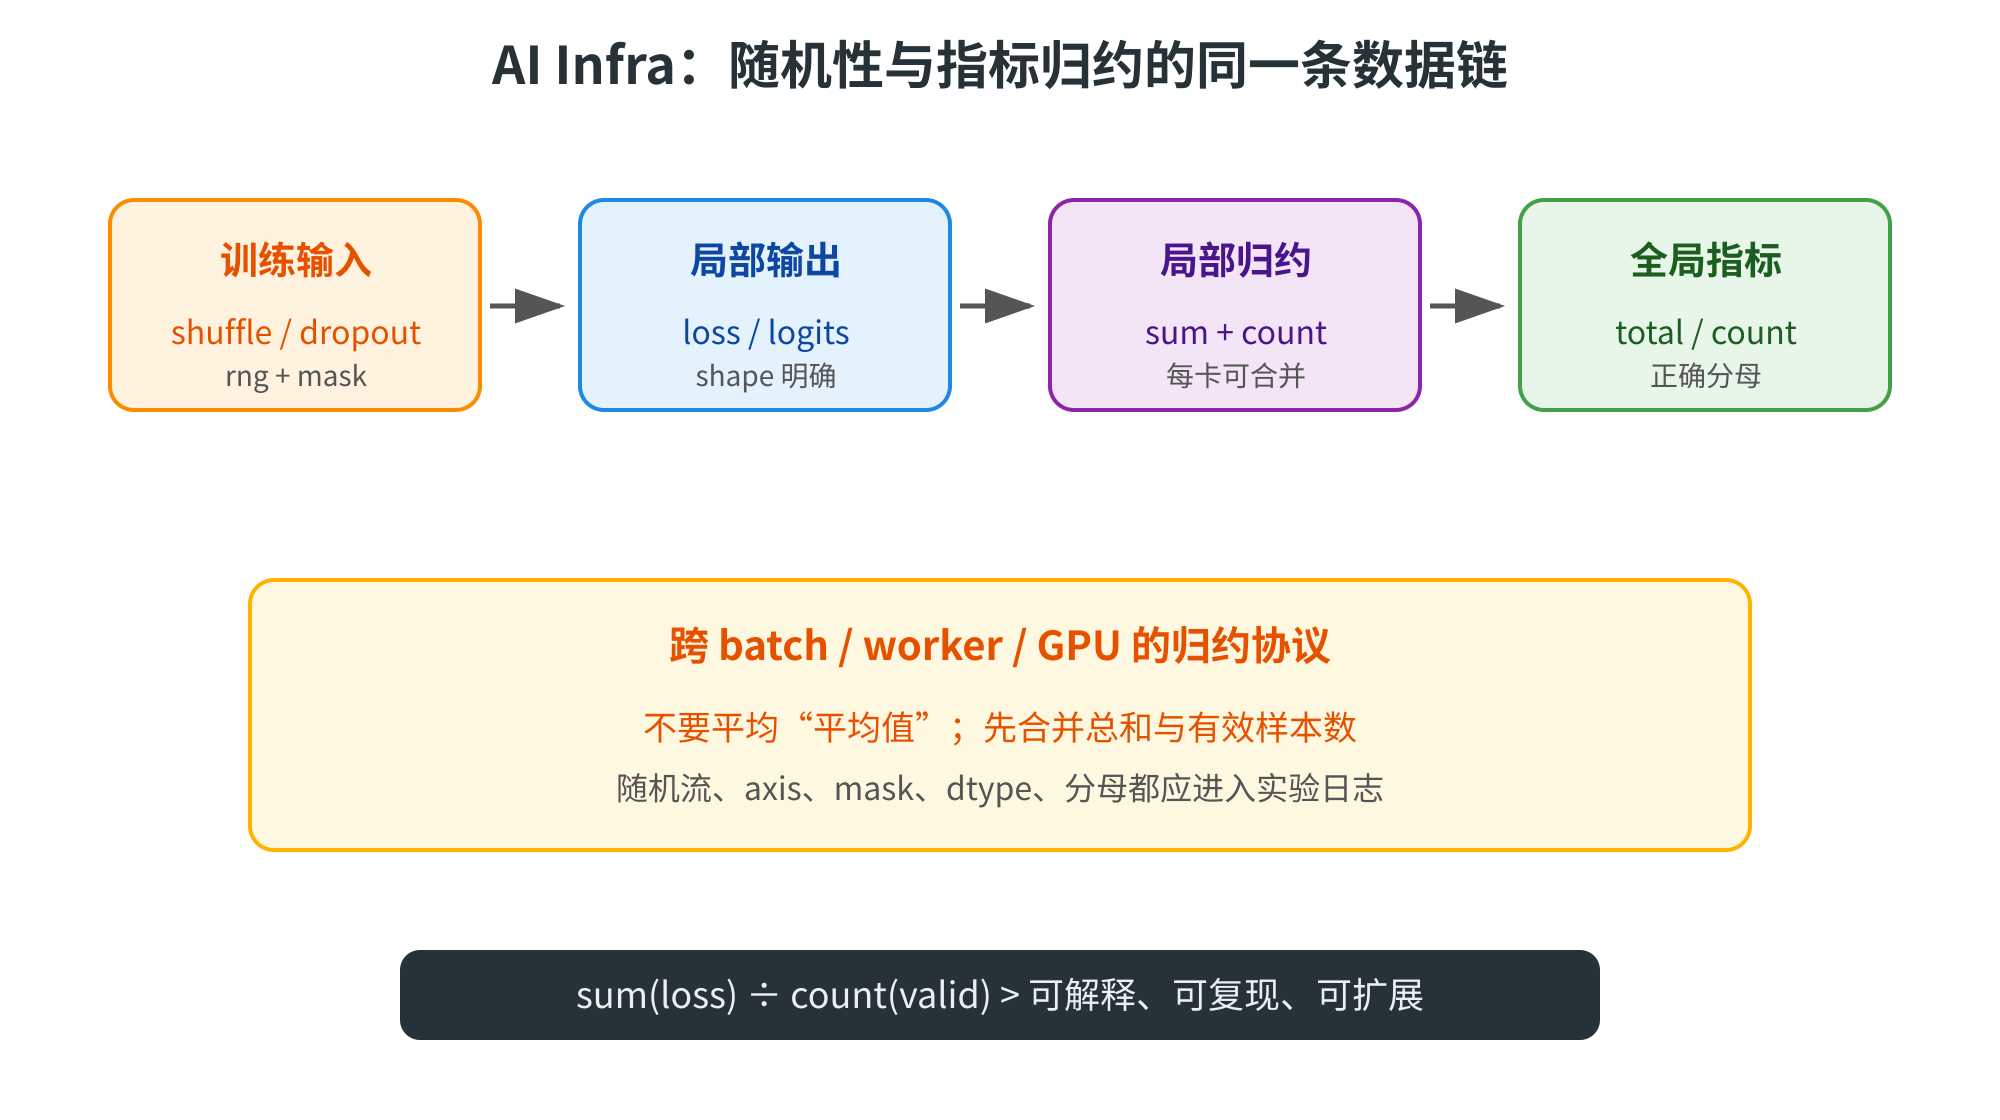
图5 AI Infra 指标链路:采样、掩码与分布式归约
六、性能、内存与数值边界
6.1 先批量生成,再向量化归约
Python 循环中每次调用一次随机 API,会放大函数调用和状态管理开销,也让代码难以表达 shape。通常应一次生成 (B, T) 或 (B, H) 的数组,再用 NumPy 的 C 实现完成比较、乘法和归约。rng.random(size) 仍然会分配内存;如果只需要一个统计量,就不要无意中生成远大于需求的临时数组。
import numpy as np

rng = np.random.default_rng(0)
noise = rng.normal(size=(1000, 128)).astype(np.float32)
energy = np.square(noise).mean(axis=1, dtype=np.float64)
print(noise.shape, energy.shape, energy.dtype)
(1000, 128) (1000,) float64
np.square 和 mean 都可能产生中间结果;在内存紧张的推理服务里,要关注峰值而不只是最终数组大小。可以通过分块统计 (sum, count),避免把所有日志或样本一次装进内存。对非常大的数组,内存带宽常常比算术运算更容易成为瓶颈,减少无用拷贝和重复遍历通常比微调 Python 语法更有效。
6.2 归约顺序和浮点误差
浮点数有有限精度,(a + b) + c 不一定等于 a + (b + c)。长数组中,小数和大数相加会丢失部分低位;并行归约因为分块顺序不同,最后几位可能变化。不要用 == 判断两个不同执行计划的浮点均值;使用 np.isclose,并根据业务给出 rtol、atol。
还要警惕整数溢出和空切片。计数、token id 和数组大小可能是整数,但累计总量要选择足够宽的 dtype;均值需要非空分母。监控系统中如果某个窗口没有有效样本,应输出“无数据”状态,而不是把 NaN 静默转成 0。
6.3 不要把 NumPy 随机数当作密码学随机数
API key、session token、密码重置链接等安全用途应使用 secrets 或操作系统提供的密码学随机源。NumPy 的 PRNG 目标是速度、统计性质和可复现模拟,而不是抵抗攻击者推断状态。即使设置了不可见的 seed,也不等于安全。AI Infra 中的训练随机性和身份认证随机性是两类完全不同的需求。
七、踩坑大全
通用
坑 1:把 * 误认为随机缩放或矩阵运算。 * 对数组是逐元素乘法;dropout 的缩放需要显式乘 mask 再除以保留概率,矩阵乘法仍是 @。
坑 2:只调用一次 np.random.seed 就宣称全部可复现。 生成器、Python random、框架、数据 worker、GPU kernel 和输入顺序都可能有独立随机性;应记录完整实验配置,并优先使用显式 Generator。
坑 3:把 rng.integers(10) 当成长度为 10 的数组。 没有 size 时得到标量 shape == ();需要 (10,) 就写 size=10。
坑 4:误读 axis=0。 它消掉第 0 轴而不是“对第 0 列单独计算”;二维 (B, F) 上沿 axis=0 求和,结果保留 F。
坑 5:argmax 当成最大值。 argmax 返回位置,max 返回数值;分类预测通常要 argmax(axis=1)。
坑 6:平均 batch 平均值。 batch 大小不同会产生加权错误;跨 batch、跨卡应累计总和与有效计数。
Linux / GPU 服务器与 AI Infra
坑 7:多进程复用同一个随机状态。 fork 或 worker 初始化不当可能让不同 worker 产生重复序列;为每个 worker 派生独立 seed,并在日志中记录 worker id。
坑 8:用 CPU NumPy 的 seed 推断 GPU 结果一定相同。 NumPy 只控制自己的生成器;PyTorch、CUDA、通信库各自有随机状态和确定性开关,跨设备还可能存在浮点误差。
坑 9:把 keepdims 省掉后依赖“碰巧能广播”。 (B,) 与 (B, T) 的对齐方向可能和业务意图相反;归约后要打印 shape 或写断言,必要时保留长度为 1 的轴。
坑 10:把随机采样的频率当作硬约束。 p=[0.7, 0.2, 0.1] 只表示期望比例;小样本偏差正常。测试应验证概率、shape 和统计区间,而不是固定某次 token 序列。
八、小结
np.random.default_rng(seed)返回独立的Generator,显式传递它比修改全局状态更容易测试和复现。random、integers、choice、normal、binomial的区别在于取值空间和概率模型;size决定输出 shape。- 复现依赖 seed、调用顺序、算法版本、dtype、并行方式和输入数据;不同任务应使用可追踪的独立随机流。
sum、mean、std、argmax都是沿轴归约;axis决定消掉哪一维,keepdims=True保留长度为 1 的维度以便广播。- dropout、token sampling、数据 shuffle 和指标聚合都需要同时审查随机状态、shape、分母与数值稳定性。
- AI Infra 中的局部统计应优先输出
(sum, count)等可合并状态,再跨 batch、worker、GPU 做正确归约。
九、课后练习
- (基础) 创建一个固定 seed 的
Generator,生成(3, 4)的uniform、normal和integers数组,分别打印shape、dtype和数值范围。 - (基础) 对一个
(2, 3, 4)数组分别使用axis=0、axis=1、axis=2求和,先猜结果 shape,再用assert验证;补做axis=(1, 2), keepdims=True。 - (理解) 写一个
row_standardize(x),返回每行均值为 0、标准差为 1 的数组,要求使用keepdims=True,并处理标准差为 0 的行。 - (理解) 实现
masked_mean(values, valid, axis=...),不能把无效位置填 0 后直接mean;用(sum, count)处理任意 axis。 - (进阶) 用
SeedSequence.spawn为数据增强和参数初始化生成两个子流,验证改变增强调用次数不会改变初始化流的前几项。 - (进阶) 实现带 temperature、top-k 的单步 token 采样,加入固定 seed 测试;分别观察 temperature 为
0.5、1.0、2.0时的频率变化。 - (AI Infra) 模拟 3 张卡上不同数量的 token loss,比较“先卡内平均再卡间平均”和“总和除总 count”的差异,解释哪一个在样本数不同时正确。
- (AI Infra) 为
(B, T, H)激活设计两种 dropout mask:每元素一张 mask 与每 token 一张 mask;打印广播后的 shape,并说明两种正则化假设的区别。
下一篇预告
下一篇是 第35篇|stride、reshape、transpose 的底层原理。本篇的 axis 告诉我们“沿哪一维归约”,但数组为什么能在不移动数据的情况下改变形状?下一篇会从 shape、strides 和连续内存出发,拆解 reshape、transpose、view 与 copy 的关系,解释为什么转置后的矩阵可能影响缓存访问,以及如何在 AI Infra 的 batch、token、hidden 维度之间安全换轴。
我们会继续沿着专栏三的路线前进:先理解 NumPy 数组的内存契约,再在第 36 篇用纯 NumPy 手写 MLP 的前向与反向。届时,随机初始化、dropout 和 loss 归约不再是孤立 API,而会组合成一个可检查、可复现的训练循环。