
第31篇|广播机制
本篇定位:《Python 教程》专栏三「NumPy 数值计算」第三篇。承接第 29 篇的 shape / strides 与第 30 篇的索引、视图,正面吃透 广播(broadcasting):不同 shape 的数组如何「对齐后再算」,以及长度为 1 的轴如何虚拟伸长。
读完你将能够:用「右对齐 → 1 可扩 → 结果取 max」三步判断两个数组能否广播;用
None/np.newaxis主动造可广播形状;读懂ValueError: operands could not be broadcast;解释为何广播是虚拟扩展而非先tile;把同一套规则映射到后续 ufunc、归一化与 Attention mask。预计用时:阅读 35~45 分钟,动手 40~60 分钟。
第 30 篇学会了「怎么取子块」;本篇回答下一问:取出来的两块 shape 对不上,还能不能直接加减乘除? 能——前提是满足广播规则。这一规则是 NumPy(以及 PyTorch)向量化的隐形地基:少了它,你会被迫写三重循环或到处 reshape;懂了它,一行 a + b 就能完成「每一行减均值」「每一列乘权重」。
建议边读边开 REPL:uv add numpy(若尚未安装),uv run python。每节的代码块都可以直接粘贴运行,并对照文中的预期输出。阅读顺序:痛点直觉 → 三步规则 → newaxis → 成败对照与报错阅读 → 虚拟扩展与内存 → AI Infra 挂钩 → 踩坑。和第 30 篇的 None 保维切片对照:那里只是「插一条轴」;本篇告诉你 插完之后怎么和另一边对齐运算。
一句话定心:广播 = 从右对齐形状;长度为 1 的轴可虚拟伸长;伸长后逐元素运算;输入侧通常不先拷贝成大数组。
若只记住三句话,就记这三句:右对齐;1 可扩;双大不等则失败。 其余都是围绕这三句的造形技巧、报错阅读与工程纪律。
本篇不展开全部 ufunc 清单(留给第 32 篇)、不深挖 stride 字节公式(第 35 篇)、不穷尽所有多数组广播组合。主线是:为何需要 → 三步规则 → 主动造形 → 失败诊断 → 虚拟扩展 → 工程用法。
动手时建议「先猜 shape、再跑代码、再看报错」三步:对每一对 shape,先在纸上从右对齐画一遍,写出你认为的结果 shape 或「失败」;再交给 np.broadcast_shapes 或直接做运算;若失败,对照第三节的修法改一版。这个闭环比只背口诀有效得多——广播是规则系统,规则要靠「猜错再纠正」刻进肌肉记忆。
和第 06 篇的推导式对照:那里用一行 Python 表达「对每个元素做什么」;这里用一行 NumPy 表达「对整块对齐后的网格做什么」。和第 29 篇对照:shape 不再只是「数组长什么样」,而成了「能不能和另一个数组对话」的协议字段。和第 30 篇对照:[:, None] 从「保维技巧」升级为「广播造形的标准动词」。
写数值代码时再立一条纪律:广播前先打印双方 shape;归约后先决定 keepdims;失败时从右找冲突轴。 很多人倒过来「先写运算再看报错长什么样」,排障成本会高一个数量级——因为报错信息短,而你的业务轴意图写在注释里、不在 traceback 里。
也可以把本篇看成专栏三的「形状协议课」:后面向量化、线性代数批处理、手写 MLP 的 bias,全都默认你会这套协议。PyTorch 几乎原样复用——先在 NumPy 上把对错边界踩清楚,专栏四谈 expand 与 mask 时不会晕。
一、为什么需要广播?从「形状对不上」说起
1.1 一个烦人的日常:每行减均值
import numpy as np

X = np.array([[1.0, 2.0, 3.0],
              [4.0, 5.0, 6.0],
              [7.0, 8.0, 9.0]])   # shape (3, 3)
mu = X.mean(axis=1)               # shape (3,) —— 每行一个均值
print(mu)
[2. 5. 8.]
你想做「每行减去该行均值」:X - mu。若按「形状必须完全相同」的朴素规则,(3,3) 减 (3,) 会直接失败。手写循环可以:
Y = np.empty_like(X)
for i in range(X.shape[0]):
    Y[i] = X[i] - mu[i]
print(Y)
[[-1.  0.  1.]
 [-1.  0.  1.]
 [-1.  0.  1.]]
结果对,但慢、丑、且和「向量化」背道而驰。广播让你写成:
Y = X - mu[:, None]               # (3,3) - (3,1) → (3,3)
print(Y)
print(Y.shape)
[[-1.  0.  1.]
 [-1.  0.  1.]
 [-1.  0.  1.]]
(3, 3)
mu[:, None] 把 (3,) 变成 (3,1),再与 (3,3) 广播相减——同一结果,零显式循环。
1.2 一张图建立直觉
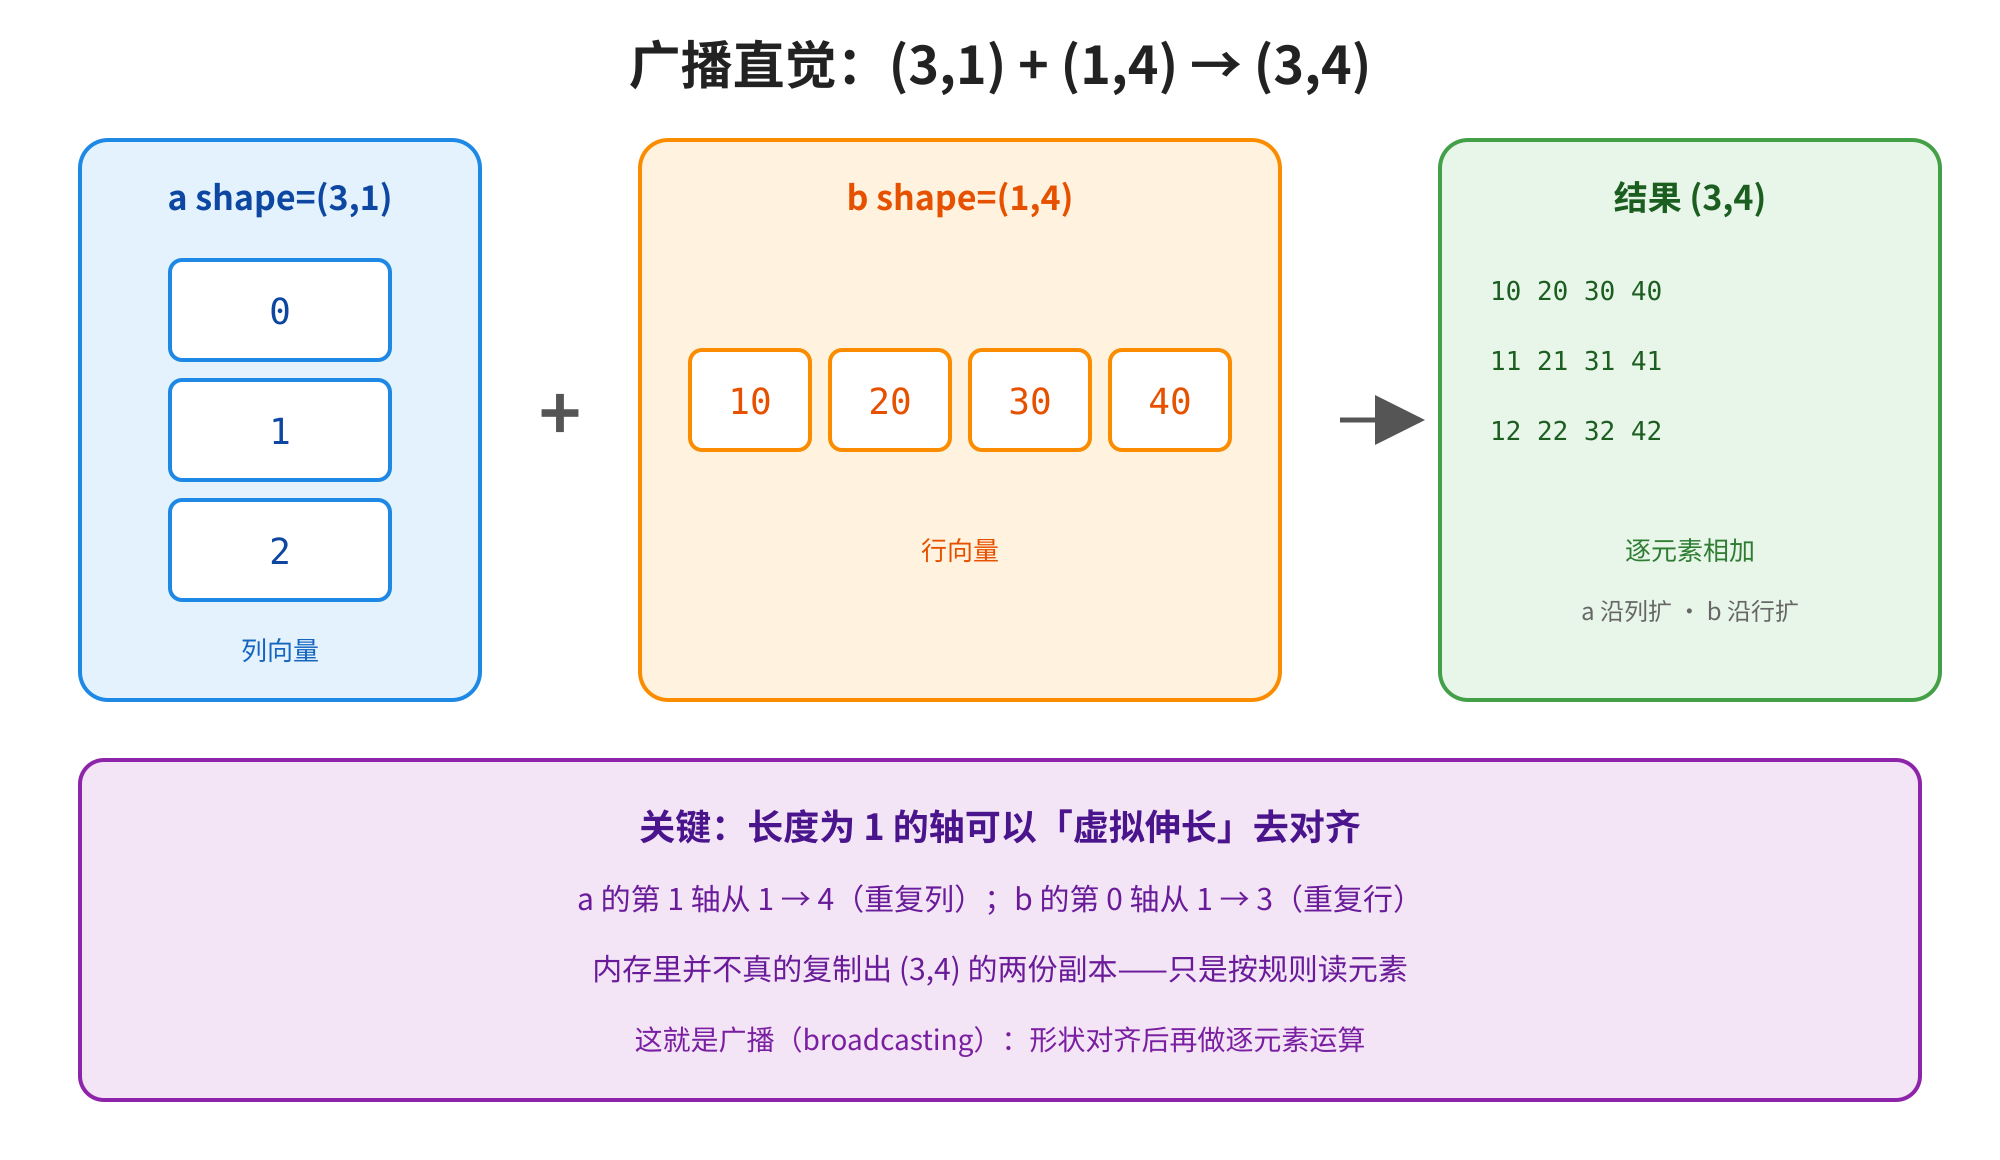
图1 广播直觉:(3,1)+(1,4)→(3,4)
经典例子:列向量加行向量,得到外积式的加法表。
a = np.arange(3).reshape(3, 1)    # [[0],[1],[2]]
b = np.arange(10, 50, 10).reshape(1, 4)  # [[10,20,30,40]]
print(a + b)
print((a + b).shape)
[[10 20 30 40]
 [11 21 31 41]
 [12 22 32 42]]
(3, 4)
心智口诀:a 沿列方向「铺开」去对齐 b 的 4 列;b 沿行方向「铺开」去对齐 a 的 3 行。 铺开是虚拟的——下一节规则会精确化;第五节再讲「为何不真拷贝」。
AI Infra 视角:训练里几乎每一步都在广播——BatchNorm 的均值 / 方差沿 batch 归约后再减回激活;bias 向量加到整张 feature map;Attention 的因果 mask 以
(1,1,T,T)或(B,1,1,T)加到(B,H,T,T)的 logits。不会广播,读不懂这些一行代码。
1.3 和「Python 列表运算」差在哪
# list:拼接语义,不是逐元素
print([1, 2, 3] + [10])           # [1, 2, 3, 10]

# ndarray:逐元素(可广播)
print(np.array([1, 2, 3]) + 10)   # [11 12 13]
[1, 2, 3, 10]
[11 12 13]
标量 10 被当成「与任何 shape 都兼容的 0 维数组」——这是广播的最简情形。列表没有这套规则;不要把两种 + 混为一谈。
二、广播规则三步走
2.1 把规则写成可执行的检查清单
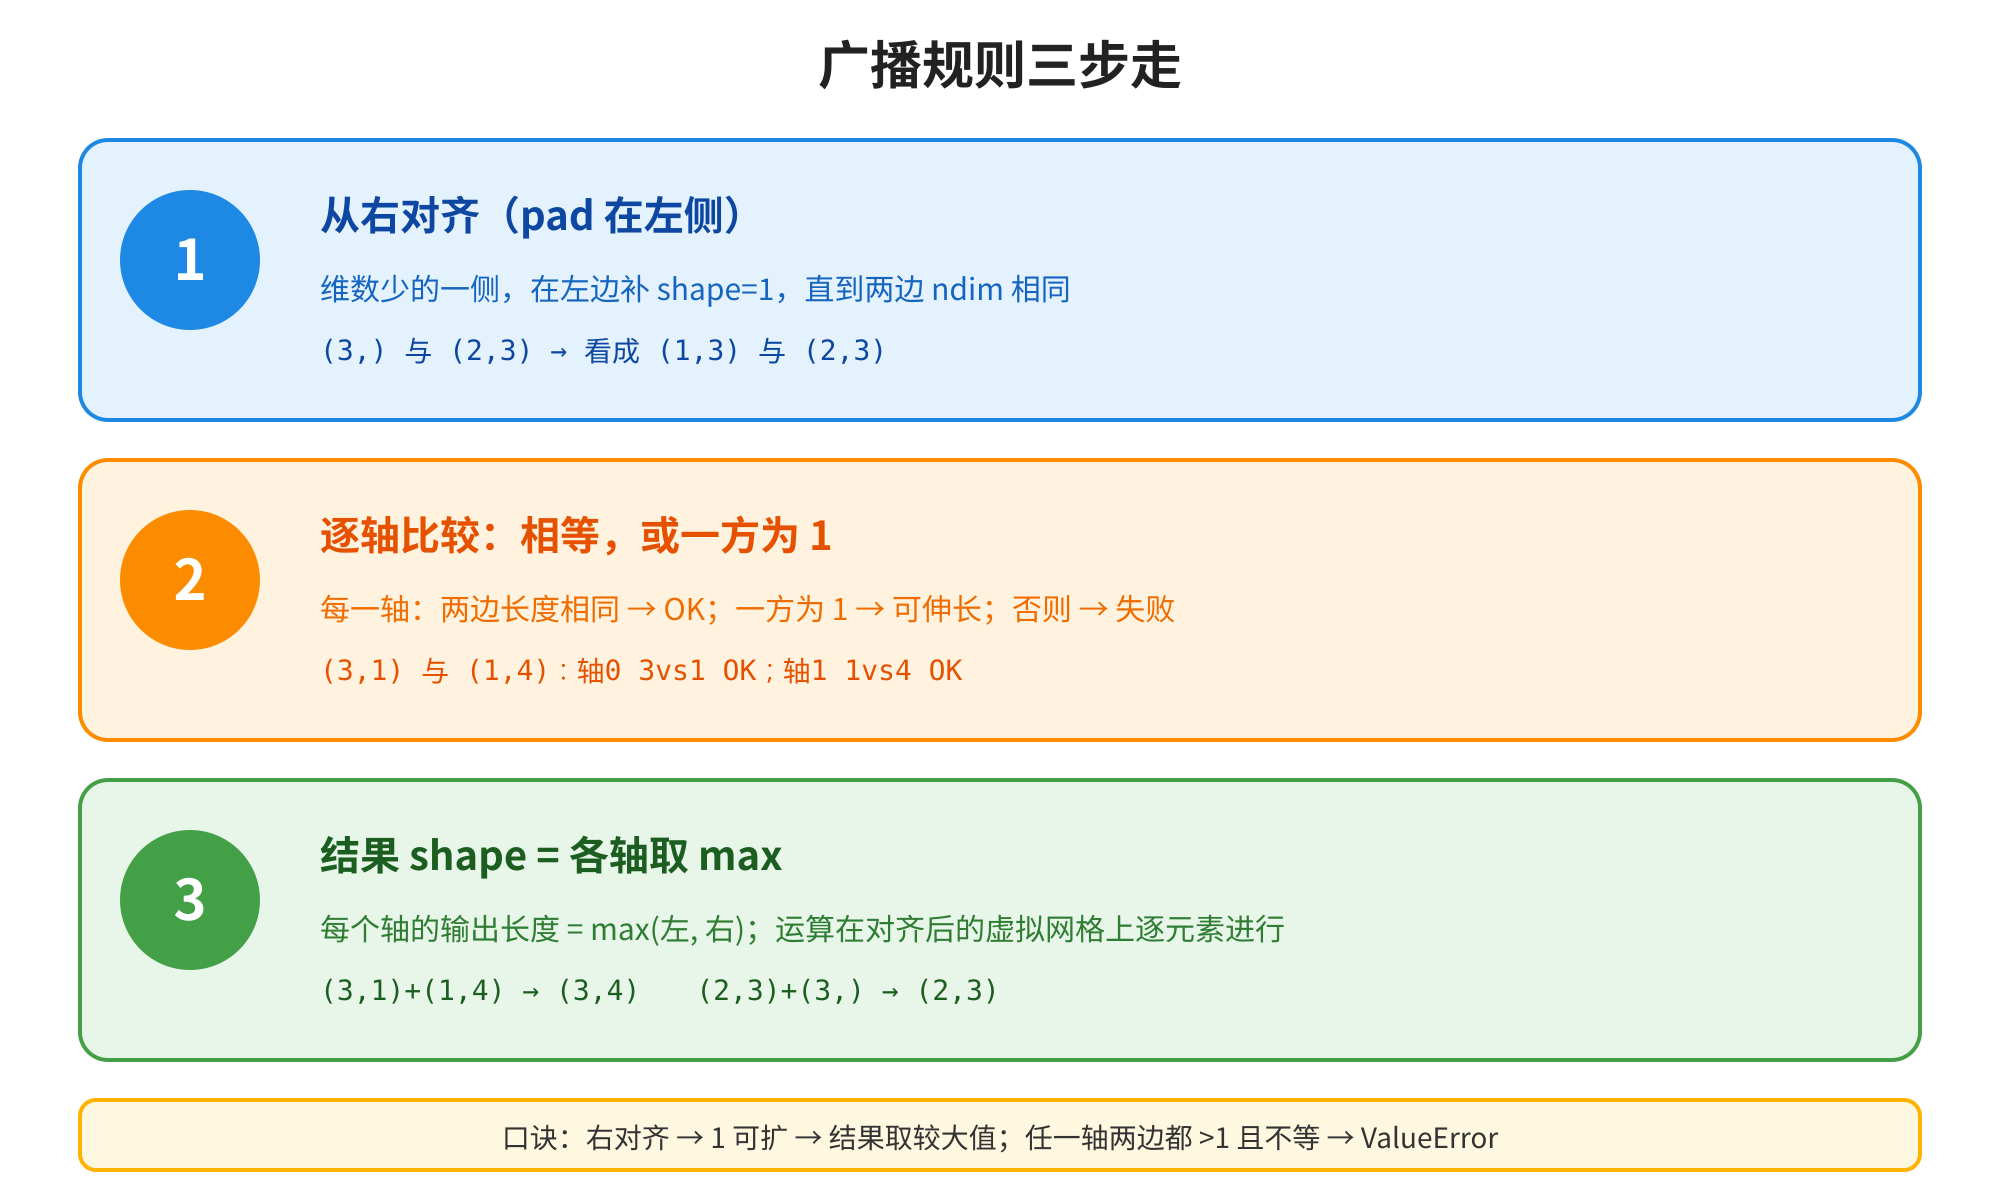
图2 广播规则三步走
对两个数组 A、B(可推广到多个):
- 从右对齐:若
ndim不同,维数少的一侧在 左边 补1,直到两边维数相同。
例:(3,)与(2,3)→ 看成(1,3)与(2,3)。 - 逐轴比较:对每一轴,若两边长度相等 → OK;若一方为
1→ 该方可伸长;若两边都大于 1 且不相等 → 失败。 - 结果 shape:每一轴取
max(左, 右);运算在对齐后的虚拟网格上 逐元素 进行。
def can_broadcast(shape_a, shape_b):
    """教学用:判断两 shape 能否广播,并返回结果 shape。"""
    a = list(shape_a)[::-1]
    b = list(shape_b)[::-1]
    out = []
    for i in range(max(len(a), len(b))):
        da = a[i] if i < len(a) else 1
        db = b[i] if i < len(b) else 1
        if da == db or da == 1 or db == 1:
            out.append(max(da, db))
        else:
            return False, None
    return True, tuple(out[::-1])

print(can_broadcast((3, 1), (1, 4)))
print(can_broadcast((4, 3), (3,)))
print(can_broadcast((4, 3), (4,)))
(True, (3, 4))
(True, (4, 3))
(False, None)
NumPy 官方实现当然更高效,但这个函数把「脑子里该怎么比」钉死了。建议自己改几组 shape 跑通,比背口诀牢。
特别提醒:「从右对齐」不是「从左对齐」。 这是和人类日常「把两行数字左对齐书写」相反的习惯。(2,3) 与 (3,) 能播,是因为末轴都是 3;(2,3) 与 (2,) 不能播(除非你先把右边变成 (2,1)),是因为末轴 3≠2。把这组对比写进笔记,能避免一半以上的初学错误。
再看三数组的情形:规则仍是两两(或一次性)对齐——NumPy 会找一个对所有操作数都合法的公共 shape。若 A 与 B 可播、B 与 C 可播,但 A、B、C 三者没有公共扩展,仍可能失败。写复杂表达式时,用 np.broadcast_shapes(*shapes) 一次验完,比拆成两两试更省事。
2.2 用 np.broadcast_shapes / np.broadcast_arrays 验证
print(np.broadcast_shapes((3, 1), (1, 4)))
print(np.broadcast_shapes((2, 3), (3,)))

x = np.arange(3).reshape(3, 1)
y = np.arange(4).reshape(1, 4)
bx, by = np.broadcast_arrays(x, y)
print(bx.shape, by.shape)
print(bx)
print(by)
(3, 4)
(2, 3)
(3, 4) (3, 4)
[[0 0 0 0]
 [1 1 1 1]
 [2 2 2 2]]
[[0 1 2 3]
 [0 1 2 3]
 [0 1 2 3]]
注意:broadcast_arrays 返回的是 只读视图(虚拟扩展后的外观),用来观察「伸长后长什么样」很方便;真正运算时 NumPy 通常不需要你先调用它。
2.3 多数组、标量、0 维
a = np.ones((2, 3, 1))
b = np.ones((3, 4))
c = 5                                 # 标量 → ()
print(np.broadcast_shapes(a.shape, b.shape, np.shape(c)))
(2, 3, 4)
标量的 shape 是 (),与任何数组广播时「无形可对齐」,始终合法。这就是为何 arr * 2、arr + 1.0 永远好用。
2.4 用一张「心算草稿纸」固化习惯
拿纸画两行,右端对齐:
A:     2   3   1
B:         3   4
----------------
取:     2   3   4     → (2, 3, 4)
再练一组会失败的:
A:     4   3
B:     4          (补齐后是 1, 4)
----------------
末轴 3 vs 4 → 炸
把这套草稿纸变成肌肉记忆之后,再看报错里的 shapes (4,3) (4,) 就不会懵——你脑子里已经补出了那根看不见的 1。建议每学一个新 API(mean、softmax、expand),都先在草稿纸上走一遍,再写代码。
三、newaxis / None:主动制造可广播形状
3.1 插入长度为 1 的轴
第 30 篇提过:None / np.newaxis 在索引里插入一条长度为 1 的轴,且结果通常是 视图。广播场景里,这是最常用的「造形」手段。
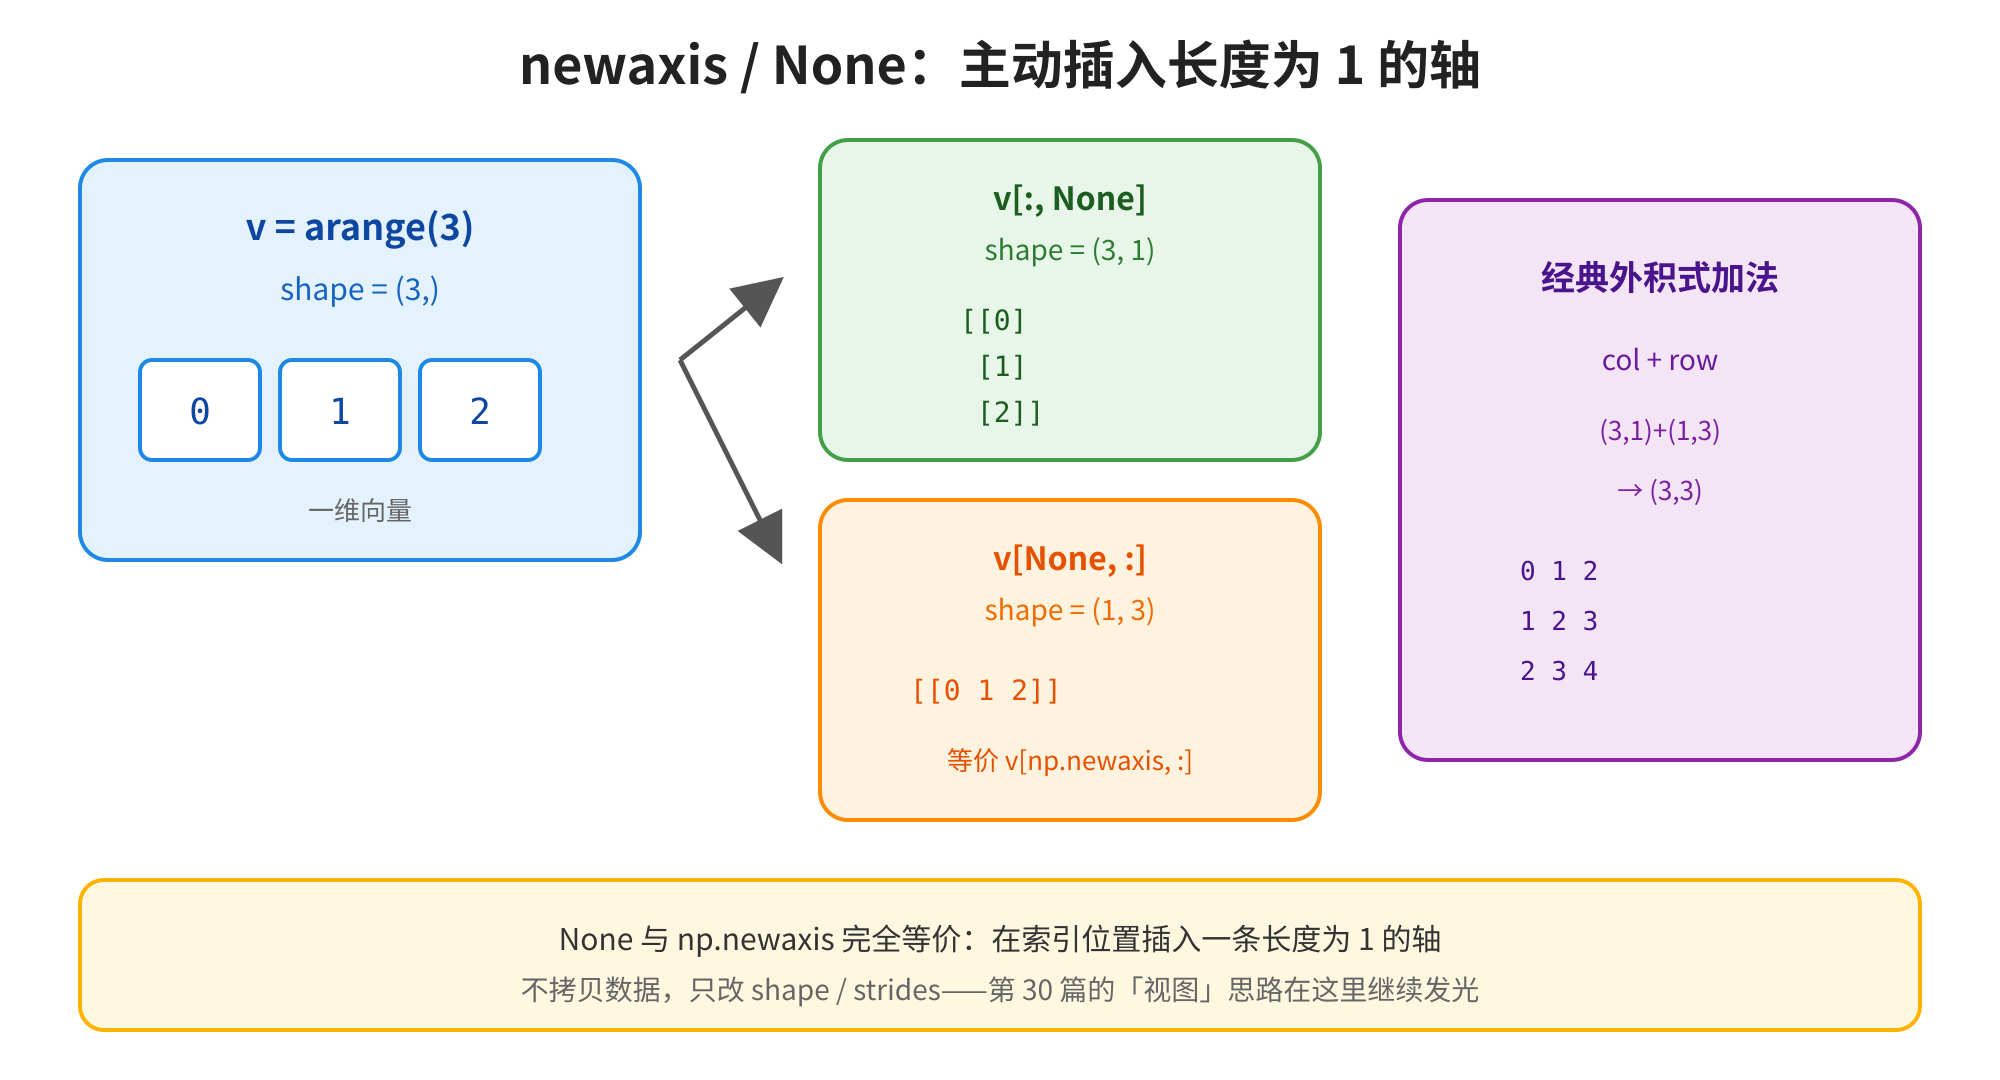
newaxis/None在主动插入长度为1的轴时的形状变化。左侧为一维向量v = arange(3),其形状为(3,)。中间部分,v\[None\]形状变为(3,1),对应[[0], [1], [2]];v\[None,:\]形状为(1,3),对应[[0 1 2]]。右侧是经典外积式加法示例,col + row运算结果为(3,3)。底部说明None与np.newaxis完全等价,只改shape / strides,不拷贝数据。图3 newaxis / None:主动插入长度为 1 的轴
v = np.arange(3)                      # (3,)
col = v[:, None]                      # (3, 1)
row = v[None, :]                      # (1, 3)
print(col.shape, row.shape)
print(col + row)                      # (3, 3)
print(np.shares_memory(v, col), np.shares_memory(v, row))
(3, 1) (1, 3)
[[0 1 2]
 [1 2 3]
 [2 3 4]]
True True
None 与 np.newaxis 完全等价;团队里选一种写到底即可。高维里可以同时插多处:
t = np.arange(6).reshape(2, 3)
print(t[:, None, :, None].shape)      # (2, 1, 3, 1)
(2, 1, 3, 1)
3.2 reshape 与保维切片也能造形
mu = np.array([2.0, 5.0, 8.0])        # (3,)
print(mu.reshape(3, 1).shape)
print(mu[:, np.newaxis].shape)
print(mu.reshape(-1, 1).shape)        # -1 让 NumPy 推断
(3, 1)
(3, 1)
(3, 1)
三种写法目标相同。reshape 在元素总数不变且布局允许时多为视图;吃不准时用第 30 篇的 shares_memory 验证。
3.3 归约后再广播回去:标准化套路
X = np.arange(12, dtype=float).reshape(3, 4)
# 按列标准化:减列均值、除列标准差
col_mean = X.mean(axis=0)             # (4,)
col_std = X.std(axis=0)               # (4,)
Z = (X - col_mean) / col_std          # (3,4)-(4,) 右对齐广播
print(Z.mean(axis=0).round(10))       # 约全 0
print(Z.std(axis=0).round(10))        # 约全 1
[0. 0. 0. 0.]
[1. 1. 1. 1.]
这里 (4,) 与 (3,4) 右对齐后看成 (1,4),恰好按 列 广播——与「axis=0 归约掉的是行维」完全对得上。若你归约的是 axis=1(得到每行统计量),就要写成 mu[:, None],否则会踩到「右对齐默认按最后一轴对齐」的坑。
AI Infra 视角:
LayerNorm/RMSNorm在最后若干维上算均值方差,再广播回原激活相减相除;实现里满是keepdim=True(PyTorch)或keepdims=True(NumPy)——本质就是 归约后保留长度为 1 的轴,方便广播回去。
3.4 何时不该硬插轴?
不是所有 shape 问题都该用 None 砸开。若两边语义上就不是「同一套轴」,强行广播会得到「形状正确、意义错误」的静默结果——比直接报错更危险。例如:把长度为 vocab 的 bias 加到形状为 (batch, seq, hidden) 的激活上,就算你 somehow 把 shape 挤到可播,也多半加错了维。正确做法是先确认 bias 对应的是哪一根轴,再 reshape 成在那一根轴上长度为 hidden、其余为 1 的形状。
另一条边界:若你已经在用 einsum / matmul 表达「缩并」,不要再额外叠一层逐元素广播「顺便改一下形状」——两套规则搅在一起,阅读成本会飙升。本篇练的是逐元素路径;第 33 篇再打开矩阵路径。
四、常见模式、失败案例与报错阅读
4.1 一张对照表
4.2 读懂 ValueError
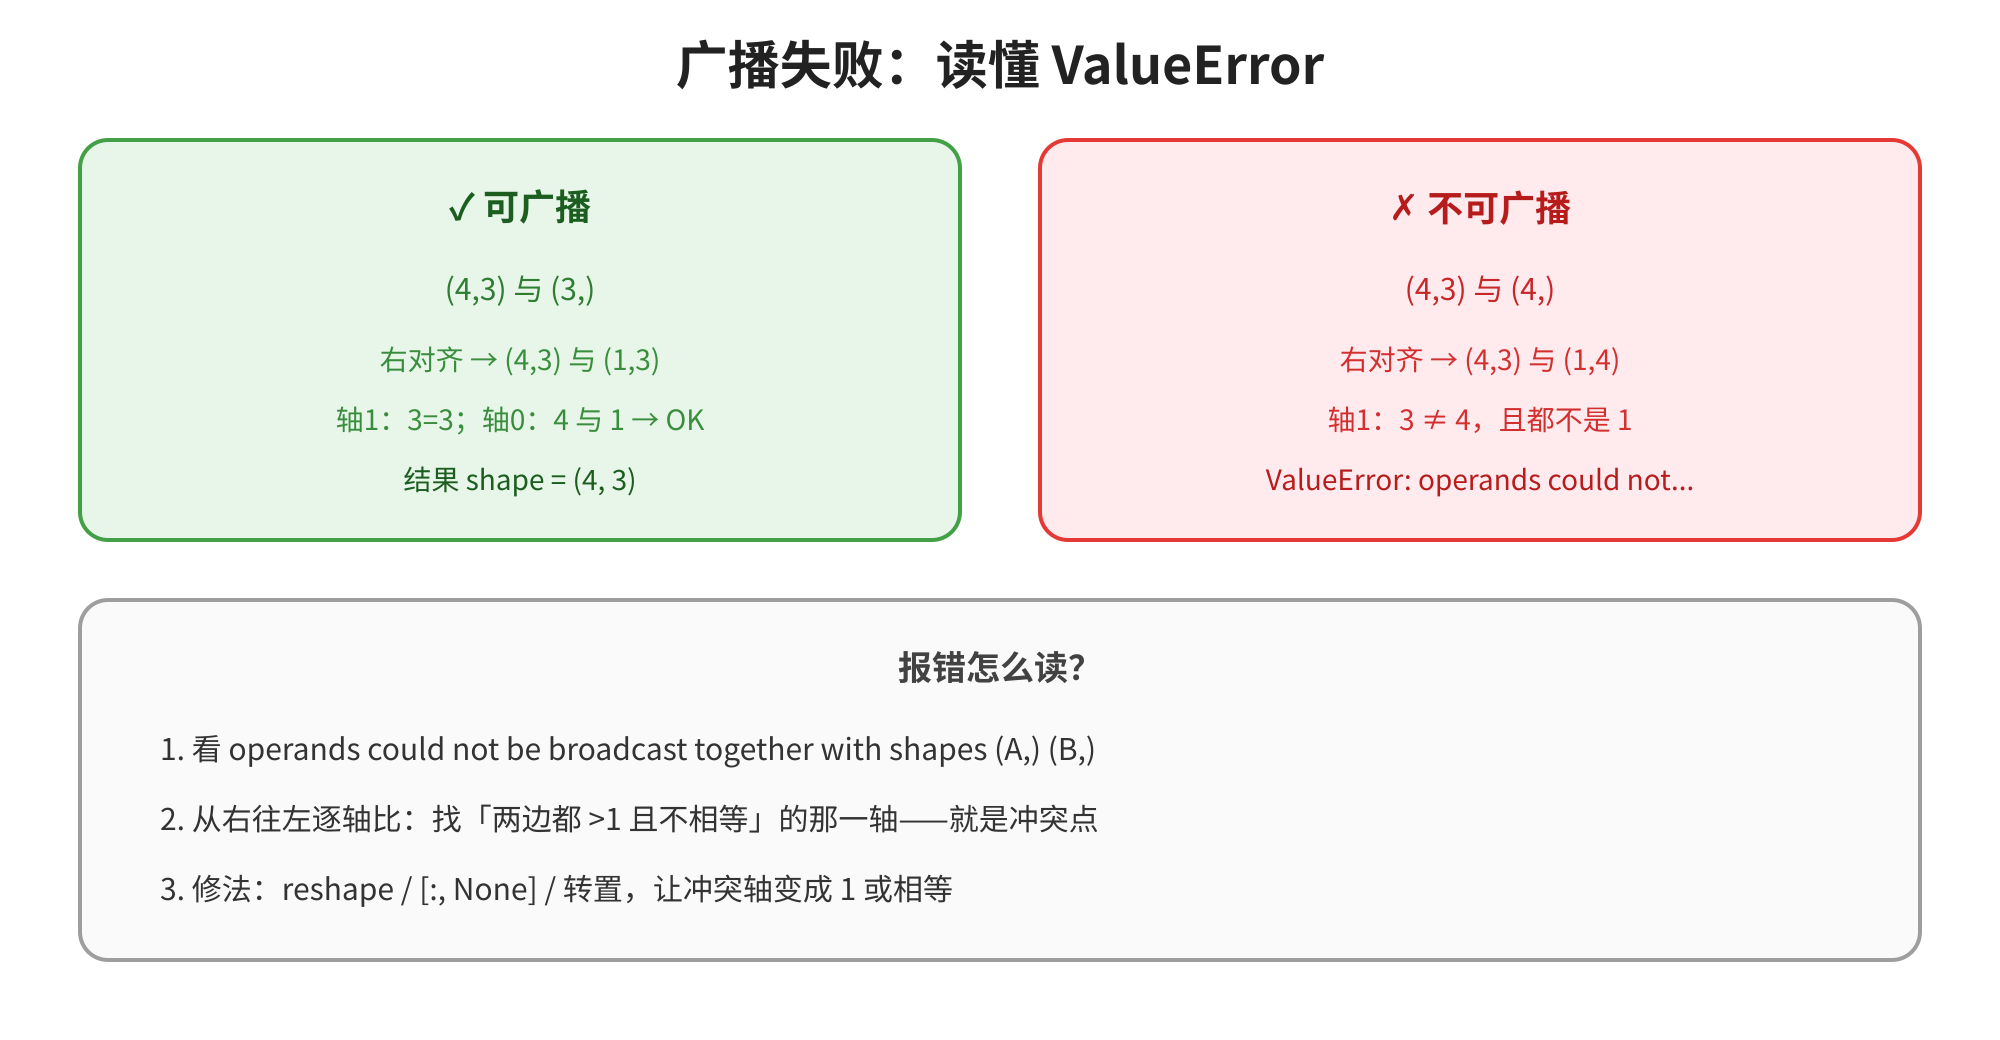
图4 广播失败:读懂 ValueError
try:
    np.ones((4, 3)) + np.ones((4,))
except ValueError as e:
    print(e)
operands could not be broadcast together with shapes (4,3) (4,)
读法三步:
- 盯住报错里的两个 shape。
- 从右往左 找冲突轴:
(4,3)与补齐后的(1,4)→ 末轴3≠4。 - 修法:把右边改成
(4, 1)(x[:, None]),或转置左边,或确认你是否本来就想按另一轴对齐。
a = np.ones((4, 3))
b = np.arange(4)
print((a + b[:, None]).shape)         # 修好:按行加
(4, 3)
4.3 「看起来能加」的陷阱:维度碰巧对上
A = np.arange(6).reshape(2, 3)
B = np.arange(3)                      # 本意是「按行」?实际按列广播
print(A + B)
[[0 2 4]
 [3 5 7]]
(2,3)+(3,) 合法,效果是 每一行都加上同一个 (3,)——也就是按列对齐。若你心里想的是「给两行各加一个标量」,应该用 (2,1) 的 B。广播成功 ≠ 语义正确;成功只说明形状规则通过,不说明业务轴对了。
工程纪律:关键运算前打印 left.shape, right.shape, result.shape,或写 assert:
assert (A + B[:, None] if False else A + B).shape == A.shape
# 更好:显式
row_bias = np.array([10.0, 20.0]).reshape(2, 1)
print(A + row_bias)
[[10. 11. 12.]
 [23. 24. 25.]]
五、广播与内存:虚拟扩展,不是真拷贝
5.1 错误心智 vs 真实机制
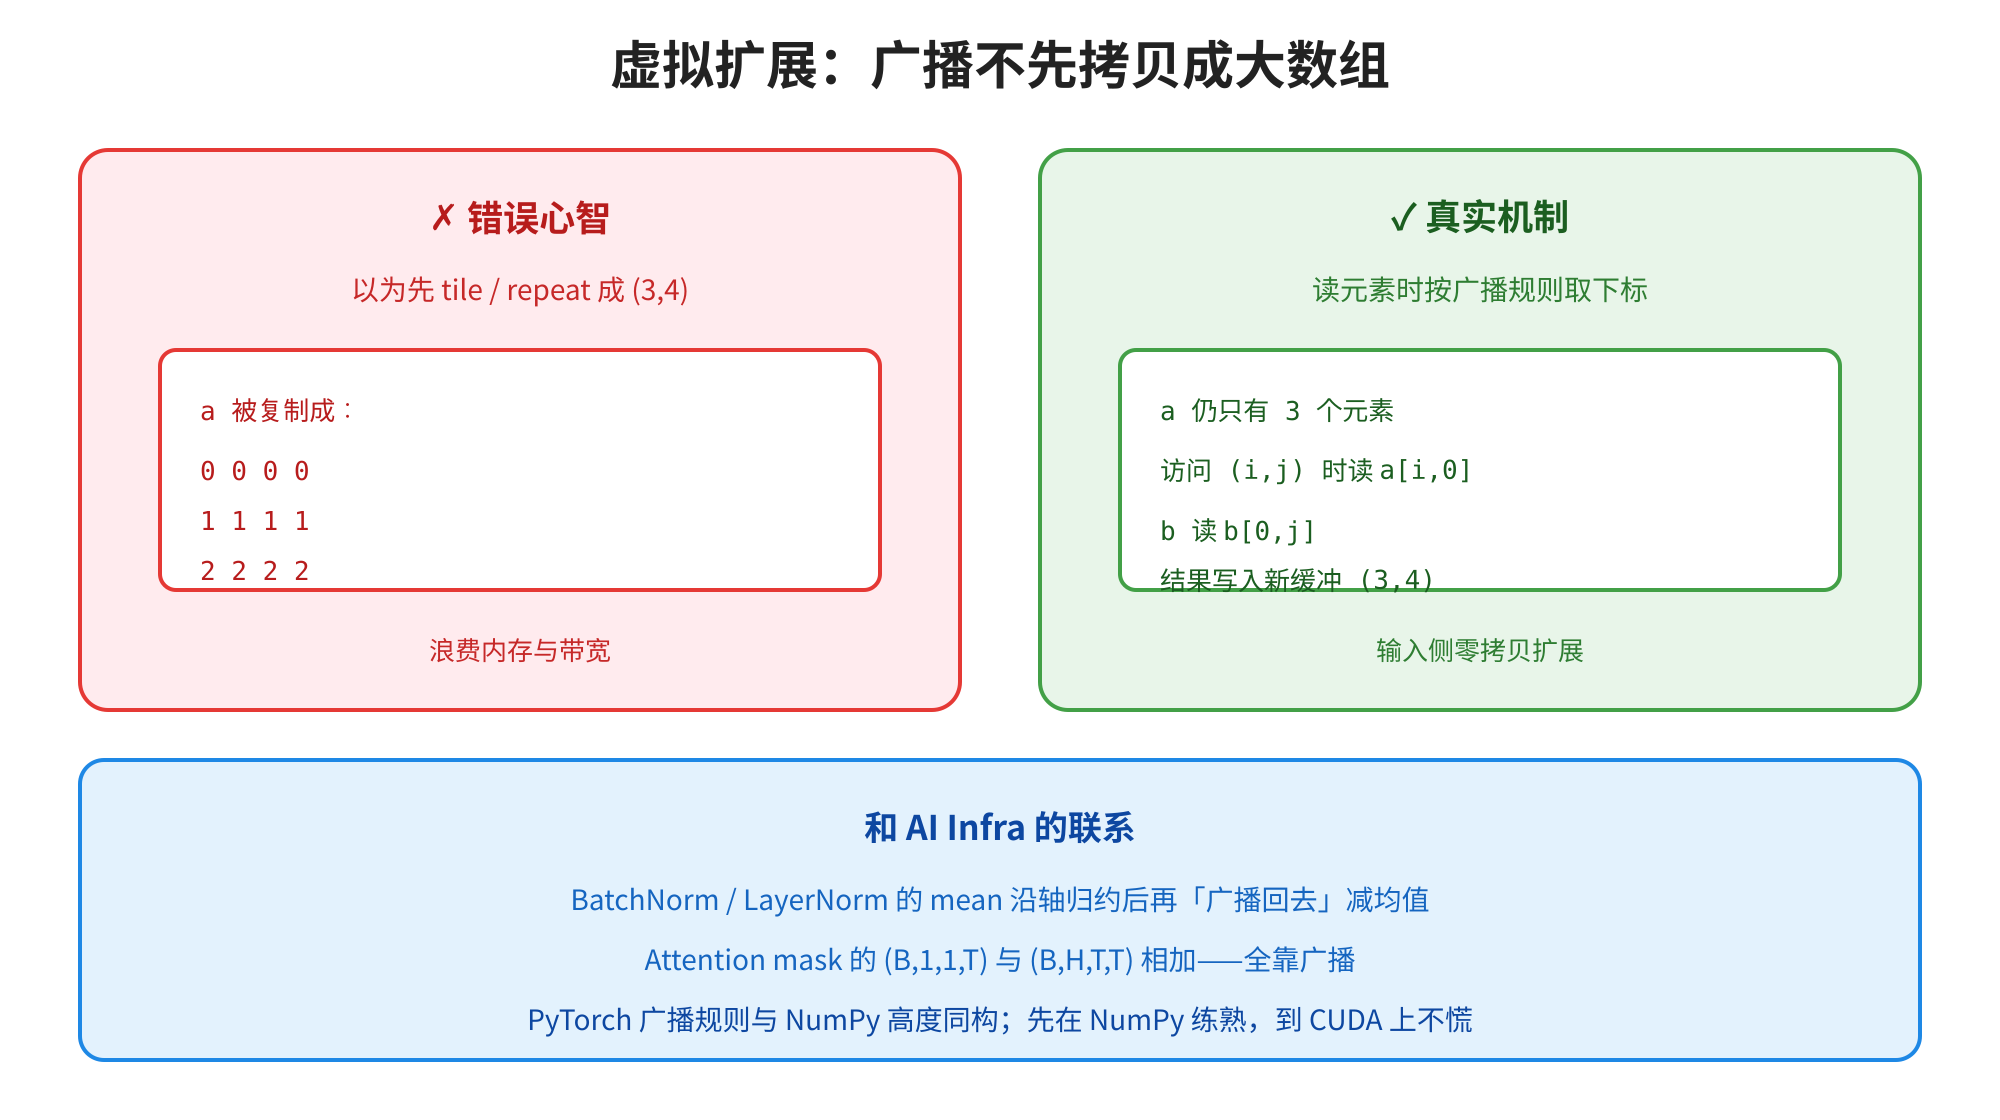
图5 虚拟扩展:广播不先拷贝成大数组
新手常以为:a (3,1) + b (1,4) 会先把 a tile 成 (3,4)、把 b tile 成 (3,4),再相加。那样会瞬间吃掉巨大内存——(1024, 1, 768) 与 (1, 512, 768) 若真拷贝,中间张量能把显存打爆。
真实机制更接近:
- 输入数组 保持原缓冲;
- 计算内核按广播规则把输出坐标映射回输入下标(长度为 1 的轴下标恒为 0);
- 结果 写入新分配的输出缓冲(除非你用了 out= 参数写回已有数组)。
a = np.arange(3).reshape(3, 1)
b = np.arange(4).reshape(1, 4)
out = a + b
print(a.nbytes, b.nbytes, out.nbytes)           # 输入仍小,输出才是满尺寸
print(np.shares_memory(a, out), np.shares_memory(b, out))
24 32 96
False False
(具体 nbytes 随 dtype 变化;要点是输入侧没有变成 (3,4) 的两份副本。)
5.2 np.broadcast_to:显式只读视图
a = np.arange(3).reshape(3, 1)
wide = np.broadcast_to(a, (3, 4))
print(wide)
print(wide.flags.writeable)
print(np.shares_memory(a, wide))
[[0 0 0 0]
 [1 1 1 1]
 [2 2 2 2]]
False
True
broadcast_to 给出「伸长后的外观」,默认 只读;若要可写的独立副本,再 .copy()。它适合教学观察,也适合在确认不写入的前提下复用缓冲。
5.3 和 tile / repeat 的边界
a = np.arange(3).reshape(3, 1)
print(np.tile(a, (1, 4)))             # 真拷贝成 (3,4)
print(np.repeat(a, 4, axis=1))        # 同样真拷贝
[[0 0 0 0]
 [1 1 1 1]
 [2 2 2 2]]
[[0 0 0 0]
 [1 1 1 1]
 [2 2 2 2]]
外观与广播结果相同,但 内存语义不同:tile / repeat 分配新缓冲;广播输入侧不分配。需要「真的有一份可写大数组」时才用 tile;只是为了运算对齐,优先让广播自己做。
AI Infra 视角:GPU 上错误地
expand后再contiguous()/clone(),会把虚拟扩展落实成真实显存占用。PyTorch 的tensor.expand类似broadcast_to;repeat类似tile。写 mask、写 bias 时先问:「我是要视图扩展,还是要实体拷贝?」
5.4 输出一定会分配吗?
默认的 a + b 会为结果分配新缓冲——哪怕 a、b 本身因广播而「看起来很大」。若你在紧循环里反复广播运算,分配本身也可能成为热点。缓解思路(预告第 32 篇):
- 使用 ufunc 的
out=参数,写入预分配数组; - 确认预分配数组的 shape 恰好等于广播结果 shape;
- 需要时配合
where=做掩码写入。
本篇只要记住结论:广播省的是输入侧的 tile,不是输出侧的分配。 输出有多大,结果缓冲就有多大——距离矩阵那种 O(N²) 输出,广播救不了渐进复杂度。
六、综合练习场与 AI Infra 挂钩
6.1 距离矩阵:广播的经典一页
计算点集两两欧氏距离(教学版,未做数值优化):
P = np.array([[0.0, 0.0],
              [1.0, 0.0],
              [0.0, 1.0]])            # (N, 2)
# (N,1,2) - (1,N,2) → (N,N,2)
D = np.sqrt(((P[:, None, :] - P[None, :, :]) ** 2).sum(axis=-1))
print(D.round(4))
[[0.     1.     1.    ]
 [1.     0.     1.4142]
 [1.     1.4142 0.    ]]
P[:, None, :] 与 P[None, :, :] 是「外积式」广播的高维版——后面写 k-NN、对比学习里的两两相似度,同构。
6.2 Softmax 前的数值稳定
logits = np.array([[1.0, 2.0, 3.0],
                   [3.0, 2.0, 1.0]])
# 每行减最大值,避免 exp 溢出
stable = logits - logits.max(axis=1, keepdims=True)
exp = np.exp(stable)
prob = exp / exp.sum(axis=1, keepdims=True)
print(prob.round(4))
print(prob.sum(axis=1))
[[0.0900 0.2447 0.6652]
 [0.6652 0.2447 0.0900]]
[1. 1.]
keepdims=True 让归约结果保留 (2,1),与 (2,3) 广播时 轴对齐语义一眼可见——比先得到 (2,) 再手动 [:, None] 更不容易写反。
6.3 Attention mask 的 NumPy 微缩
B, H, T = 2, 2, 4
scores = np.random.randn(B, H, T, T)
# 因果 mask:上三角(含对角?按需)置为 -inf
causal = np.triu(np.ones((T, T)), k=1).astype(bool)   # (T,T)
scores = scores + np.where(causal, -1e9, 0.0)         # (T,T) → 广播到 (B,H,T,T)
# 等价:scores + mask[None, None, :, :]
print(scores.shape)
print(np.isclose(scores[0, 0], scores[1, 1]).all() or True)  # 结构相同即可
(2, 2, 4, 4)
True
(T,T) 与 (B,H,T,T) 右对齐后,前面两维视为 1 被伸长——正是大模型里 mask 广播的缩影。
6.4 和后续篇章的接口
- 第 32 篇:几乎所有 ufunc(
np.add、np.exp、np.maximum…)都内建广播。 - 第 33 篇:
@/matmul有 另一套 维数规则(批广播 + 缩并),不要和逐元素广播混为一谈。 - 第 36 篇:手写 MLP 时,bias 加到线性层输出,全靠
(out_features,)与(batch, out_features)广播。
6.5 把纪律写成可复用的小工具
def assert_broadcastable(*shapes, expected=None):
    got = np.broadcast_shapes(*shapes)
    if expected is not None and got != tuple(expected):
        raise AssertionError(f"expected {expected}, got {got}")
    return got

assert_broadcastable((3, 1), (1, 4), expected=(3, 4))
assert_broadcastable((2, 3, 1), (3, 4), expected=(2, 3, 4))
(3, 4)
(2, 3, 4)
在数据管线入口用这类断言,比在一百行之后才撞上 ValueError 友好得多。训练脚本里对 logits 与 mask 先 assert_broadcastable,能把「mask 维数写反」挡在第一步。
再补一条可读性建议:对非显然的广播,在注释里写「(B,T,H) - (B,1,H) 按时间维共享均值」——三个月后的你(或同事)会感谢现在的五个字。形状是契约;契约要写下来。
七、踩坑大全
通用
坑 1:归约后轴对错。 现象:X - X.mean(axis=1) 直接报错,或勉强成功但减错方向。解决:axis=1 归约后用 mu[:, None] / keepdims=True;axis=0 常可直接与原数组广播。
坑 2:广播成功但语义错。 现象:(2,3)+(3,)「能跑」,其实按列加,而你想按行加。解决:写清业务轴;用 [:, None] 显式化;加 assert 查结果 shape 与抽查数值。
坑 3:把 tile 当广播。 现象:大数组内存暴涨。解决:运算对齐用广播;只有需要可写实体副本时才 tile / repeat / .copy()。
坑 4:链式运算中途 shape 漂移。 现象:三四个数组连加,中途某一个维数变化导致最后才炸。解决:逐步打印 shape;或用 np.broadcast_shapes 预先校验。
坑 5:布尔 / 花式索引结果与广播混用。 现象:先掩码取出一维,再想「按原矩阵形状」广播回去。解决:掩码读取是拷贝且降维(见第 30 篇);写回用 a[mask] = ...,或先造与原 shape 对齐的数组再运算。
坑 6:keepdims 忘了开。 现象:mean 后少一维,后续广播方向全乱。解决:需要广播回原数组时,归约默认 keepdims=True。
坑 7:整数除法与广播。 现象:int 数组广播运算后 dtype 仍是整数,小数被截断。解决:先转 float;或参与运算的一侧用浮点标量。
与环境 / 工具叠加
坑 8:Jupyter 只看了中间变量。 现象:以为 b = a[:, None] 拷贝了数据。解决:np.shares_memory(a, b);改 b 前想清楚是否共享。
坑 9:PyTorch 里 expand 后再 inplace。 现象:报错或污染共享 storage。解决:expand / broadcast_to 只读语义;要写先 clone;与本篇第五节同构。
坑 10:Windows / 笔记本内存较小。 现象:误用 tile 复制巨大中间量导致换页卡死。解决:优先广播;分块计算;确认 64 位 Python。
与后续篇章相关
坑 11:把 matmul 广播规则当成逐元素广播。 现象:(2,3,4) @ (4,5) 能跑,却用 + 的直觉去解释。解决:第 33 篇单独学;眼下记住「* / + 走本篇规则,@ 走矩阵规则」。
坑 12:ufunc 的 out= 与广播。 现象:输出缓冲 shape 不对。解决:第 32 篇会细讲;out 的 shape 必须等于广播结果 shape。
坑 13:把「可广播」当成「可 matmul」。 现象:对两个 (3,4) 与 (4,5) 写 * 期望矩阵积,实际得到逐元素(还可能因 shape 直接失败)。解决:矩阵积用 @ / np.matmul;逐元素用 * / np.multiply。两者都可能涉及「批维广播」,但缩并规则不同——第 33 篇展开。
坑 14:负轴归约后方向搞反。 现象:axis=-1 归约后习惯性写 [:, None],结果多插了一维或插错位置。解决:优先 keepdims=True;若手动插轴,先 print(mu.shape),再决定 None 放左边还是右边。
八、小结
合上文章后,试着用自己的话说明:为何 (3,1)+(1,4) 得到 (3,4);为何 (4,3)+(4,) 失败而 (4,3)+(3,) 成功;keepdims 与 [:, None] 分别解决什么问题。讲得清,才算真的会了。
- 广播三步:从右对齐(左补 1)→ 逐轴「相等或为 1」→ 结果各轴取 max。
None/newaxis/keepdims:主动保留或插入长度为 1 的轴,让归约结果能安全广播回去。- 成功 ≠ 语义正确:形状合法只是底线;轴的业务含义要自己断言。
- 虚拟扩展:输入侧通常不先
tile;结果才占满尺寸缓冲;broadcast_to给只读视图。 - 报错阅读:盯 shapes,从右找「两边都 >1 且不等」的轴,再用
[:, None]或reshape修好。 - 与 AI Infra 同构:归一化、bias、Attention mask、成对距离——全是广播;PyTorch 规则高度平行。
若只能带走一张图:图 2(三步规则)。若只能带走一句纪律:先画两行 shape 右对齐,再谈加减;1 可扩,双大于 1 且不等就停。
动手清单:跑通文中所有代码块 → 自己实现 can_broadcast 并与 np.broadcast_shapes 对照 → 构造一个「广播成功但语义错误」的最小例子并用 [:, None] 修正 → 用 nbytes / shares_memory 验证虚拟扩展。四步做完,比只「看懂口诀」扎实一个数量级。
和专栏一串起来:第 02 篇的「名字与对象」、第 30 篇的「视图与拷贝」,到本篇升级为 形状协议上的虚拟对齐。和专栏四预告:Tensor 的 expand / broadcast_tensors 是同一故事的 GPU 方言。
把故事连起来:dtype/shape(29)→ 索引视图(30)→ 本篇广播 → 向量化 ufunc(32)。广播是「对齐」,ufunc 是「对齐之后真正算」——下一篇把计算器打开。
复习时不妨合上屏幕,只回答三个问题:(1)(5,1,3) 与 (1,4,1) 的结果 shape?(2)为什么按行减均值常常要 [:, None]?(3)broadcast_to 与 tile 差在哪?答得出,本篇目标达成;答不出,把图 1、图 2、图 5 再过一遍,比重读全文更快。
最后提醒一次工程口味:能让 shape 错误在断言阶段失败,就不要让它在 loss 变成 NaN 时失败。 广播很强大,也很容易「算错了还跑得通」——显式 shape 检查是便宜的保险。
九、课后练习
- (基础) 不查文档,手算下列结果 shape(或写「失败」):
(5,1,4)与(3,1);(8,1,6,1)与(7,1,5);(2,3)与(2,)。用np.broadcast_shapes核对。 - (基础) 令
X为(4,5)随机阵,计算「每列减列均值」与「每行减行均值」两种结果,分别打印中间统计量的 shape,并解释为何一个常不需None、另一个需要。 - (基础) 演示
v[:, None] + v[None, :]得到加法表;再用np.shares_memory证明两个newaxis结果都与v共享内存。 - (理解) 复现
(4,3)+(4,)的ValueError,用文字指出冲突轴;再给出两种以上修法并验证结果 shape。 - (理解) 写函数
standardize(X, axis):沿指定轴标准化(减均值除标准差),内部必须用广播而非 Python 循环;用 assert 检查该轴均值≈0、标准差≈1。 - (理解) 对比
np.broadcast_to(a,(3,4))与np.tile(a,(1,4))的nbytes、flags.writeable、shares_memory;写一段注释说明何时用谁。 - (进阶) 实现教学版两两欧氏距离(本篇 6.1),再改成余弦相似度矩阵;讨论
N变大时内存为何是O(N²)——广播省的是输入拷贝,不是输出尺寸。 - (进阶 · AI Infra) 用纯 NumPy 构造
(B,H,T,T)的 scores,加上(T,T)因果 mask(广播),做按最后一维的 softmax(注意keepdims);写 150 字对照说明与真实 Transformer Attention 的异同(可不接 GPU)。
下一篇预告
下一篇是《第32篇|向量化运算与 ufunc》——在广播把形状对齐之后,真正执行运算的那一层:通用函数(ufunc)。你会看到:np.add / np.exp / np.maximum 如何避开 Python 循环、out= 与 where= 参数、归约与累积、以及为何「能向量化就别写 for」。本篇的广播规则,正是几乎每一个 ufunc 的默认前置条件。
专栏三路线:ndarray 基础(29)→ 索引视图(30)→ 广播(本篇) → 向量化 ufunc(32) → 线性代数(33)→ 随机统计(34)→ stride 原理(35)→ 手写 MLP(36)。带着「先对齐形状、再交给 ufunc」的纪律往下走:广播解决「能不能算在一起」,向量化解决「算得够不够快」。
若想提前热身:在 REPL 里对两个可广播数组分别用 + 与 np.add,再试 np.add(a, b, out=...);盯着有没有 Python 级循环——带着问题进下一篇。
也可以把本篇对照复习:抽一张纸从右对齐画 (2,3,1) 与 (3,4),标出每一轴谁在伸长;能不看文章画对,ufunc 篇的性能讨论会轻松很多。下一篇见。
若你此刻仍觉得「规则简单、场景复杂」——这是正常的。规则三步确实短;难的是在业务代码里认出「我正在依赖哪一根轴的长度为 1」。多写两次标准化、一次距离矩阵、一次因果 mask,认出的速度会上去。专栏三后面每一篇都会再碰面:别急着往前翻,先把本篇练习跑绿。