
第35篇|stride、reshape、transpose 的底层原理
本篇定位:专栏三「NumPy 数值计算」第七篇。承接第 34 篇的随机数、统计与归约,把
shape和axis继续向下追问:数组元素在内存里到底怎样排布?读完你将能够:读懂
ndarray.strides、itemsize和 C/F contiguous;判断reshape、transpose、swapaxes返回的是 view 还是 copy;用np.shares_memory、flags和np.ascontiguousarray写出可靠的布局检查;把 batch、token、hidden 的布局选择连接到 GEMM、NHWC/NCHW 和 AI Infra kernel。预计用时:阅读 50~70 分钟,动手 60~90 分钟。
第 34 篇中,我们用 axis 描述“沿哪一维做归约”。例如,对形状为 (B, T, H) 的激活沿 axis=2 求均值,就是把每个 token 的 H 个特征汇总起来。但 axis 只是逻辑视角;底层计算还必须回答一个问题:相邻的两个元素,地址相差多少字节?
这正是 stride(步长)的工作。一个 NumPy 数组不只是“数据 + shape”,还带着数据起始地址、每个轴的字节步长、dtype 和读写属性。reshape 有时只改这份元数据,transpose 通常只交换 shape 与 strides,而连续性则决定一个 C 扩展或 GPU kernel 能不能用最简单、最快的地址公式访问数据。本文先建立内存模型,再把这些操作放到 AI Infra 的布局转换中。
一、数组不是表格:用 strides 计算地址
1.1 shape 之外的三件事
设一个二维数组 x 的 shape 是 (行数, 列数)。我们平时写 x[i, j],NumPy 实际需要把逻辑坐标换算成内存地址。这个数组至少可以抽象成四部分:
- data pointer:第一个元素所在的起始地址;
- shape:每个轴有多少个元素;
- strides:沿每个轴前进一个位置,需要跳过多少字节;
- dtype / itemsize:每个元素占多少字节,以及如何解释这些字节。
对任意维数组,地址公式可以写成:
address(i0, i1, ...) = data_pointer + i0*strides[0] + i1*strides[1] + ...
strides 的单位是字节,不是元素个数。下面用 int32 的二维数组观察它:
import numpy as np

x = np.arange(12, dtype=np.int32).reshape(3, 4)
print(x)
print("shape:", x.shape)
print("dtype:", x.dtype, "itemsize:", x.itemsize)
print("strides:", x.strides)
print("C contiguous:", x.flags.c_contiguous)
[[ 0  1  2  3]
 [ 4  5  6  7]
 [ 8  9 10 11]]
shape: (3, 4)
dtype: int32 itemsize: 4
strides: (16, 4)
C contiguous: True
沿最后一个轴移动一格,地址增加 4 字节;沿第一个轴移动一格,要跳过一整行 4 * 4 = 16 字节。因此 x[1, 2] 的地址偏移是 1 * 16 + 2 * 4 = 24 字节。数组的“行”和“列”不是内存中自带的概念,而是 shape 与 strides 共同提供的解释方式。
1.2 从元素 stride 到字节 stride
如果 x 是 float64,每个元素占 8 字节;同样的 (3, 4) C-order 数组会拥有 (32, 8) 的 strides。可以把 stride 除以 itemsize,得到“沿这个轴前进多少个元素”的直觉:
import numpy as np

for dtype in (np.int32, np.float64):
    x = np.zeros((2, 3, 4), dtype=dtype)
    element_strides = tuple(s // x.itemsize for s in x.strides)
    print(dtype.__name__, x.itemsize, x.strides, element_strides)
int32 4 (48, 16, 4) (12, 4, 1)
float64 8 (96, 32, 8) (12, 4, 1)
元素 stride 由 shape 和布局决定,字节 stride 还要乘以 dtype 的大小。这个区别很重要:把一个 float32 指针误当成 float16,或者在 C/CUDA 扩展里忘记按字节换算,都会把正确的坐标送到错误的地址。
1.3 切片如何制造“带空洞”的 view
切片通常只修改起始偏移、shape 和 strides,不会搬运数据。x[::2] 每隔一个元素取一个,因此新的 stride 变成原来的两倍;x[:, ::2] 则让列方向出现空洞:
import numpy as np

x = np.arange(20, dtype=np.int64).reshape(4, 5)
y = x[::2, 1::2]
print(y)
print("shape:", y.shape, "strides:", y.strides)
print("shares:", np.shares_memory(x, y))
y[0, 0] = 999
print("x[0, 1] =", x[0, 1])
[[ 1  3]
 [11 13]]
shape: (2, 2) strides: (80, 16)
shares: True
x[0, 1] = 999
这里 y 的第二个元素不是紧邻的下一个 int64,而是隔了一个元素;第一轴更要跨过两行。它仍然是合法的 view,但不能假定“数组中的所有元素都连续相邻”。负 stride 也同理,x[::-1] 可以从后往前读。
1.4 view 的共享关系与生命周期
数组 view 还带来一个生命周期问题:小切片可能让一整个大数组继续存活。比如一个几百 MB 的输入 buffer 只取出一个长度为 10 的 header view,只要这个 view 仍被引用,底层大 buffer 就不能被垃圾回收。对长时间运行的数据服务,这会表现为内存缓慢上涨,而不是一次明显的泄漏。
import numpy as np

big = np.arange(1_000_000, dtype=np.int64)
small_view = big[:3]
small_copy = big[:3].copy()
print(np.shares_memory(big, small_view))
print(np.shares_memory(big, small_copy))
print(small_view.base is None, small_copy.base is None)
True
False
False True
base 不是完整的共享判断工具,但它能帮助理解所有权:view 通常把某个拥有 buffer 的对象保存在引用链上,copy 则拥有自己的存储。在缓存、队列或异步任务中,如果只需要很小的结果而不需要共享更新,可以及时 .copy(),用一次可控的复制换取大 buffer 的释放。反过来,如果要频繁切片并且生命周期短,保留 view 往往更节省带宽。
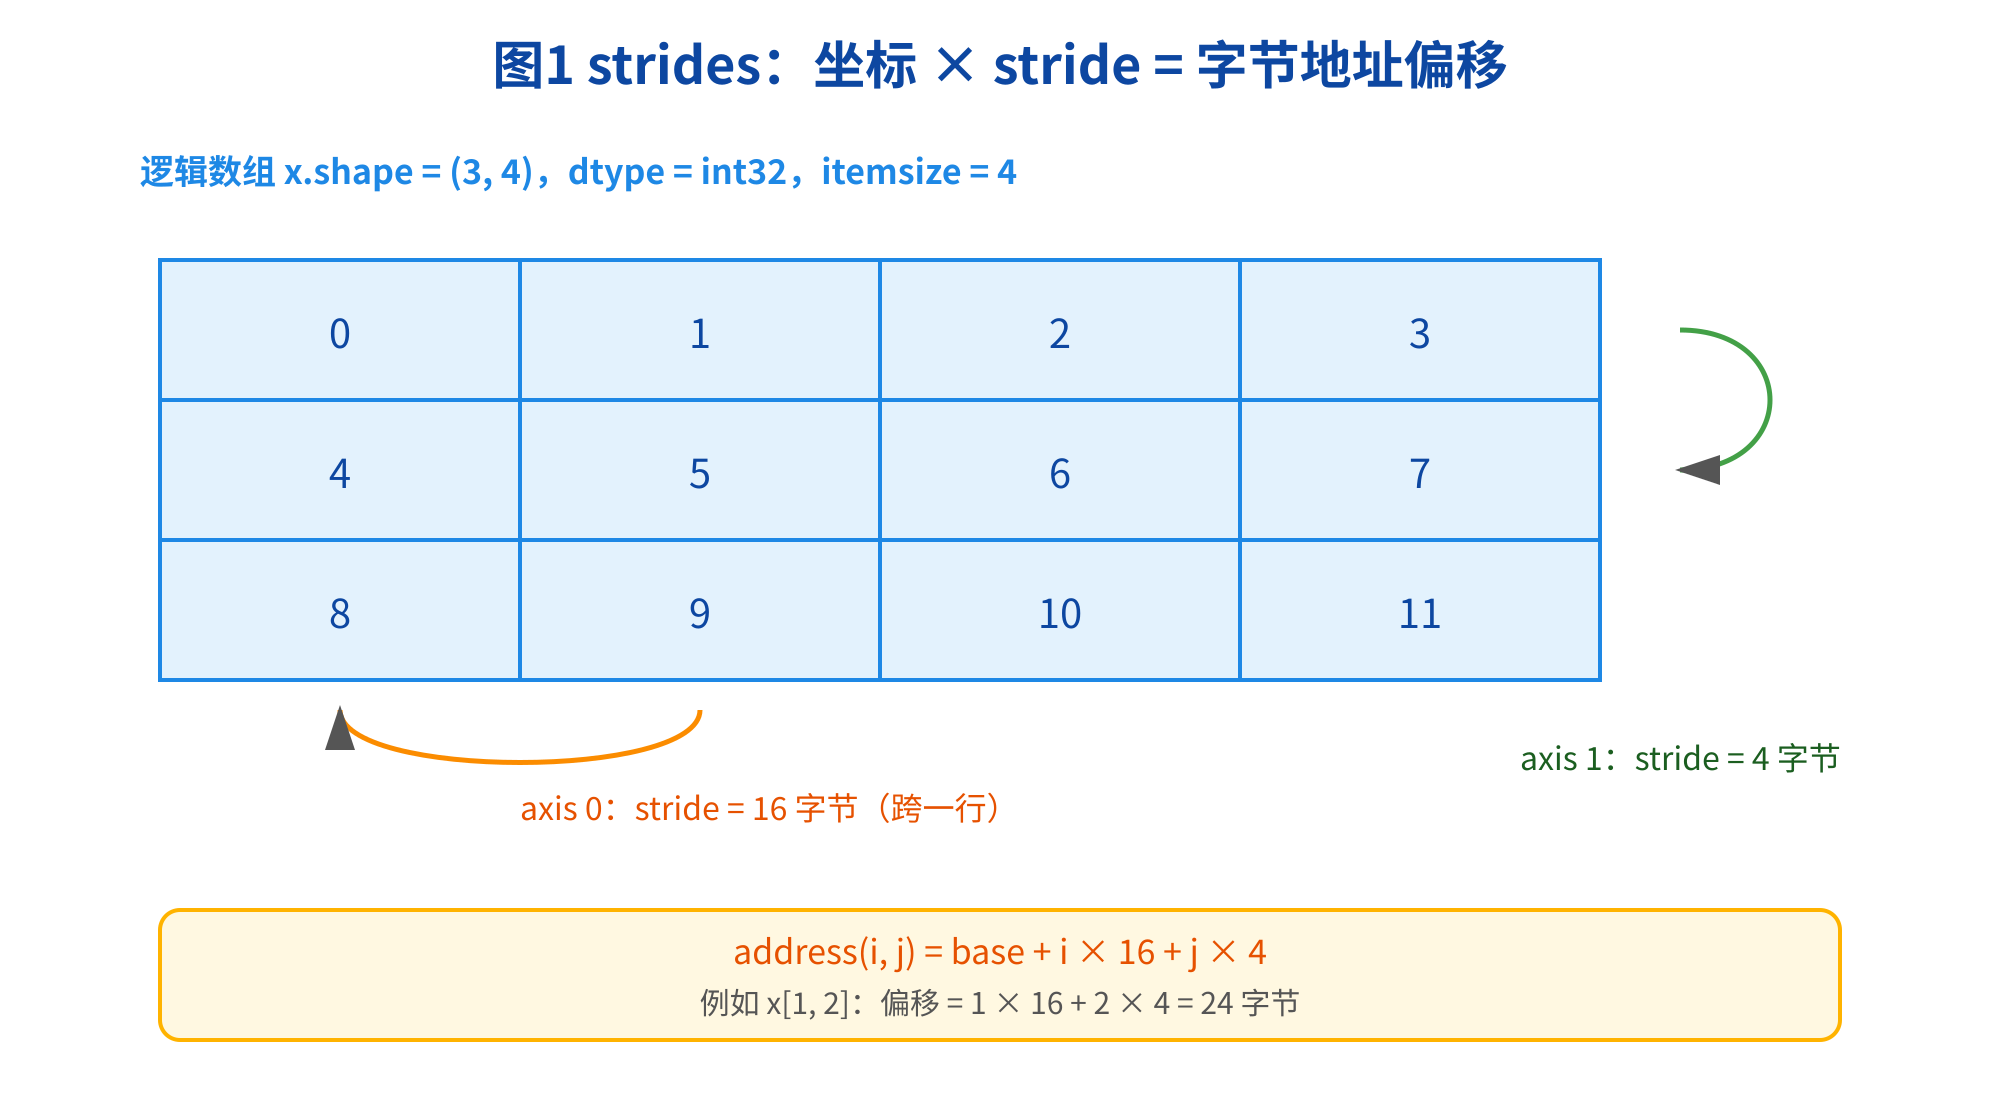
图1 strides:逻辑坐标通过各轴步长映射到字节地址
AI Infra 视角:在 Python 层,
x[i, j]看起来是抽象索引;在 NumPy C 循环或 CUDA kernel 中,它最终都要变成地址计算。stride 是把高层 shape 传给底层 kernel 的内存契约。理解它,才能看懂为什么同一个算子在不同 layout 上速度不同。
二、连续性:C-order、F-order 与 flags
2.1 C contiguous 的含义
C-order(行主序)把最后一个轴设计为最内层:二维数组按行连续,三维数组按最后一个维度连续。对 C contiguous 的数组,连续内存中的元素顺序等价于 C 风格的多重循环:
import numpy as np

x = np.zeros((2, 3, 4))
shape = x.shape

def visit(value):
    return value

for i0 in range(shape[0]):
    for i1 in range(shape[1]):
        for i2 in range(shape[2]):
            visit(x[i0, i1, i2])
对 shape=(2, 3, 4),元素 stride 是 (12, 4, 1)。一般地,C-order 的最后一项元素 stride 是 1,前一项等于后续 shape 的乘积。只要 shape 允许,这种排布很适合把整个数组当作一段连续 buffer 交给 C API。
import numpy as np

x = np.arange(24).reshape(2, 3, 4)
print(x.strides)
print(x.flags.c_contiguous, x.flags.f_contiguous)
print(x.ravel(order="C"))
(96, 32, 8)
True False
[ 0  1  2  3  4  5  6  7  8  9 10 11 12 13 14 15 16 17 18 19 20 21 22 23]
一维数组和长度为 1 的特殊维度可能同时被标记为 C contiguous 与 F contiguous。不要只根据一个布尔值猜顺序,必要时还要结合 shape、strides 和实际操作。
2.2 F contiguous 是列主序
F-order(Fortran order)把第一个轴作为最内层:二维数组按列连续。NumPy 可以明确创建这种布局:
import numpy as np

c = np.arange(12).reshape(3, 4)
f = np.asfortranarray(c)
for name, x in (("c", c), ("f", f)):
    print(name, "strides=", x.strides,
          "C=", x.flags.c_contiguous, "F=", x.flags.f_contiguous)
print("same values:", np.array_equal(c, f))
c strides= (32, 8) C= True F= False
f strides= (8, 24) C= False F= True
same values: True
两者的值完全一样,只有解释同一块逻辑矩阵的方式不同。对列方向的循环,F-order 可以让访问更连续;对行方向的循环,C-order 往往更自然。实际性能还会受到 cache、SIMD、线程和算子实现影响,所以 contiguous 是重要前提,不是唯一的性能结论。
2.3 contiguous 不等于“永远快”
连续数组通常更容易交给底层库,也更容易被向量化。但一个小数组的 copy 成本可能比一次运算还大;一个带 stride 的 view 也可能恰好适合某个按列处理的 kernel。工程判断应包含三个问题:这里的“连续”还要和数据生命周期一起看:短暂的小数组可以直接复制,长寿命的大激活则应尽量统一布局,避免在多个层之间来回转换。
- 这个算子是否要求某一种连续性,还是能接受任意 stride?
- 为了连续化要复制多少数据、复制几次?
- 后续会复用连续副本多少次,能否摊平 copy 成本?
不要把 np.ascontiguousarray 放在每一个函数入口而不检查上下文。它是清晰的边界工具,但滥用会把一个本来是 view 的数据管道变成隐形的内存带宽消耗。
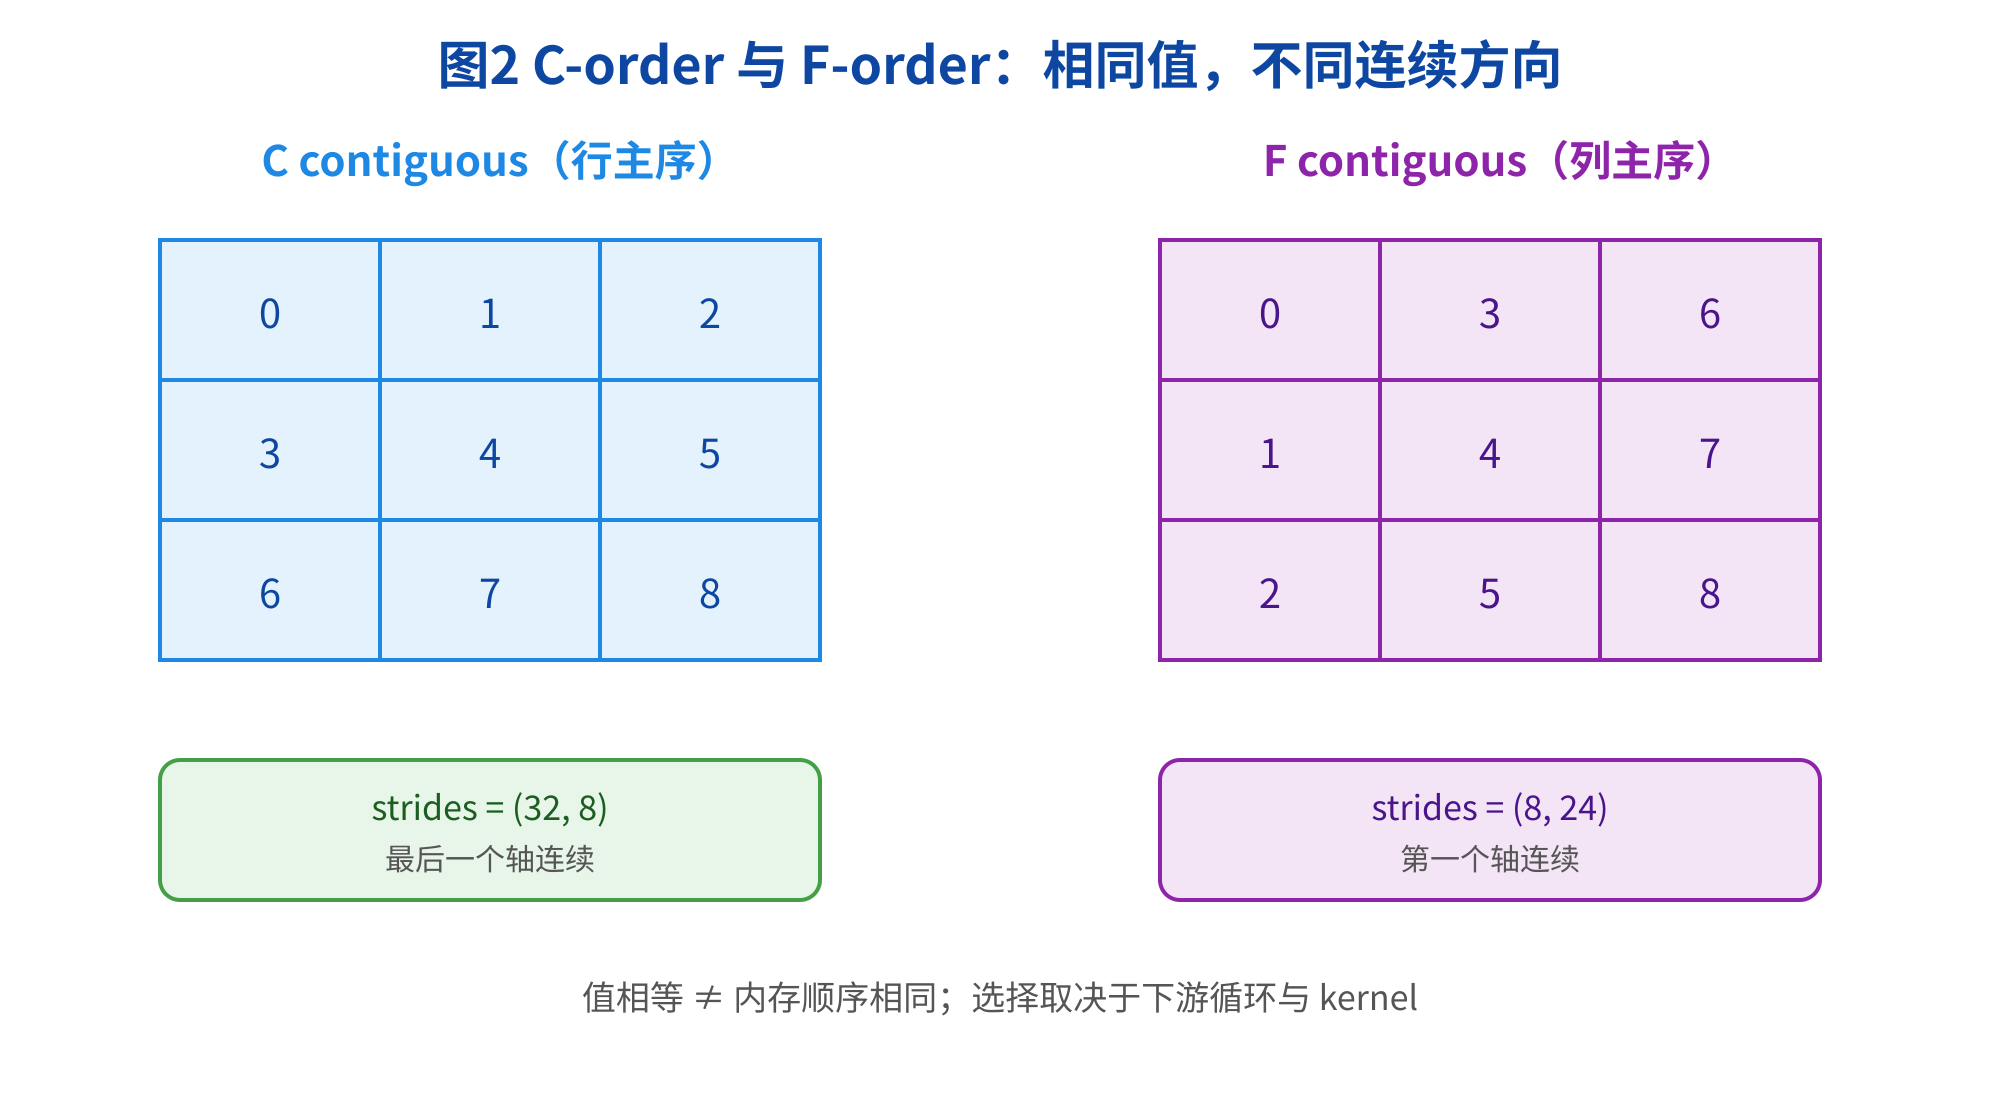
np.ascontiguousarray会增加内存带宽消耗。图2 C-order 与 F-order:同样的值,不同的连续方向
三、reshape:改形状,还是复制数据?
3.1 reshape 的理想情况是只改元数据
如果原数组连续,且新旧 shape 的元素总数相同、顺序兼容,reshape 可以返回共享底层存储的 view。例如 (2, 6) 变成 (3, 4) 时,不需要搬动 12 个元素,只需重新解释同一段连续内存:
import numpy as np

x = np.arange(12)
y = x.reshape(3, 4)
print("x:", x.shape, x.strides)
print("y:", y.shape, y.strides)
print("shares:", np.shares_memory(x, y))
y[0, 0] = 100
print("x[0] =", x[0])
x: (12,) (8,)
y: (3, 4) (32, 8)
shares: True
x[0] = 100
这解释了为什么 reshape 经常很快:它只创建一个新的数组对象,并更新 shape/strides。可是“经常是 view”不等于“保证是 view”。当原数组有切片空洞、转置后的非连续布局,或者 order 约束不匹配时,NumPy 可能先复制,再按目标 shape 返回。
3.2 用 shares_memory 验证,不要凭函数名猜
reshape 的返回对象可能是 view,也可能拥有新 buffer。应使用 np.shares_memory 或 np.may_share_memory 检查;不要只看 y.base is x,因为 view 可能通过中间对象间接持有底层数组:
import numpy as np

x = np.arange(12).reshape(3, 4)
view = x.reshape(2, 6)
copy = x.T.reshape(2, 6)
print("view shares:", np.shares_memory(x, view))
print("copy shares:", np.shares_memory(x, copy))
print("copy C:", copy.flags.c_contiguous)
view shares: True
copy shares: False
copy C: True
这里 x.T 把 strides 变成了列主序方向,继续要求 C-order 的 (2, 6) 时,元素顺序不能用简单的 strides 表达,NumPy 因而常常创建副本。具体是否复制取决于 shape、order 和版本实现;可观察的契约是结果值正确,view/copy 要用检查或显式 API 确认。
3.3 order 不是“原数组是什么就是什么”
reshape(..., order="C") 按 C 索引顺序解释,order="F" 按 Fortran 索引顺序解释,order="A" 在可能时沿用输入的连续方向。它们描述的是读写元素的遍历规则,不是简单的标签:
import numpy as np

x = np.arange(6).reshape(2, 3)
print(x.reshape(3, 2, order="C"))
print(x.reshape(3, 2, order="F"))
[[0 1]
 [2 3]
 [4 5]]
[[0 2]
 [4 1]
 [3 5]]
同一组数字,使用不同顺序得到不同二维排列。reshape 不负责“转置”;如果业务语义是交换轴,应该明确写 transpose 或 swapaxes,让读代码的人知道你是在改变维度含义,而不是只把一段 buffer 重新分组。
3.4 ravel、flatten 与显式选择
ravel 尽量返回 view,必要时才复制;flatten 总是返回副本。需要把结果交给会原地修改的代码时,flatten 的独立所有权反而更安全;只想临时遍历或传给只读函数时,ravel 可能减少一次 copy:
import numpy as np

x = np.arange(6).reshape(2, 3)
a = x.ravel()
b = x.flatten()
a[0] = 10
b[1] = 20
print(x)
print("ravel shares:", np.shares_memory(x, a))
print("flatten shares:", np.shares_memory(x, b))
[[10  1  2]
 [ 3  4  5]]
ravel shares: True
flatten shares: False
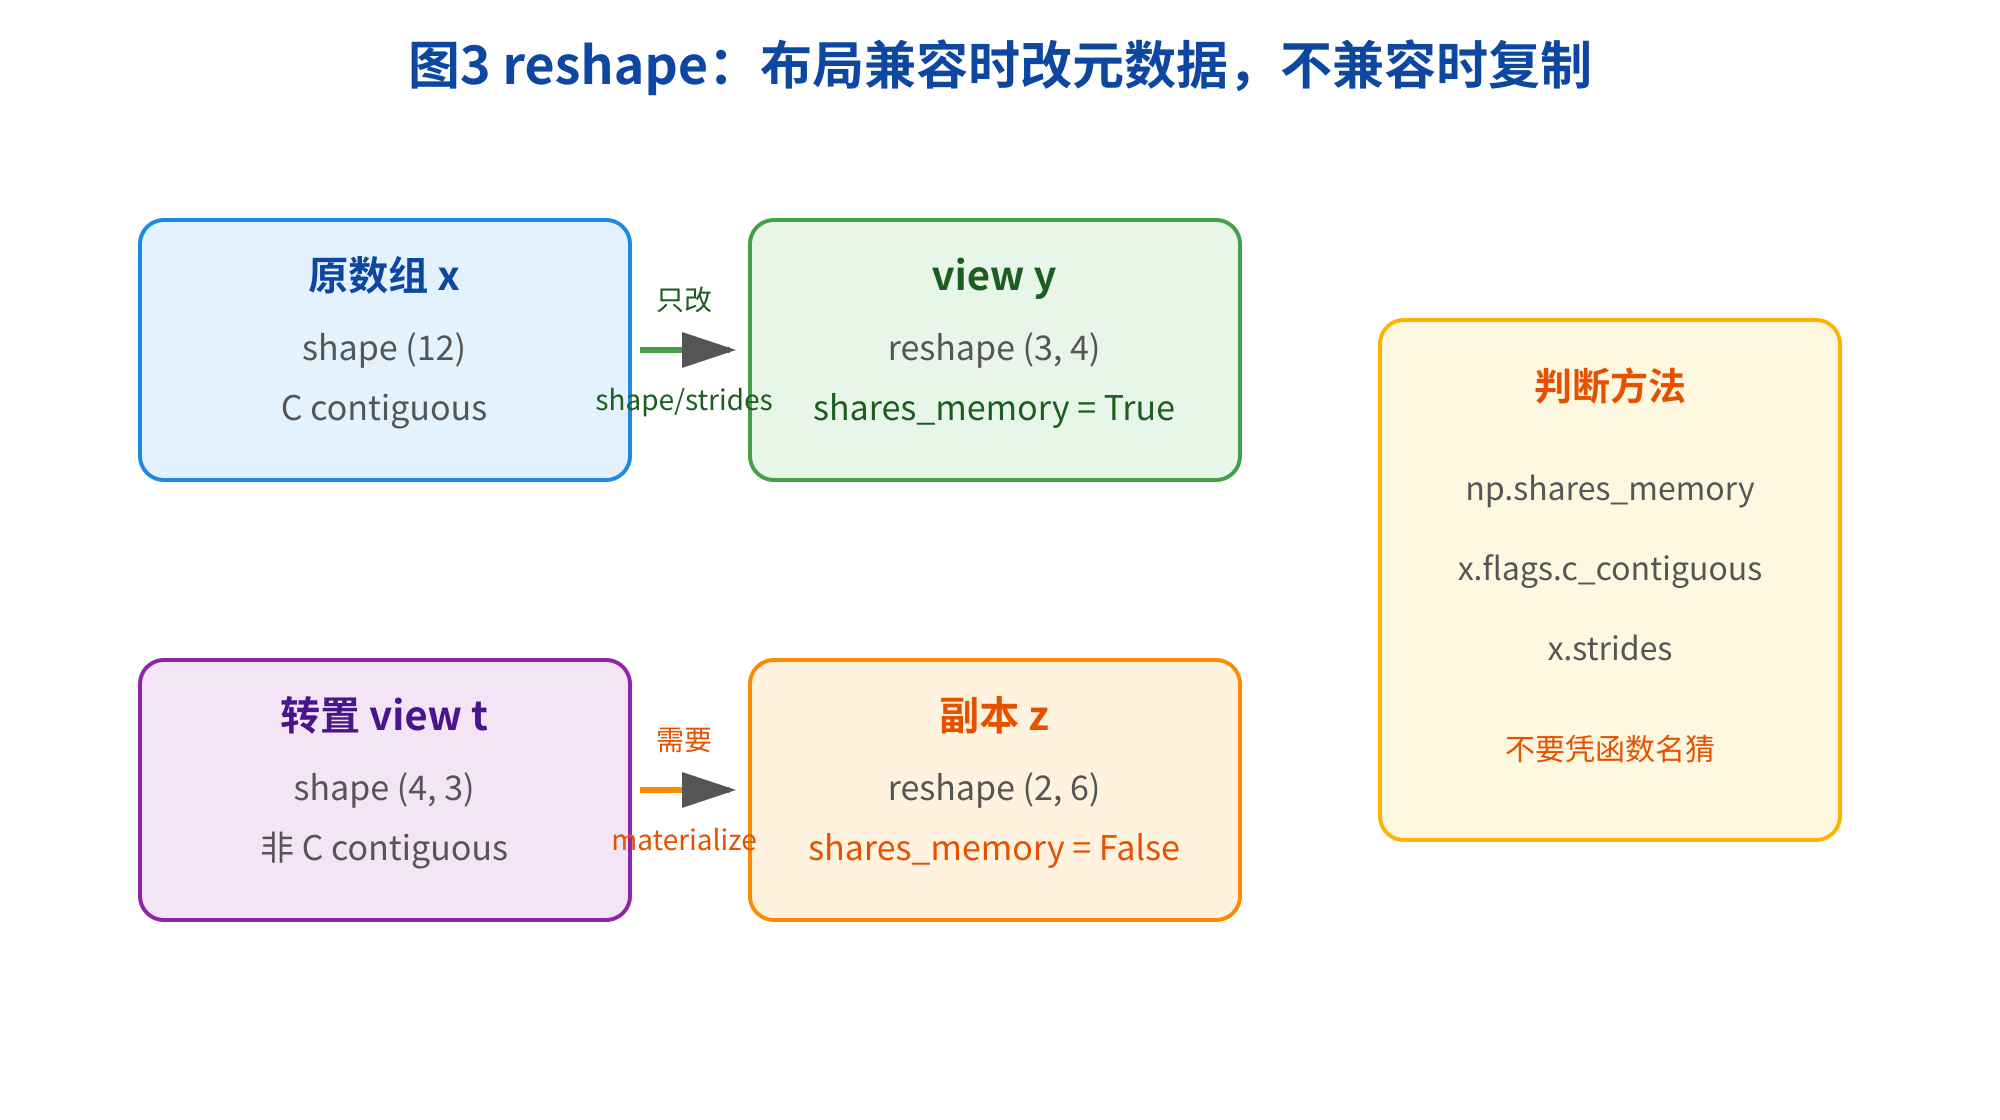
图3 reshape:连续时改元数据,布局不兼容时产生副本
AI Infra 视角:深度学习张量常常在 batch、sequence、hidden 之间折叠或展开。一个“看起来只是 reshape”的操作,如果迫使系统复制数 GB 的激活,就会增加显存峰值和内存带宽压力。性能排查时,shape 日志之外还要记录是否发生了 copy。
四、transpose 与 swapaxes:交换轴,通常不搬数据
4.1 转置主要交换 shape 与 strides
二维数组的 x.T 是 x.transpose() 的简写。它通常只交换轴的解释方式:原来行方向的 stride 变成新数组的列方向 stride,底层数据仍然共享:
import numpy as np

x = np.arange(12, dtype=np.int32).reshape(3, 4)
t = x.transpose()
print("x:", x.shape, x.strides, x.flags.c_contiguous)
print("t:", t.shape, t.strides, t.flags.c_contiguous)
print("shares:", np.shares_memory(x, t))
t[1, 0] = 777
print("x[0, 1] =", x[0, 1])
x: (3, 4) (16, 4) True
t: (4, 3) (4, 16) False
shares: True
x[0, 1] = 777
转置后的 t 看起来是一个正常二维矩阵,但它的每一行在内存中并不连续。打印结果看不出这种差异,strides 和 flags 才能揭示它。对一个很小的数组,这种差异可以忽略;对大矩阵和重复 kernel,则可能决定吞吐。
4.2 多维 transpose 的轴排列
x.transpose(axes) 给出新轴顺序。假设激活是 (B, T, H):
import numpy as np

x = np.empty((2, 3, 4), dtype=np.float32)
for axes in ((0, 2, 1), (1, 0, 2), (2, 0, 1)):
    y = x.transpose(axes)
    print(axes, "shape=", y.shape, "strides=", y.strides,
          "C=", y.flags.c_contiguous)
(0, 2, 1) shape= (2, 4, 3) strides= (48, 4, 16) C= False
(1, 0, 2) shape= (3, 2, 4) strides= (16, 48, 4) C= False
(2, 0, 1) shape= (4, 2, 3) strides= (4, 48, 16) C= False
这里没有复制数据;只是把原来的 stride 元组按 axes 重排。transpose 的参数表达的是轴的身份,reshape 的参数表达的是形状。先 transpose 再 reshape 和先 reshape 再 transpose 通常不是同一件事,必须从业务维度写出每一步。
4.3 swapaxes 与 moveaxis
swapaxes(a, i, j) 只交换两个轴,适合表达“把 batch 轴和时间轴互换”。moveaxis(a, source, destination) 则把某个轴移动到指定位置,适合写可读的 layout 变换:
import numpy as np

x = np.zeros((2, 3, 4))  # B, T, H
bht = np.moveaxis(x, -1, 1)  # B, H, T
back = np.moveaxis(bht, 1, -1)  # B, T, H
print("swap:", np.swapaxes(x, 0, 1).shape)
print("move:", bht.shape)
print("back:", back.shape)
swap: (3, 2, 4)
move: (2, 4, 3)
back: (2, 4, 3)
最后一行故意提醒一个常见误会:moveaxis(x, -1, 1) 返回的是 (B, H, T),并不会自动“恢复”原数组;要恢复应明确把当前的 H 轴移回最后位置。轴变换是 view,但它改变了每个位置的语义,变量名和注释要跟着更新。
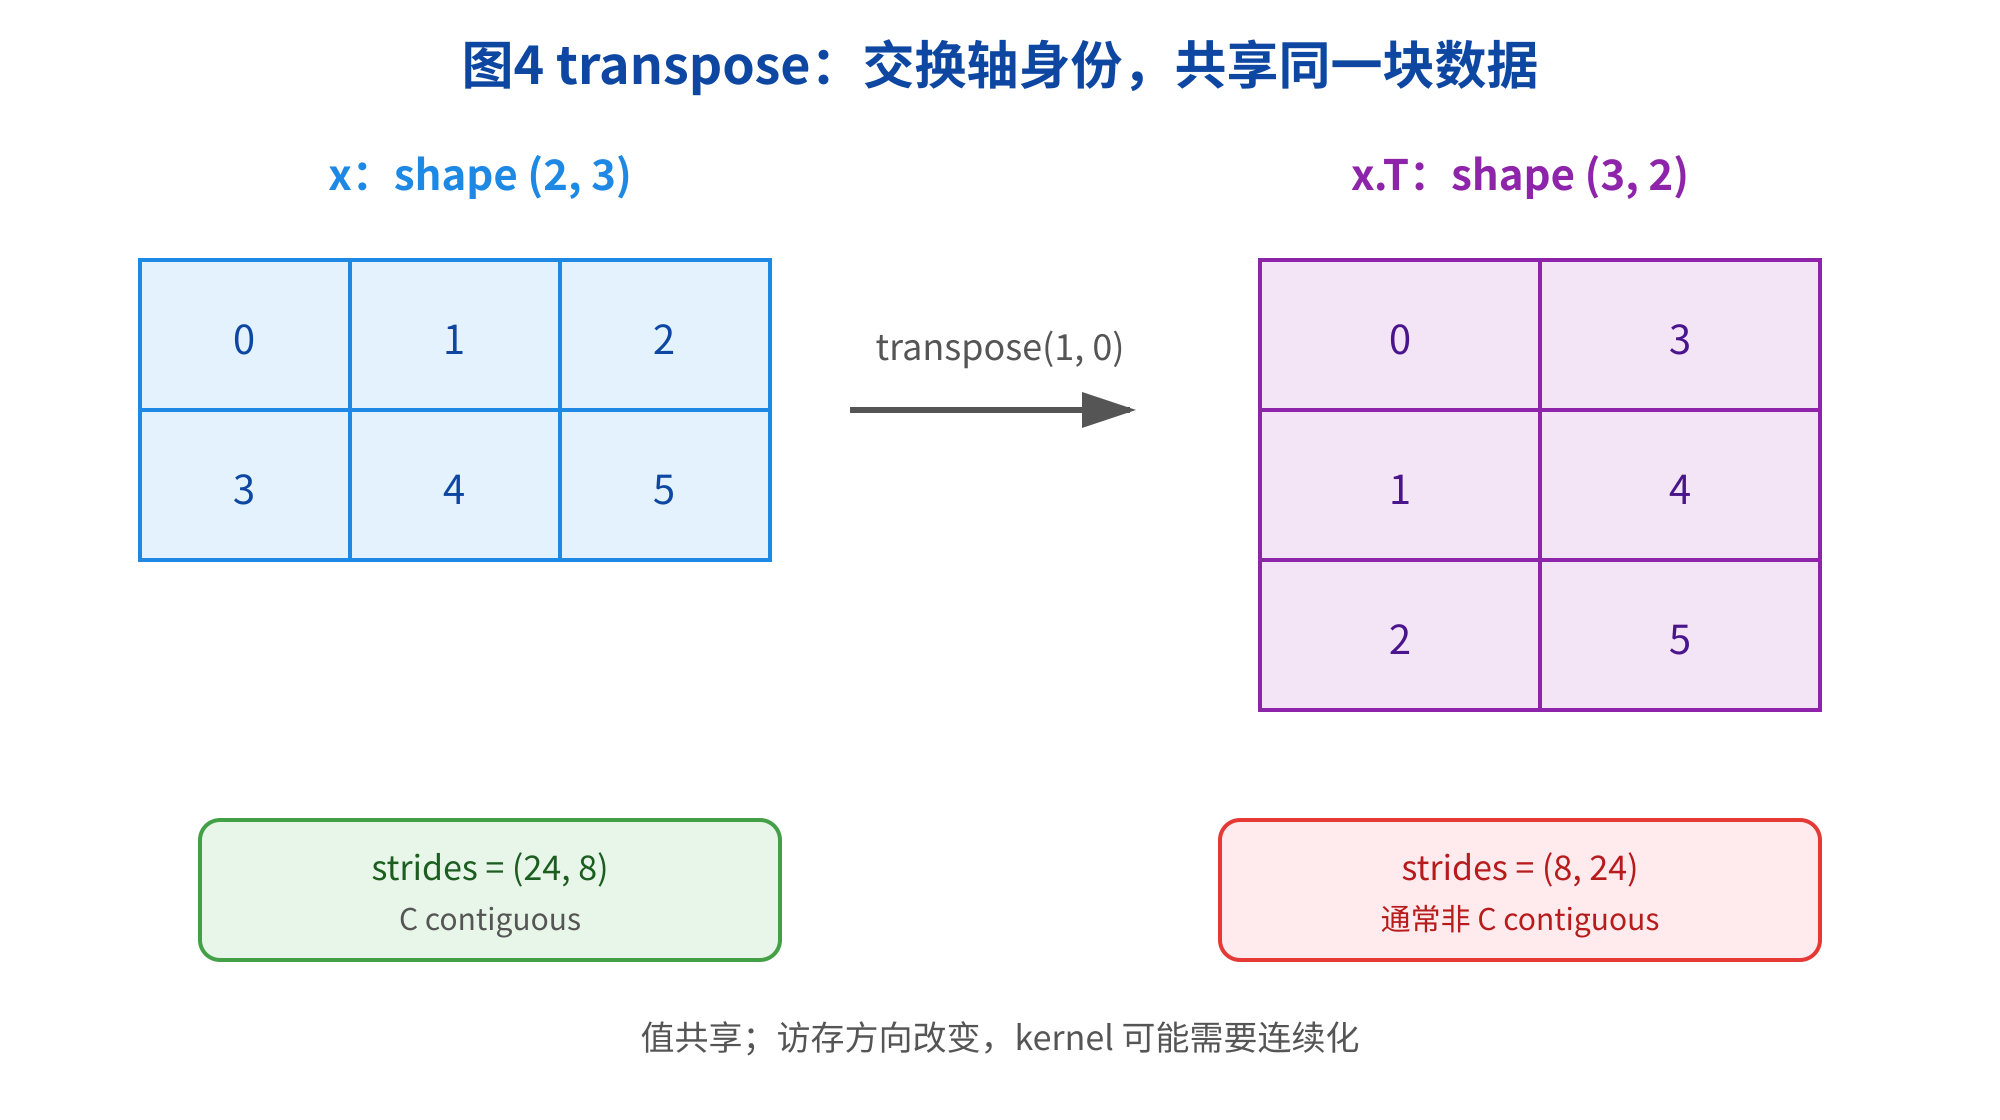
transpose操作,说明其交换轴身份,共享同一块数据。左侧为x,形状为(2, 3),右侧为x.T,形状为(3, 2)。箭头表示transpose(1, 0)操作。下方标注strides = (24, 8),C contiguous,strides = (8, 24),通常非C contiguous。底部文字说明值共享,访存方向改变,kernel可能需要连续化。该图与上下文紧密相关,直观呈现了transpose操作前后数据变化及内存布局情况。图4 transpose:同一块内存,用新的轴顺序解释
AI Infra 视角:Attention、卷积和线性层对维度顺序有不同偏好。把
(B, T, H)变成(B, H, T)可能只是 stride view;但下游 GEMM 若要求连续的最后一维,系统就可能在 kernel 边界做一次 materialize。布局转换的成本应被当作算子图的一部分,而不是“免费 reshape”。
五、把 view 变成连续 buffer:ascontiguousarray
5.1 只在需要的边界连续化
np.ascontiguousarray(x) 的语义很清晰:如果 x 已经是 C contiguous,就返回一个等价的数组(通常不复制);否则创建 C contiguous 副本。它不会改变元素的逻辑顺序,只是按 C-order 把值重新排布:
import numpy as np

x = np.arange(12).reshape(3, 4)
t = x.T
c = np.ascontiguousarray(t)
print("t:", t.shape, t.strides, t.flags.c_contiguous)
print("c:", c.shape, c.strides, c.flags.c_contiguous)
print("shares:", np.shares_memory(t, c))
print("same values:", np.array_equal(t, c))
t: (4, 3) (8, 32) False
c: (4, 3) (24, 8) True
shares: False
same values: True
如果你需要 F contiguous,则使用 np.asfortranarray。如果你需要无论如何都得到独立副本,可以写 np.array(x, order="C", copy=True);如果只想调整布局,不应无意中改变 dtype 或数值。
5.2 view 与 copy 的写入边界
view 的优点是少复制,风险是多个数组共享同一份可写数据。连续化产生的 copy 通常与原数据独立,但最好用检查验证,不要依赖实现细节。对外部 C/CUDA 扩展,还要同时检查 writeable、dtype、对齐和设备位置:
import numpy as np

x = np.arange(6, dtype=np.float32)
view = x[::2]
copy = np.ascontiguousarray(view)
print(view.strides, copy.strides)
print(view.flags.writeable, copy.flags.writeable)
copy[0] = -1
print("x:", x)
print("copy:", copy)
(8,) (4,)
True True
x: [0. 1. 2. 3. 4. 5.]
copy: [-1.  2.  4.]
只读 view 不能通过 ascontiguousarray 重新获得对原数组的写入权限;“布局连续”和“可写”是两个独立属性。生产代码应在 API 文档中说明函数是否会保留共享关系、是否允许原地修改。
5.3 一个可复用的布局检查函数
在数据管道边界,把隐含假设写成断言,比在 kernel 内部遇到错误地址更容易排查:
import numpy as np


def require_c_f32(x):
    x = np.asarray(x)
    if x.dtype != np.float32:
        x = x.astype(np.float32, copy=False)
    if not x.flags.c_contiguous:
        x = np.ascontiguousarray(x)
    assert x.flags.c_contiguous
    assert x.dtype == np.float32
    return x

x = np.arange(12, dtype=np.float64).reshape(3, 4).T
out = require_c_f32(x)
print(out.dtype, out.shape, out.flags.c_contiguous)
float32 (4, 3) True
函数把 dtype 转换与 layout 转换集中在一个边界。真实项目还可能需要检查 ndim、shape 上限、内存对齐、是否允许负 stride,以及输入是不是来自 mmap 或共享内存。核心思想是:让底层 kernel 接收到的契约显式可验证。
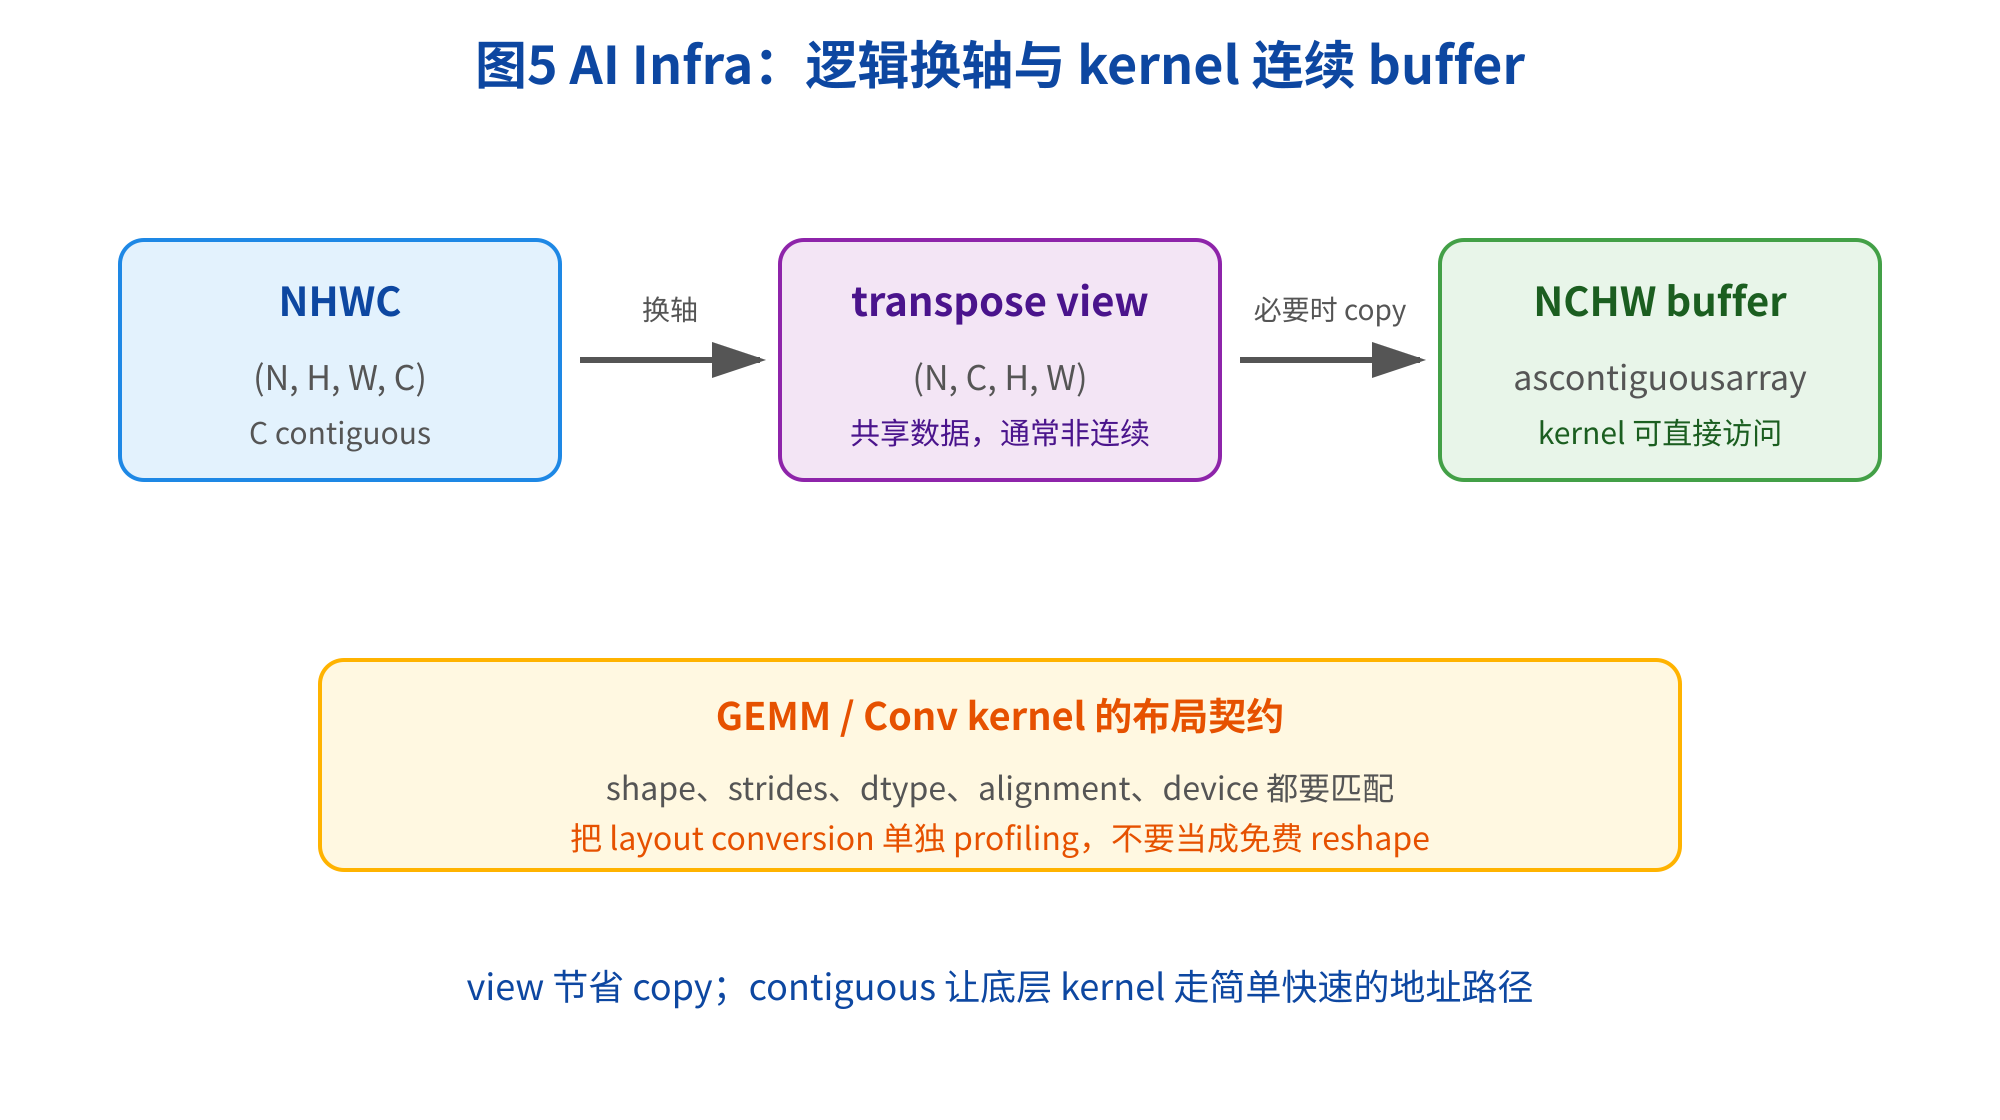
图5 ascontiguousarray:在 kernel 边界把非连续 view materialize 成 C buffer
六、AI Infra 中的布局:GEMM、NHWC 与 NCHW
6.1 GEMM 为什么关心最后一维
矩阵乘法 C = A @ B 通常可以写成 C[i, j] = sum_k A[i, k] * B[k, j]。如果 A 的 k 方向或 B 的 k 方向访问不连续,kernel 需要更复杂的 stride 计算,内存合并和 cache 命中也可能变差。高性能 BLAS、CPU SIMD 和 GPU tensor core 往往会把输入切成 tile,再要求某些维度对齐、连续或具有固定 stride。
这不是说 GEMM 只能接受 C contiguous。许多库支持转置标志、leading dimension 或任意 stride;关键是调用者必须准确传递布局。一个危险模式是:先 A.T 得到非连续 view,再把它当成 C 连续指针交给只支持连续 buffer 的扩展。
import numpy as np

rng = np.random.default_rng(35)
a = rng.normal(size=(2, 3)).astype(np.float32)
b = rng.normal(size=(3, 4)).astype(np.float32)
print("a:", a.shape, a.strides, a.flags.c_contiguous)
print("b:", b.shape, b.strides, b.flags.c_contiguous)
print("c:", (a @ b).shape)

at = a.T
safe_at = np.ascontiguousarray(at)
print("at C:", at.flags.c_contiguous, "safe_at C:", safe_at.flags.c_contiguous)
a: (2, 3) (12, 4) True
b: (3, 4) (16, 4) True
c: (2, 4)
at C: False safe_at C: True
6.2 NHWC 与 NCHW 的直觉
图像 batch 常见的四个逻辑维度是 N(batch)、H(height)、W(width)、C(channel)。NHWC 的 shape 是 (N, H, W, C),NCHW 的 shape 是 (N, C, H, W)。二者包含相同的像素值,但 channel 轴位置不同;transpose(0, 3, 1, 2) 可以做逻辑换轴:
import numpy as np

nhwc = np.zeros((2, 8, 8, 3), dtype=np.float32)
nchw_view = nhwc.transpose(0, 3, 1, 2)
nchw = np.ascontiguousarray(nchw_view)
print("NHWC:", nhwc.shape, nhwc.strides)
print("view :", nchw_view.shape, nchw_view.strides,
      nchw_view.flags.c_contiguous)
print("NCHW :", nchw.shape, nchw.strides, nchw.flags.c_contiguous)
NHWC: (2, 8, 8, 3) (768, 96, 12, 4)
view : (2, 3, 8, 8) (768, 4, 96, 12) False
NCHW : (2, 3, 8, 8) (768, 256, 32, 4) True
transpose 本身几乎没有搬运成本,但卷积 kernel 如果要求 NCHW contiguous,真正的代价出现在 ascontiguousarray。现代框架会通过 layout-aware kernel、通道打包和算子融合减少这类转换;写 NumPy 原型时,也应该把“逻辑换轴”和“物理连续化”分开测量。
6.3 batch、token、hidden 的布局选择
语言模型激活常写成 (B, T, H)。若最后一维 H 连续,那么每个 token 的 hidden 向量可以被一段连续的 SIMD/GPU load 读入;这通常适合逐 token 的线性层。若把它换成 (B, H, T),每个 token 的 H 个值会跨 stride 访问,某些算子需要先转成另一种 layout。
但是,某些按 hidden 维聚合或按序列维计算的 kernel 可能偏好另一种布局。不存在脱离算子图的“永远正确布局”,只有在一段工作负载中减少总转换与访存的选择。可以用如下小工具打印每一步,而不是凭变量名猜:
import numpy as np

x = np.empty((8, 128, 4096), dtype=np.float16)  # B, T, H
for name, y in [
    ("BTH", x),
    ("BHT view", x.transpose(0, 2, 1)),
    ("BHT C", np.ascontiguousarray(x.transpose(0, 2, 1))),
]:
    print(name, "shape=", y.shape, "strides=", y.strides,
          "C=", y.flags.c_contiguous)
BTH shape= (8, 128, 4096) strides= (1048576, 8192, 2) C= True
BHT view shape= (8, 4096, 128) strides= (1048576, 2, 8192) C= False
BHT C shape= (8, 4096, 128) strides= (1048576, 256, 2) C= True
AI Infra 视角:layout 是性能协议的一部分,和 dtype、device、alignment 一样重要。PyTorch tensor、CUDA kernel、通信库和推理引擎都可能携带 stride;“contiguous”不是装饰性属性,而是决定是否能走某个 fused kernel、是否触发隐式 copy 的运行时条件。做 profiling 时要把 layout conversion 单独列出来。
6.4 用显式 stride 模拟底层访问
布局检查最好在数据刚进入模块时完成,并在日志里保留原始 layout 与转换后的 layout。这样线上出现吞吐下降时,可以区分是输入本来就非连续,还是某个新版本算子改变了中间结果的 stride。不要只记录一个“shape 正确”的日志:两个同 shape 数组仍可能有完全不同的地址访问路径。
为了把“stride 是地址契约”变成可运行的直觉,可以写一个只读的访问器。它不依赖 NumPy 的 x[i, j],而是把数组的 data buffer 看成一维字节区域,再按照 shape 和 strides 计算偏移。教学示例只处理一维 int32 数组,生产代码不要绕过 NumPy 的边界和 dtype 检查:
import numpy as np

x = np.arange(6, dtype=np.int32).reshape(2, 3)
raw = x.view(np.uint8).reshape(-1)

def read_i32(a, raw, i, j):
    offset = i * a.strides[0] + j * a.strides[1]
    start = offset // a.itemsize
    return np.frombuffer(raw[start * a.itemsize:], dtype=a.dtype, count=1)[0]

print(x.strides)
print(read_i32(x, raw, 1, 2))
(12, 4)
5
对于真实的任意 view,data pointer 可能从原 buffer 中间开始,stride 也可能为负数;还要处理对齐、边界、字节序和只读标记。这个示例的价值不在于替代 NumPy,而在于展示 C/CUDA kernel 的核心循环:先取得轴 stride,再将逻辑坐标换成字节偏移。transpose 不需要复制,因为只要把 stride 元组换一个顺序,访问器就能读出同一批值。
进一步想象一个 (B, T, H) 的 kernel。若 H 方向 stride 等于 itemsize,一个线程组读取同一 token 的 hidden 向量时可以连续加载;若 stride 很大,线程需要跨越内存访问。即使两个数组 shape 完全相同,只要 strides 不同,缓存行为和向量化机会就可能完全不同。排查性能时应同时记录 shape、dtype、strides、连续性和实际 copy 次数。
七、踩坑大全
通用
- 坑 1:把
reshape当成必然 view。 现象是修改结果影响不到原数组,或大数组突然占用更多内存。原因是非连续布局无法按目标顺序表达;用np.shares_memory验证,想要副本则显式.copy()。 - 坑 2:把
strides当成元素个数。 现象是 C 扩展索引错位。原因是 NumPy 的 stride 单位是字节;应除以itemsize后才能得到元素步长。 - 坑 3:看到转置结果正确就忽略布局。 现象是打印没问题,但 kernel 变慢。原因是
transpose通常返回非连续 view;在明确边界使用ascontiguousarray,并把 copy 计入性能预算。 - 坑 4:用
base is x判断是否共享。 现象是明明共享却检查失败。原因是 view 可能经由中间对象持有 base;使用np.shares_memory,必要时配合np.may_share_memory。 - 坑 5:混淆
reshape与transpose。 现象是 batch、token、channel 的语义错位。原因是前者重新分组元素,后者交换轴身份;先写出每个轴的名字,再写 API。 - 坑 6:无条件连续化。 现象是每个函数都在复制,吞吐下降、峰值内存上升。原因是没有区分 view、copy 和后续复用次数;把连续化放在真正需要的 kernel/API 边界。
Linux / GPU 服务器与 AI Infra
- 坑 7:CPU 数组的 contiguous 等于 GPU tensor contiguous。 现象是 NumPy 原型正常,迁移 CUDA 后仍触发 layout copy。原因是 device、dtype、alignment、stride 是不同层面的约束;在目标框架中重新检查 tensor 属性。
- 坑 8:只 benchmark 算子,不 benchmark layout conversion。 现象是单次 GEMM 很快,端到端却慢。原因是计时范围漏掉 transpose 后的 materialize;分别测 view、copy、kernel,并确认是否有隐式同步。
- 坑 9:把 NHWC/NCHW 只当作 shape 字符串。 现象是图像数值位置错或卷积性能异常。原因是轴顺序代表真实语义,且物理连续方向也变了;给每个轴命名,转换后检查少量像素与 strides。
- 坑 10:忽略大数组 copy 的带宽。 现象是显存峰值或主机内存峰值突然翻倍。原因是一个激活同时保留原 view 和连续副本;复用缓冲区、融合算子或在更早阶段确定统一 layout,并记录转换次数。
八、小结
ndarray的地址由 data pointer、shape 和每个轴的字节strides共同决定;stride 不是元素个数,务必记住。- C-order 让最后一个轴连续,F-order 让第一个轴连续;
flags可以检查连续性,但连续不等于所有场景都最快,仍需结合算子访问方向。 reshape在布局兼容时可以只改元数据,遇到空洞或转置布局时可能复制;应使用shares_memory验证。transpose、swapaxes和moveaxis通常是零拷贝 view,但会改变轴语义与访存方向。ascontiguousarray把非连续 view 物化成 C buffer,应该放在明确需要连续输入的边界,并把 copy 成本纳入 profiling。- GEMM、NHWC/NCHW、batch-token-hidden 的选择,本质上都是在逻辑 shape 与物理 layout 之间做工程权衡;先保证契约清楚,再谈极限优化。
九、课后练习
- (基础) 对一个
(2, 3, 4)的float32数组,手算每个轴的字节 stride,再用x.strides验证;把同一题改成float64。 - (基础) 分别创建 C contiguous 和 F contiguous 的
(3, 4)数组,打印shape、strides、flags,说明哪一个循环方向更连续。 - (理解) 写函数
explain(x),输出dtype、itemsize、shape、strides、C/F contiguous;对原数组、切片、转置逐个调用。 - (理解) 构造一个切片 view,比较
reshape、ravel、flatten的shares_memory,并解释为什么flatten修改后不影响原数组。 - (进阶) 对
(B, T, H)数组实现BTH -> BHT -> BTH,每一步打印轴名、shape 和 strides;验证来回变换的值相等但中间 view 可能非连续。 - (进阶) 写一个
to_c_float32(x),只在 dtype 或 C contiguous 不满足时转换;用np.shares_memory测试它对不同输入是否避免了不必要的 copy。 - (AI Infra) 生成 NHWC 图像 batch,比较
transposeview 与ascontiguousarray的内存占用和耗时;解释为何只测transpose会得出误导性结论。 - (AI Infra) 用
A @ B做一个小型 GEMM 实验,分别传入连续数组、转置 view 和连续化后的转置,记录 shape、strides、耗时,并写出你对 kernel 布局契约的建议。
下一篇预告
下一篇是 第36篇|实战:用 NumPy 手写 MLP 前向与反向。我们会把本篇的连续数组、view/copy 判断和第 34 篇的随机初始化、归约组合起来,从零写出多层感知机(MLP)的前向传播、损失计算、反向传播与参数更新。
真正的训练代码不只是“矩阵乘法写对了”:权重和激活的 shape 要对齐,batch 维要沿正确的轴归约,梯度不能被意外的共享 view 覆盖,布局转换也不能悄悄吞掉大部分时间。第 36 篇会用有限的 NumPy 工具把这些契约逐项打印、断言和数值检查,作为进入第 37 篇 PyTorch Tensor 世界之前的一次完整演练。届时你会看到,前向与反向的每个中间数组都可以用 shape、stride 和数值范围来解释;当结果不对时,先检查布局和轴语义,通常比盯着最后一个 loss 更快找到根因。