
第32篇|向量化运算与 ufunc
本篇定位:专栏三「NumPy 数值计算」第四篇。承接第 31 篇的广播机制:形状已经对齐之后,谁真正把每个元素算出来?答案是通用函数(universal function,简称 ufunc)。
读完你将能够:区分 Python 循环、列表推导式与 NumPy 向量化;理解 ufunc 的输入、广播、dtype 解析与输出流程;使用
out=、where=控制分配和掩码写入;掌握reduce、accumulate等归约方法;在训练和推理数据准备中识别 Python 循环热点。预计用时:阅读 40~50 分钟,动手 50~70 分钟。
第 31 篇解决的是「两个数组的 shape 能不能对齐」。本篇继续往前走:对齐之后,a + b 到底由谁执行?为什么同样是把一百万个数乘以 2,NumPy 往往比 Python for 快很多?为什么 out= 能减少临时数组,而 where= 又能避免无效位置的计算?
在 AI Infra 里,这不是语法细节。数据预处理、batch 拼接前的缩放、mask 生成、采样前的裁剪,以及把 NumPy 数组交给 PyTorch 之前的格式转换,常常都在处理成批元素。若每个元素都回到 Python 解释器,CPU 时间会被循环调度和对象管理消耗;若把整个批次交给底层内核,循环可以在 C 或 SIMD 层一次处理。
先建立一句主线:向量化是表达方式,ufunc 是执行抽象,广播是形状对齐,底层 C / SIMD 内核才是速度来源。 向量化不等于「自动使用 GPU」,也不等于所有代码都不用循环;它指的是把同一种逐元素操作交给数组内核批量执行。
本文会频繁使用第 31 篇的口诀:右对齐、1 可扩、双大不等就失败。 每当看到两个 ufunc 输入,先判断广播结果,再讨论 dtype 和性能。不要因为表达式只有一行,就忘了它仍然有 shape、内存和类型成本。
一、从 Python 循环到向量化
1.1 三种写法,表达同一件事
假设要把一批分数乘以缩放因子并截断到区间 [0, 1]。Python 列表、列表推导式、NumPy 数组都能写,但执行路径完全不同:
import numpy as np

values = [0.2, 0.7, 1.4, -0.3]
scale = 0.8

loop_result = []
for x in values:
    y = x * scale
    loop_result.append(min(1.0, max(0.0, y)))

comprehension_result = [min(1.0, max(0.0, x * scale)) for x in values]
arr = np.array(values)
vector_result = np.clip(arr * scale, 0.0, 1.0)

print(loop_result)
print(comprehension_result)
print(vector_result)
[0.16000000000000003, 0.5599999999999999, 1.0, 0.0]
[0.16000000000000003, 0.5599999999999999, 1.0, 0.0]
[0.16 0.56 1.   0.  ]
结果相同,但列表里装的是一个个 Python float 对象;循环每次都要经过解释器、取出对象、调用运算并把结果放回列表。arr * scale 则把「对每个元素乘法」交给 NumPy 的数组内核,np.clip 再交给另一个内核完成逐元素上下限处理。打印形式不同只是显示精度策略不同,不是数值逻辑不同。
列表推导式通常比显式 for 更紧凑,有时也更快,但它仍然是 Python 层循环。代码短不等于离开了解释器。 向量化的关键不是少写几个字符,而是把循环的控制权交给底层实现。
1.2 ufunc 是什么
ufunc 是「通用函数」的缩写,英文是 universal function。它是 NumPy 中面向数组的逐元素函数对象,例如:
- 二元 ufunc:
np.add、np.subtract、np.multiply、np.divide、np.maximum; - 一元 ufunc:
np.exp、np.sqrt、np.abs、np.tanh、np.isnan; - 比较与逻辑:
np.greater、np.equal、np.logical_and。
把一个 ufunc 想成一个「带有数组协议的函数」:它接收一个或多个输入,先按广播规则确定迭代空间,再按 dtype 选择循环实现,最后把结果写入新数组或用户提供的输出数组。它并不是 Python 函数被神奇地重复调用一百万次,而是 NumPy 在底层拥有一套按类型组织的循环。
import numpy as np

x = np.array([-1.0, 0.0, 1.0, 2.0])
y = np.array([0.5, 1.5, 0.5, 3.0])

print(np.add(x, y))
print(x + y)
print(np.maximum(x, y))
print(np.exp(np.array([0.0, 1.0])).round(4))
print(np.add.nin, np.add.nout, np.add.identity)
[-0.5  1.5  1.5  5. ]
[-0.5  1.5  1.5  5. ]
[0.5 1.5 1.  3. ]
[1.     2.7183]
2 1 0
+ 通常会分派到 np.add,* 通常对应 np.multiply;写成显式 ufunc 有助于发现 out=、where= 和 reduce 等接口。nin 是输入个数,nout 是输出个数,identity 是某些归约可以使用的单位元。不要把 np.vectorize 误当成 ufunc:后者是底层数组循环,前者主要是 Python 函数的包装器,后面会专门说明。
1.3 一张执行流水线图
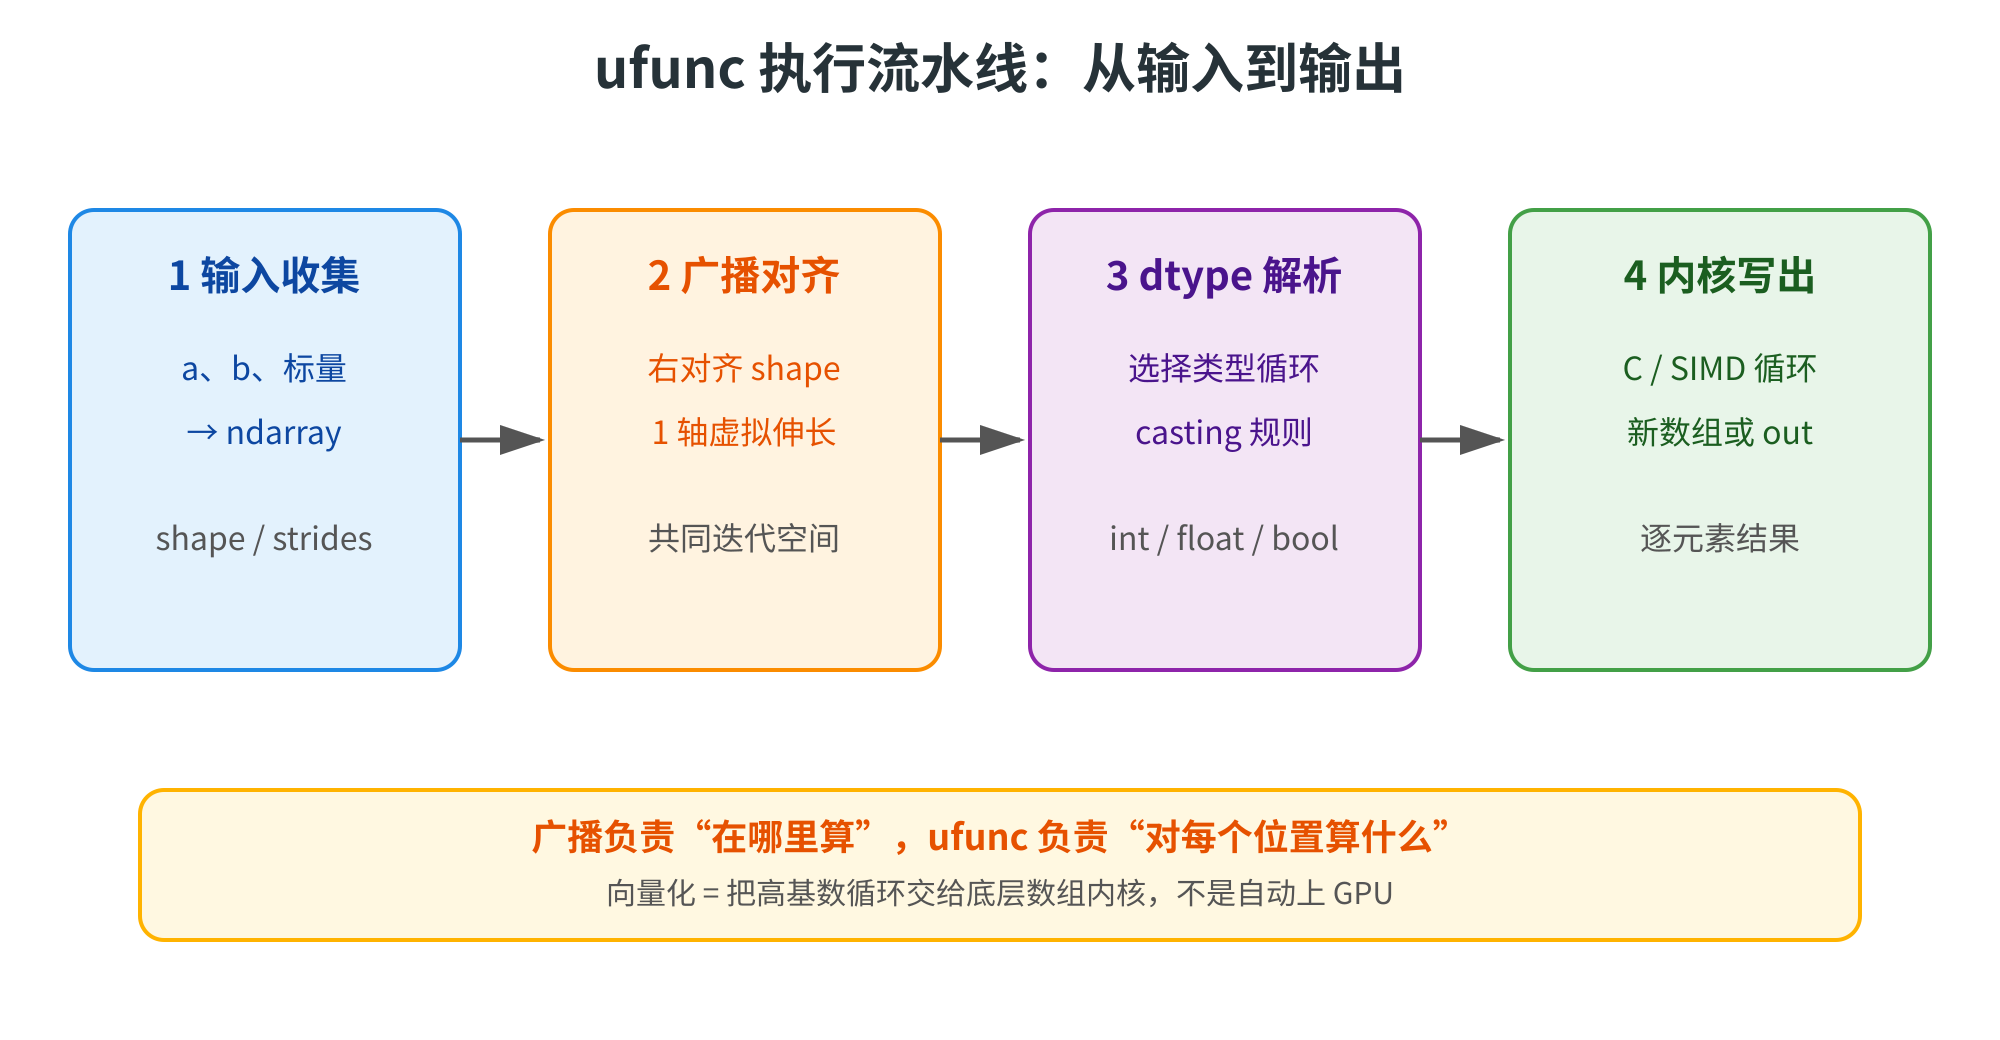
图1 ufunc 执行流水线:输入到输出
一个 np.add(a, b) 可以按四步理解:
- 收集输入:把标量、列表或
ndarray转为 NumPy 能处理的数组对象; - 广播对齐:根据 shape 计算共同的迭代空间,例如
(B, T, H)与(H,)得到(B, T, H); - 类型解析:决定输入和输出使用哪一种循环,必要时做安全类型转换;
- 运行并写出:遍历底层缓冲区,把每个位置的结果写进新数组或
out。
这张图也解释了为什么「向量化」和「广播」不是同义词:广播只负责让输入在坐标上相遇,ufunc 才负责逐元素计算;一个广播表达式仍可能因为 dtype 转换或大规模输出而昂贵。
AI Infra 视角:预处理服务收到一个 batch 后,最好把缩放、裁剪、
isnan检查等同类型操作变成数组表达式,再一次性交给 NumPy。这样 Python 线程主要负责调度和 I/O,而不是负责逐 token、逐特征地搬运对象。
二、ufunc 的广播、dtype 与类型转换
2.1 每个 ufunc 都会继承广播规则
import numpy as np

scores = np.arange(12, dtype=np.float32).reshape(3, 4)
bias = np.array([0.1, 0.2, 0.3, 0.4], dtype=np.float32)
result = np.add(scores, bias)

print(scores.shape, bias.shape, result.shape)
print(result.dtype)
print(result[0].round(1))
(3, 4) (4,) (3, 4)
float32
[0.1 1.2 2.3 3.4]
bias 的 (4,) 从右侧与 (3, 4) 对齐,因此每一行都加上同一个特征偏置。若想让每个 batch 样本有一个标量偏置,就需要把它写成 (3, 1);表达式能否运行和语义是否正确,是两个问题。
多输入 ufunc 也一样:np.where(mask, a, b) 要求 mask、a、b 能共同广播。复杂表达式可以先用 np.broadcast_shapes 验证,避免在深层服务逻辑里才发现维度冲突。
mask = np.array([[True], [False]])       # (2, 1)
a = np.full((2, 3), 10)
b = np.zeros((3,), dtype=int)            # (3,)
print(np.where(mask, a, b))
print(np.broadcast_shapes(mask.shape, a.shape, b.shape))
[[10 10 10]
 [ 0  0  0]]
(2, 3)
2.2 dtype 不是装饰,而是计算协议
NumPy 数组的 dtype 决定元素如何解释、占多少字节,也参与 ufunc 选择循环。整数数组除以浮点数通常会产生浮点结果;整数数组做整数加法则不会自动给你小数精度。
import numpy as np

ints = np.array([1, 2, 3], dtype=np.int32)
print((ints + 0.5), (ints + 0.5).dtype)
print((ints * 2).dtype)
print((ints / 2).dtype)

small = np.array([120, 120], dtype=np.int8)
print(small + small)
print((small + small).dtype)
[1.5 2.5 3.5] float64
int32
float64
[-16 -16]
int8
最后一个结果发生了 int8 溢出:240 无法表示在 int8 的范围内,于是按固定宽度回绕。不要看到「向量化」就忘了数值类型。训练前处理常见 uint8 图像、float16 激活和 float32 统计量,混合运算可能触发提升、转换、溢出或额外内存。
ufunc 会在可用的类型循环中选择一个实现,并遵守 casting 规则。默认通常允许安全转换,但把浮点结果硬写进整数 out 往往会报错或造成截断风险。可以显式指定 dtype=,也可以在进入关键计算前 astype,把精度意图写出来:
x = np.array([1, 2, 3], dtype=np.int32)
print(np.add(x, 0.5, dtype=np.float32))
print(np.multiply(x, 2, dtype=np.float64))
[1.5 2.5 3.5]
[2. 4. 6.]
astype 默认会返回新数组;对大 batch 反复转换会增加带宽压力。工程上应在数据入口统一 dtype,之后尽量保持一致,而不是在每一个小运算前临时转换。
2.3 np.vectorize 为什么不是性能开关
如果已有一个只能处理标量的 Python 函数,np.vectorize 可以帮你获得数组形状和广播的外观:
import numpy as np

def bucket(x):
    return 1 if x >= 0 else -1

x = np.array([-2, 0, 3])
v = np.vectorize(bucket)
print(v(x))
print(type(v))
[-1  1  1]
<class 'numpy.vectorize'>
它的主要价值是方便迁移和原型验证,不是把 bucket 编译成 C。内部仍然会逐元素调用 Python 函数,通常比真正的 ufunc 慢。能用 np.where、比较 ufunc 或 np.select 表达时,应优先使用它们;需要复杂且高频的自定义数值内核时,再考虑 Numba、Cython 或专门的 GPU 算子。
AI Infra 视角:在 tokenizer 后处理、采样结果清洗或 batch 特征校验里,
np.vectorize可能让代码先跑起来,但它不能解决 Python 调度瓶颈。上线前应基于真实 batch 做 profile,而不是因为 API 名字里有 vectorize 就认为已经向量化。
三、用 out= 和 where= 控制内存与掩码
3.1 out=:把结果写到预分配缓冲
普通表达式会创建新数组:
import numpy as np

a = np.arange(5, dtype=np.float32)
b = np.full(5, 2.0, dtype=np.float32)
result = np.empty_like(a)

np.add(a, b, out=result)
print(result)
print(result is a, result.dtype)
[2. 3. 4. 5. 6.]
False float32
out 必须是数组或符合写入协议的对象,shape 要能容纳广播结果,dtype 也要允许结果写入。这里 result 先分配一次,后续可以在循环中复用:
buf = np.empty(5, dtype=np.float32)
for step in range(3):
    np.multiply(a, step + 1, out=buf)
    print(buf)
[0. 1. 2. 3. 4.]
[0. 2. 4. 6. 8.]
[ 0.  3.  6.  9. 12.]
这个 Python for 只循环 3 次「步骤」,每一步的大循环仍在 NumPy 内核里。不要把「完全没有 for」当成目标;真正重要的是把高基数的元素循环移出 Python。
3.2 where=:只在需要的位置写入
where 接受布尔条件,也遵循广播。条件为 True 的位置才执行并写入 ufunc 结果;条件为 False 的位置保持 out 原来的值。因此配合 out 时,必须先决定那些位置应该保留什么。
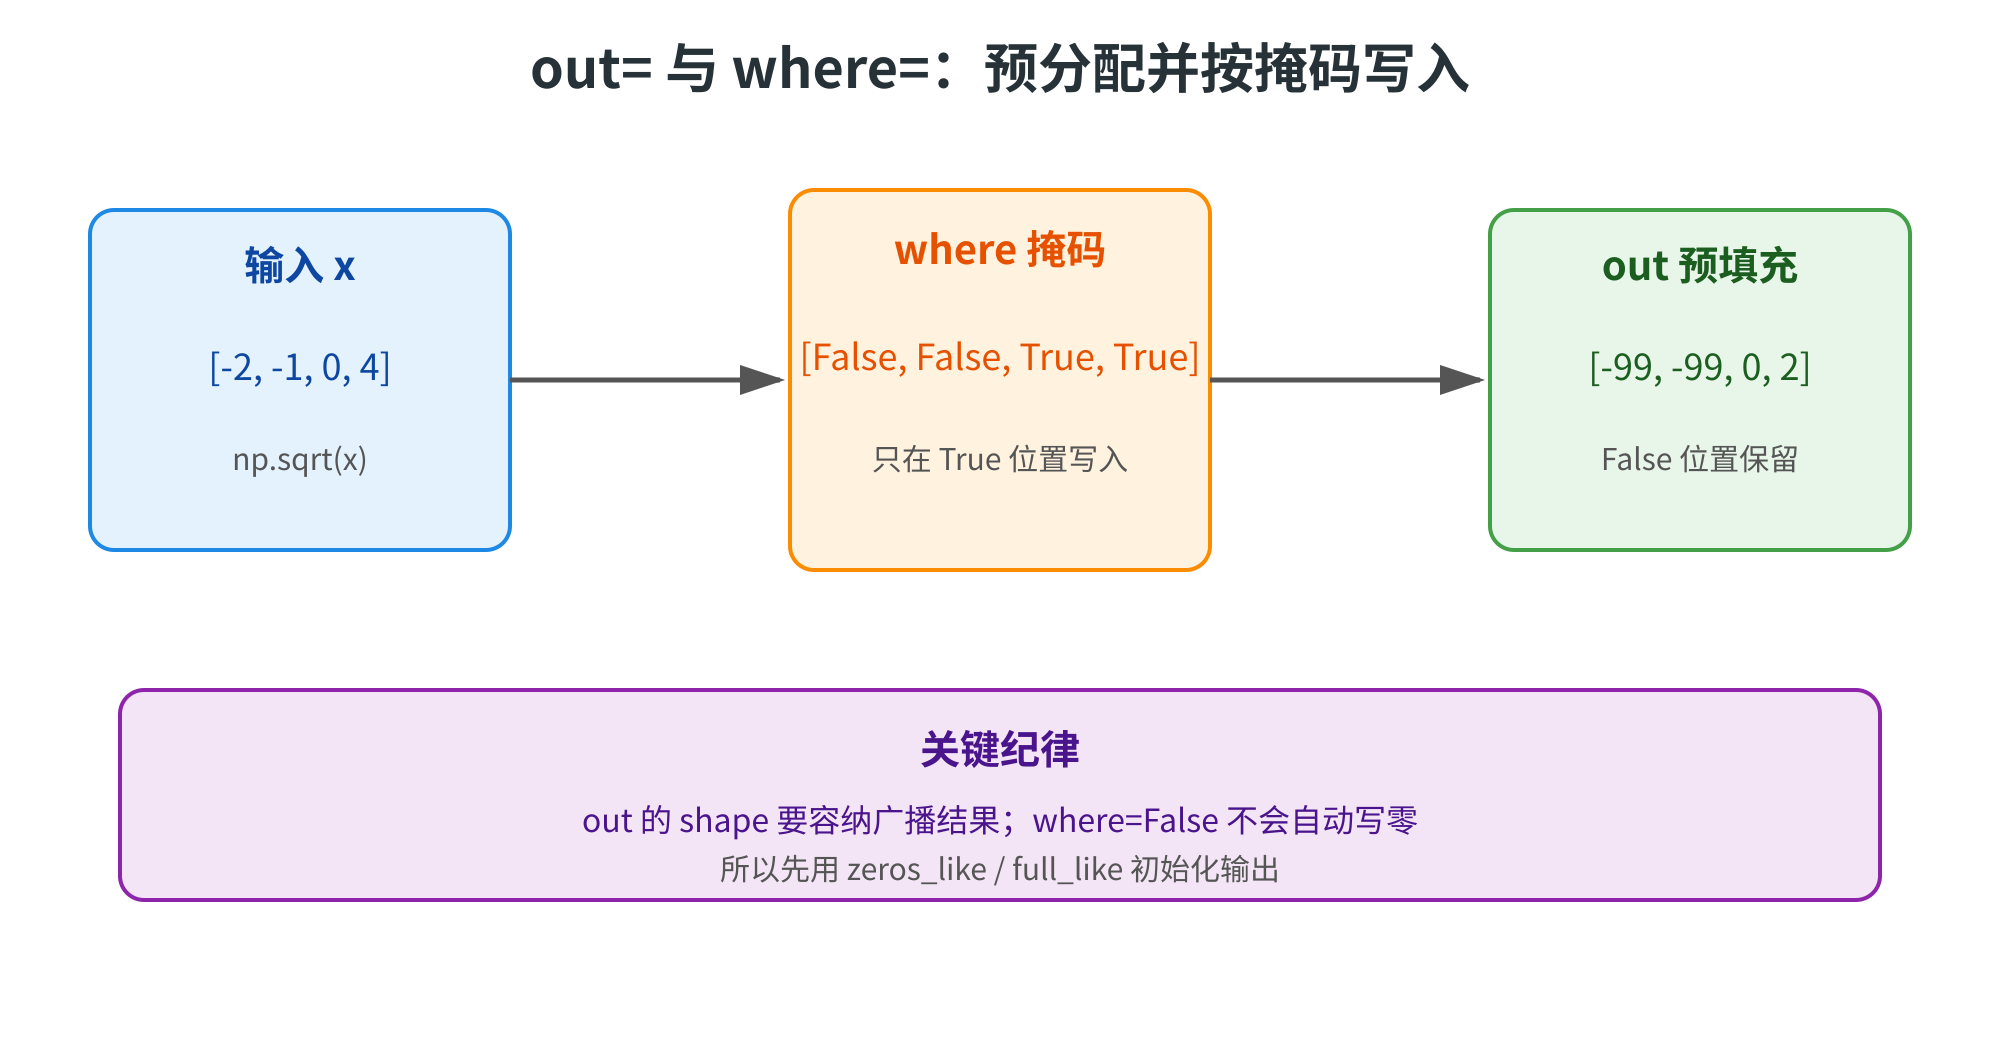
图2 out= 与 where=:预分配并按掩码写入
import numpy as np

x = np.array([-2.0, -1.0, 0.0, 4.0])
out = np.full_like(x, -99.0)
np.sqrt(x, out=out, where=x >= 0)
print(out)
[-99. -99. 0. 2.]
如果写成 np.sqrt(x),负数会产生 nan 并发出 warning;这里用 where 跳过无效位置,同时让输出预先填成业务需要的哨兵值。注意:where 并不是「把所有危险输入先算完再丢掉」,它描述的是 ufunc 的选择性写入路径;对未初始化的 out 来说,False 位置仍可能保留随机内存,所以要先 fill 或用 np.full。
3.3 out 与广播结果必须对齐
import numpy as np

x = np.arange(6).reshape(2, 3)
bias = np.array([10, 20, 30])
out = np.empty_like(x)
np.add(x, bias, out=out)
print(out)

try:
    wrong = np.empty(2, dtype=int)
    np.add(x, bias, out=wrong)
except ValueError as e:
    print(type(e).__name__)
[[10 21 32]
 [13 24 35]]
ValueError
广播结果是 (2, 3),所以 (2,) 的输出不能承接它。out= 不是绕过 shape 检查的后门。对服务代码而言,可以在初始化阶段按 batch 的最大 shape 预分配,也可以按实际 shape 建立缓冲池;但不能为了省一次分配,把不匹配的数组硬塞进去。
3.4 原地写入的别名风险
out=a 有时很方便,但要确认输入和输出重叠不会破坏尚未读取的数据。NumPy 的 ufunc 会尽力处理一些安全的重叠情况,但复杂切片、不同 strides 和多个输入重叠时,不要依赖猜测。简单的逐元素原地缩放通常可读:
x = np.array([1.0, 2.0, 3.0])
np.multiply(x, 10.0, out=x)
print(x)
[10. 20. 30.]
若运算链很长,宁可使用明确的临时数组或独立缓冲,也不要为了少一个分配制造隐蔽的别名关系。性能优化必须服从可验证的数值正确性。
四、归约、累积与沿轴计算
4.1 逐元素之后的下一层:reduce
逐元素 ufunc 产生和输入相同或可广播的网格;归约则沿某个轴把许多元素合成一个。np.add.reduce 与 sum 关系密切,np.maximum.reduce 可以求最大值,np.logical_and.reduce 可以检查一组布尔条件是否全部为真。
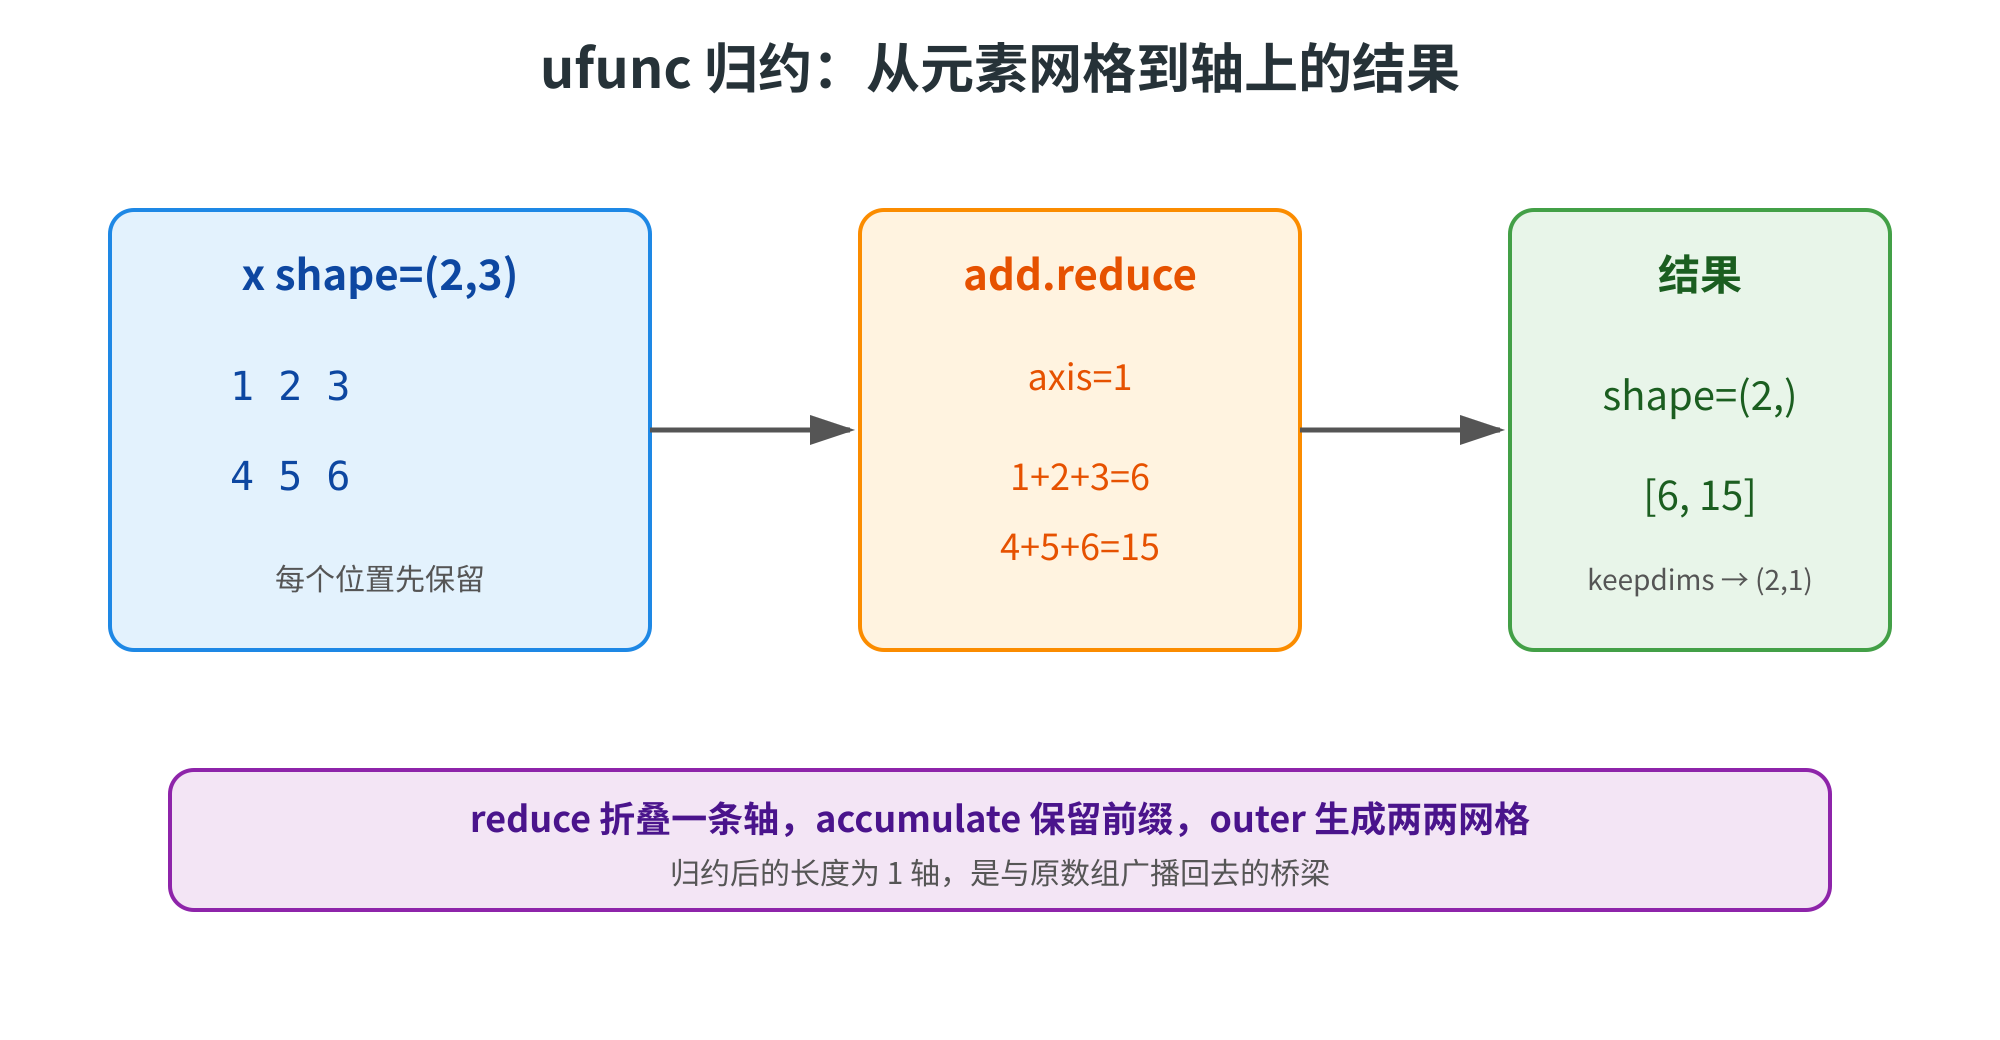
add.reduce操作,axis=1将列方向折叠,保留行,计算结果为6和15。右侧绿色框是结果,形状为(2,),值为[6, 15],keepdims=True保留了长度为1的轴。底部紫色框总结了reduce、accumulate、outer操作特点。图3 ufunc 归约:从元素网格到轴上的结果
import numpy as np

x = np.arange(1, 7).reshape(2, 3)
print(np.add.reduce(x))
print(np.add.reduce(x, axis=1))
print(np.maximum.reduce(x, axis=0))
print(np.add.reduce(x, axis=1, keepdims=True))
[5 7 9]
[ 6 15]
[4 5 6]
[[ 6]
 [15]]
axis=0 把行方向折叠,保留列;axis=1 把列方向折叠,保留行。keepdims=True 会把被归约的轴保留为长度 1,这正是第 31 篇讲过的广播接口:结果 (2, 1) 可以安全地与原来的 (2, 3) 配合。
4.2 accumulate 与 outer
accumulate 不把整条轴压成一个值,而是保留每一步的前缀结果:
import numpy as np

x = np.array([1, 2, 3, 4])
print(np.add.accumulate(x))
print(np.multiply.accumulate(x))
print(np.add.outer(np.array([1, 2, 3]), np.array([10, 20])))
[ 1  3  6 10]
[ 1  2  6 24]
[[11 21]
 [12 22]
 [13 23]]
outer 会把两个输入的每一对元素做 ufunc,常见结果是 (3, 2) 的网格。它和第 31 篇的 [:, None] 加 None, :] 类似,但由 ufunc 方法直接表达。代价也很直接:输出元素数量是两边长度的乘积,不能因为写成一行就忽略 O(N²) 内存。
4.3 归约的数值稳定性
归约不只是「写一个更短的循环」。浮点加法不满足严格结合律,不同的分块顺序可能带来微小差异;大规模统计还要考虑溢出、nan 与空数组。np.sum 往往比手写 Python 累加更快,也可能使用更适合的精度策略,但并不自动保证统计学意义上的稳定。
import numpy as np

x = np.array([1.0, np.nan, 3.0])
print(np.sum(x))
print(np.nansum(x))
print(np.add.reduce(np.array([], dtype=np.int64), initial=10))
nan
4.0
10
initial 给归约提供初始值;空数组没有自然的结果时,显式写出初值比依赖默认行为更清楚。训练指标、loss 汇总和在线监控中,应先决定 nan 是错误、缺失还是需要忽略,再选择 sum、nansum 或掩码。
AI Infra 视角:一个 batch 的 token loss 通常先在 token 维做归约,再在 batch 维做归约。每一次
axis选择都改变后续广播和通信的 shape;分布式训练中还要区分本地归约与跨卡 all-reduce,不能把 NumPy 的单机reduce直觉直接当成通信操作。
五、向量化收益、代价与自定义 ufunc
5.1 用小实验测真正的收益
下面用相同数据比较 Python 循环和 NumPy 表达式。不要把单次小数组的结果当作普遍规律;基准测试要多轮、预热,并观察内存和输入类型。
import time
import numpy as np

n = 1_000_000
x = np.linspace(-2.0, 2.0, n, dtype=np.float64)

start = time.perf_counter()
loop = [value * value + 1.0 for value in x]
loop_ms = (time.perf_counter() - start) * 1000

start = time.perf_counter()
vec = x * x + 1.0
vec_ms = (time.perf_counter() - start) * 1000

print(np.allclose(loop, vec), loop_ms > 0, vec_ms > 0)
print(vec.shape, vec.dtype)
True True True
(1000000,) float64
具体毫秒数随机器、NumPy 版本和后台负载变化,因此只验证结果与实验完成状态。向量化通常更快,因为减少了 Python 对象和解释器分派,并能利用连续内存、缓存和 SIMD;但 x * x + 1.0 可能产生中间数组 x * x,内存带宽而不是算术吞吐可能成为瓶颈。可以用 out 重用缓冲,但要注意运算顺序和可读性。
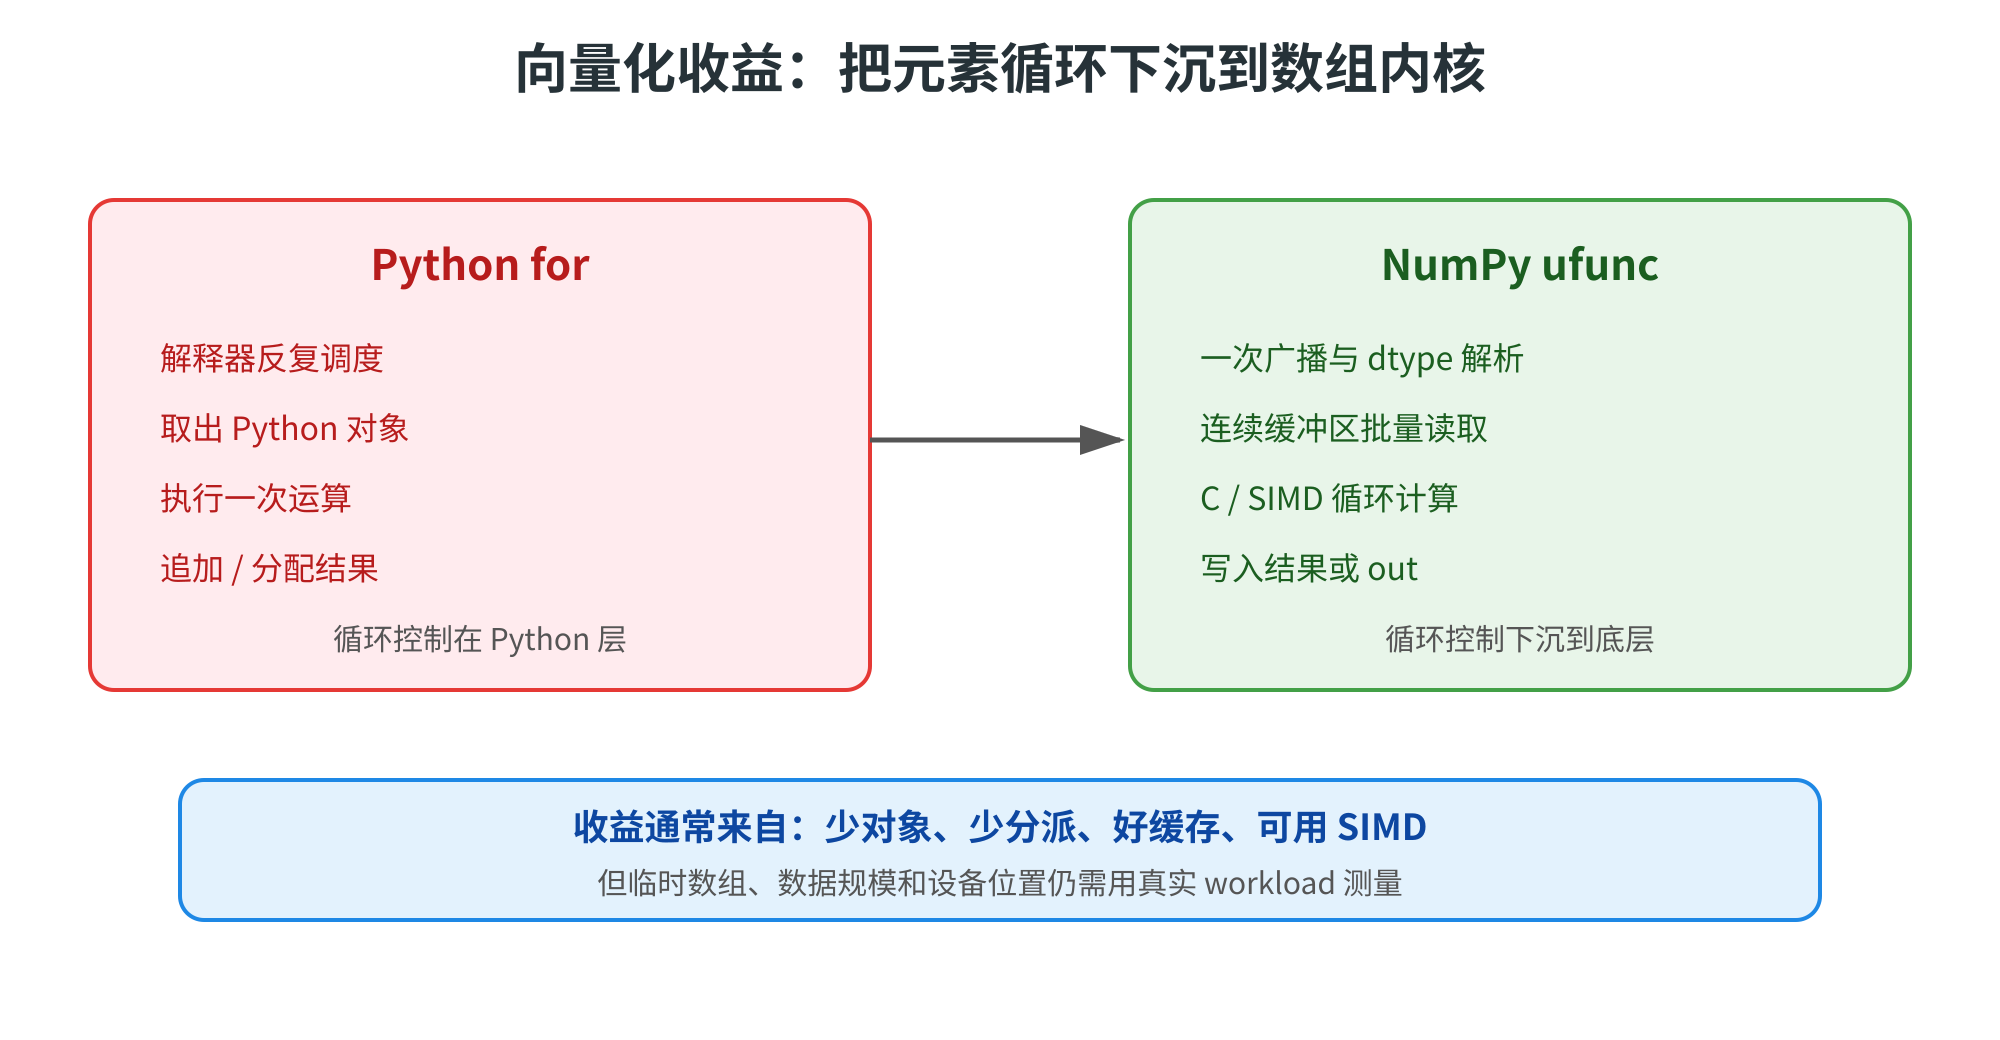
图4 向量化收益:把元素循环下沉到数组内核
5.2 何时向量化并不划算
第一,数组很小。创建 ndarray、调用 ufunc 的固定成本可能超过几次 Python 运算。第二,逻辑有强烈的数据依赖,例如每一步都决定下一步的 shape,简单 ufunc 无法表达。第三,向量化链条制造了多个巨大临时数组,导致内存带宽和峰值内存成为瓶颈。第四,真正的目标设备是 GPU,却在 CPU 上用 NumPy 处理本应留在 GPU 的 tensor。
因此工程判断应问四个问题:数据规模多大?输入是否已经是数组?中间结果是否会爆内存?计算是否应该在 CPU、GPU 或专用算子上完成?「能向量化」通常是好方向,但不是脱离 profiling 的宗教。
5.3 自定义 ufunc:先理解边界
最简单的自定义方式是 np.frompyfunc:它把 Python 函数包装成 ufunc 形状,但输出通常是 object,性能仍然受 Python 函数调用限制,适合教学或混合类型原型:
import numpy as np

def join_tag(x, y):
    return f"{x}:{y}"

tag = np.frompyfunc(join_tag, 2, 1)
print(tag(np.array(["a", "b"]), 3))
print(type(tag))
['a:3' 'b:3']
<class 'numpy.ufunc'>
注意:名字是 ufunc 不代表已经获得 C 级速度。若需要真正高性能的自定义数值循环,可以使用 Numba 的 @vectorize(在合适的环境中生成机器码),或实现 C / Cython 扩展;若计算要上 GPU,则应使用 PyTorch、CuPy 或目标框架的 kernel 机制。选择工具要看部署环境和数据驻留位置。
5.4 把 NumPy 向量化迁移到 AI 栈
NumPy 的逐元素表达式是很好的 CPU 心智模型,但 PyTorch tensor 还多了 device、autograd、dtype 精度和 kernel launch 等因素。torch.add、torch.where、torch.sum 与本篇概念相似;torch.compile 还可能把多个操作融合,减少中间张量和 kernel 启动。
批量推理的常见优化路径是:输入解析保持 Python 边界清晰;一旦进入数值区,就把同一批数据转换成连续、明确 dtype 的数组或 tensor;尽可能合并逐元素操作;在必要时预分配输出;最后才转回 Python 标量或序列化格式。不要在 batch 内逐条调用 .item(),那会把批处理重新拆成解释器操作,GPU 场景还可能触发同步。
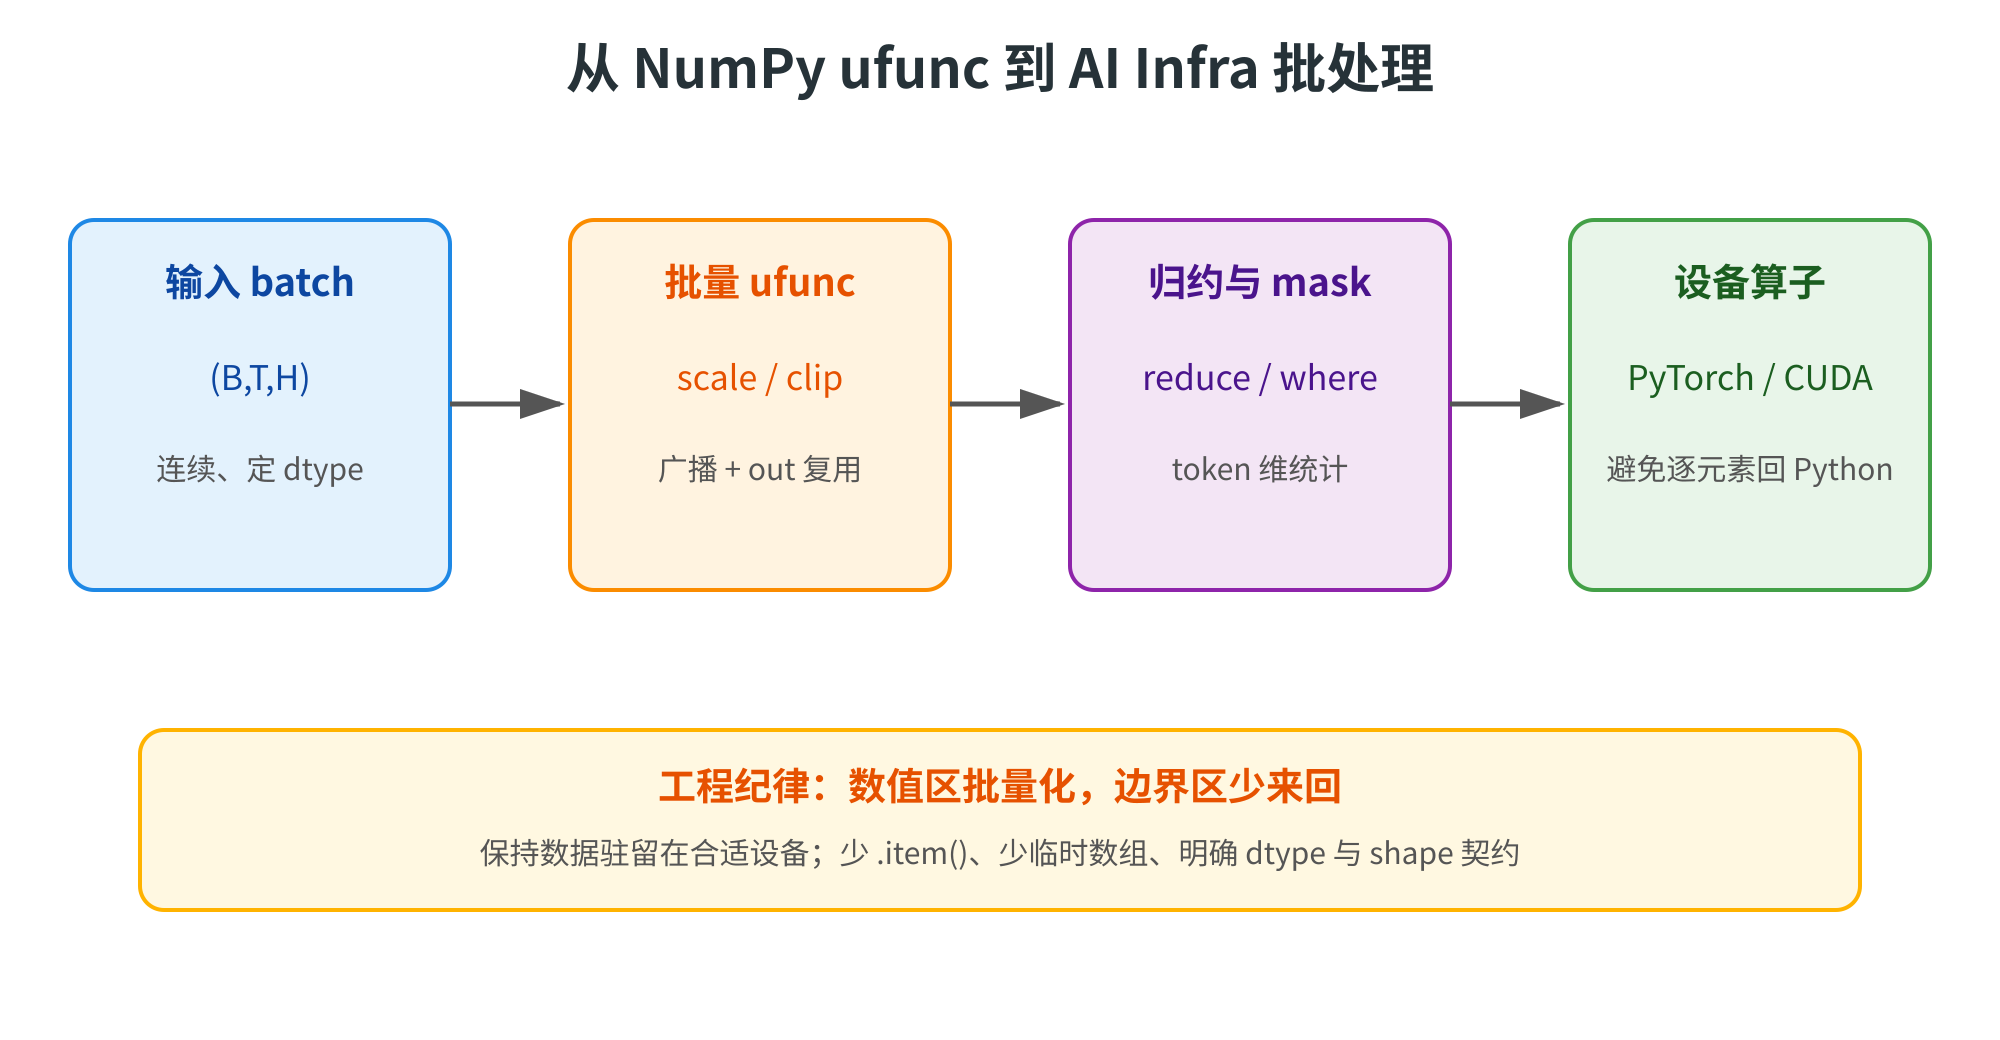
图5 从 NumPy ufunc 到 AI Infra 批处理:同一批量心智模型
六、综合案例:一个安全的 batch 预处理管线
6.1 需求与 shape 契约
假设收到形状 (B, T, H) 的激活,先做缩放和裁剪,再把无效位置置零,最后得到每个 token 的 L2 范数。这里用 NumPy 模拟 CPU 侧预处理,重点是 ufunc、广播、out 和归约的配合。
import numpy as np

B, T, H = 2, 3, 4
x = np.array([
    [[-2, 0, 1, 2], [3, 4, 5, 6], [7, 8, 9, 10]],
    [[1, -1, 2, -2], [0, 1, 0, 1], [4, 4, 4, 4]],
], dtype=np.float32)
scale = np.array([1.0, 0.5, 0.25, 0.1], dtype=np.float32)  # (H,)
valid = np.array([[True, True, False], [True, False, True]])  # (B,T)

work = np.empty_like(x)
np.multiply(x, scale, out=work)                       # (B,T,H) * (H,)
np.clip(work, -1.0, 1.0, out=work)                   # 原地裁剪
np.multiply(work, valid[..., None], out=work)        # (B,T,H)*(B,T,1)

norm = np.sqrt(np.add.reduce(work * work, axis=-1)) # (B,T,H)->(B,T)
print(work.shape, norm.shape)
print(norm.round(3))
(2, 3, 4) (2, 3)
[[1.    1.732 0.   ]
 [1.    0.    1.265]]
逐行解释:scale 依靠最后一轴广播;clip 和 multiply 复用 work,避免为每一步产生同 shape 的结果;valid[..., None] 把 (B,T) 变成 (B,T,1),沿特征轴广播;最后平方、沿 H 归约、开方。work * work 仍会产生一个临时数组,如果内存压力更高,可以另设平方缓冲,再用 np.multiply(work, work, out=squared)。
6.2 更严格地处理无效值与输出
上面的 valid 是布尔乘法,逻辑直观;另一种写法是 where,并先把输出填成零:
masked = np.zeros_like(x)
np.copyto(masked, x, where=valid[..., None])
print(masked[0, 2])
print(masked[1, 1])
[0. 0. 0. 0.]
[0. 0. 0. 0.]
np.copyto 不是 ufunc,但使用同样的广播掩码思想。若无效值不是「置零」而是「跳过统计」,应使用 where 参数或 masked array,并明确归约分母;把无效 token 直接置零会改变均方、均值等统计的含义。
6.3 用断言把 shape 契约写下来
assert x.shape == (B, T, H)
assert scale.shape == (H,)
assert valid.shape == (B, T)
assert np.broadcast_shapes(x.shape, scale.shape) == x.shape
assert np.broadcast_shapes(x.shape, valid[..., None].shape) == x.shape
这些断言在开发和测试阶段很便宜,却能把「把 batch 轴和 token 轴写反」的问题尽早暴露。进入生产后可以根据性能策略保留关键断言,或在边界处做一次校验。形状是接口契约,不应只靠读者猜。
七、踩坑大全
通用
坑 1:把列表推导式当成向量化。 现象:代码只有一行,但大 batch 仍然慢。原因是元素循环仍在 Python;解决:优先选择真正的 NumPy ufunc、where、clip 和归约。
坑 2:把 np.vectorize 当成编译器。 现象:包了一层之后速度没有改善。原因是它通常仍调用 Python 函数;解决:改写成 ufunc 组合,或评估 Numba / Cython / GPU 算子。
坑 3:只看表达式,不看临时数组。 现象:a * b + c * d 峰值内存很高。原因是多个中间结果同时存在;解决:用 out= 分步复用缓冲,或使用能做算子融合的框架。
坑 4:where 配合未初始化输出。 现象:掩码为 False 的位置出现随机数。原因是这些位置没有被写入;解决:先用 np.zeros_like / np.full_like 初始化 out。
坑 5:out shape 错误。 现象:ValueError 或结果被错误截断。原因是输出必须容纳广播结果,并满足 dtype 写入规则;解决:先算广播 shape,再分配匹配的输出。
坑 6:整数溢出被误认为 ufunc 出错。 现象:int8 相加得到负数。原因是固定宽度整数回绕;解决:进入计算前提升到合适的 int32 / float32,并测试边界值。
坑 7:归约轴写反。 现象:均值 shape 对了,但含义错了。原因是 axis=0 和 axis=1 的业务方向被混淆;解决:在注释里写 (B,T,H) 沿 H 归约,必要时使用 keepdims=True。
AI Infra / 环境
坑 8:NumPy 数组以为会自动上 GPU。 现象:CPU 处理仍是瓶颈。原因是 NumPy ufunc 只在 CPU 内存上执行;解决:明确迁移到 PyTorch / CuPy 等设备数组,并减少 CPU 与 GPU 间往返。
坑 9:在 GPU tensor 上逐元素 .item()。 现象:推理延迟突然升高。原因是每次取标量可能触发设备同步;解决:保持 batch tensor,最后一次性转为需要的格式。
坑 10:只用单个小样本做 benchmark。 现象:优化结论上线后失效。原因是固定调用成本、缓存和真实 batch 分布不同;解决:使用接近生产的 shape、dtype、线程数和预热流程测量。
坑 11:广播成功但业务轴错。 现象:结果没有报错,模型指标却下降。原因是 (H,) 被按最后一轴广播,未必是你想要的轴;解决:打印 shape、写 broadcast_shapes 断言,并抽查一个位置的手算值。
坑 12:链式原地修改破坏输入。 现象:后续步骤发现原始 batch 已被改写。原因是 out=x 或切片共享内存;解决:明确所有权,必要时 .copy(),并用 shares_memory 验证。
八、小结
- 向量化的本质:把高基数的元素循环从 Python 解释器下沉到 NumPy 的底层数组内核;列表推导式短,但仍是 Python 循环。
- ufunc 的流水线:收集输入 → 广播对齐 → dtype / casting 解析 → 底层循环写出。
+、*等运算符通常会调用对应 ufunc。 - dtype 影响正确性和性能:整数可能溢出,混合类型可能提升并产生临时数组;在数据入口明确
dtype,不要把转换成本藏在热循环里。 out=控制分配,where=控制写入:预分配输出并复用缓冲可以降低峰值内存;掩码输出必须初始化 False 位置。- 归约改变 shape:
reduce沿轴聚合,accumulate保留前缀,outer生成成对网格;keepdims=True是归约后重新广播的桥梁。 - 性能要靠测量:向量化通常快,但小数组、巨大临时量、复杂依赖和错误设备选择都可能让收益消失;
np.vectorize不是性能开关。
把本篇和第 31 篇连起来:广播回答「输入在哪些坐标相遇」,ufunc 回答「相遇后对每个坐标做什么」。再和第 29、30 篇连起来:dtype 决定元素解释,shape / strides 决定如何访问,视图决定是否共享缓冲。NumPy 的快不是魔法,而是这几层协议一起让底层内核高效工作。
九、课后练习
- (基础) 分别用
for、列表推导式和np.sqrt计算一百万个非负数的平方根,验证三者结果一致,并用time.perf_counter比较时间。 - (基础) 对形状
(2, 3, 4)的数组加上(4,)、(3, 1)和(2, 1, 1),先手算广播结果,再用np.broadcast_shapes核对。 - (理解) 用
np.add(..., out=buffer)完成 100 次数组加法,比较每次新建结果和复用缓冲的写法;用tracemalloc观察峰值内存。 - (理解) 构造含负数的数组,使用
np.sqrt配合where=,让非法位置保持-1;再故意使用未初始化out,观察为什么必须先填充。 - (理解) 对二维数组分别运行
np.add.reduce的axis=0、axis=1,再加上keepdims=True;解释每个结果能否直接与原数组广播。 - (进阶) 实现一个只使用 ufunc 的稳定 softmax:先沿最后一轴减最大值,再
exp,最后用add.reduce(..., keepdims=True)除回去;检查每行和是否接近 1。 - (进阶) 用
np.frompyfunc包装一个字符串函数,再与纯 NumPy 数值表达式做 benchmark,说明为何「返回 ufunc 对象」不代表底层没有 Python 调用。 - (进阶 · AI Infra) 把第 6.1 节的
(B,T,H)预处理改写成 PyTorch tensor 版本,记录 CPU NumPy 与 GPU tensor 的数据驻留、dtype、同步点和临时张量差异,写出一份 200 字迁移说明。
下一篇预告
下一篇是《第33篇|线性代数与矩阵乘法》——从逐元素计算进入「缩并」:向量内积、矩阵乘法、批量矩阵乘法、@ 与 np.matmul 的维度规则,以及它们如何成为 MLP、Attention 和线性层的数学骨架。记住:+、* 走本篇的逐元素 ufunc 规则;@ 不是把每个位置相乘,而是沿轴相乘后求和。
专栏三路线:ndarray 基础(29)→ 索引与视图(30)→ 广播(31)→ 向量化与 ufunc(本篇) → 线性代数与矩阵乘法(33) → 随机数与归约(34)→ stride 原理(35)→ 手写 MLP(36)。现在你已经知道如何高效执行一批相同的逐元素操作;下一篇把「一批乘加」组织成矩阵运算。
离开前做一个热身:创建 A.shape == (2, 3)、B.shape == (3, 4),分别试 A * B 和 A @ B,记录哪个是广播失败、哪个得到 (2, 4)。带着这个差异进入下一篇,会更容易理解矩阵乘法为什么需要另一套轴规则。