
第30篇|索引、切片与视图/拷贝
本篇定位:《Python 教程》专栏三「NumPy 数值计算」第二篇。承接第 29 篇的 dtype、shape、strides 与内存布局,正面吃透 怎么从 ndarray 里取数:整数索引、基本切片、花式索引、布尔掩码,以及贯穿始终的 视图(view)与拷贝(copy) 分界。
读完你将能够:用左闭右开规则熟练切片一维 / 多维数组;解释为何
a[1:4]改写会牵连原数组,而a[[1,3]]不会;用.base、flags.owndata、np.shares_memory做诊断;在需要隔离时主动.copy();把同一套规则映射到后续广播、向量化与 PyTorch Tensor 的 storage 共享。预计用时:阅读 35~45 分钟,动手 40~60 分钟。
第 29 篇把 ndarray 立成「带元数据的连续(或步进)缓冲区」:dtype 定元素宽度,shape 定形状,strides 定怎么跳。本篇回答下一问:取子块时,你是借了同一块缓冲,还是另开一张新表? 这一问答错,轻则训练日志里 loss 莫名抖动,重则「改了验证集却污染了训练集」——在 GPU 显存紧张时更致命。
建议边读边开 REPL:uv add numpy(若尚未安装),uv run python。阅读顺序:一维切片直觉 → 视图 / 拷贝对照 → 二维索引与降维 → 花式 / 布尔(必拷贝)→ 诊断工具与 AI Infra → 踩坑。和第 03、04 篇的「字符串 / 列表切片」对照:表面语法很像,语义差在「是否共享底层缓冲」。
一句话定心:基本切片多半是视图;整数数组与布尔掩码一定是拷贝;吃不准就 .copy(),吃得准就省一次分配。
本篇不展开广播规则(留给第 31 篇)、不穷尽所有高级索引组合、不替代第 35 篇对 stride 的底层深挖。主线是:索引语法 → 视图 / 拷贝心智 → 多维取数 → 花式 / 布尔 → 诊断与工程纪律。
动手时沿用「先切片再诊断」两步:先写出你以为正确的取数代码,再用 shares_memory / .base 验证有没有共享。做完后回头看第 04 篇的浅拷贝图,你会发现叙事完全平行——只是共享的层级从「Python 引用」沉到了「C 缓冲」。
和第 29 篇对照:那一篇回答「数组在内存里怎么排」;本篇回答「取走一块之后,所有权归谁」。两问合成一张完整底图,后面的广播、ufunc、线性代数才不会变成「调 API 碰运气」。写训练脚本时,索引错误往往比公式错误更难查——因为数值还能「看起来差不多」,共享污染却会让复现实验对不上。
一、一维索引与基本切片:语法熟,语义要换脑
1.1 整数索引:取出标量(或 0 维数组)
import numpy as np

a = np.arange(8)          # [0 1 2 3 4 5 6 7]
print(a[0], a[-1])        # 0 7
print(type(a[0]))         # <class 'numpy.int64'> —— 不是 Python int
0 7
<class 'numpy.int64'>
越界会 IndexError,与 list 一致。负索引从末尾数,也与序列协议一致。注意:取出的是 NumPy 标量类型,参与 Python 运算时通常会自动提升,但和纯 int 比 isinstance 时要小心。
1.2 基本切片:左闭右开,结果是视图
a = np.arange(8)
b = a[2:6]                # [2 3 4 5]
b[0] = 99
print(a)                  # [0 1 99 3 4 5 6 7] —— 原数组被改写!
[ 0 1 99 3 4 5 6 7]
这是本篇第一条铁律:基本切片返回视图,默认共享 data buffer。 列表切片 lst[2:6] 得到的是新 list(浅拷贝一层容器);ndarray 切片是「换一副眼镜看同一块内存」。
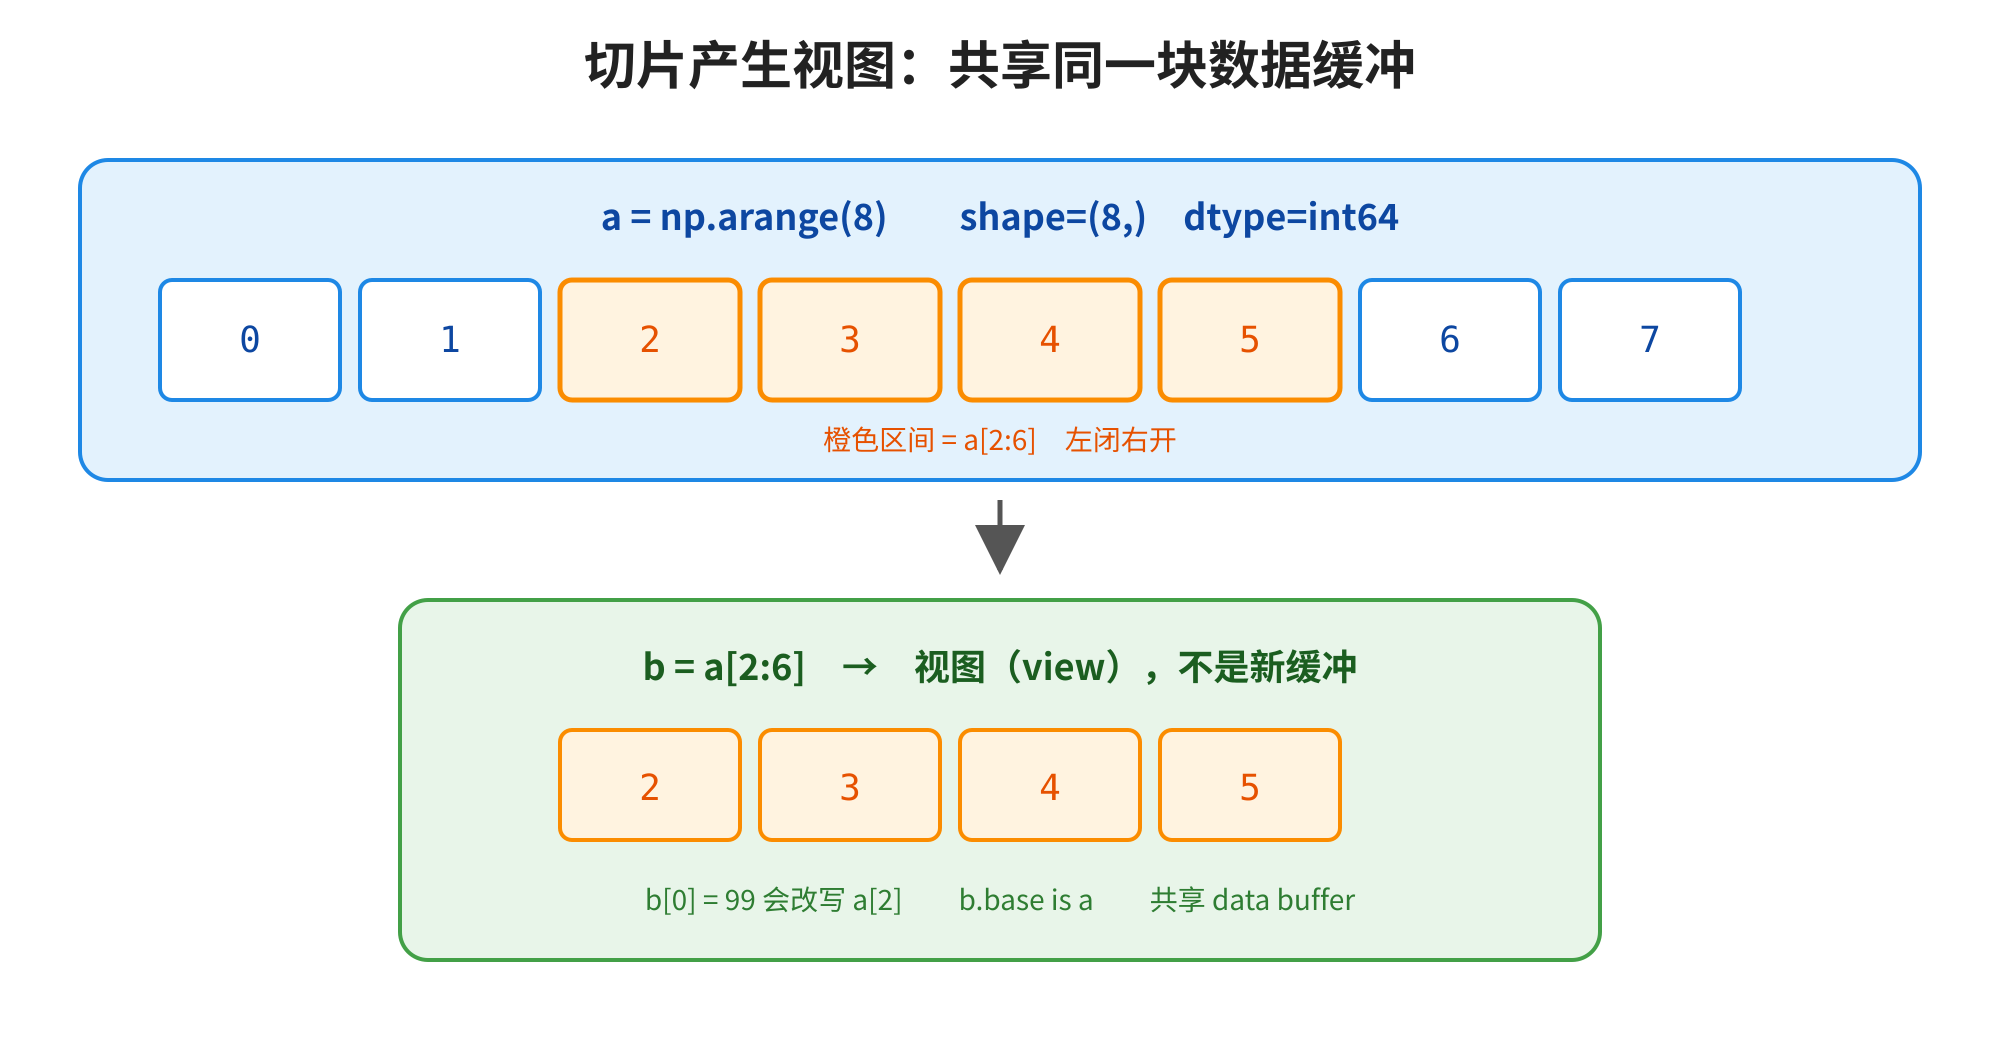
图1 切片产生视图:共享同一块数据缓冲
切片语法与序列相同:a[start:stop:step],可省略两端;step 可为负(反转)。带步长的切片 仍然是视图(只是 strides 变了):
c = a[::2]                # 隔一个取一个,仍是视图
print(c.flags.owndata)    # False
False
1.3 和 list 切片的心理对照表
AI Infra 视角:DataLoader 里若对同一 batch 缓冲做
batch[:, :seq_len]再 inplace 改,可能污染缓存的下一轮数据。训练管线里「切片后立刻.copy()/.clone()」常常不是洁癖,而是防串味。
也可以把基本切片想成「开了一扇窗」:窗子的大小和位置由 start/stop/step 决定,窗外的风景(缓冲)还是原来的那一片。列表切片更像「复印了几页目录」——目录是新的,但若条目指向可变对象,内容仍可能共享。两种模型都对,只是适用对象不同;混用会出事。
步长为负时,视图照样成立:a[::-1] 反转后改第一个元素,改的是原数组末尾。调试「反转后 inplace 归一化」这类代码,务必先确认你是否故意要写回。
二、视图与拷贝:本篇的核心分界
2.1 一张图定生死
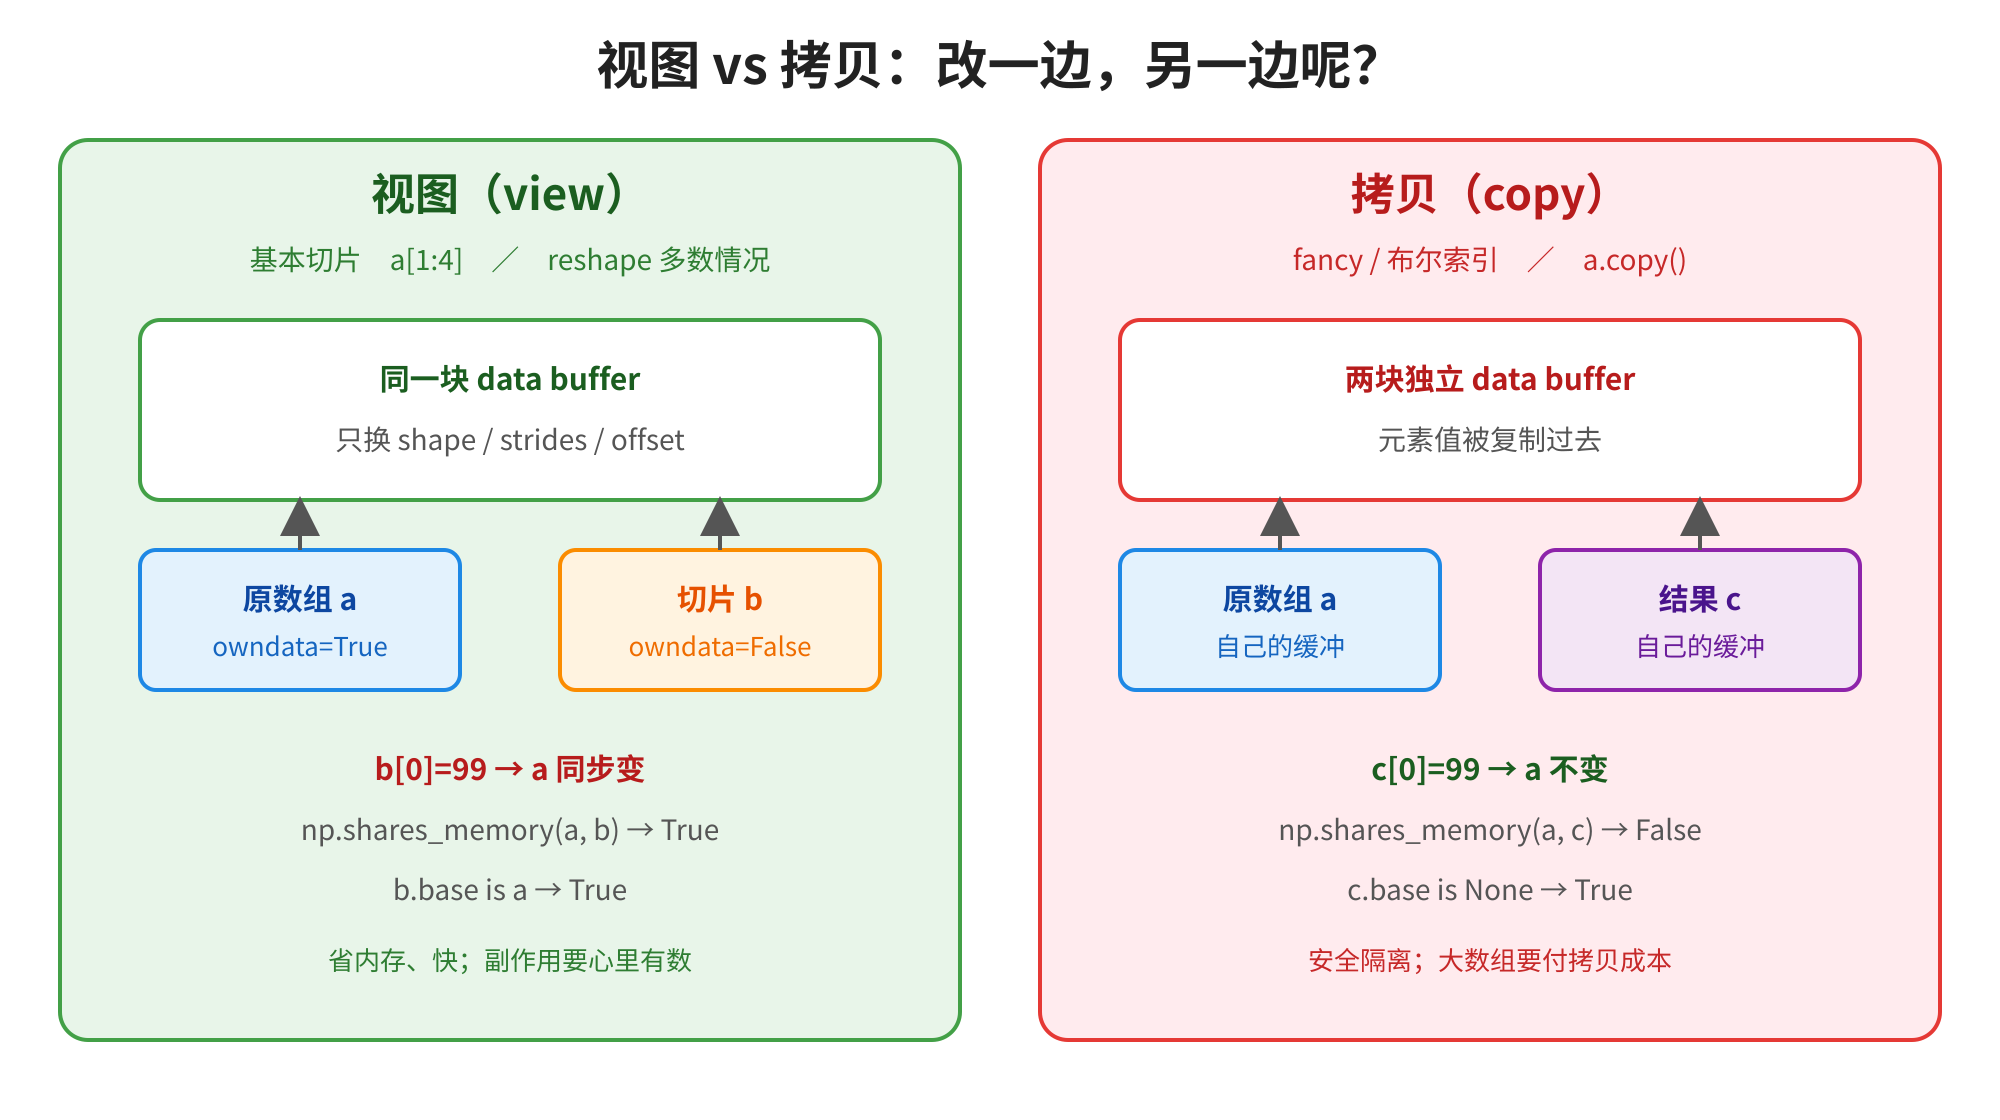
图2 视图 vs 拷贝:改一边,另一边呢?
- 视图:新的 ndarray 对象,但
data指针落在同一块(或同一块的子区间)缓冲上;改元素两边都看见。 - 拷贝:新对象 + 新缓冲;值被复制;两边互不影响。
a = np.arange(6)
v = a[1:4]                 # 视图
c = a[[1, 2, 3]]           # 花式索引 → 拷贝
v[0] = 100
c[0] = 200
print(a)                   # [0 100 2 3 4 5] —— 只有 v 牵连了 a
print(np.shares_memory(a, v), np.shares_memory(a, c))
[  0 100   2   3   4   5]
True False
2.2 谁产生视图?谁产生拷贝?
经验规则(够用 90% 场景):
没有单一的 is_view 官方开关——要用下一节的诊断工具组合判断。
2.3 为何 NumPy 默认给视图?
因为数值计算里 子块运算极常见:取一行做归一化、切一个时间窗做 FFT、把 (N, H, W, C) 里某通道拿出来。若每次切片都深拷贝,内存与带宽会爆炸。视图用「改 shape / strides / offset」表达子块,成本接近零。代价是:共享语义必须进入你的心智模型——和第 02 篇「名字绑定到对象、赋值不复制」同一家族,只是从 Python 对象引用升级到了 C 缓冲共享。
工程上还有一条软规则:函数参数默认当视图别名处理。 若你的函数会 inplace 修改传入的 ndarray,请在文档字符串写明会改输入;若保证不改输入,要么只读,要么入口处 .copy()。团队里统一这条,比事后用版本回滚找「哪次切片污染了 batch」便宜得多。
和 Python 赋值对比:b = a 让两个名字指向同一 ndarray 对象;b = a[1:4] 则是两个对象共享缓冲。前者是「同一个箱子」,后者是「两个箱子盖在同一堆零件上」。打印 id(a) == id(b) 只能鉴别前者;鉴别后者要靠 shares_memory。
reshape 是否返回视图,取决于元素顺序是否可通过改 strides 表达。C 连续数组做「不打乱线性顺序」的 reshape 通常是视图;若你先转置再 reshape,常被迫拷贝。吃不准就看返回值的 owndata,不要死背特例表。
三、多维索引:逗号、降维、保维
3.1 用一张图看清行、列、子块
a = np.arange(12).reshape(3, 4)
print(a)
# [[ 0  1  2  3]
#  [ 4  5  6  7]
#  [ 8  9 10 11]]
print(a[0])          # [0 1 2 3]  shape (4,) —— 整数索引降维
print(a[0, 2:])      # [2 3]
print(a[1:, :2])     # [[4 5] [8 9]]  shape (2, 2)
print(a[:, 1])       # [1 5 9]  shape (3,)
print(a[:, 1:2])     # [[1] [5] [9]]  shape (3, 1) —— 切片保维
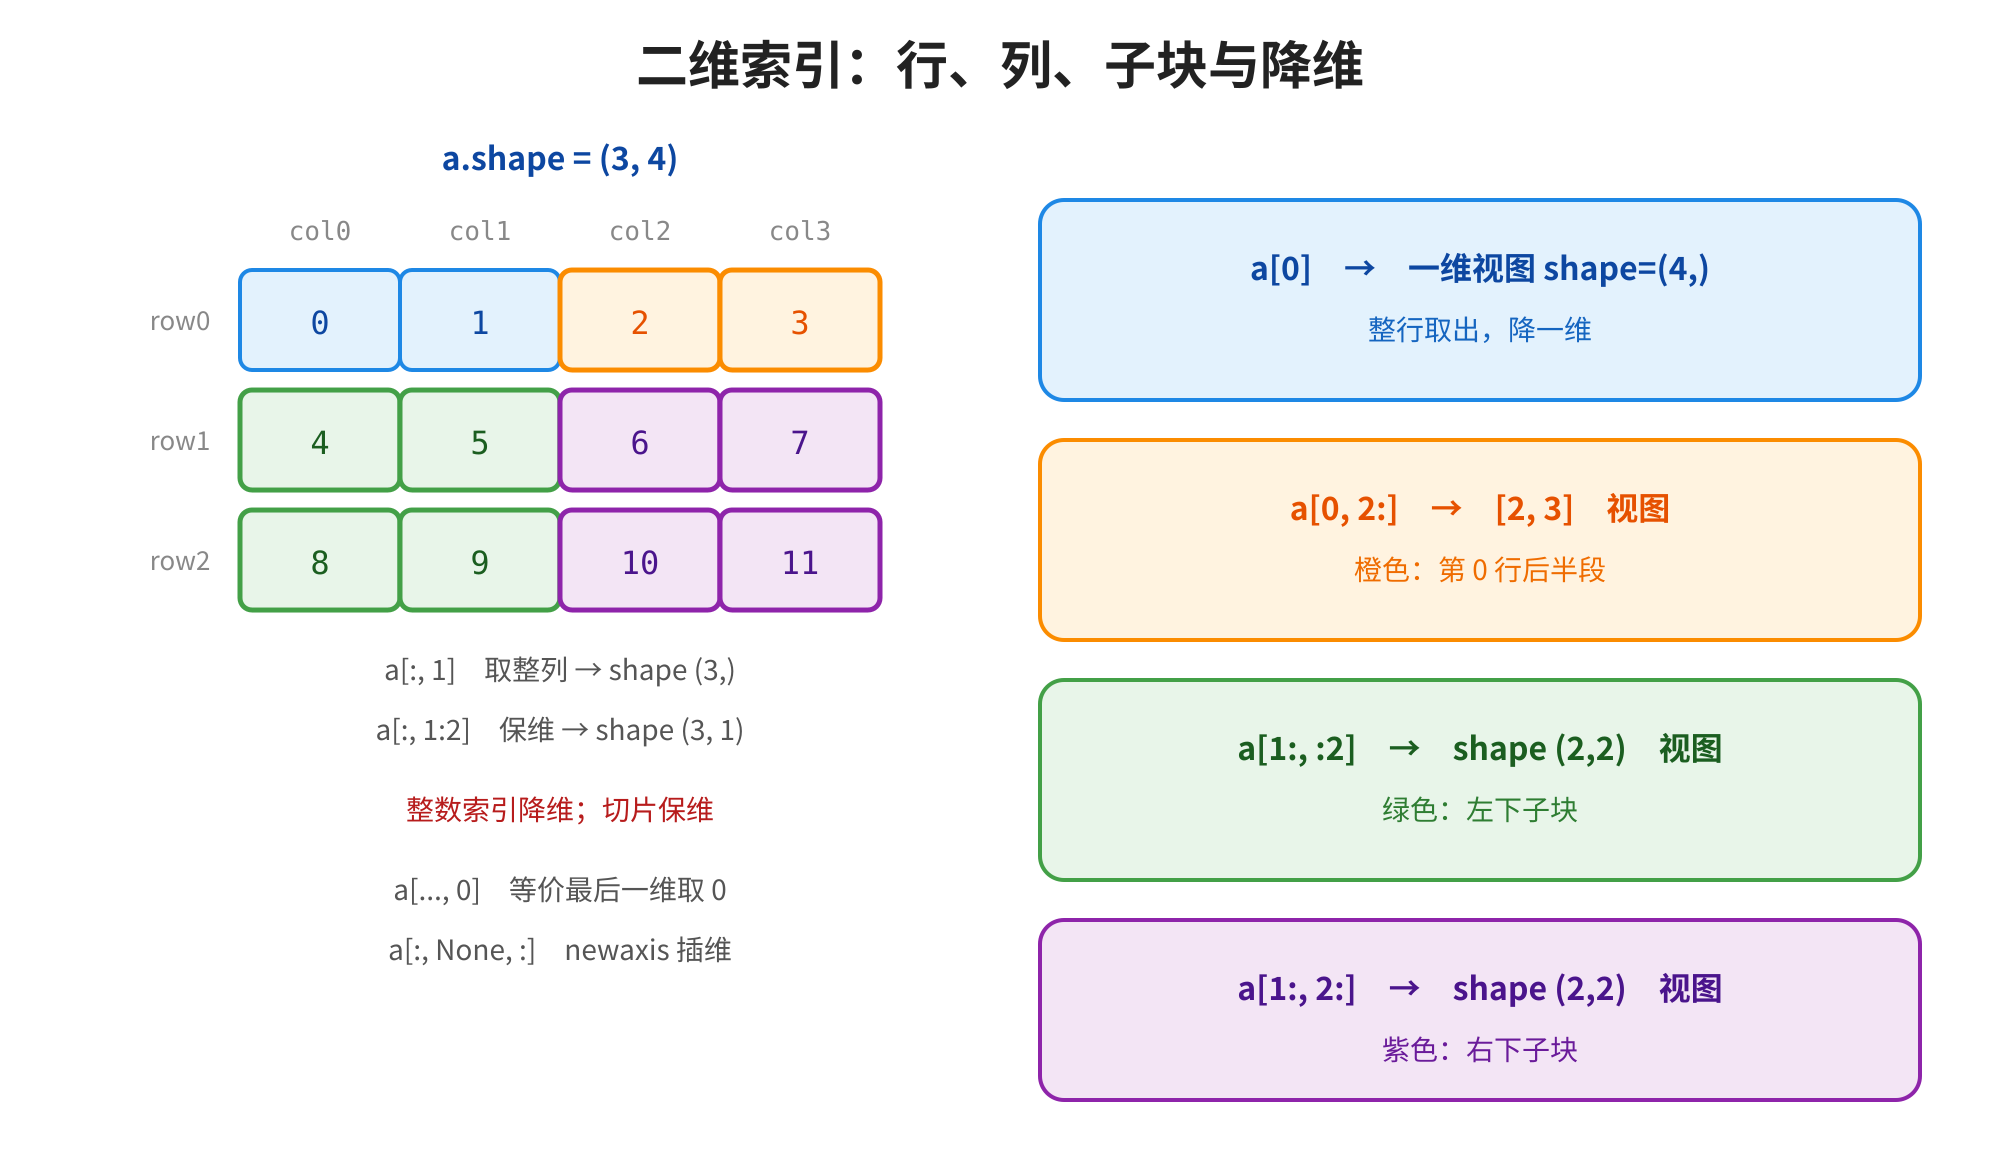
图3 二维索引:行、列、子块与降维
口诀再念一遍:
- 整数索引:该轴消失(降维)
- 切片:该轴保留(哪怕长度为 1)
- 需要「占位保维」时用
None/np.newaxis:a[:, None, :]在中间插入长度为 1 的轴(第 31 篇广播会大量用到)
3.2 省略号 ... 与多维捷径
x = np.zeros((2, 3, 4, 5))
print(x[0, ..., 1].shape)     # (3, 4) —— 中间维度全要
print(x[..., 0].shape)        # (2, 3, 4) —— 最后一维取 0
(3, 4)
(2, 3, 4)
... 表示「填满剩下的 :」,高维张量里比手写一长串冒号更不易错。图像 / feature map 代码里 feat[..., :hidden] 随处可见。
3.3 组合切片仍是视图
block = a[1:, 2:]
block[:] = -1
print(a)
[[ 0  1  2  3]
 [ 4  5 -1 -1]
 [ 8  9 -1 -1]]
多维基本切片组合 仍然共享缓冲。只有当你引入「整数数组作索引」或「布尔掩码」时,语义才切换到拷贝。
三维及以上时,建议固定一种「读索引」的口播方式:从左到右念轴含义,例如把 batch、通道、高、宽说清楚。口播能显著降低写错轴的概率。需要把某一通道单独拿出来做统计时,优先用切片(视图),而不是先转置再花式索引(容易拷贝且更慢)。
保维与降维的选择,会直接影响下一篇广播能否对齐。归约若丢掉了长度为 1 的轴,后续减法可能广播到错误方向——那时你会感谢今天强制自己写出保维切片,而不是随手用整数索引降维。
四、花式索引与布尔索引:结果总是拷贝
4.1 花式索引:用整数数组当下标
a = np.arange(10) * 10      # [0 10 20 ... 90]
idx = np.array([0, 2, 2, 7])
b = a[idx]
print(b)                    # [0 20 20 70]
b[0] = 999
print(a[0])                 # 0 —— 原数组未改
print(np.shares_memory(a, b))
[ 0 20 20 70]
0
False
花式索引允许 重复、乱序、任意可广播的索引数组。因为结果在内存上通常不连续,NumPy 选择 分配新缓冲并拷贝元素——这是设计取舍,不是 bug。
二维里可以「成对取点」:
m = np.arange(12).reshape(3, 4)
rows = np.array([0, 2])
cols = np.array([1, 3])
print(m[rows, cols])        # [1 11] —— 取 (0,1) 与 (2,3)
[ 1 11]
若写成 m[rows][:, cols],那是「先取行(花式→拷贝)再取列」,形状与共享语义都不同——读别人代码时要分清。
4.2 布尔索引:掩码挑选
a = np.array([1, 4, 2, 7, 5, 0])
mask = a > 3                # [False True False True True False]
print(a[mask])              # [4 7 5] —— 拷贝
a[a < 2] = -1               # 布尔索引支持赋值回写!
print(a)                    # [-1 4 2 7 5 -1]
[4 7 5]
[-1  4  2  7  5 -1]
注意两段语义:
- 读取
a[mask]:得到拷贝的一维(或按 True 位置拼出的)数组。 - 写入
a[mask] = value:直接改原数组对应位置——这是原地修改,不经过「先拷贝再写回」。
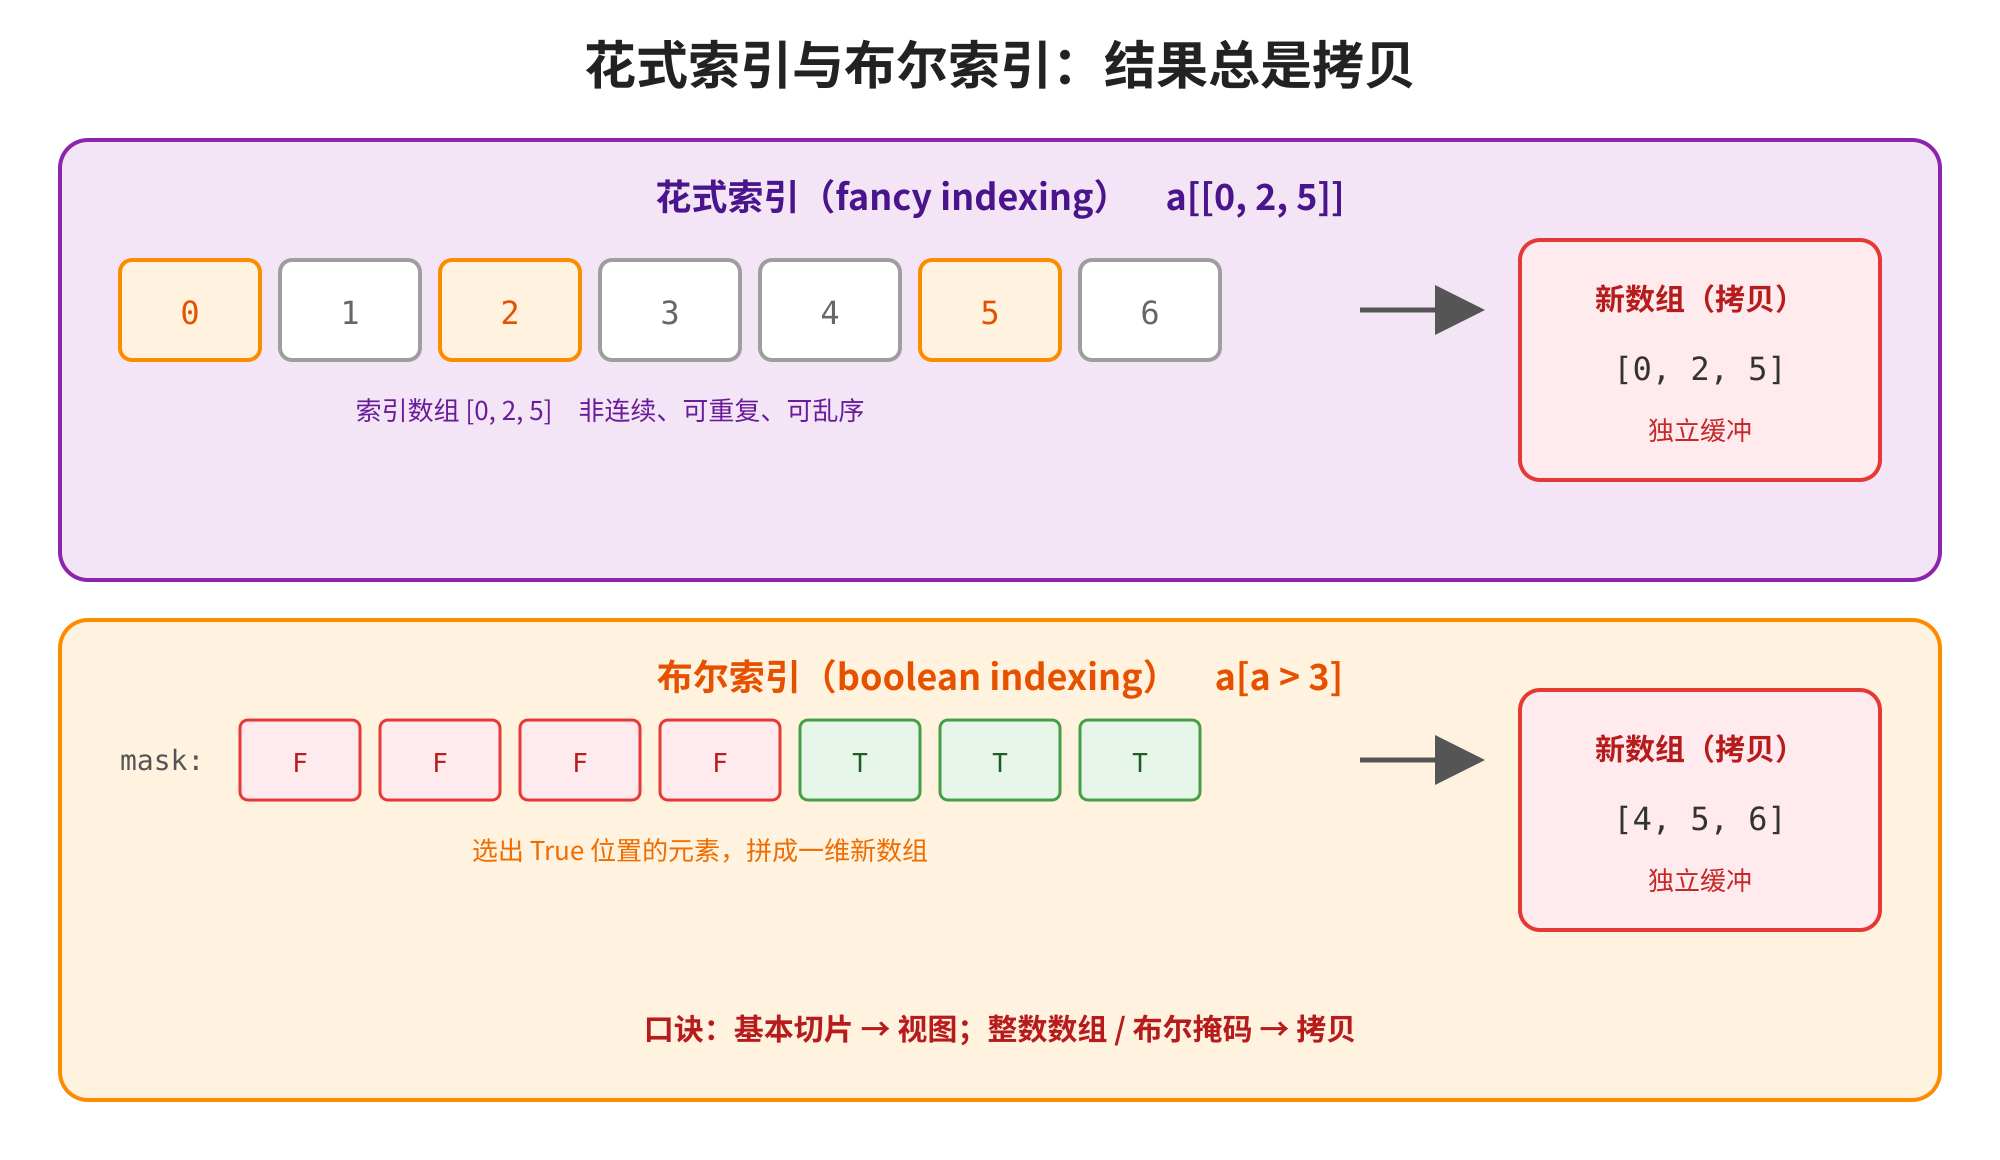
图4 花式索引与布尔索引:结果总是拷贝
4.3 口诀卡片(建议背下来)
基本切片 → 视图;花式 / 布尔读取 → 拷贝;布尔赋值 → 改原数组。
混淆这三项,是 NumPy 新手最常见的「幽灵 bug」来源。
布尔索引在数据清洗里几乎天天用:去缺失值、按阈值过滤、按标签掩码。记住读取是拷贝,意味着「滤完再改滤液」不会影响原杯药水;若你本意是改原数据,请用赋值形式。花式索引常出现在查表、负采样、按编号重排批次——这些场景本来就要新缓冲,拷贝语义反而正确;真正要警惕的是「以为共享结果却做了原地缩放」。
多维布尔掩码形状必须可对齐。对二维序列矩阵,用一维样本级掩码时,往往要先扩维——这又和广播篇提前握手了。眼下若报错,先打印双方形状,再决定是扩维还是换写法。
五、诊断工具:.base、owndata、shares_memory
5.1 三件套怎么用
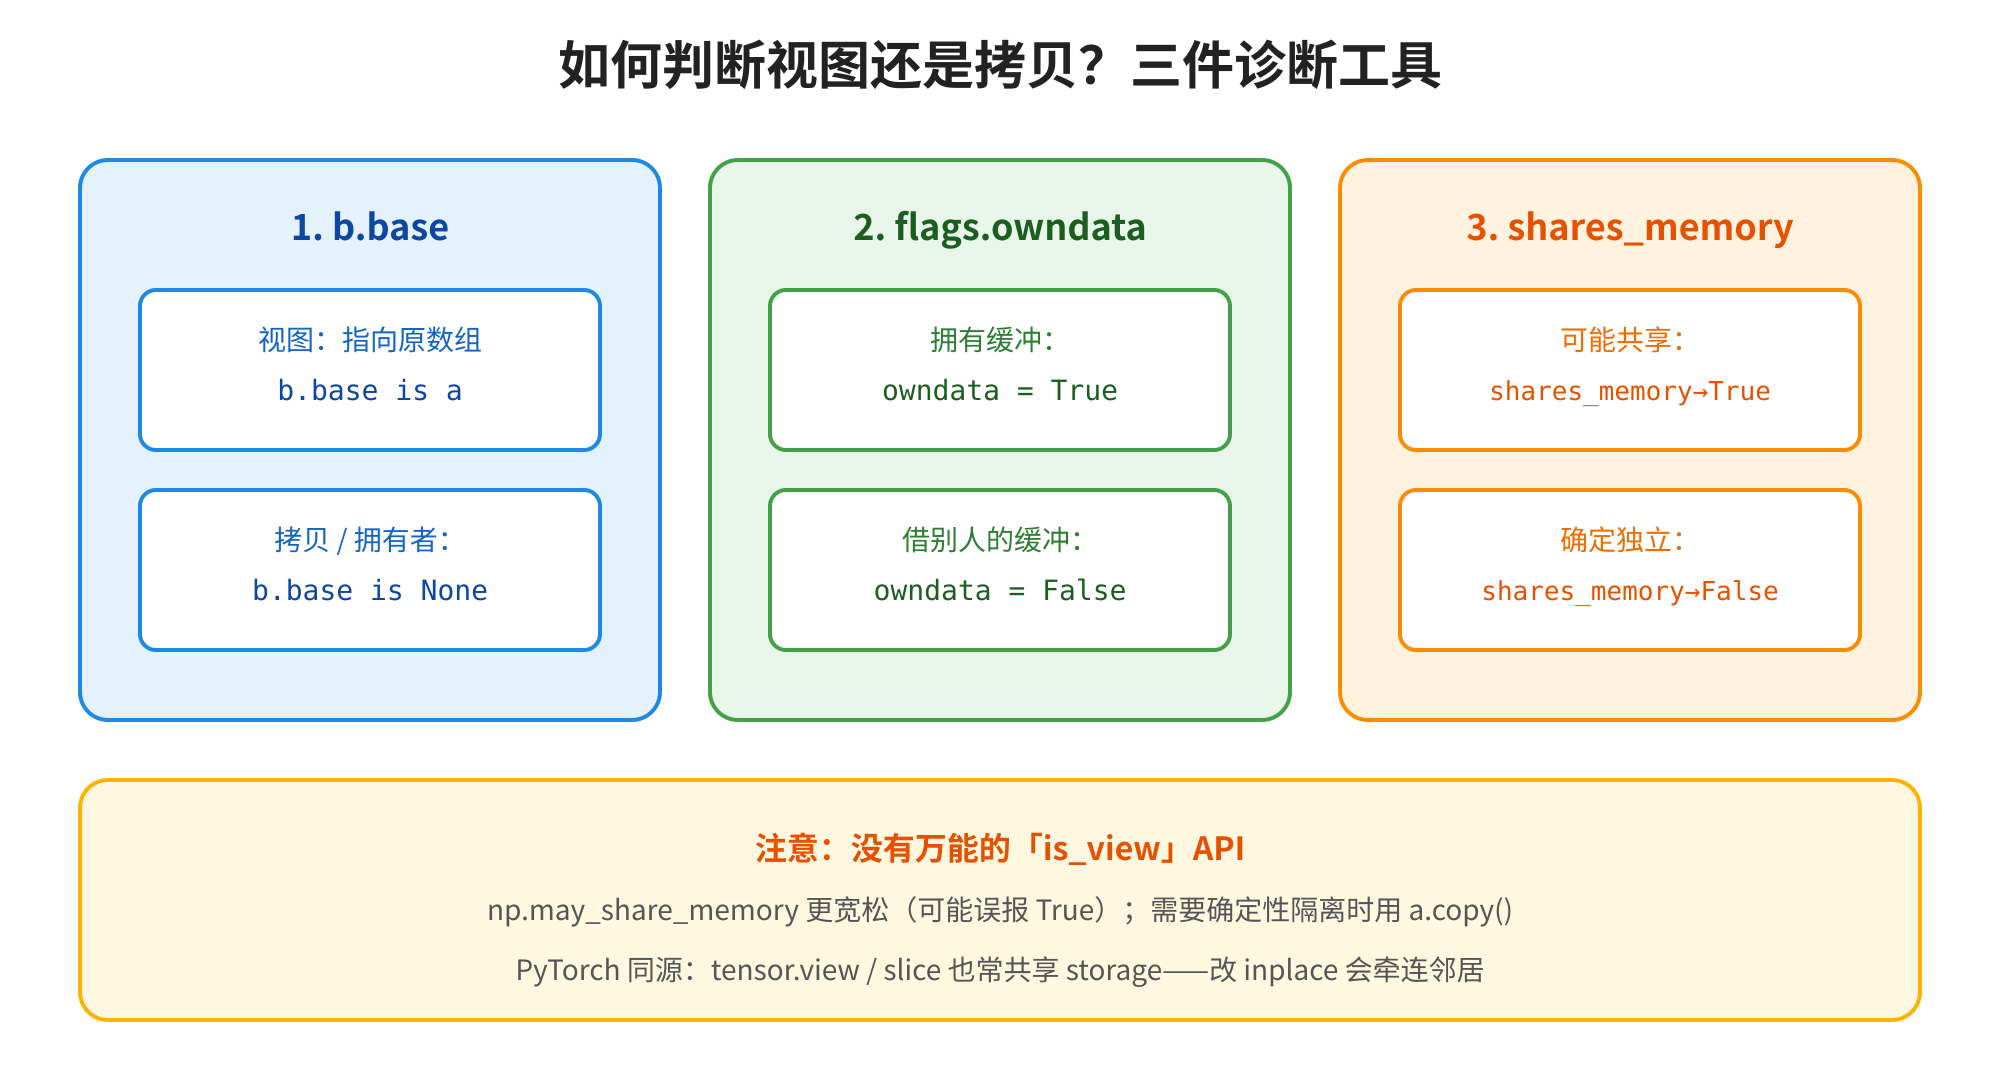
.base、owndata、shares_memory三个判断指标。图中以三个分区分别介绍:第一个分区说明,若对象为视图则base指向原数组的对应对象,若为拷贝则base为None;第二个分区说明,owndata为True代表对象拥有自身数据缓冲,为False则表示借用他人数据缓冲;第三个分区说明,shares_memory为True代表对象可能共享数据,为False则代表数据独立。图中还标注了注意事项,指出没有万能的“is_view”API,补充了相关工具的使用提示。图5 如何判断视图还是拷贝?三件诊断工具
心智上记住三问:
a = np.arange(8)
v = a[2:6]
c = a.copy()
f = a[[1, 3, 5]]

def diagnose(name, x, root):
    print(name,
          "base is root:", x.base is root,
          "owndata:", x.flags.owndata,
          "shares:", np.shares_memory(x, root))

diagnose("v", v, a)
diagnose("c", c, a)
diagnose("f", f, a)
v base is root: True owndata: False shares: True
c base is root: False owndata: True shares: False
f base is root: False owndata: True shares: False
解读:
x.base is a:强烈暗示「我是 a 的视图」(注意:链式视图时base可能指向中间对象,需沿链追到拥有者)。flags.owndata:我是否拥有自己的数据缓冲。np.shares_memory(x, y):两数组是否可能共享任意字节(实用且直观)。
另有 np.may_share_memory:更宽松,可能把其实不共享的情况也报 True(保守近似)。需要「必须隔离」时,不要赌,直接 x = x.copy()。
5.2 何时必须显式拷贝?
- 切片结果要 长期独立保存(缓存、checkpoint、跨请求复用)。
- 把数组交给 可能 inplace 修改 的函数(不少老数值库默认改输入)。
- 从大数组切出小块后,希望大数组能被 GC / 释放——若小块仍是视图,会 拖住整块缓冲(经典内存泄漏形态)。
- 与 PyTorch 互转前后需要明确所有权(专栏四会展开)。
# 反例:小视图拖住大数组
big = np.zeros((10_000_000,))
small = big[100:110]          # 视图
del big                       # small.base 仍引用那 80MB
# 正确:small = big[100:110].copy()
5.3 AI Infra 视角:从 NumPy 视图到 Tensor storage
PyTorch 的 tensor[1:5]、view、transpose 同样经常共享 storage;tensor.clone() / tensor.contiguous() 对应「我要独立 / 我要连续」的显式请求。KV Cache 里按 layer 切片、按 batch 取子序列,几乎全是视图思维;错误的 inplace 写会污染下一 token 的状态。本篇练熟的「先问共享、再问拷贝」,到 GPU 上只会更值钱。
AI Infra 视角:显存泄漏排障时,常问「这个窄切片是否仍 base 到整段 KV?」——和 NumPy 小视图拖住大数组是同一张图。第 35 篇讲 stride 时会把这张图画到字节级;第 37 篇互转时会强调
torch.from_numpy默认也共享缓冲。
诊断时建议形成肌肉记忆:一疑共享,先 shares_memory;二要追根,看 .base;三看所有权,读 owndata。三者一致才下结论。若只看 may_share_memory 为真就断言「一定是视图」,可能误判——它是「可能共享」的保守探针,适合快速排除「绝不可能共享」,不适合当最终证据。
在库函数边界,还有一个实用套路:用 np.array(x, copy=True, order="C") 强制连续拷贝,既断开共享,又让后续线性代数例程更开心。热点路径再考虑零拷贝优化;先正确,再谈快。
六、综合练习场:把规则用到手顺
6.1 归一化一行但不污染原矩阵
def row_normalize_safe(m: np.ndarray, i: int) -> np.ndarray:
    row = m[i].copy()                 # 显式隔离
    s = row.sum()
    if s != 0:
        row /= s
    return row

m = np.arange(12, dtype=float).reshape(3, 4)
r = row_normalize_safe(m, 1)
print(m[1])                           # 原行不变
print(r)
若写成 row = m[i]; row /= row.sum(),原矩阵第 i 行会被除法改写——有时你就是想 inplace,但函数名与文档必须说清楚。
6.2 布尔筛选后再改,别以为改的是视图
a = np.array([1.0, 2.0, 3.0, 4.0])
b = a[a > 2]                          # 拷贝
b *= 0
print(a)                              # [1. 2. 3. 4.] 未变
a[a > 2] *= 0                         # 赋值语法走原数组路径
print(a)                              # [1. 2. 0. 0.]
[1. 2. 3. 4.]
[1. 2. 0. 0.]
同一句「选出 >2 的再乘 0」,先取出再乘与 掩码赋值 完全不同。代码评审时盯紧这一类。
6.3 与第 29 篇 strides 的衔接(预告第 35 篇)
a = np.arange(12).reshape(3, 4)
print(a.strides)
print(a[:, ::2].strides)              # 列步长变大,仍是视图
切片改的是「怎么走」,不是「把数搬到哪」。真正搬数的是花式 / 布尔 / copy / 某些 reshape 失败回退。把这句话留下,第 35 篇会用字节地址验算。
再补一个「切片加赋值广播」的小实验,帮助你和下篇接轨:对全零矩阵执行「某一列赋标量」「某一行赋一维向量」,赋值成功依赖广播规则;若右侧形状离谱,会立刻报错。把「索引选出的区域」当成临时左值,广播作用在左值形状与右值形状之间——心智上先建立,细节留到第 31 篇。
写完本篇示例后,不妨把关键函数收进练习脚本,用 uv run 反复跑。数值课的记忆曲线很陡:三天不碰,视图与拷贝又会混。短脚本比高亮笔记更抗遗忘。
七、踩坑大全
通用
坑 1:以为 a[:] 像 list 一样是拷贝。 现象:改了「副本」原数组也变。解决:用 a.copy();需要 Fortran 顺序等再传 order=。
坑 2:花式索引赋值形状广播踩坑。 现象:a[[0,1]] = x 时 x 形状不匹配报错或意外广播。解决:先打印 a[[0,1]].shape,再对齐右值;复杂时拆成循环或 np.put。
坑 3:a[0] 与 a[0:1] 混用。 现象:下游函数要二维却拿到一维。解决:保维用切片或 a[0:1, :] / keepdims 思路。
坑 4:布尔掩码与数组长度不一致。 现象:IndexError: boolean index did not match。解决:掩码必须与被索引轴形状可对齐;先 assert mask.shape == a.shape。
坑 5:小视图拖住大数组导致内存打满。 现象:del big 后 RSS 不降。解决:切片后 .copy();或避免从巨型临时数组取长期视图。
坑 6:链式索引的「拷贝还是视图」直觉失灵。 现象:a[0][1] = 9 有时改得动有时改不动(尤其涉及花式中间结果)。解决:写 a[0, 1] = 9 一次性索引;避免 ][ 链式。
坑 7:ravel / flatten 分不清。 现象:改了 flatten() 结果原数组不变,改了 ravel() 却变了。解决:要隔离用 flatten 或 copy;要省内存且接受共享用 ravel。
与环境 / 工具叠加
坑 8:Jupyter 里「看起来没变」。 现象:只打印了旧变量名。解决:改完后重新输出 a;注意 Out 历史引用的是旧对象展示。
坑 9:torch.from_numpy(a) 后改 Tensor。 现象:NumPy 侧也被改。解决:互转默认共享;要隔离先 a.copy() 或 tensor.clone()(专栏四详述)。
坑 10:Windows 大数组拷贝导致内存错误。 现象:MemoryError。解决:减少不必要 fancy 索引;分块处理;确认 64 位 Python。
坑 11:把视图结果写入 pickle / 跨进程队列。 现象:序列化时悄悄变成拷贝,或共享语义消失。解决:跨进程边界当作拷贝语义设计;用 multiprocessing 共享内存时走显式 API。
与后续篇章相关
坑 12:尚未学广播就写 a[i] = b。 现象:形状不齐却意外成功(广播写入)。解决:第 31 篇会系统讲;眼下赋值前先 print(a[i].shape, b.shape)。
坑 13:对视图做 resize。 现象:连带改写了原数组尺寸或直接失败。解决:resize 作用于拥有数据的数组;对视图先拷贝再改大小,或改用返回新数组的接口并读清文档。
坑 14:误用链式两层括号赋值期望总是写回。 现象:中间结果若是标量或拷贝,赋值落空。解决:统一写成一次逗号索引到位;多维不要拆成两次方括号。
八、小结
合上文章后,试着用自己的话说明:为何 a[1:4][0]=1 会改原数组,而 a[[1,2,3]][0]=1 不会;二维里整数索引与切片在「降维 / 保维」上的差别;三件诊断工具各自回答什么问题。讲得清,才算真的会了。
- 基本切片(含多维组合、步长):默认 视图,共享 data buffer;改元素即改原数组。
- 花式索引 / 布尔读取:默认 拷贝;布尔 赋值 则写回原数组。
- 整数索引降维,切片保维;
None/newaxis插维;...省略中间轴。 - 诊断三件套:
.base、flags.owndata、np.shares_memory;必隔离时.copy()。 - 小视图拖住大数组 是真实的内存陷阱;长期持有的子块优先拷贝。
- 与 list 切片同形异义:语法可迁移,共享语义不可想当然。
若只能带走一张图:图 2(视图 vs 拷贝)。若只能带走一句纪律:基本切片当别名;花式布尔当快照;吃不准就 copy。
动手清单:跑通文中所有代码块 → 自己构造一个「切片改写污染原矩阵」的最小复现 → 再用 .copy() 修好 → 用三件套打印证据。五步做完,比只「看懂文章」扎实一个数量级。
和专栏一串起来:第 02 篇的引用模型、第 04 篇的浅拷贝,到本篇升级为 缓冲级共享。和专栏四预告:Tensor 的 storage / view / clone 是同一故事的 GPU 方言。
也可以用「三个不要」自检:不要把整表切片当拷贝;不要对花式结果做「改完期望写回」;不要长期持有指向巨型临时数组的小视图。
再留一个三十秒口述稿给同事:基本切片是别名,花式布尔读取是快照,布尔赋值改本体;诊断靠三件套;保维还是降维决定广播能不能接得上。对方能独立画出图 2,就可以一起审查数值相关改动了。
本篇技能会立刻复利:读开源训练代码时先搜切片与拷贝;写数据加载后处理时默认考虑污染;和同事争论「要不要拷贝」时用三件套拿证据,而不是凭感觉。
把故事连起来:dtype/shape/strides(29)→ 本篇索引与视图 → 广播(31)→ 向量化(32)。索引是「取数」,广播是「对齐形状再算」,两者经常在同一行代码里相遇。
九、课后练习
- (基础) 创建
a = np.arange(10),令b = a[3:7],改b[1],断言a[4]同步变化;再令c = a[3:7].copy(),改c[1],断言a不变。 - (基础) 对
np.arange(12).reshape(3,4),分别打印a[1]、a[1:2]、a[:, 2]、a[:, 2:3]的 shape,并用一句话注释「降维还是保维」。 - (基础) 用布尔索引把一维数组中所有偶数变为
-1(写a[a % 2 == 0] = -1),再对比「先b=a[a%2==0]; b[:]=-1」为何无效。 - (理解) 写函数
takes_row(m, i, *, copy=True):按开关返回视图或拷贝;用np.shares_memory写 pytest 或 assert 覆盖两种分支。 - (理解) 构造花式索引
a[[0,0,1]],证明结果是拷贝;再演示索引可重复导致的长度变化。 - (理解) 复现「小视图拖住大数组」:分配大数组、取小视图、
del大数组名,用small.base(或内存工具)说明缓冲仍在;改为.copy()后再观察。 - (进阶) 二维「成对取点」
m[rows, cols]与m[rows][:, cols]的结果差异用具体数字说明,并判断各自是否共享原数组内存。 - (进阶 · AI Infra) 写 200 字笔记:把本篇视图 / 拷贝对照到 PyTorch 的
slice/view/clone/contiguous(可查文档,不要求跑 GPU),并举例一个「KV Cache 切片误 inplace」可能造成的后果。
下一篇预告
下一篇是《第31篇|广播机制》——NumPy 里让不同 shape 的数组「对齐后再算」的规则集。你会看到:长度为 1 的轴如何伸缩、为何 (3,1) 能和 (1,4) 加成 (3,4)、广播失败时的报错怎么读,以及它如何支撑向量化、避免手写三重循环。本篇的 newaxis 与保维切片,正是广播的前门砖。
专栏三路线:ndarray 基础(29)→ 索引视图(本篇) → 广播(31) → 向量化 ufunc(32)→ 线性代数(33)→ 随机统计(34)→ stride 原理(35)→ 手写 MLP(36)。带着「先问共享再问计算」的纪律往下走:广播再强大,也先要搞清你操作的是不是同一块缓冲。
若想提前热身:在 REPL 里试 np.arange(3).reshape(3,1) + np.arange(4).reshape(1,4),盯着结果 shape 想「谁在膨胀」——带着问题进下一篇。
也可以把本篇对照复习:抽一张纸画 a[1:4] 与 a[[1,2,3]] 的内存框,标上 base / owndata;能不看文章画对,广播篇的 shape 游戏会轻松很多。下一篇见。
进入广播篇之前,可把本篇练习脚本留在仓库:专门断言视图与拷贝。广播篇学完后,你可以给同一文件加「切片左值赋值」用例——索引与广播本就是一对搭档。
若时间充裕,再多做一件事:打开任一数值项目或自己的旧笔记,搜索方括号与拷贝调用,抽三处判断「这里共享是否有意」。这种阅读比空背规则更能把分界刻进肌肉记忆。
写索引或查缺陷时再记一条:诡异数值往往来自共享与形状(视图污染、降维后广播错位),而不是公式写错一个符号。和「调用栈很长但根因很浅」相比,先打印形状与共享探测能省很多时间。