
第28篇|实战:用纯 Python 写一个最小 Agent(工具调用循环)
本篇定位:《Python 教程》专栏二「Python 进阶与工程」收官篇。承接第 26 篇 HTTP / 大模型 API、第 27 篇 FastAPI 推理服务,正面用手写一遍 Agent 工具调用循环:
messages→ 模型 →tool_calls→execute→append→ 再问模型。不引入 LangChain 等框架,只靠列表、字典与函数,把「Agent 魔法」拆成可读的 while。读完你将能够:用自己的话解释 Agent 与单次 Chat Completions 的差别;设计
toolsJSON Schema 与本地REGISTRY;实现带max_steps的工具循环;用假模型跑通可重复 demo,并知道如何换成第 26 篇的真实 HTTP 客户端;说出白名单、参数校验与观测的底线。预计用时:阅读 40~50 分钟,动手 60~90 分钟。
第 26 篇教你「发一封信」;第 27 篇教你「开一个店收信」。本篇把两者接到一条 循环 里:模型可以不只回一段文字,还可以 点菜——点的是你注册过的工具;你执行完把结果写回对话历史,再让模型组织最终回答。一句话定心:Agent = while 循环 + messages + tool schema + execute + append。
建议边读边建练习目录:uv init --no-package。本篇示例 默认不依赖 API Key:用一个确定性的 FakeLLM 演示协议;有 Key 时再把 chat() 换成第 26 篇的 httpx POST。阅读顺序:循环心智 → 四种 role → Schema 与注册表 → 完整最小实现 → 真模型对接 → 安全与 AI Infra → 踩坑。
和「装一个 Agent 框架就完事」相比,本篇的正确价值是:你会在框架源码里认出同一套列表与字典,并能在框架不够用时自己改循环。 和第 07~08 篇对照:工具是带名字的函数;和第 18 篇对照:Schema 是给模型看的「类型注解」;和第 11 篇对照:执行失败要变成可回传的字符串,而不是默默炸掉整个进程。
动手时沿用「假模型 → 真协议 → 真 LLM」三步:先让 FakeLLM 按脚本吐出 tool_calls;再确认 messages 形状与 OpenAI 兼容一致;最后把 chat() 换成真实端点。做完后打开任意开源 Agent,你会在 run / step / agent_loop 里看见熟悉的 while。
本篇不穷尽多 Agent 协作、不替代完整安全审计、不绑定某一家框架。主线是:循环骨架 → messages → schema → execute/append → 真假模型切换 → 生产纪律(步数上限 / 白名单 / 可观测)。写代码时保持工程直觉:只执行登记过的工具;参数先校验再调用;每一步打日志;循环必须有出口。
一、Agent 心智:不是一次问答,是带工具的循环
1.1 一张图看清骨架
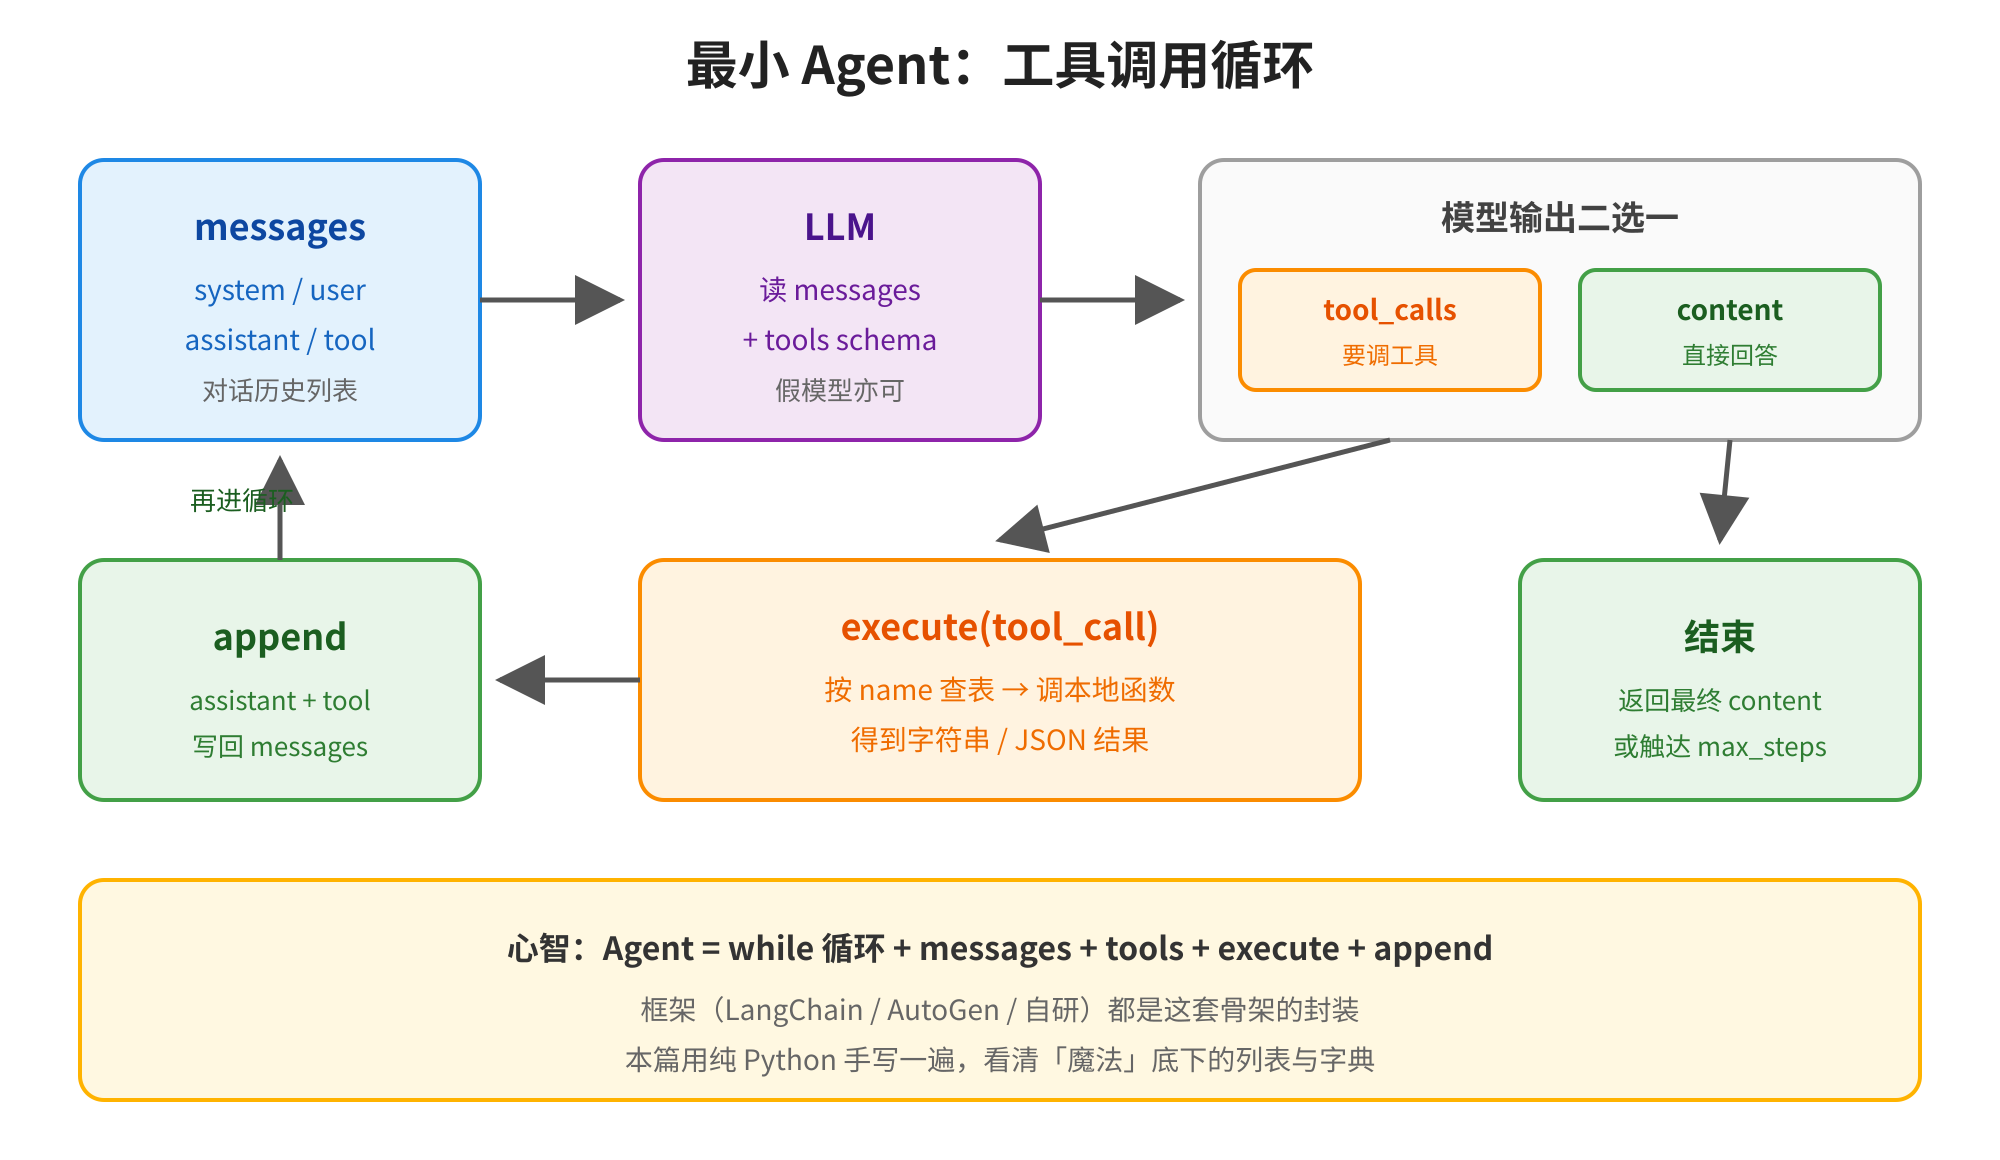
图1 最小 Agent:工具调用循环
单次 Chat Completions 是「问一句、答一句」;Agent 是「问一句,模型可能先调工具,再调几轮,最后才答」。框架把循环藏进 agent.run();本篇把它摊开。
1.2 和专栏二的挂钩
- 第 26 篇:
chat()的物理层是 HTTP POSTchat/completions,tools进请求体。 - 第 27 篇:工具也可以是「打你自己的 FastAPI」——
execute里发 httpx。 - 第 18 篇:Pydantic / dataclass 适合做参数校验层。
- 第 22 篇:循环与工具函数都该有单测(假模型最适合测协议)。
AI Infra 视角:推理侧关心吞吐与 KV Cache;Agent 侧关心 步数、工具延迟、失败重试与轨迹可回放。评测一个 Agent,往往是「同一题跑 N 次轨迹」——没有清晰的 messages append,就没有可回放的轨迹。
1.3 最小「假循环」直觉
先别管 JSON Schema,用伪代码感受出口:
messages = [{"role": "user", "content": "北京气温?"}]
for step in range(8):  # max_steps
    reply = model(messages, tools)
    if not reply.tool_calls:
        print(reply.content)
        break
    messages.append(reply.as_assistant_message())
    for call in reply.tool_calls:
        messages.append({"role": "tool", "tool_call_id": call.id, "content": run(call)})
要点就三句:有步数上限;有 tool 就执行并写回;没有 tool 就结束。 后文把 model / run / 消息形状写实。
也可以把「单次聊天」看成 max_steps=1 且 tools=[] 的退化 Agent:没有工具可点,模型只能直接 content。反过来,Agent 只是把这层限制打开,并要求你在打开时补上白名单与出口。这种退化视角有助于和产品经理沟通:「我们不是换了另一种模型,而是换了一种调用方式。」
在团队里推广时,优先交付可跑的假模型轨迹,而不是先争论选哪家框架。轨迹能评审、能单测、能当文档;框架选型可以第二周再做。和「先上平台再补协议」相比,先协议后平台通常返工更少。
二、messages:四种角色与历史只增不改
2.1 角色表
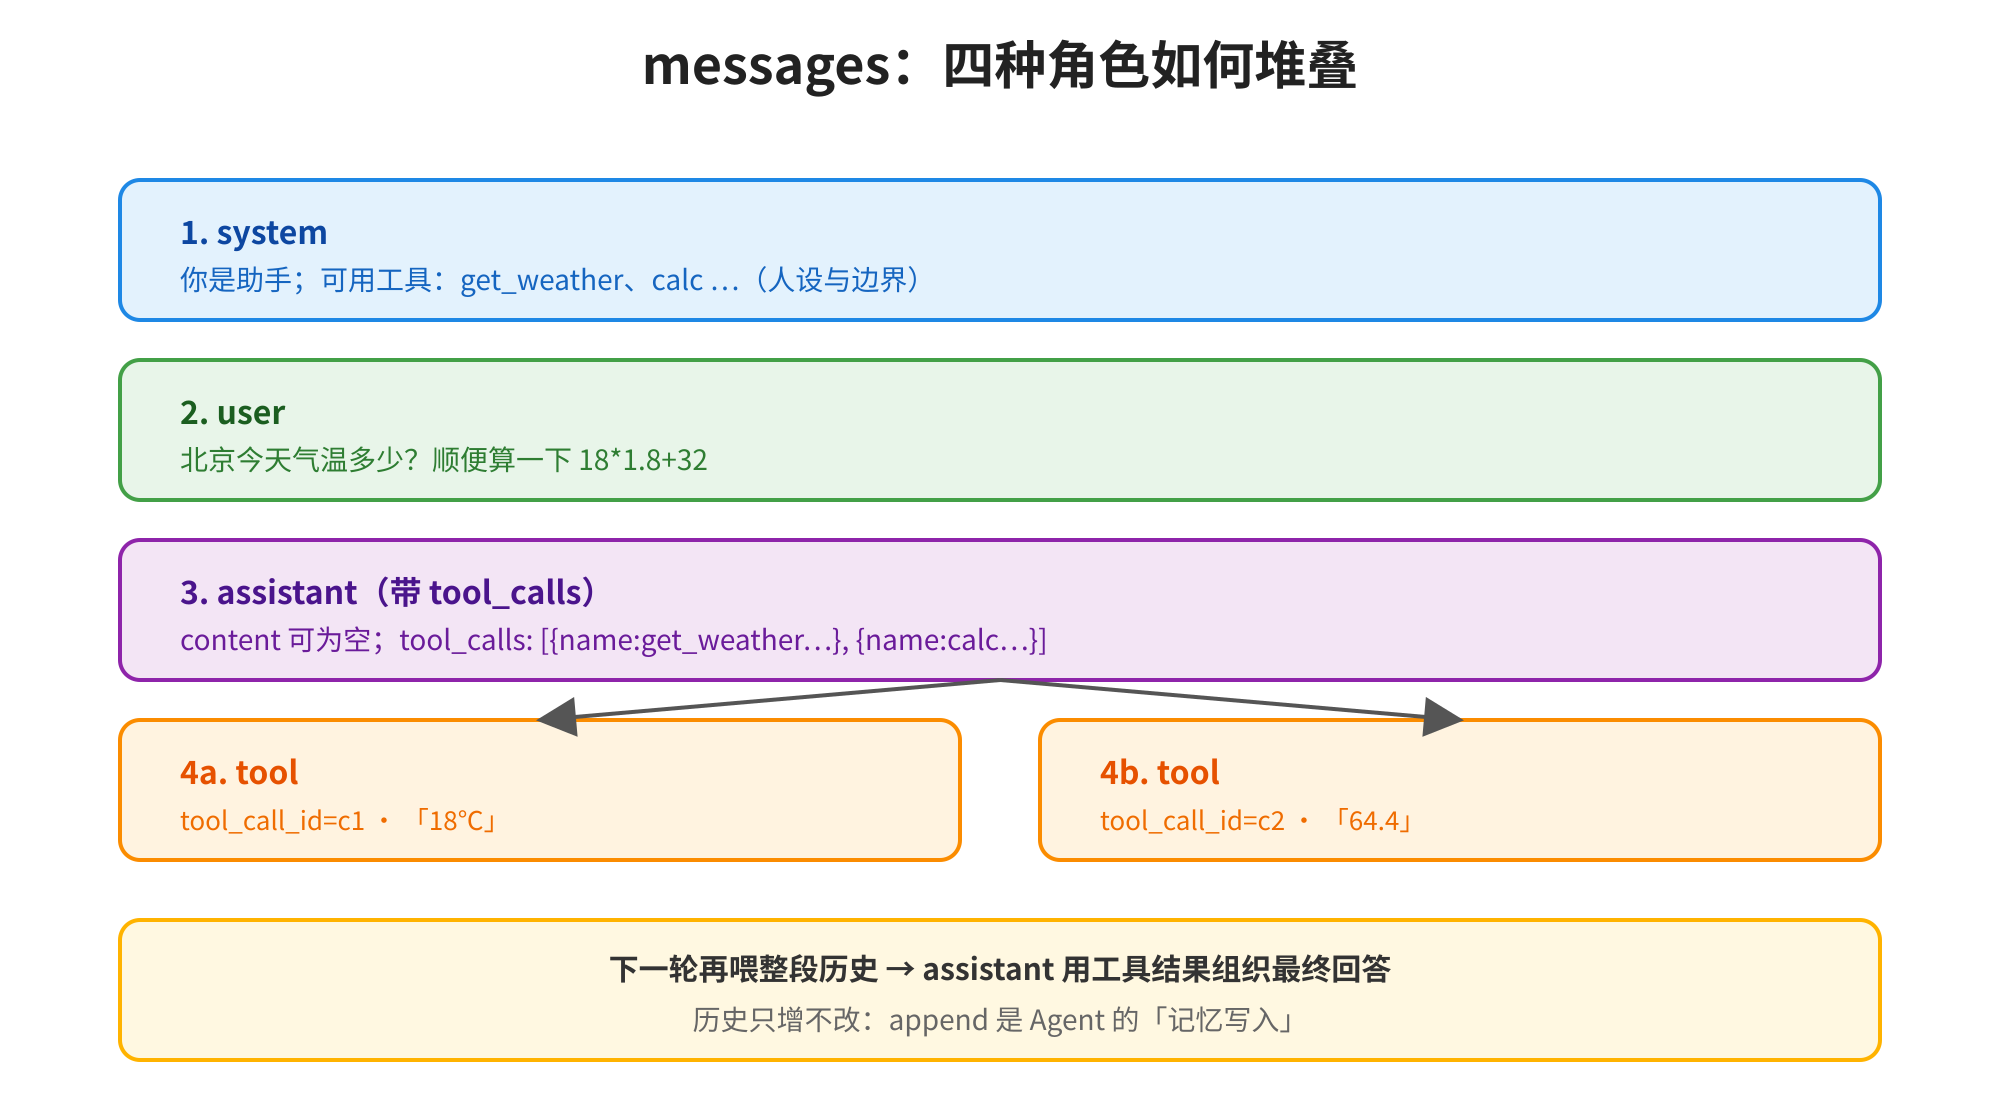
图2 messages:四种角色如何堆叠
兼容协议里,一轮多工具常见写法是:先 一条 带 tool_calls 的 assistant,再 N 条 role=tool。乱序或缺 id,下一轮模型会对不上号。
2.2 用 list 模拟增长
messages: list[dict] = [
    {"role": "system", "content": "你是助手。需要外部信息时调用工具。"},
    {"role": "user", "content": "北京今天气温?再把摄氏度换成华氏。"},
]

# 假设模型决定调两个工具——运行时 append:
messages.append(
    {
        "role": "assistant",
        "content": None,
        "tool_calls": [
            {
                "id": "call_1",
                "type": "function",
                "function": {"name": "get_weather", "arguments": '{"city":"北京"}'},
            },
            {
                "id": "call_2",
                "type": "function",
                "function": {"name": "calc", "arguments": '{"expr":"18*1.8+32"}'},
            },
        ],
    }
)
messages.append({"role": "tool", "tool_call_id": "call_1", "content": "18"})
messages.append({"role": "tool", "tool_call_id": "call_2", "content": "64.4"})

print(len(messages), [m["role"] for m in messages])
5 ['system', 'user', 'assistant', 'tool', 'tool']
要点:
- 历史是事实日志,不要回头改旧消息「圆谎」。
- tool 的 content 建议是字符串(JSON 就
json.dumps),方便各家网关统一。 - 截断策略(超长上下文)是进阶题:先会完整保留,再谈滑动窗口。
2.3 system 提示写什么
少而硬:角色、可用工具边界、输出风格、禁止事项。把「工具清单」同时放进 API 的 tools 字段;system 里重复「何时该用工具」即可,不必把整份 Schema 粘进 prompt(除非对方网关不支持 tools 字段)。
三、Tool Schema 与 REGISTRY:说明书 vs 厨房
3.1 Schema 长什么样
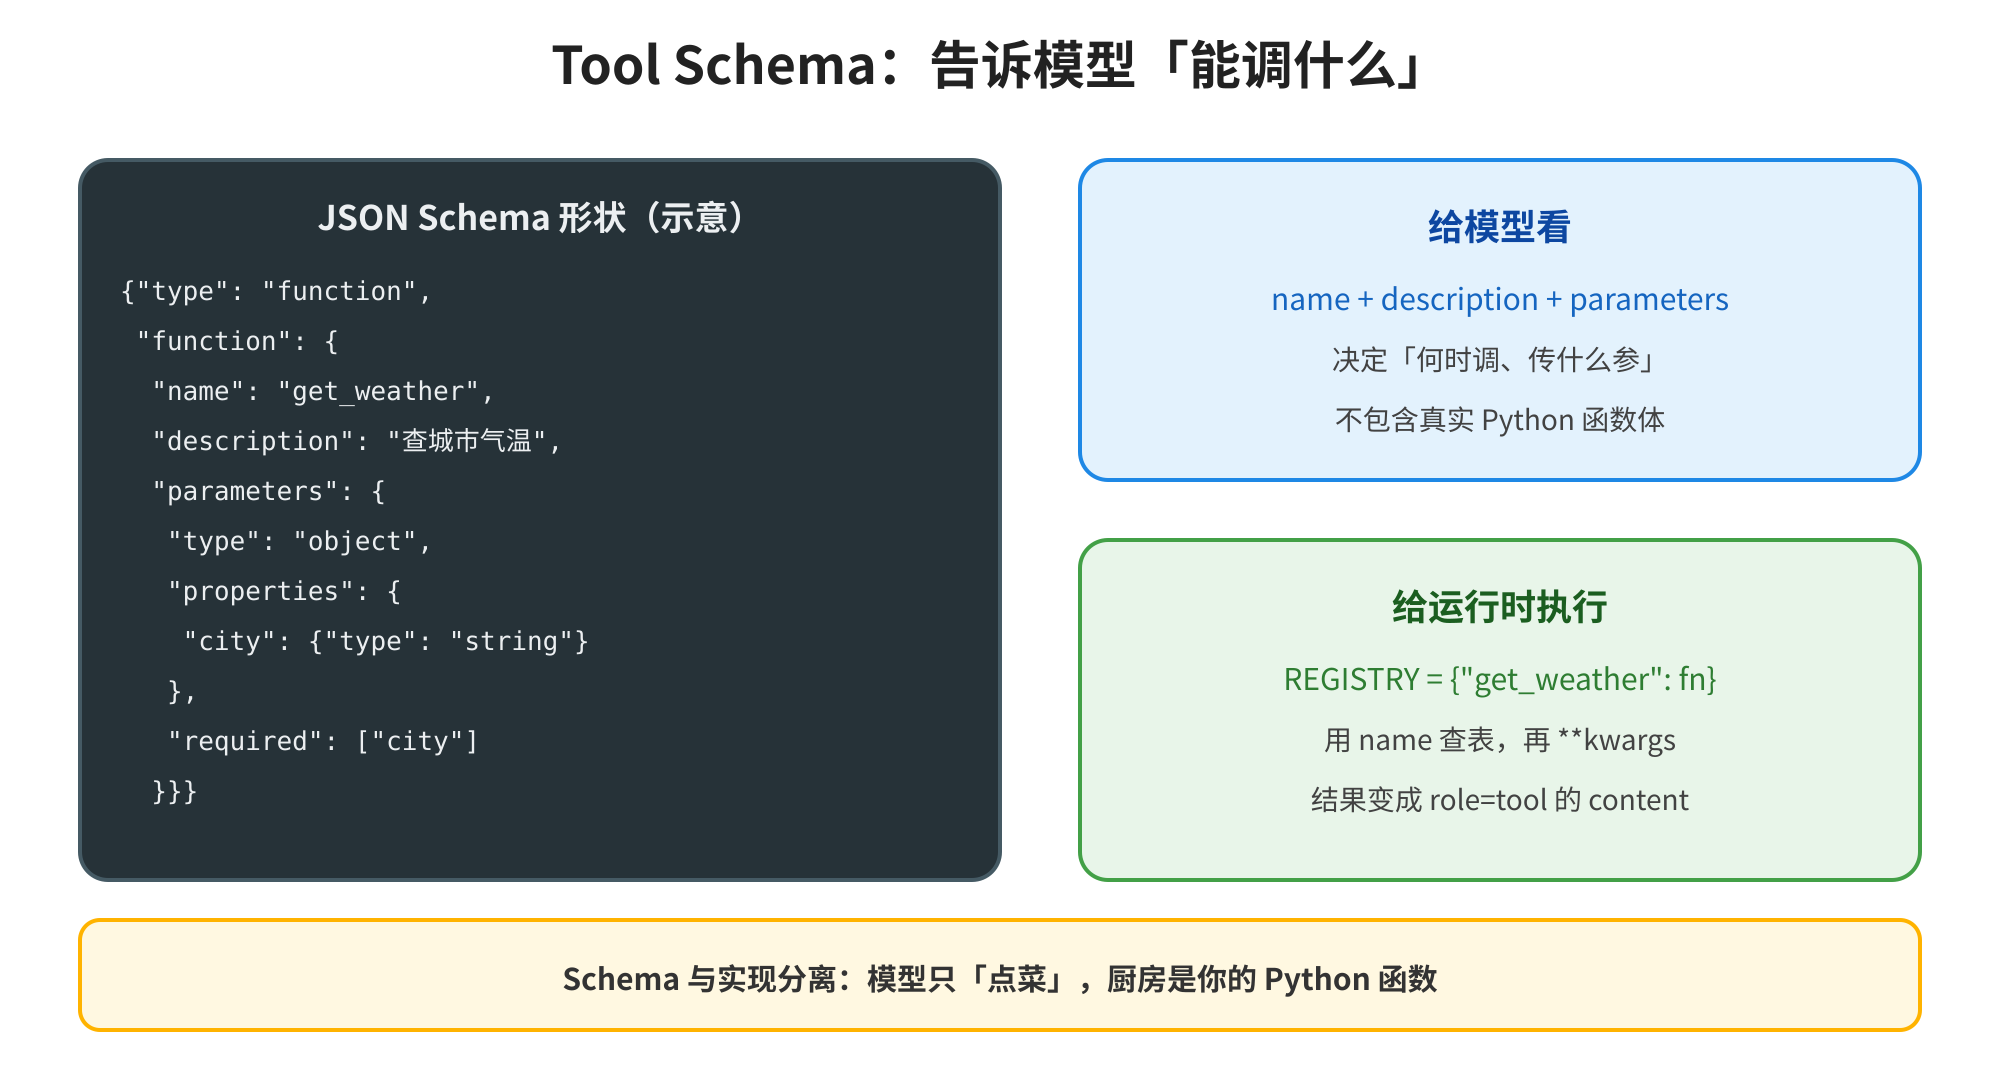
图3 Tool Schema:告诉模型能调什么
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "查询城市当前气温(摄氏度,演示用假数据)。",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string", "description": "城市名,如 北京"},
                },
                "required": ["city"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "calc",
            "description": "计算一个简单算术表达式,仅支持数字与 + - * / ( )。",
            "parameters": {
                "type": "object",
                "properties": {
                    "expr": {"type": "string", "description": "算术表达式"},
                },
                "required": ["expr"],
            },
        },
    },
]
模型只看见 name / description / parameters;它 看不见 你的 Python 源码。描述写清楚「做什么、不做什么」,能显著减少胡调。
3.2 注册表:唯一允许执行的入口
import ast
import operator

_FAKE_WEATHER = {"北京": 18, "上海": 22, "深圳": 26}

def get_weather(city: str) -> str:
    temp = _FAKE_WEATHER.get(city)
    if temp is None:
        return f"未知城市: {city}"
    return str(temp)


_BINOPS = {
    ast.Add: operator.add,
    ast.Sub: operator.sub,
    ast.Mult: operator.mul,
    ast.Div: operator.truediv,
}


def _eval_node(node):
    if isinstance(node, ast.Expression):
        return _eval_node(node.body)
    if isinstance(node, ast.Constant) and isinstance(node.value, (int, float)):
        return node.value
    if isinstance(node, ast.BinOp) and type(node.op) in _BINOPS:
        return _BINOPS[type(node.op)](_eval_node(node.left), _eval_node(node.right))
    if isinstance(node, ast.UnaryOp) and isinstance(node.op, ast.USub):
        return -_eval_node(node.operand)
    raise ValueError("不支持的表达式")


def calc(expr: str) -> str:
    tree = ast.parse(expr, mode="eval")
    return str(_eval_node(tree))


REGISTRY = {
    "get_weather": get_weather,
    "calc": calc,
}
# 手工试一下
>>> get_weather("北京")
'18'
>>> calc("18*1.8+32")
'64.4'
绝不对模型给的字符串直接 eval / exec。上面的 calc 用 ast 白名单节点,是「最小可用」示范;生产应用更常见的是固定 API(查库、调 HTTP),而不是通用表达式。
AI Infra 视角:工具延迟往往远大于一次 token 生成。并行 tool_calls(同一 assistant 消息里多个 call)可以
ThreadPoolExecutor或 asyncio 并发执行——但本篇先串行写对,再谈加速。
四、完整最小实现:FakeLLM + agent_loop
4.1 execute 与 append 铁律
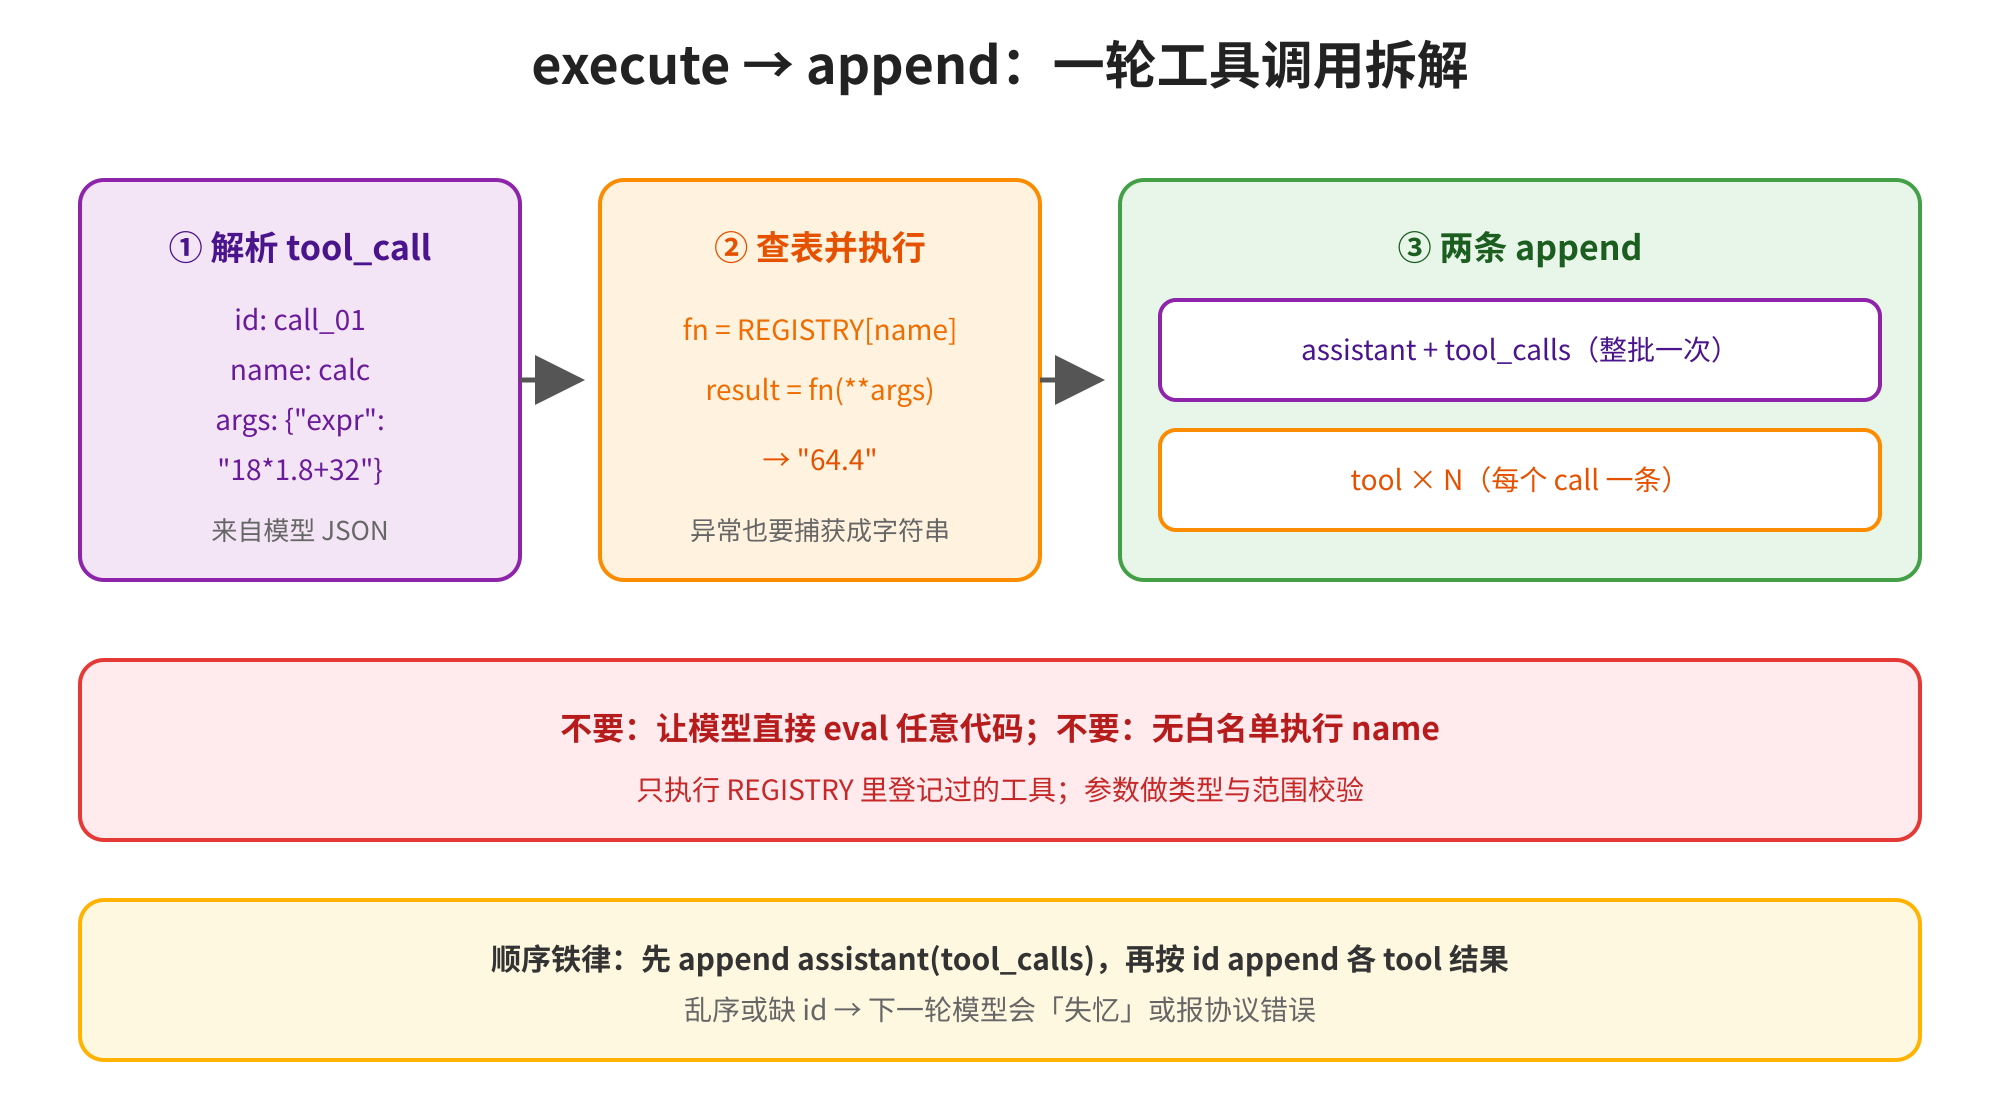
图4 execute → append:一轮工具调用拆解
import json
from typing import Any


def execute_tool(name: str, arguments: str) -> str:
    if name not in REGISTRY:
        return f"错误: 未知工具 {name}"
    try:
        args = json.loads(arguments) if arguments else {}
        if not isinstance(args, dict):
            return "错误: arguments 必须是 JSON 对象"
        result = REGISTRY[name](**args)
        return result if isinstance(result, str) else json.dumps(result, ensure_ascii=False)
    except Exception as e:  # 工具失败也要回传,供模型改策略
        return f"错误: {type(e).__name__}: {e}"
4.2 FakeLLM:不花钱也能测协议
真模型输出有随机性;教学与单测需要 可重复脚本。下面的假模型按「第几步」吐固定 tool_calls,最后给自然语言回答:
from dataclasses import dataclass


@dataclass
class LLMReply:
    content: str | None
    tool_calls: list[dict] | None  # 与兼容协议同形的 dict 列表


class FakeLLM:
    """按步数返回预设动作,专门练 agent 循环。"""

    def __init__(self) -> None:
        self.step = 0

    def chat(self, messages: list[dict], tools: list[dict]) -> LLMReply:
        self.step += 1
        if self.step == 1:
            return LLMReply(
                content=None,
                tool_calls=[
                    {
                        "id": "call_weather",
                        "type": "function",
                        "function": {
                            "name": "get_weather",
                            "arguments": json.dumps({"city": "北京"}, ensure_ascii=False),
                        },
                    },
                    {
                        "id": "call_calc",
                        "type": "function",
                        "function": {
                            "name": "calc",
                            "arguments": json.dumps({"expr": "18*1.8+32"}),
                        },
                    },
                ],
            )
        # 第二步:读 tool 结果,组织最终回答
        weather = next(
            (m["content"] for m in messages if m.get("role") == "tool" and m.get("tool_call_id") == "call_weather"),
            "?",
        )
        fahrenheit = next(
            (m["content"] for m in messages if m.get("role") == "tool" and m.get("tool_call_id") == "call_calc"),
            "?",
        )
        text = f"北京当前约 {weather}℃,换算华氏约为 {fahrenheit}°F。"
        return LLMReply(content=text, tool_calls=None)
4.3 agent_loop:本篇核心三十行
def agent_loop(
    user_text: str,
    llm: FakeLLM,
    tools: list[dict],
    *,
    max_steps: int = 8,
    system: str = "你是助手。需要外部信息时调用工具,最后给出简洁中文回答。",
) -> str:
    messages: list[dict] = [
        {"role": "system", "content": system},
        {"role": "user", "content": user_text},
    ]
    for step in range(1, max_steps + 1):
        reply = llm.chat(messages, tools)
        if reply.tool_calls:
            messages.append(
                {
                    "role": "assistant",
                    "content": reply.content,
                    "tool_calls": reply.tool_calls,
                }
            )
            for call in reply.tool_calls:
                fn = call["function"]
                out = execute_tool(fn["name"], fn.get("arguments") or "{}")
                messages.append(
                    {
                        "role": "tool",
                        "tool_call_id": call["id"],
                        "content": out,
                    }
                )
            print(f"[step {step}] tool_calls → {len(reply.tool_calls)} 个结果已 append")
            continue
        # 无工具:最终回答
        messages.append({"role": "assistant", "content": reply.content or ""})
        print(f"[step {step}] final")
        return reply.content or ""
    return "(触达 max_steps,已停止)"


if __name__ == "__main__":
    answer = agent_loop(
        "北京今天气温多少?顺便换算成华氏。",
        FakeLLM(),
        TOOLS,
    )
    print(answer)
[step 1] tool_calls → 2 个结果已 append
[step 2] final
北京当前约 18℃,换算华氏约为 64.4°F。
把这段存成 mini_agent.py,uv run python mini_agent.py 应得到同上输出。这就是 纯 Python 最小 Agent:没有框架,没有网络,协议形状却是真的。
4.4 为什么 FakeLLM 值得留着
| 用途 | 假模型 | 真模型 | 注意 |
|---|---|---|---|
| 单测循环 / append 顺序 | 稳定 | 贵且飘 | 人设、边界、工具使用策略 |
| 教协议、画轨迹 | 清晰 | 噪声大 | 本轮任务 |
| 评测工具实现本身 | 可控 | 混入模型错误 | 调工具时 content 可空 |
| 体验自然语言规划 | 弱 | 强 | 必须能对上 call id |
| execute() | 跑本地函数 | 捕获异常,返回字符串 | |
| 循环出口 | 无 tool_calls 或触达 max_steps | 防死循环 |
工程上常见模式:协议用假模型测绿,再开真模型做集成测试。 和第 22 篇 pytest 一脉相承。
五、换成真模型:接上第 26 篇的 HTTP 肌肉
5.1 chat() 的真实形状
有 OPENAI_API_KEY 时,把 FakeLLM.chat 换成下方逻辑(依赖 httpx,与第 26 篇一致):
import os
import httpx


def real_chat(messages: list[dict], tools: list[dict]) -> LLMReply:
    base = os.environ.get("OPENAI_BASE_URL", "https://api.openai.com/v1").rstrip("/")
    key = os.environ["OPENAI_API_KEY"]
    payload: dict[str, Any] = {
        "model": os.environ.get("OPENAI_MODEL", "gpt-4o-mini"),
        "messages": messages,
        "tools": tools,
    }
    with httpx.Client(timeout=60.0) as client:
        r = client.post(
            f"{base}/chat/completions",
            headers={"Authorization": f"Bearer {key}"},
            json=payload,
        )
        r.raise_for_status()
        msg = r.json()["choices"][0]["message"]
    raw_calls = msg.get("tool_calls") or None
    return LLMReply(content=msg.get("content"), tool_calls=raw_calls)
把 agent_loop 里的 llm.chat(...) 换成 real_chat(...)(或做一个同样暴露 chat 方法的类)即可。请求体字段名与假模型返回的 dict 形状对齐——这就是 FakeLLM 存在的第二意义:逼你先定协议。
5.2 流式与 Agent
流式(SSE)适合「最终 content 打字机」;带 tool_calls 的中间步通常仍等完整 JSON 再执行工具。实践中可:工具轮非流式;最终轮流式。不要在半截 tool_calls 上 execute。
5.3 工具是 HTTP?
execute_tool 里完全可以 httpx.get 打天气 API,或打第 27 篇的 FastAPI。此时 Agent 进程 = 编排器,工具 = 出站客户端——第 26 篇的超时、限流、密钥纪律全部生效。
def get_weather_http(city: str) -> str:
    # 示意:打自己的服务;必设 timeout
    r = httpx.get("http://127.0.0.1:8000/weather", params={"city": city}, timeout=5.0)
    r.raise_for_status()
    return str(r.json()["temp_c"])
六、生产纪律:步数、白名单、观测与边界
6.1 循环必须有出口
| 机制 | 作用 |
|---|---|
| max_steps | 硬上限,防工具来回抖 |
| 无 tool_calls | 正常结束 |
| 重复 call 检测 | 可选:同一 name+args 连续三次则熔断 |
| 用户取消 / 超时 | 服务端场景要能打断 |
「模型说还要再想想」不是出口;你的代码说 stop 才是。
6.2 安全底线(本篇最小集)
- 白名单:只跑
REGISTRY内的 name。 - 参数校验:JSON 解析失败、缺字段、类型不对 → 返回错误字符串,勿盲
**args。 - 禁止通用代码执行:不要
eval(user_or_model_string)。 - 密钥与副作用:写操作工具要幂等键或人工确认;日志里打码。
- 权限:能查天气 ≠ 能删库;按角色暴露不同 REGISTRY。
6.3 可观测:轨迹即资产
每步至少记录:step、是否 tool、name、耗时、成功/错误摘要。评测与排障靠轨迹回放,不靠「我记得上次对了」。把 messages 快照落盘,往往比只存最终答案有用一个数量级。
6.4 和框架的关系
LangChain / LlamaIndex / AutoGen / 自研网关,核心仍是本篇循环。框架多的是:提示模板、记忆插件、重试、并行工具、人机交互节点。先手写通,再引入框架,debug 时才知道该拆哪一层。
选型时可用一张粗表:原型与教学 → 手写 loop;要插件生态 → 成熟框架;要强控轨迹与多租户 → 自研网关封装本篇骨架。没有银弹;有的是对 messages 与 tool 边界是否清晰。清晰则换框架也便宜,模糊则任何框架都像玄学。
和「把业务逻辑写进 prompt 长文」相比,把可执行部分下沉为工具函数,通常更可测:pytest 直接测 calc / get_weather,不必每次点火模型。prompt 负责策略与话术,REGISTRY 负责真相来源——边界清楚,联调才不互相甩锅。
6.5 专栏二收官与下一站
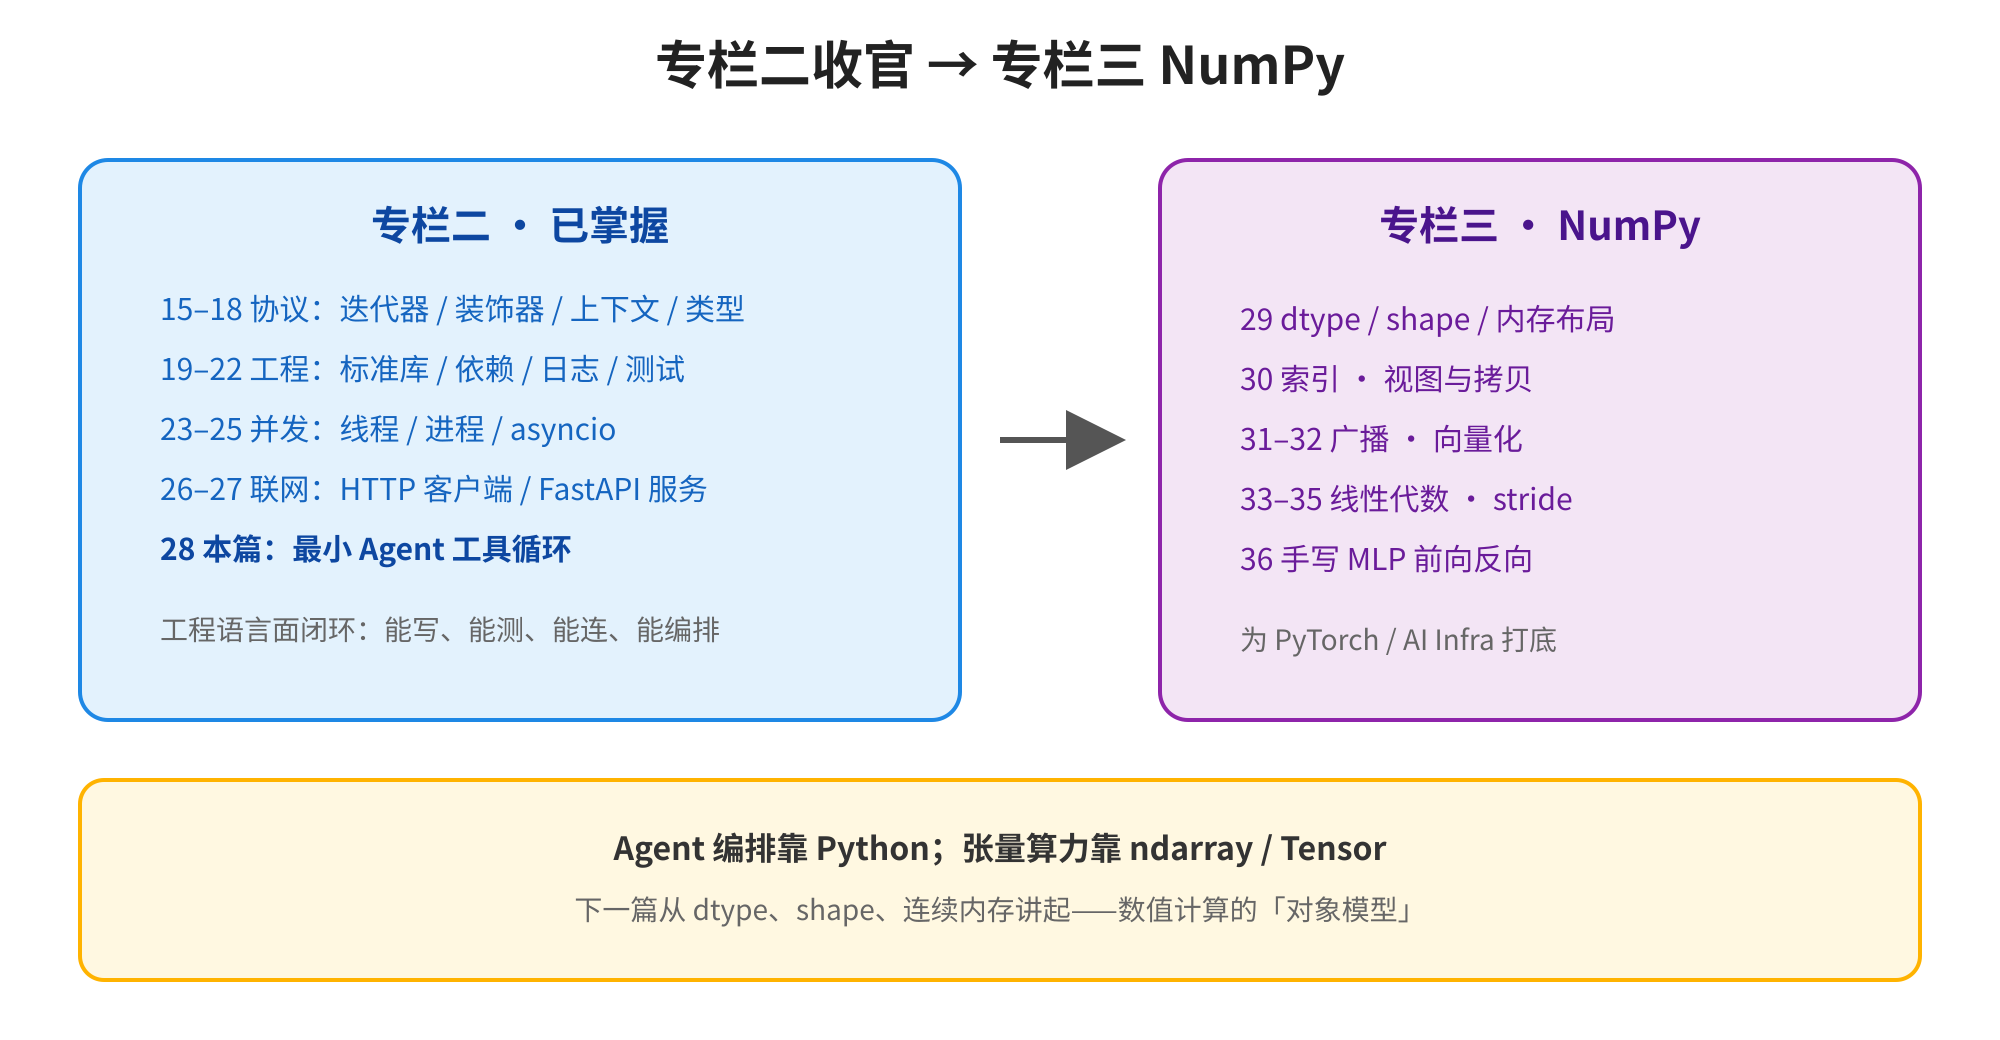
图5 专栏二收官 → 专栏三 NumPy
专栏二从迭代器走到 Agent,工程语言面闭环:协议、类型、依赖、日志、测试、并发、HTTP、服务、编排。下一站专栏三进入 数值计算:ndarray 的 dtype、shape 与内存布局——Agent 负责「怎么决策与调工具」,张量负责「怎么算得快」。两条线在专栏四 PyTorch / AI Infra 交汇。
读到这里自检:你能否不看文档画出图 1?能否解释为何先 append assistant 再 append tool?能否说出 FakeLLM 对单测的价值?卡壳就回到图 1~图 4。
若只能带走一句话:Agent 不是神秘对象,是带工具白名单与步数上限的 messages while 循环。
动手时再记一条:Agent 的第一原则仍是正确优先于炫——错误的「全自动无限循环」比手动多点一次更糟,因为它会在工具副作用与账单上放大错误。排障时一条最小可复现(FakeLLM 固定两步 + 打印 messages 角色序列),往往比一百次「再换个更强模型」更值钱。
和「一切都上框架默认 Agent」的神话相比,更值钱的是看懂循环与协议:你会改 max_steps、会加白名单、会落轨迹,框架只是薄封装。把这个品味带进 code review,比强制「必须用某某库」温和且有效。
若你刚从第 26~27 篇「HTTP 与 FastAPI」过来,本篇前两节会换一种体感:同样是 JSON 往返,但挂钩点从「一次请求」换成「多步记忆」。把单次 chat 改成 while + append,把「模型直接答」改成「先 tool 再答」——两条路径走完,Agent 直觉就长出来了。
和「在聊天里口头说会写 Agent」相比,可运行 mini_agent.py 的价值是:机器可重复、可测、可对比步数与 tool 结果——本地与 CI 上同一套结论。排障时你面对的是「谁少 append、谁错 id、谁没上限」,而不是「我记得好像跑通了」。
写循环代码时再记一条:编排层的第一原则仍是可观测优先——每一步至少能回答:第几步、是否调工具、调了谁、花了多久、结果摘要、是否触达上限。缺这六问,线上「偶发胡调」会变成玄学。
批量跑 Agent 评测还要注意计费与配额:步数上限不仅是为了防死循环,也是为了自己的账单与公平性。把 max_steps、工具超时、日预算写成配置,而不是硬编码在循环里。
也可以把 Agent 看成「有状态的远程函数编排」:messages 是状态,tools 是可调用集合,模型是调度器,execute 是本地副作用边界。这样想,第 11 篇的异常分层与本篇的工具错误回传就对上了。
七、踩坑大全
通用
坑 1:没有 max_steps。 现象:模型与工具来回抖,账单与 CPU 空转。解决:硬编码上限;超限返回明确提示。
坑 2:只 append tool,忘了 assistant(tool_calls)。 现象:网关 400 或模型失忆。解决:严格按「一条 assistant + N 条 tool」顺序。
坑 3:tool_call_id 对不上。 现象:结果挂错调用。解决:原样使用模型返回的 id;单测用 FakeLLM 固定 id。
坑 4:对模型参数 eval / exec。 现象:任意代码执行。解决:白名单函数 + 校验;算术用 ast 子集或干脆不用通用表达式。
坑 5:工具抛异常导致整个 loop 崩溃。 现象:一次坏工具杀死会话。解决:execute_tool 内捕获,把错误变成字符串写回 messages。
坑 6:Schema 的 name 与 REGISTRY 键不一致。 现象:总是「未知工具」。解决:单一来源生成两边;启动时 assert 对齐。
坑 7:把流式半截 JSON 拿去 execute。 现象:解析失败。解决:工具轮等完整 message;最终轮再 stream。
macOS / Linux / Windows
坑 8:Windows 控制台中文路径 / 编码。 现象:工具读文件乱码。解决:统一 UTF-8;PYTHONIOENCODING=utf-8。
坑 9:Linux 上工具子进程僵尸 / 未关 Client。 现象:长跑 Agent 服务文件描述符泄漏。解决:复用 httpx Client;with 管生命周期(第 17、26 篇)。
与模型 / 服务叠加
坑 10:system 里禁止调工具,却又传了 tools。 现象:模型行为打架。解决:提示与 API 字段一致。
坑 11:并行 tool_calls 却共享可变全局状态。 现象:偶现错乱。解决:工具无副作用或加锁;先串行正确再并行。
坑 12:真模型单测依赖外网。 现象:CI 红一片。解决:协议测 FakeLLM;真模型标 @pytest.mark.integration 并跳过无 Key。
八、小结
合上文章后,试着用自己的话说明:Agent 与单次聊天差在哪、四种 role 如何堆叠、Schema 与 REGISTRY 为何分离、为何 FakeLLM 对工程有价值。讲得清,才算真的会了。动手至少跑通:mini_agent.py 假模型两步轨迹 → 给 calc 加一个新表达式用例 →(可选)换 real_chat 打真端点。
- Agent 骨架:
while+messages+tools+execute+append;出口是无 tool_calls 或max_steps。 - messages:system / user / assistant / tool;历史只增不改;assistant(tool_calls) 在前,tool 结果在后。
- Schema vs 实现:模型只看说明书;运行时只跑白名单 REGISTRY。
- execute:解析 JSON、校验、调用、异常变字符串;禁止盲目
eval。 - FakeLLM:稳定测协议;真模型通过同一
LLMReply形状接入第 26 篇 HTTP。 - 生产纪律:步数上限、白名单、观测轨迹、工具超时与密钥纪律。
把故事连起来:并发三件套 → HTTP → FastAPI → 本篇 Agent 循环。专栏二工程刀具成套,下一站 NumPy 打开数值计算面。
若只能带走一张图:图 1。若只能带走一句代码纪律:只执行 REGISTRY 里的名字,并且循环必须能停。
若把本篇压成给同事的三十秒讲解:先画「messages → 模型 → tool → append」;再强调「白名单与 max_steps」;最后提「FakeLLM 测协议」。三张草图比贴一篇博客更管用。等对方能独立把单次聊天改成两步工具循环,并解释为何先 append assistant,就可以一起 code review Agent PR 了。
动手清单再压缩一版:跑通 FakeLLM 两步;trace.json 落盘;加一个新工具并改假模型脚本;pytest 覆盖未知工具与 max_steps;选做 real_chat。五步做完,比只「看完文章」扎实一个数量级。
也可以用「三个不要」自检:不要无上限的 while;不要执行未登记工具;不要丢掉 tool_call_id。
再留一个自测:把 get_weather 的假数据改成「上海」,改 FakeLLM 第一步的 city,跑通并核对最终句——协议稳了,再碰真模型。
本篇技能会立刻复利:读开源 Agent 先找 loop;PR 里要求展示轨迹与 max_steps;工具函数先写单测再挂到 REGISTRY。后续 NumPy / PyTorch 篇里,Agent 仍可作「外环编排」,张量作「内环计算」。
和专栏一串起来:函数与作用域(07~08)是工具本质;异常(11)要在 execute 边界消化;类型(18)帮你校验参数;HTTP(26)与 FastAPI(27)是工具的常见身体;本篇是专栏二把「编排智能」说透的收官课。
九、课后练习
- (基础) 把文中
REGISTRY/FakeLLM/agent_loop收进一个文件,跑通并保存完整messages到trace.json。 - (基础) 新增工具
get_time()(返回固定字符串即可),扩展 FakeLLM:第一步只调它,第二步最终回答;断言 messages 角色序列。 - (基础) 故意让
calc("1/0"),确认 loop 不崩溃且 tool content 含错误信息,模型步仍能结束(可改 FakeLLM 第二步读到错误也给出提示)。 - (理解) 写 pytest:给定 FakeLLM,断言
max_steps=1时返回触达提示且只执行一轮工具。 - (理解) 将
execute_tool改为:对未知 name / 错误 JSON / 缺少 required 字段分别返回可区分的错误前缀,并补测试。 - (理解) 画一张你自己的 Agent 轨迹图(纸笔即可):标出每一步 append 的 role 与 tool_call_id。
- (进阶) 实现可选并行:同一轮多个 tool_calls 用
ThreadPoolExecutor执行,但 append 顺序仍与 call 列表一致。 - (进阶 · AI Infra) 接
real_chat(有 Key 时):限制max_steps=5,打印每步耗时;写 200 字说明「轨迹日志」对评测复现的意义。
下一篇预告
下一篇是《第29篇|ndarray 基础:dtype、shape、内存布局》——专栏三「NumPy 数值计算」开篇。在搞清「用纯 Python 编排 Agent」之后,进入 连续内存上的多维数组:dtype 如何定元素、shape 如何定形状、C/F 连续如何影响切片与性能。你会看到:为什么向量化比纯 Python for 快、视图与拷贝为何事关显存与调试,以及这和后面 PyTorch Tensor 的血缘。
专栏三路线:ndarray 基础 → 索引视图 → 广播 → 向量化 → 线性代数 → 随机统计 → stride 原理 → 手写 MLP。带着专栏二的工程纪律学数值:代码仍要可测、可观测;只是数据从「JSON 消息」换成了「Typed buffer」。
若想提前热身:uv add numpy,在 REPL 里打印 np.array([1,2,3]).dtype、.shape、.ndim、.strides——带着问题进下一篇。
也可以把专栏二收官对照:迭代器到 Agent,你已经能写、能测、能连、能服务、能编排;下一站补上「算得快」的底座。下一篇见。
专栏一用十四篇把对象与协议立住;专栏二用十四篇把工程与编排立住;专栏三用八篇把 ndarray 立住。三线齐备,才谈得上专栏四的训练与推理基建。
若时间充裕,再多做一件事:打开任意开源 Agent 仓库,搜索 tool_calls 或 max_iterations,对照本篇图 1,用三句话笔记「它的 loop 出口在哪、工具白名单在哪、轨迹如何记录」。这种阅读比空背框架 API 更能把骨架刻进肌肉记忆。
进入专栏三之前,可把 mini_agent.py 留在练习库:假模型测协议、真模型做演示。数值篇学完后,你可以尝试给 Agent 加一个 np_dot 工具——会编排也会算,才是 AI 工程的日常。
写 Agent 或读框架源码时再记一条:错误往往来自 协议形状与出口条件(少 append、错 id、无上限),而不是「模型不够聪明」。和「栈很长但根因很浅」相比,先固定 FakeLLM 轨迹能省很多时间。
也可以把本篇看成专栏二的「编排收官」:前面把协议、积木、眼睛、断言、并发、HTTP、服务收齐,本篇把工具循环收齐。后面 NumPy 篇教你如何让数组在内存里乖乖列队;PyTorch 篇则把数组推进 GPU 与自动求导。
若阅读时觉得「Agent / 工作流 / 链」名词总搅在一起,回到图 1:只要存在「模型可点工具、结果写回历史、再问模型」,你就已经在 Agent 循环上。名词是包装,while 才是骨架。
收官前对照练习:同一用户问题,分别跑「无工具单次聊天」(假)与「本篇两步工具循环」。你会清楚感受到:Agent 多出来的不是玄学,而是 可验证的中间状态(tool 结果)——也是工程上可测、可观测的关键。
写完练习后,不妨在自己的仓库里开一个小 PR:只把某处「手写拼接 prompt 假装工具」改成显式 tools + REGISTRY + max_steps,不改业务语义。这种「小步显式化」比空读框架文档更能把工作流刻进团队规范。
写出站工具或读 Agent 延迟报告时再记一条:错误往往来自协议与出口(少 append、错 id、无上限、无白名单)。和「模型不够聪明」的归因相比,先固定轨迹与 FakeLLM 能省很多时间。
收官前对照练习:同一用户问题,用「禁止 tools 的单次 chat」与「本篇 loop」各跑一次(假模型即可)。你会清楚感受到:多出来的中间 tool 结果,才是工程上可断言的锚点——也是专栏二与数值/训练篇章对接的入场券之一。
若你带新人,可以把图 1 与图 4 打印成一页速查:左列循环零件,右列安全纪律(白名单 / 校验 / 上限 / 轨迹)。新人挂新工具时对着贴,两周后就会自然说出「先登记再执行」与「先 FakeLLM 测绿」。工具文化是带出来的,不是靠一次分享会喊出来的。
最后把专栏二的位置再钉一次:协议篇(15~18)解决「怎么正确接线」;标准库与依赖篇(19~20)解决「积木与环境」;可观测与可验证篇(21~22)解决「如何被看见与自动验证」;并发篇(23~25)解决「线程、进程、协程如何分层」;联网与服务篇(26~27)解决「HTTP 怎么出站与入站」;本篇解决「最小 Agent 工具循环怎么写」。六者齐备,脚本才既写得快,又编排得敢——下一专栏再给它配上 ndarray 的实话。