
第19篇|标准库精选:collections、itertools、functools
本篇定位:《Python 教程》专栏二「Python 进阶与工程」第 19 篇。承接第 04~05 篇的列表 / 字典、第 15 篇的迭代器与生成器、第 16 篇的装饰器、第 18 篇的类型合同,把标准库里最高频的三块积木讲透:
collections(更合适的容器)、itertools(惰性迭代器代数)、functools(偏函数、缓存、单分发)。为第 20 篇虚拟环境与打包、第 25~28 篇异步 / HTTP / Agent 提供「零依赖默认选项」。读完你将能够:用
Counter/defaultdict/deque/namedtuple/ChainMap替换手写样板;用chain/islice/groupby/product/batched搭惰性管道;用partial/lru_cache/singledispatch/wraps做函数级工程;说明三者如何组合,以及在词频统计、批推理、Agent 工具循环中的典型落点。预计用时:阅读 35~45 分钟,动手 25~35 分钟。
第 18 篇把「数据形状」立成合同;本篇转向另一件工程常识——先搜标准库,再造轮子。Python 号称「自带电池」(batteries included):很多你准备手写的计数、分组、滑动窗口、参数绑定、结果缓存,其实都有经过充分测试的实现。
一句话定心:注解描述形状,标准库提供高效积木。 collections 解决「用什么容器」;itertools 解决「如何惰性变换流」;functools 解决「如何改造与复用函数」。三者常一起出现:Counter 统计、islice 截断、lru_cache 记住纯查询。
建议边读边开练习目录(uv init --no-package,本篇无需第三方包)。阅读顺序:心智模型 → collections → itertools → functools → 组合与 AI Infra → 踩坑。下一篇预告虚拟环境、依赖管理与打包(20):你会把这些「电池」锁进可复现的环境。
和第 04~05 篇对照:list / dict 仍是基础,本篇是「更对口的专用容器」;和第 15 篇对照:生成器写「怎么产」,itertools 写「怎么拼」;和第 16 篇对照:wraps / lru_cache / singledispatch 都是装饰器家族;和第 18 篇对照:给 Counter[str]、Callable 写注解,合同与积木一起用。
动手时建议沿用「日志 / token / 工具调用」意象:先 Counter 统计词频,再 islice 取前 N,再 partial 绑定客户端,最后给纯查询加 lru_cache。做完后打开任意训练脚本或 Agent 循环,你会认出同一套形状。
本篇不穷尽标准库每一项(不讲 heapq 完整算法课、不讲 operator 全表、不展开 asyncio——那是第 25 篇)。主线是:选型心智 → 高频 API → 组合用法 → 工程禁忌。和「到处手写 if k not in d」相比,标准库的价值是:意图更清晰、边界情况更少、性能通常更好。
写代码时保持一个工程直觉:标准库优先于第三方「便利包」——能用 deque 就不要为滑动窗口再引一个重型依赖;能用 lru_cache 就不要先上 Redis(除非真有跨进程共享需求)。社区里那些「依赖树比业务还长」的仓库,往往是忘了先翻文档。
也可以把本篇看成专栏二的「工具面」补课:第 15 篇管流式;第 16 篇管横切;第 17 篇管资源;第 18 篇管形状;本篇管日常数据结构与函数工具。后面打包、日志、测试、并发,都会反复用到这里的积木。
读官方 collections / itertools / functools 文档时,按本篇目录对照即可。入门阶段把「会选、会用、会避开雷」做扎实,比背完整函数表更重要。
动手时再记一条:标准库的 API 往往比「抄一段 Stack Overflow 循环」更经得起时间考验——边界情况(空输入、缺键、maxlen 淘汰)已经被无数项目踩过并修过。你省下的不只是代码行数,还有排障时的心跳。
和「为每个小需求引一个工具包」相比,本篇推荐的默认策略是:先翻标准库文档三分钟。三分钟找不到对口积木,再考虑第三方。这个习惯在依赖审计、安全扫描、冷启动部署时都会回报你。
若你刚从第 18 篇「注解 vs Pydantic」的热身过来,本篇前两节会换一种爽感:同样是工程化,但挂钩点从「数据合同」换成「容器与函数积木」。把「手写词频」改成 Counter,把「list.pop(0) 队列」改成 deque,把「固定 client 参数的 lambda」改成 partial——三条路径走完,选型直觉就长出来了。
和「在 Wiki 里写一段『推荐用 Counter』」相比,标准库的价值是:API 稳定、文档齐全、无额外安装——CI、服务器、同事笔记本上默认就有。排障时你面对的是熟悉的类名,而不是某个小众工具包的冷门异常。
一、标准库精选心智模型
1.1 三块积木各管什么
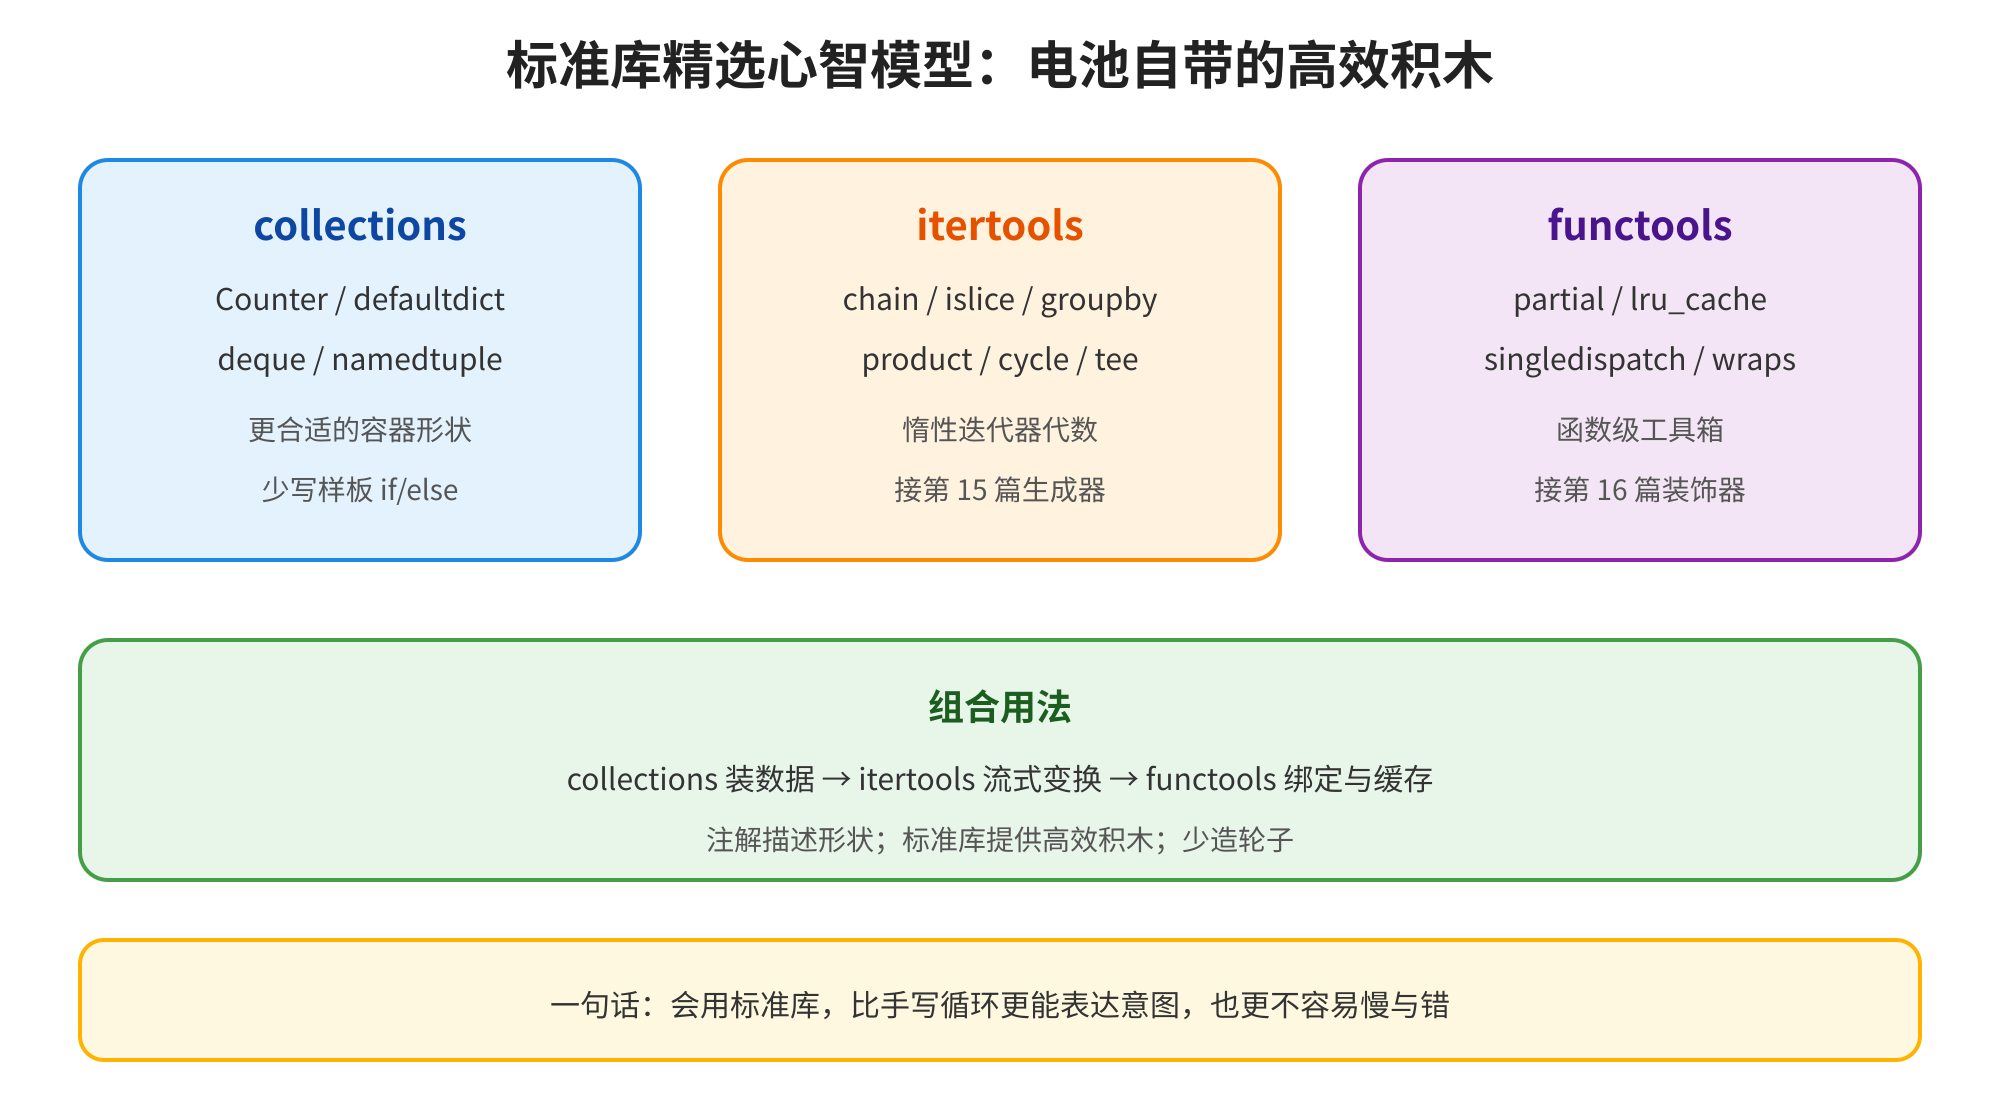
图1 标准库精选心智模型:电池自带的高效积木
from collections import Counter
from itertools import islice
from functools import lru_cache

tokens = ["a", "b", "a", "c", "a", "b"]
print(Counter(tokens).most_common(2))
print(list(islice(tokens, 3)))
[('a', 3), ('b', 2)]
['a', 'b', 'a']
要点:
- 专用容器比裸
dict/list更表达意图——读Counter就知道在计数。 - 惰性优于过早
list(...)——大日志、长生成器上先管道再截断。 - 函数工具减少闭包样板——
partial/ 缓存 / 分发比手写if树清晰。
1.2 「电池」与第三方的边界
标准库适合:算法清晰、无网络、单进程内、依赖零安装。第三方适合:HTTP 客户端生态、复杂校验(Pydantic)、深度学习框架。本篇三者几乎总是「先用标准库」。
AI Infra 视角:训练循环里统计 label 分布用
Counter;按 batch 切请求用batched/islice;embedding 查表用lru_cache(小词典)或真正的向量库(大规模)。先分清「进程内积木」和「系统级服务」。
1.3 和类型注解一起用
from collections import Counter
from collections.abc import Iterable

def top_tokens(words: Iterable[str], n: int = 10) -> list[tuple[str, int]]:
    return Counter(words).most_common(n)
第 18 篇的合同挂在积木上:Counter[str]、deque[str]、Callable[..., T] 都可读。静态检查器能提醒你「别把 deque 当随机下标数组滥用」。
也可以把三块积木想成厨房里的刀具:collections 是锅碗瓢盆(装什么),itertools 是流水线传送带(怎么连续加工),functools 是调料与定时器(怎么固定配方、记住火候)。菜谱(业务)每天变,刀具相对稳定——先认刀具,读别人的训练脚本会快很多。
工程上还有一层隐藏收益:团队词汇统一。大家都说 Counter / deque / partial,code review 时不必解释「这段 dict 累加在干什么」。共享词汇降低沟通税,这和类型注解降低形状沟通税是同一类投资。
1.4 渐进采用
老代码里到处 d[k] = d.get(k, 0) + 1?改动点遇到就换成 Counter;遇到 pop(0) 就换 deque;遇到「固定前两个参数的 lambda」就换 partial。标准库债务和类型债务一样,靠持续偿还。
二、collections:更合适的容器
2.1 Counter:计数一等公民
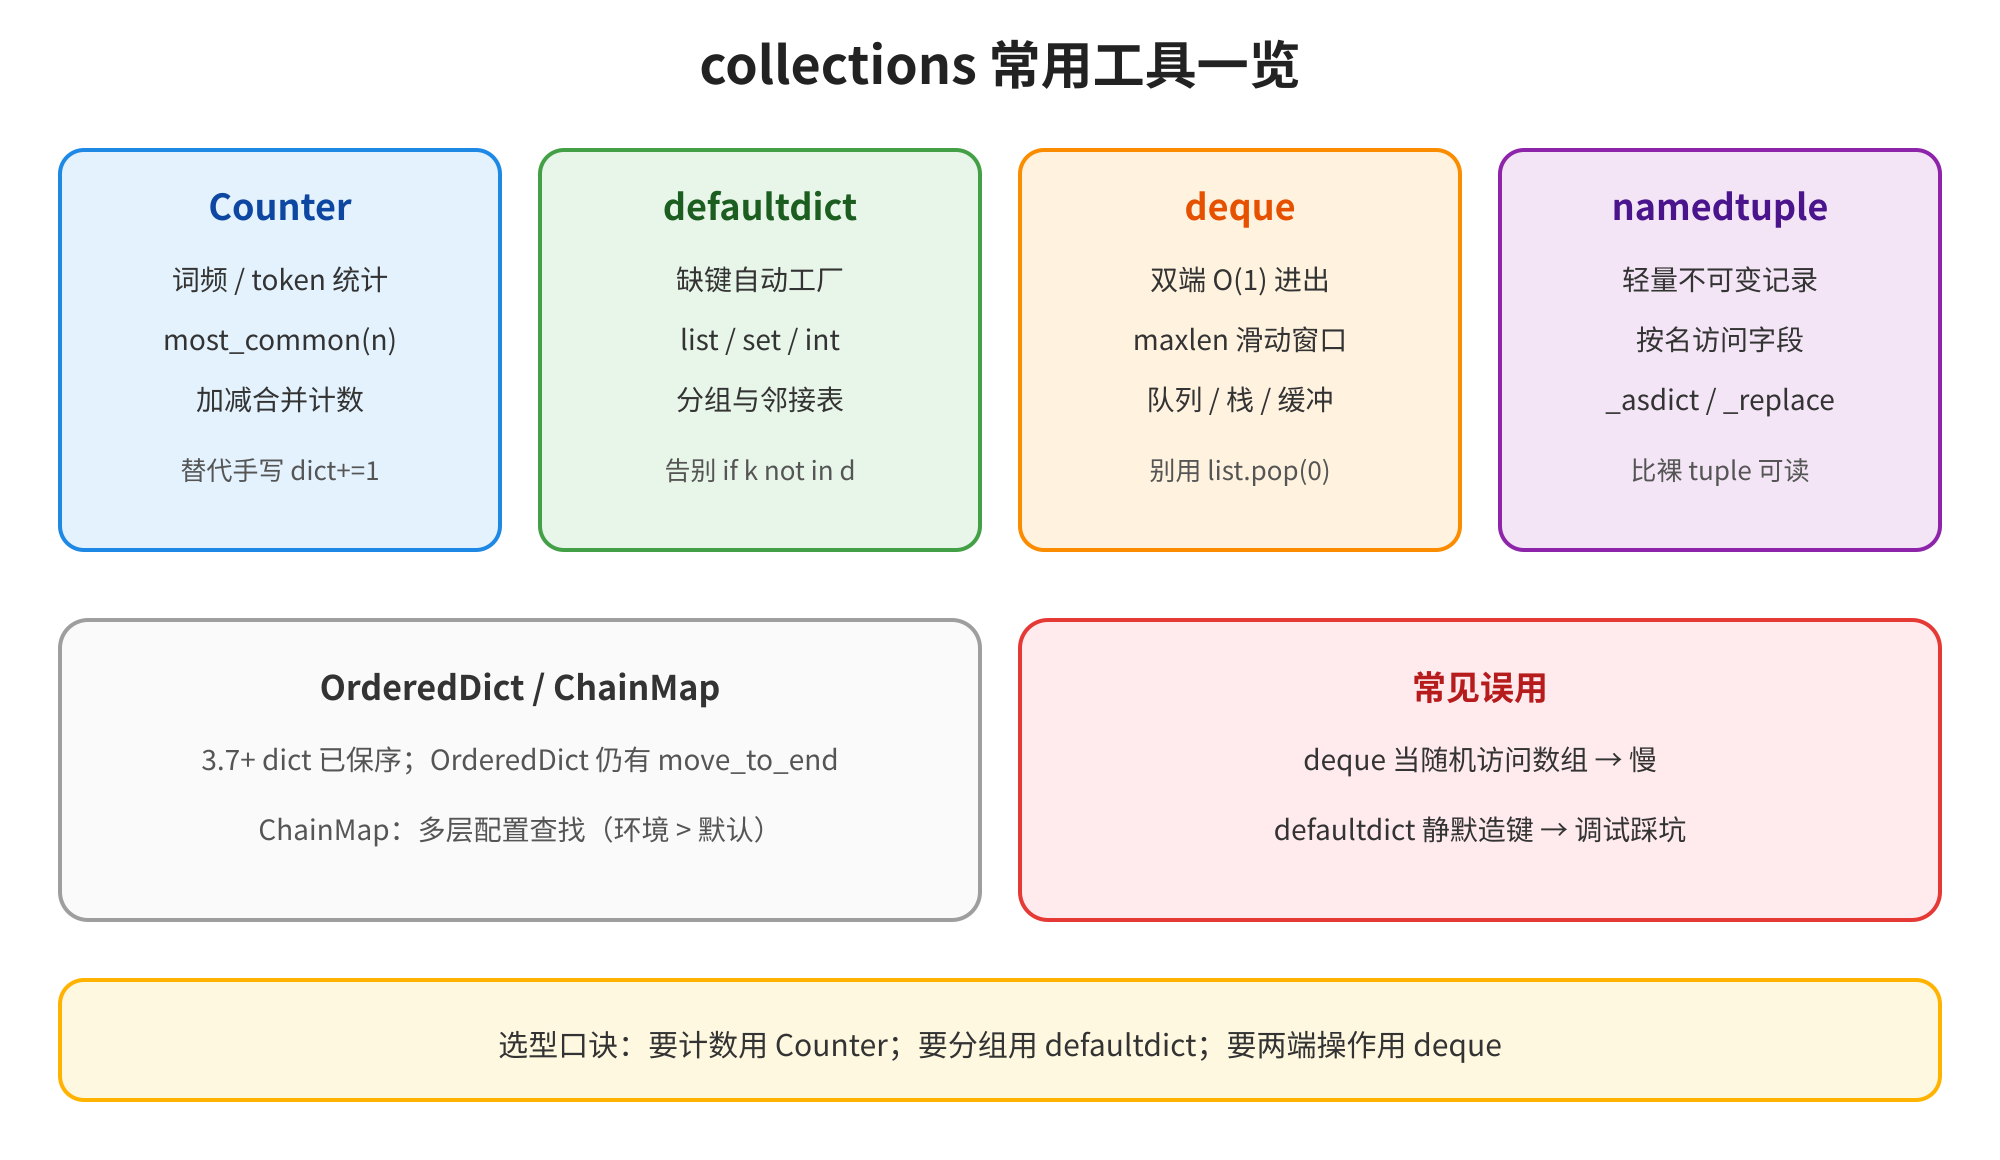
图2 collections 常用工具一览
from collections import Counter

c = Counter("abracadabra")
print(c)
print(c.most_common(3))
print(c["z"])  # 缺键为 0,不抛 KeyError
Counter({'a': 5, 'b': 2, 'r': 2, 'c': 1, 'd': 1})
[('a', 5), ('b', 2), ('r', 2)]
0
Counter 支持加减与更新,适合合并多批统计:
a = Counter(cats=3, dogs=1)
b = Counter(cats=1, dogs=2, birds=1)
print(a + b)
print(a - b)  # 只保留正计数
Counter({'cats': 4, 'dogs': 3, 'birds': 1})
Counter({'cats': 2})
2.2 defaultdict:缺键自动工厂
from collections import defaultdict

groups: dict[str, list[str]] = defaultdict(list)
for name, dept in [("Ada", "ML"), ("Bob", "Infra"), ("Cara", "ML")]:
    groups[dept].append(name)
print(dict(groups))
{'ML': ['Ada', 'Cara'], 'Infra': ['Bob']}
工厂可以是 list、set、int、lambda: defaultdict(int)(邻接表 / 二维计数)。坑:读不存在的键也会造出空值——调试时用 dict(d) 或先 k in d 判断是否真有数据。
2.3 deque:双端队列与滑动窗口
from collections import deque

q = deque([1, 2, 3])
q.appendleft(0)
q.append(4)
print(q.popleft(), list(q))

window = deque(maxlen=3)
for x in [10, 20, 30, 40]:
    window.append(x)
    print(list(window))
0 [1, 2, 3, 4]
[10]
[10, 20]
[10, 20, 30]
[20, 30, 40]
两端进出近似 O(1);中间插入 / 随机下标访问差——那时用 list。日志尾部、BFS 队列、固定长度上下文窗口,都是 deque 主场。
2.4 namedtuple 与 ChainMap
from collections import namedtuple, ChainMap

Point = namedtuple("Point", "x y")
p = Point(3, 4)
print(p.x, p._asdict())

defaults = {"temp": 0.7, "top_p": 0.9}
env = {"temp": 0.2}
cfg = ChainMap(env, defaults)
print(cfg["temp"], cfg["top_p"])
3 {'x': 3, 'y': 4}
0.2 0.9
namedtuple 轻量不可变;要可变字段、默认值、类型注解,优先第 18 篇的 @dataclass。ChainMap 做「环境覆盖默认」查找,不拷贝大字典。
选型时再补一张心理卡片:dict 仍然是默认哈希表;只有当你需要「计数语义」「缺省工厂」「双端操作」「轻量记录」「多层查找」时,才升级到 collections 里的专用类型。不要为了「看起来高级」把所有 dict 改成 OrderedDict——在 3.7+ 的保留插入序世界里,那常常是多余噪音。
namedtuple 与 @dataclass 如何选?规则很短:字段少、要当元组用(可拆包、可当字典键若字段可哈希)、不需要默认值方法——用 namedtuple;要默认值、可变、类型注解、post_init——用 dataclass。两者都比「下标 0、1、2 的裸元组」可读。
AI Infra 视角:评测集标签用
Counter;按user_id聚合轨迹用defaultdict(list);推理服务里最近 K 条消息用deque(maxlen=K);多层配置(CLI > 环境变量 > 文件默认)可用ChainMap或 Pydantic 设置源——小脚本前者够用。
三、itertools:迭代器代数
3.1 惰性管道心智
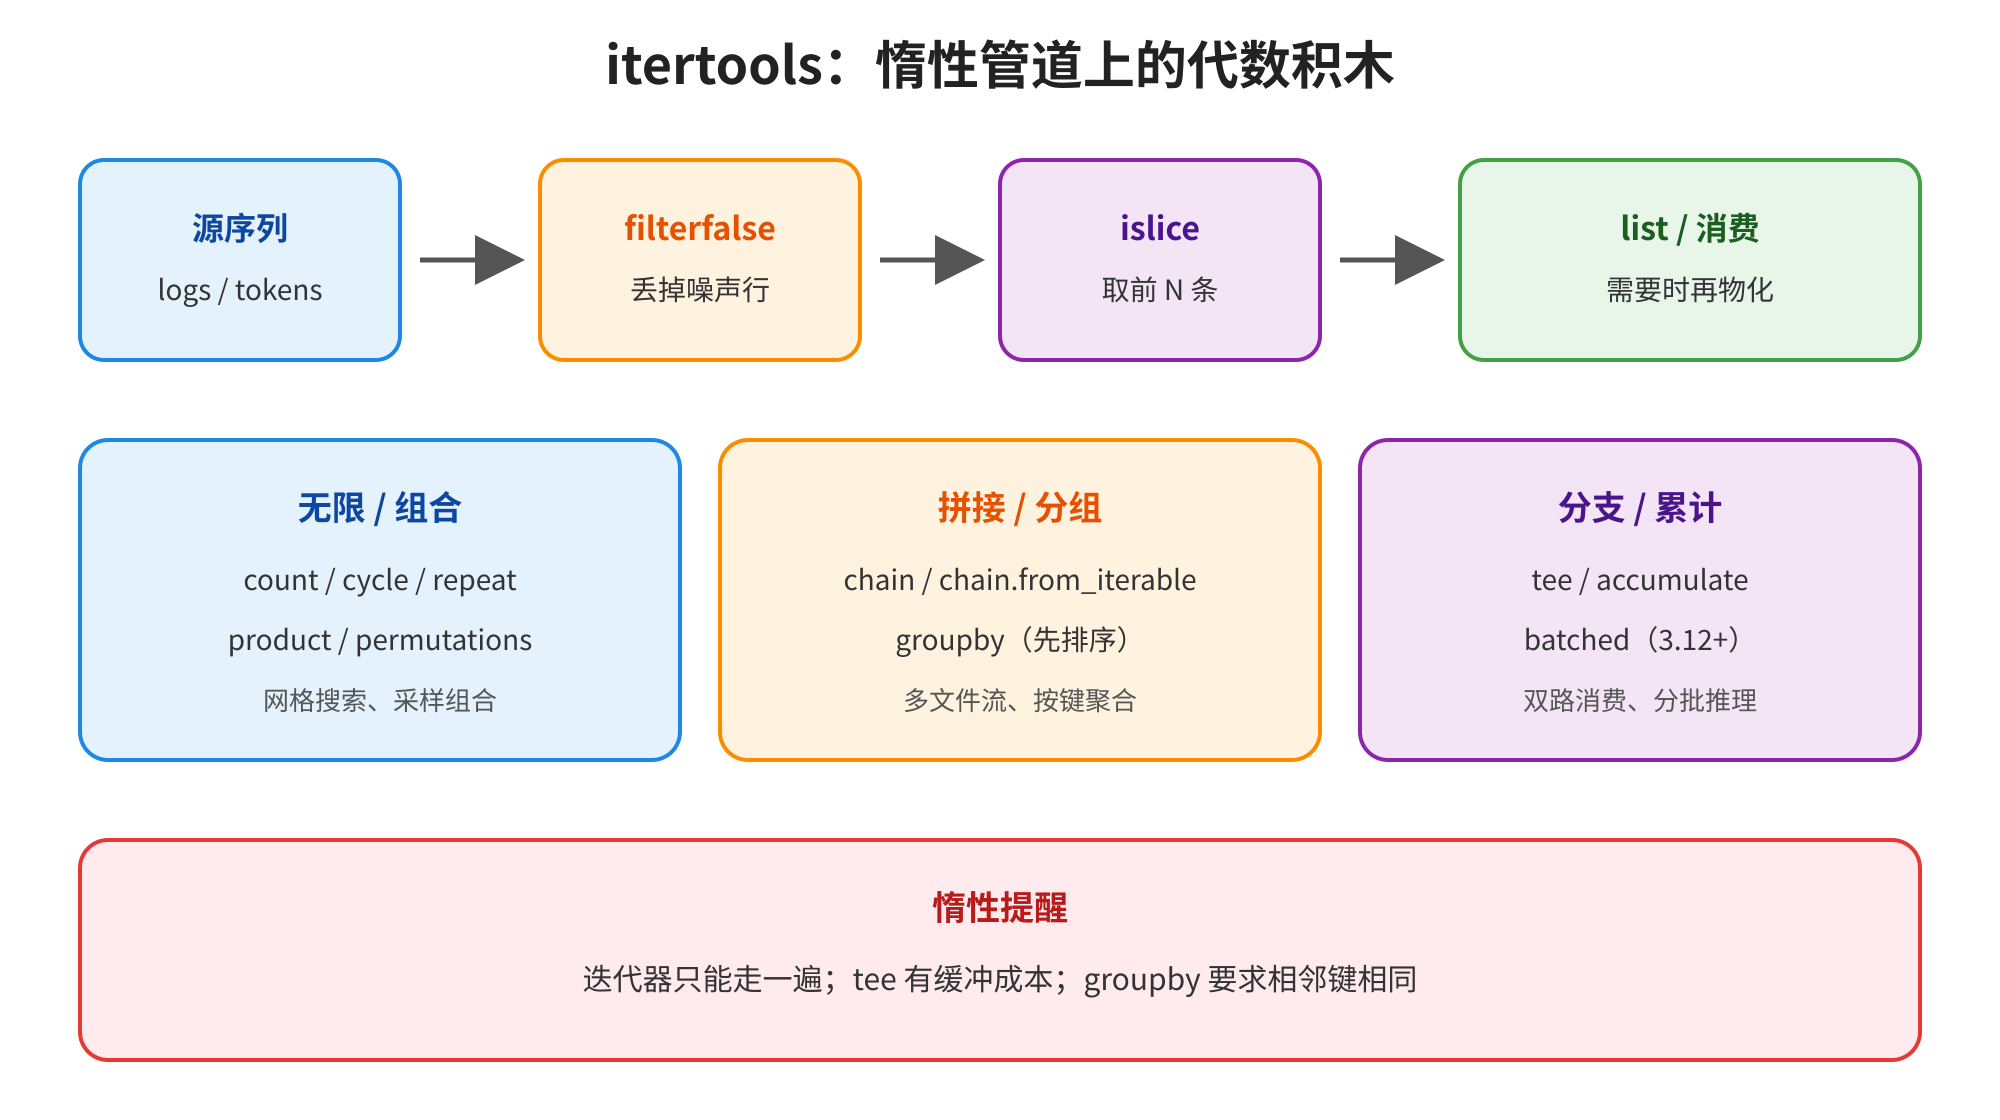
itertools模块在惰性管道上的代数积木。上方流程为源序列(logs/tokens)经filterfalse(丢掉噪声行)、islice(取前N条)后,再由list(消费)消费。下方分为无限/组合(count/cycle/repeat等)、拼接/分组(chain/groupby等)和分支/累计(tee/accumulate等)三类。底部红色框内提醒迭代器只能走一遍,tee有缓冲成本,groupby要求相邻键相同。此图与上下文紧密相关,直观呈现了itertools在惰性管道中的操作逻辑。图3 itertools:惰性管道上的代数积木
第 15 篇强调:迭代器走一遍就耗尽。itertools 提供的是组合子——输入迭代器,输出迭代器,中间尽量不物化。
from itertools import islice, filterfalse

logs = (f"line-{i}" for i in range(1000))
noisy = lambda s: s.endswith("3")
clean = filterfalse(noisy, logs)
print(list(islice(clean, 5)))
['line-0', 'line-1', 'line-2', 'line-4', 'line-5']
3.2 拼接、切片、分组
from itertools import chain, groupby

a = [1, 2]
b = [3, 4]
print(list(chain(a, b)))
print(list(chain.from_iterable([[1], [2, 3], [4]])))

rows = [("ML", "Ada"), ("ML", "Cara"), ("Infra", "Bob")]
rows.sort(key=lambda x: x[0])  # groupby 要求相邻键相同
for dept, members in groupby(rows, key=lambda x: x[0]):
    print(dept, [m[1] for m in members])
[1, 2, 3, 4]
[1, 2, 3, 4]
Infra ['Bob']
ML ['Ada', 'Cara']
坑:groupby 不是 SQL 的 GROUP BY——它只合并连续相同键;通常先 sort。
3.3 无限迭代与组合积
from itertools import count, cycle, product, islice

print(list(islice(count(10, 2), 4)))
print(list(islice(cycle("AB"), 5)))
print(list(product([0, 1], ["x", "y"])))
[10, 12, 14, 16]
['A', 'B', 'A', 'B', 'A']
[(0, 'x'), (0, 'y'), (1, 'x'), (1, 'y')]
product 适合小规模网格搜索(学习率 × batch size);规模一大要改随机采样或专用调参库。
3.4 tee、accumulate、batched
from itertools import tee, accumulate, batched

xs = [1, 2, 3, 4]
a, b = tee(xs, 2)
print(list(a), list(accumulate(b)))

# Python 3.12+
print(list(batched(range(10), 3)))
[1, 2, 3, 4] [1, 3, 6, 10]
[(0, 1, 2), (3, 4, 5), (6, 7, 8), (9,)]
tee 可双路消费,但有缓冲成本——能重算源就别 tee。batched 是批推理 / 批写库的天然积木(旧版本可用手写生成器模拟)。
惰性管道的调试技巧:在链中间插入 tee 或临时 list(islice(it, 20)) 抽样看形状,确认后再去掉。切忌一上来就把整个生成器 list 掉——评测集很大时,内存峰值会教训你。和生产环境的「流式读 JSONL」一样,开发机上也保持惰性习惯,手感才能迁移。
另一个常见问题是「无限迭代器忘了截断」:count() / cycle() 很好用,但必须搭配 islice 或显式 break。写示例时养成「无限源 + 有限窗」的配对思维,和 deque(maxlen=...) 的窗口思维一致。
AI Infra 视角:读超长 JSONL 评测集时,
islice+batched控制内存;超参小网格用product;多文件日志用chain.from_iterable(open(p) for p in paths)(注意及时关闭,生产代码用上下文管理器包一层)。
四、functools:偏函数、缓存、单分发
4.1 partial:绑定部分参数
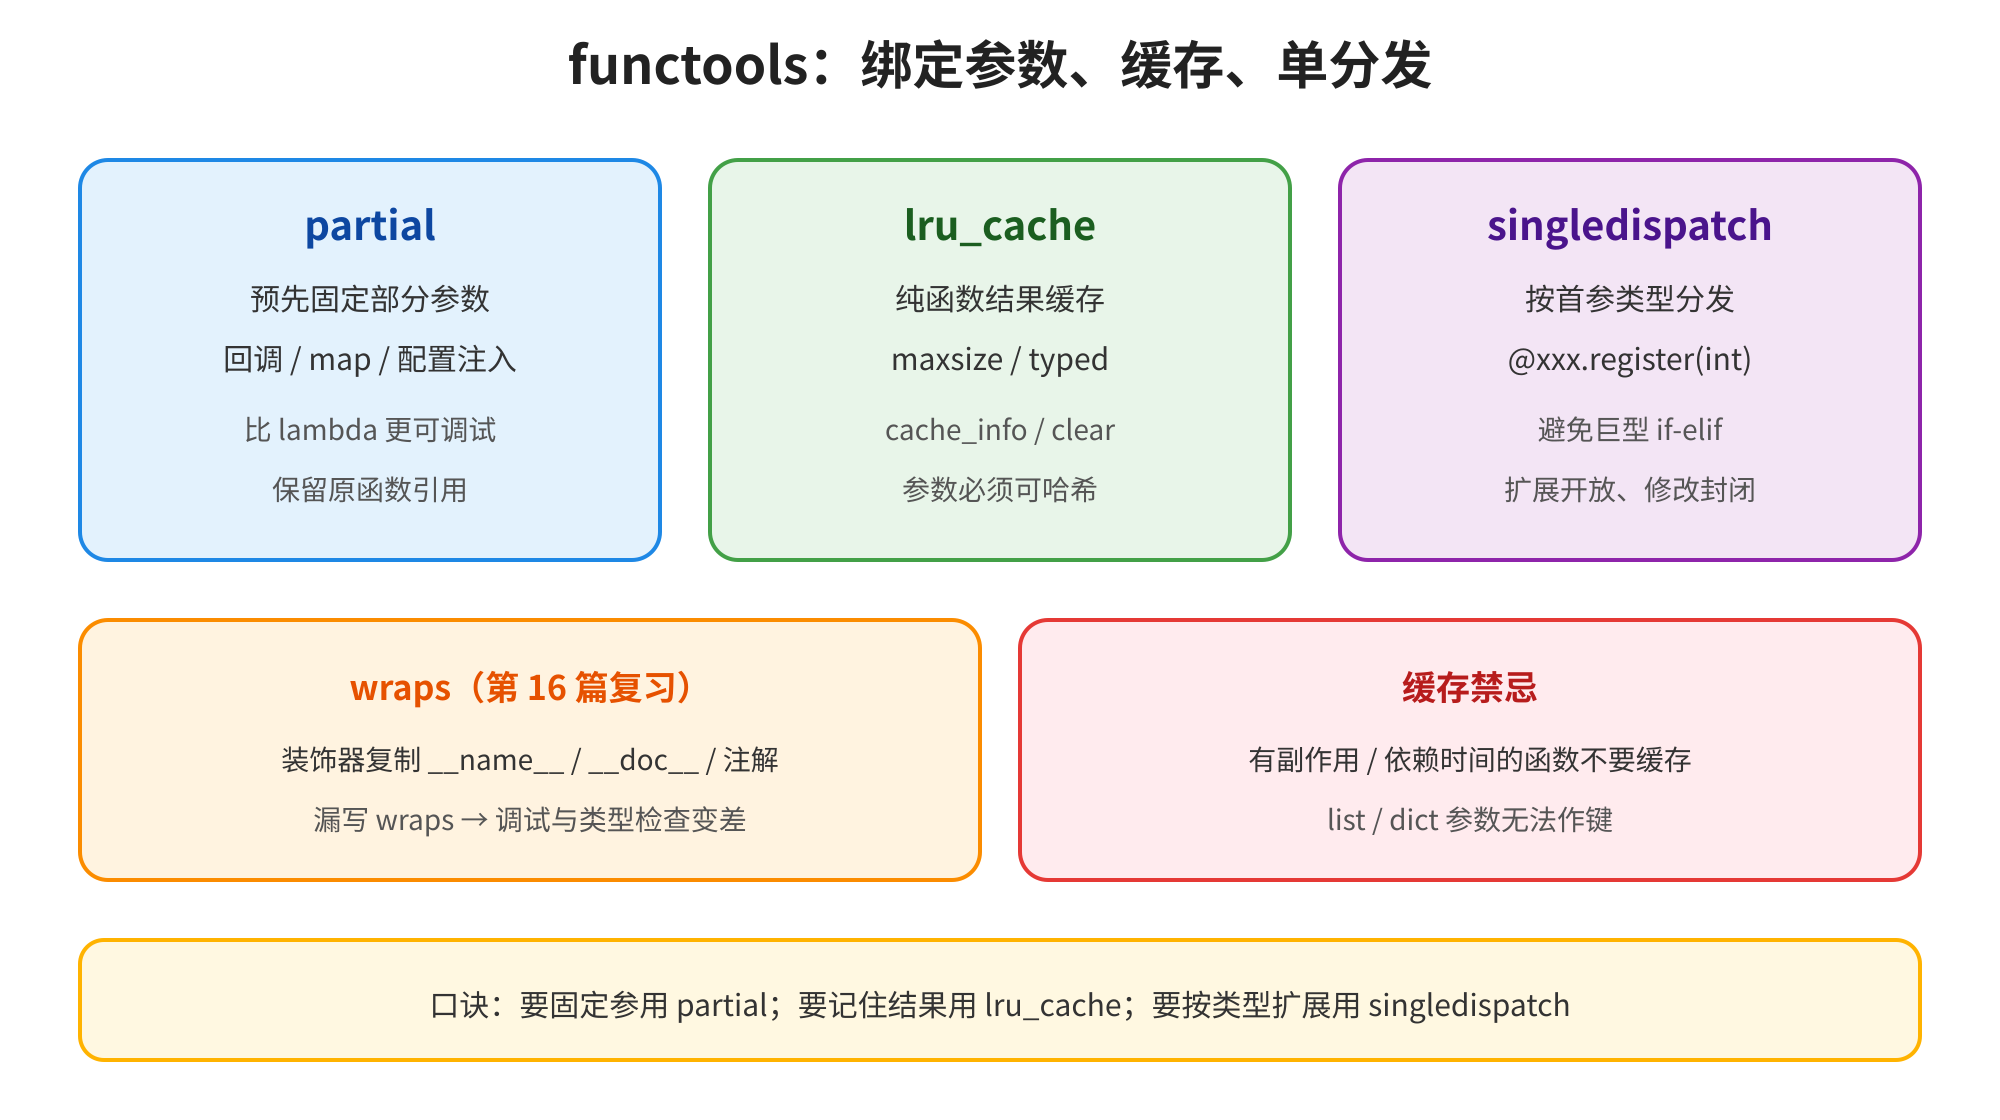
图4 functools:绑定参数、缓存、单分发
from functools import partial

def power(base: float, exp: float) -> float:
    return base**exp

square = partial(power, exp=2)
print(square(5), square(9))
25.0 81.0
比 lambda x: power(x, 2) 更易调试(保留 func / args 属性),也适合塞进 map、回调、工具注册表。
4.2 lru_cache:记住纯函数结果
from functools import lru_cache
import time

@lru_cache(maxsize=128)
def fib(n: int) -> int:
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)

t0 = time.perf_counter()
print(fib(35), fib.cache_info())
print(f"{time.perf_counter() - t0:.4f}s")
9227465 CacheInfo(hits=33, misses=36, maxsize=128, currsize=36)
0.0001s
(具体秒数因机器而异,但应远快于无缓存的朴素递归。)
规则:
- 参数必须可哈希(不要传
list/dict)。 - 函数应接近纯:无副作用、不依赖「现在几点」。
maxsize=None变无界缓存,注意内存;cache_clear()在测试间重置。
4.3 singledispatch:按类型扩展
from functools import singledispatch

@singledispatch
def dump(obj: object) -> str:
    return f"<unknown {type(obj).__name__}>"

@dump.register
def _(obj: int) -> str:
    return f"int:{obj}"

@dump.register
def _(obj: list) -> str:
    return "list[" + ", ".join(dump(x) for x in obj) + "]"

print(dump(3), dump([1, 2]), dump(1.5))
int:3 list[int:1, int:2] <unknown float>
适合「开放扩展、少改中心 if-elif」的渲染 / 序列化。类上的方法分发可用 singledispatchmethod。
4.4 wraps:装饰器元数据(复习)
from functools import wraps

def timer(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        return fn(*args, **kwargs)

    return wrapper


@timer
def add(a: int, b: int) -> int:
    """加法。"""
    return a + b


print(add.__name__, add.__doc__)
add 加法。
第 16 篇强调过:漏写 wraps,调试栈与类型检查器都会看到 wrapper。本篇把它放回「functools 工具箱」统一记忆。
partial 与闭包的边界:都能「记住一些值」。闭包更灵活(可捕获可变状态);partial 更直白(只绑定实参)。团队规范里若鼓励少写嵌套 def,partial 往往是更干净的默认选项。调试时打印 fn.func / fn.args / fn.keywords,比对着一层层 lambda 猜捕获值轻松。
缓存的容量规划:maxsize=128 是常见起点;热点键很少就够用,长尾很多就增大或换显式字典 + TTL。务必在监控或日志里偶尔打出 cache_info(),否则「命中率近零」的缓存会默默占着位置却不帮忙。
AI Infra 视角:
partial(client.chat, model="...")固定默认模型;对小词典 / 规范化函数用lru_cache;按工具返回类型(str/dict/list)用singledispatch渲染给下一跳 LLM——比巨型isinstance树好维护。
五、三者如何组合
5.1 一条迷你流水线
from collections import Counter, deque
from itertools import islice, batched
from functools import partial, lru_cache


@lru_cache(maxsize=256)
def normalize(token: str) -> str:
    return token.strip().lower()


def analyze(lines: list[str], top_n: int = 5) -> list[tuple[str, int]]:
    tokens = (normalize(t) for line in lines for t in line.split())
    return Counter(tokens).most_common(top_n)


lines = ["Hello World", "hello Python", "World of Agents"]
print(analyze(lines))

take3 = partial(islice, stop=3)
print(list(take3(iter([10, 20, 30, 40]))))
print(list(batched(range(7), 3)))

recent = deque(maxlen=2)
for msg in ["u1", "u2", "u3"]:
    recent.append(msg)
print(list(recent))
[('hello', 2), ('world', 2), ('python', 1), ('of', 1), ('agents', 1)]
[10, 20, 30]
[(0, 1, 2), (3, 4, 5), (6,)]
['u2', 'u3']
读这段时按层拆:normalize 被缓存;生成器惰性拆词;Counter 聚合;partial 固化 islice;batched 分批;deque 保最近上下文。
5.2 选型速查
组合时的可读性纪律:一条管道超过三四个组合子,就拆成具名中间变量或小函数。标准库让你能把逻辑写成很密的表达式,但 code review 更喜欢「一眼看出意图」的名字——tokens、window、batches 比三重嵌套生成器表达式友好。
5.3 和「手写循环」如何取舍
可读的 for 仍然好——不要为了「炫技」把简单逻辑拧成难以调试的迭代器链。标准库胜在重复出现的模式:计数、缺省、双端、截断、缓存。模式一出现,就换成积木名。
六、AI Infra 场景速写
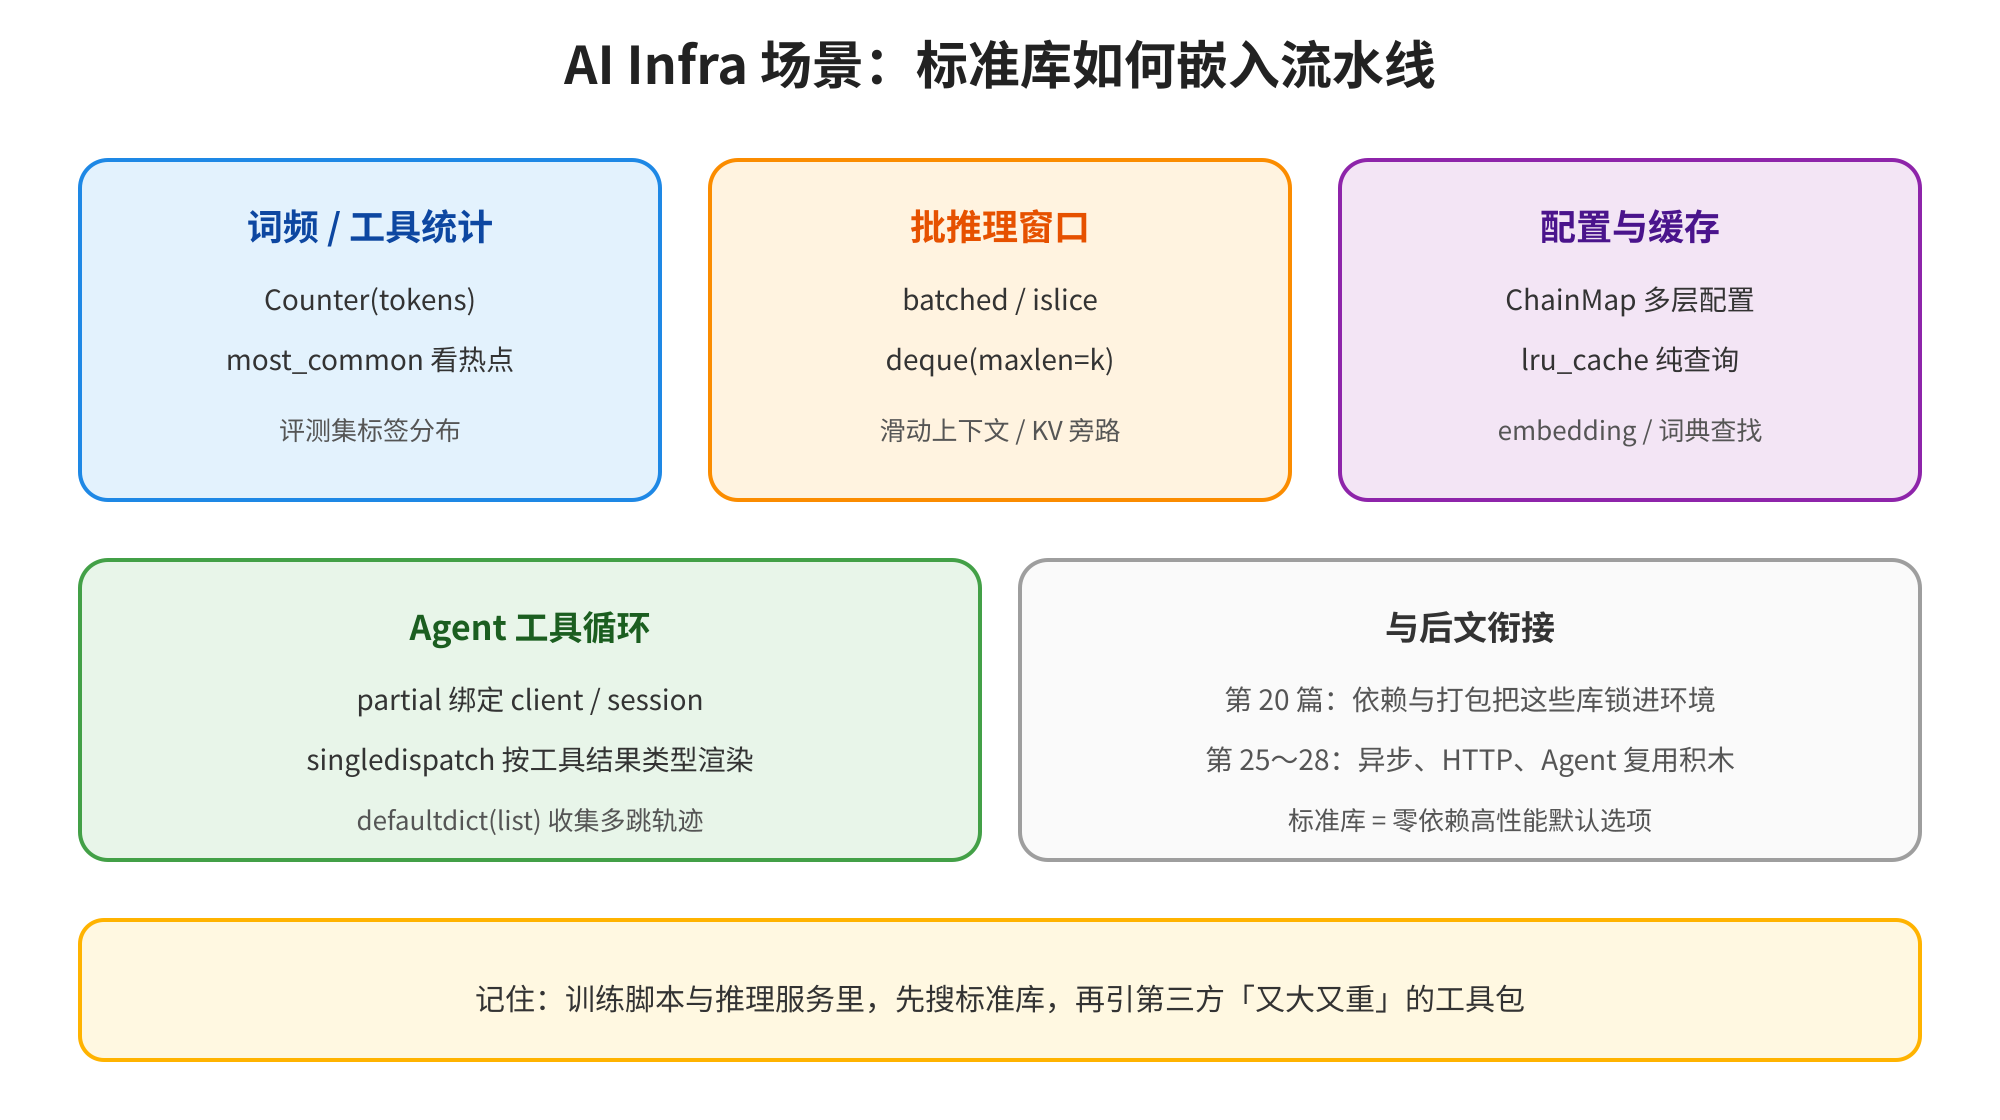
图5 AI Infra 场景:标准库如何嵌入流水线
6.1 评测与数据分析
from collections import Counter

preds = ["pos", "neg", "pos", "pos", "neg"]
labels = ["pos", "neg", "neg", "pos", "neg"]
print("pred", Counter(preds))
print("label", Counter(labels))
print("ok", sum(p == y for p, y in zip(preds, labels, strict=True)))
pred Counter({'pos': 3, 'neg': 2})
label Counter({'neg': 3, 'pos': 2})
ok 4
6.2 批请求与上下文窗口
from collections import deque
from itertools import batched

def iter_batches(items: list[str], size: int):
    for batch in batched(items, size):
        yield list(batch)


ctx = deque(maxlen=4)
for turn in ["hi", "need help", "about GPU", "oom", "retry"]:
    ctx.append(turn)
print("context", list(ctx))
print(list(iter_batches(list(range(8)), 3)))
context ['need help', 'about GPU', 'oom', 'retry']
[[0, 1, 2], [3, 4, 5], [6, 7]]
落到 AI Infra 时再强调一次边界:标准库解决进程内的结构与变换;模型权重、向量检索、分布式队列是另一层。用 lru_cache 加速「词表 id 查询」很香;用它缓存「一次完整的大模型 HTTP 响应」则要谨慎——响应大、易过期、且可能含用户数据。积木对不对,取决于问题半径。
6.3 Agent 工具循环里的绑定与分发
from collections import defaultdict
from functools import partial, singledispatch

traces: dict[str, list[str]] = defaultdict(list)


def call_tool(name: str, payload: str, *, session: str) -> str:
    traces[session].append(name)
    return f"{name}:{payload}"


run = partial(call_tool, session="s1")
print(run("search", "GIL"), run("fetch", "url"))


@singledispatch
def render(result: object) -> str:
    return str(result)


@render.register
def _(result: dict) -> str:
    return ",".join(f"{k}={v}" for k, v in result.items())


print(render({"hits": 3}), dict(traces))
search:GIL fetch:url
hits=3 {'s1': ['search', 'fetch']}
第 28 篇最小 Agent 会把工具调用循环写全;本篇先把「绑定 session、收集轨迹、按类型渲染」这三块积木揣进口袋。
七、踩坑大全
通用
坑 1:把 deque 当数组随机下标狂取。 现象:比 list 还慢。原因:双端优、中间随机访问不优。解决:随机访问用 list;只要两端用 deque。
坑 2:defaultdict 静默造键。 现象:if d[k]: 或打印时冒出一堆空键。原因:getitem 会调用工厂。解决:探测用 k in d / d.get;或转成普通 dict 再对外返回。
坑 3:groupby 未排序。 现象:同一键出现多组。原因:只合并相邻相同键。解决:先按同一 key 排序,或改用 defaultdict(list) 做真分组。
坑 4:迭代器耗尽后二次 for。 现象:第二次为空。原因:第 15 篇讲过的一次性。解决:要多次消费就物化 list,或 tee(接受缓冲成本)。
坑 5:lru_cache 缓存了带副作用的函数。 现象:写文件 / 请求网络只发生一次;或读到过期配置。解决:只缓存纯计算;有状态用显式字典并自行失效。
坑 6:不可哈希参数进缓存。 现象:TypeError: unhashable type: 'list'。解决:改传 tuple / frozenset,或自己做 key 规范化。
坑 7:Counter 减法出现空键预期不符。 现象:以为留下 0。原因:a - b 只保留正计数。解决:需要 0 值时用减法循环或 subtract 后再过滤。
坑 8:partial 与默认参数混淆。 现象:位置参数绑定错位。解决:优先用关键字绑定(partial(f, exp=2));读 partial.args / keywords 调试。
macOS / Linux / Windows
坑 9:旧 Python 无 batched。 现象:ImportError。解决:升级到 3.12+,或手写:
def batched(iterable, n):
    it = iter(iterable)
    while batch := tuple(islice(it, n)):
        yield batch
坑 10:Windows 控制台编码。 现象:打印 Counter 含中文乱码。解决:终端 UTF-8;文件读写显式 encoding="utf-8"(与第 10 篇一致)。
与框架叠加
坑 11:在多进程里共用一个 lru_cache。 现象:子进程缓存不共享或重复计算。原因:缓存在进程地址空间内。解决:跨进程用真正的外部缓存;或接受每进程一份。
坑 12:Agent 里缓存「带时间 / 用户」的查询。 现象:用户 A 命中用户 B 的结果。解决:key 必须包含 user / tenant;或干脆不缓存个性化结果。
八、小结
合上文章后,试着用自己的话说明:为什么 list.pop(0) 该换成 deque,以及 lru_cache 为什么要求参数可哈希。讲得清,才算真的会了。动手至少跑通:Counter.most_common、一条 islice 管道、一个 partial + lru_cache 示例。
collections:Counter计数、defaultdict分组、deque双端 / 窗口、namedtuple/ChainMap轻量结构与多层查找。itertools:惰性组合子——chain/islice/groupby/product/tee/batched;注意一次性与排序前提。functools:partial绑定、lru_cache缓存纯函数、singledispatch按类型扩展、wraps保元数据。- 组合:容器装数据 → 迭代器变换 → 函数工具绑定与加速。
- 选型:标准库优先;重复模式出现就换积木名,不为炫技拧逻辑。
- AI Infra:词频与标签、批切分、上下文窗口、工具循环绑定 / 分发,都是同一套积木。
把故事连起来:第 04~05 篇容器 → 第 15 篇流式 → 第 16 篇装饰器 → 第 18 篇合同 → 本篇把高频标准库收进口袋。专栏二工程刀具继续成套:下一站是虚拟环境与打包(20),把这些电池锁进可复现环境。
若只能带走一句话:先搜标准库,再造轮子;注解描形状,积木提效率。
也可以用「三个不要」自检:不要用 list.pop(0) 当队列;不要对脏函数瞎加 lru_cache;不要在未排序数据上指望 groupby 做 SQL 式分组。
再留一个自测:说出 Counter 与 defaultdict(int) 各适合什么;用 islice 取生成器前 10 项;给一个双参数函数写 partial——三问都顺,本篇就站稳了。
本篇技能会立刻复利:读框架源码时认出 deque / partial;写评测脚本先 Counter;写 Agent 时用 defaultdict 收轨迹。后续打包、日志、测试、并发,都是在「会用积木」的基础上继续加能力。
和专栏一串起来复习也不亏:列表字典(04~05)是容器基础;迭代器(15)解释惰性;装饰器(16)解释 wraps / lru_cache;类型(18)给积木挂注解——本篇是专栏二把「日常标准库」立成一等工具的一课。
也可以把收获压成检查清单:会选 Counter/deque/defaultdict;会搭 islice 管道;会用 partial 与 lru_cache;知道 groupby 与缓存禁忌;能举一个 AI Infra 落点。五项过关,即可进入虚拟环境与打包篇。
若把本篇压成给同事的三十秒讲解:先画「容器 / 迭代 / 函数」三块;再各举一个替换手写样板的例子;最后强调「惰性与纯函数」两条纪律。三张草图比贴一篇博客更管用。等对方能独立把词频脚本改成 Counter + most_common,并解释为什么不要缓存带用户态的查询,就可以一起 code review 训练与 Agent 脚本了。
动手清单再压缩一版:统计一段文本词频;用 deque(maxlen=5) 模拟上下文;用 partial 固定日志前缀;给纯函数加 lru_cache 并看 cache_info。四步做完,比只「看完文章」扎实一个数量级。
九、课后练习
- (基础) 用
Counter统计一段中英文混合字符串中字母(忽略大小写)的频次,打印most_common(5)。 - (基础) 用
defaultdict(set)把(user, tag)列表聚成「用户 → 标签集合」,再转成普通dict打印。 - (基础) 用
deque(maxlen=3)模拟最近三条日志;再对比错误写法list+pop(0)的接口差异(不必测性能)。 - (理解) 用
groupby对已排序的(date, event)按日期分组计数;故意打乱顺序再跑一次,解释现象。 - (理解) 写
partial(str.split, sep=",")处理多行 CSV 风格字符串;再写成lambda对比可读性与调试信息。 - (理解) 给斐波那契或「字符串规范化」加
lru_cache,打印cache_info;尝试传入list参数,记录报错并修复为tuple。 - (进阶) 用
singledispatch实现to_prompt(obj):支持str、dict、list,默认分支返回repr;为dict写成多行k: v。 - (进阶 · AI Infra) 组合题:读入若干行用户消息,用
deque(maxlen=K)维护窗口,用Counter统计窗口内词频,用batched把历史 id 列表按批打印。讨论:窗口大小 K 与批大小如何影响「上下文相关性」和「请求次数」?
下一篇预告
下一篇是《第20篇|虚拟环境、依赖管理与打包》——在标准库积木揣进口袋之后,解决「同一套代码如何在同事机器、CI、GPU 服务器上复现」:uv / venv、锁文件、pyproject.toml、可编辑安装与基础打包。你会看到:标准库是零依赖默认选项;一旦引入 Pydantic / FastAPI / PyTorch,就必须把环境钉死。
专栏二后续路线:虚拟环境与打包 → 日志调试性能 → pytest → 并发与 asyncio → HTTP / FastAPI → 最小 Agent。带着本篇的积木直觉,读源码时先认容器与函数工具,再跟业务分支。
若想提前热身:用 uv init --no-package 建空项目,uv add 一个小库再 uv run 跑本篇 Counter 示例;打开 pyproject.toml 看依赖如何声明。做完后第 20 篇谈锁文件与打包时你会带着具体文件感。
也可以把第 15~19 篇对照:生成器产流、装饰器横切、上下文管资源、类型管形状、标准库给积木——工程五件套的轮廓已经清晰,下一篇把「跑起来的环境」也工程化。
专栏一用十四篇把「对象与协议」立住;专栏二从迭代器(15)走到标准库(19),下一站是虚拟环境与打包。下一篇见。
若时间充裕,再多做一件事:打开你写过的脚本,找出三处「手写计数 / pop(0) / 固定参数的 lambda」,改成 Counter / deque / partial,并给其中一处纯函数加上 lru_cache。改完后你会更笃定:专栏二不是要你背更多 API,而是把已经会的循环与函数,接到标准库的稳定积木上。
进入专栏二至此,五把刀具已经齐:生成器管「流」、装饰器管「横切」、上下文管「资源」、类型管「形状」、标准库管「日常积木」。下一篇开始把环境与依赖钉牢,工程味道会从「脚本能跑」变成「别人也能跑」。若某一节读着抽象,回到对应插图把箭头走一遍,再手打示例——多数卡住的地方,其实是「惰性耗尽」与「缓存纯度」被混成一件事。
写 groupby 或 lru_cache 时再记一条:错误往往来自前提被忽略(未排序、不可哈希、有副作用)。和「堆栈很长但根因很浅」相比,先检查前提能省很多时间。
也可以把本篇看成专栏二的「标准库面」补课:前面把协议立住,本篇把高频工具收齐。后面打包篇会教你如何声明与锁定依赖;测试篇会教你如何为缓存与分发写断言;FastAPI 与 Agent 篇则把这些积木接到网络与工具调用上。
若阅读时觉得 itertools 和生成器总搅在一起,回到图 3:生成器解决「怎么产」,itertools 解决「怎么拼」。日常编程两者都要,但职责不同——混谈是多数初学者卡住的根源。
收官前对照练习:同一份「日志行列表」,分别用手写 dict 计数、Counter、再加 islice 只看前 100 行。你会清楚感受到:标准库不是纸面游戏,而是把日常数据处理抬到与框架源码同一套操作面的关键一步——也是专栏二工程化与服务 / Agent 对接的入场券之一。
写完练习后,不妨在自己的仓库里开一个小 PR:只替换三处明显的手写样板为标准库积木,不改业务语义。这种「小步替换」比空读文档更能把 API 刻进肌肉记忆,也更适合团队推广。
若你带新人,可以把本篇插图打印成一页速查:左列场景,右列积木名。新人写评测脚本时对着贴,两周后就会自然说出 most_common 与 maxlen。工具文化是带出来的,不是靠一次分享会喊出来的。
最后把专栏二的位置再钉一次:协议篇(15~18)解决「怎么正确接线」;本篇解决「接线时手里有哪些趁手工具」;下一篇解决「工具与依赖如何在每台机器上一致」。三者齐备,脚本才既写得快,又交得出去。