
第21篇|日志、调试与性能分析
本篇定位:《Python 教程》专栏二「Python 进阶与工程」第 21 篇。承接第 20 篇「环境可复现」之后,把运行时的眼睛与听诊器配齐:
logging分层与配置、pdb/breakpoint断点调试、cProfile/py-spy性能采样,并简要对接 PyTorch Profiler 的 AI Infra 视角。为第 22 篇 pytest、第 26~28 篇 HTTP / FastAPI / Agent 提供可观测底座。读完你将能够:用
logging取代散落的breakpoint()与 pdb 命令检查栈与局部变量;用time.perf_counter、cProfile、py-spy区分「慢在哪一层」;解释训练 / 推理场景下为何要结构化日志 + profiler,而不是只靠肉眼看进度条。预计用时:阅读 35~45 分钟,动手 30~40 分钟。
第 20 篇解决了「同事机器能装出同一棵依赖树」;本篇回答更日常的问题——跑起来之后,出了问题你怎么看见?慢了你怎么量? 只靠 print("here") 不够:线上没有你的终端,异步与多 worker 会把输出搅成浆糊,性能问题更不可能靠肉眼数秒表。
一句话定心:日志负责「发生了什么」;调试负责「现在卡在哪」;性能分析负责「时间花在哪」。 三者都是工程能力,不是「出了 bug 才临时学」的急救包。
建议边读边在第 20 篇的练习项目里动手(uv run)。阅读顺序:可观测心智 → logging 四级件 → 配置与结构化 → 断点调试 → 计时与 profiler → AI Infra 简图 → 踩坑。下一篇预告单元测试 pytest(22):能看见问题之后,再谈「如何用断言把正确性钉死」。
和第 11 篇对照:异常告诉你「炸了」;日志告诉你「炸之前发生了什么」。和第 16 篇对照:装饰器常被用来统一打点、计时、记录入参——横切关注点与本篇天然相邻。和第 17 篇对照:with 可以包住计时区间或临时改日志级别。和第 20 篇对照:锁文件保证「同一套代码」;本篇保证「同一套代码出问题时有同一套眼睛」。
动手时建议沿用「小推理客户端」意象:请求前打 INFO(model、latency 预算),失败打 ERROR(status、重试次数),热点路径用 cProfile 或 perf_counter 粗测。做完后打开任意开源服务的日志配置,你会认出同一套形状。
本篇不穷尽 ELK / Loki 运维栈、不深入 gdb / C 扩展调试、不替代完整 APM 产品课。主线是:心智模型 → logging 工程用法 → 交互调试 → 性能分层工具 → AI 场景挂钩。和「到处 print 再删」相比,工程日志的价值是:可分级、可落盘、可检索、可与请求 ID 关联。
写日志时保持一个工程直觉:日志是给未来的自己与值班同事看的合同,不是给现在的自己看的便签。 「奇怪,刚才那次请求」如果不落结构化字段,三小时后就变成传说。社区里那些「只剩 tqdm 进度条、没有 request_id」的服务,往往是排障地狱的入口。
也可以把本篇看成专栏二的「可观测面」补课:第 15~19 篇把协议与积木立住,第 20 篇钉环境,本篇把运行时可见性工程化。后面测试、并发、服务,都假设「你知道如何打点与断点」。
读官方 logging HOWTO、pdb 文档与 PyTorch Profiler 指南时,按本篇目录对照即可。入门阶段把「会配置、会断点、会粗测、会读火焰图心智」做扎实,比背完整 Handler 子类表更重要。
动手时再记一条:性能优化的第一原则是先测量再动手——过早微优化往往不如先确认「慢在 I/O、CPU 还是 GPU 等待」。排障时一条带 request_id 的 ERROR,往往比一百行无上下文的 DEBUG 更值钱。
和「出了问题再把日志级别调到 DEBUG 却忘了改回」相比,本篇推荐的默认策略是:开发可啰嗦,生产默认 INFO;用配置与环境变量切换,而不是改代码重新部署才想起分级。 这个习惯在夜班告警、事故复盘、开源贡献时都会回报你。
若你刚从第 20 篇「锁与打包」过来,本篇前两节会换一种爽感:同样是工程化,但挂钩点从「装得一样」换成「跑得明白」。把 print 改成 logger.info,把「大概慢」改成 cProfile 报表——两条路径走完,可观测直觉就长出来了。
和「在聊天里口头描述复现步骤」相比,结构化日志 + 栈信息的价值是:机器可读、可关联、可回放——本地、CI、GPU 服务器上同一套字段。排障时你面对的是级别、时间戳与关键字段,而不是「我记得大概报错了」。
一、可观测三件套:日志、调试、性能
1.1 一张图看清分工
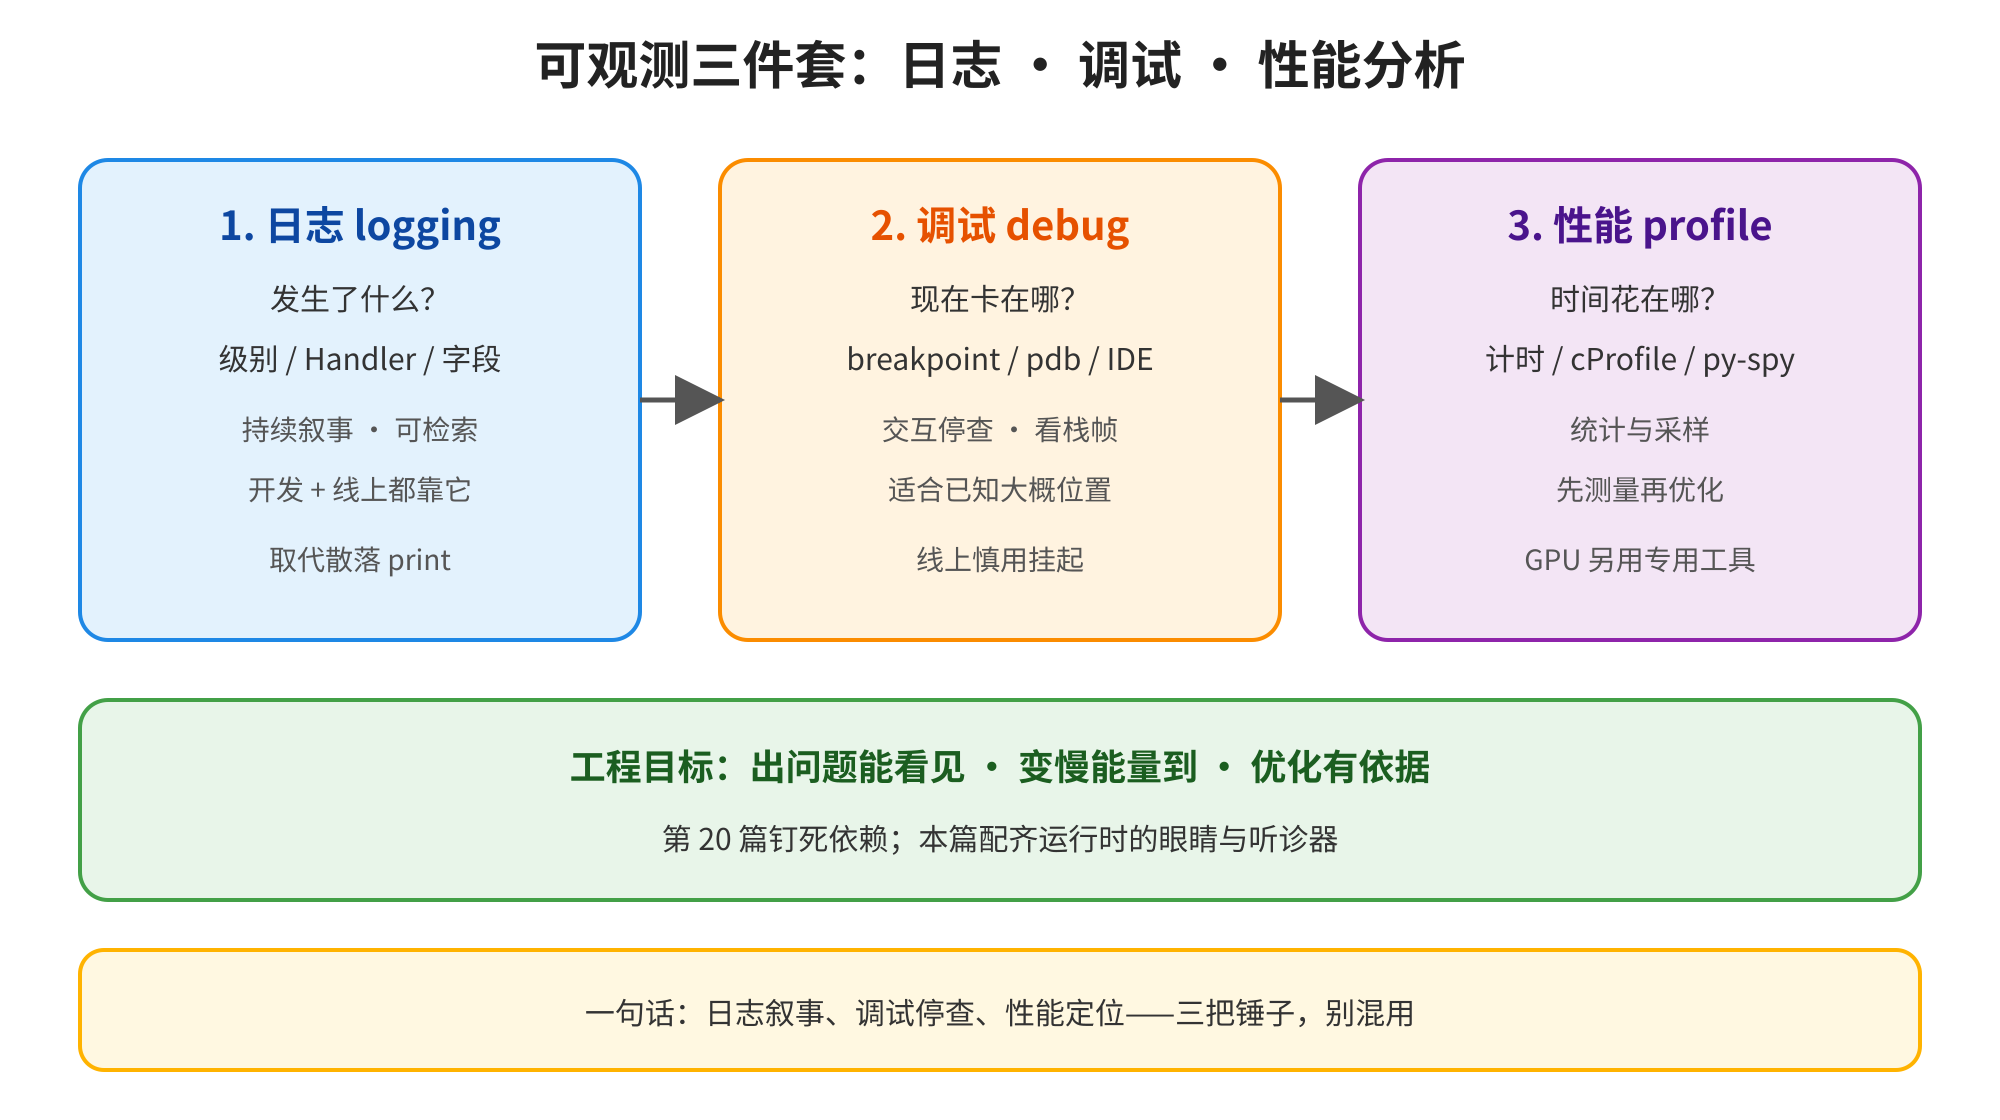
图1 可观测三件套:日志 · 调试 · 性能分析
import logging
import time

logging.basicConfig(level=logging.INFO, format="%(levelname)s %(message)s")
log = logging.getLogger("demo")

def work(n: int) -> int:
    t0 = time.perf_counter()
    s = sum(range(n))
    log.info("work done n=%s elapsed_ms=%.2f", n, (time.perf_counter() - t0) * 1000)
    return s

print(work(1_000_000))
INFO work done n=1000000 elapsed_ms=...
499999500000
要点:
- 日志是持续产出的叙事——不只在崩溃时存在。
- 调试是交互式停下来看——适合「已知大概位置」。
- 性能分析是统计与采样——适合「不知道慢在哪」。
1.2 和第 11、16、20 篇的边界
第 11 篇已讲 try/except 与异常链;本篇默认你会捕获并记录异常(logger.exception),而不是只 print(e)。第 16 篇的装饰器可统一计时与审计;本篇提供装饰器里该写什么。第 20 篇保证依赖一致;本篇假设 uv run 已就绪。
AI Infra 视角:推理服务的一次慢请求,可能慢在 tokenization、排队、GPU kernel、还是网络回包。没有分级日志与 profiler,值班只能猜。vLLM / SGLang 类系统把「指标 + 日志 + trace」当一等公民,不是装饰。
1.3 渐进采用
老脚本全是 print?可以:先把关键路径换成 logging.getLogger(name),级别 INFO;调试期临时 DEBUG;上线用文件或 stderr Handler。不必一天引入完整可观测平台,但新代码不要再增加无级别的 print 叙事。
二、logging 四级件:Logger、Handler、Filter、Formatter
2.1 级别金字塔
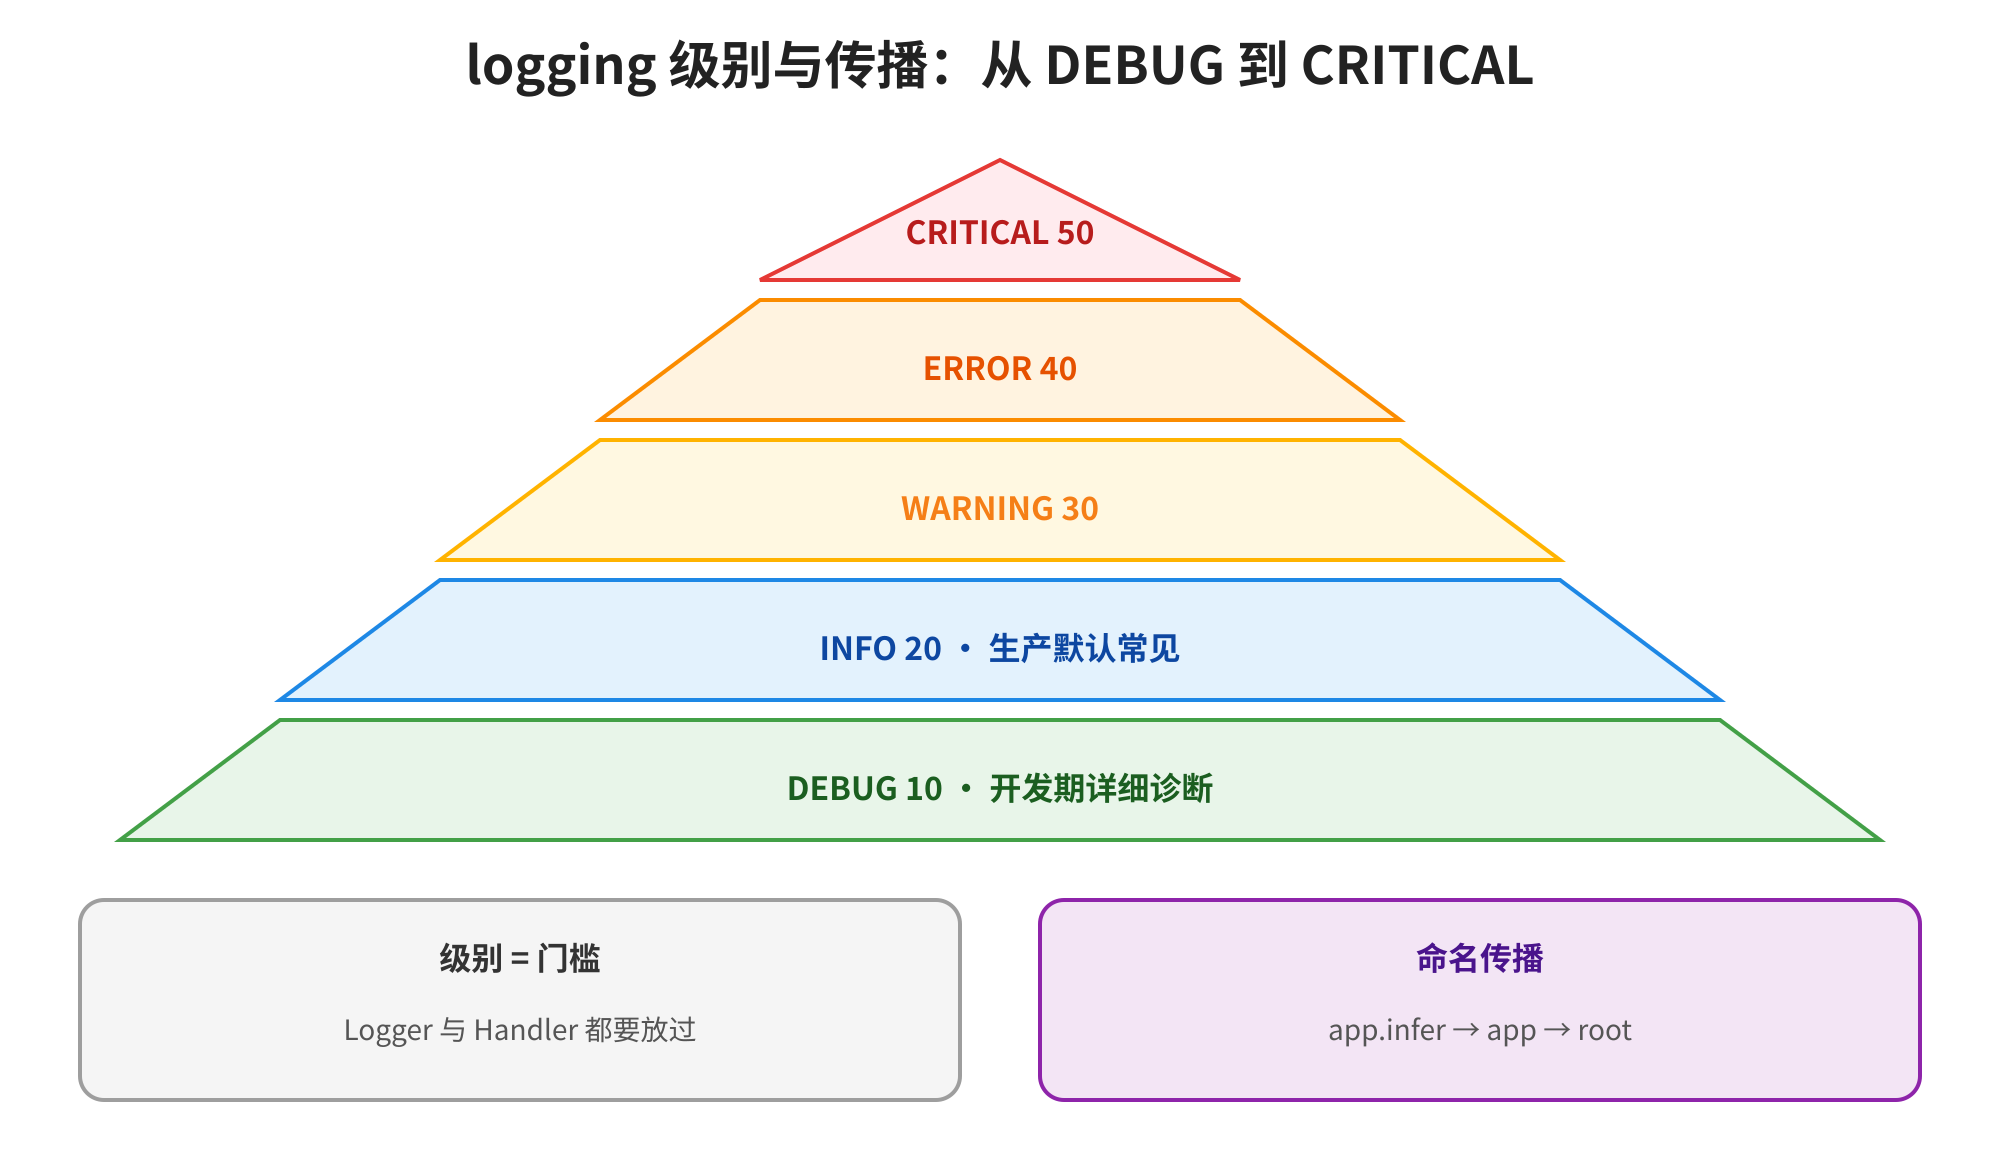
图2 logging 级别与传播:从 DEBUG 到 CRITICAL
import logging

logging.basicConfig(
    level=logging.DEBUG,
    format="%(asctime)s %(levelname)s [%(name)s] %(message)s",
)
logger = logging.getLogger("app.infer")

logger.debug("batch shape=%s", (8, 128))
logger.info("request ok latency_ms=%s", 42)
logger.warning("retry %s/%s", 1, 3)
logger.error("upstream timeout")
记忆口诀:级别是门槛——Logger 与 Handler 都可以设 level;消息要「两边都过」才会输出。
2.2 传播与命名
import logging

root = logging.getLogger()           # 根
app = logging.getLogger("app")       # 子
infer = logging.getLogger("app.infer")

# 默认 propagate=True:子 Logger 处理完还会传给父
infer.info("hello")  # 若只给 root 配了 Handler,也能看见
推荐:logging.getLogger(name),与模块树同构,便于按包过滤。避免到处 getLogger("root") 式的扁平命名。
2.3 Handler 与 Formatter
import logging
from logging.handlers import RotatingFileHandler

logger = logging.getLogger("app")
logger.setLevel(logging.INFO)
logger.handlers.clear()
logger.propagate = False

fmt = logging.Formatter(
    "%(asctime)s %(levelname)s [%(name)s] %(message)s"
)

sh = logging.StreamHandler()
sh.setLevel(logging.INFO)
sh.setFormatter(fmt)

fh = RotatingFileHandler("app.log", maxBytes=1_000_000, backupCount=3, encoding="utf-8")
fh.setLevel(logging.DEBUG)
fh.setFormatter(fmt)

logger.addHandler(sh)
logger.addHandler(fh)
logger.info("handlers ready")
要点:
- Logger 选消息,Handler 选去向(终端 / 文件 / syslog)。
- Formatter 只负责字符串形状,不决定是否输出。
- 生产常用轮转文件或交给进程管理器收 stderr,避免单文件撑爆磁盘。
2.4 logger.exception 与堆栈
import logging

log = logging.getLogger("app")
logging.basicConfig(level=logging.INFO)

try:
    1 / 0
except ZeroDivisionError:
    log.exception("divide failed")  # 等价于 ERROR + 异常栈
在 except 块里优先 exception / error(..., exc_info=True),不要只记 str(e)——栈才是排障主粮。
三、配置、结构化与请求上下文
3.1 dictConfig:配置与代码分离
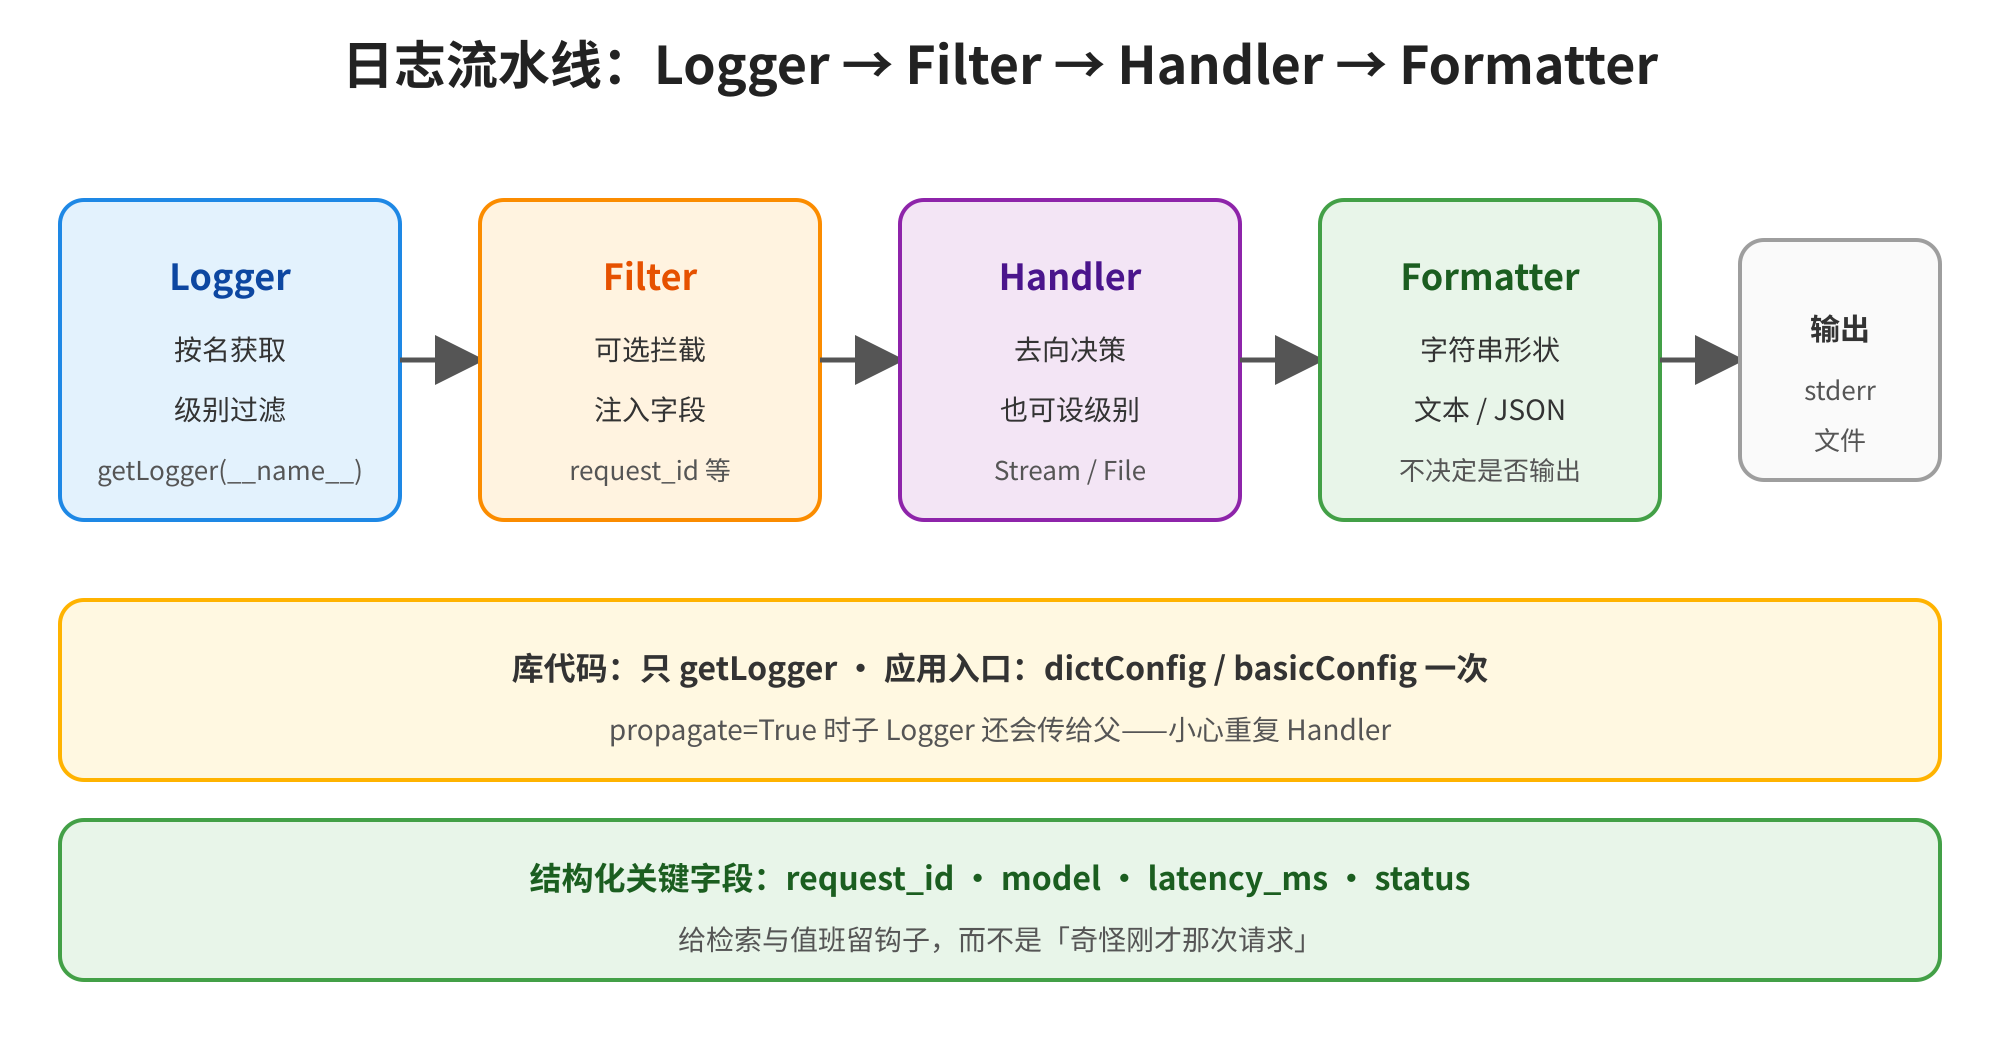
图3 日志流水线:Logger → Filter → Handler → Formatter → 输出
import logging.config

LOGGING = {
    "version": 1,
    "disable_existing_loggers": False,
    "formatters": {
        "standard": {
            "format": "%(asctime)s %(levelname)s [%(name)s] %(message)s"
        }
    },
    "handlers": {
        "console": {
            "class": "logging.StreamHandler",
            "level": "INFO",
            "formatter": "standard",
        }
    },
    "root": {"level": "INFO", "handlers": ["console"]},
    "loggers": {
        "app": {"level": "DEBUG", "handlers": ["console"], "propagate": False}
    },
}

logging.config.dictConfig(LOGGING)
logging.getLogger("app").debug("dictConfig ok")
库代码里:只 getLogger,不要 basicConfig——配置权交给应用入口(FastAPI / 脚本 main)。否则第三方库一初始化就抢走 root 配置,调试时你会怀疑人生。
3.2 结构化字段:给检索留钩子
import json
import logging

class JsonFormatter(logging.Formatter):
    def format(self, record: logging.LogRecord) -> str:
        payload = {
            "level": record.levelname,
            "logger": record.name,
            "msg": record.getMessage(),
        }
        if hasattr(record, "request_id"):
            payload["request_id"] = record.request_id
        return json.dumps(payload, ensure_ascii=False)

log = logging.getLogger("api")
log.handlers.clear()
log.propagate = False
h = logging.StreamHandler()
h.setFormatter(JsonFormatter())
log.addHandler(h)
log.setLevel(logging.INFO)

log.info("done", extra={"request_id": "req-7f3a"})
{"level": "INFO", "logger": "api", "msg": "done", "request_id": "req-7f3a"}
AI 服务里至少预留:request_id、model、latency_ms、token_in / token_out、错误码。字段稳定后,Grafana / Loki / 云日志才能吃得下去。
3.3 Filter 与上下文(轻量)
import logging

class RequestIdFilter(logging.Filter):
    def __init__(self, request_id: str) -> None:
        super().__init__()
        self.request_id = request_id

    def filter(self, record: logging.LogRecord) -> bool:
        record.request_id = self.request_id
        return True
更完整的方案会用 contextvars 在中间件里注入请求 ID(第 25、27 篇会更自然)。本篇先建立「字段要进 LogRecord」的直觉。
四、调试:breakpoint、pdb 与 IDE
4.1 breakpoint() 是现代入口
def normalize(scores: list[float]) -> list[float]:
    total = sum(scores)
    breakpoint()  # 等价于调用 pdb.set_trace(可配置 PYTHONBREAKPOINT)
    return [s / total for s in scores]

normalize([1.0, 2.0, 3.0])
进入 pdb 后常用命令:
uv run python script.py
# 或直接:
uv run python -m pdb script.py
4.2 条件断点与事后调试
for i, item in enumerate(batch):
    if i == 17 and item["bad"]:
        breakpoint()
崩溃后想看栈:python -m pdb -c continue script.py,或在异常处设 breakpoint()。IDE(VS Code / PyCharm)本质是图形化的同一套协议——学会 pdb 命令后,IDE 只是更快。
4.3 调试礼仪
- 不要在库的深层循环里无条件狂断——会不可用。
- 敏感数据别
pp到共享屏幕——token、密钥、用户原文。 - 线上优先日志与采样,不要开 pdb 挂住 worker(会拖死服务)。
AI Infra 视角:训练 job 挂在某个 step,优先看日志里的 step / loss / OOM;需要交互时用单进程小 batch 本地复现,而不是在 8 卡任务里随手
breakpoint()。
五、性能分析:先分层,再选工具
5.1 计时金字塔
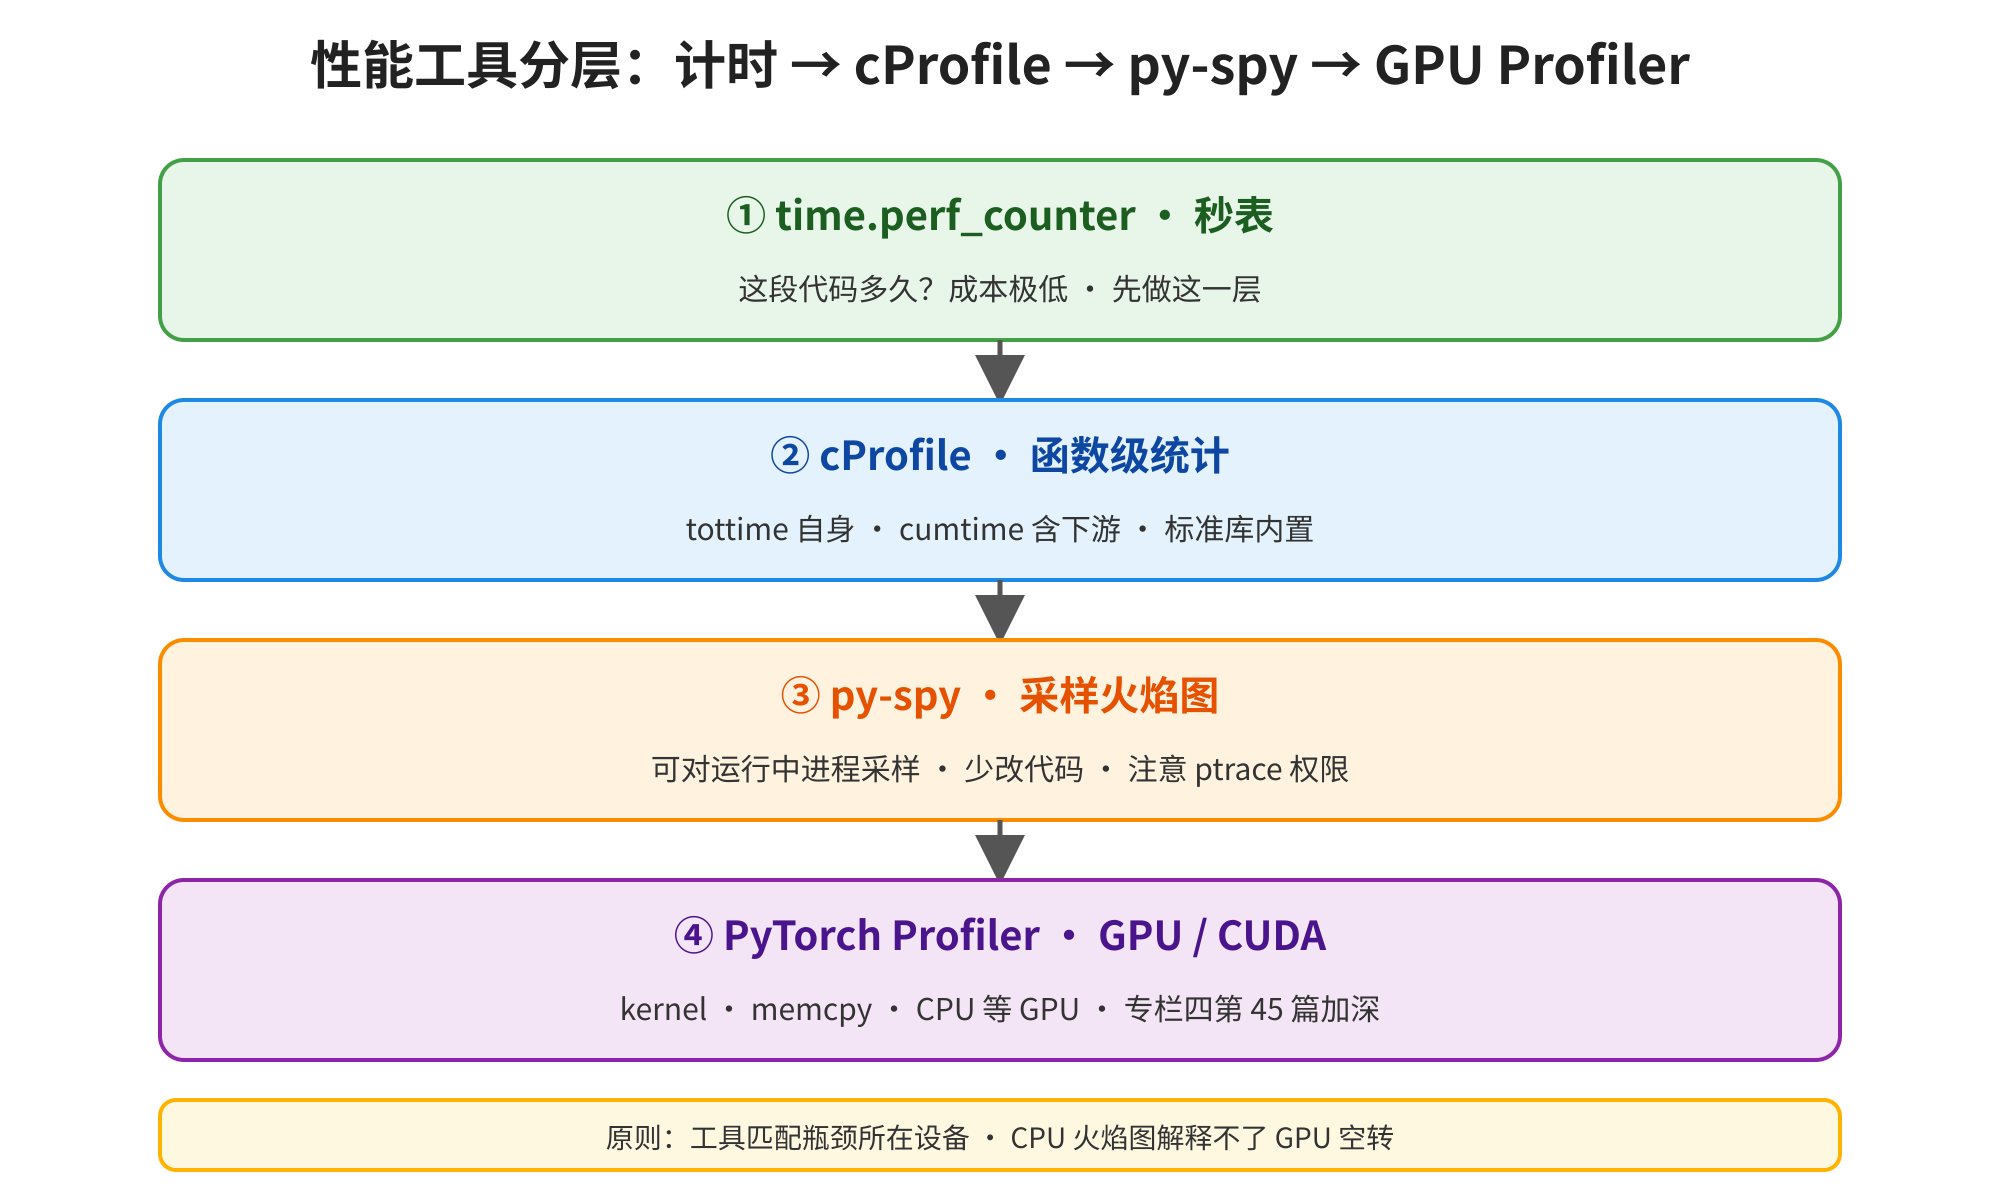
图4 性能工具分层:计时 → cProfile → py-spy → GPU Profiler
import time

def heavy(n: int) -> int:
    return sum(i * i for i in range(n))

t0 = time.perf_counter()
heavy(2_000_000)
print(f"elapsed_ms={(time.perf_counter() - t0) * 1000:.2f}")
先秒表,再 profiler。 若整段只要 2ms,别为它开一场火焰图仪式。
5.2 cProfile:标准库内置
import cProfile
import pstats
from io import StringIO

def a() -> None:
    sum(range(200_000))

def b() -> None:
    for _ in range(50):
        a()

pr = cProfile.Profile()
pr.enable()
b()
pr.disable()

buf = StringIO()
ps = pstats.Stats(pr, stream=buf).sort_stats("cumulative")
ps.print_stats(10)
print(buf.getvalue())
或命令行:
uv run python -m cProfile -s cumulative script.py | head
读报表时盯:tottime(自身) 与 cumtime(含子调用)。cumtime 高、tottime 低 → 时间在下游;两者都高 → 函数本身重。
5.3 py-spy:低开销采样(了解)
# 需另行安装;对正在跑的进程采样(示意)
# uv add --dev py-spy
# py-spy top --pid <PID>
# py-spy record -o profile.svg -- python script.py
适合:不想改代码、想对「已经很慢的服务」拍一张火焰图。注意权限(容器里可能要 --cap-add SYS_PTRACE)与符号是否可读。
5.4 常见性能直觉(Python)
- 纯 Python 双重循环扛大矩阵 → 考虑 NumPy / PyTorch 向量化(专栏三、四)。
- 反复小文件 I/O、同步 HTTP → 批量与连接池(第 26 篇)。
- GIL 下 CPU 密集多线程 → 别指望线性加速(第 23~24 篇)。
- 日志字符串在 DEBUG 关闭时仍先格式化 → 用
%惰性参数或isEnabledFor,避免热路径造大字符串。
# 推荐:惰性格式化
logger.debug("tensor=%s", big_tensor)

# 昂贵时先判断
if logger.isEnabledFor(logging.DEBUG):
    logger.debug("dump=%s", expensive_serialize(obj))
六、AI Infra 简图:训练 / 推理怎么看慢
6.1 一张图:请求路径上的探针
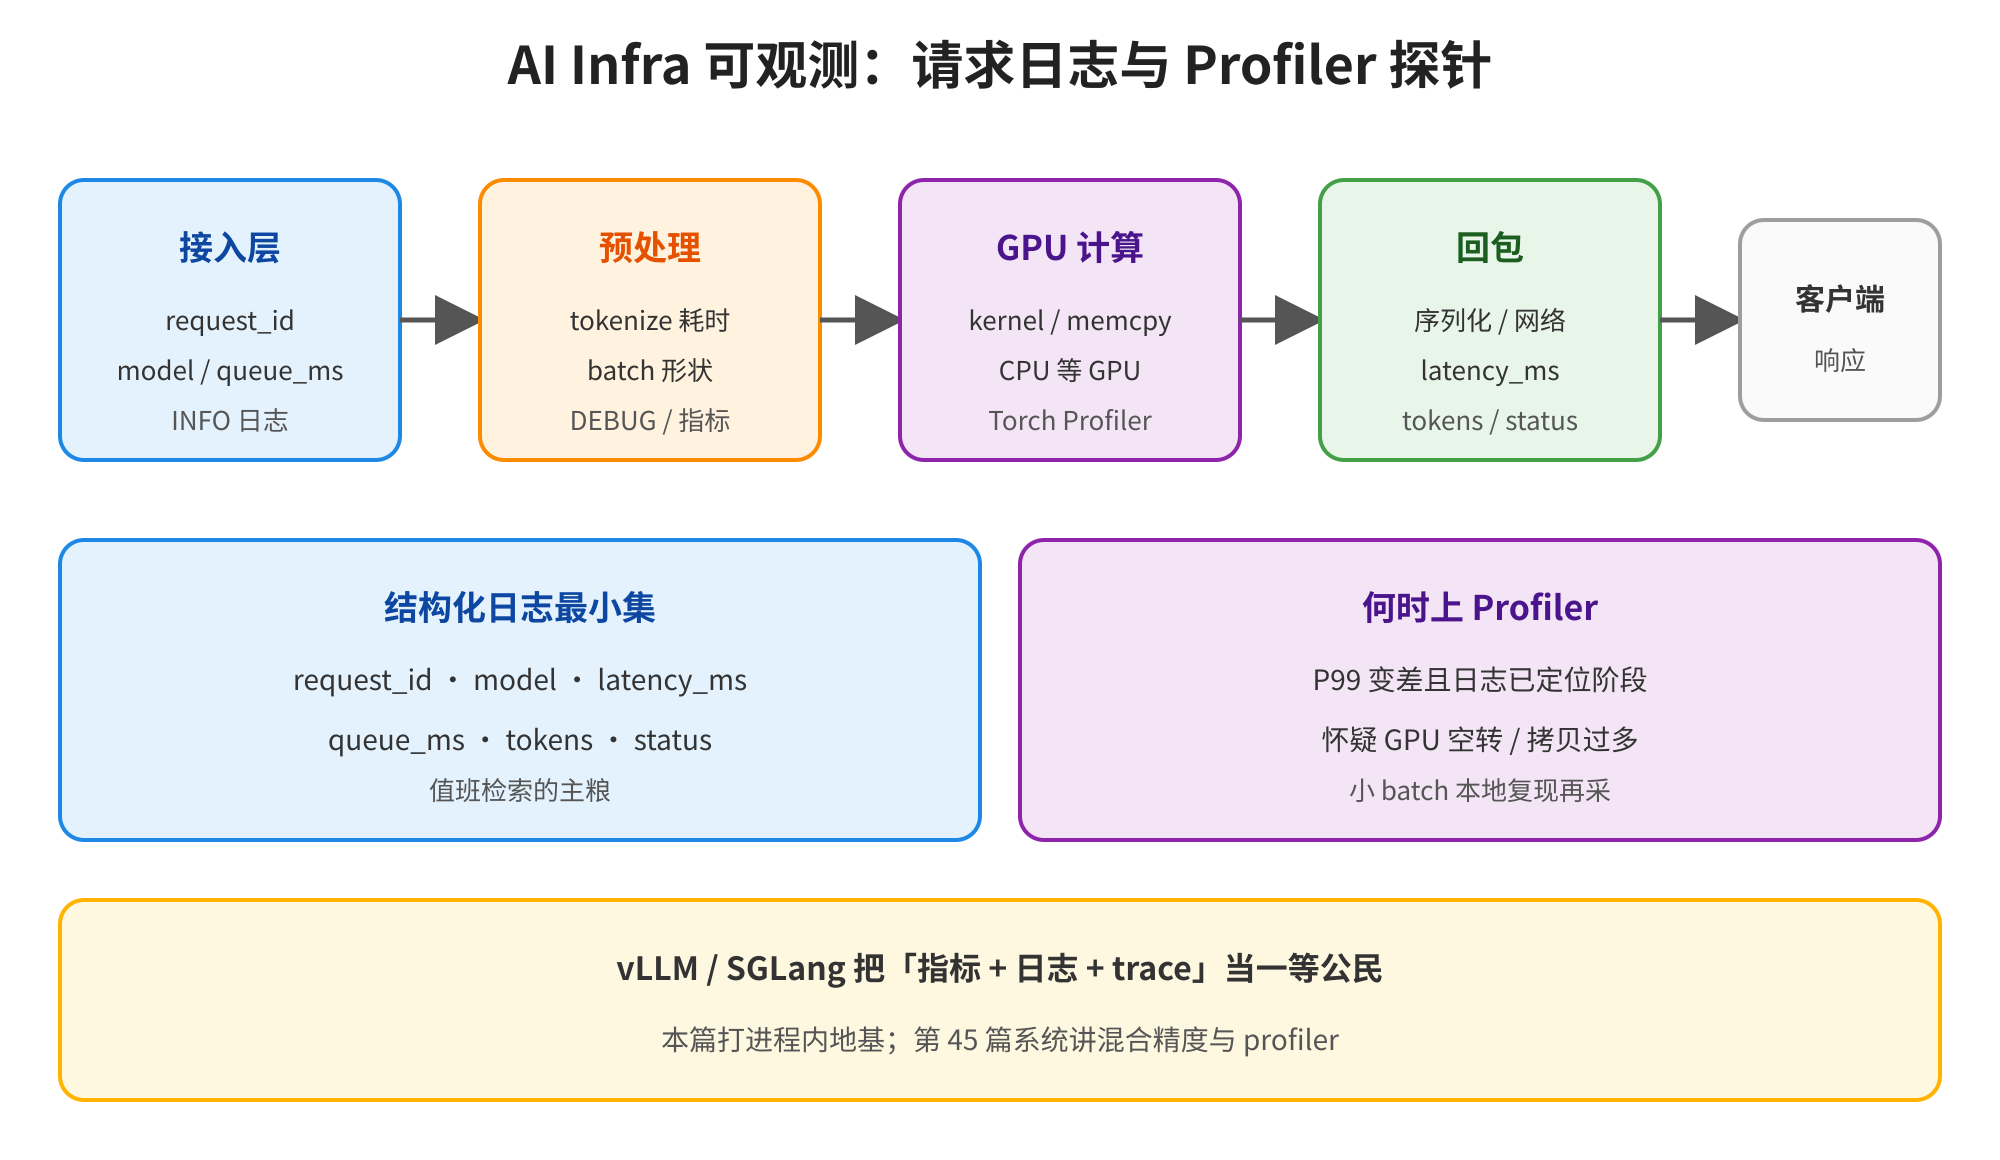
图5 AI Infra 可观测:请求日志与 Profiler 探针
推理路径示意:
- 接入层:打
request_id、模型名、队列等待时间(INFO)。 - 预处理:tokenizer 耗时(DEBUG / 指标)。
- GPU 计算:用 PyTorch Profiler 看
cudakernel、memcpy、CPU 等 GPU。 - 后处理与回包:序列化与网络(常被忽略的 I/O)。
# 极简 torch profiler 示意(需已安装 torch;不必本篇真跑大模型)
# import torch
# from torch.profiler import profile, ProfilerActivity
#
# with profile(activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA]) as prof:
#     model(input_ids)
# print(prof.key_averages().table(sort_by="cuda_time_total", row_limit=10))
专栏四第 45 篇会系统讲混合精度与 profiler;本篇只需建立:CPU 火焰图解释不了 GPU 空转——工具要匹配瓶颈所在设备。
6.2 日志字段最小集(服务)
把这些打进结构化日志,比在群里问「谁的请求又慢了」高效一个数量级。
6.3 和测试、监控的分工
- 本篇:进程内眼睛(log / pdb / profile)。
- 第 22 篇:正确性断言(pytest)——可观测 ≠ 测过。
- 后续服务篇:指标(QPS、P99)、健康检查、链路追踪会叠加上来。
先把进程内三件套用熟,再谈平台级可观测,不会在概念上打架。
读到这里,不妨停一秒做个自我检查:你能不能在白板上画出 Logger → Handler → Formatter,并标出级别门槛作用在哪两处?能不能说清 breakpoint 与「加一行 print」在排障策略上的差别?能不能解释为何 GPU 空转时候选 CPU 火焰图会误导?三问里有两问卡壳,就回到对应插图把箭头再走一遍——本篇其余文字都是在给这三张图加注释。
和「等出了线上事故再学 logging」相比,现在付出的配置成本极低:一个 dictConfig、几个关键字段、一条测量纪律。事故夜里你会感谢今天的自己。也可以把本篇练习项目当成以后 FastAPI / Agent 篇的日志骨架——字段名先约定好,比事后统一格式便宜得多。
再强调一次边界:本篇教你在进程内把眼睛擦亮;集中式日志平台、分布式追踪、告警路由是下一层工程,会在服务实战里逐步露面。不要因为「还没上 ELK」就拒绝 getLogger——本地与单机服务同样需要分级叙事。
若你带团队做 code review,可以把本篇收成三条合并门槛:错误路径是否有 logger.exception;新增热路径是否避免无条件的昂贵日志格式化;性能相关改动是否附带前后测量数据(哪怕只是 perf_counter 打印)。门槛不在于「必须上火焰图」,而在于不许只凭感觉改。
七、踩坑大全
通用
坑 1:处处 basicConfig,库与应用抢 root。 现象:日志重复或格式错乱。原因:多次配置 root。解决:应用入口配置一次;库只用 getLogger(name)。
坑 2:用 print 打生产叙事。 现象:无法分级、难重定向、无时间戳约定。解决:换成 logging;容器场景打 stderr + 集中收集。
坑 3:logger.info("x=%s" % big) 或 f-string 热路径。 现象:即使 INFO 关闭仍先算字符串。解决:用 % 惰性参数或 isEnabledFor。
坑 4:捕获异常只记 str(e)。 现象:丢栈。解决:logger.exception 或 exc_info=True。
坑 5:所有 Logger 都挂同一文件 Handler 且 propagate 重复。 现象:一行日志写两遍。解决:理清 propagate;Handler 挂在合适层级。
坑 6:一变慢就「优化算法」却从未计时。 现象:改了无关代码。解决:先 perf_counter / cProfile 定位。
坑 7:在多线程 / 异步里用 pdb 乱断。 现象:死锁或难复现。解决:缩小复现;异步用专用调试思路(第 25 篇)。
macOS / Linux / Windows
坑 8:Windows 控制台编码与文件 Handler。 现象:中文乱码。解决:Handler 指定 encoding="utf-8";终端代码页留意。
坑 9:Linux 容器内 py-spy 无权限。 现象:attach 失败。解决:文档化 ptrace 权限;或在构建 CI 的采样 job 里做。
坑 10:macOS 上路径与工作目录导致 app.log 写到奇怪位置。 解决:用绝对路径或相对项目根;与第 10 篇路径纪律一致。
与 AI / GPU 叠加
坑 11:只看 CPU cProfile 就断定「模型慢」。 现象:优化了数据处理,GPU 利用率依旧低。解决:补 GPU profiler / nvidia-smi dmon;区分 H2D、kernel、同步点。
坑 12:训练日志每 step 打巨型 DEBUG。 现象:I/O 拖慢训练、磁盘爆。解决:采样打印、指标系统、级别按环境切换。
八、小结
合上文章后,试着用自己的话说明:Logger / Handler / Formatter 各管什么,以及为何「先测量再优化」。讲得清,才算真的会了。动手至少跑通:getLogger + 级别 → breakpoint 看局部变量 → cProfile 读 Top 函数。
- 三件套:日志叙事、调试停查、性能定位——问题不同,工具不同。
- logging:级别门槛、按模块命名、Handler 定去向、入口统一配置。
- 结构化:
request_id等字段让检索与值班成为可能。 - 调试:
breakpoint()+ pdb 命令;线上慎用交互断点。 - 性能:秒表 → cProfile → 采样 / GPU profiler;匹配瓶颈设备。
- AI Infra:请求字段 + 分阶段耗时 + Profiler;为第 45 篇打样。
把故事连起来:第 11 篇异常 → 第 16 篇横切 → 第 20 篇环境钉死 → 本篇让运行时可见。专栏二工程刀具继续成套:下一站是单元测试 pytest(22)。
若只能带走一句话:先让问题看得见,再谈改得快;看得见靠日志与测量,不是靠猜。
也可以用「三个不要」自检:不要在库里 basicConfig;不要无测量就微优化;不要在热路径强行 f-string 拼巨日志。
再留一个自测:给练习项目的一次假「推理请求」打上 request_id 与 latency_ms,再用 cProfile 指出 Top 1 函数——两问都顺,本篇就站稳了。
本篇技能会立刻复利:读服务源码先找 logger 配置;PR 里要求错误路径有 exception;性能争议先贴测量。后续测试、并发、FastAPI、Agent,都假设这层已稳。
和专栏一串起来复习也不亏:异常(11)是信号;文件与上下文(10、17)管资源;本篇是专栏二把「可观测」立成一等约束的一课。
也可以把收获压成检查清单:会配置 dictConfig 或 basicConfig;会 getLogger(name);会 breakpoint;会读 cProfile;能说出 CPU 与 GPU profiler 的分工。五项过关,即可进入 pytest 篇。
若把本篇压成给同事的三十秒讲解:先画「日志 / 调试 / 性能」三框;再强调「库不 basicConfig」;最后提「先秒表再火焰图」。三张草图比贴一篇博客更管用。等对方能独立把 print 叙事迁到 logging,并解释 cumtime 与 tottime,就可以一起 code review 排障 PR 了。
动手清单再压缩一版:给模块加 logger;入口 dictConfig;故意除零用 exception;breakpoint 看变量;对热点 python -m cProfile。五步做完,比只「看完文章」扎实一个数量级。
九、课后练习
- (基础) 用
logging.basicConfig与getLogger(name)改造一段含三个print的脚本,分别打 DEBUG / INFO / ERROR,调整 root level 观察输出变化。 - (基础) 配置
StreamHandler+RotatingFileHandler,确认终端与文件级别可以不同(终端 INFO、文件 DEBUG)。 - (基础) 在函数中放
breakpoint(),练习p/n/c/w;用自己的话写清n与s的区别。 - (理解) 实现一个最小
JsonFormatter,用extra={"request_id": ...}打出一行 JSON;说明为何生产更爱结构化。 - (理解) 对两段函数(一段纯运算、一段故意
time.sleep)跑cProfile,解释报表里谁的tottime/cumtime高及原因。 - (理解) 演示「f-string 热路径」与「
logger.debug("x=%s", x)」在关闭 DEBUG 时的成本差异(可用计数器 / 秒表近似)。 - (进阶) 用装饰器(回看第 16 篇)写
@timed:记录函数名与elapsed_ms到 logger;再写@log_calls记录入参摘要(注意截断大对象)。 - (进阶 · AI Infra) 设计一次「假推理」函数的日志字段表(至少 6 个字段),并写一段话说明:若 P99 变差,你会先看哪些字段、何时才上 PyTorch Profiler(不必真跑 GPU)。
下一篇预告
下一篇是《第22篇|单元测试 pytest》——在能看见问题、能量到慢点之后,解决「如何用自动化断言把正确性钉死」:测试发现、fixture、参数化、异常断言、覆盖率直觉。你会看到:没有测试的服务,日志再漂亮也只能「事后解释」;而可测的设计往往倒逼更好的模块边界。
专栏二后续路线:pytest → GIL 与多线程 → 多进程 → asyncio → HTTP / FastAPI → 最小 Agent。带着本篇的 logger 与测量纪律,写测试时记得:失败消息与日志字段一样,是给未来值班的人看的。
若想提前热身:给当前练习项目加一个纯函数与一条 assert,再用 uv add --dev pytest 跑起来;观察失败时的栈。做完后第 22 篇谈 fixture 与参数化时你会带着具体体感。
也可以把第 15~21 篇对照:生成器管流、装饰器管横切、上下文管资源、类型管形状、标准库给积木、依赖钉环境、本篇给眼睛——工程七件套的轮廓已经清晰,下一篇把「可验证」也工程化。
专栏一用十四篇把「对象与协议」立住;专栏二从迭代器(15)走到日志与性能(21),下一站是 pytest。下一篇见。
若时间充裕,再多做一件事:打开你最近用过的一个开源 Web / 推理项目,找到它的 logging 配置与(若有)profiler 文档,记三条「它如何把 request_id 串起来」。这种阅读比空背命令更能把纪律刻进肌肉记忆。
进入专栏二至此,可观测面与交付面开始交汇:会钉依赖,也要会在运行时看见问题。下一篇开始把正确性断言配齐。若某一节读着抽象,回到对应插图把箭头走一遍,再手打 logger.info / breakpoint / cProfile——多数卡住的地方,其实是「日志、调试、性能」被混成同一把锤子。
写日志或读火焰图时再记一条:错误往往来自工具与问题错配(用 print 查线上、用 CPU profiler 查 GPU 空转)。和「栈很长但根因很浅」相比,先选对眼睛能省很多时间。
也可以把本篇看成专栏二的「值班面」补课:前面把协议、积木与环境收齐,本篇把叙事与测量收齐。后面测试篇教你如何断言;并发与 asyncio 篇教你如何在更多任务下仍保持可见;FastAPI 与 Agent 篇则把字段打进真实请求路径。
若阅读时觉得「要不要上 ELK」总搅在一起,回到图 1:先进程内三件套;平台采集是下一层。日常编程两者都要懂一点,但职责不同——混谈是多数初学者卡住的根源。
收官前对照练习:同一段会失败的脚本,分别用「只 print」与「logging.exception + 简单计时」各排障一次。你会清楚感受到:可观测不是纸面游戏,而是把「我这边看过一眼」抬到与团队契约同一套操作面的关键一步——也是专栏二工程化与服务 / Agent 对接的入场券之一。
写完练习后,不妨在自己的仓库里开一个小 PR:只引入统一 logging 配置与 request_id 字段约定,不改业务语义。这种「小步替换」比空读文档更能把工作流刻进肌肉记忆,也更适合团队推广。
若你带新人,可以把本篇插图打印成一页速查:左列场景(排障 / 断点 / 变慢 / GPU),右列工具。新人写服务时对着贴,两周后就会自然说出「先测量」与「库不 basicConfig」。工具文化是带出来的,不是靠一次分享会喊出来的。
最后把专栏二的位置再钉一次:协议篇(15~18)解决「怎么正确接线」;标准库与依赖篇(19~20)解决「积木与环境」;本篇解决「运行时如何被看见与被测量」。三者齐备,脚本才既写得快,又查得出去——下一篇再给它配上测试的安全带。