
第15篇|迭代器与生成器
本篇定位:《Python 教程》专栏二「Python 进阶与工程」的开篇(第 15 篇)。专栏一已从环境、对象模型走到 OOP 与数据模型收官;本篇承接第 14 篇点到的
iter,把 可迭代对象(iterable)、迭代器(iterator) 与 生成器(generator) 讲透,并落到惰性流水线。为第 16 篇装饰器、第 17 篇上下文管理器、第 19 篇itertools、第 25 篇asyncio、第 28 篇最小 Agent、第 41 篇DataLoader打底。读完你将能够:分清 Iterable 与 Iterator;手写带
iter/next的游标类;用yield写生成器与生成器表达式;搭出「源 → 变换 → 汇」的惰性流水线;解释为何大文件、训练 batch、流式 token、Agent 事件流都爱迭代器;避开「迭代器用尽再 for」「在生成器里吞掉 StopIteration」等常见坑。预计用时:阅读 35~45 分钟,动手 25~35 分钟。
专栏一(第 01~14 篇)让你能搭环境、懂对象与容器、写函数与模块、处理文件与异常、建类继承,并让自定义类型接入数据模型。专栏二从本篇起转向「进阶语言特性 + 工程化」:先把「按需产生下一个值」变成一等公民,再谈装饰器、类型注解、测试、并发与服务化。
你每天都在用迭代:for x in lst、for line in f、for k, v in d.items()。第 04、06 篇把它当语法;第 10 篇文件对象「一行行读」其实已是惰性;第 14 篇说 for x in obj 会找 iter。本篇把协议拆开,并引入 yield——用几行函数体代替一整页游标类。
也可以先用一句话定心:可迭代对象提供遍历能力;迭代器带着位置往前走;生成器用 yield 自动实现迭代器。 急切(eager)一次装满列表,惰性(lazy)按消费者节奏生产——扫 GB 级日志、喂 DataLoader、推流式推理时,这条分界线决定你会不会 OOM。
建议边读边开练习目录(uv init --no-package)。阅读顺序:Iterable/Iterator → 手写协议 → yield 与生成器表达式 → 惰性流水线 → AI Infra 场景 → 踩坑。下一篇预告装饰器(16):你会看到「包装可调用」与「包装迭代」经常一起出现在框架里。
和第 06 篇推导式对照:[f(x) for x in xs] 立刻建整表;(f(x) for x in xs) 是生成器表达式,几乎不占中间内存。和第 08 篇闭包对照:生成器帧里冻着局部变量,有点像「可恢复的闭包」。和第 14 篇对照:Dataset 最小形状是 len+getitem;若还要 for sample in ds,要么靠序列协议回退,要么显式 iter——本篇给你第二种写法。
动手时建议沿用前面的 Tool / PairDataset 意象:先给数据集加显式 iter,再写一个 batched 生成器,最后模拟 Agent 逐步 yield 事件。对比「先 list 再处理」与「一路惰性」的写法差异——比背术语表更有体感。
本篇不穷尽生成器的协程用法(send 只点到),也不提前展开 async for。主线是协议、yield、惰性与场景;异步迭代留给第 25 篇。和「什么都能先装进列表」相比,迭代器的价值是:生产者与消费者解耦,内存与延迟按拉取节奏分配——标准库、框架与你的业务代码都按这个节奏协作。
读官方文档 Iterator Types 与 Yield expressions 时不必一次吞完:按本篇目录对照即可。遇到 atexit、上下文里关闭生成器、或生成器最终化(finalization)的边角,先保证主路径正确,再查文档细项。入门阶段把「能写、能读、能避坑」做扎实,比收藏冷门 API 更重要。
也可以把迭代看成时间维度上的协议:第 14 篇多数 dunder 回答「这个对象此刻如何响应一次操作」;迭代器回答「一串操作如何跨越多次调用保持进度」。状态从「全在容器里」部分搬到「游标上」——这正是流式系统的起点。
一、可迭代对象与迭代器
1.1 两个角色,不要混
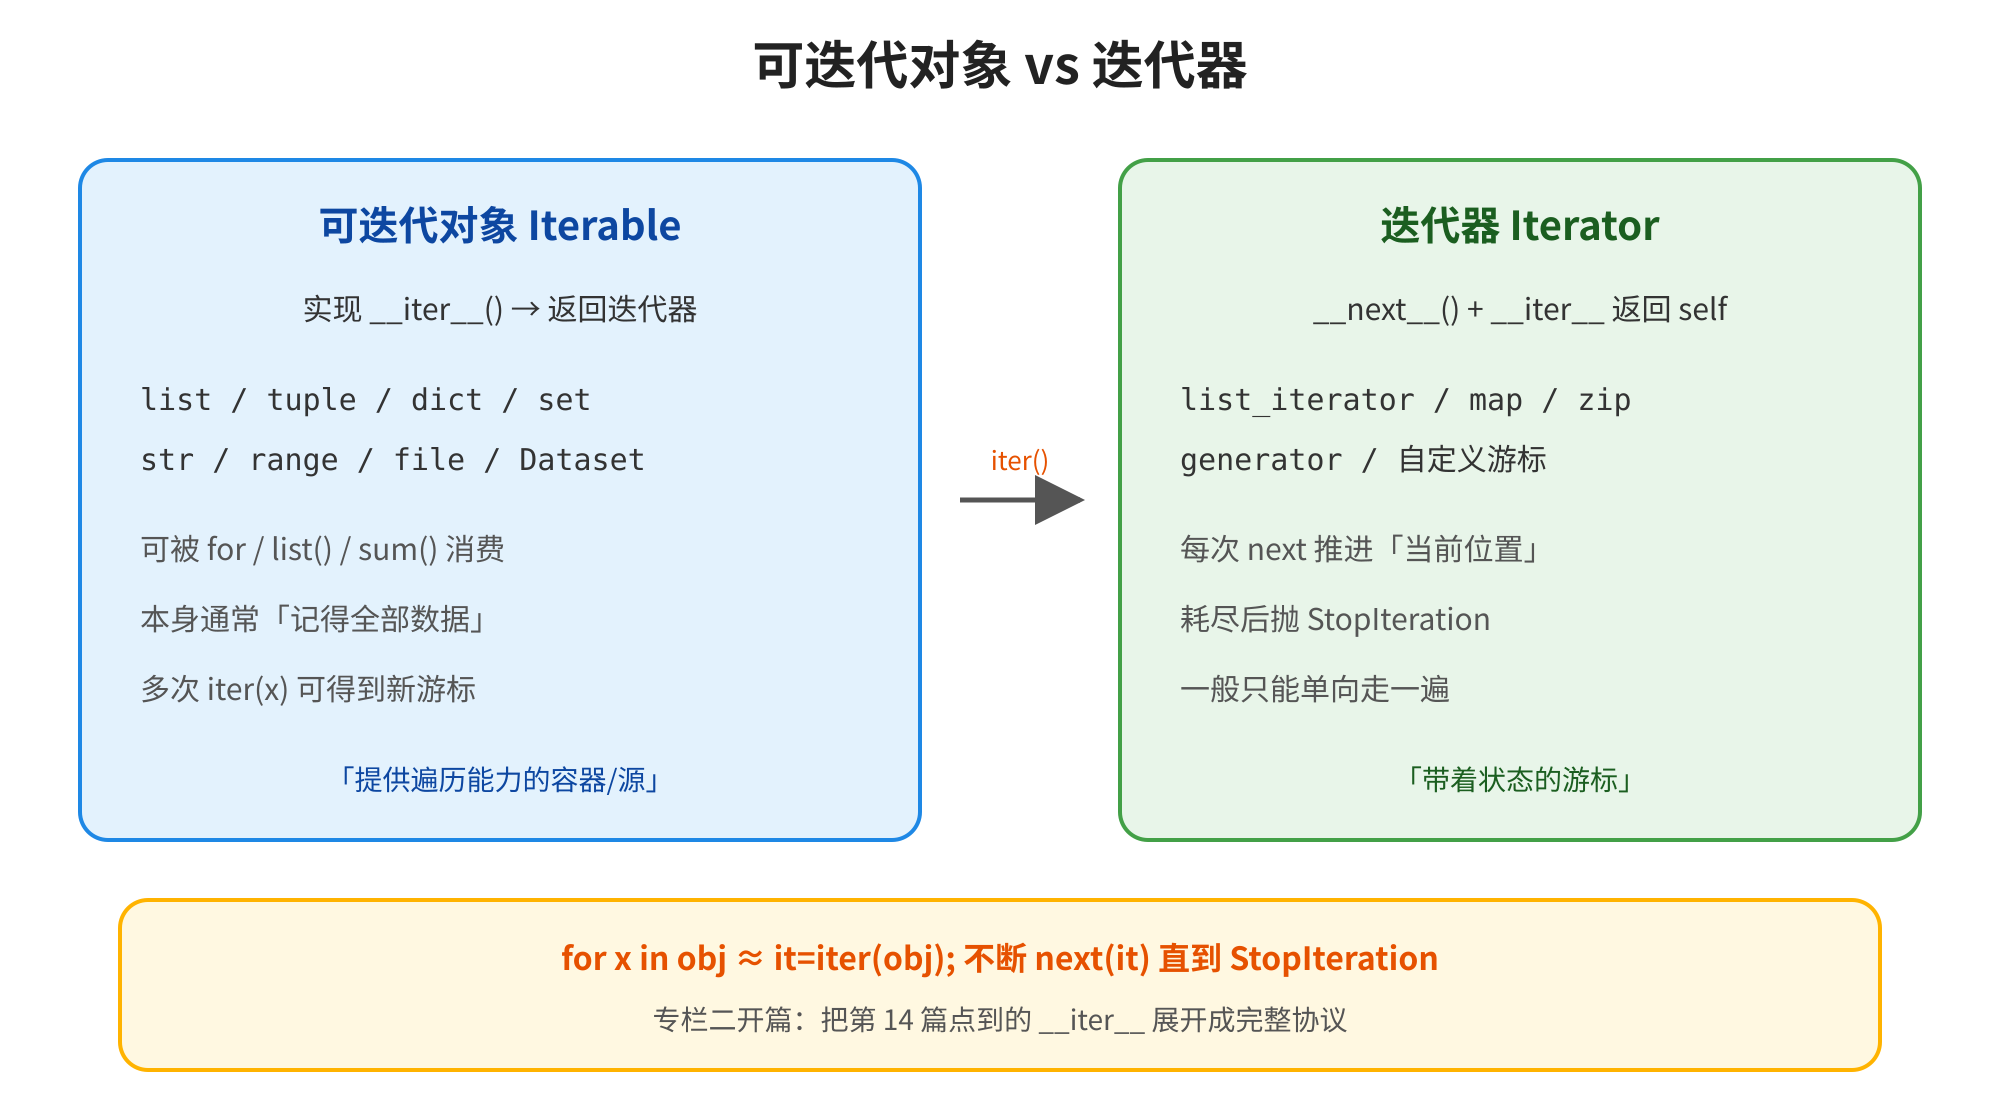
图1 可迭代对象 vs 迭代器
| 角色 | 关键方法 | 典型例子 | 直觉 |
|---|---|---|---|
| Iterable | iter → 返回迭代器 | list、dict、range、文件、多数 Dataset | 数据源 / 能被遍历的东西 |
| Iterator | next;iter 常返回 self | list_iterator、map、zip、generator | 带着进度的游标 |
xs = [10, 20, 30]
it = iter(xs)          # 等价于 xs.__iter__()
print(type(it).__name__)
print(next(it), next(it), next(it))
list_iterator
10 20 30
再 next(it) 会抛 StopIteration——这是正常结束信号,不是业务错误。for 会捕获它并退出循环。
1.2 for 在底层做什么
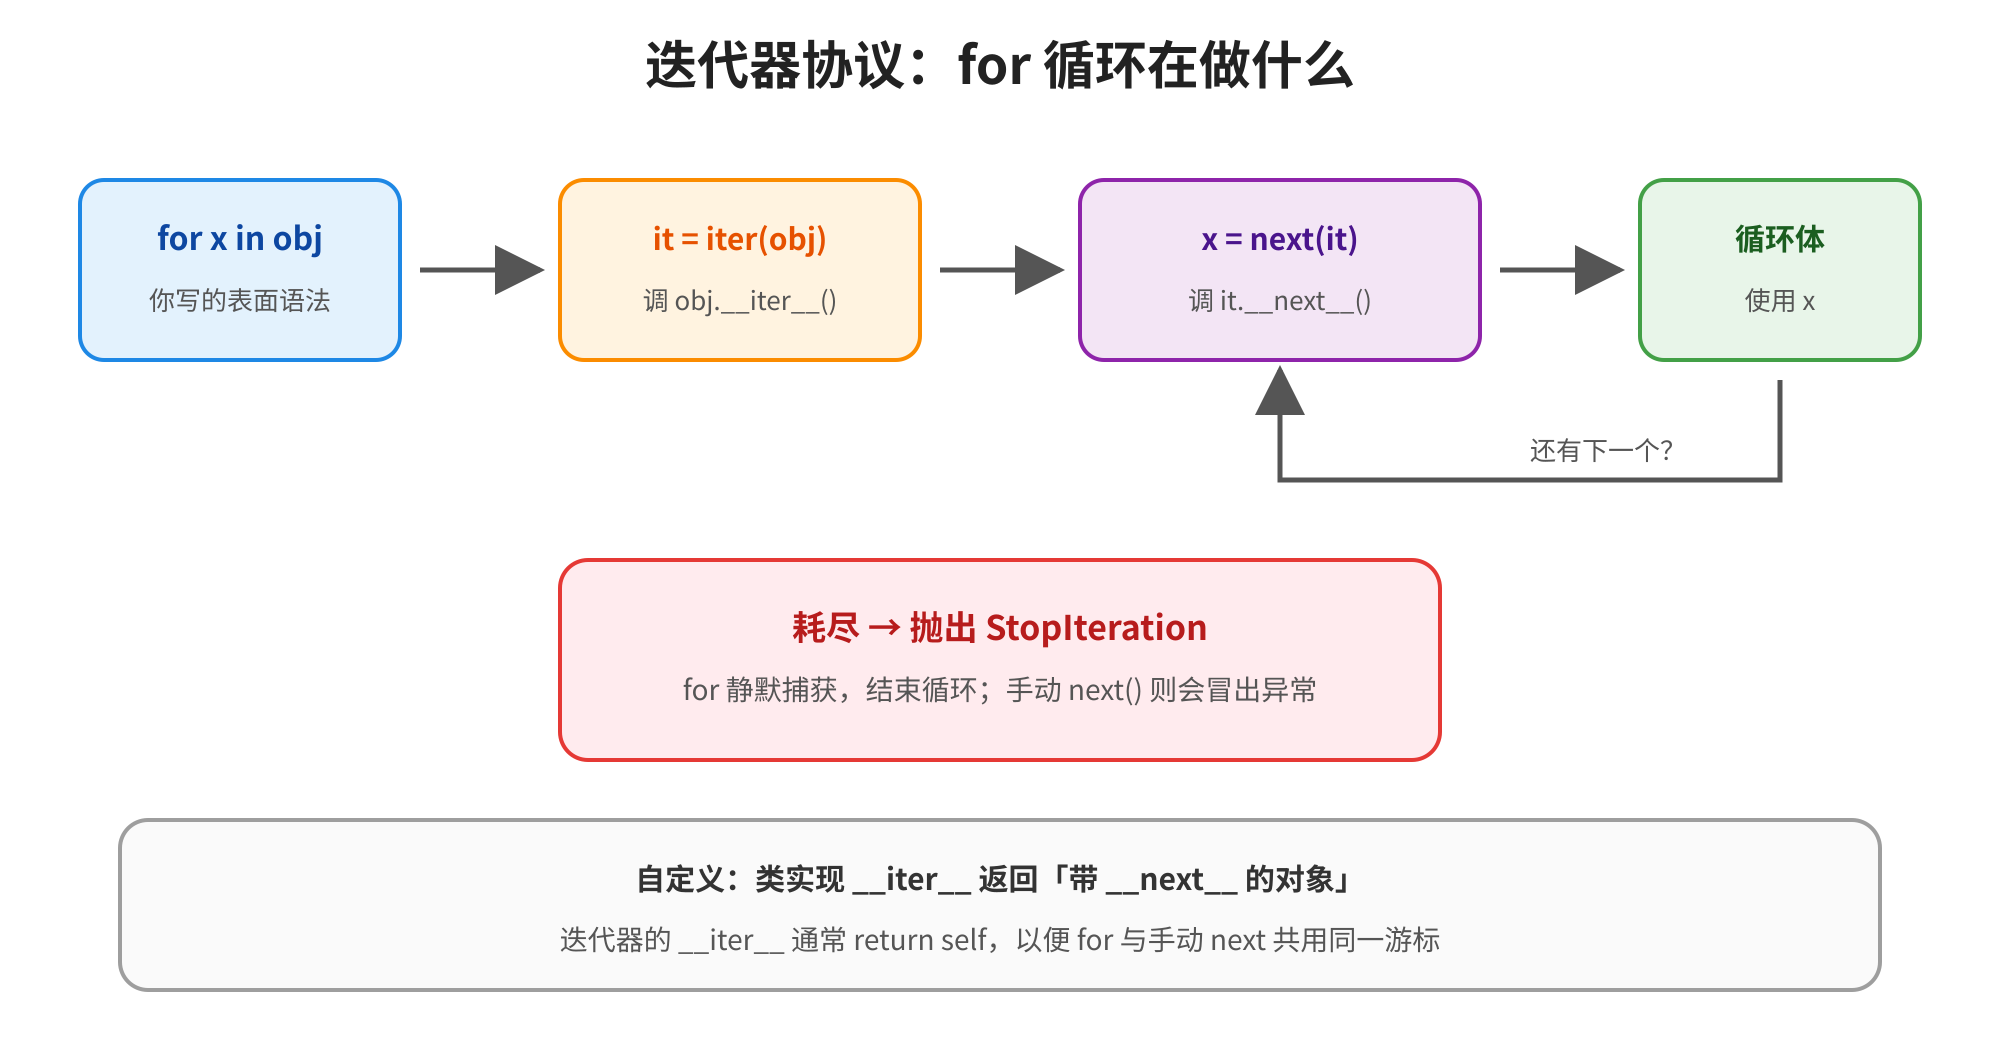
for x in obj,接着调用obj.__iter__()获取迭代器it,再执行it.__next__()得到结果x,随后进入循环体使用x,完成后会判断是否还有下一个元素;若迭代器耗尽,会抛出StopIteration异常,for循环会静默该异常并结束循环,手动调用next()则会抛出该异常。图中还补充说明,自定义迭代器类需实现__iter__()返回带__next__()方法的对象,迭代器的__iter__()通常返回自身,以便和手动next()共用同一游标。图2 迭代器协议:for 循环在做什么
伪代码心智模型:
# for x in obj:  body
it = iter(obj)
while True:
    try:
        x = next(it)
    except StopIteration:
        break
    # body 使用 x
因此:
obj必须可迭代(有iter,或旧式回退到getitem从 0 递增)。- 真正推进状态的是迭代器,不是容器本身。
- 同一列表可以
iter多次,每次得到新游标;但同一个迭代器通常只能走一遍。
xs = ["a", "b"]
it1, it2 = iter(xs), iter(xs)
print(next(it1), next(it2), next(it1))
a a b
1.3 iter / next 的内置入口
日常优先写 for;调试或手写驱动时用 iter / next。next(it, default) 可在耗尽时返回默认值而不抛异常:
it = iter([1])
print(next(it, None))
print(next(it, None))
1
None
AI Infra 视角:
DataLoader的iter每次返回新的 batch 迭代器;epoch 循环是「外层 for epoch,内层 for batch」。流式 API 则是「一个长生命周期迭代器不断next」。先分清「源」和「游标」,读框架源码不晕。
1.4 为什么内置类型「又像容器又像流」
list 是典型容器:随机访问、可反复遍历、长度已知。range 更像懒序列:表现得可迭代、可下标,却不真的存下每一个整数。文件对象更偏流:向前读、带位置、通常不假设能廉价地「再来一遍」。学协议时不要幻想所有 Iterable 同一套性能画像——协议统一的是接口,不是复杂度。
写自己的类型时,先问:调用方需要随机下标,还是主要顺序扫描?需要多次遍历,还是一次管道?答案决定你优先实现 Dataset 形状、显式 iter,还是两者都给。
和鸭子类型合看:框架常常只要求「可迭代」,并不要求你继承 collections.abc.Iterable。注册 ABC 有助于静态检查与 isinstance,但运行时 for 只认协议方法。先把方法写对,再按需挂 ABC。
二、手写迭代器协议
2.1 最小游标类
class CountDown:
    """从 n 倒数到 1 的迭代器(自身既是 iterable 也是 iterator)。"""

    def __init__(self, n: int):
        self._n = n

    def __iter__(self):
        return self

    def __next__(self) -> int:
        if self._n <= 0:
            raise StopIteration
        value = self._n
        self._n -= 1
        return value


print(list(CountDown(3)))
[3, 2, 1]
注意:这种写法把「数据源」和「游标」合成一个对象——list(CountDown(3)) 之后实例已耗尽,不能直接再 for 一遍。更稳妥的设计是容器可迭代、每次 iter 返回新游标:
class CountDownSource:
    def __init__(self, n: int):
        self.n = n

    def __iter__(self):
        return CountDown(self.n)  # 每次新游标


src = CountDownSource(3)
print(list(src), list(src))
[3, 2, 1] [3, 2, 1]
2.2 与 getitem 回退
没有 iter 但实现了从 0 开始的 getitem 时,iter(obj) 仍可能成功(历史兼容)。新代码应显式写 iter,语义更清晰,也避免与映射类型的键下标混淆。
class PairRows:
    def __init__(self, rows: list[tuple[str, int]]):
        self._rows = rows

    def __len__(self) -> int:
        return len(self._rows)

    def __getitem__(self, index: int) -> tuple[str, int]:
        return self._rows[index]

    def __iter__(self):
        for row in self._rows:
            yield row  # 下一节:生成器方法


ds = PairRows([("hi", 0), ("agent", 1)])
print(list(ds))
[('hi', 0), ('agent', 1)]
第 14 篇的 Dataset 形状(len+getitem)服务随机下标;本篇的 iter 服务顺序扫描。训练里两者常常并存。
2.3 迭代器是一次性的
it = iter([1, 2, 3])
print(list(it))
print(list(it))  # 已空
[1, 2, 3]
[]
把迭代器传给会「耗尽消费」的 API(list、tuple、sum、多数 for)前,想清楚还能不能再用。需要多次遍历,保留可迭代源,或 tee(第 19 篇 itertools),或物化成列表。
经验上还有一条:API 边界要写清「接受 Iterable 还是 Iterator」。 若你的函数内部会遍历两次(例如先数长度再处理),参数应是可反复 iter 的源,或在文档里声明「会物化成列表」。若只扫描一次,接受 Iterable 并用一次 for 即可,别先 list(xs) 除非必要。
和异常篇合看:迭代器协议用 StopIteration 做控制流,这是少数「用异常当信号」的语言级设计。业务代码尽量别再发明第二种「用异常表示没数据」的习惯,否则生成器边界上会撞 PEP 479 的保护逻辑。
三、生成器与 yield
3.1 含 yield 的函数会返回生成器
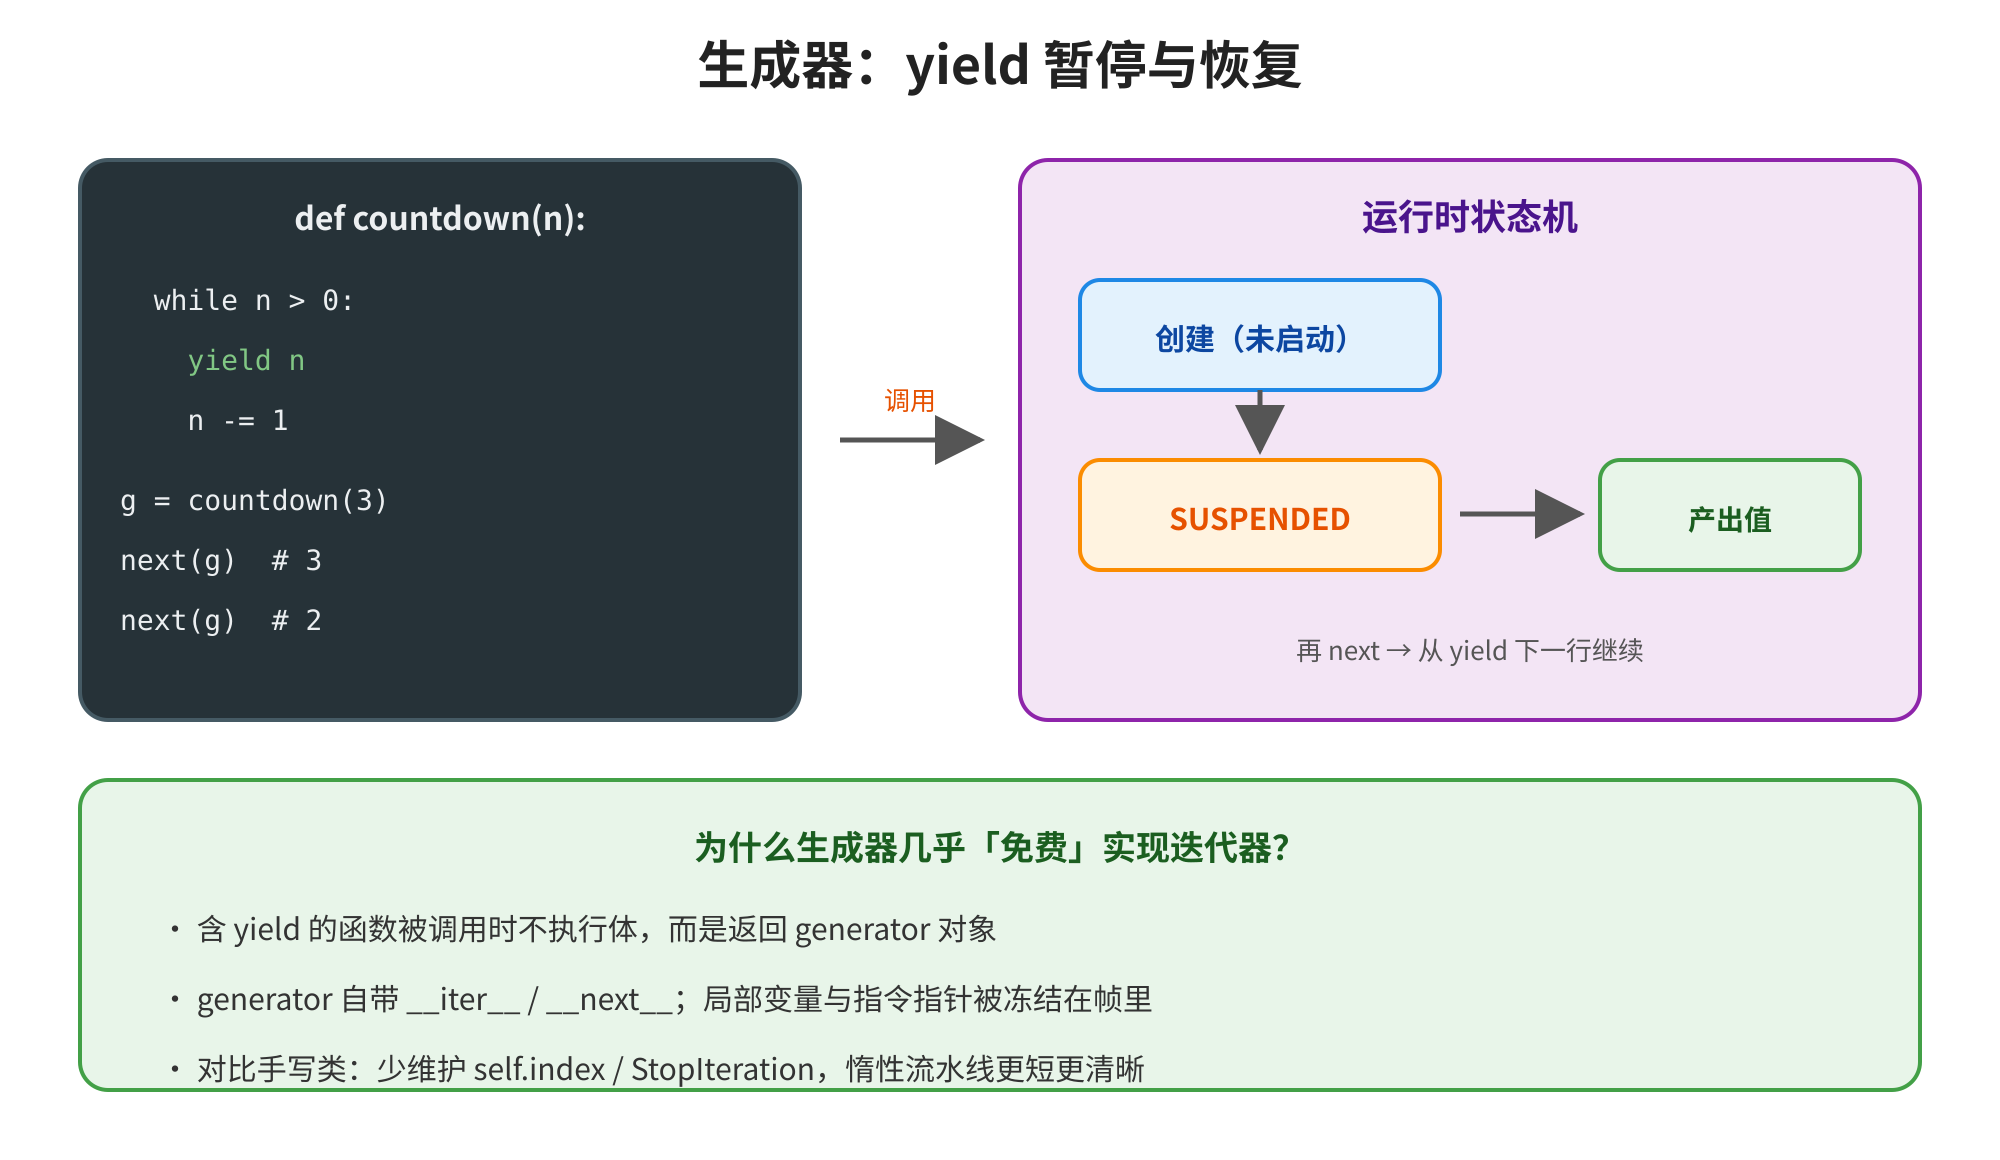
yield暂停与恢复的运行时状态机。左侧代码框中,countdown函数通过yield暂停,每次next运行到下一个yield产出值并暂停,局部变量与执行位置保存在生成器帧里。右侧状态机从创建(未启动)状态,经SUSPENDED暂停,再next从yield下一行继续,产出值。底部绿色框说明生成器几乎免费实现迭代器,含yield的函数被调用时不执行体,返回generator对象,且generator自带__iter__/__next__,局部变量与指令指针冻结在帧里,对比手写类少维护self.index/StopIteration,惰性流水线更短更清晰。图3 生成器:yield 暂停与恢复
def countdown(n: int):
    while n > 0:
        yield n
        n -= 1


g = countdown(3)
print(type(g).__name__)
print(next(g), next(g), next(g))
generator
3 2 1
调用 countdown(3) 不会立刻跑完函数体,而是得到 generator 对象。每次 next:运行到下一个 yield,把值产出,暂停;局部变量与执行位置保存在生成器帧里;再 next 从暂停处继续。
3.2 对比手写类
同一倒数逻辑,生成器通常更短、更不易写错 StopIteration:
def countdown_gen(n: int):
    while n > 0:
        yield n
        n -= 1


print(list(countdown_gen(4)))
[4, 3, 2, 1]
何时仍用手写类?需要额外方法(如 peek、reset)、要进继承树、或状态机事件极多时。其余优先生成器。
3.3 生成器表达式
圆括号推导式:
squares = (x * x for x in range(5))
print(type(squares).__name__)
print(list(squares))
generator
[0, 1, 4, 9, 16]
可直接塞进聚合函数,避免中间列表:
total = sum(x * x for x in range(1, 6))
print(total)
55
若外层已是函数调用的唯一参数,可省略一层括号:sum(x*x for x in range(5))。
3.4 yield from 委托
子生成器或任意可迭代对象,用 yield from 扁平委托:
def chain_ab():
    yield from [1, 2]
    yield from (3, 4)


print(list(chain_ab()))
[1, 2, 3, 4]
比手写 for x in sub: yield x 更清晰,也正确传递 send / 异常(进阶用法,见踩坑与文档)。
AI Infra 视角:把「读文件 → 清洗 → tokenize → batch」每段都写成生成器,再用
yield from或串联函数组装,调试时可单独list(stage(...))看一段,而不必一次加载全语料。
3.5 生成器也是迭代器
def gen():
    yield 1


g = gen()
print(iter(g) is g)
print(hasattr(g, "__next__"))
True
True
因此 for x in gen(): 不需要你再包一层。也因此生成器同样一次性:调用函数得到新生成器,不要指望同一个 g 回放。
返回值方面:生成器函数里的 return value 不会变成 next 的返回值,而是成为 StopIteration.value(yield from 可以接到)。日常写管道时,用 yield 产出元素、用 return 表示结束即可;需要「最终汇总结果」时再显式设计,别与普通函数的 return 心智混用。
调试技巧:g.gi_frame / g.gi_running 能偷看状态(实现细节,勿当公共 API 依赖);多数时候打印阶段性 yield 的值,或短暂 take(n, g) 抽样,就够定位。
四、惰性流水线
4.1 急切 vs 惰性
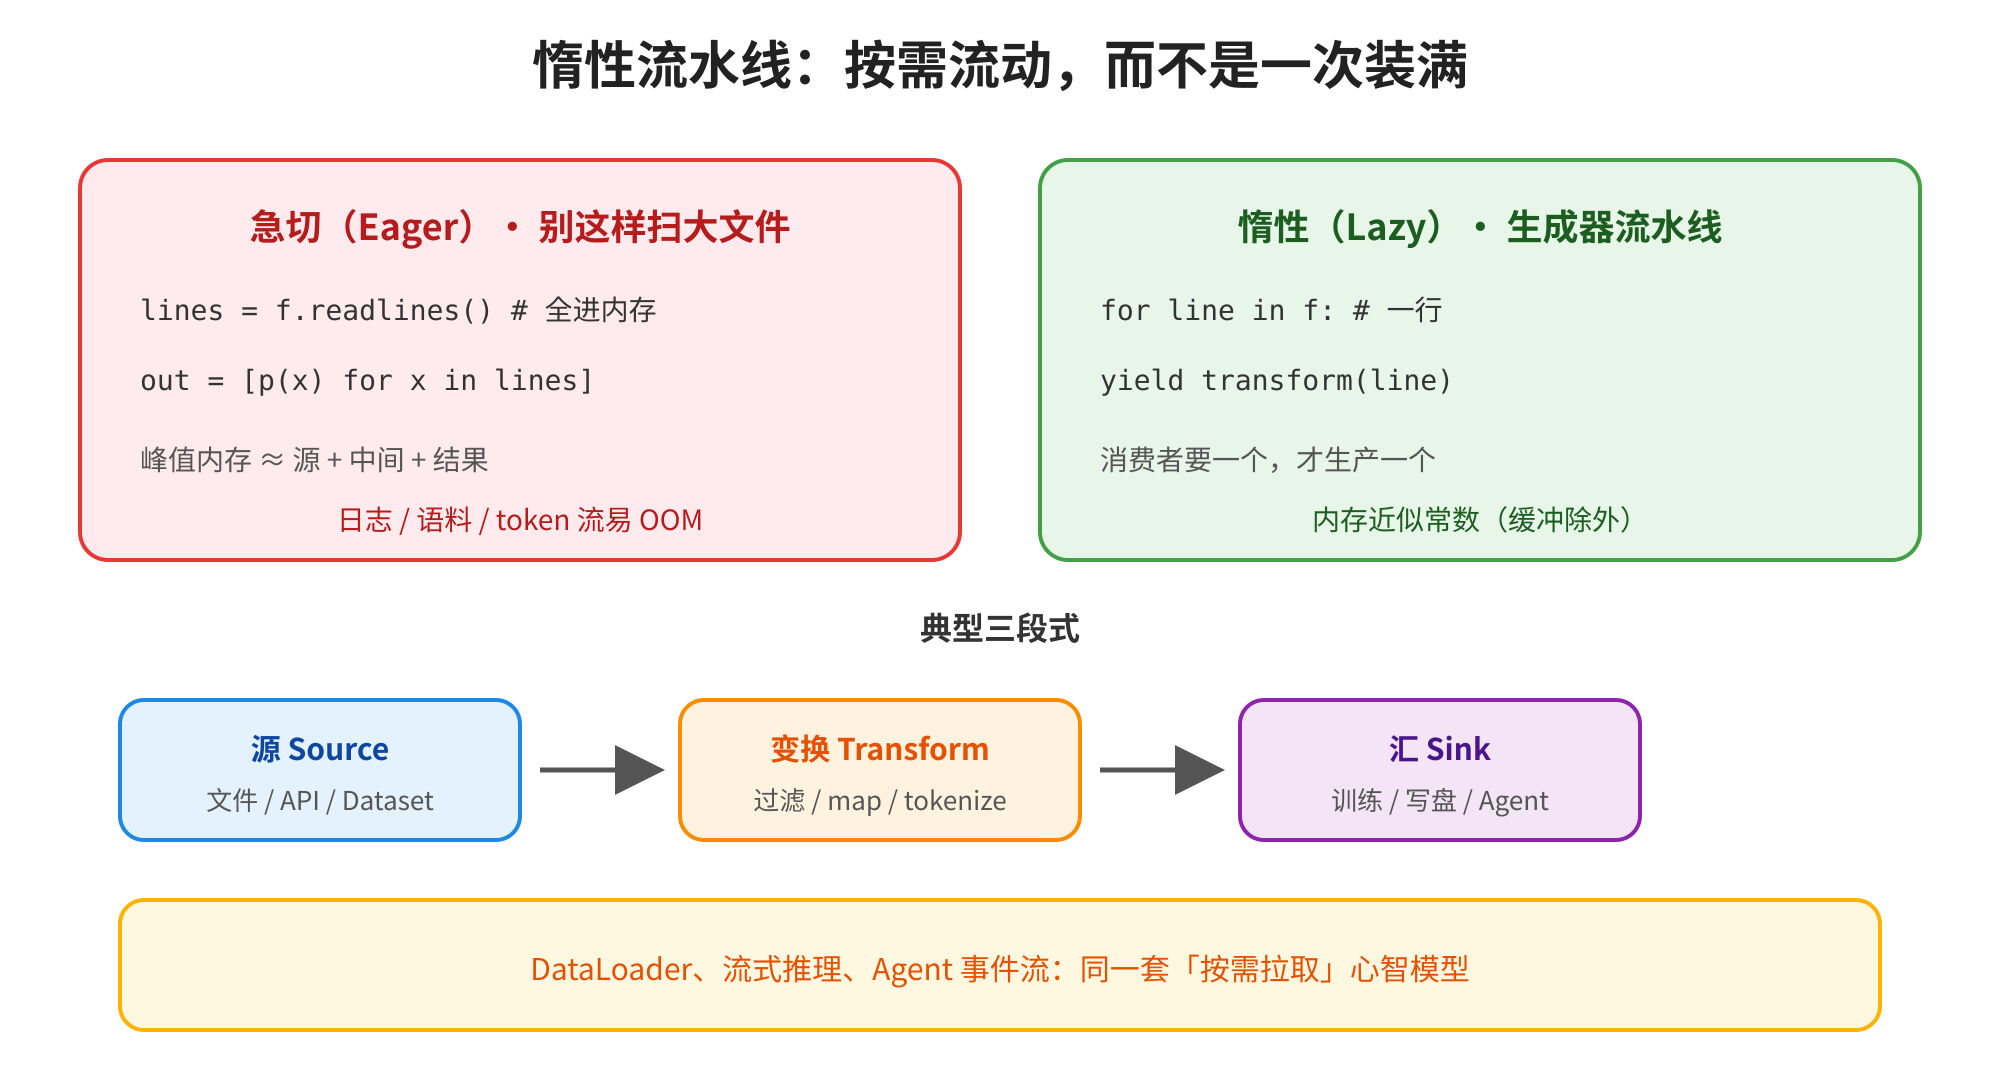
图4 惰性流水线:按需流动,而不是一次装满
# 急切:中间列表全在内存
nums = list(range(10))
evens = [n for n in nums if n % 2 == 0]
squares = [n * n for n in evens]
print(squares)

# 惰性:一路 generator
def evens_of(xs):
    for n in xs:
        if n % 2 == 0:
            yield n


def squares_of(xs):
    for n in xs:
        yield n * n


pipe = squares_of(evens_of(range(10)))
print(list(pipe))
[0, 4, 16, 36, 64]
[0, 4, 16, 36, 64]
结果相同;差别在峰值内存与能否处理无限/超大流。惰性管道在没有消费者时甚至几乎不干活:
pipe = squares_of(evens_of(range(10**9)))  # 不会真的造 10^9 个数
print(next(pipe), next(pipe))
0 4
4.2 文件行扫描
第 10 篇已见:文件对象本身可迭代。再包一层过滤,仍保持惰性:
def nonblank_lines(path: str):
    with open(path, encoding="utf-8") as f:
        for line in f:
            s = line.strip()
            if s:
                yield s


# 演示:用内存里的伪文件接口也行
from io import StringIO

def nonblank_from_text(text: str):
    for line in StringIO(text):
        s = line.strip()
        if s:
            yield s


sample = "alpha\n\nbeta\n  \ngamma\n"
print(list(nonblank_from_text(sample)))
['alpha', 'beta', 'gamma']
真实大日志请坚持 for line in f,避免 readlines()。
4.3 有限窗口与提前停止
惰性不意味永远跑下去。break、islice、或业务条件都可以让上游停产:
def naturals():
    n = 0
    while True:
        yield n
        n += 1


def take(n: int, xs):
    for i, x in enumerate(xs):
        if i >= n:
            break
        yield x


print(list(take(5, naturals())))
[0, 1, 2, 3, 4]
无限生成器 + 有限消费,是日志跟随、事件监听的常见形状。
4.4 何时该物化
惰性不是教条。下列情况考虑 list / tuple:
- 需要多次遍历且源不可重复(网络流、一次性生成器)。
- 需要长度、下标、切片,而源只是纯迭代器。
- 下游 API 硬性要求序列(部分库只接受
list)。 - 数据量保证很小,物化能换可读性。
反过来:训练语料、长日志、token 流、Agent 长时间事件——默认保持惰性,只在观测窗口物化。团队规范里写一句「禁止无界 list(stream) 进主路径」,能避免不少线上 OOM。
和推导式选择对照:列表推导表达「我要一张完整表」;生成器表达式表达「我要一条管道」。看名字选工具,比事后用 del 省内存更可靠。
五、进阶接口与标准库接点
5.1 send / throw / close(知道即可)
生成器还可接收外部值:g.send(v) 会让当前 yield 表达式的结果变成 v。协程式用法在现代代码里多被 async/await(第 25 篇)取代;本篇只需知道:生成器是带状态的可恢复调用,不只是「只出不进」的管道。
def accumulator():
    total = 0
    while True:
        x = yield total
        if x is None:
            break
        total += x


g = accumulator()
print(next(g))       # 启动到第一个 yield
print(g.send(5))
print(g.send(7))
0
5
12
首次必须用 next(g) 或 g.send(None) 启动到第一个 yield,否则会 TypeError。
5.2 与 map / filter / zip
它们返回的是迭代器(懒的):
m = map(str.upper, ["ai", "agent"])
print(type(m).__name__, list(m))
map ['AI', 'AGENT']
可读性上,简单变换用生成器表达式往往更直观;复杂多步仍建议具名生成器函数。
5.3 预告 itertools
第 19 篇会展开 islice、chain、tee、groupby 等。本篇先建立「一切皆可拉流」的直觉;标准库是零件箱,不是另一套范式。
enumerate、reversed、sorted 也常与迭代结伴:enumerate 懒封装;reversed 要求能随机访问或实现 reversed;sorted 总会物化并排序——它接受 Iterable,但输出是新列表。写管道时盯住「哪一步偷偷变成急切」,是性能审查的基本功。
xs = (x for x in range(5))
print(sorted(xs, reverse=True))
print(list(xs))  # 已被 sorted 耗尽
[4, 3, 2, 1, 0]
[]
六、AI Infra / Agent 场景
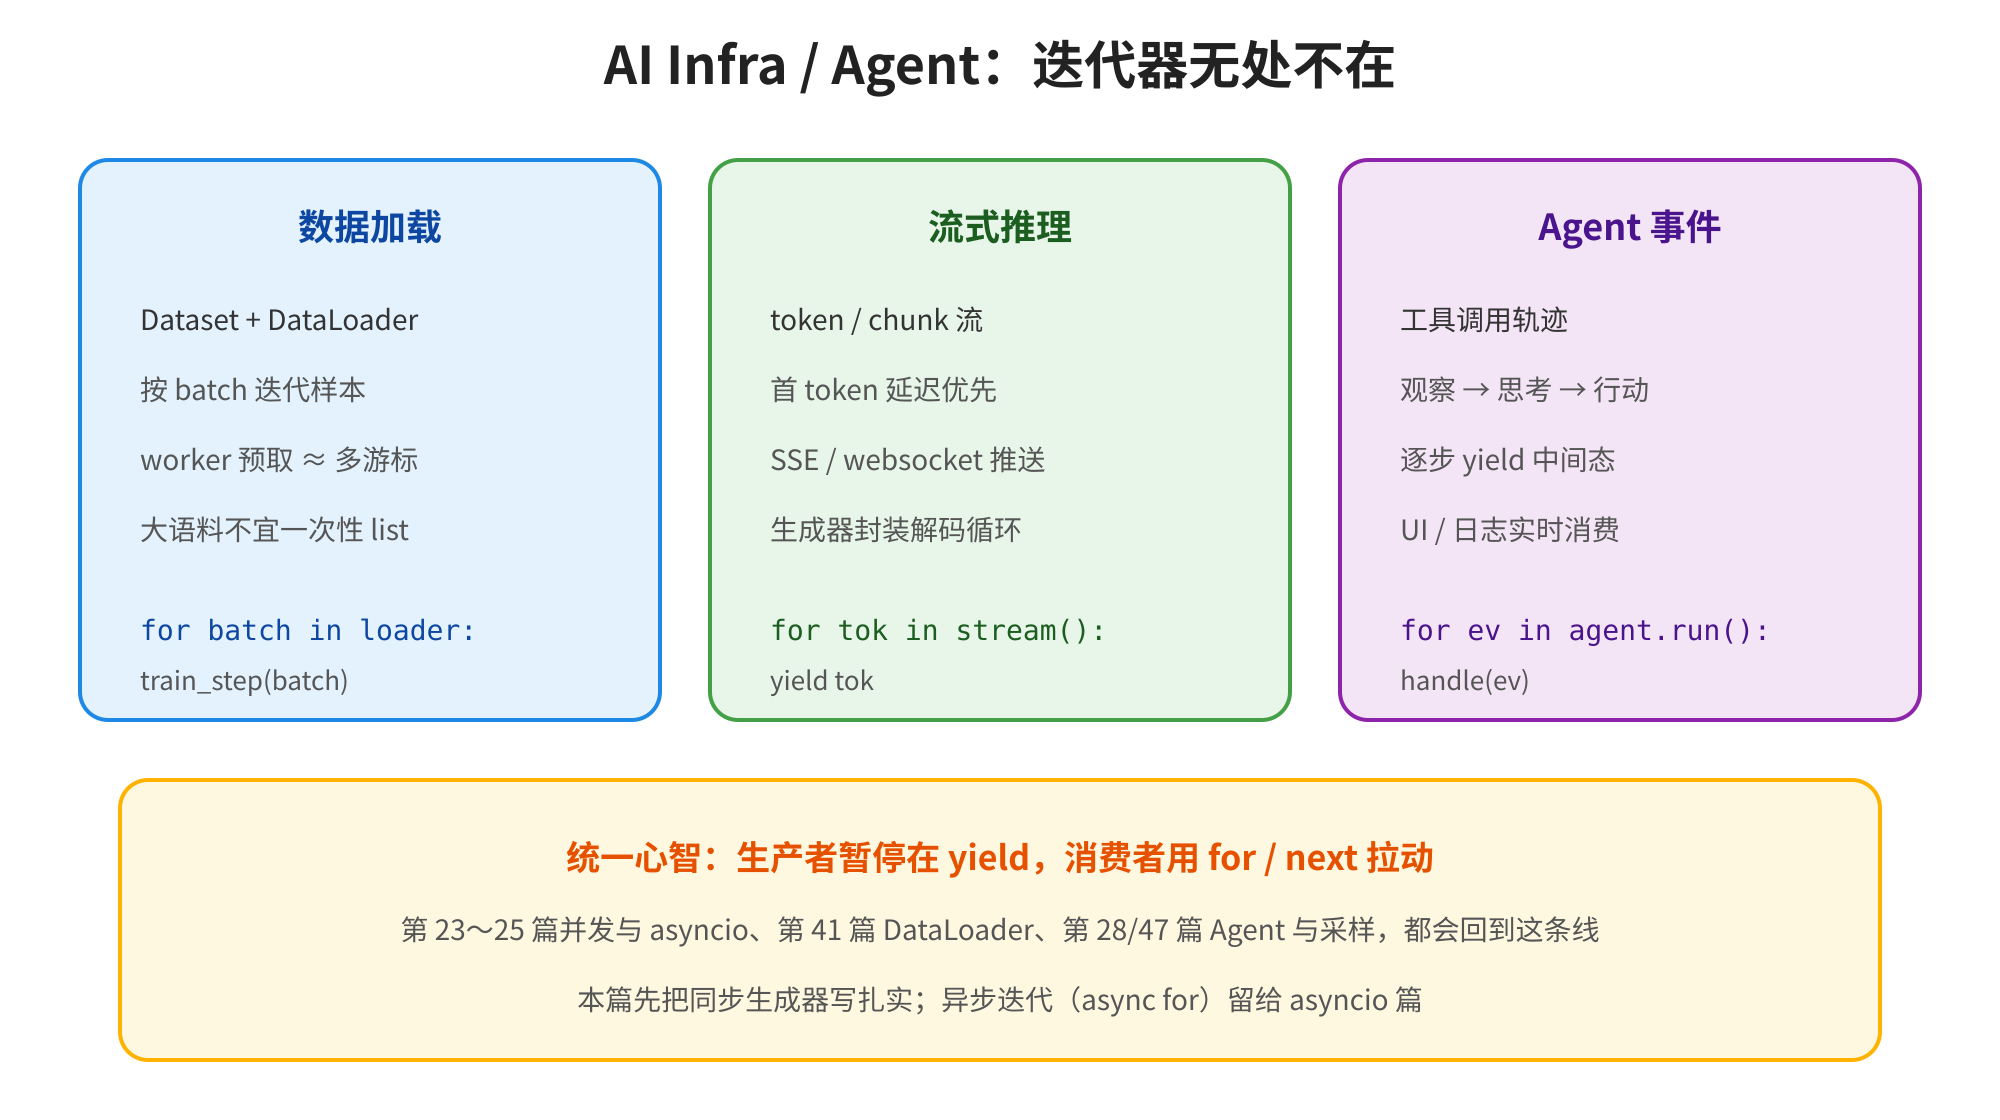
图5 AI Infra / Agent:迭代器无处不在
6.1 迷你 batch 迭代器
def batched(xs, size: int):
    batch = []
    for x in xs:
        batch.append(x)
        if len(batch) == size:
            yield tuple(batch)
            batch = []
    if batch:
        yield tuple(batch)


print(list(batched(range(7), 3)))
[(0, 1, 2), (3, 4, 5), (6,)]
真实 DataLoader 还要 shuffle、多进程、销钉对齐;心智模型仍是「按需产出下一批」。
6.2 流式 token
def fake_stream(text: str, chunk: int = 4):
    for i in range(0, len(text), chunk):
        yield text[i : i + chunk]


for piece in fake_stream("Hello, Agent!"):
    print(piece, end="|")
print()
Hell|o, A|gent|!|
把模型解码循环包成生成器后,Web 层可以边产生边推 SSE——用户先看到首 token,而不等整段结束。
6.3 Agent 事件流
def agent_run(query: str):
    yield {"type": "thought", "text": f"plan for {query!r}"}
    yield {"type": "tool", "name": "echo", "args": {"q": query}}
    yield {"type": "observation", "text": f"echo: {query}"}
    yield {"type": "final", "text": query}


for ev in agent_run("ping"):
    print(ev["type"], "→", ev.get("text") or ev.get("name"))
thought → plan for 'ping'
tool → echo
observation → echo: ping
final → ping
UI、日志、评测 harness 都只是不同的消费者;生产者保持生成器,两边解耦。第 28 篇最小 Agent 会把工具调用循环写完整;本篇先占住「事件可迭代」的接口。
AI Infra 视角:vLLM / SGLang 等推理引擎对外的 streaming,本质也是「迭代器 / 异步迭代器」。同步篇先练好
for tok in gen;异步async for在第 25 篇接上。
6.4 和专栏一技能的接缝
- 02 引用:生成器对象是独立对象;
list(g)与g不是同一份「剩下的元素容器」,而是消费动作。 - 10 文件 / with:生成器里
open要注意——函数返回后,若调用方很晚才迭代,with可能已退出。常见写法是让生成器自己包住资源生命周期,或由上层with再把文件对象传入。 - 11 异常:生成器内未捕获异常会在
next时抛给调用方;close()会注入GeneratorExit。 - 14 数据模型:
iter返回生成器,是接协议的最省事方式。
6.5 一张「先写什么」清单
面向本系列后续,可以按优先级记:
- 顺序扫描的数据源 → 生成器函数或
iter+yield。 - 训练 map-style 数据 → 先
len/getitem(14),再按需加iter。 - batch / 滑窗 →
batched一类生成器;边界策略写进文档。 - 流式输出 → 生成器
yieldchunk/token;调用方for推送。 - Agent 轨迹 → 事件字典(或小型类型)的迭代流;UI 与测试共用消费者。
不必第一天接上异步与多进程。先让单线程惰性管道正确,再在第 23~25、41 篇叠加并发与 DataLoader 细节。和第 14 篇一样:扩展点有名字、有约定,比临时把一切 list 掉更可演进——本篇的名字是迭代器协议与 yield。
把第 08 篇的高阶函数与本篇对照:map(f, xs) 是懒的;你自己写的 def map_f(xs): for x in xs: yield f(x) 更易读、易下断点。装饰器篇会教你给这类管道函数加计时与日志,而不改流水线骨架。
七、踩坑大全
7.1 协议与耗尽
坑 1:把迭代器用尽后再 for 一遍,以为还能出数。 现象:第二次得到空。解决:保留可迭代源;或每次新建生成器;需要分叉消费时用 itertools.tee / 物化。
坑 2:在业务代码里手动捕获 StopIteration 当「没数据」并继续。 现象:Python 3 起,生成器内冒出的 StopIteration 可能被转换为 RuntimeError(PEP 479)。解决:循环结束用 return;对外信号用业务异常或哨兵值,别滥用 StopIteration。
坑 3:iter 返回 self 却不实现 next(或反过来)。 现象:TypeError: iter() returned non-iterator。解决:迭代器必须同时满足协议;用 collections.abc.Iterator 自检。
7.2 生成器与资源
坑 4:在生成器里 with open(...) 后立刻在外部长时间不做 next。 现象:若 with 在第一个 yield 之前结束还好;若错误地把打开放在调用方、关闭时机错乱,会遇到「文件已关仍读」。解决:资源与 yield 交错时,确保 with 包住整个产出周期,或显式把已打开对象注入。
坑 5:对同一生成器表达式既 list(g) 又想再遍历。 现象:第二次为空。解决:表达式每次重新写,或写成生成器函数可多次调用。
坑 6:在列表推导里误用 yield(语法/认知混乱)。 现象:推导式不是生成器函数。解决:要惰性用生成器函数或生成器表达式 (...)。
7.3 工程与 AI Infra
坑 7:无限生成器忘记上层 break / islice。 现象:CPU 空转或内存涨(若中间又物化)。解决:所有无限源必须有明确停止策略。
坑 8:把巨大中间结果 list(...)「方便调试」后遗留在生产路径。 现象:训练/ETL OOM。解决:调试用 take(n, pipe);生产保持惰性。
坑 9(DataLoader 心智):以为 Dataset 只要 iter 不要 getitem。 现象:部分采样/多进程策略不适用。解决:PyTorch 风格仍以 map-style(len/getitem)为主;Iterable-style Dataset 是另一条路径,需读框架文档。
坑 10(Agent):在生成器里做阻塞 HTTP 且无超时。 现象:事件流卡死。解决:超时、取消与第 25/26 篇的异步与 HTTP 客户端一并设计;本篇先保证接口是可迭代事件。
def once():
    yield 1


g = once()
print(list(g), list(g))
[1] []
(再次提醒:生成器一次性。)
八、小结
合上文章后,试着用自己的话说明:for 如何变成 iter/next,以及为何 yield 能少写一整个游标类。讲得清,才算真的会了。动手至少跑通:手写 CountDown、用生成器重写、搭一条 batched 流水线。
- Iterable vs Iterator:前者提供
iter;后者提供next并通常iter返回自身。 for协议:iter→ 反复next→ 捕获StopIteration结束。- 生成器:含
yield的函数返回 generator;暂停/恢复局部状态;是实现迭代器的快捷方式。 - 惰性流水线:源 → 变换 → 汇按需流动,控制峰值内存;大文件与无限流依赖它。
- 一次性:迭代器/生成器默认走一遍;多次遍历靠新游标或物化。
- AI Infra:batch 循环、流式 token、Agent 事件,都是同一套拉取模型;异步变体留给后文。
把故事连起来:专栏一收官于数据模型插头(14)→ 本篇把 iter 展开为迭代器与生成器 → 下一篇装饰器用「包装」增强函数(常与缓存、重试、计时一起出现在工程代码里)。
若只能带走一句话:能 for 的叫可迭代;能 next 的叫迭代器;带 yield 的函数给你生成器。
也可以用“三个不要”自检:不要把用尽的迭代器当还能再扫的源;不要对大语料默认 list(全量);不要在生成器里用 StopIteration 表达业务结束。
再留一个自测:写出 iter(x) / next(it) 与 dunder 的对应;解释生成器表达式与列表推导的内存差别;说明为何 DataLoader 外层按 epoch 重新 iter——三问都顺,本篇就站稳了。
本篇技能会立刻复利:读开源 ETL、看推理 streaming、写 Agent 轨迹,都会先找「谁在 yield、谁在 for」。专栏二后续的装饰器、上下文、类型注解,都是在可运行系统上继续加刀具。
和专栏一串起来复习也不亏:环境(01)保证例子跑得动;对象与引用(02)解释生成器对象独立;容器与循环(04/06)是协议的日常表面;函数与闭包(07/08)对照生成器帧;文件与 with(10)是惰性 I/O 样板;异常(11)提醒 StopIteration 的特殊地位;OOP 与数据模型(12~14)提供 iter 插头——本篇是专栏二把「流」立成一等公民的第一课。
也可以把收获压成检查清单:能画 Iterable/Iterator 分工图;能把 for 翻译成 iter/next;能用 yield 重写游标类;能说出何时物化、何时保持惰性;能举一个 DataLoader / 流式 token / Agent 事件的例子。五项过关,即可进入装饰器篇。
九、课后练习
- (基础) 手写
Squares(n)迭代器类:产出0..n-1的平方;用list(Squares(5))验证。 - (基础) 用生成器函数重写上一题;再写等价生成器表达式。
- (基础) 实现
take(n, xs)与drop(n, xs);对range(10)组合使用。 - (理解) 实现
batched(xs, size);讨论最后一个不满批是否应yield(按任务二选一并说理由)。 - (理解) 写
nonblank_lines风格函数处理多行字符串;对比先splitlines再列表过滤的内存差异(可用更大重复文本感受)。 - (理解) 演示:同一
iter(list)被list(it)后再次list(it)为空;改成可多次遍历的源类。 - (进阶) 用生成器实现简易
agent_run,至少产出thought/tool/final三种事件;写一个消费者统计事件类型次数。 - (进阶 · AI Infra) 把「range → 过滤偶数 → 平方 → 每 3 个一批」串成惰性管道;中间不出现完整大列表。思考:若要多进程 map,哪里必须物化或换队列?
下一篇预告
下一篇是《第16篇|装饰器》——在不动业务函数签名的前提下,用 @decorator 包装日志、计时、缓存、权限与重试。你会看到:装饰器本质是「可调用 → 可调用」的高阶函数(第 07、08 篇闭包会回来);与本篇结合时,既可以装饰普通函数,也可以装饰生成器函数(注意包装后如何保留 iter 语义)。
专栏二后续路线:装饰器 → 上下文管理器 → 类型注解 / dataclass / Pydantic → 标准库精选(含 itertools)→ 工程化与测试 → 并发 / asyncio → HTTP 与 FastAPI → 最小 Agent。带着本篇的惰性与协议直觉,读源码时先找 yield 与 for,再跟业务。
若想提前热身:写一个 @timer 装饰器打印函数耗时(可用 time.perf_counter);再试着装饰本篇的 batched,观察包装生成器函数时要 yield from 还是返回生成器对象。做完后第 16 篇谈装饰器栈与 functools.wraps 时你会带着具体坑感。
也可以把第 14 篇的 call 与装饰器对照:都是「在调用前后插入行为」;装饰器偏函数注册时缠绕,call 偏对象协议。两者在 FastAPI 依赖注入与 Agent 工具注册里会碰头。
专栏一用十四篇把「对象与协议」立住;专栏二从本篇开始加「流式与工程刀具」。下一篇见。
若时间充裕,再多做一件事:打开任意你写过的「先读全文件再处理」脚本,改成生成器管道,用一个稍大的样例文件对比内存与体感延迟。改完后你会更笃定:专栏二不是要你背更多语法,而是把已经会的语言,接到真实数据体量与系统边界上。
收官前对照练习:同一份「过滤 + 变换 + 聚合」,分别用列表推导链、生成器函数链、以及错误地把生成器用尽两次的写法走一遍。你会清楚感受到:协议与惰性不是语法糖游戏,而是把自定义处理抬到与内置 for / 文件流同一套操作面的关键一步——也是专栏二工程化与框架对接的入场券。