
第24篇|多进程与 concurrent.futures
本篇定位:《Python 教程》专栏二「Python 进阶与工程」第 24 篇。承接第 23 篇把 GIL 与线程说清之后,正面讲清 多进程(multiprocessing) 与
concurrent.futures:如何真正用上多核、进程间如何交接、同一套 futures API 如何在线程池与进程池之间切换。为第 25 篇 asyncio、DataLoadernum_workers、批处理预处理与推理流水线选型打底。读完你将能够:用自己的话解释「多进程为何能绕开 GIL」;区分
fork/spawn并写出带if name == "main"的安全入口;用ProcessPoolExecutor加速 CPU 密集任务;用同一套submit/map/as_completed对照线程池与进程池;判断序列化成本与 AI Infra 场景里进程该放哪一层。预计用时:阅读 35~45 分钟,动手 45~60 分钟。
第 23 篇给了同进程并发的边界:I/O 用线程,纯 Python CPU 别硬上。本篇回答下一个工程问题——「我想真用多核算」时,Python 默认怎么干? 很多人把「开多进程」当成银弹:要么忘了序列化翻车,要么在已有线程后再 fork 搞出死锁,要么把编排状态拆进多个进程乱写。
一句话定心:每个进程有自己的解释器与 GIL,纯 Python 重计算可以真并行;代价是启动成本与跨进程数据必须可序列化。 线程共享世界;进程各有世界——交接靠 pickle、Queue、Pipe 或共享内存,而不是「随便传个闭包」。
建议边读边在练习目录里动手(uv init --no-package,标准库即可)。阅读顺序:心智模型 → 启动方式 → multiprocessing 基础 → concurrent.futures 统一脸 → 选型与序列化 → AI Infra → 踩坑。下一篇预告 asyncio(25):当 I/O 连接数上千、线程栈扛不住时,单线程协程如何叠海量等待。
和第 02 篇对照:进程默认不共享对象引用——这正是「少竞态」的来源,也是「必须 pickle」的代价。和第 09 篇对照:spawn 会重新 import 目标模块,顶层副作用会被放大。和第 23 篇对照:同一段 CPU 重循环,线程池几乎不加速,进程池常能降墙钟——用测量说话。
动手时建议沿用「批处理预处理」意象:主进程编排任务列表;ProcessPoolExecutor 跑可 pickle 的纯函数(分词、特征、压缩);结果写回列表或落盘。真正的 GPU 算子仍交给 CUDA;进程池别用来「抢同一块显卡会话」。做完后打开任意 DataLoader / 批推理脚本,你会认出同一套形状。
本篇不穷尽所有共享内存 API(SharedMemory 细节)、不替代分布式任务队列(Celery / Ray)、不深入操作系统调度。主线是:隔离心智 → 启动方式 → 进程池工作流 → futures 统一 API → 选型与 AI 场景 → 踩坑。和「听说多进程就乱开」相比,正确价值是:在 CPU 边界叠进程,在交接边界保证可序列化,在编排边界保持单点清晰。
写多进程时保持一个工程直觉:能返回值就别共享状态;必须共享就用队列或显式共享内存;入口永远带 if name == "main"。 「在模块顶层直接 Process().start()」在 spawn 下会递归炸进程——三个月后的夜班你会感谢今天的防护。
也可以把本篇看成专栏二「并行面」的下半场:第 23 篇同进程叠任务,本篇跨进程真并行,第 25 篇单线程叠海量 I/O。后面 HTTP、FastAPI、Agent,都假设「你知道何时换 Executor」。
读官方 multiprocessing 与 concurrent.futures 文档时,按本篇目录对照即可。入门阶段把「会选启动方式、会写进程池、会处理 pickle、会对照计时」做扎实,比背完整同步原语表更重要。
动手时再记一条:并行的第一原则仍是正确优先于快——错误的进程池比串行更糟,因为它摧毁可复现性并放大序列化错误。排障时一条最小可复现(顶层函数 + 小入参),往往比一百次「再开多几个 worker」更值钱。
和「进程数等于 CPU 核数」的神话相比,更值钱的是匹配瓶颈与成本:任务太短时序列化吃掉收益;任务太长时要控内存峰值。把这个品味带进 code review,比强制「必须多进程」温和且有效。
若你刚从第 23 篇「GIL 挡字节码」过来,本篇前两节会换一种体感:同样是叠任务,但挂钩点从「共享与锁」换成「隔离与序列化」。把「纯 Python 重循环」改成 ProcessPoolExecutor 对照计时,把「lambda 丢进进程池」改成顶层函数——两条路径走完,多进程直觉就长出来了。
和「在聊天里口头说并行」相比,可运行示例的价值是:机器可重复、可测、可对比墙钟时间——本地与 CI 上同一套结论。排障时你面对的是 pickle 错误与启动方式,而不是「我记得好像快了一点」。
动手前再立一条纪律:先单进程正确,再并行。 先写串行纯函数并测绿,再引入进程池,最后用计时验证是否真有收益。很多人倒过来「先并行再修 pickle」,修的时候容易不自觉把不可序列化对象塞进闭包——进程变成了复杂度放大器。小步红绿循环在多进程里同样成立。
一、为什么要谈多进程:绕开 GIL 用多核
1.1 一张图看清进程与线程
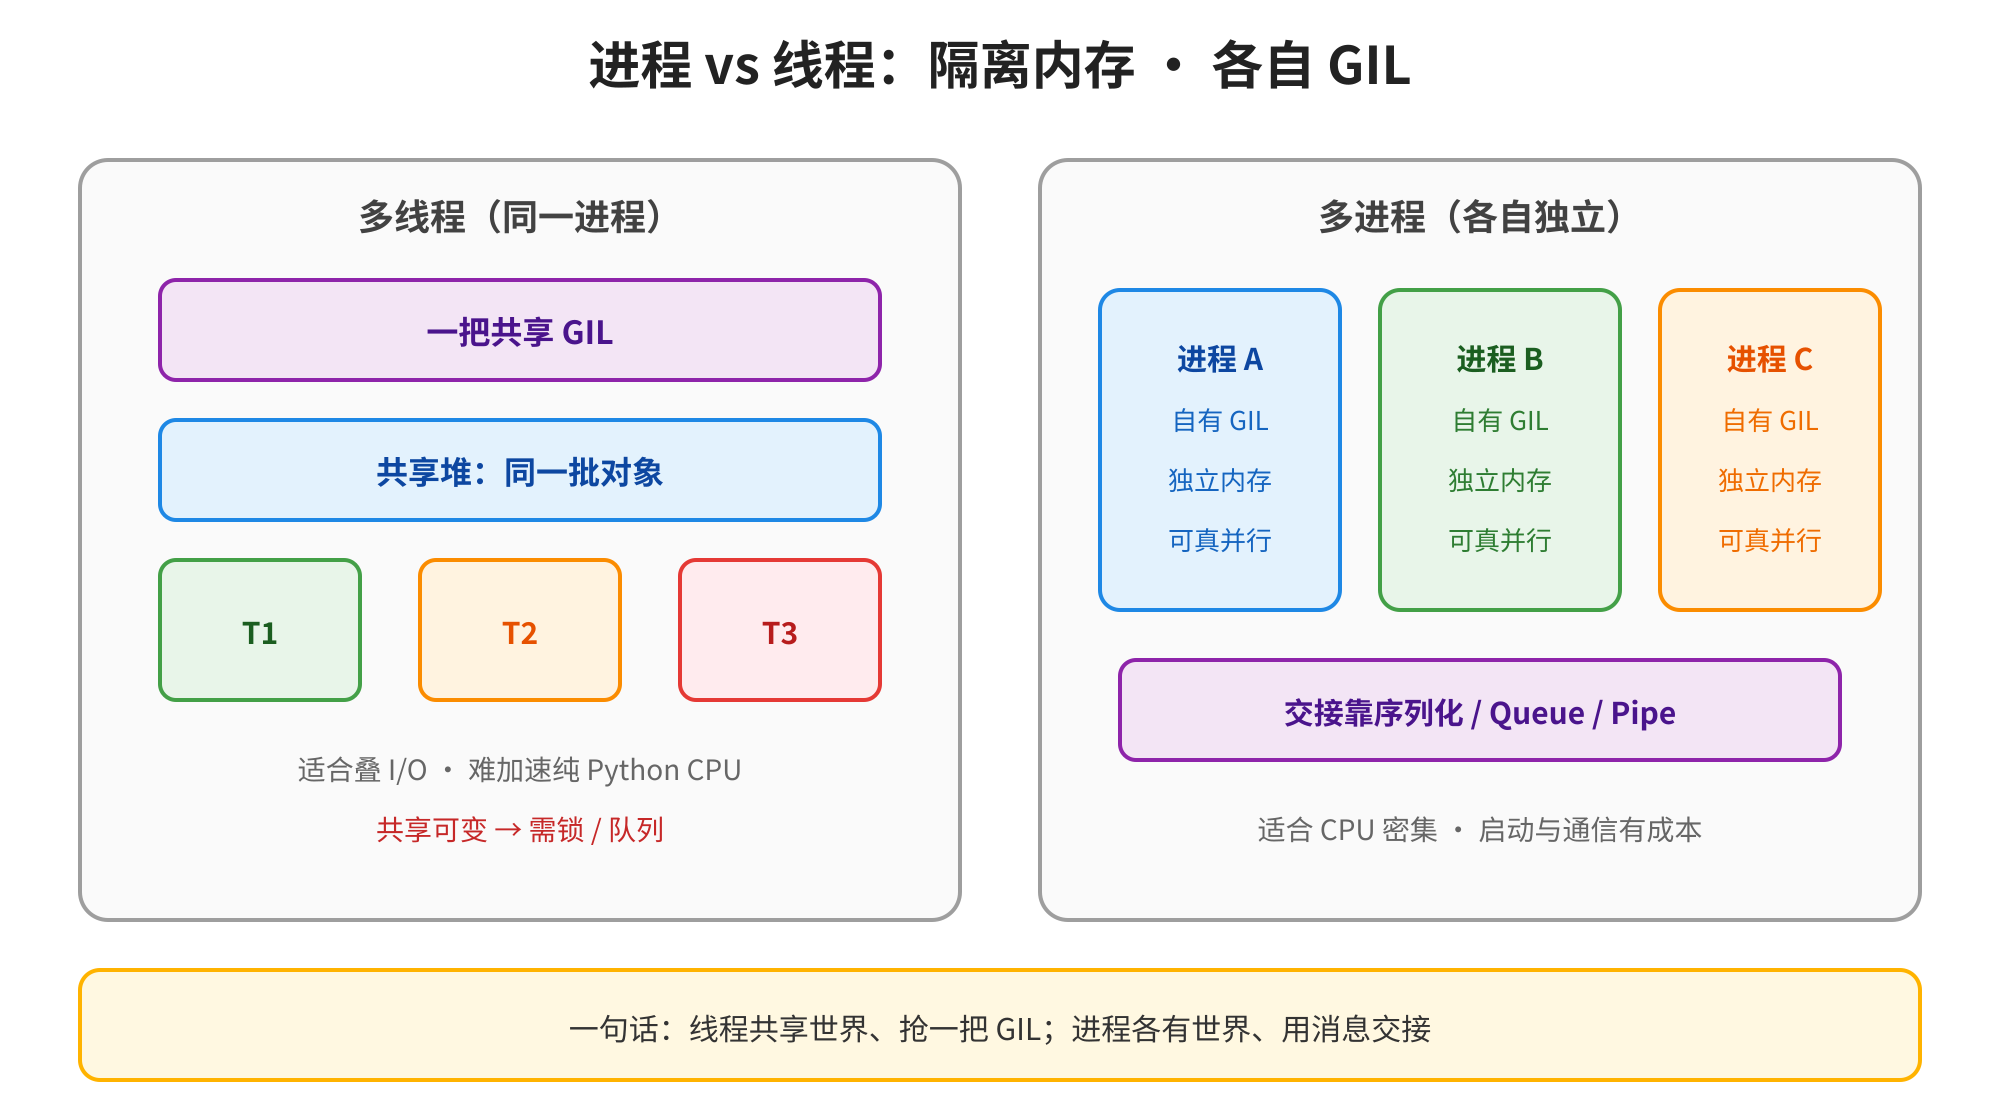
图1 进程 vs 线程:隔离内存 · 各自 GIL
import time
from concurrent.futures import ProcessPoolExecutor, ThreadPoolExecutor


def cpu_heavy(n: int) -> int:
    s = 0
    for i in range(n):
        s += i * i
    return s


def main() -> None:
    N = 3_000_000
    jobs = [N] * 4

    t0 = time.perf_counter()
    with ThreadPoolExecutor(max_workers=4) as pool:
        list(pool.map(cpu_heavy, jobs))
    print("threads", f"{time.perf_counter() - t0:.2f}s")

    t0 = time.perf_counter()
    with ProcessPoolExecutor(max_workers=4) as pool:
        list(pool.map(cpu_heavy, jobs))
    print("processes", f"{time.perf_counter() - t0:.2f}s")


if __name__ == "__main__":
    main()
threads 1.85s
processes 0.62s
(具体秒数因机器而异;趋势通常是:线程版接近串行,进程版明显更快。)把第 23 篇的「线程不加速纯 Python」体感,用进程池翻成另一条曲线——这就是本篇存在的理由。
要点:
- 多进程 = 多个解释器:各自执行字节码,互不抢同一把 GIL。
- 隔离换安全:默认看不到对方变量,减少共享可变竞态。
- 隔离换成本:传参与返回值要序列化;worker 启动要时间。
1.2 和第 09、23 篇的边界
第 09 篇讲 import:spawn 子进程会重新导入主模块相关依赖,顶层副作用(连库、起服务)可能被执行多次。第 23 篇讲 GIL:线程叠 I/O;本篇把 CPU 密集交给进程。两者互补,不是互斥——混合流水线很常见:线程管下载,进程管重解析。
AI Infra 视角:DataLoader 的
num_workers、特征批处理、离线评测扫大量样本——典型进程池场景;并发打 LLM API——仍偏线程或 asyncio。先问「等的是网络还是算力」,再问「数据能不能 pickle」。
1.3 渐进采用
老脚本全是串行 for 重循环?可以:先把循环体提成模块顶层纯函数;再包进 ProcessPoolExecutor;用返回值收集结果,别先上共享全局。不必一天引入 Ray,但新 CPU 边界不要再无脑指望线程。
二、启动方式:fork、spawn、forkserver
2.1 三种方式一张图
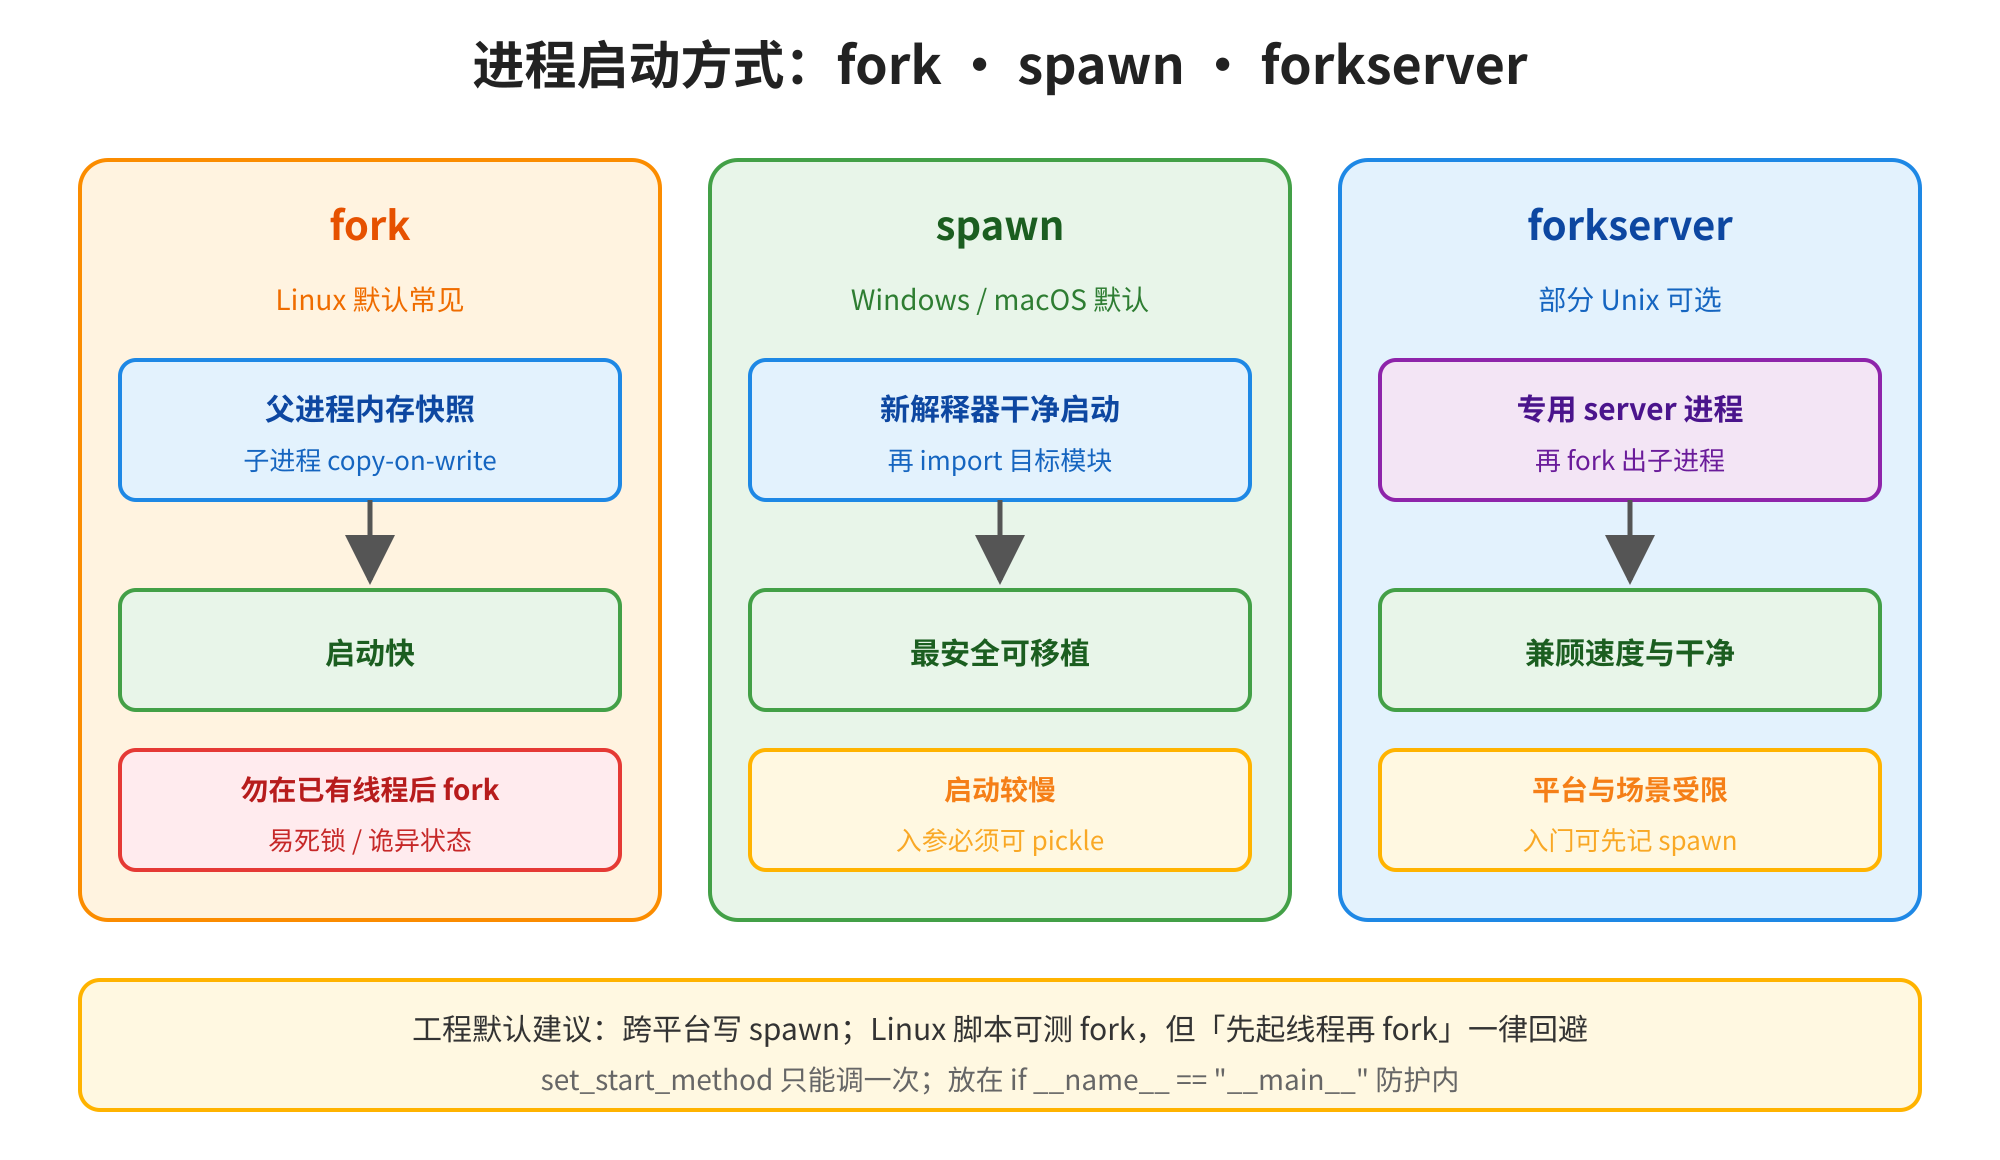
图2 进程启动方式:fork · spawn · forkserver
import multiprocessing as mp

print(mp.get_start_method())  # 看当前默认
# 若需显式指定,只能成功调用一次:
# mp.set_start_method("spawn")
fork
(在 macOS / Windows 上你可能看到 spawn。)工程建议:跨平台代码写 spawn 心智;Linux 性能敏感脚本可测 fork,但牢记第 23 篇坑——先起线程再 fork 一律回避。
2.2 为什么必须有 if name == "main"
spawn(以及某些环境下的惰性导入)会让子进程重新执行模块顶层。若顶层直接 Process(...).start() 或创建进程池,子进程会再次创建子进程——递归爆炸或怪异挂起。
# good_entry.py
from concurrent.futures import ProcessPoolExecutor


def work(x: int) -> int:
    return x * x


def main() -> None:
    with ProcessPoolExecutor(max_workers=2) as pool:
        print(list(pool.map(work, range(4))))


if __name__ == "__main__":
    main()
[0, 1, 4, 9]
把 main() 调用挪到防护外,在 spawn 下几乎必炸。把这条当成肌肉记忆,比事后查 traceback 便宜。
2.3 可移植默认策略
- 业务代码按
spawn可运行来写(顶层函数、可 pickle 入参、main防护)。 - 需要时再针对 Linux 测
fork是否更快。 - 库代码尽量不要在 import 时
set_start_method——那是应用入口的职责。
三、multiprocessing 基础:Process、Pool、Queue
3.1 Process:显式创建与汇合
from multiprocessing import Process
import os


def show(tag: str) -> None:
    print(tag, "pid=", os.getpid())


if __name__ == "__main__":
    p = Process(target=show, args=("child",))
    p.start()
    show("parent")
    p.join()
    print("exitcode", p.exitcode)
parent pid= 12345
child pid= 12346
exitcode 0
(pid 数字因环境而异。)和 threading.Thread 形状相似:start / join;但子进程有独立 pid,变量不共享。
3.2 Pool:批量映射
from multiprocessing import Pool


def square(x: int) -> int:
    return x * x


if __name__ == "__main__":
    with Pool(processes=2) as pool:
        print(pool.map(square, range(5)))
[0, 1, 4, 9, 16]
Pool 是经典 API;新代码更推荐下一节的 ProcessPoolExecutor(与线程池同一张脸,异常模型更统一)。两者底层都是「worker 进程 + 任务队列」。
3.3 Queue:跨进程消息
from multiprocessing import Process, Queue


def producer(q: Queue) -> None:
    for i in range(3):
        q.put(i)
    q.put(None)  # 哨兵:结束


def consumer(q: Queue) -> None:
    while True:
        item = q.get()
        if item is None:
            break
        print("got", item)


if __name__ == "__main__":
    q: Queue = Queue()
    p = Process(target=producer, args=(q,))
    c = Process(target=consumer, args=(q,))
    p.start()
    c.start()
    p.join()
    c.join()
got 0
got 1
got 2
跨进程 Queue 会自动处理序列化;和线程版 queue.Queue 心智相近,但对象在另一边是拷贝,不是同一引用。别指望「改了对象另一边立刻看见」。
四、concurrent.futures:统一的 submit / map / as_completed
4.1 一张脸切两种池
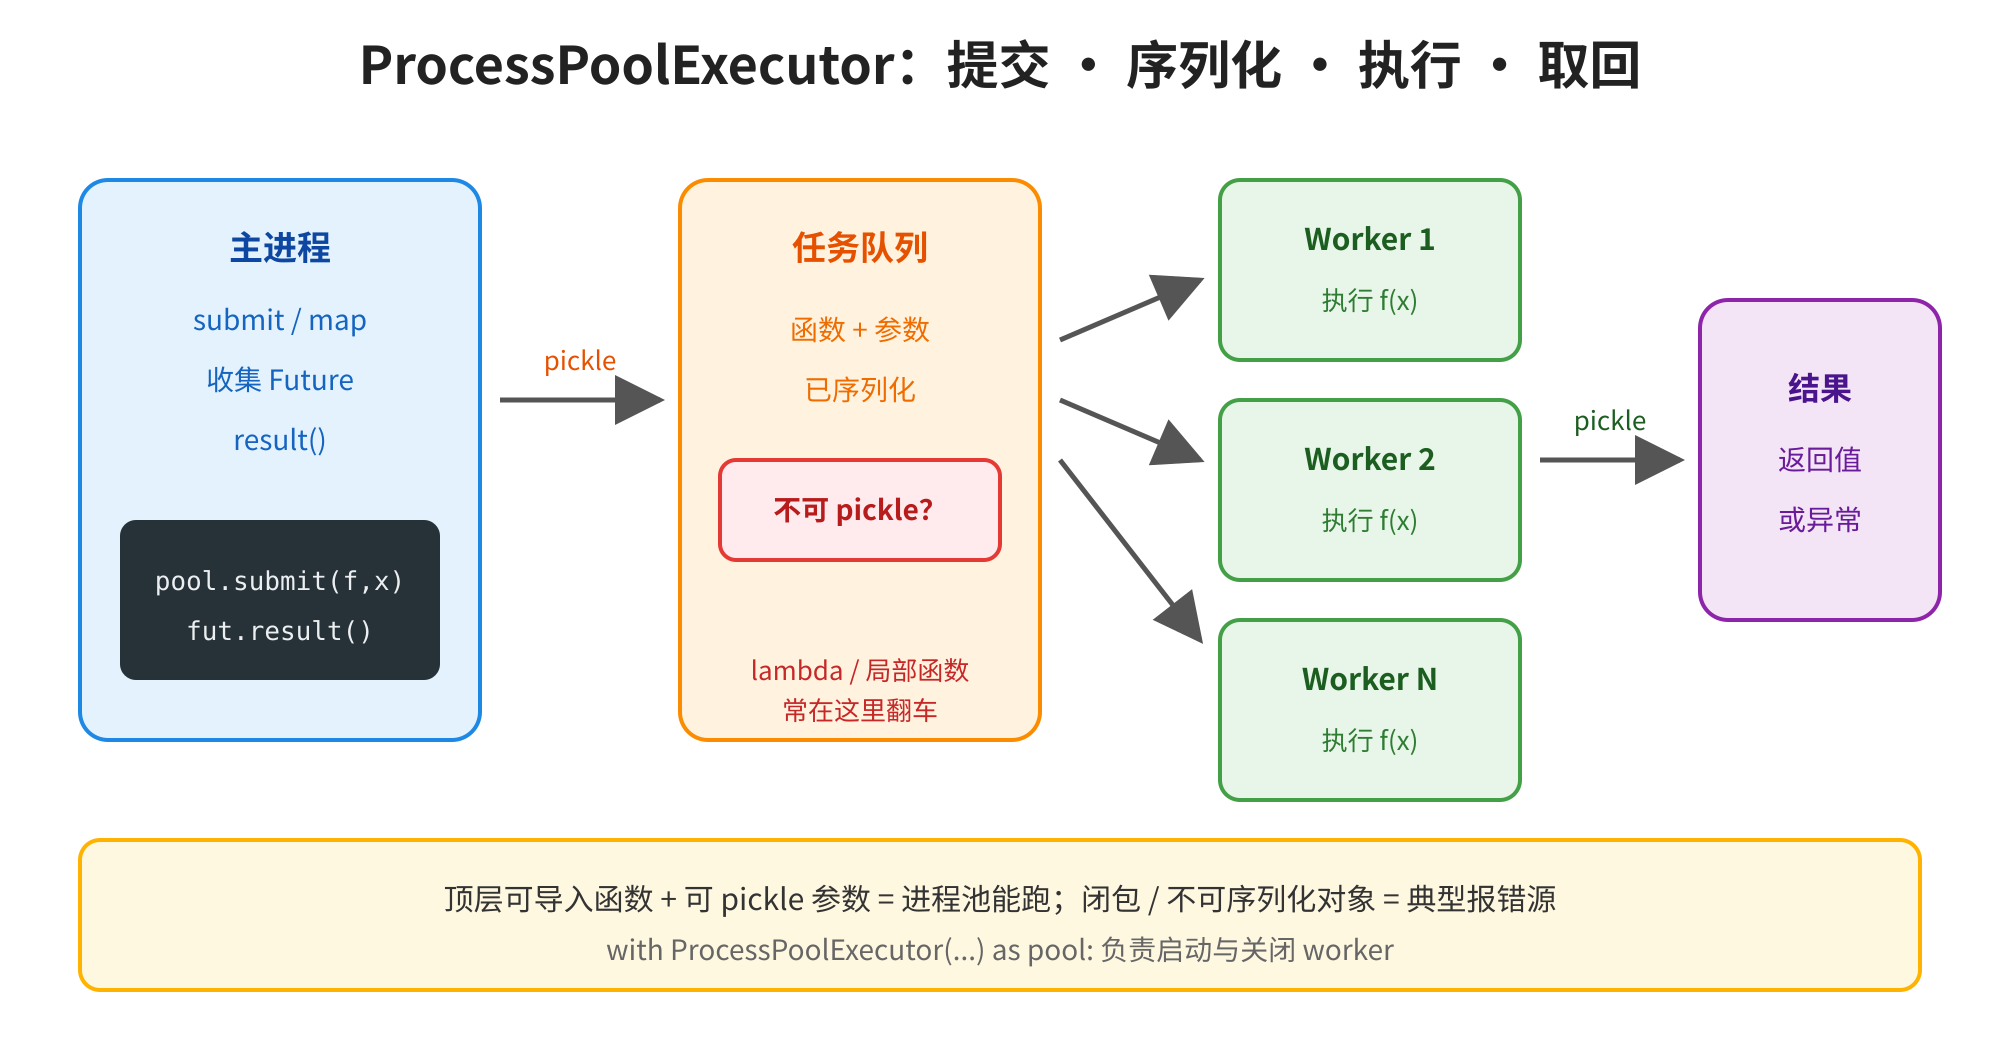
图3 ProcessPoolExecutor:提交 · 序列化 · 执行 · 取回
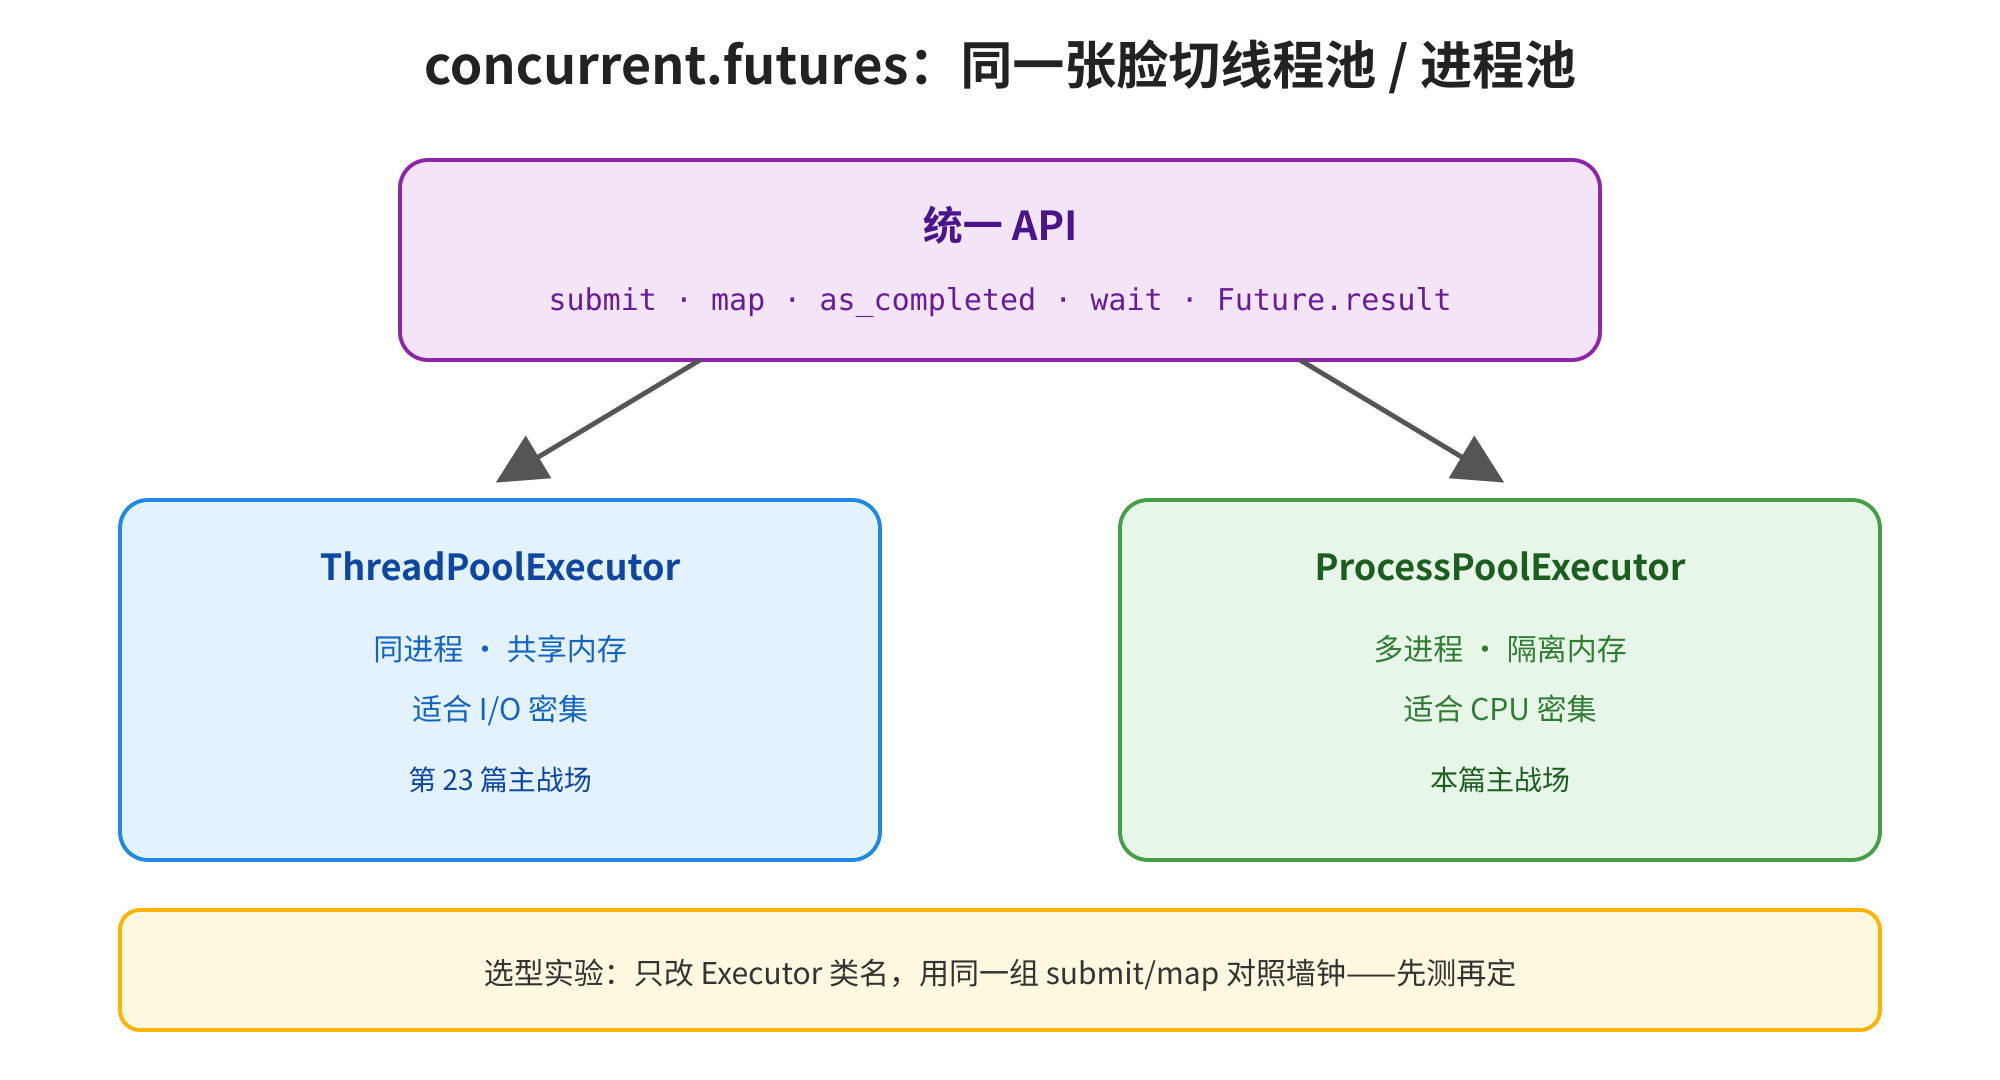
图4 concurrent.futures:同一张脸切线程池 / 进程池
from concurrent.futures import ProcessPoolExecutor, as_completed


def parse_chunk(text: str) -> int:
    return text.count("a")


if __name__ == "__main__":
    chunks = ["banana", "apple", "avocado", "grape"]
    with ProcessPoolExecutor(max_workers=2) as pool:
        futs = {pool.submit(parse_chunk, c): c for c in chunks}
        for fut in as_completed(futs):
            src = futs[fut]
            print(src, "->", fut.result())
banana -> 3
apple -> 1
avocado -> 3
grape -> 1
(完成顺序可能不同。)submit 返回 Future;result() 取回值或抛出工作函数里的异常——和第 23 篇线程池同一套合同。
4.2 map:保序便利接口
from concurrent.futures import ProcessPoolExecutor


def triple(x: int) -> int:
    return x * 3


if __name__ == "__main__":
    with ProcessPoolExecutor(max_workers=2) as pool:
        print(list(pool.map(triple, range(5))))
[0, 3, 6, 9, 12]
map 按输入顺序产出;适合「一批同类任务」。需要「谁先完谁处理」用 as_completed。
4.3 对照实验:只改类名
import time
from concurrent.futures import ProcessPoolExecutor, ThreadPoolExecutor


def cpu_heavy(n: int) -> int:
    return sum(i * i for i in range(n))


def bench(executor_cls, n: int = 2_000_000, workers: int = 4) -> float:
    jobs = [n] * workers
    t0 = time.perf_counter()
    with executor_cls(max_workers=workers) as pool:
        list(pool.map(cpu_heavy, jobs))
    return time.perf_counter() - t0


if __name__ == "__main__":
    print("thread", f"{bench(ThreadPoolExecutor):.2f}s")
    print("process", f"{bench(ProcessPoolExecutor):.2f}s")
thread 1.20s
process 0.40s
这是本篇最值钱的实验模板:同一工作函数、同一 map,只换 Executor。I/O 版把 cpu_heavy 换成 time.sleep,结论会反转——和第 23 篇呼应。
五、序列化、成本与选型
5.1 什么能进进程池
from concurrent.futures import ProcessPoolExecutor


def ok(x: int) -> int:
    return x + 1


if __name__ == "__main__":
    with ProcessPoolExecutor(max_workers=2) as pool:
        print(list(pool.map(ok, [1, 2, 3])))
        # pool.map(lambda x: x + 1, [1, 2, 3])  # 典型失败:无法 pickle
[2, 3, 4]
规则:工作函数放在模块顶层;参数尽量小而干净。 大数组反复 pickle 可能比计算本身还贵——此时考虑共享内存、分块落盘、或向量化(后续 NumPy 篇)。
5.2 任务粒度
5.3 选型速查
六、AI Infra:进程放哪一层
6.1 选型地图
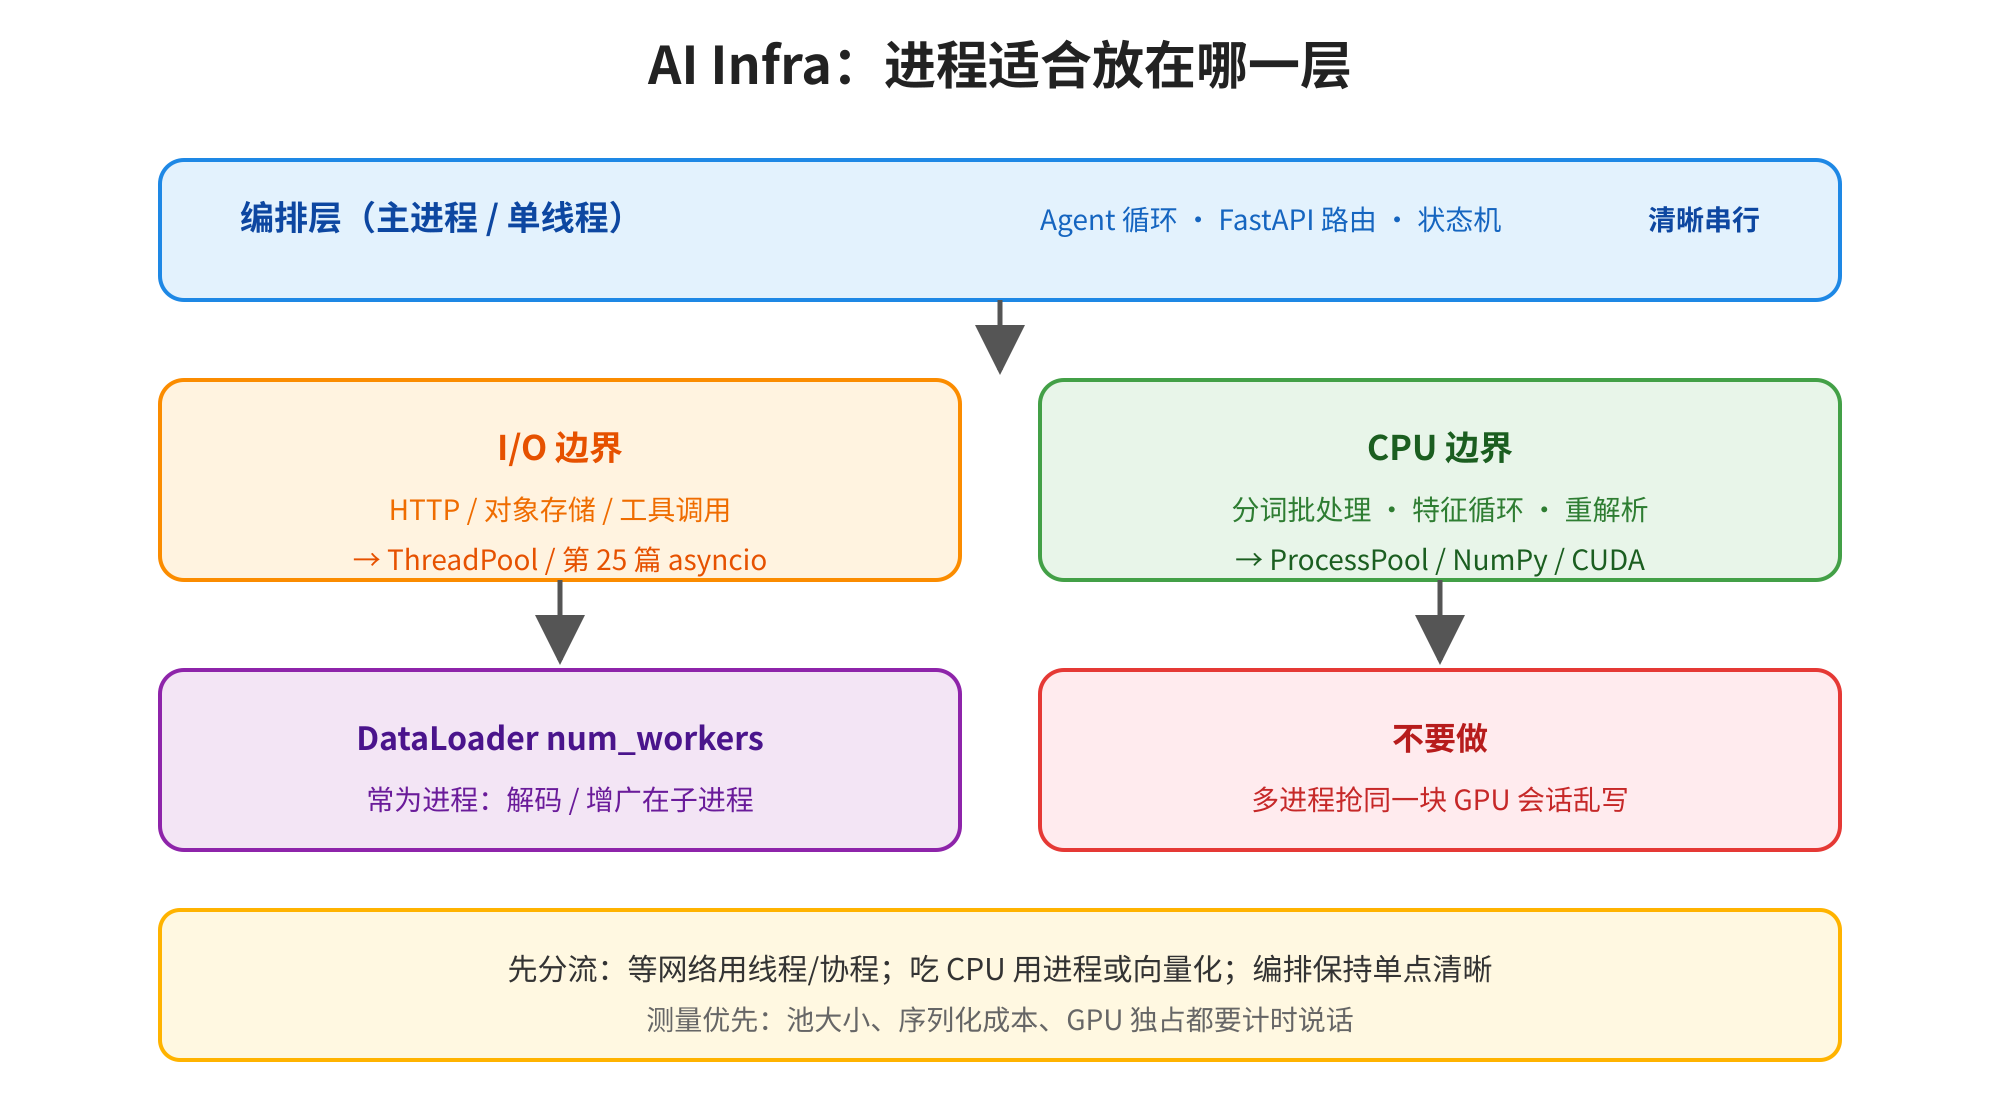
图5 AI Infra:进程适合放在哪一层
6.2 Agent 与批处理
Agent 循环里「并行跑两个互不依赖的重 CPU 工具」(本地重解析、大文件压缩)适合进程池:输入输出是可 pickle 的路径或字节,状态机仍在主进程。可变的「当前对话状态」不要拆进多个进程各写一份——和第 22、23 篇同向:编排单点,工人无状态。
6.3 和后续篇章的分工
- 第 23 篇:同进程、GIL、线程、锁、队列。
- 本篇:多进程绕开 GIL、
ProcessPoolExecutor、futures 统一脸。 - 第 25 篇:单线程协程叠海量 I/O。
- 第 26~28 篇:HTTP / FastAPI / Agent——默认别在请求路径里无防护地狂建进程池。
读到这里,不妨停一秒自检:你能不能画出「每进程一把 GIL」?能不能解释为何 lambda 进进程池常失败?能不能对「并发打 API」与「纯 Python 累加」分别给出 Executor 建议?两问卡壳,就回到图 1、图 3、图 4 把箭头再走一遍。
和「等线上偶发再改启动方式」相比,现在付出的代价极低:顶层函数、main 防护、可 pickle 入参、有界进程池。事故夜里你会感谢今天的自己。也可以把本篇练习当成以后 DataLoader / 批评测的骨架——池大小与序列化先约定好,比事后补齐便宜得多。
再强调一次边界:本篇教你在 CPython 默认模型下正确使用多进程与 futures;分布式队列、Kubernetes 多副本、Ray 集群是下一层,会在服务与 Infra 实战里逐步露面。不要因为「听说有更炫的框架」就今天在业务里省略 main 防护。
若你带团队做 code review,可以把本篇收成三条合并门槛:新增并行是否先证明是 CPU 瓶颈;工作函数与入参是否可 pickle;进程池是否有界且入口有 main 防护。门槛不在于「必须打满核」,而在于不许用错误并行换虚假加速。
七、踩坑大全
通用
坑 1:模块顶层直接起进程 / 进程池。 现象:spawn 下递归创建或挂起。原因:子进程重导入执行顶层。解决:所有启动放进 if name == "main"。
坑 2:把 lambda 或嵌套函数丢进进程池。 现象:PicklingError。原因:无法序列化。解决:改成模块顶层 def。
坑 3:任务太短却开很多进程。 现象:比串行更慢。原因:启动与 pickle 开销。解决:合并批次;先测墙钟。
坑 4:以为跨进程 Queue 传的是同一对象引用。 现象:改了没同步。原因:本质是拷贝。解决:用消息传递新状态;或显式共享内存。
坑 5:Future.result() 不调用就以为异常会自己冒泡到主流程日志。 现象:静默失败。原因:异常存在 Future 里。解决:始终取结果或检查 exception()。
坑 6:进程池 max_workers 无界或过大。 现象:内存打满、机器卡死。解决:按 CPU 核数与单任务内存估算;留余量。
坑 7:在已有多线程程序里再 fork。 现象:死锁或诡异锁状态。原因:子进程只复制当前线程。解决:用 spawn;或 fork 前保持单线程。
macOS / Linux / Windows
坑 8:Windows 上忘记 main 防护。 现象:RuntimeError 提示要 freeze support。解决:标准入口写法;必要时 multiprocessing.freeze_support()。
坑 9:macOS 默认 spawn,从 Linux 抄来的「依赖 fork 隐式共享」代码失效。 现象:属性丢失、变慢。解决:按 spawn 心智重写交接。
坑 10:Linux 上 fork 后继承了父进程打开的 GPU / 数据库连接。 现象:连接损坏。解决:子进程内重新建立连接;或改用 spawn。
与 AI / 服务叠加
坑 11:多个进程同时初始化同一块 GPU 上下文乱抢。 现象:OOM 或驱动错误。解决:一进程一卡;或主进程持有引擎、工人只做 CPU 预处理。
坑 12:在 FastAPI 请求路径里同步狂建 ProcessPoolExecutor。 现象:延迟尖刺、进程泄漏。解决:应用启动时建有界池,shutdown 时关闭;轻 I/O 别用进程。
八、小结
合上文章后,试着用自己的话说明:多进程为何能绕开 GIL、spawn 与 fork 差在哪、以及为何工作函数要可 pickle。讲得清,才算真的会了。动手至少跑通:一次 CPU 重循环线程 vs 进程对照 → 一次顶层函数进程池 → 一次故意 lambda 看报错 → 一次 as_completed 收集。
- 隔离与并行:每进程自有 GIL;纯 Python CPU 可真并行。
- 启动方式:跨平台按
spawn写;main防护必带;慎 fork-after-thread。 - multiprocessing:
Process/Pool/Queue;新代码优先进程池 Executor。 - futures 统一脸:
submit/map/as_completed切 Thread/Process 池做对照。 - 序列化与粒度:顶层函数 + 可 pickle 入参;任务别太碎。
- AI Infra:预处理 / DataLoader 偏进程;HTTP / 编排偏线程或协程;GPU 独占别乱抢。
把故事连起来:第 02 篇对象与引用 → 第 09 篇 import → 第 23 篇 GIL 与线程 → 本篇跨进程并行与 futures。专栏二工程刀具继续成套:下一站是 asyncio(25)。
若只能带走一句话:吃 CPU 用进程;交接靠序列化;入口永远防护 main。
也可以用「三个不要」自检:不要在顶层裸起进程;不要对不可 pickle 对象硬塞进程池;不要用进程池硬扛纯 I/O。
再留一个自测:把第 23 篇 CPU 重循环换成 ProcessPoolExecutor 对照;故意提交 lambda 并读懂报错;用 as_completed 打印完成顺序——三问都顺,本篇就站稳了。
本篇技能会立刻复利:读开源先看它如何限 num_workers;PR 里要求说清瓶颈与 pickle 边界;重构争议先测量再加大池。后续 asyncio、FastAPI、Agent,都假设这层已稳。
和专栏一串起来复习也不亏:对象与引用(02)解释为何进程默认更安全;模块(09)解释 spawn 重导入;异常(11)要在 .result() 里浮出;本篇是专栏二把「跨进程真并行」说透的一课。
也可以把收获压成检查清单:会画进程 vs 线程;会设启动方式心智;会 ProcessPoolExecutor;会处理 pickle;能区分 I/O 与 CPU 选型。五项过关,即可进入 asyncio 篇。
若把本篇压成给同事的三十秒讲解:先画「每进程一把 GIL」;再强调「spawn + main」;最后提「只改 Executor 类名做对照」。三张草图比贴一篇博客更管用。等对方能独立把 CPU 重循环改成有界进程池,并解释为何 lambda 失败,就可以一起 code review 并行 PR 了。
动手清单再压缩一版:写 cpu_heavy 对照;顶层函数 map;as_completed 收集;故意触发一次 PicklingError。四步做完,比只「看完文章」扎实一个数量级。
九、课后练习
- (基础) 写模块顶层
def square(x),在if name == "main"里用ProcessPoolExecutor对range(8)做map,打印结果。 - (基础) 故意把
pool.map(lambda x: x * x, ...)跑一遍,记录报错类型与关键信息,用三句话解释原因。 - (基础) 同一
cpu_heavy,分别用ThreadPoolExecutor与ProcessPoolExecutor对照墙钟,制成小表。 - (理解) 用
Process+Queue实现一生产者一消费者(哨兵结束),说明与线程版 Queue 在「是否同一对象」上的差别。 - (理解) 查阅并打印当前
get_start_method();在文档中确认你的 OS 默认;写一段话说明若强制spawn你的代码要满足哪些条件。 - (理解) 用
submit+as_completed处理 6 个耗时不等的任务(可用time.sleep模拟),打印完成顺序是否等于提交顺序。 - (进阶) 设计「批处理 100 个假文本块」:合并为若干 chunk 再进进程池,比较「一任务一文」与「一任务一批」的总耗时,总结粒度。
- (进阶 · AI Infra) 画一张你当前项目的并发图:哪些步骤用线程、哪些用进程、哪些必须留在主进程编排;写 200 字说明 GPU 相关步骤为何通常不塞进随意进程池。
下一篇预告
下一篇是《第25篇|asyncio 异步编程》——在搞清「线程叠 I/O、进程扛 CPU」之后,解决「单线程如何高效叠成千上万个等待」。你会看到:async / await、事件循环、与 concurrent.futures 的边界;以及为何「在协程里调用阻塞 CPU」会堵死整条环。
专栏二后续路线:asyncio → HTTP / FastAPI → 最小 Agent。带着本篇的进程池纪律与 futures 对照法,写异步时记得:别在事件循环里跑重 CPU(可丢给进程池);可等待的 I/O 才配 await;用测量说话。
若想提前热身:把本篇 I/O 版 sleep 示例保存下来,下篇用 asyncio.gather 原样对照「成千上万个等待」时线程池与协程的资源差异。做完后第 25 篇谈事件循环时你会带着具体体感。
也可以把第 15~24 篇对照:生成器管流、装饰器管横切、上下文管资源、类型管形状、标准库给积木、依赖钉环境、日志给眼睛、测试给安全带、线程给同进程并发、本篇给跨进程并行——工程十件套的轮廓已经清晰,下一篇把「异步 I/O」说透。
专栏一用十四篇把「对象与协议」立住;专栏二从迭代器(15)走到多进程(24),下一站是 asyncio。下一篇见。
若时间充裕,再多做一件事:打开你最近用过的一个训练或评测项目,找到 num_workers 或进程池配置,记三条「它为何用进程、如何限制并发、数据如何交接」。这种阅读比空背启动方式定义更能把选型刻进肌肉记忆。
进入专栏二至此,可验证面、可观测面与并行面开始交汇:会看见问题,会自动验回归,也要会在正确层级叠任务。下一篇开始把 asyncio 配齐。若某一节读着抽象,回到对应插图把箭头走一遍,再手打进程池对照与 pickle 报错——多数卡住的地方,其实是「线程、进程、序列化」被混成同一句话。
写进程或读并行报告时再记一条:错误往往来自错误层级与不可序列化交接(该用线程却用进程、该用顶层函数却用 lambda)。和「栈很长但根因很浅」相比,先选对并发模型能省很多时间。
也可以把本篇看成专栏二的「真并行」补课:前面把协议、积木、环境、眼睛、断言与同进程并发收齐,本篇把跨进程并行收齐。后面 asyncio 篇教你如何在单线程里叠海量等待;FastAPI 与 Agent 篇则把并发打进真实请求与工具循环。
若阅读时觉得「线程、进程、协程」总搅在一起,回到图 1 与图 5:先定瓶颈类型,再选层。日常编程三者都要懂一点,但职责不同——混谈是多数初学者卡住的根源。
收官前对照练习:同一段「四个 CPU 重任务」,分别用串行 for、线程池、进程池。你会清楚感受到:进程不是万能加速器,而是用隔离换多核的工具——也是专栏二工程化与 DataLoader / 批处理对接的入场券之一。
写完练习后,不妨在自己的仓库里开一个小 PR:只把串行 CPU 重循环改成有界 ProcessPoolExecutor,不改业务语义。这种「小步叠并行」比空读文档更能把工作流刻进肌肉记忆,也更适合团队推广。
若你带新人,可以把本篇插图打印成一页速查:左列场景(HTTP / 纯循环 / DataLoader / Agent 编排),右列策略(线程池 / 进程池 / 框架 workers / 主进程)。新人写批处理时对着贴,两周后就会自然说出「先量瓶颈」与「先保证可 pickle」。工具文化是带出来的,不是靠一次分享会喊出来的。
最后把专栏二的位置再钉一次:协议篇(15~18)解决「怎么正确接线」;标准库与依赖篇(19~20)解决「积木与环境」;可观测与可验证篇(21~22)解决「如何被看见与自动验证」;并发篇(23~24)解决「同进程与跨进程如何叠任务」;下一篇解决「异步 I/O 如何叠海量等待」。五者齐备,脚本才既写得快,又叠得敢——下一篇再给它配上 asyncio 的实话。