
第16篇|装饰器
本篇定位:《Python 教程》专栏二「Python 进阶与工程」第 16 篇。承接第 07、08 篇的高阶函数与闭包,以及第 15 篇「可调用与流式」的工程直觉,把 装饰器(decorator) 讲透:语法糖、包装器、
functools.wraps、带参装饰器、装饰器栈,以及计时 / 重试 / 缓存 / 注册等横切关注点。为第 17 篇上下文管理器、第 19 篇functools、第 22 篇测试、第 26~28 篇 HTTP / FastAPI / Agent 打底。读完你将能够:把
@f翻译成「定义后重新绑定」;手写无参与带参装饰器,并正确使用wraps;解释多层@的绑定顺序与调用顺序;用装饰器实现计时、重试、简易缓存与工具注册;在装饰生成器函数时保持yield语义;避开「丢元数据」「@retryvs@retry()混用」「装饰方法丢self」等坑。预计用时:阅读 35~45 分钟,动手 25~35 分钟。
第 15 篇把「按需产生下一个值」立成一等公民;本篇转向另一把工程刀具——在不改业务函数签名的前提下,往调用前后插入行为。日志、鉴权、限流、重试、缓存、指标采集,几乎都是横切关注点(cross-cutting concerns):每个业务函数都可能需要,但又不该复制粘贴进每个函数体。
装饰器正是 Python 里表达横切的主流语法。第 08 篇已经预告过:「@loudly 大致等于先 def,再 name = loudly(name)」。本篇把它从预习升级成可落地的写法,并接到 AI Infra / Agent 的真实场景:给 call_llm 加超时重试、给 embedding 加 LRU 缓存、用 @tool 把函数登记进 Agent 工具表。
一句话定心:装饰器是接收可调用、返回可调用的高阶函数(或可调用对象);@ 只是定义完成后的重新绑定。 真正干活的通常是闭包包装器(wrapper);functools.wraps 负责把原函数的名字、文档弦等元数据拷回包装器,避免调试与注册表错乱。
建议边读边开练习目录(uv init --no-package)。阅读顺序:语法糖心智模型 → 手写无参装饰器与 wraps → 带参三层嵌套 → 类装饰器与方法 → 装饰器栈与标准库 → AI Infra 场景 → 踩坑。下一篇预告上下文管理器(17):你会看到「块级资源协议」与「函数级缠绕」经常成对出现——with 管进入/退出,@ 管声明时增强。
和第 07 篇对照:参数与返回值是函数的「正面合同」;装饰器改的是合同外围的行为。和第 08 篇对照:闭包冻住配置与原函数,正是包装器的实现手段。和第 14 篇对照:call 让实例可调用,类也可以当装饰器。和第 15 篇对照:装饰生成器函数时,包装器要么返回生成器对象,要么 yield from,否则惰性语义会被吃掉。
动手时建议沿用前面的 fetch / call_llm / Tool 意象:先写 @timer,再写 @retry(times=3),再把两者叠在同一函数上观察顺序;最后写一个 @register_tool 把函数丢进全局表——这已经是最小 Agent 工具注册的雏形。
本篇不穷尽描述器协议的全部边角(get 只点到与方法绑定相关的部分),也不提前展开 async def 的异步装饰器细节(第 25 篇再补)。主线是:语法糖 → 包装器 → 参数化 → 栈 → 工程场景。和「把横切逻辑复制进每个函数」相比,装饰器的价值是:策略集中、业务干净、组合可声明。
读官方文档 Function definitions 里 decorator 一节,以及 functools 模块说明时,按本篇目录对照即可。入门阶段把「能写、能读栈、能避坑」做扎实,比收藏冷门装饰器库更重要。
写装饰器时保持一个工程直觉:能配置的尽量显式,能注入的尽量可测,能命名的尽量不要匿名。 lambda 很难被漂亮地装饰;复杂策略优先 def 出名字。社区里那些「一行 @ 搞定全世界」的库很酷,但你自己的业务代码更需要可读的三层闭包,而不是魔法。
也可以把装饰器看成空间维度上的协议:第 15 篇回答「一串值如何跨多次调用产生」;本篇回答「一次调用如何在前后被增强」。状态与策略从「散落在业务里」部分搬到「包装层」——这正是框架(Flask/FastAPI 路由、pytest fixture 周边、Agent 工具注册)喜欢 @ 的原因。
一、装饰器是什么:语法糖与重新绑定
1.1 @f 到底做了什么
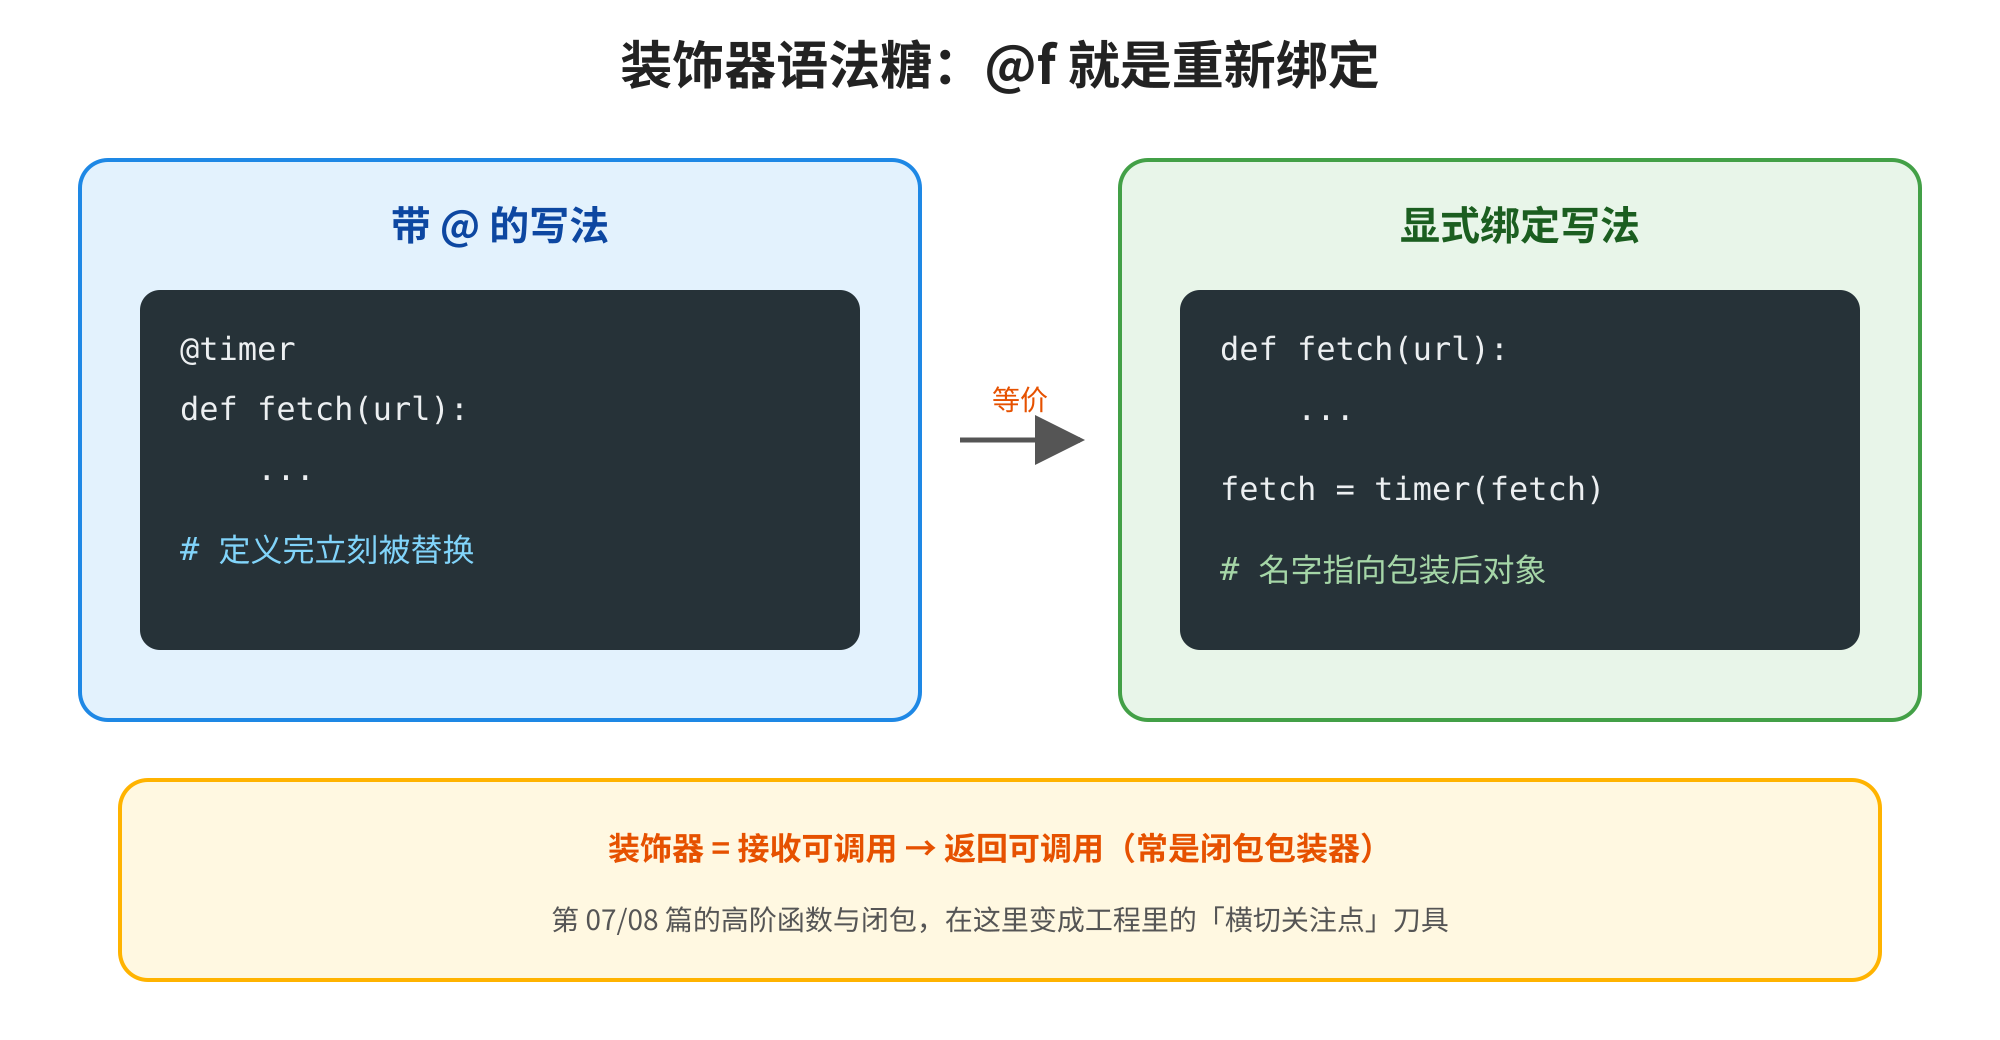
图1 装饰器语法糖:@f 就是重新绑定
下面两段在语义上等价:
def timer(fn):
    def wrapper(*args, **kwargs):
        return fn(*args, **kwargs)
    return wrapper


@timer
def add(a, b):
    return a + b
def timer(fn):
    def wrapper(*args, **kwargs):
        return fn(*args, **kwargs)
    return wrapper


def add(a, b):
    return a + b


add = timer(add)
要点:
- 装饰发生在定义时,不是第一次调用时。
- 名字
add最终指向的是wrapper(或装饰器返回的任意可调用对象)。 - 原函数对象通常被闭包捕获,仍可通过包装器间接调用。
print(add(2, 3))
print(add.__name__)  # 若未 wraps,往往是 'wrapper'
5
wrapper
1.2 为什么叫「横切」
业务函数关心「算什么 / 请求什么」;计时、日志、鉴权关心「每次调用前后多做点什么」。若把后者写进每个函数体,会出现:
- 复制粘贴,改一处漏十处;
- 单元测试难:业务与策略缠死;
- 阅读噪音大:三行业务被三十行样板淹没。
装饰器用「声明式标注」把策略挂在函数外侧。阅读时先看业务,再按需展开外层。
1.3 装饰器的类型合同(直觉版)
| 形态 | 接收 | 返回 | 例子 |
|---|---|---|---|
| 无参装饰器 | 函数 | 函数(包装器) | @timer |
| 带参装饰器工厂 | 配置参数 | 无参装饰器 | @retry(3) |
| 类作装饰器 | 函数 | 实例或函数 | 少见但合法 |
| 装饰类 | 类 | 类或替代对象 | 注册、包装类 |
日常 90% 的代码是前两行。先把「函数进、函数出」练熟,再碰类装饰器。
AI Infra 视角:推理服务里,
@app.post、依赖注入、中间件,本质都是「在可调用外包一层」。Agent 框架的@tool/@function_tool则是「装饰时收集元数据 + 运行时按名分发」。先吃透纯 Python 装饰器,读框架源码只是换皮。
1.4 和「手动包装」比,@ 赢在哪里
你当然可以每次写 fetch = timer(fetch),效果一样。@ 的优势是:定义处一眼看见策略;多层叠放时版面仍清晰;与社区、框架约定一致。代价是:初学者容易忘记「名字已经被换掉」,以及调试时栈里多出 wrapper 帧——后者用 wraps 缓解。
二、手写无参装饰器与 functools.wraps
2.1 最小计时器
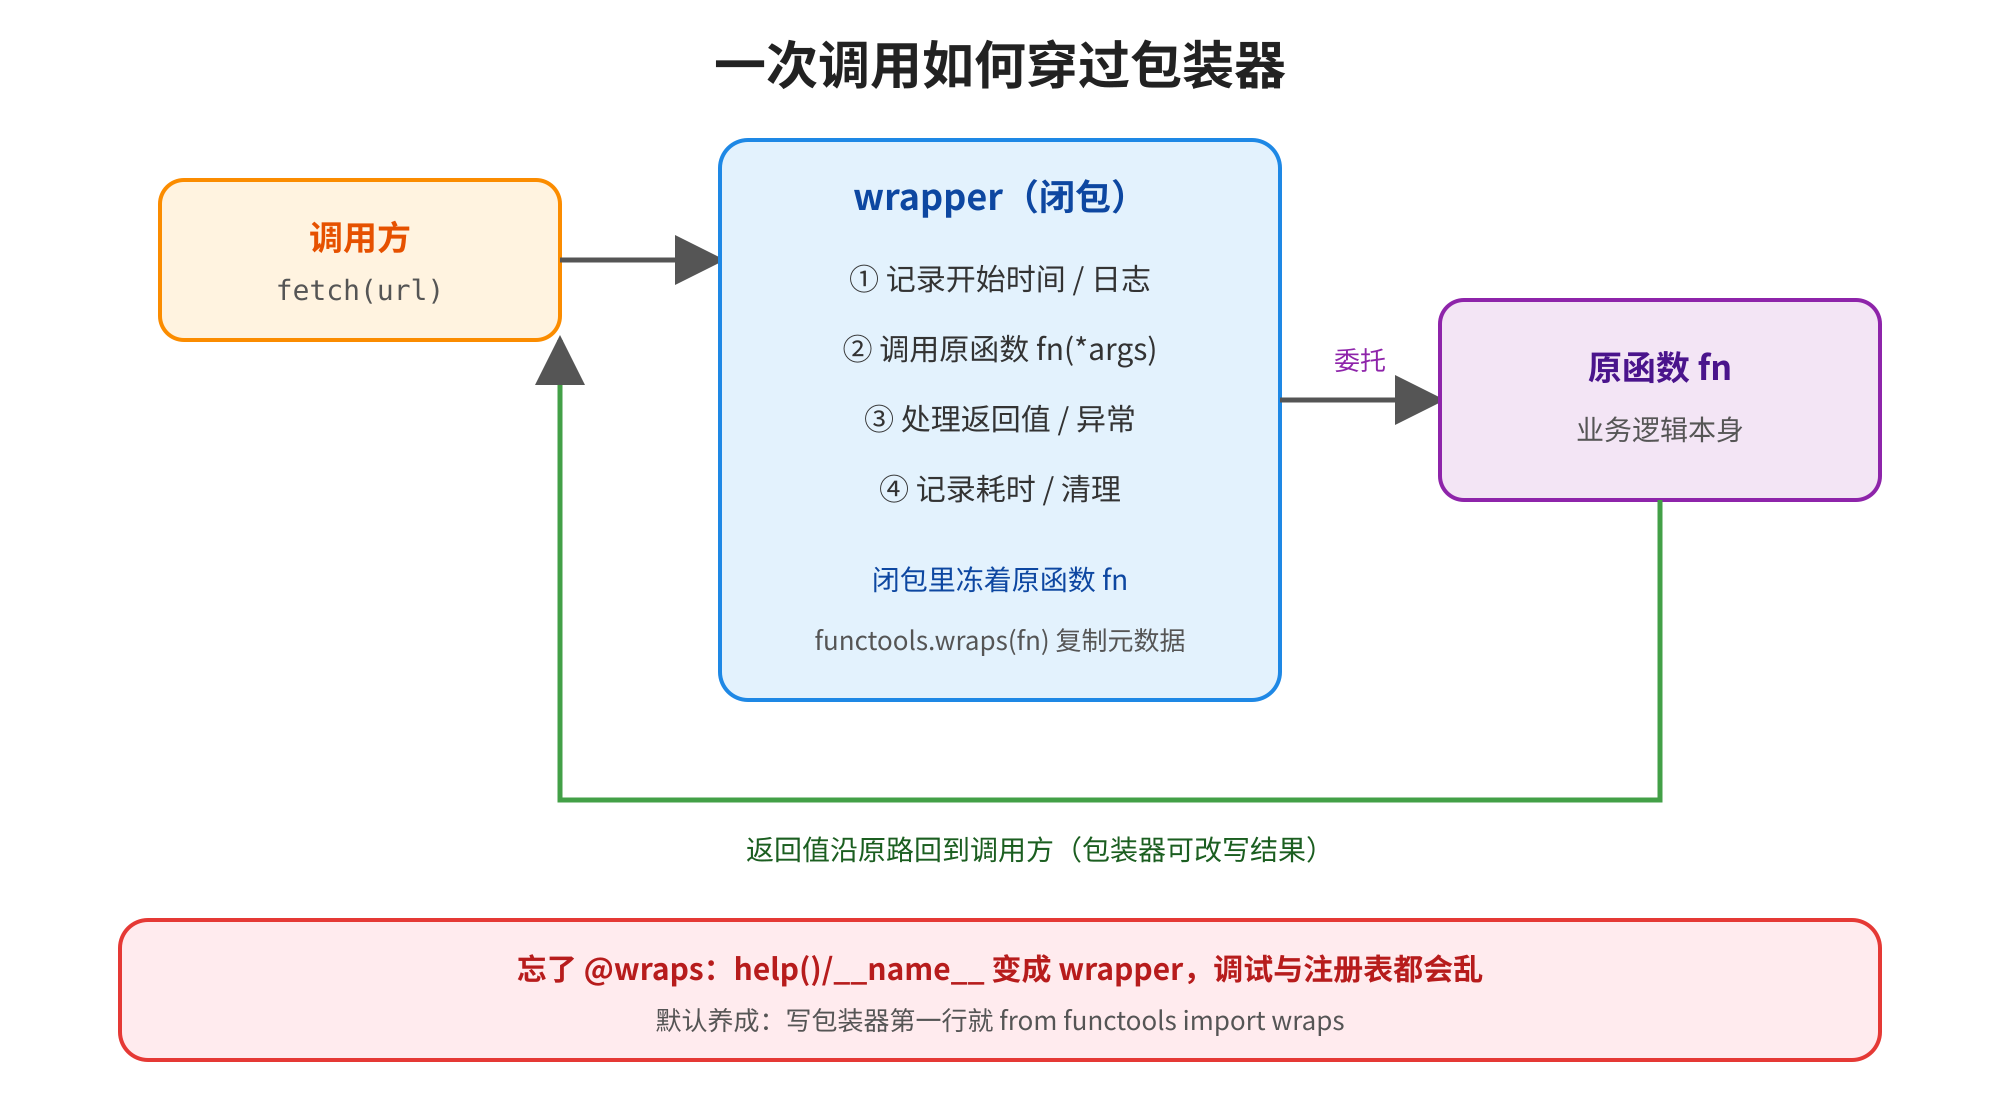
图2 一次调用如何穿过包装器
import time
from functools import wraps


def timer(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        t0 = time.perf_counter()
        try:
            return fn(*args, **kwargs)
        finally:
            dt = time.perf_counter() - t0
            print(f"{fn.__name__} took {dt:.4f}s")

    return wrapper


@timer
def slow_add(a, b):
    """示范用:假装有点慢。"""
    time.sleep(0.05)
    return a + b


print(slow_add(1, 2))
print(slow_add.__name__)
print(slow_add.__doc__)
slow_add took 0.050x s
3
slow_add
示范用:假装有点慢。
(耗时小数会因机器略有浮动。)
@wraps(fn) 做了什么?它把 fn 的 name、doc、module、annotations 等拷到 wrapper 上,并设置 wrapped 指向原函数。这样 help(slow_add)、测试框架收集用例名、以及你自己的注册表,都还能认到「业务名」。
2.2 透明转发:*args, **kwargs
包装器几乎总是:
def wrapper(*args, **kwargs):
    # before
    result = fn(*args, **kwargs)
    # after
    return result
这与第 08 篇「胶水转发」同构:不假设原函数有几个参数、是否仅关键字。若你写死 wrapper(x),一旦原函数变成两参数就会炸——除非你有意收窄接口。
2.3 在包装器里处理异常
from functools import wraps


def silence(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        try:
            return fn(*args, **kwargs)
        except Exception as e:
            print(f"{fn.__name__} failed: {type(e).__name__}: {e}")
            return None

    return wrapper


@silence
def div(a, b):
    return a / b


print(div(1, 0))
print(div(6, 2))
div failed: ZeroDivisionError: division by zero
None
3.0
生产里「吞掉所有异常」通常是坏味道;更常见的是:记录日志后重新抛出,或只捕获可恢复的异常类型。装饰器不改变「异常是控制流」的原则(第 11 篇),它只是提供统一的挂钩点。
2.4 wrapped:需要原函数时
from functools import wraps


def tag(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        return fn(*args, **kwargs)

    return wrapper


@tag
def greet(name: str) -> str:
    return f"hi {name}"


print(greet.__wrapped__("agent"))
hi agent
测试或特殊路径想「绕过装饰」时,可以走 wrapped;多层装饰时可能需要一路解包。多数业务代码不需要手动碰它,但知道它在,读 functools 文档不慌。
三、带参数的装饰器:三层嵌套
3.1 为什么需要多一层
@timer 不需要配置;@retry(times=3) 需要。写法上:
@retry(3)
def call():
    ...
等价于:
def call():
    ...


call = retry(3)(call)
也就是说:先调用工厂 retry(3) 得到装饰器,再用该装饰器包函数。于是出现三层:工厂 → 装饰器 → 包装器。
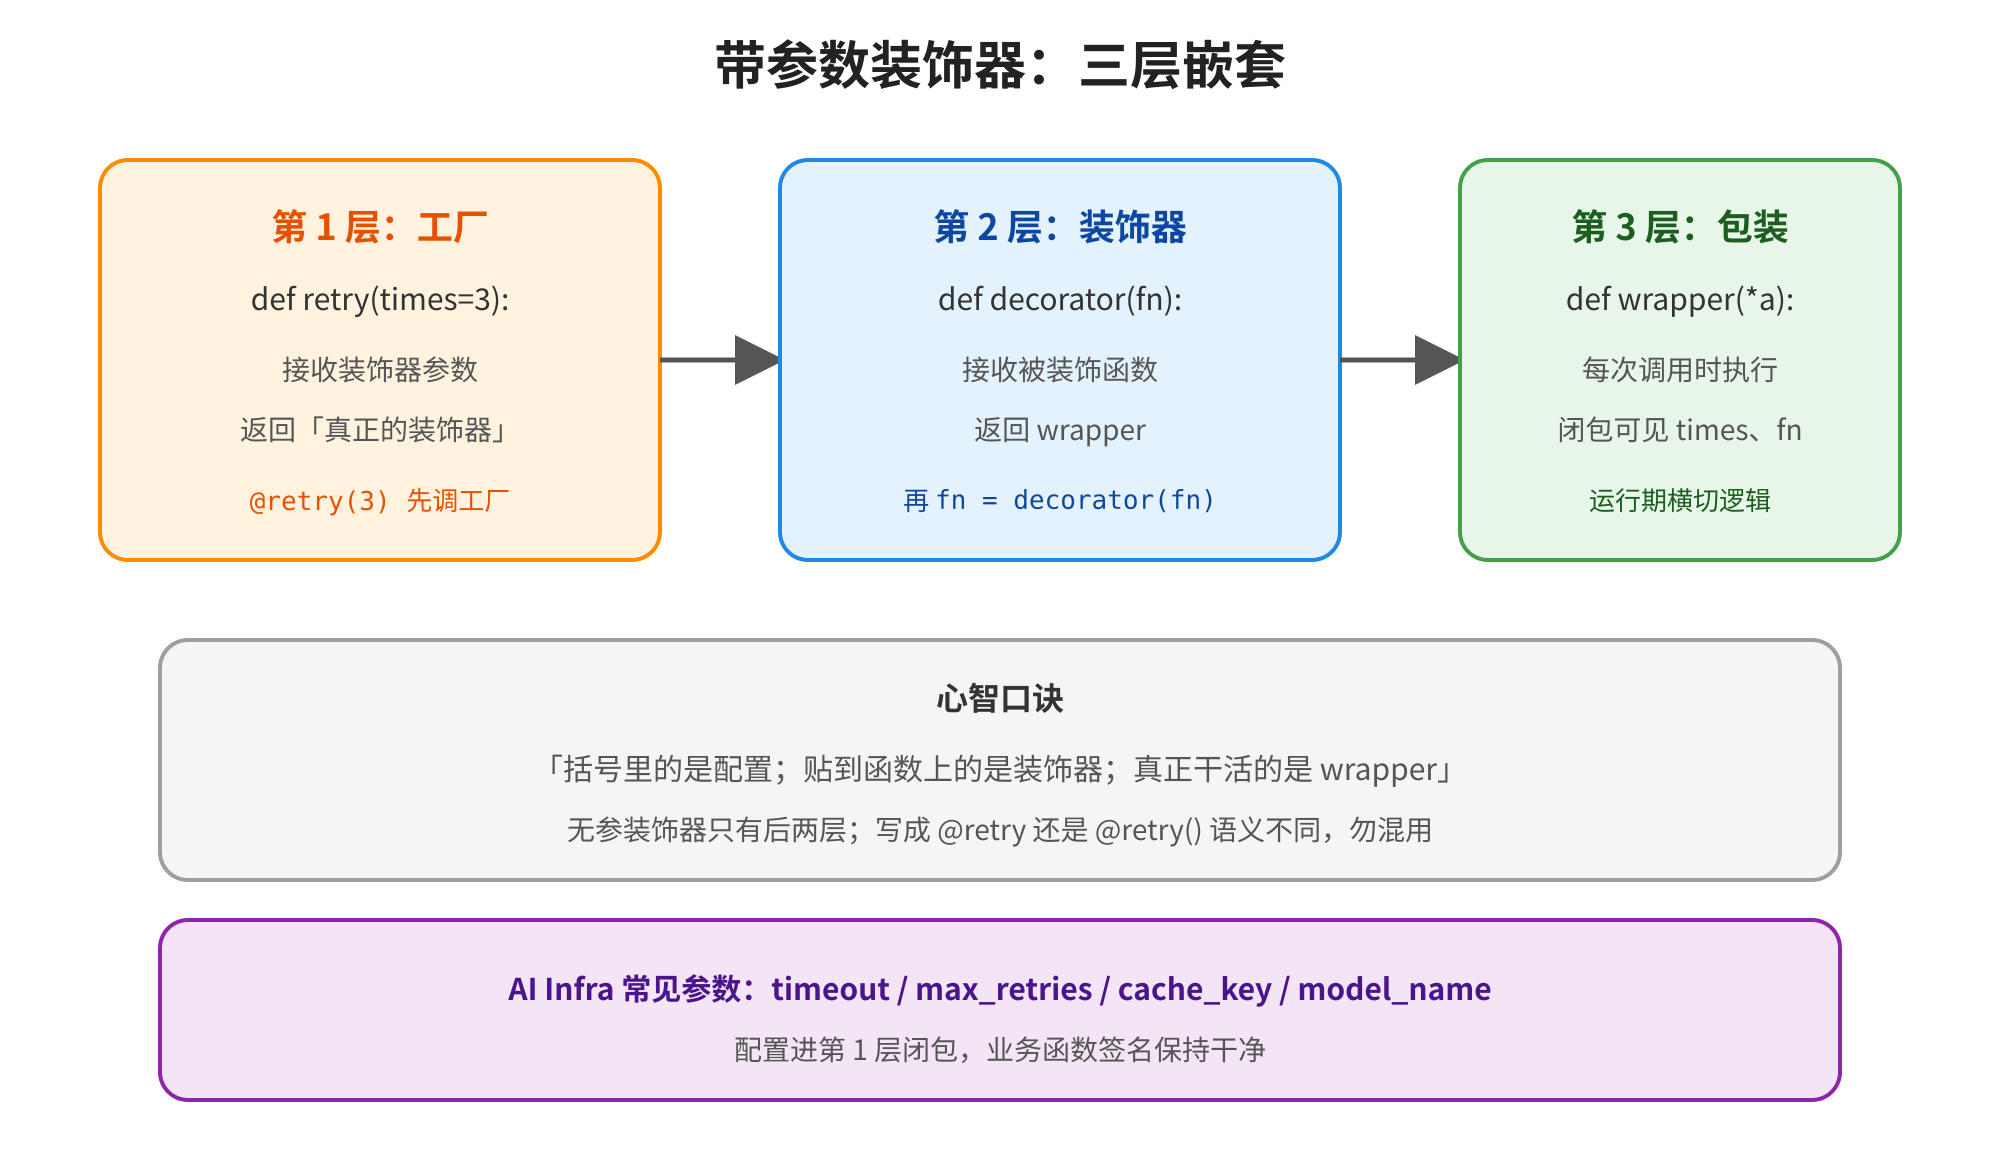
图3 带参数装饰器:三层嵌套
3.2 手写 @retry
import random
import time
from functools import wraps


def retry(times=3, delay=0.01, exceptions=(Exception,)):
    def decorator(fn):
        @wraps(fn)
        def wrapper(*args, **kwargs):
            last = None
            for attempt in range(1, times + 1):
                try:
                    return fn(*args, **kwargs)
                except exceptions as e:
                    last = e
                    print(f"{fn.__name__} attempt {attempt}/{times} failed: {e}")
                    if attempt < times:
                        time.sleep(delay * (2 ** (attempt - 1)))
            raise last

        return wrapper

    return decorator


@retry(times=3, delay=0.01)
def flaky():
    if random.random() < 0.7:
        raise ConnectionError("upstream busy")
    return "ok"


# 多次运行可能成功或最终失败;下面演示结构即可
口诀:括号里的是配置;贴到函数上的是装饰器;真正每次调用干活的是 wrapper。
3.3 @retry 与 @retry() 不要混
def retry(times=3):
    def decorator(fn):
        @wraps(fn)
        def wrapper(*args, **kwargs):
            return fn(*args, **kwargs)

        return wrapper

    return decorator


# 正确:带括号 → 先工厂
@retry(3)
def a():
    return 1


# 错误示范:把「工厂」直接当装饰器
# @retry
# def b(): ...
# 此时 b 会变成 decorator 函数本身,而不是 wrapper!
若希望同时支持 @retry 与 @retry(3),需要检测第一个参数是否可调用——可以做,但可读性下降。入门阶段统一带括号的工厂风格更清晰。
3.4 配置进闭包,业务签名保持干净
from functools import wraps


def with_model(model_name: str):
    def decorator(fn):
        @wraps(fn)
        def wrapper(*args, **kwargs):
            kwargs.setdefault("model", model_name)
            return fn(*args, **kwargs)

        return wrapper

    return decorator


@with_model("mini-gpt")
def complete(prompt: str, model: str | None = None) -> str:
    return f"[{model}] {prompt}"


print(complete("hello"))
[mini-gpt] hello
这在调用大模型 API 时很常见:默认模型写在装饰器配置里,测试时仍可显式传入覆盖。
四、装饰方法、类与可调用对象
4.1 装饰实例方法:别丢 self
from functools import wraps


def logged(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        print(f"call {fn.__name__}")
        return fn(*args, **kwargs)

    return wrapper


class Agent:
    @logged
    def step(self, obs: str) -> str:
        return f"act:{obs}"


print(Agent().step("see"))
call step
act:see
包装器用 *args, **kwargs 时,self 只是第一个位置参数,一般无感。若你写成 wrapper(x) 只接一个参数,实例方法就会炸——再次强调透明转发。
4.2 staticmethod / classmethod / property 也是装饰器
它们是内置描述器,但用法同属 @ 家族:
class C:
    @staticmethod
    def ping():
        return "pong"

    @classmethod
    def name(cls):
        return cls.__name__

    @property
    def tip(self):
        return "read-only-ish"


print(C.ping(), C.name(), C().tip)
pong C read-only-ish
多个装饰器叠在方法上时,描述器相关的 @classmethod / @staticmethod 通常放在最上面(最外),否则绑定协议可能错乱。记一句:靠描述器协议的内置装饰器,优先当「最外层外套」。
4.3 类作为装饰器
若类实现了 init(self, fn) 与 call,实例就可以当包装器:
from functools import update_wrapper


class CountCalls:
    def __init__(self, fn):
        self.fn = fn
        self.n = 0
        update_wrapper(self, fn)

    def __call__(self, *args, **kwargs):
        self.n += 1
        return self.fn(*args, **kwargs)


@CountCalls
def inc(x):
    return x + 1


print(inc(1), inc(2), inc.n)
2 3 2
类装饰器适合「包装器需要可变状态」(计数、打开的连接等)。注意:装饰在实例方法上时,描述器行为更绕,入门可先用于模块级函数。
4.4 装饰类:注册与包装
REGISTRY = {}


def register(cls):
    REGISTRY[cls.__name__] = cls
    return cls  # 必须返回类,否则类名会变成 None


@register
class EchoTool:
    def run(self, text: str) -> str:
        return text


print(list(REGISTRY))
['EchoTool']
这在插件系统、模型注册表里很常见:定义类的同时完成登记。返回值很重要——若忘记 return cls,类名绑定成 None,后面全崩。
五、装饰器栈与标准库刀具
5.1 多层 @ 的顺序
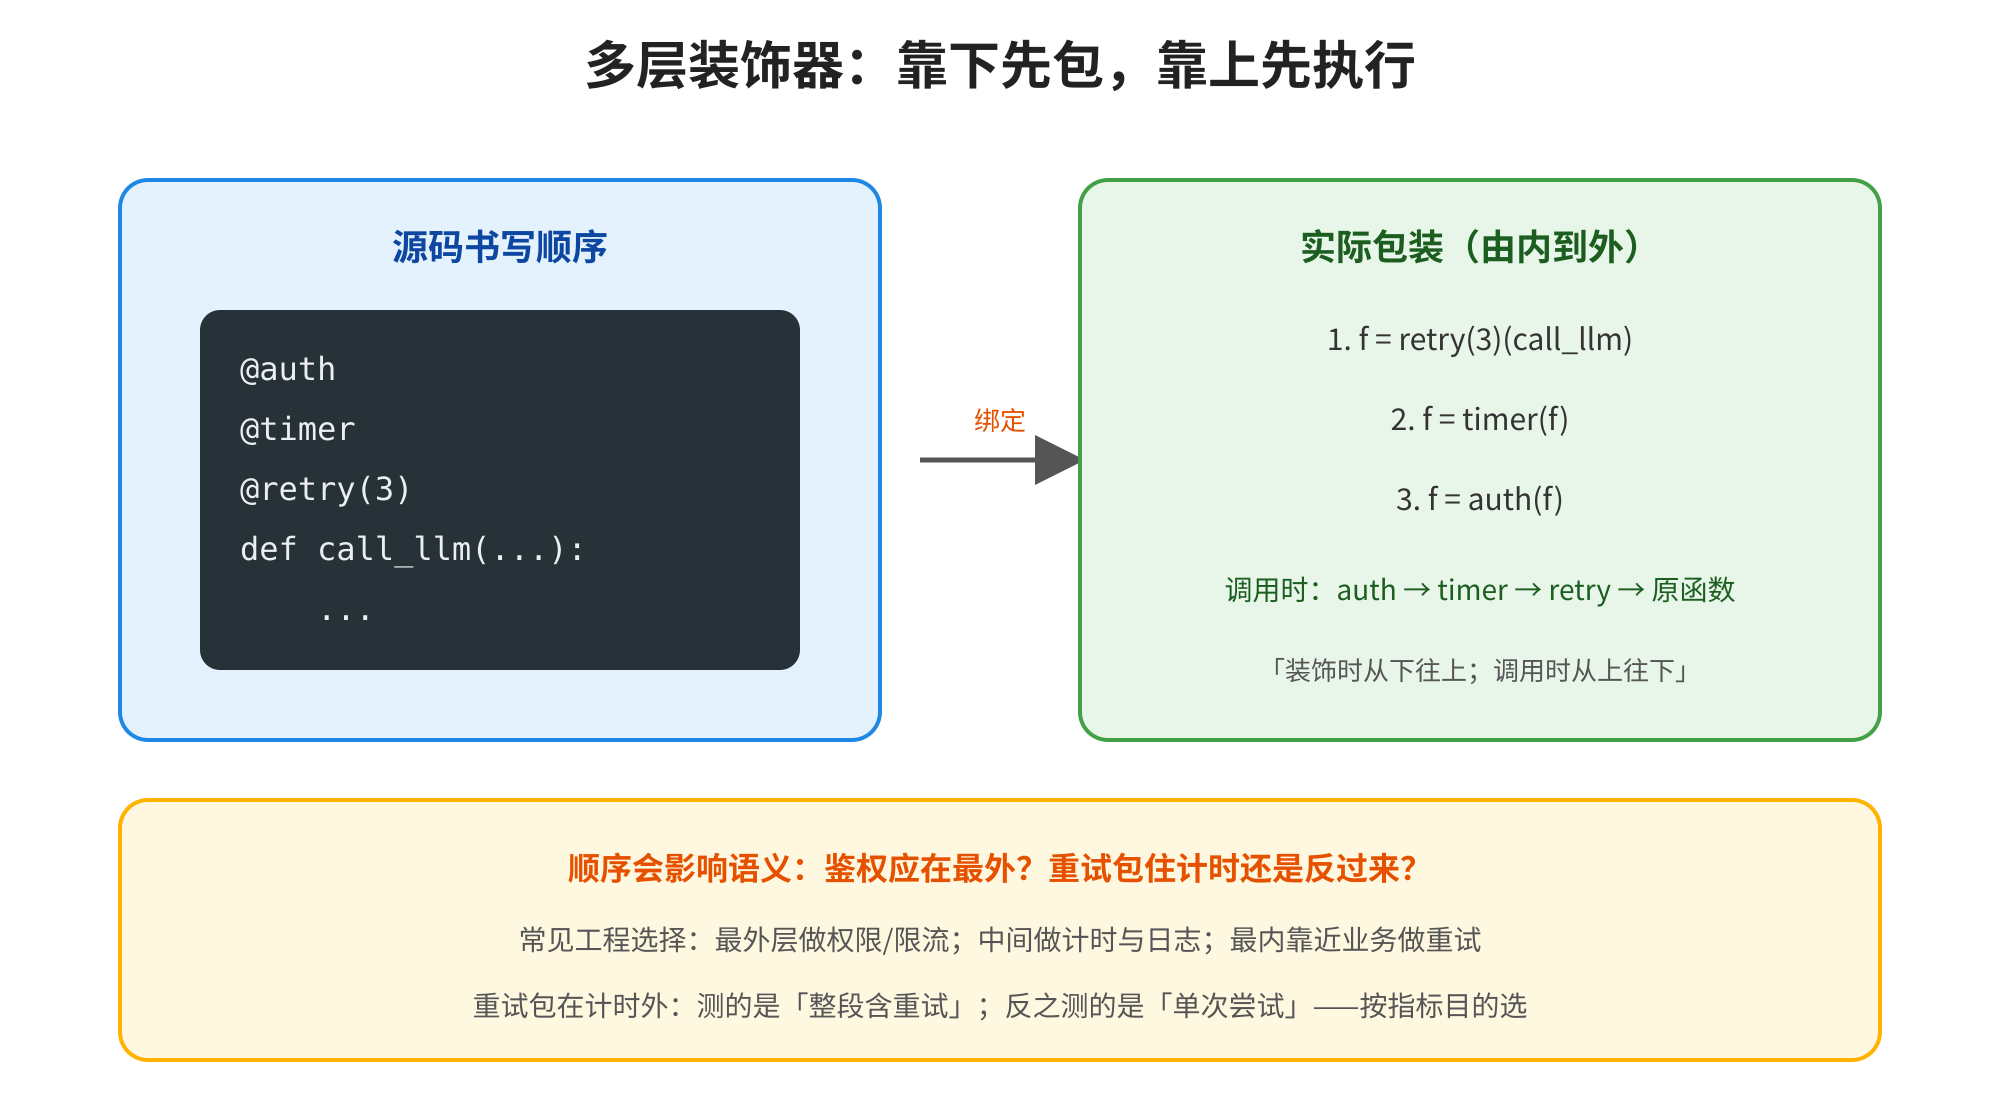
图4 多层装饰器:靠下先包,靠上先执行
from functools import wraps


def auth(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        print("auth")
        return fn(*args, **kwargs)

    return wrapper


def timer(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        print("timer-in")
        result = fn(*args, **kwargs)
        print("timer-out")
        return result

    return wrapper


def retry(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        print("retry")
        return fn(*args, **kwargs)

    return wrapper


@auth
@timer
@retry
def call_llm(prompt: str) -> str:
    print("business", prompt)
    return "ok"


call_llm("hi")
auth
timer-in
retry
business hi
timer-out
ok
绑定过程(由内到外):
call_llm = retry(call_llm)call_llm = timer(call_llm)call_llm = auth(call_llm)
调用时从上往下进入,从下往上返回。口诀:装饰时从下往上包;调用时从上往下穿。
工程上如何选顺序?常见经验:
- 最外:鉴权、限流、入口日志(先决定「能不能进」);
- 中间:计时、指标、结构化日志;
- 最内靠近业务:重试、缓存(策略紧贴真正的副作用)。
「计时包住重试」测的是单次尝试;「重试包住计时」测的是整段含重试——按你的 SLI 含义选择。
5.2 functools.lru_cache
from functools import lru_cache


@lru_cache(maxsize=128)
def embed_len(text: str) -> int:
    print("compute", text)
    return len(text)


print(embed_len("hi"), embed_len("hi"), embed_len("agent"))
print(embed_len.cache_info())
compute hi
2 2 compute agent
5
CacheInfo(hits=1, misses=2, maxsize=128, currsize=2)
参数必须可哈希(hashable)。列表、字典不能直接当键——可先变成元组 / frozenset,或自己实现缓存键函数。第 19 篇还会把 functools 与 itertools 放在一起加深。
5.3 functools.singledispatch
from functools import singledispatch


@singledispatch
def to_text(x) -> str:
    return str(x)


@to_text.register
def _(x: int) -> str:
    return f"int:{x}"


@to_text.register
def _(x: list) -> str:
    return "list:" + ",".join(map(str, x))


print(to_text(3), to_text([1, 2]), to_text(1.5))
int:3 list:1,2 1.5
这是「按类型分发」的轻量方案;复杂对象建模更常见的是类继承或协议。知道装饰器还能做分发表,读标准库不陌生即可。
5.4 装饰生成器函数(接第 15 篇)
from functools import wraps


def traced(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        print("start gen", fn.__name__)
        yield from fn(*args, **kwargs)
        print("end gen", fn.__name__)

    return wrapper


@traced
def events():
    yield "thought"
    yield "tool"
    yield "final"


print(list(events()))
start gen events
end gen events
['thought', 'tool', 'final']
若包装器里写成 return fn(*args, **kwargs) 而不 yield from,外层调用仍能得到生成器,但「进入/退出时打印」的时机会变——你可能只在创建生成器对象时触发 before,而看不到迭代结束。需要环绕整个迭代生命周期时,用生成器包装器(yield from)更贴切。
六、AI Infra / Agent 场景落地
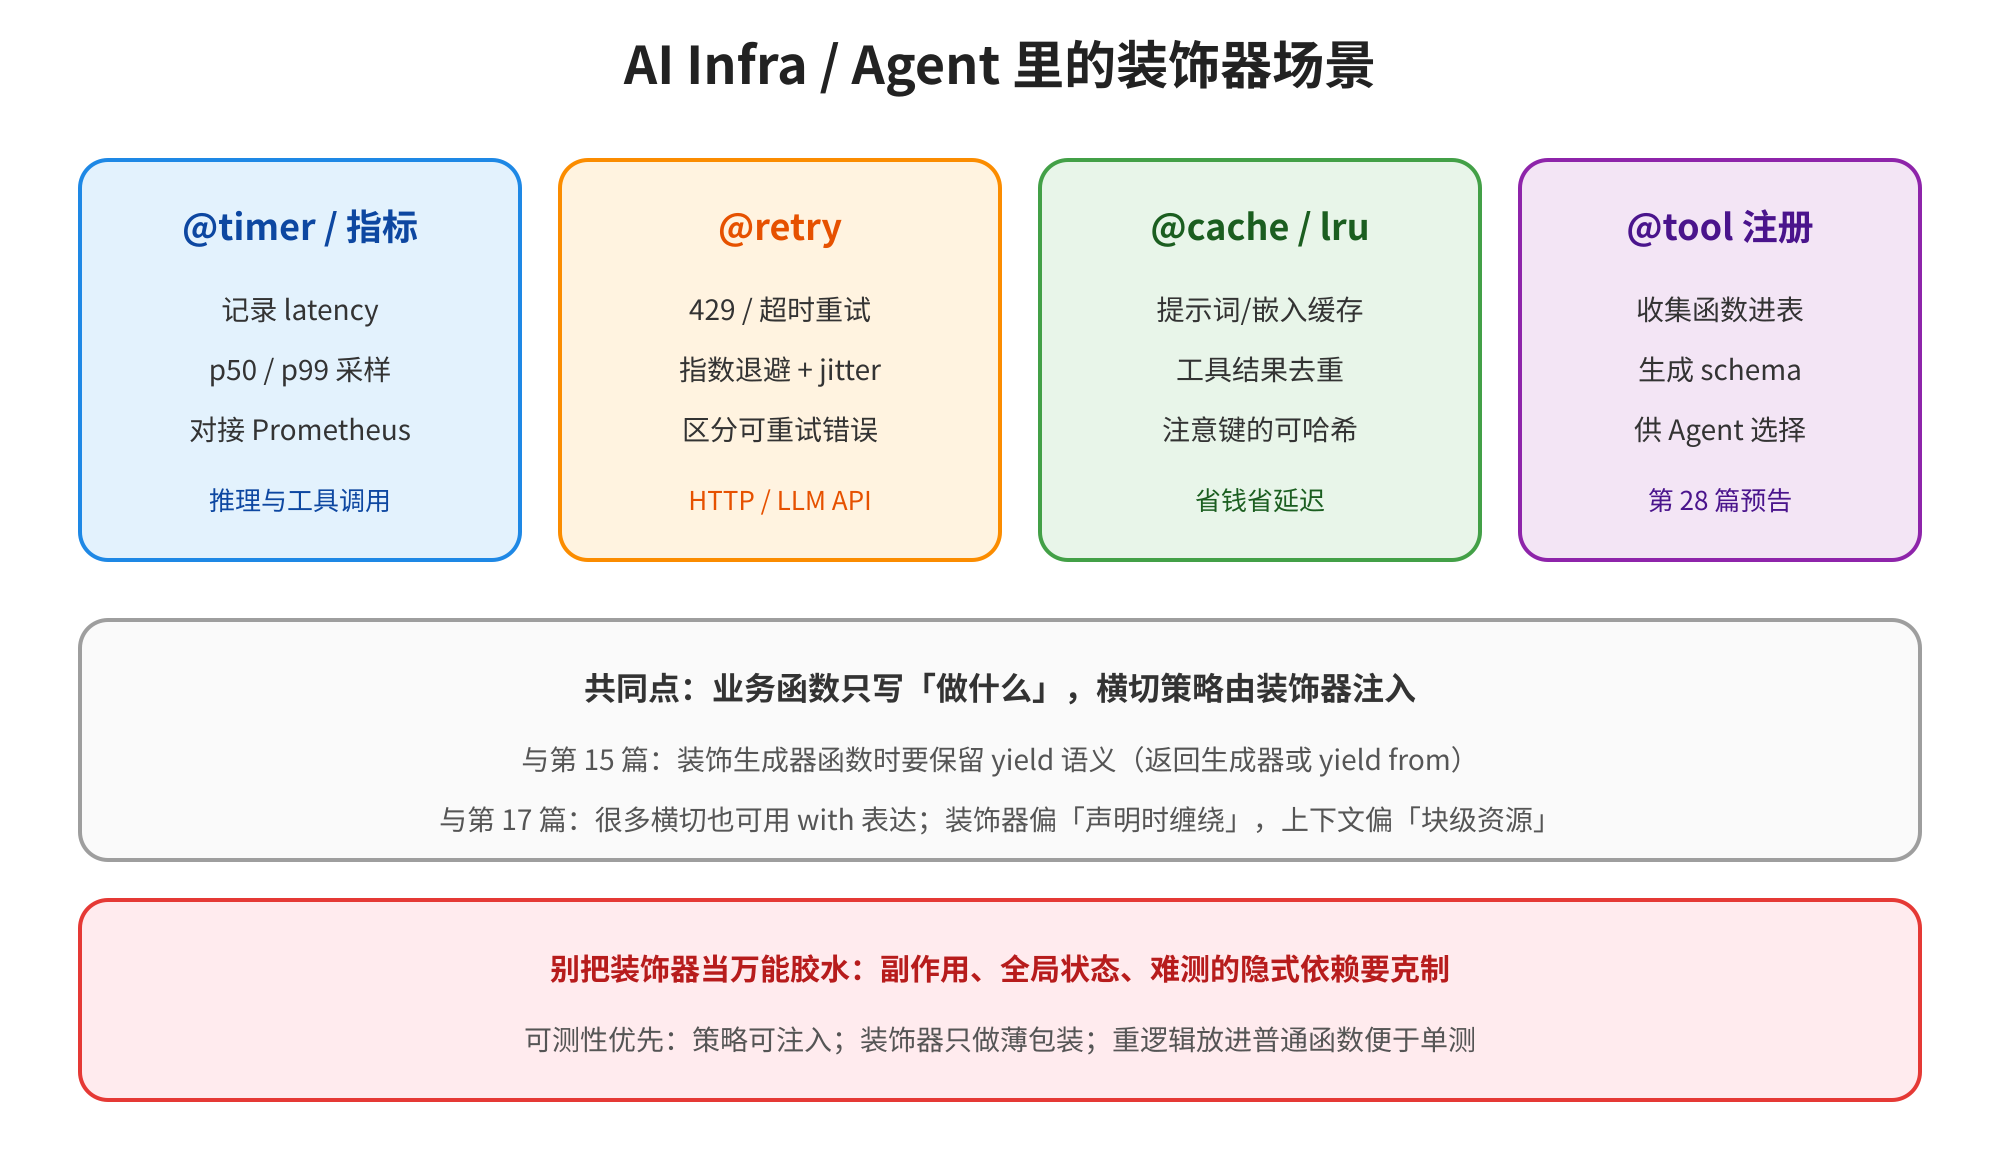
图5 AI Infra / Agent 里的装饰器场景
6.1 计时与简易指标
import time
from functools import wraps

_LATENCIES: list[float] = []


def track_latency(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        t0 = time.perf_counter()
        try:
            return fn(*args, **kwargs)
        finally:
            _LATENCIES.append(time.perf_counter() - t0)

    return wrapper


@track_latency
def infer(x: int) -> int:
    time.sleep(0.01)
    return x * 2


infer(1)
infer(2)
print(round(sum(_LATENCIES) / len(_LATENCIES), 4))
0.01xx
真实系统会把样本送进直方图或监控后端;装饰器负责「每次调用采一点」。
6.2 重试:区分可重试错误
from functools import wraps


class RateLimitError(Exception):
    pass


def retry_on_rate_limit(times=3):
    def decorator(fn):
        @wraps(fn)
        def wrapper(*args, **kwargs):
            for i in range(times):
                try:
                    return fn(*args, **kwargs)
                except RateLimitError:
                    if i == times - 1:
                        raise
                    print("backoff", i + 1)

        return wrapper

    return decorator
对连接超时、429 可重试;对 400 参数错误不要盲重试——否则只会放大账单与噪声。装饰器参数里传入 exceptions=(...),比写死 except Exception 更安全。
6.3 工具注册:最小 Agent 雏形
from functools import wraps

TOOLS = {}


def tool(name: str | None = None):
    def decorator(fn):
        key = name or fn.__name__
        TOOLS[key] = fn
        return wraps(fn)(fn) if False else fn  # 注册不改函数,原样返回

    return decorator


@tool()
def search(q: str) -> str:
    return f"result:{q}"


@tool(name="calc")
def add(a: int, b: int) -> int:
    return a + b


def agent_call(tool_name: str, **kwargs):
    return TOOLS[tool_name](**kwargs)


print(sorted(TOOLS), agent_call("search", q="python"), agent_call("calc", a=1, b=2))
['calc', 'search'] result:python 3
第 28 篇会把「模型选工具 → 执行 → 观察」做成循环;本篇先把注册这一刀用装饰器砍干净。注意:这里装饰器返回原函数即可,不一定非要再包一层——装饰器也可以只做副作用(登记)。
6.4 与 FastAPI / 路由的对照(预告)
# 伪代码心智模型,本篇不必安装 FastAPI
# @app.get("/health")
# def health():
#     return {"ok": True}
框架在装饰时把路径与函数放进路由表,请求来时再分发——与上面的 TOOLS 同构。学装饰器,是为了读这些框架时不再觉得 @ 是魔法。
6.5 可测性:薄包装、策略可注入
装饰器里塞满全局状态,单测会痛苦。更好的形状:
- 核心逻辑写成普通函数(易测);
- 装饰器只负责取配置、调核心、写副作用;
- 必要时允许依赖注入(把
clock、sleep、logger当参数或闭包配置传入)。
第 22 篇 pytest 会回到「如何测带装饰器的函数」:常测 wrapped,或测装饰后的公共行为。
也可以从「谁在什么时候运行」再钉一次钉子:工厂参数在装饰那一刻就求值并冻进闭包;包装器函数体在每次调用才执行。于是「默认模型名」「最大重试次数」适合当装饰器参数;「当前请求的 user_id」「本次 prompt」适合当运行时参数。把两者放错层,轻则难测,重则出现跨请求串数据的隐蔽 bug。
和类型注解(第 18 篇预告)的关系也值得提前知道:装饰器若丢了 annotations,静态检查与运行时校验(含 Pydantic)可能读不到原签名;wraps 会把注解一并拷回。写 API 层装饰器时,这不是细节,而是合同能否被工具链看见的问题。
最后用一张「决策小表」收束本节经验(不必背,用时查):
| 需求 | 更偏向 |
|---|---|
| 每次调用前后插一段 | 函数装饰器 |
| 给整段代码块管资源 | 上下文管理器(下篇) |
| 只在定义时登记元数据 | 返回原函数的注册装饰器 |
| 需要按类型分发 | singledispatch 或类多态 |
| 需要缓存纯函数结果 | lru_cache / 自研键 |
选错刀具也能凑合跑,但维护成本会在三个月后找上门——专栏二强调的正是「先选对协议,再写业务」。
七、踩坑大全
7.1 元数据与调试
坑 1:忘记 @wraps,name 全是 wrapper。 现象:日志、测试名、OpenAPI 文档里函数名错乱。解决:包装器定义处立刻 @wraps(fn);类包装器用 update_wrapper。
坑 2:多层装饰只 wraps 一层。 现象:最外层名字对了,中间层丢了。解决:每一层包装器都 wraps;需要原函数时沿 wrapped 解包。
7.2 参数化与调用方式
坑 3:@retry 与 @retry() 混用。 现象:函数变成「装饰器函数」或参数错位,调用即 TypeError。解决:团队统一风格;工厂装饰器一律写 @retry(...)。
坑 4:把装饰器参数写成可变默认值。 现象:def retry(blacklist=[]) 跨函数共享列表。解决:用 None + 函数内新建(第 07 篇老坑,装饰器工厂同样适用)。
7.3 方法与描述器
坑 5:包装器写死参数个数,装饰方法时丢掉 self。 现象:TypeError: missing 1 required positional argument。解决:统一 *args, **kwargs 转发。
坑 6:@classmethod 叠放顺序错误。 现象:拿到的不是绑定方法。解决:classmethod / staticmethod 放最外;先查官方建议再叠自定义装饰器。
7.4 缓存与生成器
坑 7:lru_cache 参数不可哈希。 现象:TypeError: unhashable type: 'list'。解决:转元组;或自写键函数;对 dict 参数要想清楚「内容变了缓存还算不算命中」。
坑 8:装饰生成器却用普通 return fn(...) 并期望 finally 在迭代结束时跑。 现象:资源释放时机不对。解决:需要环绕迭代生命周期就用 yield from 生成器包装器;或改用第 17 篇的上下文管理器管资源。
7.5 工程与 AI Infra
坑 9:在装饰器里盲目 except Exception 并吞掉。 现象:故障被隐藏,排障地狱。解决:窄捕获;记录后重新抛;区分可重试与不可重试。
坑 10:用装饰器堆出隐式全局依赖,导致难测难复用。 现象:单测要 import 副作用、改环境变量才能跑。解决:薄包装;策略注入;重逻辑放普通函数。Agent 工具注册可以有全局表,但执行逻辑保持纯、可测。
from functools import wraps


def always_wraps(fn):
    @wraps(fn)
    def wrapper(*args, **kwargs):
        return fn(*args, **kwargs)

    return wrapper


@always_wraps
def demo():
    """keep me"""
    return 1


print(demo.__name__, demo.__doc__)
demo keep me
(自检:养成 wraps 肌肉记忆。)
八、小结
合上文章后,试着用自己的话说明:@f 如何变成重新绑定,以及带参装饰器为何多一层工厂。讲得清,才算真的会了。动手至少跑通:@timer、@retry(times=3)、两者叠放、以及一个 @tool 注册表。
- 语法糖:
@decorator等价于定义后name = decorator(name);发生在定义时。 - 包装器:闭包冻住原函数与配置;用
*args, **kwargs透明转发;wraps复制元数据。 - 带参装饰器:工厂 → 装饰器 → 包装器三层;
@f(x)先调用工厂。 - 装饰器栈:靠下先包,靠上先进入;顺序影响鉴权 / 计时 / 重试的语义。
- 标准库:
lru_cache、singledispatch、wraps/update_wrapper是日常刀具。 - AI Infra:计时、重试、缓存、工具注册都是横切;与第 15 篇的生成器、第 17 篇的上下文常组合使用。
把故事连起来:第 08 篇闭包 → 本篇把闭包包装升级成声明式装饰器 → 下一篇用上下文管理器表达块级资源协议(with)。专栏二的工程刀具正在成套:流式(15)→ 横切(16)→ 资源(17)。
若只能带走一句话:装饰器就是「可调用 → 可调用」;@ 只是好看的重新绑定。
也可以用「三个不要」自检:不要忘 wraps;不要混 @f / @f();不要在包装器里吞光所有异常。
再留一个自测:画出三层带参装饰器;说出 @a @b def f 的绑定顺序与调用顺序;解释为何 lru_cache 要求参数可哈希——三问都顺,本篇就站稳了。
本篇技能会立刻复利:读 FastAPI 路由、看 Agent @tool、给推理函数加重试,都会先翻译成「定义时注册 / 调用时包装」。后续类型注解、测试、异步,都是在可装饰的函数面上继续加约束。
和专栏一串起来复习也不亏:函数参数(07)决定你怎么转发;闭包(08)实现包装;异常(11)决定捕获策略;数据模型与 call(14)让类也能当装饰器;迭代器(15)提醒装饰生成器要保语义——本篇是专栏二把「横切关注点」立成一等语法的一课。
也可以把收获压成检查清单:能把 @ 翻译成赋值;能手写 wraps 版 timer;能写 retry(times) 工厂;能解释装饰器栈顺序;能举一个工具注册或 API 重试的例子。五项过关,即可进入上下文管理器篇。
若把本篇压成给同事的三十秒讲解:先画「@ 等于赋值」;再画「带参多一层工厂」;最后强调「wraps 与栈顺序」。三张草图比贴一篇博客更管用。等对方能独立写出 @retry(3) 并解释打印顺序,就可以一起 code review 你们项目里的路由装饰器与工具注册了。
九、课后练习
- (基础) 实现
@timer,用time.perf_counter打印耗时;验证name在有/无wraps时的差异。 - (基础) 实现
@once:函数只真正执行第一次,后续调用返回缓存的首次结果(注意异常首次失败是否缓存——自行约定并写进文档弦)。 - (基础) 写
@retry(times=3),对一个「前两次抛ValueError、第三次成功」的函数验证。 - (理解) 叠放
@auth @timer @retry(可用 print 模拟),画出绑定顺序与一次成功调用的打印顺序。 - (理解) 用
@lru_cache(maxsize=32)缓存「字符串 → 大写」;再尝试传入list参数,解释报错原因并给出改法。 - (理解) 装饰一个生成器函数,要求在迭代开始与结束时各打印一行;对比
return fn(...)与yield from fn(...)的行为差异。 - (进阶) 实现
@tool(name=None)注册表;写call_tool(name, **kwargs);至少注册两个工具并调用。 - (进阶 · AI Infra) 为模拟
call_llm实现带指数退避的重试装饰器,仅捕获自定义RateLimitError;讨论:计时应包在重试内还是外,才能表示「用户可感知延迟」?
下一篇预告
下一篇是《第17篇|上下文管理器》——用 with 把「获取资源 → 使用 → 必定清理」收成协议:enter / exit、contextlib.contextmanager、可重入与组合。你会看到:装饰器偏声明时缠绕函数,上下文管理器偏块级生命周期;计时、加锁、临时改目录、打开会话,两种写法常常可以互相表达,但语义侧重点不同。
专栏二后续路线:上下文管理器 → 类型注解 / dataclass / Pydantic → 标准库精选(collections / itertools / functools)→ 虚拟环境与打包 → 日志调试性能 → pytest → 并发与 asyncio → HTTP / FastAPI → 最小 Agent。带着本篇的包装与栈直觉,读源码时先找 @ 与 with,再跟业务。
若想提前热身:把本篇的 @timer 改写成 with Timer(): ... 形式(手写类即可);再试 contextlib.contextmanager 用生成器写同一个计时器。做完后第 17 篇谈 exit 与异常抑制时你会带着具体对比感。
也可以把第 10 篇的 with open 与装饰器对照:都是「在某段逻辑前后插入行为」;一个管文件句柄生命周期,一个管函数调用横切。两者在「临时文件 + 重试下载」之类的任务里会并肩作战。
专栏一用十四篇把「对象与协议」立住;专栏二从迭代器(15)走到装饰器(16),下一站是资源协议。下一篇见。
若时间充裕,再多做一件事:打开你写过的脚本,找出三处复制粘贴的「打印耗时 / 失败重试 / 写日志」,改成装饰器或准备改成 with。改完后你会更笃定:专栏二不是要你背更多语法,而是把已经会的函数与闭包,接到真实工程的横切与资源边界上。
收官前对照练习:同一份「调用 LLM」逻辑,分别用手工包装、@retry+@timer、以及下一篇将学的 with 计时走一遍。你会清楚感受到:装饰器不是语法糖游戏,而是把自定义策略抬到与框架路由 / 工具注册同一套操作面的关键一步——也是专栏二工程化与框架对接的入场券之一。