
Transformer 注意力机制:从点积到多头计算
解密 Transformer 的核心——注意力机制
🏂
如果你想真正搞懂 Transformer 是怎么工作的,那就必须越过一座大山:注意力机制(Attention)。可以说,理解了 Attention,就懂了 Transformer 的灵魂。
今天这份讲义,我们就把这个看似高深的概念,从最基础的数学运算,一直推导到最终的“多头注意力”(Multi-Head Attention)。为了不讲空话,我们将贯穿一个具体的例子:“我 喜欢 程序喵”🤣,带着具体的数字,手把手推演一遍公式是怎么生效的。
第一部分:用最简单的数学,搭起大厦的基石
在正式聊 Attention 之前,我们得先统一下“语言”。在深度学习里,一切皆为数字。
- 向量:简单来说,向量就是一行数字,没啥特别的,高中咱们也学过。在AI infra的语境中,你可以把它想象成描述一个词语特征的“数值档案”。 所谓的“维度”,其实就是这个档案里有几个指标。3 维向量就是 3 个数,64 维就是 64 个数:
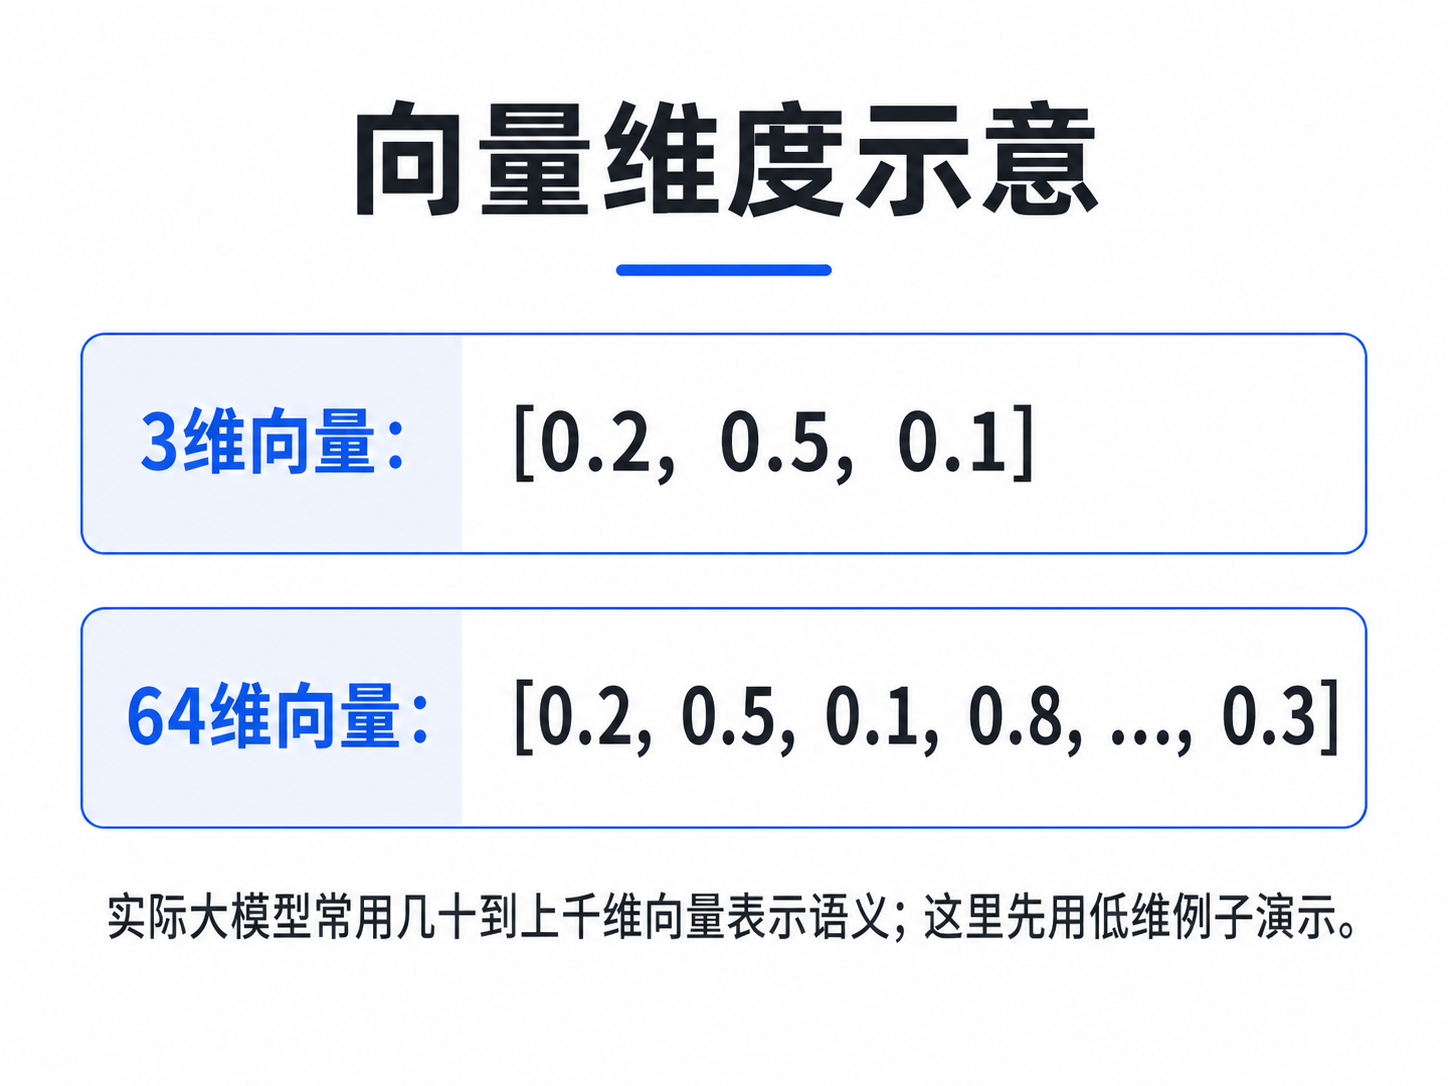
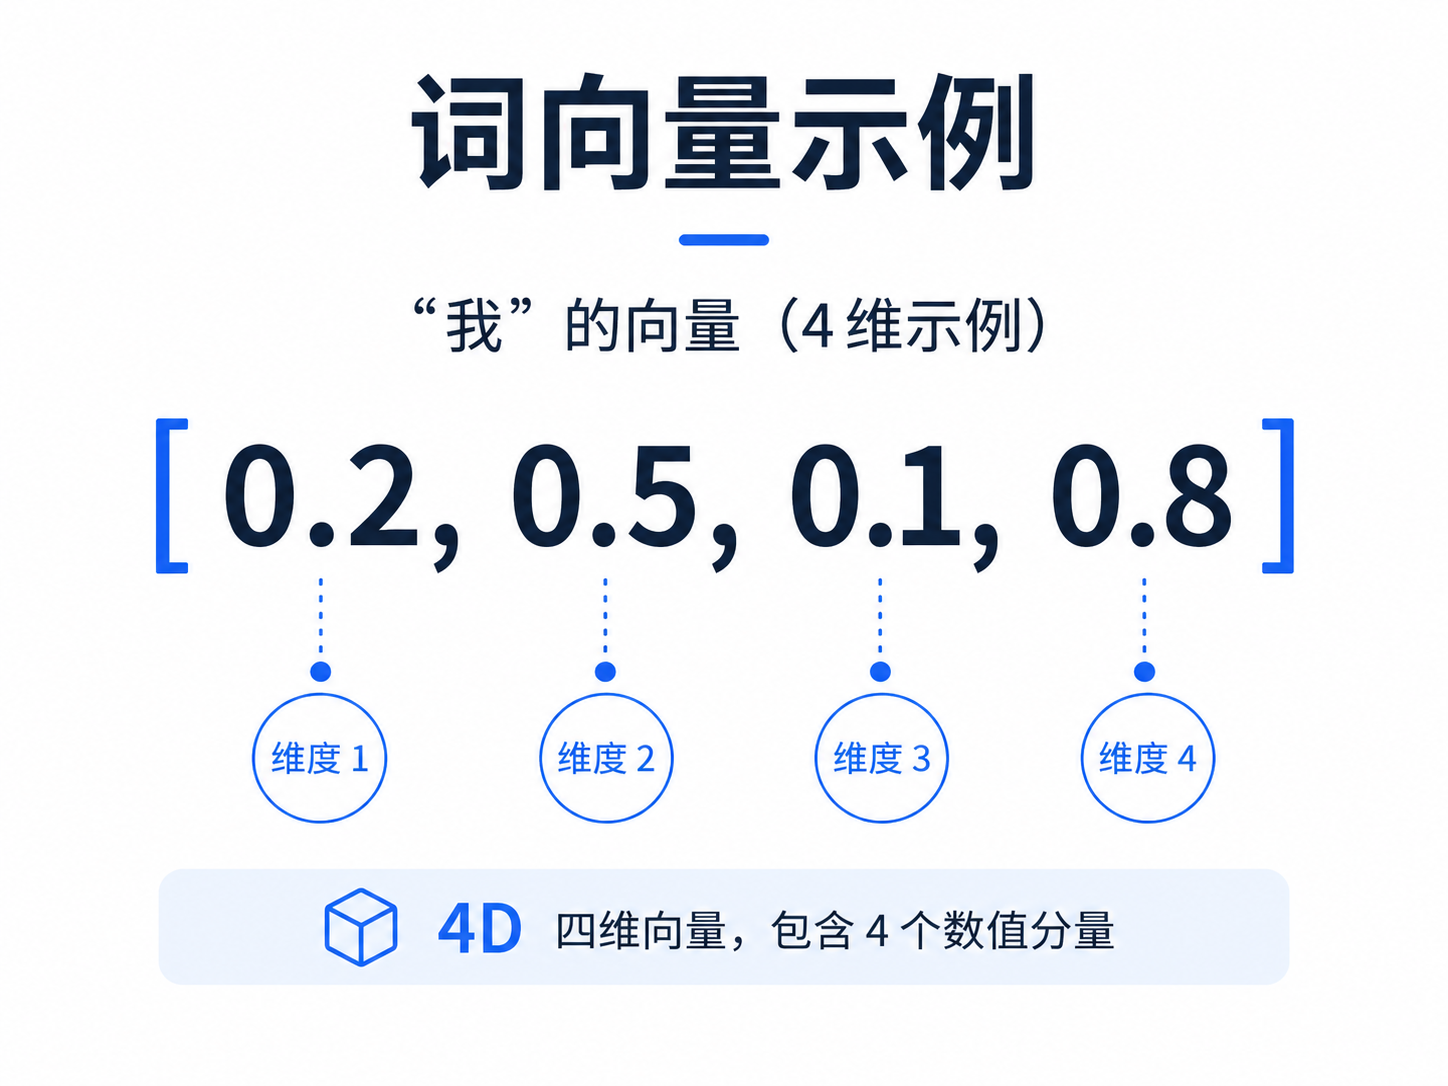
- 在实际的大模型里,往往会用几百上千维的向量来精准刻画一个词的多种含义。在今天的讲义里,为了方便大家手算,我们主要会用 3 维和 4 维的短向量来演示:
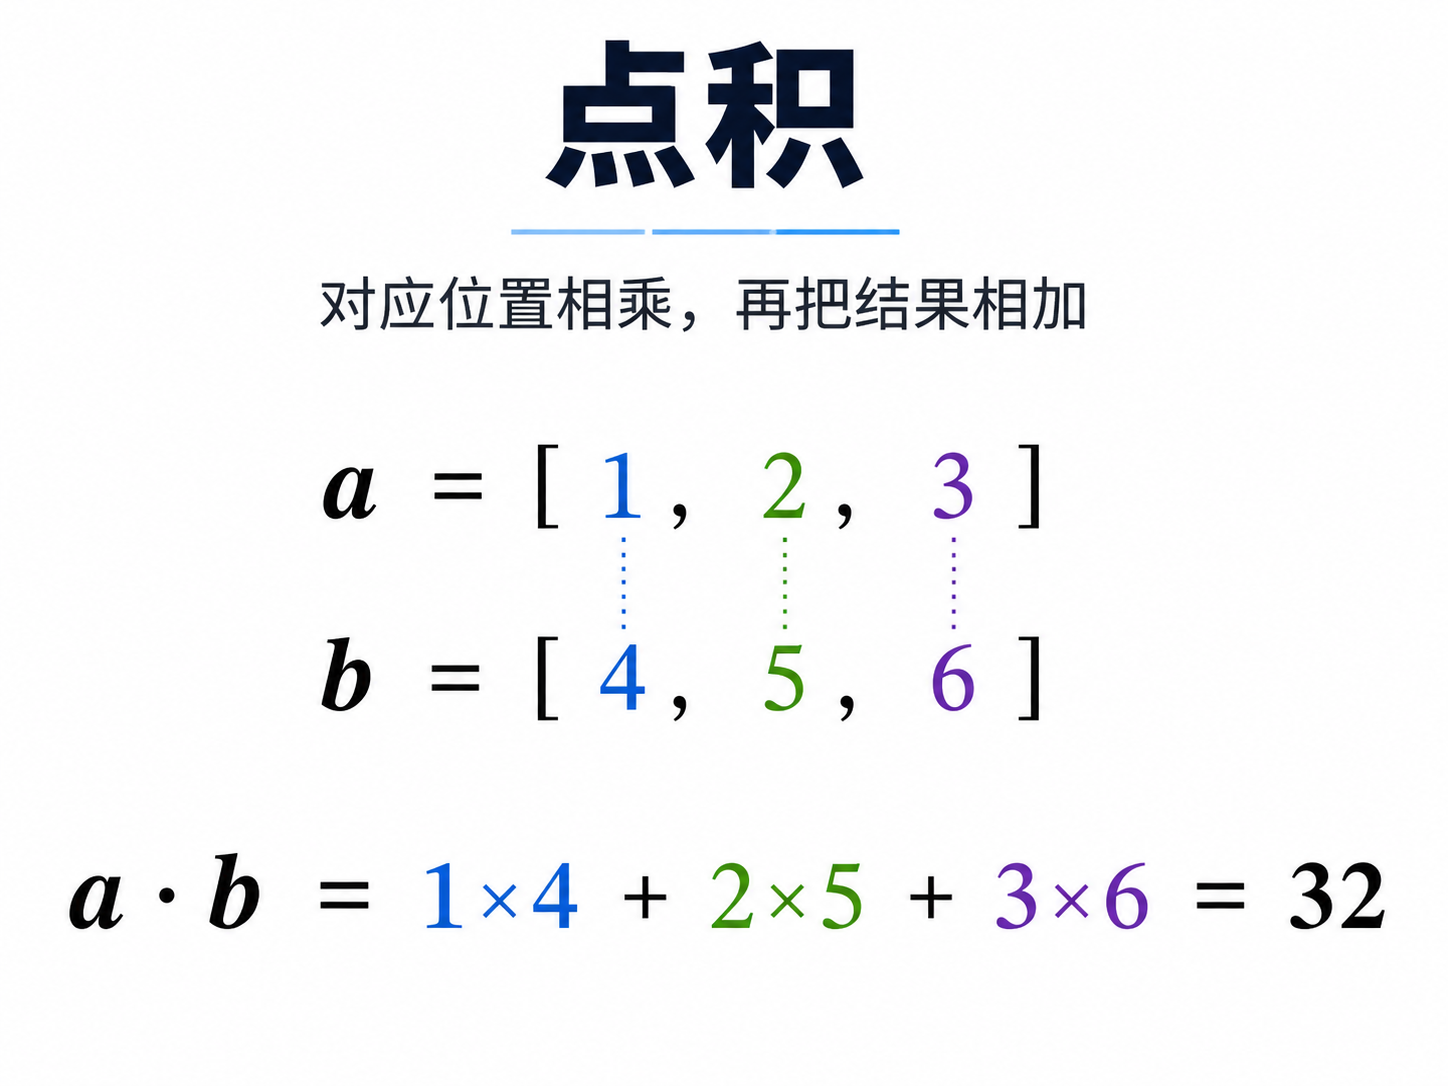
- 点积:如果给你两个向量,让你衡量它们到底有多相似,最直接的办法就是算点积(对应位置相乘再相加)。点积结果越大,说明这两个向量在方向上越一致,越“相关”。
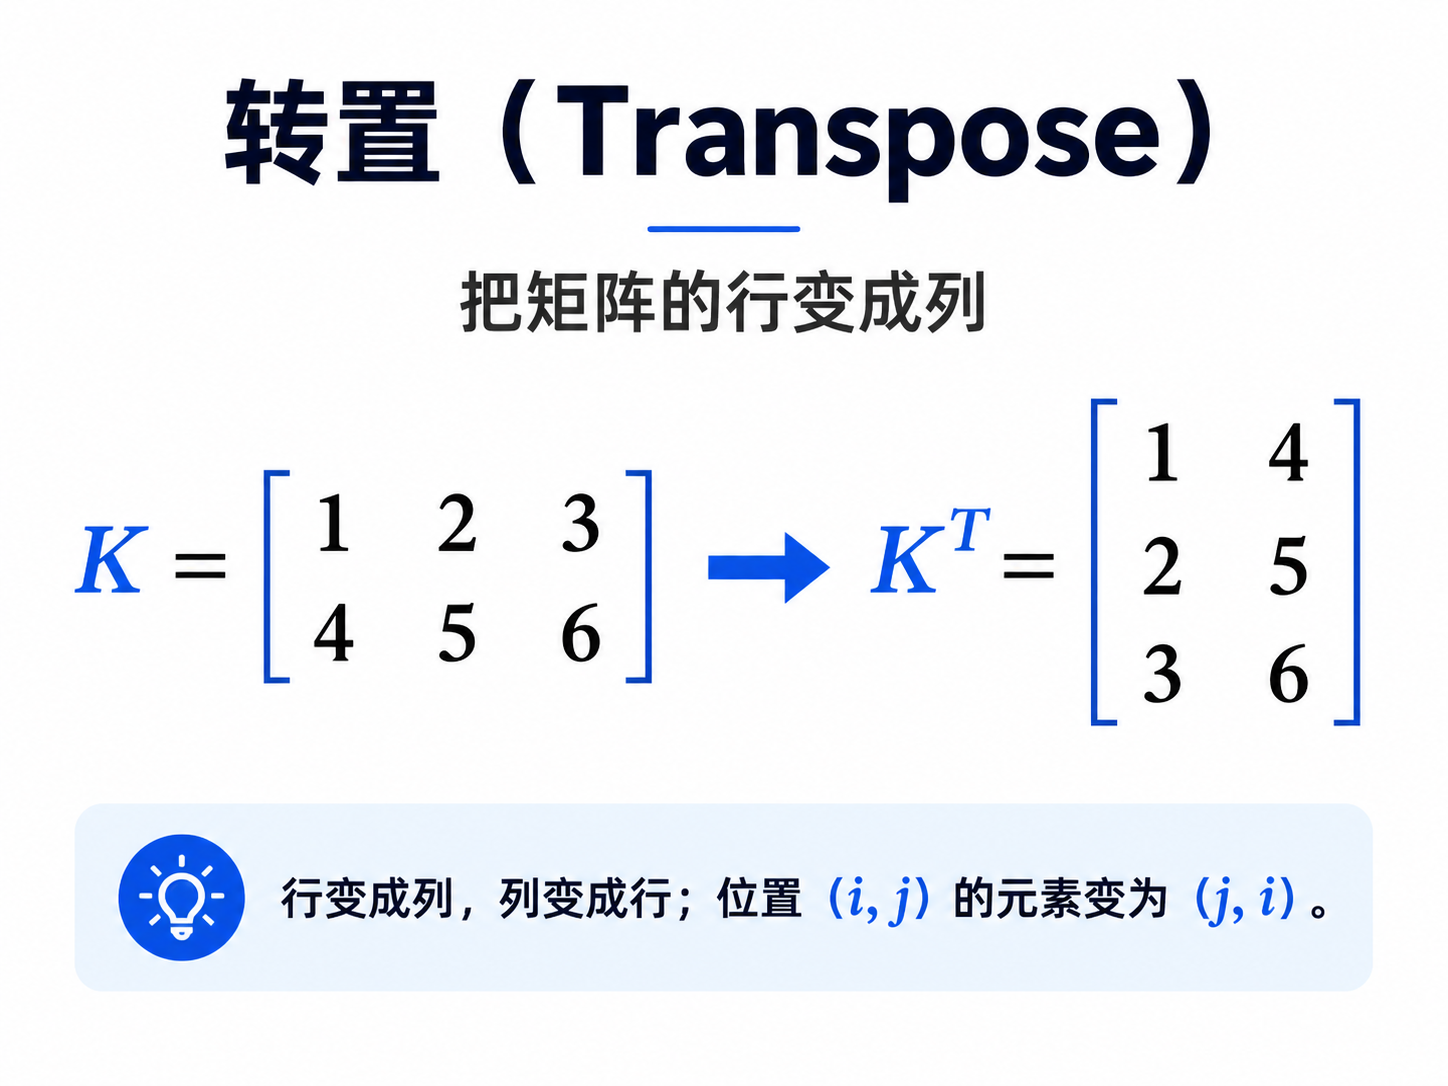
- 转置 (Transpose):把矩阵的行变成列。这往往是为了让矩阵乘法在维度上能顺利“咬合”。
好,基础有了哈。现在我们进入正题!
第二部分:缩放点积注意力(Scaled Dot-Product Attention)
这就是大名鼎鼎的单头注意力(来自 Attention is all you need这篇论文),它的完整公式只有这一行:
Wtf man...看起来有点吓人?别怕,我们拿“我 喜欢 程序喵”这三个词,分四步把它拆开看。
在 Attention 的世界里,每个词都会分身出三个身份:
- Q (Query):这是查询条件——“我想找什么信息?”
- K (Key):这是自我介绍——“我能提供什么特征?”
- V (Value):这是核心底牌——“我实际携带的内容是什么?”
假设这三个词原本有自己的词向量,经过与模型里的权重矩阵()相乘后,变成了维度 的 $Q、K、V $矩阵(矩阵里的每一行代表一个词):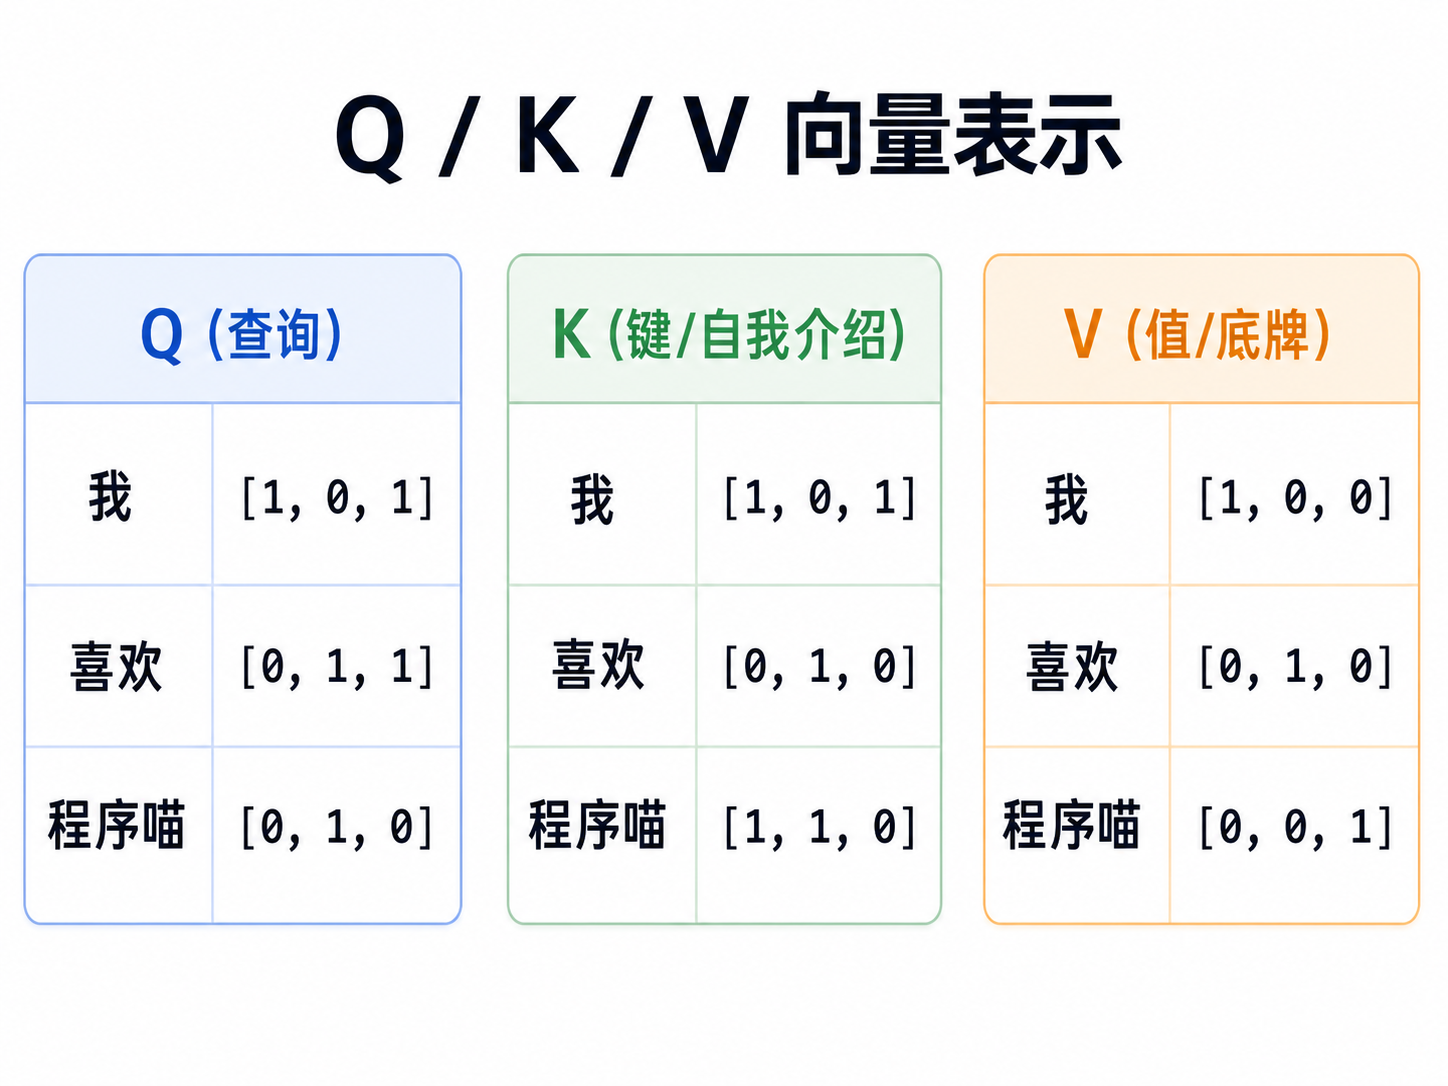
现在,见证奇迹的时刻开始了。
步骤 1:找相关性
我们让所有词的 Query,去跟句子里所有词的 Key 进行“匹配”。匹配的方式就是矩阵相乘。
为了能乘起来,我们先做个转置: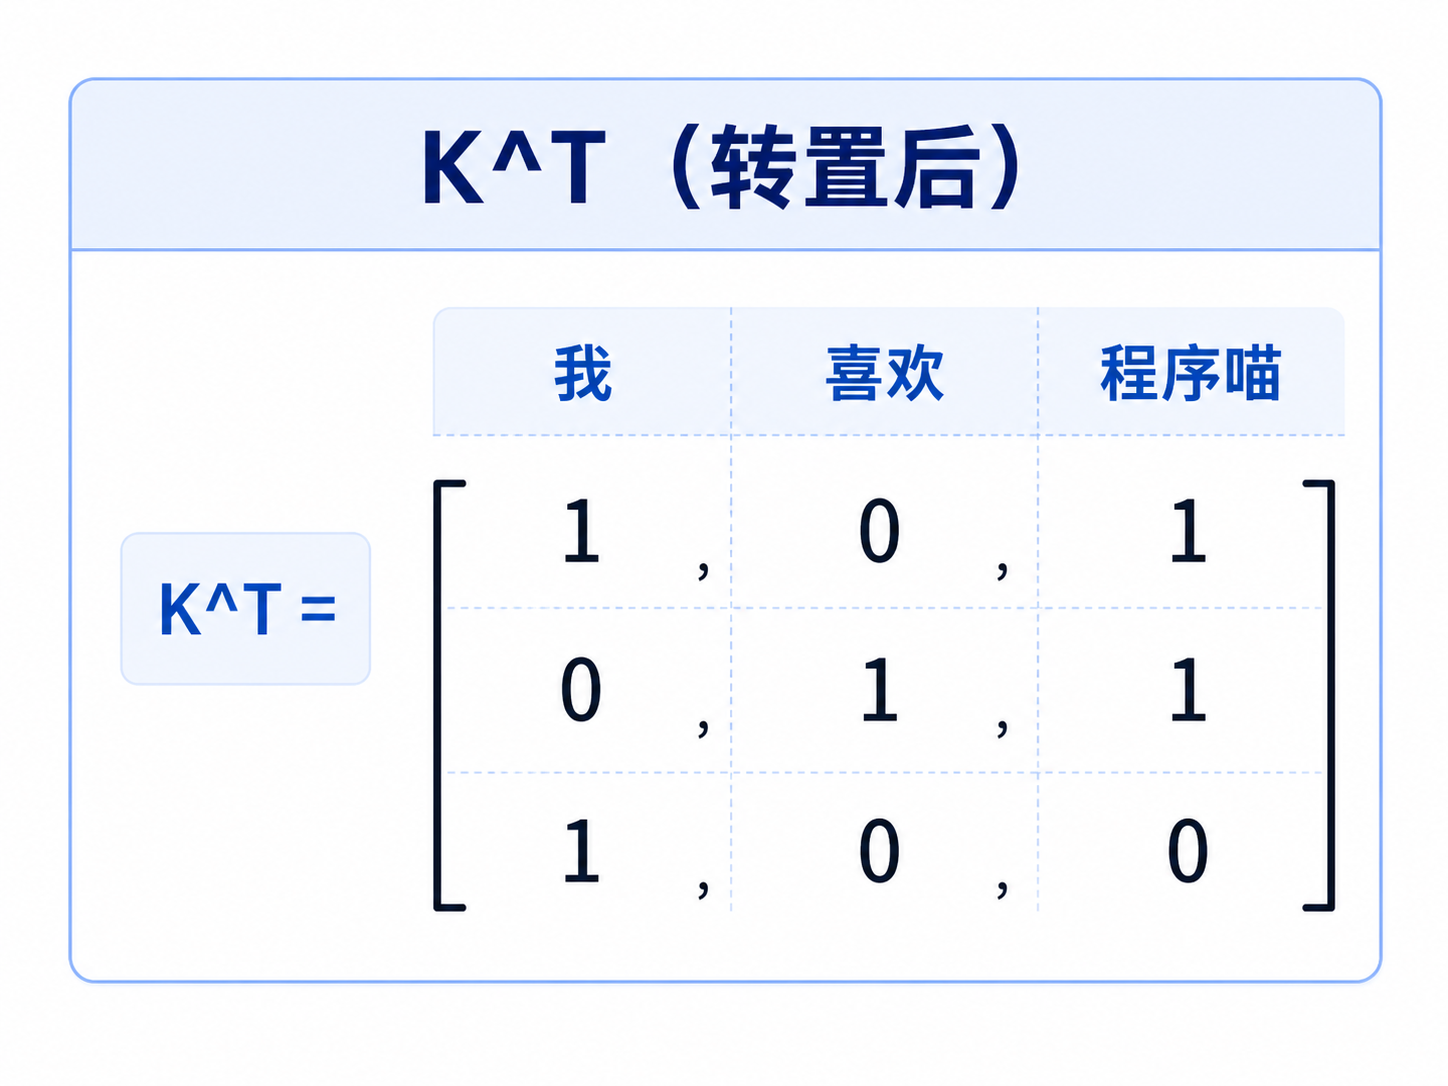
然后计算 相当于两两计算点积):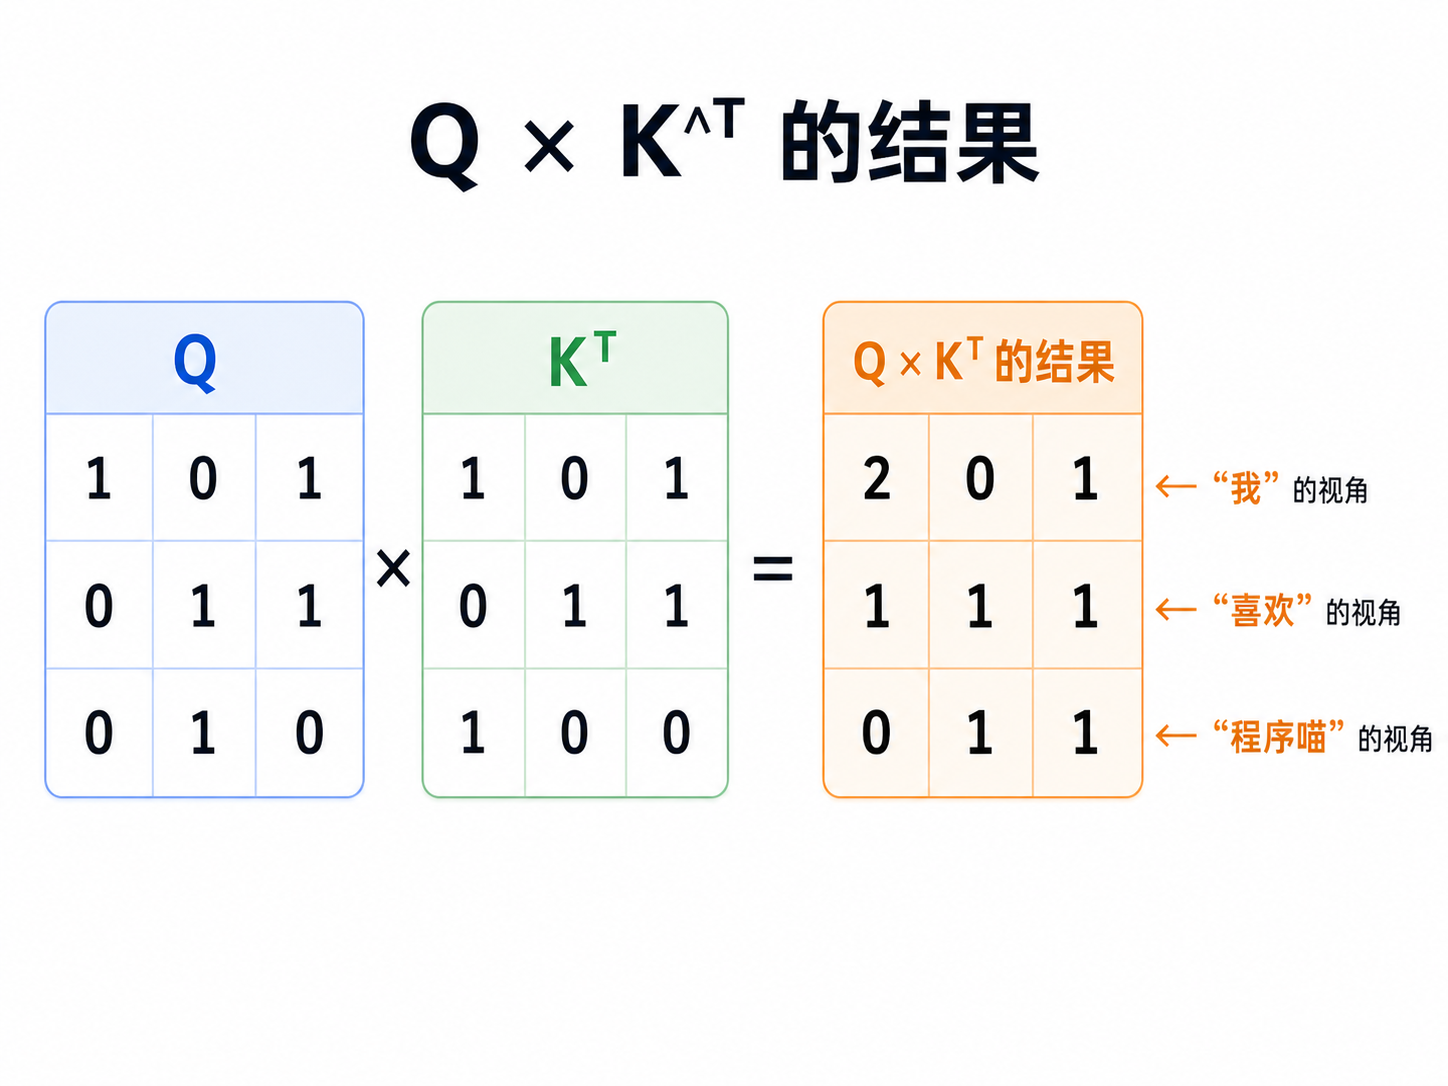
敲黑板:看结果矩阵的第一行
[2, 0, 1]。这代表从“我”的视角出发:
- “我” 匹配 “我”([1,0,1] · [1,0,1]),得分是:1×1 + 0×0 + 1×1 = 2
- “我” 匹配 “喜欢”([1,0,1] · [0,1,0]),得分是:1×0 + 0×1 + 1×0 = 0
- “我” 匹配 “程序喵”([1,0,1] · [1,1,0]),得分是:1×1 + 0×1 + 1×0 = 1
这就是“注意力”的雏形:“我”最关注自己(2分),其次是“程序喵”(1分),对“喜欢”毫无兴趣(0分)。
步骤 2:防爆雷 (除以 )
实际应用中,往往很大(如64维)。维度高了,算出来的点积总和就会大得离谱。这会导致后续算概率时,模型变得非常极端(只关注最高分的词,其他全是0),也就是陷入所谓的“梯度消失”。
我们的维度 是 3。为了给分数降温,我们sqrt(3)≈1.733≈1.73。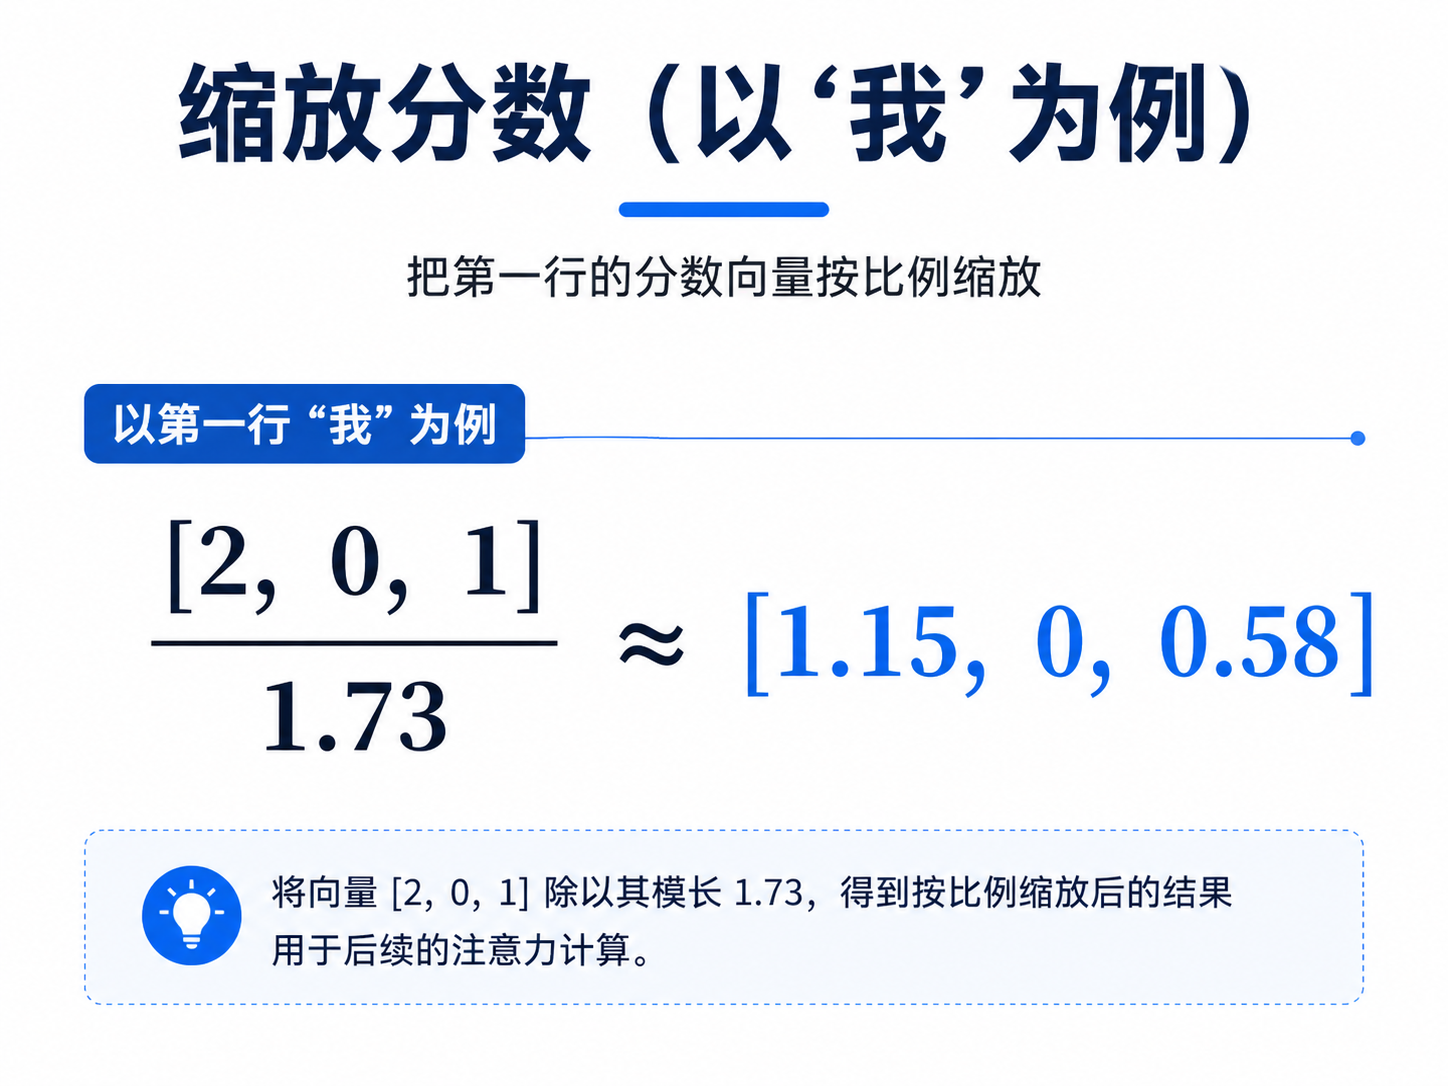
你看,成绩分布变得平缓了。
步骤 3:算权重 (Softmax)
现在的分数还是原始数值。为了方便组合,我们要把它们转换成加起来等于 1 的概率权重。 用 Softmax 公式:
我们继续拿“我”这一行 [1.15, 0, 0.58] 来算: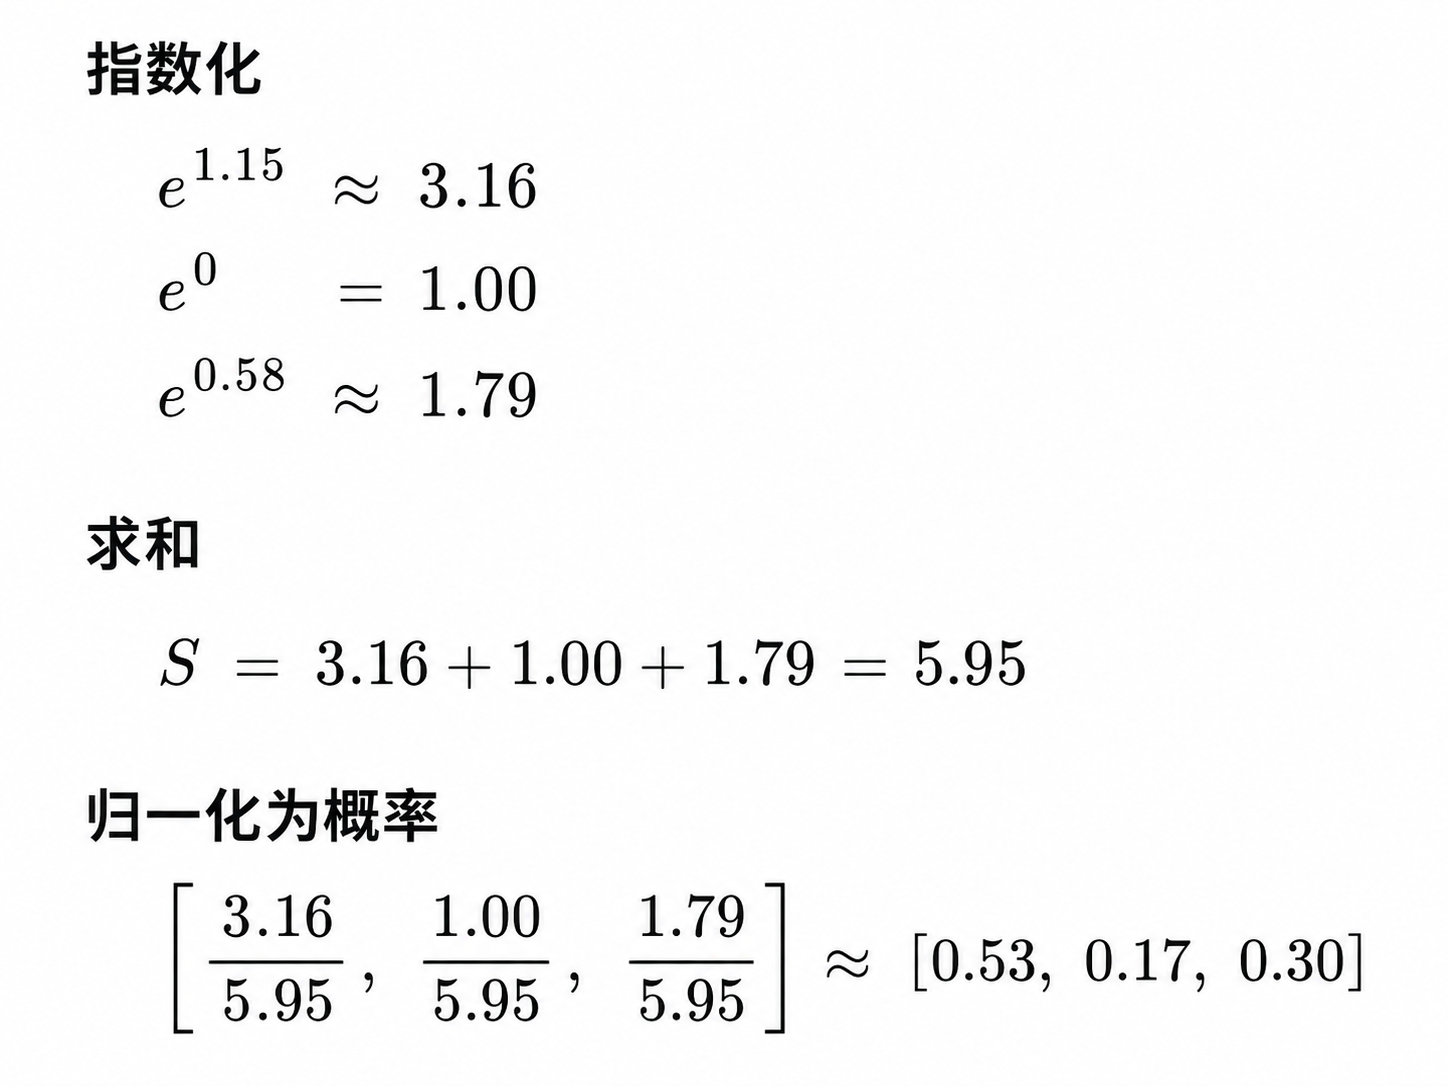
现在,注意力变成了一个严谨的概率分布:关注“我”占 53%,关注“喜欢”占 17%,关注“程序喵”占 30%。
步骤 4:做融合 (乘以 V)
拿到了百分比权重,最后一步就是收割! 我们用这组权重,去按比例混合这三个词的 Value(底牌)。
回顾前面的 V 矩阵: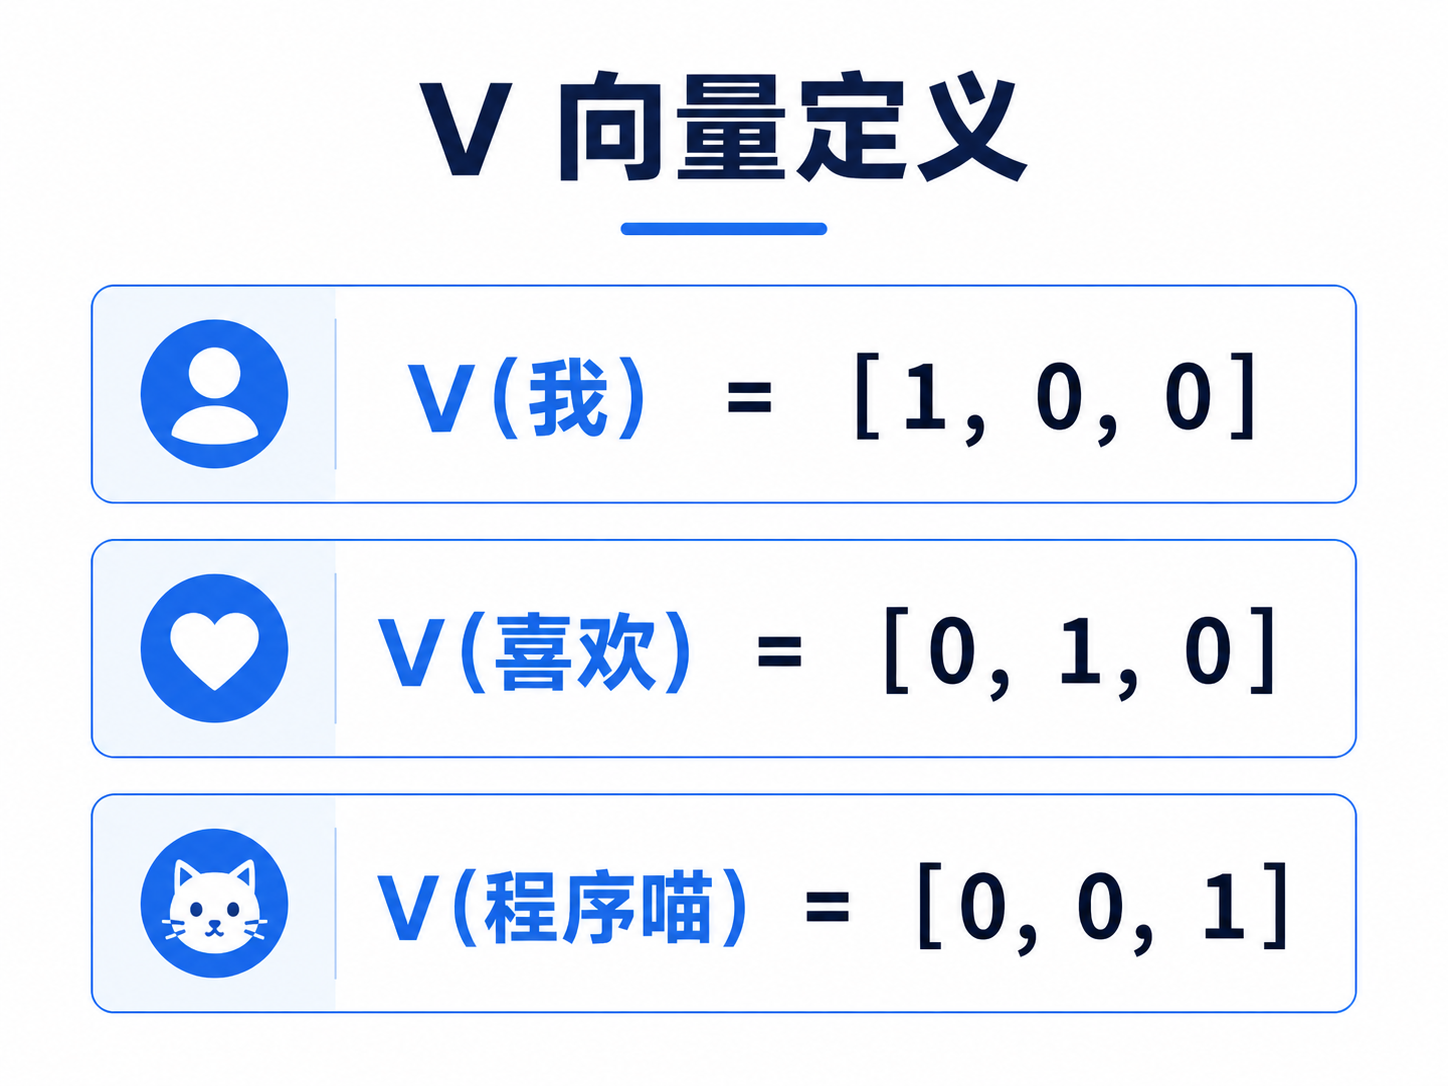
计算融合后的新的“我”: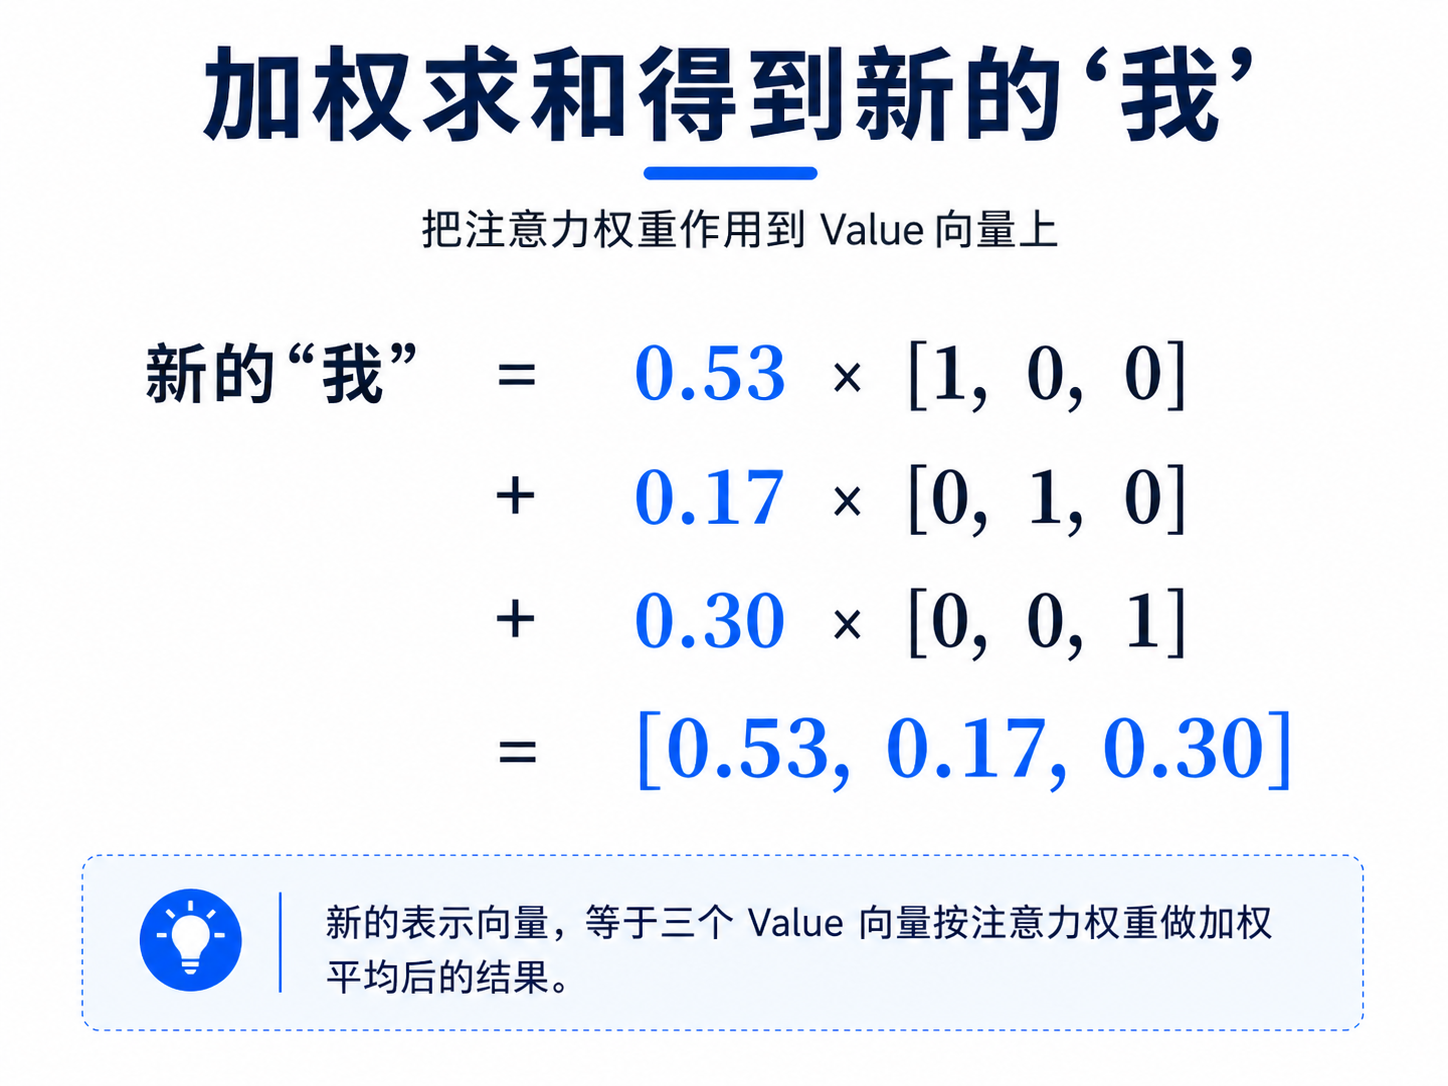
仔细看这个结果!输出的“新的‘我’”,已经不再是刚开始那个孤立的 [1, 0, 0] 了。它吸收了 30% “程序喵”的信息和 17% “喜欢”的信息。
这就是 Self-Attention(自注意力机制) 的真谛:每个词都打量了一遍全场,算出了自己对大家的关心程度,然后把觉得重要的信息融合进了自己体内。
第三部分:进化为“多头”(Multi-Head Attention)
既然单头注意力已经很完美了,为什么还要搞个“多头”?
道理很简单:单头注意力有点“一根筋”。 在上面的例子中,算了一圈,“我”主要关注了自己和“程序喵”(主宾关系)。但语言是很复杂的,“我”和“喜欢”难道就没有语法关系(主谓)了吗? 我们希望模型能“眼观六路,耳听八方”,同时从不同的角度(如语法、情感、指代等)去捕捉关系。
这就是多头的动机:拆分视角,各司其职。
具体怎么做呢?拿一个 4 维的特征举例,它并没有成倍地增加计算资源:
1. 先切分 (Split)
我们不额外增加庞大的矩阵,而是把每个词原始的、较长的 Q、K、V 像切香肠一样切开。 假设原本“我”的 Query 是 4 维的: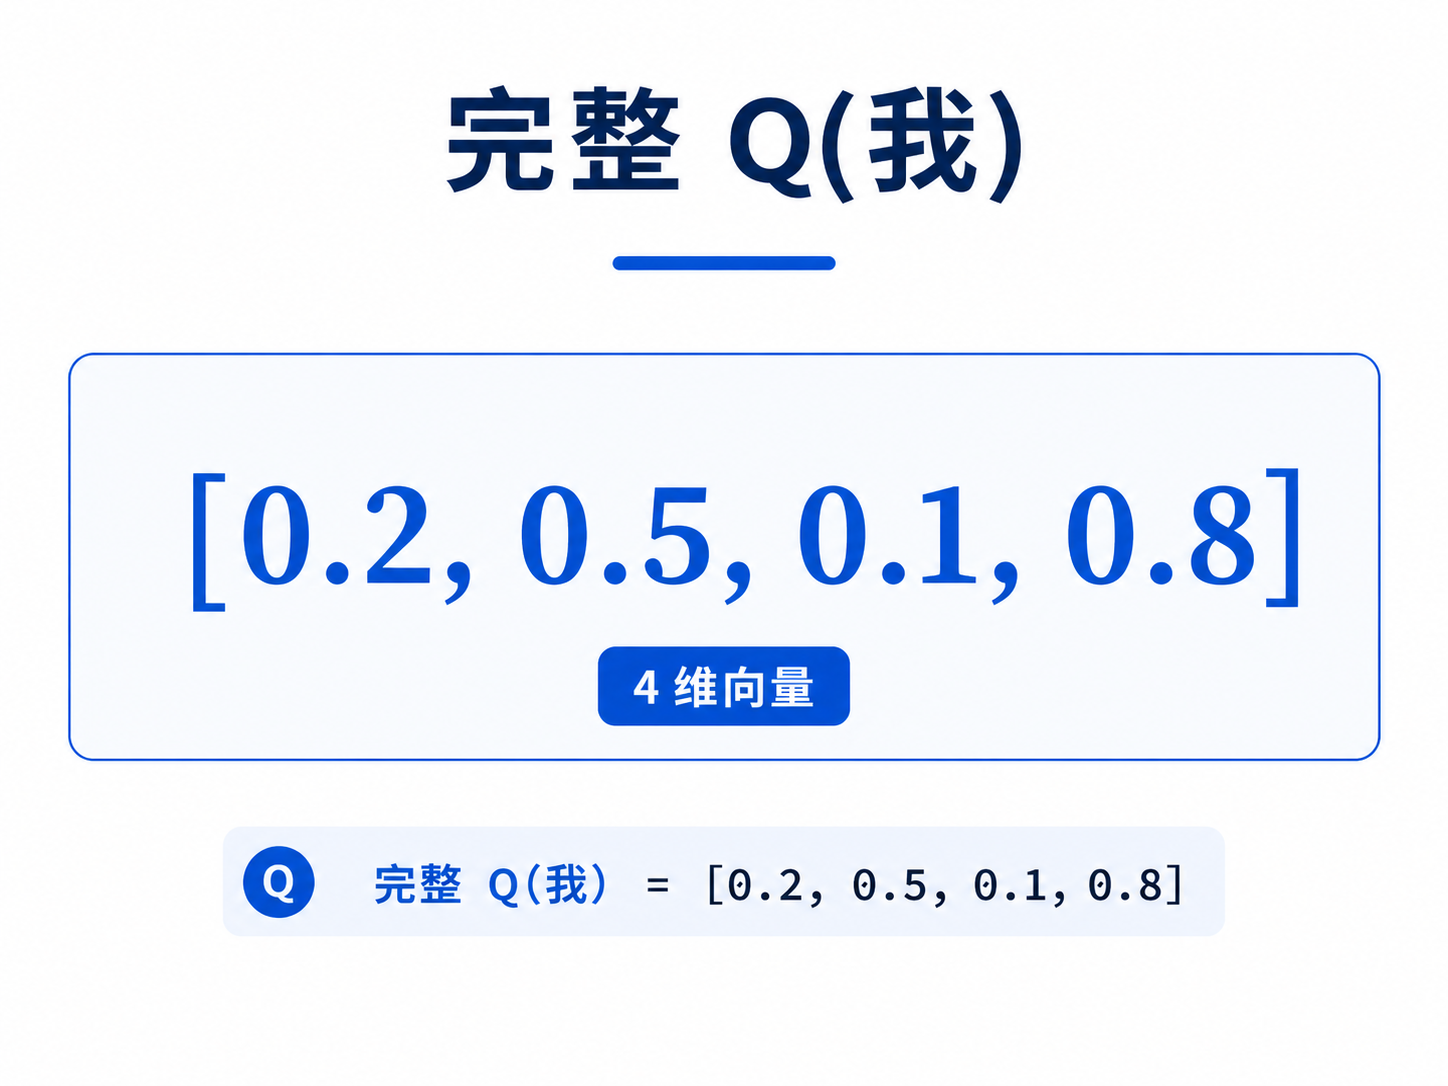
如果我们想设置 2 个头(Head):
- 头1 分到前两维:
[0.2, 0.5] - 头2 分到后两维:
[0.1, 0.8]
K 和 V 也做同样的切分。
2. 各干各的
现在,头1和头2各自拿着缩水后的 Q、K、V 数据,关起门来,并行且独立地去跑一遍我们刚才推演的 Scaled Dot-Product Attention(算点积、缩放、Softmax、乘 V)。
因为它们看到的数据片段截然不同,所以它们算出来的关注点必然产生分歧: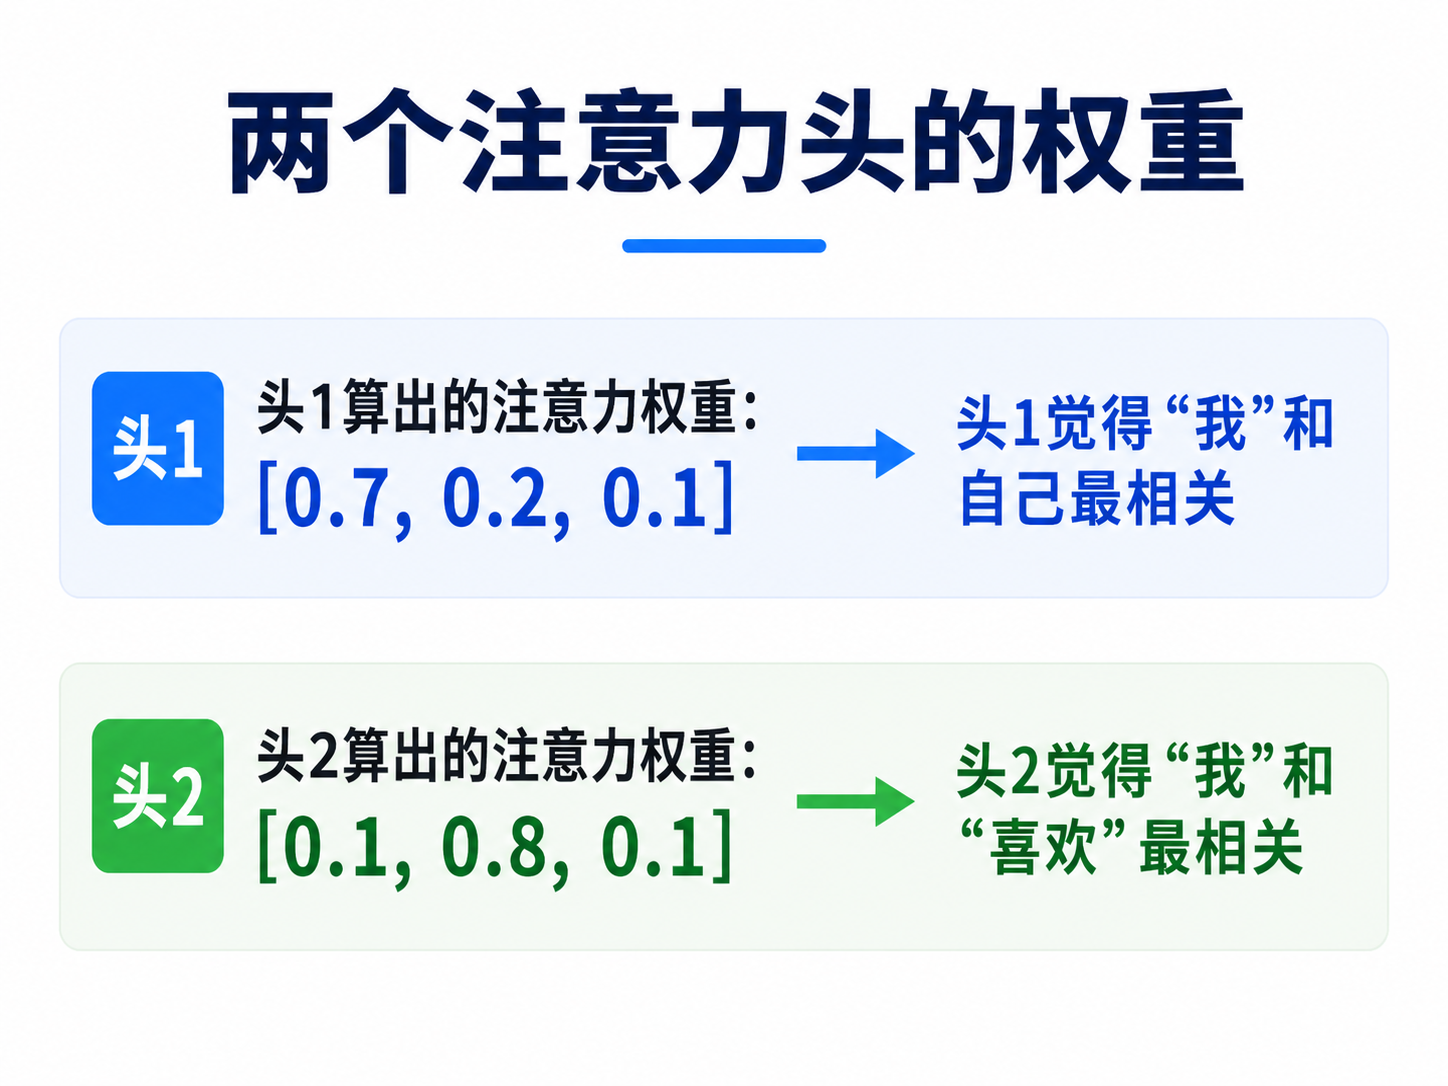
3. 重新拼装 (Concat) 与融合
等所有头都算完自己的局部结果后,比如: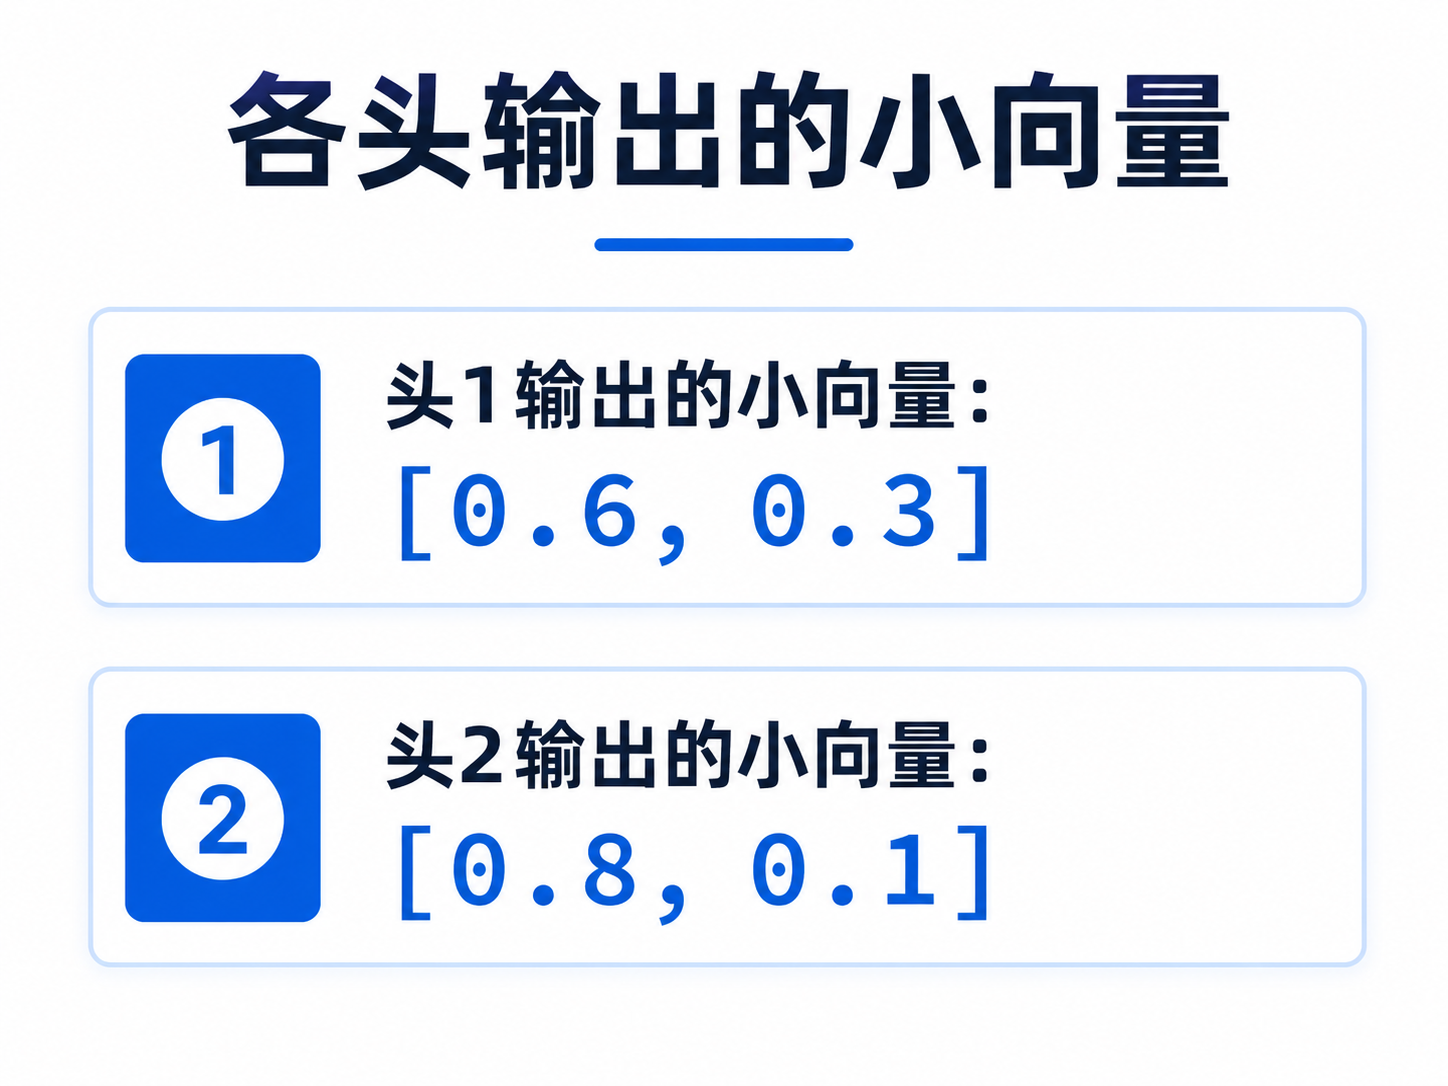
我们直接把它们按顺序无缝拼装在一起: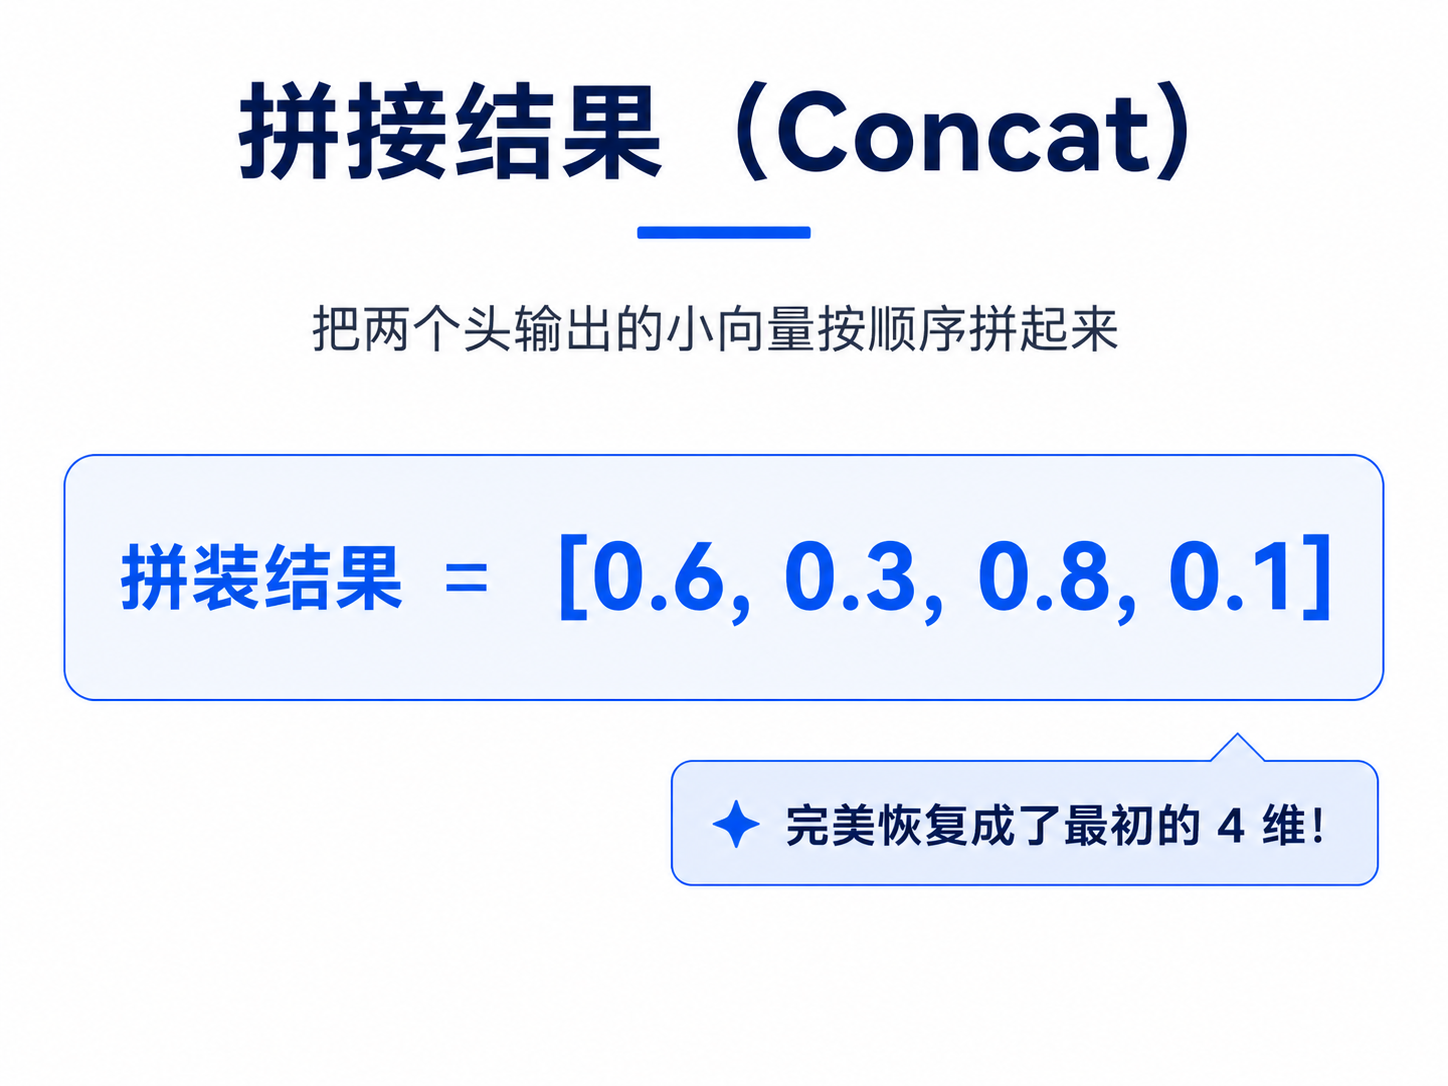
最后,为了防止大家各说各话,让拼装好的长条向量再乘上一个输出权重矩阵 进行线性映射: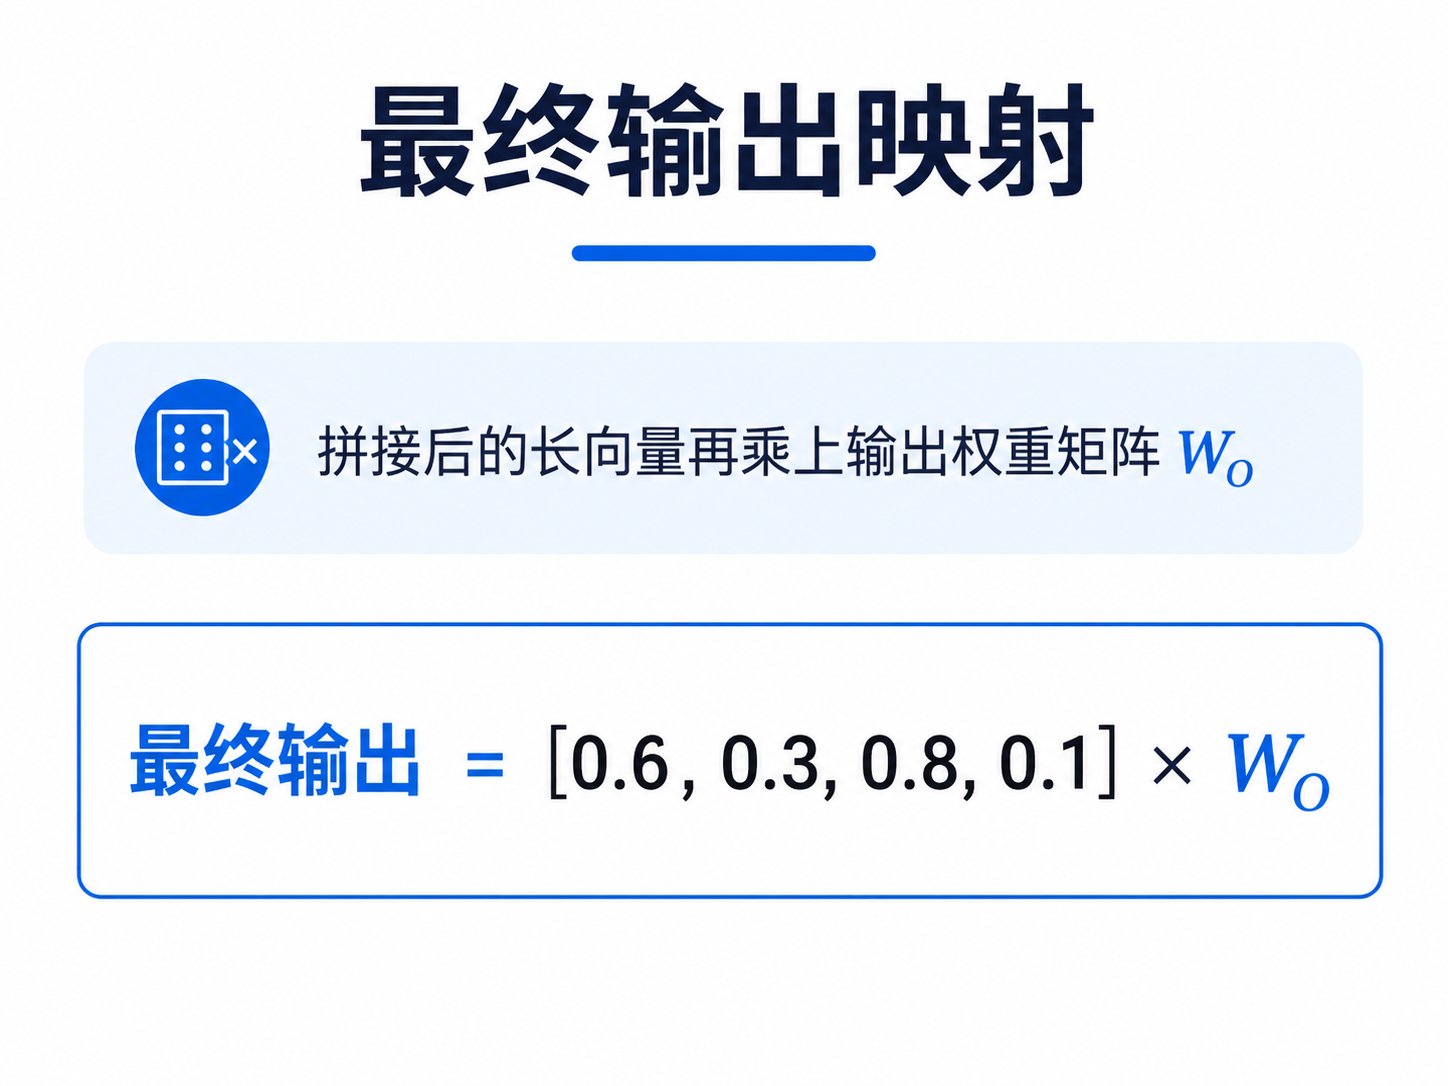
这相当于开个总结会,把各个头提取的“多视角特征”完美地杂糅、提炼成最终的输出结果。
总结一下
从单头到多头,其实就是从“单点突破”走向了“全面开花”。
- 第一步:计算宏观的 Q、K、V;
- 第二步:把它们切开,分给各个头去独立发现不同的特征;
- 第三步:把大家的结果拼回来,过一遍矩阵做完美的总结融合。
理清了具体数字是怎么在矩阵里流转的,注意力机制这个“黑盒”,对你来说就已经彻底透明了吧!!!
阅读导航



