
Self-Attention 图解:QKV、缩放、Mask 与加权读取
Self-Attention 图解:QKV、缩放、Mask 与加权读取
图解 Self-Attention
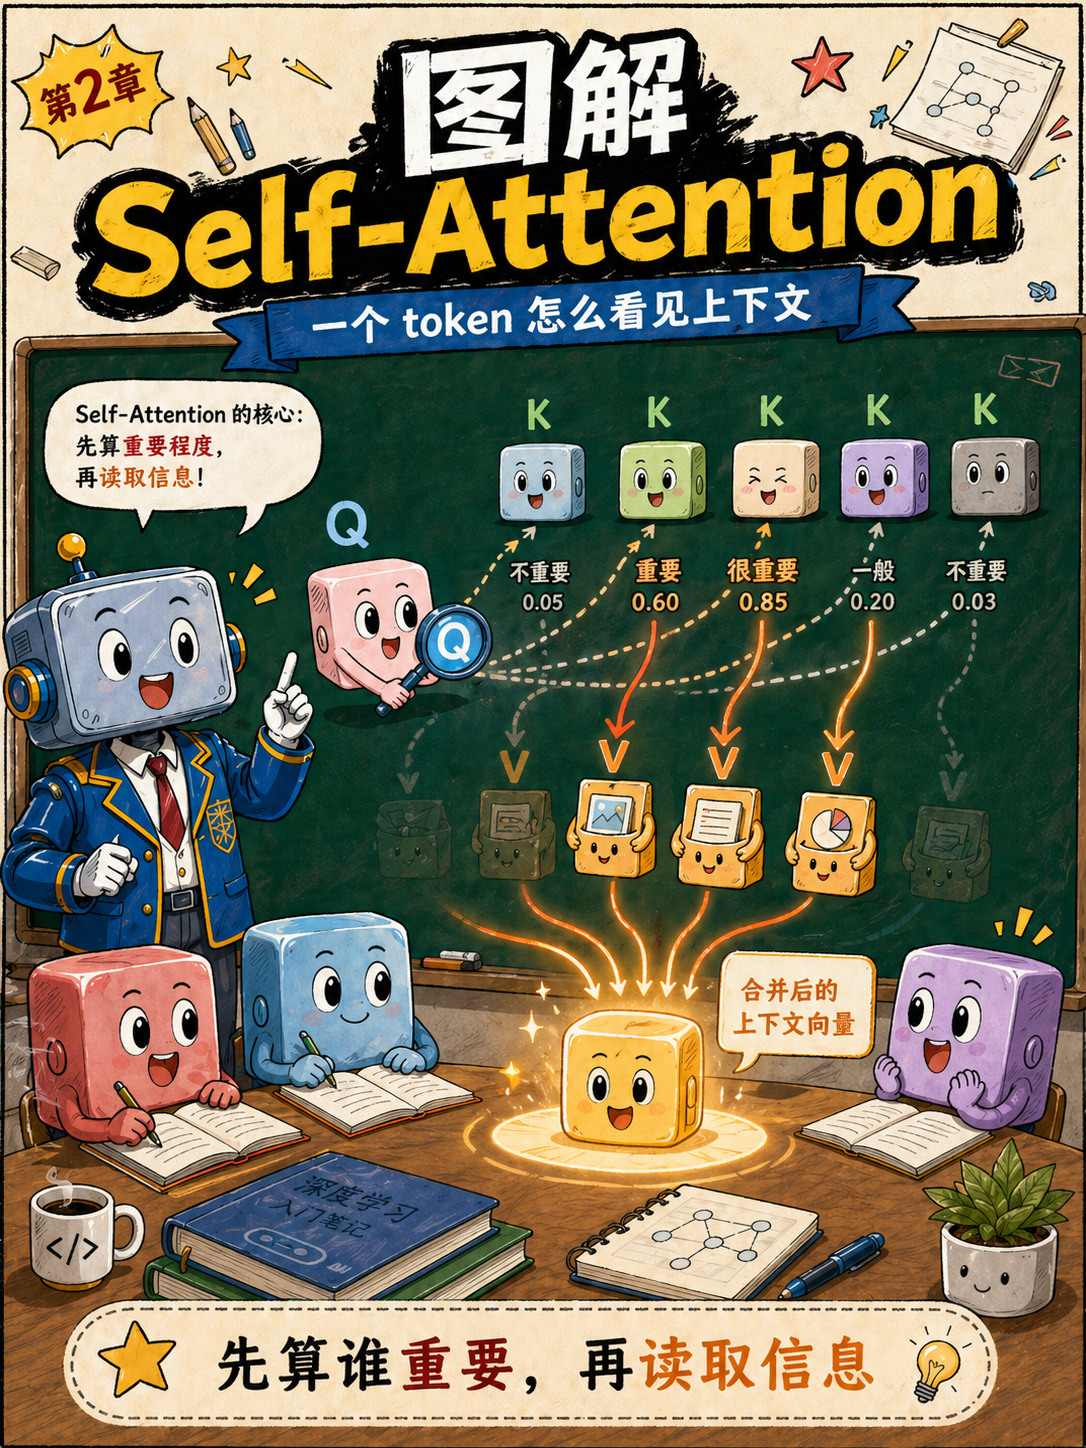
我们在第一章已经把主线走通了:文字变成 token,token 变成编号,编号查出向量,向量带着位置信息进入 Transformer,然后在上下文里不断更新。第二章开始拆其中最关键的一步:self-attention 到底怎么让一个 token 看见上下文呢?
咱们可以先把 self-attention 理解成一个“信息分配和读取”的过程。当前 token 会先判断哪些可见 token 更相关,再按相关程度读取它们的信息,最后得到一个新的上下文向量。
这件事的核心公式是:
看起来挺麻烦哈,但拆开以后就是几件很具体的事:Q 去匹配 K,得到 score;score 经过缩放和 mask;softmax 把分数变成权重;权重再去加权读取 V。
Self-Attention 的核心动作是:先算谁重要,再按权重读取信息。
Q/K/V 从同一个向量来
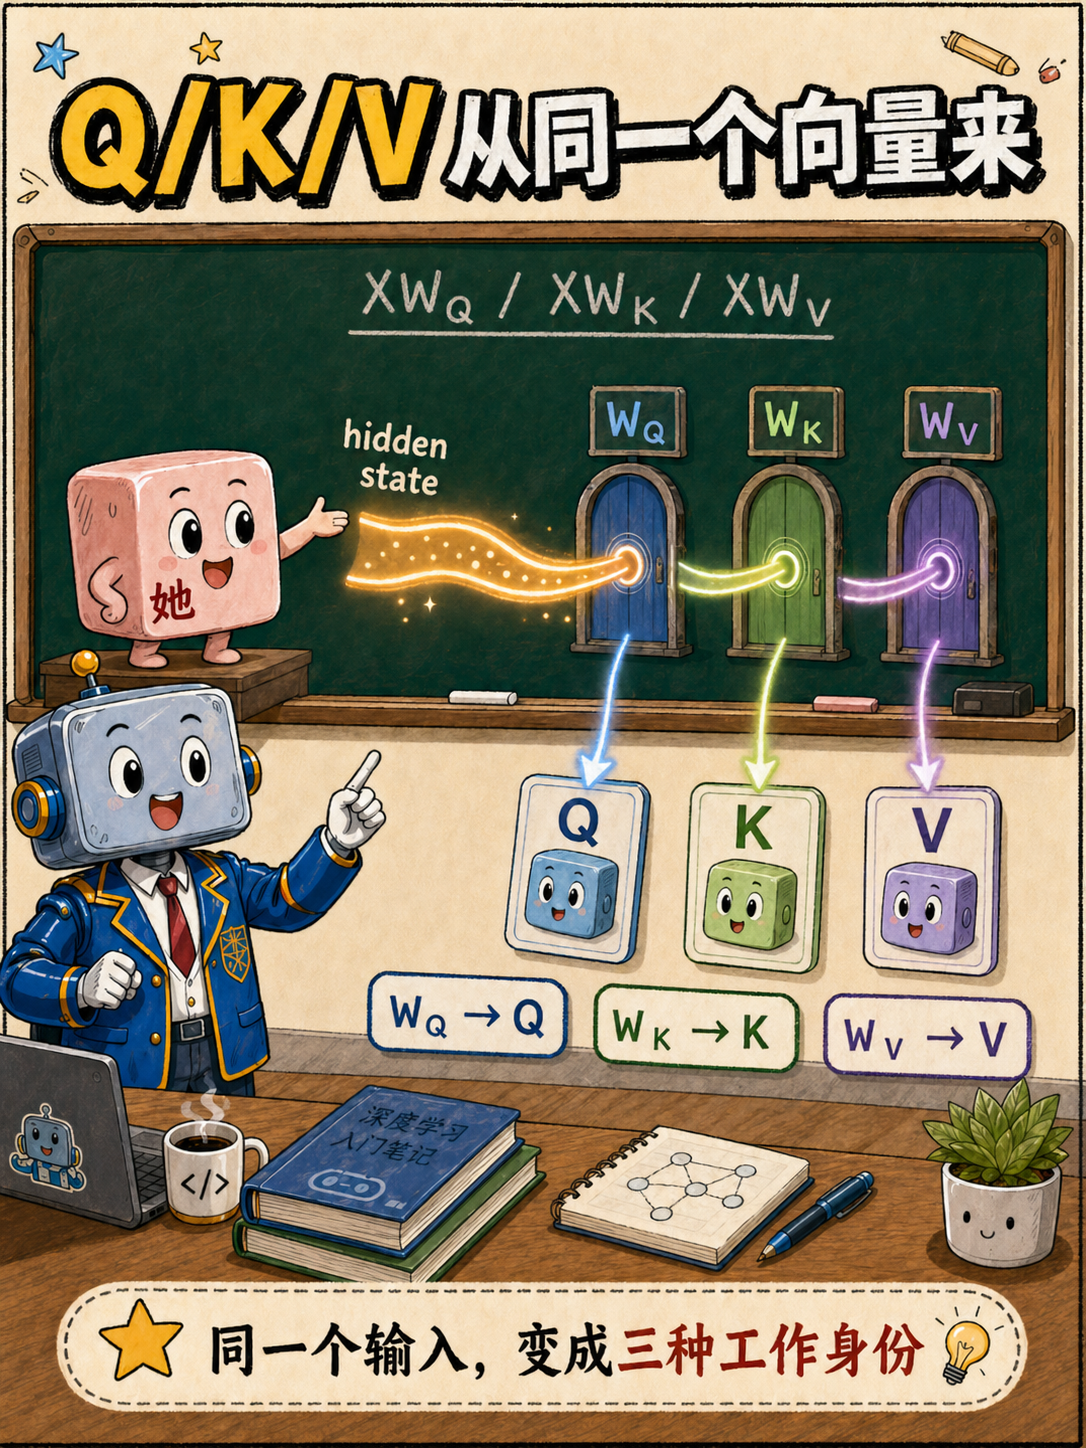
一个 token 进入 attention 时,手里已经有一个当前层的输入表示。这个表示通常叫 hidden state,可以理解成“这个 token 目前在这一层里携带的信息”。
attention 会先把这个表示通过三组不同参数矩阵投影成三份向量:Query、Key、Value。写成简化形式就是:
同一个输入表示,乘以不同的参数矩阵,就得到不同的工作身份:
Q 负责发起查询,.
K 负责参与匹配,
V 负责被读取和混合。
它们都来自同一个 token 当前表示,职责不同。
这一步说白了就是一次线性变换。X 是输入矩阵,W_Q / W_K / W_V 是训练出来的参数矩阵,输出就是三套新的向量。
Q、K、V 是同一个输入表示经过不同投影得到的三种工作身份。
Q:我想找什么
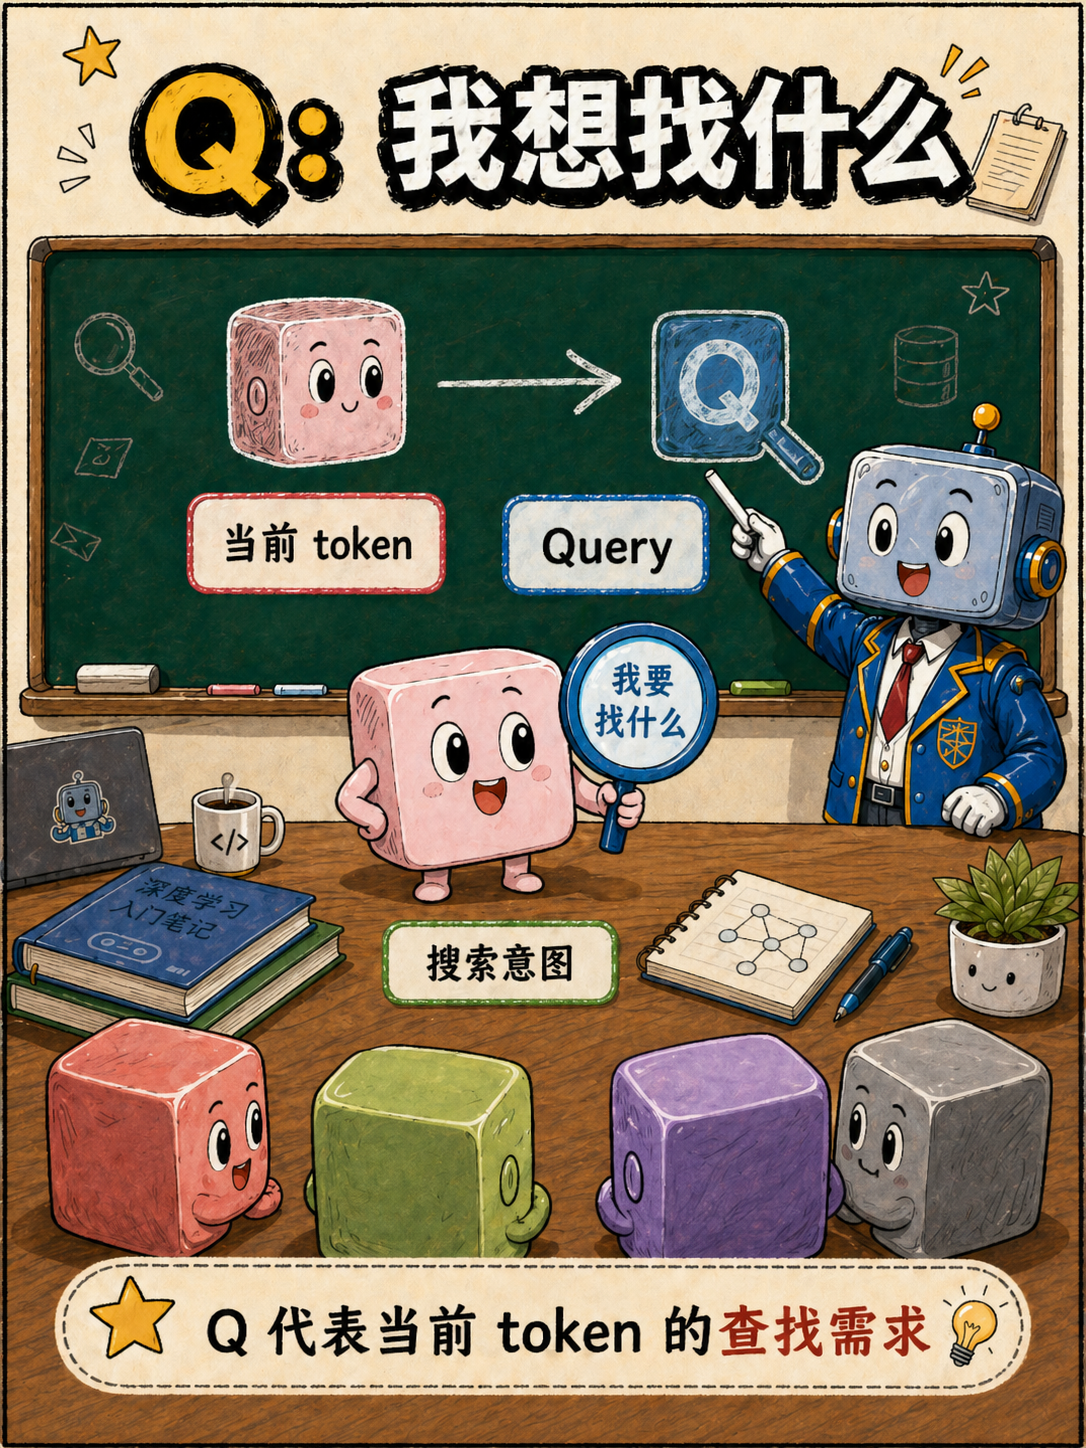
Query 可以先理解成“当前 token 的查找需求”。当前 token 想更新自己的表示,就要去上下文里找有用信息。Q 就承担这个“我要找什么”的角色。
比如当前 token 是“她”,它可能需要寻找前面哪个人物和自己有关。它的 Q 就会带着这种查找方向,去和可见 token 的 K 做匹配。
这里要保持一个边界:Q 是高维向量。我们说“我要找什么”,只是帮助理解它在 attention 里的职责。真实计算里,Q 会和 K 做点积,得到相关性分数。
每个 token 都会产生自己的 Q。也就是说,序列里的每个位置都会从自己的视角出发,去判断上下文里哪些位置更重要。
Q 是当前 token 发起查询的向量,它决定“我用什么角度去找上下文信息”。
K:我怎么被匹配
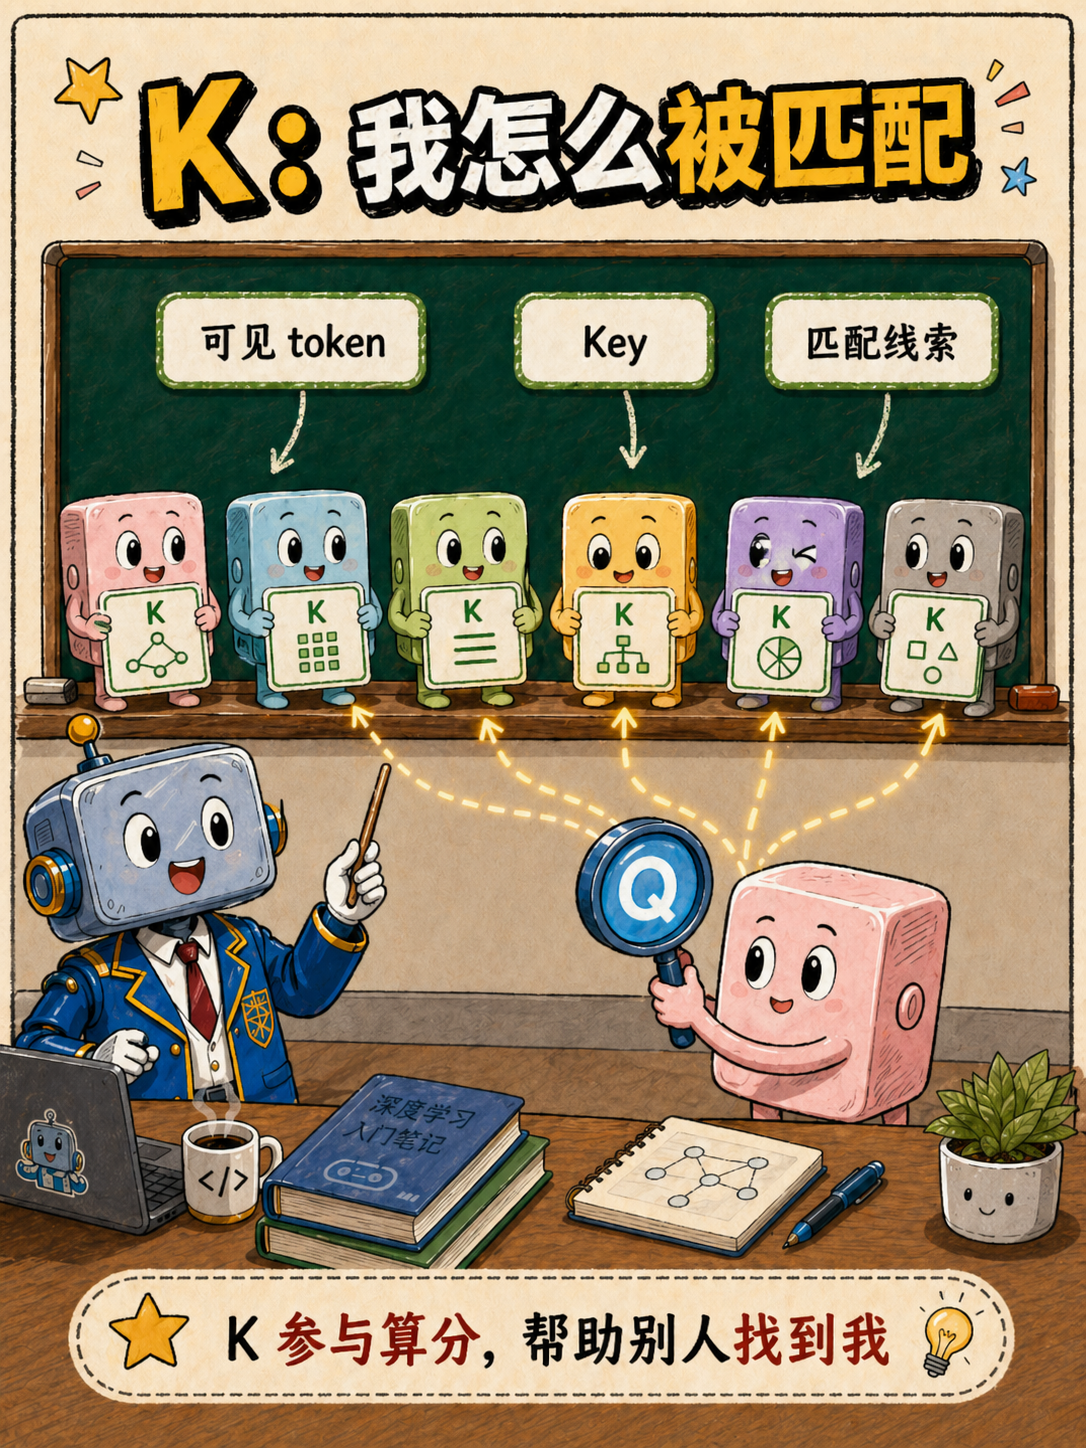
Key 可以理解成“我怎么被别人匹配到”。当某个 token 的 Q 来查上下文时,所有可见 token 的 K 都会参与匹配。匹配结果越高,这个 token 对当前 token 越重要。
这里容易出现一个误解:K 属于高维向量,来自当前层输入表示通过 W_K 的投影结果。它承担匹配职责,和人工写好的标签、数据库字段属于两类东西。
为什么 K 和 V 要分开?因为匹配和读取是两件事。K 负责参与“该不该关注我”的算分,V 负责“关注我以后能拿走什么”。一个 token 既需要被找到,也需要在被找到之后贡献信息。
用课堂比喻讲,K 像“可匹配线索”。别人拿 Q 来照它,能算出一个匹配分数。这个分数只决定注意力怎么分配,还没有真正把内容读走。
K 参与匹配和算分,帮助当前 token 判断“这个位置值不值得看”。
我能提供什么
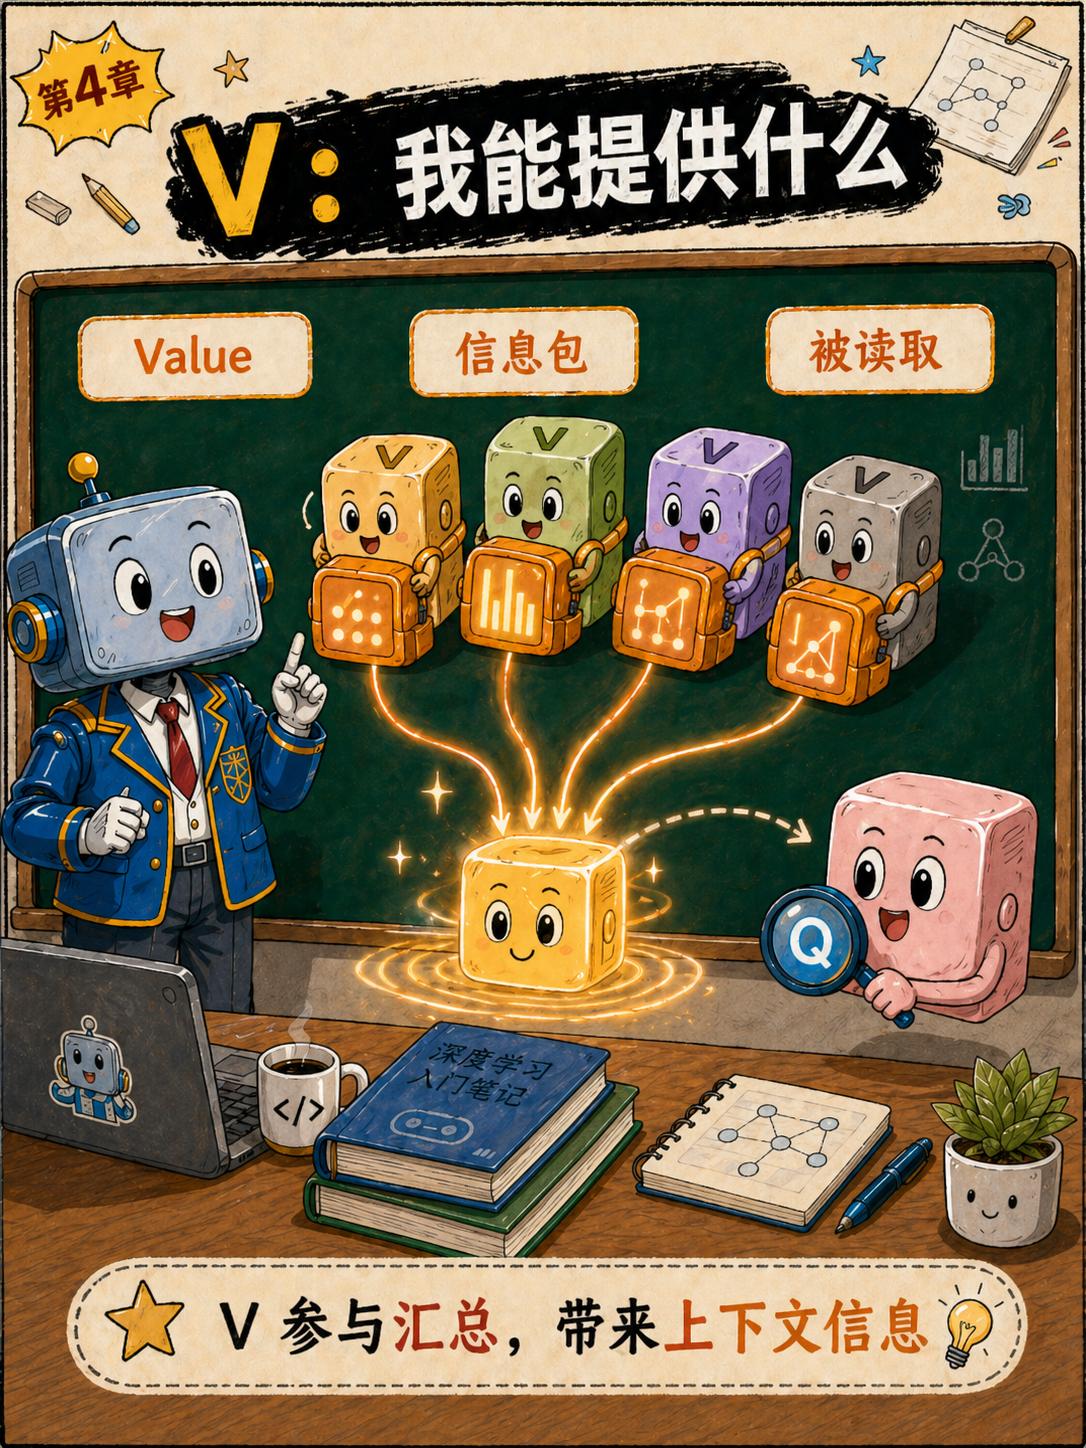
Value 是 attention 里真正被读取和混合的内容。当前 token 用 Q 和其他 token 的 K 算完权重以后,会用这些权重去加权求和所有可见 token 的 V。
如果某个 token 的权重高,它的 V 对最终结果贡献更大;权重低,贡献就更小。最终混合出来的向量,就是当前 token 从上下文里收集到的信息。
V 是当前 token 表示经过 W_V 投影后的向量。我们把它画成信息包,是为了表达它在流程中的职责:被读取,被加权,被汇总。
这一步能解释第一章里“token 的表示会吸收上下文”这句话。真正混进当前 token 新表示里的,是其他可见 token 的 V 按权重加权后的结果。
V 是被读取和加权混合的向量,最终负责把上下文信息带进当前表示。
QK 匹配
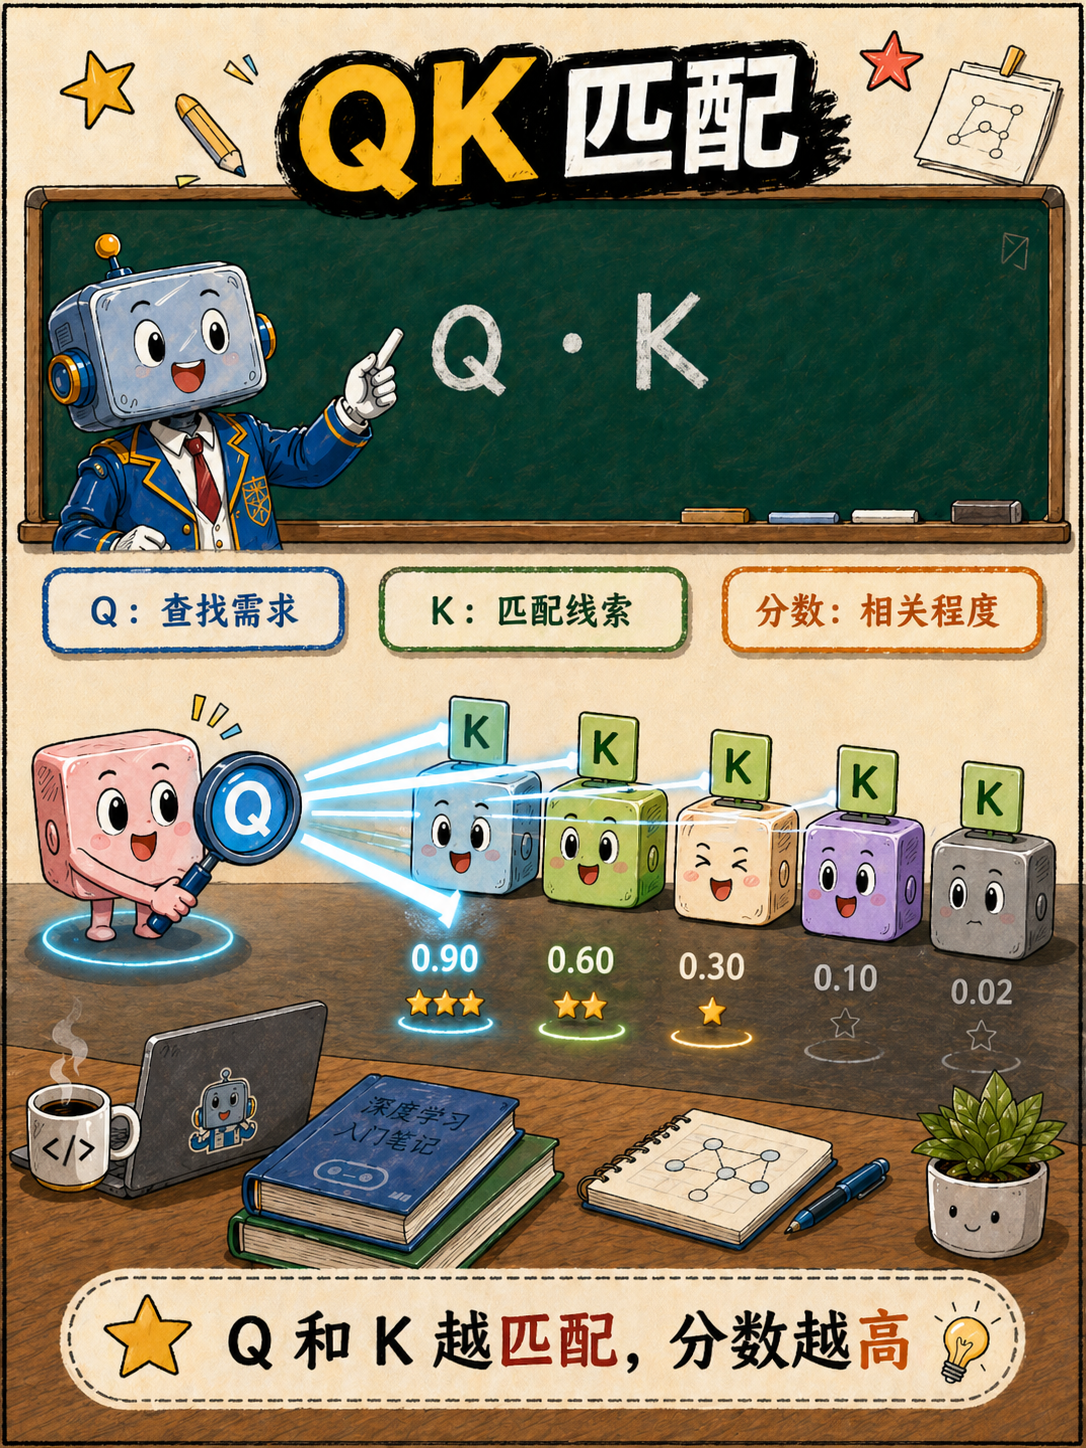
有了 Q 和 K,下一步就是匹配。当前 token 的 Q 会和所有可见 token 的 K 做点积。点积的结果是一个数,可以先理解成相关程度。
点积的直觉很简单:两个向量方向越一致,点积通常越大;方向越不一致,点积越小。
至于为什么点积能用来算这个匹配度,我们可以看看它背后的数学意义。从几何上说,两个向量的点积等于它们长度的乘积再乘以夹角的余弦值(cosθ)。当两个向量方向很一致的时候,夹角很小,余弦值趋近于 1,点积就大;如果它们相互垂直,点积就是 0。
如果从代数角度看可能更直观一些:点积就是把两个向量在各个维度上的值逐一对应相乘,然后全部加起来。如果 Q 和 K 在相同的维度上都有较大的值,乘积累加起来自然就很大。这其实就意味着,Q 在某些维度上“想要寻找的特征”,刚好 K 在这些维度上“具备”了,所以它们俩一拍即合,得到的分数就高。放在 attention 里,就是 Q 和某个 K 越匹配,当前 token 就越可能关注那个位置。
如果把所有 token 的 Q 排成矩阵 Q,所有 token 的 K 排成矩阵 K,那么一次矩阵乘法 QK^T 就能算出所有 query 对所有 key 的匹配分数。
这里的 K^T 是转置。转置后,每个 query 就能和每个 key 对齐做点积。结果是一个分数矩阵:每一行代表一个 token 的视角,每一列代表它正在看哪个 key。
QK^T算的是“每个 token 从自己的视角看,哪些可见 token 更相关”。
Attention Score
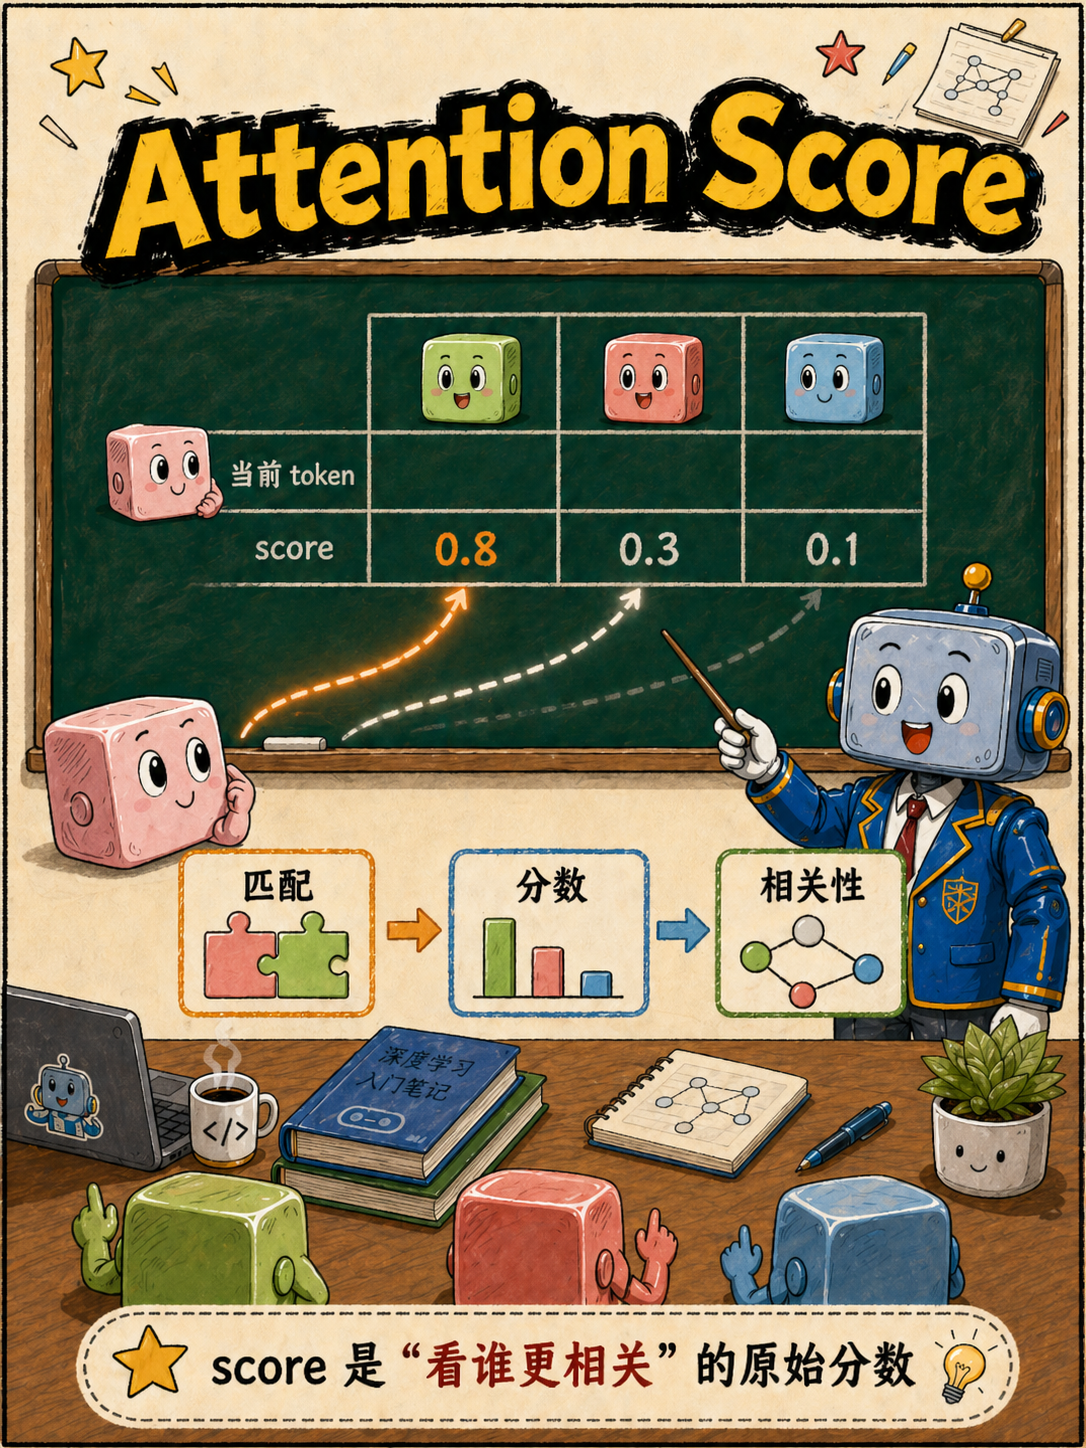
QK^T 得到的是 attention score,也就是原始相关性分数。它后面还要经过 softmax,才会变成最终注意力权重。
以三个 token 为例,当前 token 可能对三个位置得到 [2, 0, 1] 这样的分数。分数越高,说明从当前 Q 的视角看,那个 K 更匹配。
注意 score 是原始分数。它可以是任意实数,不要求加起来等于 1,也不一定都为正。后面还要经过 scale、mask 和 softmax,才会变成真正可用于加权求和的注意力权重。
从矩阵角度看,score 矩阵里的每一行都代表一个 token 的注意力视角。第 i 行就是第 i 个 token 对所有可见 token 的原始关注分数。
Scale:给分数降降温
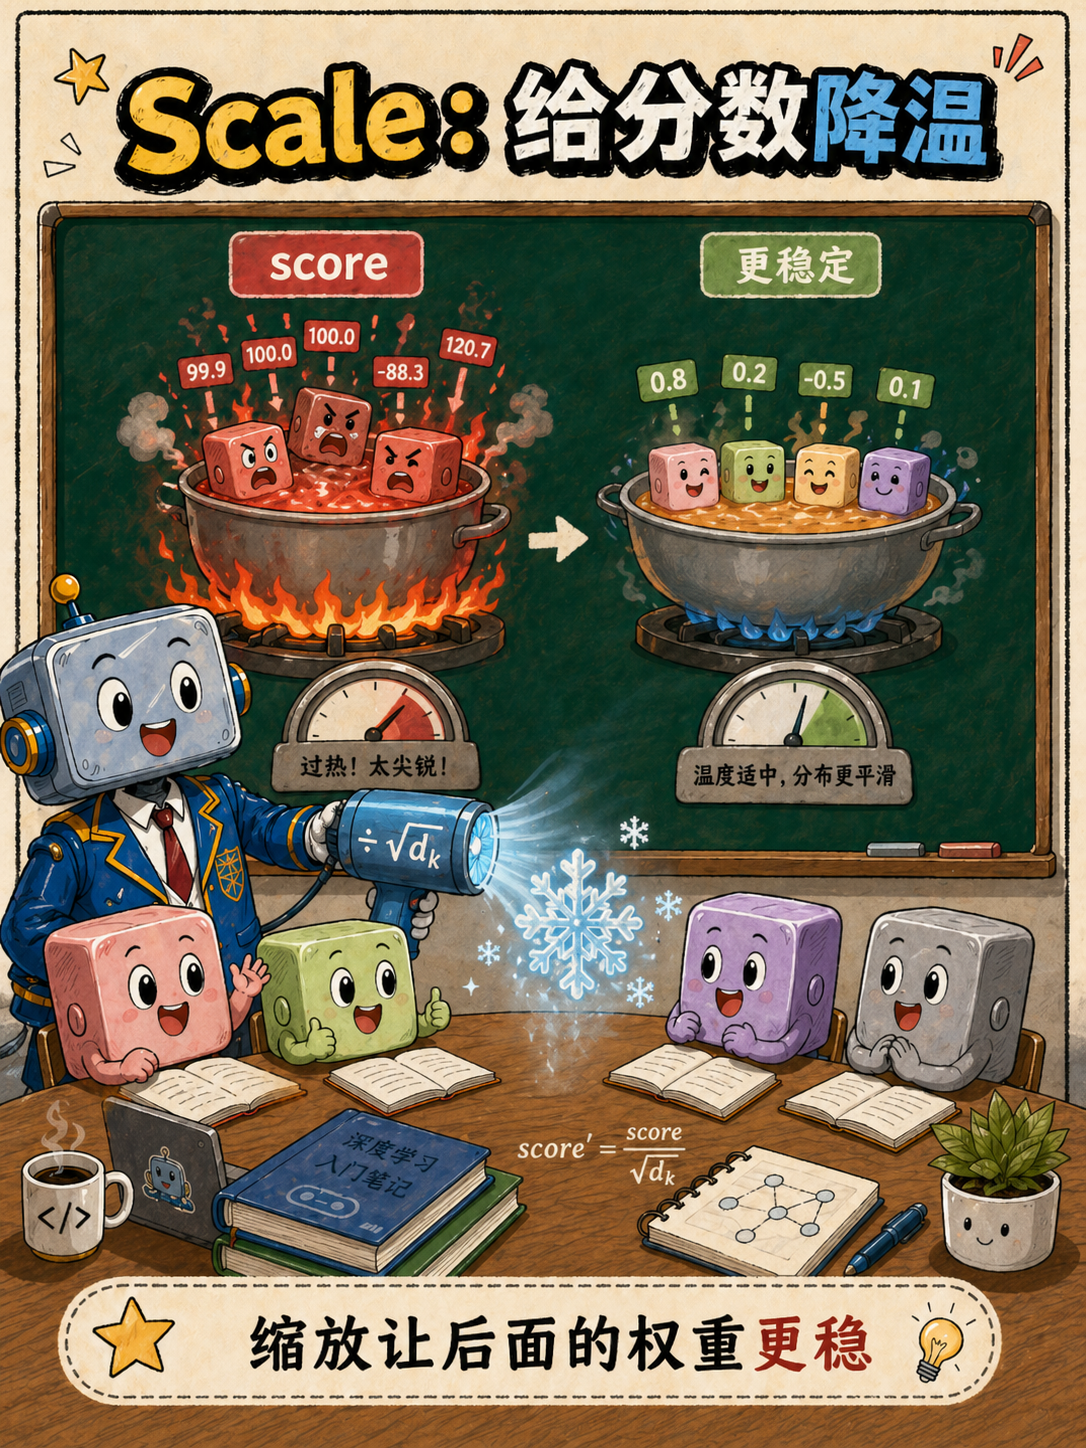
Scaled Dot-Product Attention 里的 scaled,指的就是把 score 除以 sqrt(d_k)。d_k 是 key 向量的维度。
为什么要缩放?因为高维向量做点积时,数值容易变大。softmax 对数值大小很敏感。如果输入分数太大,softmax 会变得很尖锐,几乎把全部权重压到一个位置上。
比如 [2, 0, 1] 经过 softmax 后可能还比较平滑;[20, 0, 10] 经过 softmax 后会几乎全集中到最大值。这样模型容易只看一个 token,训练时梯度也会变得很小。
除以 sqrt(d_k) 相当于给分数降温,让分布更稳定。它不会改变 attention 的基本逻辑,只是让后面的 softmax 更好工作。
scale 的作用是控制分数尺度,避免 softmax 过早变得极端。
Mask:挡住不能看的位置
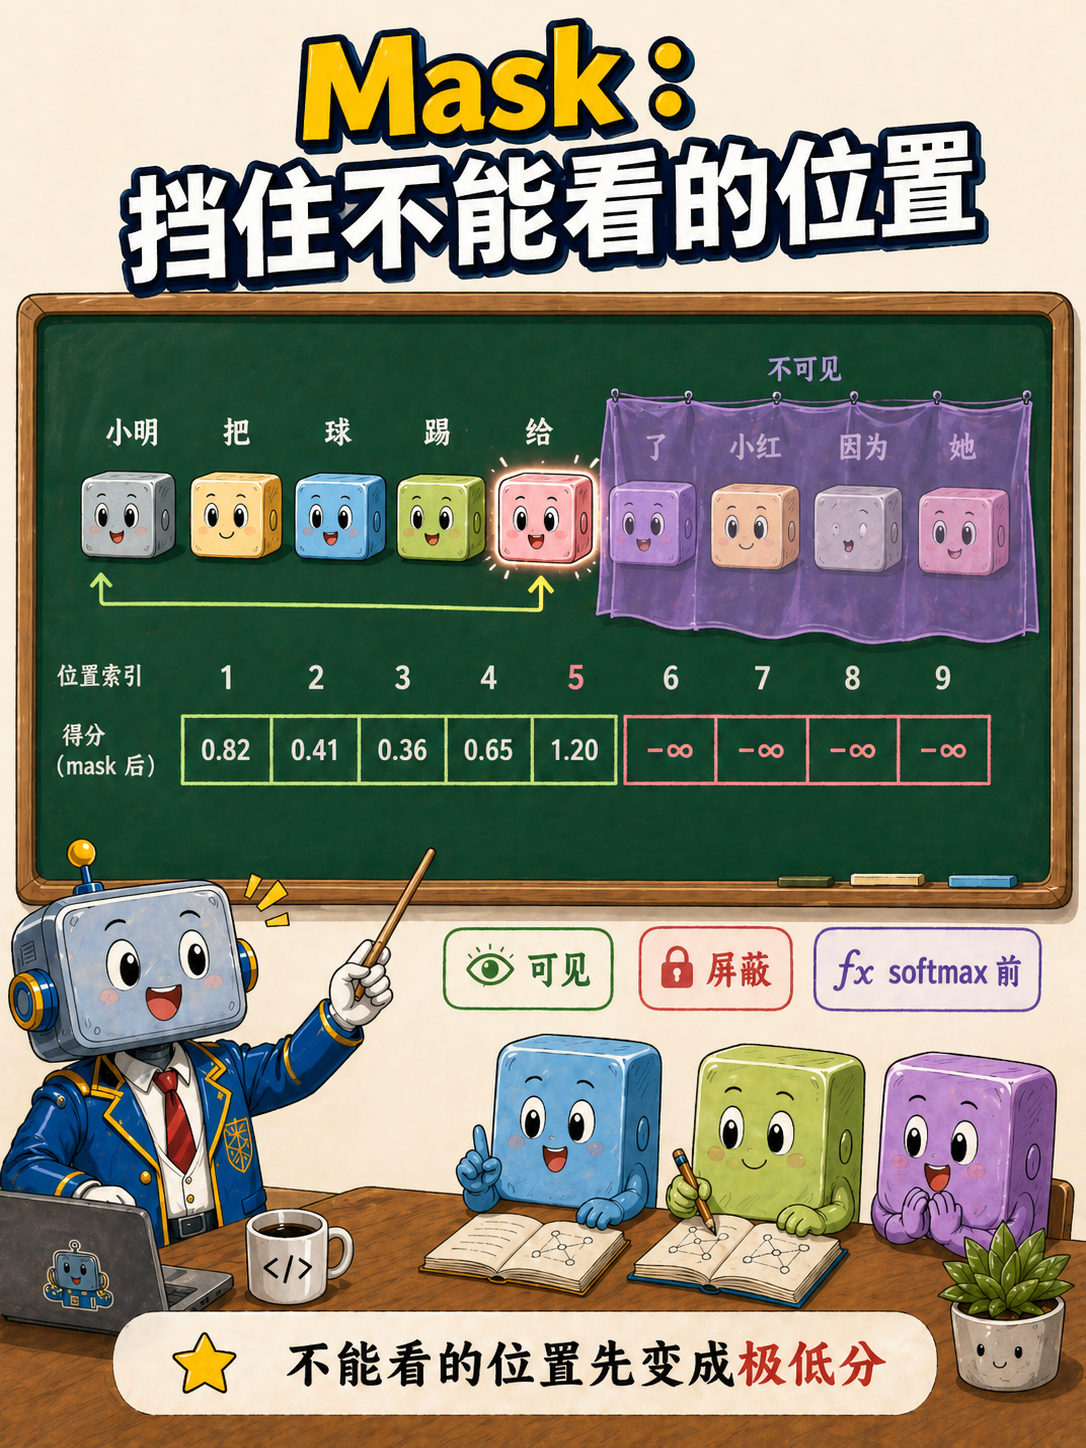
mask 解决的是“哪些位置允许看”。在 decoder-only LLM 里,生成时未来 token 还没有出现,所以当前 token 不能看右边未来位置。
实际计算里,mask 通常作用在 softmax 之前。做法是把不能看的位置加上一个非常大的负数,直觉上可以理解成 -∞。这样 softmax 之后,那些位置的权重就会接近 0。
这一步很重要。mask 在分数进入 softmax 之前就把不可见位置压低,让这些位置在 softmax 后得到接近 0 的权重。
第一章已经讲过“可见 token”。这里就能接上:当前 token 只对可见位置分配注意力,不可见位置先被 mask 屏蔽。
mask 在 softmax 前生效,让不可见位置的注意力权重接近 0。
Softmax:分数变权重
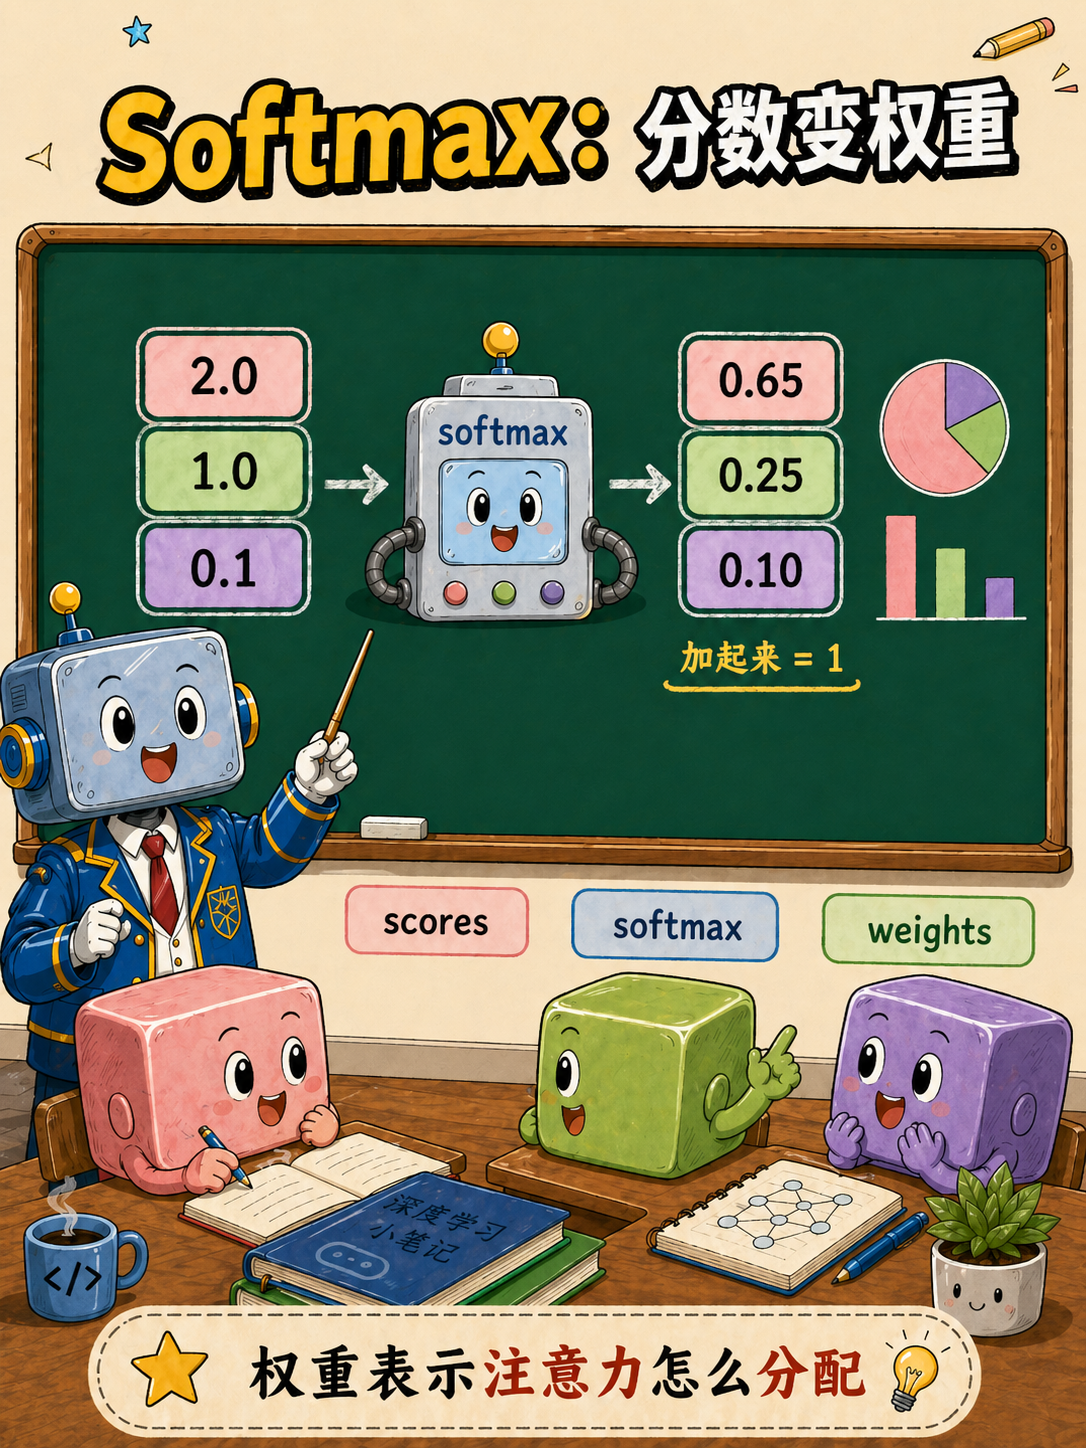
softmax 的任务很明确:把一组分数变成一组权重。输出的每个值都是正数,并且加起来等于 1。
它具体是怎么做的呢?其实主要就两步。第一步是求指数(也就是算 e 的几次方)。这一步有两个效果:一是把所有的分数都变成了正数;二是放大了差异,原本大一点的分数,求完指数后会变得非常大,拉开了和低分的差距。第二步是归一化,就是把第一步得到的每个值,除以它们的总和。这么一除,所有的值就都被按比例缩放到了 0 到 1 之间,而且总和刚好等于 1。
比如 [2, 0, 1] 经过 softmax 后,可能变成 [0.67, 0.09, 0.24]。这组数字就能解释为注意力分配:第一个位置贡献最大,第二个位置贡献很小,第三个位置也有一定贡献。
在 attention 里,softmax 的重点是把原始 score 转成可以做加权求和的比例。
经过 softmax 之后,模型有了一组可执行的读取方案:每个位置读多少。
softmax 把相关性分数变成注意力权重,权重加起来等于 1。
Weighted Sum:按权重读取 V
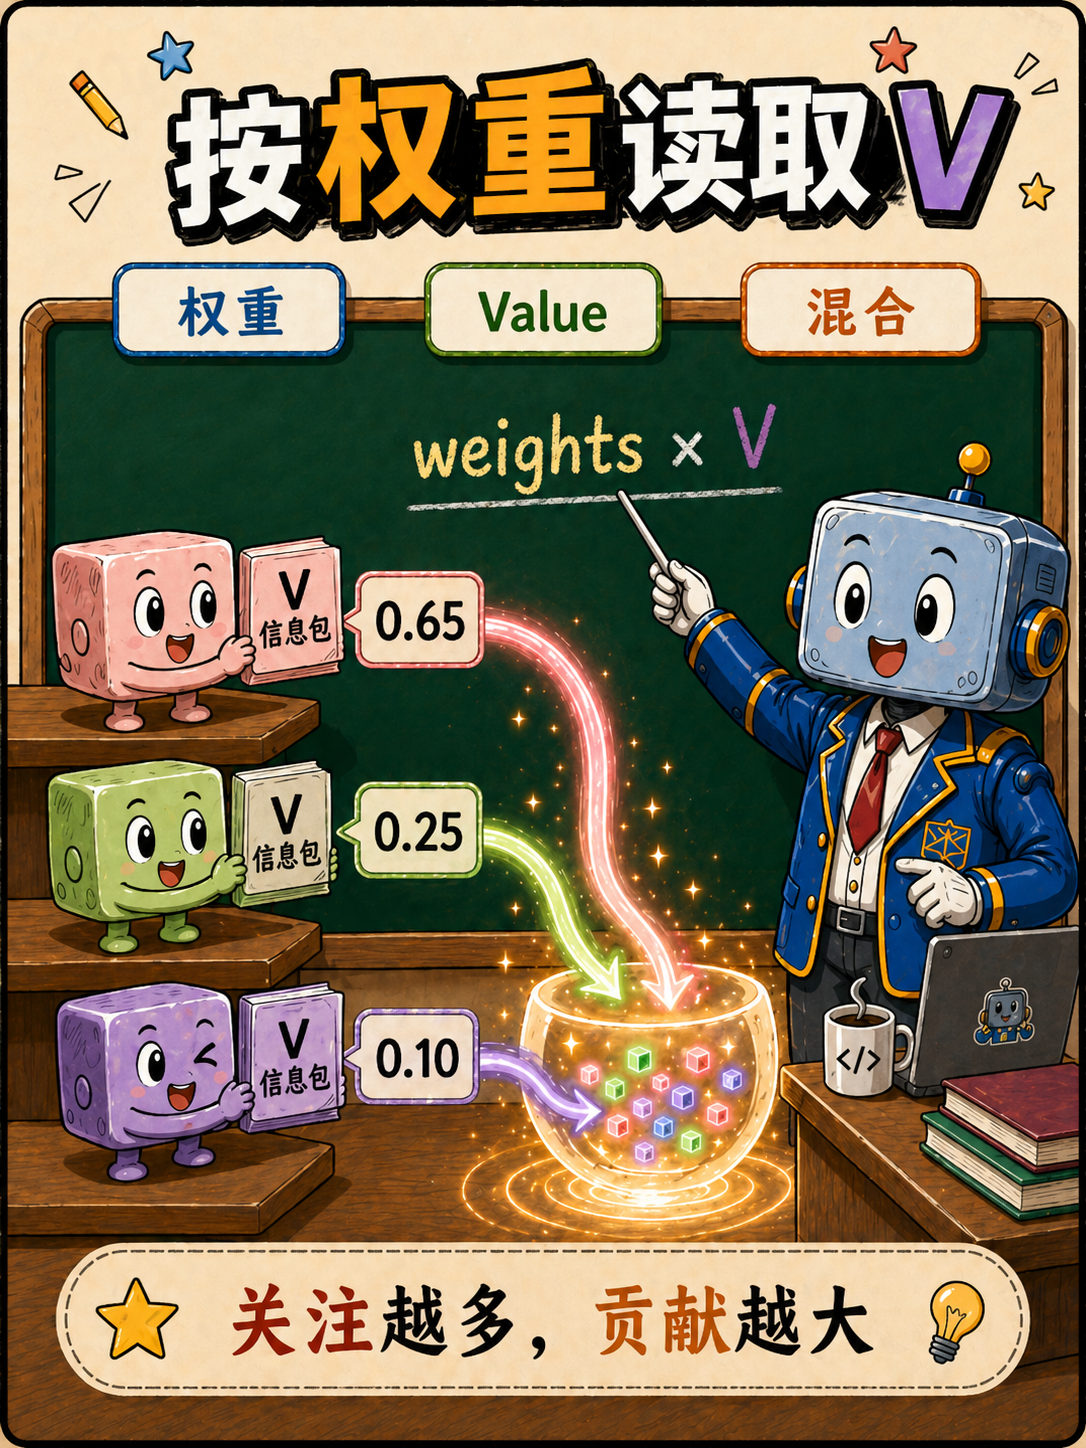
有了注意力权重以后,就可以读取 V。读取方式是对所有可见 token 的 V 做加权求和。
如果权重是 [0.67, 0.09, 0.24],那么输出就是:
0.67 * V_1 + 0.09 * V_2 + 0.24 * V_3
权重大,贡献就大;权重小,贡献就小。这样当前 token 可以同时吸收多个位置的信息。
这一步就是第一章说的“按相关性收集上下文”。attention 会把多个 Value 向量按比例混合成一个新的向量。
weighted sum 是加权混合;关注越多,贡献越大。
Context Vector:得到上下文向量
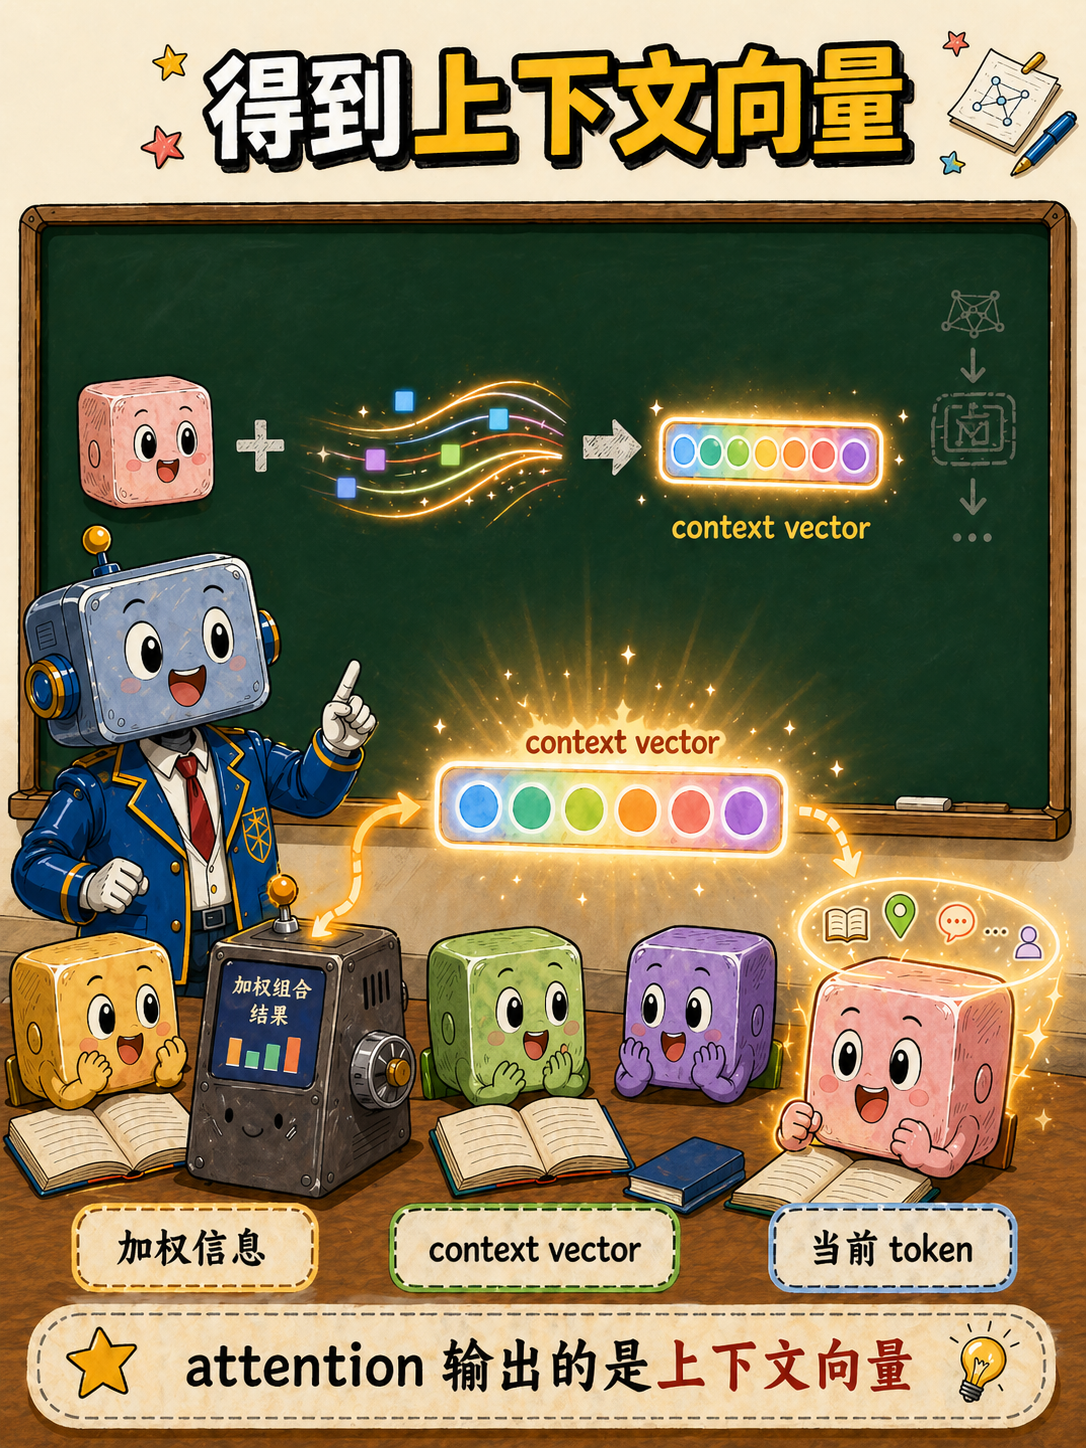
加权求和后的结果,就是当前 token 通过 attention 收集到的 context vector。它是一个向量,里面混合了可见上下文的信息。
这个 context vector 仍然对应当前 token 的位置。也就是说,序列长度不会因为 attention 变短;每个位置都会得到一个属于自己的上下文向量。
这里要保持精确:attention 本身输出的是上下文向量。完整 Transformer block 里,后面还会有残差连接、归一化、FFN 等步骤。第一章和第二章咱们先把 attention 这一段吃透,其他先别管。
从直觉上看,当前 token 拿到了一个更懂上下文的自己。它已经结合了位置、可见上下文和注意力分配。
context vector 是 attention 的输出,它让当前 token 带上上下文信息。
Self-Attention 全流程
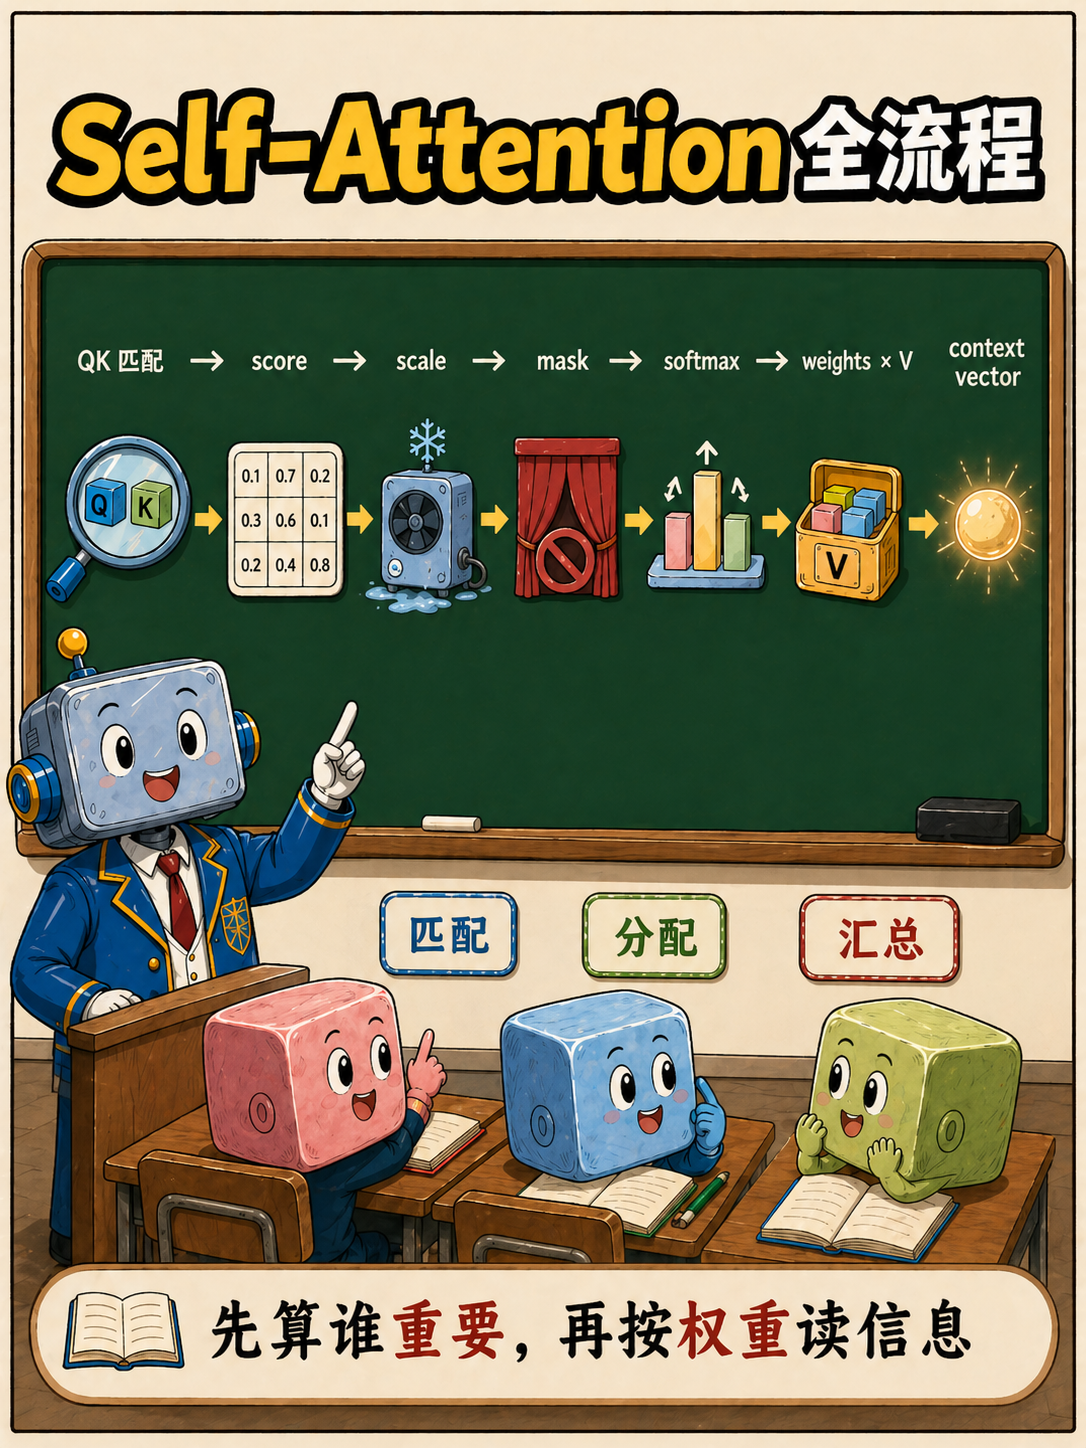
最后咱们把整章串起来,self-attention 的流程就是:
QK^T → scores → scale → mask → softmax → weights × V → context vector
先用 Q 和 K 算匹配分数,再用 sqrt(d_k) 控制分数尺度;如果有 mask,就先屏蔽不能看的位置;softmax 把分数变成权重;最后用权重去加权读取 V,得到当前 token 的上下文向量。
这个流程会对每个 token 都发生一次。每个 token 都从自己的 Q 出发,去看可见 token 的 K,再读取可见 token 的 V。因此每个位置最后都会得到一个新的上下文表示。
第二章聚焦单头 attention,下一章咱们进入 multi-head:简单讲就是多个 head 从不同角度各跑一遍 attention,最后把结果拼起来之后再融合。
Self-Attention 是一次完整的表示更新:先分配注意力,再读取并混合上下文信息。
阅读导航



