
图解 Transformer:自注意力、位置编码与编码器解码器
图解 Transformer
原文: The Illustrated Transformer — Jay Alammar — 一次可视化一个机器学习概念。
译者注: 本文是 Jay Alammar 所著《The Illustrated Transformer》的中文翻译。原文采用 CC BY-NC-SA 4.0 协议授权,作者允许翻译。本译文仅供学习交流。
在这篇博文中,我们将考察 Transformer —— 一个使用注意力来加速此类模型训练速度的模型。Transformer 在某些任务上超越了谷歌神经机器翻译(GNMT)模型。然而,它最大的好处来自于 Transformer 本身非常适合并行化这一特性。事实上,Google Cloud 推荐将 Transformer 作为使用其 Cloud TPU 服务的参考模型。那么,让我们把这个模型拆开来看一看它是如何运作的。
Transformer 最初是在论文《Attention is All You Need》中提出的。其 TensorFlow 实现作为 Tensor2Tensor 包的一部分提供。哈佛大学 NLP 小组创建了一份用 PyTorch 实现注释该论文的指南。在这篇博文中,我们会尝试把事情稍微简化一点,逐个引入概念,希望能让那些对该主题没有深入了解的人也能更容易理解。
2025 年更新: 我们已经制作了一门免费短课程,用动画把这篇博文的内容更新到了最新版本:
高层概览
让我们先把这个模型当作一个单一的黑盒来看待。在机器翻译应用中,它会接收一种语言的一个句子,输出另一种语言的翻译。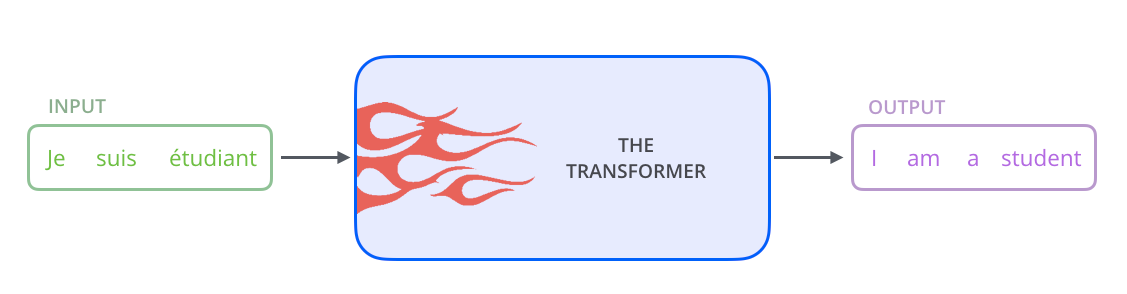
打开擎天柱般的宝贝,我们会看到一个编码组件、一个解码组件。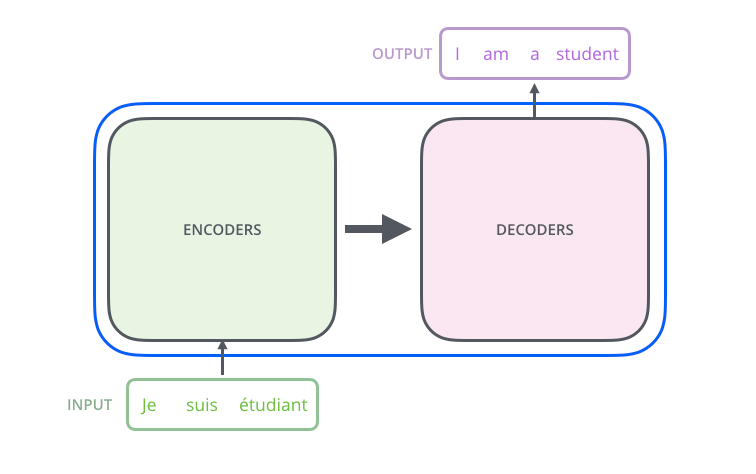
编码组件是一摞编码器(encoder)堆叠而成(论文中堆叠了 6 个 —— 数字 6 并没有什么神奇之处,完全可以尝试其他排列方式)。解码组件是相同数量的解码器(decoder)堆叠而成。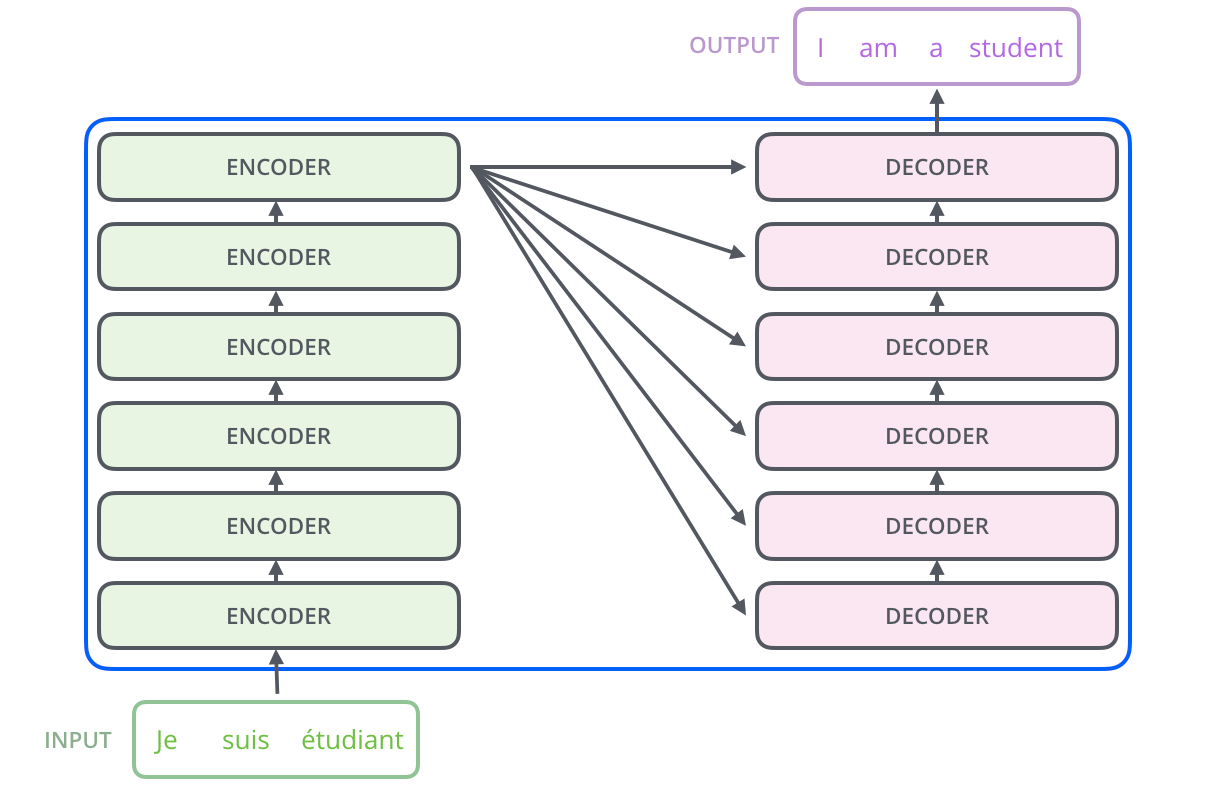
这些编码器在结构上完全相同(但它们并不共享权重)。每一个编码器都拆分为两个子层: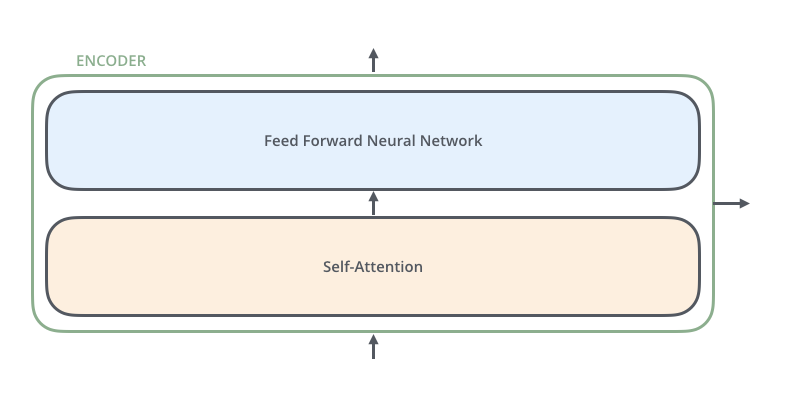
编码器的输入首先流经一个 自注意力(self-attention)层 —— 这一层帮助编码器在编码某个特定词时,能够「看到」输入句子中的其他词。我们稍后会在文中更仔细地考察自注意力。
自注意力层的输出被送入一个 前馈神经网络(feed-forward neural network)。完全相同的前馈网络会独立地作用于每一个位置。
解码器同样拥有这两个层,但在它们之间还有一个 注意力层,帮助解码器关注输入句子中相关的部分(类似于 seq2seq 模型中注意力的作用)。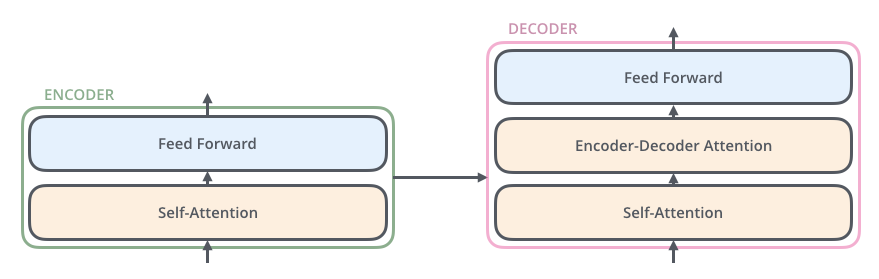
把张量引入画面
既然我们已经看到了模型的主要组件,那就开始来看各种向量/张量是如何在这些组件之间流动,从而把一个已训练模型的输入变成输出的。
正如一般 NLP 应用中的做法,我们首先使用一个 嵌入算法(embedding algorithm) 把每个输入词转换为一个向量。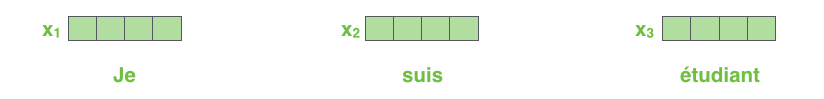
每个词被嵌入为一个大小为 512 的向量。我们用这些简单的方框来表示这些向量。
嵌入只发生在最底层的编码器中。所有编码器共同拥有的抽象是:它们接收一个由 512 维向量组成的列表 —— 在最底层编码器中那是词嵌入,但在其他编码器中,则是其正下方那个编码器的输出。这个列表的大小是一个我们可以设置的超参数 —— 基本上它就是训练数据集中最长句子的长度。
把输入序列中的词嵌入之后,每个词向量都会流经编码器的两个层。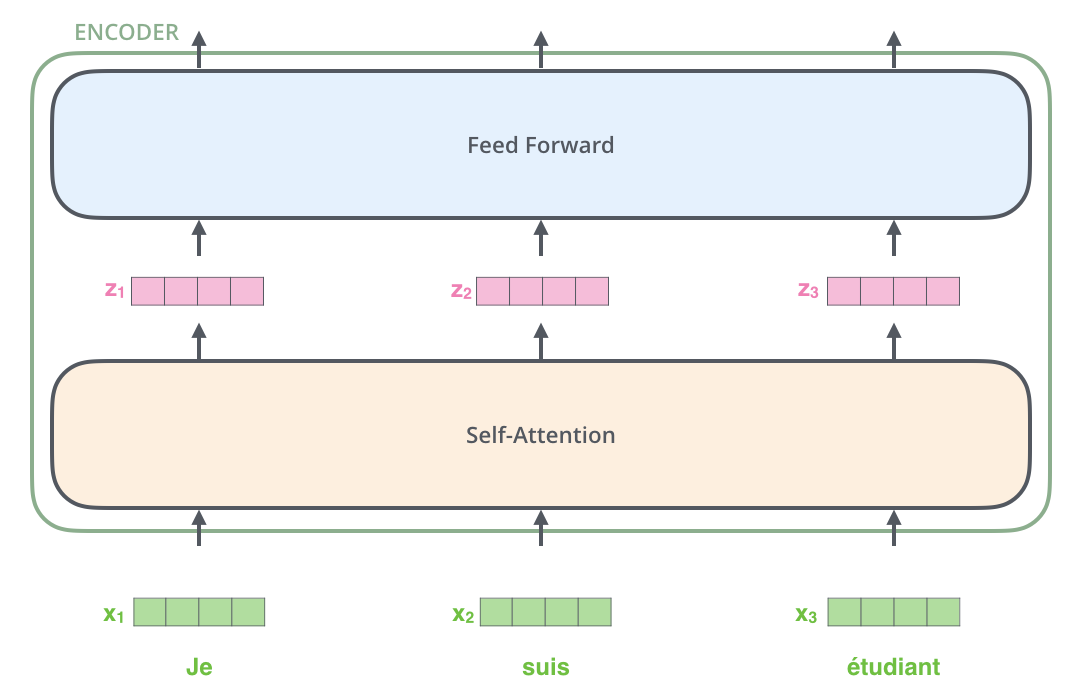
这里我们开始看到 Transformer 的一个关键特性:每个位置的词都沿着自己的路径流过编码器。在自注意力层中这些路径之间存在依赖关系。然而前馈层并没有这些依赖,因此各条路径可以在流经前馈层时并行执行。
接下来,我们会把例子换成一个更短的句子,并看看编码器的每个子层中发生了什么。
现在开始编码!
正如我们已经提到的,编码器接收一个向量列表作为输入。它把这些向量传入一个自注意力层,再传入一个前馈神经网络,然后把输出向上发送给下一个编码器。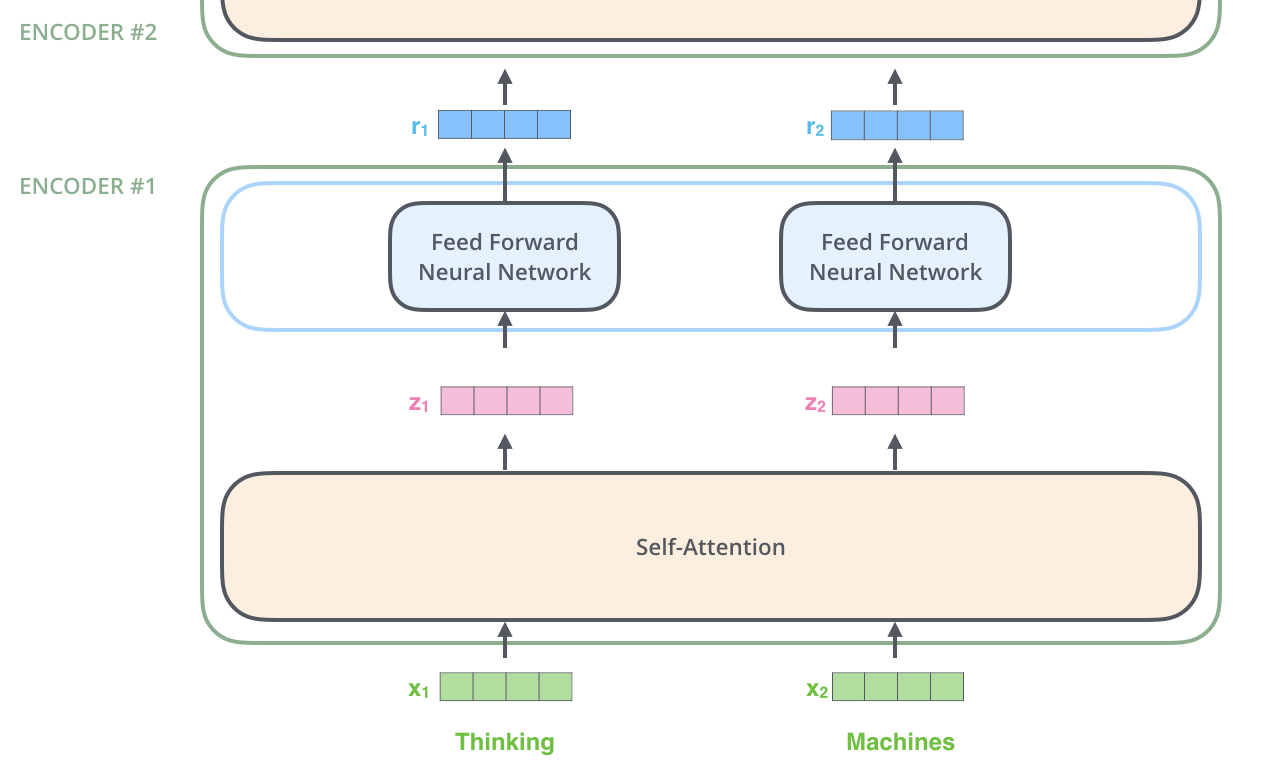
每个位置的词都会经过一个自注意力过程。然后,它们各自经过一个前馈神经网络 —— 完全相同的网络,每个向量分别独立地流过它。
高层理解自注意力
别被我随口抛出「自注意力(self-attention)」这个词所迷惑,搞得好像它是一个人人都该熟悉的概念一样。我个人在读《Attention is All You Need》这篇论文之前从未接触过这个概念。让我们来提炼一下它是如何运作的。
假设下面这句话是我们想要翻译的输入句子:
「The animal didn't cross the street because it was too tired」
(那只动物没有过马路,因为它太累了。)
这句话中的 「it」 指的是什么?是指 「street」(马路)还是 「animal」(动物)?对人类来说这是个简单的问题,但对算法来说就没那么简单了。
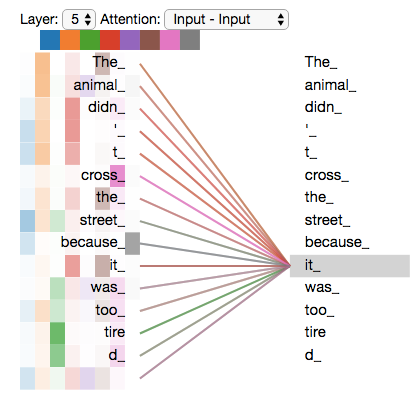
当模型在处理单词 「it」 时,自注意力允许它把 「it」 与 「animal」 关联起来。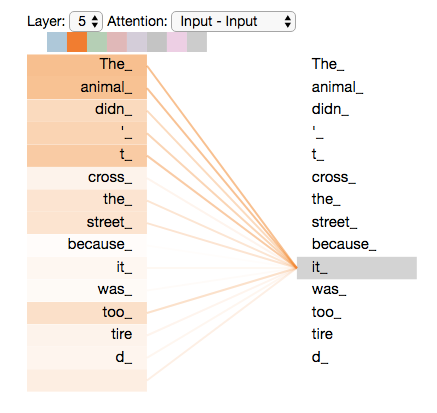
当我们在第 5 个编码器(堆栈最顶层的编码器)中编码单词 「it」 时,注意力机制的一部分聚焦在 「The Animal」 上,并把它的部分表示融入到了 「it」 的编码中。
当模型处理每个词(输入序列中的每个位置)时,自注意力允许它查看输入序列中的其他位置以寻找线索,从而帮助得到该词更好的编码。
如果你熟悉 RNN,可以回想一下:维护一个隐藏状态如何让 RNN 把它对已处理过的先前词/向量的表示与当前正在处理的那个融合在一起。自注意力就是 Transformer 用来把其他相关词的「理解」融入到当前正在处理的词中的方法。
请务必试试 Tensor2Tensor notebook,你可以在其中加载一个 Transformer 模型,并使用这种交互式可视化来考察它。
自注意力详解
让我们先看看如何用向量计算自注意力,然后再看它实际上是如何用矩阵实现的。
计算自注意力的 第一步,是从编码器的每个输入向量(这里就是每个词的嵌入)创建出三个向量。也就是说,对于每个词,我们创建一个查询向量(Query)、一个键向量(Key)和一个值向量(Value)。这些向量是通过把嵌入乘以三个在训练过程中训练得到的矩阵来创建的。
注意,这些新向量的维度比嵌入向量要小。它们的维度是 64,而嵌入以及编码器的输入/输出向量维度是 512。它们并不一定非要更小,这是一种架构选择,目的是让多头注意力的计算量(基本)保持恒定。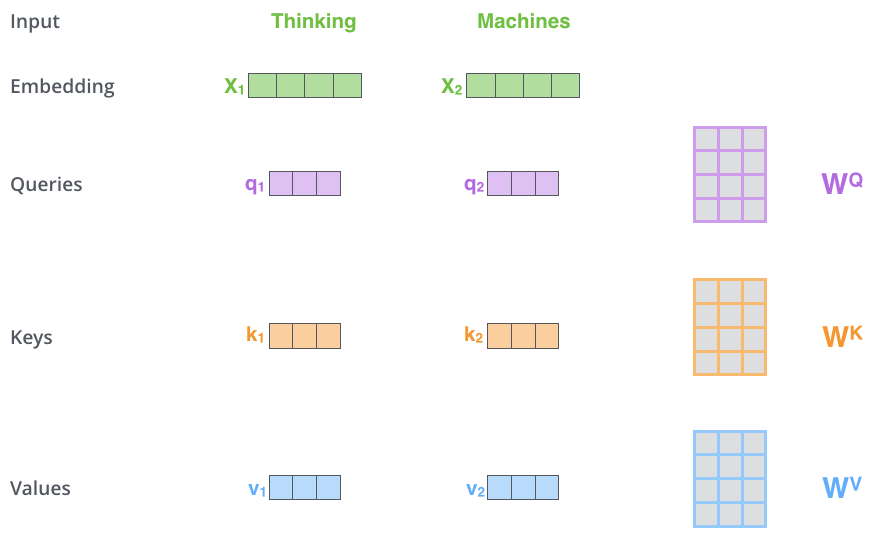
把
x1乘以WQ权重矩阵得到q1,即与该词相关联的「查询」向量。我们最终为输入句子中的每个词都创建一个「查询」、「键」和「值」投影。
那「查询」、「键」、「值」向量到底是什么?它们是抽象概念,对于计算和思考注意力非常有用。一旦你继续往下读看到注意力是如何计算的,你就会差不多了解这些向量各自扮演的角色了。
计算自注意力的 第二步 是计算一个分数。假设我们在为这个例子中的第一个词「Thinking」计算自注意力。我们需要对输入句子中的每个词针对当前这个词打分。这个分数决定了在编码某个位置的词时,要对输入句子其他部分投入多少关注。
分数的计算方式是:拿查询向量与我们要打分的那个词的键向量做点积。所以如果我们在为位置 #1 的词计算自注意力,第一个分数就是 q1 和 k1 的点积。第二个分数就是 q1 和 k2 的点积。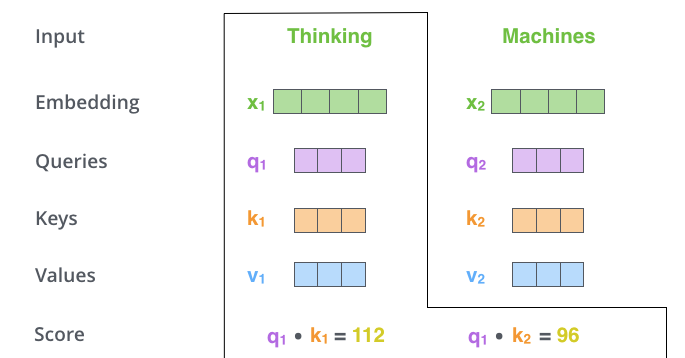
第三步和第四步 是把分数除以 8(论文中使用的键向量维度的平方根 —— 64 的平方根。这能让梯度更稳定。这里也可以用其他值,但这是默认值),然后把结果通过一个 softmax 运算。softmax 把这些分数归一化,使它们全部为正数且加起来等于 1。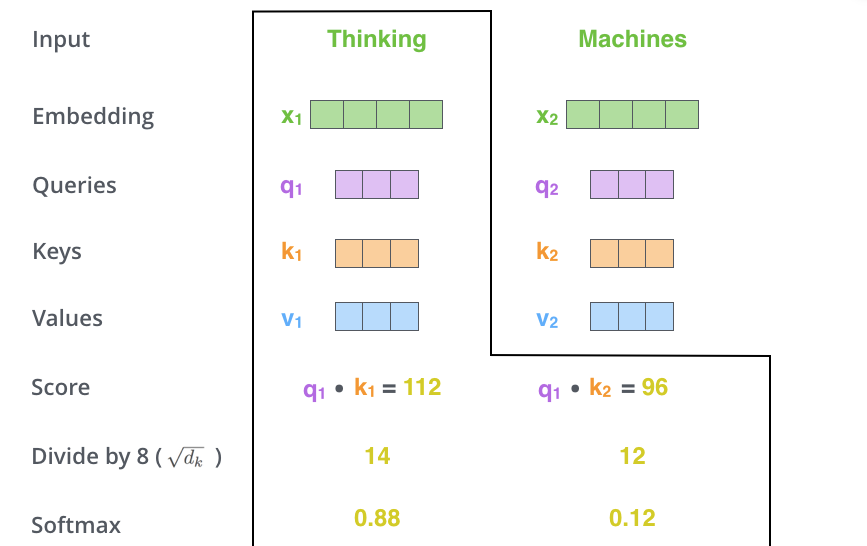
这个 softmax 分数决定了每个词在这个位置上会被「表达」多少。显然,这个位置上的词本身会有最高的 softmax 分数,但有时关注与当前词相关的另一个词也是有用的。
第五步 是把每个值向量乘以 softmax 分数(为把它们相加做准备)。这里的直觉是:保留我们想要聚焦的词的值不变,而把无关的词「淹没」掉(例如把它们乘以 0.001 这样很小的数)。
第六步 是把加权后的值向量求和。这就得到了该位置(第一个词)上自注意力层的输出。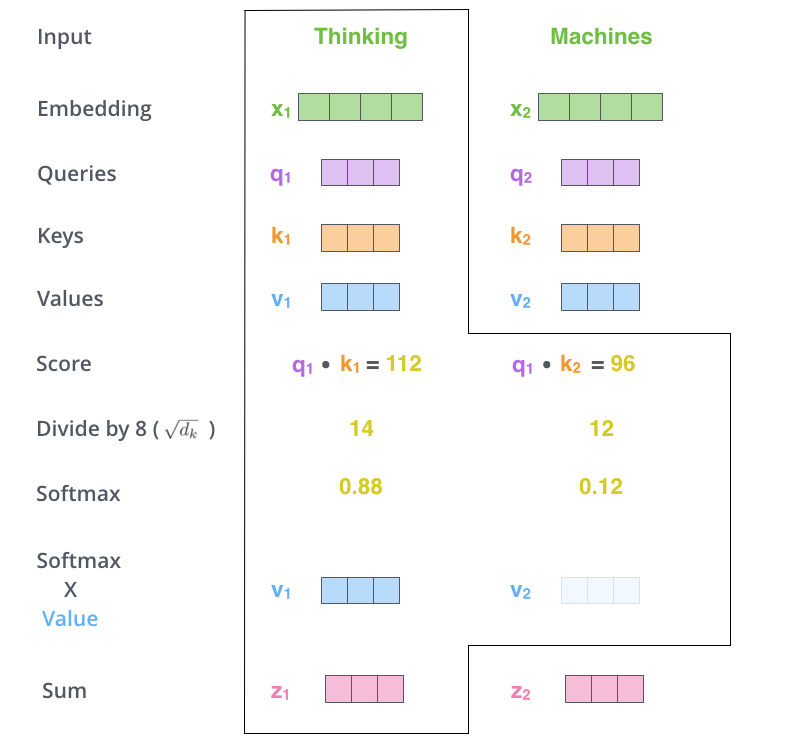
至此自注意力计算就结束了。得到的这个向量就是我们可以送给前馈神经网络的向量。然而在具体实现中,这个计算是以矩阵形式进行的,以便更快地处理。既然我们已经从词级别看到了计算的直觉,那就来看看矩阵形式。
自注意力的矩阵计算
第一步 是计算 Query、Key 和 Value 矩阵。我们通过把嵌入打包成一个矩阵 X,并把它乘以我们训练得到的权重矩阵(WQ、WK、WV)来实现。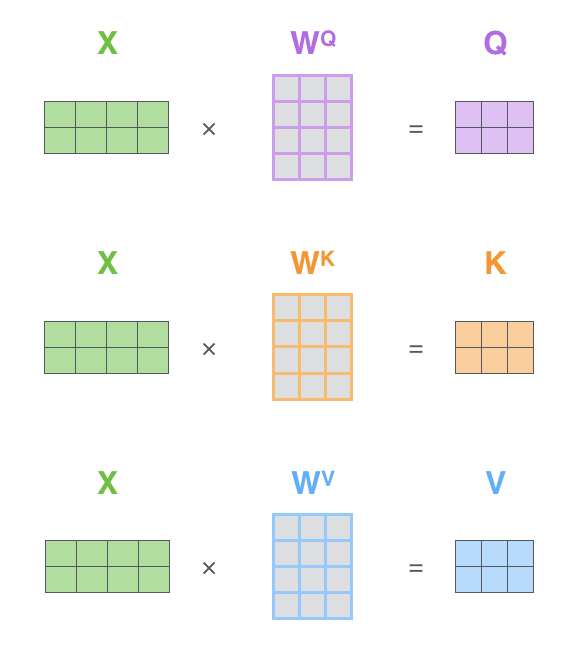
X矩阵中的每一行对应输入句子中的一个词。我们再次看到嵌入向量(512 维,图中用 4 个方框表示)和 q/k/v 向量(64 维,图中用 3 个方框表示)在大小上的差异。
最后,既然我们处理的是矩阵,就可以把第二到第六步压缩成一个公式来计算自注意力层的输出。
自注意力的矩阵形式计算
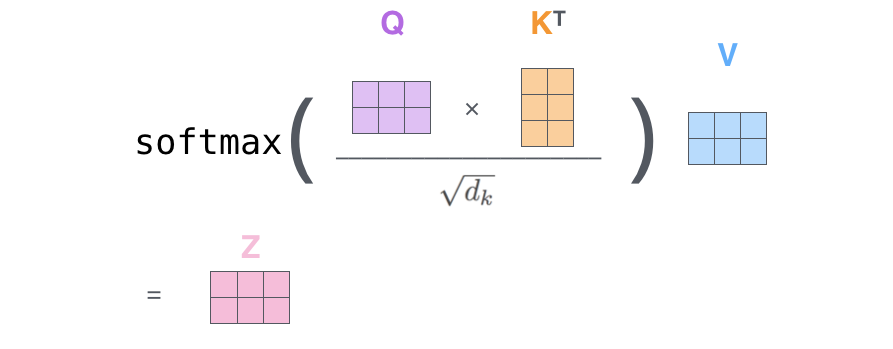
多头怪兽
论文通过引入一种叫做「多头(multi-headed)」注意力的机制进一步改进了自注意力层。它从两个方面提升了注意力层的性能:
- 它扩展了模型聚焦于不同位置的能力。是的,在上面的例子中,
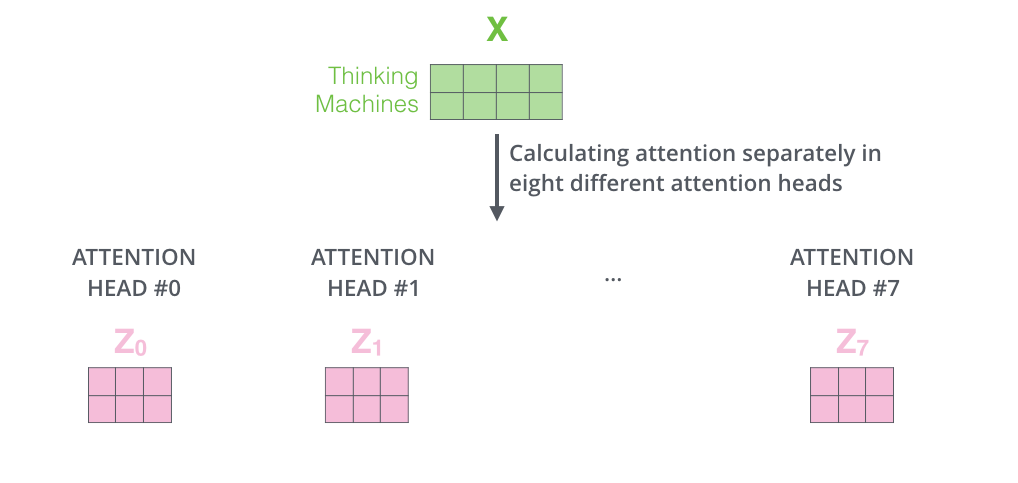
z1包含了一点点其他所有编码,但它可能被词本身所主导。如果我们翻译像「The animal didn't cross the street because it was too tired」这样的句子,知道「it」指代哪个词会很有用。 - 它给注意力层提供了多个「表示子空间」。接下来我们会看到,有了多头注意力,我们不仅有唯一一组 Query/Key/Value 权重矩阵,而是有多组(Transformer 使用 8 个注意力头,所以每个编码器/解码器最终有 8 组)。每一组都是随机初始化的。然后,在训练之后,每一组都被用来把输入嵌入(或来自更低层编码器/解码器的向量)投影到不同的表示子空间中。
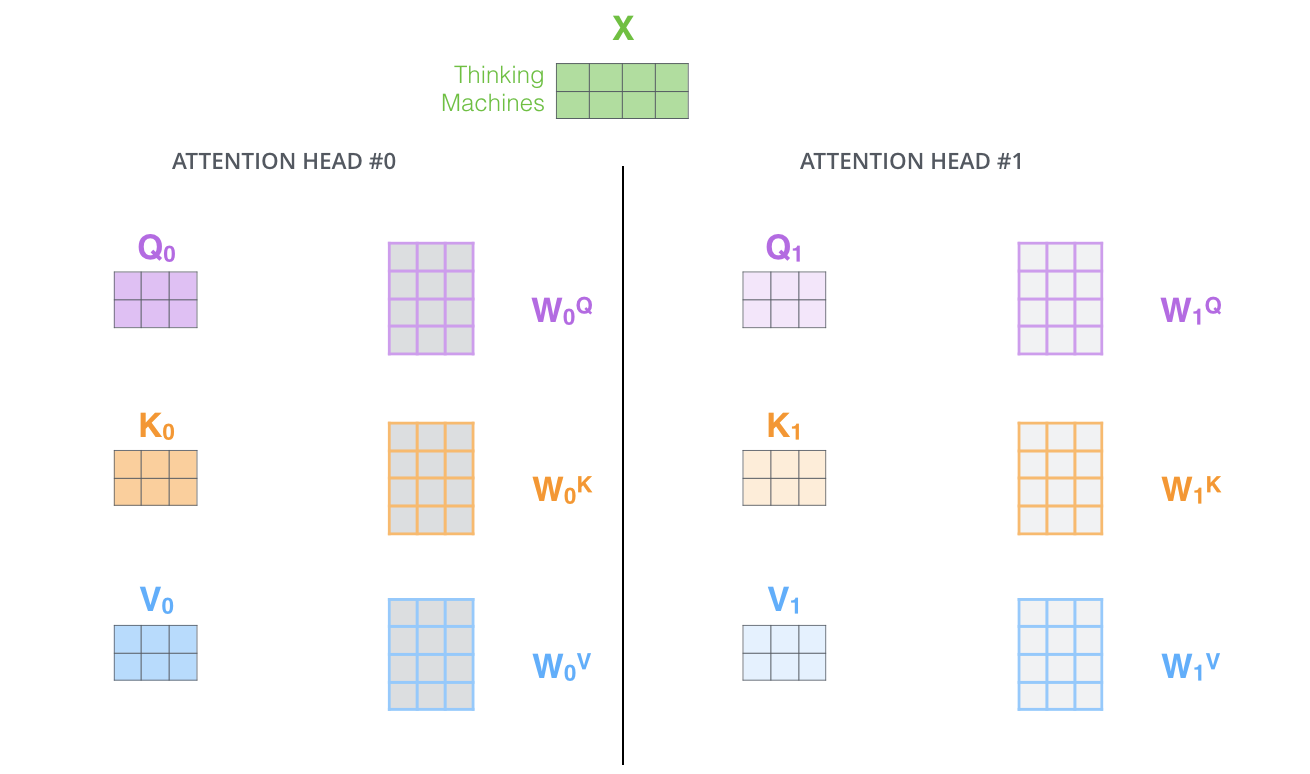
在多头注意力中,我们为每个头维护独立的 Q/K/V 权重矩阵,从而得到不同的 Q/K/V 矩阵。和之前一样,我们用
X乘以WQ/WK/WV矩阵来产生 Q/K/V 矩阵。
如果我们用上面概述的同样的自注意力计算,只是用不同的权重矩阵做 8 次,就会得到 8 个不同的 Z 矩阵。
这就给我们留下了一个小小的难题。前馈层并不期望接收 8 个矩阵 —— 它期望的是单个矩阵(每个词一个向量)。所以我们需要一种方法把这 8 个压缩成一个矩阵。
怎么做呢?我们把这些矩阵拼接(concat)起来,然后乘以一个额外的权重矩阵 WO。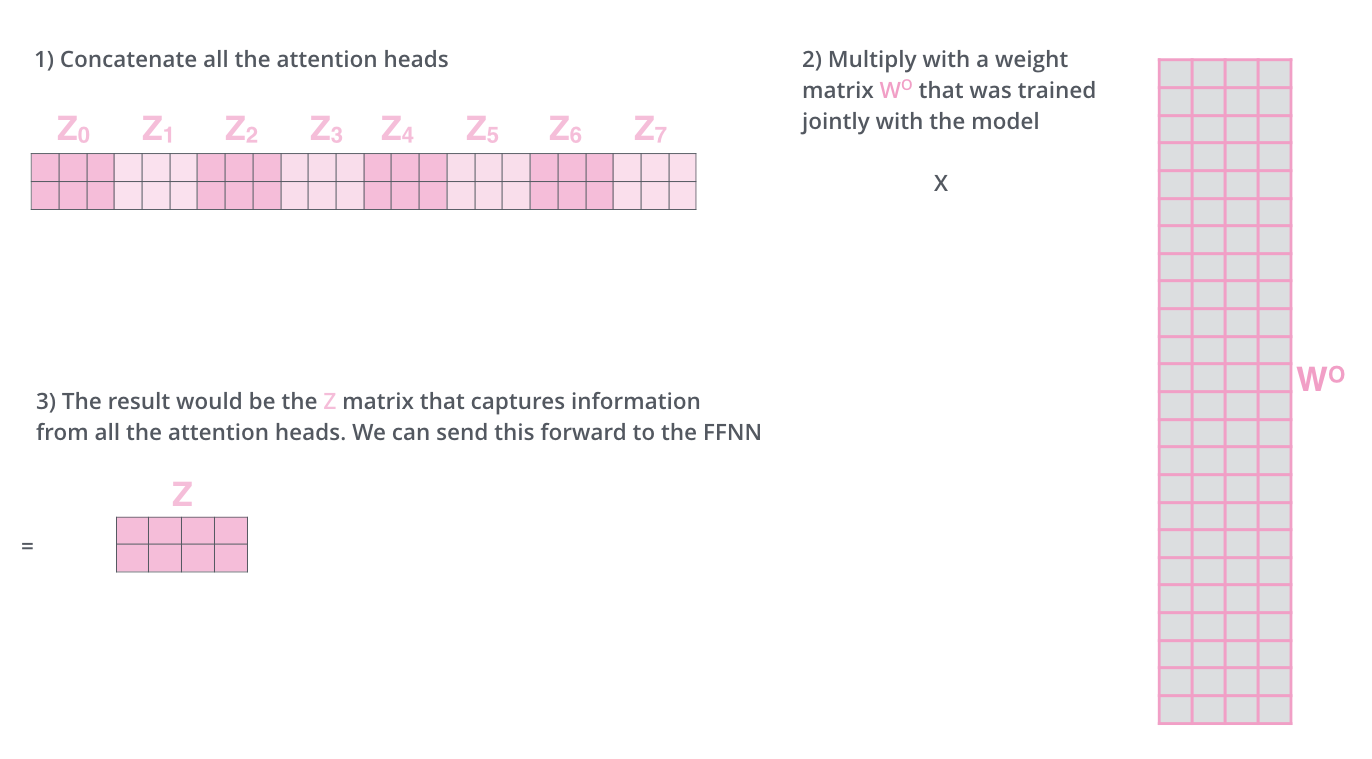
多头自注意力基本上就是这些了。我承认这确实是一大堆矩阵。让我尝试把它们全部放进一张图里,这样我们就可以在一个地方一起看: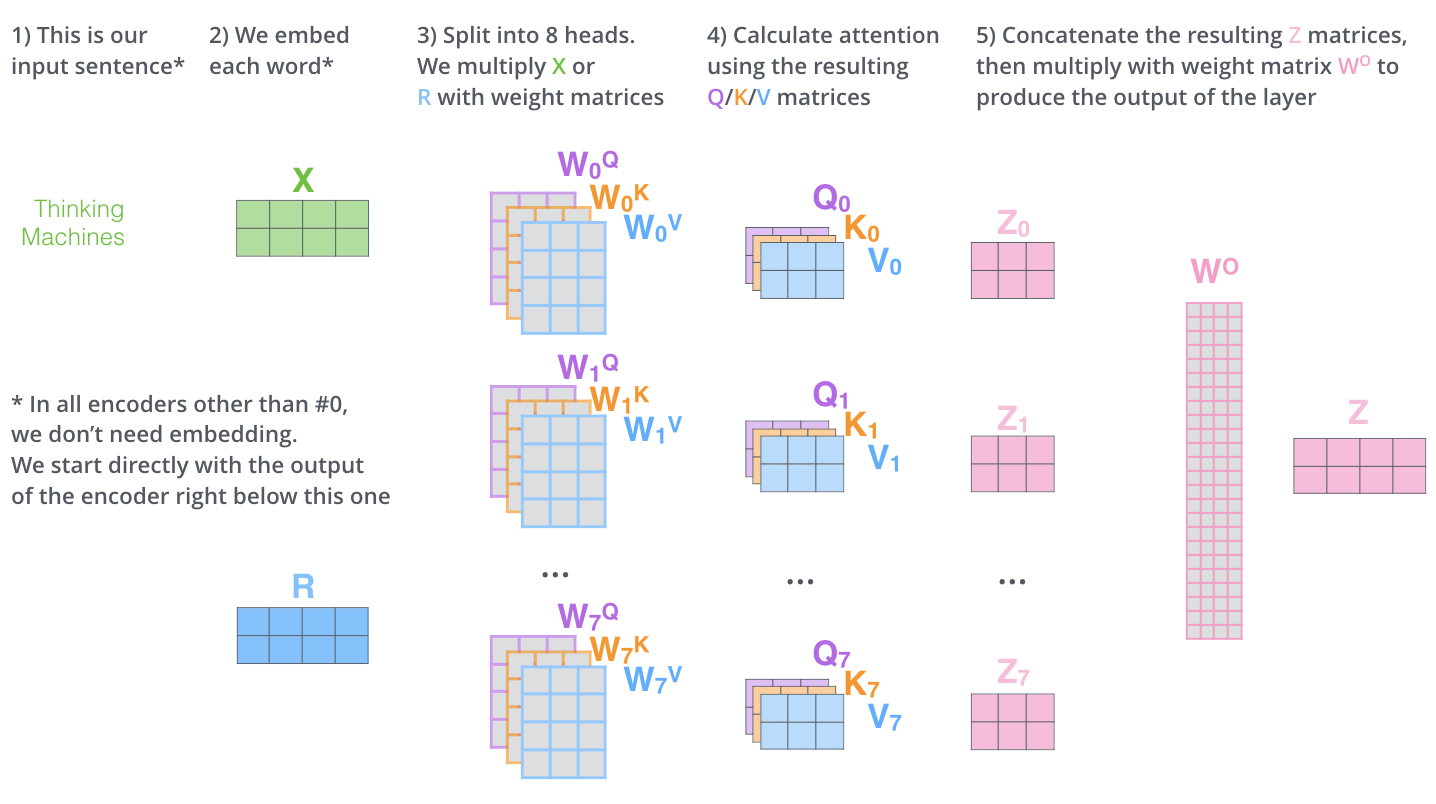
既然我们已经触及了注意力头,那就回到之前的例子,看看在编码例句中的词「it」时,不同的注意力头分别聚焦在哪里: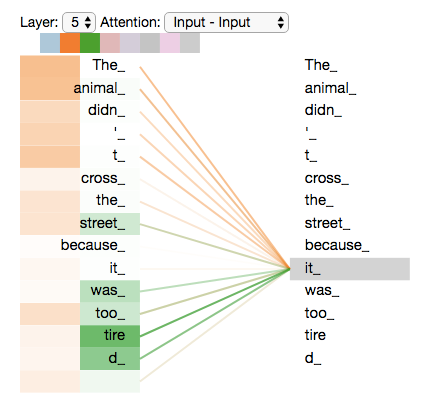
当我们编码单词「it」时,一个注意力头主要聚焦在「the animal」上,而另一个聚焦在「tired」上 —— 在某种意义上,模型对「it」这个词的表示里融入了「animal」和「tired」两者的一部分表示。
然而,如果我们把所有注意力头都加到图里,事情可能就难以解释了:
用位置编码表示序列的顺序
到目前为止,在我们描述的模型中,还缺少一种解释输入序列中词序的方式。
为了解决这个问题,Transformer 给每个输入嵌入加上一个向量。这些向量遵循一个特定的模式,模型会学习这种模式,从而帮助它确定每个词的位置,或序列中不同词之间的距离。这里的直觉是:把这些值加到嵌入上之后,一旦嵌入被投影成 Q/K/V 向量并在点积注意力中被使用,嵌入向量之间就会具有有意义的距离。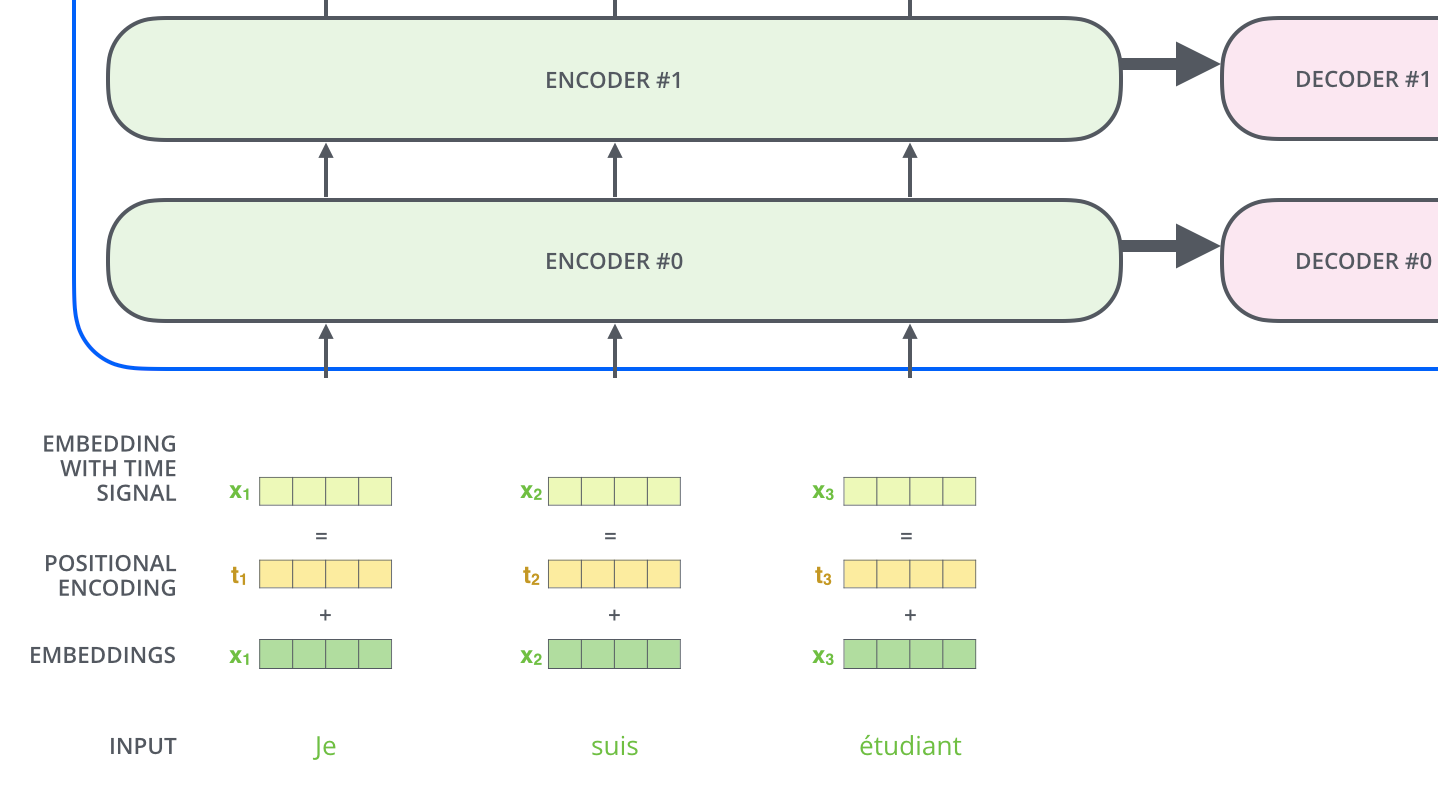
为了给模型一种词序的感觉,我们加上位置编码向量 —— 这些向量的值遵循一个特定的模式。
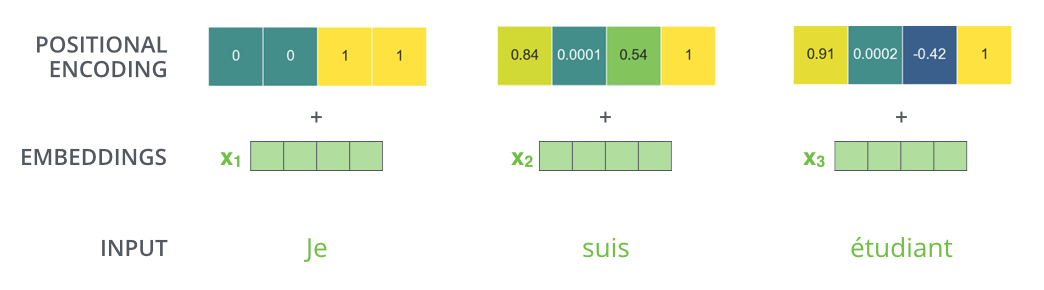
如果我们假设嵌入的维度是 4,那么真实的位置编码看起来会是这样的:
一个真实的位置编码示例,玩具嵌入大小为 4
这个模式可能长什么样呢?
在下图中,每一行对应一个向量的位置编码。所以第一行就是我们会加到输入序列第一个词嵌入上的那个向量。每一行包含 512 个值 —— 每个值都在 1 到 -1 之间。我们用颜色对它们进行了编码,使模式可见。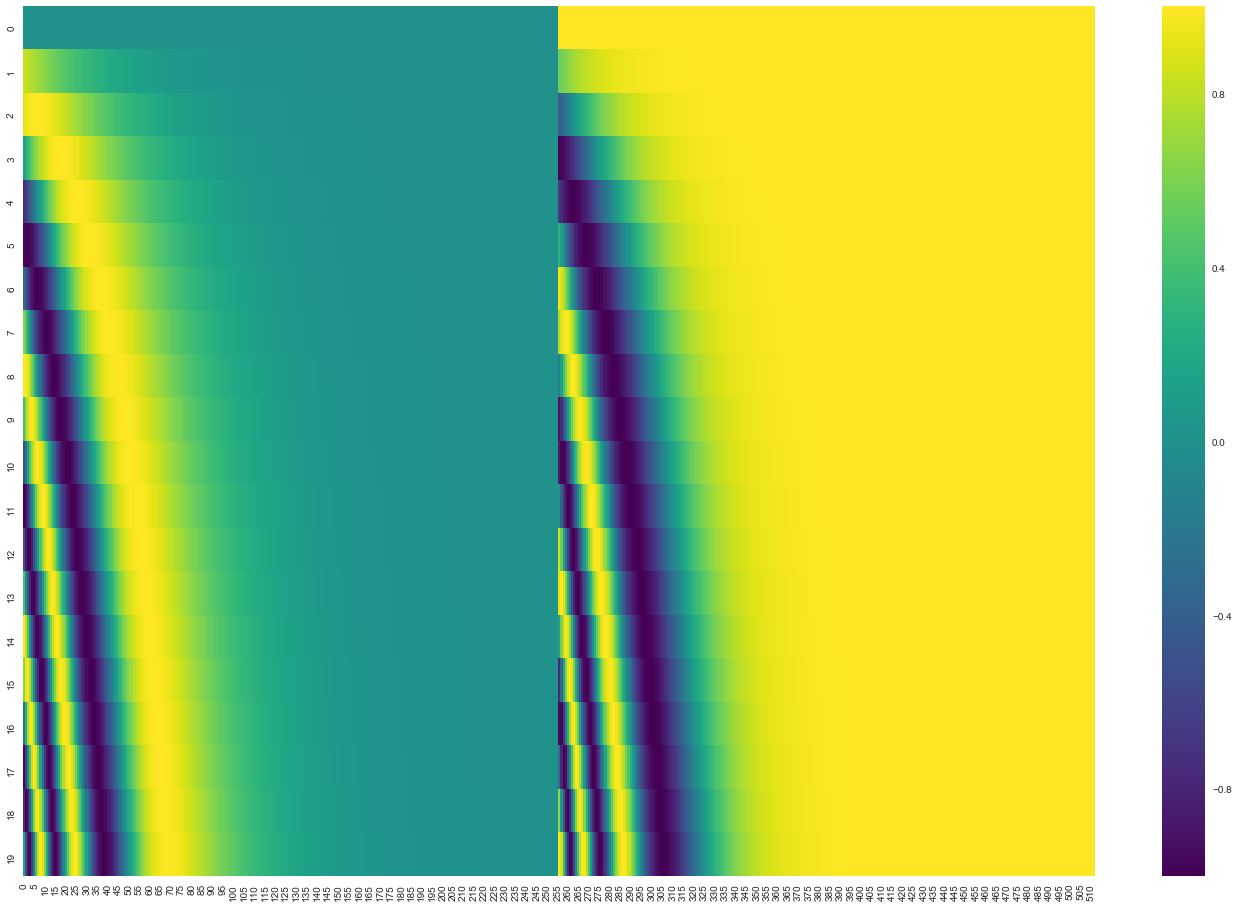
一个真实的位置编码示例,对应 20 个词(行),嵌入大小为 512(列)。你可以看到它似乎从中间被分成了两半。这是因为左半边的值由一个函数(使用正弦)生成,而右半边由另一个函数(使用余弦)生成。然后它们被拼接起来形成每个位置编码向量。
位置编码的公式在论文中(3.5 节)有描述。你可以在 get_timing_signal_1d() 中看到生成位置编码的代码。这不是位置编码唯一可能的方法。然而,它具有能够扩展到未见过的序列长度的优势(例如,如果我们训练好的模型被要求翻译一个比训练集中任何句子都长的句子)。
2020 年 7 月更新:
上面展示的位置编码来自 Transformer 的 Tensor2Tensor 实现。论文中展示的方法略有不同:它不直接拼接,而是把两个信号交织(interweave)在一起。下图展示了它的样子。这里是生成它的代码: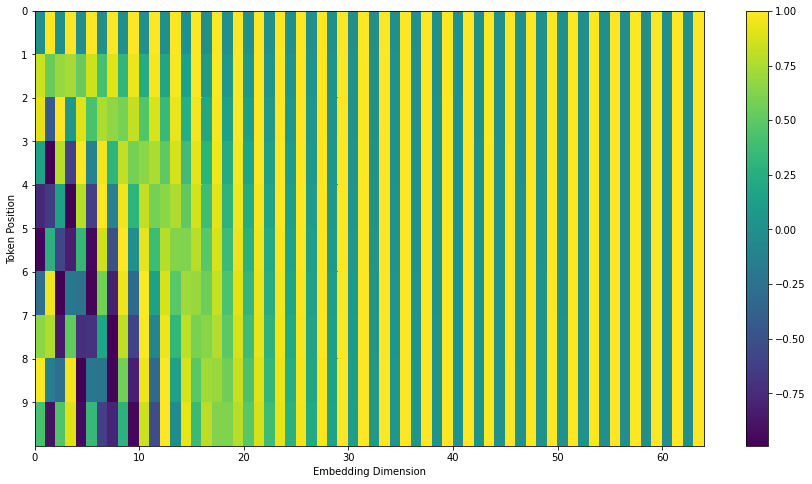
残差连接
在继续之前,我们需要提及编码器架构中的一个细节:编码器中的每个子层(自注意力、ffnn)周围都有一个 残差连接(residual connection),其后还跟着一个 层归一化(layer-normalization) 步骤。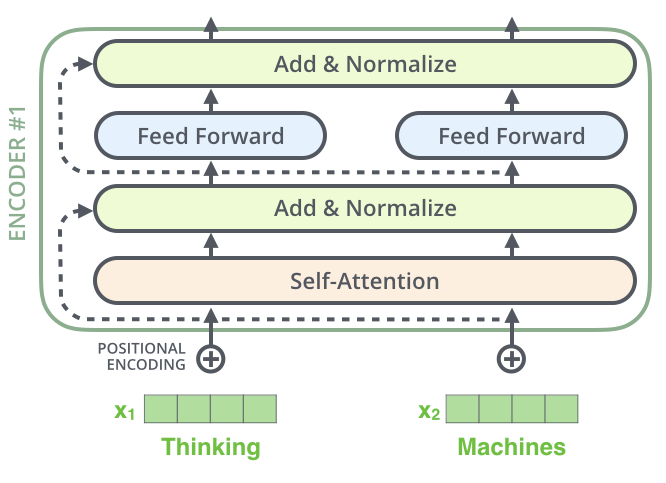
如果我们把与自注意力相关的向量和层归一化操作可视化出来,它看起来会是这样: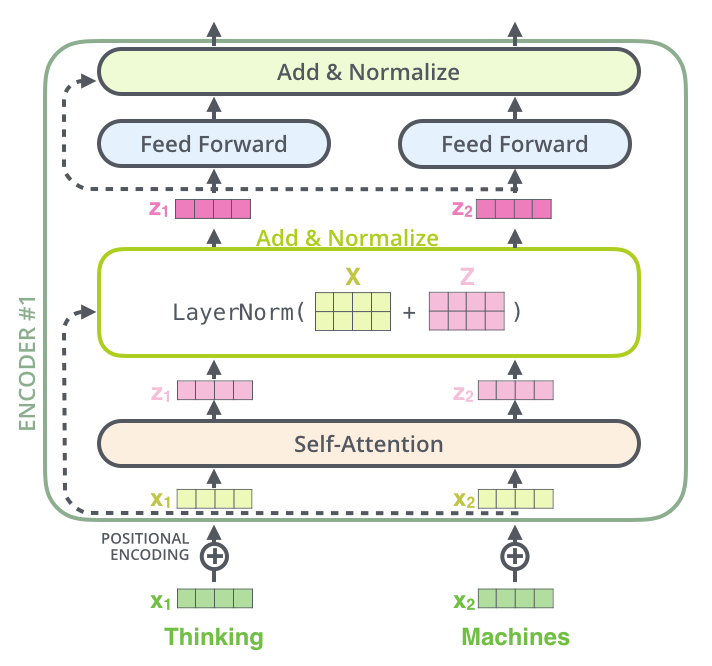
解码器的子层也同样如此。如果我们设想一个由 2 个堆叠的编码器和解码器组成的 Transformer,它看起来会是这样: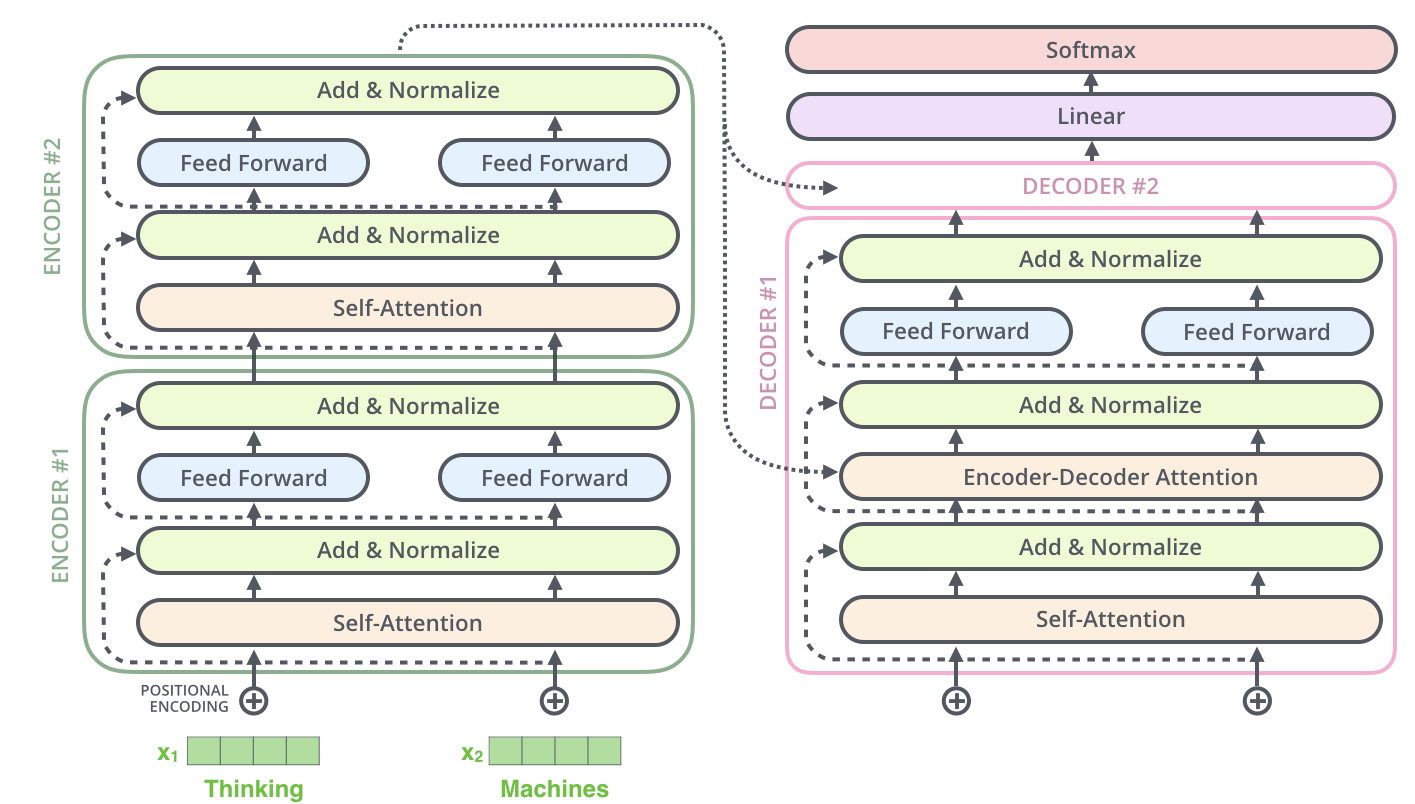
解码器一侧
既然我们已经覆盖了编码器一侧的大部分概念,我们基本上也就了解了解码器的组件是如何工作的。但让我们看看它们是如何协同工作的。
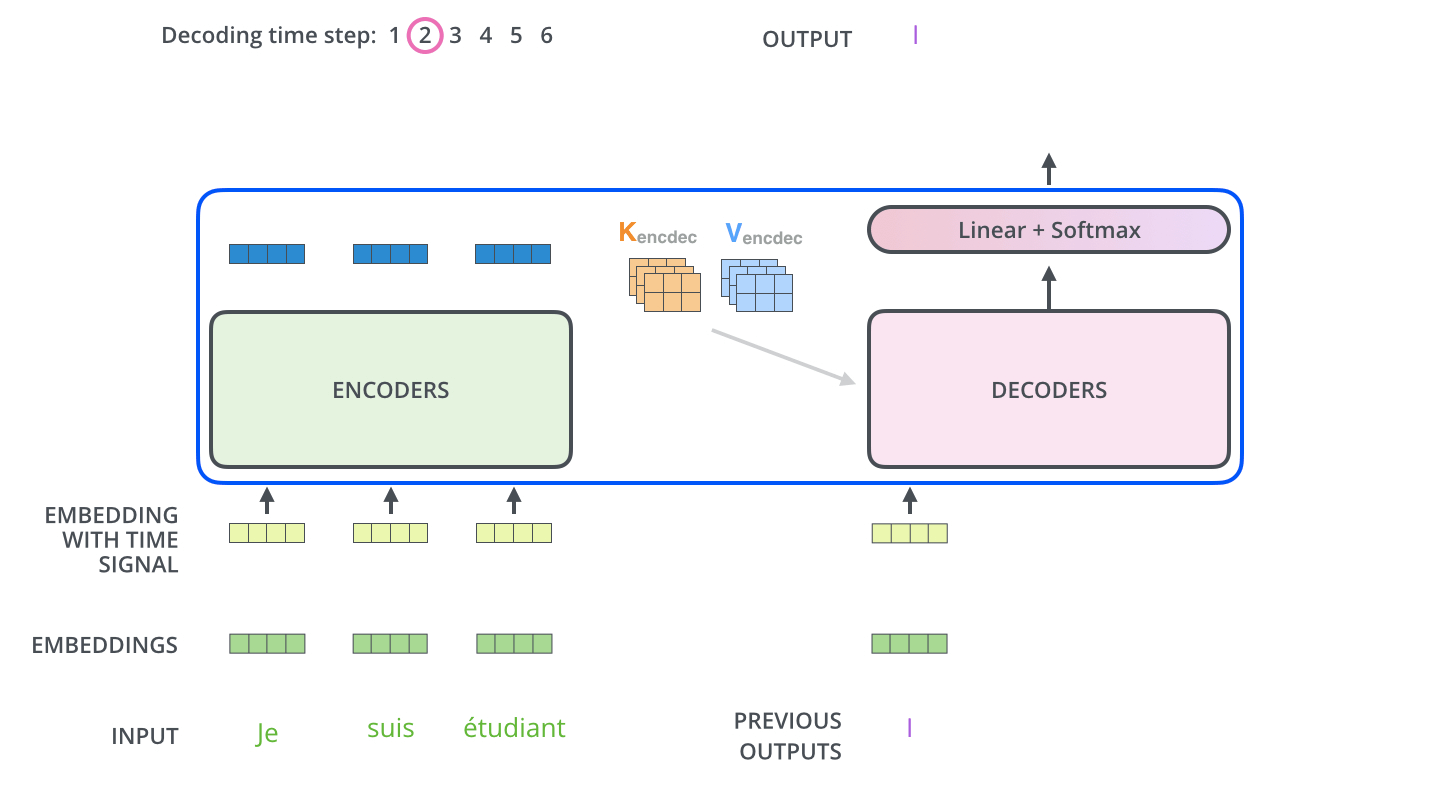
编码器先处理输入序列。最顶层编码器的输出随后被转换成一组注意力向量 K 和 V。这些向量将被每个解码器在其「编码器-解码器注意力」层中使用,帮助解码器聚焦于输入序列中合适的位置: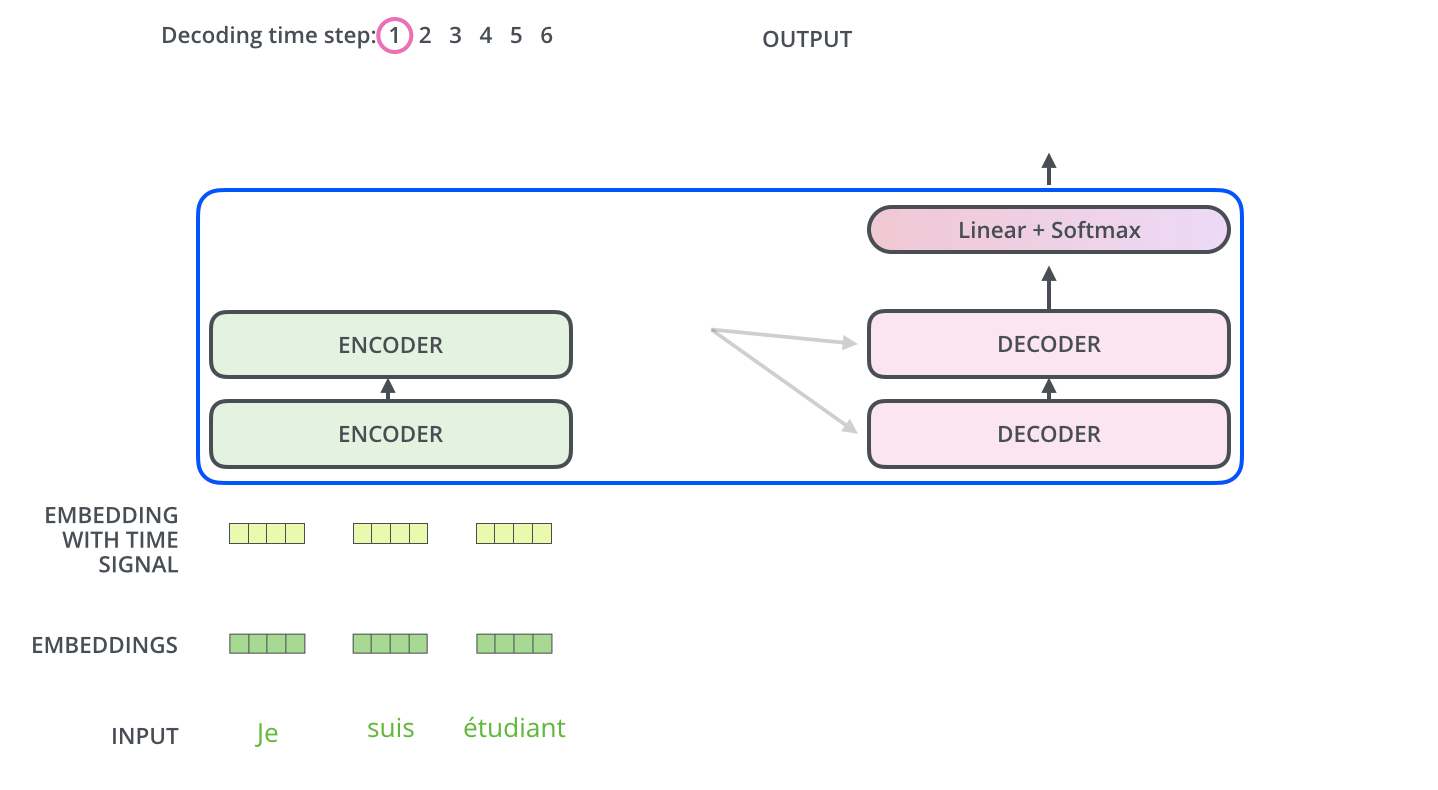
完成编码阶段后,我们开始解码阶段。解码阶段的每一步都会输出输出序列中的一个元素(这里就是英文翻译句子)。
接下来的步骤会重复这一过程,直到遇到一个特殊的<end of sentence>符号,表示 transformer 解码器已经完成输出。每一步的输出会被送入下一个时间步的最底层解码器,解码器们像编码器那样把解码结果向上传递。和我们对编码器输入所做的一样,我们对这些解码器输入进行嵌入并加上位置编码,以指明每个词的位置。
⚽
(这块大家可以去看原文,本质是个动图 https://jalammar.github.io/illustrated-transformer/)
解码器中的自注意力层运作方式与编码器中的略有不同:
在解码器中,自注意力层只允许关注输出序列中较早的位置。这是通过在自注意力计算的 softmax 步骤之前屏蔽未来位置(把它们设为 -inf)来实现的。
「编码器-解码器注意力」层的工作方式与多头自注意力完全相同,只是它从其下方的层创建自己的 Queries 矩阵,并从编码器堆栈的输出中获取 Keys 和 Values 矩阵。
最终的 Linear 和 Softmax 层
解码器堆栈输出一个浮点数向量。我们如何把它变成一个词?这就是最后的 Linear 层的工作,其后跟着一个 Softmax 层。
Linear 层是一个简单的全连接神经网络,它把解码器堆栈产生的向量投影成一个更大得多的向量,称为 logits 向量。
假设我们的模型认识 10,000 个独特的英文单词(我们模型的「输出词表」),这些是它从训练数据集中学到的。这会让 logits 向量有 10,000 个单元格宽 —— 每个单元格对应一个独特单词的分数。这就是我们解释模型在 Linear 层之后的输出的方式。
softmax 层接着把这些分数转换成概率(全部为正数,全部加起来等于 1.0)。概率最高的那个单元格被选中,与之关联的词就作为这个时间步的输出。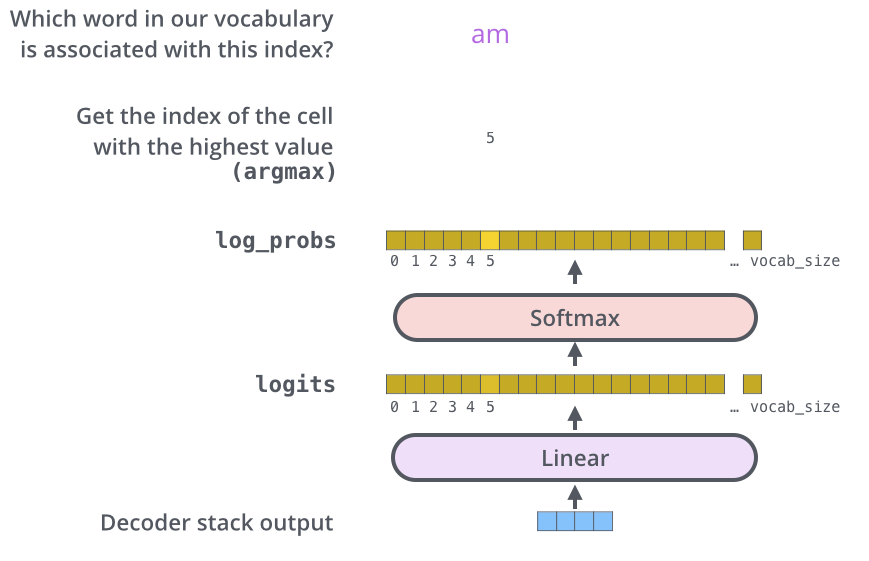
这张图从底部开始,以解码器堆栈输出的向量开始。它随后被转换成一个输出词。
训练回顾
既然我们已经走完了一个已训练 Transformer 的整个前向传播过程,那瞥一眼训练这个模型的直觉会很有帮助。
在训练期间,一个未训练的模型会经历完全相同的前向传播。但由于我们是在一个有标签的训练数据集上训练它,我们可以把它的输出与实际正确的输出进行比较。
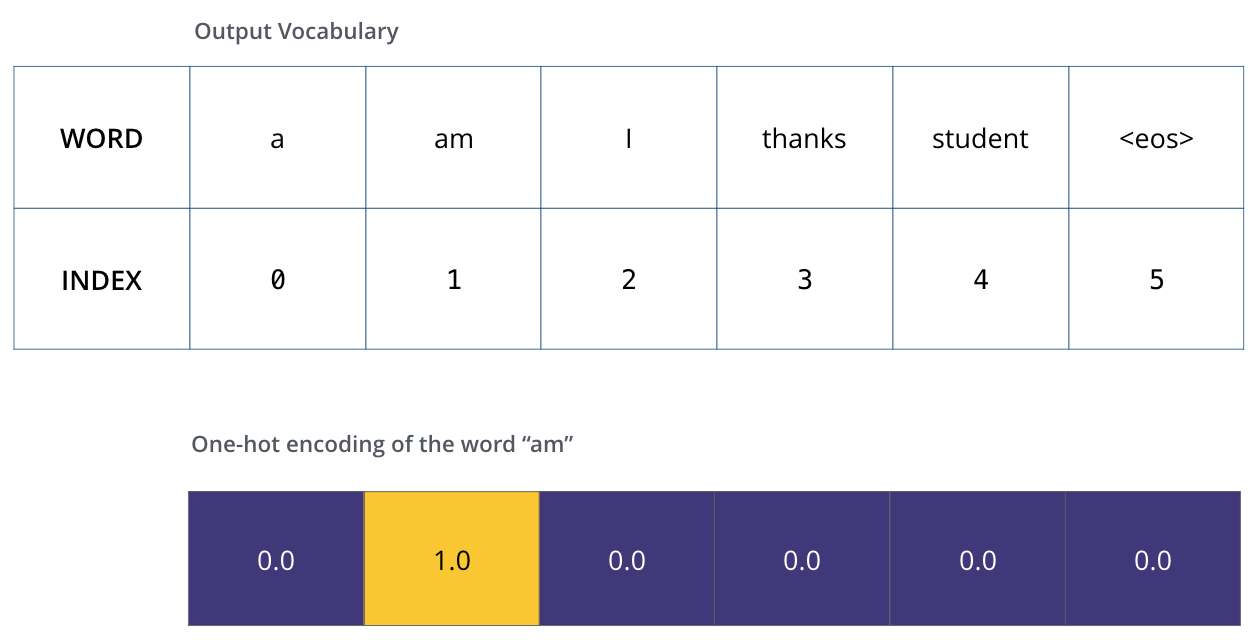
为了把这个可视化,让我们假设我们的输出词表只包含六个词(「a」、「am」、「i」、「thanks」、「student」,以及 <eos>(end of sentence 的缩写))。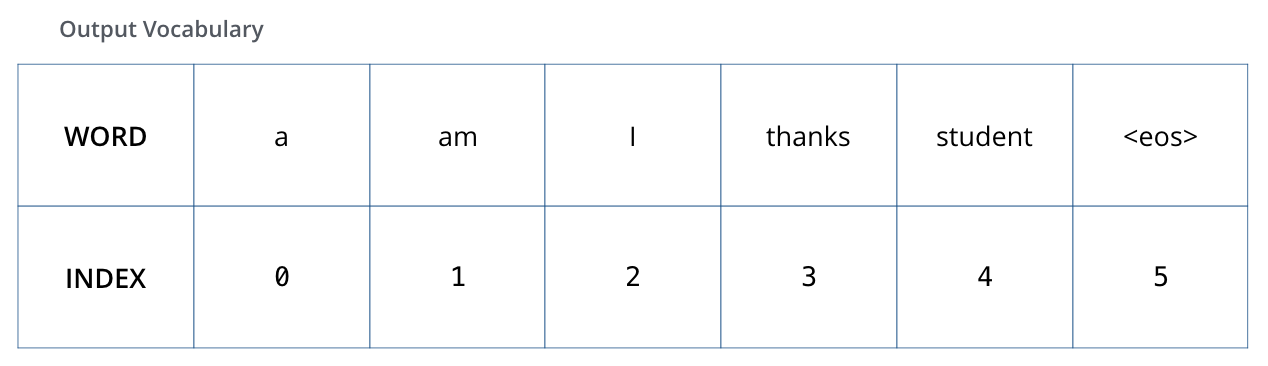
我们模型的输出词表是在我们甚至开始训练之前的预处理阶段创建的。
一旦我们定义了输出词表,我们就可以用一个相同宽度的向量来表示词表中的每个词。这也被称为 one-hot 编码。所以例如,我们可以用下面的向量来表示单词「am」:
示例:我们输出词表的 one-hot 编码
回顾完这些,让我们讨论一下模型的损失函数 —— 我们在训练阶段优化以得到一个训练好的、希望惊人地准确的模型的指标。
损失函数
假设我们正在训练我们的模型。假设这是训练阶段的第一步,我们正在一个简单的例子上训练它 —— 把「merci」翻译成「thanks」。
这意味着我们希望输出是一个表示单词「thanks」的概率分布。但由于这个模型还没训练好,这暂时不太可能发生。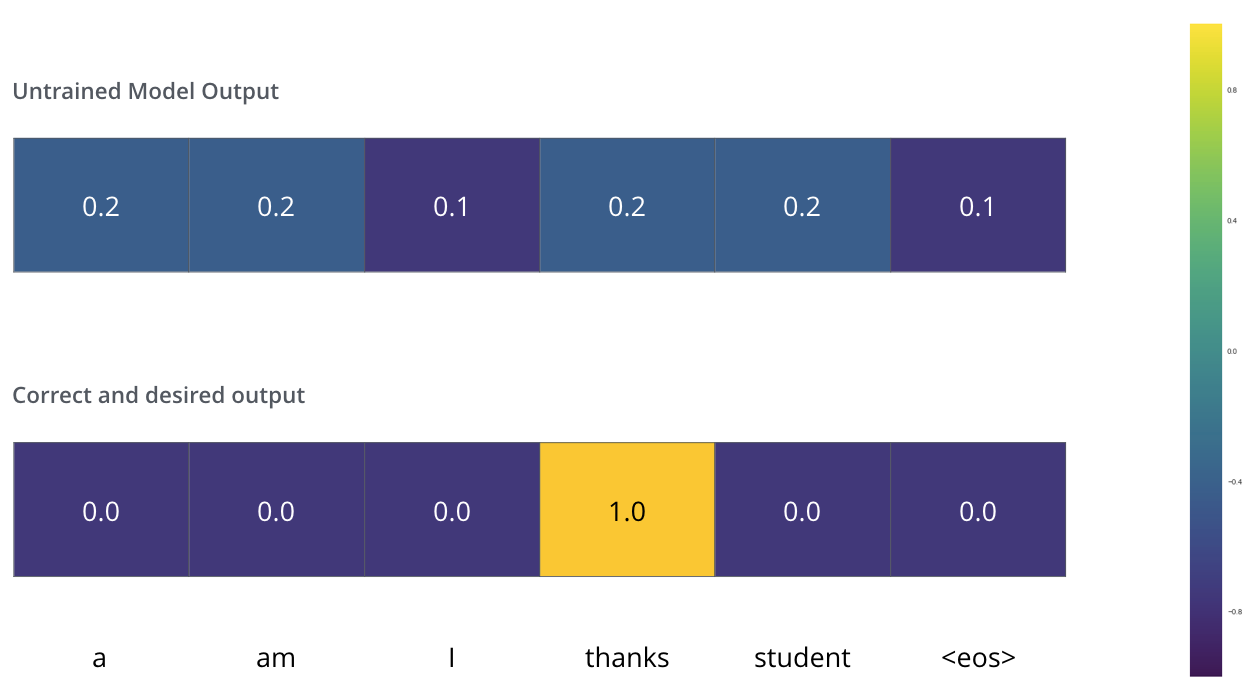
由于模型的参数(权重)都是随机初始化的,(未训练的)模型产生一个对每个单元格/词具有任意值的概率分布。我们可以把它与实际输出进行比较,然后用反向传播调整模型所有的权重,使输出更接近期望的输出。
如何比较两个概率分布?我们简单地用一个减去另一个。更多细节,请看 交叉熵(cross-entropy) 和 Kullback–Leibler 散度。
但请注意这是一个过度简化的例子。更现实地,我们会使用一个长于一个词的句子。例如 —— 输入:「je suis étudiant」和期望输出:「i am a student」。这真正意味着,我们希望我们的模型相继输出概率分布,其中:
- 每个概率分布由一个宽度为 vocab_size 的向量表示(在我们的玩具例子中是 6,但更现实的是一个像 30,000 或 50,000 的数字)
- 第一个概率分布在与单词「i」关联的单元格处具有最高概率
- 第二个概率分布在与单词「am」关联的单元格处具有最高概率
- 以此类推,直到第五个输出分布表示
<end of sentence>符号,它在 10,000 元素的词表中也有一个关联的单元格。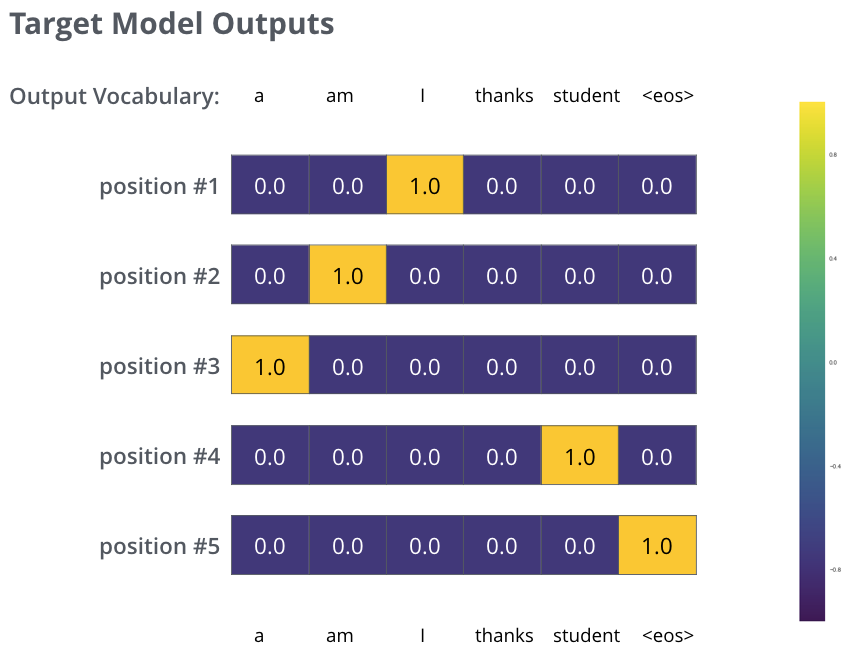
在一个样本句子的训练示例中,我们将训练模型去逼近的目标概率分布。
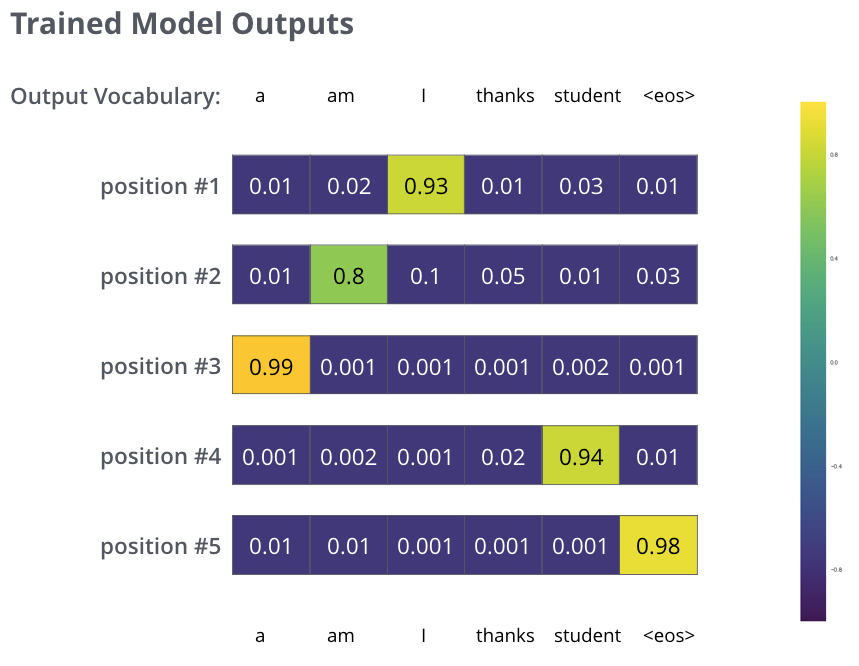
在足够大的数据集上训练足够长的时间后,我们希望产生的概率分布会是这样:
希望训练后,模型会输出我们期望的正确翻译。当然,这并不能真正说明这个短语是否是训练数据集的一部分(参见:交叉验证)。注意,即使某个位置不太可能是那个时间步的输出,它也会得到一点点概率 —— 这是 softmax 一个非常有用的性质,有助于训练过程。
现在,因为模型一次产生一个输出,我们可以假设模型从那个概率分布中选择概率最高的词,并丢弃其余的。这是一种做法(称为贪心解码,greedy decoding)。另一种做法是保留比如前两个词(例如「I」和「a」),然后在下一步中,运行模型两次:一次假设第一个输出位置是单词「I」,另一次假设第一个输出位置是单词「a」,并保留在考虑位置 #1 和 #2 两者时产生更少错误的那个版本。我们对位置 #2 和 #3 等重复这一过程。这种方法称为「束搜索(beam search)」,在我们的例子中,beam_size 为 2(意味着任何时候都保留两个部分假设(未完成的翻译)在内存中),top_beams 也是 2(意味着我们将返回两个翻译)。这两个都是你可以试验的超参数。
前进与变换
我希望你发现这是一个有用的起点,帮你打破对 Transformer 主要概念的陌生感。如果你想更深入,我建议接下来的步骤:
- 阅读 Attention Is All You Need 论文、Transformer 博客文章(Transformer: A Novel Neural Network Architecture for Language Understanding)以及 Tensor2Tensor 公告。
- 观看 Łukasz Kaiser 的演讲,他带你走过这个模型及其细节
- 玩一玩作为 Tensor2Tensor 仓库一部分提供的 Jupyter Notebook
- 探索 Tensor2Tensor 仓库。
后续工作: - Depthwise Separable Convolutions for Neural Machine Translation
- One Model To Learn Them All
- Discrete Autoencoders for Sequence Models
- Generating Wikipedia by Summarizing Long Sequences
- Image Transformer
- Training Tips for the Transformer Model
- Self-Attention with Relative Position Representations
- Fast Decoding in Sequence Models using Discrete Latent Variables
- Adafactor: Adaptive Learning Rates with Sublinear Memory Cost
阅读导航



