
Transformer Block 图解:多头注意力、FFN 与残差
第03章:从多头注意力到一层完整结构
图解 Transformer Block

前两章已经走完了 attention 的核心计算:一个 token 先用 Q 去匹配可见 token 的 K,得到分数;分数经过缩放、mask、softmax 变成权重;权重再去读取并混合 V,得到上下文向量。
第三章把视角往外拉一层:真实的 Transformer 里,attention 通常以 Multi-Head Attention 的形式出现。多个 head 会从不同表示子空间、不同位置关系里同时提取信息,然后把结果合并回来。attention 子层之后,token 还会经过 FFN、Residual、Norm 等模块,形成一层完整的 Transformer Block。
可以把一层 Block 理解成两次核心动作:先交流,再加工。Multi-Head Attention 让 token 之间交换上下文信息,这一步是横向操作;FFN / MLP 对每个 token 的表示做进一步加工,这一步是纵向操作;Residual 和 Norm 让这个过程在很多层堆叠时保持稳定。
原始 Transformer 论文里的 encoder layer 有两个子层:Multi-Head Self-Attention 和 position-wise Feed-Forward Network。每个子层周围都有 residual connection 和 layer normalization。而现代 LLM 的具体顺序和归一化方式常有变化,比如 pre-norm、RMSNorm、SwiGLU,但主线仍然是:attention 负责信息交互,MLP 负责逐位置加工,残差和归一化负责稳定深层网络。
一层 Transformer Block 的核心节奏是:先交换信息,再各自加工。
为什么需要 Multi-Head
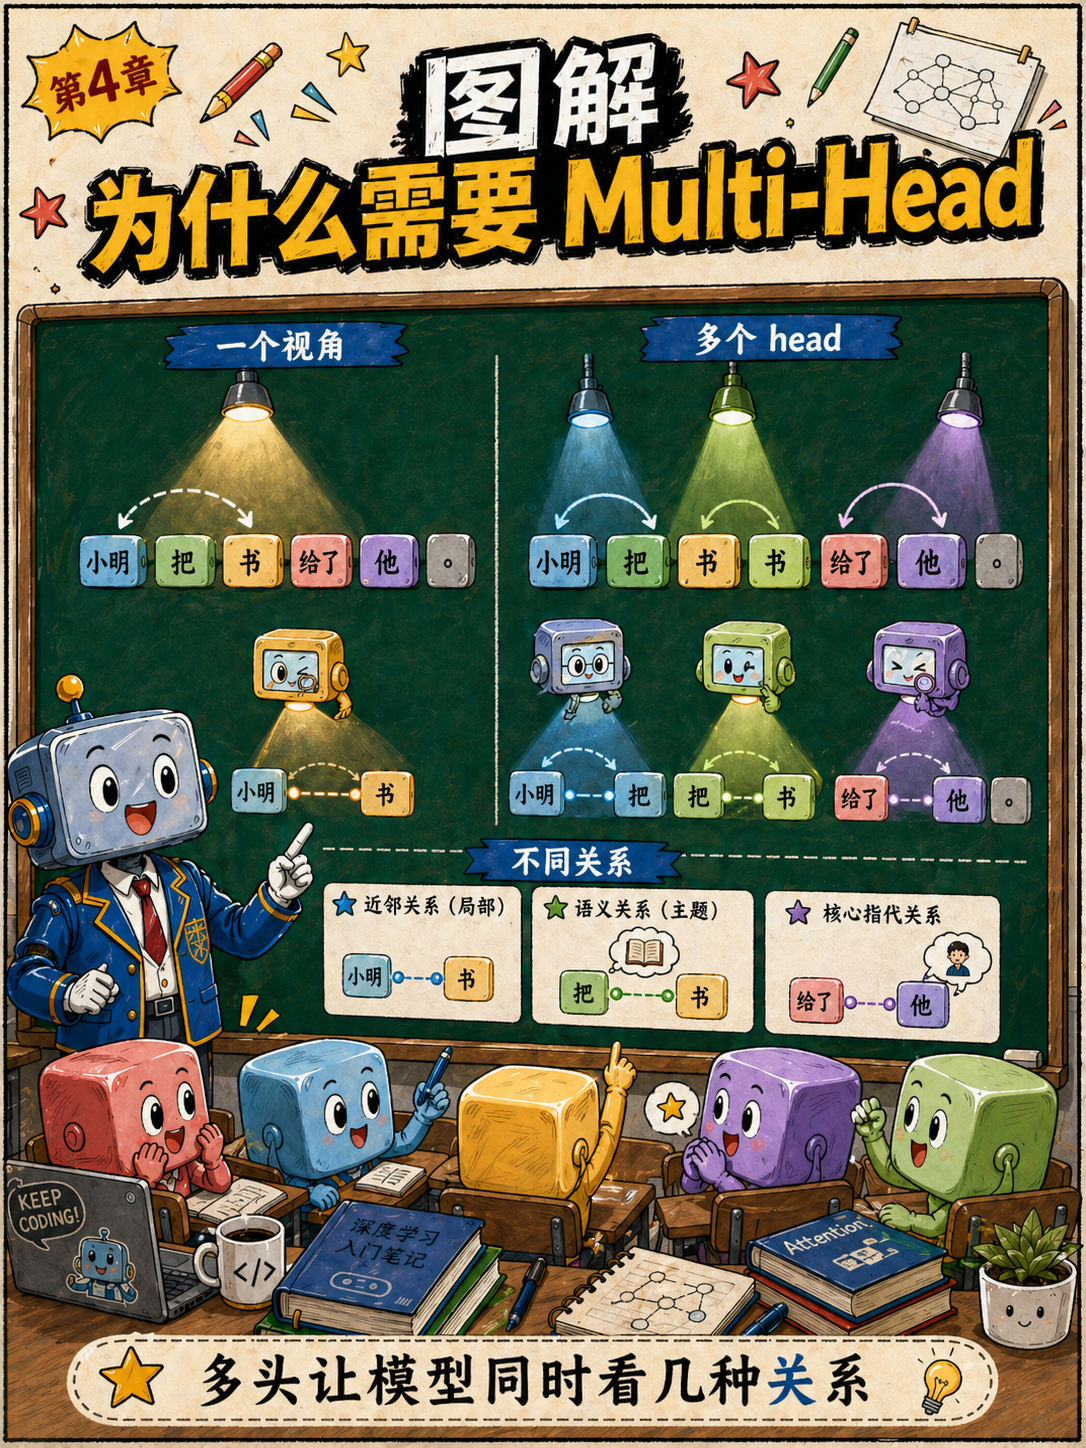
单头 attention 会为每个 token 产生一组注意力权重。这组权重可以表达一种关注分布:当前 token 该多看谁,少看谁。但是问题在于,一句话里的关系常常有很多种:相邻词关系、指代关系、修饰关系、语义相关关系,都可能同时有用。
Multi-Head Attention 的设计目标,是让模型在不同表示子空间里并行地做多次 attention。论文里的说法是:多头让模型能够同时关注不同位置、不同表示子空间里的信息。用课堂比喻讲,就是同一批 token 被分给几个讨论小组,每个小组从自己的角度观察同一句话。
这里要注意一下:某个 head 具体学到什么关系,是训练后形成的结果。它可能对局部词更敏感,也可能对远距离依赖更敏感,还可能呈现更复杂的模式。我们画“局部关系”“语义关系”,是在帮助建立直觉,真实模型里没有人手工规定 Head 1 必须负责局部、Head 2 必须负责语义。
多头带来的价值,是把一次注意力拆成多个并行视角。每个视角都能产生自己的上下文结果,最后再汇合成一个更丰富的表示。
Multi-Head 的核心价值是:让同一个 token 同时拥有多个观察上下文的角度。
Q/K/V 分给多个 head
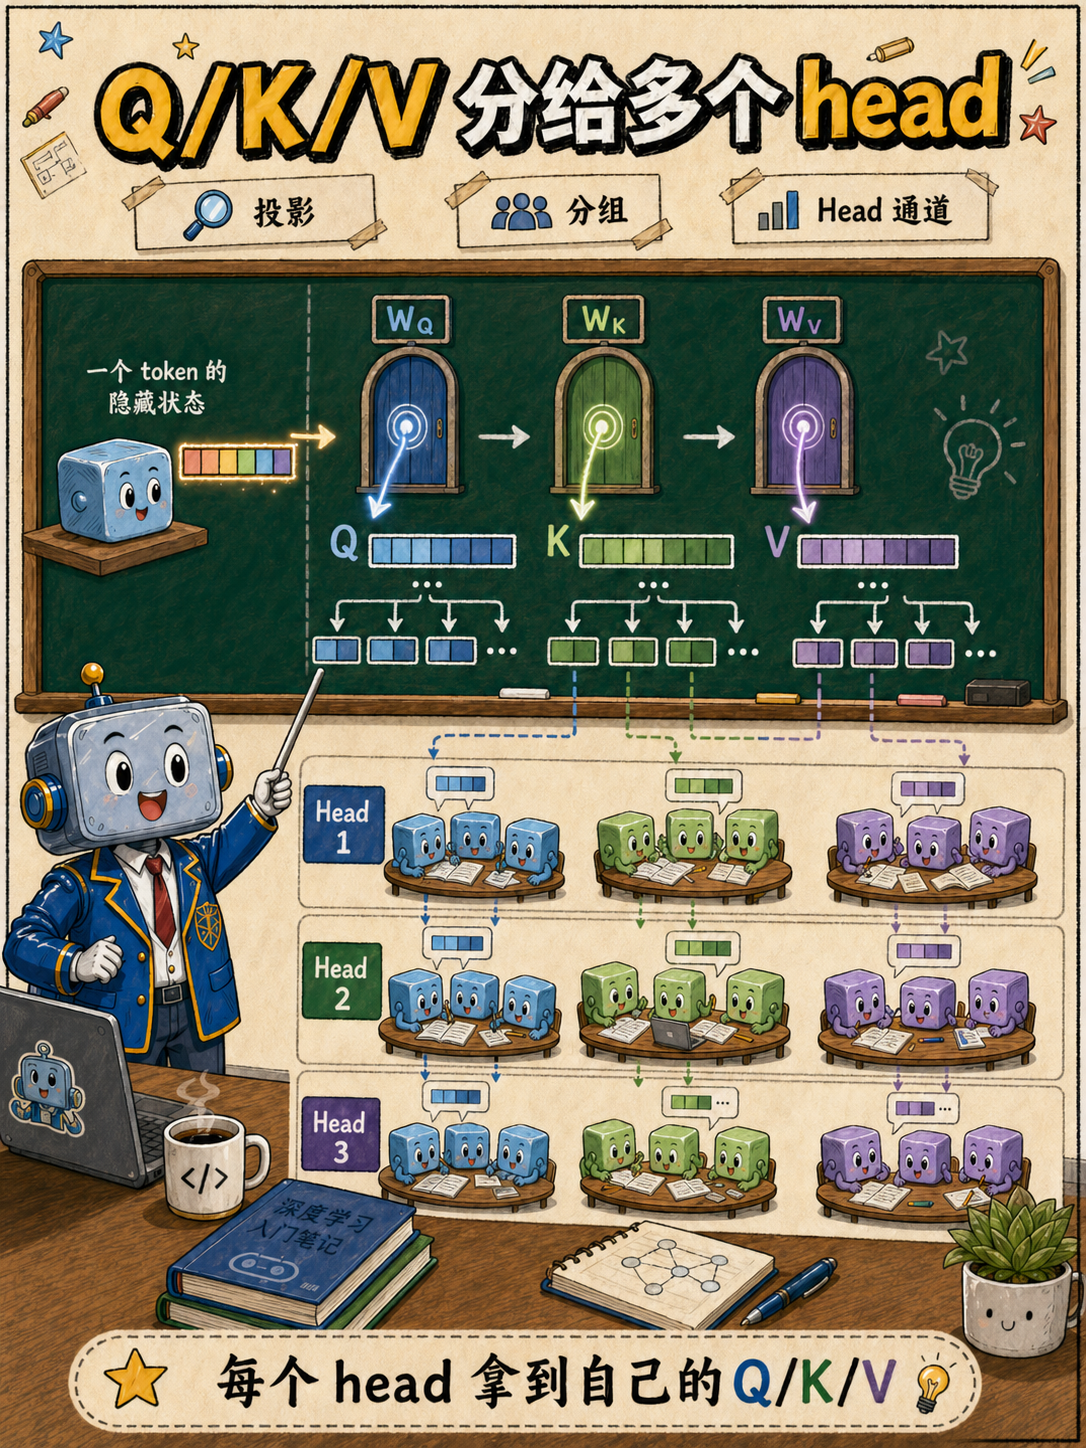
第二章里,我们把 Q、K、V 当成单头 attention 的输入。到了 Multi-Head Attention,这三组向量还会进入多个 head。每个 head 都有自己的 Q、K、V 子空间,然后各自跑一遍 scaled dot-product attention。
论文公式通常写成:
head_i = Attention(QW_i^Q, KW_i^K, VW_i^V)
MultiHead(Q,K,V) = Concat(head_1, ..., head_h)W^O
这个写法强调:第 i 个 head 有自己的一组投影矩阵 W_i^Q、W_i^K、W_i^V。工程实现里,经常会把所有 head 的投影合在一次大矩阵运算里完成,然后把结果 reshape / split 成多个 head。两种视角服务于同一件事:让不同 head 拿到自己的 Q/K/V 表示去计算 attention。
如果模型维度是 d_model,head 数是 h,常见设置会让每个 head 的维度大约是 d_model / h。这样多个小 head 并行工作,最后拼接回来时,总宽度仍然能回到模型需要的表示维度。
Multi-Head 先把 Q/K/V 放进多个 head 通道,每个 head 在自己的子空间里算 attention。
Head 1:看一种关系
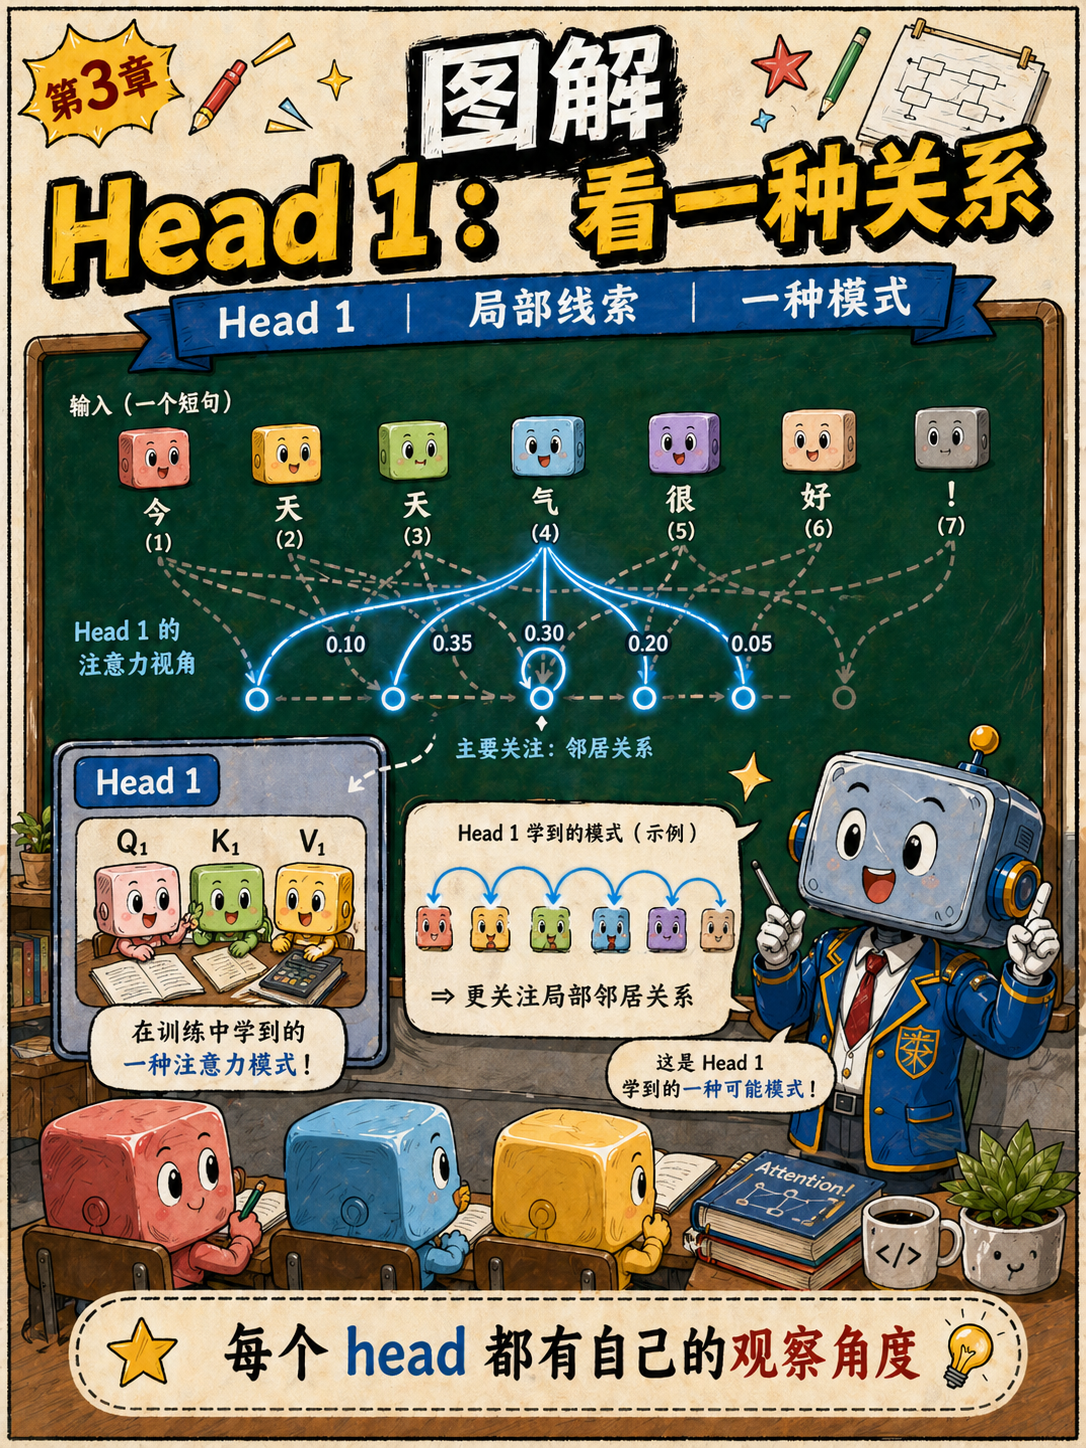
一个 head 跑 attention 时,会像第二章那样完整经历:QK 匹配、缩放、mask、softmax、读取 V。区别在于,它只在自己的 head 子空间里计算。
这样做的结果,是每个 head 都会得到一组属于自己的注意力权重。对于同一句话,同一个当前 token,在 Head 1 里可能更关注相邻词,在 Head 2 里可能更关注远处某个名词。注意力权重不同,读取到的 V 混合结果也会不同。
图里把 Head 1 画成“看一种关系”,是一个教学镜头。它想表达的是:每个 head 都有机会形成自己的观察模式。这个模式来自训练数据、参数和目标函数共同塑造。
从计算上看,Head 1 的输出仍然是一个向量。它代表这个 head 从上下文里提取到的信息。后面 concat 时,这个向量会和其他 head 的输出并排放在一起。
一个 head 会产生一种注意力分布,也会产出一份自己的上下文结果。
Head 2:换个角度看
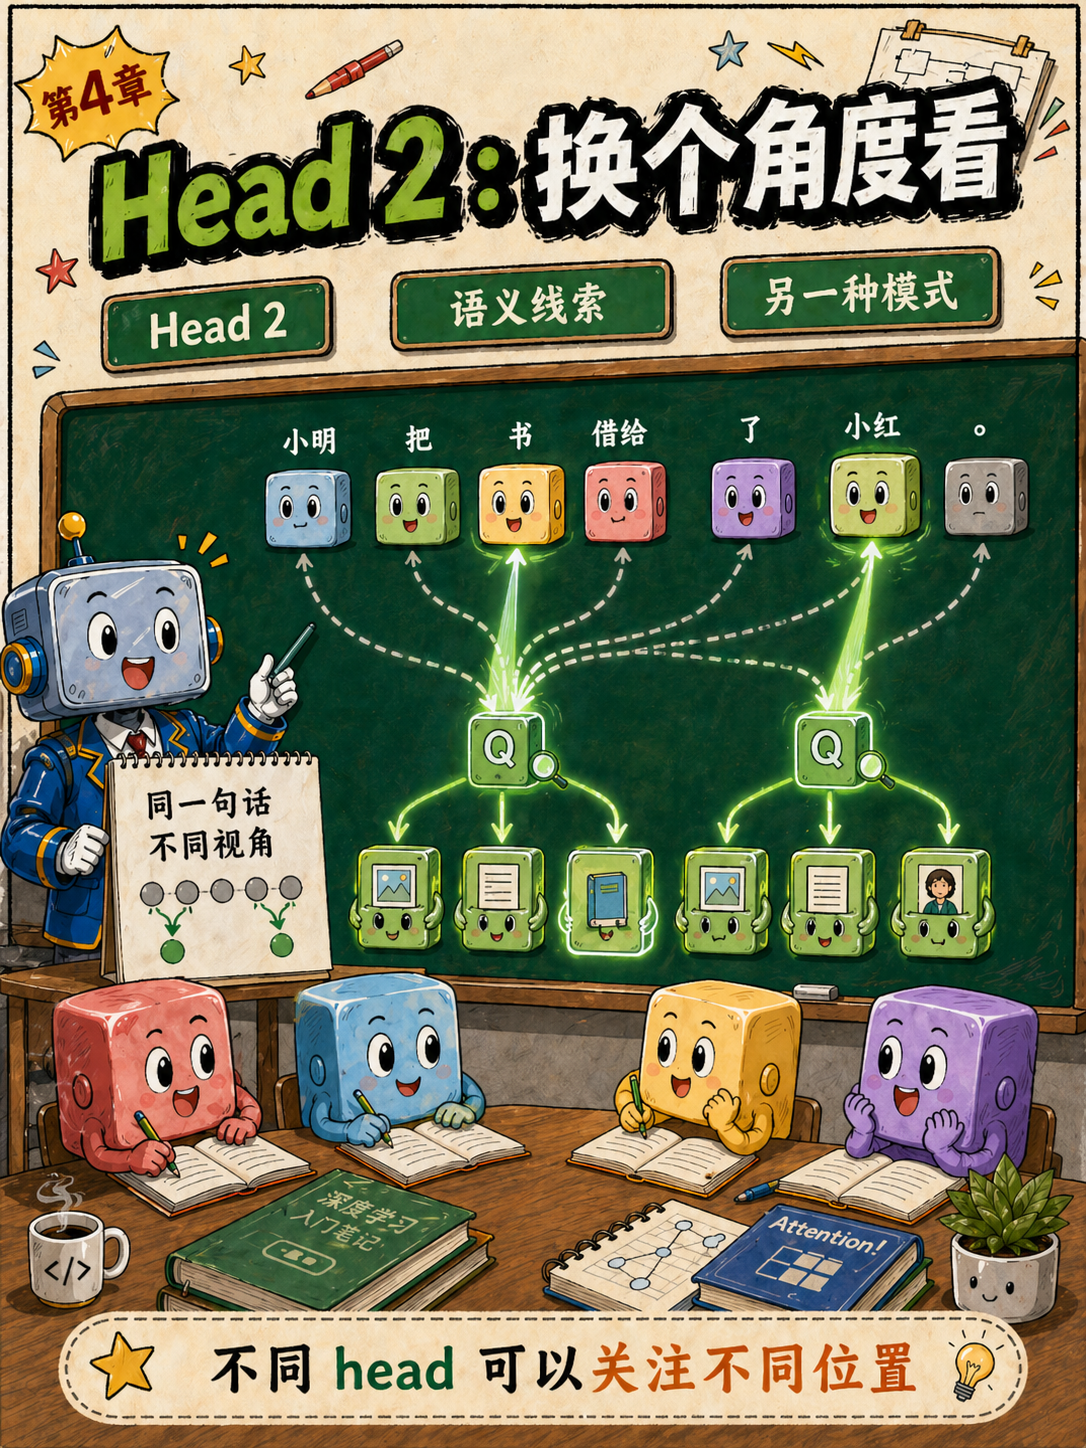
Head 2 和 Head 1 的计算流程相同,参数和输入子空间不同。因此它可以形成另一组注意力权重,也可以读出另一份上下文信息。
这就是 Multi-Head 的直觉核心:同一个 token 可以同时从多个角度看上下文。一个角度可能偏向近处词,一个角度可能偏向远处词,一个角度可能更关注某种语义线索。最后这些视角合并起来,会比单一视角更有表达力。
用“我 喜欢 猫”这种短句做例子,某个 head 可能让“我”更多看自己,另一个 head 可能让“我”更多看“猫”。这只是一个帮助理解的例子。真实训练里的 head 关注模式会更复杂,也会随着层数、任务和模型规模变化。
这页的重点是:多头提供了并行的观察空间。每个 head 产出的信息都保留下来,后面统一拼接和融合。
不同 head 可以给同一个 token 提供不同角度的上下文信息。
每个 head 自己算 attention
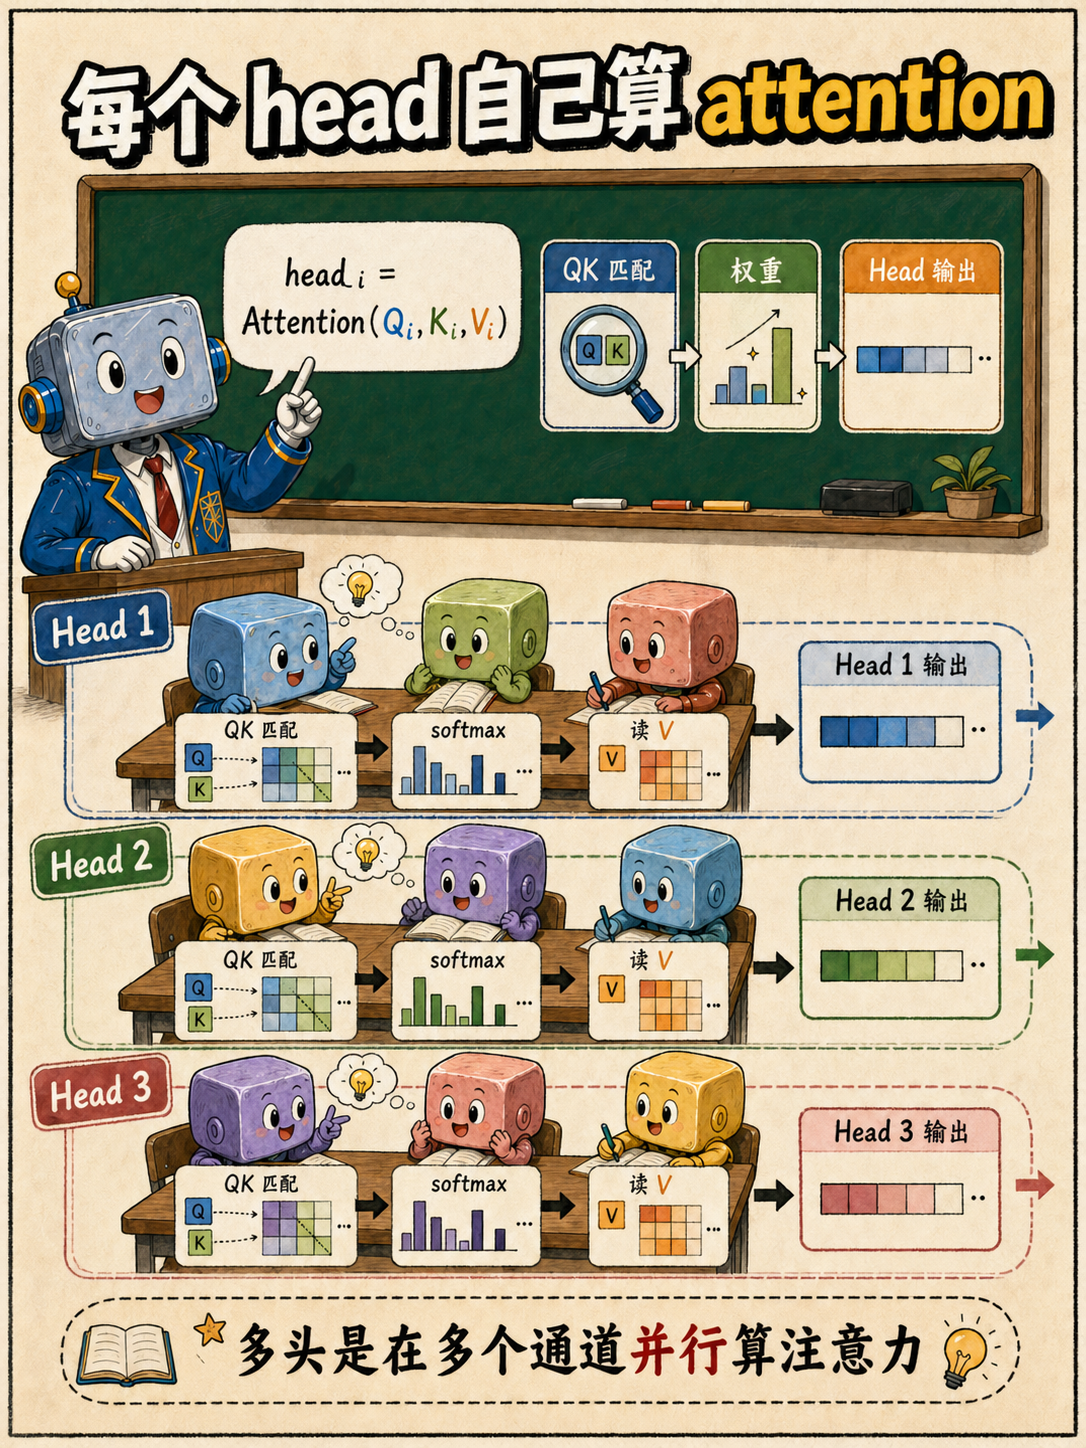
每个 head 拿到自己的 Q、K、V 后,会独立执行 scaled dot-product attention。它的计算仍然是第二章那条链路:
Attention(Q_i, K_i, V_i) = softmax(Q_iK_i^T / sqrt(d_k))V_i
这里的 i 表示第 i 个 head。每个 head 都会算自己的 score、自己的权重、自己的加权 V,最后得到自己的 head output。
这些 head 通常可以并行计算。并行是 Multi-Head Attention 在工程上很自然的形态:不同 head 的计算互相独立,最后再把结果合并。真正实现时,框架常用批量矩阵运算一次性完成多个 head 的计算。
这一步还有一个重要细节:head 数变多以后,每个 head 的维度通常会变小。这样总计算量保持在可控范围内,同时模型获得多个注意力子空间。
多头 attention 的每个 head 都独立完成一次 scaled dot-product attention。
Concat:合并多个 head
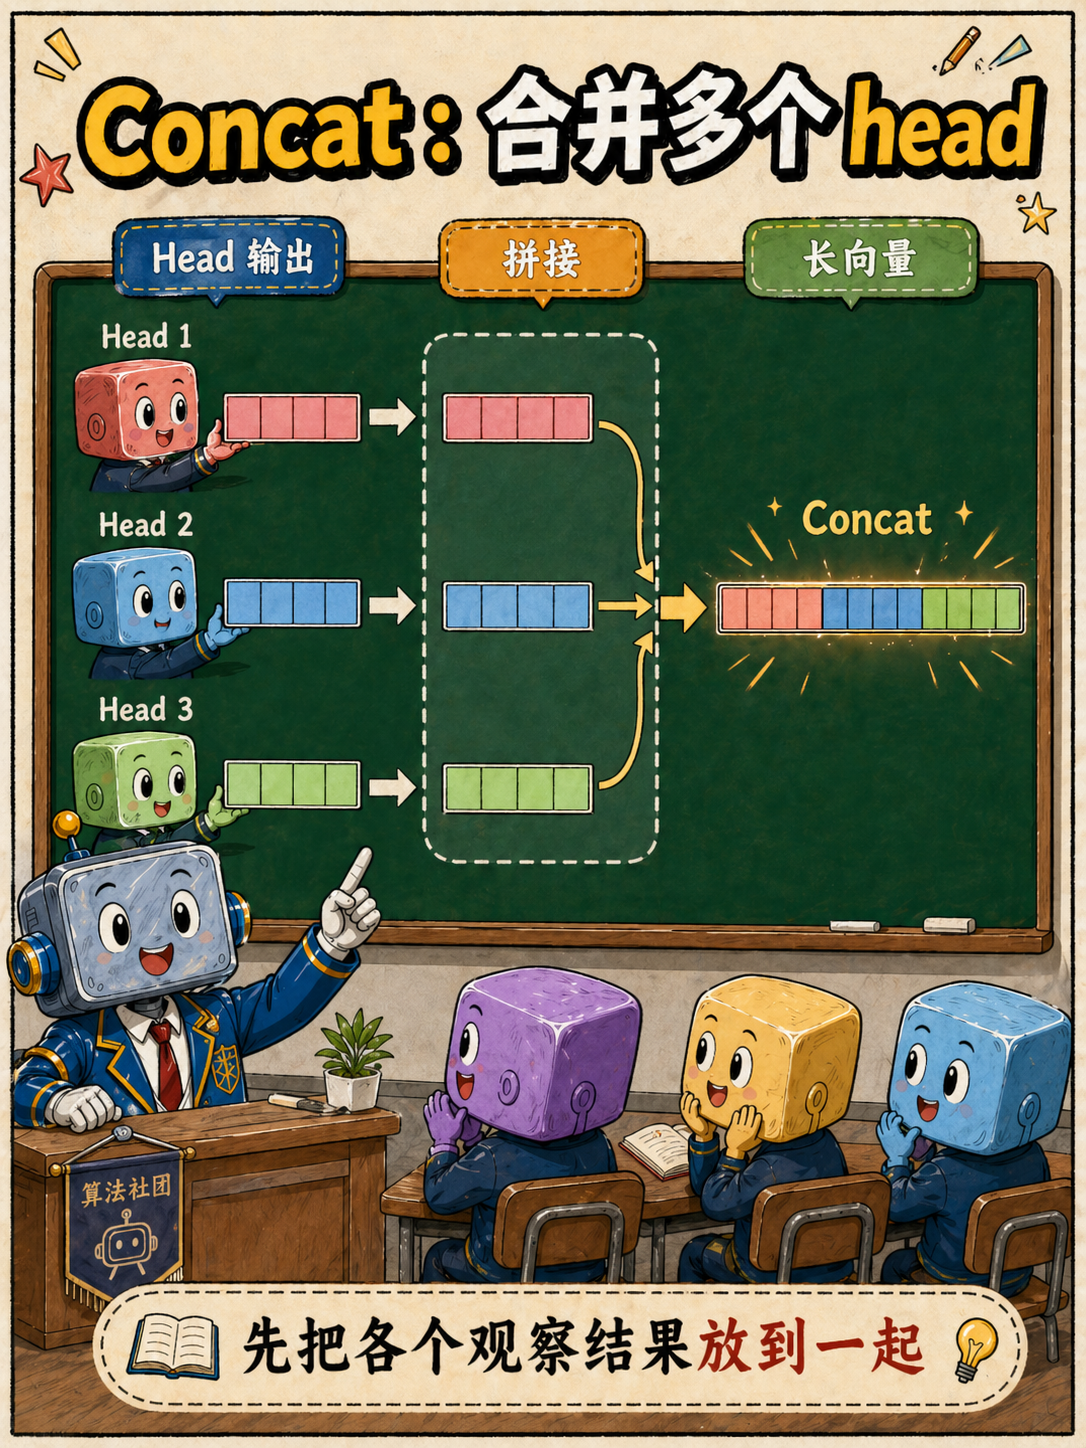
每个 head 算完 attention 后,都会输出一段向量。Concat 做的事很直接:把这些 head output 沿着特征维度拼接起来。
比如有 3 个 head,每个 head 输出一段小向量。Concat 会把它们排成一条更长的向量:
Concat(head_1, head_2, head_3)
这个动作是拼接。它把多个观察结果并排保留下来。它的直觉像把几个讨论小组的记录贴在同一张长纸上:每个小组都贡献一段内容,长纸上保存了全部小组的观察结果。
Concat 之后,向量里包含多个 head 的输出。它已经把多种视角汇聚到同一个 token 位置上,但这些信息还只是并排放在一起。下一步需要 W_O 把它们进一步混合和整理。
Concat 把多个 head 的输出沿特征维度拼成一个完整表示。
W_O:把多头结果整理好
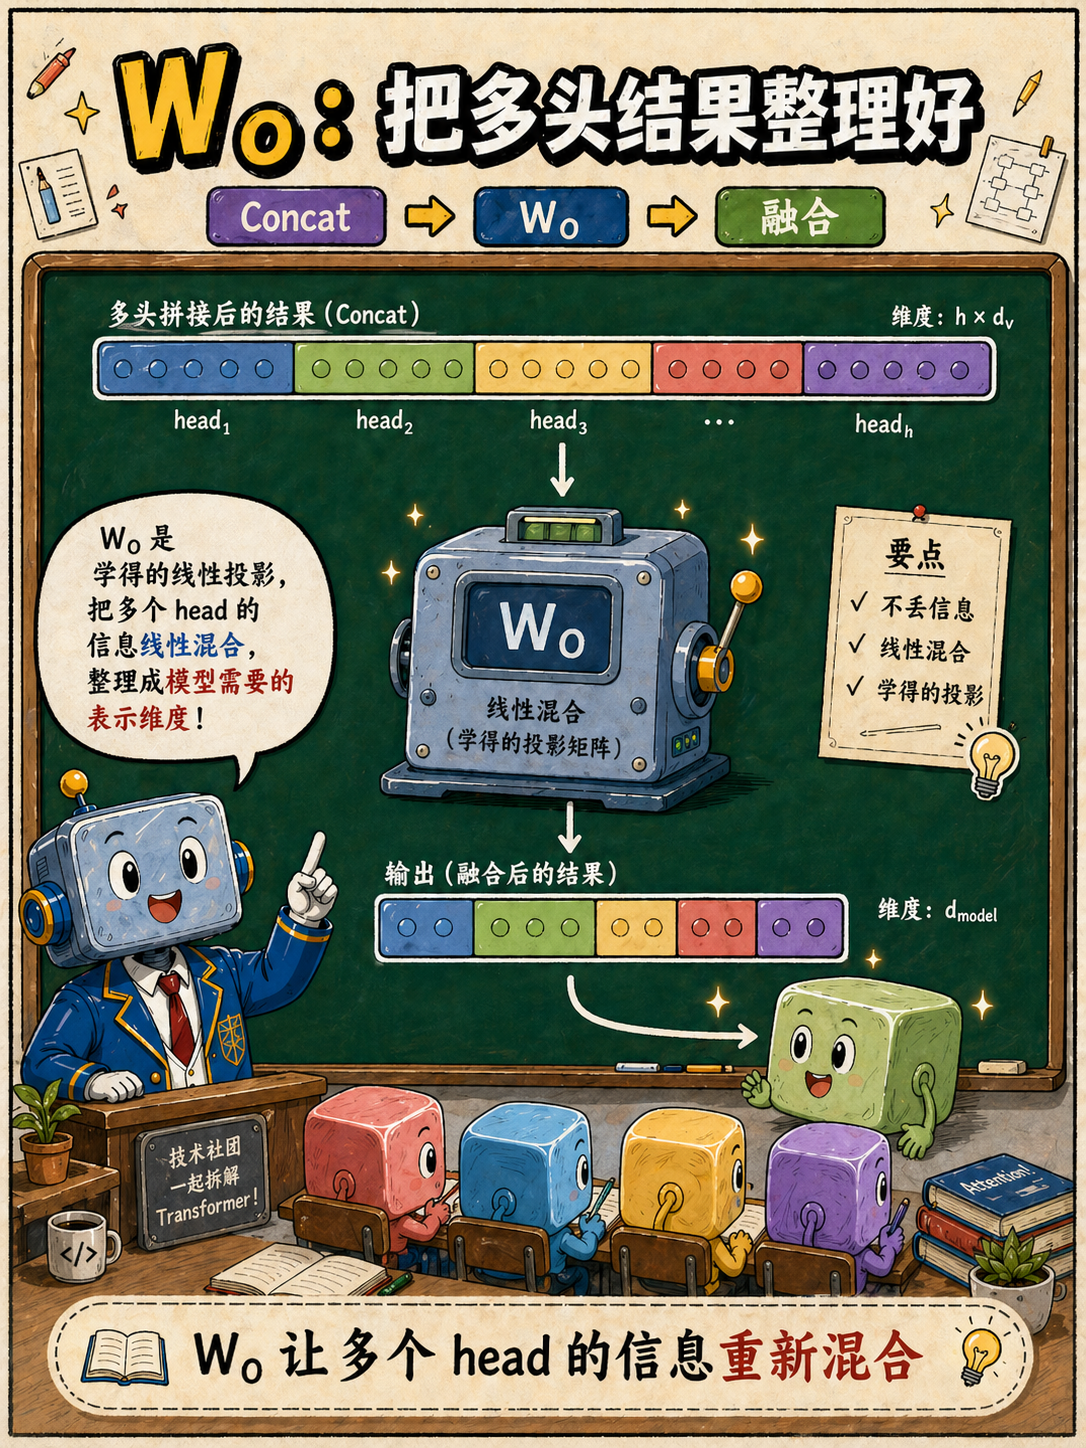
Concat 后的长向量会再乘一个输出投影矩阵 W^O。这一步叫 output projection。公式里就是:
MultiHead(Q,K,V) = Concat(head_1, ..., head_h)W^O
W^O 的作用,是把拼接后的多头结果线性变换回模型后续需要的表示空间。它会混合不同 head 的信息,让多个观察角度能够在同一个输出表示里发生组合。
如果只做 concat,各个 head 的结果只是简单的揉在了一起。但经过 W^O 之后,模型可以学习怎样综合这些 head:哪些信息该加强,哪些信息该和其他 head 的信息组合,怎样形成下一步子层可以使用的表示。
到这里,Multi-Head Attention 的主流程就完整了:投影得到多组 Q/K/V;每个 head 独立跑 attention;把 head 输出 concat;再经过 W^O 输出一个 attention 子层结果。后半章会把这个结果接到 FFN、Residual 和 Norm 上,形成完整 Transformer Block。
W^O负责融合多头结果,让多个观察角度变成同一个可继续加工的表示。
Attention 子层全流程
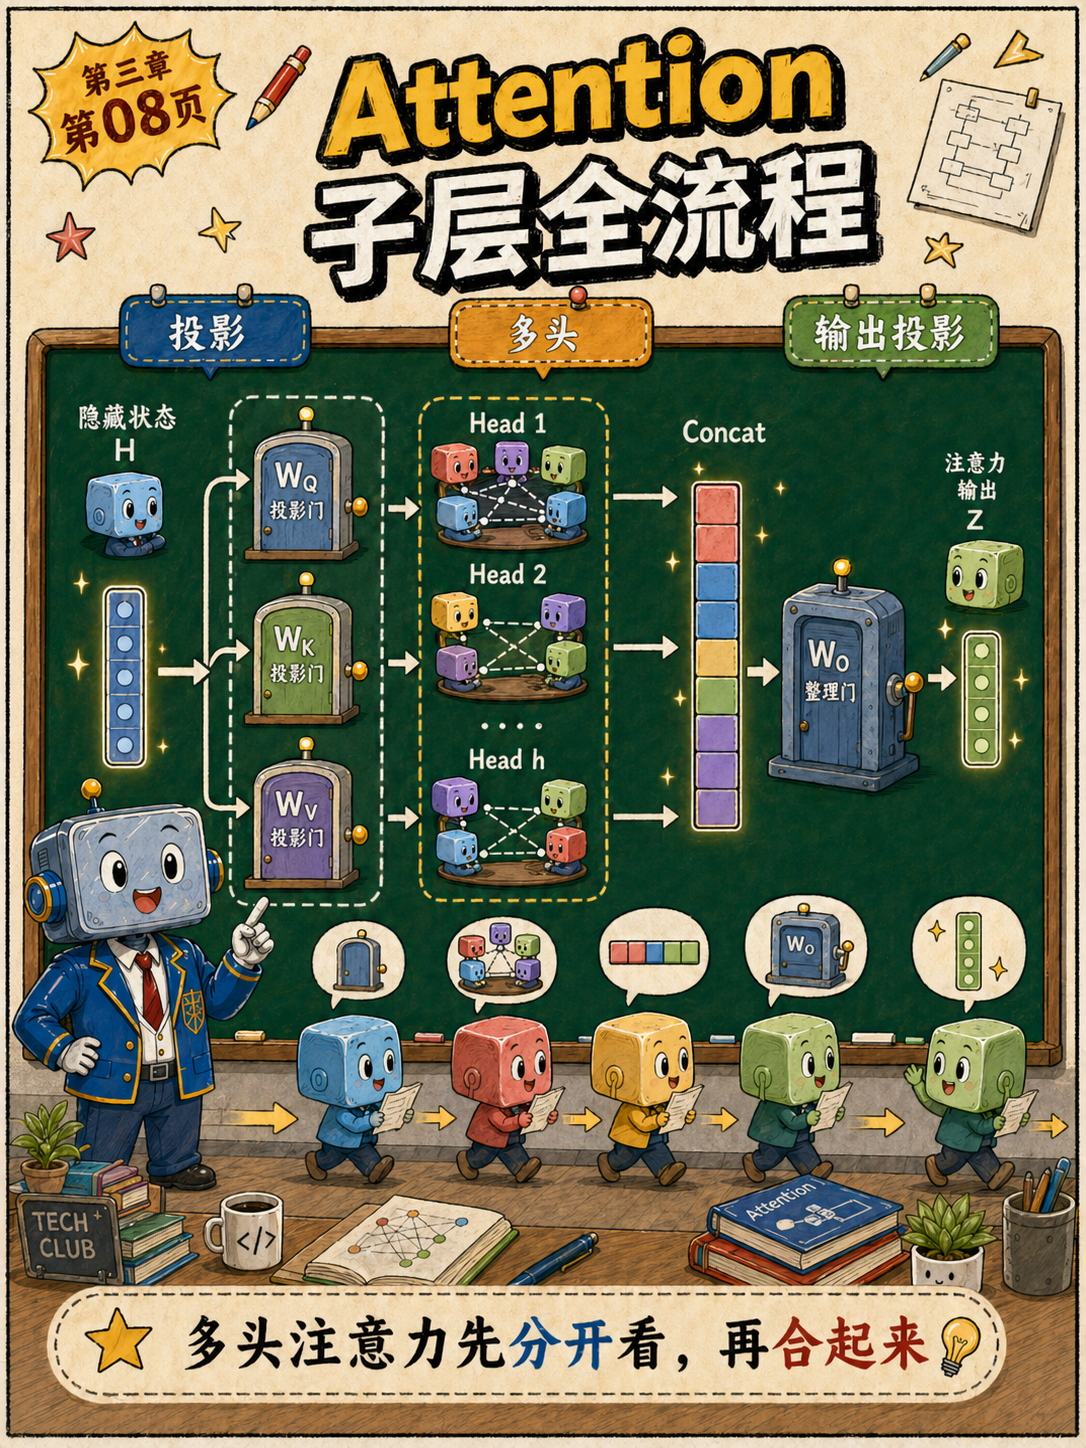
把前面的几页合在一起,Multi-Head Attention 子层的主流程就是:
输入表示 → Q/K/V 投影 → 多个 head 各自算 attention → Concat → W^O → attention output
每个 token 进入这一层时,都带着当前层的表示。模型先通过线性投影得到 Q、K、V,再把它们分到多个 head。每个 head 在自己的子空间里计算注意力权重,并按权重混合 V。然后所有 head 的输出被拼接起来,经过 W^O 融合,得到这一层 attention 子层的输出。
这一步解决的是“token 之间怎么交换信息”。如果当前 token 需要理解上下文,它就不能只盯着自己。attention 子层让每个 token 都从可见 token 那里收集信息,多头机制让这种收集可以从多个角度同时发生。
注意这里说的是 attention 子层。完整 Transformer Block 后面还有 FFN、Residual、Norm 等结构。attention output 只是中间结果,后续模块会继续加工它。
Attention 子层负责让 token 之间交换上下文信息。
FFN:每个 token 自己加工
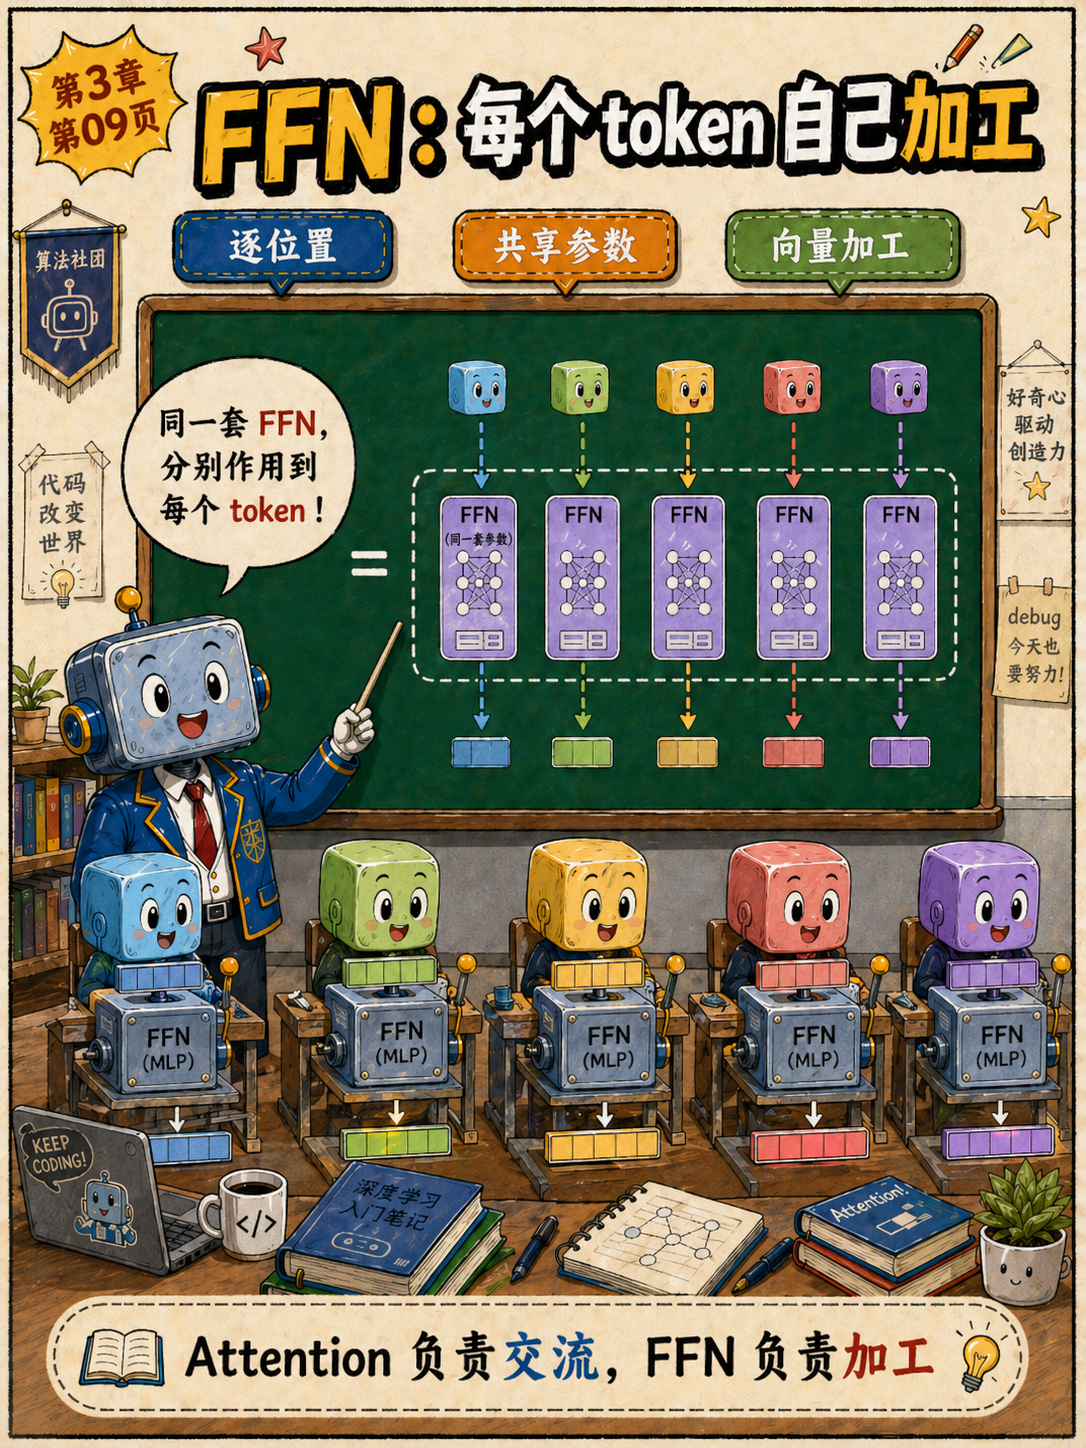
attention 子层负责让 token 互相看见。FFN 负责让每个 token 对自己的表示做进一步加工。
原始 Transformer 论文把它叫 position-wise feed-forward network。position-wise 的意思是:它分别作用在每个位置上。每个 token 都会经过同一套 FFN 参数,但不同 token 之间在这一步没有互相读取信息。
原始论文中的 FFN 由两层线性变换和中间的 ReLU 激活组成:
FFN(x) = max(0, xW_1 + b_1)W_2 + b_2
现代 LLM 里,这个模块常被叫作 MLP,也经常使用 SwiGLU、GEGLU 等门控变体。名字和细节会变,但主线很稳定:attention 先把上下文信息带进来,FFN 再对每个位置的表示做非线性加工。
Attention 负责交流,FFN 负责逐位置加工。
激活函数:有选择地加工
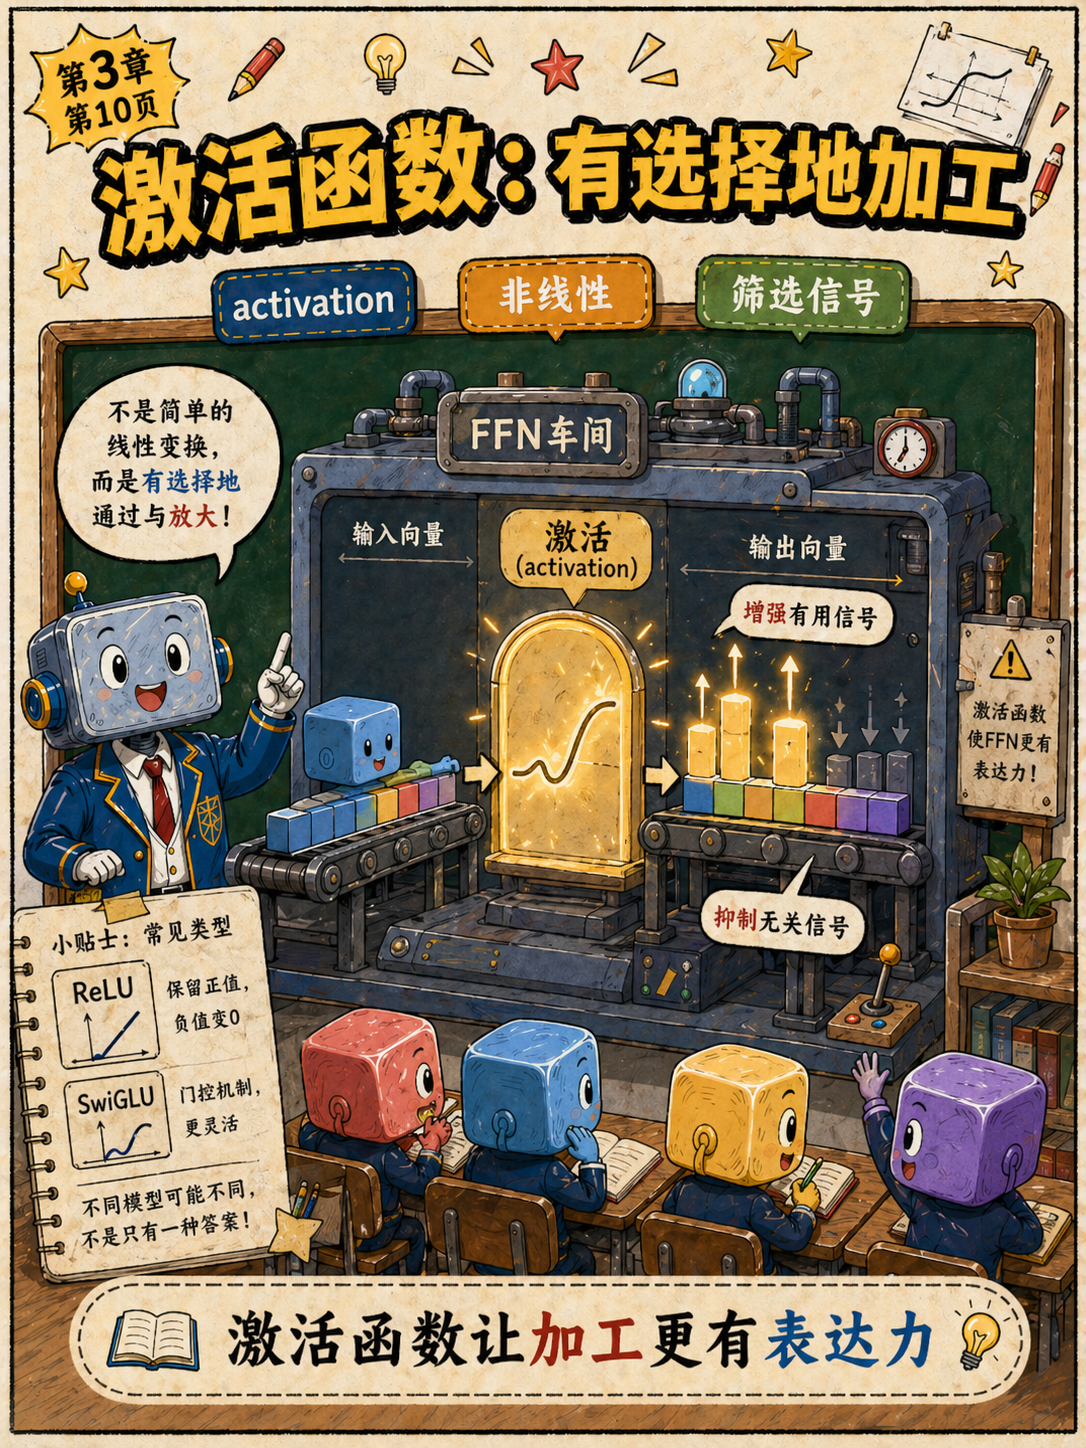
FFN 里需要激活函数,因为两层线性变换直接连在一起,本质上仍然可以合并成一次线性变换。激活函数引入非线性,让模型能表达更复杂的关系。
用图里的“加工门”理解就够了:向量进来以后,有些信号会被保留或放大,有些信号会被压低。这样 FFN 就不只是把向量换个坐标系,而是在做有选择的特征加工。
原始 Transformer 使用 ReLU。很多现代 LLM 使用门控激活,例如 SwiGLU。它们的具体公式不同,但承担的角色相近:让 FFN 的表达能力更强。
这里要避免一个误解:激活函数不是在读上下文。上下文交换主要发生在 attention 子层。激活函数位于 FFN / MLP 内部,作用在每个 token 自己的表示上。
激活函数给 FFN 加上非线性,让表示加工更有表达力。
Residual:保留原来的自己
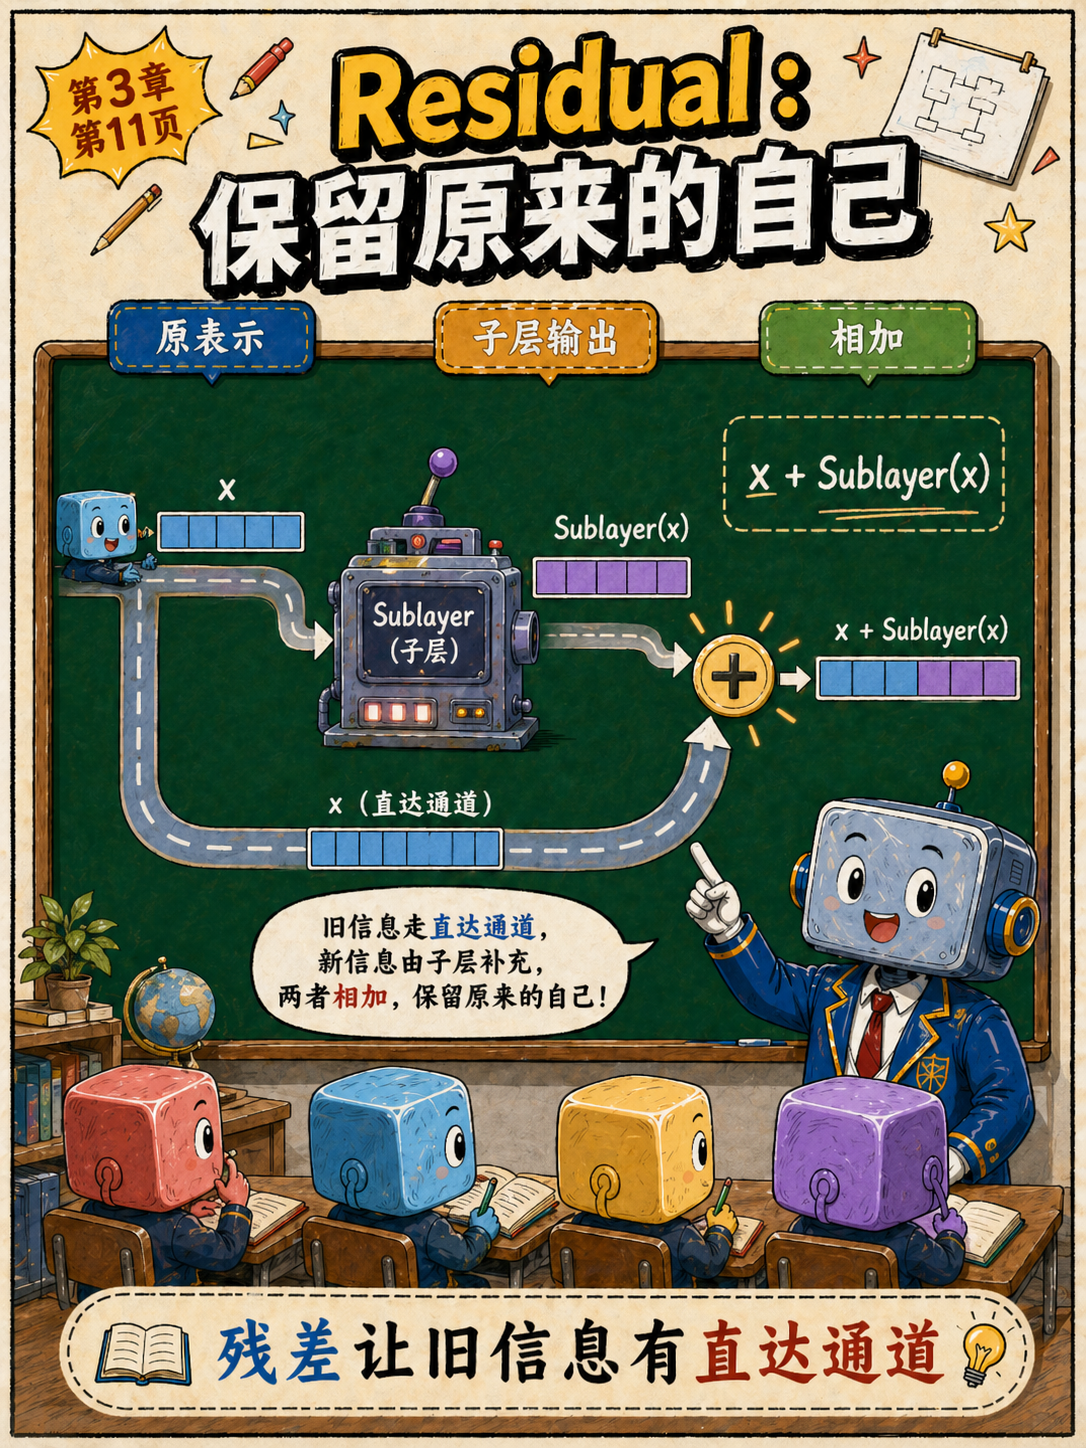
Residual connection 的核心动作很简单:把子层输入加回子层输出。原始 Transformer 论文对每个子层使用的形式是:
LayerNorm(x + Sublayer(x))
这里的 x 是子层输入,Sublayer(x) 是 attention 或 FFN 的输出。相加以后,原来的表示有一条直达通道,新加工出来的信息也能叠加进去。
直觉上,残差连接让模型每一层都不用从零开始改写 token。它可以在原表示基础上补充新信息。这样很多层堆起来时,信息更容易穿过网络,训练也更稳定。
现代 Transformer 常见 pre-norm 结构会把 Norm 放在子层前面,残差相加的位置也会随架构写法变化。但 residual 的核心不变:保留输入路径,把子层产生的新信息加回来。
Residual 让旧信息有直达通道,新信息通过相加叠加进去。
Norm:让表示更稳定
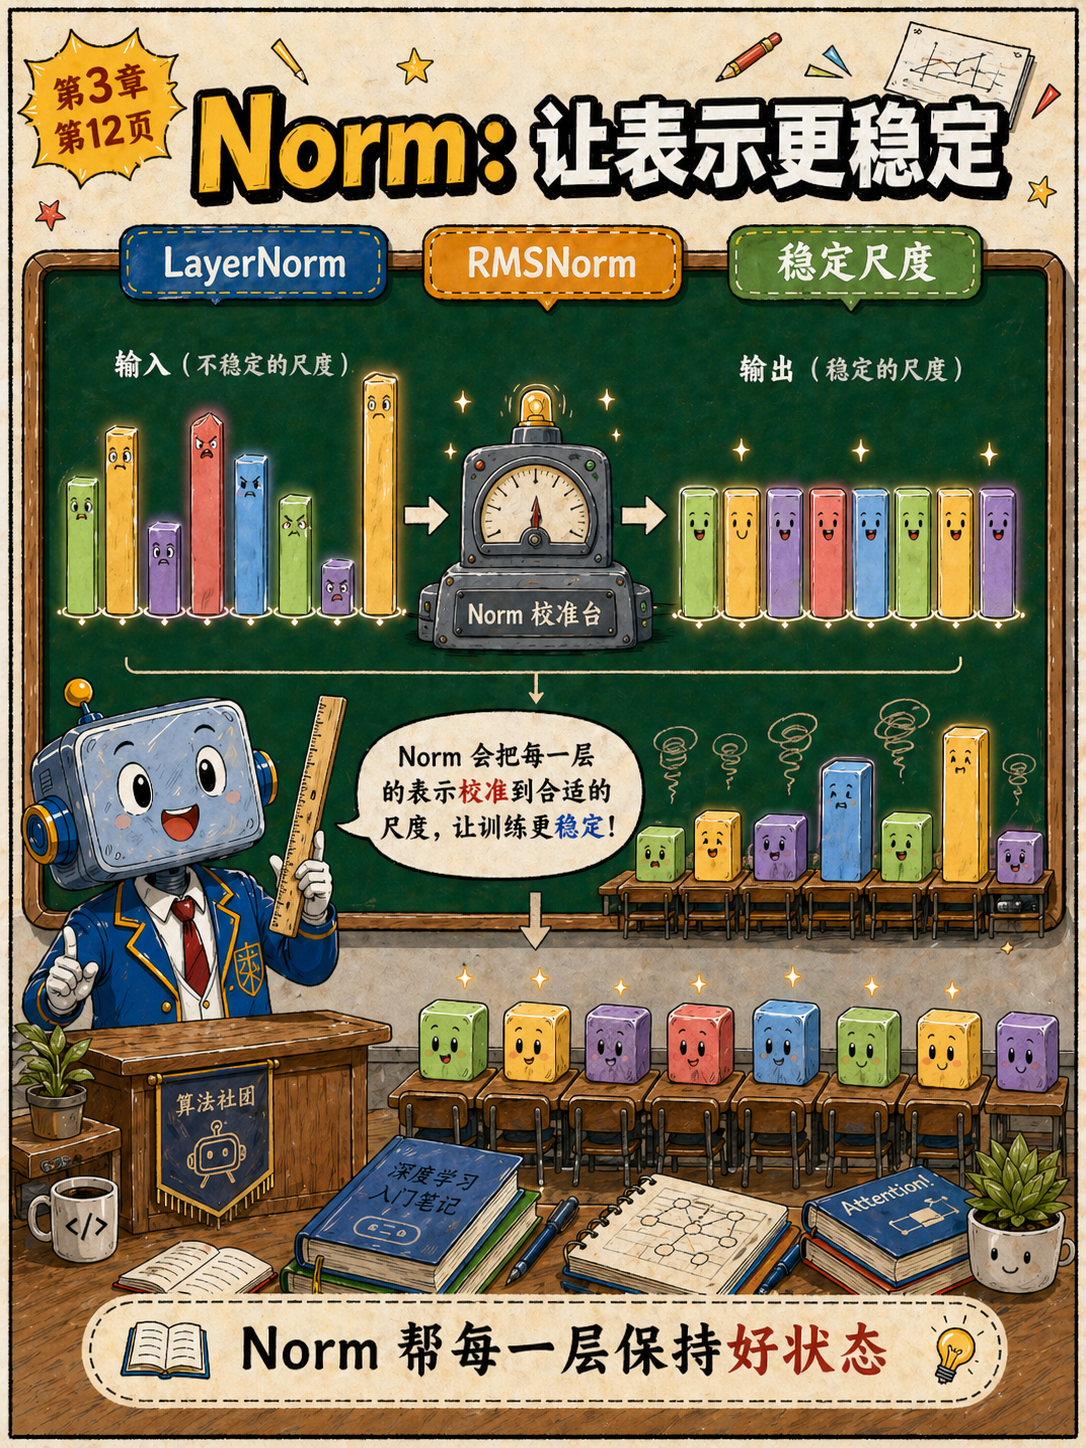
Transformer 会堆很多层。每层都在做投影、注意力、FFN 和相加,如果表示的数值尺度一路乱跑,后面的层就更难稳定工作。Norm 的作用,是让每层附近的表示尺度更可控。
原始 Transformer 使用 LayerNorm,并且放在 residual 相加之后。很多现代 LLM 使用 pre-norm,也就是先归一化再进入 attention 或 FFN;不少现代模型还使用 RMSNorm。具体实现不同,但它们都在解决同一个工程问题:让深层网络里的表示保持稳定。
图里把 Norm 画成校准台,是为了表达这个直觉。它不是把 token 的语义变成统一答案,也不是清空信息。它是在数值层面调整表示,让后续计算更容易处理。
写正文和看模型结构图时,要留意两个差异:一种是 Norm 类型,比如 LayerNorm 或 RMSNorm;另一种是 Norm 位置,比如 post-norm 或 pre-norm。不同模型会有不同选择。
Norm 帮助深层 Transformer 维持更稳定的表示尺度。
一层 Transformer Block
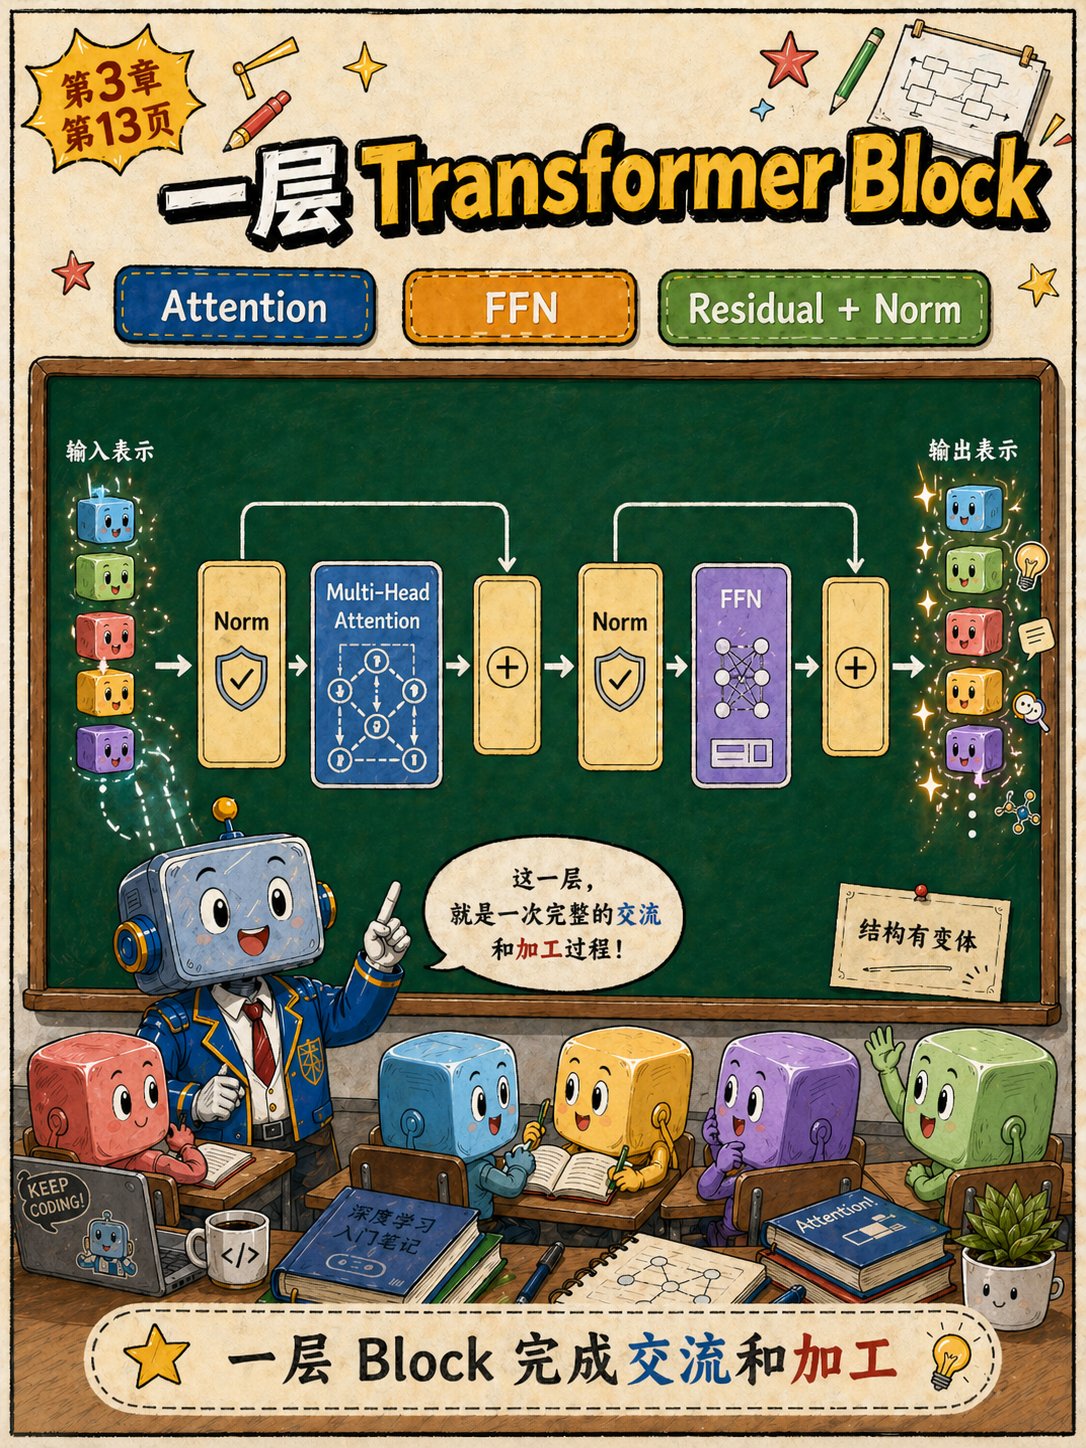
现在可以把一层 Transformer Block 串起来了。常见现代 decoder-only block 可以用这条主线理解:
输入表示 → Norm → Multi-Head Attention → Residual Add → Norm → FFN / MLP → Residual Add → 输出表示
这个结构里,attention 子层让 token 交换上下文信息;FFN / MLP 子层对每个 token 的表示做进一步加工;Residual 把输入路径保留下来;Norm 控制表示尺度。四类模块配合起来,构成一层完整的表示更新。
原始 Transformer 的论文结构更接近 post-norm:子层输出先和输入相加,再做 LayerNorm。现代 LLM 大量使用 pre-norm。你现在不用急着记住所有变体,先抓住稳定主线:attention 负责交流,FFN 负责加工,Residual 和 Norm 负责让多层堆叠可训练、可运行。
Block 的输出仍然是一串 token 表示。序列长度没有变,每个位置都有自己的新表示,只是这些表示已经吸收了本层带来的上下文信息和非线性加工。
一层 Block 完成一次“交流 + 加工”的表示更新。
多层堆叠:表示越来越深
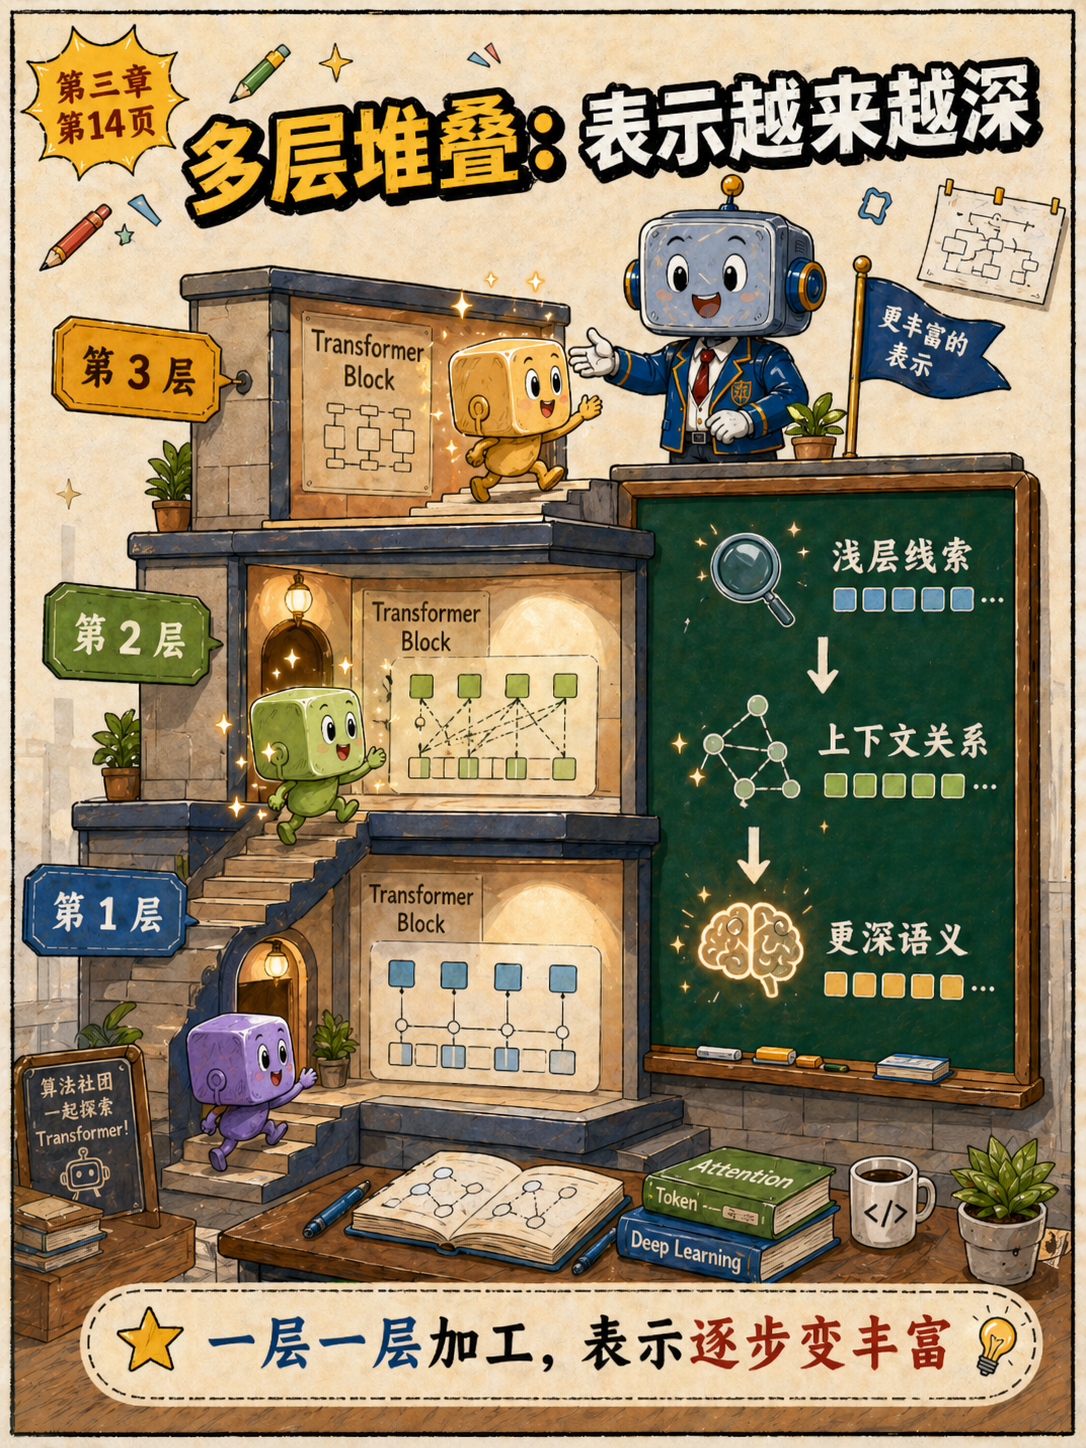
一个 Transformer 通常会堆很多层 Block。第 1 层输出的表示,会作为第 2 层输入;第 2 层输出,再进入第 3 层。每一层都重复 attention、FFN、Residual、Norm 这套节奏。
堆叠的意义,是让 token 表示逐层变丰富。浅层可能更多处理局部线索和较直接的模式;越往后,表示里可能融合更大范围、更抽象的上下文信息。这里的“更深语义”是对表示层级的直觉描述,具体每层学到什么由训练和模型结构决定。
从第一章到这里,整条线咱们已经打通了:token 变成向量,带上位置进入模型;self-attention 让它读取上下文;multi-head 让它从多个角度读取;FFN 继续加工;Residual 和 Norm 让这些模块可以堆很多层。最终,模型在最后一层拿到更丰富的 token 表示,再进入后续预测下一个 token 的流程。
第三章到这里完成了一个关键转折:我们已经从“attention 是什么”走到“一层 Transformer 怎么工作”。下一章会把视角切到现代 LLM 生成:decoder-only、causal mask、自回归生成、logits 和 sampling。
多层 Block 让 token 表示经过多次交流和加工,逐步变得更丰富。
阅读导航



