
C++ 静态库原理:目标文件归档与链接顺序
08 静态库为什么像一包目标文件
第 7 章讲了链接器怎样把多个目标文件中的符号对上号。但如果一个项目有几十上百个 .cc,每次链接都在命令行里逐个列出所有 .o 文件显然不现实。静态库就是用来解决这个问题的:把一组相关目标文件打包成一个 .a 文件(Linux/macOS)或 .lib 文件(Windows),链接时传给 -l 参数,链接器自动从库里抽取需要的目标文件。静态库的"静态"指的是链接时就把库中的代码提取并合入最终可执行文件,链接完成之后可执行文件不再依赖那个 .a 文件。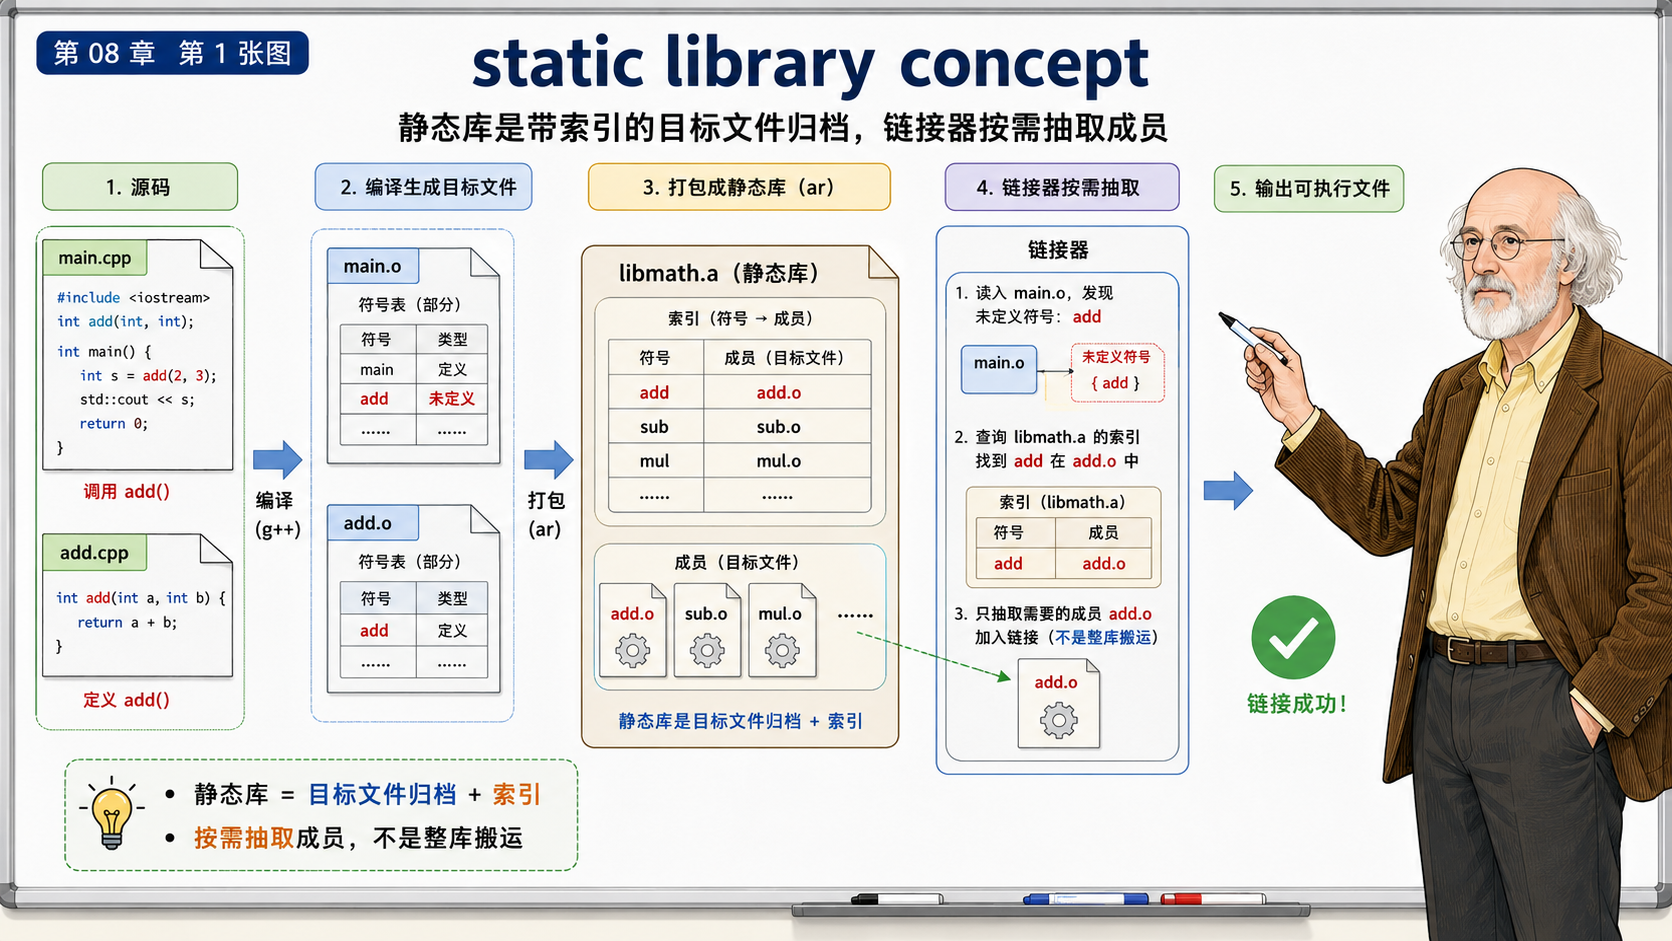
静态库本质上是一组目标文件的归档(archive),加上一个索引(index)帮助链接器快速查找。用极简例子从头演示。准备 math.h、add.cc、mul.cc 和 main.cc:
// math.h
#ifndef MATH_H_
#define MATH_H_

int Add(int left, int right);
int Multiply(int left, int right);

#endif
// add.cc
#include "math.h"

int Add(int left, int right) {
  return left + right;
}
// mul.cc
#include "math.h"

int Multiply(int left, int right) {
  return left * right;
}
// main.cc
#include "math.h"

#include <iostream>

int main() {
  std::cout << Add(2, 3) << " " << Multiply(4, 5) << "\n";
  return 0;
}
先把 add.cc 和 mul.cc 各自编译成目标文件,然后用 ar 工具打包成静态库:
clang++ -std=c++20 -Wall -c add.cc -o add.o
clang++ -std=c++20 -Wall -c mul.cc -o mul.o
ar rcs libmath.a add.o mul.o
ar 是 Unix 系统上的归档工具,r 表示将文件插入归档(替换同名成员),c 表示创建归档(如果不存在),s 表示为归档建立符号索引。libmath.a 现在包含了 add.o 和 mul.o 的完整内容。用 ar t libmath.a 可以列出归档中的所有成员,用 nm libmath.a 可以看每个成员的符号表。
编译 main.cc 并和静态库链接:
clang++ -std=c++20 -Wall -c main.cc -o main.o
clang++ main.o libmath.a -o app
./app
# 输出:5 20
main.o 的符号表中有两个未定义符号需求:Add 和 Multiply。链接器在处理 libmath.a 时,根据符号需求从归档中抽取了 add.o(提供 Add)和 mul.o(提供 Multiply)。最终 app 中只包含了被抽中的目标文件的代码,没有被引用的归档成员不会进入可执行文件。
这个"按需抽取"是静态库和直接列出 .o 文件的核心区别。如果写成 clang++ main.o add.o mul.o -o app,add.o 和 mul.o 的全部内容无条件地进入最终可执行文件。如果写成 clang++ main.o libmath.a -o app,libmath.a 中的 add.o 和 mul.o 只在其提供的符号被 main.o(或前面已处理的成员)需要时才会被抽取。对于大型库,这个差异决定了最终二进制的大小。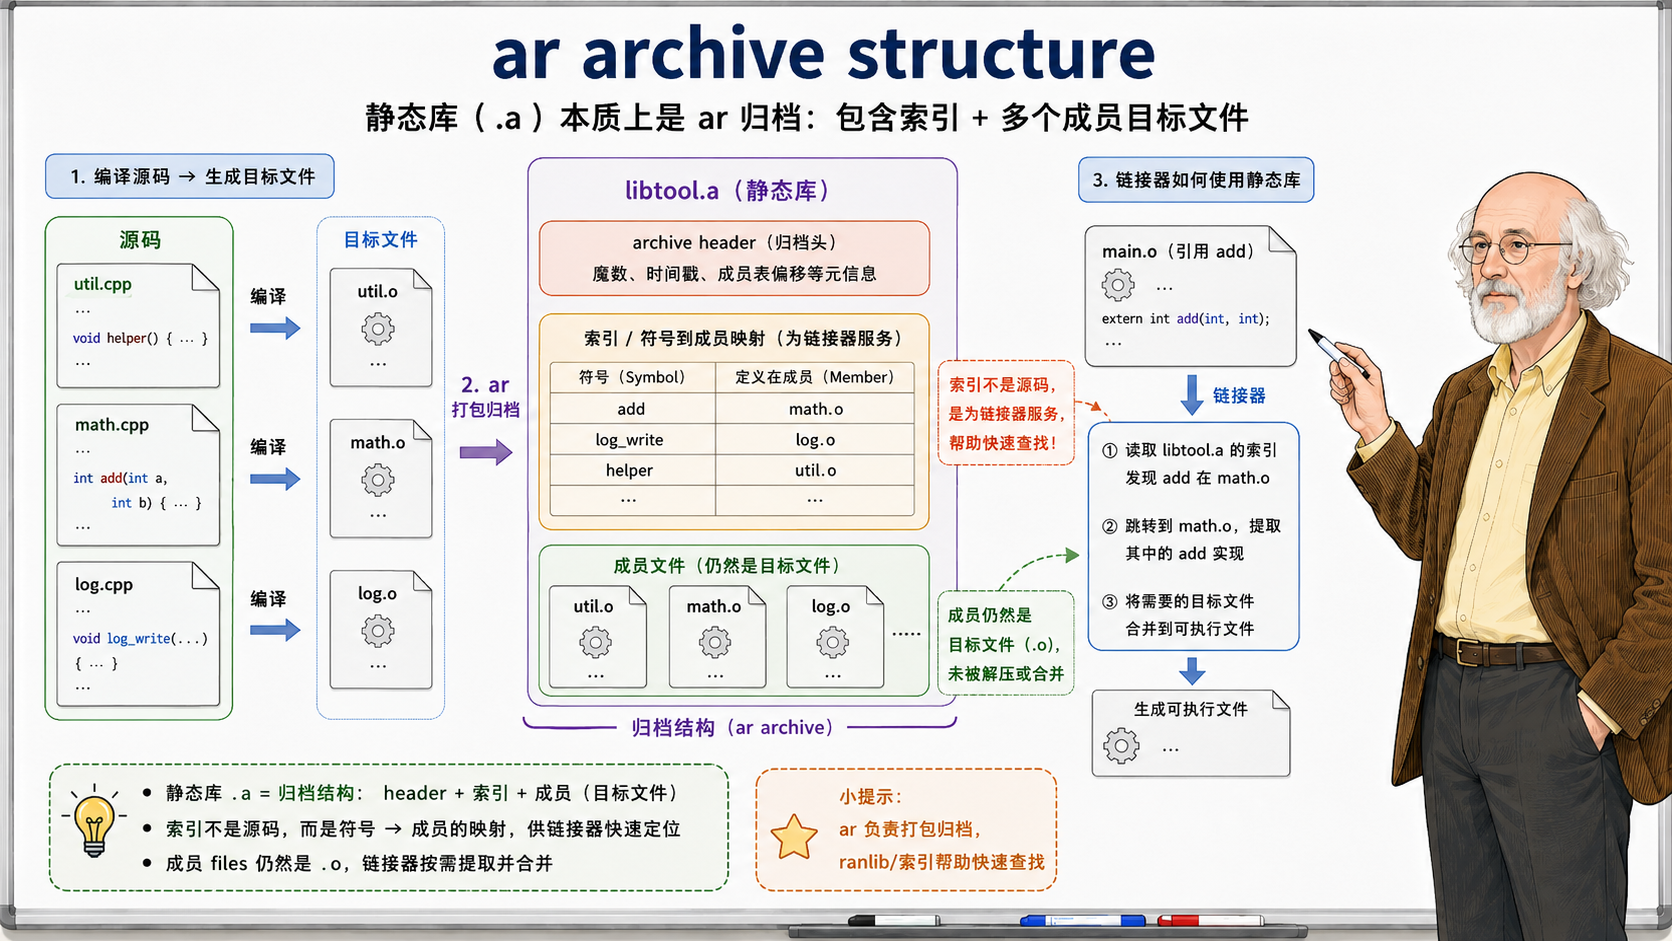
链接器处理静态库的算法通常是一个按命令行顺序逐遍扫描的过程。链接器维护一个"未解析符号集合",初始为空。依次处理命令行上的每个输入:如果是目标文件,将其提供的符号加入"已定义符号集合",如果它引用了未定义符号且当前未解析符号集合中找不到,将其加入未解析符号集合,如果它解决了一些未解析符号的需求,从集合中移除那些符号。如果是静态库,遍历库中每个目标文件成员,检查该成员是否提供了当前未解析符号集合中某个(或多个)符号的定义;如果提供,则将该成员从库中抽取出来,把它当作一个独立的目标文件重新纳入符号解析流程,该成员提供的符号可能解决更多未解析需求,该成员引用的符号可能产生新的未解析需求。重复这个"逐个成员检查、满足需求就抽取"的过程直到一趟扫描结束。扫描完所有输入后,如果未解析符号集合为空,链接成功;否则报 undefined reference。
这个算法模型解释了静态库使用中一条重要的规则:链接顺序敏感。当链接器从左到右扫描命令行时,如果库 A 中的成员需要库 B 提供的符号,通常库 B 应该放在库 A 之后出现。因为在扫描到库 A 时,链接器会检查库 A 中每个成员是否解决了当前已有的未解析符号需求。如果当时还没有来自库 B 的未解析符号需求,库 A 就不会被充分抽取;等到后面扫描到库 B 时,B 中成员的符号才会被提取,但 A 中对 B 的需求在前一趟扫描中可能已经被记录为未解析,链接器在单趟扫描中不会回头重新扫描已经遍历过的库。
实际例子:如果 main.o 使用了 A() 和 B(),而 libmath.a 中的 add.o 定义了 A() 但内部调用了 B(),mul.o 定义了 B()。链接命令 clang++ main.o libmath.a 的扫描过程是:先处理 main.o,将 A 和 B 加入未解析集合;然后遍历 libmath.a,add.o 提供了 A 被抽取,A 从集合中移除,但 add.o 内部对 B 的调用引入了对 B 的新需求(已在集合中),继续扫描库中剩余成员找到 mul.o 提供了 B,抽取 mul.o,B 从集合中移除。一切正常。
但如果 add.o 和 mul.o 分在不同的库中,比如 libfirst.a 包含 add.o,libsecond.a 包含 mul.o,命令行是 clang++ main.o libfirst.a libsecond.a:main.o 引入对 A 和 B 的需求;扫描 libfirst.a,add.o 提供 A 被抽取,A 需求解决;add.o 引出对 B 的需求;继续扫描 libfirst.a 中剩余成员,没有再提供 B 的成员;转向 libsecond.a,mul.o 提供 B 被抽取。链接成功。如果顺序反过来:clang++ main.o libsecond.a libfirst.a:先扫描 libsecond.a,此时未解析集合中有 A 和 B;mul.o 提供 B 被抽取,B 需求解决;mul.o 没有引入新需求;继续扫描 libsecond.a 剩余成员,没有提供 A 的;再扫描 libfirst.a,add.o 提供 A 被抽取。也成功了。库的顺序在两个库各自独立提供符号时可能不那么严格。
真正容易出问题的是库之间有交叉依赖:libfirst.a 中的某个成员使用了 libsecond.a 中的符号,而 libsecond.a 中的某个成员又使用了 libfirst.a 中的符号。这种情况下,单趟扫描不够,要么调整库的顺序让依赖方向从左到右一致,要么在命令行中重复库名让链接器做多趟扫描,要么使用 GNU ld 的分组扫描选项或 macOS 的强制加载选项,让链接器对这组库执行多轮符号解析。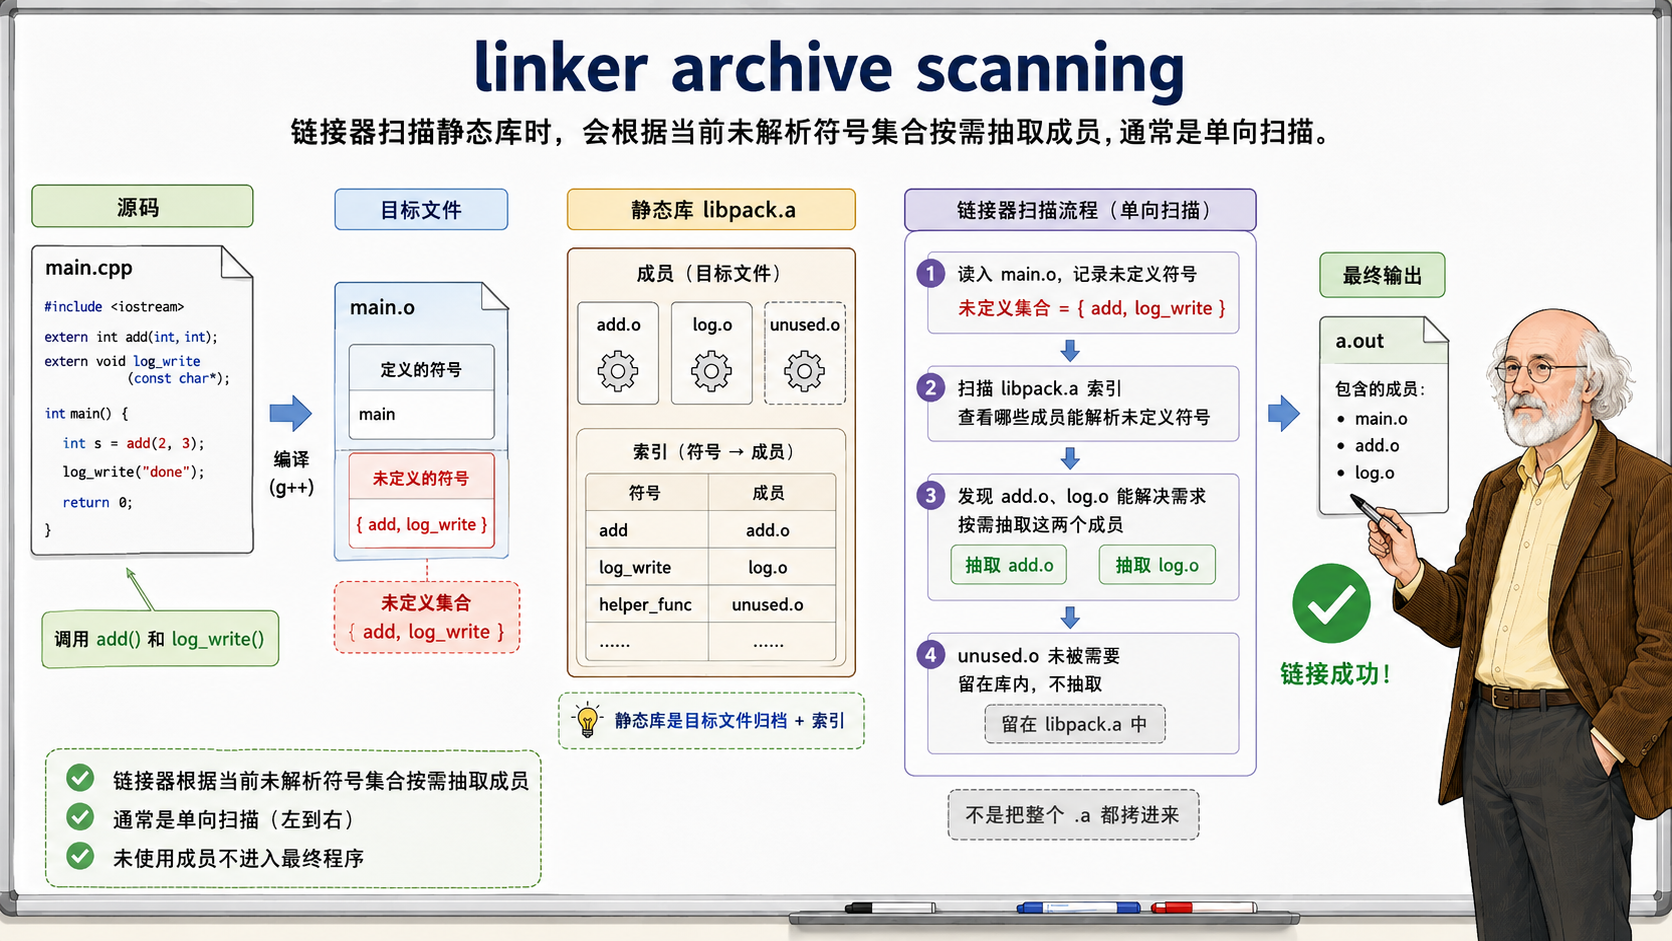
静态链接之后,可执行文件包含了被抽取的目标文件中的全部代码和数据。用 nm app 可以确认 Add 和 Multiply 的符号已经在可执行文件中有了确定的地址(标记不再是 U)。此时 libmath.a 文件不再需要参与程序的运行。把 app 拷贝到另一台没有安装开发库的机器上,只要能满足系统层面的兼容性(相同的操作系统版本、相同的 CPU 架构),程序就能直接运行。这是静态链接最大的优势:部署简单,没有运行时的库依赖。
静态链接的代价体现在几个方面。可执行文件的体积会增长,因为每个使用了该库的程序都包含了一份库代码的副本。如果十个程序都静态链接了同一个大型库,磁盘上就会有十份这个库的代码。库的更新需要重新链接所有使用该库的程序。如果库修复了一个安全漏洞,所有静态链接了该库的程序都需要重新编译和重新发布。相比之下,动态库可以在不重新编译程序的情况下更新库文件本身。
ar 创建的静态库在各种 Unix 系统(Linux、macOS、BSD)上通用,但内部格式有些细微差异。macOS 上的 ar 创建的是 Mach-O 格式的静态库,Linux 上的 ar 创建的是 ELF 格式的静态库。Windows 上的静态库后缀是 .lib,由 MSVC 的 lib.exe 工具创建,内部是 COFF 格式的目标文件集合。ar t、ar rcs 这类命令的行为在各平台上是相通的,但目标文件本身的格式不同,导致 Linux 上创建的 .a 文件不能直接用于 macOS 链接器。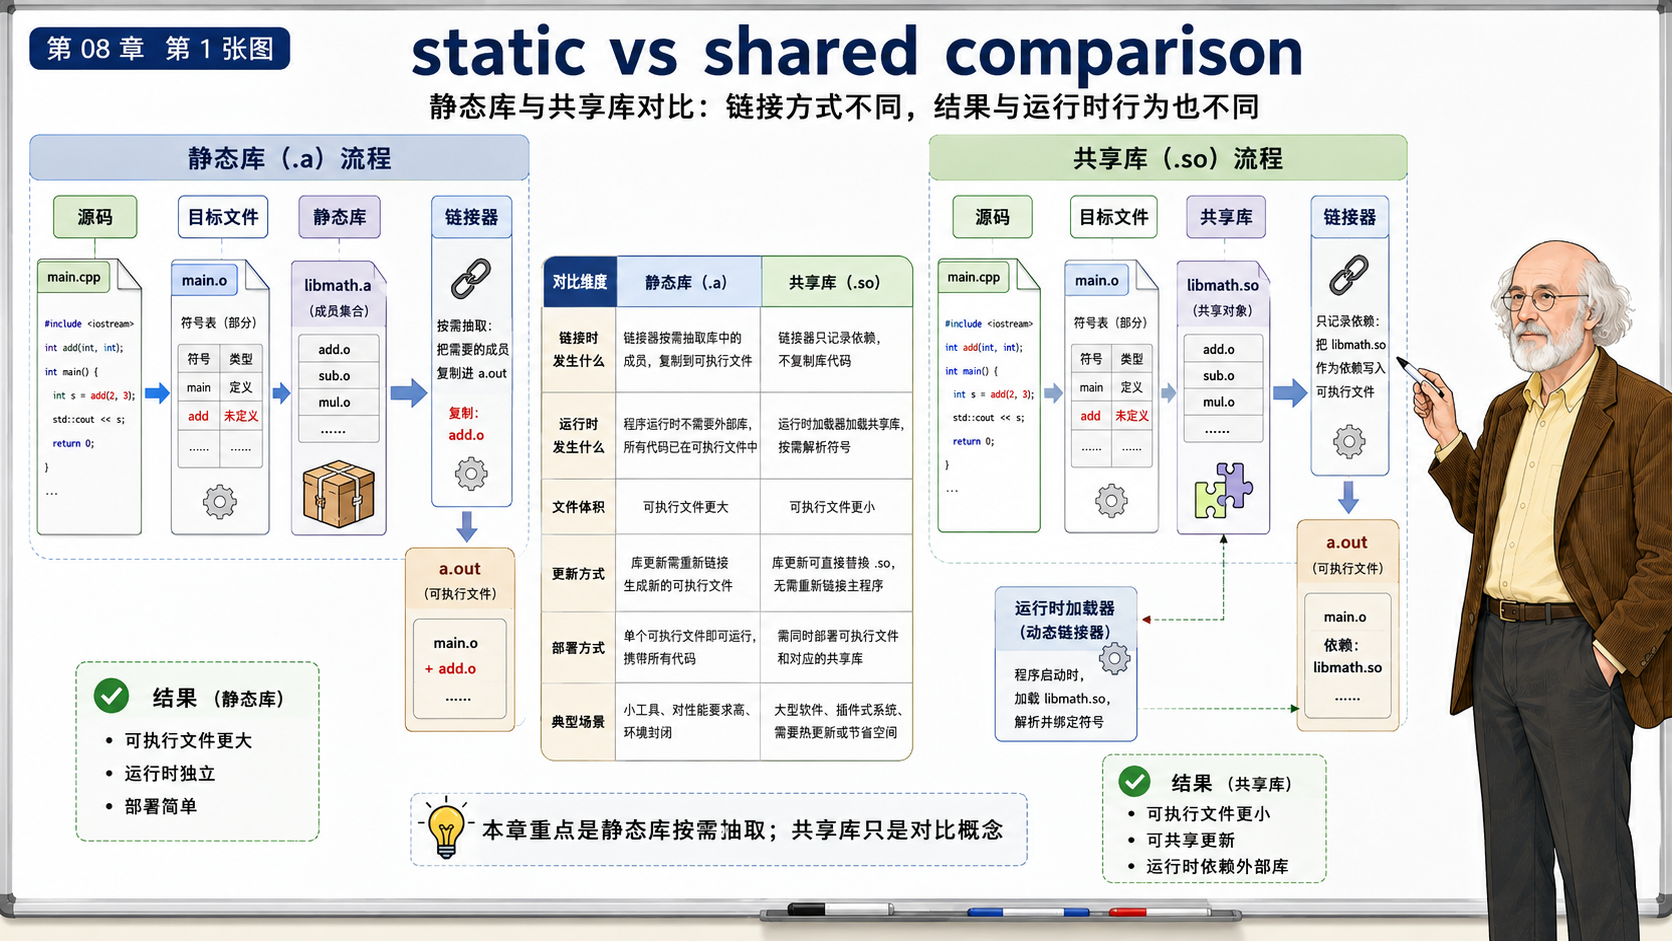
静态库是 C++工程中组织代码复用的基础手段。应用层的使用很简单:ar rcs 打包,-l 链接,这是每个 C++ 程序员都应该掌握的基础操作。理解静态库在链接器内部的处理算法(按需抽取和顺序扫描)则能帮助你在遇到链接顺序导致的 undefined reference 时,知道问题不在符号缺失,而在库的排列顺序。
常见的库链接顺序实践是把依赖关系从上到下排列:主程序的目标文件放在最前面,高层库紧随其后,底层库放在最后。如果库 A 使用了库 B 中的符号,B 应该出现在 A 之后。这条经验法则在大多数情况下都能让链接器的单趟扫描正确完成符号解析。如果项目中的库依赖关系非常复杂,出现了循环依赖,经验法则是把循环内的库重复列一次,或启用链接器提供的库分组扫描能力。
从工程管理的角度审视静态库,它解决了"十几上百个目标文件怎么管理和分发"的问题。把一个库的内部实现拆成多个 .cc 文件,编译成各自的目标文件,再用 ar 打包在一起。库的使用者只需要拿到头文件(接口声明)和 .a 文件(实现),不需要关心库内部有多少个源文件、各自叫什么名字。头文件提供声明,.a 提供定义,这个模型和前面四章建立的"声明/定义分工"以及"ODR 的唯一定义要求"完全吻合。
静态库和 ODR 的关系也值得点一下。静态库是由多个目标文件组成的归档,每个目标文件来自一个翻译单元。ODR 要求整个程序中每个外部符号只有一个定义,这个要求同样适用于静态库中的目标文件。两个不同的 .a 文件中不能包含同名的强符号定义,否则链接器在抽取过程中可能同时抽取两份,触发 multiple definition。排查这种跨库的重复定义时,可以用 nm 分别查看两个静态库的符号表,用 ar t 定位到具体是哪个目标文件提供了重复的符号。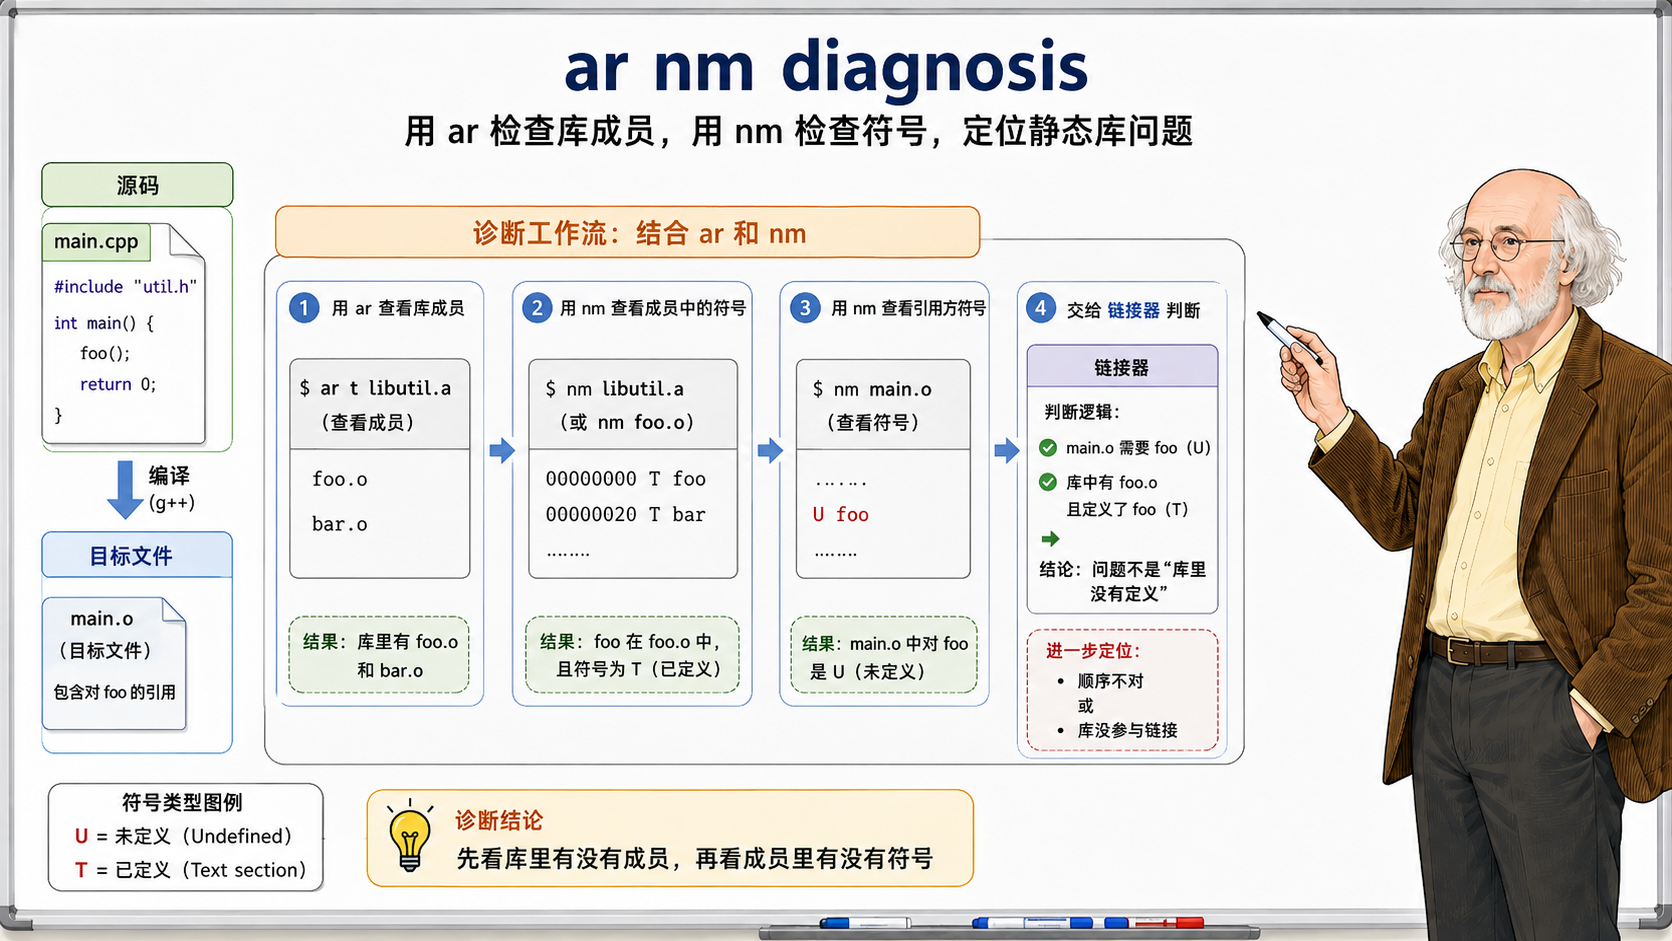
静态库的构建过程可以做到相当标准化。一个典型的 Makefile 或 CMake 模式是:add.cc 和 mul.cc 各自编译成 add.o 和 mul.o,ar rcs libmath.a add.o mul.o 打包。CMake 中 add_library(math STATIC add.cc mul.cc) 一步完成了编译和打包。这些构建系统的细节放在《图解 构建系统与工具链》中展开,本章聚焦在静态库本身的机制模型上。
有一个边界情况需要说明:如果静态库中的某个成员目标文件没有任何符号被引用,链接器不会抽取它,该成员提供的全局对象构造函数也不会被执行。这在某些依赖全局对象构造函数做自动注册的模式中是一个隐藏的坑。比如一个测试框架或插件框架可能在某个 .cc 文件里定义全局注册对象,构造函数负责把插件登记到全局表中;但主程序没有显式引用这个目标文件里的任何函数或变量,链接器就会认为这个成员不需要进入最终程序,注册动作自然不会发生。遇到这种模式,工程上通常会保留一个显式引用入口,或者使用平台提供的强制加载静态库选项,让链接器加载库中的全部目标文件,不再按符号需求筛选。
这个边界也解释了为什么"我已经把库传给链接器了"不等于"库里的所有代码都会生效"。静态库进入链接命令后,只是给链接器提供了一个候选集合。真正进入可执行文件的,是候选集合中被当前未解析符号需求选中的成员目标文件。没有被选中的成员继续留在 .a 文件里,不影响最终程序。这个机制对普通函数库很友好,因为它自动剔除未用代码;对自动注册、反射表生成、链接期插件发现这类模式就需要额外设计入口,否则代码看起来在库里,实际上从未进入可执行文件。
从二进制体积角度看,按需抽取还有一个重要后果:静态库的大小和最终可执行文件的大小没有线性关系。一个 100MB 的静态库被传给链接器,并不意味着可执行文件一定增加 100MB。如果程序只引用了库里一个很小的目标文件成员,链接器可能只抽取那一个成员。反过来,如果库的构建方式把大量功能都放进同一个巨大 .o,只要程序引用其中一个符号,整个目标文件成员都会被抽取,未用函数也可能一起进入可执行文件。静态库的抽取粒度是成员目标文件,不是单个函数。库作者把功能拆成多少个源文件,会影响使用者最终链接出来的体积。
这就是很多基础库会把实现拆成多个小 .cc 文件的原因。拆得太粗,链接器按需抽取的精度差;拆得太碎,构建系统和归档管理成本会上升。实际工程里通常按功能边界拆分:一组强相关函数放在同一个翻译单元,彼此独立的模块放在不同翻译单元。这样打包成静态库后,链接器既能按模块抽取,又不会让源文件数量失控。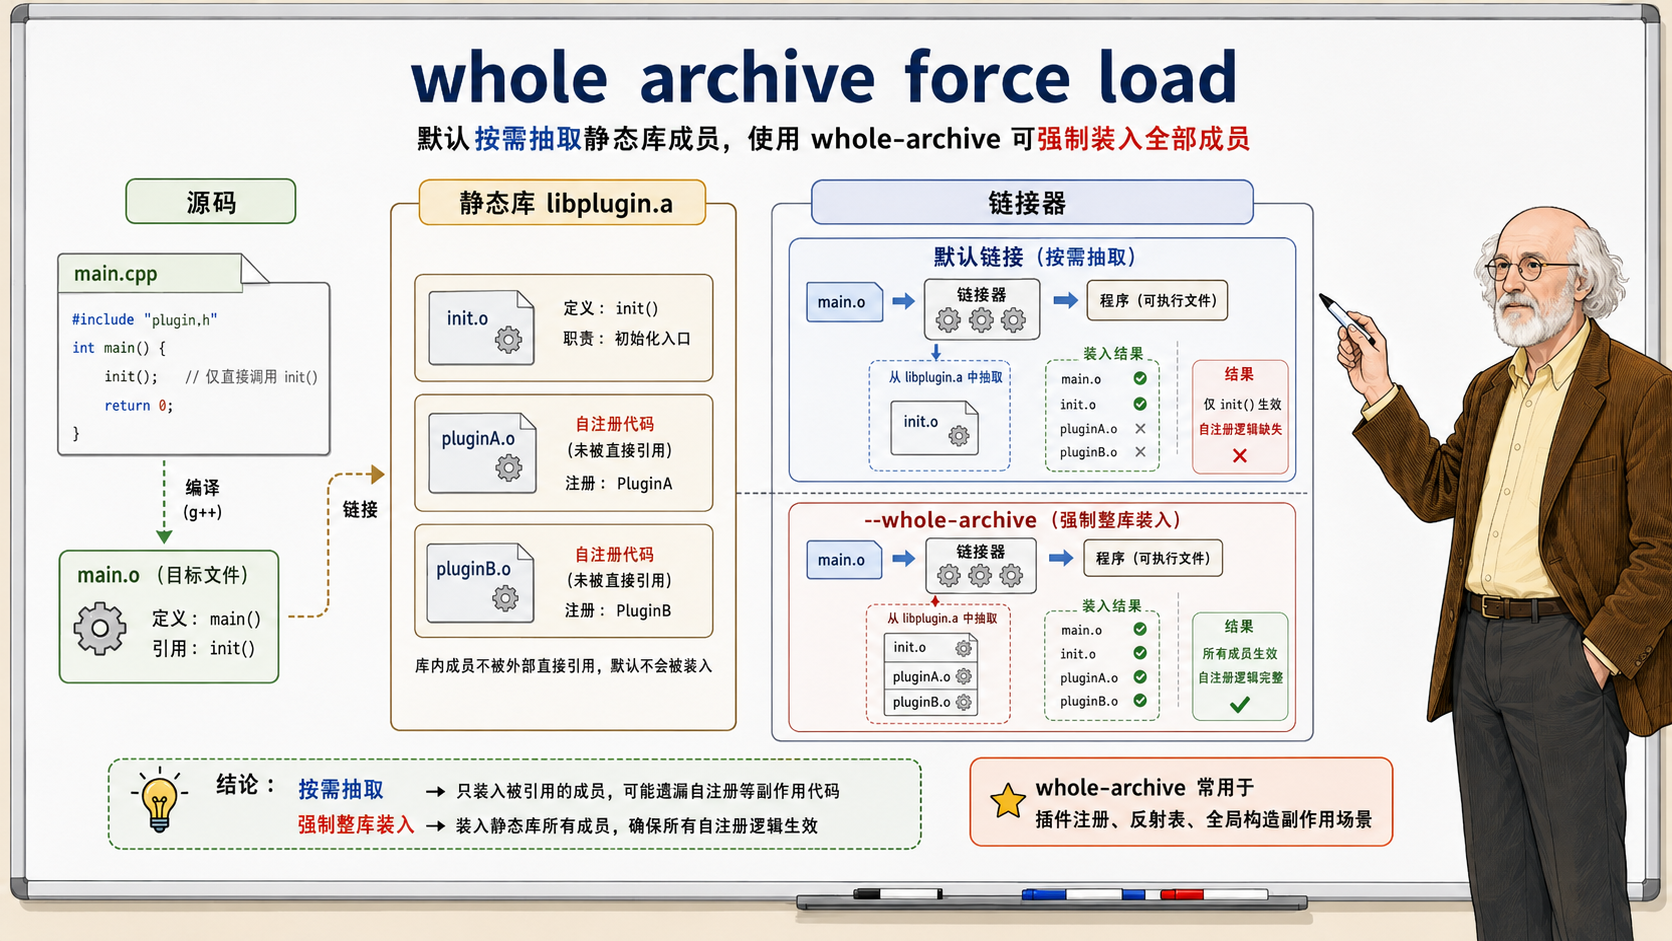
静态库的"像一包目标文件"这个直觉需要记住一个精确的修正:它不是简单的压缩包。压缩包只是把文件打包以便传输,链接器需要先解压才能读取其中的目标文件。静态库是归档格式,链接器可以直接在归档内部按索引查找符号并随机访问成员目标文件的内容,不需要先解压整个归档。这个索引就是 ar rcs 中 s 参数的产物:它在归档中写入一个符号到成员的映射表,链接器读取这个映射表后,能够快速判断某个未解析符号是由库中的哪个目标文件成员提供的。如果用 ar r 创建归档而没有 s,链接器可能无法正确识别库中成员的符号(除非之后用 ranlib 补建索引)。日常使用中直接用 ar rcs 一步到位即可。
把静态库看成"带索引的目标文件仓库",比把它看成一个普通库文件更贴近链接器的真实行为。
排查静态库问题时,最有效的办法是把库拆回目标文件视角。看到 undefined reference,先问两个问题:需要的符号在不在某个库成员里,那个成员有没有机会被抽取。第一个问题用 nm libmath.a 看符号表,确认目标符号是否标记为已定义。第二个问题看链接命令顺序,确认在扫描到这个库时,未解析符号集合里是否已经有对该符号的需求。很多链接错误表面像库里没有实现,实际原因是库放得太早,链接器扫描到它时还不知道后面会需要它。把符号存在性和抽取时机分开查,能避免在错误方向上反复改命令。
如果 nm 显示库里确实没有目标符号,问题就回到库的构建过程。可能是对应 .cc 没有编译进库,可能是函数签名和声明不一致导致 C++ 名字修饰后的符号名不同,也可能是函数被放进了匿名命名空间或标成了内部链接,只在当前目标文件内部可见。这个时候继续调换库顺序没有意义,因为链接器无论扫描多少次都找不到可对外使用的定义。要回到源文件、头文件和库打包命令,确认定义真的以外部可见符号进入了归档。
如果 nm 显示两个库都提供了同一个强符号,问题就变成第 5 章讲过的 ODR 冲突。静态库本身不会自动隔离同名符号。只要两个成员目标文件都被抽取进同一个程序,链接器就会在全局符号表里看到两个同名强定义。工程上常见原因是把普通函数定义放进头文件,或者两个库都打包了同一份公共源码。修复方向是让公共实现只存在一份,或者把真正需要头文件实现的函数改成符合规则的 inline。
还有一类问题来自库版本不一致。头文件来自新版库,.a 文件还是旧版库,编译阶段会通过,因为新版头文件提供了声明;链接阶段会失败,因为旧版静态库里没有对应定义。反过来,头文件是旧版、库是新版,也可能在函数签名、结构体布局或命名空间上出现不匹配。静态库发布时必须把头文件和库文件当成一组产物管理,不能只替换其中一个。这个习惯对动态库同样重要,只是动态库还会多出运行时路径和 ABI 兼容问题。
下一个要讨论的模型是动态库。动态库和静态库在"链接时被链接器读取"这一点上相同,但动态库的代码不完整复制进可执行文件,而是保留了一份运行时的依赖记录。这意味着动态库要同时面对链接期和运行期两个阶段,每个阶段都有自己找库的规则和路径,这个话题放在第 9 章展开。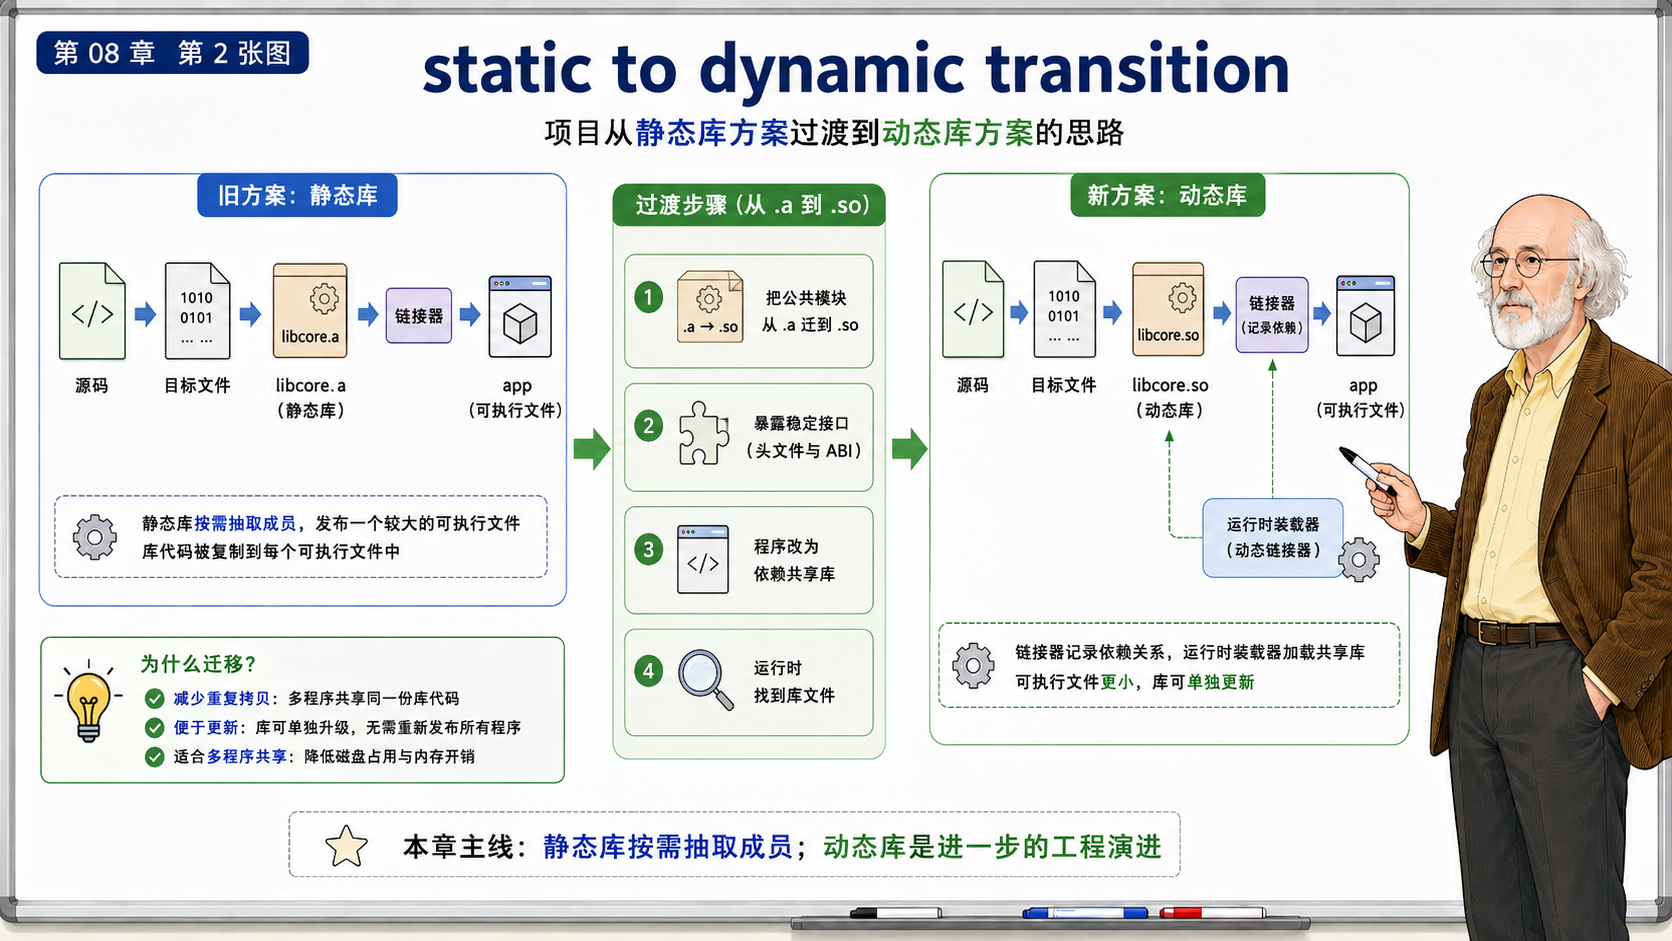
阅读导航



