
C++ 编译流程:预处理、编译、汇编与链接
01 一个 C++ 程序是怎样变成可执行文件的
创建一个 main.cc,写入几行 C++ 代码,然后在终端里敲一行 clang++ 命令,一个可执行文件就出现了。这件事大多数 C++ 程序员每天都在做,但这一条命令里面到底发生了什么,很多人并没有仔细拆过。
#include <iostream>int main() {
  std::cout << "hello from the build pipeline\n";
  return 0;
}
clang++ -std=c++20 -Wall main.cc -o hello
./hello
# 输出:hello from the build pipeline
程序的源码不到十行,命令也只有一行,从敲回车到看到输出不到一秒。这里面藏着 C++ 工具链最核心的一条流水线:源码文本先经过预处理展开成完整的翻译单元,再由编译器转成汇编代码,汇编器把汇编转成目标文件的机器码,链接器再把目标文件和库拼成操作系统能直接加载的可执行文件。一条 clang++ 命令之所以能完成所有这些事,是因为它的角色是一个总控程序(compiler driver),按顺序调度预处理器、编译器、汇编器和链接器,把前一阶段的输出转交给下一阶段。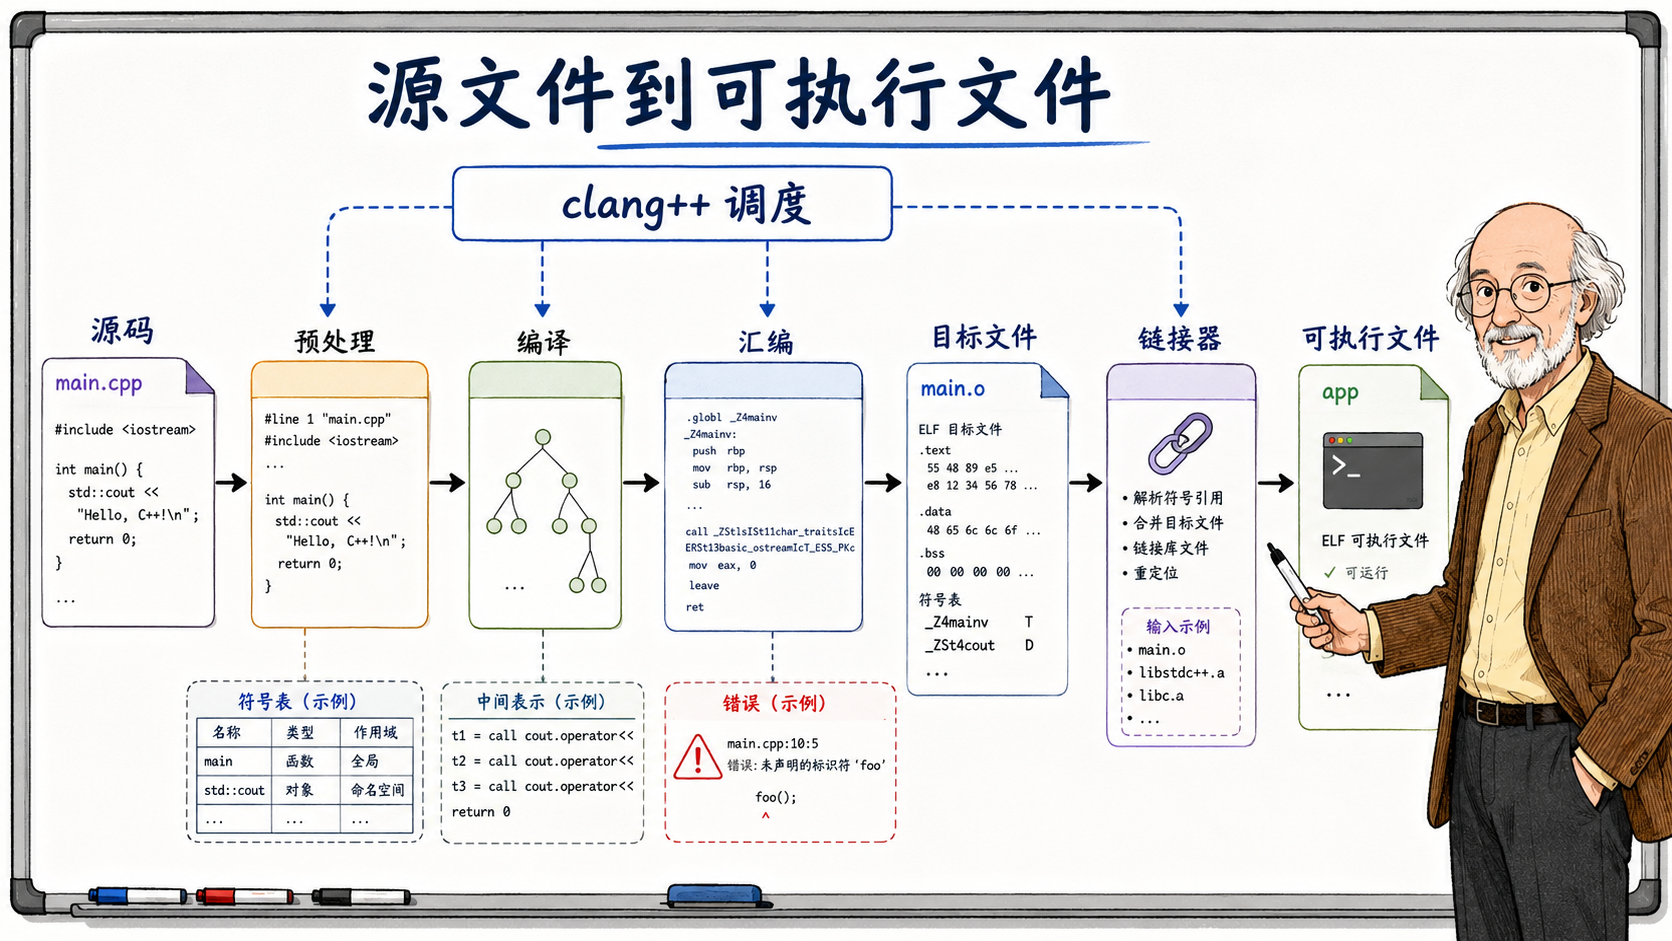
本章把这条命令拆开,用 clang++ 自带的控制参数让它在每个中间阶段停下来,把中间产物留在磁盘上。读者看到的行数、文件大小和文件类型都是在一台 Apple Silicon Mac 上用 Clang 实际跑出来的数字,不同平台和不同工具链的具体数值会有差异,但流水线的逻辑结构是共通的。
clang++ 是总控程序,不是单一的编译器
很多教程把 clang++(以及 g++)称为"C++ 编译器",这个说法在日常交流中没问题,但从工具链架构的角度看,clang++ 本身并不直接做语法分析、代码生成或机器码输出。它是一个 driver,负责解析命令行参数、决定调用哪些工具、按什么顺序调用、传递哪些选项。真正干活的是它调度的一组独立程序:预处理器(preprocessor)、编译器前端(compiler frontend)、汇编器(assembler)和链接器(linker)。
用一个类比来建立直觉:clang++ 像一个项目经理,接到"把这份源码变成可执行文件"的需求后,它把任务分解成几个阶段,分别交给团队里不同的人,最后把各阶段的产出串成最终交付物。你可以在任何一个阶段喊停,项目经理会把到目前为止的中间产物交给你。
从源码到可执行文件的标准流水线是四段。第一段是预处理,输入 .cc 源文件和它通过 #include 引入的所有头文件,输出一个展开后的纯文本文件(习惯上叫 .i 文件)。第二段是编译,输入预处理后的文本,输出汇编代码文本(.s 文件)。第三段是汇编,输入汇编文本,输出二进制目标文件(.o 文件)。第四段是链接,输入一个或多个目标文件以及程序依赖的库,输出可执行文件。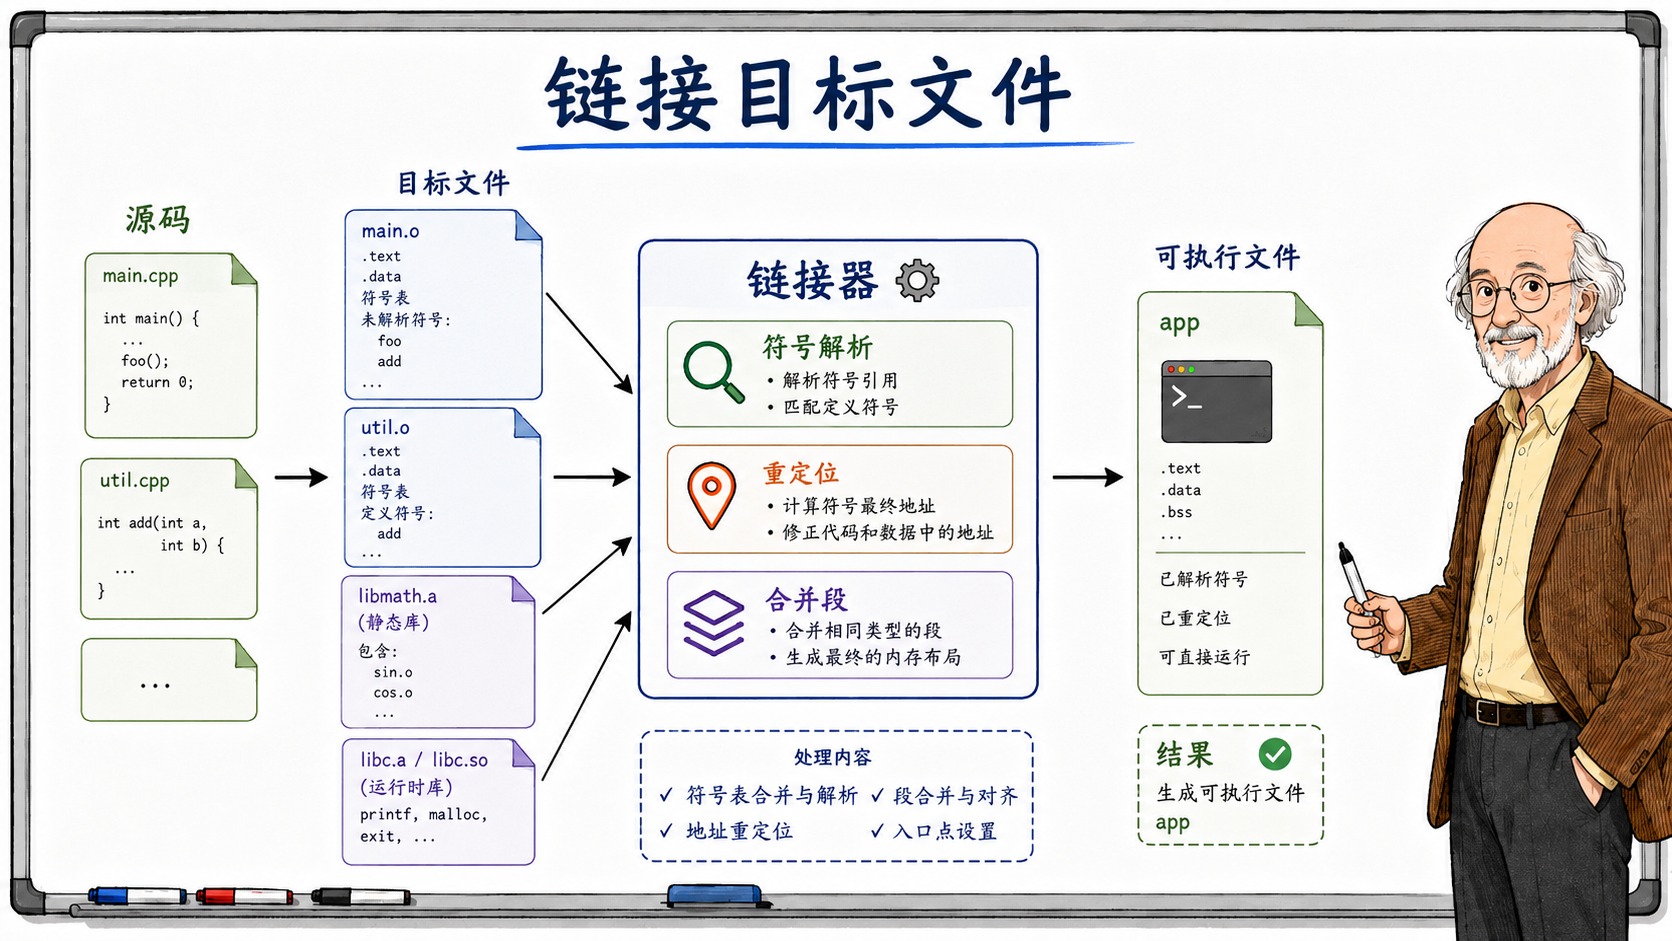
在 Clang/LLVM 工具链内部,预处理通常由 clang 的预处理模式完成,编译由 clang -cc1 这个前端进程完成(负责词法分析、语法分析、语义分析、中间代码生成和汇编代码输出),汇编由系统汇编器(通常是 as 或 LLVM 内置的集成汇编器)完成,链接由系统链接器(macOS 上是 ld,Linux 上通常是 GNU ld 或 lld)完成。GCC 工具链的调度方式类似,只是内部工具的名称和分工略有不同:预处理由 cpp(C preprocessor)完成,编译由 cc1 或 cc1plus 完成,汇编由 as 完成,链接由 collect2 调度 ld 完成。日常开发中不需要关心这些内部工具的具体名称,但知道它们存在,对于理解后面要讲的编译错误和链接错误分别由哪个环节产生有直接帮助。
clang++ main.cc -o hello 这条命令会让 driver 一口气跑完四段,中间文件不落盘,直接通过管道或临时文件传递。这种全自动模式在日常开发中很高效,但学习编译链接模型时,需要主动让它停下来,把每一段的产物拿出来看。Clang(以及 GCC)提供了一组控制参数来做这件事:-E 停在预处理后,-S 停在编译(生成汇编)后,-c 停在汇编(生成目标文件)后。不传任何停步参数时,driver 默认走完全程直到链接出可执行文件。这四个参数就是本章用来观察流水线内部结构的窗口。
预处理:文本展开
先用 -E 让 driver 在预处理阶段结束后停下来:
clang++ -std=c++20 -E main.cc -o main.i
main.i 是预处理后的文本文件。用 wc -l 看一下行数,在本机验证中得到约 93446 行。一个不到十行的源文件,经过预处理后膨胀到了近十万行。
原因在于 #include <iostream>。#include 做的事情非常朴素:它把指定文件的内容完整复制到当前文件的 #include 指令所在位置。<iostream> 本身包含了 <ios>、<streambuf>、<istream>、<ostream> 等一系列标准库头文件,这些头文件又各自包含更多头文件,最终形成一个很大的头文件树。预处理器的输出就是这个树的完整展开结果:除了 main.cc 原来的几行代码,前面还塞进了所有被包含头文件的内容。
打开 main.i 翻到最后,你会看到自己写的 main 函数安安静静地待在近十万行展开文本的最末尾。在它前面的是标准库的完整声明:类定义、函数声明、模板、inline 函数、类型别名、各种 extern 声明。这些内容原本分散在几十个头文件里,预处理阶段把它们全部拉进同一个文本流,形成编译器接下来要处理的"翻译单元"(translation unit)的完整面貌。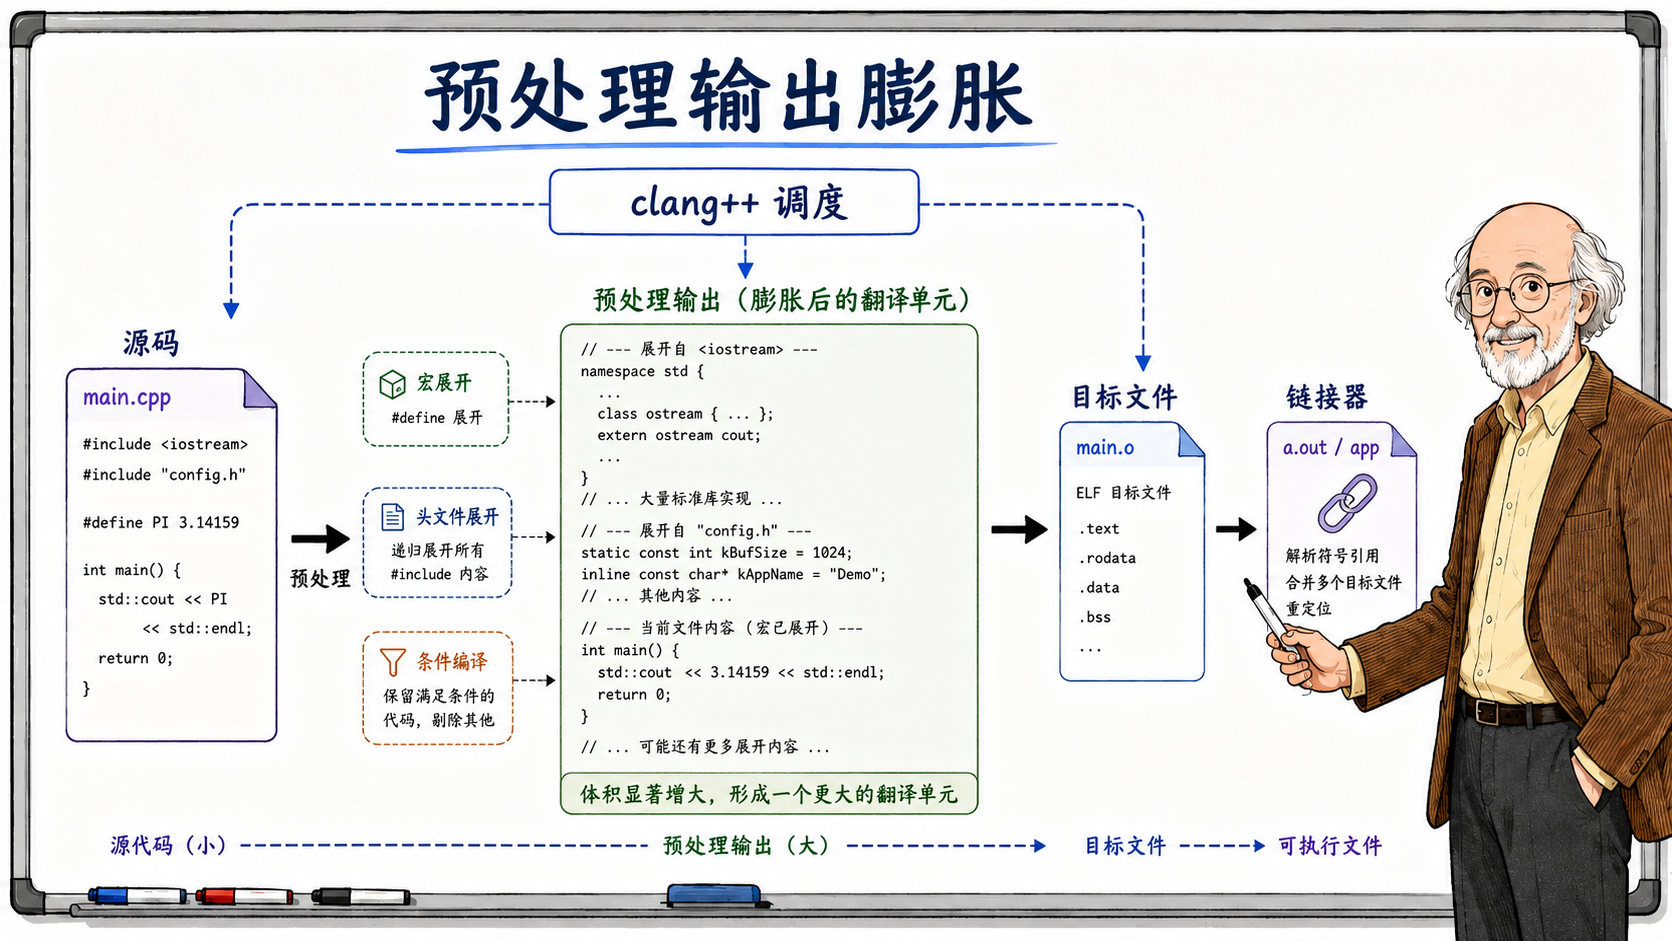
预处理阶段不只做 #include 展开,它还处理宏替换(#define)、条件编译(#ifdef/#ifndef/#endif)、行号标记(#line)等指令,最终产出一个没有任何预处理指令残留的纯 C++ 源码文本。不过对于理解编译链接流水线来说,现阶段只需要抓住一个关键点:预处理器的输出是一个完整的、自包含的文本文件,里面不再有任何 #include 或 #define,只有展开后的 C++ 代码,编译器拿到它之后就可以开始做真正的语法和语义分析。头文件的组织方式、include guard 的机制、宏对后续编译的影响,这些放在下一章展开。
编译:从 C++ 到汇编
拿到了预处理后的完整文本,编译器就可以真正开始工作了。用 -S 让 driver 在编译阶段结束后停下:
clang++ -std=c++20 -S main.cc -o main.s
传给 -S 的可以是源文件 main.cc(driver 会先自动做预处理再编译),也可以是已经预处理好的 main.i。对于日常实验来说直接传源文件就行。
编译阶段的核心任务是把 C++ 源码翻译成汇编代码。汇编代码是人类可读的机器指令文本,每一行基本上对应一条 CPU 指令。本机验证中,main.s 大约有 1380 行。相比预处理后的近十万行,这个数字缩小了近两个数量级。
缩小的原因很直接:预处理阶段把大量标准库头文件内容拉了进来,但编译器只生成那些真正被用到的代码。std::cout << "..." 虽然背后涉及很多模板实例化和运算符重载,但它最终对应的机器指令数量仍然远小于头文件中各种声明、注释、未用到的模板和条件编译分支的文本体量。编译器不会把每个看见的声明都翻译成指令,只有实际被引用的实体才会进入代码生成。从编译器的视角看,预处理后的近十万行文本里,绝大多数是声明(告诉编译器某样东西存在、长什么样),声明的信息被编译器吸收进内部的符号表和类型系统后就完成了使命;真正需要生成机器码的,只有源文件里那些实际被调用的函数和实际被操作的对象。
编译阶段内部本身也是一个多步骤的过程。编译器先做词法分析,把字符流切成一个个 token(关键字、标识符、字面量、运算符);再做语法分析,按 C++ 文法把 token 序列组织成抽象语法树(AST);接着做语义分析,检查类型是否匹配、函数调用是否合法、访问权限是否正确;然后生成中间表示(intermediate representation,IR),在 LLVM 中就是 LLVM IR;最后把 IR 翻译成目标平台的汇编代码。这一整套流程全部在编译阶段内部完成,从外面看就是"进去一段 C++ 文本,出来一段汇编文本"。内部各步骤的细节会在编译器原理相关的课程中展开,本系列关注的是编译阶段在整个构建流水线中的位置和输入输出关系。
打开 main.s 可以看到汇编代码的典型结构:文件开头是一些汇编指示字(directives),比如 .section 指定代码放在哪个段、.globl 声明对外可见的符号。随后是函数体的指令序列,比如 _main 标签下面按顺序排列的 stp、sub、adrp、ldr、bl 等 ARM64 指令。即使不熟悉 ARM64 汇编,也能从结构上看出这些指令在做几件事:设置栈帧、准备参数、调用函数、清理返回值。其中 bl(branch with link)指令就是函数调用,你能看到对 std::cout 相关符号和 operator<< 的调用。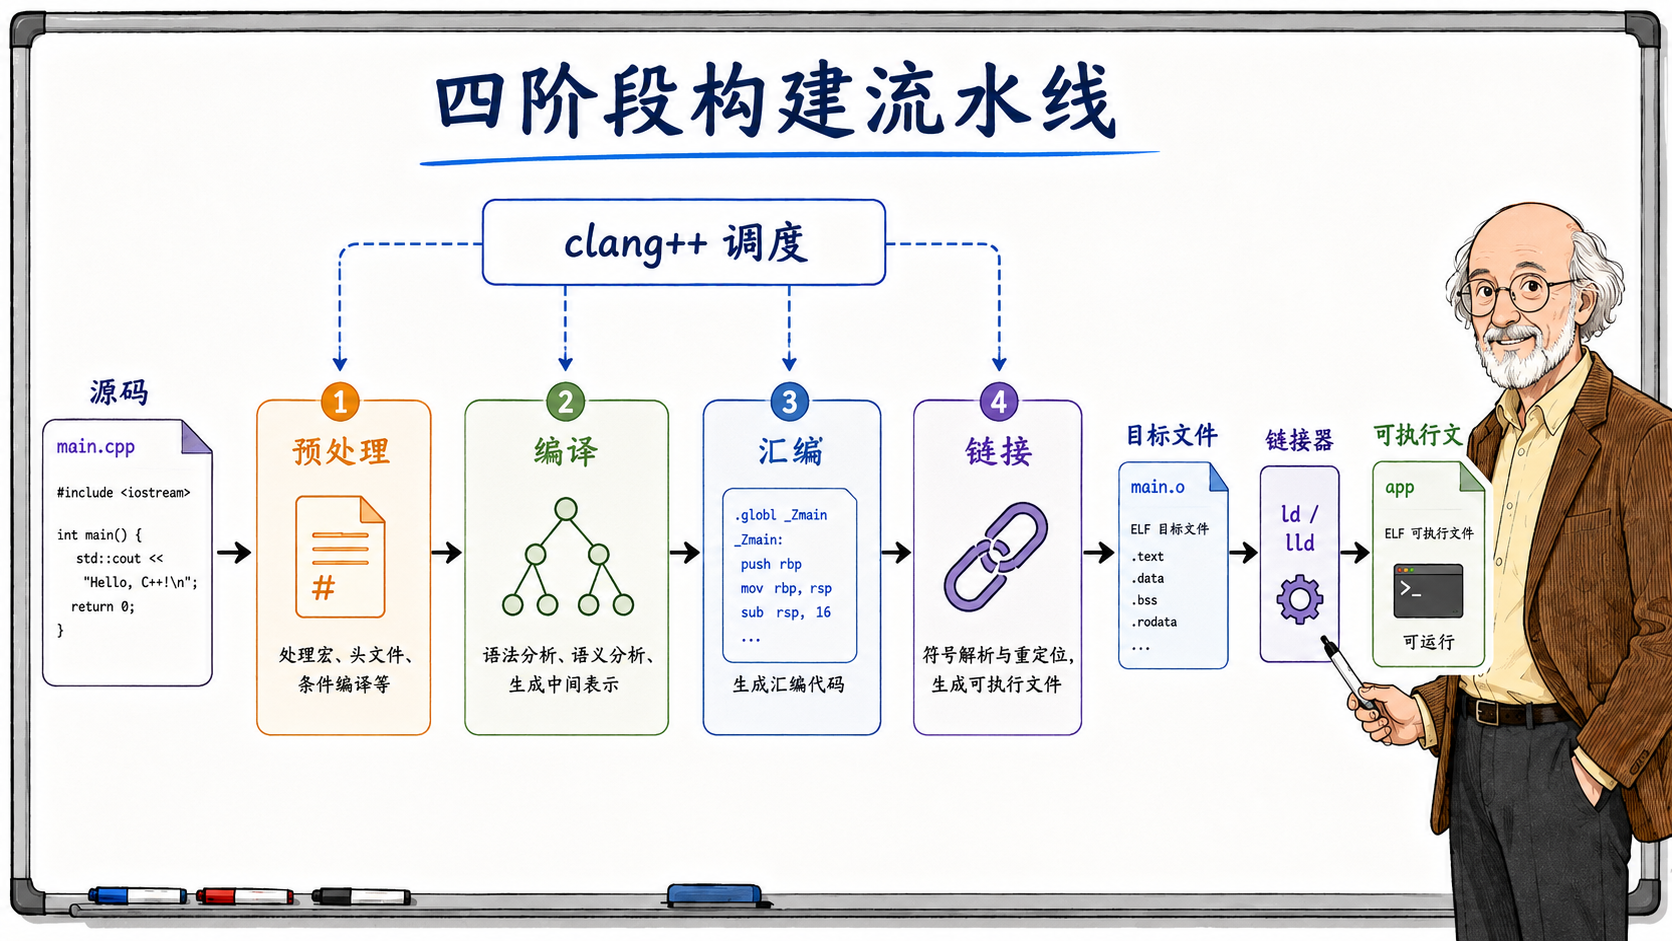
汇编代码已经非常接近机器能执行的形式,但它仍然是文本。CPU 不认识文本形式的 bl _ZNSt3__14coutE,CPU 只认识编码后的二进制指令。汇编阶段负责这一步转换。
汇编:从文本到目标文件
用 -c 让 driver 在汇编阶段结束后停下:
clang++ -std=c++20 -c main.cc -o main.o
-c 的意思是"compile only",这个命名在历史上有点歧义:它实际上包含了预处理、编译和汇编三个阶段,只是不执行最后的链接。产出的 main.o 是一个二进制目标文件(object file)。
用 file 命令查看 main.o 的属性,在本机验证中得到 Mach-O 64-bit object arm64。这说明它是 Mach-O 格式的 64 位目标文件,包含 ARM64 指令。用 ls -l 查看大小,约 9816 字节,也就是不到 10KB。从近十万行预处理文本,到一千多行汇编文本,再到不到 10KB 的二进制目标文件,每一步都在从"给人看的文本"向"给机器执行的二进制"逼近。
目标文件里有什么?它已经不是纯文本了,不能直接用编辑器阅读。它里面包含几个关键部分:编译生成的机器码(放在 .text 段或类似段里)、程序中用到的常量数据(放在 .rodata 之类的只读数据段里)、符号表(symbol table,记录了这个目标文件提供了哪些函数和变量、需要从外部获取哪些函数和变量)以及重定位信息(relocation,告诉链接器哪些地址引用需要在最终链接时修正)。为什么要把机器码和数据分开放在不同的段里?因为不同段有不同的访问属性和生命周期:.text 里的机器码在运行时是只读且可执行的,.rodata 里的常量是只读但不可执行的,后续章节讲到的全局变量所在的 .data 和 .bss 则是可读可写但不可执行的。段的划分让操作系统和链接器能够对不同类型的代码和数据施加不同的权限和优化策略。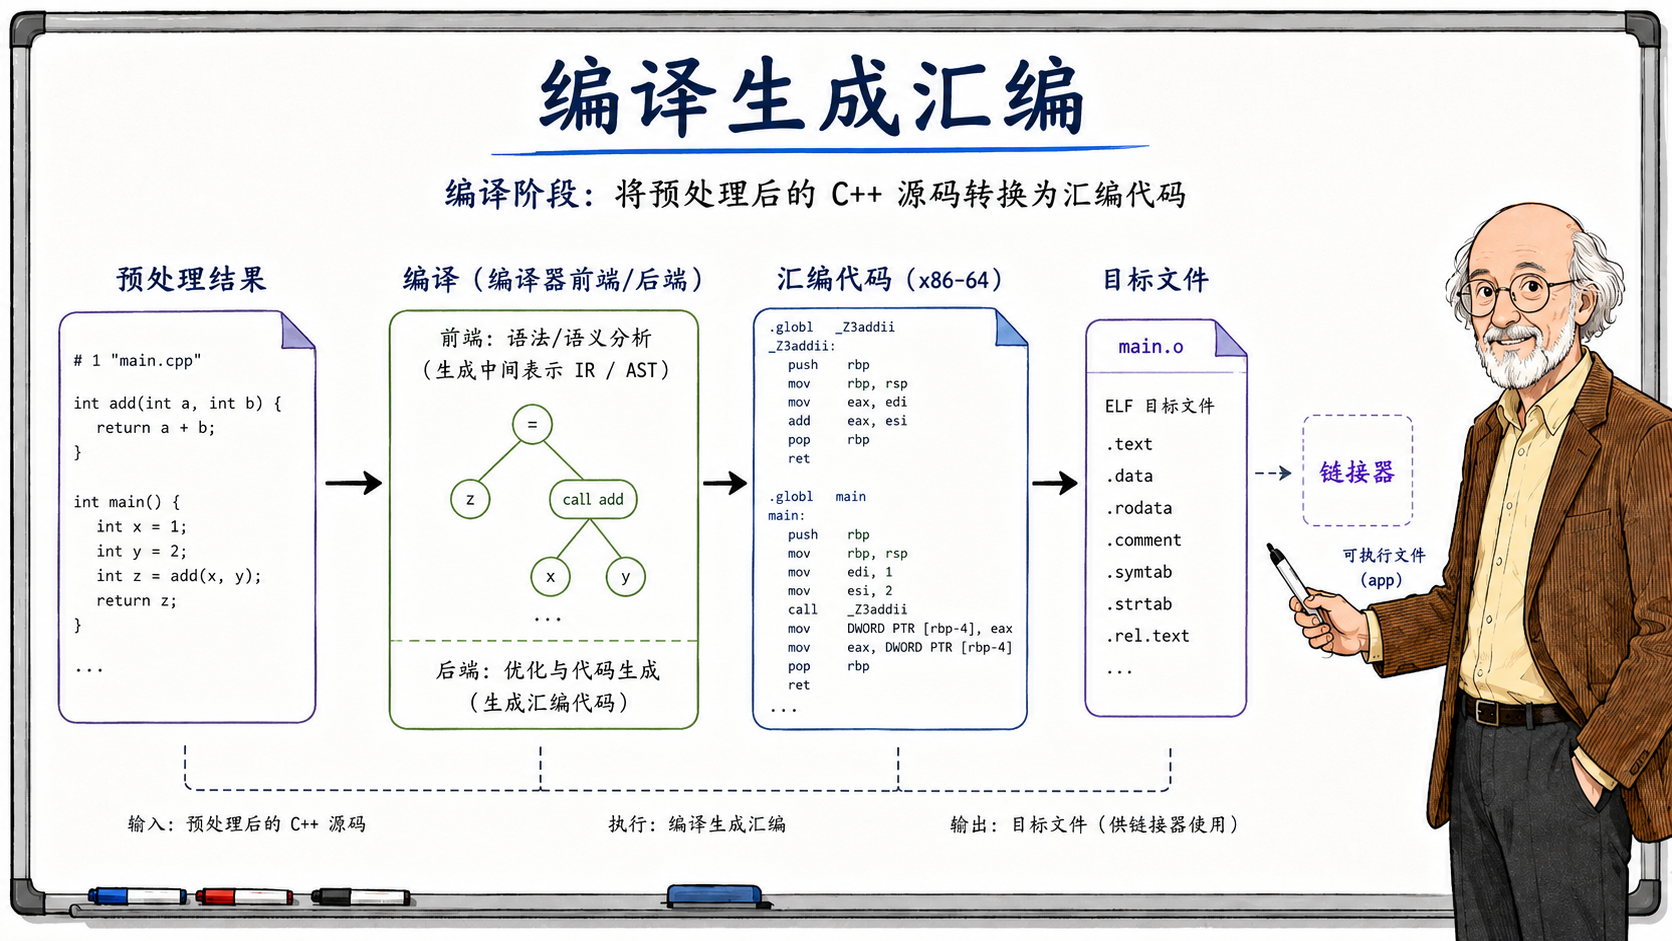
每一段机器码和每一个符号表条目在后续章节都会展开讲,现阶段先建立总体直觉:目标文件是一块已经翻译好的机器码,但它还不能直接运行。原因有两个。第一个是地址问题:代码里对 std::cout 等外部符号的引用还是占位状态,这些符号的最终地址要等链接器把多个目标文件和库拼在一起之后才能确定。这就像你写了一个函数调用 printf(...),汇编器能把调用指令本身编码出来,但被调用方的地址还不知道,只能先留一个空位,等链接时再填。第二个是依赖问题:程序要跑起来,除了 main 函数本身的代码,还需要启动例程(startup routine)来初始化标准库、设置全局对象、调用 main、处理返回值。这些启动代码不在 main.o 里,它们存在于 C++ 运行时支持库中,只有链接阶段才会被拉进来。
用 nm 工具看一眼 main.o 的符号表,能清楚地看到已定义符号和未定义符号的区分:main 函数是这个目标文件提供的已定义符号,而 std::cout、operator<<、std::ios_base::Init 等是未定义符号(在 nm 输出中通常标记为 U),链接器需要在后续阶段为它们找到定义。
链接:拼出可执行文件
最后一步是把目标文件交给链接器:
clang++ main.o -o hello
这里没有用 -std=c++20 或 -Wall,因为这些是编译器参数,对于只做链接的步骤来说不需要。clang++ 识别到输入是 .o 文件后,直接把它转交给链接器处理。链接器读入 main.o,检查符号表里有哪些未定义的符号,然后去标准库和其他默认库中寻找这些符号的定义。找到了 std::cout、operator<<、启动例程等符号的定义后,链接器把所有需要的代码和数据从各个目标文件和库中提取出来,合并到一个文件里,修正所有地址引用,最终生成操作系统能加载的可执行文件。
用 file 命令查看 hello 的属性,本机验证得到 Mach-O 64-bit executable arm64。注意它从 object 变成了 executable,这是链接器的核心贡献:它把多个不完整的目标文件合成了一个完整的、操作系统能直接装载运行的程序。
这里有一个容易被忽视的事实:即使是只有一个源文件的程序,也必须经过链接阶段。很多初学者会困惑:"我就一个 main.cc,又没有引用其他 .cc 里的函数,为什么还要链接?"因为 main.cc 引用了标准库,std::cout 的定义在标准库的实现文件里,不在 main.cc 的编译产物里。编译阶段看到 #include <iostream> 只是让编译器知道了 std::cout 的声明(它长什么样、怎么用),编译器检查完类型和语法就继续往下走了,并没有把 std::cout 的实际实现代码放进 main.o。链接器的任务就是把 main.o 中对 std::cout 的引用和标准库中对 std::cout 的定义对接上。这个"声明在头文件里,定义在库的实现文件里"的模式,是 C++ 工程组织的基础,后续章节讲声明与定义分离以及符号解析时还会反复回到这个主题。
除了标准库符号,链接器还会自动链接 C++ 运行时支持(C++ runtime support)和 C 运行时启动代码(C runtime startup,常被称为 crt0)。启动代码负责在 main 函数被调用之前完成运行环境初始化,包括设置栈、初始化全局对象、配置标准输入输出流等。程序运行时,CPU 最先执行的是启动代码的入口点,启动代码做完准备工作后才调用 main,main 返回后启动代码再负责清理和退出。这一切对写单文件程序的开发者来说是透明的,但理解它的存在,对后面理解动态库加载顺序、全局对象初始化时机、以及某些诡异的启动崩溃有直接帮助。
错误出现在不同阶段
理解了四个阶段的输入输出之后,一个直接的工程收益是:看到编译错误信息时,你能判断它卡在哪一关。不同阶段的错误,排查方向完全不同。
预处理和编译阶段的错误通常表现为语法错误、类型不匹配、找不到声明、头文件路径错误。这类错误的共同特征是链接器还没开始工作就报错了,命令行输出里不会出现 ld: 或 linker 字样。举个例子:写错了 std::cout 的名字变成 std::cot,编译器会在语义分析阶段发现 cot 不是 std 命名空间里的已知名字,报出 no member named 'cot' in namespace 'std';漏了语句末尾的分号,语法分析阶段就会报 expected ';' after expression;#include 的头文件路径不对,预处理阶段直接报 fatal error: 'xxx.h' file not found。排查这类错误时关注的是代码写法、类型系统和头文件搜索路径(-I 参数)。
链接阶段的错误表现为 undefined reference(未定义引用)和 multiple definition(重复定义)。链接器已经拿到了所有目标文件,但在符号表里找不到某个被引用的符号,或者发现了多个同名的强定义。这类错误信息里通常有 ld: 前缀(在 Clang/GCC 工具链上),说明编译和汇编都已经通过了,问题出在符号解析。举个例子:你在一个 .cc 文件里调用了 add(1, 2),但忘记把定义 add 函数的那个 .cc 文件编译出的 .o 文件传给链接器,链接器就会报 undefined reference to 'add(int, int)',其中的 add(int, int) 是经过名字修饰(name mangling)以后的 C++ 符号名。排查时关注的是函数和变量是否真的被定义了、库是否被正确链接(-l 和 -L 参数是否正确)、目标文件是否被遗漏、是否存在违反单一定义规则(ODR,One Definition Rule)的写法。
运行时的加载错误在编译和链接都成功之后才可能出现,通常涉及动态库。程序启动时,操作系统的动态装载器(dynamic loader)会根据可执行文件中记录的依赖信息去搜索所需的动态库文件。如果动态库不在系统搜索路径里,程序会直接启动失败,报出的错误类似 dyld: Library not loaded(macOS)或 error while loading shared libraries(Linux)。这类错误和源码本身无关,排查时关注的是动态库的安装位置、运行时搜索路径配置(如 LD_LIBRARY_PATH、DYLD_LIBRARY_PATH、RPATH)。
把这三种错误的位置放进同一个心智模型:源码的语法和类型问题卡在编译阶段之前或编译阶段之内,符号引用和定义匹配问题卡在链接阶段,动态库路径和环境问题卡在程序启动时。看到一个错误,先分辨它出现在哪个阶段,再去对应阶段找原因,比直接在几千行错误输出里乱翻高效得多。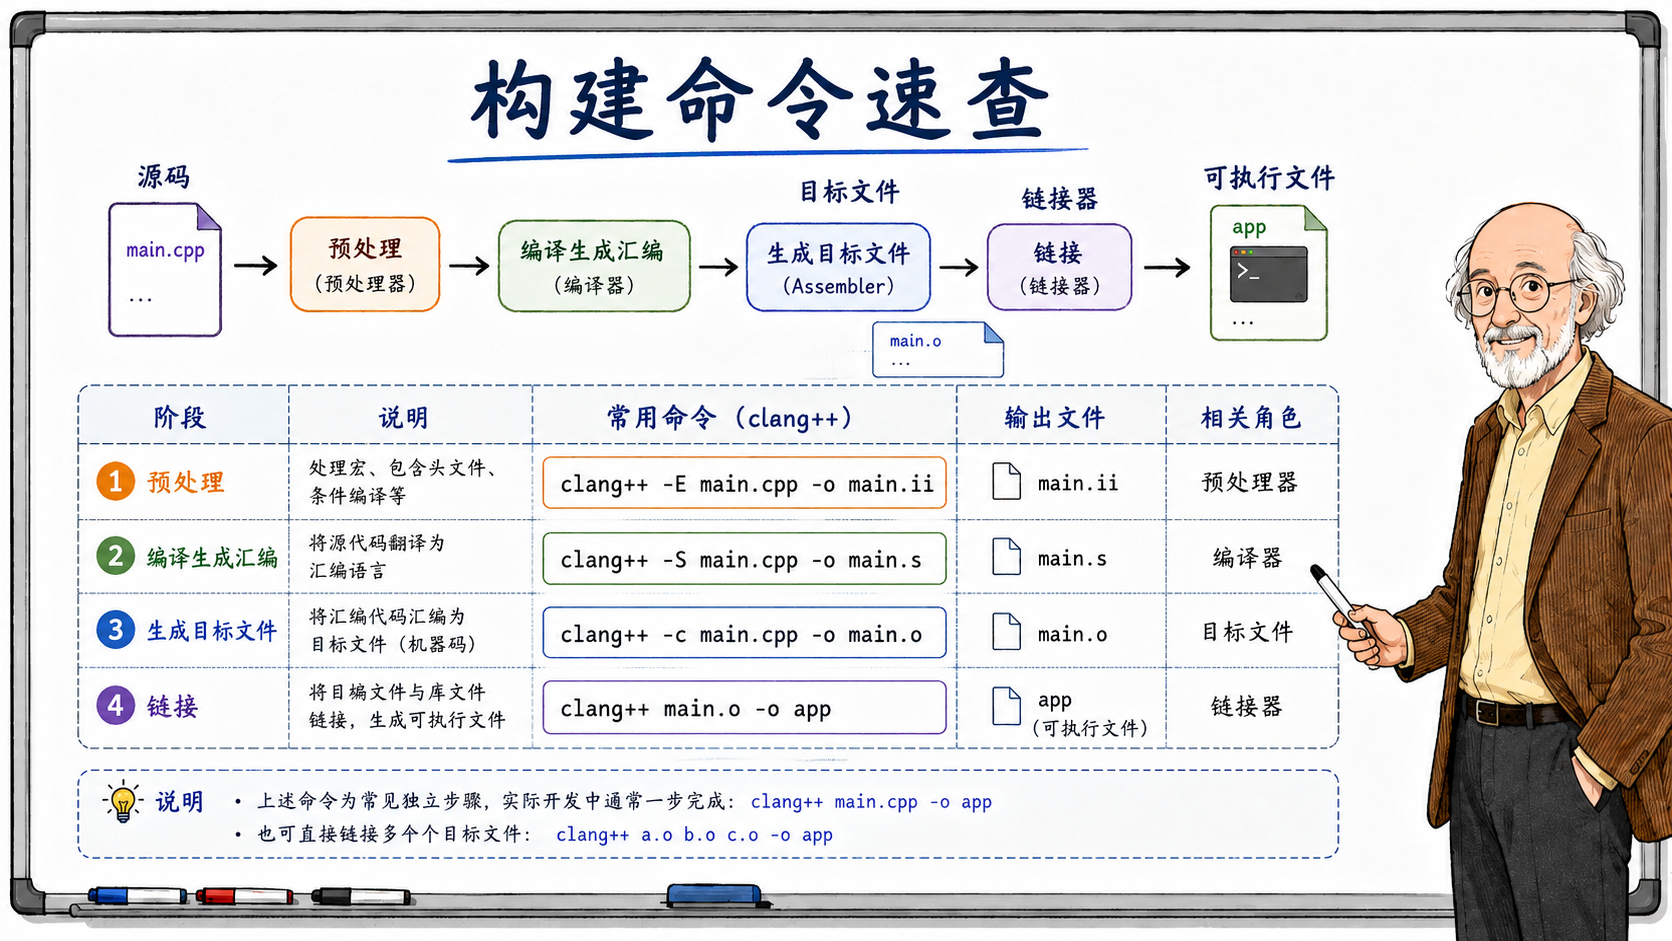
从流水线视角理解 C++ 构建
回到开头那条命令:clang++ -std=c++20 -Wall main.cc -o hello。经过本章的拆解,这条命令不再是"编译器把源码变成程序"这样一个模糊的黑盒,而是一条四段流水线的快捷入口。预处理把分散的头文件合并成一个完整的翻译单元,编译把翻译单元转成汇编代码,汇编把汇编转成目标文件的机器码,链接把目标文件和库拼成操作系统能加载的可执行文件。
单文件程序和多文件程序在这条流水线上的差别只在于链接阶段的输入数量。单文件程序只有一个目标文件,但它引用了标准库和运行时库,链接器仍然需要把这些外部符号的定义拉进来。多文件程序每个 .cc 文件各自生成一个目标文件,链接阶段把它们合并到一起,同时接上库。从流水线的角度看,并没有"单文件程序不需要链接"这回事,只是单文件程序让链接的复杂度被工具链自动处理了,开发者感受不到。
接下来的章节会沿着这条流水线逐段深入:下一章讲预处理和头文件,把 #include 展开、include guard 和宏替换的机制讲透;再往后讲翻译单元的本质、声明与定义的分离、单一定义规则、目标文件的内部结构,以及链接器如何做符号解析。理解了每一段,反过来再看 clang++ 这条命令,你会清楚地知道每一步在做什么,以及出了问题该往哪个方向排查。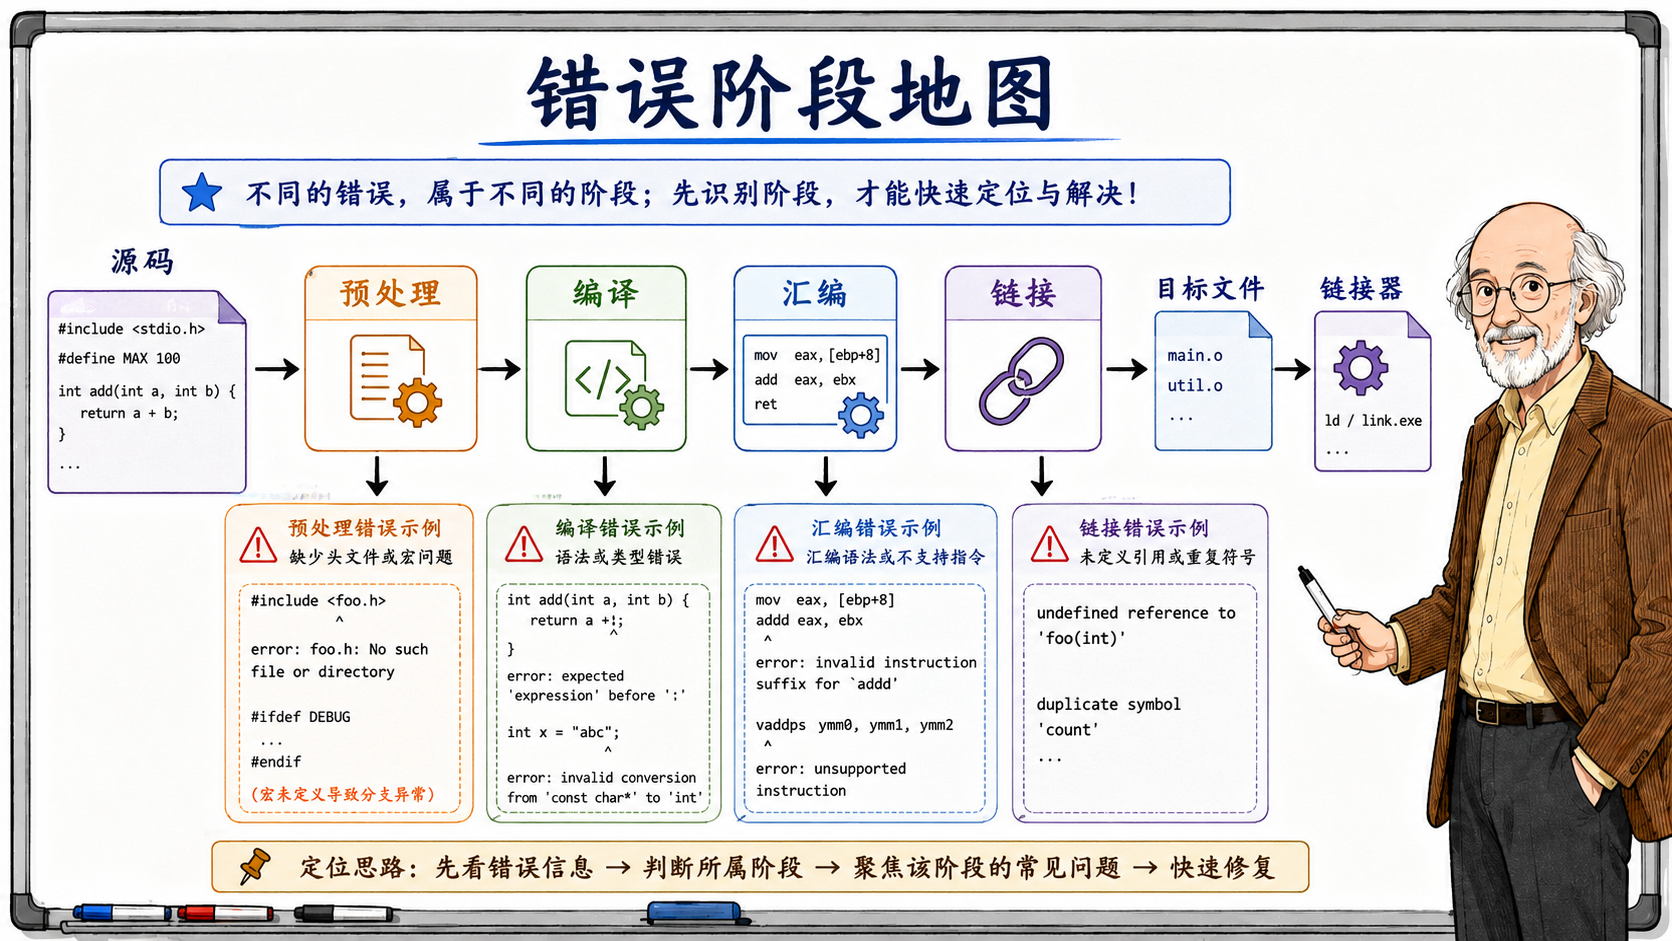
阅读导航



