
C++ 目标文件结构:机器码、符号表与重定位
06 目标文件里到底有什么
第 3 章讲过,一个翻译单元经过编译器处理之后产出一个目标文件(.o)。这个文件不是 C++ 源码,也还不是可执行文件,它是编译链路中间的一道半成品:翻译单元里的代码已经被转成了机器码,但对外部符号的引用还悬着,整体的地址布局还没确定。目标文件的存在价值是让每个翻译单元可以独立编译,把跨翻译单元的符号解析和地址安排推迟到链接阶段统一处理。
用一套最小例子开始观察。math.h 声明 Add,math.cc 实现它,main.cc 调用它并且额外定义了一个全局变量和一个字符串常量。
// math.h
#ifndef MATH_H_
#define MATH_H_

int Add(int left, int right);

#endif
// math.cc
#include "math.h"

int Add(int left, int right) {
  return left + right;
}
// main.cc
#include "math.h"

#include <iostream>

namespace {
constexpr int kLocalBias = 1;
}  // namespace

const char kMessage[] = "symbol demo";
int g_total = 0;

int main() {
  g_total = Add(40, kLocalBias);
  std::cout << kMessage << ": " << g_total << "\n";
  return 0;
}
分别编译,拿到两个目标文件:
clang++ -std=c++20 -Wall -c main.cc -o main.o
clang++ -std=c++20 -Wall -c math.cc -o math.o
main.o 和 math.o 都是二进制文件,不能直接用文本编辑器阅读。用 file 命令看属性,macOS 上会输出 Mach-O 64-bit object arm64,Linux 上则是 ELF 64-bit LSB relocatable。格式不同,但里面装的东西在结构上是相通的:机器码、数据、符号表和重定位信息。本节以 macOS (Mach-O) 的 nm 和 objdump 输出为基准,Linux 上对应的命令是 nm 和 objdump,输出格式略有差异但信息等价。
目标文件不是源码的简单二进制翻译。如果只是把 C++ 语句逐条转成机器指令然后写进文件,链接器根本无法工作,因为链接器需要知道每个函数从哪里开始、每个全局变量占多大空间、哪些位置的指令引用了尚不知道地址的外部符号。目标文件的格式之所以要设计 sections、符号表和重定位记录这三层结构,就是为了在"编译产物"和"链接输入"之间建立一个标准化的信息接口。编译器在这个接口的一侧填写每个翻译单元的信息,链接器在另一侧消费这些信息。
目标文件内部按照功能划分成若干段(section),每个段承载不同类型的内容。最常见的四个段是 .text、.data、.rodata 和 .bss。.text 段存放编译生成的机器指令,也就是函数的执行体。.data 段存放已初始化且可写的数据,比如 int g_total = 0; 这个全局变量就会落在这里。.rodata 段存放只读数据,比如 "symbol demo" 这个字符串常量。.bss 段比较特殊:它存放的是零初始化的全局变量和静态变量,但它在目标文件里不占用实际空间,只记录"这里需要一块大小为 N 的零值内存",等程序装载时由操作系统分配并清零。这样设计的原因是零初始化的变量不需要在文件中存储实际内容,节省了目标文件和最终可执行文件的体积。
这些段之所以要分开,根源在于运行时的内存保护需求。.text 在程序运行时被映射为只读和可执行(CPU 可以从中取指令,但不能写),.rodata 被映射为只读(不能写也不能执行),.data 和 .bss 被映射为可读可写但不能执行。如果把它们混在一个段里,操作系统就无法对不同类型的内容施加不同的保护策略。段的安排在编译时由编译器决定,在链接时由链接器合并,在装载时由操作系统落实。从这个角度讲,目标文件内部的分段设计,直接服务于进程地址空间的段权限模型。不同段在最终可执行文件中的相对位置由链接器根据链接脚本或默认布局规则决定,.text 通常放在低地址区域,.data 和 .bss 紧随其后。
符号表(symbol table)是目标文件里对链接器最重要的数据结构。它记录了当前翻译单元提供了哪些符号(已定义符号)以及需要哪些外部符号(未定义符号)。nm 工具可以快速查看一个目标文件的符号表。运行 nm main.o,输出大致如下:
0000000000000000 T _main
                 U _Add
0000000000000008 D _g_total
0000000000000000 D _kMessage
                 U __ZNSt3__14coutE
                 U __ZNSt3__1lsB6v16000INS_11char_traitsIcEE
每一行是一个符号条目。第一列是符号在当前目标文件内的地址(未定义的符号没有地址,显示为空白),第二列是符号类型标记,第三列是符号名。在第二列中,T 表示该符号在 .text 段中有定义(是一个函数),D 表示在 .data 段中有定义(是一个已初始化的全局变量),U 表示这个符号是未定义的,需要链接器从别处找。main 被标记为 T,说明 main.o 提供了 main 函数的定义。Add 被标记为 U,说明 main.o 调用了 Add 但它的函数体不在当前翻译单元里。std::cout 和 operator<< 同样标记为 U,它们来自 C++ 标准库。
math.o 的符号表则反过来:Add 被标记为 T,说明 math.o 提供了 Add 的定义。链接器的工作就是把 main.o 中的 U Add 和 math.o 中的 T Add 配对,让所有未定义符号都找到唯一的定义。
nm 的符号类型标记不止 T、D、U 三种。常见完整的集合包括:t(局部函数,通常是匿名命名空间或 static 函数)、d(局部已初始化数据)、b 和 B(.bss 段中的零初始化数据)、r 和 R(.rodata 中的只读数据)、s 和 S(未初始化的全局数据,取决于对齐)。大写字母表示全局可见,小写字母表示局部(只在当前目标文件内部可见)。用 nm -m 或 llvm-nm -m 可以看更详细的信息,包括符号所属的段名和链接属性。
一个值得注意的细节是 kMessage 这个 const char 数组和 kLocalBias 这个 constexpr int 在符号表中的表现。kMessage 标记为 D,因为它是命名空间作用域的 const 数组,虽然元素不可修改,但它本身是一个有外部链接的对象。kLocalBias 被放在了匿名命名空间中,它的符号标记是小写的 t 或根本不出现,因为它被限制在当前翻译单元内部,链接器不需要为它对外暴露符号。这个对比恰好印证了第 3 章和第 4 章讲过的内部链接和外部链接的区别在目标文件层面的具体表现。用 nm 观察不同链接属性的符号在目标文件中的标记差异,是把语言层面的链接规则和工具链层面的符号机制对应起来的最直接方式。内部链接的符号在 nm 输出中是小写字母,链接器在符号解析阶段不会把它们纳入全局符号匹配;外部链接的符号是大写字母,是链接器全局匹配的候选对象。
重定位(relocation)是目标文件中紧挨着符号表的另一组关键信息。编译器在处理翻译单元时,对跨翻译单元的符号引用无法确定最终地址,只能先留下"占位 + 重定位记录"的组合。重定位记录的内容大致是:在目标文件的偏移 X 处有一条指令引用了符号 Y,链接时请把符号 Y 的最终地址按照重定位类型 Z 填入偏移 X 处的指令编码中。编译器之所以能生成这种"带空位的指令",是因为它知道目标平台的指令编码格式:ARM64 的 bl 指令编码中有 26 位留给偏移量,x86-64 的 call 指令编码中有 32 位留给相对偏移,编译器在生成指令时先把这些位填成占位值,在重定位记录中标明"此处引用了符号 Add,请用 Add 的最终地址按重定位规则修正"。链接器在执行重定位时,从符号表获取目标符号的最终地址,根据重定位类型计算出需要写入指令操作数位的具体值,完成指令的最终编码。
以 main.o 中对 Add 的调用为例。编译器在编译 main.cc 时看到了 Add 的声明,知道它接受两个 int、返回一个 int,于是为调用点生成了对应的机器指令(在 ARM64 上是一条 bl 指令,在 x86-64 上是一条 call 指令)。编译器生成了调用指令的编码框架,但被调用方的地址还不知道。编译器在目标文件中留下一条重定位记录:偏移 P 处的指令引用符号 Add,链接时请将 Add 的最终地址填入。链接器在链接阶段确定 Add 的最终地址(找到 math.o 中 Add 的代码位置并安排布局后),用这个地址修正 main.o 中那条调用指令的操作数。
用 objdump -r 或 llvm-objdump -r 可以查看目标文件的重定位记录:
llvm-objdump -r main.o
输出列出了每条重定位记录的偏移位置、重定位类型和引用的符号名。main.o 中对 Add 的重定位条目会显示类似 ARM64_RELOC_BRANCH26 Add(ARM64)或 R_X86_64_PLT32 Add(x86-64)的信息。不同 CPU 架构的重定位类型命名规则不同,但整体逻辑一致:告诉链接器"在这个位置,用这种方式,填入那个符号的地址"。
重定位的类型取决于指令编码方式和寻址模式。ARM64 的 BRANCH26 表示一条 26 位偏移量的跳转指令,适合近距调用;x86-64 的 PLT32 表示一个 32 位相对偏移的调用,通过 PLT(Procedure Linkage Table)间接寻址。对链接器的使用者而言,不需要逐条了解每种重定位类型的编码细节,但需要知道重定位记录的存在解释了为什么"引用了外部符号的指令"不能直接在目标文件中形成正确的机器码:这些指令的操作数字段目前放着的是占位值(通常是 0 或一个相对偏移 0),真正的地址要等链接器确定了所有段的布局之后才能计算出来。
目标文件的格式在三大平台上各有自己的名字和结构,但 .text / .data / .rodata / .bss 的分段逻辑和符号表/重定位的功能是共通的。Linux 使用 ELF(Executable and Linkable Format),目标文件后缀是 .o,可执行文件通常没有后缀。macOS 使用 Mach-O,目标文件和可执行文件都是 Mach-O 格式,只是内部标记不同(object vs executable)。Windows 使用 PE/COFF 格式,目标文件后缀是 .obj,可执行文件后缀是 .exe 或 .dll。日常开发中不需要记住这些格式的内部字段,但知道目标文件里"有机器码、有数据、有符号表、有重定位记录"这四样东西,就能理解链接器接下来要做的事了。
macOS 目标文件格式对应的常用查看工具是 otool 和 llvm-objdump,Linux 上对应的是 objdump 和 readelf。macOS 上的 nm 输出默认每个符号前有一个下划线前缀(比如 _main、_Add),这是 Mach-O 的符号命名约定,ELF 格式没有这个前缀。正文中的 nm 输出示例使用了 macOS 的实际风格,读者在不同平台看到的结果中符号名可能略有差异,但符号类型标记(T、U、D 等)的语义是完全一致的。
用 nm math.o 对比一下两个目标文件的符号表角色互补关系。math.o 中 Add 符号标记为 T(已定义),而 main.o 中同一个符号标记为 U(未定义)。同一个符号名在两个目标文件中的类型标记互为镜像,这恰好说明了目标文件的设计意图:每个目标文件独立记录自己的供给和需求,链接器在后续阶段对比所有目标文件的供给和需求清单,找到匹配项。
目标文件还有一个"半成品"的特征值得强调:它不能被操作系统直接加载运行。main.o 即使包含了 main 函数的完整机器码,操作系统也不会把它当作可执行文件。原因有两个方面。技术上,目标文件的内部结构不包含操作系统装载器需要的程序头表(program headers),操作系统不知道把各段映射到虚拟地址空间的哪个位置,而且 .bss 段在目标文件中还没有被分配具体的装载地址。依赖上,目标文件中的外部符号引用还是悬空的,如果强行执行,任何对外部函数的调用都会跳到一个无效地址导致崩溃。链接器的工作正是填补这两个缺口:为所有段安排最终地址,解析所有外部符号,把多个目标文件的代码和数据合并成一个完整的、操作系统认得出来的可执行文件。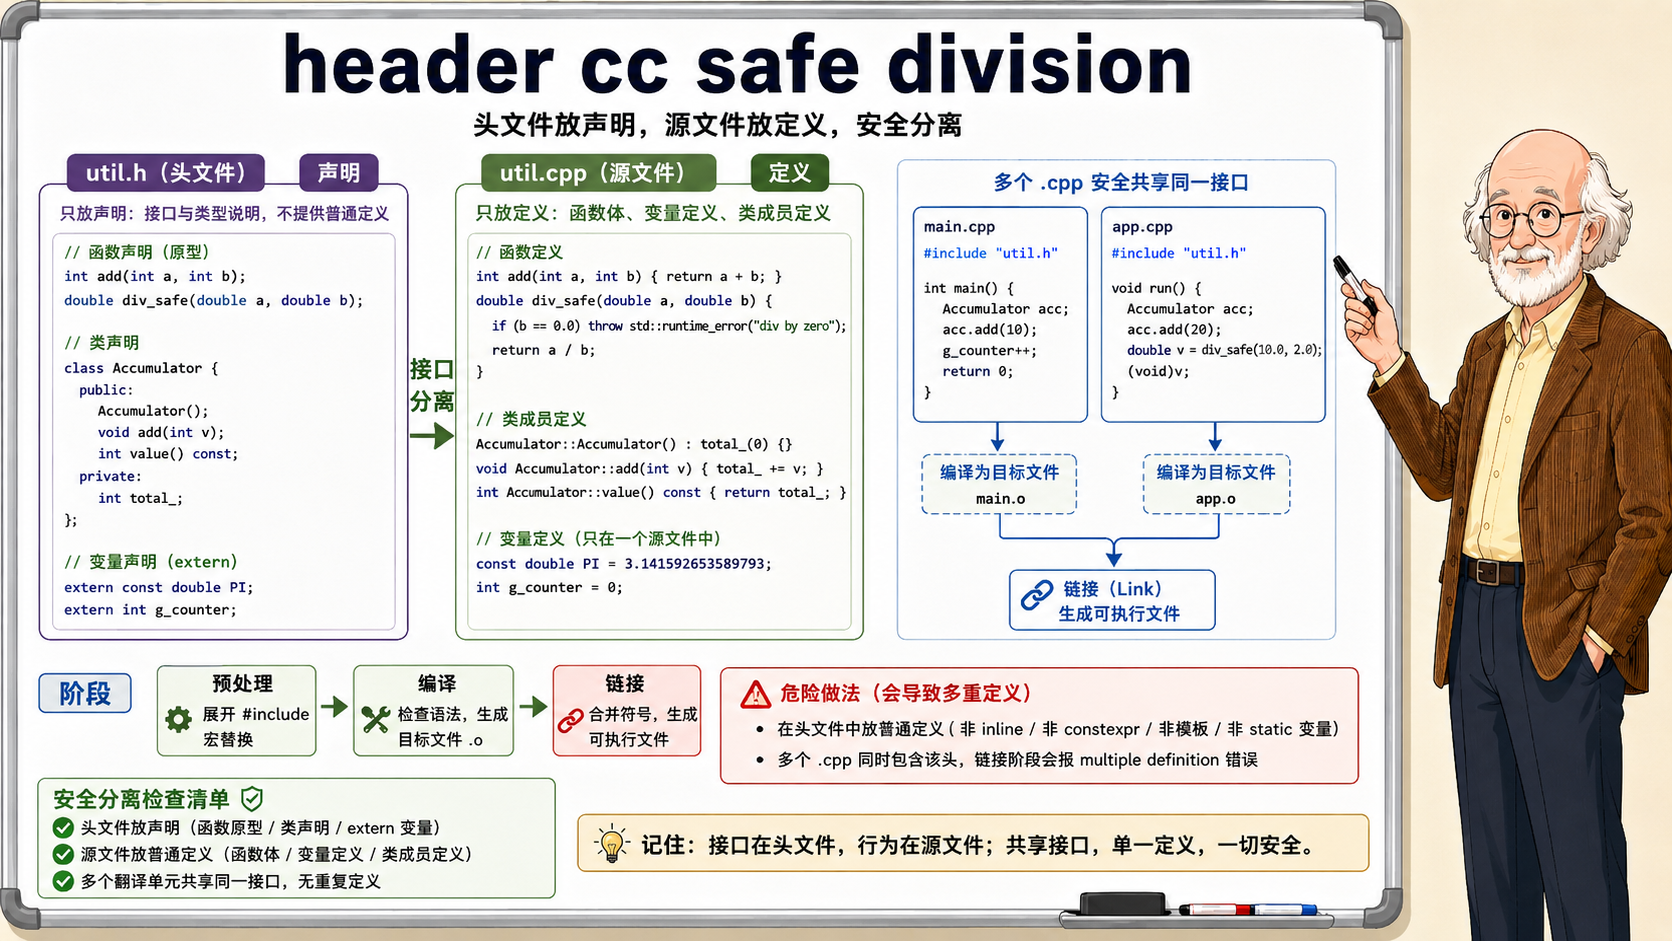
回头把 main.o 和 math.o 链接起来,确认运行结果和符号配对的一致性:
clang++ main.o math.o -o app
./app
# 输出:symbol demo: 41
程序输出 41,说明 Add(40, 1) 的结果是正确的,链接器成功把 main.o 中对 Add 的引用和 math.o 中 Add 的定义对上了。整个过程中,main.o 在编译时完全不知道 Add 的地址,链接器通过符号表和重定位记录实现了这个配对。
把目标文件的内容和它作为"链接前半成品"的角色放到一起看,就能理解为什么 C++的编译链接模型需要目标文件这个中间层。编译器只负责把一个翻译单元翻译成机器形态的产品(目标文件),并在产品上标记清楚"我能提供什么"和"我还需要什么"。链接器负责收集所有翻译单元的产品,按符号需求和供给进行全局匹配,补全地址引用,最终生成操作系统能装载的可执行文件。目标文件的标准格式(ELF、Mach-O、PE/COFF)让不同编译器、不同语言生成的目标文件可以在链接阶段互操作,只要它们遵守相同的符号命名和重定位约定。这一层互操作性也是 C++ 能够和 C、汇编以及各种系统库协作的基础设施。
从目标文件中还有一个视角可以连接前面讲过的 translate unit 和 ODR。一个翻译单元产生一个目标文件,目标文件中每个外部可见的已定义符号(标记为大写字母的类型,如 T、D、B)在整个程序中应该只出现一次。如果两个目标文件各提供了一个同名的 T 符号,链接器就会报 multiple definition,这正是第 5 章 ODR 在目标文件层面的直接体现。用 nm 检查两个 .o 文件的符号表,可以提前发现潜在的重复定义:如果两个目标文件中同一个符号名都标记为 T 或 D(而不是一个 T 一个 U),链接阶段必然失败。这个技巧在多文件项目中排查 ODR 违规时比直接链接看错误信息更加精细,因为它能告诉你到底是哪两个目标文件在竞争同一个符号。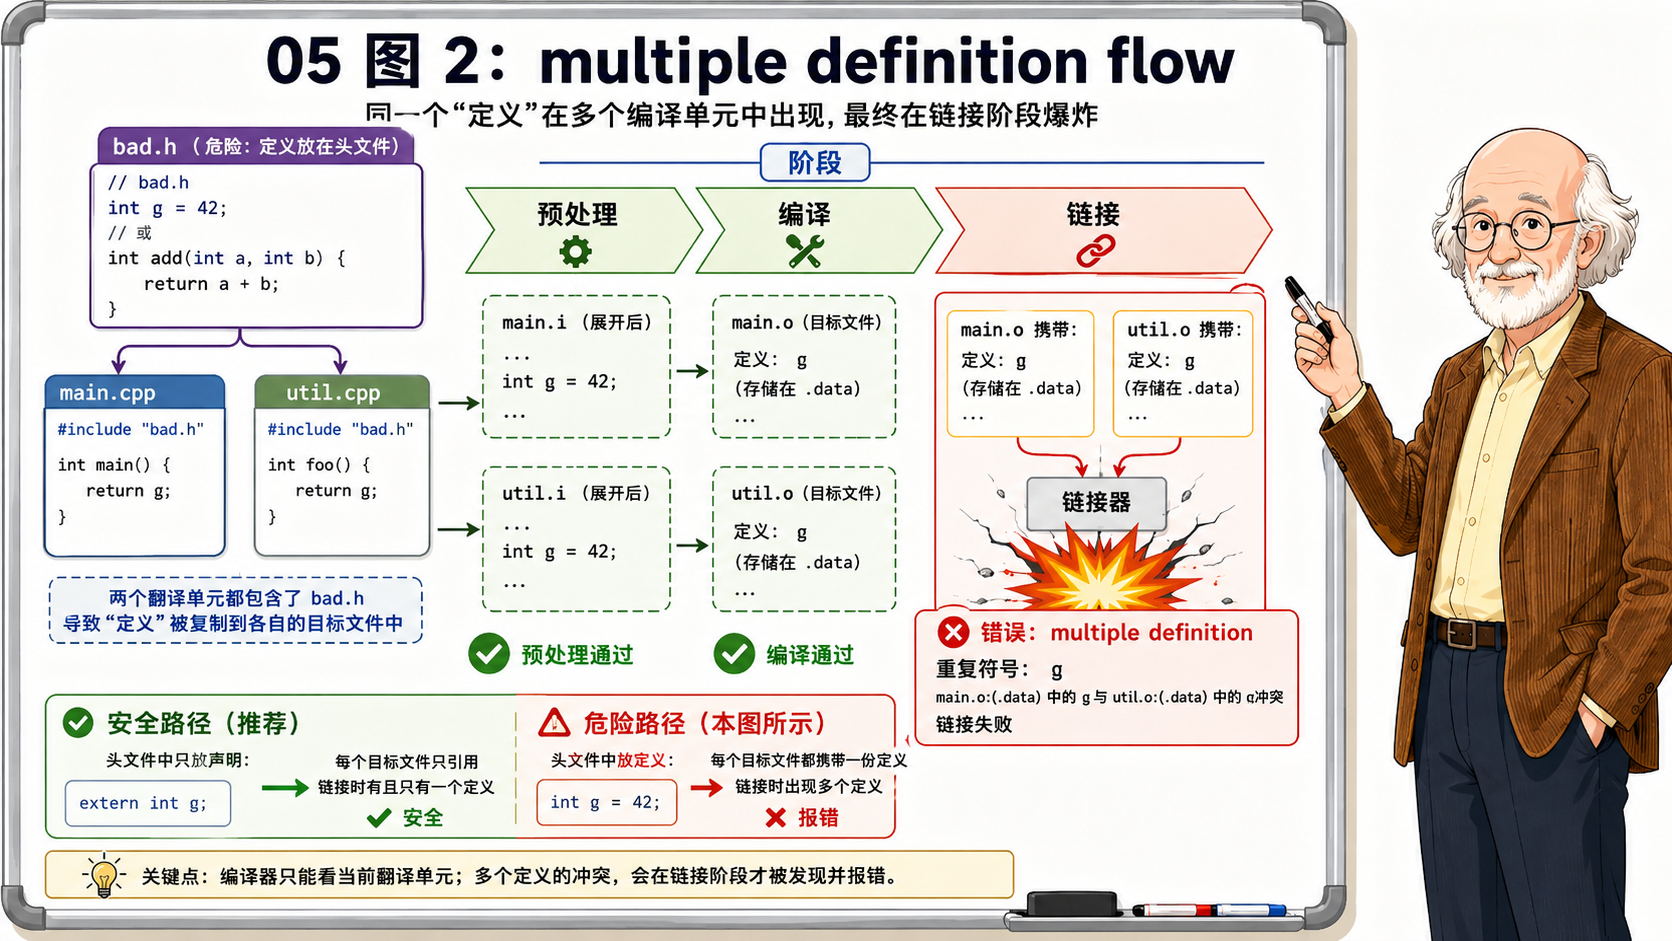
目标文件的存在让增量编译成为可能。修改 math.cc 后,只需要重新编译 math.cc 这一个翻译单元,生成新的 math.o,再和未变化的 main.o 重新链接。main.o 不用重编,因为它的符号需求和供给都没有变化:它依然需要 Add 符号,依然提供 main 符号。修改头文件则会把依赖链上的多个翻译单元的目标文件一起打上"需要重新编译"的标记,因为头文件的变化会改变多个翻译单元的预处理结果,进而可能改变它们的符号表和机器码。这个对比是构建系统依赖管理的底层逻辑。
链接器的输入是目标文件,输出是可执行文件。把目标文件看作"带有清单的机器码包",把链接器看作"按清单配货并打包的装配线",这个模型足以支撑接下来两章对符号解析和库机制的讨论。
实际工程中,nm 和 objdump 的使用场景远不止教学演示。排查链接错误时,在怀疑的目标文件上跑 nm 确认某个符号到底是 U(未定义)还是 T(已定义),往往能迅速定位问题是由哪个翻译单元引入的。核对发布二进制中是否意外暴露了内部符号时,nm 输出的符号列表是最直接的审查入口。检查两个目标文件之间是否存在符号冲突时,对比两份 nm 输出中同名的外部符号标记,可以提前预判链接是否会失败。本章建立的"目标文件 = 机器码 + 数据 + 符号表 + 重定位"这个心智模型,是后续所有链接阶段分析和排错的基础。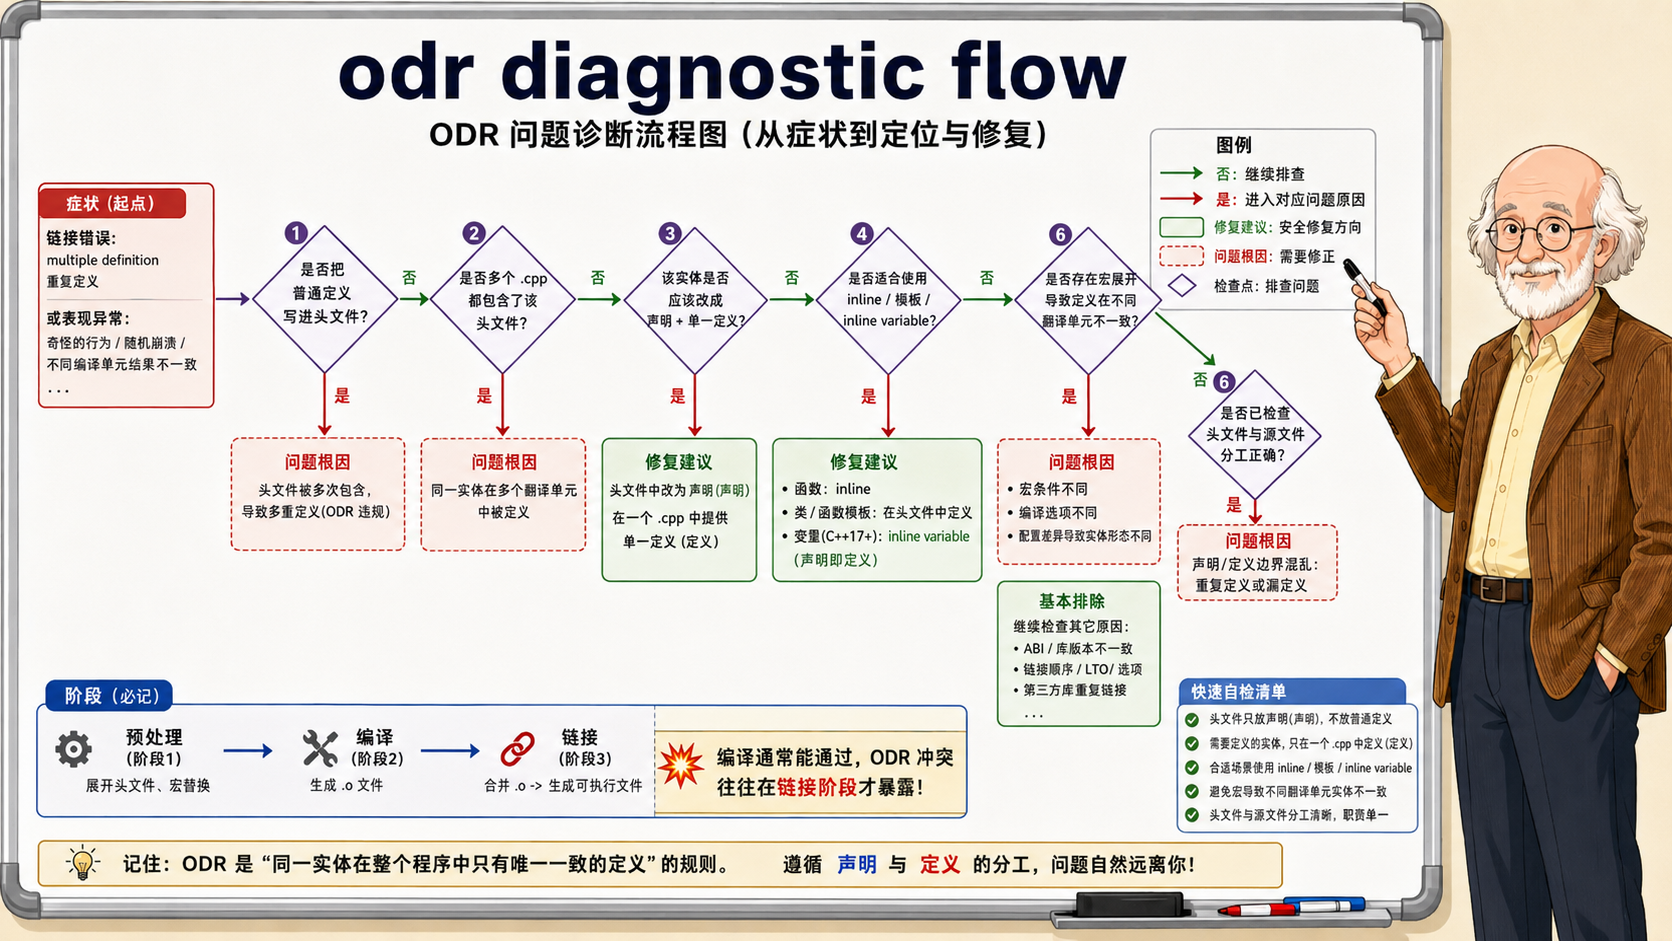
目标文件看起来只是一个中间产物,实际承担的是工程边界:它让每个翻译单元可以独立编译、独立缓存、独立暴露符号清单,再由链接器做最后的全局装配。理解这一层,后面看静态库和动态库时就不会把库文件当成普通压缩包或普通源文件集合。
第 7 章我们把目光推到链接器上:多个目标文件放在一起之后,链接器如何遍历符号表、如何把 U Add 和 T Add 对上号、在 C++ 函数重载和命名空间导致符号名变得复杂之后配对过程有什么变化。
阅读导航



