
C++ 声明与定义:编译检查和链接实体的分工
04 声明让编译器通过检查,定义给链接器提供实体
C++程序员早晚会碰到这样一种情况:代码编译成功了,链接却失败了。编译通过说明语法没问题、类型没错、声明也都齐全;链接失败说明虽然"嘴上说好了",但某个承诺的实体最终没有兑现。这个现象背后就是声明和定义的分工:声明管编译期检查,定义管链接期实体提供。这两个词在日常交流中经常被混用,但在多文件 C++ 工程里,它们承担完全不同的职责,边界一旦搞混,头文件的组织方式就会出错。
用一套最小例子把这两个概念按在地上看清楚。写一个 main.cc,里面只有 Add 函数的声明和 main 函数的定义,没有 Add 的函数体:
// main.cc
int Add(int a, int b);  // 声明

int main() {
  return Add(1, 2);     // 使用声明,编译器检查调用
}
编译这一步:
clang++ -std=c++20 -Wall -c main.cc -o main.o
编译通过了。编译器看到 int Add(int a, int b); 这一行声明,知道 Add 接受两个 int、返回一个 int,于是它能检查 Add(1, 2) 这个调用是否合法:参数数量正确,参数类型匹配,返回值类型在 main 里作为 int 返回也合理。编译器做完这些检查之后生成 main.o,在符号表里为 Add 留一个未定义符号标记。链接这一步:
clang++ main.o -o app
失败了,报 undefined reference to 'Add(int, int)'。链接器遍历所有输入的目标文件,找不到任何地方提供了 Add 的函数体。声明让编译器放了行,定义缺失让链接器停了手。
给 Add 补上函数体,完整重现一次正确的流程:
// math.h
#ifndef MATH_H_
#define MATH_H_

int Add(int left, int right);  // 声明

#endif
// math.cc
#include "math.h"

int Add(int left, int right) {  // 定义
  return left + right;
}
// main.cc
#include "math.h"

#include <iostream>

int main() {
  std::cout << Add(1, 41) << "\n";
  return 0;
}
clang++ -std=c++20 -Wall -c main.cc -o main.o   # 编译通过
clang++ -std=c++20 -Wall -c math.cc -o math.o   # 编译通过
clang++ main.o math.o -o app                     # 链接通过
./app
# 输出:42
math.h 里的 int Add(int left, int right); 是声明,它告诉编译器函数的签名。math.cc 里的函数体是定义,它提供链接器需要的实体。main.cc 只需要 include math.h 拿到声明就能完成编译;main.o 和 math.o 一起交给链接器才能凑齐所有符号定义。声明和定义在多文件项目中的分工,这三条命令已经完整呈现。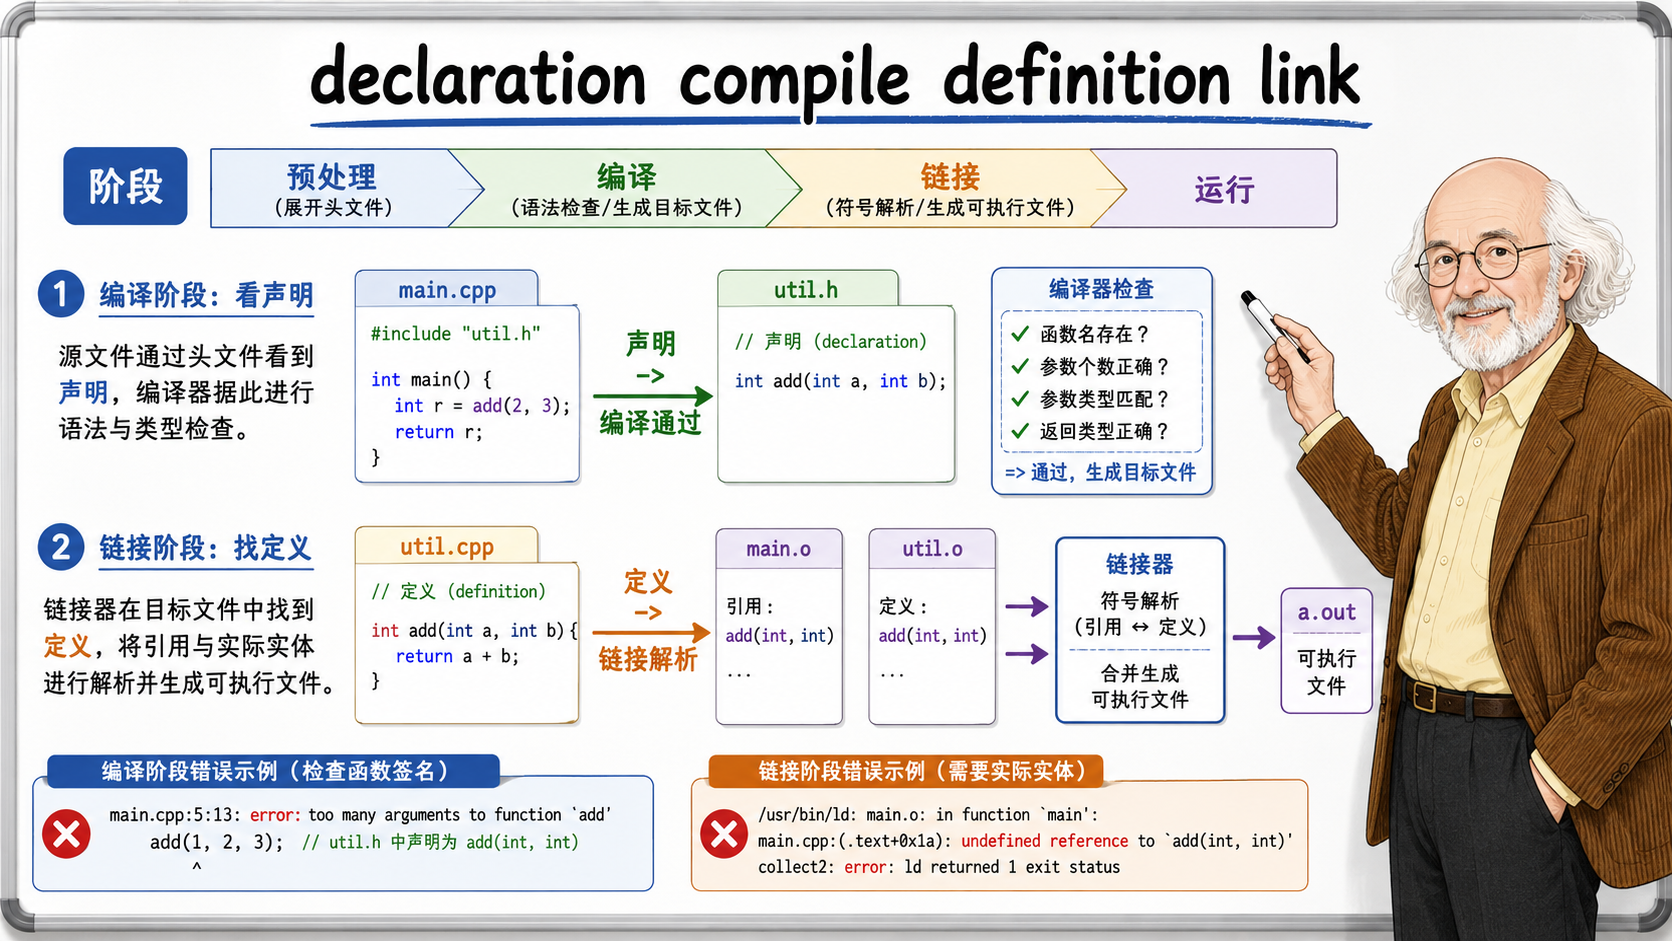
声明(declaration)的本质是向编译器引入一个名字并描述它的基本属性。函数声明提供参数类型和返回类型,编译器用它检查调用点。变量声明(extern int counter;)告诉编译器有这么一个变量,它的类型是什么。类型声明(类的前向声明 class Widget;)告诉编译器这个名字是一个类型,可以用来声明指针和引用。声明不产生实体,不分配存储,不生成机器码。编译器的态度是:"好的,我记住有这么一个东西。你用它的时候我会按你描述的接口来检查。"
有一个细节值得一提:有些声明同时也是定义。int counter; 在命名空间作用域是一个定义(分配存储但不显式初始化),void Func() {} 既是声明也是定义(因为带了函数体),struct Point { int x, y; }; 是定义(提供了完整的类型结构)。判断"这是声明还是定义"的实用方法是:如果编译器看到它就能生成代码或分配存储,那它就是定义;如果它只是描述接口让编译器做类型检查,那它就是纯声明。标准库头文件 <iosfwd> 是纯声明集合的代表,它只提供前向声明,不拖入任何定义,专门用于需要知道某个类型存在但不需要完整定义的场景。
定义(definition)的本质是提供一个实体的完整信息。函数定义除了声明部分以外还包含函数体,编译器会为它生成机器码,链接器能为它标记"已定义"符号。全局变量定义(int counter = 0;)会分配存储空间,在目标文件中留出对应的数据区域。类定义(class Widget { /* 成员 */ };)提供完整的类型结构信息。每种实体在"声明还是定义"这个问题上的边界略有一点差异:函数原型一定是声明而不是定义;带有初始化器的全局变量声明就是定义(即使初始化器是零值);类体的完整定义算定义但允许出现在多个翻译单元中。
extern 关键字在变量声明和定义之间划了一条重要的线。extern int counter; 是一个不分配存储的声明,它只是说"counter 这个变量在别处定义了"。int counter = 0; 才是定义,它实际分配存储并初始化。如果把 int counter = 0; 直接写在头文件里,每个 include 这个头文件的 .cc 都会在各自的翻译单元里产生一份存储分配,链接阶段就会看到多份同名全局变量定义,报 multiple definition 错误。正确做法是头文件放 extern int counter;(声明),选一个 .cc 放 int counter = 0;(定义)。
// counter.h - 正确:只放声明
#ifndef COUNTER_H_
#define COUNTER_H_

extern int g_counter;         // 声明,不分配存储
void IncreaseCounter();       // 声明,不提供函数体

#endif
// counter.cc - 正确:放定义
#include "counter.h"

int g_counter = 0;            // 定义,分配存储

void IncreaseCounter() {      // 定义,提供函数体
  ++g_counter;
}
extern 还有一个不那么明显的用法:extern "C"。这个关键字组合不影响声明或定义的语义,但改变了符号名在目标文件中的编码规则。在 extern "C" 块内声明的函数,其符号名按 C 的规则生成,不包含 C函数重载所需的参数类型编码,这使得 C++代码和 C 代码可以通过一致的符号名互相引用。extern "C" 通常配合 #ifdef __cplusplus 条件编译来让同一个头文件同时服务 C 和 C++编译器,是实现 C/C 混合编程的基础设施。关于 name mangling 和 extern "C" 在符号层面的机制细节,第 7 章会结合链接器的符号解析详细展示。
反过来看反例。在头文件里直接定义全局变量:
// bad_counter.h - 错误:头文件里放了定义
#ifndef BAD_COUNTER_H_
#define BAD_COUNTER_H_

int g_bad_counter = 0;        // 这是定义,include 它的每个 .cc 都会分配一份存储

#endif
如果有两个 .cc 都 include 了 bad_counter.h,链接器会看到两份 g_bad_counter 的定义,直接报重复定义。Include guard 管不了跨翻译单元的重复,这个问题已经在第 2 章和第 3 章反复讲过了。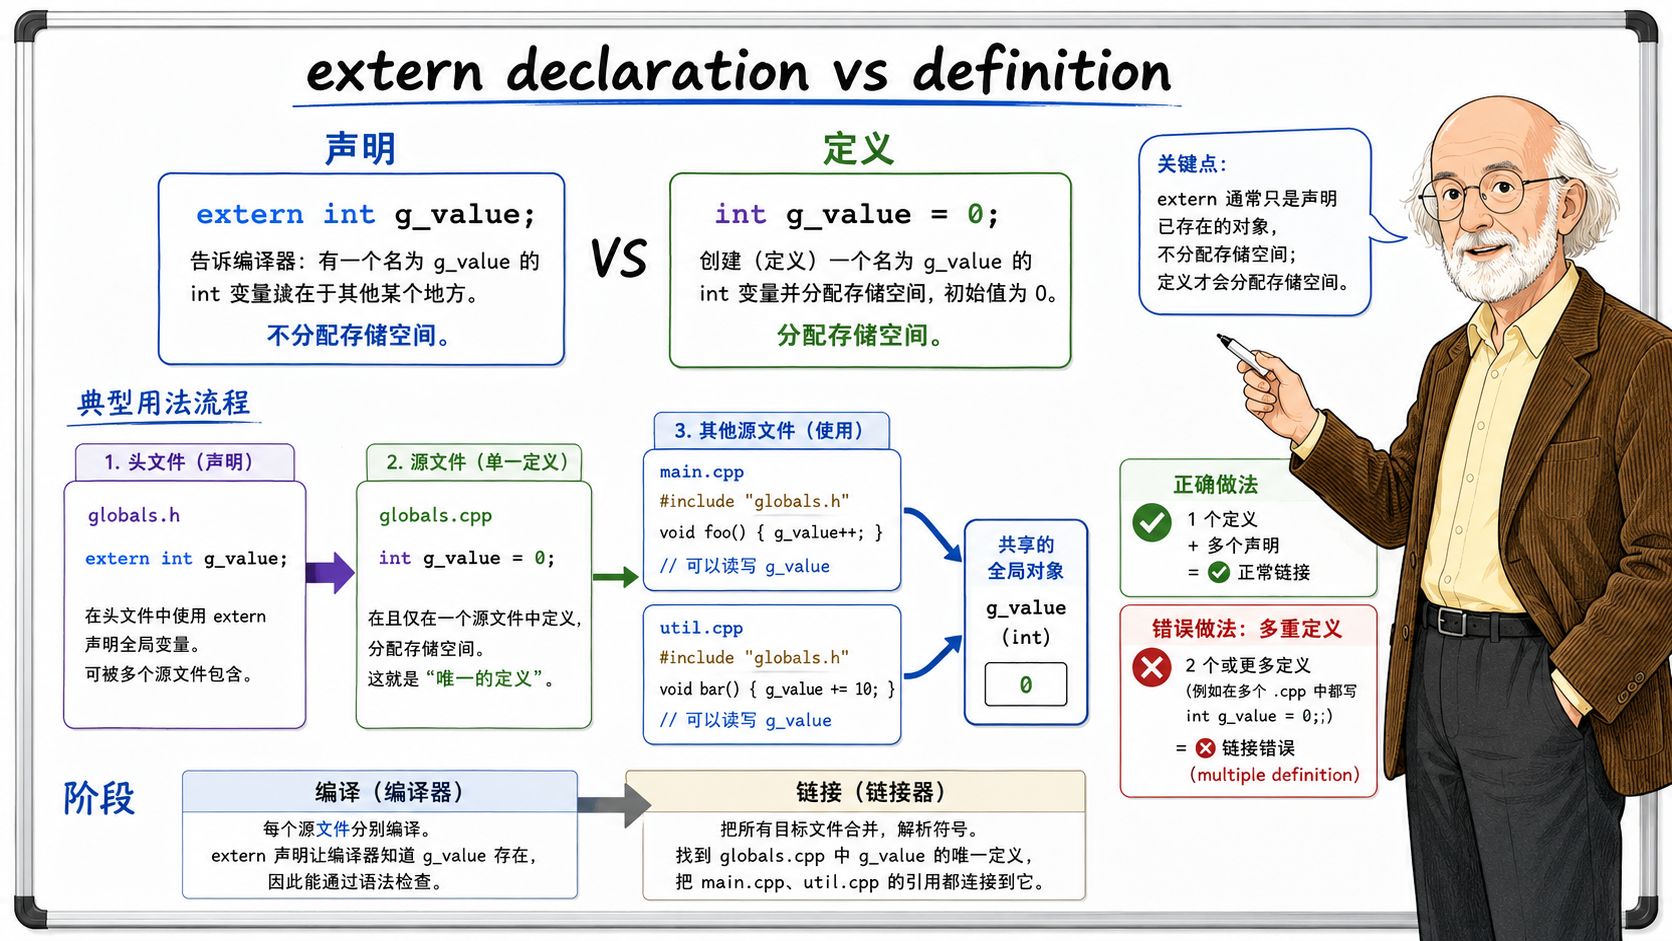
头文件到底能放什么、不能放什么,答案由声明和定义的边界直接决定。可以放头文件的内容:函数声明(int Add(int, int);),类定义(完整类型结构,允许在多个翻译单元中各出现一次),模板定义(同样允许跨翻译单元出现),inline 函数和 inline 变量定义,类型别名(using、typedef),枚举定义,常量表达式变量(constexpr)。应该放在 .cc 文件的内容:普通函数定义(函数体),普通全局变量定义,非 inline 的命名空间作用域变量。
在类定义中直接定义的成员函数(在类体内部给出函数体)自动带有 inline 属性,这也是为什么类体内实现的简单 getter/setter 可以放在头文件里而不触发重复定义。反之,在类体外、头文件中定义但不加 inline 的成员函数,和普通自由函数一样会触发重复定义问题。工程中通常把短小的成员函数在类内直接实现,把较长的成员函数实现放在对应的 .cc 文件中。
关于 const 的全局变量有一个特殊规则值得单拎出来。在命名空间作用域定义的 const 变量默认具有内部链接(internal linkage),每个翻译单元看到它都会生成一份独立的副本,不会引发重复定义错误。这意味着 const int kMaxSize = 100; 写进头文件是安全的,每个 .cc 各自有一份自己的 kMaxSize,互不冲突。constexpr 变量同样默认内部链接。不过要注意这个规则适用于命名空间作用域的 const 变量,类内的 static const 成员变量的规则稍有不同。
C++17 引入的 inline 变量则提供了另一种选择:inline int g_config = 1; 允许跨翻译单元共享同一个变量实体,链接器负责去重,语义上和 inline 函数保持一致。有了 inline 变量之后,头文件里放全局变量的需求有了标准的解决方案,不再需要用各种变通办法(比如用函数返回静态局部变量的引用)。在 C++17 之前,头文件里需要共享全局变量的常见模式是写成函数内静态局部变量并返回引用,本质上是通过把变量藏进函数体来绕过"全局变量定义不能放在头文件"的限制。inline 变量直接把这个问题解决了,让头文件里的全局变量有了合法的存在方式。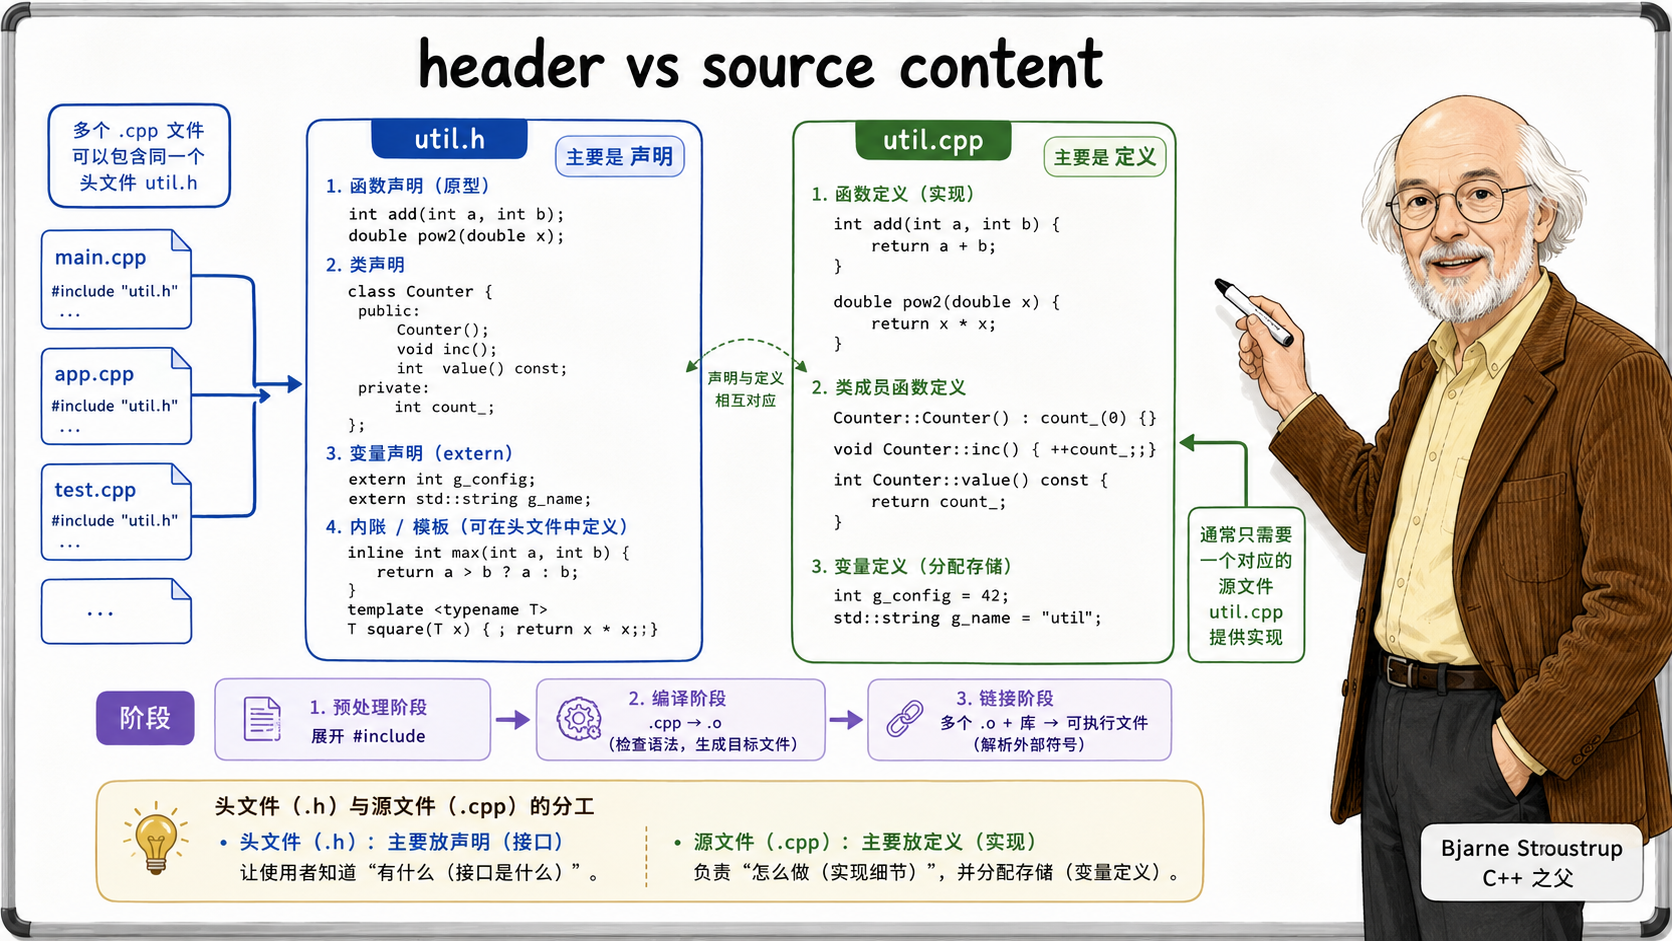
inline 关键字在声明和定义边界上扮演特殊角色,而且它在 C++ 中的含义和大多数人的第一反应不同。inline 在现代编译器中跟"是否真正展开函数体以减少函数调用开销"的关系已经很弱了,编译器有自己的内联判断逻辑,基于调用频率、函数体大小、调用上下文等因素独立决定是否在调用点展开,加不加 inline 关键字对编译器内联决策的影响微乎其微。inline 真正的、主要的作用是改变定义规则:它允许同一个函数(或变量)的定义在多个翻译单元中重复出现,只要每个翻译单元看到的定义完全一致,链接器最终保留一份。这跟普通函数"整个程序只能有一处定义"是截然不同的规则。
正是因为 inline 的这个特性,inline 函数定义可以放进头文件,被多个 .cc include 后,每个翻译单元都有一份函数体,链接器负责保留一份。如果没有 inline,同样的做法就会触发 multiple definition。也正是因为 inline 只改定义规则、不改优化行为,读者应该把"inline 控制链接期行为"作为第一直觉,把"inline 提示编译器展开函数体"彻底忘掉。
inline 函数的另一个约束是:所有翻译单元中同一个 inline 函数的定义必须由相同的 token 序列组成。这指的是预处理展开后函数体的文本内容必须一致。如果不同翻译单元因为宏状态不同看到了不同的函数体,程序不合法且无需编译器诊断(IFNDR),实际表现可能是链接器随机保留了其中一份,或者行为完全不可预测。
在实际工程中,inline 最典型的应用场景是头文件中短小的辅助函数、类内定义的成员函数、以及 C++17 的 inline 变量。这些场景的共同特征是:实体本身足够轻量,放在头文件中可以减少源文件之间的依赖编排成本。而对于超过十几行的函数,即使加了 inline,把它们放在头文件中也会显著增加每个翻译单元的编译负担,因为每个 include 了该头文件的翻译单元都要完整编译一遍函数体。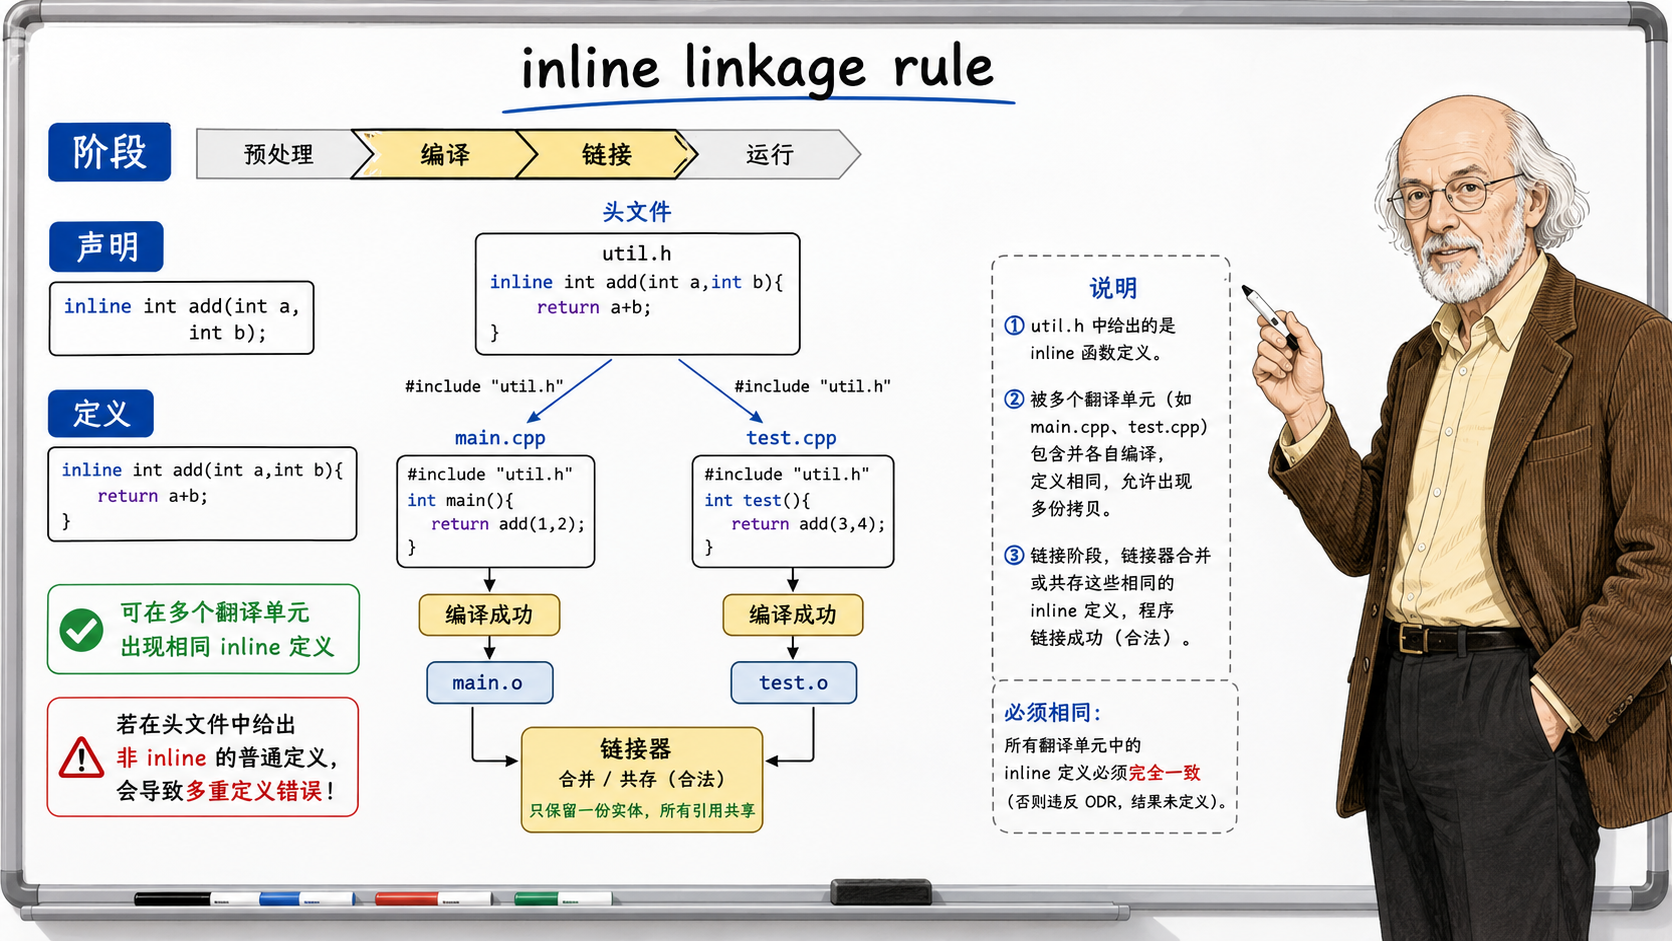
链接属性把声明和定义推到一个更广的维度上。C++ 中有三种链接属性:外部链接(external linkage),名字可以被其他翻译单元引用,普通函数和全局变量默认属于这一类;内部链接(internal linkage),名字只在当前翻译单元内可见,static 全局函数/变量和匿名命名空间中的名字属于这一类;无链接(no linkage),局部变量、函数形参、成员名等只在当前作用域内可见。
内部链接用法的选择值得展开。匿名命名空间:
namespace {
int local_helper(int x) { return x * 2; }
}  // namespace
和 static 全局函数:
static int local_helper(int x) { return x * 2; }
都能把名字限制在当前翻译单元内。匿名命名空间是 C++ 标准推荐的方式,因为它还可以用于类型和变量,而 static 修饰类型在命名空间作用域没有意义。实际工程中两种写法共存都很常见,关键在于理解它们的目标一致:这个实体是当前翻译单元的私有实现细节,不应被跨翻译单元引用。
内部链接还有一个性能上的侧面影响:编译器知道某个函数只会在当前翻译单元内被调用,它可以更自由地做内联和优化,因为不需要生成"可能被外部调用者引用"的保守版本。这也是为什么现代 C++ 建议把辅助函数放进匿名命名空间:除了避免符号冲突,还给编译器提供了更强的优化假设。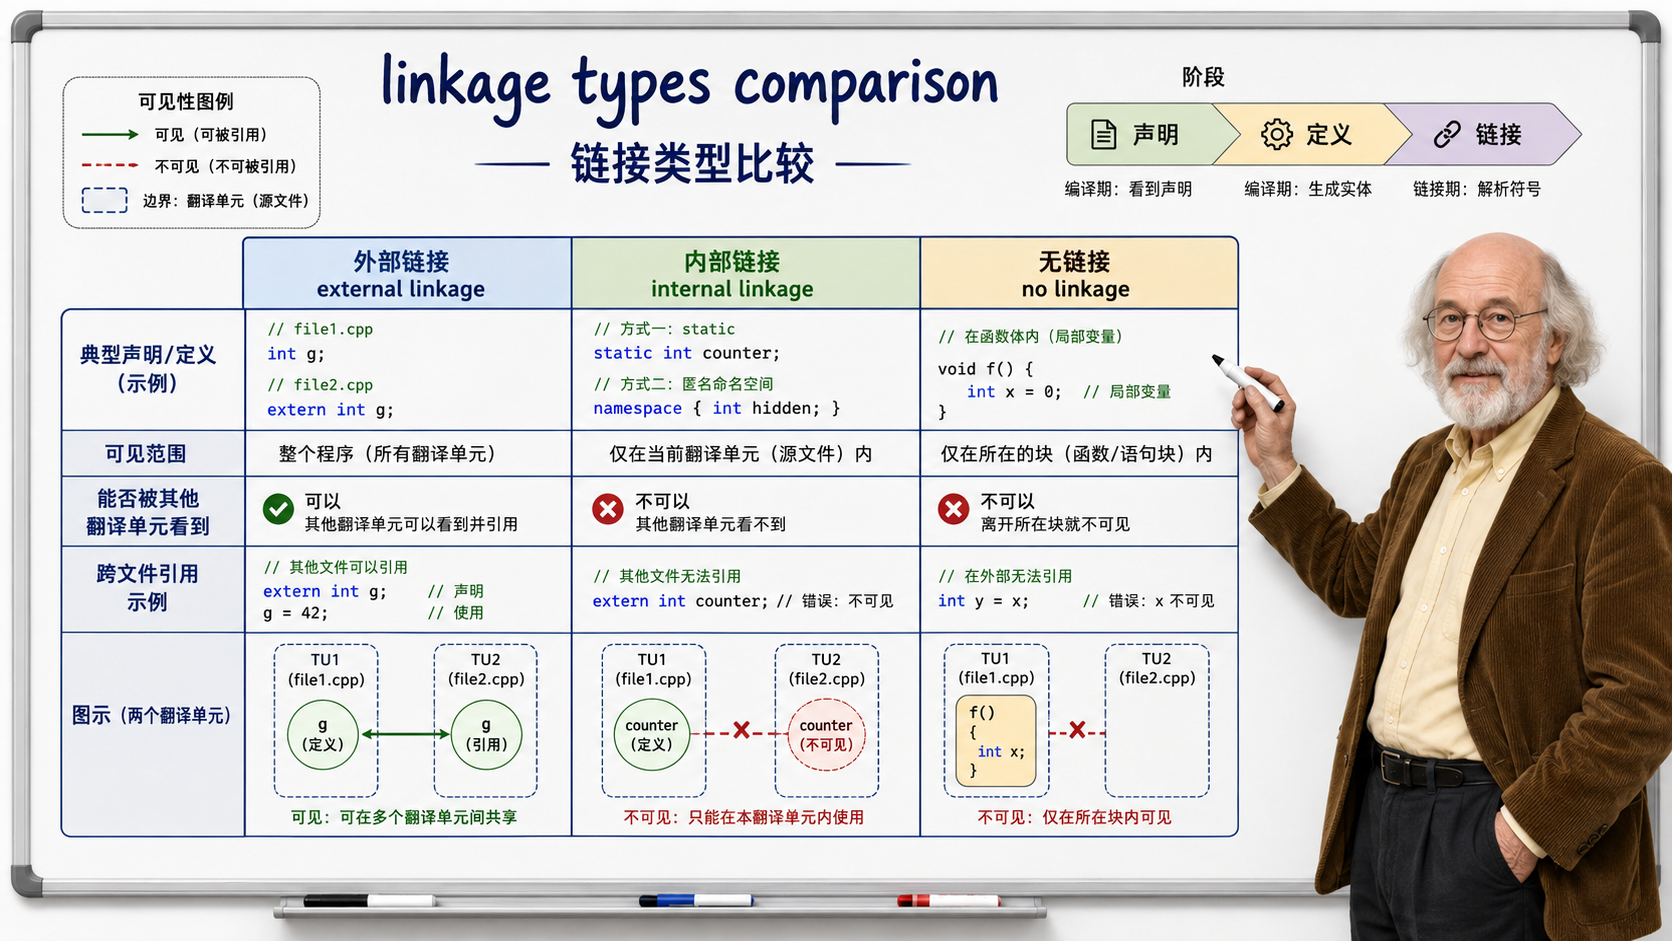
声明还有一个和 C++函数重载直接相关的功能:同一个函数名可以有多个不同的声明,只要参数类型或数量不同,编译器会根据调用点的实参类型选择匹配的声明。这是 C++ 支持的静态多态形式,所有重载决议完全在编译期完成,基于当前翻译单元内可见的声明集合。如果某个翻译单元看不到某个重载版本的声明,该重载版本的调用就会失败,即使定义存在于其他翻译单元中。编译器看不到声明就无法做重载匹配,这件事和第 3 章讲的"编译器一次只看一个翻译单元"是同一个道理的不同表现。这也是为什么你需要把某个函数的所有重载版本都声明在同一个头文件中的原因:确保所有使用方的翻译单元看到完整的重载集合。
声明和定义的分工还有一个重要推论:可以声明但从未定义的东西,编译完全合法。比如 int NeverImplemented(int x); 这个函数声明放在头文件里,没有任何一个 .cc 提供它的函数体。只要程序中从未调用 NeverImplemented,编译和链接都会成功,没有未定义的符号引用需要解析。一旦有翻译单元实际调用了它,链接器会因为找不到定义报 undefined reference。这种"声明超前于定义"或者"声明存在但定义尚未就绪"的情况,在增量开发中很常见:先定义接口声明,再逐个实现。
全局变量也是类似的情况。在一个 .cc 里写 extern int some_counter; 然后读取或写入它,编译通过。如果链接时没有任何目标文件或库提供 some_counter 的定义,链接器报未定义符号。如果提供了两份定义(两个 .cc 各有一个 int some_counter = 0;),链接器报重复定义。
这种"声明可以多次出现,定义只能出现一次"的不对称规则,可以概括为:一个名字在一个翻译单元内可以被声明任意多次(只要每次声明的接口一致),但实体定义在整个程序中只能出现一次(或对 inline、模板等特殊情况按规则允许多次)。编译器在面对多次出现的同一个声明时,会验证每次声明的接口是否一致,例如返回类型和参数类型必须完全相同,不一致则立即报错。链接器在面对多次出现的同一个定义时,会根据符号属性决定拒绝(普通外部符号的重复定义)还是合并(inline 和模板实例化的重复代码)。
理解声明和定义的边界之后,排查编译链接错误可以形成一个清晰的二分策略。编译错误意味着编译器在当前翻译单元的范围内发现了问题:缺少声明、类型不匹配、语法错误或者访问权限违规。修正方向集中在当前翻译单元或其包含的头文件中。链接错误意味着编译器已经完成了每个翻译单元的独立检查,但链接器在全局范围内找不到某个声明的对应实体、或者找到了多个同名的外部实体。修复方向集中在目标文件列表、库列表和跨翻译单元的符号一致性上。两种错误有各自的典型关键词:编译阶段常见 was not declared in this scope、no matching function for call to,链接阶段常见 undefined reference to、multiple definition of。这个二分策略在第 10 章会发展成完整的错误诊断流程,覆盖从预处理到运行时加载的全部阶段。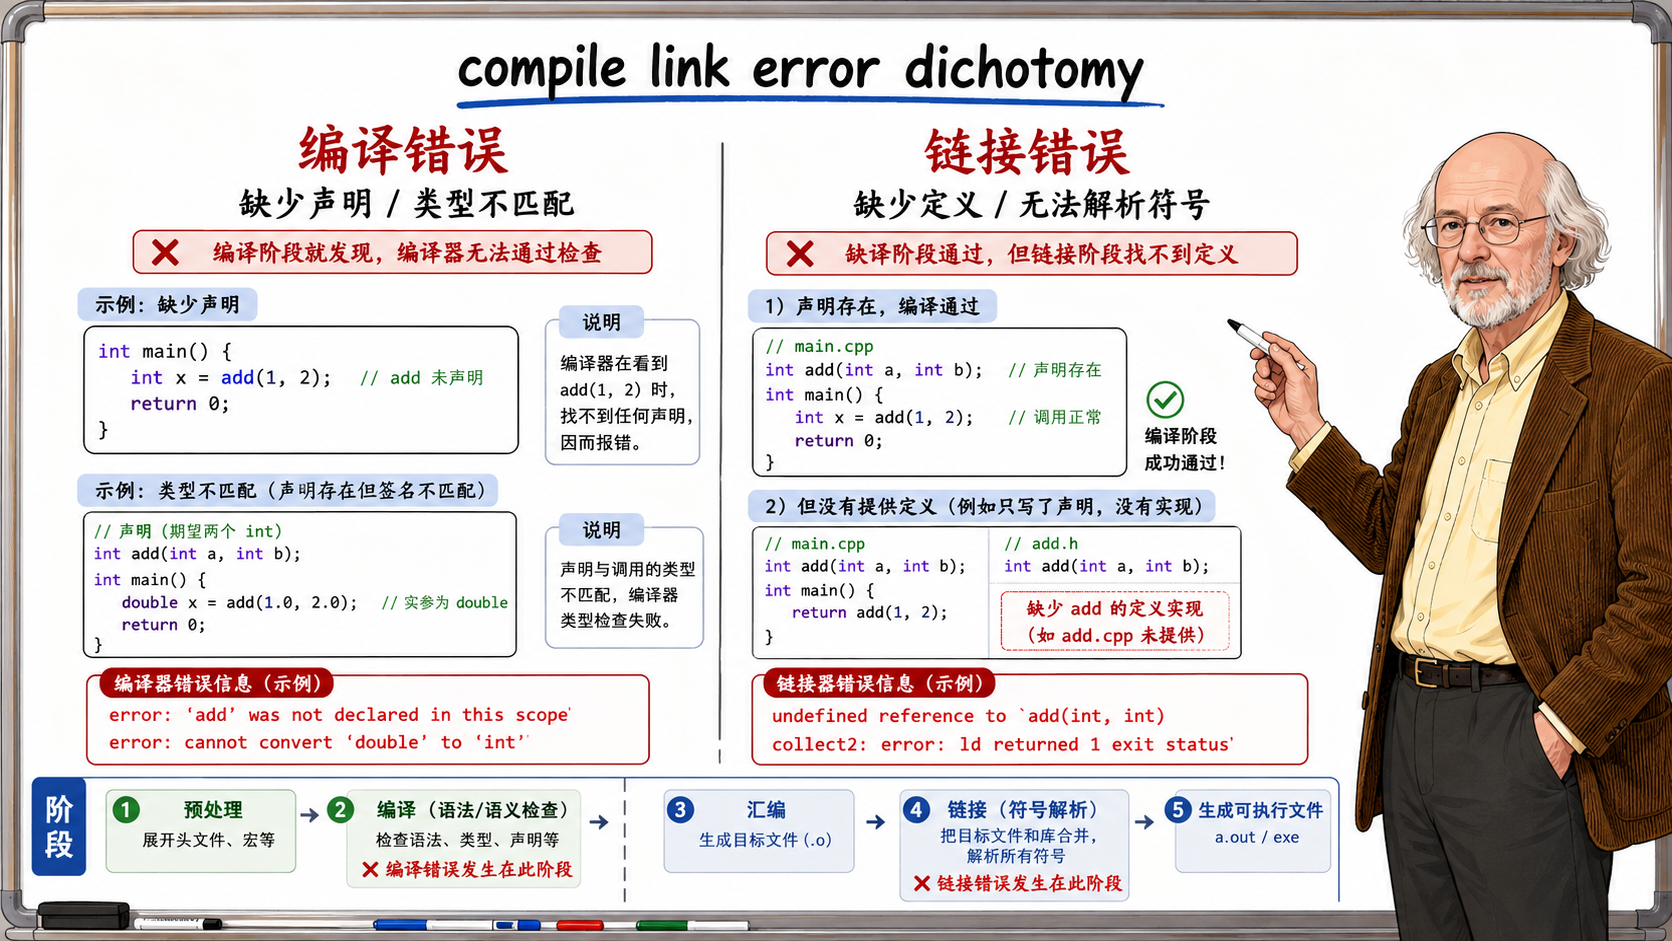
多文件工程中最常见的组织模式就是声明和定义分工的直接应用:头文件里放接口声明、类型定义、模板定义和 inline 实体,源文件里放实现定义和全局变量定义。每个使用接口的翻译单元只需要 include 头文件就能拿到编译所需的全部声明。提供实现的翻译单元负责兑现头文件里的承诺。链接器最终把调用方和实现方对在一起。
这个模式是 C++ 分离编译模型和声明/定义分工共同作用的结果,它背后有明确的因果链:声明为编译器提供接口检查的依据,定义为链接器提供实体解析的依据,头文件和源文件的分工是从这两层需求中自然推出来的工程实践。理解了这层因果关系,头文件里能放什么不能放什么就不再是死记硬背的规则,任何一条"应该放头文件"还是"应该放源文件"的判断,都可以追溯到声明和定义在这两层中各自承担的责任。下一章讲的 ODR 就是这个分工的严格化版本:它精确规定了每种实体在程序中最多能定义多少次、在什么条件下允许跨翻译单元重复出现。
阅读导航



