
Triton 入门教程:Block 编程模型与算子实现
Triton 教程与 block-level 编程模型
本文主要讲 Triton——一种完全不同的编程抽象:你操作的是 block(一组元素),不是单个线程。读完你会理解 Triton 为什么能几十行写出接近手写 CUTLASS 的 kernel,以及官方 tutorial 该怎么刷。
阅读地图
本文先讲 Triton 的 block-level 编程模型和它跟 CUDA thread-level 的根本差异,再按官方 tutorial 顺序(vector add → fused softmax → matmul → fused attention)逐个讲透,最后给学习路径。
一、Triton:block-level 编程模型
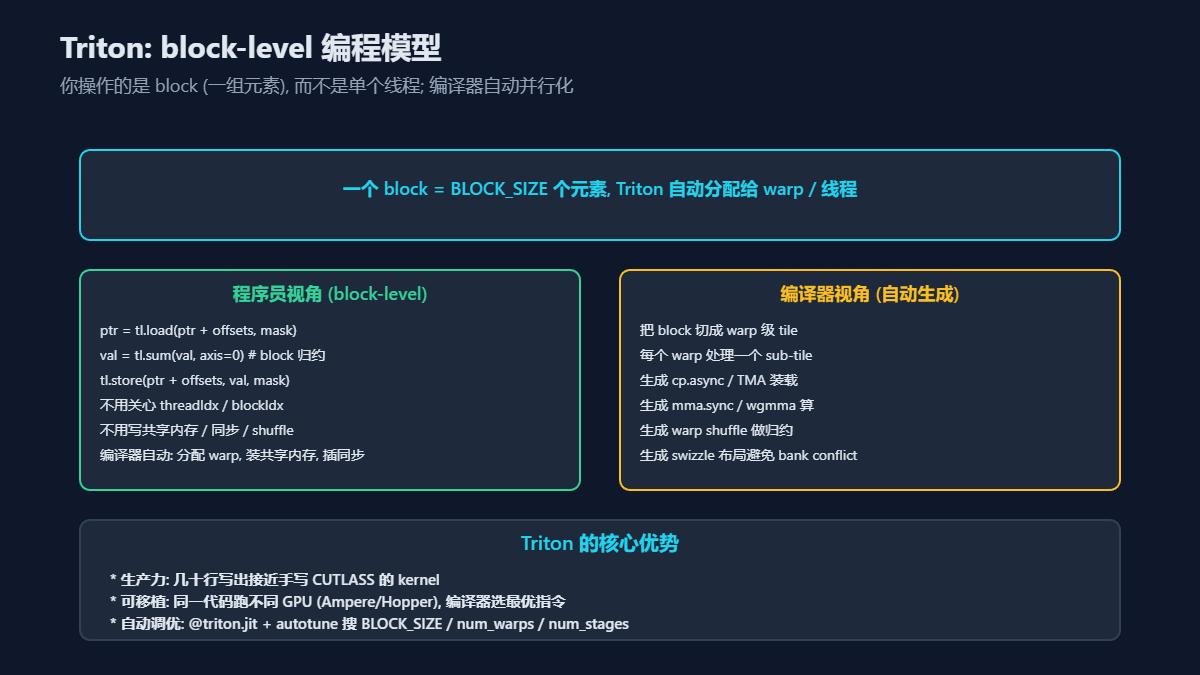
Triton 的核心思想是「你管 block,编译器管线程」。这是它和 CUDA 最大的区别。
白话定义:在 Triton 里,你写的代码操作的是「一组元素」(block),而不是单个线程。你不用关心 threadIdx、不用手写共享内存、不用插同步——编译器自动帮你做。
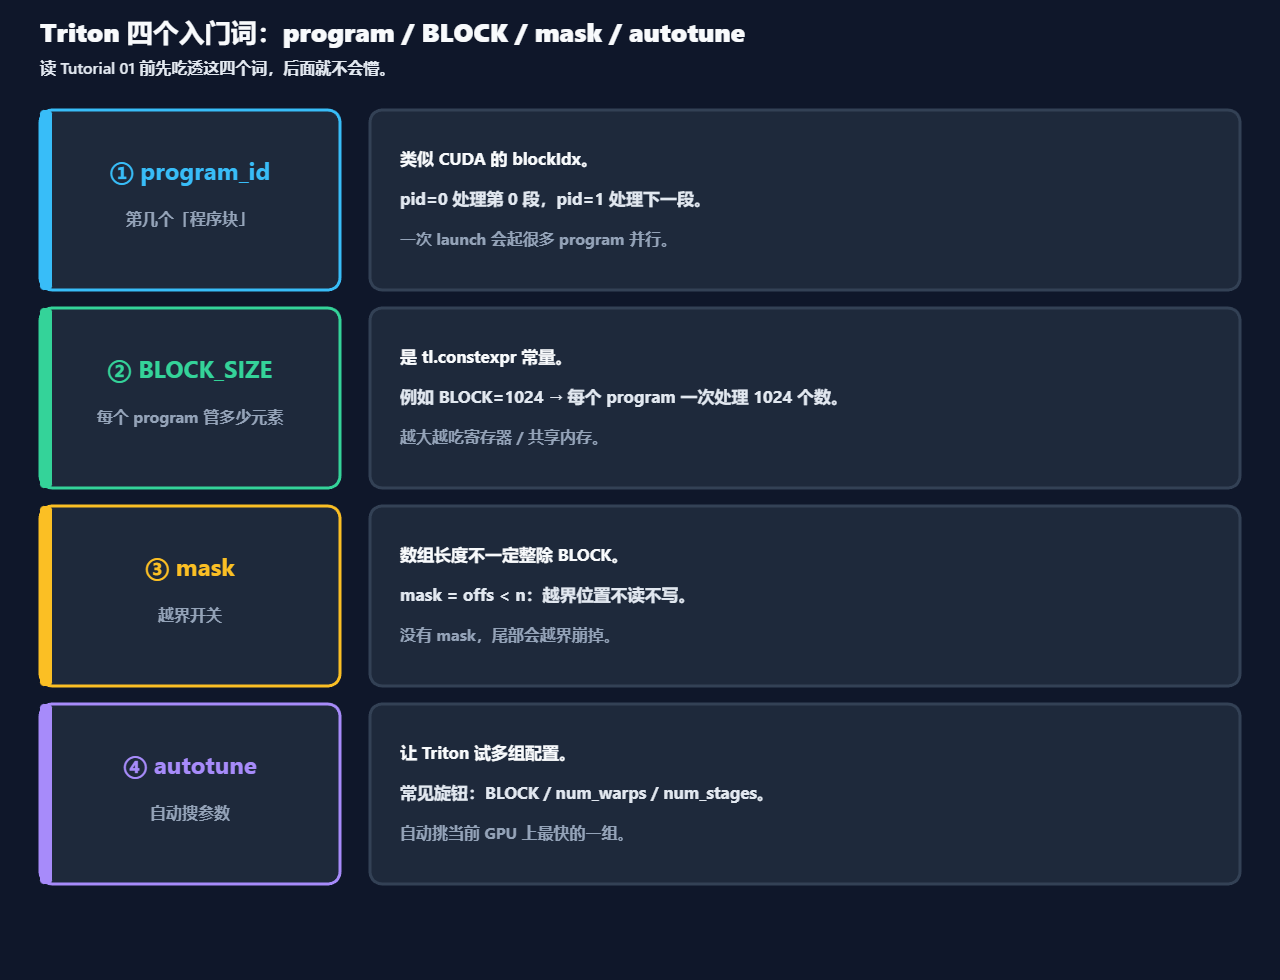
术语拆解
| 词 | 人话 |
|---|---|
| program_id | 第几个程序块(类似 blockIdx);pid=0 处理第 0 段 |
| BLOCK_SIZE | 每个 program 一次处理多少元素(编译期常量) |
| mask | 越界开关:offs < n 时才读写,长度不整除 BLOCK 也不崩 |
| autotune | 自动试多组 BLOCK / num_warps / num_stages,挑最快配置 |
| num_warps | 每个 program 用几个 warp(影响占用与并行度) |
| num_stages | 流水线深度(装下一块 / 算上一块重叠几级) |
精确定义:一个 block = BLOCK_SIZE 个元素,Triton 自动分配给 warp / 线程。 |
程序员视角(block-level):
ptr = tl.load(ptr + offsets, mask)   # 装一个 block
val = tl.sum(val, axis=0)             # block 归约
tl.store(ptr + offsets, val, mask)    # 写回一个 block
# 不用关心 threadIdx / blockIdx
# 不用写共享内存 / 同步 / shuffle
编译器视角(自动生成):
- 把 block 切成 warp 级 tile。
- 每个 warp 处理一个 sub-tile。
- 生成 cp.async / TMA 装载。
- 生成 mma.sync / wgmma 算。
- 生成 warp shuffle 做归约。
- 生成 swizzle 布局避免 bank conflict。
Triton 的核心优势: - 生产力:几十行写出接近手写 CUTLASS 的 kernel。
- 可移植:同一代码跑不同 GPU(Ampere/Hopper),编译器选最优指令。
- 自动调优:
@triton.jit+autotune搜 BLOCK_SIZE / num_warps / num_stages。
实践含义:Triton 让"写高性能 kernel"从少数专家的活变成普通工程师能做的事。SGLang 大量 fused kernel(激活、量化、RMSNorm、attention)都用 Triton 写。
二、Triton (block-level) vs CUDA (thread-level)
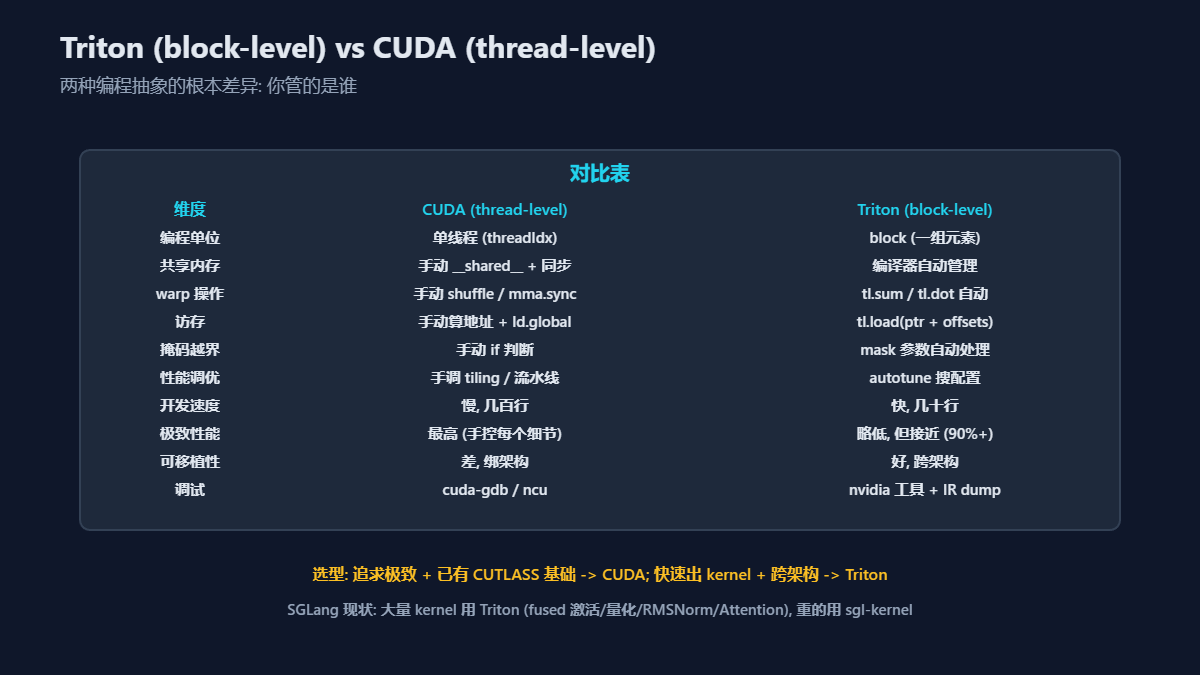
理解这两种抽象的根本差异,才能选对工具。
白话定义:CUDA 让你管每个线程,Triton 让你管一组元素。前者控制力强但繁琐,后者生产力高但牺牲极致控制。
精确定义(对比表):
| 维度 | CUDA (thread-level) | Triton (block-level) |
|---|---|---|
| 编程单位 | 单线程 (threadIdx) | block (一组元素) |
| 共享内存 | 手动 __shared__ + 同步 | 编译器自动管理 |
| warp 操作 | 手动 shuffle / mma.sync | tl.sum / tl.dot 自动 |
| 访存 | 手动算地址 + ld.global | tl.load(ptr + offsets) |
| 掩码越界 | 手动 if 判断 | mask 参数自动处理 |
| 性能调优 | 手调 tiling / 流水线 | autotune 搜配置 |
| 开发速度 | 慢,几百行 | 快,几十行 |
| 极致性能 | 最高(手控每个细节) | 略低,但接近(90%+) |
| 可移植性 | 差,绑架构 | 好,跨架构 |
| 调试 | cuda-gdb / ncu | nvidia 工具 + IR dump |
| 选型: |
- 追求极致 + 已有 CUTLASS 基础 → CUDA。
- 快速出 kernel + 跨架构 → Triton。
- SGLang 现状:大量 kernel 用 Triton(fused 激活/量化/RMSNorm/Attention),重的用 sgl-kernel(CUTLASS)。
实践含义:不是二选一。SGLang 这种大项目里,Triton 负责"灵活 + 快速迭代"的 fused kernel,CUTLASS 负责"极致性能"的 GEMM / attention。理解两者差异,才知道什么场景该用什么。
三、Tutorial 01:Vector Add(入门)
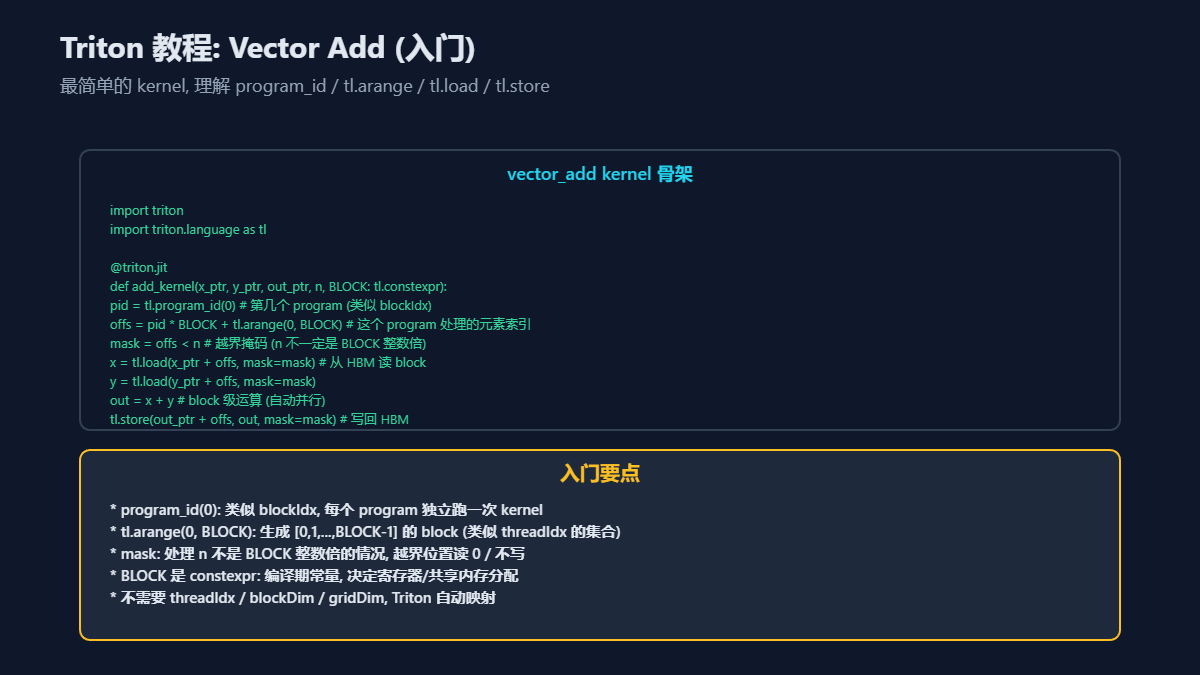
最简单的 kernel,理解 Triton 的四个核心原语:program_id / tl.arange / tl.load / tl.store。
白话定义:两个数组逐元素相加。用 Triton 写只要十几行,但能讲清所有基础概念。
kernel 骨架:
import triton
import triton.language as tl

@triton.jit
def add_kernel(x_ptr, y_ptr, out_ptr, n, BLOCK: tl.constexpr):
    pid = tl.program_id(0)            # 第几个 program (类似 blockIdx)
    offs = pid * BLOCK + tl.arange(0, BLOCK)  # 这个 program 处理的元素索引
    mask = offs < n                   # 越界掩码 (n 不一定是 BLOCK 整数倍)
    x = tl.load(x_ptr + offs, mask=mask)     # 从 HBM 读 block
    y = tl.load(y_ptr + offs, mask=mask)
    out = x + y                       # block 级运算 (自动并行)
    tl.store(out_ptr + offs, out, mask=mask)  # 写回 HBM

# 启动: grid = (triton.cdiv(n, BLOCK),)  # ceil(n/BLOCK) 个 program
入门要点:
program_id(0):类似 blockIdx,每个 program 独立跑一次 kernel。tl.arange(0, BLOCK):生成[0,1,...,BLOCK-1]的 block(类似 threadIdx 的集合)。mask:处理 n 不是 BLOCK 整数倍的情况,越界位置读 0 / 不写。BLOCK是constexpr:编译期常量,决定寄存器/共享内存分配。- 不需要 threadIdx / blockDim / gridDim,Triton 自动映射。
实践含义:刷完这个你就理解了 Triton 的"program + block"心智模型。后面所有 tutorial 都在这个基础上加概念。
四、Tutorial 02:Fused Softmax(block 归约)
网络权威配图:下面这张来自 Triton 官方 tutorial 的实测基准图,对比了 Triton fused softmax、PyTorch 原生 softmax、Torch JIT softmax 在不同列数下的性能。可以看到 fused 版本(中间读一次 HBM、寄存器内算完)相对 naive 版本(多次 HBM 往返)的明显优势,尤其在列数较大、行能装进 SRAM 时。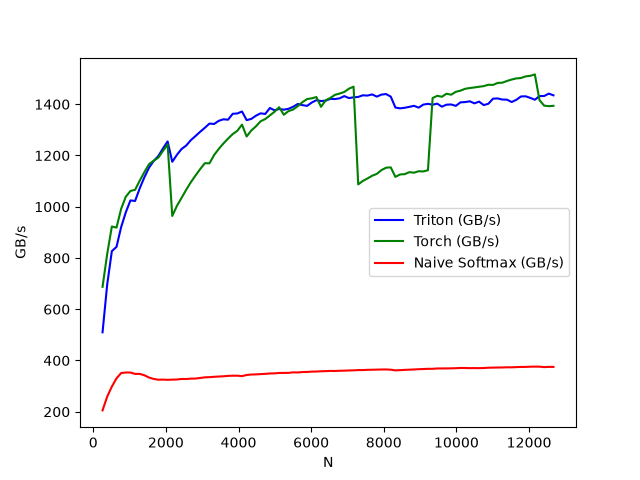
fused softmax 引入 block 级归约(tl.max / tl.sum)和数值稳定技巧。
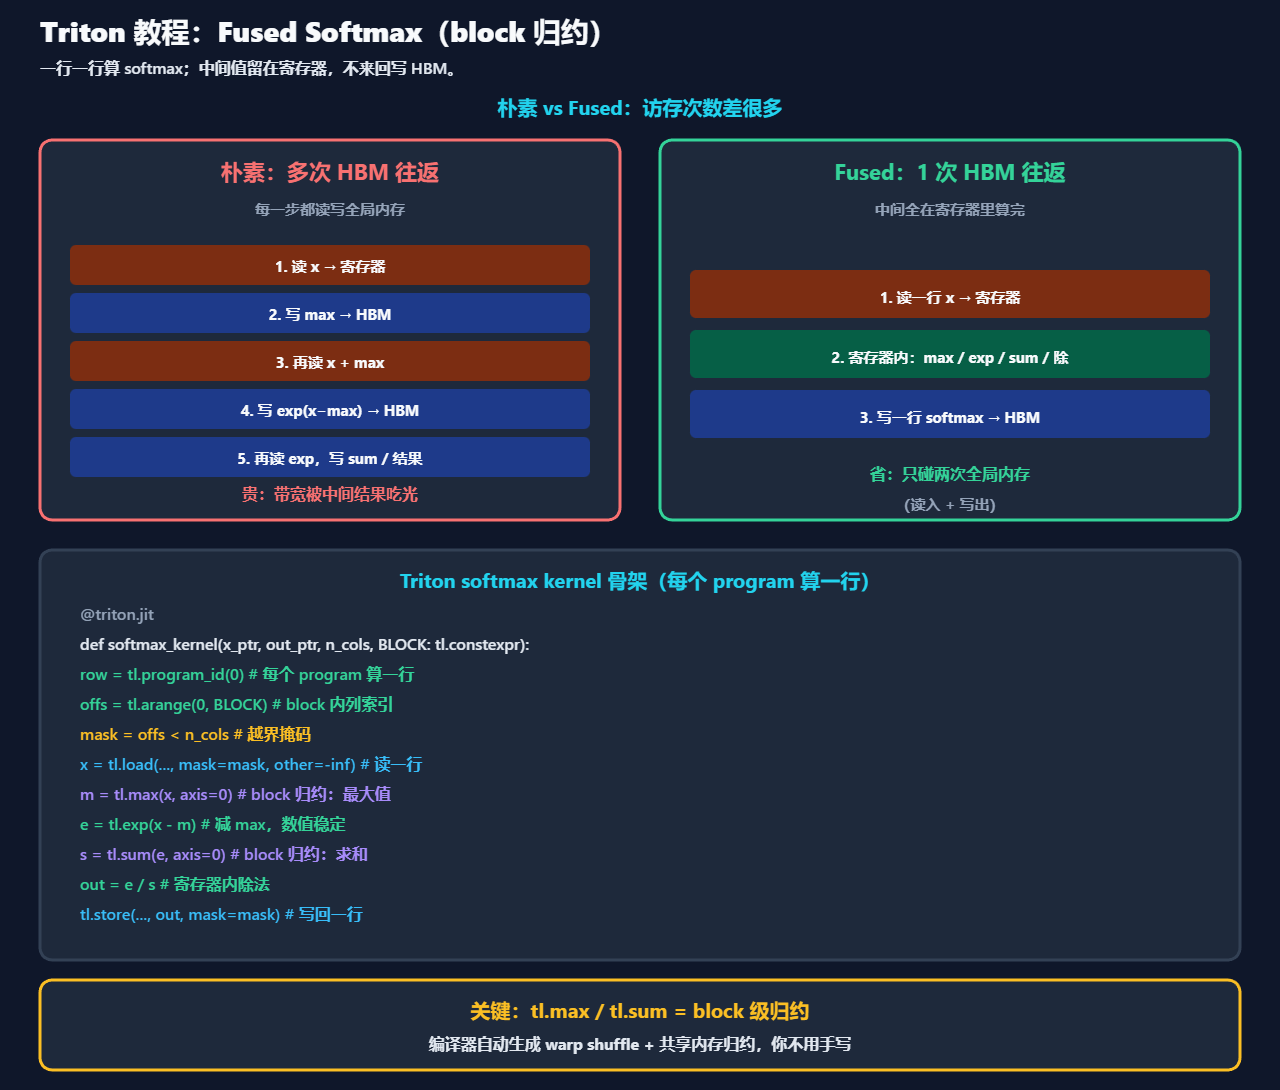
白话定义:softmax = exp(x - max) / sum(exp(x - max))。朴素实现要 3 次 HBM 往返,fused 实现只 1 次,中间值全在寄存器。
朴素 vs fused 的访存对比:
- 朴素(3 次 HBM 往返):读 x → 写 max 到 HBM → 读 x + max → 写 exp 到 HBM → 读 exp + sum → 写 sum。
- Fused(1 次 HBM 往返):读一行 x 到寄存器 → 寄存器内算 max / exp / sum / 除 → 写一行 softmax 回 HBM。
kernel 骨架:
@triton.jit
def softmax_kernel(x_ptr, out_ptr, n_cols, BLOCK: tl.constexpr):
    row = tl.program_id(0)            # 每个 program 算一行
    offs = tl.arange(0, BLOCK)         # block 内的列索引
    mask = offs < n_cols               # 越界掩码
    x = tl.load(x_ptr + row*n_cols + offs, mask=mask, other=-inf)
    m = tl.max(x, axis=0)               # block 归约: 最大值
    e = tl.exp(x - m)                   # 减最大值, 数值稳定
    s = tl.sum(e, axis=0)               # block 归约: 求和
    out = e / s                         # 寄存器内除法
    tl.store(out_ptr + row*n_cols + offs, out, mask=mask)
关键:tl.max / tl.sum 是 block 级归约,编译器自动生成 warp shuffle + 共享内存归约。你只管写"对这一行求 max",不用管 warp 怎么协作。
实践含义:这个 tutorial 教会你"block 归约"——Triton 最强大的抽象之一。后面 RMSNorm、LayerNorm、reduce-mean 都是同一个套路。
五、Tutorial 03:Matmul(分块 GEMM + Tensor Core)
网络权威配图:下面两张来自 Triton 官方 tutorial。第一张是 matmul 教程里最经典的图——对比"按行优先顺序发射 block"与"按 super-group 分组发射 block"两种 program 排序对 L2 cache 命中率的影响:分组排序让相邻 program 复用 B 的同一批列块,L2 命中率提升,性能可提升 10%+(A100 上 220→245 TFLOPS)。第二张是 Triton matmul 与 cuBLAS 的方阵性能实测对比。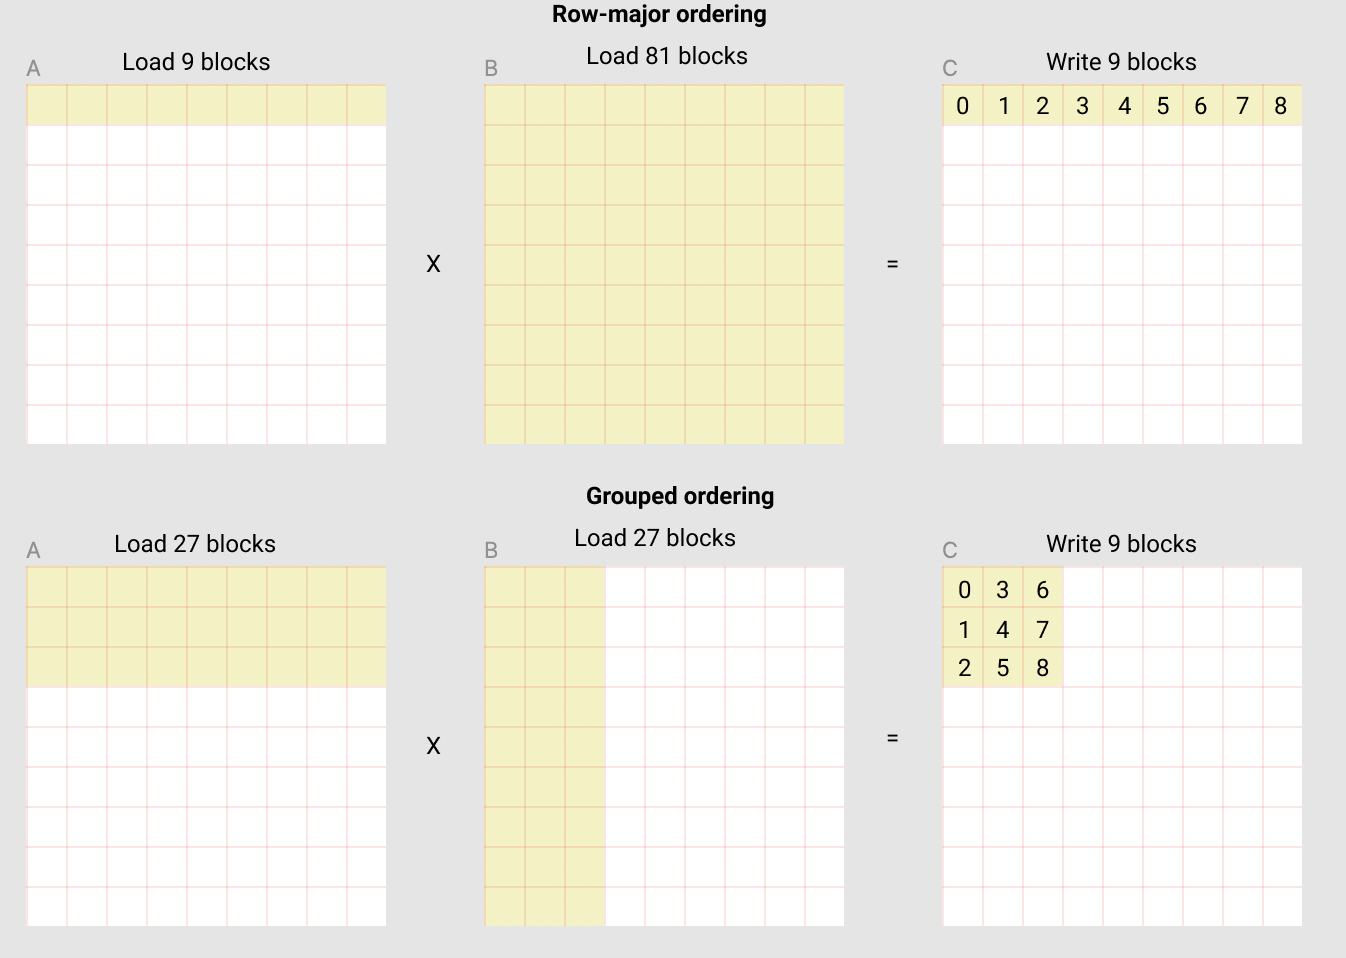
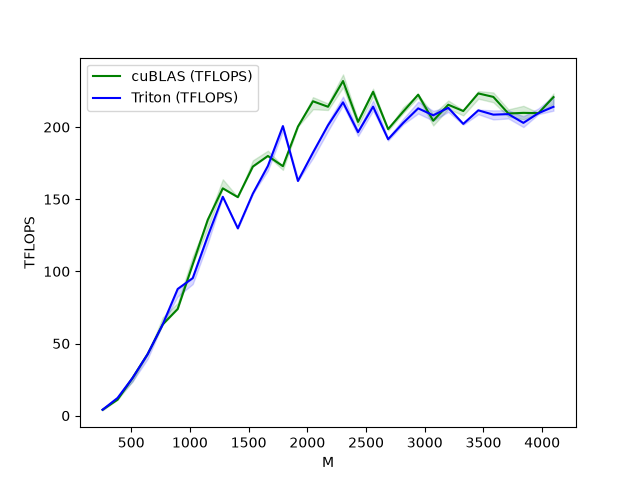
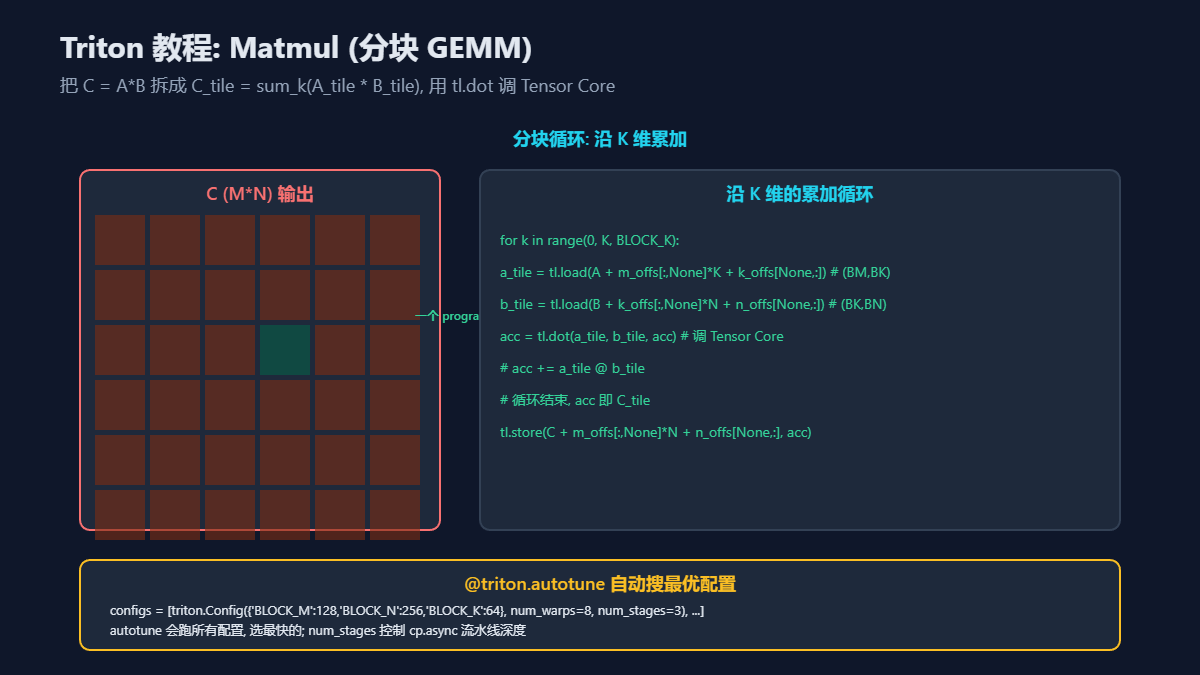
matmul 引入 tl.dot(调 Tensor Core)、2D 分块、沿 K 维累加。
白话定义:C = A×B,把 C 切成 tile,每个 program 算一个 C_tile,沿 K 维累加 A_tile × B_tile。
分块循环:
for k in range(0, K, BLOCK_K):
    a_tile = tl.load(A + m_offs[:,None]*K + k_offs[None,:])  # (BM,BK)
    b_tile = tl.load(B + k_offs[:,None]*N + n_offs[None,:])  # (BK,BN)
    acc = tl.dot(a_tile, b_tile, acc)  # 调 Tensor Core
    # acc += a_tile @ b_tile
# 循环结束, acc 即 C_tile
tl.store(C + m_offs[:,None]*N + n_offs[None,:], acc)
autotune 自动搜最优配置:
configs = [
    triton.Config({'BLOCK_M':128,'BLOCK_N':256,'BLOCK_K':64}, num_warps=8, num_stages=3),
    # ... 更多配置
]
@triton.autotune(configs=configs, key=['M','N','K'])
@triton.jit
def matmul_kernel(...):
    ...
autotune 会跑所有配置,选最快的。num_stages 控制 cp.async 流水线深度。
实践含义:这个 tutorial 教会你"2D 分块 + Tensor Core + 流水线"——所有 GEMM 类 kernel 的通用骨架。FlashAttention 也是在这个基础上改 K 循环逻辑。
六、Tutorial 06:Fused Attention(Flash 思想)
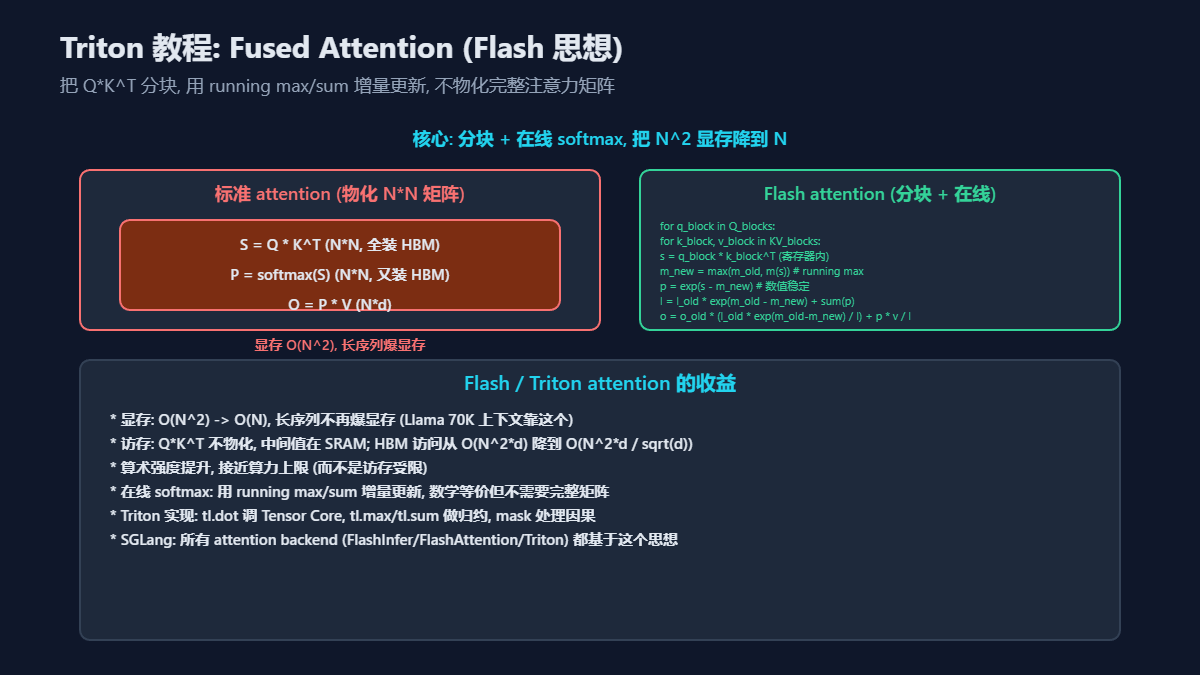
网络权威配图(核心):下面这张是 FlashAttention 论文(Dao et al., 2022)的 Figure 1,是讲解 Flash 思想最权威的一张图。左半部分展示 FlashAttention 用 tiling 避免物化 N×N 注意力矩阵;右半部分展示在线 softmax——用 running max/sum 增量更新,每来一个新块就重整化(rescale)累加结果,数学上等价于标准 softmax 但不需要完整中间矩阵。这正是本文"分块 + 在线 softmax"的官方出处。
网络权威配图(实测):下面这张是 Triton 官方 fused attention tutorial 的实测基准图,对比了 Triton fused attention 与 PyTorch 原生 attention 在不同序列长度下的前向+反向耗时,直观体现 Flash 思想带来的加速。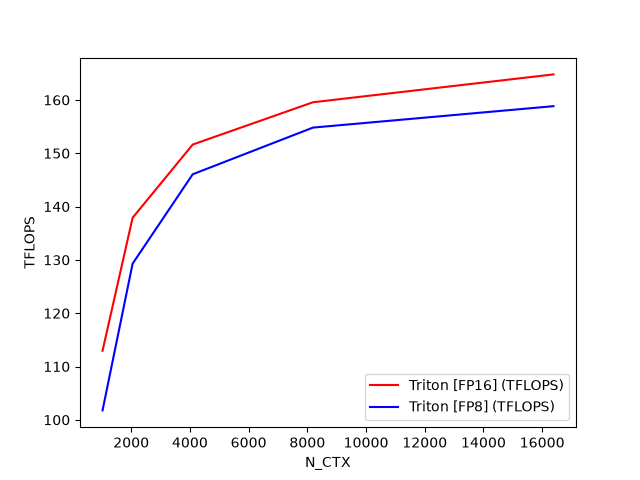
fused attention 是 Triton tutorial 的高峰,引入 Flash 的"分块 + 在线 softmax"思想。
白话定义:标准 attention 要物化 N×N 的注意力矩阵,长序列爆显存。Flash attention 分块算,用 running max/sum 增量更新,显存从 O(N²) 降到 O(N)。
标准 attention(物化 N×N 矩阵):
- S = Q×K^T(N×N,全装 HBM)
- P = softmax(S)(N×N,又装 HBM)
- O = P×V(N×d)
- 显存 O(N²),长序列爆显存。
Flash attention(分块 + 在线):
for q_block in Q_blocks:
    for k_block, v_block in KV_blocks:
        s = q_block * k_block^T  (寄存器内)
        m_new = max(m_old, m(s))  # running max
        p = exp(s - m_new)  # 数值稳定
        l = l_old * exp(m_old - m_new) + sum(p)
        o = o_old * (l_old * exp(m_old-m_new) / l) + p * v / l
收益:
- 显存:O(N²) → O(N),长序列不再爆显存(Llama 70K 上下文靠这个)。
- 访存:Q×K^T 不物化,中间值在 SRAM;HBM 访问从 O(N²·d) 降到 O(N²·d / √d)。
- 算术强度提升,接近算力上限(而不是访存受限)。
- 在线 softmax:用 running max/sum 增量更新,数学等价但不需要完整矩阵。
- Triton 实现:
tl.dot调 Tensor Core,tl.max/tl.sum做归约,mask 处理因果。 - SGLang:所有 attention backend(FlashInfer/FlashAttention/Triton)都基于这个思想。
实践含义:刷完这个你就理解了现代 LLM 推理的 attention 是怎么省显存、提带宽的。SGLang 的 attention backend 选择、prefix cache、long context 都建立在这个理解上。
七、官方 Tutorial 学习路径
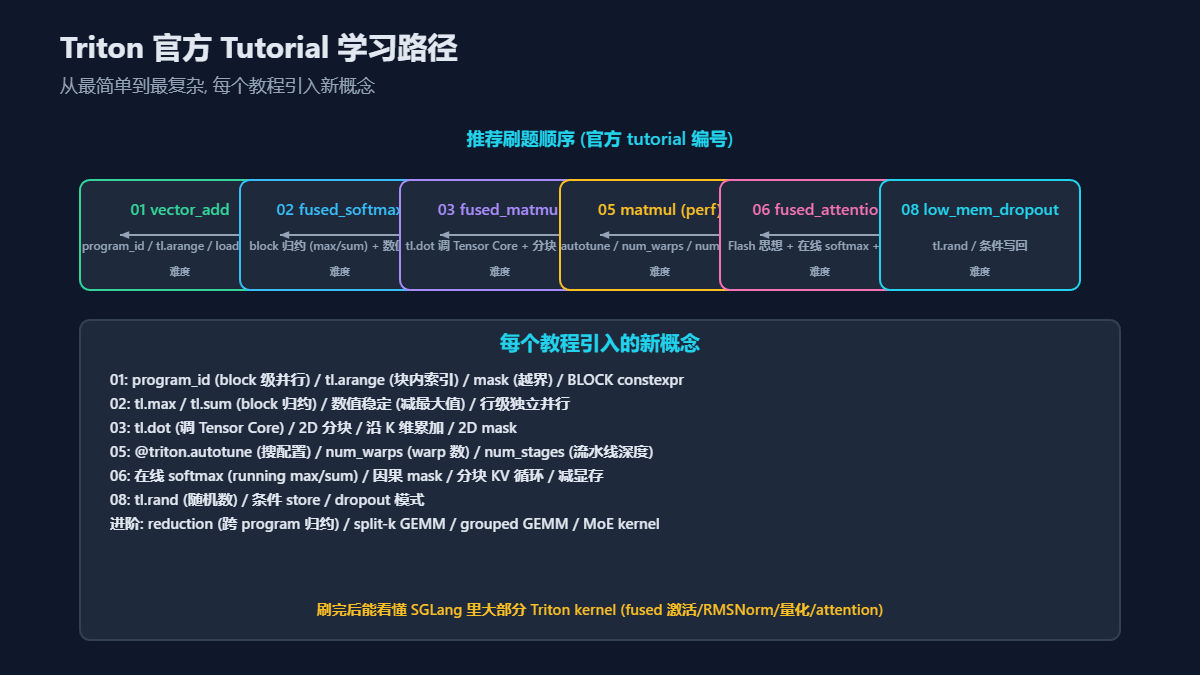
把官方 tutorial 按顺序刷,每个引入新概念,循序渐进。
推荐刷题顺序(官方 tutorial 编号):
- 01 vector_add:
program_id/tl.arange/load/store。难度:入门。 - 02 fused_softmax:block 归约(max/sum)+ 数值稳定。难度:入门-中。
- 03 fused_matmul:
tl.dot调 Tensor Core + 分块 K 循环。难度:中。 - 05 matmul (perf):
autotune/num_warps/num_stages。难度:中-高。 - 06 fused_attention:Flash 思想 + 在线 softmax + mask。难度:高。
- 08 low_mem_dropout:
tl.rand/ 条件写回。难度:中。
每个教程引入的新概念:
- 01:program_id(block 级并行)/ tl.arange(块内索引)/ mask(越界)/ BLOCK constexpr。
- 02:tl.max / tl.sum(block 归约)/ 数值稳定(减最大值)/ 行级独立并行。
- 03:tl.dot(调 Tensor Core)/ 2D 分块 / 沿 K 维累加 / 2D mask。
- 05:@triton.autotune(搜配置)/ num_warps(warp 数)/ num_stages(流水线深度)。
- 06:在线 softmax(running max/sum)/ 因果 mask / 分块 KV 循环 / 减显存。
- 08:tl.rand(随机数)/ 条件 store / dropout 模式。
- 进阶:reduction(跨 program 归约)/ split-k GEMM / grouped GEMM / MoE kernel。
实践含义:刷完前 6 个,你能看懂 SGLang 里大部分 Triton kernel(fused 激活/RMSNorm/量化/attention)。进阶的 reduction / grouped GEMM 是 MoE 场景的关键。
八、Triton 在 SGLang 里的应用
SGLang 大量使用 Triton,理解 tutorial 后能看懂这些场景:
- fused 激活 + 量化:
silu + mul + quant一条 kernel 搞定,省 HBM 往返。 - RMSNorm:
tl.sum做归约,tl.rsqrt做开方,全程寄存器。 - 量化 kernel:FP8 / INT8 量化,per-tensor / per-channel 缩放。
- attention:Triton attention backend,Flash 思想 + 因果 mask。
- MoE:grouped GEMM(一个 kernel 算多个 expert 的矩阵乘)。
- rotary embedding:位置编码的 fused 计算。
SGLang 的 kernel 分层: - Triton kernel(
python/sglang/srt/layers/):灵活、快速迭代、跨架构。 - sgl-kernel AOT CUDA(
sgl-kernel/):极致性能、Hopper 专属(wgmma + TMA)、用 CUTLASS。 - JIT kernel(
python/sglang/srt/jit_kernel/):运行时编译,按 shape 特化。
术语速查(本文)
| 术语 | 一句话 |
|---|---|
| block-level | 操作一组元素,不管单个 threadIdx |
| program_id | 第几个程序块(≈ blockIdx) |
| BLOCK_SIZE | 每个 program 处理的元素数 |
| mask | 越界保护布尔掩码 |
| tl.load / tl.store | 读写一个 block |
| tl.dot | block 级矩阵乘(尽量走 Tensor Core) |
| num_warps / num_stages | 每 program 的 warp 数 / 流水线深度 |
| autotune | 自动搜上述超参 |
| fused | 多步合成一个 kernel,少写回 HBM |
常见误区
- 误区一:Triton 一定比 CUDA 慢。不一定。多数场景 Triton 能达到手写 CUDA 的 90%+,且开发快十倍。极致场景(Hopper wgmma + TMA 深度流水线)CUTLASS 仍领先。
- 误区二:BLOCK_SIZE 越大越好。错。BLOCK_SIZE 大 → 寄存器多 → occupancy 低;要 autotune 搜。
- 误区三:autotune 跑一次就行。不够。不同 shape / 硬件最优配置不同;autotune 的 key 要包含 shape。
- 误区四:Triton 不用管 bank conflict。部分对。编译器自动 swizzle,但某些自定义访问模式仍可能撞 bank,要看 IR / ncu。
- 误区五:tl.dot 自动用 Tensor Core。对,但前提是数据类型和 tile 形状满足 Tensor Core 要求(如 FP16 的 16 对齐),否则回退。
实践清单
刷 Triton tutorial 或写 kernel 时对照检查:
FAQ
Q:Triton 学完能替代 CUDA 吗?
A:大部分场景能。fused kernel、归约、attention 用 Triton 足够。极致性能的 Hopper kernel(wgmma + TMA 深度流水线)仍需 CUTLASS / CUDA。
Q:Triton 怎么调试?
A:用 TRITON_INTERPRET=1 跑解释模式(单线程,可 print);用 ncu 看 kernel 指标;用 tl.debug_barrier() 定位 hang。SGLang 的 --enable-debug 也能帮定位。
Q:Triton 的 autotune 很慢怎么办?
A:autotune 结果会缓存,第一次慢后续快。可以预编译(启动时跑一遍 representative shape);或缩小 configs 搜索空间。
Q:SGLang 里怎么加一个 Triton kernel?
A:参考 .claude/skills/add-jit-kernel/SKILL.md(轻量 JIT)和 add-sgl-kernel/SKILL.md(重型 AOT)。先看现有同类 kernel 的写法,再改。
总结
Triton 的 block-level 抽象是 GPU 编程的一次范式转变:从"管线程"到"管数据块"。它让高性能 kernel 从专家专利变成普通工程师能做的事,同时保持接近手写 CUDA 的性能。刷完官方 tutorial 前 6 个,你就能看懂 SGLang 里大部分 Triton kernel,并自己写 fused kernel。
阅读导航



