
CUDA 性能分析:Nsight、Graph、Stream 与 CUTLASS
分析工具与 CUDA Graph / Stream / CUTLASS
讲了硬件和优化套路。这篇讲工程化武器:怎么用 nsys / ncu 找瓶颈(读 SGLang profile 必备),怎么用 CUDA Graph 省 CPU 开销,怎么用 stream 并发重叠任务,以及 CUTLASS 这套模板库怎么帮你拼出高性能 kernel。
本文先讲两个分析工具(nsys 宏观、ncu 微观),再讲三个工程化武器(CUDA Graph、stream 并发、CUTLASS),最后给一个完整的"读 SGLang profile"工作流。
一、Nsight Systems (nsys):系统级 timeline
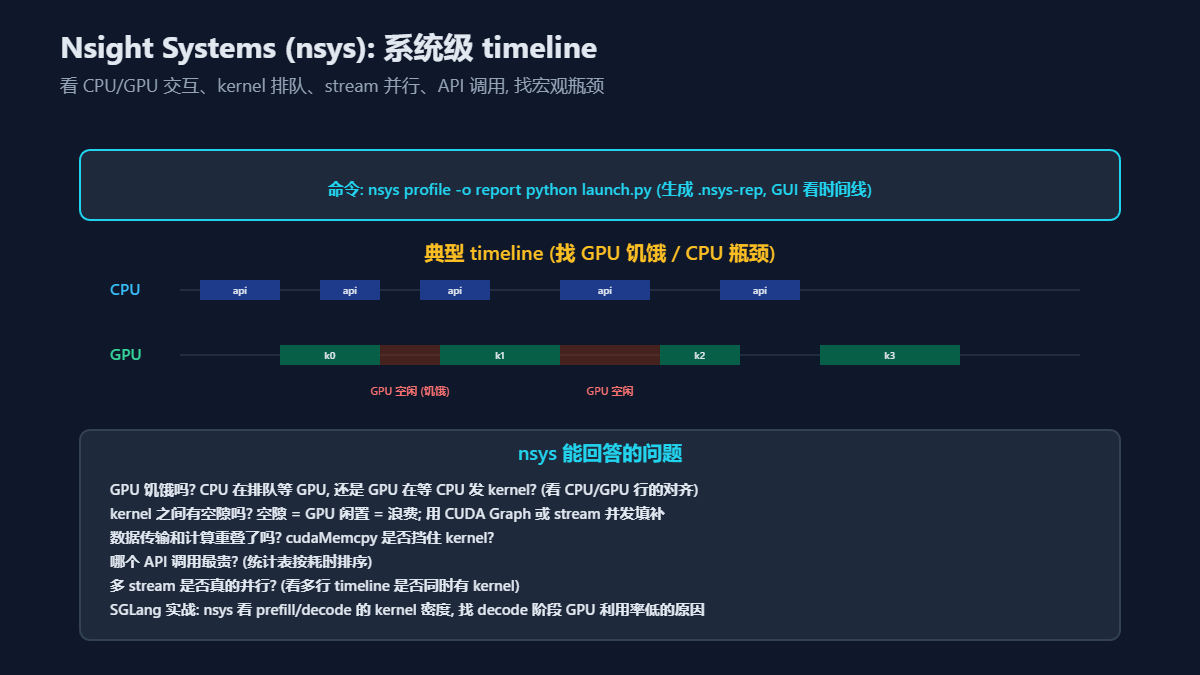
nsys 是看"宏观"的工具:CPU/GPU 交互、kernel 排队、stream 并行、API 调用。它是读 SGLang profile 的第一站。
白话定义:nsys 把整个程序跑一遍,录成一条时间线,你能看到 CPU 在干什么、GPU 在干什么、它们之间怎么对齐。
精确定义:
nsys profile -o report python launch.py
# 生成 report.nsys-rep, 用 GUI 打开看时间线
nsys 报告里最核心的是 timeline 视图:上面一行是 CPU 的 API 调用,下面一行是 GPU 的 kernel 执行。对齐看就能发现:
- GPU 饥饿:CPU 行有 API 调用,GPU 行空着(kernel 之间有空隙)→ GPU 闲置浪费。
- CPU 瓶颈:CPU 行密密麻麻,GPU 行稀疏 → CPU 发 kernel 太慢。
- 传输挡计算:cudaMemcpy 把 kernel 挡住了 → 没用 stream 并发。
- 多 stream 是否真并行:多行 timeline 是否同时有 kernel。
nsys 能回答的问题:
- GPU 饥饿吗?CPU 在排队等 GPU,还是 GPU 在等 CPU 发 kernel?(看 CPU/GPU 行的对齐)
- kernel 之间有空隙吗?空隙 = GPU 闲置 = 浪费;用 CUDA Graph 或 stream 并发填补。
- 数据传输和计算重叠了吗?cudaMemcpy 是否挡住 kernel?
- 哪个 API 调用最贵?(统计表按耗时排序)
- 多 stream 是否真的并行?(看多行 timeline 是否同时有 kernel)
- SGLang 实战:nsys 看 prefill/decode 的 kernel 密度,找 decode 阶段 GPU 利用率低的原因。
实践含义:调优第一步永远是 nsys,先看宏观有没有 GPU 饥饿、有没有空隙、哪个阶段最久。不要一上来就钻 kernel 内部。
二、Nsight Compute (ncu):kernel 级 profiler
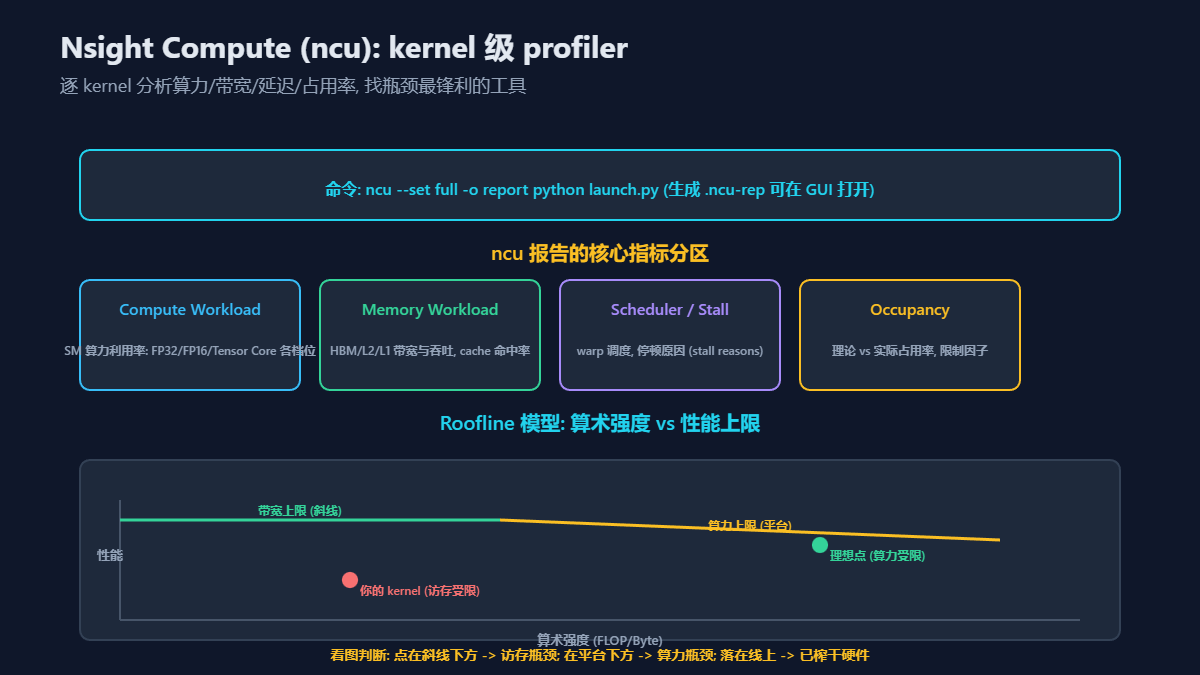
ncu 是看「微观」的工具:逐 kernel 分析算力、带宽、延迟、占用率。它是找 kernel 瓶颈最锋利的武器。
白话定义:ncu 钻进单个 kernel,告诉你它卡在哪——是算力不够、带宽不够、还是 occupancy 太低。
精确定义:
ncu --set full -o report python launch.py
# 生成 report.ncu-rep, GUI 打开; 也可命令行 --csv 导指标
ncu 报告分四个核心指标区:
- Compute Workload:SM 算力利用率,FP32/FP16/Tensor Core 各档位。
- Memory Workload:HBM/L2/L1 带宽与吞吐,cache 命中率。
- Scheduler / Stall:warp 调度,停顿原因(stall reasons)。
- Occupancy:理论 vs 实际占用率,限制因子。
Roofline:用一张图判断「卡算力还是卡带宽」
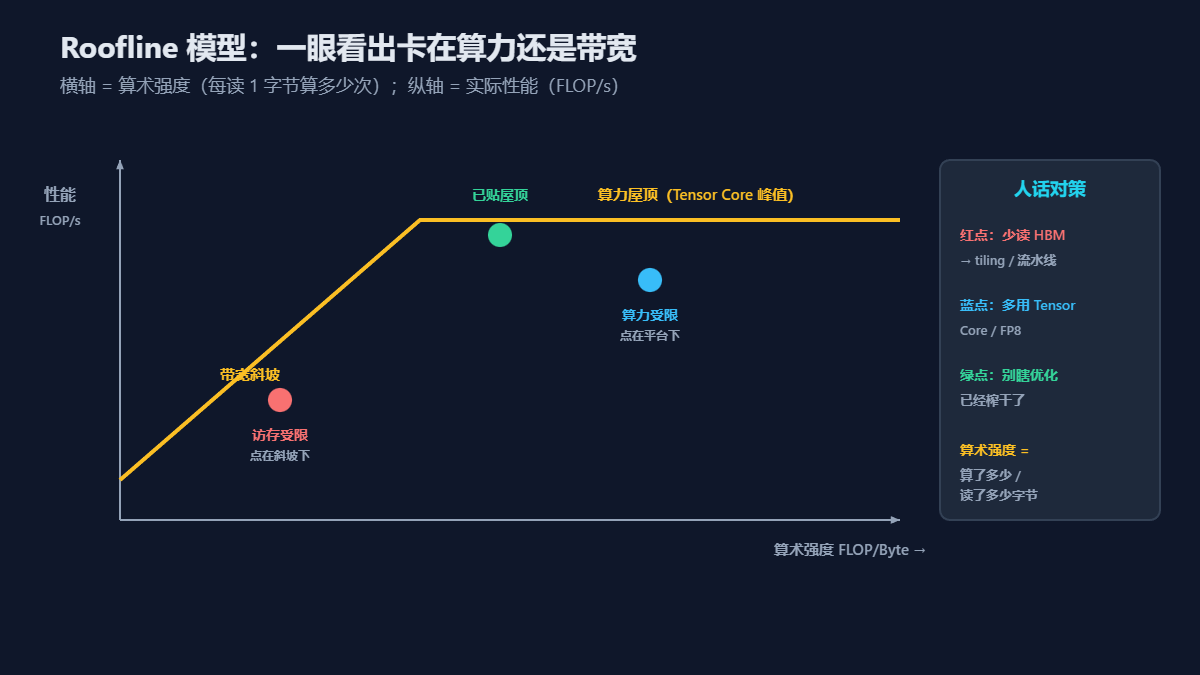
| 词 | 人话 |
|---|---|
| 算术强度 | 每从显存读 1 字节,能做多少次浮点运算(FLOP/Byte) |
| 带宽斜坡 | 强度低时,性能被「读得不够快」限制(斜线) |
| 算力屋顶 | 强度够高时,性能被 Tensor Core 峰值限制(水平线) |
| 点在斜坡下 | 访存受限 → 加 tiling / 流水线 / 少读 HBM |
| 点在平台下 | 算力受限 → 确认走 Tensor Core / FP8 / 减冗余计算 |
| 常见 stall 人话: | |
| Stall 名 | 人话 |
| - | - |
| Long Scoreboard | 在等全局内存数据到寄存器 |
| Wait / Barrier | 在等 __syncthreads / mbarrier / wait_group |
| Divergence | warp 内分支走散了 |
| 实践含义: |
- 先用 nsys 找最久的 kernel,再用 ncu 钻进去。
- 看 roofline 判断瓶颈类型,再看对应指标区。
三、CUDA Graph:录制 + 重放,省掉 CPU 调度开销
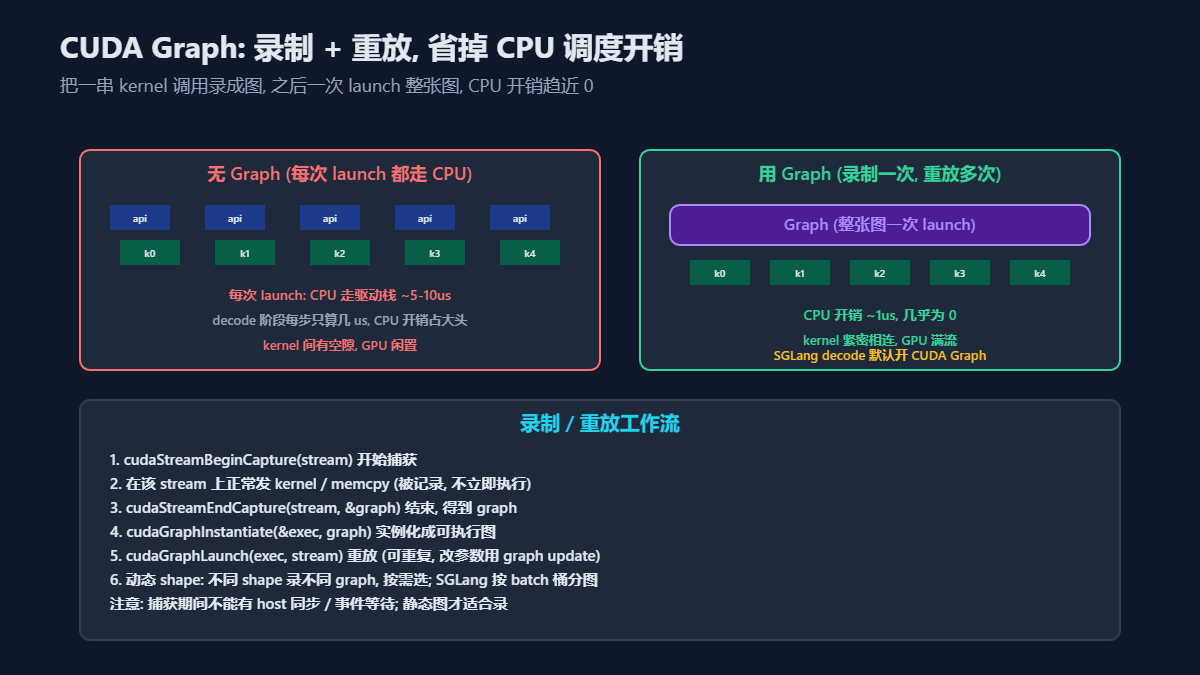
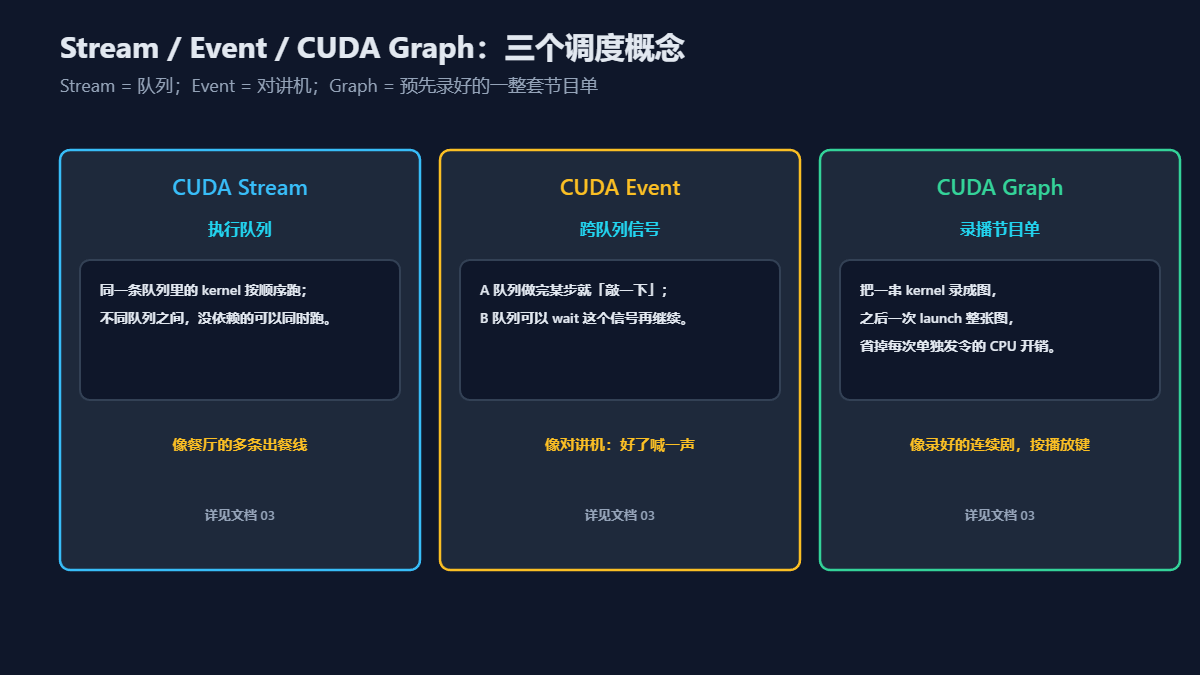
CUDA Graph 是 decode 阶段的关键武器:把一串 kernel 录成图,之后一次 launch 整张图,CPU 开销趋近 0。
术语拆解:Stream / Event / Graph
| 概念 | 比喻 | 人话 |
|---|---|---|
| Stream | 出餐线 | 同一条队列里的活按顺序做;不同队列可并行 |
| Event | 对讲机 | A 队列做完敲一下,B 队列可以等这个信号 |
| CUDA Graph | 录好的节目单 | 把一串 kernel 录成图,之后按「播放」一次发完整套 |
| 白话定义:把要反复执行的 kernel 序列录成一张「图」,之后每次只发「重放这张图」一条指令,省掉每个 kernel 单独 launch 的 CPU 开销。 |
精确定义:
- 无 Graph:每次 launch 一个 kernel,CPU 都要走一遍驱动栈,约 5-10 微秒。decode 阶段每步只算几微秒,CPU 开销占大头,kernel 间有空隙, GPU 闲置。
- 有 Graph:录制一次,重放多次,CPU 开销约 1 微秒,kernel 紧密相连,GPU 满流。
录制 / 重放工作流:
1. cudaStreamBeginCapture(stream)  开始捕获
2. 在该 stream 上正常发 kernel / memcpy (被记录, 不立即执行)
3. cudaStreamEndCapture(stream, &graph)  结束, 得到 graph
4. cudaGraphInstantiate(&exec, graph)  实例化成可执行图
5. cudaGraphLaunch(exec, stream)  重放 (可重复, 改参数用 graph update)
6. 动态 shape: 不同 shape 录不同 graph, 按需选; SGLang 按 batch 桶分图
注意:
- 捕获期间不能有 host 同步 / 事件等待;静态图才适合录。
- 动态 shape:不同 shape 录不同 graph,按需选。SGLang 按 batch 桶分图,避免重录开销。
- 改参数用
cudaGraphExecKernelNodeSetParams(graph update),不用重录。 - SGLang decode 默认开 CUDA Graph,这是它 decode 吞吐高的关键之一。
实践含义: - 任何"小 kernel 反复跑"的场景都该考虑 CUDA Graph(decode、采样、小 batch 推理)。
- 大 kernel / 一次性计算不需要 Graph,CPU 开销占比小。
- SGLang 的
cuda_graph相关代码在python/sglang/srt/model_executor/和 scheduler 里。
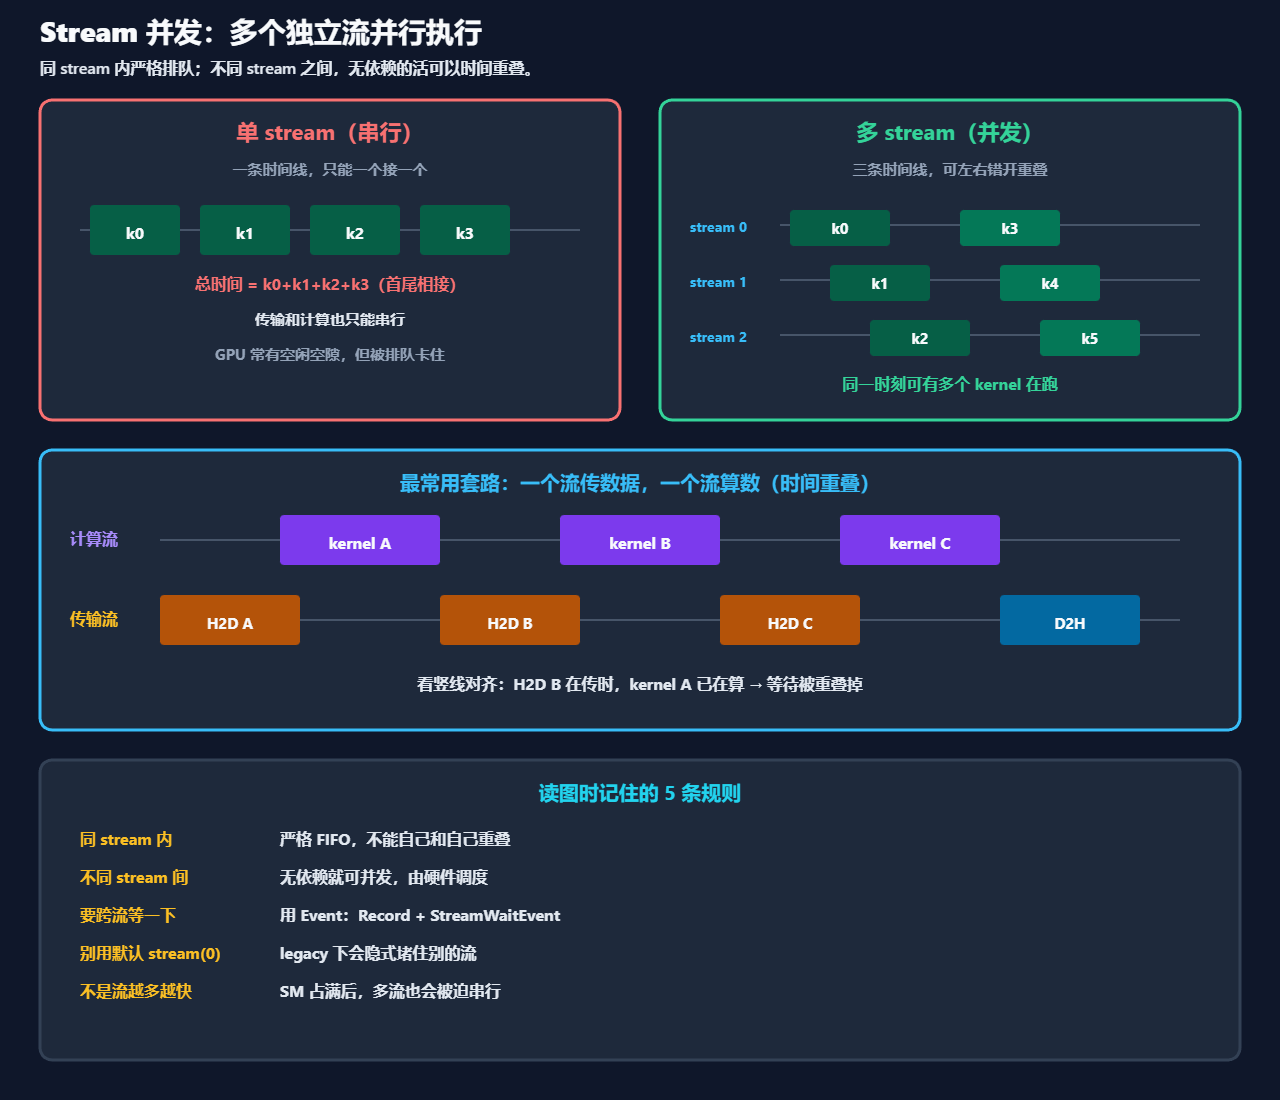
四、Stream 并发:多个独立流并行执行
网络权威配图:下面这张来自 NVIDIA CUDA C++ Best Practices Guide,对比了"拷贝与 kernel 串行执行"与"用多个 stream 让拷贝和 kernel 并行执行"的时间线。这正是 stream 并发价值的最直观说明——通过把数据传输和计算放到不同 stream,让它们时间重叠,缩短总耗时。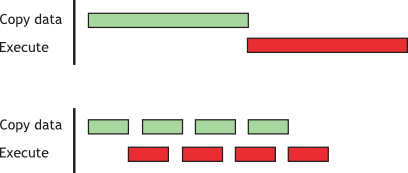
stream 并发让不同任务(计算 / 传输 / 不同 kernel)同时跑,重叠等待时间。
白话定义:CUDA stream 是 kernel 的执行队列。同一 stream 内 kernel 串行,不同 stream 间无依赖的 kernel 可并发。
精确定义:
- 单 stream:kernel 依次排队,无重叠,传输和计算也串行。
- 多 stream:不同 stream 的 kernel 时间重叠,由硬件调度器决定并发度。
关键规则:
- 同 stream 内:严格按发射顺序执行(FIFO),不重叠。
- 不同 stream 间:无依赖的 kernel 可并发,由硬件调度器决定。
- 建立依赖:
cudaEventRecord+cudaStreamWaitEvent(跨 stream 同步)。 - 默认 stream(0):隐式阻塞所有其他 stream(legacy),建议显式建 stream。
- 并发上限:受 SM 资源限制;kernel 太大反而串行(资源占满)。
- 实战:一个流算,一个流传数据(H2D/D2H),重叠传输和计算。
- SGLang:多 DP rank / 多 EP group 用不同 stream 并发通信和计算。
实践含义:
- 传输和计算重叠:H2D 流 + 计算流,让数据搬运和 kernel 并行。
- 多任务并发:多个独立 kernel 放不同 stream,填满 SM。
- 跨 stream 同步用 event,不要用
cudaDeviceSynchronize(太重)。 - 注意:并发不是无限,SM 资源占满后 kernel 仍会串行。
五、CUTLASS:NVIDIA 官方 GEMM / 卷积模板库
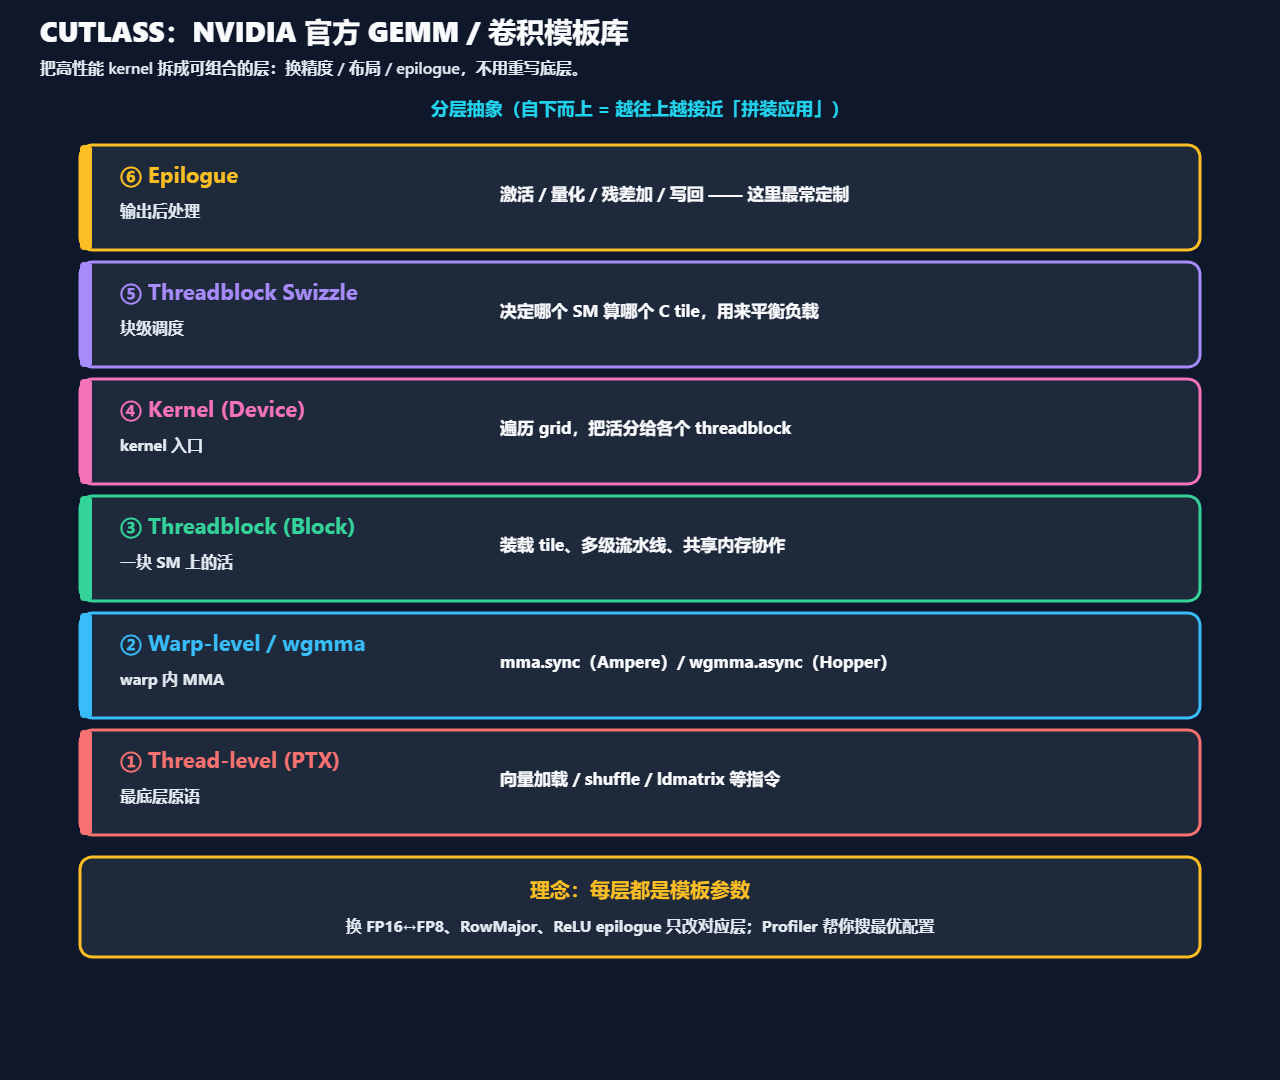
CUTLASS 是写高性能 kernel 的「乐高」:把 kernel 拆成可组合的层,你换精度 / 布局 / epilogue 不用动其他层。
白话定义:CUTLASS 是 NVIDIA 开源的高性能 GEMM / 卷积模板库,把一个 kernel 拆成多层抽象,每层都是模板参数,你拼出定制 kernel 而不重写底层。
术语拆解(六层从下到上)
| 层 | 人话 |
|---|---|
| PTX / Thread | 最底层机器味指令:向量加载、shuffle、ldmatrix… |
| Warp / wgmma | 一个(或一组)warp 的 MMA |
| Threadblock | 一个 SM 上的计算块:装 tile、流水线 |
| Kernel / Device | kernel 入口:grid 怎么扫 |
| Threadblock Swizzle | 决定「哪个 SM 算 C 的哪一块」,均衡负载 |
| Epilogue | 算完矩阵乘之后的「收尾」:加 bias、激活、量化、写回 |
理念:换 FP16→FP8、换 RowMajor、换 ReLU epilogue,只改对应模板参数。CUTLASS Profiler 可搜配置;SGLang sgl-kernel 部分 AOT 基于它改造。 |
六、读 SGLang profile 的完整工作流
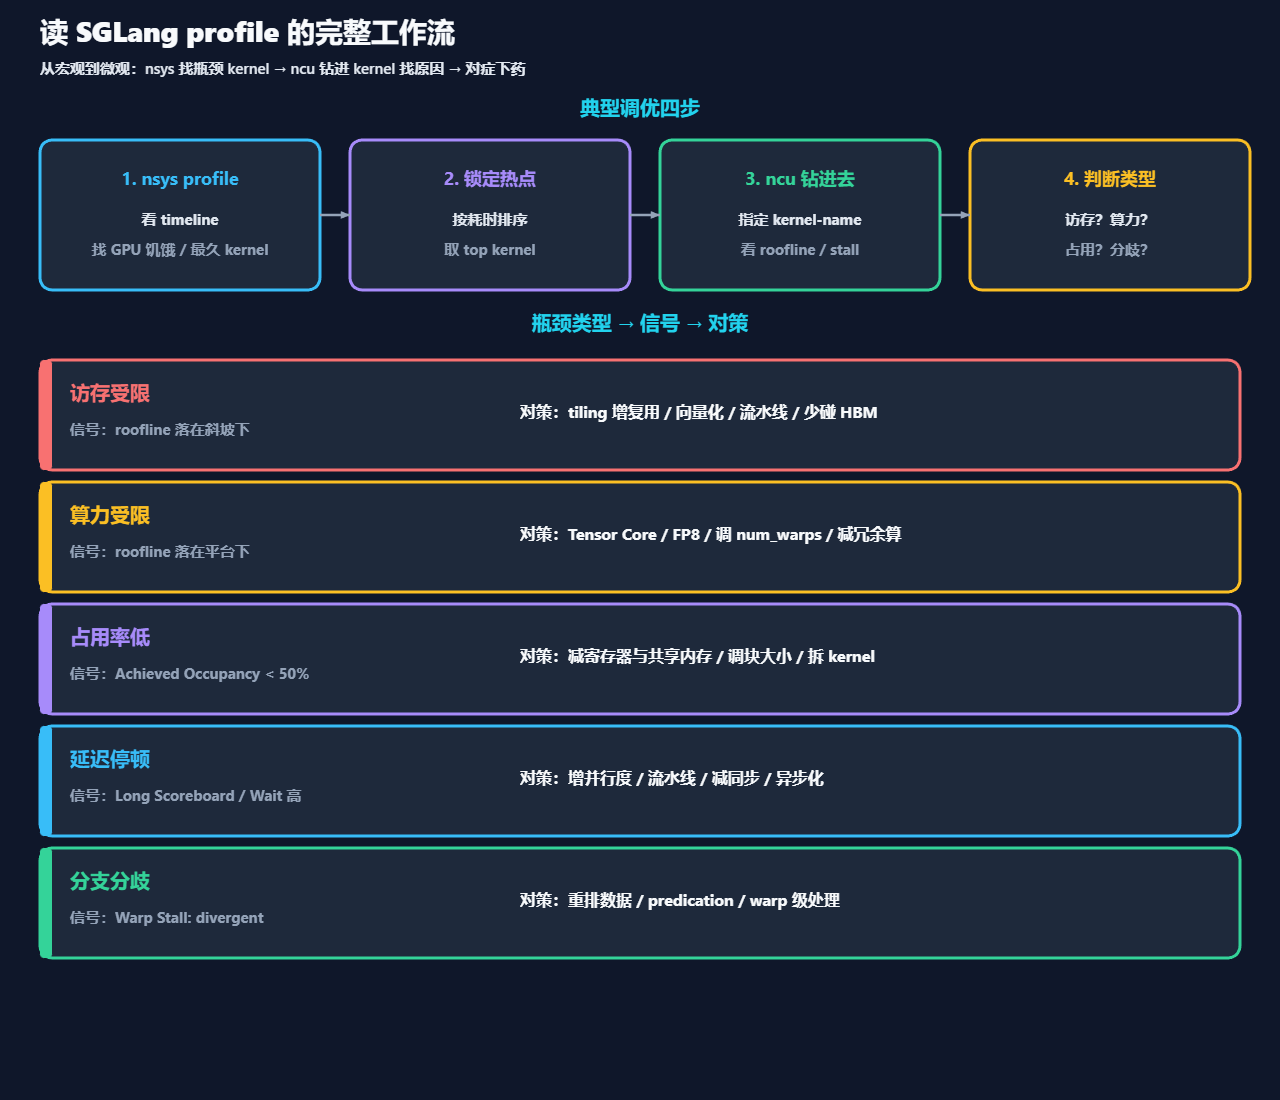
把前面四个工具串起来,就是一个完整的调优工作流:从宏观到微观,从瓶颈定位到对策。
典型调优工作流:
- nsys profile:看 timeline,找 GPU 饥饿 / 哪个 kernel 最久。
- 锁定热点 kernel:从 nsys 报告里按耗时排序,取 top kernel。
- ncu --kernel-name:只 profile 那个 kernel,看 roofline / stall。
- 判断瓶颈类型:访存受限?算力受限?占用率低?分支分歧?
瓶颈类型 → 对策:
| 瓶颈 | 信号 | 对策 |
|-|-|-|
| 访存受限(memory bound) | 点在 roofline 斜线下 | tiling 增复用 / 向量化 / 流水线 / 减 HBM 访问 |
| 算力受限(compute bound) | 点在 roofline 平台下 | 用 Tensor Core / FP8 / 调 num_warps / 减冗余算 |
| 占用率低(low occupancy) | Achieved Occupancy < 50% | 减寄存器/共享内存 / 调块大小 / 拆 kernel |
| 延迟停顿(stall) | Long Scoreboard / Wait 高 | 增并行度 / 流水线 / 减同步 / 异步化 |
| 分支分歧(divergence) | Warp Stall: divergent | 重排数据 / predication / warp 级处理 |
SGLang 实战场景:
- decode 吞吐低:先 nsys 看 decode 阶段 kernel 密度。若 GPU 空闲多 → CPU 调度开销大 → 开 CUDA Graph。
- prefill 慢:ncu 看 attention kernel,若访存受限 → 检查 tiling / 流水线深度。
- 多 GPU 通信慢:nsys 看 NCCL / EP 通信是否和计算重叠,没重叠 → 用 stream 并发。
- FP8 精度掉:ncu 看 Tensor Core 利用率,确认走 FP8 路径;检查缩放因子。
术语速查(本文)
| 术语 | 一句话 |
|---|---|
| nsys | 系统级时间线:CPU/GPU 对齐、空隙、饥饿 |
| ncu | kernel 级:算力/带宽/stall/occupancy |
| Roofline | 算术强度 vs 性能,区分访存/算力瓶颈 |
| Stream | 执行队列;同队列串行,异队列可并行 |
| Event | 跨队列同步信号 |
| CUDA Graph | 录制一串 kernel,一次重放 |
| CUTLASS | GEMM/卷积模板库,分层拼 kernel |
| Epilogue | 矩阵乘之后的收尾(激活/量化/写回) |
| PTX | NVIDIA 虚拟汇编,靠近硬件的指令层 |
常见误区
- 误区一:一上来就 ncu 钻 kernel。错。先 nsys 看宏观,确认是哪个 kernel、是不是 GPU 饥饿,再 ncu 钻进去。
- 误区二:CUDA Graph 万能。不是。大 kernel / 一次性计算不需要 Graph;动态 shape 频繁变化时重录开销大。
- 误区三:多 stream 一定更快。不一定。SM 资源占满后 kernel 仍串行;并发度受硬件限制。
- 误区四:CUTLASS 直接用最快。不一定。默认配置未必最优,要用 Profiler 搜配置;Triton 的 autotune 有时更省事。
- 误区五:ncu 指标看一个就够。不够。要 roofline + stall + occupancy 一起看,才能定位真正瓶颈。
实践清单
调优或读 profile 时对照检查:
FAQ
Q:nsys 和 ncu 该先跑哪个?
A:永远先 nsys。它快(不插桩),看宏观定位热点 kernel;再 ncu 钻微观。反过来会迷失在细节里。
Q:CUDA Graph 能录任意 kernel 吗?
A:不能。捕获期间不能有 host 同步、事件等待、动态内存分配。静态、反复执行的图才适合。
Q:SGLang 里怎么开 CUDA Graph?
A:--enable-cuda-graph(默认 decode 阶段开)。按 batch 桶分图,避免每个 batch 重录。
Q:CUTLASS 和 Triton 该用哪个?
A:追求极致 + 已有 CUTLASS 基础 → CUTLASS;快速出 kernel + 跨架构 → Triton。SGLang 两者都用:重的 AOT kernel 用 CUTLASS,灵活的 fused kernel 用 Triton。
阅读导航



