
CUDA 编程优化:合并访存、Bank Conflict 与 Tiling
CUDA 编程模型与优化套路
讲了硬件(SM、warp、Tensor Core、Hopper 三件套)。这篇讲怎么把这些硬件用起来:内存合并访问、bank conflict、occupancy、tiling、向量化加载、warp shuffle、cp.async 流水线。每个套路都对应一个硬件特性,理解了"为什么"才能举一反三。
本文按"约束 → 优化"组织:先讲三个编程模型层面的硬约束(合并访问、bank conflict、occupancy),再讲四个经典优化套路(tiling、向量化加载、warp shuffle、cp.async 流水线)。每个套路都说明它解决哪个硬件瓶颈。
一、内存合并访问:让一次访存喂饱 32 个线程
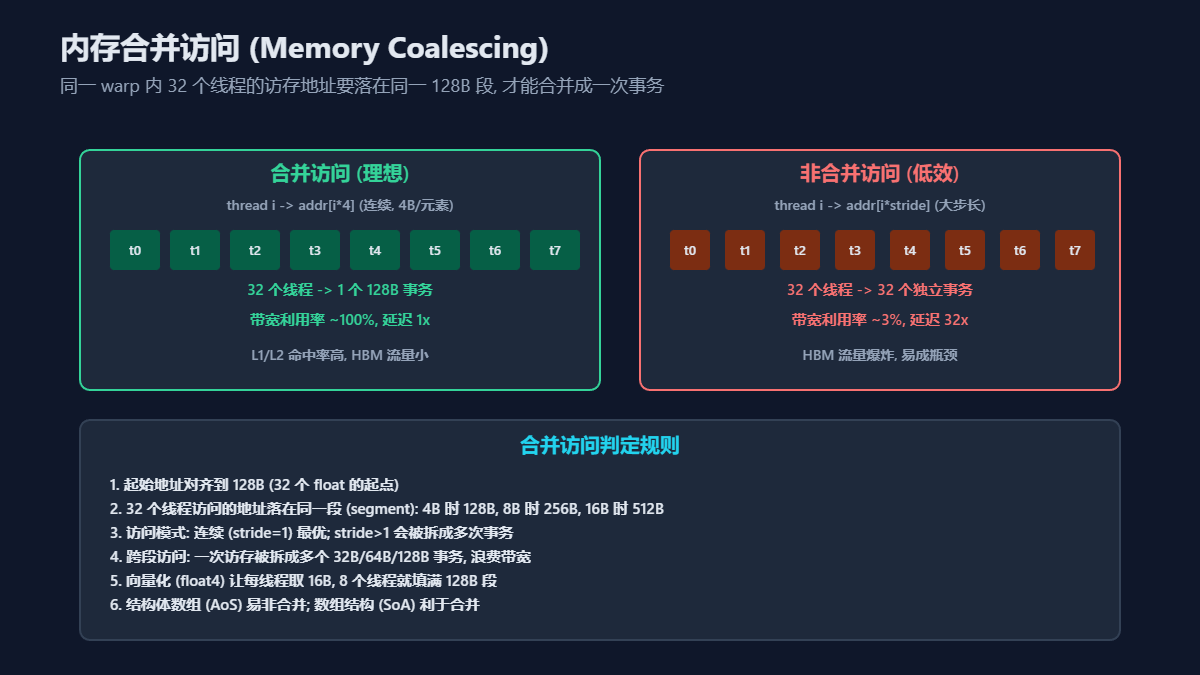
网络权威配图:下面三张来自 NVIDIA CUDA C++ Best Practices Guide,是讲解合并访问最权威的图。第一张展示理想的合并访问(coalesced access,32 线程地址落在同一 128B 段);第二张展示错位但仍顺序的地址如何跨段、拆成多次事务;第三张展示跨步(stride=2)访问如何让带宽利用率减半。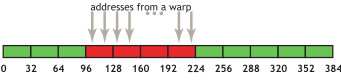
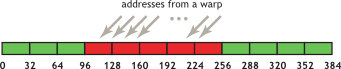
合并访问是 GPU 访存效率的第一道关。理解它,才能理解为什么数组结构(SoA)比结构数组(AoS)快。
1.1 「同一 128B 段」到底是什么(必读)
图上那句「落在同一 128B 段」最容易懵。先把三个词拆开: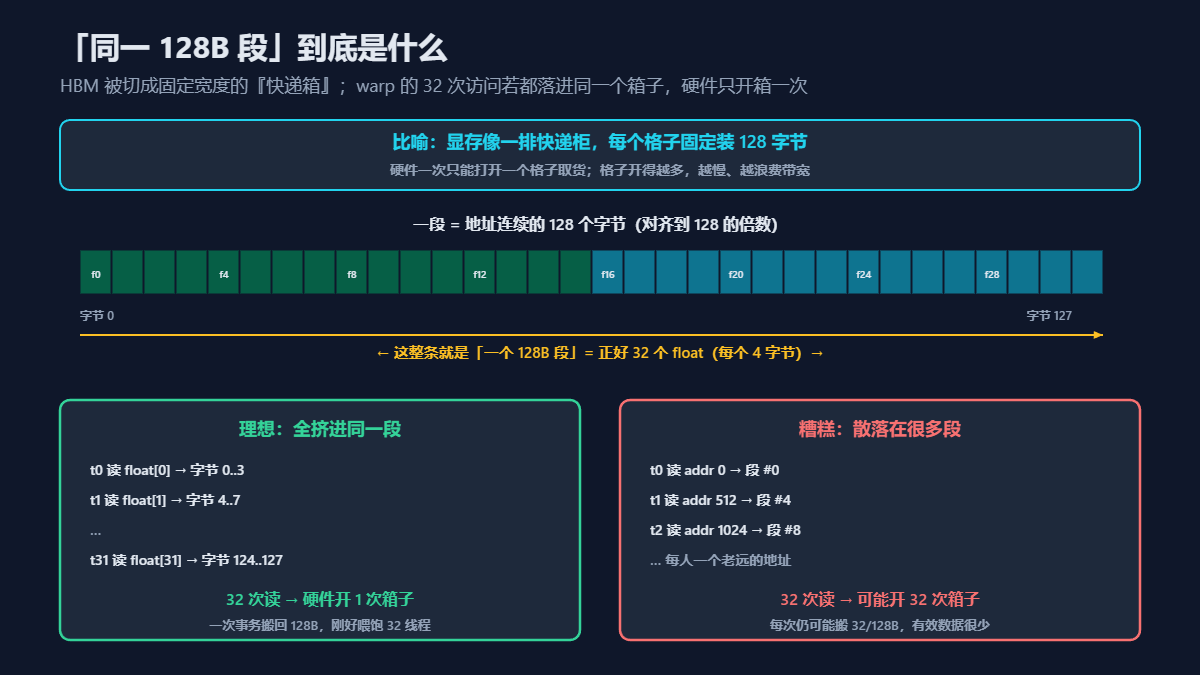
| 词 | 人话 |
|---|---|
| 段(segment) | 硬件把显存地址空间切成固定宽度的「快递柜格子」。常见宽度是 32 / 64 / 128 字节。合并访问讨论里,最常盯的是 128 字节这一档。 |
| 128B | 128 字节。若每个元素是 float(4 字节),正好 32 个 float;一个 warp 正好 32 个线程 → 一人一个 float,刚好装满一格。 |
| 同一段 | 这 32 个线程这次要读的地址,都落在同一个 128 字节对齐窗口里。例如都在字节 [0, 127],而不是有人在 [0,127]、有人在 [512,639]。 |
| 事务(transaction) | 硬件「开一次箱子、搬一次货」的动作。开箱有成本;你只要 4 字节,它也可能按整段搬。所以大家挤进同一段 → 开箱次数最少。 |
| 地址怎么对齐成「一段」? |
把显存想成从 0 开始的连续字节:
段 #0: 字节   0 ..  127
段 #1: 字节 128 ..  255
段 #2: 字节 256 ..  383
…
段号 ≈ floor(地址 / 128)
「落在同一 128B 段」= 这 32 个线程访问的地址,算出来的 段号都相同(或在规则允许下能被合并成尽量少的几次事务)。
为什么恰好是 128 和 32?
- warp = 32 线程,锁步一起发访存
- 常用元素
float/int= 4 字节 - 字节 → 一整段刚好喂饱整个 warp
这就是「一次访存喂饱 32 个线程」的字面含义。
1.2 开箱取货:事务浪费在哪
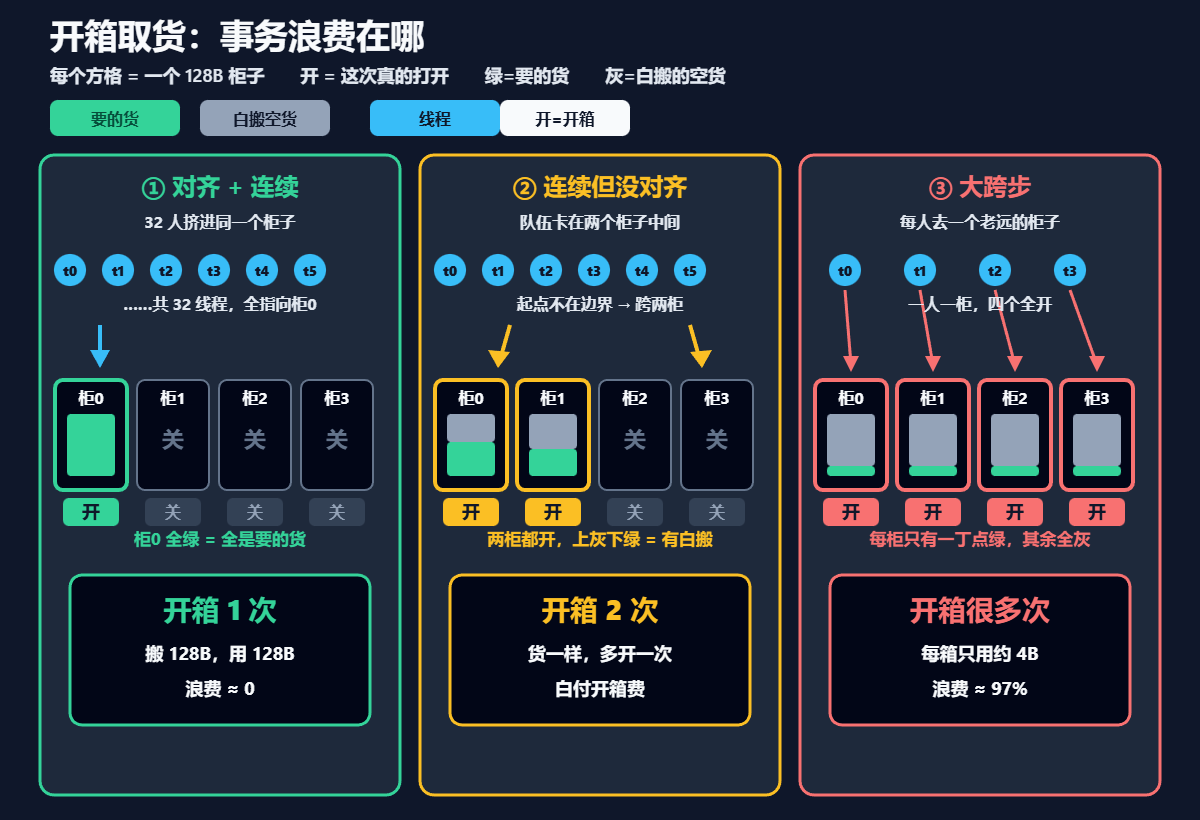
把每个 128B 段画成一个快递柜:
| 图上看到什么 | 含义 |
|---|---|
| 灰框写「关着」 | 这次访问没动这个柜子 |
| 亮边 +「开!」 | 硬件真的开了这个柜子(= 发了一次事务) |
| 柜子里的绿块「要的」 | 你真正用到的那几字节 |
| 柜子里的灰块「白搬」 | 开箱时顺带搬回来、但你根本不用的字节 |
| 三种情况一眼对比: | |
| ① 对齐+连续 | |
| - | - |
| 人怎么站 | 32 人挤进同一个柜子 |
| 开几个柜 | 1 |
| 柜子里长什么样 | 全是绿 |
| 结果 | 浪费 ≈ 0 |
| 所以「合并」不是玄学,就是:让大家尽量挤进同一个柜子,少开箱;开了的柜子里尽量装满「要的」货。 |
1.3 术语拆解:SoA / AoS / stride
| 词 | 人话 | 例子 |
|---|---|---|
| stride(步长) | 相邻线程访问地址的间隔(按元素个数) | stride=1 连续;stride=2 隔一个取一个 |
| SoA | Structure of Arrays:同字段连在一起 | xs[i], ys[i] 分两个数组 → 易合并 |
| AoS | Array of Structures:一条记录一个结构体 | Point{x,y}[i] → 易跨段、难合并 |
| 白话定义:同一 warp 里 32 个线程的访存地址要「挤」在同一段 128 字节里,硬件才能合并成一次(或很少几次)事务;否则拆成多次,带宽浪费。 |
精确定义(简化规则):
- 起点尽量对齐到 128B(32 个 float 的起点)。
- 32 个线程的地址尽量落在同一段:元素 4B 时盯 128B;8B 时窗口往往更大;16B(float4)时 8 个线程就能填满 128B。
- 连续访问(stride=1)最优;stride>1 容易跨很多段。
- 向量化(float4)让每线程一次取 16B,更容易「填满箱子」。
- SoA 利于合并;AoS 容易把同一字段拆散到不同段。
实践含义:
- kernel 里优先
A[threadIdx.x]这种连续排布,少写A[threadIdx.x * stride]。 - 框架里 tensor 默认 contiguous / SoA,就是为了合并访问。
- 必须按列读(跨步)时:先整行搬进共享内存,再在共享内存里按列读,避免直接打 HBM。
二、共享内存 Bank Conflict:32 个 bank 的并行陷阱
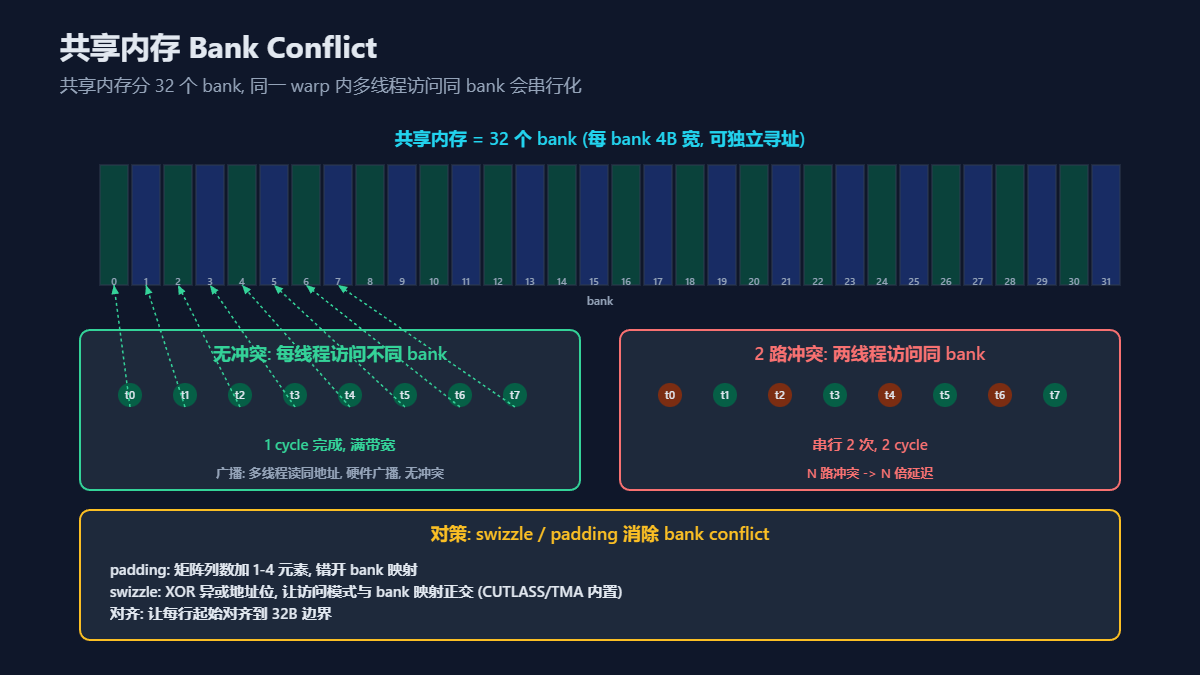
共享内存虽然快,但有 32 个 bank 的并行限制。bank conflict 是共享内存性能的隐形杀手。
白话定义:共享内存分成 32 个 bank(像 32 个独立的小存储),同一 warp 内多个线程访问同一个 bank 就要排队,访问不同 bank 才能并行。
术语拆解
| 词 | 人话 |
|---|---|
| bank | 共享内存的 32 个「并行窗口」;地址 addr/4 mod 32 决定进哪个窗口 |
| bank conflict | 多个线程同时敲同一个窗口(且不是同一地址)→ 串行排队 |
| broadcast | 多线程读同一地址 → 硬件广播一次,不算冲突 |
| padding | 行末多塞几个元素,错开 bank 映射 |
| swizzle | 用异或等改写地址,让访问模式和 bank 映射错开(TMA/CUTLASS 常内置) |
精确定义:共享内存按 4 字节宽分 32 个 bank,地址 addr 落在 bank addr/4 mod 32。一个 warp 的 32 个线程同时访存: |
- 32 个线程访问 32 个不同 bank → 1 cycle 完成,满带宽。
- N 个线程访问同一个 bank(且不是同一地址)→ N 路冲突,串行 N 次,延迟 N 倍。
- 多线程访问同一地址 → 硬件广播,无冲突。
典型场景:矩阵按行存,每行 32 个 float,第 i 列对应 bank i。如果一列 32 个线程同时读一列(每人读不同行的同一列),全部撞 bank 0 → 32 路冲突。
2.1 三种防冲突手段:为什么有效
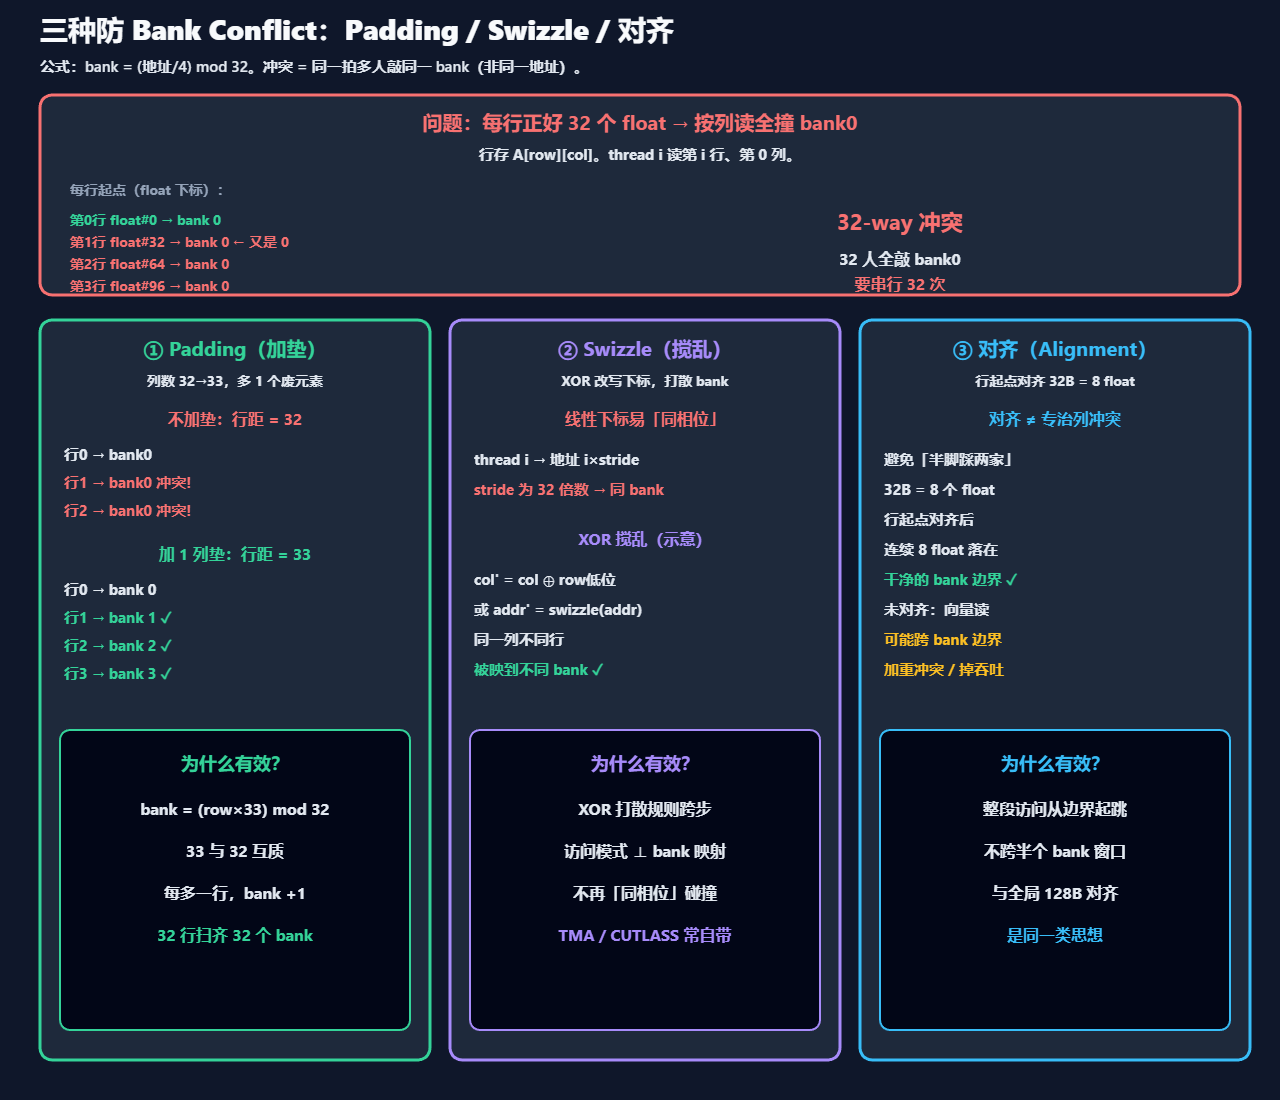
核心公式先钉死:
bank = (字节地址 / 4) mod 32
     = (float 下标) mod 32
同一拍里,多人敲同一个 bank且不是同一地址 → 排队串行。防冲突 = 让这 32 个线程落到 32 个不同的 bank。
(1)Padding:多塞 1 列,行距从 32 变成 33
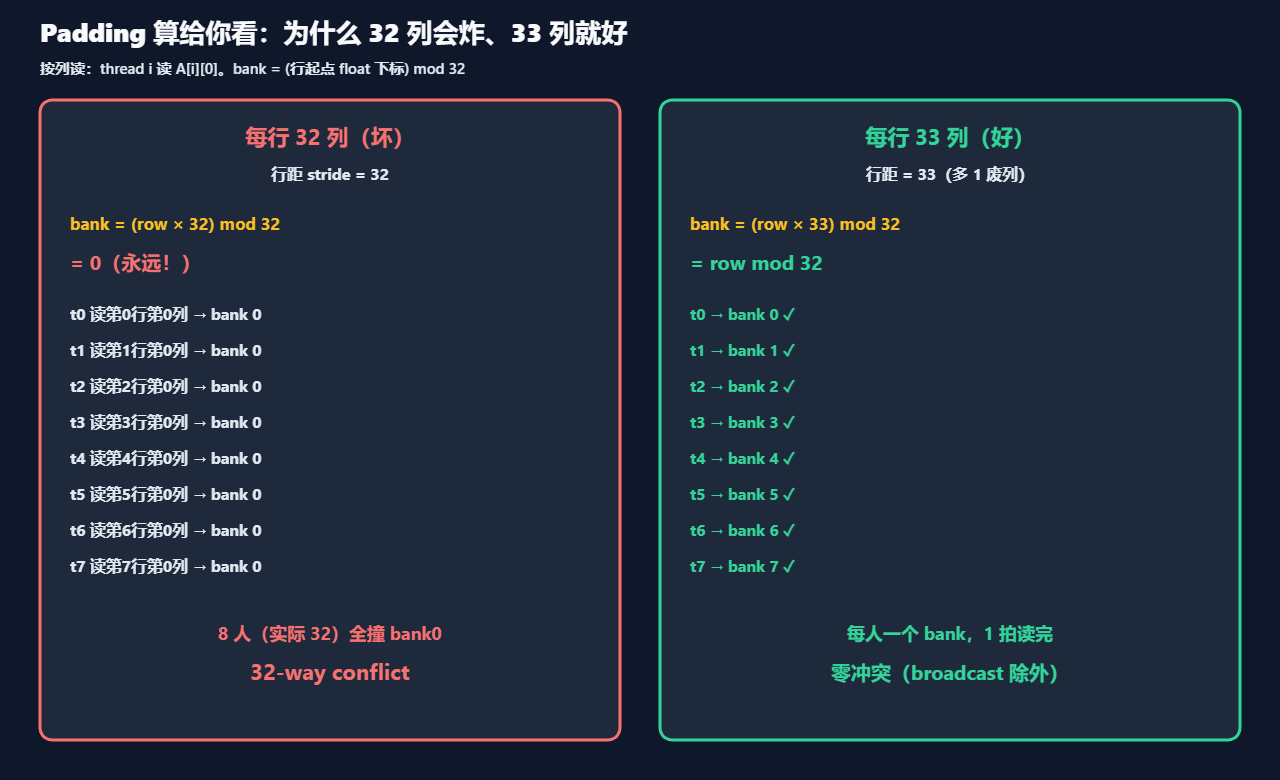
场景:共享内存里一块 A[rows][COLS],按列读(thread i 读 A[i][0])。
| 每行 32 列(坏) | 每行 33 列(好,多 1 个废元素) | |
|---|---|---|
| 行距(stride) | 32 | 33 |
第 row 行第 0 列的 bank | (row×32) mod 32 = **0** | (row×33) mod 32 = **row** |
| thread0 / 1 / 2 … | 全是 bank0 | bank0 / 1 / 2 … |
| 结果 | 32-way conflict | 每人一个 bank,1 拍读完 |
| 为什么 33 管用? |
因为 33 和 32 互质(gcd(33,32)=1)。每往下一行,bank 编号就 +1(再 mod 32),绝不会在「按列读」时整列塌缩到同一个 bank。多出来的那一列是废数据,只为错开映射,不参与计算。
实践:__shared__ float tile[BM][BK + 1]; 这种 +1 就是经典 padding。
(2)Swizzle:用 XOR 把「规则跨步」打散
问题本质:冲突往往来自「访问步长」和「bank 周期 32」同相位——比如步长是 32 的倍数,每人落地差整数个完整周期,bank 号不变。
Swizzle 做什么:不改你逻辑上的 (row, col),但在真正算共享内存地址时,用异或搅一下,例如:
col' = col XOR f(row)     // f 取 row 的若干低位
或更一般:addr' = swizzle(addr)
效果:
- 原来「同一列、不同行」会撞同一 bank;
- 搅乱后,这些地址被映射到不同 bank;
- 访问模式和 bank 映射变得「正交」(不共振)。
为什么 XOR 有效(直觉):
线性地址 row×stride + col 在 stride 整除 32 时,bank 只依赖 col。XOR 引入与 row 相关的扰动,打破「只跟 col 走」的简单同余,把规则条纹打成近似均匀分布。
谁在用:CUTLASS 的 shared memory layout、Hopper TMA 描述符里的 swizzle 模式,都是硬件/库帮你做这件事,手写 kernel 时少踩坑。
代价:地址计算稍复杂;读/写必须用同一套 swizzle,否则读写对不上。
(3)对齐:行起点对齐到 32B(8 个 float)
对齐主要不是用来单独消灭「32 列按列读」那种经典冲突(那主要靠 padding/swizzle),而是保证:
- 向量化加载(如一次读 8/16 字节)从 bank 边界起跳,不会「半脚踩两个 bank 窗口」;
- 和全局内存合并访问里的「128B 段对齐」是同一类思想:边界干净 → 硬件一次服务更整齐;
- 配合 padding 时,整行布局可预期,避免未对齐导致的额外跨 bank 访问。
32B = 8×float:一行从 bank 边界开始,连续 8 个 float 依次落在连续 8 个 bank 上,干净利落。若起点歪了,同一次宽加载可能跨更多 bank 边界,吞吐变差,严重时放大冲突。
2.2 怎么选
| 手段 | 最管用的场景 | 代价 |
|---|---|---|
| Padding | 手写 shared tile、按列/转置读 | 多占一点共享内存 |
| Swizzle | 复杂 2D 访问、要极致带宽 | 地址公式复杂;库/TMA 可代劳 |
| 对齐 | 向量加载、与 padding 搭配 | 可能多一点点对齐空隙 |
实践含义:写共享内存 kernel 前先想清访问模式会不会让 下标 mod 32 塌缩。Hopper 上尽量走 TMA(自带 swizzle);手写 Ampere 风格时,BK+1 padding 往往是性价比最高的一招。 |
三、Occupancy:驻留 warp 数决定隐藏延迟的能力
网络权威配图:下面这张来自 NVIDIA CUDA C++ Best Practices Guide,展示了 CUDA Occupancy Calculator 的用法——输入每线程寄存器数、每块共享内存、块大小,就能算出 SM 上能驻留的 warp 数与占用率。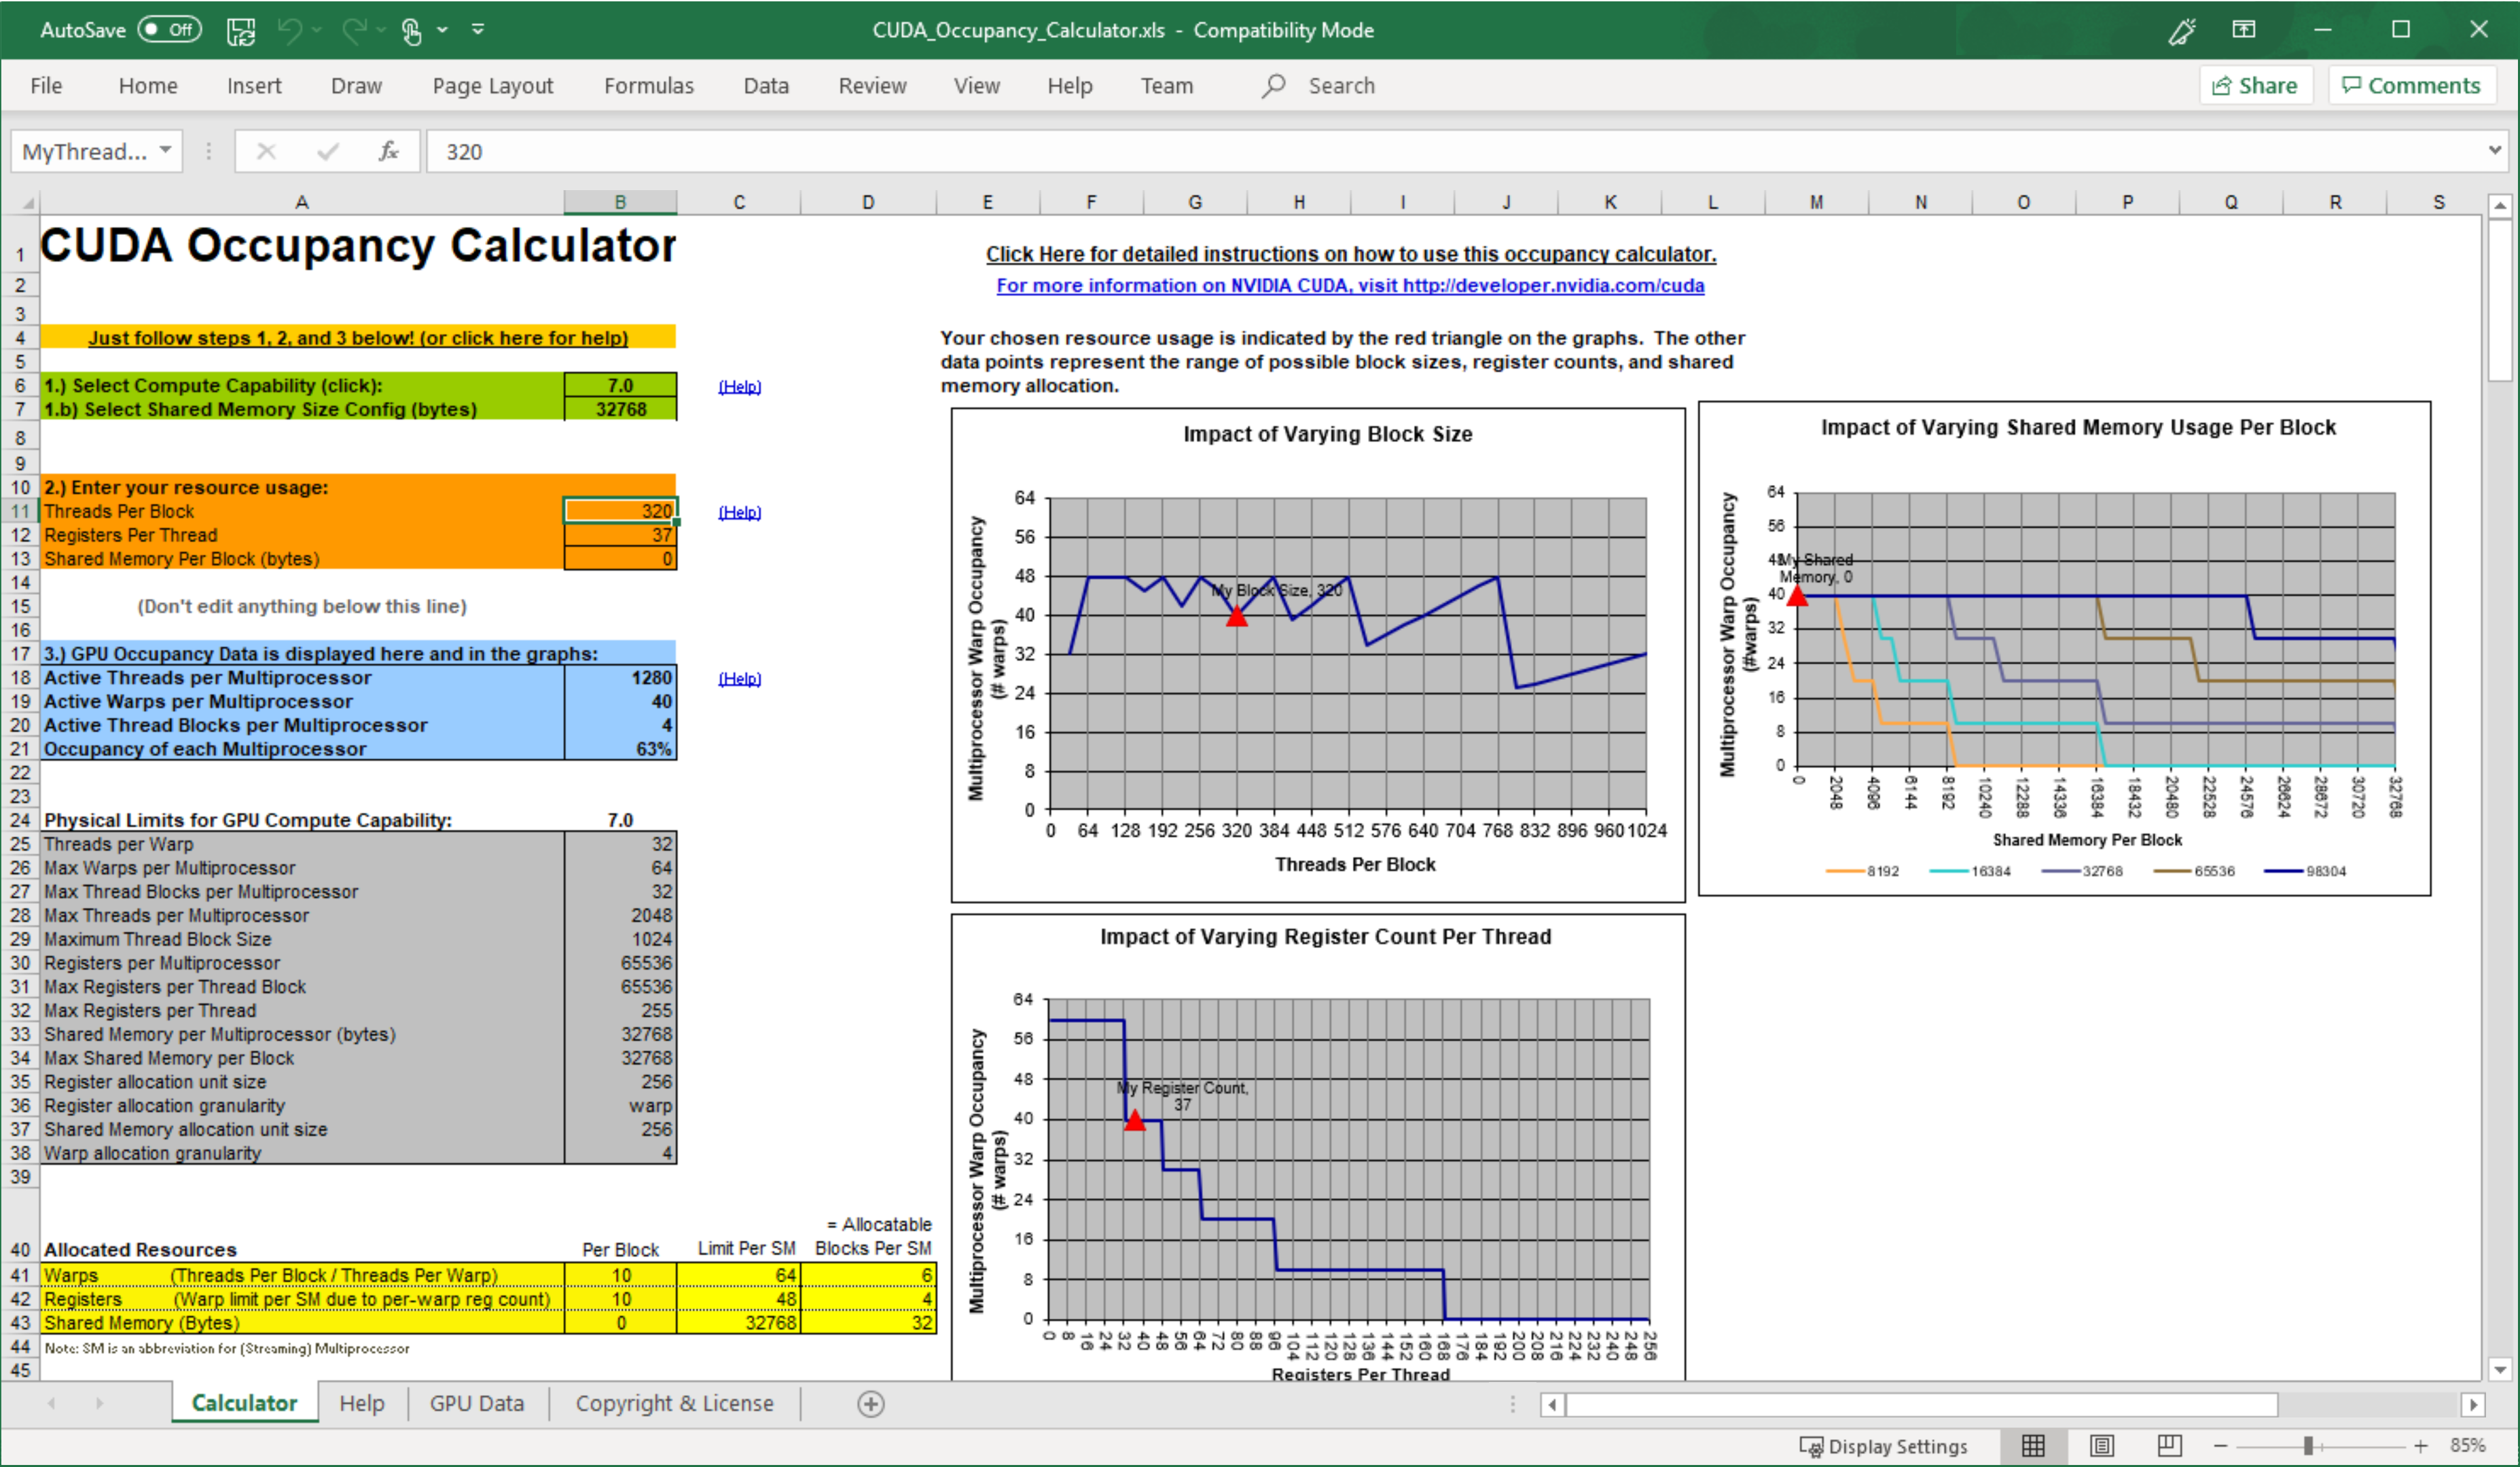
3.1 公式到底在说什么
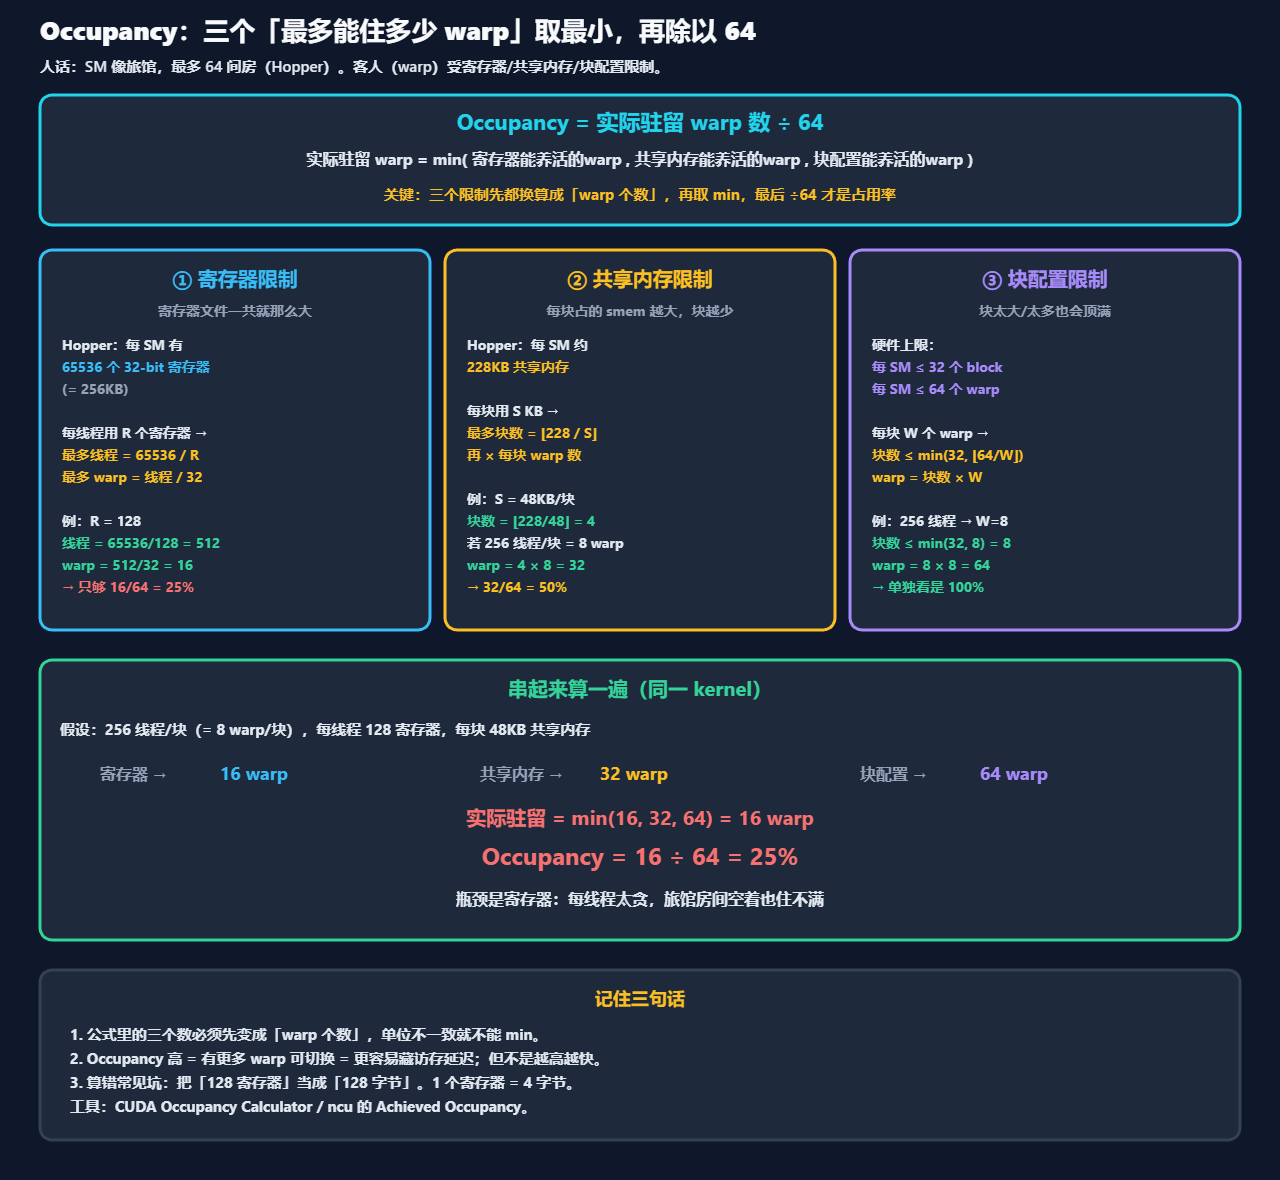
白话:SM 像旅馆,Hopper 每间 SM 最多 64 间房(64 个 warp)。Occupancy = 实际住进去的 warp ÷ 64。住不满通常不是「不想住」,而是 寄存器 / 共享内存 / 块配置 三道关卡里最紧的那道卡住了。
正确公式(三个限制必须先都换成「warp 个数」,单位一致才能 min):
实际驻留 warp = min(
    寄存器能养活的 warp,
    共享内存能养活的 warp,
    块配置能养活的 warp
)
Occupancy = 实际驻留 warp / 64
旧写法 min(寄存器限制, 共享内存限制, 块大小限制) / 64 容易误会——若有的是「线程数」、有的是「块数」,直接 min 没意义。
3.2 三道关怎么换算成 warp(Hopper)
| 关卡 | 硬件库存 | 换算 |
|---|---|---|
| 寄存器 | 每 SM 65536 个 32-bit 寄存器(= 256KB) | 最多线程 = 65536 / 每线程寄存器数,再 ÷32 得 warp |
| 共享内存 | 每 SM 约 228KB | 最多块 = ⌊228 / 每块KB⌋,再 × 每块 warp 数 |
| 块配置 | ≤32 block/SM,且 ≤64 warp/SM | 块数 ≤ min(32, ⌊64 / 每块warp⌋),再 × 每块 warp |
常见算错:把「128 个寄存器」当成「128 字节」。1 个寄存器 = 4 字节,所以要用 个数 65536 / R,不要用 256KB / 128B。 |
3.3 串起来算一遍
假设同一 kernel:256 线程/块(= 8 warp/块),每线程 128 寄存器,每块 48KB 共享内存。
- 寄存器:
65536 / 128 = 512线程 →512 / 32 = 16warp - 共享内存:
⌊228 / 48⌋ = 4块 →4 × 8 = 32warp - 块配置:块数 ≤
min(32, ⌊64/8⌋) = 8→8 × 8 = 64warp
→min(16, 32, 64) = 16→ Occupancy = 16/64 = 25%
→ 瓶颈是寄存器:每线程太贪,房间空着也住不满。
3.4 高 occupancy ≠ 高性能
- 访存密集:更在乎高 occupancy,多 warp 才能藏 HBM 延迟。
- 计算密集:低 occupancy + 多寄存器往往更快(每线程算得更多、复用更好)。
- 工具:
ncu看Achieved Occupancy,配合 stall reasons;也可用 Occupancy Calculator 做设计期估算。
实践含义:别盲追 100%。先看 achieved occupancy 和 stall;__launch_bounds__可压寄存器换 occupancy。经验:访存密集目标 50%+,计算密集 25–50% 也可接受。
四、优化套路一:Tiling(分块),减少 HBM 访问
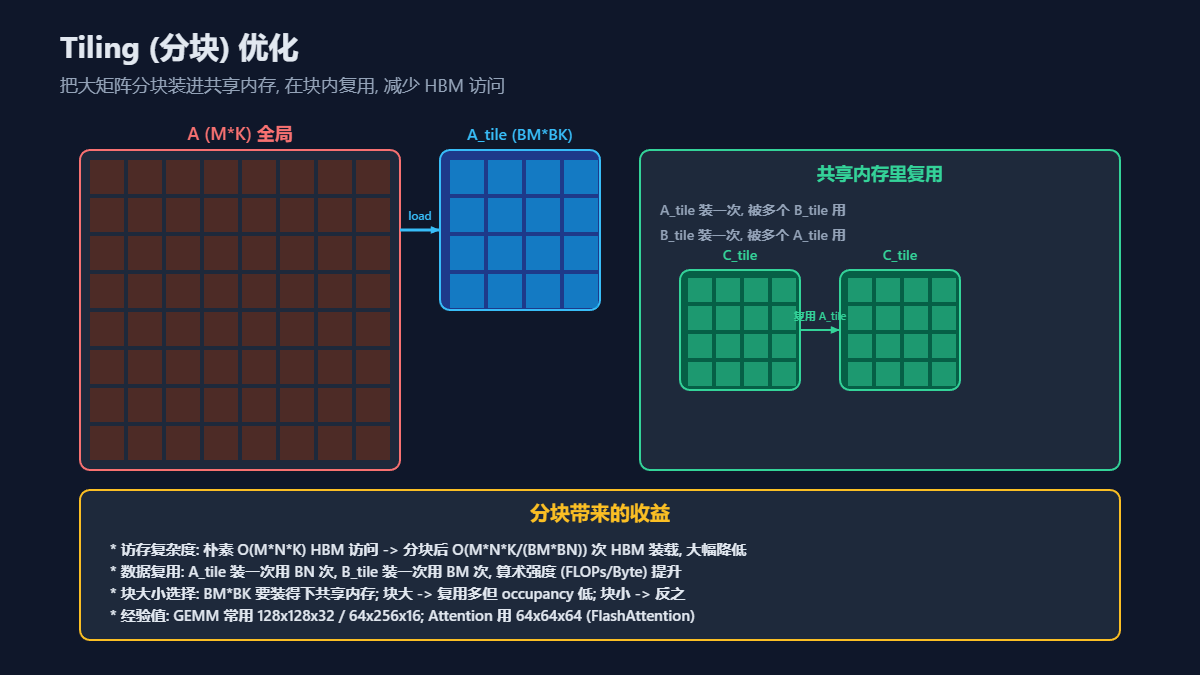
网络权威配图:下面两张来自 NVIDIA CUDA C++ Best Practices Guide,是讲解矩阵分块乘法最经典的图。第一张展示把 A 切成块列、B 切成块行,每个输出块由一个块列乘一个块行得到;第二张展示用 A 的一行 tile 乘 B 的若干行 tile 来算 C 的一行 tile——这正是"装一次用多次"的 tiling 思想在矩阵乘里的体现。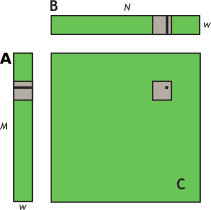
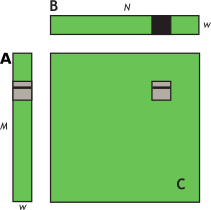
tiling 是一切 GEMM / attention / conv 优化的起点。它的核心是「装一次用多次」。
术语拆解
| 词 | 人话 |
|---|---|
| tile / 分块 | 大矩阵切出的一小块,能塞进共享内存 |
| BM / BN / BK | tile 在 M/N/K 三个方向的边长(见文档 01 的 M/K/N) |
| 算术强度 | 每从显存读 1 字节,能做多少次浮点运算(FLOP/Byte);tiling 就是把它抬高 |
| 白话定义:把大矩阵切成小块装进共享内存,在块内反复复用,减少去 HBM 取数据的次数。 |
精确定义:朴素矩阵乘 C = A×B,每个 A 元素被读 N 次、每个 B 元素被读 M 次,HBM 访问量 O(M×N×K)。分块后:
- 把 A 切成
BM×BK的 tile,B 切成BK×BN的 tile。 - 一个 A_tile 装一次,被 BN 个 B_tile 用(复用 BN 次)。
- 一个 B_tile 装一次,被 BM 个 A_tile 用(复用 BM 次)。
- HBM 装载次数降到 O(M×N×K / (BM×BN))。
收益: - 访存复杂度大幅降低。
- 数据复用提升算术强度(FLOPs/Byte),从访存受限推向算力受限。
- 块大小选择:BM×BK 要装得下共享内存;块大 → 复用多但 occupancy 低;块小 → 反之。
经验值: - GEMM 常用 128×128×32 / 64×256×16。
- Attention 用 64×64×64(FlashAttention)。
- Triton 用
autotune搜最优 BLOCK_M / BLOCK_N / BLOCK_K。
实践含义:tiling 不是"可选项",是写高性能 kernel 的必经之路。所有 CUTLASS / Triton / FlashAttention 的核心都是 tiling + 流水线。
五、优化套路二:向量化加载(float4 / LDG.128)
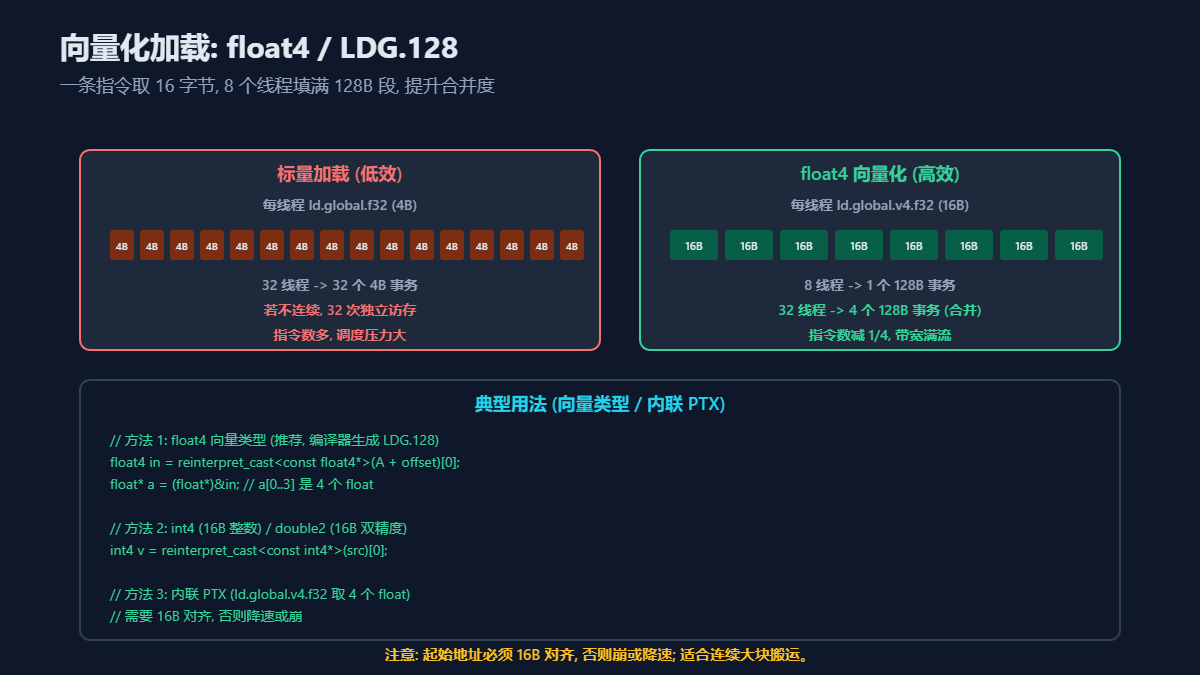
向量化加载是合并访问的「加强版」:一条指令取 16 字节,8 个线程就填满 128B 段。
术语拆解
| 词 | 人话 |
|---|---|
| float4 | 4 个 float 捆成 16 字节,一条指令装走 |
| LDG.128 | Load Global 128-bit:从全局内存一次读 16 字节的硬件指令形态 |
| 对齐 | 起始地址必须是 16 的倍数,否则向量化可能降速或出错 |
| 白话定义:让每个线程一次取 16 字节(4 个 float),而不是一次取 4 字节(1 个 float),指令数约减到 1/4,合并度更高。 |
精确定义:
- 标量加载:每线程
ld.global.f32(4B),32 线程 → 32 个 4B 事务,若不连续则 32 次独立访存。 - float4 向量化:每线程
ld.global.v4.f32(16B),8 线程 → 1 个 128B 事务,32 线程 → 4 个 128B 事务(合并)。 - 指令数减 1/4,带宽满流,调度压力小。
用法:
// 方法 1: float4 向量类型 (推荐, 编译器生成 LDG.128)
float4 in = reinterpret_cast<const float4*>(A + offset)[0];
float* a = (float*)∈ // a[0..3] 是 4 个 float
// 方法 2: int4 (16B 整数) / double2 (16B 双精度)
int4 v = reinterpret_cast<const int4*>(src)[0];
// 方法 3: 内联 PTX (ld.global.v4.f32 取 4 个 float)
// 需要 16B 对齐, 否则降速或崩
注意:
- 起始地址必须 16B 对齐,否则崩或降速。
- 适合连续大块搬运,不适合跨步访问。
- Triton 里
tl.load自动选最优向量化宽度,不用手写。
六、优化套路三:Warp Shuffle,寄存器间直接交换
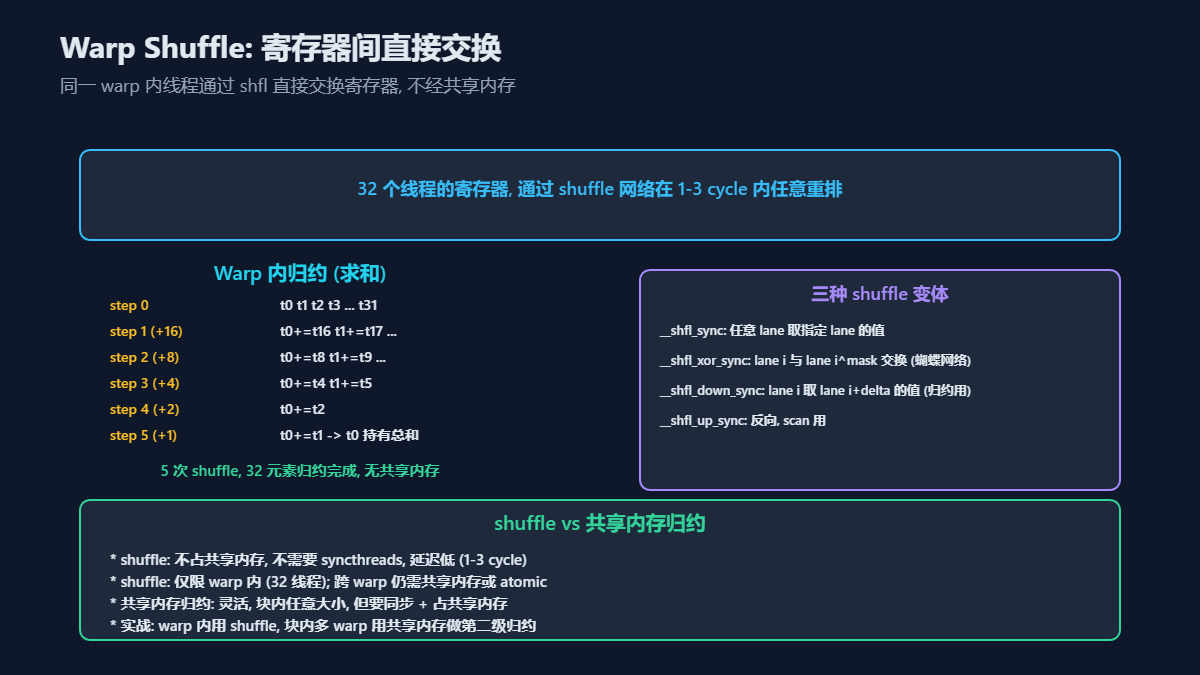
warp shuffle 让 warp 内 32 个线程的寄存器直接互联,做归约 / scan 不经共享内存。
术语拆解
| 词 | 人话 |
|---|---|
| lane | warp 里的第几个线程(0~31) |
| shuffle | 直接读别的 lane 的寄存器,不经共享内存 |
| 归约(reduce) | 把 32 个数合成 1 个(求和/求最大…) |
| scan / prefix | 前缀和一类「递推」运算 |
| 蝴蝶网络(xor shuffle) | 用 lane ^ mask 成对交换,像折叠纸扇一样归约 |
白话定义:同一 warp 内线程通过 shuffle 指令直接读其他线程的寄存器值,约 1~3 cycle,不占共享内存、不需要 __syncthreads。 |
精确定义:shuffle 网络连接同一 warp 的 32 个线程的寄存器,支持:
__shfl_sync(mask, val, src_lane):任意 lane 取指定 lane 的值。__shfl_xor_sync(mask, val, lane_mask):lane i 与 lane i^mask 交换(蝴蝶网络)。__shfl_down_sync(mask, val, delta):lane i 取 lane i+delta 的值(归约用)。__shfl_up_sync(mask, val, delta):反向,scan 用。
warp 内归约(求和)的 5 步:
step 0: t0  t1  t2  t3  ... t31
step 1 (+16): t0+=t16  t1+=t17 ...
step 2 (+8):  t0+=t8   t1+=t9  ...
step 3 (+4):  t0+=t4   t1+=t5
step 4 (+2):  t0+=t2
step 5 (+1):  t0+=t1 -> t0 持有总和
5 次 shuffle,32 元素归约完成,无共享内存。
shuffle vs 共享内存归约:
- shuffle:不占共享内存,不需要
__syncthreads,延迟低(1-3 cycle)。 - shuffle:仅限 warp 内(32 线程);跨 warp 仍需共享内存或 atomic。
- 共享内存归约:灵活,块内任意大小,但要同步 + 占共享内存。
- 实战:warp 内用 shuffle,块内多 warp 用共享内存做第二级归约。
实践含义:所有 block 级归约(求和、求最大、求最小)都应该用"warp shuffle + 跨 warp 共享内存"两段式,比纯共享内存归约快很多。
七、优化套路四:cp.async 双缓冲流水线
网络权威配图:下面这张来自 NVIDIA CUDA C++ Best Practices Guide,对比了同步拷贝(synccopy,拷贝时 SM 阻塞等待)与异步拷贝(cp.async,拷贝与计算重叠)的时间线。这正是本文"双缓冲流水线"思想的官方出处——异步拷贝让访存延迟被计算时间盖住。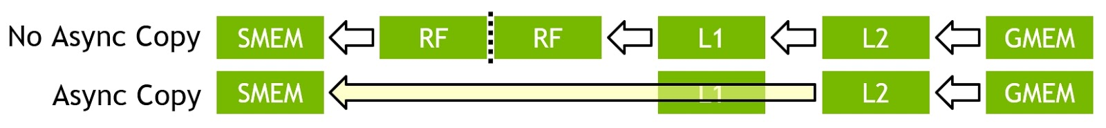
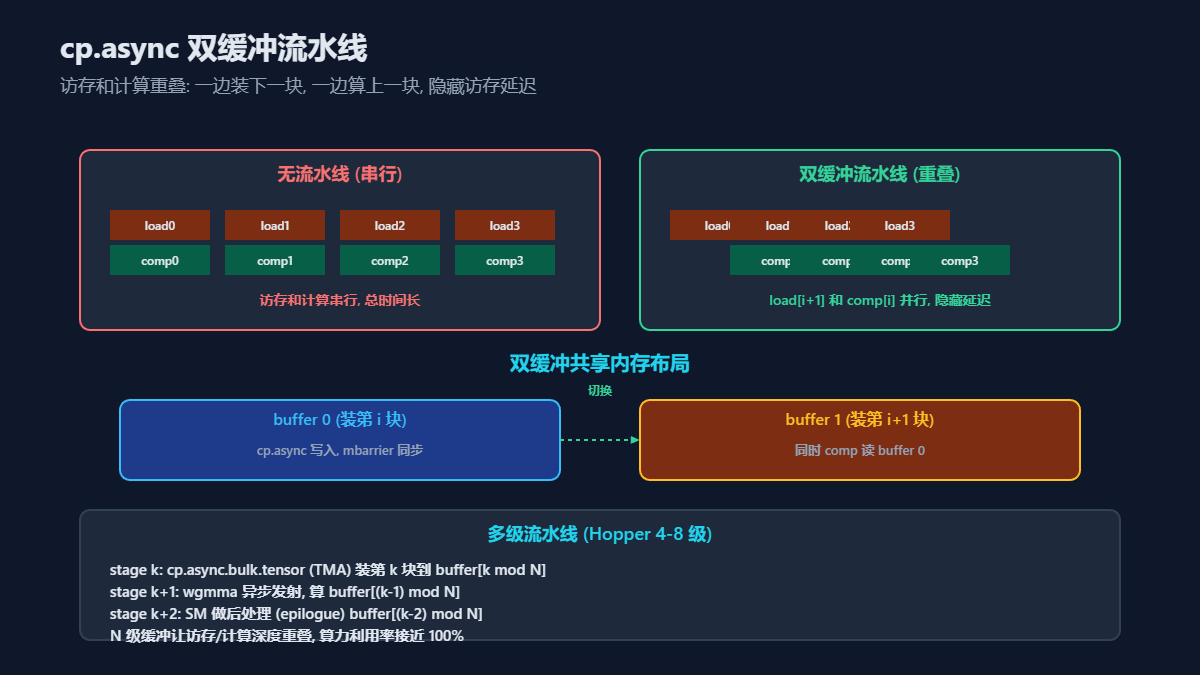
cp.async + 双缓冲是"访存和计算重叠"的经典手法,Hopper 上升级成 TMA + wgmma 的多级流水线。
白话定义:一边装下一块数据,一边算上一块数据,让访存延迟被计算时间盖住。
精确定义:
- 无流水线:load → comp → load → comp 串行,总时间长,GPU 闲置。
- 双缓冲:用两块共享内存(buffer 0、buffer 1),load[i+1] 和 comp[i] 并行执行。
- buffer 0 装 i 块时,buffer 1 同时被 comp 读(算 i-1 块)。
- 下一轮切换:buffer 1 装 i+1 块,buffer 0 被 comp 读。
- 用 mbarrier(内存屏障)做生产者-消费者同步。
Hopper 多级流水线(4-8 级):
stage k:   cp.async.bulk.tensor (TMA) 装第 k 块到 buffer[k mod N]
stage k+1: wgmma 异步发射, 算 buffer[(k-1) mod N]
stage k+2: SM 做后处理 (epilogue) buffer[(k-2) mod N]
N 级缓冲让访存 / 计算深度重叠,算力利用率接近 100%。
实践含义:
- Ampere:cp.async + 双缓冲 + mma.sync,2-3 级。
- Hopper:TMA + wgmma + 多级(4-8 级)+ mbarrier,深度重叠。
- Triton 用
num_stages参数控制流水线深度,autotune搜最优值。 - CUTLASS 3.x 的
CollectiveBuilder自动生成多级流水线。
八、套路之间的因果关系
这些优化套路不是孤立的,它们层层递进、互相配合:
| 套路 | 解决的硬件瓶颈 | 配合的硬件特性 |
|---|---|---|
| 合并访问 | HBM 带宽浪费 | warp 锁步访存 |
| 避免 bank conflict | 共享内存串行化 | 32 bank 结构 |
| 调 occupancy | 延迟无法隐藏 | warp 调度器切换 |
| tiling | HBM 访问过多 | 共享内存复用 |
| 向量化加载 | 指令数多 / 合并度低 | LDG.128 指令 |
| warp shuffle | 归约要同步 / 占共享内存 | shuffle 网络 |
| cp.async 流水线 | 访存延迟暴露 | 异步 DMA + mbarrier |
| 理解了"每个套路对应哪个硬件瓶颈",遇到新硬件 / 新场景就能自己推导该用什么套路。 |
术语速查(本文)
| 术语 | 一句话 |
|---|---|
| 合并访问 | warp 的地址挤进同一 128B 段,一次事务喂饱 32 线程 |
| 128B 段 | 显存按 128 字节切的对齐窗口; 刚好一段 |
| 事务 | 硬件开一次段、搬一次货 |
| SoA / AoS | 字段分开存 / 结构体数组;前者易合并 |
| bank conflict | 多线程同时敲共享内存同一 bank |
| padding / swizzle / 对齐 | 错开行距 / XOR 打散 / 边界对齐,防 bank 冲突 |
| occupancy | 驻留 warp / 上限;藏延迟用,不是越高越好 |
| tiling | 分块装共享内存,装一次用多次 |
| 算术强度 | FLOP / Byte,决定更像卡带宽还是卡算力 |
| float4 / LDG.128 | 一次读 16B |
| warp shuffle | warp 内寄存器直连交换 |
| lane | warp 内线程编号 0~31 |
| cp.async / 双缓冲 | 异步搬下一块,同时算上一块 |
常见误区
- 误区一:bank conflict 只在共享内存出现。对,但 L1 cache 也有类似冲突模式,只是硬件透明处理,性能影响小。
- 误区二:occupancy 100% 才算优化好。错。计算密集 kernel 低 occupancy + 多寄存器常常更快。看 achieved occupancy + stall reasons。
- 误区三:tiling 块越大越好。错。块大复用多但 occupancy 低、寄存器压力大;要 autotune 搜。
- 误区四:float4 一定比 float 快。不一定。跨步访问或不对齐时 float4 反而崩或降速。要连续 + 16B 对齐。
- 误区五:warp shuffle 能做块级归约。不能。shuffle 仅限 warp 内(32 线程)。块级要 shuffle + 共享内存两段式。
- 误区六:流水线级数越多越好。错。级数多占共享内存多,occupancy 降;要平衡。Hopper 通常 4-8 级。
实践清单
写或读 kernel 时对照检查:
FAQ
Q:tiling 和流水线是一回事吗?
A:不是。tiling 是"分块装共享内存复用",流水线是"装下一块 + 算上一块重叠"。两者配合:tiling 决定块大小,流水线决定重叠深度。
Q:warp shuffle 和 atomic 哪个快?
A:shuffle 快得多(1-3 cycle),但只做 warp 内归约 / 重排。atomic 是跨线程 / 跨块的随机更新,慢且要序列化。归约用 shuffle,随机更新才用 atomic。
Q:cp.async 和 TMA 我该用哪个?
A:Hopper 用 TMA(硬件卸载、自带 swizzle、配 mbarrier),Ampere 及更早用 cp.async。CUTLASS / Triton 已封装,写 kernel 用高层 API。
阅读导航



