
CUDA 硬件基础:GPU 存储层次与 Hopper 架构
CUDA 硬件基础与 Hopper 架构特性
这份文档面向已经会写 Python / PyTorch、想深入 GPU 底层的工程师。读完你会理解:一块 GPU 内部到底由什么组成、指令怎么跑、Hopper 相比 Ampere 多了什么武器、以及为什么这些硬件特性决定了 kernel 的写法。
一、GPU 显存层次:数据离计算越近越好
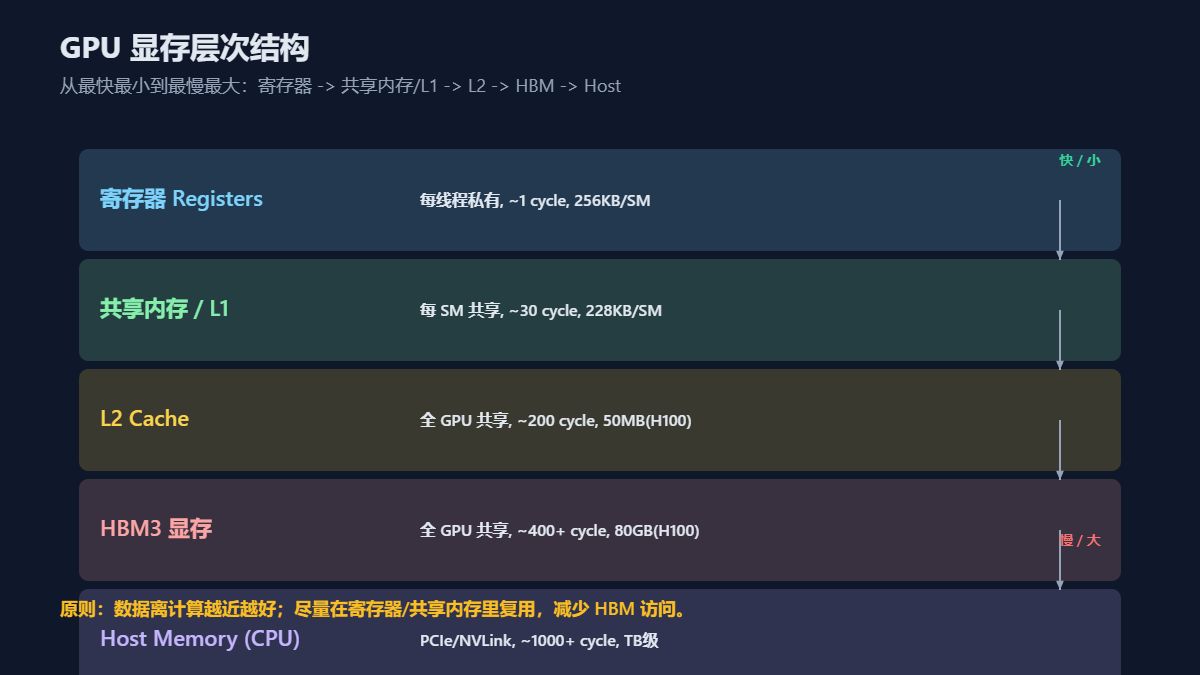
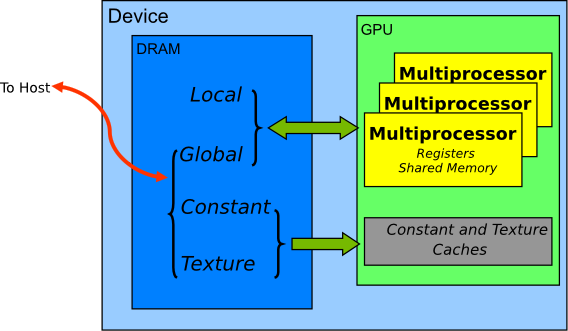
GPU 的存储是一套金字塔:越往上越快越小,越往下越慢越大。理解这个层次,是理解一切 kernel 优化的前提。
白话定义:GPU 不是只有一块"显存"。它有寄存器、共享内存、L1、L2、HBM、还有对面的 CPU 内存,速度差好几个数量级。
精确定义:以 H100 为例,从快到慢依次是:
- 寄存器(Registers):每线程私有,访问约 1 个时钟周期,每 SM 有 256 KB,由 warp 平分。
- 共享内存 / L1(Shared Memory):每 SM 内一块 SRAM,约 30 周期,H100 上每 SM 228 KB,所有线程共享。
- L2 Cache:全 GPU 共享,约 200 周期,H100 约 50 MB。
- HBM3(显存):全 GPU 共享,约 400+ 周期,H100 80 GB,带宽 ~3 TB/s。
- Host Memory(CPU 内存):经 PCIe / NVLink,1000+ 周期,TB 级容量。
实践含义:kernel 性能的天花板由"数据在不在寄存器/共享内存里"决定。一个 kernel 如果每算一个数都要去 HBM 取一次,再快的算力也白搭。所有优化套路(tiling、流水线、向量化)本质都是把数据往金字塔顶端搬,并在那里复用。
二、SM:GPU 的最小执行单元
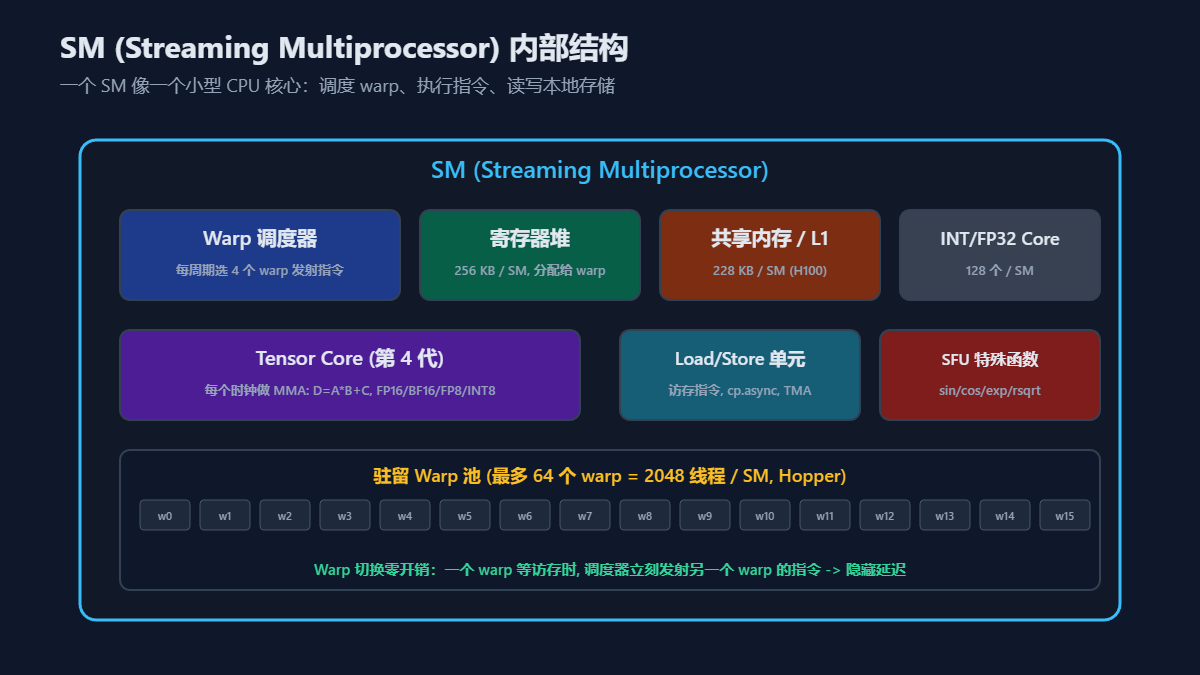
GPU 不是一块大 CPU,而是由几十上百个 SM 组成的阵列。SM 才是真正"跑指令"的地方。
白话定义:SM 像一个小型 CPU 核心,里面有自己的调度器、寄存器、共享内存、各种计算单元。
精确定义:一个 Hopper SM 包含:
| 部件 | 人话 | 干什么 |
|---|---|---|
| Warp 调度器 | 车间调度员 | 每周期挑几个「活着的」warp,发它们的下一条指令。Hopper 每周期最多发 4 条(4-issue)。 |
| 寄存器堆 | 每人自己的桌面便签 | 256 KB/SM,按 warp 分给驻留线程;访问约 1 周期,最快。 |
| 共享内存 / L1 | 车间公共白板 | 228 KB/SM(H100),同块内线程共享,约 30 周期。 |
| CUDA Core(INT/FP32) | 标量计算器 | 128 个/SM,做「一个数」的整数/FP32 运算(含 FMA)。 |
| Tensor Core | 小矩阵计算器 | 算力主体,做 MMA。详见下一节。 |
| Load/Store 单元 | 搬运工入口 | 发访存指令;Hopper 还支持 cp.async、TMA。 |
| SFU | 特殊函数机 | Special Function Unit:算 sin/cos/exp/rsqrt 等,普通 Core 不擅长这些。 |
| 驻留 Warp 池:Hopper 每 SM 最多同时挂着 64 个 warp(2048 线程)。它们都「活着」,调度器在它们之间零开销切换——A 在等显存时,立刻让 B 算,隐藏延迟。 |
实践含义:SM 的哲学是「用大量 warp 隐藏延迟」。这就是 occupancy(占用率) 重要的原因:驻留 warp 越多,越容易把算力单元喂饱。(但不是越高越好)
三、Warp 与 SIMT 执行模型
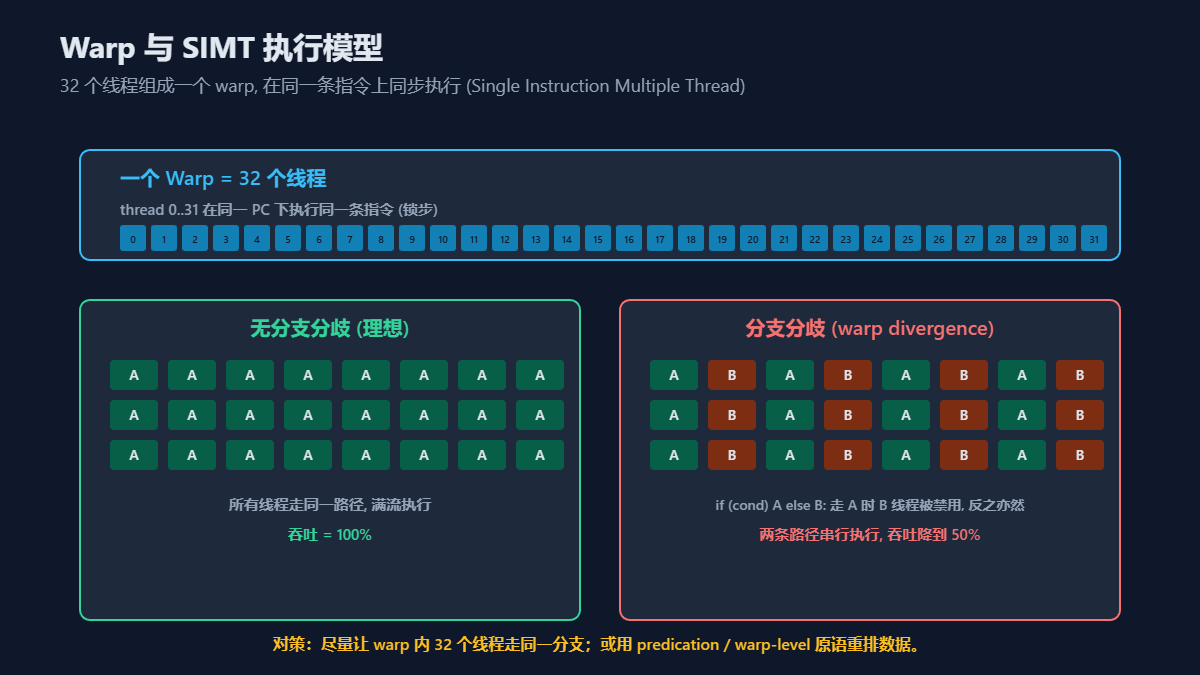
理解 warp,才能理解为什么有些代码快、有些慢,为什么分支会拖累性能。
白话定义:warp 是 32 个线程组成的「小队」,它们在同一时刻执行同一条指令,像绑在一起跑。
精确定义:GPU 采用 SIMT(Single Instruction, Multiple Thread)模型。一个 warp = 32 个线程,共享一个 PC(Program Counter,程序计数器:指向「下一条要执行哪条指令」),锁步执行同一条指令。每个线程有自己的寄存器,可以处理不同的数据,但必须走同一条指令路径。
术语拆解
| 词 | 人话 |
|---|---|
| SIMT | 一条指令,很多线程各算各的数据。和 CPU 的 SIMD「一条指令一批向量」类似,但编程时按线程写。 |
| PC(程序计数器) | 当前执行到哪条指令的指针。warp 内 32 线程共用一个 PC → 必须同步走。 |
| 锁步 | 同一步伐:这一拍全员执行同一条指令,没有人跑到前面去。 |
| 分支分歧(warp divergence) | warp 内有人走 if、有人走 else:硬件先跑 A(B 线程闲着),再跑 B(A 线程闲着),吞吐腰斩。 |
| predication(谓词执行) | 不用真正跳转:两条路径都算,用「条件寄存器」决定写不写结果。小分支常用,避免分歧。 |
| 实践含义: |
- 尽量让 warp 内 32 个线程走同一分支。例如 attention 因果 mask:整行被 mask 的 warp 直接跳过,而不是每个线程各自判断。
- 小分支优先用 predication,而不是
if/else跳转。 - 数据布局上,把「同类」数据排在一起,让同一 warp 处理相似条件的元素。
四、Tensor Core:GPU 算力的真正主体
如果你只记一个 GPU 算力来源,那就是 Tensor Core。现代大模型训练推理的 FLOPS,几乎全来自它。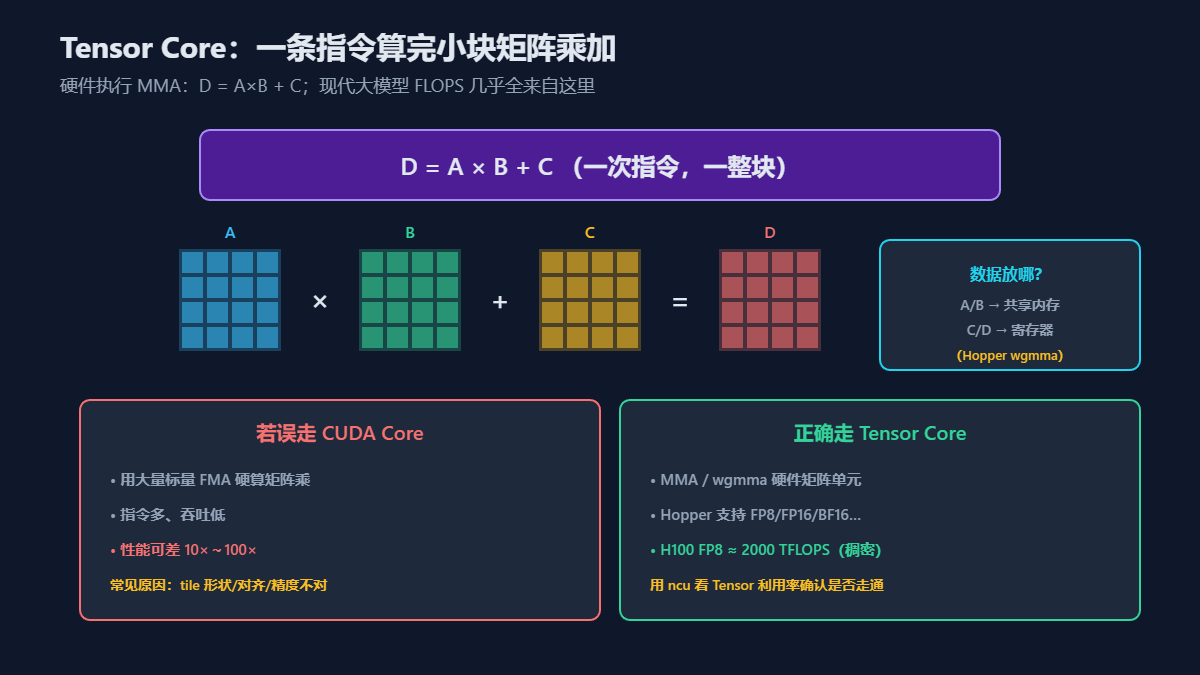
白话定义:Tensor Core 是一块专门做「小矩阵乘加」的硬件,一条指令就能算完 D = A×B + C 的小块。
精确定义:Tensor Core 执行 MMA 指令,一次完成一个小块矩阵乘加:D = A×B + C。A、B、C、D 都是寄存器或共享内存里的小矩阵。Hopper 第 4 代 Tensor Core 支持 FP64 / TF32 / BF16 / FP16 / FP8 / INT8 / INT4;FP8 下 H100 稠密算力约 2000 TFLOPS。
4.1 先把三个词吃透:FMA / MMA / FLOPS / GEMM
上面这段里蹦出来的缩写,必须先讲清楚,否则后面全是雾。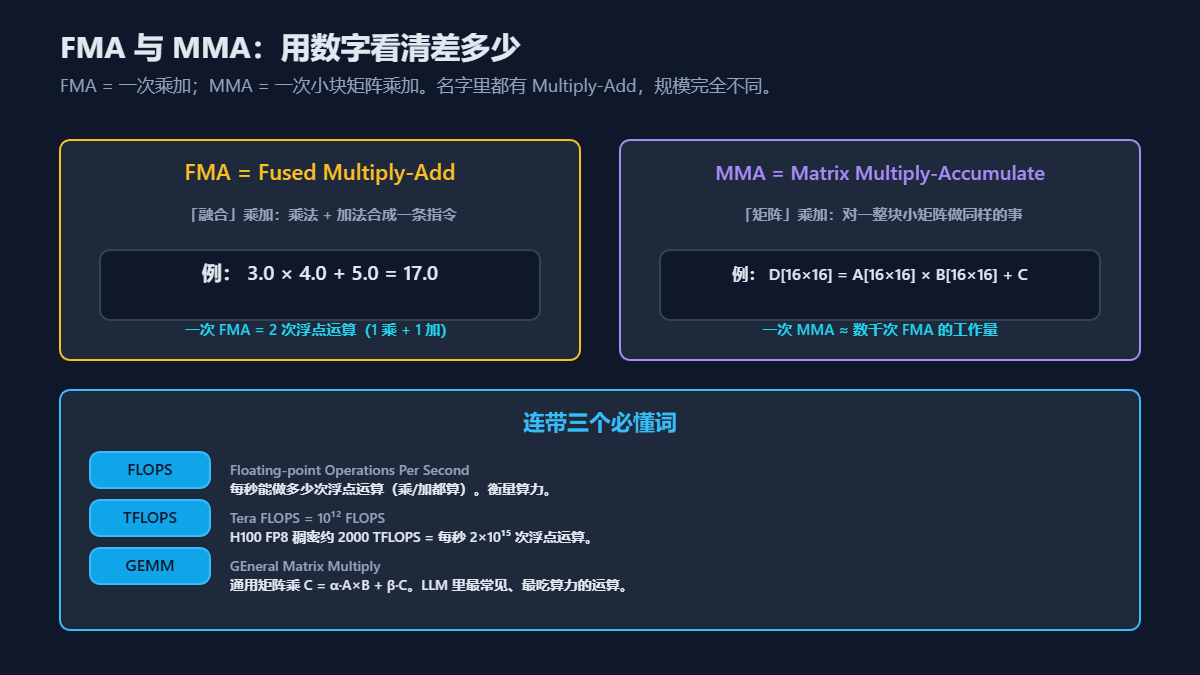
| 词 | 全称 | 人话 |
|---|---|---|
| FMA | Fused Multiply-Add | 一次乘加:d = a×b + c,只动「一个数」。CUDA Core 的基本动作。 |
| MMA | Matrix Multiply-Accumulate | 一块矩阵乘加:D = A×B + C,动「一整块小矩阵」。Tensor Core 的基本动作。 |
| FLOPS | Floating-point Operations Per Second | 每秒做多少次浮点运算(乘、加都算)。衡量「算得有多快」。 |
| TFLOPS | Tera-FLOPS | FLOPS。H100 FP8 ≈ 2000 TFLOPS = 每秒约 次浮点运算。 |
| GEMM | GEneral Matrix Multiply | 通用矩阵乘 C = α·A×B + β·C。LLM 里线性层、attention 的核心运算,最吃算力。 |
| 记忆口诀:FMA 算数,MMA 算小矩阵,GEMM 是业务名,FLOPS 是成绩单。 |
4.2 CUDA Core vs Tensor Core:同一件事,两条路
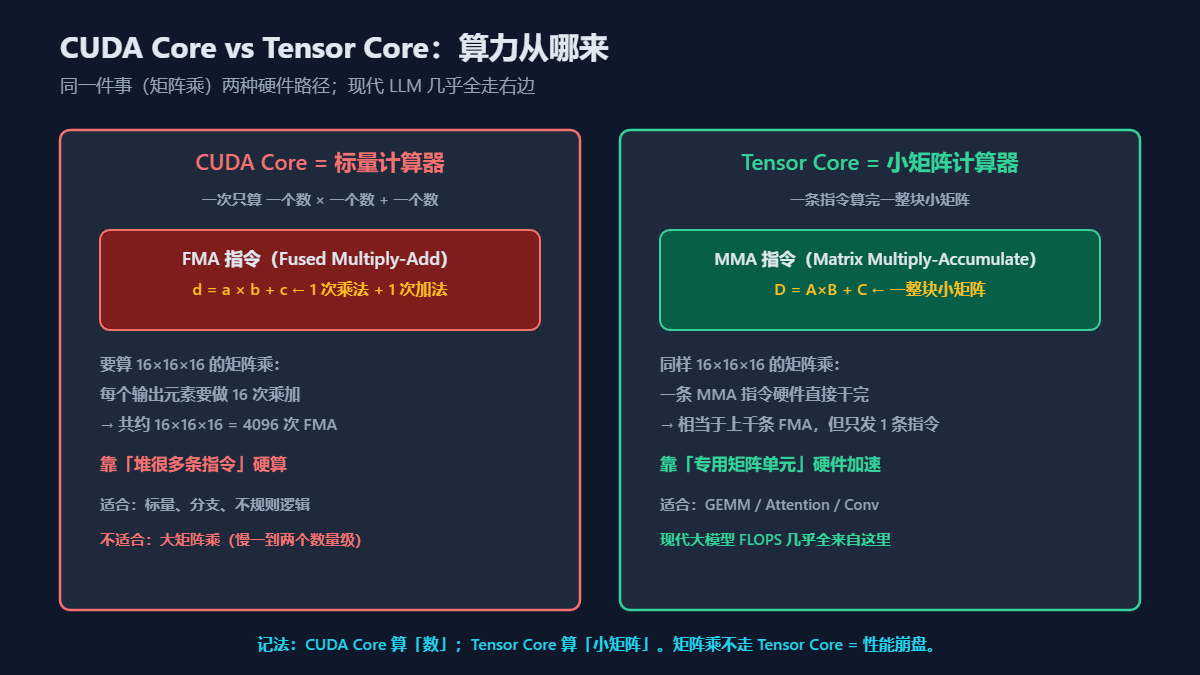
| CUDA Core | Tensor Core | |
|---|---|---|
| 一次干什么 | 1 次 FMA(一个数) | 1 次 MMA(一小块矩阵) |
| 算 16×16×16 | 约 4096 次 FMA | 约 1 条 MMA 指令 |
| 适合 | 标量、分支、不规则逻辑 | GEMM / Attention / Conv |
| LLM 占比 | 边角料 | 算力主体 |
| 误区:以为「写了矩阵乘就自动走 Tensor Core」。不会。tile 形状、对齐、精度不对时,编译器会退回 CUDA Core,性能可差 10×~100×。要用 ncu 看 Tensor Core 利用率确认。 |
4.3 M / K / N 三个字母怎么读
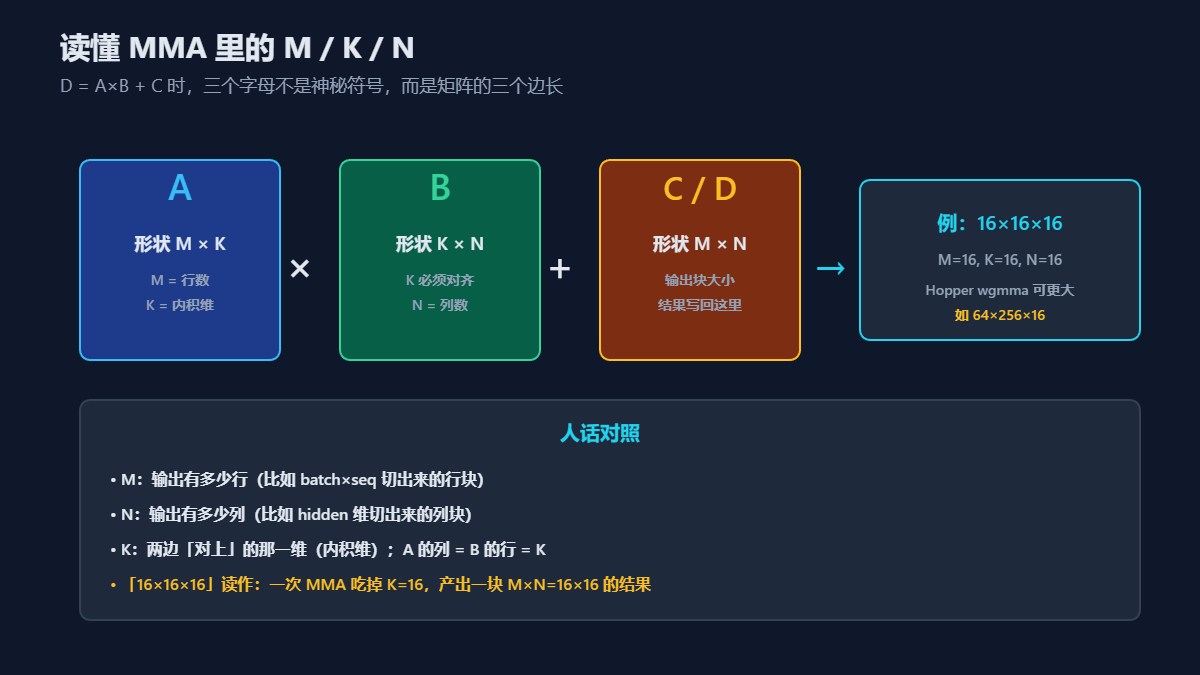
- M:输出有多少行
- N:输出有多少列
- K:两边对上的内积维(A 的列 = B 的行)
- 说「16×16×16」= 一次 MMA 吃掉 K=16,产出一块 16×16 的结果
- Hopper 的 wgmma 可以一次更大,例如 64×256×16
4.4 异步相关词(Hopper 才真正用满)
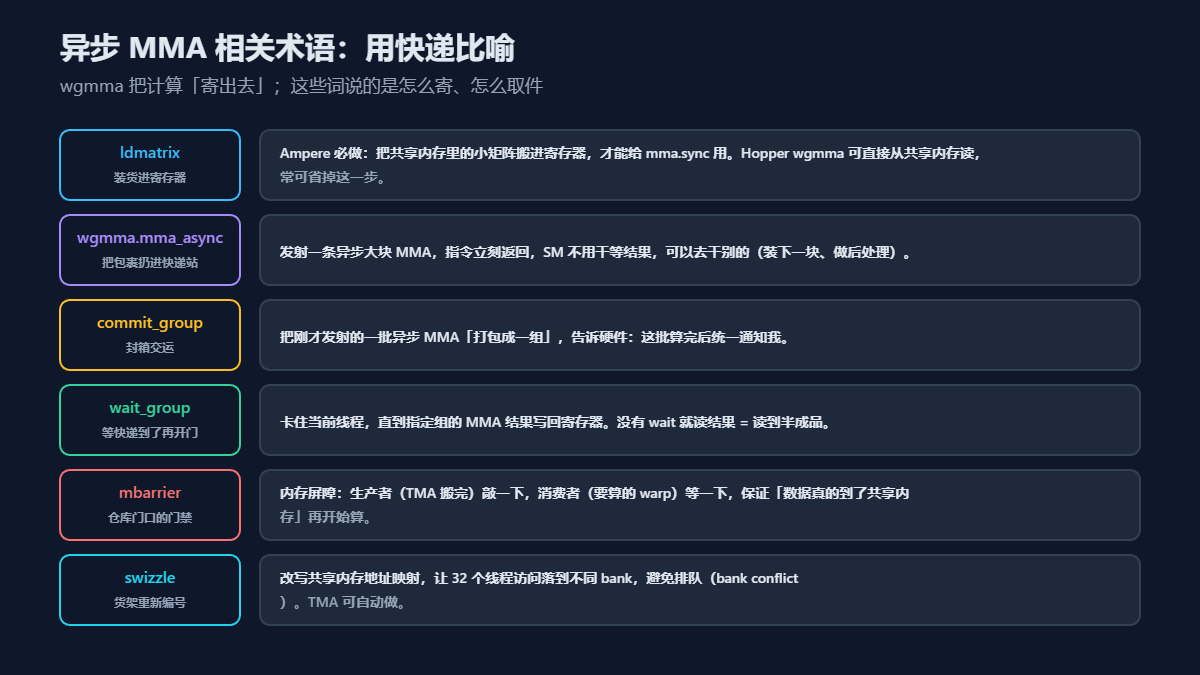
| 术语 | 比喻 | 人话 |
|---|---|---|
ldmatrix | 装货进寄存器 | Ampere:A/B 先从共享内存装进寄存器再算。Hopper wgmma 常可直接从共享内存读。 |
wgmma.mma_async | 把包裹扔进快递站 | 发射异步大块 MMA,指令立刻返回,SM 可去干别的。 |
commit_group | 封箱交运 | 把一批异步 MMA 打成一组。 |
wait_group | 等快递到了再开门 | 等到该组结果写回寄存器再读;否则读到半成品。 |
mbarrier | 仓库门禁 | 内存屏障:搬完再算,保证共享内存里的数据真的到了。 |
swizzle | 货架重新编号 | 改地址映射,让 32 线程落到不同 bank,避免排队。 |
4.5 实践含义
- 写 GEMM / attention / conv,必须落到 Tensor Core,否则性能崩。
- 数据布局要满足要求(如 FP16 的 16B 对齐、特定 tile 形状)。
- Hopper:用 wgmma 异步发射;A/B 在共享内存,C/D 在寄存器;用
commit_group+wait_group同步。 - 用 ncu 的 Tensor 利用率确认没有退回 CUDA Core。
五、Hopper 特性一:TMA(Tensor Memory Accelerator)
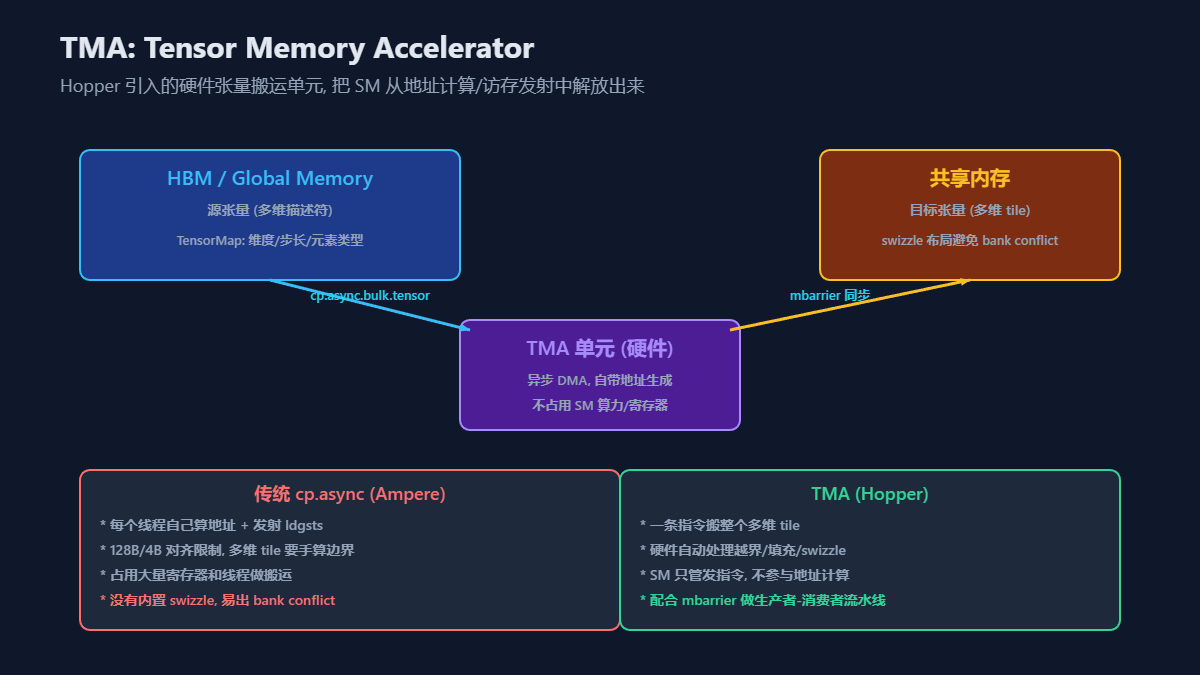
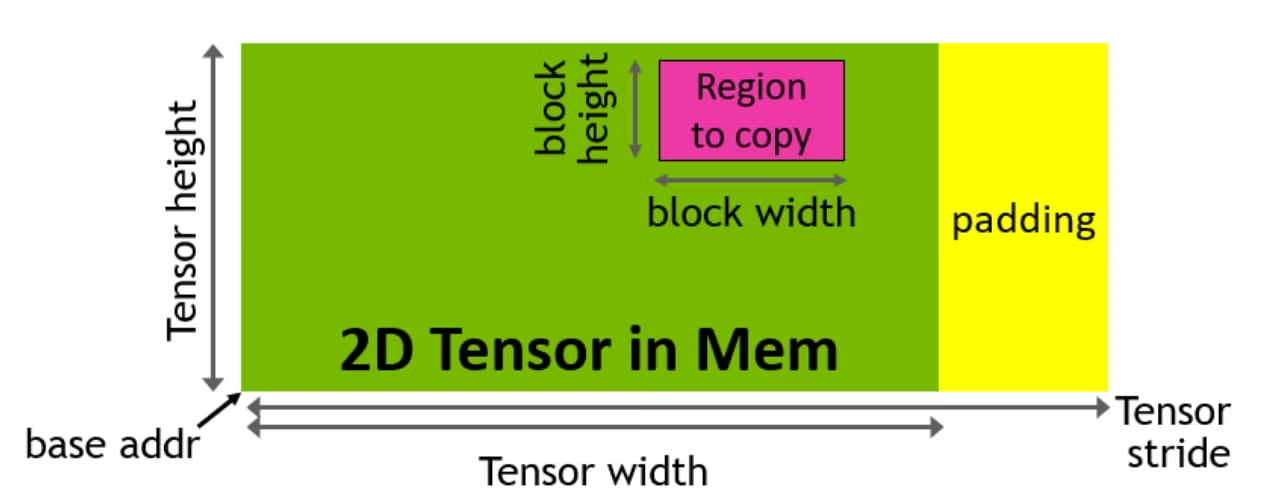
网络权威配图:下面两张来自 PyTorch 官方博客《Deep Dive on the Hopper TMA Unit for FP8 GEMMs》,是讲解 TMA 最清晰的图。第一张对比了 Ampere(A100,线程级 cp.async,每线程自己算地址)与 Hopper(H100,TMA 硬件单元,单线程发描述符即搬整块)的数据搬运模型差异;第二张展示了 TMA 如何通过一个 copy descriptor(含张量维度/坐标)完成地址生成,免去逐元素寻址。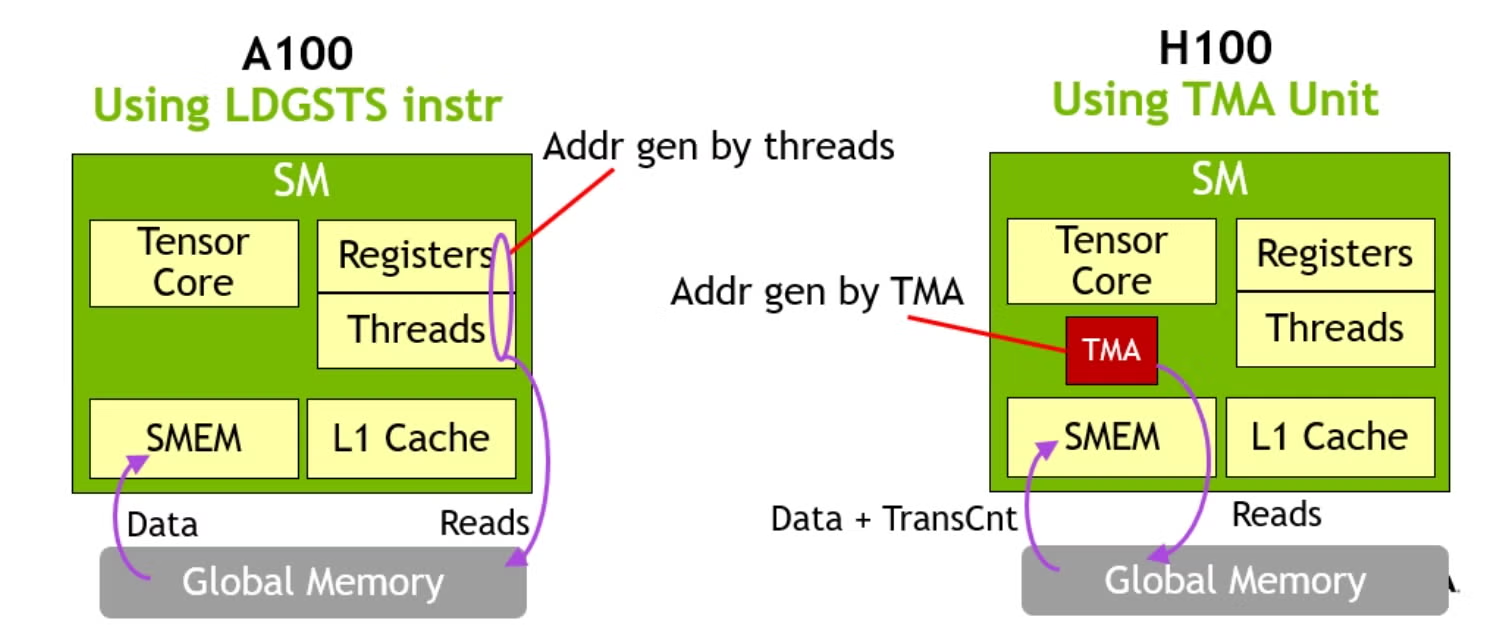
实测带宽图:下面两张是同一篇博客用 Nsight Compute 抓的 H100 GMEM 带宽实测——未用 TMA 时约 910 GB/s,用 TMA 后达到 1.45 TB/s,直观说明 TMA 把访存带宽喂得更满。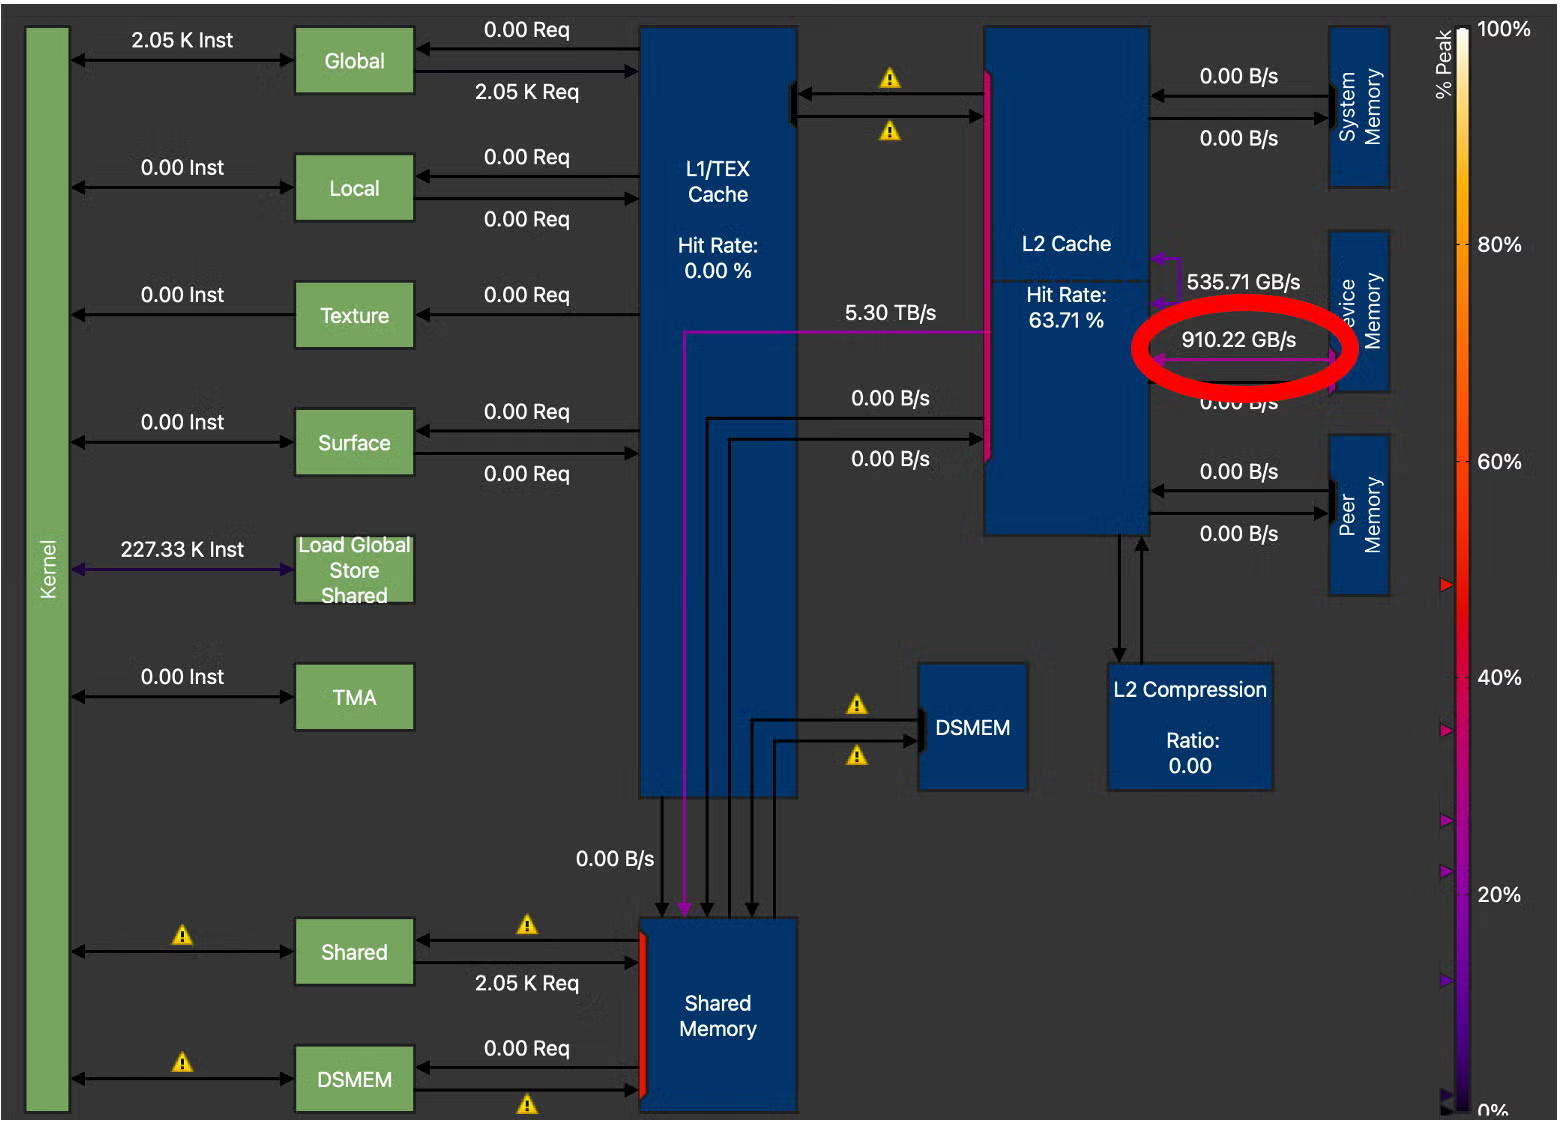
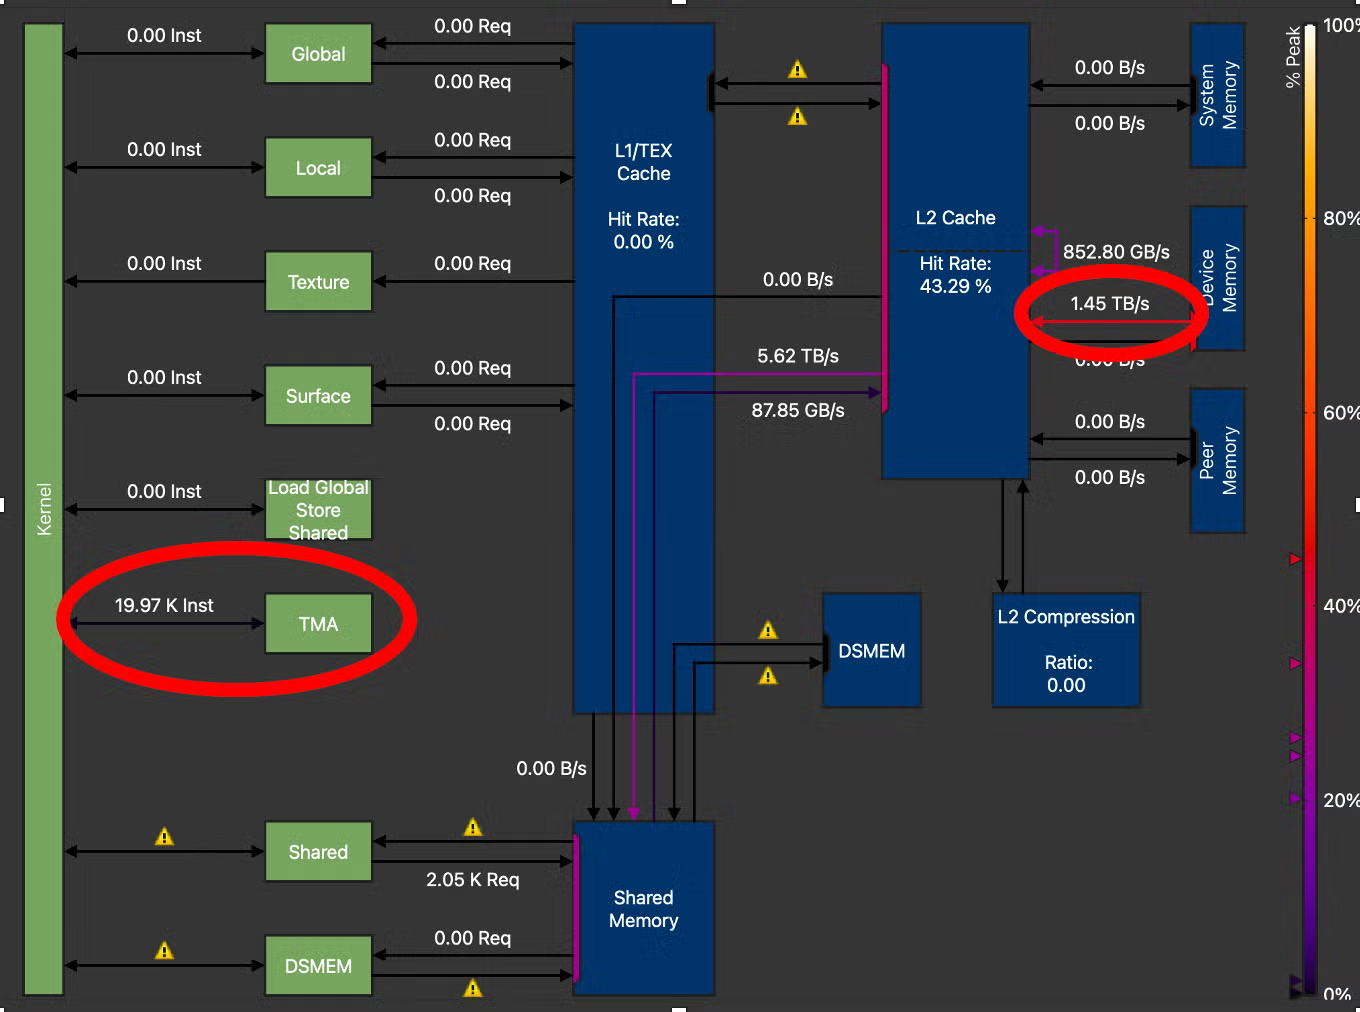
TMA 是 Hopper 最重要的访存革新,它把 SM 从「搬运工」解放成「计算工」。
白话定义:TMA 是一个专门的硬件搬运单元,你给它一个多维张量描述,它自己把整块数据从 HBM 搬到共享内存,SM 完全不参与。
术语拆解
| 词 | 人话 |
|---|---|
| TMA | Tensor Memory Accelerator:硬件 DMA,专搬多维 tile |
| TensorMap | host 端建好的「说明书」:维度、步长、元素类型、是否 swizzle |
cp.async.bulk.tensor | 发一条「按说明书搬整块」的指令 |
| boundary handling | 越界自动填充,不用线程手写边界 if |
| cp.async(Ampere) | 旧方案:每线程自己算地址发 ldgsts,占寄存器、无内置 swizzle |
精确定义:程序员先在 host 创建 TensorMap,kernel 里一条 TMA 指令搬整个多维 tile。硬件自动:地址生成、越界填充、swizzle、与 mbarrier 做生产者-消费者同步。 |
实践含义:
- Hopper kernel 的访存应该尽量用 TMA,而不是手写 cp.async。
- TMA 天然配合 wgmma 的异步流水线:TMA 装下一块,wgmma 算上一块,深度重叠。
- CUTLASS 3.x 和 Triton 都已封装 TMA,写 kernel 时用高层 API 即可。
六、Hopper 特性二:FP8 浮点格式
网络权威配图:下面两张来自 PyTorch 官方博客,量化展示了 FP8 + TMA 的实测收益。第一张对比了不同 FP8/FP16 Triton 与 cuBLAS kernel 的吞吐(TFLOPS),可见 FP8 在中小矩阵上吞吐显著高于 FP16;第二张是 Triton FP8+TMA GEMM 与 cuBLAS 的性能对比,证明 TMA 对 FP8 GEMM 的关键作用。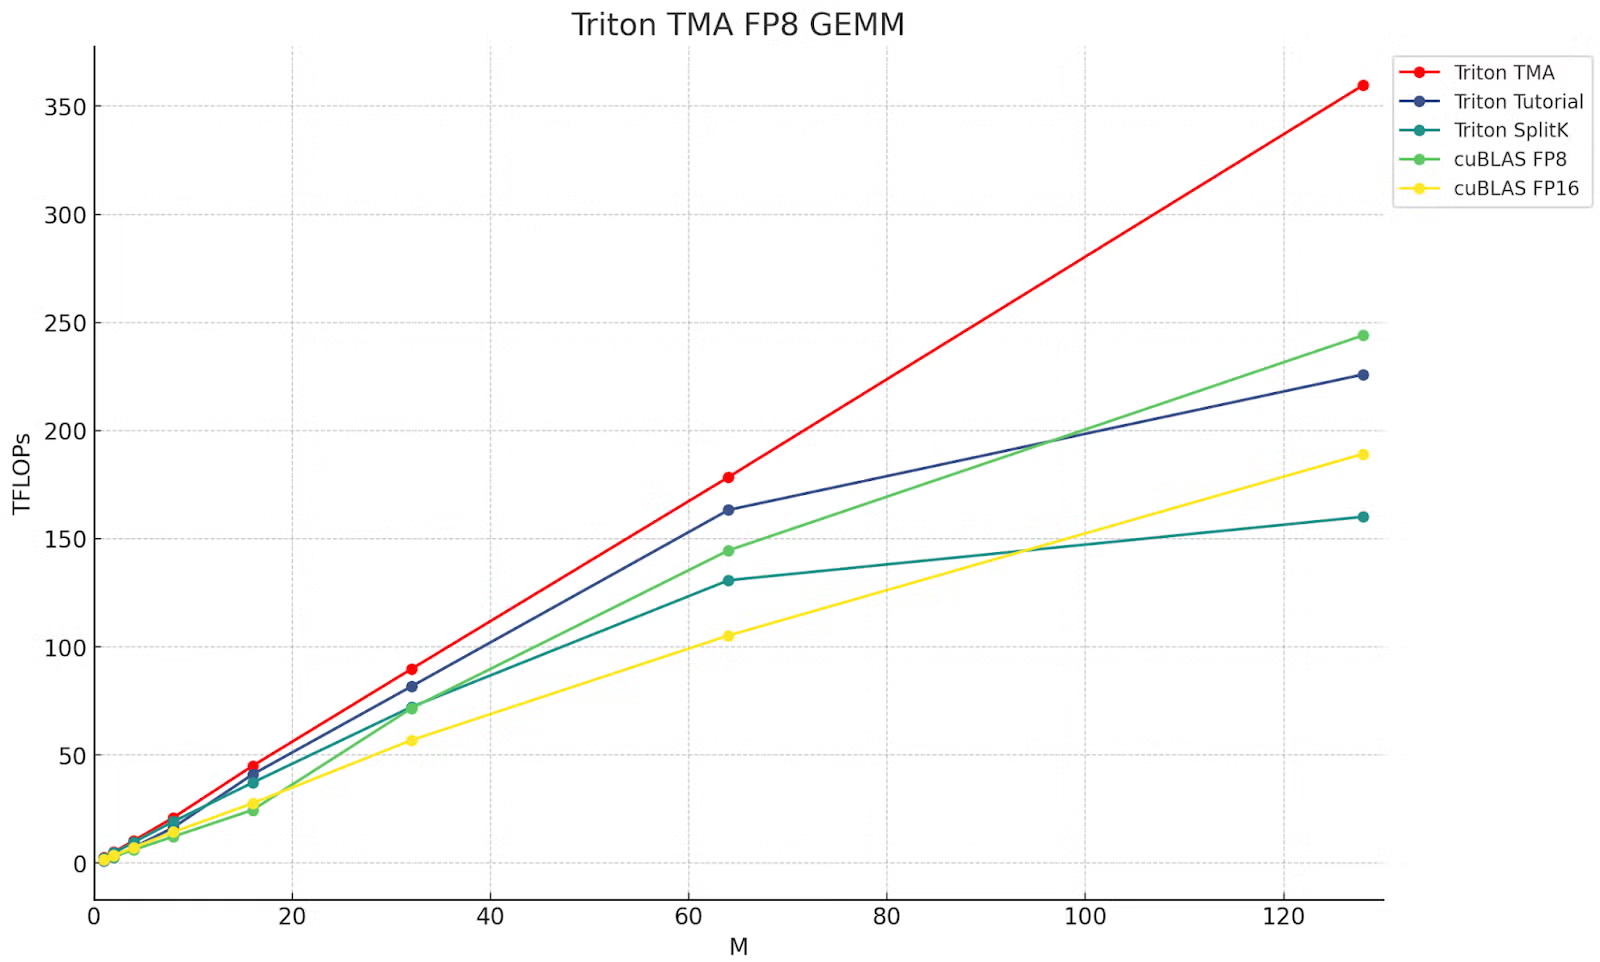
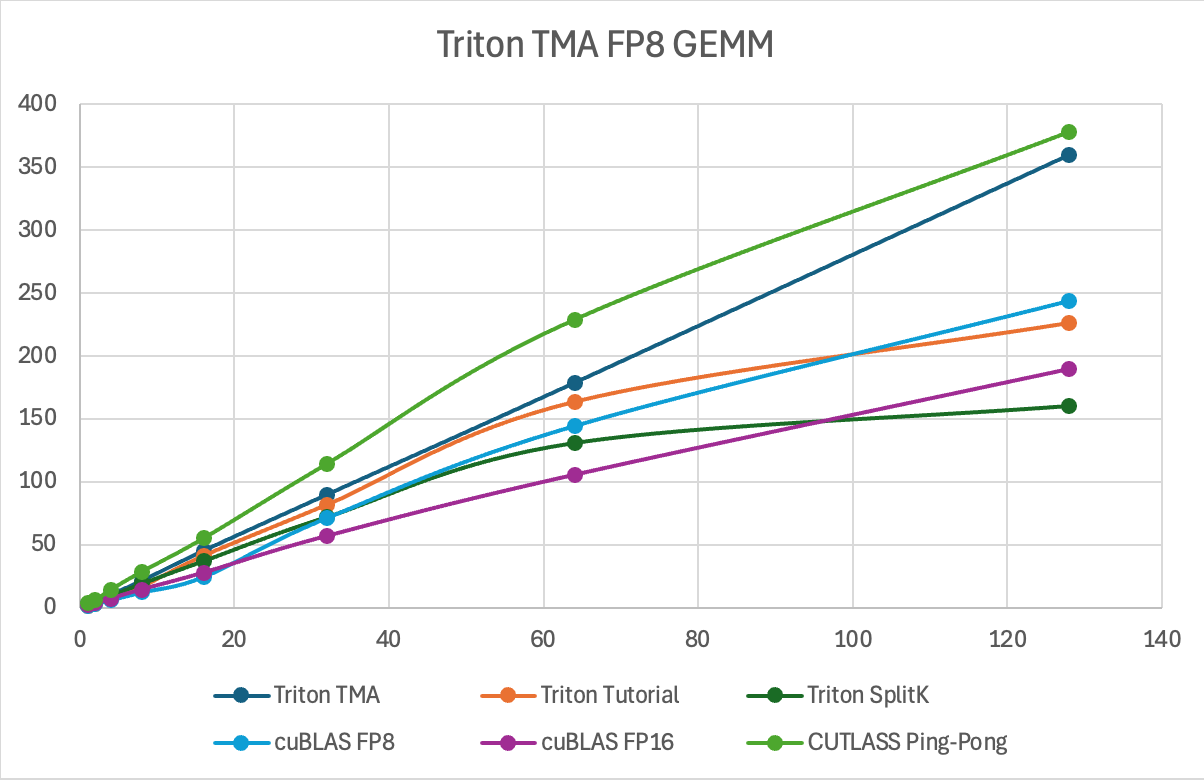
FP8 是 Hopper 在推理场景的关键武器:用一半位宽换接近 2 倍算力和 2 倍带宽。
白话定义:FP8 是 8 位浮点数,比 FP16/BF16 少一半位,算力翻倍、带宽减半,代价是精度和动态范围变小。
术语拆解:浮点格式在数什么
一个浮点数通常拆成三段:
| 段 | 英文 | 人话 |
|---|---|---|
| S | Sign | 符号位:正还是负 |
| E | Exponent | 指数:决定「能表示多大/多小」(动态范围) |
| M | Mantissa / Fraction | 尾数:决定「同一个数量级里能分多细」(精度) |
| bias | 指数偏置 | 存的时候指数要加一个固定偏移;解码时再减回去 |
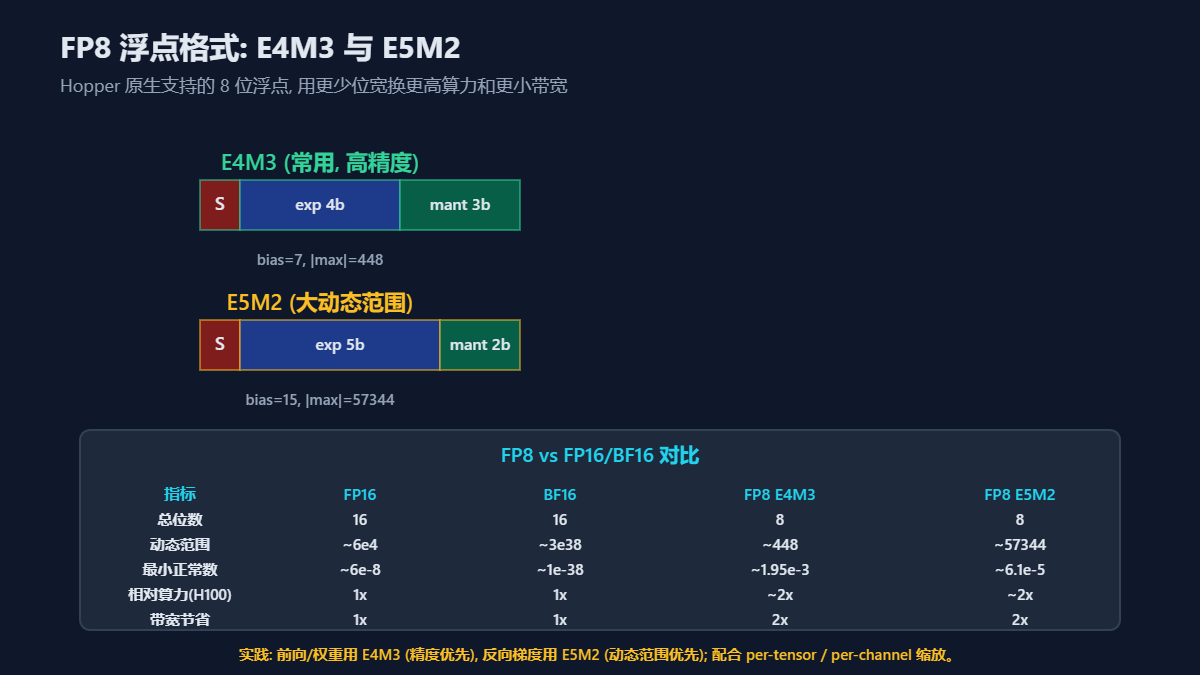
| 精确定义:Hopper 支持两种 FP8: |
- E4M3:1 符号 + 4 指数 + 3 尾数,bias=7,\|max\|≈448 → 精度相对好,范围小
- E5M2:1 符号 + 5 指数 + 2 尾数,bias=15,\|max\|≈57344 → 范围大,精度差
对比:FP16 范围约 6e4;BF16 约 3e38(指数多);E4M3 只有约 448。所以 FP8 必须配缩放因子(scale),否则容易溢出或下溢。
实践含义:
- 前向 / 权重用 E4M3(精度优先),反向梯度用 E5M2(范围优先)。
- 配合 per-tensor / per-channel scaling factor,把有限范围「撑开」。
- SGLang / vLLM 的 FP8 推理就是这套;不是所有模型都适合,要校准。
七、Hopper 特性三:wgmma(Warp-Group MMA)
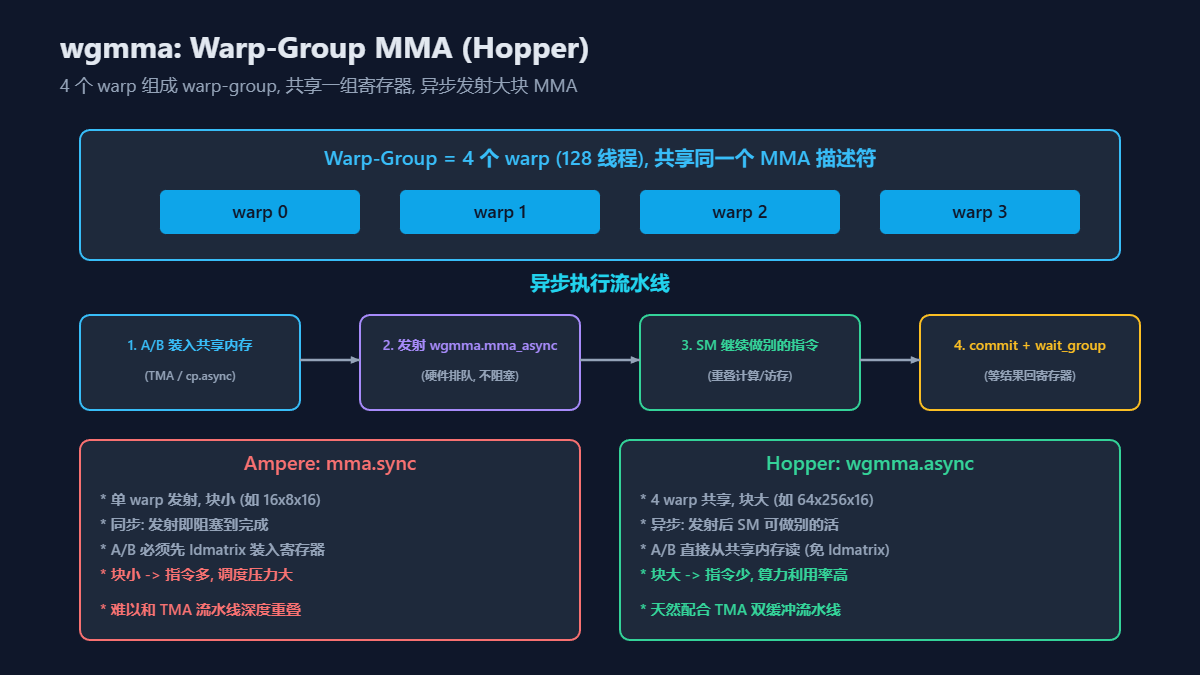
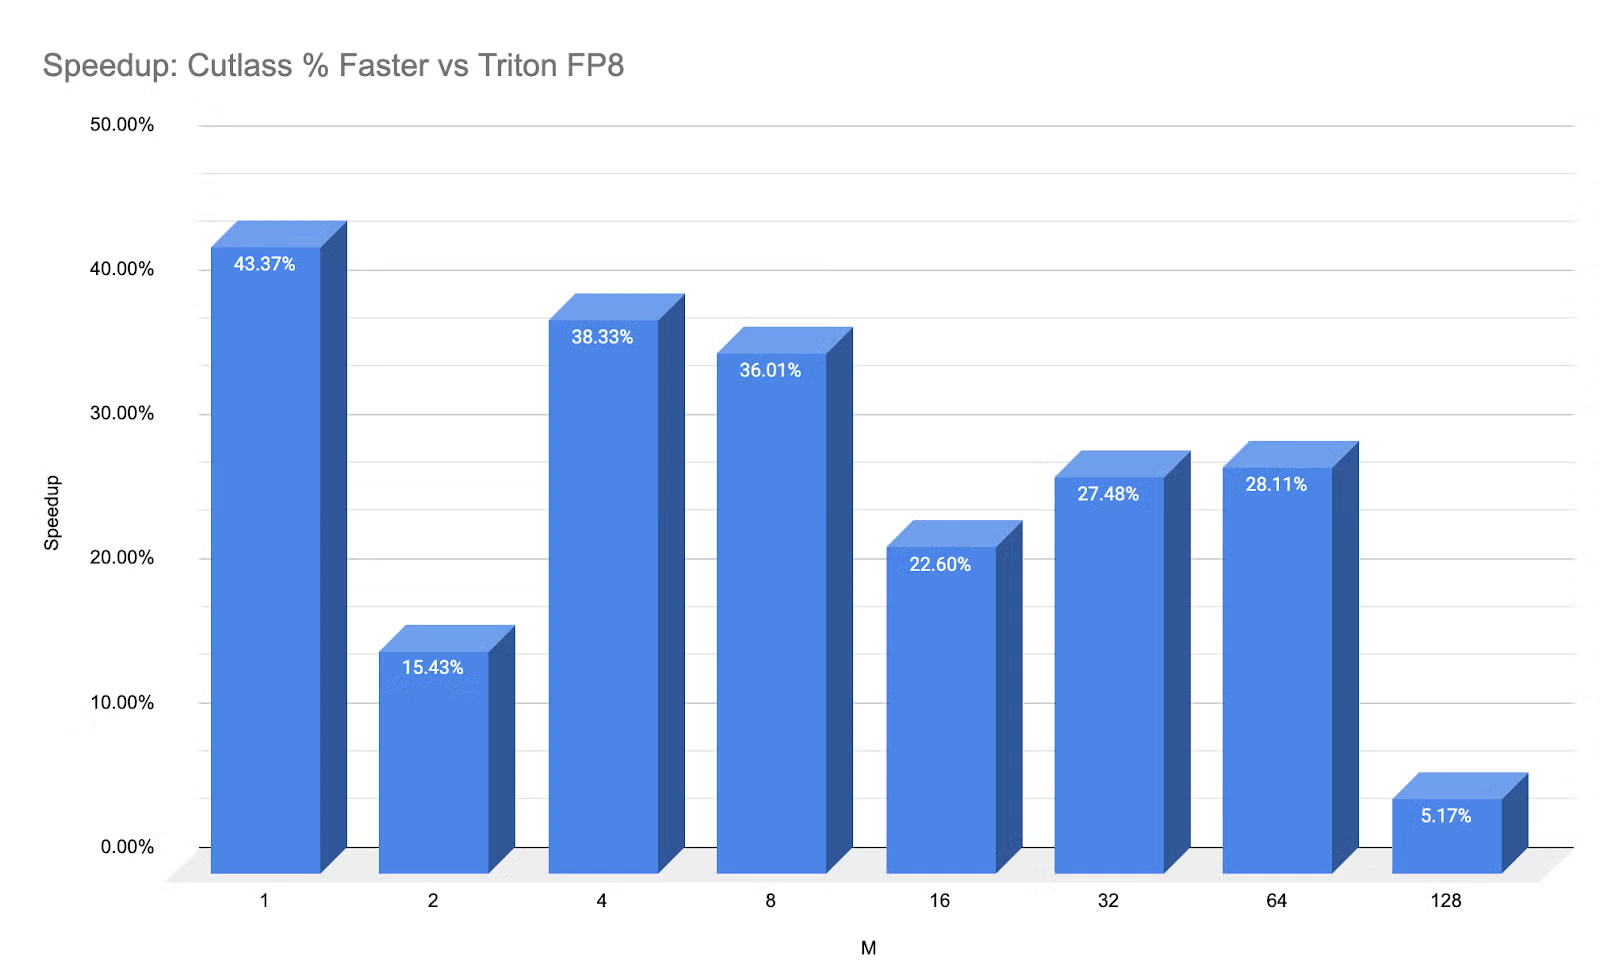
网络权威配图:下面两张来自 PyTorch 官方博客,展示了 wgmma + TMA 组合在 FP8 GEMM 上的实测性能。第一张对比 Triton 与 CUTLASS Ping-Pong FP8 GEMM 的 TFLOPS(M=N=K=4096);第二张是 CUTLASS Ping-Pong 相对 Triton FP8+TMA 的加速比。可以看出 Hopper 上 wgmma + 多级流水线 + Ping-Pong 调度能把 FP8 算力榨到接近峰值。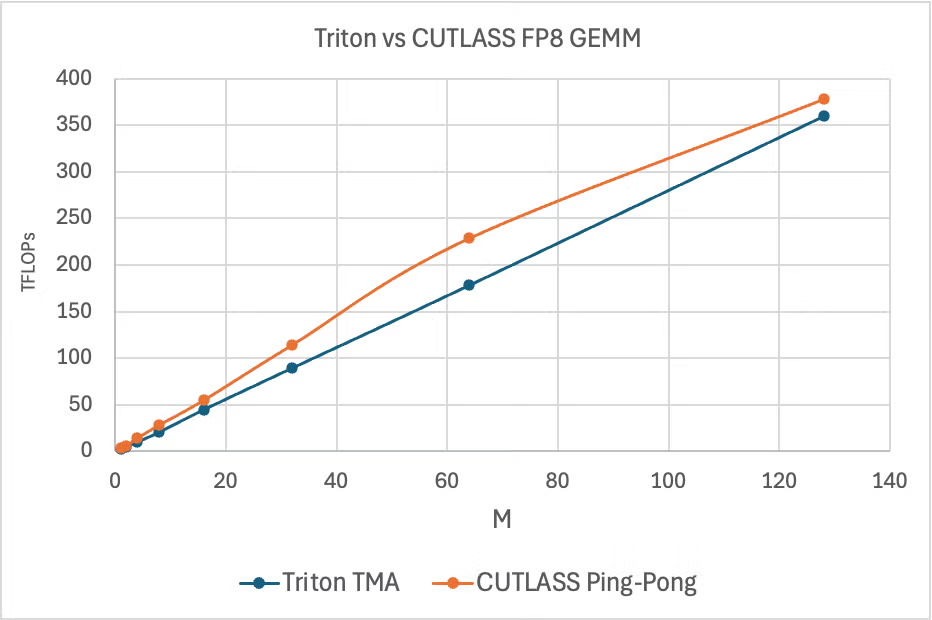
wgmma 是 Hopper 把「算」也异步化的关键,让访存和计算能深度重叠。
白话定义:wgmma = 4 个 warp(128 线程)组成一个小队,一起发射一条大块、异步的 MMA;发射后不等结果,SM 可以继续干别的。
精确定义:Hopper 引入 warp-group:4 个 warp 共享一组 MMA 描述符,用 wgmma.mma_async 发射大块(如 64×256×16)。
术语拆解(和 Ampere 对比)
Ampere mma.sync | Hopper wgmma.mma_async | |
|---|---|---|
| 谁发 | 单 warp(32 线程) | warp-group(4 warp / 128 线程) |
| 块大小 | 小,如 16×8×16 | 大,如 64×256×16 |
| 同步 | 同步:发射就等做完 | 异步:发射就返回 |
| A/B 从哪读 | 必须先 ldmatrix 进寄存器 | 可直接从共享内存读 |
| 和访存重叠 | 难做深 | 天然配合 TMA 多级流水线 |
commit_group / wait_group / ldmatrix / mbarrier 的人话见 [§4.4](#44-异步相关词hopper-才真正用满)。 |
实践含义:
- Hopper GEMM / attention 优先 wgmma + TMA,流水线 4~8 级。
- CUTLASS 3.x / Triton(
num_stages)都已封装这套组合。
八、Hopper 特性小结:为什么这些特性一起出现
TMA、FP8、wgmma 不是孤立特性,而是一套"让 Hopper 在大模型推理上质变"的组合拳:
- TMA 把访存从 SM 卸载到硬件,SM 不再当搬运工。
- wgmma 把计算异步化,让访存和计算深度重叠。
- FP8 把每拍算力和带宽翻倍,喂饱更快的算力单元。
- swizzle + mbarrier 让共享内存访问无冲突、流水线同步高效。
这套组合让 H100 在 LLM 推理上相比 A100 有数倍吞吐提升,也是 SGLang / vLLM 在 Hopper 上能跑出高 token/s 的硬件基础。
术语速查(本文)
| 术语 | 一句话 |
|---|---|
| SM | GPU 上真正跑指令的「小核心」 |
| warp | 32 线程锁步小队 |
| SIMT | 一条指令、多线程各算各的数据 |
| CUDA Core | 标量 FMA 单元 |
| Tensor Core | 小矩阵 MMA 单元,算力主体 |
| FMA / MMA | 一次乘加(数) / 一次矩阵乘加(块) |
| FLOPS / TFLOPS | 每秒浮点运算次数 / 万亿次 |
| GEMM | 通用矩阵乘 |
| TMA | Hopper 硬件张量搬运,SM 不参与地址计算 |
| wgmma | 4-warp 异步大块 MMA |
| FP8 E4M3/E5M2 | 8 位浮点:偏精度 / 偏范围 |
| mbarrier / swizzle | 内存屏障同步 / 地址重排防 bank conflict |
| occupancy | SM 上驻留 warp 占比(隐藏延迟用) |
常见误区
- 误区一:occupancy 越高越好。不对。计算密集 kernel 用更多寄存器、更低 occupancy 反而更快,因为每线程算得更多。要看 achieved occupancy + stall reasons 一起判断。
- 误区二:Tensor Core 自动启用。不会。数据布局不对、tile 形状不对、精度不对,编译器会回退到 CUDA Core,性能差一两个数量级。要主动确保走 MMA 路径。
- 误区三:TMA 只是 cp.async 的别名。不是。TMA 是独立硬件单元,自带地址生成、越界处理、swizzle,SM 完全不参与;cp.async 是线程级、要算地址。
- 误区四:FP8 直接替换 FP16 就行。不行。FP8 动态范围小,必须配缩放因子,否则精度掉得厉害。前向用 E4M3、反向用 E5M2 是经验。
- 误区五:wgmma 和 mma.sync 只是块大小不同。本质差异是异步 vs 同步。wgmma 发射后 SM 能继续干活,mma.sync 发射即阻塞,这决定了能否做深度流水线。
实践清单
读 Hopper kernel 或自己写时,对照检查:
FAQ
Q:Hopper 和 Ampere 最大的实战差异是什么?
A:TMA + wgmma + FP8 三件套。Hopper kernel 的访存和计算能深度重叠(异步),且 FP8 让算力翻倍。Ampere 上要手写 cp.async + mma.sync,深度重叠难做。
Q:我不用 Hopper,这些还重要吗?
A:概念通用。TMA/wgmma 是 Hopper 特有,但 tiling、occupancy、bank conflict、Tensor Core、流水线思想在所有 GPU 上都适用,只是实现指令不同。
Q:SGLang 里哪里能看到这些?
A:sgl-kernel 里的 AOT CUDA kernel(attention、quant、moe)大量用 wgmma + TMA;Triton kernel 用 num_stages 控制流水线;FP8 量化路径在 python/sglang/srt/layers/ 下。
阅读导航



