
Prefill FLOPs 估算:模型线性计算与 Attention 成本
Prefill 阶段 FLOPs 与 Attention 计算
Prefill 阶段会把长度为 N 的输入 Prompt 一次性送入模型,计算每个输入位置的隐藏状态,并为所有输入 token 构建 KV Cache。
对于参数量为 P 的模型,线性层部分可以使用一个非常实用的粗略公式:
Prefill FLOPs_linear ≈ 2 × P × N
其中:
P:模型参数量
N:输入 token 数
2:一次乘加通常按 2 个 FLOPs 计数
例如 70B 模型处理 4,000 token:
2 × 70B × 4,000
= 560,000,000,000,000 FLOPs
= 560 TFLOPs
但这还没有完整计算 Attention。Attention 的两次核心矩阵运算会产生与序列长度平方相关的计算:
Attention FLOPs_full ≈ 4 × Layer 数 × N² × Hidden Size
更完整的量级模型是:
Prefill FLOPs_total
≈ 2PN
+ 4L N² d_model
+ Norm、激活、RoPE、Softmax 等开销
这里的 2PN 是线性层主项,4L N² d_model 是按完整 Attention 矩阵计算的上界。Causal Attention 的逻辑有效区域约为下三角,理论上约减半,但实际是否跳过无效区域取决于 Kernel。
1. Prefill 在做什么
可以把 Prefill 想象成“先把整篇文章读完并建立索引”。模型不是只计算最后一个 token,而是会为 Prompt 中的每个位置计算隐藏状态和 K/V 表示。
Prompt:t1, t2, t3, ..., tN

Prefill:一次处理 t1 到 tN
输出:每个位置的隐藏状态,以及每层对应的 K/V
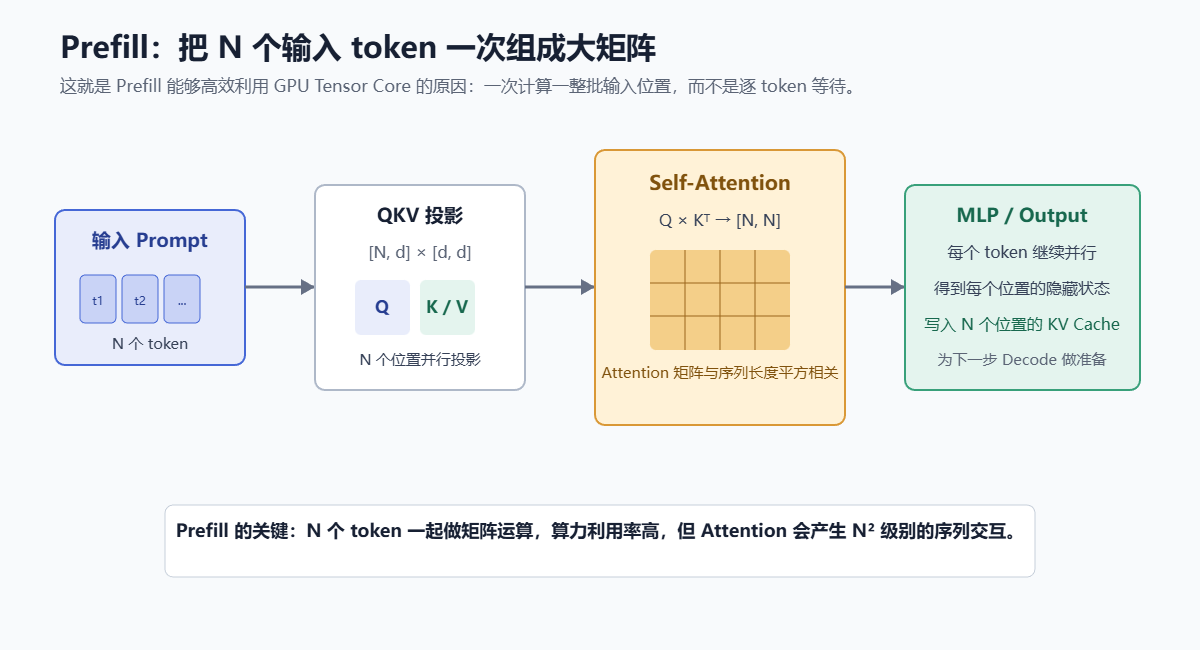
N 个输入 token 被组织成矩阵,一起完成 QKV 投影、Attention 和 MLP,并写入 N 个位置的 KV Cache。
Prefill 的输出主要有两类:
- 最后一个位置的 logits,用于生成第一个输出 token
- 所有输入位置的 K/V,写入 KV Cache,供后续 Decode 使用
2. FLOPs、FLOPS 和 TFLOPs
FLOPs 表示一次任务的总浮点运算量;FLOPS 表示每秒可以完成的浮点运算量。
FLOPs = 计算总量
FLOPS = 每秒计算能力
如果 Prefill 需要 560 TFLOPs,GPU 的有效计算能力是 500 TFLOPS,线性层理想计算时间约为:
560 TFLOPs / 500 TFLOPS/s
= 1.12 秒
真实时间还会受到 Tensor Core 利用率、矩阵形状、数据类型、通信、Kernel 和调度影响:
Prefill 时间
≈ 总 FLOPs / 有效 FLOPS
3. 2 × P × N 是如何来的
一个矩阵乘法:
A:M × K
B:K × N
C = A × B:M × N
C 中的每个元素需要 K 次乘法和 K-1 次加法。工程估算通常把一次乘法和一次加法合计为 2 个 FLOPs:
FLOPs_matmul ≈ 2 × M × K × N
一个线性层的形状是:
输入 X:N × d_in
权重 W:d_in × d_out
输出 Y:N × d_out
因此:
FLOPs_linear ≈ 2 × N × d_in × d_out
Transformer 中大量计算来自 Q、K、V 投影、Attention 输出投影和 MLP 投影。把这些线性层权重参数量加起来,记为 P_linear:
FLOPs_linear ≈ 2 × N × P_linear
工程上常用总参数量 P 近似替代 P_linear,于是得到:
Prefill FLOPs_linear ≈ 2 × P × N
它是非常实用的量级公式,但不是严格等式,因为 Embedding、Norm、RoPE、Softmax、权重共享和 LM Head 的计算方式不同。
4. 70B 模型、4,000 token 的线性计算
假设:
P = 70 × 10^9
N = 4,000
代入:
FLOPs_linear
= 2 × 70 × 10^9 × 4,000
= 560 × 10^12
= 560 TFLOPs
如果 GPU 有效 Prefill 算力是 1,000 TFLOPS:
线性层理想计算时间
≈ 560 / 1,000
≈ 0.56 秒
实际 TTFT 还要加上排队、Tokenizer、Attention、KV Cache 写入、Kernel 同步、通信和采样等时间。
5. Attention 为什么出现 N²
Attention 的核心是每个 Query 位置与每个 Key 位置计算相关性:
Score = Q × Kᵀ
假设:
Q:N × d_model
Kᵀ:d_model × N
结果就是:
Score:N × N
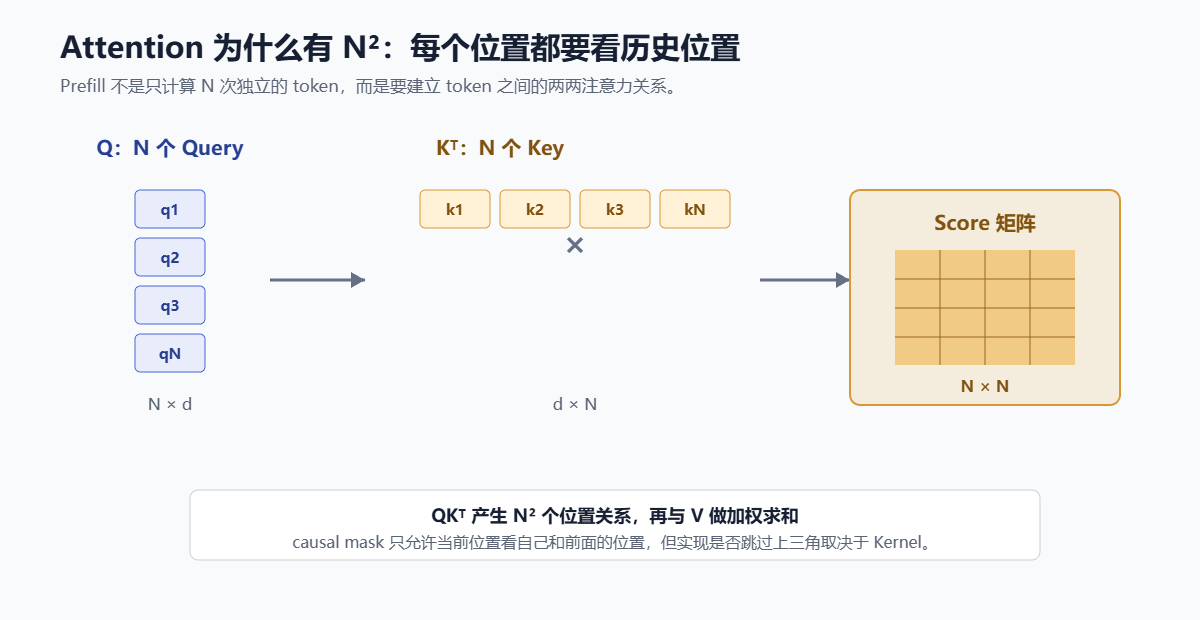
输入位置之间需要建立两两关系,因此 QKᵀ 包含 N×N 个分数位置。Causal mask 会限制可见范围,但实现是否跳过上三角取决于 Kernel。
QKᵀ 的 FLOPs:
FLOPs_QK
≈ 2 × N × d_model × N
≈ 2 × N² × d_model
Attention 权重与 V 的矩阵乘法:
FLOPs_AV
≈ 2 × N × N × d_model
≈ 2 × N² × d_model
两部分合计,单层 Attention 的矩阵乘法部分约为:
FLOPs_attention_per_layer
≈ 4 × N² × d_model
模型有 L 层时:
FLOPs_attention
≈ 4 × L × N² × d_model
6. Causal Attention 会不会把 N² 降为一半
Decoder-only 模型通常使用 causal mask,第 i 个 token 只能看 1...i 的位置。逻辑上有效关系数量为:
1 + 2 + 3 + ... + N
= N(N+1) / 2
≈ N² / 2
如果 Kernel 真正只计算下三角区域:
FLOPs_attention_causal
≈ 2 × L × N² × d_model
但工程上不能永远简单除以 2,因为 GPU 更喜欢规则、对齐的 Tile,某些实现仍会处理包含无效位置的完整块,FlashAttention 的分块优化也不等于简单的三角矩阵计算。
因此应明确三种口径:
全矩阵上界:4LN²d_model
理想因果三角区域:约 2LN²d_model
实际执行量:以 Kernel 和 Profiler 为准
7. 70B、4,000 token 的 Attention 计算
假设一个 Llama 类模型:
Layer 数 L = 80
Hidden Size d_model = 8,192
输入长度 N = 4,000
按全矩阵上界:
FLOPs_attention
≈ 4 × 80 × 4,000² × 8,192
≈ 41.9 TFLOPs
与线性层主项比较:
线性层:约 560 TFLOPs
Attention 全矩阵上界:约 41.9 TFLOPs
Attention 约为线性主项的:
41.9 / 560 ≈ 7.5%
如果按理想 causal 三角区域:
约 41.9 / 2 ≈ 21.0 TFLOPs
在 4k 输入下,Prefill 通常仍主要由线性层和 MLP 计算主导,Attention 的平方项已经存在,但还没有压倒参数相关计算。
8. 长上下文时平方项如何反超
输入长度从 4k 增加到 32k,相当于增加 8 倍。
线性层随 N 线性增长:
560 TFLOPs × 8
= 4,480 TFLOPs
= 4.48 PFLOPs
Attention 随 N² 增长:
41.9 TFLOPs × 8²
= 2,684.4 TFLOPs
= 2.68 PFLOPs
此时:
线性层:约 4.48 PFLOPs
Attention 全矩阵上界:约 2.68 PFLOPs
Attention 已经从 4k 时约 7.5% 上升到接近 60%。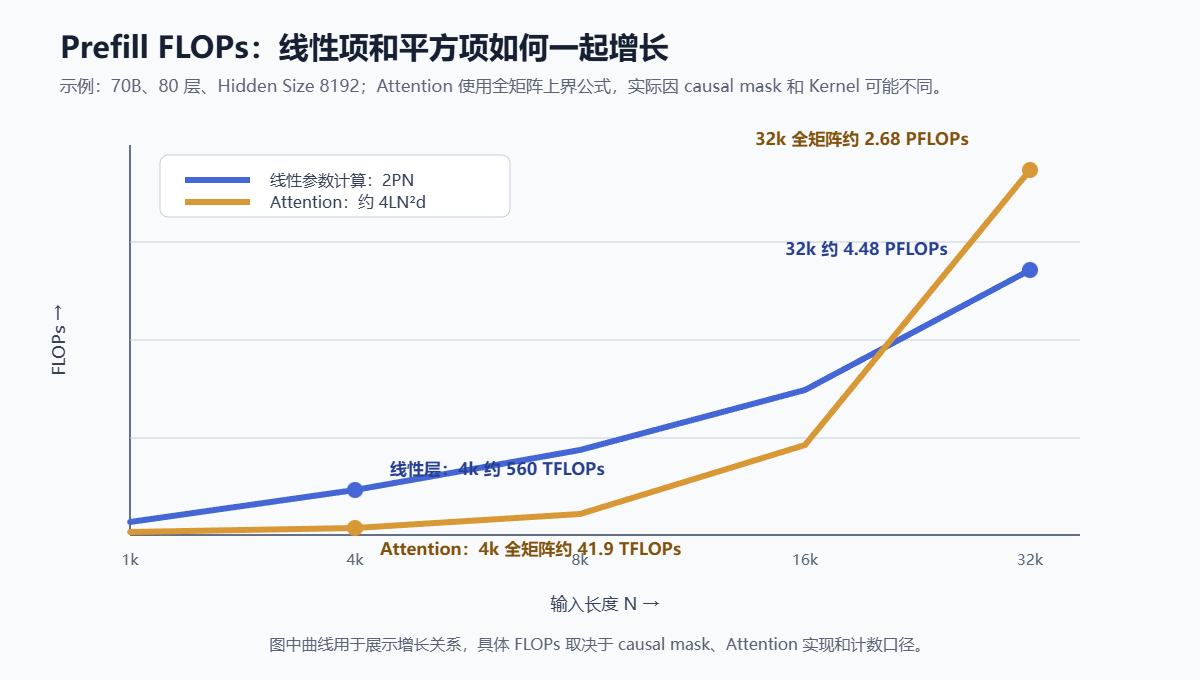
线性层随 N 线性增长,Attention 的平方项随 N² 增长。长上下文的计算压力不是简单地按 token 数同比增加。
令线性项和 Attention 全矩阵上界大致相等:
2PN ≈ 4LN²d_model
约去一个 N:
N_cross ≈ P / (2L d_model)
代入 70B、80 层、8192 hidden:
N_cross
≈ 70 × 10^9 / (2 × 80 × 8,192)
≈ 53,406 token
这是全矩阵上界下的粗略交叉点。按理想 causal 三角区域计算,交叉点大约会增加一倍;真实交叉点还取决于模型结构、Kernel 和硬件。
9. Prefill 为什么容易获得较高算力利用率
Prefill 的线性层通常是:
输入激活:N × d_model
权重:d_model × d_out
输出:N × d_out
当 N 较大时,矩阵拥有很多行:
N = 1:矩阵很瘦,计算资源不容易填满
N = 4,000:矩阵有大量行,Tensor Core 更容易持续工作
因此 Prefill 通常具备:
大量 token 可并行
矩阵乘法规模大
一次权重读取可以服务多个 token
GPU 算力利用率较高
但“算力利用率高”不等于“Prefill 一定很快”。如果输入是 128k token,总 FLOPs 和 Attention 计算也非常大,TTFT 仍然可能很高。
10. Prefill 会写入多少 KV Cache
Prefill 为输入的每个 token 写入 K/V。
KV Bytes / token
= 2 × L × Hkv × d_head × KV dtype bytes
假设:
L = 80
Hkv = 8
d_head = 128
BF16 = 2 Bytes
单 token:
2 × 80 × 8 × 128 × 2
= 327,680 Bytes
≈ 320KB
4,000 token 输入的 KV 写入量:
4,000 × 320KB
≈ 1.28GB
32k 输入的 KV 写入量:
32,000 × 320KB
≈ 10.24GB
长 Prompt Prefill 因此会同时带来高计算量、高 KV 分配量、高 KV 写入量,以及更大的后续 Decode 状态。
11. Prefill 和 Decode 为什么会互相影响
在线服务同时存在两类工作:
Prefill:新请求进入,处理输入 Prompt
Decode:已有请求继续生成输出 token
长 Prefill 可能占用大量 Tensor Core 和显存带宽,使正在输出的请求无法及时执行下一轮 Decode。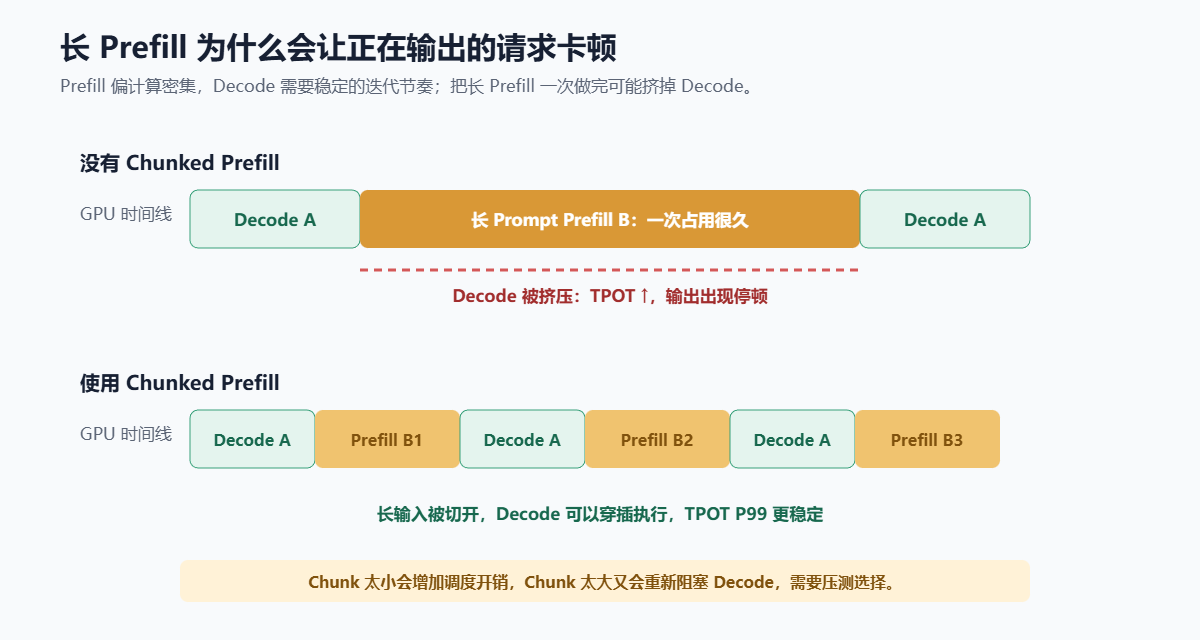
一次性执行长 Prefill 可能让 Decode 长时间等待;Chunked Prefill 将长输入切块,并允许 Decode 穿插执行。
如果 Decode 被阻塞,会出现:
TPOT 上升
流式输出间隔变长
用户感觉回复卡顿
Active Sequences 持续占用 KV Cache
Queue Time 和 TTFT 进一步上升
因此在线推理调度器通常会限制 Prefill:
max_num_batched_tokens
Prefill Token Budget
Chunked Prefill
Decode 优先级
长短请求隔离
12. Chunked Prefill 如何改变调度
假设一个请求有 32k Prompt。
一次性 Prefill:
一次处理 32k token
大矩阵计算集中执行
可能长时间占用 GPU
Chunked Prefill:
每次处理 2k 或 4k token
多个 Prefill Chunk 分多轮执行
中间穿插其他请求的 Decode
Chunked Prefill 不会消除总 FLOPs:
总输入 token 数没有变
2 × P × N 的主项仍然存在
它优化的是调度行为:把一次长时间独占拆成多个可调度片段,保护 Decode 的 TPOT 和尾延迟。
代价是:
调度次数增加
可能降低纯 Prefill 峰值吞吐
Chunk 太小会增加 Kernel 和调度开销
Chunk 太大仍可能阻塞 Decode
13. Prefill 的带宽和算力如何判断
Prefill 可能是计算受限,也可能受到显存和通信影响。可以比较两个粗略上界:
计算时间
≈ FLOPs / 有效 FLOPS

带宽时间
≈ 数据搬运字节数 / 有效 HBM 带宽
如果计算时间明显更大,更接近计算受限,应关注:
Tensor Core 利用率
矩阵形状
数据类型
Kernel 是否融合
GPU 有效算力
如果带宽时间明显更大,更接近带宽受限,应关注:
HBM 带宽利用率
激活读写
KV 写入
Attention 中间结果
量化解码
如果跨卡时间很高,则可能是通信受限:
All-Reduce
All-Gather
PCIe / NVLink 拓扑
跨节点网络
14. 一个完整的 70B、4k Prompt 估算
假设:
模型参数量 P = 70B
输入长度 N = 4,000
层数 L = 80
Hidden Size d_model = 8,192
KV Heads = 8
Head Dim = 128
KV dtype = BF16
14.1 线性层 FLOPs
2 × 70B × 4,000
= 560 TFLOPs
14.2 Attention 全矩阵上界
4 × 80 × 4,000² × 8,192
≈ 41.9 TFLOPs
14.3 Attention causal 理想区域
约 41.9 / 2
≈ 21.0 TFLOPs
14.4 KV Cache 写入
每 token:约 320KB
4,000 token:约 1.28GB
14.5 总体计算量粗估
按全矩阵 Attention 上界:
Prefill FLOPs
≈ 560 + 41.9
≈ 601.9 TFLOPs
这还没有计入 Norm、RoPE、Softmax、激活、Embedding、LM Head、Padding、通信和 Kernel 额外操作。因此它适合估算量级和比较方案,不适合直接当作线上 TTFT 承诺。
15. Padding 会让 Prefill FLOPs 被浪费
如果把不同长度请求放进同一个普通 Batch,通常需要 Padding 到 Batch 内最大长度。
例如:
请求 A:1,000 token
请求 B:4,000 token
请求 C:8,000 token
若统一 Padding 到 8,000:
实际有效 token = 1,000 + 4,000 + 8,000 = 13,000
计算 token 位置 = 3 × 8,000 = 24,000
Padding 浪费比例:
(24,000 - 13,000) / 24,000
≈ 45.8%
这就是为什么推理框架需要 Continuous Batching、Paged Attention、按 token 调度、长度分桶和 Chunked Prefill。这些技术不仅影响调度,也直接影响实际 Prefill FLOPs。
16. Prefill 的压测方法
16.1 固定模型,改变输入长度
建议测试:
N = 512、1k、2k、4k、8k、16k、32k、64k
记录:
TTFT
Prefill tokens/s
GPU Compute Utilization
HBM Bandwidth
Attention Kernel 时间
KV Cache 写入量
如果输入长度增加 2 倍:
TTFT 约增加 2 倍:线性项主导
TTFT 超过 2 倍:Attention、带宽或调度开始显著影响
16.2 固定长度,改变 Prefill Batch
例如:
Batch = 1、2、4、8、16
观察总 Input TPS、单请求 TTFT、GPU 算力利用率、HBM 带宽利用率和 KV Cache 使用率。
16.3 混合 Prefill 与 Decode
不要只测纯 Prefill。线上需要测试:
已有 Decode 请求 + 新长 Prompt
短 Prompt + 长 Prompt
短输出 + 长输出
流量突发 + 长上下文
重点观察:
Decode TPOT P95/P99
Prefill TTFT P95/P99
Queue Time
Chunked Prefill 是否有效
17. 常见错误理解
错误一:70B 模型处理 4k token 就只需要 560 TFLOPs
不完整。560 TFLOPs 主要是线性层估算,还要加 Attention、Norm、激活、Softmax 和其他操作。
错误二:Attention 一定就是 L × N² × Hidden
这是量级公式。严格计算需要考虑 QKᵀ 和 AV 两次矩阵乘法、FLOPs 计数口径、causal mask 和实际 Kernel。
错误三:Causal mask 一定让 Attention FLOPs 减半
不一定。逻辑上只有约一半位置有效,但实现可能为了规则 Tile 仍计算部分无效区域。要看 Kernel 和 Profiler。
错误四:Prefill 越多,GPU 利用率越高,服务就越好
不一定。Prefill 过多可能让 Decode 失去执行机会,导致 TPOT、TTFT 和 P99 恶化。
错误五:Chunked Prefill 会减少总计算量
它主要改善调度和尾延迟,不会改变输入 token 总数对应的主要 FLOPs。
18. 一页式计算模板
输入参数
P:模型参数量
N:输入 token 数
L:层数
d_model:Hidden Size
Hkv:KV Head 数
d_head:Head Dim
b:KV dtype 每元素字节数
计算公式
1. 线性层主项
F_linear ≈ 2PN

2. Attention 全矩阵上界
F_attention_full ≈ 4LN²d_model

3. Attention causal 理想区域
F_attention_causal ≈ 2LN²d_model

4. 单 token KV Cache
K_token = 2LHkv d_head b

5. Prefill KV 写入
D_KV_write = N × K_token

6. 粗略总 FLOPs
F_total ≈ F_linear + F_attention + 其他开销
判断步骤
1. 先算 2PN,确定参数相关主项。
2. 再算 4LN²d_model,判断 Attention 是否已经显著。
3. 对比 N=4k、32k 或业务 P99,确认平方项增长。
4. 计算 KV 写入,确认 Prefill 是否会压满显存池。
5. 用有效 FLOPS 估算 TTFT 下界。
6. 用真实混合流量压测验证调度和尾延迟。
19. 最终总结
Prefill 的核心计算可以拆成两部分:
线性层和 MLP:
≈ 2 × P × N
随输入长度 N 线性增长

Attention:
≈ 4 × L × N² × d_model
全矩阵上界,随输入长度 N² 增长
以 70B、4,000 token 为例:
线性层:约 560 TFLOPs
Attention 全矩阵上界:约 41.9 TFLOPs
当上下文增长到 32k:
线性层:约 4.48 PFLOPs
Attention 全矩阵上界:约 2.68 PFLOPs
因此 Prefill 优化不能只看 GPU 算力,还要同时考虑输入长度、Attention 平方项、KV Cache 写入、Padding 浪费、Prefill Batch、Chunked Prefill,以及 Prefill 与 Decode 的调度冲突。
真正可落地的目标,是让有效 token 尽量组成高效矩阵计算,减少无效 Prompt 和 Padding,控制长上下文的平方级 Attention 成本,并避免 Prefill 长时间阻塞 Decode。
阅读导航



