
大模型推理性能估算:显存、吞吐与容量规划
大模型推理性能估算:显存、吞吐与容量规划
本文目标是建立一套可用于实际工作的框架:面对一个模型、一组 GPU、一个业务流量目标,你能够计算显存、并发、吞吐、延迟、实例数和成本,并知道每个优化手段解决的到底是什么问题。
推理优化并不是单纯让模型“更快”。它是在质量、延迟、吞吐、显存、稳定性和成本之间做工程权衡。
🎨
这份文档中的内容,如果都能吃透,那大模型推理优化,可以说基本算入门了。
先建立正确的全局模型
一次 LLM 请求通常经历下面的过程:
【用户端】
    ↓ HTTP(SSE)/gRPC流式请求
【网关层】
    ├─ 身份鉴权(API Key / JWT)
    ├─ 限流控制(RPM、TPM、租户额度)
    ├─ 请求路由、负载均衡
    └─ 请求参数校验(非法参数提前拦截)
    ↓
【请求排队层】
    ├─ 全局请求队列缓冲
    └─ 队列长度监控,超出阈值拒绝429
    ↓
【推理引擎前端】
    ├─ Tokenize:原始文本 → Token ID列表
    ├─ 上下文长度校验(prompt + max_new_tokens)
    ↓
【Scheduler调度器(vLLM/SGLang核心)】
    ├─ 纳入批处理队列、动态Batch合并
    ├─ 预分配KV Cache内存页(PagedAttention)
    ↓
【GPU计算流程】
    ├ ① Prefill阶段
    │    - 完整Prompt并行Attention计算
    │    - 生成初始KV Cache存入显存
    │    - 产出第一个token(TTFT计时终点)
    │    ↓流式返回首段内容
    ├ ② Decode循环阶段(多次迭代)
    │    - 复用历史KV Cache,只推理最新1个token
    │    - 不断追加KV缓存
    │    - 持续流式推送token(TPOT持续采集)
    │    └─ 循环直到命中停止条件
    ↓
【会话资源回收】
    ├─ 释放当前会话所有KV Cache显存页面 ⭐关键
    ├─ 释放临时激活张量、输入缓冲区
    └─ 记录全链路指标,上报监控系统
其中最重要的是两个模型计算阶段:
| 阶段 | 做什么 | 用户感知 | 主要瓶颈 |
|---|---|---|---|
| Prefill | 一次性读取整个输入 Prompt,生成首个 token 前的计算 | 首 token 延迟 TTFT | 算力、Attention 计算 |
| Decode | 每次只生成一个新 token,循环执行 | 输出速度 TPOT / TPS | 显存带宽、KV Cache、调度 |
| 一句话概括: |
- 输入很长时,Prefill 往往是主要问题。
- 输出很长、并发很高时,Decode 往往是主要问题。
- 长上下文和高并发时,KV Cache 往往决定服务是否能跑起来。
- 线上真正决定体验的是排队时间、TTFT 和每 token 延迟,而不只是 GPU 利用率。
推理性能的核心指标
不要只看“RPS”或“tokens/s”。LLM 是流式生成服务,至少需要同时看以下指标。
| 指标 | 含义 | 重要原因 |
|---|---|---|
| RPS | 每秒完成请求数/每秒请求数(没有特别严格的定义) | 业务入口流量 |
| Input TPS | 每秒处理的输入 token 数 | 衡量 Prefill 压力 |
| Output TPS | 每秒生成的输出 token 数 | 衡量 Decode 吞吐 |
| RPM/TPM | 每分钟请求数/每分钟token数,其实RPM/TPM比RPS /TPS更常用 | |
| TTFT | Time To First Token,首 token 时间 | 用户是否感觉“响应快” |
| TPOT | Time Per Output Token,后续每 token 延迟 | 流式输出是否顺滑 |
| E2E Latency | 从请求开始到生成结束 | 完整任务体验 |
| Queue Time | 请求进入推理引擎前的等待时间 | 容量不足最早出现的信号 |
| Active Sequences | 正在生成或占用 KV Cache 的请求数 | 并发与显存核心指标 |
| KV Cache Usage | KV Cache 已使用显存比例 | 决定 OOM 和排队风险 |
| P50 / P95 / P99 | 延迟分位数 | P99 才能说明高峰是否稳定 |
| 核心关系如下: |
E2E 延迟 = 排队时间 + TTFT + 输出 token 数 × TPOT
例如:
排队:0.2 秒
TTFT:0.8 秒
输出:400 token
TPOT:25 ms = 0.025 秒

E2E = 0.2 + 0.8 + 400 × 0.025
    = 11 秒
即使 TTFT 只有 0.8 秒,只要生成 400 个 token,TPOT 仍然会主导总耗时。
第一步:把业务负载转化为可计算的参数
优化前先明确工作负载。不同业务的优化方向可能完全不同。
需要收集:
峰值 RPS
平均 RPS
输入 token 的均值、P95、P99、P50
输出 token 的均值、P95、P99、P50
最大上下文长度
SLO:TTFT、TPOT、E2E 的 P95/P99 目标
是否流式输出
是否存在共享系统 Prompt
是否使用 RAG、多轮对话、工具调用
是否有突发流量
假设业务数据为:
峰值 RPS:100
平均输入:1,200 token
P95 输入:6,000 token
平均输出:300 token
P95 输出:1,000 token
TTFT P95 目标:< 2 秒
TPOT P95 目标:< 50 ms
先换算 token 吞吐需求:
输入 TPS = RPS × 平均输入 token
         = 100 × 1,200
         = 120,000 input tokens/s

输出 TPS = RPS × 平均输出 token
         = 100 × 300
         = 30,000 output tokens/s
这两个数字必须分开看。因为输入吞吐主要消耗 Prefill 算力,输出吞吐主要消耗 Decode 带宽和 KV Cache。
第二步:计算模型权重显存
模型权重通常是第一块固定显存成本。
公式:
权重显存 = 参数量 × 每参数字节数
常见精度:
| 精度 | 每参数字节数 | 70B 模型权重显存 |
|---|---|---|
| FP32 | 4 Bytes | 280 GB |
| BF16 / FP16 | 2 Bytes | 140 GB |
| FP8 | 1 Byte | 70 GB |
| INT8 | 1 Byte | 70 GB |
| INT4 | 0.5 Byte | 35 GB |
| 例如,70B BF16 模型: |
70 × 10^9 × 2 Bytes
= 140 GB
注意,这只是权重本身。实际运行显存还包括:
模型权重
+ KV Cache
+ CUDA Graph 预留
+ Attention / GEMM Workspace
+ 通信 Buffer
+ CUDA Runtime
+ 显存碎片
因此不能因为“模型理论上刚好放得下”就认为能够上线。
例如一张 80GB H100,不能部署 70B BF16 单卡模型:
权重:140GB
GPU 显存:80GB
即使使用两张卡:
140GB / 2 = 70GB / GPU
每卡只剩约 10GB,几乎没有空间留给 KV Cache 和运行时 Buffer,实际服务能力会很差。
第三步:理解 KV Cache,它是推理服务的关键
在自回归生成中,模型每生成一个 token,都需要注意力机制“看到”之前的 token。
🎹
如果每一步都重新计算历史 token,计算量会无法接受。因此系统会把每层 Attention 的 Key 和 Value 缓存下来,这就是 KV Cache。
KV Cache 的特点:
- 随上下文长度线性增长。
- 随并发请求数线性增长。
- 随模型层数线性增长。
- 它通常占据推理服务中最大的可变显存。
- 它决定最大并发和最大上下文长度。
KV Cache 单 token 显存公式:
KV Cache / token
= Layer 数
× 2
× KV Head 数
× Head Dim
× 每元素字节数
其中:
2代表 Key 和 Value。- KV Head 数不是 Attention Head 数。使用 GQA/MQA 的模型,KV Head 通常更少。
- BF16 / FP16 每元素是 2 Bytes。
- FP8 KV Cache 每元素通常可按 1 Byte 估算,但需验证质量。
完整公式:
KV Cache 总显存
= batch_size
× sequence_length
× layer_num
× 2
× kv_heads
× head_dim
× bytes_per_element
KV Cache 示例:Llama 类 70B 模型
假设模型配置:
层数 L = 80
KV Heads = 8
Head Dim = 128
KV 精度 = BF16 = 2 Bytes
单 token KV Cache:
80 × 2 × 8 × 128 × 2
= 327,680 Bytes
≈ 320 KB
也就是说,一个 token 的 KV Cache 就约为 320KB。
若一个请求的上下文加输出总长度为 8,000 token:
8,000 × 320 KB
≈ 2.5 GB
若同时有 32 个这样的请求:
32 × 2.5 GB
= 80 GB
这还是整个模型的 KV Cache 总量,不包括权重和运行时开销。
🎉
这解释了一个常见现象:
模型能够成功启动,但一提高并发或处理长文本就 OOM。
模型“能加载”不等于“能服务”。
GQA、MQA 为什么对推理很重要
传统 Multi-Head Attention 中,每个 Query Head 都有对应的 Key/Value Head。
- GQA,Grouped Query Attention,允许多个 Query Head 共享一组 KV Head。
- MQA,Multi-Query Attention,则让所有 Query Head 共享一个 KV Head。
| Attention 类型 | KV Head 数 | KV Cache 大小 |
|-|-|-|
| MHA | 接近 Query Head 数 | 最大 |
| GQA | 少于 Query Head 数 | 明显降低 |
| MQA | 1 | 最小 |
假设 Query Heads 为 64:
MHA:KV Heads = 64
GQA:KV Heads = 8
MQA:KV Heads = 1
在其他条件相同的情况下:
GQA 的 KV Cache 约为 MHA 的 1/8
MQA 的 KV Cache 约为 MHA 的 1/64
📍
因此,推理模型的架构参数不能只看总参数量。两个同样是 70B 的模型,KV Head 数不同,实际可支持的并发可能相差数倍。
如何计算最大并发
先计算可用于 KV Cache 的显存:
KV 可用显存
= GPU 总显存
- 权重显存
- Runtime 预留
- 通信和 Workspace
- 安全冗余
假设:
4 × H100 80GB
70B FP8 权重
Tensor Parallel = 4
每张卡上的权重:
70GB / 4
= 17.5GB
假设每卡预留:
Runtime + CUDA Graph + Workspace + 冗余 = 12GB
则每卡可用于 KV Cache:
80 - 17.5 - 12
= 50.5GB
因为 KV Cache 按 Tensor Parallel 分片,单卡 KV Cache 容量约为:
50.5GB
前面计算过,完整模型每 token KV Cache 为约 320KB。4 卡 TP 下,每卡约承担:
320KB / 4
= 80KB / token
因此每卡最多能保存的 token 位置:
50.5GB / 80KB
≈ 660,000 token positions
如果平均每个活跃请求占用 8,000 token:
660,000 / 8,000
≈ 82 个请求
理论最大并发约为 82。
实际生产环境不能按 82 配置,通常会留出额外余量,应使用:
实际安全并发 = 理论最大并发 × 0.6 ~ 0.8
例如:
82 × 0.7 ≈ 57
🏖️
因此可以先将 max_num_seqs 设为 48 或 56,再通过压测验证。
Prefill 和 Decode 的本质差异
8.1 Prefill:一次处理整个输入
Prefill 阶段会把用户输入的 Prompt 一次性送入模型,并构建 KV Cache。
对于参数量为 P 的模型,长度为 N 的输入,线性层计算量可粗略估算为:
Prefill FLOPs ≈ 2 × P × N
主要用于单个token内部特征映射(FFN/QKV)
例如 70B 模型处理 4,000 token:
2 × 70B × 4,000
= 560 TFLOPs
此外,Attention 还会产生与序列长度平方相关的计算:
Attention FLOPs ≈ Layer 数 × Sequence Length² × Hidden Size
主要用于token之间两两相似度匹配,注意力交互计算。
所以 Prompt 特别长时,Attention 成本会显著增加。
Prefill 的典型特点:
- 能将大量 token 组成矩阵计算。
- GPU 容易获得较高算力利用率。
- 对长输入非常敏感。
- Prefill 过多会挤占 Decode 资源,导致在线请求输出卡顿。
8.2 Decode:一次只生成一个 token
Decode 是循环过程:
输入历史上下文
-> 生成 1 个 token
-> 将新 token 写入 KV Cache
-> 再生成下一个 token
线性层计算可粗略写为:
Decode FLOPs / token ≈ 2 × 参数量
70B 模型每生成一个 token:
2 × 70B
= 140 GFLOPs / token
📌
但是 Decode 的真正瓶颈经常不是算力,而是显存带宽。
原因是每生成一个 token,都需要读取大量模型权重和历史 KV Cache;但每次真正计算的 token 数只有一个,矩阵乘法不够“饱和”。
这就是为什么:
- GPU 的理论 FLOPS 很高。
- 但单用户生成速度可能只有几十 token/s。
- 增加并发和 Continuous Batching 后,整体吞吐会提高很多。
Decode 阶段的带宽估算
一个粗略但很有用的下界:
Decode tokens/s 上限
≈ 显存带宽 / 每 token 需要读取的数据量
在 batch 很小的情况下,每生成一个 token 都需要读取大部分模型权重。
假设:
模型权重:70GB
GPU HBM 带宽:3TB/s
理想化上限:
3,000GB/s / 70GB
≈ 42.8 token/s
这不是实际可承诺值,因为真实系统还会受到:Kernel 效率、KV Cache 读取、通信开销、显存碎片、调度开销、采样开销、网络传输影响。
但它能帮助你理解一个关键事实:
🎉
Decode 优化的核心,常常是提高“每次读权重时服务的 token 数”,也就是通过 batching 增加复用,而不是单纯追求更高峰值 FLOPS。
详见:
Batching:吞吐优化的核心手段
10.1 静态 Batch
静态 Batch 指先凑齐固定数量请求,再一起执行。
例如:
每次收集 16 个请求
统一执行 Prefill 或 Decode
优点:
- 实现简单。
- 硬件利用率较高。
缺点: - 必须等最慢请求完成。
- 短请求会被长请求拖住。
- 流式输出体验差。
- 请求长度差异大时,Padding 浪费严重。
不适合通用在线 LLM 服务。
10.2 动态 Batch
动态 Batch 会在一个很短的等待窗口中,将新到请求合并执行。
例如:
最长等待 10ms
最多合并 32 个请求
它在吞吐和延迟之间折中:
等待窗口越大:
吞吐通常越高
TTFT 通常越差
适合请求长度相对接近的服务。
10.3 Continuous Batching
Continuous Batching,也叫 Iteration-level Scheduling,是当前主流 LLM Serving 的关键技术。
其思想是:每轮 Decode 都重新调度。
第 1 轮:A、B、C 一起生成
第 2 轮:A 完成,D 新加入,B、C、D 一起生成
第 3 轮:B、C、D、E 一起生成
不会像静态 Batch 一样等待所有请求结束。
收益:
- 请求完成后立即释放 slot。
- 新请求能够快速插入。
- 低延迟和高吞吐可以同时兼顾。
- 特别适合流式输出和请求长度差异大的场景。
vLLM、SGLang、TensorRT-LLM 等推理框架都围绕这一思想构建调度器。
Prefill 与 Decode 的调度冲突
Prefill 通常需要大计算量,Decode 需要低延迟。
如果系统把大量长 Prompt 的 Prefill 和在线 Decode 混在一起,可能出现:
长 Prompt 大量进入
-> GPU 花时间 Prefill
-> 正在生成的请求无法及时 Decode
-> TPOT 上升
-> 用户看到输出开始卡顿
因此,线上系统通常需要为 Prefill 设置限制。
常见控制参数:
| 参数 | 作用 |
|---|---|
| max_num_batched_tokens | 单轮最多处理的 token 总量 |
| max_num_seqs | 同时活跃请求上限 |
| Prefill Token Budget | 每轮允许进入的 Prefill token 上限 |
| Chunked Prefill | 将超长 Prompt 切分多轮处理 |
| Priority Queue | 给 Decode 或高优先级请求更高调度优先级 |
Chunked Prefill
对于 100k token 的超长输入,如果一次性 Prefill:
请求 A:100k token Prefill
请求 B:正常在线聊天请求
请求 B 的 Decode 很可能被 A 阻塞。
Chunked Prefill 会将 A 切成小块:
A:每次处理 2k 或 4k token
中间穿插 B、C、D 的 Decode
优点:
- 避免长请求独占 GPU。
- 改善 TPOT 和尾延迟。
- 适合 RAG、长文档分析、代码库问答。
代价: - 调度更复杂。
- 纯 Prefill 的总吞吐可能略有下降。
- Chunk 太小可能带来额外调度开销。
Paged Attention:解决 KV Cache 碎片问题
传统 KV Cache 分配通常要求为每个请求预留连续显存。
假设最大长度是 8k token:
请求 A 实际用了 500 token
请求 B 实际用了 1,000 token
请求 C 实际用了 6,000 token
如果按最大长度预分配,会浪费大量显存。
Paged Attention 将 KV Cache 切成固定大小的 Block,例如:
每个 Block = 16 token
请求增长时再按需申请 Block:
请求 A:申请 32 个 Block
请求 B:申请 63 个 Block
请求 C:申请 375 个 Block
它类似操作系统的分页内存管理。
收益:
- 按实际 token 数分配 KV Cache。
- 显著减少显存浪费。
- 请求结束后可立即回收 Block。
- 能提高高并发场景下的有效容量。
- 有利于 Prefix Cache 复用。
需要注意: - Block 太小,元数据和管理开销更高。
- Block 太大,内部碎片会增加。
- 实际大小一般由框架和模型特征决定。
Prefix Cache:系统 Prompt 的高价值优化
很多业务请求都有共享前缀,例如:
系统提示词
+ 产品规则
+ 工具定义
+ RAG 模板
+ 用户问题
若每次请求都重复计算前面的系统提示词,Prefill 会被重复浪费。
Prefix Cache 的目标是复用已计算好的 KV Cache。
共享 Prefix
-> 已经计算过 KV Cache
-> 后续请求直接复用
-> 只计算新增加的用户内容
假设:
共享系统 Prompt:3,000 token
每秒请求:20
没有 Prefix Cache 时:
20 × 3,000 = 60,000 input tokens/s
若 Prefix 命中率 80%,则可避免约:60,000 × 80% = 48,000 input tokens/s 的重复 Prefill。
Prefix Cache 最适合:
- 客服机器人。
- 有固定系统 Prompt 的 Agent。
- 大量共享工具定义的服务。
- 多轮对话。
- 同一份文档被多个用户查询。
- 代码仓库问答。
只有“真正共享且顺序一致”的前缀才容易命中。若每个请求都动态拼接时间、随机 ID、不同工具定义,会破坏缓存命中率。
模型量化:最直接的显存与成本优化
量化是将模型权重、激活或 KV Cache 用更低位宽表示。
主要目标:
- 降低权重显存
- 降低显存带宽压力
- 提升模型装载密度
- 减少 GPU 数量
- 降低单位 token 成本
常见推理精度:
| 精度 | 权重显存 | 通常质量风险 | 常见用途 |
|-|-|-|-|
| BF16 / FP16 | 高 | 最低 | 高质量基线 |
| FP8 | 中 | 通常较低 | 高性能生产推理 |
| INT8 | 中 | 低到中 | 通用部署 |
| INT4 | 低 | 中到高 | 成本敏感服务 |
| AWQ / GPTQ | 通常 INT4 | 依赖模型与任务 | GPU 量化部署 |
| SmoothQuant | INT8 路线 | 依赖校准 | 激活量化场景 |
量化不是“位宽越低越好”。
需要评估:
通用问答质量
数学与代码能力
结构化输出正确率
工具调用成功率
长文本摘要质量
中文和多语言能力
拒答与安全行为
格式遵循能力
一个非常常见的错误是:
只比较 benchmark 分数
不比较真实业务任务
例如,INT4 模型在通用问答上可能表现正常,但在 JSON 输出、函数调用、复杂推理或长上下文任务上明显退化。
正确做法是建立业务评测集:
输入样本
+ 预期输出或判分规则
+ 多种量化版本
+ 质量、TTFT、TPOT、成本对比
KV Cache 量化
除了权重量化,KV Cache 也可以量化。
常见配置:
BF16 KV Cache:2 Bytes / element
FP8 KV Cache:1 Byte / element
INT8 KV Cache:1 Byte / element
理论上:
FP8 KV Cache 显存约为 BF16 的 1/2
这对长上下文、高并发特别有价值。
例如:
KV Cache 原本占用 60GB
切换到 FP8 后理论约为 30GB
这部分显存可以用于:
增加并发
支持更长上下文
增加 Prefix Cache 容量
减少 GPU 数
但必须验证:
- 长上下文检索能力是否下降。
- 复杂推理是否变差。
- 是否存在特定模型不稳定。
- 框架和硬件是否真正支持高效实现。
Tensor Parallel:模型太大时如何拆到多卡
Tensor Parallel,TP,将一个层内部的矩阵拆到多张 GPU 上。
适合:
单卡放不下模型
单卡放得下但性能不足
希望通过多卡提升单实例吞吐
例如 70B FP8 权重约 70GB:
TP=1:一张 80GB 卡,运行空间很紧
TP=2:每卡权重约 35GB
TP=4:每卡权重约 17.5GB
TP 的代价是通信。
每层通常需要 All-Reduce 或 All-Gather,因此需要高速互联:
| 互联方式 | 适合程度 |
|---|---|
| NVLink / NVSwitch | 最适合 TP |
| PCIe | 可用,但通信开销更大 |
| 跨机器 InfiniBand | 可用,但需谨慎评估 |
| 普通以太网 | 通常不适合高性能 TP |
🎼
一个重要原则:TP 不一定越大越快。
TP 太大时:单卡计算减少、但通信增加,当通信时间超过节省的计算时间,性能会变差。
经验上:
- 模型能在 2 卡运行,不一定应该拆成 8 卡。
- 优先在同一台 NVLink/NVSwitch 节点内做 TP。
- 跨节点 TP 需要严谨压测。
- 对高 RPS 服务,多个较小副本往往比一个超大 TP 副本更容易扩展和隔离故障。
Pipeline Parallel 与 Data Parallel
Pipeline Parallel,PP
按层切分模型:
GPU 1:Layer 1-20
GPU 2:Layer 21-40
GPU 3:Layer 41-60
GPU 4:Layer 61-80
优点:
- 每张卡只存一部分层。
- 能部署更大的模型。
问题: - 请求需要依次经过多个 GPU。
- 单请求延迟可能较高。
- Pipeline Bubble 会影响利用率。
- 在线低延迟场景通常不如 TP 常见。
Data Parallel,DP
部署多个完整推理副本:
Replica 1
Replica 2
Replica 3
Replica 4
请求通过负载均衡分发。
优点:
- 横向扩展简单。
- 某个副本异常时可隔离。
- 无需每层跨卡通信。
- 很适合高 RPS 在线服务。
实际常见组合:
单个副本内部:TP = 2 / 4 / 8
多个副本之间:DP = N
例如:
8 GPU 节点
每副本 TP=4
一台机器可运行 2 个模型副本
Speculative Decoding:降低生成时间
自回归模型一次通常只能生成一个 token。Speculative Decoding 的思路是:
- 小模型先快速猜多个 token
- 大模型一次验证这些 token
- 验证通过的 token 直接接受
流程:
- Draft Model:预测 k 个 token
- Target Model:并行验证这 k 个 token
- 接受正确部分
- 继续下一轮
如果平均每轮可接受a个 token,则大模型实际迭代次数约减少为:原迭代次数 / a
例如输出 400 token:
普通 Decode:约 400 次大模型迭代
Speculative Decode:平均每轮接受 3 token
约需 133 次大模型迭代
适合:
- 输出较长。
- Decode 为主要瓶颈。
- 有高质量小模型或 draft 模型。
- 用户接受一定工程复杂度。
不适合或收益有限: - 输出很短。
- Draft 模型质量很差,接受率低。
- 请求主要是超长 Prompt,瓶颈在 Prefill。
- 业务质量要求极高但 draft/tokenizer 不匹配。
关键指标:
Acceptance Rate
= 被主模型接受的 Draft Token 数
/ Draft Token 总数
接受率越高,收益通常越大。
输出长度控制:最低成本、最常被忽略的优化
输出 token 是最昂贵的部分之一,因为它会持续占用:
GPU Decode 时间
KV Cache
网络连接
调度 slot
用户等待时间
输出长度的影响是线性的:
E2E 增量 = 额外输出 token × TPOT
假设:
TPOT = 30ms
多输出 500 token:
500 × 30ms = 15 秒
优化方法:
- 为不同任务设置合理的
max_tokens。 - 要求“先给结论,再给必要解释”。
- JSON、函数调用、分类任务使用结构化短输出。
- 摘要任务限制字数、段落数或要点数量。
- 多步骤 Agent 不要让每一步写冗长自然语言。
- 对明显无效的长回复设置截断和停止词。
但不能粗暴压低max_tokens。应依据真实任务统计:
平均输出长度
P95 输出长度
被 max_tokens 截断的比例
因输出不足而失败的比例
目标是消除无效冗余,而不是牺牲任务完成率。
长上下文优化:不能只把 max model len 调大
配置 128k 或 1M 上下文,并不意味着服务真正能稳定支持。
长上下文会同时放大:
KV Cache 显存
Prefill 时间
Attention 计算
排队时间
单请求资源占用
尾延迟
假设每 token KV Cache 为 320KB:
| 上下文长度 | 单请求 KV Cache |
|---|---|
| 4k | 1.25GB |
| 8k | 2.5GB |
| 32k | 10GB |
| 128k | 40GB |
| 对于高并发服务,不能把所有用户都允许使用最大上下文。 |
更合理的策略:
短上下文请求:低价、高并发、低延迟集群
长上下文请求:独立队列或独立集群
超长文档任务:异步任务化
常见优化:
- RAG 只检索最相关片段,不把整库塞进 Prompt。
- 对历史对话做摘要。
- 限制工具调用历史。
- 将大文档分块、分层摘要。
- 使用 Prefix Cache 复用公共上下文。
- 设置每用户或每租户的上下文配额。
- 使用 Chunked Prefill 防止长请求阻塞在线请求。
注意力和 Kernel 优化
这部分通常由推理框架实现,但 Infra 工程师需要理解它解决什么问题。
FlashAttention
传统 Attention 会显式构造一个巨大的 Attention Score 矩阵:
Sequence Length × Sequence Length
长序列时显存访问和中间结果都很大。
FlashAttention 通过分块计算、减少 HBM 读写,避免大量中间矩阵物化。
它主要带来以下收益:
- Prefill 更快。
- 长上下文 Attention 更高效。
- 临时显存更少。
- GPU 利用率更高。
✍️
需要注意:FlashAttention 不会减少最终 KV Cache 的存储量。
它优化的是 Attention 计算与中间访存,不是缓存本身。
Fused Kernel
推理中的许多小操作如果分别启动 Kernel,会产生额外开销。
例如:
Bias
+ Activation
+ RMSNorm
+ RoPE
+ Sampling
Fused Kernel 将多个操作合并,减少:
Kernel Launch Overhead
中间显存读写
CPU-GPU 同步
Decode 尤其受益,因为 Decode 每次只处理少量 token,小 Kernel 开销相对更明显。
推理框架参数应该如何调
不同框架参数名不同,但核心含义接近。
| 参数类型 | 作用 | 调大后的收益 | 调大后的风险 |
|---|---|---|---|
| GPU Memory Utilization | 允许 KV Cache 使用的显存比例 | 更高并发 | OOM 风险上升 |
| Max Num Seqs | 最大活跃请求数 | 更高并发 | TPOT 变差、KV 不足 |
| Max Num Batched Tokens | 单轮 token 预算 | Prefill 吞吐提高 | Decode 被挤压 |
| Max Model Len | 最大上下文 | 支持长请求 | KV 显存增长 |
| Tensor Parallel Size | 单副本 GPU 数 | 可部署大模型 | 通信开销增加 |
| Block Size | Paged KV Block 大小 | 管理开销降低 | 内部碎片增加 |
| Prefix Cache | 是否启用前缀复用 | 降低 Prefill | 占用缓存资源 |
| Chunked Prefill | 是否切分长 Prompt | 改善 TPOT | 调度复杂度增加 |
| 一个推荐调参顺序: |
- 先确定模型、精度、TP 大小,确保模型稳定运行。
- 根据显存计算设置最大上下文长度。
- 预留 10% 到 20% 显存,不要一开始将显存利用率顶满。
- 打开 Continuous Batching 和 Paged KV Cache。
- 压测逐步提高
max_num_seqs。 - 观察 TPOT P95/P99 是否超标。
- 调整
max_num_batched_tokens,平衡 Prefill 与 Decode。 - 对长 Prompt 场景启用 Chunked Prefill。
- 对共享 Prompt 场景启用 Prefix Cache。
- 用真实业务样本验证质量、稳定性和成本。
如何定位推理服务的瓶颈
不要看到“慢”就盲目加 GPU。先分类。
| 现象 | 常见原因 | 优先检查 |
|---|---|---|
| TTFT 高,TPOT 正常 | 排队或 Prefill 慢 | 长 Prompt、batch token budget、Prefix Cache |
| TTFT 正常,TPOT 高 | Decode 拥塞 | 并发过高、显存带宽、TP 通信 |
| P99 比 P50 高很多 | 长请求阻塞、排队、显存接近满载 | 请求长度分布、Chunked Prefill、队列 |
| GPU 利用率低但延迟高 | batch 太小、CPU/网络瓶颈、调度低效 | 活跃序列、tokenizer、网关 |
| GPU 利用率很高且 TTFT/TPOT 都变差 | 容量不足 | 加副本、限流、扩容 |
| 经常 OOM | KV Cache 超限或显存碎片 | max_num_seqs、max_model_len、KV 精度 |
| RPS 看似不高但服务卡住 | 每个请求很长、输出很长 | Input/Output TPS,而不是只看 RPS |
| 某些请求特别慢 | 上下文 P99 太大 | 长短请求隔离、配额、异步化 |
| 一个实用判断方法: | ||
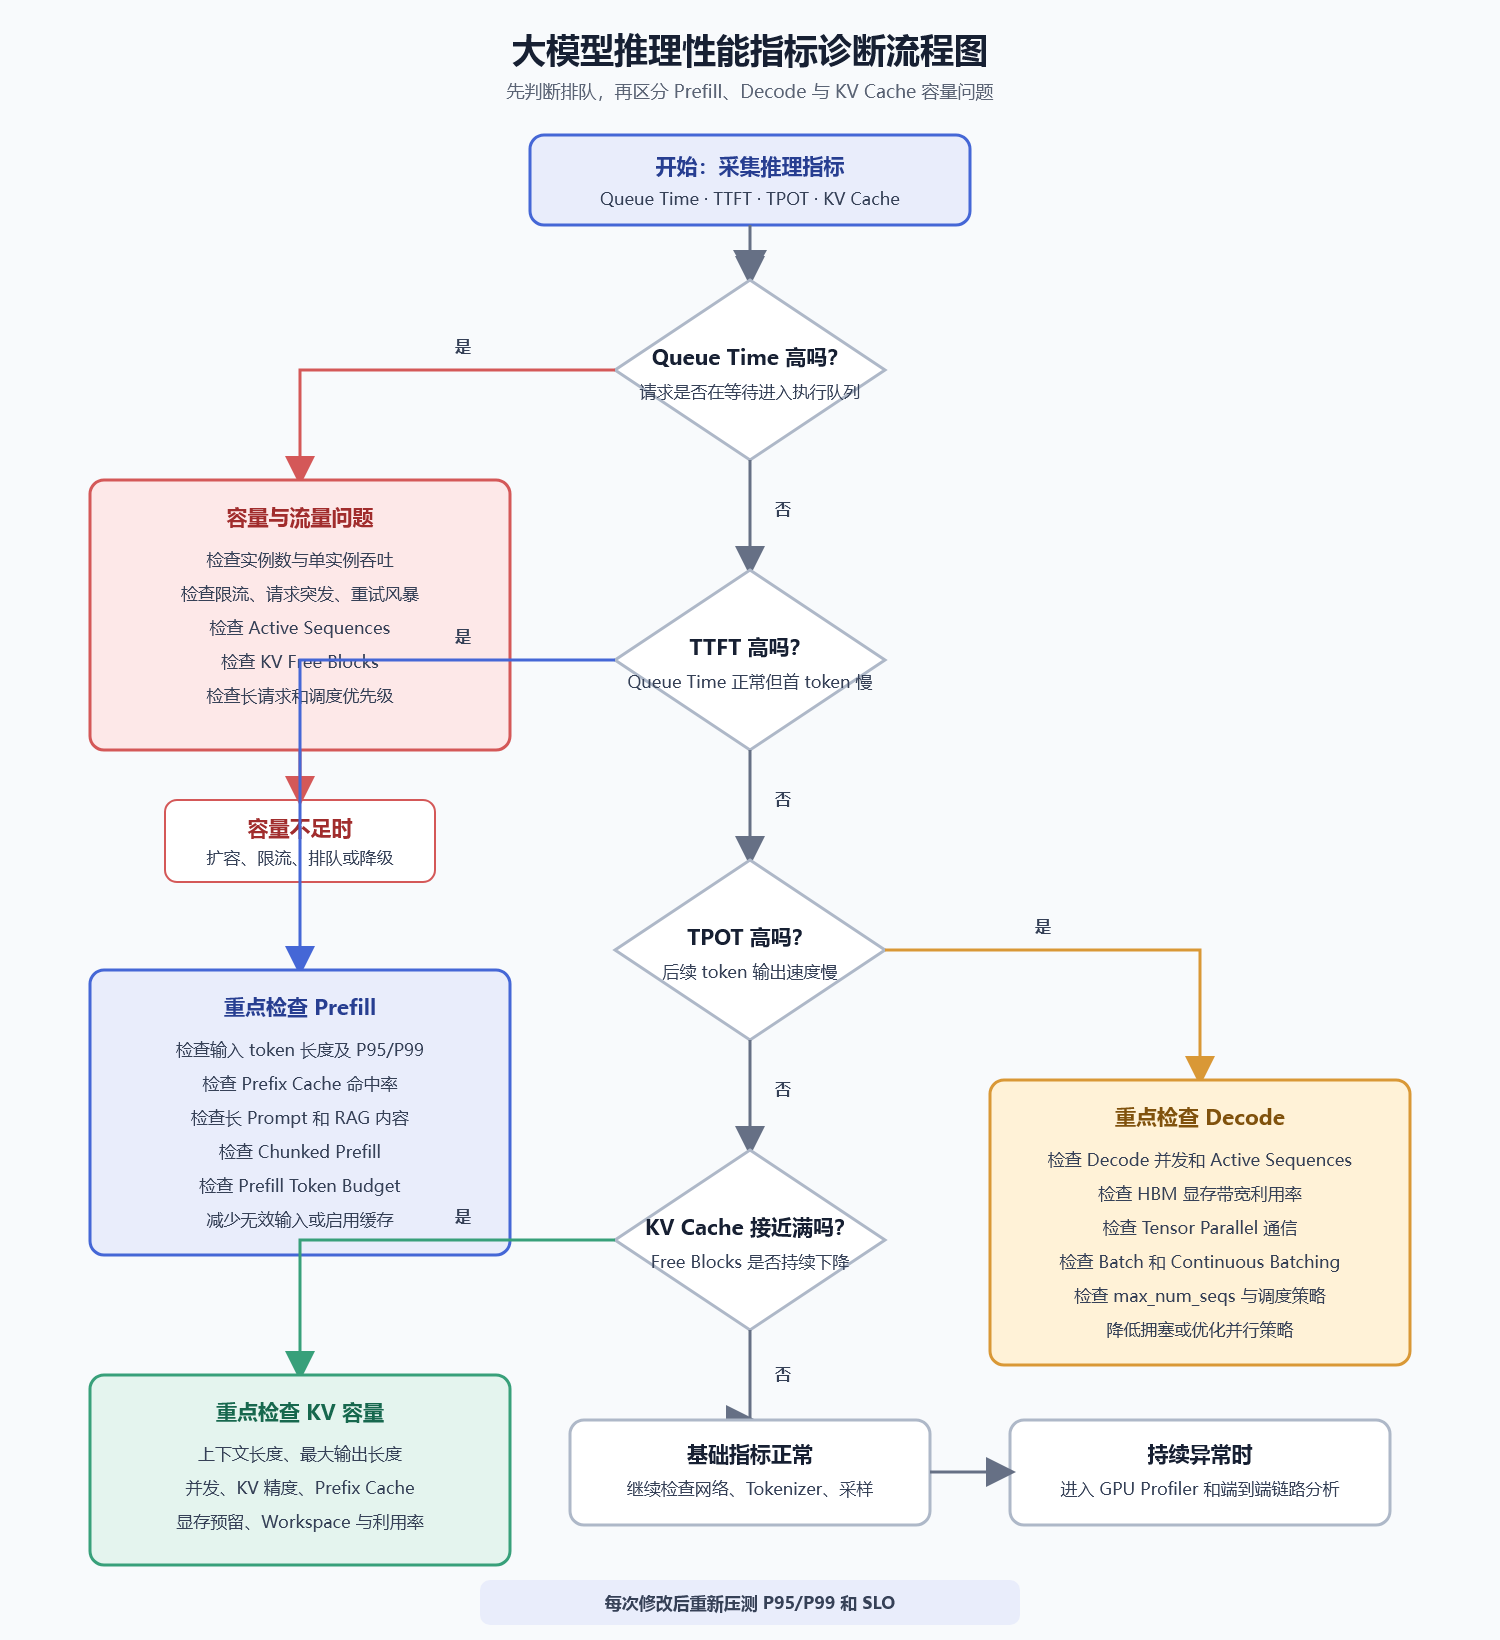 |
容量规划:从流量计算实例数
实例数不能只按平均 RPS 计算。至少要同时满足吞吐、并发和显存三个约束。
24.1 吞吐约束
所需实例数
= 业务所需 Output TPS / 单实例可提供 Output TPS
假设:
业务目标 Output TPS:30,000
压测得到单实例 Output TPS:10,000
则:
30,000 / 10,000 = 3
至少需要 3 个实例。
24.2 并发约束
根据 Little's Law:
并发数 ≈ RPS × 平均请求停留时间
假设:
峰值 RPS:200
平均请求从开始到结束:0.9 秒
则:
并发 ≈ 200 × 0.9 = 180
如果单实例在 SLO 内最多稳定承载 75 个活跃请求:
180 / 75 = 2.4
至少需要 3 个实例。
24.3 KV Cache 约束
假设单实例安全并发为 60:
业务需要 180 并发
180 / 60 = 3
至少也需要 3 个实例。
24.4 加入冗余
最终实例数:
实例数
= max(
    吞吐约束实例数,
    并发约束实例数,
    KV Cache 约束实例数
  )
× 冗余系数
例如:
吞吐:3
并发:3
KV:3
冗余系数:1.25

最终:ceil(3 × 1.25)
= 4
实际生产中还要考虑:
单实例故障
滚动发布
流量突刺
GPU 性能抖动
缓存失效
长请求异常增长
因此,通常不建议长期运行在 90% 以上容量。
成本计算
最常用成本指标是每百万 token 成本。
公式:
每百万 token 成本
= 每小时实例成本
  / (实例吞吐 tokens/s × 3600)
  × 1,000,000
假设:
单实例成本:$20 / 小时
稳定吞吐:8,000 output tokens/s
则:
每小时输出 token
= 8,000 × 3,600
= 28,800,000 token

每百万 output token 成本
= 20 / 28.8
≈ $0.694
但成本必须区分:
每百万输入 token 成本
每百万输出 token 成本
混合 token 成本
每成功请求成本
每完成业务任务成本
因为输入和输出对系统的压力不同。
例如:
- 输入 token 多,主要消耗 Prefill 资源。
- 输出 token 多,主要消耗 Decode、KV Cache 和连接时间。
- 一个模型虽然每 token 更便宜,但任务成功率更低,实际业务成本可能更高。
一个完整的推理优化案例
假设业务为企业知识库问答:
模型:70B
部署:4 × H100 80GB
精度:FP8 Weight + BF16 KV Cache
峰值 RPS:100
平均输入:4,000 token
平均输出:500 token
P95 输入:12,000 token
TTFT P95 目标:2 秒
TPOT P95 目标:40ms
第一步:计算业务 token 压力
Input TPS
= 100 × 4,000
= 400,000 input tokens/s

Output TPS
= 100 × 500
= 50,000 output tokens/s
这是明显的长 Prompt 业务,Prefill 压力很大。
第二步:识别潜在问题
输入长
-> TTFT 容易变高

RAG 文档重复
-> 有 Prefix Cache 优化空间

输出 500 token
-> Decode 也不能忽略

P95 输入 12k
-> KV Cache 和长尾延迟风险高
第三步:优化策略
1. 开启 Paged KV Cache
2. 开启 Continuous Batching
3. 开启 Chunked Prefill
4. 建立 Prefix Cache
5. 限制每次 RAG 返回文档数量
6. 清洗重复文档和无关文本
7. 对超长请求进入单独队列
8. 设置 max_num_batched_tokens,避免 Prefill 挤压 Decode
9. 对共享系统 Prompt 使用稳定模板
10. 通过压测确定 max_num_seqs
第四步:预期效果逻辑
减少 RAG token
-> Prefill 更快
-> TTFT 降低
-> KV Cache 减少
-> 并发提高

Prefix Cache 命中
-> 避免重复 Prefill
-> 输入 TPS 压力降低

Chunked Prefill
-> 长请求不再长时间阻塞 Decode
-> TPOT P99 降低

Paged KV
-> 减少显存碎片
-> 有效并发提升
压测应该怎么做
推理压测不能只发送固定 Prompt,也不能只看平均值。
压测流量应该尽量接近真实分布:
短输入 + 长输入混合
短输出 + 长输出混合
不同并发梯度
突发流量
流式请求
共享 Prefix 请求
冷启动后的首批请求
缓存命中与缓存失效场景
建议至少执行四类压测。
27.1 单请求基线
目标:
测模型在无排队、无竞争下的性能
记录:
TTFT
TPOT
总生成速度
显存占用
GPU 利用率
27.2 并发爬坡测试
逐步提高并发:
1 -> 2 -> 4 -> 8 -> 16 -> 32 -> 64 ...
观察:
Output TPS
TTFT P95/P99
TPOT P95/P99
Queue Time
KV Cache 使用率
OOM 或请求拒绝率
通常存在一个“甜点区间”:
并发增加时吞吐上升
超过某个点后,TPOT 和 P99 急剧恶化
上线配置应位于拐点之前,而不是峰值吞吐点。
27.3 长短请求混合测试
例如:
80%:1k 输入,200 输出
15%:8k 输入,500 输出
5%:32k 输入,1k 输出
这是检验调度器、Chunked Prefill 和队列隔离是否有效的关键测试。
27.4 故障和容量测试
验证:
一个副本下线
Prefix Cache 清空
GPU 重启
流量突然翻倍
上游重试风暴
超长请求集中进入
目标不是“永远不出问题”,而是确认系统会:
限流
排队
降级
拒绝低优先级请求
自动扩容
快速恢复
而不是直接 OOM 或整体不可用。
线上监控清单
建议将指标分成四类。
用户体验
TTFT P50 / P95 / P99
TPOT P50 / P95 / P99
E2E Latency P50 / P95 / P99
请求成功率
流式连接中断率
负载与调度
RPS
Input TPS
Output TPS
排队请求数
Queue Time
Active Sequences
Prefill / Decode Token 数
请求长度分布
GPU 与显存
GPU Compute Utilization
GPU Memory Utilization
HBM Bandwidth Utilization
KV Cache Usage
KV Cache Block 使用率
OOM 次数
CUDA Error
GPU 温度和功耗
业务与成本
每租户 RPS
每租户 token 使用量
输入 / 输出 token 比例
Prefix Cache Hit Rate
单位请求成本
每百万 token 成本
失败请求成本
最重要的告警通常包括:
TTFT P99 持续超标
TPOT P99 持续超标
Queue Time 快速增长
KV Cache 使用率接近上限
请求拒绝率升高
Prefix Cache 命中率突然下降
单实例吞吐异常下降
GPU Error / OOM
一套实用的优化优先级
通常建议按下面顺序做,不要一开始就进入复杂并行或内核调优。
- 明确真实流量:RPS、输入长度、输出长度、峰值和 P99。
- 建立单请求与并发基线。
- 计算权重和 KV Cache,确认显存边界。
- 使用 Continuous Batching 和 Paged KV Cache。
- 设置合理的最大上下文和最大输出长度。
- 调整
max_num_seqs与 token budget。 - 开启 Chunked Prefill,保护在线 Decode。
- 优化 Prompt、RAG 和输出长度。
- 对共享上下文启用 Prefix Cache。
- 评估 FP8、INT8、INT4 量化。
- 对 Decode 重负载场景评估 Speculative Decoding。
- 用 TP 承载单模型,用 DP 扩展业务流量。
- 做长短请求隔离、租户隔离和优先级调度。
- 用压测结果进行容量规划和成本核算。
最后记住的十个结论
- 模型能加载到 GPU,不代表它能稳定服务并发请求。
- 推理显存中,权重是固定成本,KV Cache 是随并发和上下文增长的可变成本。
- 长上下文的风险不仅是显存,更包括 Prefill、Attention 和尾延迟。
- RPS 不足以描述 LLM 负载,必须同时看 Input TPS 和 Output TPS。
- TTFT 主要受排队和 Prefill 影响,TPOT 主要受 Decode 并发和显存带宽影响。
- Continuous Batching 是在线 LLM 高吞吐服务的基础能力。
- Paged KV Cache 能减少显存碎片,提高有效并发。
- Prefix Cache 是固定 Prompt、Agent 和 RAG 场景中非常高价值的优化。
- 量化必须同时看质量、吞吐、显存和真实业务成功率。
- 实例数必须同时满足吞吐、并发、KV Cache 和故障冗余约束。
阅读导航



