
Decode 显存带宽估算:权重、KV Cache 与 Batch
Decode 阶段显存带宽估算
Decode 阶段的带宽估算,核心不是直接拿 GPU 的 FLOPS 去除以模型参数量,而是回答两个问题:
一次 Decode 迭代需要从显存搬多少字节?
GPU 每秒能够搬多少字节?
最基本的时间下界是:
一次 Decode 时间下界
≈ 一次迭代需要搬运的总字节数 / GPU 的有效显存带宽
因此,单请求、低 Batch 时常用的粗略估算是:
Decode tokens/s 上限
≈ GPU HBM 带宽 / 模型权重显存
例如:
模型权重:70GB
GPU HBM 带宽:3TB/s = 3,000GB/s

Decode tokens/s
≈ 3,000GB/s / 70GB
≈ 42.8 token/s
这个 42.8 token/s 不是模型的实际承诺速度,而是一个“权重读取主导、Batch 很小、只计算权重流量”的理想化上界。真实速度还要扣除 KV Cache、Kernel 效率、通信、调度、采样和网络等开销。
本文将从单位、假设、推导、Batch 复用、KV Cache、Tensor Parallel 和压测方法一步步展开。
1. Decode 到底在搬运什么
一次 Decode 只生成一个新 token,但它并不是只读取几个数字。可以把它想象成一个工厂:当前 token 是一件刚送到流水线的工件,模型权重是每一层都要经过的固定设备,历史 KV Cache 是堆积在仓库里的上下文资料。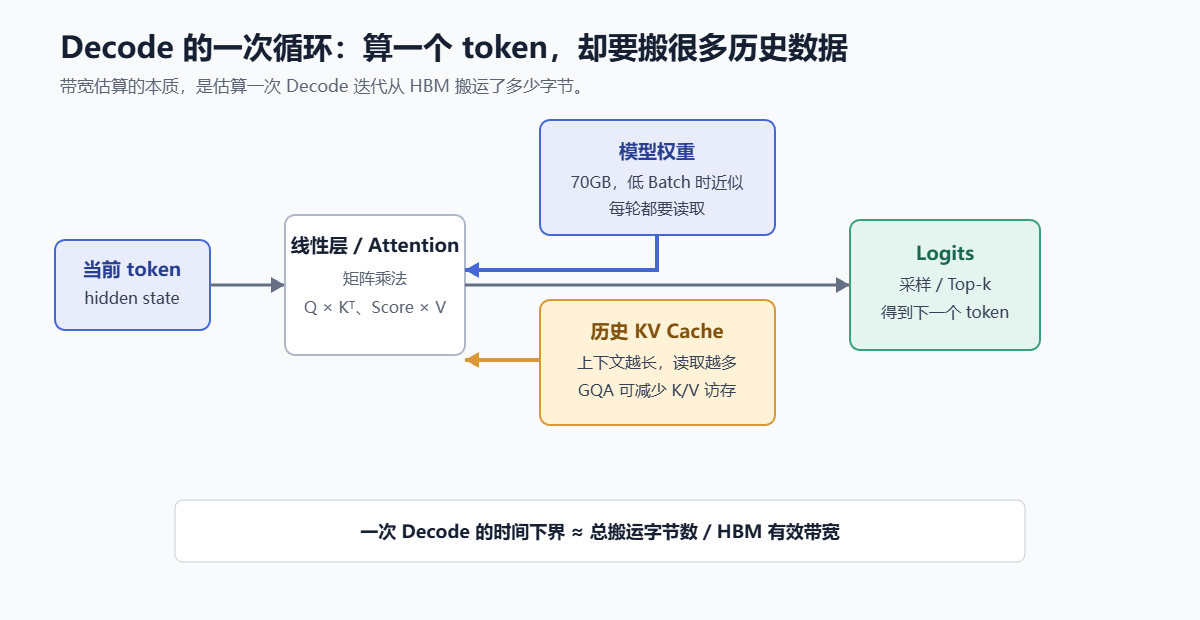
图 1:一次 Decode 迭代需要读取模型权重和历史 KV Cache,经过多层计算后才产生下一个 token。
一次 Decode 迭代的主要显存流量包括:
模型权重读取
历史 KV Cache 读取
当前 token 的 K/V 写入
激活值读写
Attention / GEMM 临时 Workspace
量化 scale、zero point 等元数据读取
通信 Buffer 读写
可以把一次迭代的总数据量记为:
D_step
≈ D_weight
+ D_KV_read
+ D_KV_write
+ D_activation
+ D_workspace
+ D_communication
最简单的 42.8 token/s 估算,只保留了第一项:
D_step ≈ D_weight
所以它只能作为第一层下界判断,不能作为完整性能模型。
2. 先把单位算对
带宽估算最容易犯的错误,是把 GB、GiB、TB、TiB 混在一起。
常见十进制单位:
1 GB = 1,000,000,000 Bytes
1 TB = 1,000 GB
常见二进制单位:
1 GiB = 1,073,741,824 Bytes
1 TiB = 1,024 GiB
如果厂商给出的 HBM 带宽是 3.0 TB/s,模型权重按十进制 70 GB 估算,那么:
3,000GB/s / 70GB = 42.857 次迭代/s
由于每次低 Batch 迭代只为一个序列生成一个 token,所以可以近似写成:
42.857 token/s
如果统一使用二进制单位:
3.0TB/s ≈ 2.728TiB/s
70GB ≈ 65.19GiB
2.728TiB/s / 65.19GiB ≈ 42.85 token/s
两种单位下结果接近。工程上最重要的是前后一致,不要把 3TB/s 和 70GiB 无意识混算。
3. 为什么低 Batch 时几乎要读取完整权重
以一个 Decoder-only 模型为例,它有很多层:
Layer 1 -> Layer 2 -> ... -> Layer N
在低 Batch Decode 中,每一轮只处理一个或很少几个新 token。线性层需要使用各层的权重矩阵,因此这些权重通常无法像大 Batch 那样被充分复用。
可以用下面的近似理解:
Batch = 1:
一次读取约 70GB 权重
服务 1 个 token

Batch = 8:
一次读取约 70GB 权重
服务 8 个 token
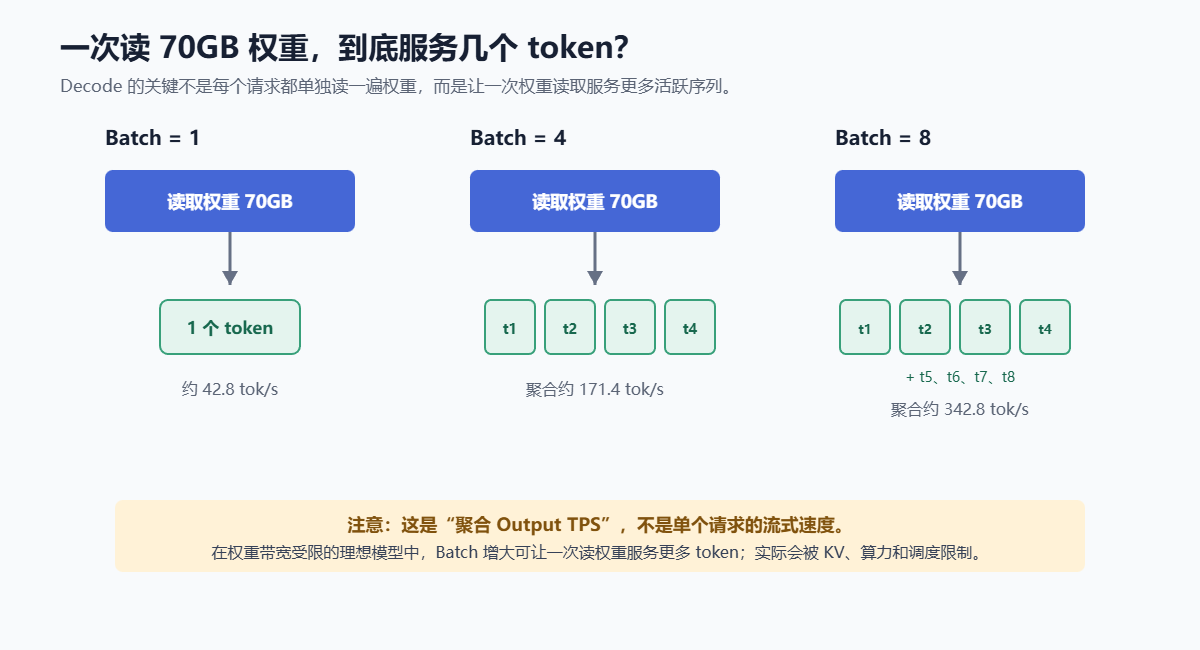
图 2:Batch 增大后,一次权重读取可以服务更多活跃序列,因此聚合 Output TPS 增长。这里的聚合吞吐不是单个请求的流式速度。
这里有一个容易混淆的概念:单请求 token/s 和 所有请求合计的 Output TPS并不是同一个指标。
假设权重带宽是唯一瓶颈,单个 Decode 迭代耗时为:
t_iter = D_weight / BW
在 Batch 为 B 时,一轮迭代可以为 B 个活跃序列各生成一个 token,因此聚合吞吐约为:
Aggregate Output TPS
≈ B / t_iter
≈ B × BW / D_weight
而同步 Batch 中每个序列仍然是每轮生成一个 token,因此单序列速度仍接近:
Per-sequence token/s
≈ 1 / t_iter
≈ BW / D_weight
这就是为什么增加 Batch 往往能显著提高整个实例的吞吐,却不一定提高单个用户看到的 token/s。
4. 复现 70B、3TB/s、42.8 token/s
假设:
模型参数量:70B
权重精度:FP8 或 INT8
有效权重显存:70GB
GPU HBM 理论带宽:3TB/s
Batch:1
第一步:确定每轮需要读取的权重
低 Batch、权重带宽主导时:D_weight ≈ 70GB
第二步:计算单轮理论时间
t_weight
= 70GB / 3,000GB/s
= 0.023333 秒
= 23.33ms
第三步:计算理论 token/s
每轮生成一个 token:
tokens/s
= 1 token / 0.023333 秒
≈ 42.86 token/s
也可以直接写成:
tokens/s
≈ 3,000 / 70
≈ 42.86
两种推导完全一致。
第四步:为什么实际一定低于 42.8
因为真实的单轮数据量至少是:
D_step
= 70GB
+ D_KV_read
+ D_KV_write
+ D_other
同时,理论 HBM 带宽也不会全部转化为有效模型带宽:
BW_effective
= BW_peak
× 带宽利用率
如果带宽利用率只有 70%,且暂时忽略 KV:
BW_effective = 3,000 × 70% = 2,100GB/s
tokens/s ≈ 2,100 / 70 = 30 token/s
再加入 KV 读取和其他流量,实际速度还会继续下降。
5. 把 KV Cache 加入带宽模型
5.1 KV Cache 单 token 大小
KV Cache 单 token 的显存公式是:
KV Bytes / token
= Layer 数
× 2
× KV Head 数
× Head Dim
× KV dtype bytes
其中 2 表示 Key 和 Value。
假设模型配置为:
Layer 数 L = 80
KV Heads = 8
Head Dim = 128
KV 精度 = BF16 = 2 Bytes
则:
KV Bytes / token
= 80 × 2 × 8 × 128 × 2
= 327,680 Bytes
≈ 320KB
5.2 8k 上下文的历史 KV 读取量
假设当前请求已有 8,000 token 上下文,每次 Decode 都要读取历史 K/V:
D_KV_read
≈ 8,000 × 320KB
≈ 2.56GB
这只是粗略的原始数据量估算,实际 Kernel 可能通过缓存、分块和数据复用改变真实 HBM 流量,但它足以帮助判断量级。
5.3 单序列完整带宽下界
只考虑模型权重和历史 KV:
D_step
≈ 70GB + 2.56GB
≈ 72.56GB
理论单轮耗时:
t_iter
≈ 72.56GB / 3,000GB/s
≈ 24.19ms
理论速度:
1 / 0.02419
≈ 41.3 token/s
相比只看权重的 42.8 token/s,已经下降。加入新 KV 写入、激活、Workspace 和有效带宽折损后,实际值还会更低。
6. Batch 为 8 时应该如何计算
当 Batch 为 8,假设 8 个请求的上下文都约为 8k token:
每轮权重读取:70GB
每个请求历史 KV 读取:2.56GB
8 个请求历史 KV 读取:8 × 2.56GB = 20.48GB
因此单轮总数据量粗略为:
D_step
≈ 70GB + 20.48GB
≈ 90.48GB
单轮时间:
t_iter
≈ 90.48GB / 3,000GB/s
≈ 0.03016 秒
≈ 30.16ms
因为这一轮为 8 个序列各生成一个 token,所以聚合吞吐是:
Aggregate Output TPS
≈ 8 / 0.03016
≈ 265.3 token/s
每个序列的平均生成速度约为:
Per-sequence token/s
≈ 1 / 0.03016
≈ 33.2 token/s
这个例子说明:
Batch 从 1 增加到 8:
单序列速度:约 41.3 -> 33.2 token/s
聚合吞吐:约 41.3 -> 265.3 token/s
Batch 提高了实例的聚合吞吐,但由于每个序列都带来了自己的 KV 读取,单轮耗时也增加了。
7. 通用的 Batch 带宽公式
设:
B:本轮活跃序列数
W:模型权重实际读取字节数
S_i:第 i 个请求当前上下文长度
K:每个 token 的 KV Cache 字节数
D_other:其他显存流量
BW_eff:有效显存带宽
则一次 Decode 迭代的数据量可近似写为:
D_step
≈ W
+ Σ(S_i × K)
+ B × K_new
+ D_other
其中:
K_new = 2 × L × Hkv × d_head × bytes
表示每个新生成 token 写入的 K/V 数据。
单轮时间:
t_iter ≈ D_step / BW_eff
聚合输出吞吐:
Aggregate Output TPS
≈ B / t_iter
≈ B × BW_eff / D_step
当请求长度不同,不能简单使用 B × 平均上下文长度,更合理的估算是:Σ(S_i × K)
因为一个 32k 请求和一个 1k 请求对 KV 带宽的贡献完全不同。
8. 权重带宽和 KV 带宽谁更重要
可以使用一个简单的比例判断:
KV / Weight Ratio
= D_KV_read / D_weight
对于前面的单序列 8k GQA 示例:
D_KV_read / D_weight
= 2.56GB / 70GB
≈ 3.7%
此时权重读取仍然是主要流量。
但如果是 128k 上下文:
D_KV_read
≈ 128,000 × 320KB
≈ 40.96GB
比例变成:
40.96GB / 70GB
≈ 58.5%
此时 KV 读取已经不能忽略。
如果是 MHA,KV Head 数为 64,那么同一模型的 KV 读取量约为 GQA 的 8 倍:
128k MHA KV read
≈ 40.96GB × 8
≈ 327.68GB
这会彻底改变 Decode 阶段的带宽预算,也说明 GQA 对长上下文推理特别重要。
9. 为什么显存带宽不是 FLOPS
FLOPS 衡量的是 GPU 每秒能做多少次浮点运算;显存带宽衡量的是每秒能从 HBM 搬运多少数据。
Decode 常常更接近“搬运问题”:
每次只计算少量新 token
但要反复读取巨大权重
还要扫描不断增长的历史 KV Cache
因此可能出现:
GPU FLOPS 利用率不高
HBM 带宽利用率很高
Decode 仍然很慢
这并不矛盾。瓶颈在于数据还没有搬到计算单元,而不是计算单元不会计算。
反过来,当 Batch 很大时,矩阵计算变得更加饱和,瓶颈可能从 HBM 带宽转移到 Tensor Core 算力、Kernel 形状或通信。
10. Batch 增大后的典型变化
Batch 从 1 增大时,通常会经历三个阶段:
阶段一:小 Batch
权重读取复用不足,聚合吞吐快速增长

阶段二:甜点区
权重已经得到较好复用,吞吐增长变缓,SLO 仍可接受

阶段三:过大 Batch
KV 读取、计算、调度和排队开始恶化,TTFT / TPOT P99 上升
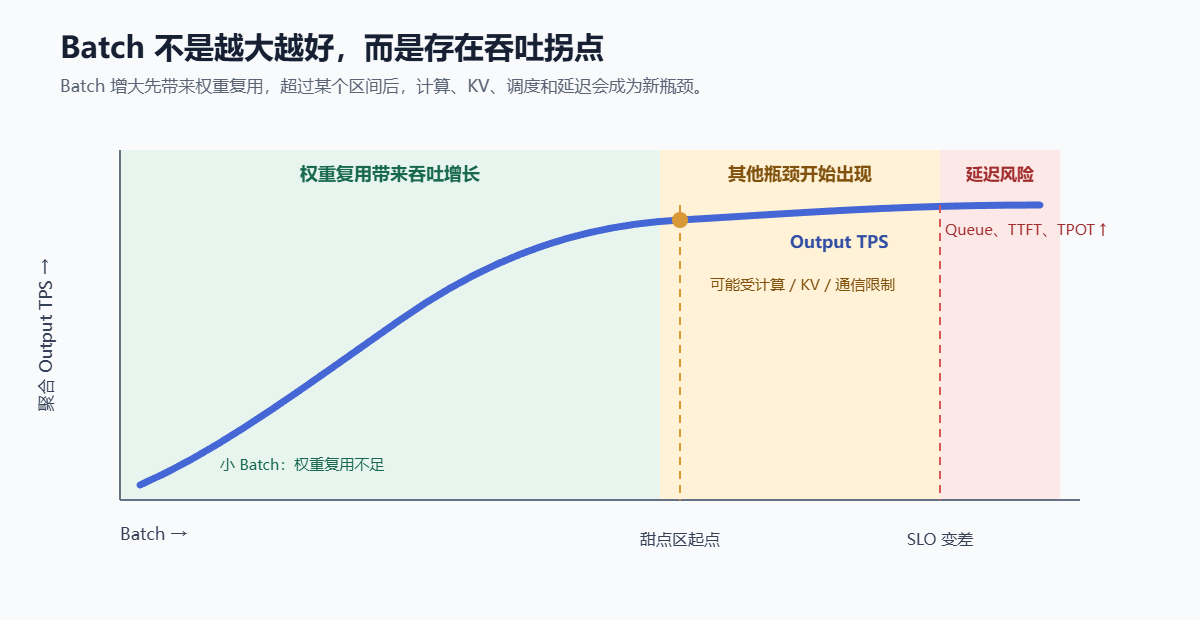
图 3:Batch 增大通常先提升聚合吞吐,超过甜点区后,继续增大可能只增加排队和尾延迟。
因此 max_num_seqs 不能只按显存上限设置。应该通过压测找到:吞吐仍在增长且 TTFT / TPOT P95、P99 仍满足 SLO的最大工作区间。
11. Tensor Parallel 如何改变带宽估算
如果模型通过 Tensor Parallel 拆到 TP 张 GPU 上,权重通常也会分片。
设完整权重为 W,理想均匀分片时:
W_local ≈ W / TP
70B FP8 模型、TP=4:
W_local ≈ 70GB / 4
        ≈ 17.5GB
如果每张卡带宽仍为 3TB/s,单卡只看本地权重读取的理论时间:
t_weight_local
≈ 17.5GB / 3,000GB/s
≈ 5.83ms
对应的理想化权重读取上界:
1 / 0.00583
≈ 171.4 token/s
但不能直接得出 TP=4 就比 TP=1 快 4 倍。因为每层还需要跨卡同步中间结果:
真实单轮时间
≈ 本地权重读取
+ 本地 KV 读取
+ All-Reduce / All-Gather
+ Kernel 等待
+ 调度开销
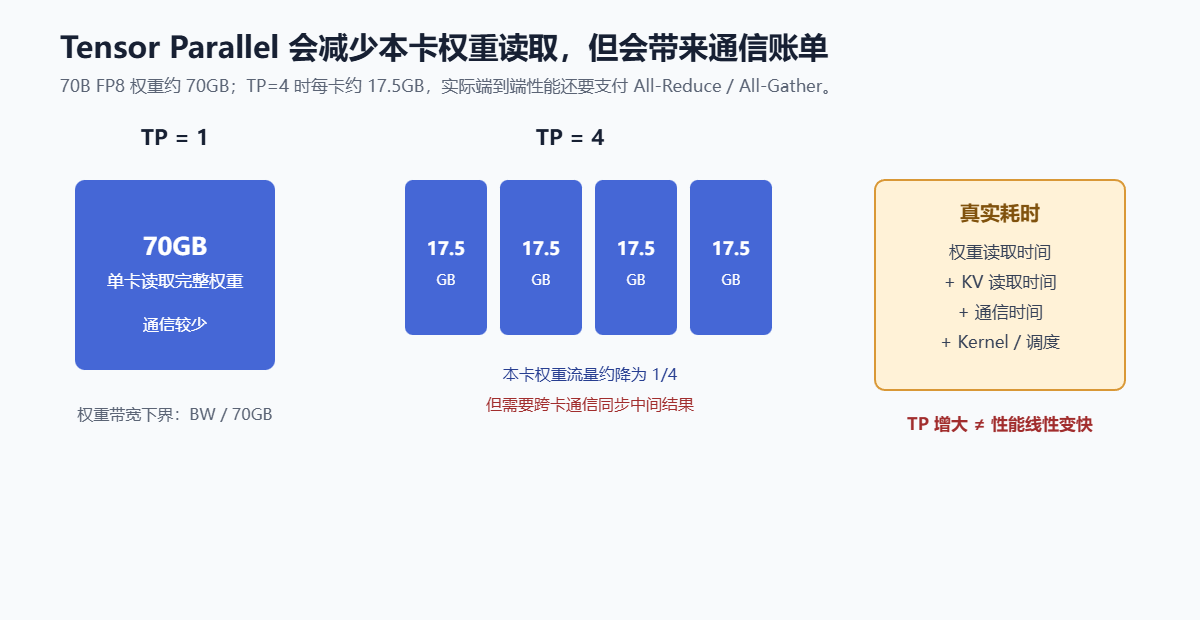
图 4:TP 把权重流量分摊到多张卡,但通信会成为新的时间项。跨 PCIe 或跨节点时尤其需要实测。
TP 的带宽估算至少需要分别记录:
每 GPU HBM 带宽
每 GPU 本地权重大小
每 GPU KV Cache 流量
NCCL 通信时间
通信链路带宽与拓扑
12. 量化如何影响带宽估算
权重量化会直接改变 D_weight。
以 70B 模型为例:
| 权重精度 | 理论权重大小 | 只考虑权重、3TB/s 的理想上界 |
|---|---|---|
| BF16 | 140GB | 21.4 token/s |
| FP8 / INT8 | 70GB | 42.8 token/s |
| INT4 | 35GB | 85.7 token/s |
| 但这些结果不能直接当作实际速度,因为低比特量化通常还需要: |
scale / zero point 元数据
反量化或融合量化 Kernel
非对齐的数据访问
额外的算子转换
因此应使用有效权重流量:
D_weight_effective
= 权重数据流量
+ 量化元数据流量
+ 反量化相关流量
某些量化方案虽然理论权重更小,但 Kernel 效率较低,实际性能未必达到理论比例。量化一定要同时测:
显存占用
HBM 带宽
Output TPS
TTFT / TPOT
模型质量
13. 有效带宽和理论峰值的区别
厂商公布的 HBM 带宽是硬件峰值,不是模型一定能使用的带宽。
定义有效带宽:
BW_eff
= BW_peak × η
其中 η 是有效利用率。如果:
BW_peak = 3,000GB/s
η = 65%
则:
BW_eff = 3,000 × 65%
       = 1,950GB/s
只考虑 70GB 权重时,速度上界变成:
1,950 / 70
≈ 27.9 token/s
有效带宽会受到以下因素影响:
访存是否连续
Tensor Core / CUDA Core Kernel 形状
是否发生非合并访问
Batch 大小
KV Block 布局
量化格式
跨卡通信
Kernel launch 和同步
因此,带宽估算最好给出两组结果:
理论峰值上界
有效带宽下界或实测估计
而不是只报告一个看起来非常精确的 token/s。
14. 如何从实测结果反推有效带宽
如果已经测得单轮 Decode 的时间,可以反推有效带宽。
假设单请求、8k 上下文,粗略估算:
D_step ≈ 70GB + 2.56GB = 72.56GB
实测每 token 时间 = 35ms
则反推有效带宽:
BW_eff
≈ 72.56GB / 0.035s
≈ 2,073GB/s
相对于峰值 3,000GB/s:
带宽利用率
≈ 2,073 / 3,000
≈ 69.1%
这个值不是严格的硬件 HBM 利用率,因为 D_step 本身是估算值,但可以帮助比较不同 Kernel、量化格式、Batch 和框架配置。
15. 一个更完整的性能上界模型
真实 Decode 性能通常同时受到多个上界约束:
实际 Output TPS
≤ 带宽上界
≤ 计算上界
≤ 通信上界
≤ KV Cache 容量与调度上界
可以用粗略的最小值模型表示:
TPS_actual
≈ min(
    TPS_bandwidth,
    TPS_compute,
    TPS_communication,
    TPS_scheduler
  )
各项含义:
TPS_bandwidth
≈ B × BW_eff / D_step

TPS_compute
≈ GPU 有效 FLOPS / 每 token FLOPs

TPS_communication
≈ 通信链路能够支持的同步频率

TPS_scheduler
≈ 调度器、KV Block 和队列能够稳定维持的吞吐
这个模型不追求数学上的精确,而是帮助定位“加 GPU 为什么没有变快”:可能带宽已经不是瓶颈,或者新瓶颈已经转移到 KV、通信、算力和调度。
16. 如何用 Profiling 验证估算
建议按下面顺序进行。
第一步:建立单请求基线
固定:
模型与精度
GPU 型号
TP 大小
输入长度
输出长度
采样参数
记录:
单 token 时间
TTFT
TPOT
GPU 显存
GPU Compute Utilization
HBM Bandwidth Utilization
第二步:固定上下文长度,改变 Batch
例如:
Batch = 1、2、4、8、16、32
对每个 Batch 记录:
聚合 Output TPS
单序列 TPOT
KV Cache 使用率
HBM 带宽
Tensor Core 利用率
Queue Time
第三步:固定 Batch,改变上下文长度
例如:
Context = 1k、4k、8k、32k、128k
如果上下文增长后 TPOT 显著恶化、HBM 带宽接近上限,说明 KV 读取已经成为主要瓶颈。
第四步:区分理论流量和实际流量
理论上可以用:
D_theory
≈ 权重字节
+ KV 字节
+ 新 KV 写入字节
实测时需要结合 GPU Profiler 观察:
Kernel 的 Global Load / Store
HBM Throughput
NCCL 时间
Kernel 空转和同步时间
如果估算值与实测差异很大,优先检查:
是否把 GB 和 GiB 混用了
是否误把权重大小当成实际读取大小
是否遗漏量化元数据
是否遗漏 KV 读取
是否存在权重驻留或缓存复用
是否发生 TP 通信
17. 常见错误理解
错误一:3TB/s / 70GB 就是模型实际速度
不对。这只是只计算权重、假设峰值带宽全部可用时的理想上界。
错误二:Batch=8,单请求速度就变成 8 倍
不对。Batch=8 主要提高聚合吞吐。单序列速度还会受到每个请求自身 KV 读取和调度的影响。
错误三:权重量化到 INT4,速度一定变成 2 倍
不一定。权重流量理论上减半,但量化 Kernel、反量化、元数据、计算和通信可能成为新瓶颈。
错误四:只看 GPU Compute Utilization 就能判断 Decode 快慢
不对。Decode 可能是 HBM 带宽受限,Compute Utilization 不高并不表示 GPU 没有压力。
错误五:TP=4 就能把速度提升 4 倍
不对。TP 减少本地权重和 KV 的分片大小,但增加跨卡通信,最终要看通信拓扑和 Kernel 实测。
错误六:KV Cache 只影响显存,不影响 Decode 时间
不对。Decode 需要反复读取历史 KV。上下文越长,KV 带宽流量越大,TPOT 可能越高。
18. 推理优化时应该如何利用这个公式
当带宽估算显示权重读取是主要瓶颈时,优先考虑:
增加有效 Batch
使用 Continuous Batching
降低权重精度
选择显存带宽更高的 GPU
减少不必要的请求输出长度
优化权重读取和量化 Kernel
当 KV 读取占比变高时,优先考虑:
使用 GQA / MQA 模型
KV Cache 量化
限制上下文长度
Prefix Cache
Paged KV Cache
长短请求隔离
当通信占比变高时,优先考虑:
减少 TP 大小
使用 NVLink / NVSwitch
优化 All-Reduce / All-Gather
优先单机内 TP
用多个较小副本做 Data Parallel
当调度和排队成为问题时,优先考虑:
限制 max_num_seqs
设置 Prefill Token Budget
启用 Chunked Prefill
设置请求优先级
控制最大输出长度
增加副本或做限流
19. 一页式计算模板
拿到一个模型和 GPU 后,可以按以下模板快速估算。
输入参数
模型权重大小:W GB
GPU HBM 峰值带宽:BW_peak GB/s
有效带宽利用率:η
活跃 Batch:B
第 i 个请求上下文长度:S_i
KV Bytes / token:K
其他流量:D_other
计算步骤
1. 有效带宽
BW_eff = BW_peak × η

2. 权重流量
D_weight = W

3. 历史 KV 流量
D_KV_read = Σ(S_i × K)

4. 新 KV 写入
D_KV_write = B × K_new

5. 总流量
D_step = D_weight + D_KV_read + D_KV_write + D_other

6. 单轮时间
t_iter = D_step / BW_eff

7. 聚合吞吐
Output TPS = B / t_iter

8. 单序列平均速度
Per-sequence TPS = 1 / t_iter
这套计算不代替压测,但可以在部署前回答几个关键问题:
为什么 Batch=1 很慢?
为什么增加 Batch 后聚合吞吐上升?
为什么长上下文会拖慢 TPOT?
为什么 GQA 会改善高并发?
为什么 TP 增大不一定线性加速?
为什么 GPU FLOPS 不高但 HBM 带宽很高?
20. 最终总结
Decode 阶段带宽估算的最简模型是:
Decode tokens/s
≈ 显存带宽 / 每 token 需要读取的权重数据
70GB 权重、3TB/s HBM 得到:
3,000 / 70 ≈ 42.8 token/s
但更完整的模型应当写成:
一次 Decode 迭代数据量
≈ 权重读取
+ 历史 KV 读取
+ 新 KV 写入
+ 激活和 Workspace
+ 通信

实际吞吐
≈ min(带宽上界、计算上界、通信上界、调度上界)
真正的优化方向是:
让一次权重读取服务更多 token
减少权重本身的字节数
减少 KV Cache 的字节数和读取量
提高有效 HBM 带宽利用率
减少 TP 通信和调度等待
所以 Decode 优化的核心不是孤立地追求峰值 FLOPS,而是围绕“每秒能够有效搬运并复用多少数据”来设计模型、Batch、KV Cache、并行策略和推理服务。
阅读导航



