
C++ 类型与变量:初始化、赋值和 sizeof
02 类型和变量:给一块数据定规则、起名字
上一章的程序只打印了一行固定文本。程序真正开始处理问题时,第一步通常是把数据放进程序里。数据进来以后,需要两个东西:一套规则,和一个名字。
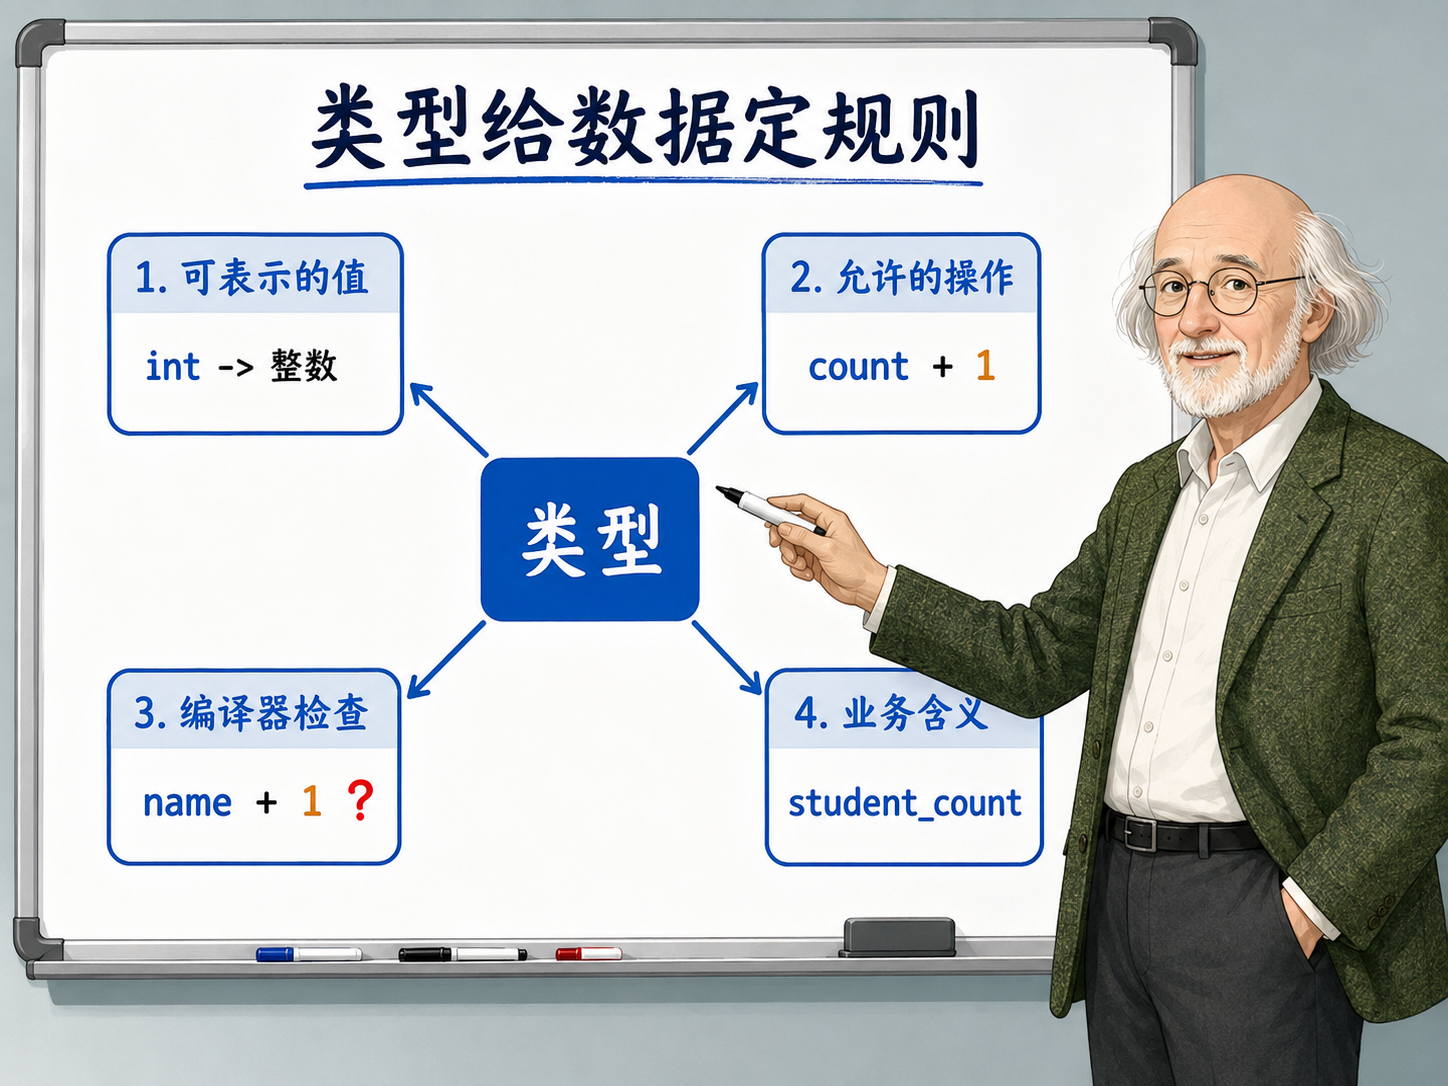
规则由类型提供,名字由变量提供。类型告诉编译器这块数据能表示什么,能参与哪些操作,大概要占多少空间。变量名则是我们在代码里访问这块数据的入口。
先看一段很小的程序:
#include <iostream>
#include <string>

int main() {
  int count = 42;
  double price = 19.5;
  bool paid = true;
  char grade = 'A';
  std::string name = "meow";

  std::cout << name << " bought " << count << " books\n";
  std::cout << "price = " << price << "\n";
  std::cout << "paid = " << paid << "\n";
  std::cout << "grade = " << grade << "\n";
  return 0;
}
这段代码里有五个变量。count 保存整数,price 保存带小数的数值,paid 保存真假状态,grade 保存单个字符,name 保存一段文本。它们看起来都是"变量",底层规则完全不同。count + 1 很自然,name + 1 就没有同样的含义;paid 更适合放进条件判断,price 更适合参与金额计算。
这就是类型的第一层意义:类型给数据定规则。
这个意义比"变量能存什么值"更大。类型还决定编译器怎样检查代码、怎样选择运算、怎样解释内存里的内容。int 和 double 都能写数字,但它们参与除法时规则不同;char 和 std::string 都和字符有关,但一个表示单个字符,一个表示一段文本。类型是程序和编译器之间的契约,你写下类型,就等于告诉编译器后面应该按哪套规则看这份数据。
类型决定数据能怎么用
C++ 是一门强类型语言,也就是说,一个变量创建时要有确定类型,之后编译器会按这个类型检查它的使用方式。写下这句代码时:
int count = 42;
int 说明 count 是一个整数对象。它可以做加减乘除,可以和另一个整数比较大小,也可以被输出到 std::cout。编译器看到 count + 1 时,知道这是整数加法。
换成 double,规则就变了:
double price = 19.5;
double 适合表示带小数的数值。它能保存 19.5 这样的价格,也能保存平均值、比例、距离这类结果。它的计算方式和整数不同,后面讲表达式时会看到整数除法和浮点除法的差异。
bool 专门表达真假:
bool paid = true;
paid 的值只有两个常见状态:true 和 false。这种变量适合描述条件,比如订单是否支付、输入是否有效、文件是否打开成功。后面的 if 会大量依赖 bool 结果。
char 保存单个字符:
char grade = 'A';
单个字符用单引号。'A' 是一个字符,"A" 是一个字符串字面量。两者看起来只差一对引号,类型已经不同。
std::string 保存文本:
std::string name = "yusen";
std::string 来自标准库,所以需要包含 <string>。它适合表达名字、标题、命令、错误信息这类文本内容。本系列先把它当作常用类型使用,内部如何管理字符数组、内存和容量,后面放到 STL/string 专题里讲。
类型带来的规则可以画成这样:
同样写一个值,放进不同类型里,程序的理解方式会变。42 放进 int,表示一个整数;42.0 放进 double,表示一个浮点数;"42" 放进 std::string,表示两个字符组成的文本。写代码时要先想清楚:这份数据在程序里承担什么角色。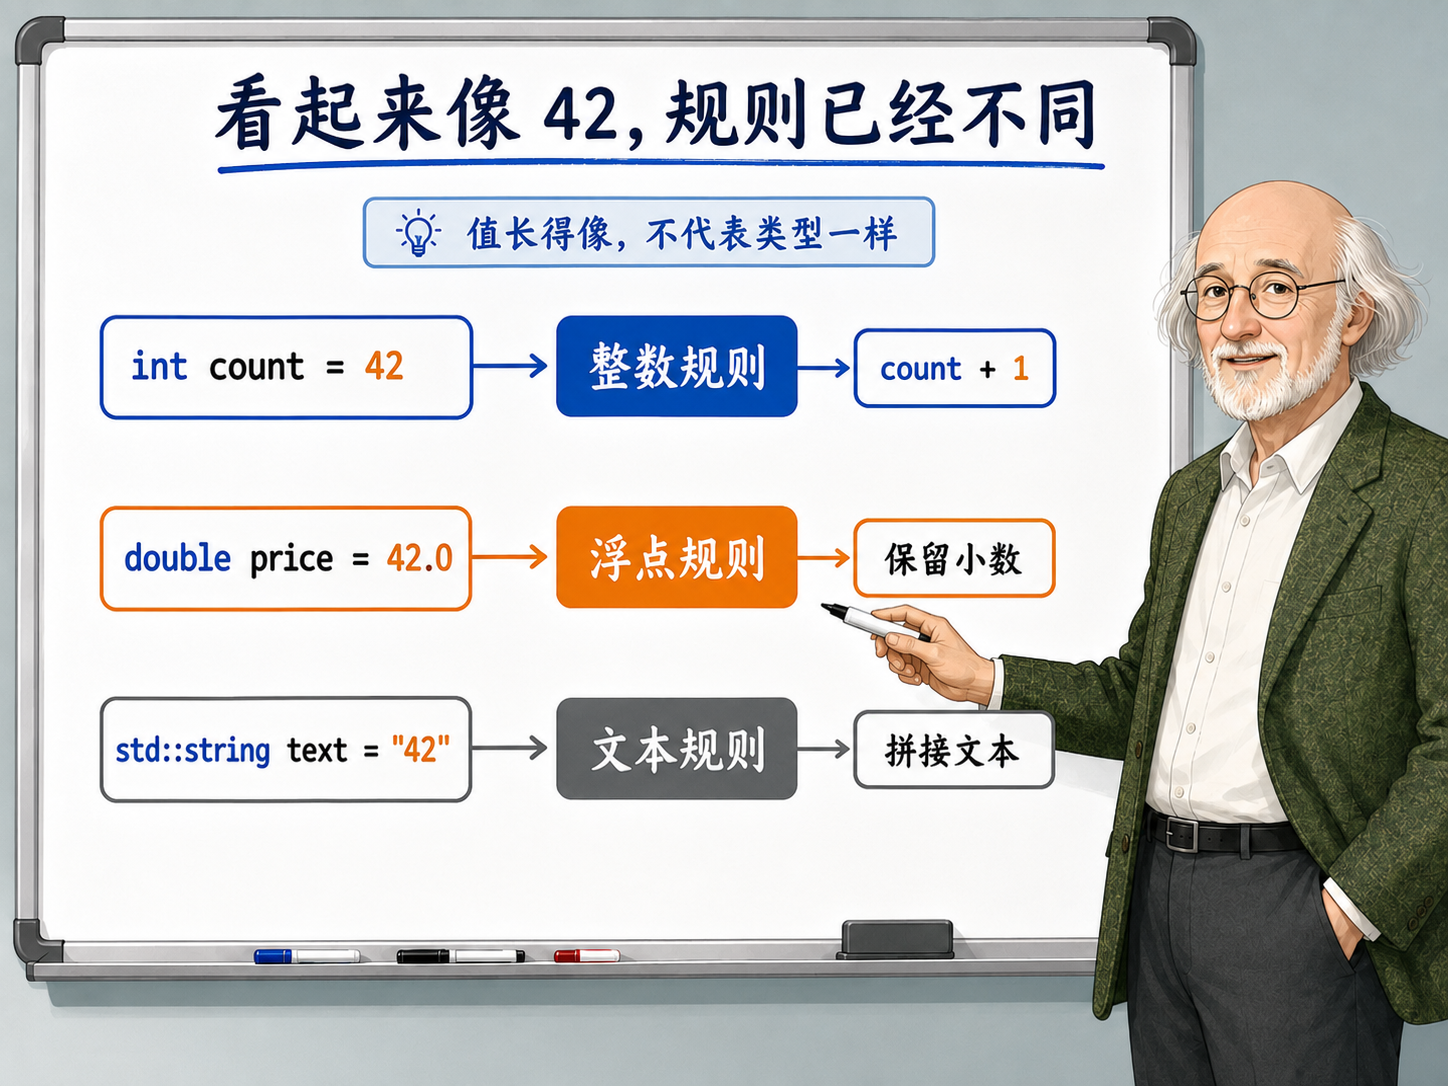
很多初学者会把类型选择看成"能装下就行"。这个想法会让代码变得含糊。学生数量用 double 也能保存 30.0,但它给读者的信号很怪;价格用 int 也能保存"分"为单位的金额,但变量名和注释要把单位说清楚。类型同时承担容量选择和业务含义表达。
变量名是访问对象的入口
变量名经常被说成"盒子上的标签"。这个说法对入门很有用。更准确一点,C++ 里的变量定义通常会引入一个对象,并给这个对象一个名字。我们在代码里写这个名字,编译器就知道要访问哪块数据。
看这句:
int score = 90;
可以把它想成:
名字 score
  ↓
绑定到一个 int 对象
  ↓
对象里保存值 90
后面写:
std::cout << score << "\n";
程序会通过 score 这个名字找到对应对象,读出里面的值,再把值送到输出流。写:
score = 95;
程序会通过同一个名字找到同一个对象,把里面保存的值改成 95。
变量名服务于人和编译器。人靠名字理解程序含义,编译器靠名字做检查和翻译。一个变量叫 x,编译器也能处理;一个变量叫 student_count,读代码的人更容易知道它表示学生数量。基础代码里,变量名要尽量表达数据角色。
变量名、对象和值可以分开理解:
变量名:代码里用来访问对象的名字
对象:程序运行时承载数据的实体
值:对象当前保存的具体内容
类型:规定这个对象的值和操作规则
这几个词后面会反复出现。现在先建立一个稳定直觉:变量名是访问对象的入口,值保存在对象里,并且可以在程序运行过程中变化。
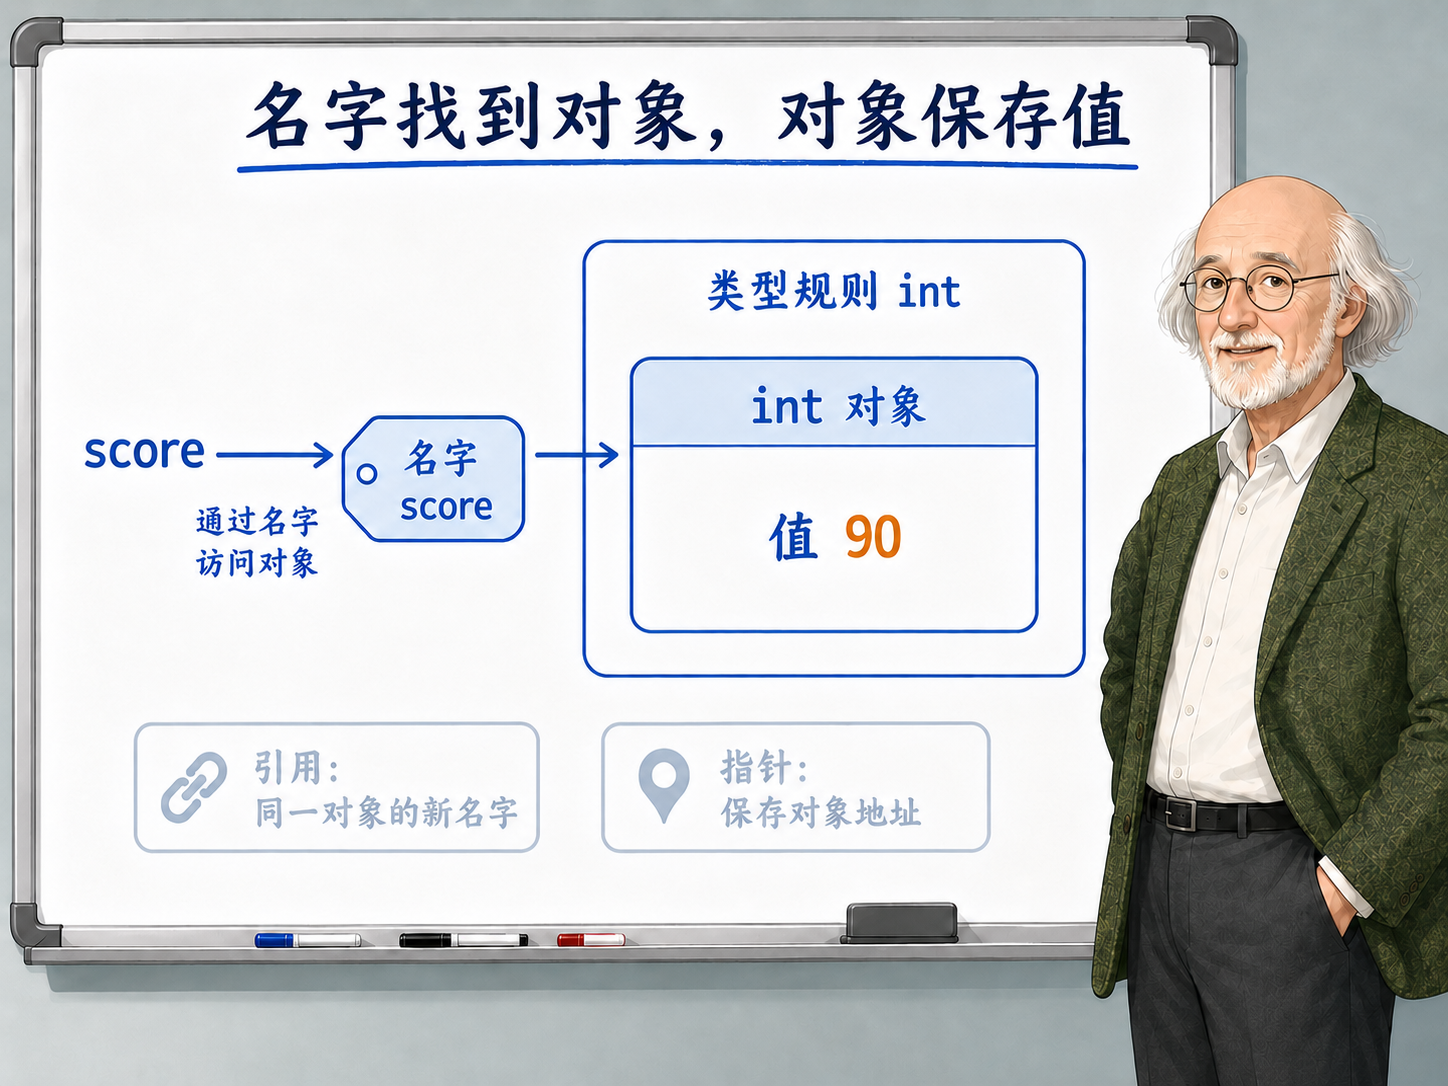
把"名字、对象、值、类型"拆开,会让后面的引用和指针更容易理解。引用会给同一个对象再起一个名字,指针会保存对象地址,const 会限制某条访问路径的修改能力。这些概念都建立在同一件事上:程序运行时有对象,代码里有名字,名字让我们找到对象。
变量名还承担一个很现实的职责:让读者知道这个值为什么存在。同样是 int,count、score、age、retry_count 表达的角色完全不同。编译器只关心它们是不是合法名字,读者关心它们在程序里扮演什么角色。基础阶段不要把变量名当成随手起的标签。名字起得准,很多注释都可以省掉。
好的变量名通常包含两层信息:数据对象是什么,以及它在当前逻辑里承担什么角色。score 说明这是分数,max_score 说明这是分数上限,current_score 说明这是当前处理到的分数。名字越贴近角色,后面读表达式和控制流时越容易判断代码意图。
名字也不要过度拉长。the_number_of_students_in_the_current_class 太重,student_count 已经足够。基础代码里可以用一个简单标准:读者看到这个名字,不需要看注释就能知道它大概表示什么;名字本身又不会长到打断表达式阅读。
初始化和赋值是两件事
这两行代码看起来都和 score 有关:
int score = 90;  // 初始化
score = 95;      // 赋值
第一行发生在变量创建时。score 这个对象刚出现,就被放进了初始值 90。这个动作叫初始化。
第二行发生在对象已经存在之后。score 已经是一个有效变量,score = 95; 修改它当前保存的值。这个动作叫赋值。
对 int 这种基础类型来说,初始化和赋值的差别看起来很小。对后面的类对象来说,差别会变大。创建一个 std::string 时初始化文本,和已经有一个 std::string 后再给它赋新文本,背后可能走不同的代码路径。第一阶段先把概念分清楚。
这个区别也影响代码阅读。看到 int score = 90;,你知道对象刚出现就是 90;看到 score = 95;,你知道某个已有对象的状态被改了。前者是在建立初始状态,后者是在改变程序状态。程序变复杂以后,能不能快速区分"创建时是什么样"和"后面在哪里被改过",会直接影响调试效率。
建议写变量时尽量直接初始化:
int count = 0;
double total = 0.0;
bool valid = false;
std::string message = "ready";
这样读者一眼能看到变量刚创建时处于什么状态。没有明确初始值的变量容易带来混乱。局部基础类型变量如果没有初始化,它的值可能是任意残留值。养成创建时给出初始值的习惯,会让程序更稳定。
初始化和赋值的关系可以画成这样: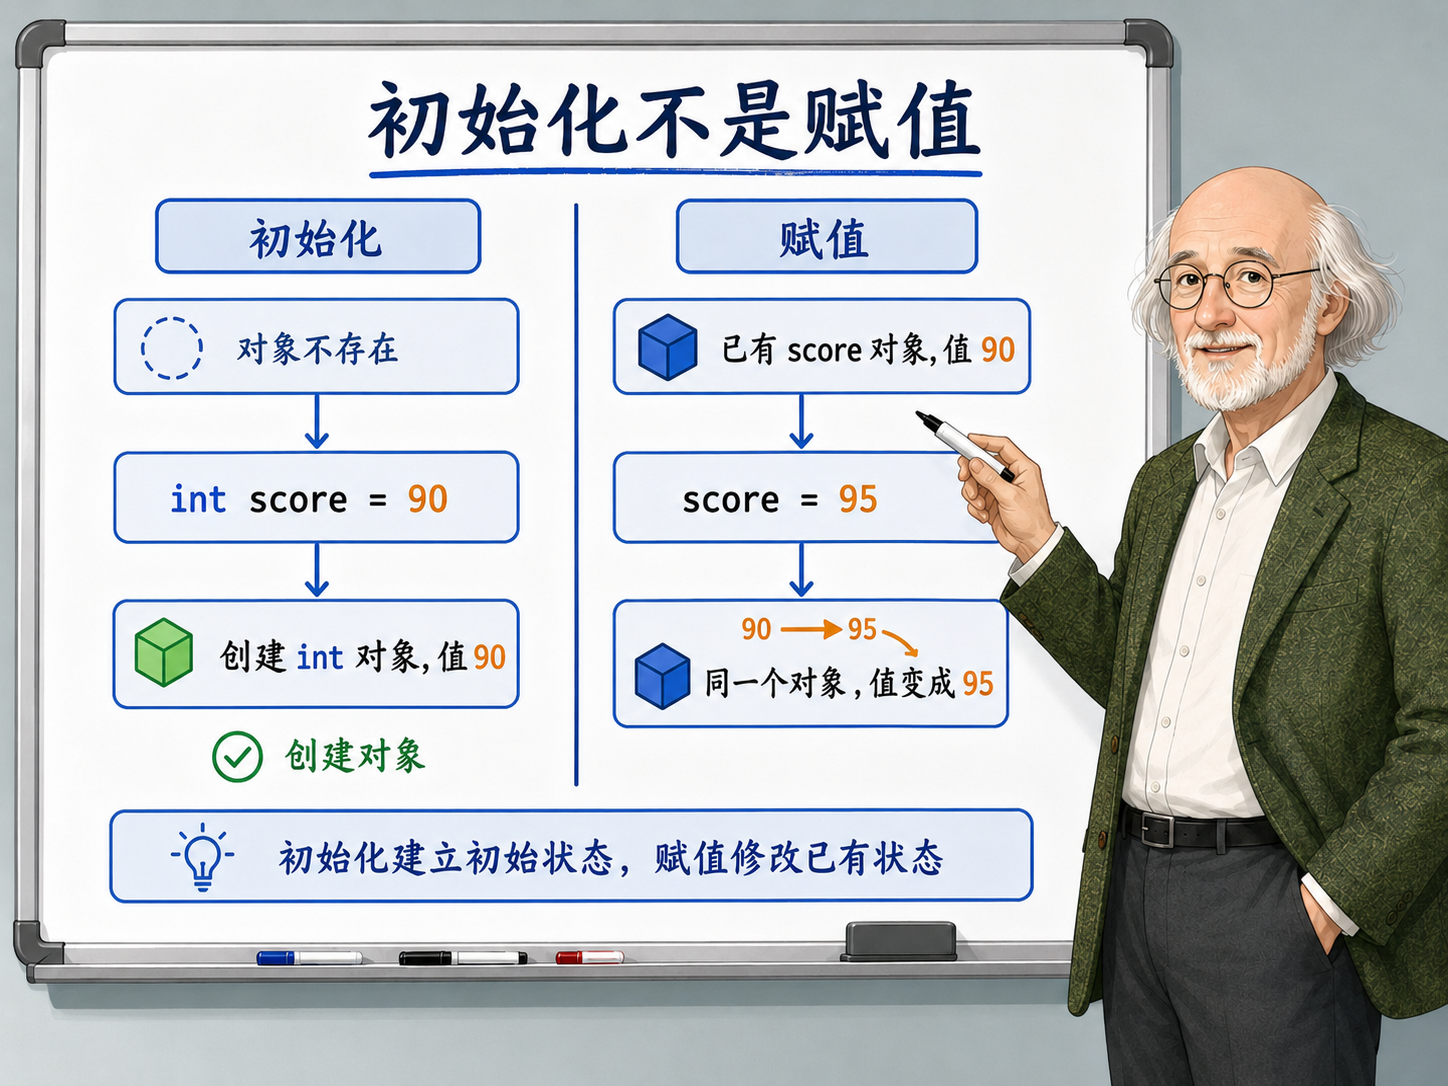
初始化写得越靠近定义位置,变量状态越清楚。下面这种写法会让读者多追几行:
int score;
score = 90;
如果中间没有别的逻辑,直接写成 int score = 90; 更清楚。变量定义和初始状态放在一起,读者不需要先看到一个空名字,再往后找它什么时候得到第一个有效值。
对于局部变量,基础阶段可以把"定义时初始化"当成默认习惯。确实需要晚一点才能得到值时,再把定义放到第一次拿到值的位置附近。这样变量既不会提前暴露,也不会以不清楚的状态存在太久。
字面量也有类型
代码里直接写出来的值叫字面量:
42
3.14
true
'A'
"hello"
它们都带着编译器能识别的类型。42 通常是整数类型,3.14 是浮点字面量,true 是 bool,'A' 是字符,"hello" 是字符串字面量。
字面量有类型,所以它们参与表达式时会影响计算规则。比如:
int a = 5 / 2;
double b = 5.0 / 2;
5 / 2 是整数除法,结果是 2。5.0 / 2 中有浮点数参与,结果会按浮点规则计算,得到 2.5。这个例子下一章会展开。这里先记住:直接写在代码里的值也带着类型规则。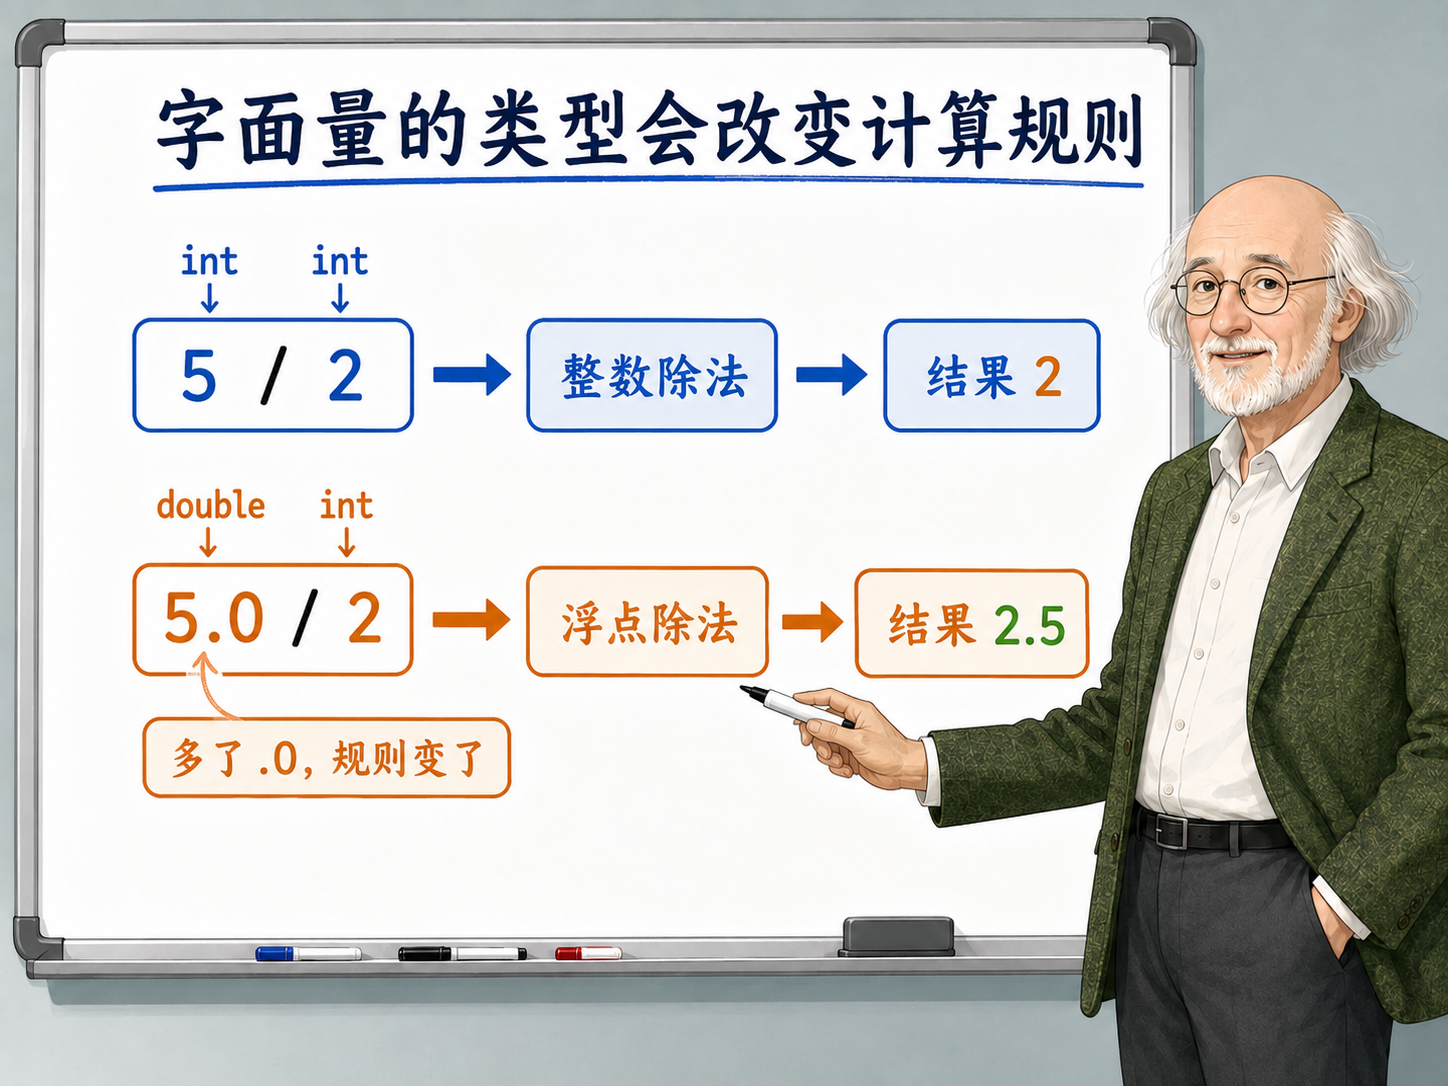
字面量的类型还会影响 auto。auto x = 0; 推导出来的是整数,auto x = 0.0; 推导出来的是浮点数。两个写法只差一个 .0,后续计算规则可能完全不同。基础阶段养成观察字面量类型的习惯,后面读表达式和类型推导会少踩很多坑。
字面量还会帮助编译器推断变量类型。后面讲 auto 时你会看到:
auto count = 42;
auto price = 3.14;
auto 左边没有直接写类型,编译器会根据右边字面量的类型推导出 count 和 price 的类型。基础类型的概念越清楚,读现代 C++ 代码时越轻松。
基础类型怎么选
入门阶段可以用一个简单判断方法: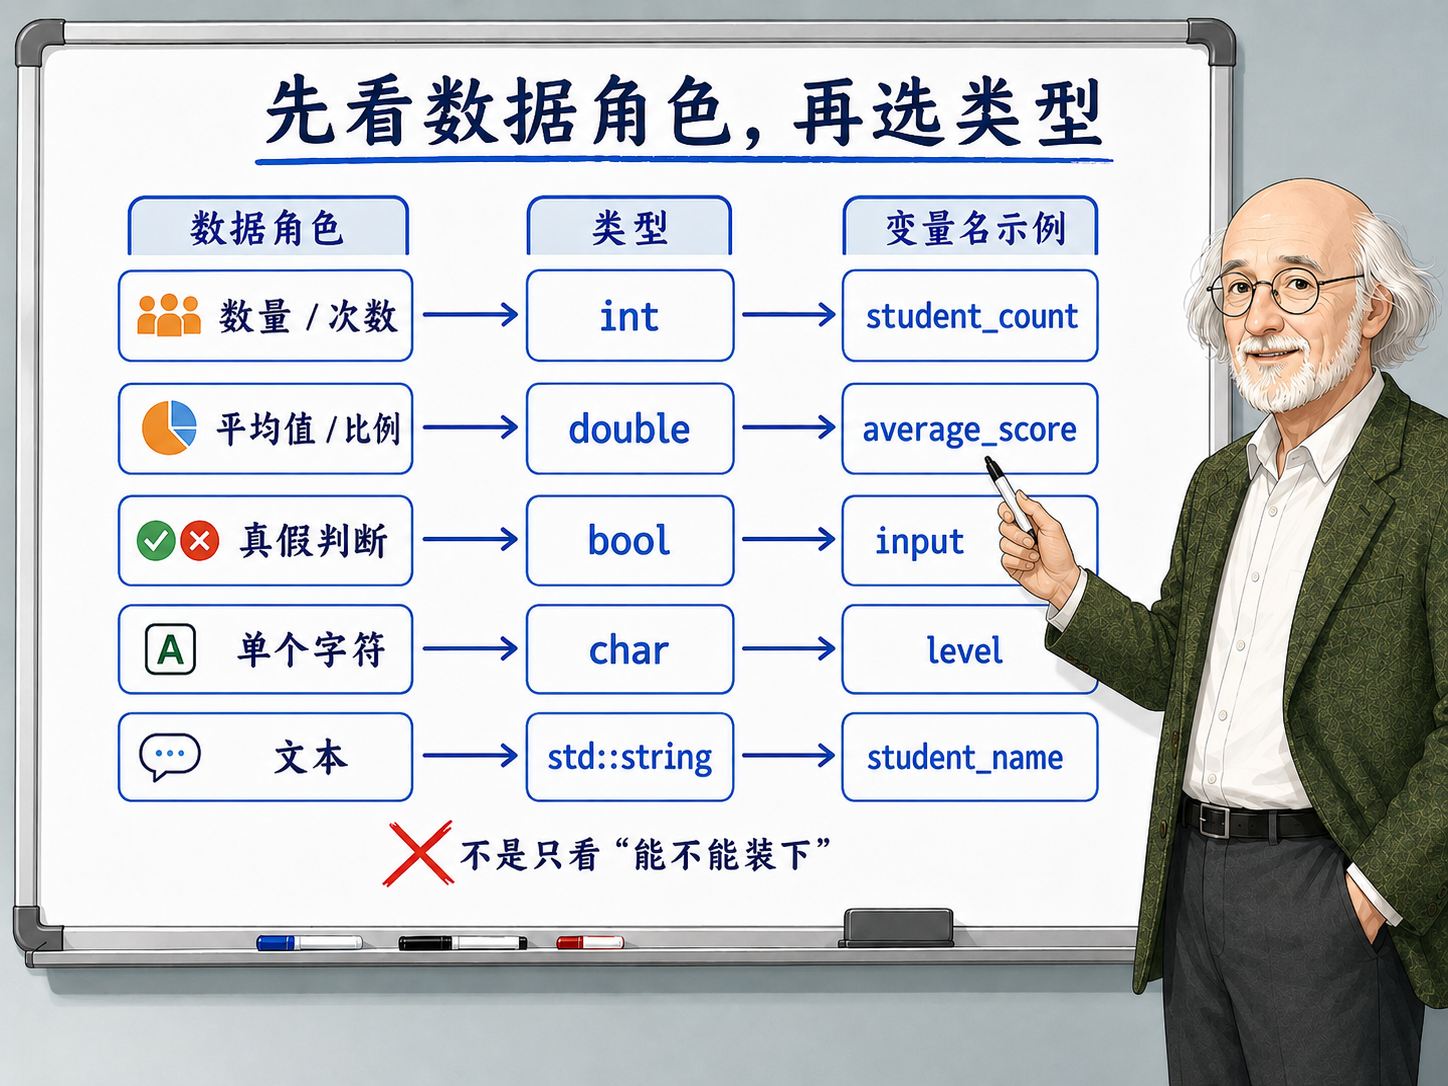
这个表的用途,是帮你先把数据角色说清楚。数量、下标、次数通常是离散值,整数更自然;平均值、比例往往需要小数,double 更合适;条件判断需要表达真假,bool 能直接告诉读者这是一条判断结果。变量类型选得好,变量名再配合好,代码本身就会带解释。
比如学生人数可以写成 int student_count = 30;,因为人数是离散数量。考试平均分可以写成 double average_score = 86.5;,因为平均值可能带小数。输入是否有效可以写成 bool input_valid = true;,因为它回答的是一个真假问题。等级字符可以写成 char level = 'B';,因为它只保存一个字符。学生姓名可以写成 std::string student_name = "Ada";,因为它保存的是一段文本。
这些选择是第一阶段够用的起点。后面你会遇到 long long、std::size_t、固定宽度整数、枚举、类类型。它们都在回答同一个问题:这份数据应该遵守什么规则。
类型选择也会影响后续代码的形状。bool input_valid 放进 if (input_valid) 很自然,int status 放进条件里就不够清楚,因为读者不知道哪些数字代表合法状态。double average_score 后面参与除法时,读者会预期它保留小数;int count 后面参与循环时,读者会预期它是一个计数。类型和变量名一起工作,把数据的角色提前告诉读者。
基础阶段不要急着追求"最省空间"的类型。比如学生人数用 short 也许足够,等级编号用 char 也许能存,但这些选择会让读者先想底层容量,再想业务含义。入门程序先把语义写清楚:数量用整数,比例用浮点,判断用布尔,文本用字符串。等进入性能、内存布局和 ABI 专题,再去讨论更细的类型宽度。
还有一类常见错误,是用类型去掩盖业务规则。比如分数范围是 0 到 100,写成 int score 只能说明它是整数,不能自动保证范围合法。范围检查仍然要靠表达式和控制流完成。类型能表达很多规则,但它不是万能的。基础阶段先把类型、变量名和校验逻辑配合起来:int score 表示分数是整数,IsValidScore(score) 负责检查它是否落在合法范围。
sizeof 能告诉你什么
类型还影响对象占用的空间。C++ 提供了 sizeof 运算符,用来查看某个类型或对象占用多少个字节。
#include <iostream>
#include <string>

int main() {
  std::cout << "sizeof(int) = " << sizeof(int) << "\n";
  std::cout << "sizeof(double) = " << sizeof(double) << "\n";
  std::cout << "sizeof(char) = " << sizeof(char) << "\n";

  int score = 90;
  std::cout << "sizeof(score) = " << sizeof(score) << "\n";
  return 0;
}
sizeof(int) 查看 int 类型的大小。sizeof(score) 查看 score 这个对象的大小。由于 score 的类型是 int,这两个结果通常相同。
这里有一个固定点:sizeof(char) 的结果一定是 1。这个 1 表示一个 C++ 字节。其他基础类型的具体大小和平台、编译器实现有关。常见机器上 int 往往是 4,double 往往是 8,但写教程和工程代码时要知道这是实现选择,不同类型在不同环境里可能不同。
sizeof(std::string) 也可以打印,但它表示 std::string 对象本身占用的空间,不等于字符串内容的字符个数。比如一个 std::string 对象内部可能保存指针、长度、容量等信息。字符串内容的管理方式放到后面的标准库章节。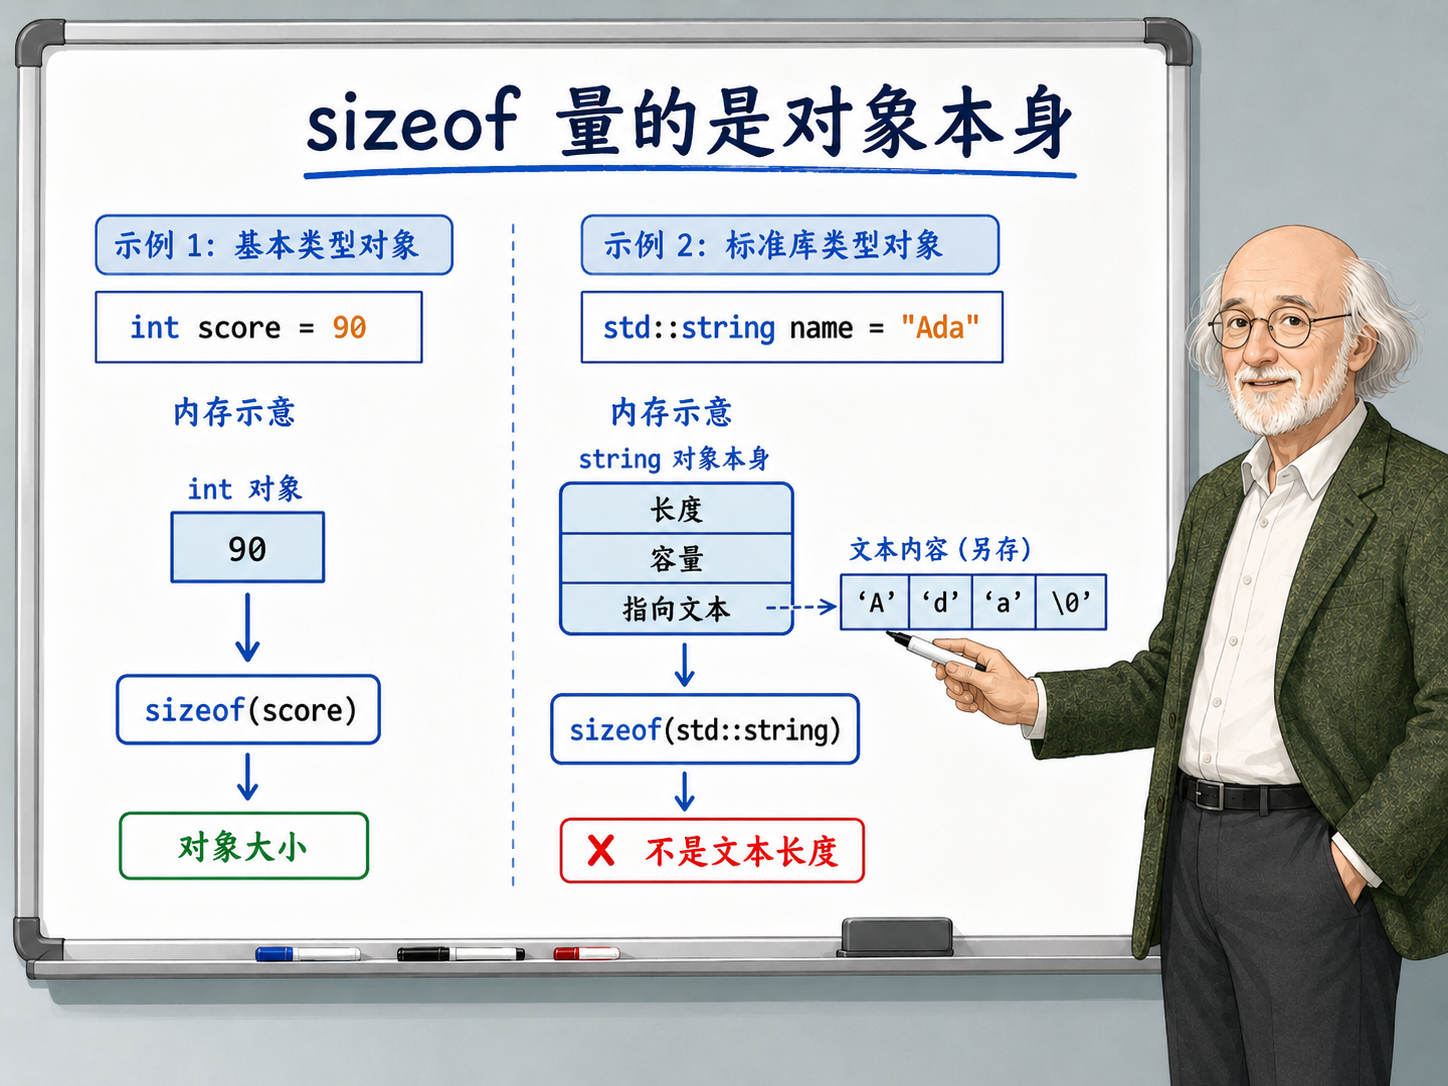
sizeof 的价值在于帮你建立空间直觉。类型会影响对象占用空间、能参与的操作和编译器检查方式。
这一点会在后续资源管理和 STL 里继续出现。std::vector<int> 和 std::vector<double> 的元素大小不同,拷贝大对象和拷贝小对象的成本不同,函数参数按值传和按引用传也会受到对象大小影响。现在先通过 sizeof 建立空间感,后面再把它和性能、内存布局连起来。
这里也要守住边界:sizeof 告诉你对象本身占多少字节,不告诉你这个对象"代表的业务数据有多少"。sizeof(int) 是整数对象的空间大小,sizeof(score) 是 score 这个对象的空间大小;sizeof(std::string) 是字符串对象本身的大小,不是文本长度。想知道字符串里有几个字符,要看字符串自己的接口,而不是用 sizeof 猜。
所以读 sizeof 结果时,要先问它量的是类型、对象,还是对象内部管理的外部资源。基础类型通常很直接,标准库对象就要小心。这个区分会让你后面看容器、字符串和动态内存时少走弯路。
一段完整演示
把本章的几个概念放在一起:
#include <iostream>
#include <string>

int main() {
  int score = 90;
  double ratio = 0.95;
  bool passed = true;
  char level = 'A';
  std::string name = "Ada";

  std::cout << name << " score = " << score << "\n";
  std::cout << "ratio = " << ratio << "\n";
  std::cout << "passed = " << passed << "\n";
  std::cout << "level = " << level << "\n";

  score = 95;
  std::cout << "new score = " << score << "\n";

  std::cout << "sizeof(score) = " << sizeof(score) << "\n";
  std::cout << "sizeof(ratio) = " << sizeof(ratio) << "\n";
  return 0;
}
这段程序展示了变量定义、初始化、赋值、输出和 sizeof。读代码时可以按三个问题走: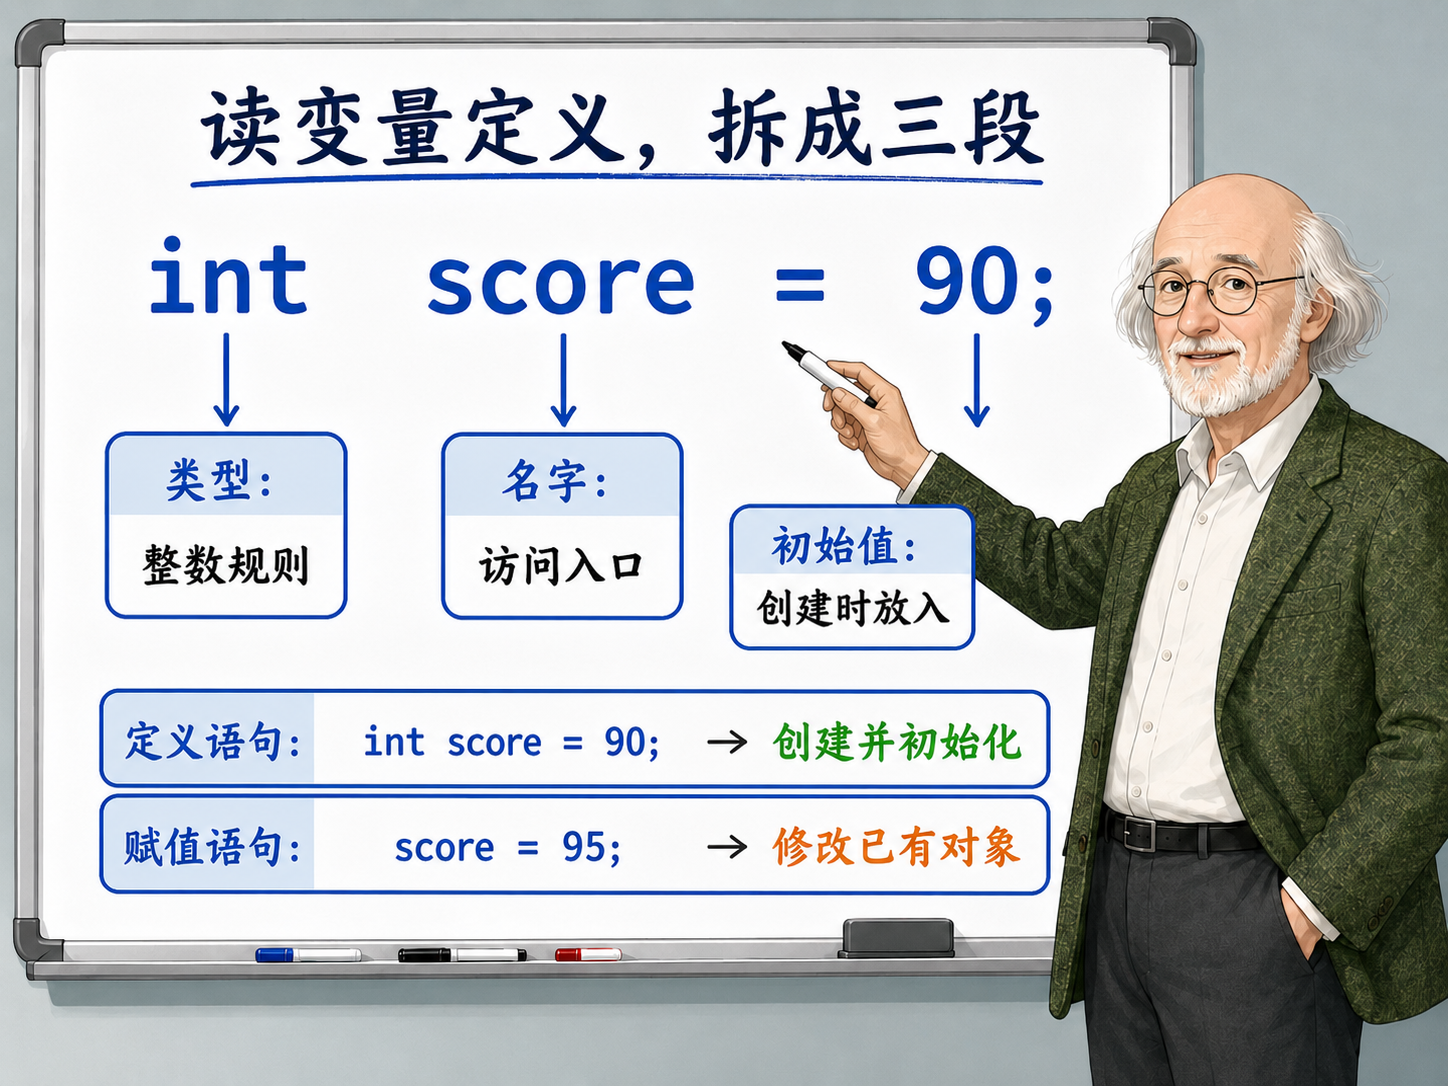
这套读法适合所有基础变量定义。看到 double ratio = 0.95;,先看 double,知道后续计算按浮点规则处理;再看 ratio,知道它表达比例;最后看 0.95,知道它的初始状态。看到 std::string name = "Ada";,也按同样顺序读。
赋值语句则少了"创建对象"这一步:
score = 95;
│       │
│       └─ 新值:覆盖对象当前内容
└───────── 已有名字:找到之前创建的对象
所以变量定义和赋值的阅读重点不同。定义语句要看类型、名字和初始值;赋值语句要看改的是哪个已有对象,新值来自哪里。把这两类语句分开读,后面看表达式和函数参数时会更稳。
这一章建立的是数据的入口。变量把值放进程序,类型给值加上规则。下一章会继续往前走:变量之间怎样参与计算,一行表达式怎样产生新的结果,比较和逻辑运算又怎样为控制流提供判断条件。
这一章真正要留下的判断是:先问数据是什么角色,再选类型,再起名字。类型负责规则,名字负责可读性,初始化负责初始状态。把这三件事做好,小程序就不会从第一行开始变得含糊。
回头再看本章开头那五个变量,count、price、paid、grade、name 并不是五种语法摆设。它们分别对应五种数据角色:数量、金额、状态、字符、文本。以后读一段陌生代码时,也可以先用这个角度扫一遍变量定义。变量名告诉你作者想表达什么,类型告诉你编译器会按什么规则处理它,初始值告诉你程序从什么状态开始。
阅读导航



