
C++ 表达式与运算符:优先级、逻辑和类型转换
03 表达式和运算符:一行代码怎样算出结果
变量把数据放进程序,表达式把这些数据组合起来,算出新的结果。
看这一行:
int total = price * count + fee;
左边是在定义变量 total。右边的 price * count + fee 就是表达式。它由变量、运算符和计算规则组成。程序运行到这一行时,会先计算右边表达式,再把结果放进 total。
表达式是 C++ 程序里非常密集的一层。赋值、输出、条件判断、函数调用,几乎都离不开表达式。读懂表达式,才能看懂一行代码真正做了哪些动作。
表达式会产生一个结果
最基础的表达式是一个值:
42
score
"hello"
42 是整数字面量表达式,score 是变量表达式,"hello" 是字符串字面量表达式。它们本身就能产生值。
更多时候,表达式由运算符组合而成:
int price = 20;
int count = 3;
int fee = 5;
int total = price * count + fee;
这行里的右侧可以画成一棵小树: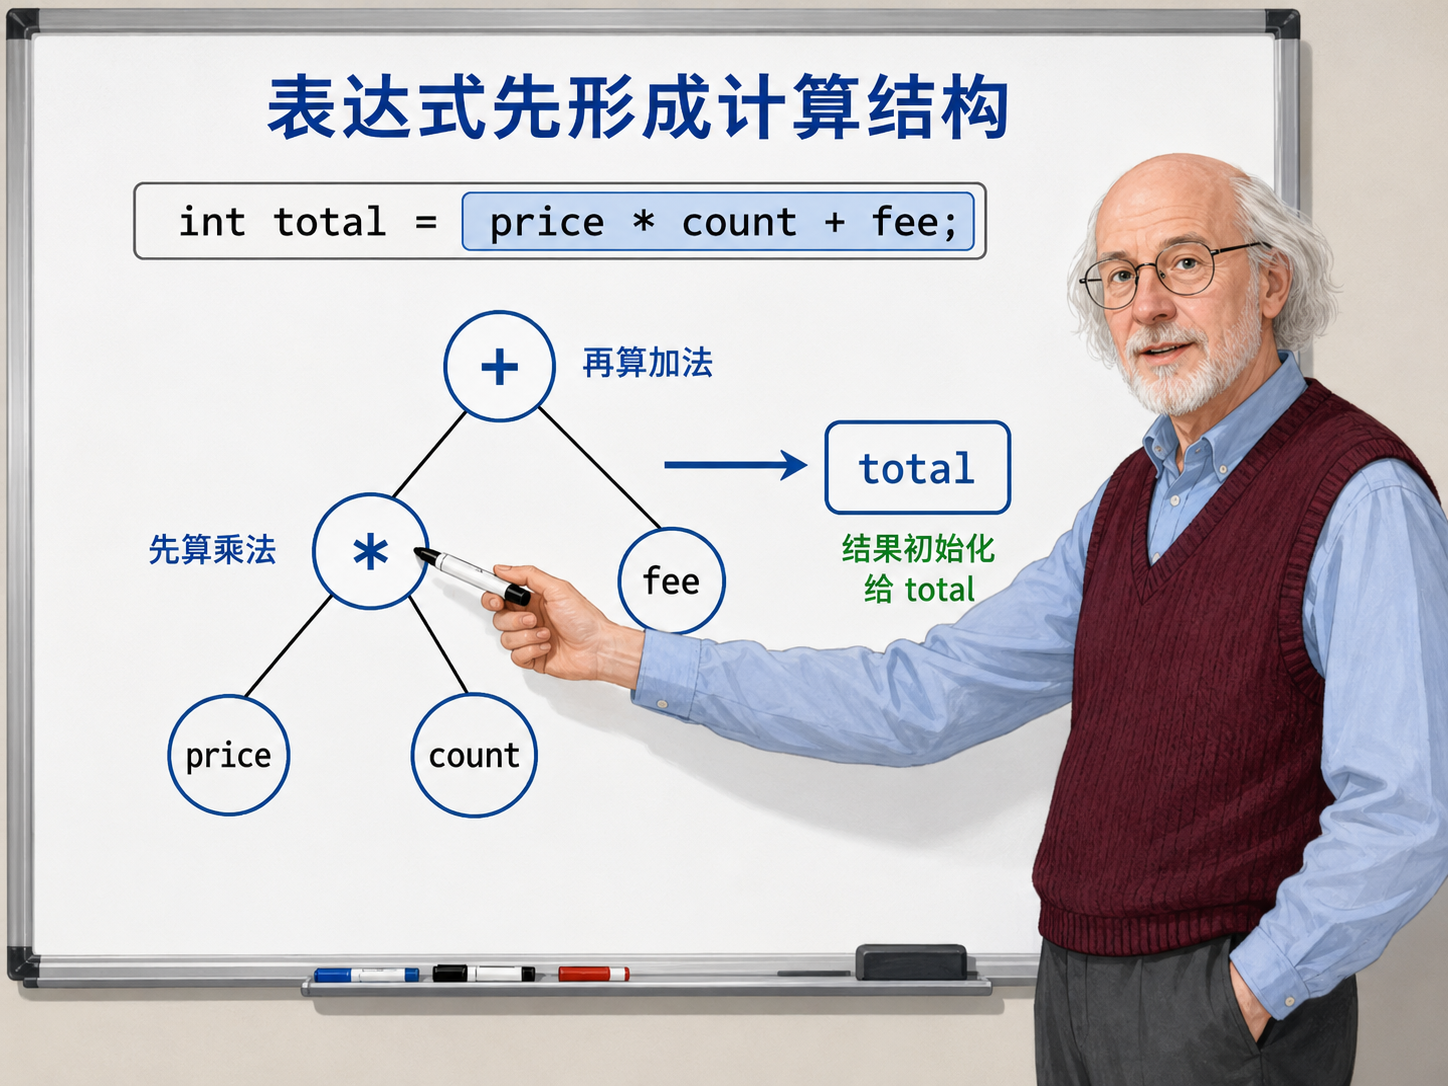
程序先算 price * count,再把结果和 fee 相加。最后得到的值用于初始化 total。
表达式可以出现在很多地方:
std::cout << total << "\n";
bool expensive = total > 50;
return total;
total 是输出表达式的一部分。total > 50 会产生一个 bool 结果。return total; 把表达式结果交回调用者。看到表达式时,要问两个问题:它算出了什么结果,它有没有顺手改变某个对象。
第二个问题就是副作用。比如 score + 5 只计算新结果,score = score + 5 会修改 score,++score 也会修改 score。表达式既可能产生值,也可能改变程序状态。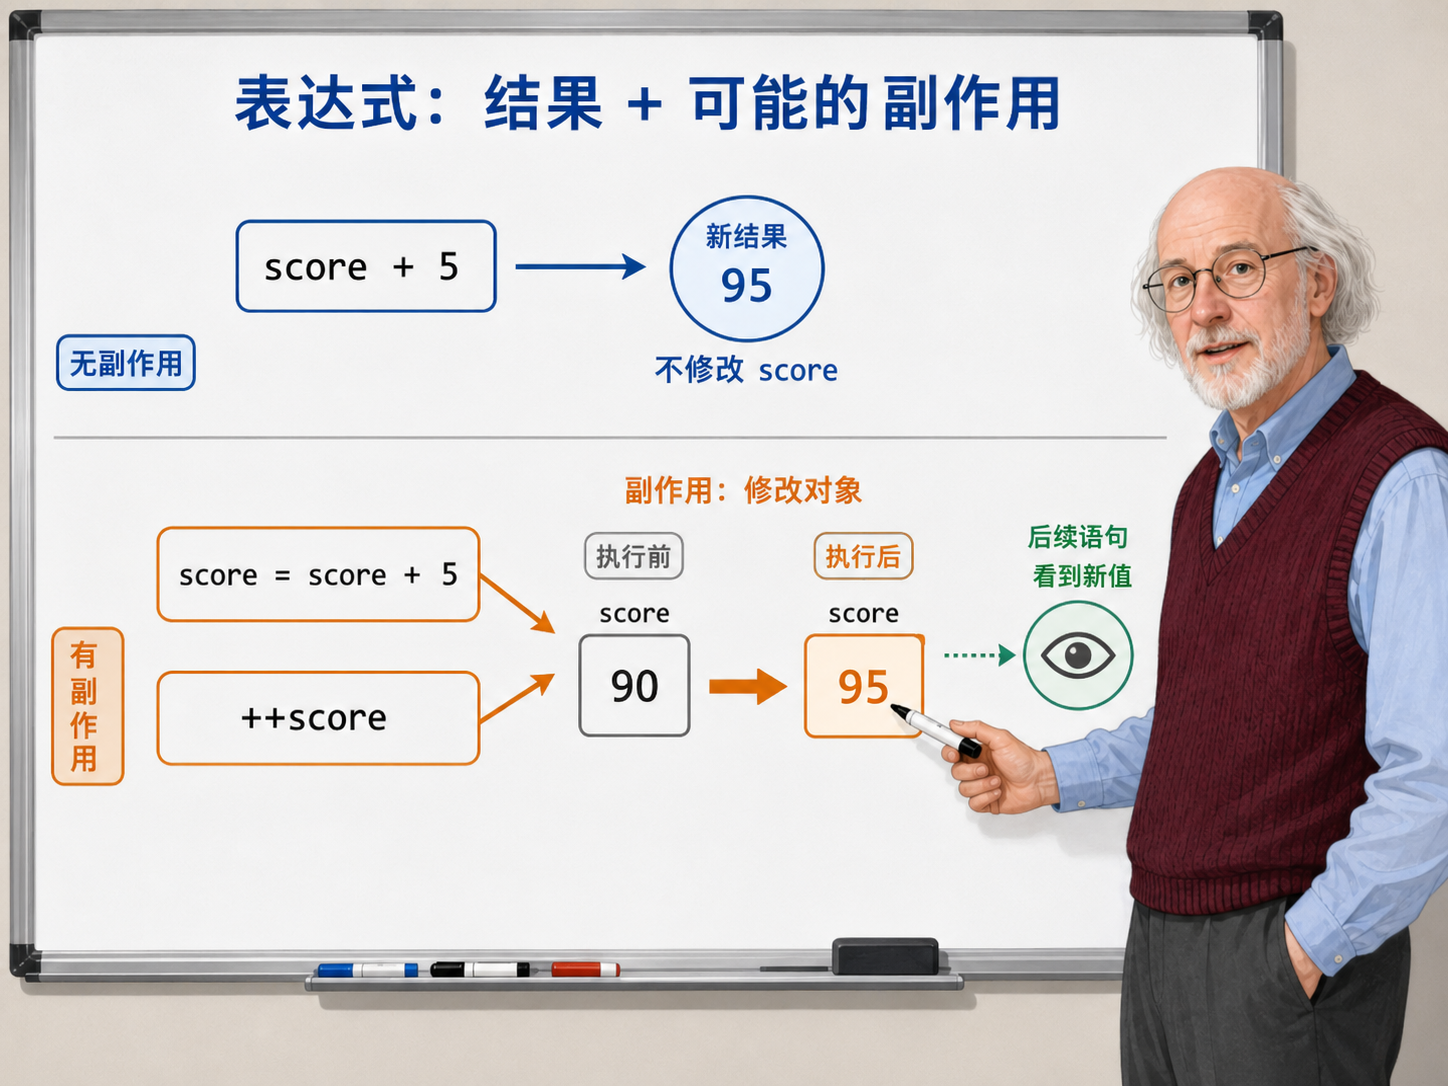
这个区别会一直影响 C++ 代码阅读。只产生结果的表达式比较容易推理,带副作用的表达式会改变后续程序状态。读一行代码时,如果它既算结果又改对象,就要多停一下:改的是谁,后面哪些语句会看到这个新状态。后面讲值类别、迭代器和移动语义时,这种"结果 + 副作用"的拆分还会继续用到。
基础阶段可以把表达式分成两类来看。第一类只回答"结果是多少",比如 price * count + fee、score >= 60、old_enough && young_enough。第二类除了产生结果,还会改变某个对象,比如 score = 95、score += 5、++count。读复杂代码时,先把第二类找出来,因为它们会改写后面的程序状态。
这也是为什么教学代码里不要把太多动作塞进一行。total += price * count + fee; 还算清楚,因为它只改 total。如果一行里同时出现赋值、自增、函数调用和逻辑判断,读者就要追踪多条状态变化。表达式越基础,越应该让它的结果和副作用都露在明处。
运算符优先级决定分组方式
这行代码的结果是多少:
int result = a + b * c;
C++ 会先算乘法,再算加法。它等价于:
int result = a + (b * c);
运算符优先级决定表达式如何分组。乘法优先级高于加法,所以 b * c 先结合在一起。赋值的优先级更低,所以右边先算完,结果再写入左边变量。
机器能按优先级算出结果,读代码的人也要能快速看懂。表达式短的时候,直接依赖优先级没问题:
int total = price * count + fee;
表达式稍微复杂时,主动加括号更稳:
int total = (price * count) + fee;
int final_score = base + (bonus * weight) - penalty;
括号不会让你显得不懂优先级。它能把作者的意图直接写出来。基础代码里,可读性比压缩字符更重要。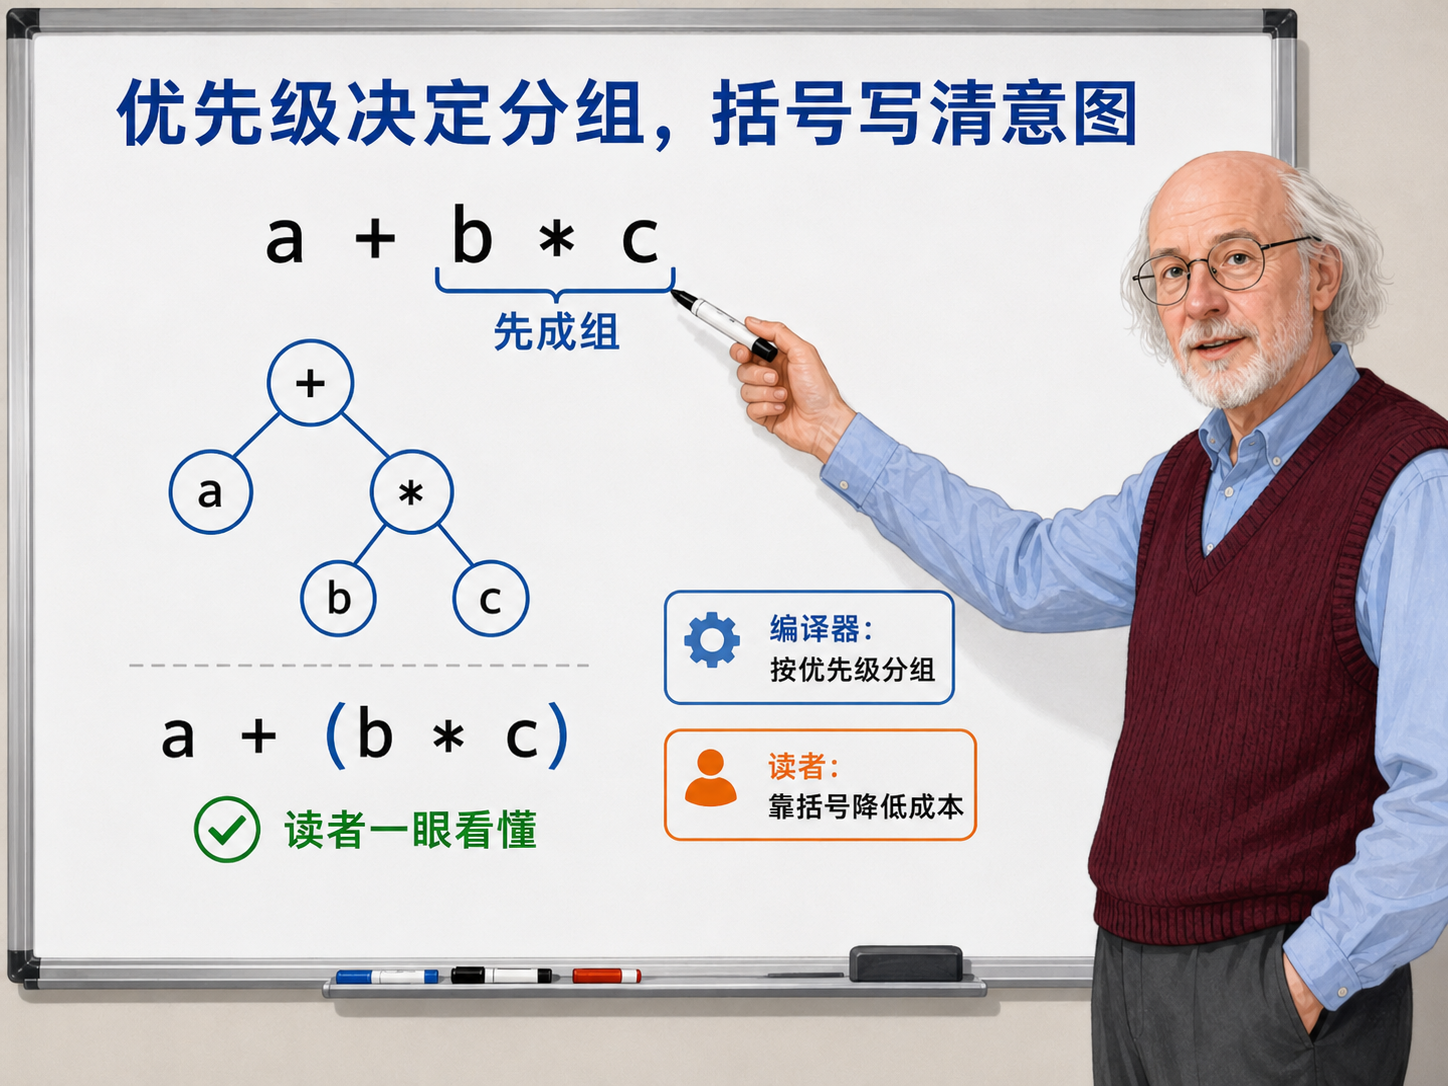
这也是工程代码里的基本取舍。能让编译器算对,只是最低要求;能让后来读代码的人快速看懂,才是更高要求。优先级表可以解决语法歧义,但不能解决阅读成本。复杂表达式里多写一组括号,经常比让读者猜你的分组意图更划算。
结合性处理同一优先级运算符的分组方向。例如赋值通常从右向左结合:
a = b = 0;
这行可以工作,但初学阶段建议拆开写:
b = 0;
a = b;
拆开以后,动作顺序更明显。等你熟悉语言规则后,再判断某些简写是否值得使用。
优先级和结合性解决"编译器怎样分组",括号解决"读者怎样理解"。这两个目标不完全一样。编译器可以轻松记住整张优先级表,读者通常是在上下文里快速扫代码。只要表达式里混入三种以上运算符,主动加括号往往更划算。括号的主要读者是后来维护这段代码的人。
比较表达式产生 bool
比较表达式用来回答真假问题:
int score = 75;
bool passed = score >= 60;
score >= 60 的结果是 true 或 false。这个结果可以保存到 bool 变量里,也可以直接放进 if: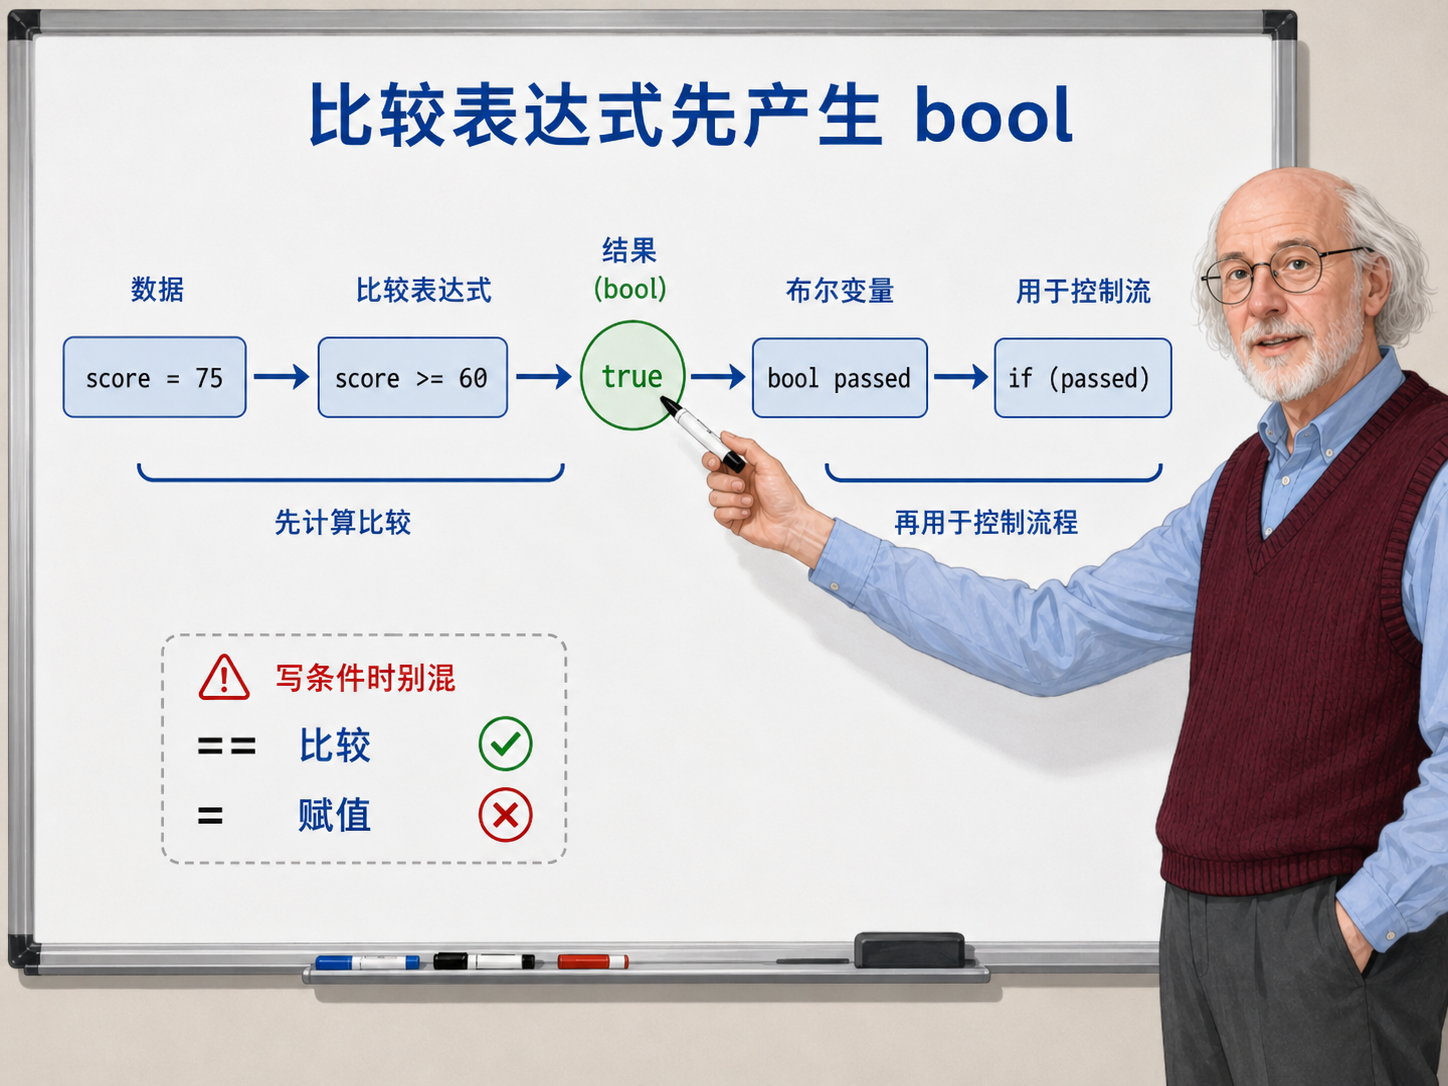
if (score >= 60) {
  std::cout << "passed\n";
}
常见比较运算符有这些:
==  相等
!=  不相等
<   小于
<=  小于等于
>   大于
>=  大于等于
注意 == 和 = 的差别。== 比较两边是否相等,= 把右边的值赋给左边。写条件时把 == 写成 = 是经典错误。现代编译器经常能给出警告,配合 -Wall 更容易发现。
比较表达式的价值在下一章会变得很明显。控制流需要一个判断条件,比较表达式正好提供这个条件。
bool 变量还有一个好处:它能给判断命名。score >= 60 是一个条件,passed 是这个条件背后的业务含义。条件复杂时,先把结果存成一个命名清楚的 bool,代码会更像人在表达判断,读者也不用解析一串符号。
这类命名在控制流里尤其有用。if (score >= 60 && attendance >= 80 && !blocked) 能运行,但读者要逐个解析条件。拆成 bool passed_score、bool attendance_ok、bool can_publish 之后,if (passed_score && attendance_ok && can_publish) 更接近业务判断。表达式不是越短越好,关键是它能不能把判断原因说清楚。
逻辑表达式组合多个条件
单个比较只能回答一个问题。实际代码经常要组合多个条件:
int age = 30;
bool valid = age >= 18 && age <= 65;
&& 表示逻辑与。两边都为 true,整个表达式才是 true。上面这行表达的是:年龄至少 18,并且最多 65。
|| 表示逻辑或。任意一边为 true,整个表达式就是 true:
bool weekend = day == 6 || day == 7;
! 表示逻辑取反:
bool blocked = !valid;
逻辑表达式非常适合放进 if、while 和 for。例如:
if (age >= 18 && age <= 65) {
  std::cout << "valid age\n";
}
表达式太长时,可以拆成有名字的 bool 变量:
bool old_enough = age >= 18;
bool young_enough = age <= 65;

if (old_enough && young_enough) {
  std::cout << "valid age\n";
}
多写两行,读者能直接看到条件含义。基础程序里,这种清晰度很划算。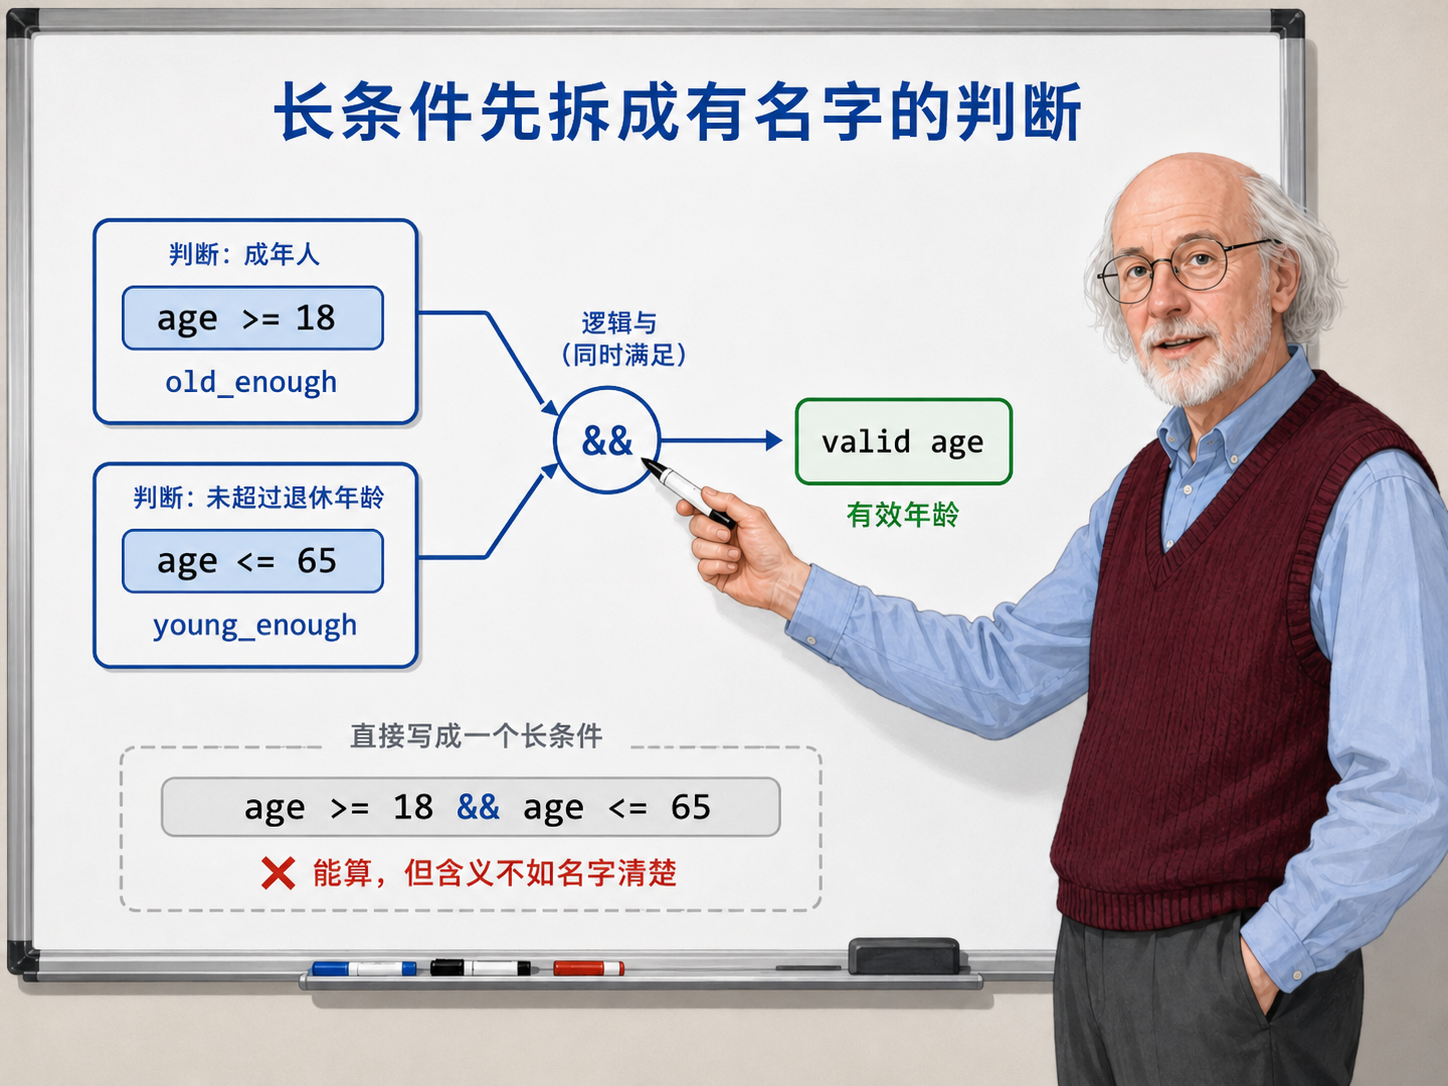
逻辑运算的难点通常不在 && 和 || 本身,而在条件含义。age >= 18 && age <= 65 还算直接;如果一行里混进输入状态、权限、分数范围和业务开关,读者就很难判断哪个条件在管什么。把条件拆开命名,本质上是在给判断过程分层。
自增自减会产生结果,也会修改变量
++ 和 -- 是 C++ 里很常见的运算符。它们会修改变量本身:
int count = 0;
++count;
std::cout << count << "\n";
++count 会把 count 加 1。作为独立语句时,它很直观。
容易让人困惑的是前置和后置的差别:
int i = 1;
int a = i++;

int j = 1;
int b = ++j;
执行完以后,i 是 2,a 是 1。i++ 产生修改前的值,然后把 i 加 1。
执行完第二段后,j 是 2,b 是 2。++j 先把 j 加 1,再产生修改后的值。
可以画成两条时间线: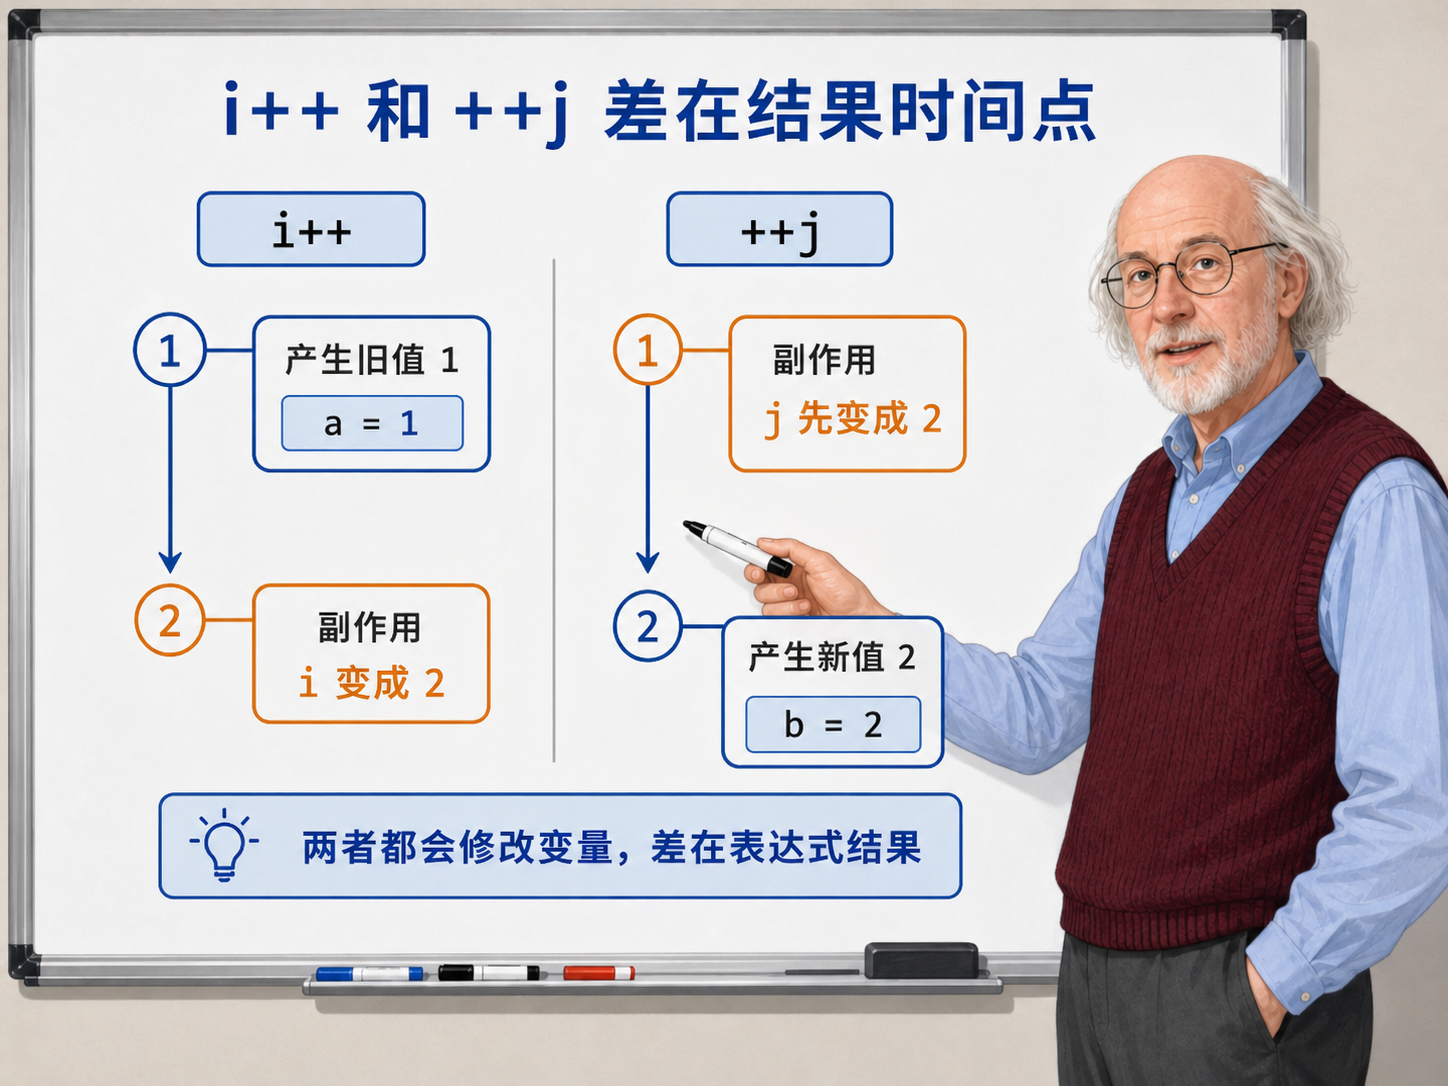
在简单循环里,经常写:
for (int i = 0; i < 5; ++i) {
  std::cout << i << "\n";
}
++i 放在这里表达"进入下一轮前让 i 加 1"。基础代码里,避免把多个自增自减塞进同一个复杂表达式。比如 values[i++] = ++count; 这种写法能编译,但读者要同时跟踪索引和值的变化,阅读成本很高。
这条习惯很实用。++i 和 i++ 的差别在某些场景里必须精确掌握,但大多数基础循环只关心"下一轮之前让 i 增加"。这时把它放在独立位置,别让它参与复杂表达式,代码会更稳定。表达式越短,副作用越明显,调试时也越容易定位。
前置和后置的区别,真正重要的场景是"自增表达式的结果还要被拿去使用"。如果它只是独立成一句,++count; 和 count++; 都会让 count 增加 1。工程代码里常用前置 ++i,原因之一是它直接表达先修改再得到新值,对迭代器这类对象也更自然。基础阶段不要把精力花在微小性能传闻上,先把"结果"和"副作用"分清楚。
赋值表达式和复合赋值
赋值也是表达式:
score = score + 5;
它的核心动作是把右边表达式的结果写入左边对象。score + 5 先计算,然后结果覆盖 score 原来的值。
常见写法可以简化成复合赋值:
score += 5;
count -= 1;
total *= 2;
score += 5 表达的是"在原来的基础上加 5"。它比 score = score + 5 更短,意图也很清楚。基础阶段掌握几种常见形式即可。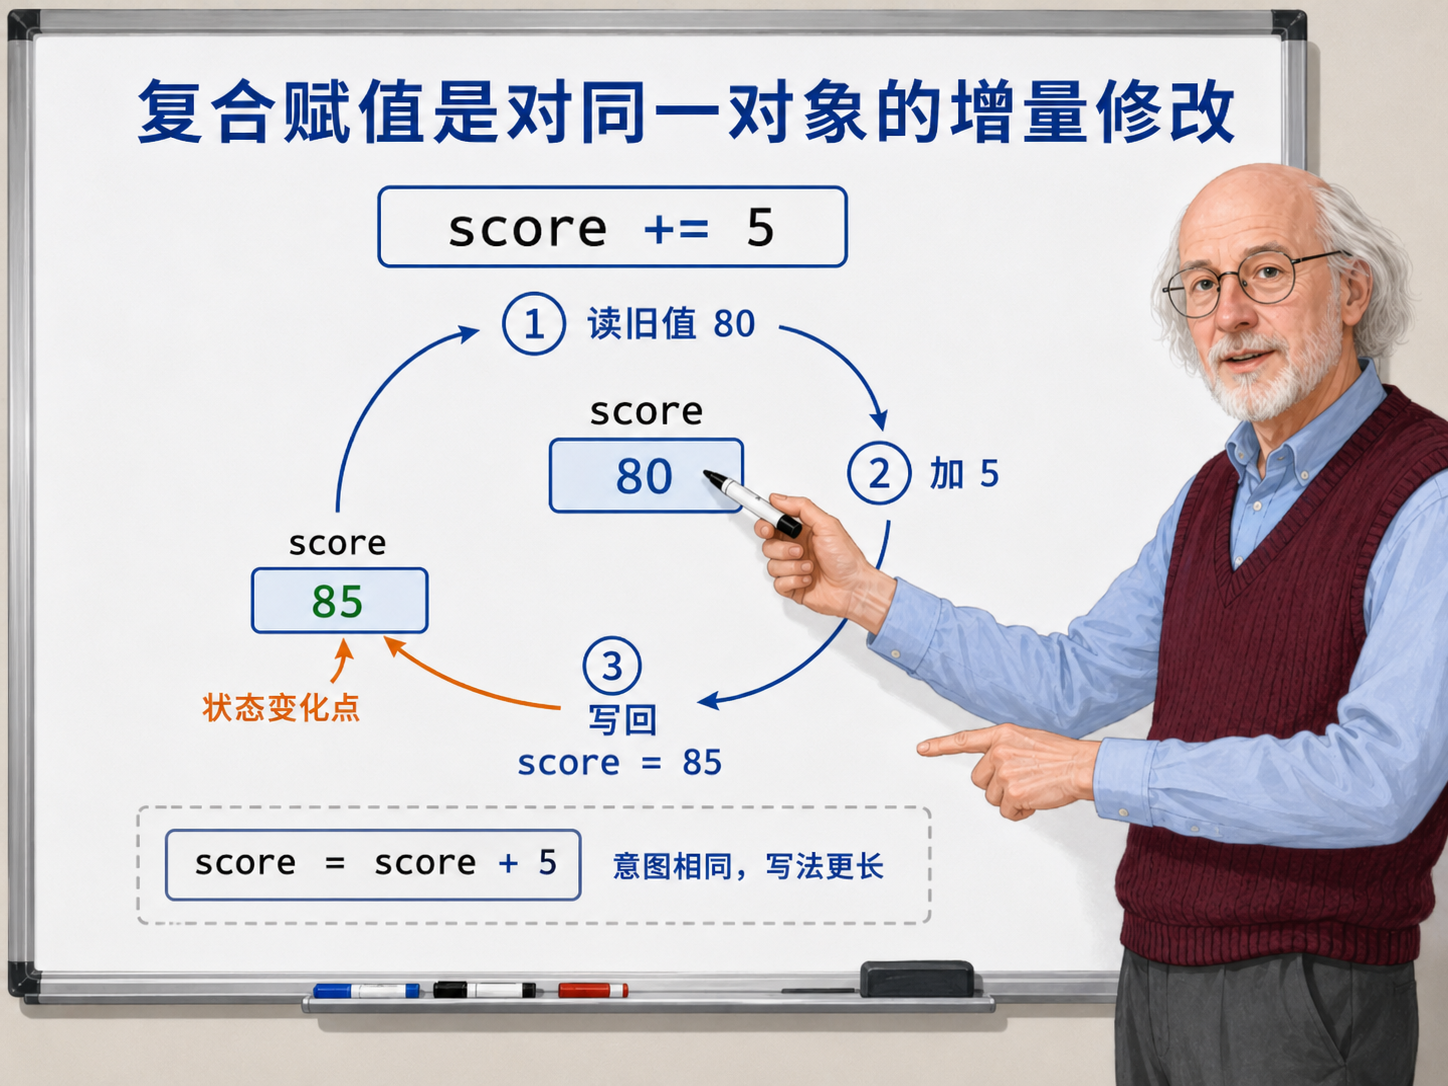
复合赋值适合表达对同一个变量的增量修改。要是右边表达式很长,拆开写会更容易检查:
int bonus = attendance_score + project_score;
score += bonus;
表达式要服务于阅读,长度排在清晰度后面。代码最终要被人读,变量名和中间结果能帮读者理解计算过程。
赋值表达式的核心是"改变已有对象"。这和上一章的初始化不同。初始化建立一个对象的初始状态,赋值改变对象后来的状态。读程序时看到赋值,要意识到从这一行开始,后面读到的对象值已经变了。
赋值左边通常应该是一个清楚的目标对象。score = score + 5; 很容易读,因为左边就是被修改的对象。复合赋值把这件事写得更短:score += 5;。如果你发现赋值左边或右边都很复杂,就应该考虑拆中间变量。赋值是状态变化点,状态变化点越清楚,调试时越容易定位问题。
整数除法和类型转换
类型会影响表达式的计算规则。最常见的坑是整数除法:
int total = 10;
int count = 4;
double average = total / count;
std::cout << average << "\n";
很多人预期结果是 2.5。实际结果通常是 2。原因是 total 和 count 都是 int,total / count 按整数除法计算,结果先变成整数 2,再放进 double average。
要得到浮点结果,需要让除法表达式里至少有一边按浮点数参与:
double average = static_cast<double>(total) / count;
static_cast<double>(total) 明确把 total 转成 double,于是除法按浮点规则计算。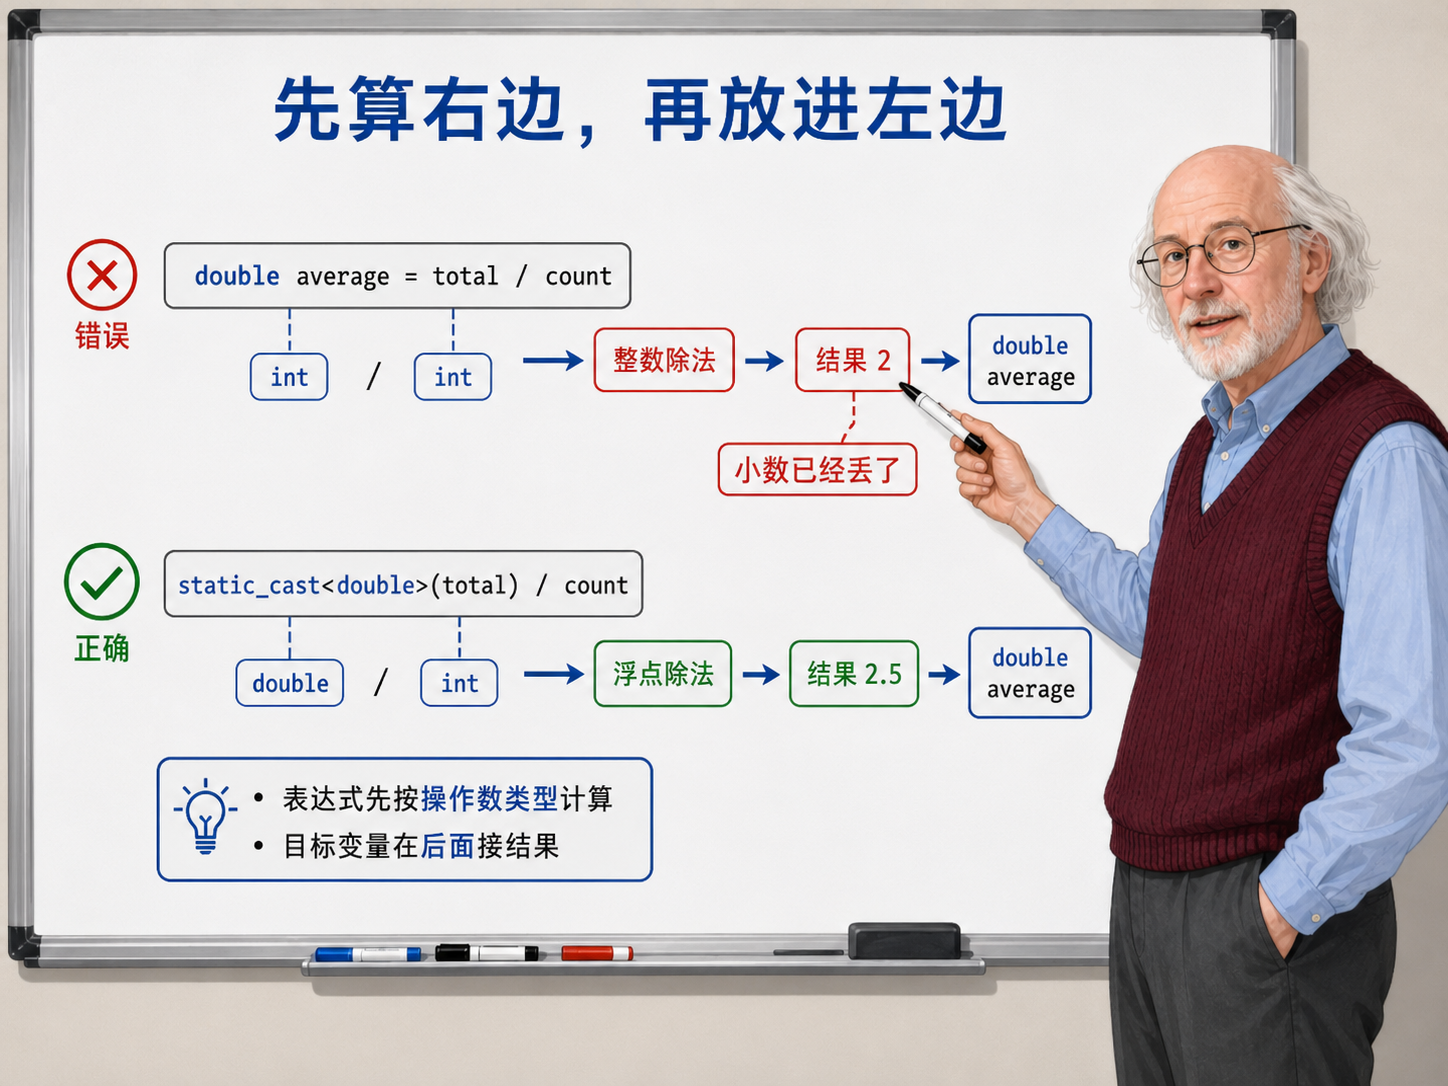
类型转换要写得清楚。static_cast<double> 看起来比偷偷依赖隐式转换长一点,但它把意图写在了代码里:这里需要浮点除法。计算平均值、比例、价格时,这种显式转换能避免很多"结果怎么少了小数"的问题。
也可以从一开始就使用 double:
double total = 10.0;
int count = 4;
double average = total / count;
哪种写法更合适,取决于数据本身。学生人数适合整数,平均分适合浮点数。表达式计算时,数据的类型会一路参与规则判断。
完整类型转换规则很复杂。第一阶段先记住这个工程判断:遇到除法,先确认你想要整数结果还是带小数结果;想要带小数,就明确让浮点类型参与计算。
这里还可以顺手建立一个读法:表达式的计算规则先看参与计算的操作数类型,再看结果放到哪里。double average = total / count; 左边是 double,但右边已经先按整数除法算完了。结果放进 double 时,小数部分已经不存在。很多类型问题都出在这个顺序上:先算表达式,再用结果初始化或赋值给目标变量。
一段完整演示
下面这段代码把本章概念放在一起:
#include <iostream>

int main() {
  int price = 20;
  int count = 3;
  int fee = 5;
  int total = price * count + fee;

  bool expensive = total > 50;
  bool valid = count > 0 && total >= 0;

  int i = 1;
  int old_value = i++;

  int j = 1;
  int new_value = ++j;

  int score = 80;
  score += 5;

  int sum = 10;
  int number_count = 4;
  double average = static_cast<double>(sum) / number_count;

  std::cout << "total = " << total << "\n";
  std::cout << "expensive = " << expensive << "\n";
  std::cout << "valid = " << valid << "\n";
  std::cout << "old_value = " << old_value << ", i = " << i << "\n";
  std::cout << "new_value = " << new_value << ", j = " << j << "\n";
  std::cout << "score = " << score << "\n";
  std::cout << "average = " << average << "\n";
  return 0;
}
读这段代码时,可以按这个顺序:
表达式把数据算成结果。比较和逻辑表达式会算出 bool。下一章的控制流会接过这些 bool 结果,让程序根据条件选择不同路线。
阅读导航



