
C++ 入门程序:main、cout 与编译运行流程
01 一个最小 C++ 程序是怎么跑起来的
我们先打开编辑器,新建一个名为 hello_cpp.cc 的文件,然后敲下这几行代码:
#include <iostream>

int main() {
  std::cout << "Hello, C++\n";
  return 0;
}
这已经是一个完整且能够真正在终端里运行的 C++程序了。虽然看起来只有短短 5 行,但它已经涵盖了 C++ 程序最核心的一条执行主线:源代码首先会被编译成可执行文件,接着操作系统把它加载到内存;程序从 main 函数开始,按顺序执行每一条语句,通过标准输出流把结果打印到终端,最后用一个状态码结束运行。
这一章,我们就专门把这条主线走通。以后不管学到多复杂的特性——变量、函数、对象、模板,甚至并发,都会回到这个最基础的起点:写在文件里的代码,到底是怎么在机器上一步步跑起来的?
这 5 行代码各自负责什么
咱们一行行拆开看,先看最开头的这句:
#include <iostream>
#include 是一条预处理指令。它的作用很简单:在编译器正式检查你的源文件之前,先把另一个头文件的内容引入进来。在这里,我们引入了 <iostream>,这是 C++ 标准库里负责基础输入输出的头文件。因为下面我们会用到 std::cout 这个来自标准库的名字,编译器必须先看到相关声明,才知道后面的输出语句该怎么处理。
现阶段,你可以把 <iostream> 当成一份接口说明书。有了它,当前的源文件就知道有个叫 std::cout 的标准输出对象存在,编译器也明白了 << 这种写法可以把数据写入输出流。关于头文件展开、翻译单元、链接器和符号解析的深层细节,我们会留到后期的编译链接专题里再去完整展开,现在先掌握使用方法即可。
接着往下是一行空行。空行对编译器来说几乎没有影响,但对阅读代码的人很重要。代码最终既要交给机器处理,也要让人能长期维护。合理的留白能让代码结构更加清晰,读者也能更快理清逻辑层次。
再往下,是程序的真正入口:
int main() {
main 是 C++程序的入口函数。一个普通的 C++ 程序启动时,系统运行环境会直接调用 main,你的所有业务逻辑都是从这里开始的。前面的 int 表示这个函数执行完毕后,会向启动它的环境返回一个整数。后面跟着的括号 () 里现在是空的,说明这个最小的程序暂时不接收命令行参数。
最后那个左大括号 { 非常关键,它标记了 main 函数体的开始。在 C++ 里,大括号的作用就是把一组语句打包成一个块,在遇到配对的右大括号 } 之前,中间的所有内容都属于 main。往后在遇到条件判断 if、循环 for,以及各种函数和类的时候,你会频繁看到大括号,它的核心作用就是帮忙划定清晰的代码边界。
进到大括号里,我们看到了真正负责产生输出的语句:
std::cout << "Hello, C++\n";
std::cout 是标准输出流对象,它默认连接到终端。std:: 这个前缀说明这个名字属于标准库的命名空间。命名空间的作用是给代码元素进行归属分类,标准库把自己的元素都放在 std 里,你自己以后写代码也可以定义自己的名字。这样不仅名字来源一清二楚,还能有效避免命名冲突。
紧跟着的 << 是流插入运算符。它负责把右边的内容输送到左边的输出流里。右边的 "Hello, C++\n" 是一个字符串字面量,也就是写在双引号里的固定文本。特别要注意末尾的 \n,它代表换行符。反斜杠加上 n 组成了一个不可见的控制字符,专门用来告诉终端,当前这一行到这里就结束了。
在这行代码的最后,有一个不可或缺的分号:
;
在 C++ 中,绝大多数普通语句都需要用分号来结束。编译器就是靠分号来断定一条语句在哪里收尾的。初学者刚写代码时最容易犯的错误之一就是漏写分号,而且报错位置往往出现在下一行,因为编译器一直读到下一行,才发现上一句话还没有结句。
main 函数的最后一条语句是:
return 0;
return 用来结束当前所在的函数。在这里,它结束的就是整个 main 函数。跟在后面的 0 就是返回给运行环境的状态码。按照软件开发的通用约定,返回 0 表示程序正常结束,如果是其他非零的数值,通常暗示程序中途碰到了某种错误。这个状态码看似不起眼,但在编写脚本、运行自动化测试、或者做工程构建时,外部工具非常依赖它来判断程序的执行状况。
最后,用一个右大括号 } 收拢 main 函数体。到这里,一个结构完整的最小 C++ 程序就呈现在你眼前了。
程序运行时从哪里开始
人在读文件时,习惯从第一行往下看。但程序运行时的主线,是直接从 main 函数内部开始的。像最开头的那句 #include <iostream>,属于编译前处理阶段的任务,等程序真正跑起来的时候,它的工作早就已经完成了。
你可以把这段程序的运行路径理解为一条直接的线索:
运行环境调用 main
  ↓
执行 std::cout << "Hello, C++\n";
  ↓
终端收到输出内容并显示
  ↓
执行 return 0;
  ↓
程序结束并交回状态码

这条线是读懂 C++ 程序的第一个核心抓手。随着代码变得复杂,执行路线里会加入函数调用、条件分支、循环往复、对象构造以及异常处理。路线可能会发生改变,但基本要素——入口在哪、按什么顺序执行语句、状态怎么变化——却是一直都在的。
不过为了严谨起见,这里需要明确一个边界:严格来说,当一个进程刚启动时,操作系统和运行时环境还要在底层做一些准备工作,比如初始化标准库和全局对象,之后才会正式进入 main。但在第一阶段,我们主要把注意力集中在自己编写的代码主线上,至于底层的启动细节,我们会留到后面的工程和编译链接章节再具体讨论。
源代码怎样变成可执行文件
写在 .cc 文件里的内容本质上只是文本,CPU 只能执行底层的机器指令。在 C++ 的开发闭环里,编译器负责把源代码转化为机器能够运行的程序。
假设你把刚才的代码保存为 hello_cpp.cc 文件,在 macOS 或 Linux 终端里,你可以通过下面这行命令进行编译:
clang++ -std=c++20 hello_cpp.cc -o hello_cpp
clang++ 是 C++编译器;-std=c20 表示按照 C++20 的标准来检查代码;hello_cpp.cc是输入的源文件;而-o hello_cpp则是指示编译器把最终生成的可执行文件命名为hello_cpp`。
如果编译成功,当前目录下就会多出一个名为 hello_cpp 的文件。这时候运行它:
./hello_cpp
终端屏幕上就会打印出结果:
Hello, C++
从纯文本的源文件到最终看到输出结果,整个流程梳理下来就是:

这就是 C++ 开发的一个最简闭环。你修改源代码,重新编译,然后再次运行查看结果。以后当工程规模不断扩大,出现了多个源文件、头文件、静态库,甚至引入了复杂的构建系统和链接步骤时,最底层的运行逻辑依然是这条线。
编译错误该怎么读
在初学 C++ 的阶段,遇到编译错误是件非常正常的事。这些报错其实是编译器在程序运行前给出的拦截信号。相比于程序跑起来之后产生未知的错误结果,在编译阶段直接发现问题反而更容易定位和修复。
例如,我们试着把分号删掉:
#include <iostream>

int main() {
  std::cout << "Hello, C++\n"
  return 0;
}
这时候编译器通常会提示缺少 ;。有时报错的位置会落在 return 0; 那一行,因为它读到 return 时才确认上一条语句确实没有正常结束。所以在处理这类错误时,可以先看报错的第一条提示,如果当前行看着没问题,就检查一下它的上一行。很多连锁报错,都是由前面漏掉一个小符号引起的。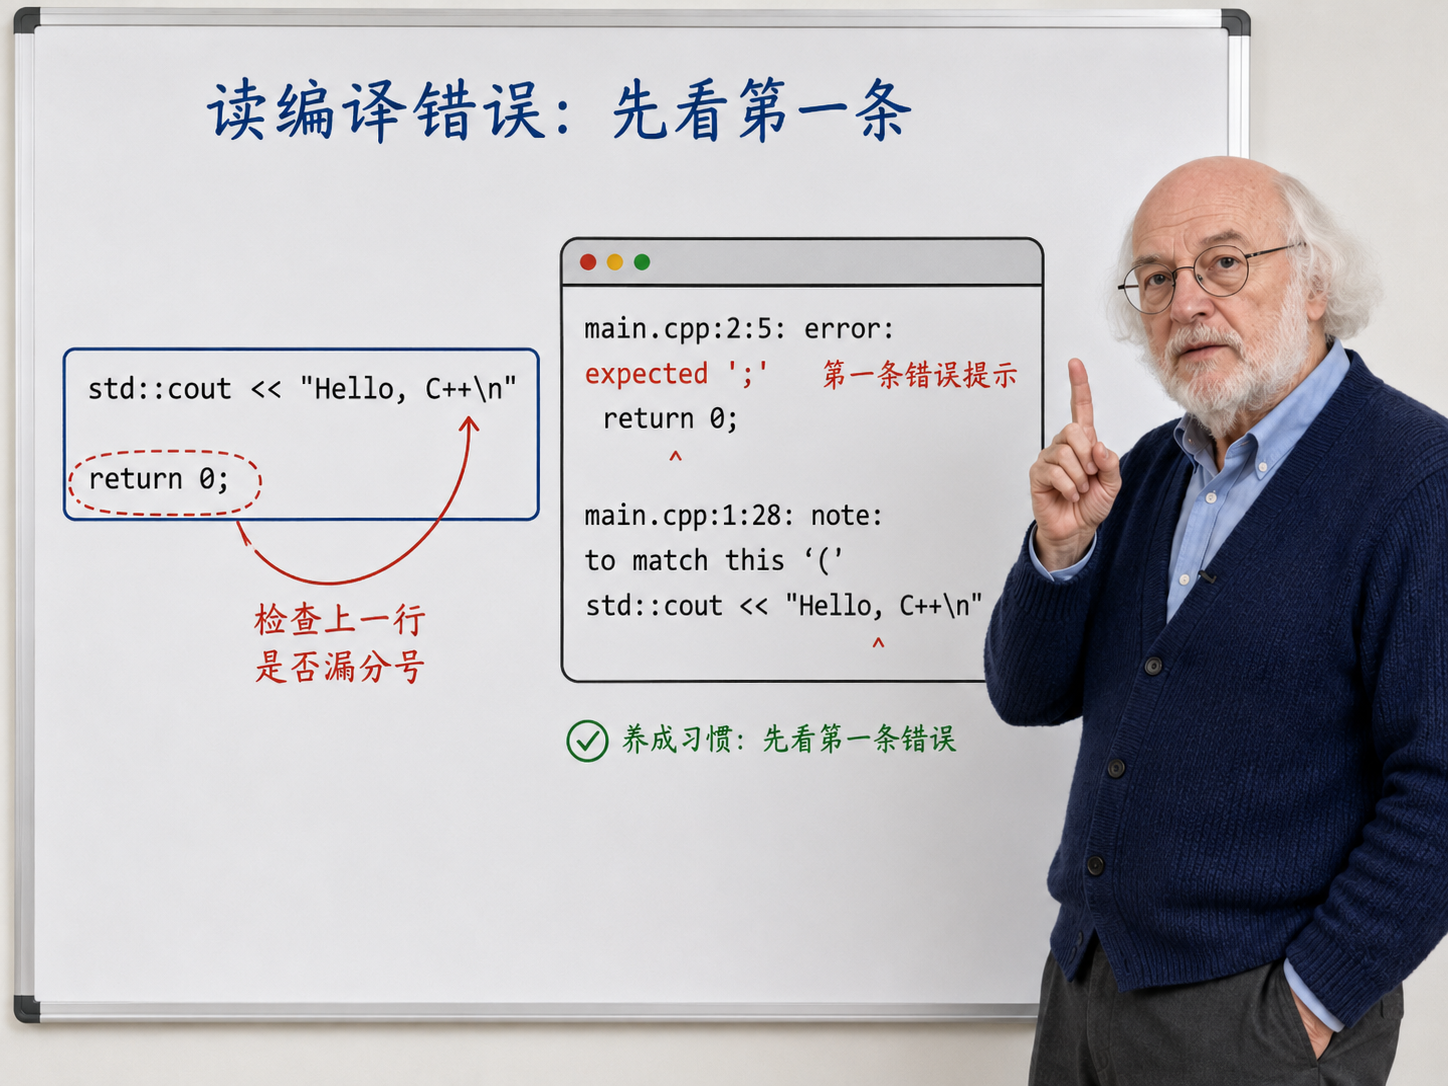
再比如,如果你省略了 std::cout 的前缀:
#include <iostream>

int main() {
  cout << "Hello, C++\n";
  return 0;
}
编译器就会告诉你它找不到 cout 这个名字。原因很直接:标准库里的输出对象全名叫 std::cout。虽然以后你会学到用 using 声明来省略前缀的方法,但在入门阶段,建议你保留 std::。这不仅能提醒你该名字来自标准库,还能有效避免以后自己命名时发生冲突。
另外,在平时编译时,建议加上 -Wall 参数:
clang++ -std=c++20 -Wall hello_cpp.cc -o hello_cpp
-Wall 会开启一批常用的编译器警告。警告和错误不同,它不会阻止程序生成,但经常能精准指向潜在的代码风险。比如你定义了一个变量却没有使用,或者函数的返回值处理不完整,编译器都会提醒你。尽早养成阅读警告的习惯,能帮你避开许多隐蔽的逻辑问题。
std::cout 到底把内容送去了哪里
我们可以把 std::cout 理解为一条默认连接着终端屏幕的输出通道。只要你把文本、数字,甚至是表达式的结果传递给它,它就会负责把这些内容写入标准输出。终端随后会将标准输出的内容显示在屏幕上。
流插入运算符 << 是可以连续使用的:
#include <iostream>

int main() {
  int answer = 42;
  std::cout << "The answer is " << answer << "\n";
  return 0;
}
编译运行这段代码,屏幕上会显示:
The answer is 42
在这个过程中,有三个不同的内容被依次送进了 std::cout:字符串文本 "The answer is "、包含数字的变量 answer,以及换行符 "\n"。标准输出流能够正确识别并处理各种常见的数据类型,所以你可以放心地把文本和数字混合在一起输出。至于这个流对象在内部是如何缓冲数据、何时真正调用系统接口,以及怎样和终端具体绑定的,这些内容会在后面的标准库和操作系统章节中详细展开。
刚才的代码,也顺带引出了下一章我们要重点讨论的概念——变量:
int answer = 42;
在这里,int 指定了数据的类型为整数,answer 是我们给这个变量起的名字,而 42 则是赋予它的初始值。目前你只需要知道,变量可以用来保存一个数值,并且能够被输出流读取打印即可。至于变量在内存中如何占用空间、类型如何限制取值范围和操作,下一章我们会系统地讲解。
return 0 有什么用
很多人刚接触 C++ 时,只是把 return 0; 视为一种固定的收尾格式。它确实频繁出现,但同时也承担着实际的职责:向外部的运行环境报告程序的结束状态。
我们可以写一个返回非零状态码的版本来验证一下:
#include <iostream>

int main() {
  std::cout << "Something went wrong\n";
  return 1;
}
编译并运行它:
clang++ -std=c++20 error_return.cc -o error_return
./error_return
echo $?
在 macOS 或 Linux 终端里,输入 echo $? 可以查看上一个执行程序的退出状态码。因为上面的程序返回了 1,所以终端里会显示出 1。如果返回的是 0,看到的自然就是 0。
这种状态码机制在软件工程中极为普遍。自动化构建脚本会根据上一步骤的返回值决定是否继续后续操作,测试系统依靠它来判断测试用例是否通过,部署环节也会根据状态码来确认环境是否正常。一个简简单单的整数,维系了程序和外部工具之间基础的协作。
关于 main 函数,C++ 有一条特殊的规则:如果代码执行到 main 的末尾仍然没有显式地写 return,编译器也会默认按照 return 0; 来处理。即使有这个规则,在学习阶段,我仍然建议你清晰地写出 return 0;。明确的收尾动作,能让整个程序的结构显得更加完整。
语句、空白和注释
C++ 程序就是由一条条具体的语句组成的。输出是一条语句,定义变量是一条语句,最后的 return 也是一条语句。一旦程序进入 main,在没有条件分支或循环干预的情况下,就会按顺序一条条执行下去。
分号负责结束大多数的普通语句,大括号则负责把相关的逻辑组织成代码块。至于代码里的空格、换行和缩进,主要都是为了提升可读性。你看下面这段代码,编译器完全可以正常处理:
int main(){std::cout<<"A";return 0;}
但对于读代码的人来说,看着就会很费劲。更适合长期维护的写法是这样的:
int main() {
  std::cout << "A";
  return 0;
}
这两段代码表达的机器动作一模一样,但第二种写法将逻辑层次清晰地展示了出来。main 函数的逻辑包裹在大括号内,里面清晰地分布着两条语句,先执行输出,后执行返回。这种结构层次越清晰,以后在代码中加入复杂的条件判断、循环和函数时,就越不容易出错。
除了留白,我们还可以写注释。注释是写给人看的,编译器在处理时会自动忽略它们。单行注释以 // 开头,一直到当前行结束:
// 输出一行问候语
std::cout << "Hello, C++\n";
注释主要用来解释代码背后的意图、边界情况或设计考量。像 // 输出一行问候语 这样的简单注释,在教学代码中用于对齐思路是没问题的;但在实际的工程代码中,更有价值的注释通常是用来解释"为什么要采取这种做法",或者提醒后续维护者需要注意哪些潜在问题。
一个稍微完整的小程序
把前面讲的这些元素结合在一起,我们可以写出一个体量依然很小,但在结构上更接近真实程序形态的示例:
#include <iostream>

int main() {
  std::cout << "Starting program...\n";

  int error_count = 0;
  std::cout << "Current error count is " << error_count << "\n";

  if (error_count > 0) {
    return 1;
  }

  return 0;
}
在这个程序中,引入了一个变量和一个条件分支。error_count 是一个用来记录错误数量的变量。程序启动后,先输出一行启动信息,接着打印当前的错误数量。紧随其后的 if 语句负责检查这个数值:如果错误数量大于 0,程序直接 return 1; 报告异常;如果没有出现错误,程序就会顺利走到末尾并 return 0;。
尽管这段代码很短,但它已经具备了正式程序的基本骨架:先准备好所需的数据,然后根据数据的状态进行逻辑判断,最后输出结果并报告程序的运行状态。接下来的章节中,我们会把这里提前露面的概念逐步深入拆解开。比如变量如何在内存中保存值,表达式如何计算出结果,if 语句如何改变执行路线,以及函数如何将复杂的逻辑切分为小模块,所有的内容都会沿着这条主线继续往前推进。
读 C++ 程序的第一套顺序
当拿到一份陌生的 C++ 代码时,第一步先去找 main。只要找到了这个入口,程序的执行主线就有了明确的起点。源文件的开头可能会包含很多 #include 指令,后面也可能跟随着大量的函数和类型定义,在第一遍阅读时,可以先跳过它们,牢牢抓住程序运行时的走向才是最重要的。
找到 main 之后,就顺着函数体往下阅读。遇到变量定义,就在脑海中记下这个名字当前保存了什么数据。看到输出语句,就留意它究竟把什么内容发送到了哪里。当遇到 return 时,弄清楚程序是在什么条件下结束的,以及返回了怎样的状态码。
在顺着主线阅读时,如果碰到了函数调用,第一遍只需了解它接收了什么参数,以及返回了什么结果即可。至于函数内部的复杂实现细节,完全可以等主线理顺之后再回头深究。在稍微大规模的工程中,如果一开始就一头扎进函数的局部细节,很容易就会迷失方向,把主线弄丢。
遇到 if、for、while 这种控制流结构时,可以将它们视为路线上的分叉口或重复执行路径。条件成立时走哪条路线,条件不满足时程序又回退到哪里,弄明白这些结构上的流向,比死抠每一行的具体细节要重要得多。程序真正的行为意图,往往就隐藏在这些控制流之中。
这套阅读代码的顺序,可以归纳成一张简洁的结构图:
这套阅读顺序,也可以反过来指导你写代码。脑海中先有一个入口,再考虑需要哪些数据,接着规划执行的分支路径,最后把繁琐逻辑拆到具体函数里。代码按这条主线组织,别人阅读时也更容易抓住程序在做什么。
第一章不要求你立刻理解所有细节。你现在只需要有一条稳定主线:程序从 main 开始,语句按顺序执行,输出流把内容送到终端,return 把状态码交回运行环境。后面的章节会逐步把变量、表达式、控制流和函数展开。先把这条主线抓稳,后面每个概念都有落点。
动手时先做这几件事
这一章的目标是帮你把 C++ 的最小运行闭环跑通。理解概念之后,直接在终端里实验一遍。
第一步,创建 hello_cpp.cc 文件,输入我们这个最精简的程序:
#include <iostream>

int main() {
  std::cout << "Hello, C++\n";
  return 0;
}
接下来,编译并运行它:
clang++ -std=c++20 -Wall hello_cpp.cc -o hello_cpp
./hello_cpp
echo $?
当你看到终端打印出 Hello, C++,并通过 echo $? 看到状态码 0 时,说明整个编译运行的闭环已经走通了。
接着,你可以尝试做三个小实验:一是故意删掉句末的分号,看看编译器是如何报错拦截的;二是将 std::cout 改成 cout,观察名字查找错误长什么样;三是把 return 0; 改成 return 1;,再次用 echo $? 查看状态码是如何变化的。
这几个小实验做起来很简单,但它们能把 C++ 第一层规则变成实际经验。你会开始习惯:语句必须用分号结束,使用标准库元素要加上 std:: 前缀,程序结束时会留下一个状态码,编译器会在运行前帮你检查出许多基础错误。把这些规则转化为实际手感,比单纯记忆技术名词更有价值。
当程序能够在你的环境中顺畅跑起来之后,下一步的重点自然会落到数据上。只打印固定文本的程序,行为是相对刻板的;只有当我们引入变量后,程序才真正具备了保存数据、读取数据,以及根据数据变化做出逻辑判断的能力。数据类型规定了数据的基础模样,变量则为这些数据赋予了能够被代码识别和使用的名称。在下一章里,我们就会顺着这个思路继续深入探讨。
阅读导航



